https://newsletter.semianalysis.com/p/huawei-deepseek
2026.10.22
[The Huawei-DeepSeek Symbiosis]
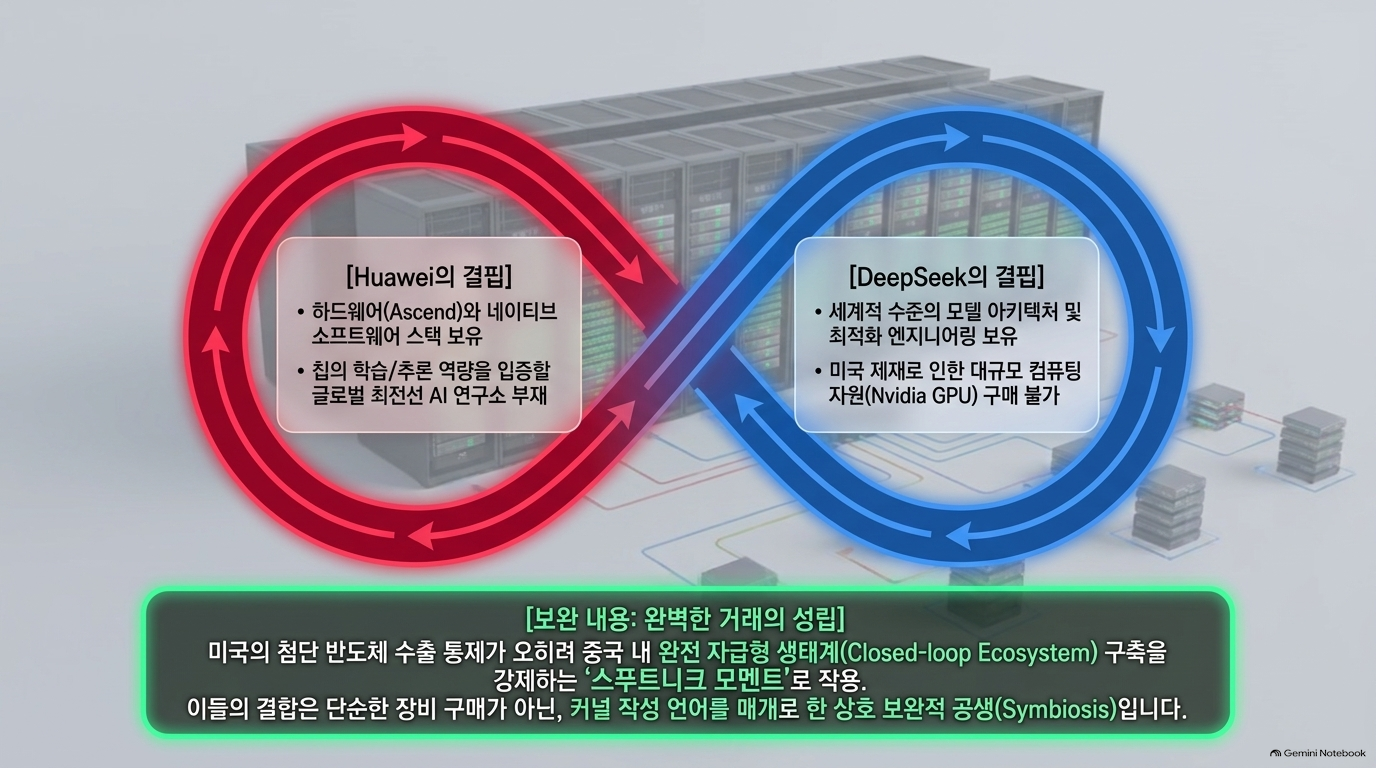
본문은 화웨이의 Ascend 950 하드웨어와 딥시크(DeepSeek)의 첨단 소프트웨어 생태계가 결합하는 상호 협력 관계를 심도 있게 분석합니다. 화웨이는 뛰어난 하드웨어 자원을 제공하지만 모델을 검증할 연구소가 부족하고, 딥시크는 우수한 AI 모델을 지녔으나 필요한 연산 장치를 구하기 어려운 한계를 지니고 있습니다. 따라서 두 기업은 상생 관계(Symbiosis)를 통해 화웨이의 네이티브 소프트웨어 스택과 딥시크의 엔지니어링 및 워크로드를 상호 교환하며 각자의 부족한 점을 보완합니다. 이 과정에서 딥시크의 여러 저장소에 Ascend 지원이 추가되어, 하드웨어 성능을 극대화하는 커널 최적화와 효율적인 데이터 구조 재편이 이루어집니다. 궁극적으로 이 분석은 기술적 제재 속에서도 자국 내 AI 생태계를 구축하려는 중국의 노력과, 하드웨어의 한계를 소프트웨어로 극복해 나가는 두 기업의 협력 과정을 명확하게 보여줍니다.
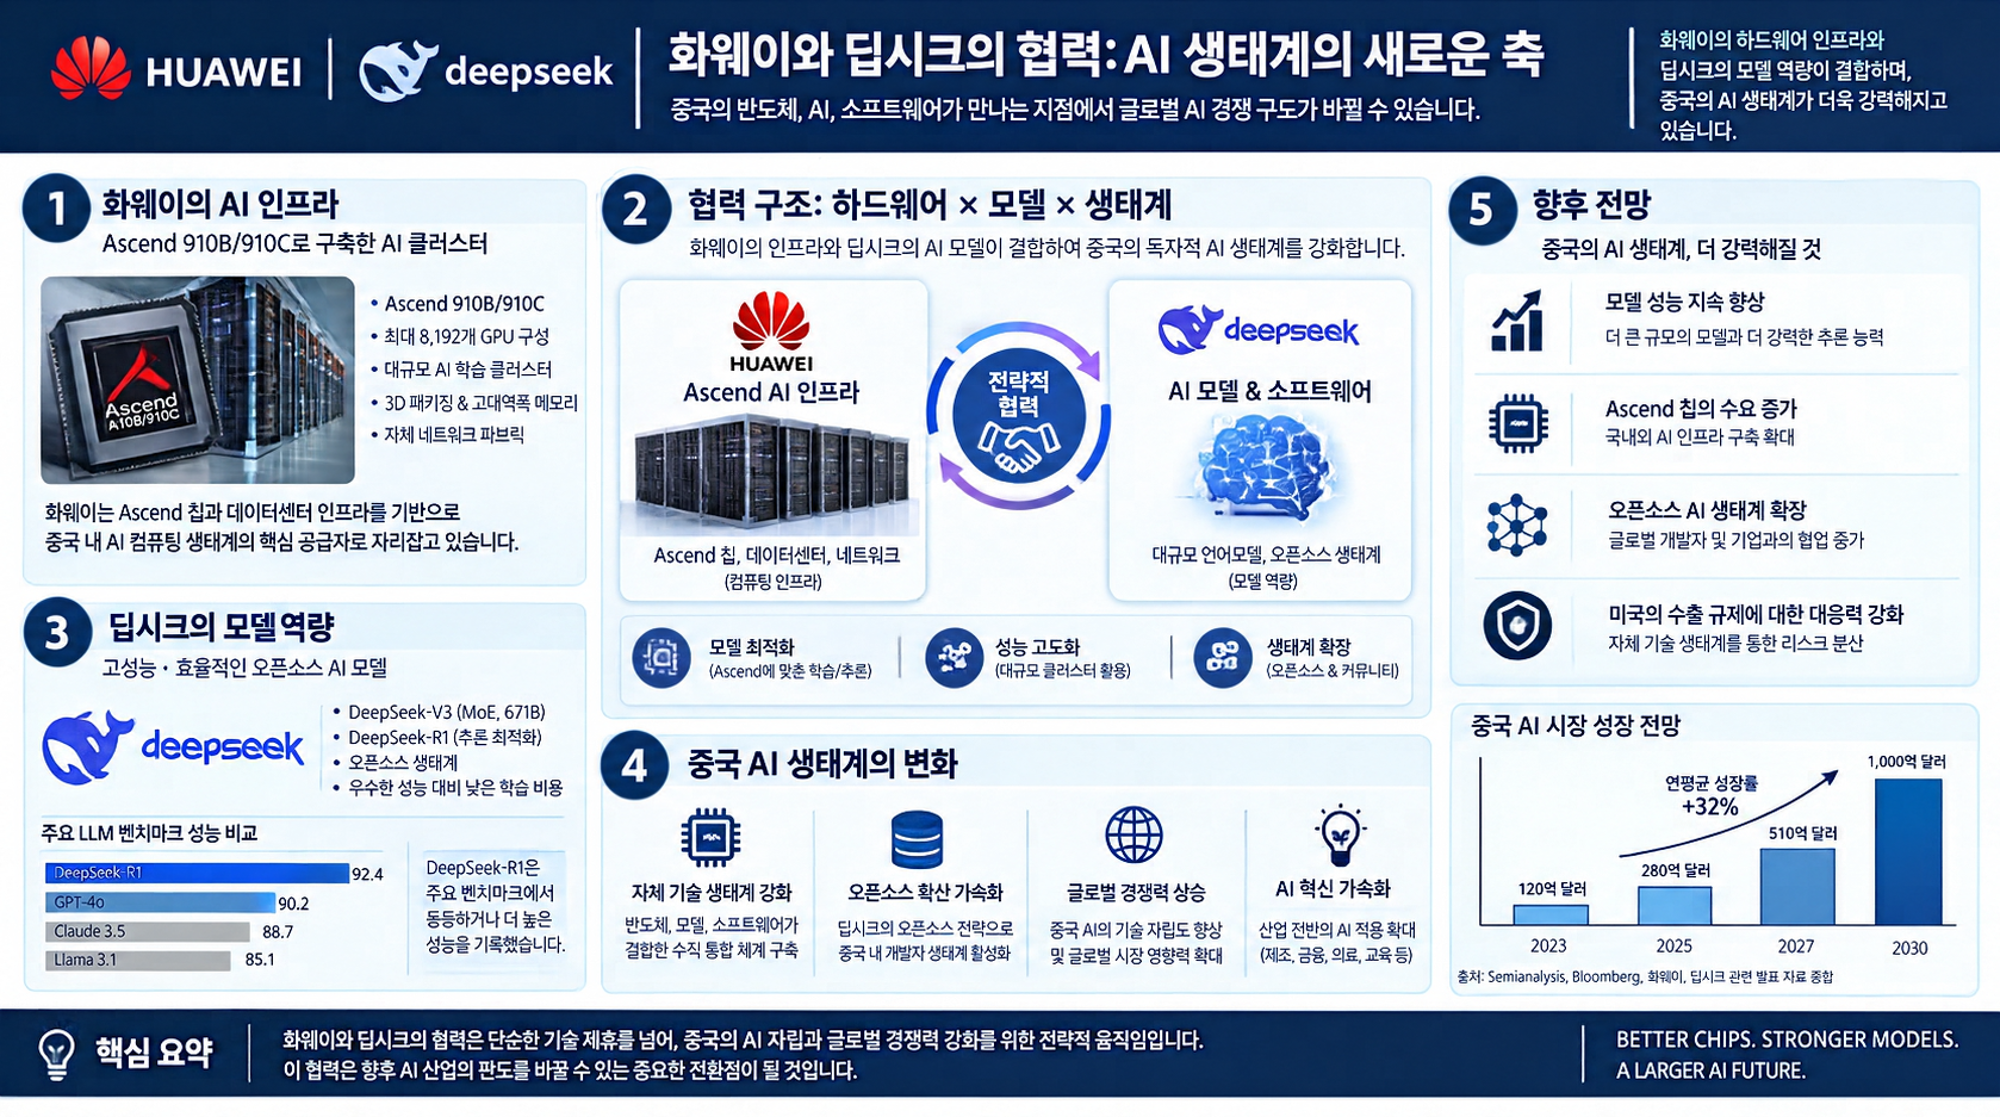
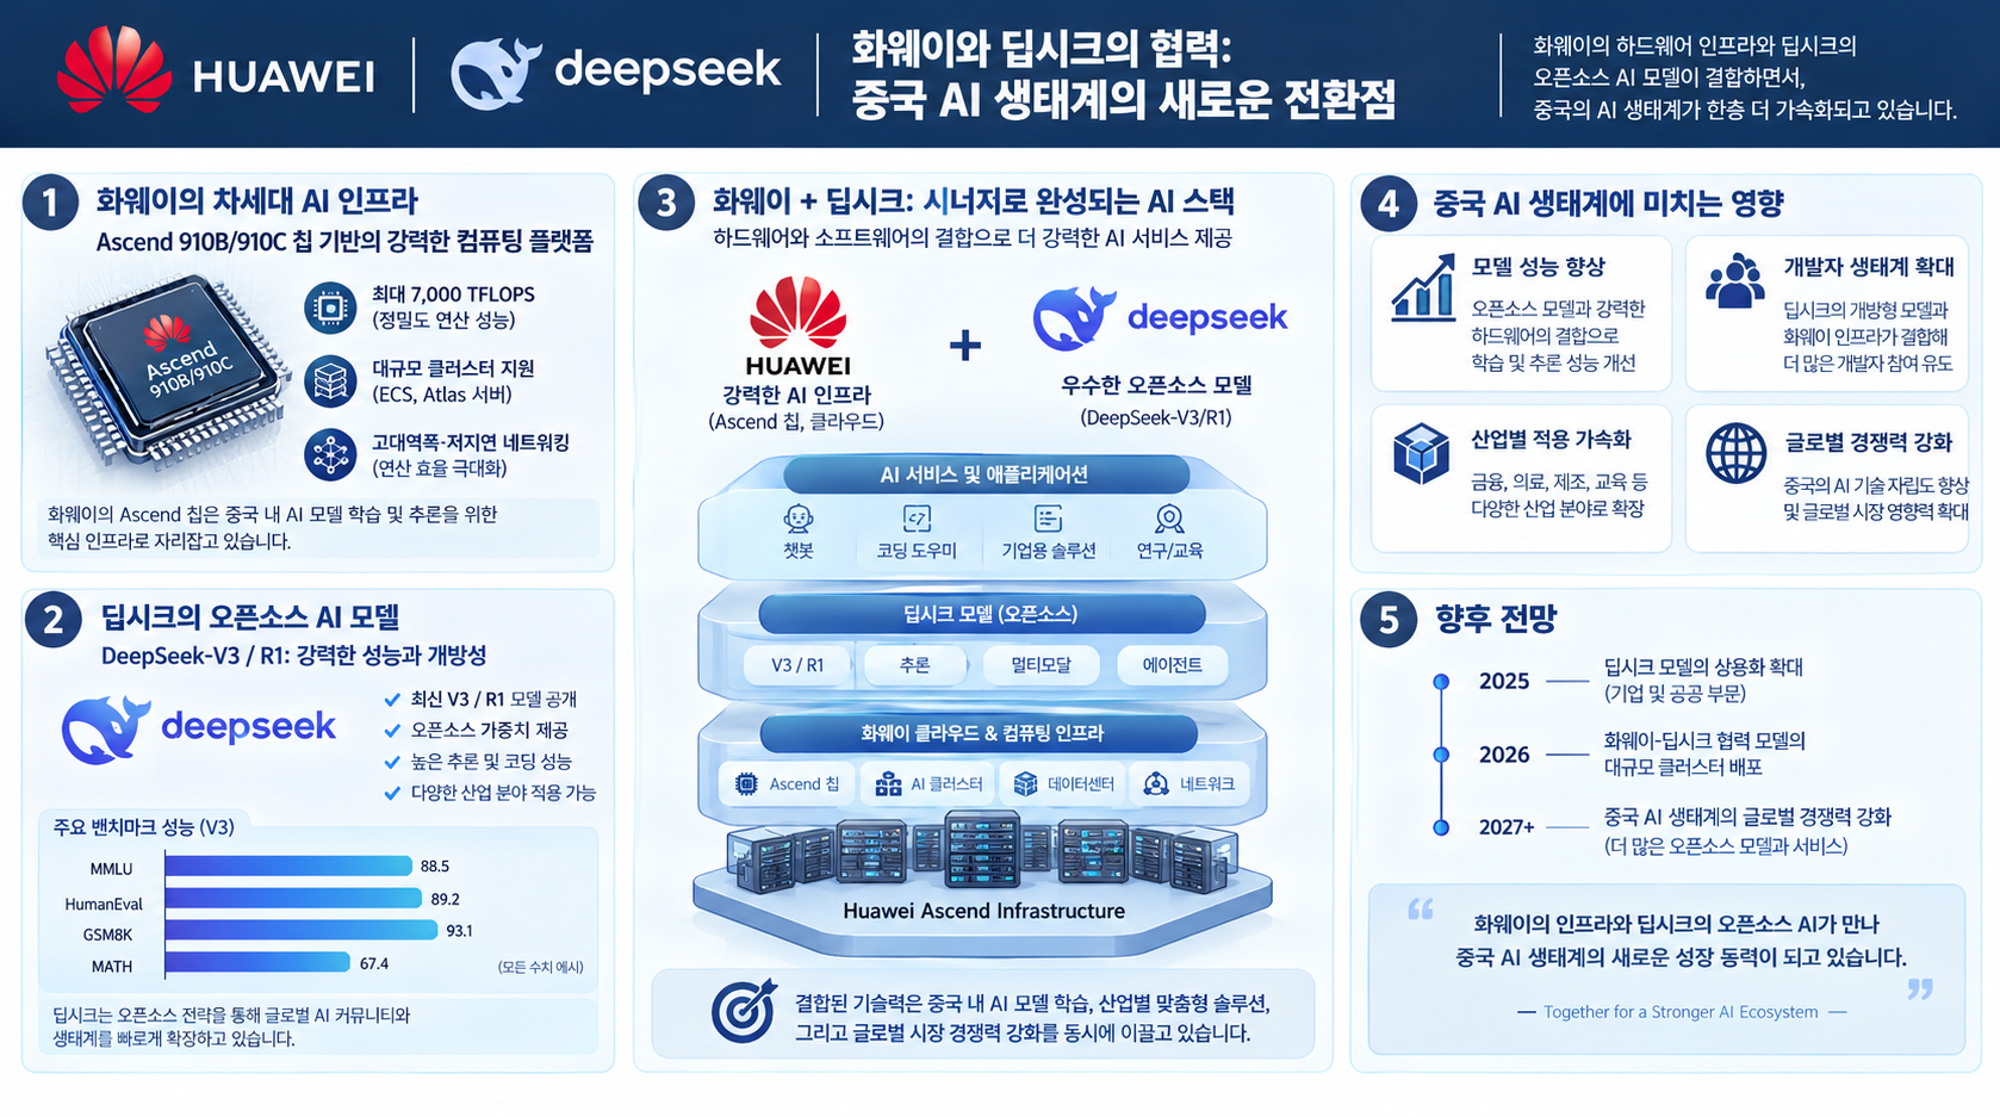
이 글의 핵심은 “Huawei가 NVIDIA를 추월했다”가 아니라, “DeepSeek의 실제 모델·엔지니어링과 Huawei의 하드웨어·시스템 소프트웨어가 결합하면서, 개별 연산 성능을 실사용 가능한 AI 플랫폼으로 전환하고 있다”는 것입니다.
- 원문: The Huawei-DeepSeek Symbiosis — Bryan Shan·Dylan Patel, 2026년 10월 21일.[1]
- 분석 범위: 추출된 본문의 마지막 「Ecosystem gaps」 내 x86 호환성 항목까지입니다. 이후에는 유료 구독 경계가 있어 추가 내용은 포함하지 않았습니다.
- 근거 구분: 아래 수치는 원문에 보고된 측정·자료입니다. 핵심 성능 그래프도 확인했으나, 벤치마크를 독립 재현하거나 연결된 저장소 전체를 검증한 것은 아닙니다.
- 구성: 원문의 실제 장·절 순서를 유지하되, 하드웨어 구조·연산 성능·개발 생산성·통신·모델 실행·범용성을 각각 분리하여 중복을 줄였습니다.
전체 구성
| 원문 장 | 핵심 질문 | 분석 초점 |
| 도입부 | 두 기업은 왜 서로 필요한가? | 전략적 상호보완 |
| Ascend 950 | 칩 내부는 어떻게 구성되는가? | 코어·메모리 구조와 AICPU |
| Microbenchmarks | 개별 연산은 얼마나 효율적인가? | GEMM·HBM 성능과 비교 조건 |
| DeepSeek Open Source | 최적화를 어떻게 확산시키는가? | 데이터 배치·컴파일러·통신 |
| DSv4.1 Flash Optimizations | 실제 모델에서는 어디가 병목인가? | Attention·추측 디코딩·메모리 계층·프로파일 |
| Ecosystem gaps | 다른 사용자도 같은 이점을 얻는가? | 호환성·지원 범위·유지보수 |
1. 도입부 — 서로 부족한 자산을 교환하는 관계
원문의 주장
저자는 Huawei와 DeepSeek의 협력을 다음과 같이 설명합니다.
- Huawei: 하드웨어와 네이티브 소프트웨어 스택을 보유하지만, 이를 최전선 모델 수준에서 입증할 모델·워크로드가 부족합니다.
- DeepSeek: 모델과 최적화 역량을 보유하지만, 필요한 연산 자원을 충분히 확보하기 어렵습니다.
- 따라서 Huawei는 실행 기반을, DeepSeek은 실제 모델과 이를 효율적으로 실행하는 엔지니어링을 제공합니다.[1]
9월 30일 공개된 TileLang·DeepGEMM·DeepEP·TileKernels·FlashMLA·DeepSelect의 Ascend 지원은 이 교환관계가 소프트웨어로 구체화된 사례로 제시됩니다.[1]
분석
이 관계를 단순한 “국산 칩으로의 모델 이식”으로 보면 부족합니다. 글이 강조하는 것은 다음의 피드백 구조입니다.
실제 모델의 요구 → 하드웨어 병목 발견 → 커널·컴파일러 수정 → 플랫폼 개선 → 다음 모델의 실행 기반 강화
핵심 자산은 모델 가중치만이 아닙니다. 어떤 데이터 배치와 실행 순서가 하드웨어에 맞는지 알아내는 지식까지 플랫폼에 축적된다는 점입니다.
해석의 경계
DeepSeek이 2027년 또는 2028년에 Huawei 스택을 주로 사용할 것이라는 서술은 저자의 전망입니다. 확정된 전환 일정이나 실제 사용 비중으로 읽어서는 안 됩니다. 도입부 그림도 원문에서 시뮬레이션이라고 명시합니다.[1]
2. Ascend 950 — 제품명보다 실제 SKU와 내부 자원 구성이 중요하다
2.1 다양한 SKU와 코어 구조
원문 내용
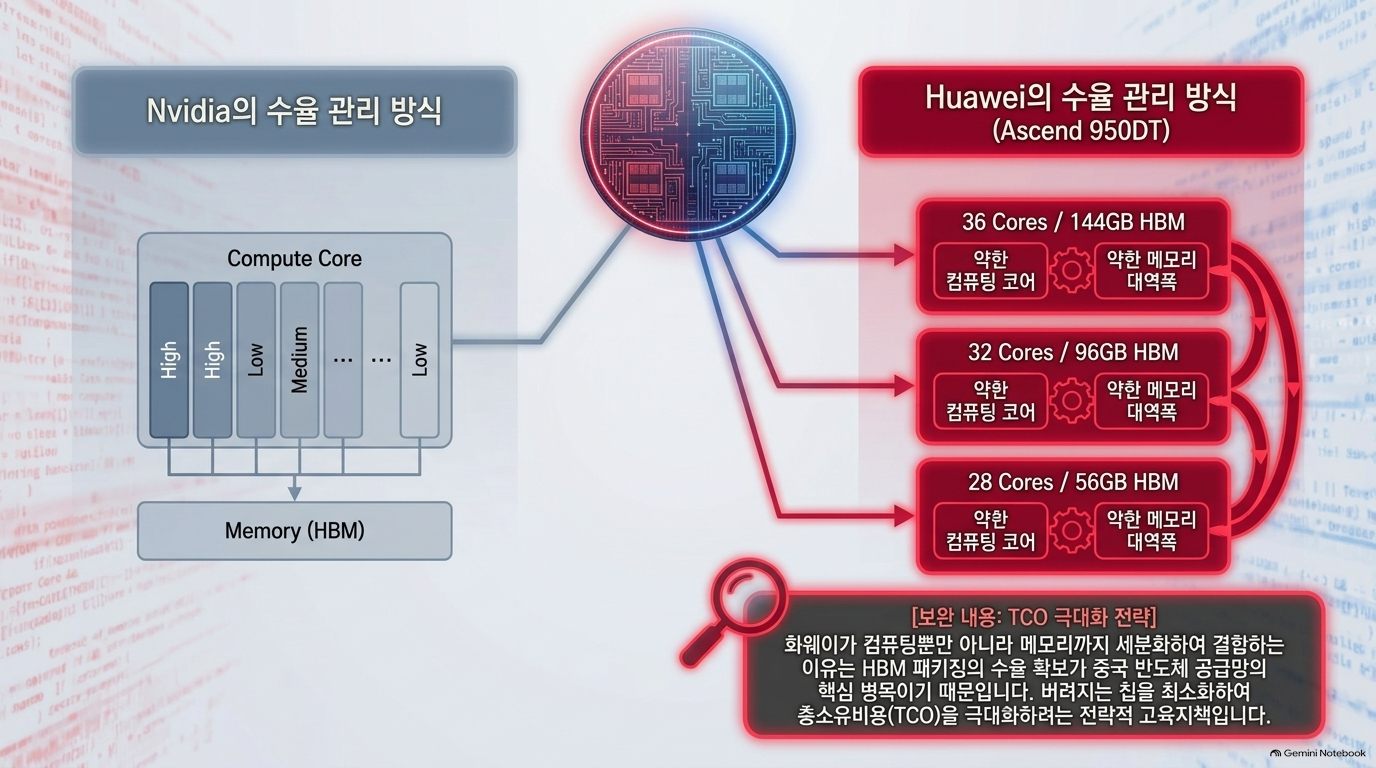
Ascend 950PR/DT에는 코어 수·HBM 구성·캐시 크기가 다른 여러 변형이 존재합니다. 저자는 제조 결함과 전력·성능 조건 미달에 대응하기 위해 Huawei가 연산 자원뿐 아니라 메모리도 함께 등급화한다고 설명합니다. 일부 변형은 가상·시뮬레이션 또는 시험용일 가능성도 언급합니다.[1]
이 글의 마이크로벤치마크 대상은 다음 구성입니다.
| 항목 | 원문에 명시된 구성 |
| SKU | Ascend 950PR_9579 |
| Cube 코어 | 28개 |
| HBM | 128 GiB |
저자는 메모리 의존 읽기의 지연과 코어 간 간섭을 측정해 내부 구조를 추정합니다. 56개 블록 이후 지연이 크게 증가하는 현상을 Vector 코어의 다음 실행 묶음이 발생하는 것과 부합한다고 해석하고, 코어별 주소 접근 특성과 간섭을 이용해 다이 및 자원 공유 그룹을 구분합니다.[1]
분석
이 절의 의미는 칩 사양표를 소개하는 데 있지 않습니다. 외부에서 관찰한 실행 특성으로 내부 자원 공유 구조를 역추론한다는 데 있습니다.
특히 Cube는 행렬 연산, Vector는 벡터 처리를 담당하므로, 코어 개수뿐 아니라 다음이 중요해집니다.
- 어떤 연산·메모리 자원을 공유하는가?
- 동시에 실행할 때 서로 간섭하는가?
- 데이터가 어느 다이에 위치하는가?
[확인 필요] 코어 그룹에 관한 실험적 근거와 물리적 배치 확정은 다릅니다. 원문도 배치도상의 물리적 위치는 개략적이라고 밝힙니다.[1]
실무 시사점: “Ascend 950 지원”만으로 성능 조건이 정의되지 않습니다. 도입 검증에서는 실제 SKU·활성 코어·메모리 구성을 고정해야 합니다.
2.2 CPU within the NPU — 작은 제어 작업을 장치 안에서 처리한다
원문 내용
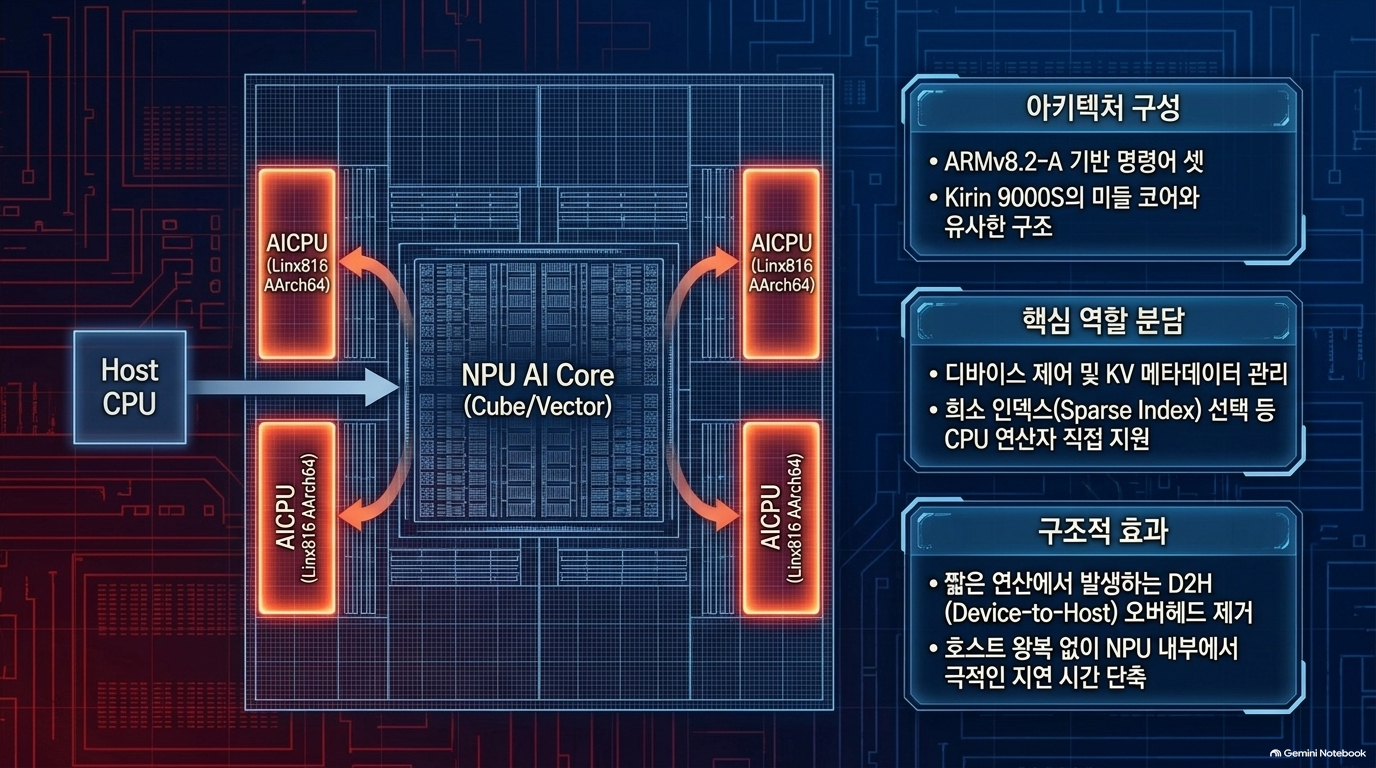
950PR에는 AArch64 계열 AICPU가 포함됩니다. 시험 SKU에서는 설정상 7개, 보이는 코어 6개, 실제 실행 코어 5개로 구분됩니다. 저자는 장치 제어뿐 아니라 KV 메타데이터 같은 CPU 성격의 연산에도 사용할 수 있다고 설명합니다.[1]
주된 장점은 계산 능력 자체보다, 짧은 작업을 위해 데이터를 호스트 CPU로 보내고 결과를 다시 받는 비용을 줄이는 데 있습니다. 원문은 DSA의 계획·인덱스 선택·gather 관련 작업을 사례로 다룹니다.[1]
분석
AICPU의 역할은 “강한 CPU를 NPU 안에 추가했다”보다 “데이터가 있는 위치 가까이에서 작은 제어 작업을 처리한다”에 가깝습니다.
효과가 기대되는 조건은 명확합니다.
- 작업 자체가 짧다.
- 데이터가 NPU에 있다.
- 결과도 NPU에서 바로 소비한다.
- 호스트 왕복 비용이 실제 계산 시간보다 크다.
따라서 모든 CPU 작업을 AICPU로 이동하는 전략은 아닙니다. 계산량이 커지면 제한된 AICPU 성능이 다시 병목이 될 수 있습니다.[1]
3. Microbenchmarks — 높은 자원 활용률과 높은 절대 성능은 다르다
3.1 BF16 GEMM — Huawei 기본 커널도 높은 효율을 보인다
원문 내용
저자는 공개 모델에서 가져온 1,055개 BF16 GEMM 형상을 비교합니다. Ascend 측 결과는 DeepSeek의 기여가 아니라, 기본 torch.matmul이 Huawei의 CANN 행렬곱 구현으로 연결된 결과입니다.[1]
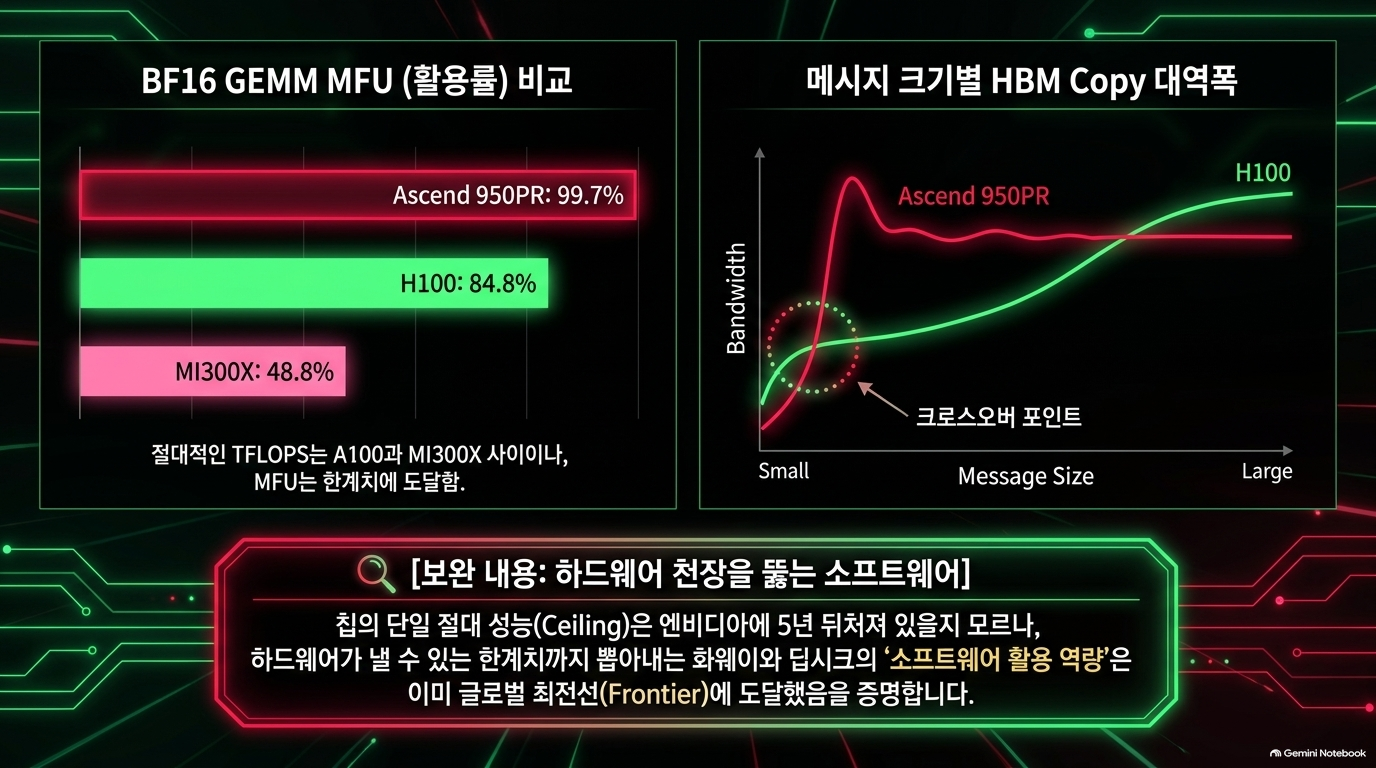
그래프에 제시된 GEMM MFU는 다음과 같습니다.
| 장치 | 중앙값 | 최고값 |
| Ascend 950PR | 86.0% | 99.7% |
| H100 | 75.5% | 84.8% |
반면 연산 집약도가 낮아 메모리 제약을 받는 구간에서는, 달성 가능 성능 대비 실제 성능의 중앙값이 Ascend 41.5%, H100 46.8%로 제시됩니다. 절대 성능에 대해서는 시험한 950PR이 A100과 MI300X 사이 수준이라고 서술합니다.[1]
분석
이 결과는 세 층으로 나누어 읽어야 합니다.
- 커널 구현의 완성도 Huawei의 기본 소프트웨어도 특정 연산에서 하드웨어 한계에 매우 근접합니다.
- 워크로드별 차이 행렬 연산 능력을 충분히 활용하는 구간과 메모리 제약 구간의 결과가 다릅니다.
- 절대 처리 능력 자체 성능 상한에 가까이 도달한다고 해서, 상한 자체가 더 높은 다른 장치보다 빠른 것은 아닙니다.
따라서 이 절의 결론은 “DeepSeek이 없으면 Huawei의 연산 소프트웨어는 작동하지 않는다”는 해석을 반박한다는 데 있습니다. 공생관계는 이미 존재하는 기본 연산 성능을 출발점으로 합니다.
[확인 필요] 비교 장치의 전력 제한과 실제 클록도 다릅니다. 원문은 일부 NVIDIA 결과가 전력 제한으로 최대 클록에 도달하지 못했다고 명시하므로, 이 표를 순수한 아키텍처 우열로 일반화하면 안 됩니다.[1]
3.2 MemBW — 작은 전송에서의 강점과 복사 경로 전환 비용
원문 내용
HBM 대역폭 측정에서는 버퍼당 메시지가 작은 구간에서 950PR이 H100보다 높은 유효 대역폭과 활용률을 보이고, 큰 메시지에서는 대역폭 활용률이 H100에 근접한다고 보고합니다.[1]
중간 크기에서 성능이 떨어지는 구간은 복사 방식이 Vector 기반 TensorMove 커널로 바뀌며 시작 비용이 증가하기 때문이라고 설명합니다. 더 큰 전송에서는 그 고정비의 상대적 영향이 작아져 대역폭이 다시 상승합니다.[1]
분석
메모리 성능은 “최대 몇 TB/s인가”만으로 설명되지 않습니다. 전송 크기에 따라 어떤 구현 경로를 선택하는가도 중요합니다.
이 절은 특히 다음을 구분하도록 요구합니다.
- 절대 대역폭과 최대 대역폭 대비 활용률
- 작은 복사와 큰 복사
- 단일 메모리 연산과 전체 모델 실행
원문도 높은 FLOPs·대역폭 활용률이 높은 전체 모델 MFU/MBU를 보장하지 않는다고 경고합니다. 학습에는 집단통신·체크포인팅·데이터 이동 등이 추가되기 때문입니다.[1]
경제성에 관한 한계: 저자는 성능/전력 및 TCO 비교가 더 중요하다고 말하지만, 이 글에서 Ascend의 TCO 우위를 입증하지는 않습니다. 관련 분석은 후속 글로 남겨 둡니다.[1]
4. DeepSeek Open Source — 빠른 커널을 재사용 가능한 개발 기반으로 전환한다
4.1 공개와 즉시 사용 가능은 다르다
원문 내용
원문은 Ascend 지원이 발표된 6개 저장소 가운데 집필 시점에 실제로 사용 가능한 것은 TileLang뿐이라고 적습니다. 나머지에는 CANN 9.2.0, C++20 컴파일러, HDK·펌웨어 등의 의존성 문제가 제시됩니다.[1]
분석
이 절은 오픈소스 발표를 평가하는 기준을 바꿉니다.
코드 공개 → 의존성 확보 → 빌드 → 실행 → 성능 재현
이 단계들은 별개입니다. 저장소가 공개되었다는 사실만으로 사용자가 동일한 결과를 재현할 수 있다는 의미는 아닙니다.
[확인 필요: 시점 정합성] 게시일은 10월 21일인데, 본문에는 “10월 15일 HDK 공개 예정”과 집필 이후 CANN이 공개되었다는 설명이 함께 남아 있습니다. 따라서 이 문단은 집필 당시 상태와 이후 편집 내용이 혼재한 것으로 읽어야 하며, 현재의 지원 상태를 확정하는 근거로 쓰기 어렵습니다.[1]
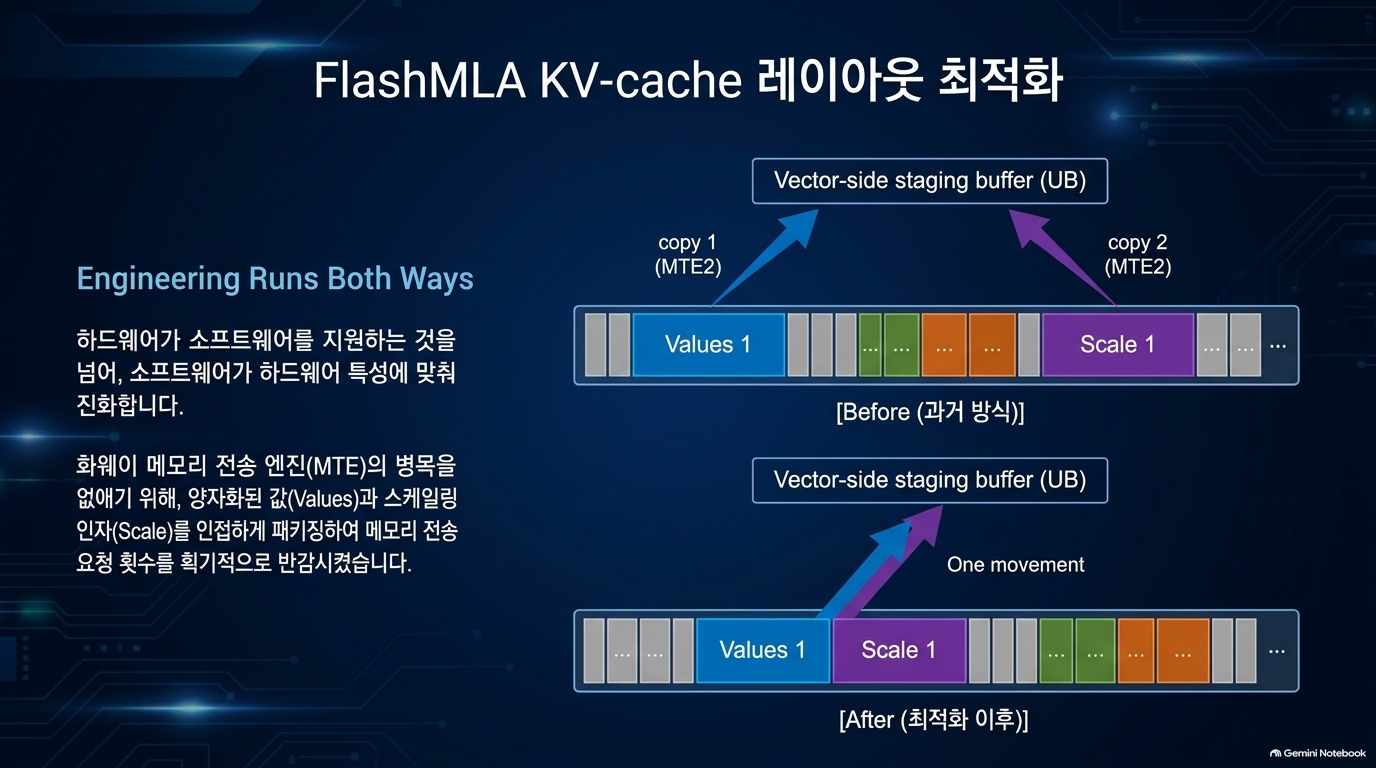
4.2 Engineering runs both ways — 하드웨어가 모델의 데이터 배치를 바꾼다
원문 내용
기존 FlashMLA KV-cache는 양자화된 값과 스케일 계수를 별도 영역에 저장했습니다. Ascend에서는 토큰 하나를 읽을 때 두 영역에서 각각 전송해야 했습니다.
새 구현은 값과 스케일을 함께 배치하여 메모리 전송 엔진인 MTE의 요청 횟수를 줄입니다.[1]
분석
이것은 데이터 양을 줄이는 최적화라기보다 같이 소비되는 정보를 같이 가져오도록 바꾸는 최적화입니다.
의미는 두 가지입니다.
- 하드웨어는 모델을 실행하는 수동적인 대상만이 아닙니다.
- 모델 소프트웨어의 내부 표현도 하드웨어의 전송 특성에 맞춰 바뀝니다.
이 사례가 원문에서 말하는 양방향 공동설계를 가장 구체적으로 보여 줍니다.
4.3 From fast kernels to reusable kernel engineering — TileLang의 가치는 개발 비용에 있다
원문 내용
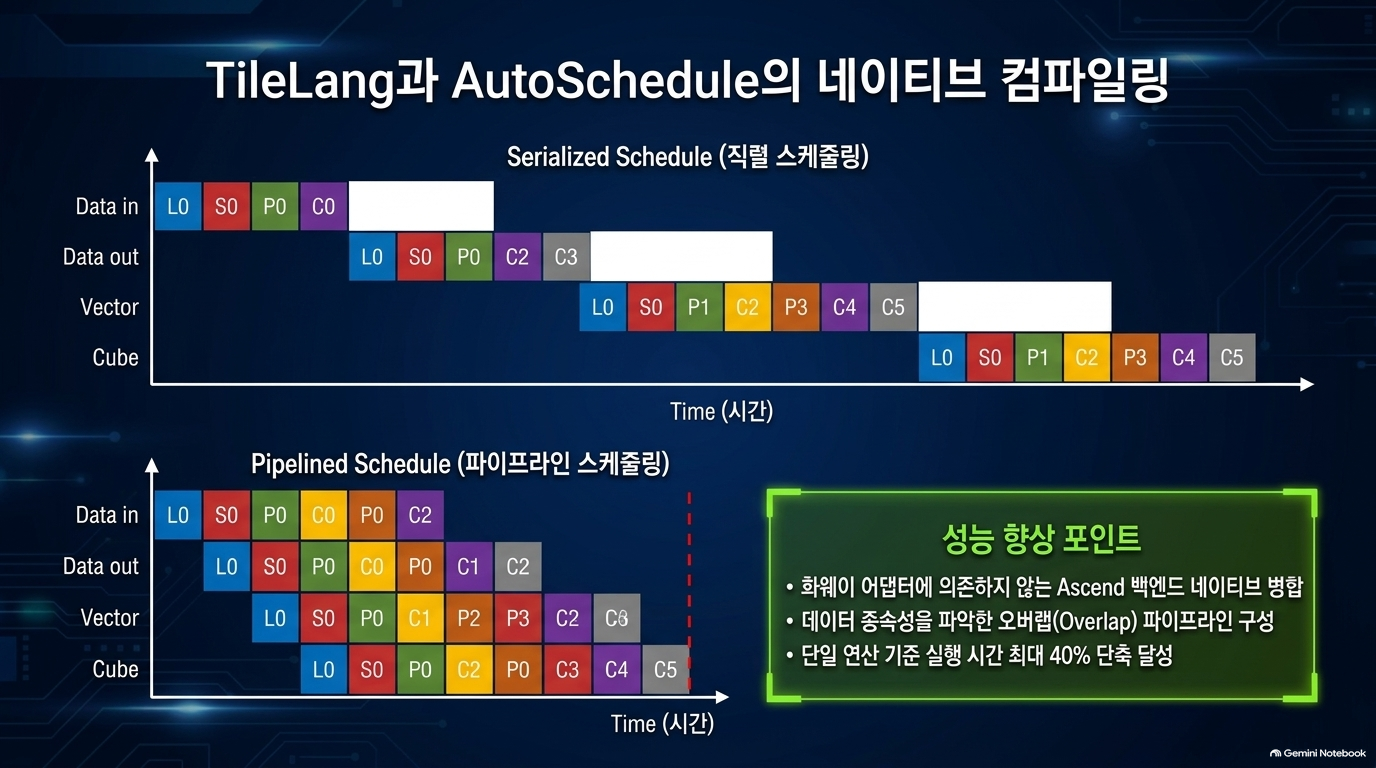
Ascend 950 백엔드는 별도 어댑터가 아니라 TileLang 주 저장소에 통합됩니다. 컴파일·스케줄링·동기화·런타임 연계를 지원합니다.[1]
개발자는 계산, 타일 크기, 데이터 저장 위치 등을 결정하고, 컴파일러가 Cube·Vector·데이터 전송 사이의 조정을 상당 부분 담당합니다.
특히 AutoSchedule은 다음을 수행합니다.
- 데이터 의존성과 실행 시간 추정에 따른 연산 중첩 계획
- 온칩 메모리 제약 안에서 버퍼 슬롯 수 선택
- 다음 데이터 로딩과 현재 타일 계산의 중첩
- 필요한 동기화 삽입 및 불필요한 대기 제거
950PR에서는 작은 크기의 일부 단일 연산에서 실행 시간을 최대 40% 줄였다고 보고합니다.[1]
분석
이 절의 핵심은 최고 성능 기록보다 최적화 지식을 여러 커널에 반복 적용할 수 있게 만드는 것입니다.
수작업으로 빠른 커널 하나를 만드는 것과, 새로운 연산을 지속적으로 개발·검증할 수 있는 도구를 만드는 것은 다릅니다. 후자가 플랫폼 확장에 더 직접적인 의미를 가집니다.
다만 개발자가 하드웨어를 몰라도 된다는 뜻은 아닙니다. 타일·메모리 배치 결정은 여전히 필요합니다.
측정 한계: CANN·Triton-Ascend 비교는 warm-cache의 단순한 벤치마크이며, 우수한 구현은 크기에 따라 달라집니다. 최대 40%는 단일 연산 실행 시간의 개선이지 전체 모델 처리량 개선율이 아닙니다.[1]
4.4 DeepEP — 대규모 MoE의 병목은 통신 경계와 자원 경합이다
원문 내용
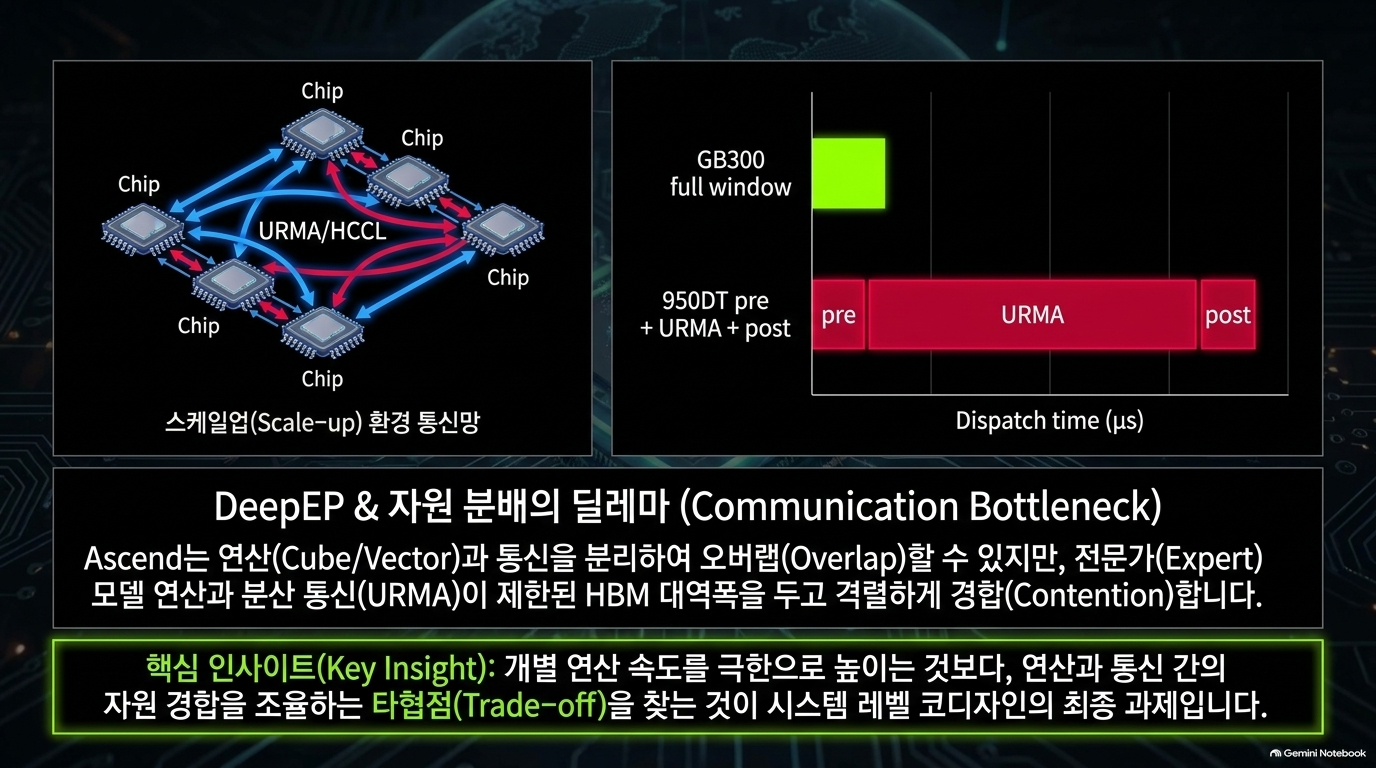
DeepEP-Ascend는 DeepEP V2.5를 기반으로 하며, 같은 Python API 아래에서 URMA·HCCL을 사용합니다. 원문은 Huawei의 대형 SuperPod에서 EP16 dispatch/combine 결과를 다룹니다.[1]
중요한 비교 조건은 다음과 같습니다.
| 비교 요소 | Huawei 측 | GB300 측 |
| Dispatch 구현 | pre / URMA / post의 순차 연산 | 하나의 fused 호출 |
| 측정 포함 범위 | 수신 완료와 expert별 확장 포함 | expert별 확장 작업 미포함 |
원문 그래프도 성능 수치뿐 아니라 측정 경계와 인터커넥트 최대치의 분모 선택에 따른 차이를 강조합니다.[1]
분석
이 절에서 중요한 것은 단순히 “어느 통신이 더 빠르다”가 아닙니다.
- 같은 dispatch라고 불러도 포함된 작업이 다를 수 있습니다.
- 통신만 빨라져도 계산과 겹칠 때 전체 성능은 나빠질 수 있습니다.
- Cube와 Vector 경로가 분리되어 있어도 HBM·데이터 이동 자원은 경합할 수 있습니다.
즉, 최적화 목표는 통신의 최대 중첩이 아니라, 계산 손실을 고려한 유효 중첩입니다.
원문은 Kimi K3 구현에서 동시 작업을 위해 Vector 사용을 제한하거나 통신 방식을 선택하는 사례를 소개합니다. 또한 combine과 URMA의 HBM 경합을 줄이기 위한 펌웨어 개선 계획도 언급합니다.[1]
[확인 필요] 펌웨어 개선은 계획입니다. 이미 해결된 병목으로 간주할 수 없습니다.
4.5 All planned — 방향성 설명에는 도움이 되지만 증거 강도는 낮다
원문은 검증되지 않은 5월 투자자 회의록에서 Liang Wenfeng이 소프트웨어 생태계 격차 축소와 Huawei 지원 방향을 언급했다고 인용합니다. 하드웨어에 대해서는 “Huawei 카드 4개가 NVIDIA 카드 1개에 해당”하고 출시가 약 2년 늦다는 발언도 실려 있습니다.[1]
분석: 이 절은 앞선 기술적 변화를 경영 전략과 연결하는 보조 서사입니다. 그러나 원문 스스로 회의록을 미검증 자료로 규정하므로, 해당 발언을 공식 입장이나 정량 성능 비교로 사용하면 안 됩니다. 카드 종류·모델·정밀도·작업 조건도 특정되지 않습니다.
5. DSv4.1 Flash Optimizations — 실제 모델에서는 병목이 여러 자원에 분산된다
5.1 Attention 최적화 — 누산 버퍼 제약을 우회한다
원문 내용
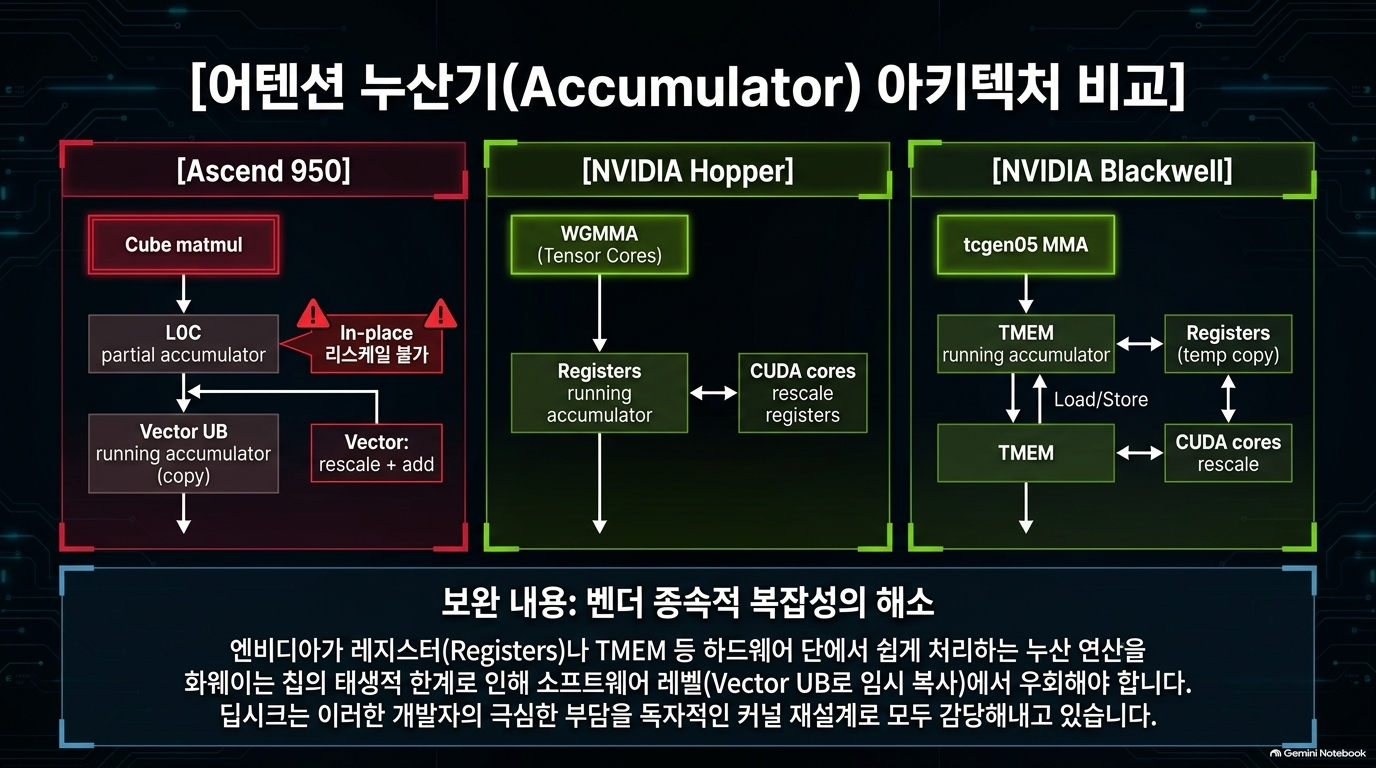
Ascend Cube의 L0C 버퍼에서는 누적 출력을 제자리에서 재스케일링할 수 없습니다. 재스케일링한 결과를 L0C에 다시 넣는 방식도 비싼 항등행렬 곱셈을 요구한다고 설명합니다.
DeepSeek은 실행 중 출력 누산값을 Vector UB에 유지하고, 필요한 부분합을 L0C에서 가져와 재스케일링·누적하는 접근을 사용합니다.[1]
분석
같은 Attention 알고리즘이라도 하드웨어별 최적 구현은 달라집니다.
이 사례에서는 행렬 곱셈 자체보다 중간 결과를 어디에 유지하고 어떻게 수정할 수 있는가가 설계를 결정합니다. 알고리즘 수준의 호환성이 커널 수준의 동일 구현을 의미하지 않는다는 사례입니다.
5.2 Profile: 실행 흐름 — Transformer 뒤의 작은 직렬 작업도 중요하다
원문 내용
프로파일 대상은 Ascend 950DT 32칩 배치 중 한 rank와 호스트 스레드입니다. 앞선 950PR 마이크로벤치마크와 다른 시험 대상입니다.[1]
보고된 실행 순서는 다음과 같습니다.
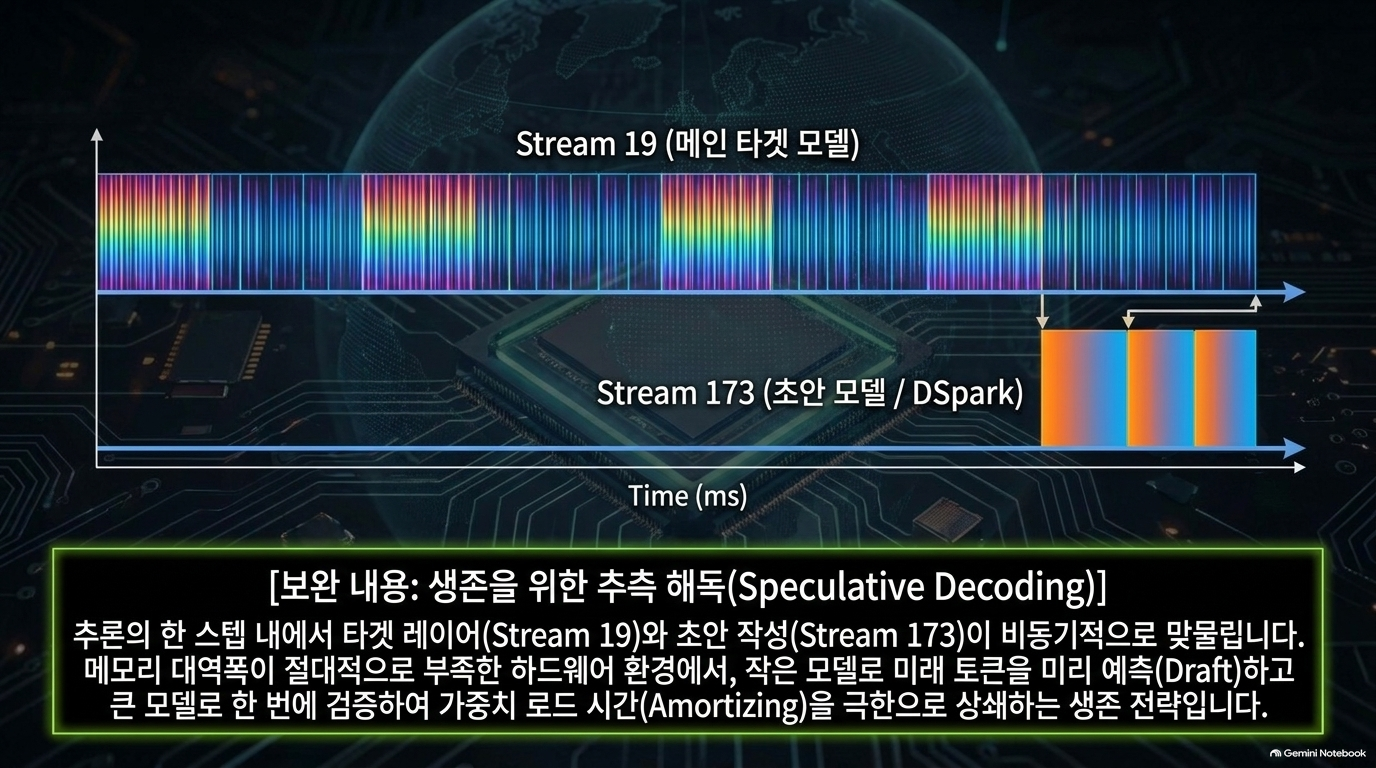
대상 모델 40개 레이어 → 대상 LM head → DSpark drafter 3개 블록 → draft LM head → 5회 sampling
주요 계산은 Stream 19, drafter는 Stream 173에서 실행됩니다. MC² V3 커널이 계산과 통신을 융합하며, 43회 expert dispatch가 있어도 AICPU가 실행한 HCCL 연산은 step당 4회만 관찰됩니다.[1]
분석
프로파일에서 독립적인 통신 호출이 적다고 통신량 자체가 적다고 판단하면 안 됩니다. 통신이 융합 커널 안으로 들어갔을 수 있기 때문입니다.
또한 step의 끝부분은 큰 행렬 연산 중심에서 작은 projection과 sampling의 직렬 체인으로 바뀝니다. 이 구간은 행렬 연산 성능을 높이는 것만으로 충분히 빨라지지 않을 수 있습니다.
5.3 DSpark — 후보마다 Transformer를 다시 돌리지 않는다
원문 내용
DSpark는 drafter 블록을 한 번 실행해 draft 위치들의 기본 logits를 만듭니다. 이후 Markov head가 sampling과 embedding feedback으로 토큰 의존성을 처리하며, 후보마다 Transformer 블록 전체를 다시 실행하지 않습니다.[1]
원문은 추측 디코딩을 draft 토큰을 만든 뒤 한 번의 검증으로 처리하여 가중치 로딩 비용을 분산하는 방법으로 설명합니다.[1]
분석
이 최적화의 핵심은 작은 모델이라는 사실만이 아니라 후보 생성 과정에서 비싼 계산을 반복하지 않는 실행 구조입니다.
다만 이 프로파일만으로 일반적인 속도 향상 배율을 확정할 수는 없습니다. 실제 이득을 평가하려면 draft 채택률, 검증 비용, 문맥 길이, 배치 조건 등을 함께 봐야 합니다.
5.4 Engram — 미리 알 수 있는 접근은 메모리 계층을 바꿀 수 있다
원문 내용
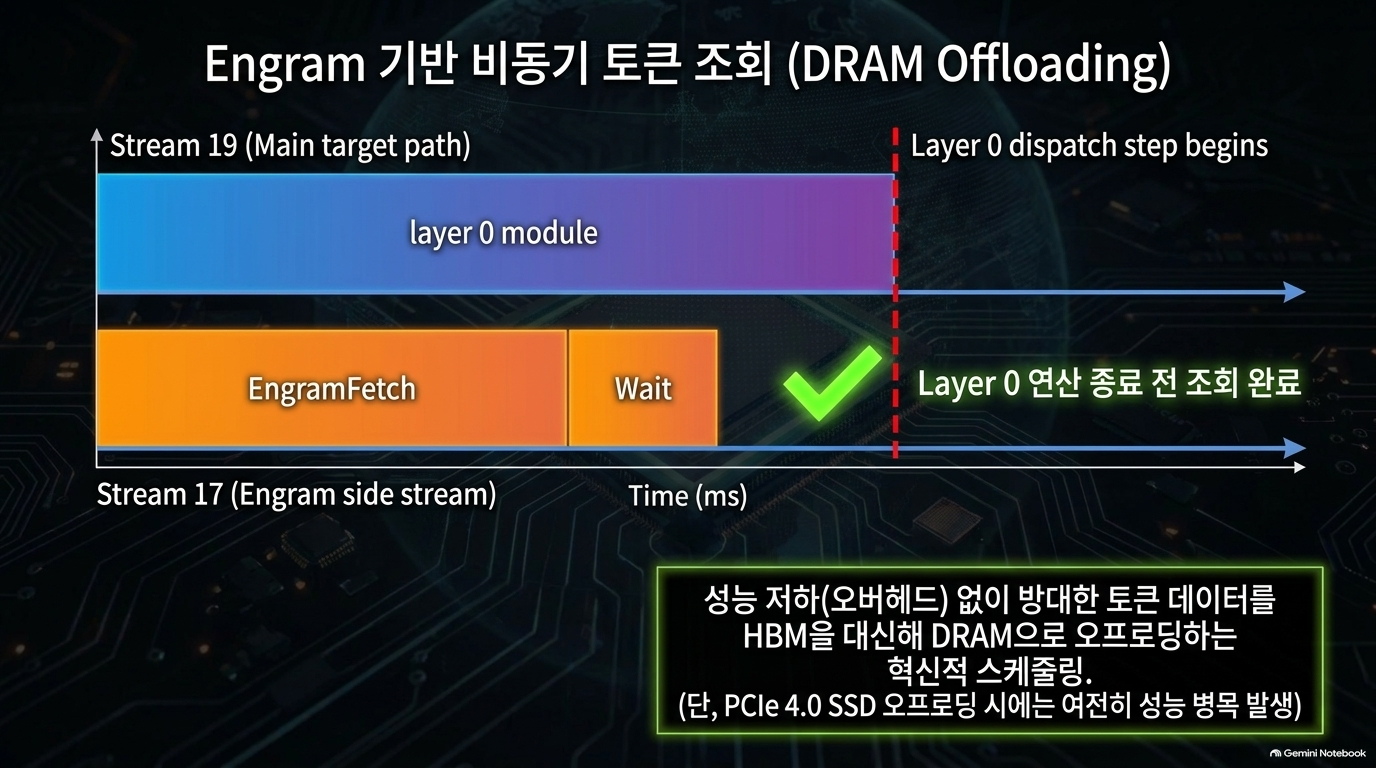
Engram은 token ID를 입력으로 사용하므로 필요한 데이터를 비동기로 미리 가져오고, 레이어 0 계산과 겹칠 수 있다고 설명합니다.
원문이 다루는 조건에서는 HBM 대신 DRAM으로 오프로딩해도 성능 손실이 없지만, PCIe 4.0 SSD로 오프로딩하면 성능이 저하됩니다.[1]
분석
이 절의 요점은 “DRAM도 HBM만큼 빠르다”가 아닙니다.
접근할 데이터를 일찍 알 수 있으면, 느린 계층의 전송 시간을 다른 계산 뒤에 숨길 수 있다.
즉, 데이터 저장 계층의 적합성은 대역폭·지연뿐 아니라 접근 예측 가능성과 사전 인출 시간에 달려 있습니다.
해석의 경계: 원문의 무손실 결과는 해당 데이터 경로와 실행 조건에 한정됩니다. 모델 전체 가중치나 KV-cache를 임의로 DRAM에 내려도 동일하다는 뜻은 아닙니다.
5.5 시간 분해 — Cube 성능을 두 배로 해도 전체는 두 배가 아니다
원문 내용
정상 상태 프로파일에서 Stream 19는 관찰 시간의 88.8%를 점유하지만, 중첩된 다른 스트림까지 합한 장치 시간에서는 72.6%를 차지합니다.[1]
저자는 Cube 처리량만 두 배로 하고 다른 작업·중첩·idle을 고정하는 1차 시나리오에서 step 성능이 1.32배 개선된다고 제시합니다.[1]
분석
88.8%와 72.6%는 서로 다른 분모입니다.
| 지표 | 의미 |
| 관찰 시간 대비 점유율 | 실제 경과 시간 중 해당 스트림이 실행된 비중 |
| 합산 장치 시간 대비 비중 | 여러 스트림의 중첩 실행 시간을 더한 값에서의 비중 |
| 물리 코어 활용률 | 실제 하드웨어 자원의 사용 정도로, 위 수치와 동일하지 않음 |
또한 MIX_AIC, MIX_AIV 같은 task 유형은 작업 분류이지, 각각 순수 Cube·Vector 사용량을 직접 측정한 값이 아닙니다.[1]
따라서 1.32배는 새 칩 성능 예측이 아니라 병목 구성에 대한 가정 기반 시나리오입니다. 이 절은 앞으로의 개선 지점이 행렬 연산뿐 아니라 양자화 융합·데이터 전달·스케줄링에도 있다는 것을 보여 줍니다.
6. Ecosystem gaps — DeepSeek의 성공이 모든 사용자의 성공은 아니다
원문 내용
저자는 이 협력이 DeepSeek에는 매우 효과적이면서도 다른 사용자에게 동일하게 편리한 Ascend 생태계를 만들지 못할 수 있다고 지적합니다.[1]
첫째, DeepSeek은 컴파일러·커널·벤더별 문제를 직접 유지보수해야 합니다. 이는 모델 연구와 제품 개발에 투입할 역량과 경쟁합니다.
둘째, 최적화가 SuperNode와 특정 구성에 집중되어 다른 환경에서는 문제가 남습니다. 원문은 vLLM-Ascend_0.26.0rc1을 기준으로 다음을 열거합니다.[1]
| 원문이 지적한 문제 | 사용자에게 미치는 영향 |
| x86 호스트의 DeepGEMM 미지원 | 최적화 경로 사용 제한 |
| memfabric_hybrid의 ARM 헤더 의존성 | 기본 구성에서 기동 차단 가능 |
| 비ARM CPU에서 CPU binding 생략 | 호스트 자원 배치 차이 |
| NPU + x86 CI 부재 및 일부 recipe 패치 필요 | 회귀 검증·재현성 부족 |
분석
이 절은 글 전체의 결론을 제한하는 가장 중요한 부분입니다.
최전선 연구소를 위한 수직 최적화와 일반 사용자를 위한 범용 플랫폼은 다른 성취입니다.
DeepSeek은 특정 모델·시스템 구성에 집중하고 전문 엔지니어를 투입할 수 있습니다. 반면 일반 조직에는 다양한 호스트, 기존 인프라, 표준 설치, 지속적인 버전 호환성이 필요합니다.
따라서 플랫폼의 완성도는 최고 처리량뿐 아니라 다음으로 평가해야 합니다.
- 표준 절차로 설치·실행되는가?
- 일반적인 하드웨어 조합에서도 지원되는가?
- 버전 변경 뒤에도 성능과 기능이 유지되는가?
- 벤더나 소수 전문가의 수작업 없이 운영 가능한가?
[확인 필요] 열거된 문제는 특정 릴리스의 관찰입니다. Ascend의 영구적인 제약이나 모든 구성의 공통 문제로 확대해서는 안 됩니다.
종합 판단 — 이 글이 입증한 것과 남겨 둔 것
| 판단 대상 | 이 글에서 확보된 근거 | 해석하면 안 되는 결론 |
| 기본 연산 소프트웨어 | 시험 조건에서 높은 GEMM·대역폭 활용률 | 전체 모델이 NVIDIA보다 빠르다 |
| 공동설계 | KV 배치·누산 위치·통신 구현의 구체적 변화 | 소프트웨어만으로 모든 하드웨어 격차가 사라진다 |
| 개발 기반 | TileLang 통합·자동 스케줄링·동기화 | 하드웨어 전문성이 필요 없다 |
| 모델 실행 | 특정 950DT 배치의 상세 프로파일 | 모든 모델·규모에 같은 개선율이 적용된다 |
| 범용 생태계 | x86·의존성·CI의 구체적 지원 공백 | DeepSeek에서 작동하면 누구나 바로 사용할 수 있다 |
| 경제성·미래 전환 | TCO 후속 분석 예고와 저자 전망 | TCO 우위나 Huawei 중심 전환이 확정됐다 |
가장 타당한 독해는 “특정 최전선 모델을 위한 공동 최적화 능력이 빠르게 강화되고 있다”입니다. 다만 그것이 범용 개발 생태계의 완성, 전체 모델 성능 우위, 경제성 우위까지 입증한 것은 아닙니다. 이 세 경계를 구분하는 것이 원문의 기술적 성과를 과소평가하지 않으면서도 과장하지 않는 방법입니다.
출처
[1] SemiAnalysis — The Huawei-DeepSeek Symbiosis

'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - RF Over Plastic(E-tube), 구리와 광통신 사이의 제3의 선택지 (0) | 2026.10.26 |
|---|---|
| AI 반도체 - OCP 2026: 근패키지 광학(NPO)과 공동패키지 광학(CPO) (0) | 2026.10.25 |
| AI 반도체 - OCP 2026: AI 클러스터 공동 설계(Co-Designing) (0) | 2026.10.25 |
| AI 반도체 - Semianalysis, Amazon Trainium3, GB300, B200 (0) | 2026.10.25 |
| AI 반도체 - CPO - 고속 광통신에 대한 종합적인 개요 (0) | 2026.10.24 |