https://www.siliconcodesign.com/p/ocp-2026-co-designing-an-ai-cluster
2026.10.24
[OCP 2026 - Co-Designing an AI Cluster]
본문은 현대 AI 인프라스트럭처가 직면한 설계와 통합의 난제를 전력, 냉각, 그리고 네트워킹이라는 세 가지 핵심 기술 영역을 중심으로 심층적으로 분석하고 있습니다. 저자는 클레이튼 크리스텐슨의 모듈형 및 상호 의존적 아키텍처 이론을 차용하여, 기업들이 공급망 제약 속에서 어떻게 표준화와 수직 계열화 사이의 균형을 맞추고 있는지 설명합니다. 또한, 고출력 랙의 효율적인 전력 분배를 위한 800V 아키텍처, 국소적 발열을 잡기 위한 액체 냉각 기술, 그리고 대규모 데이터 전송을 감당하기 위한 고속 네트워킹의 기술적 트레이드오프와 최신 동향을 상세히 다룹니다. 궁극적으로 이 글의 목적은 급증하는 컴퓨팅 수요를 뒷받침하기 위해 이러한 인프라의 하위 시스템들이 어떻게 함께 확장되고 긴밀하게 공동 설계(Co-Design)되어야 하는지 그 중요성을 엔지니어링 관점에서 명확히 전달하는 것입니다.
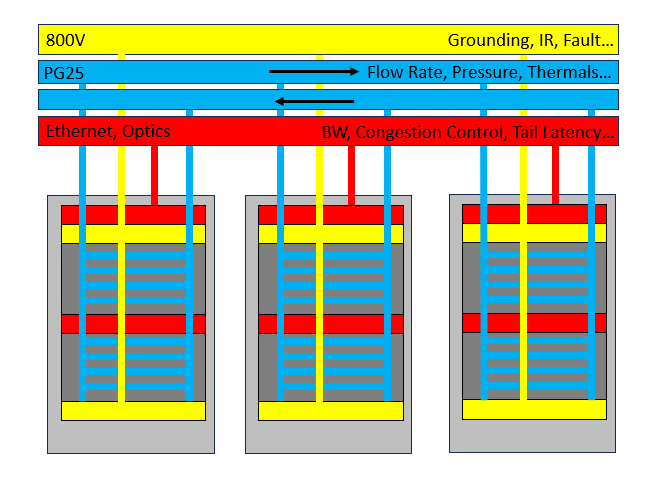
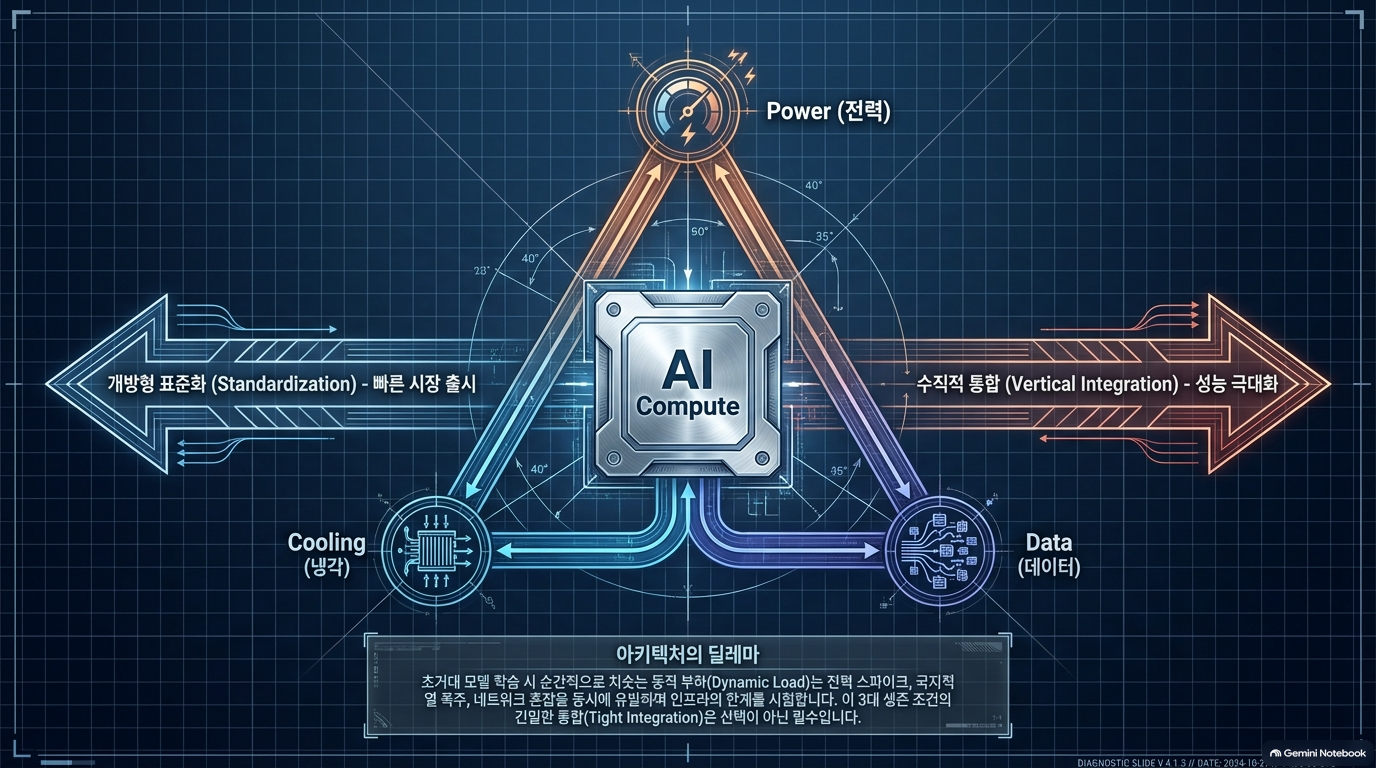
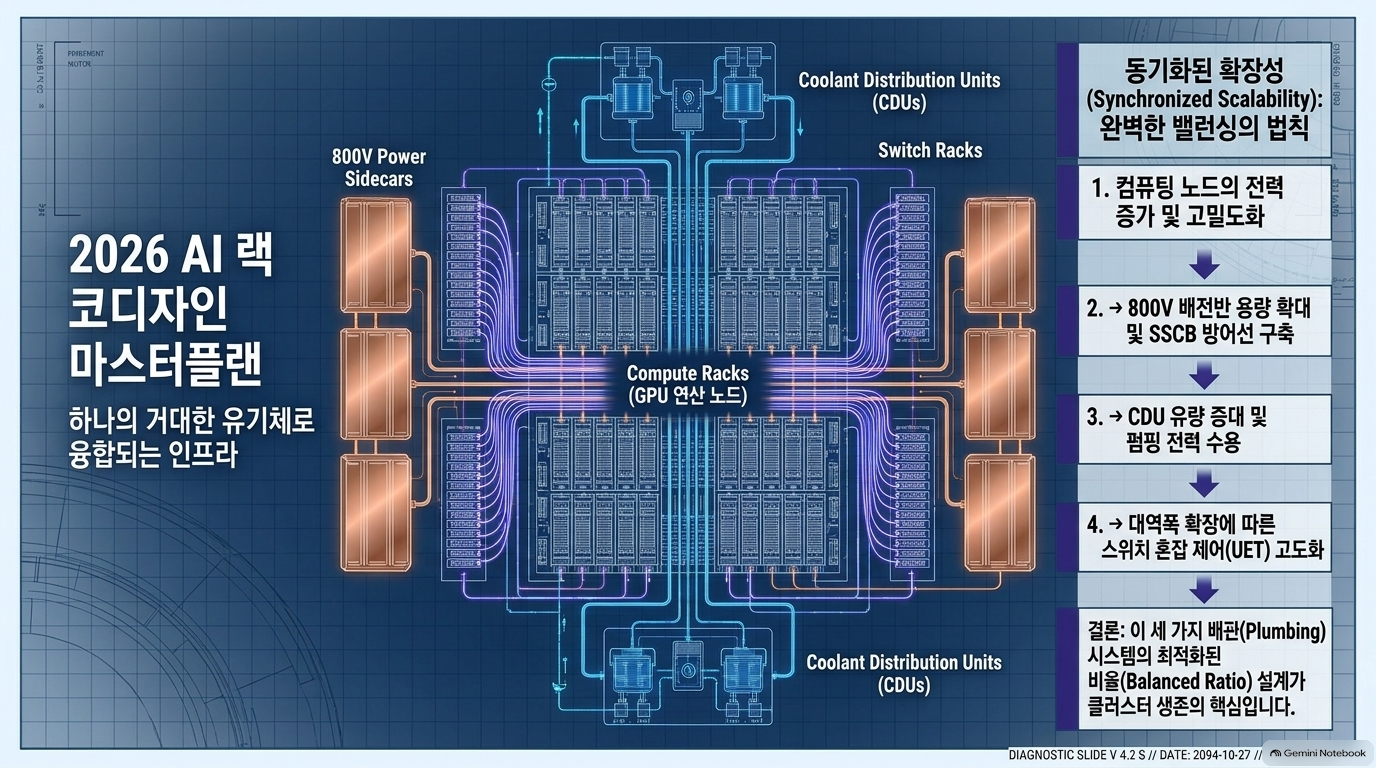
AI 컴퓨팅 랙이 토큰을 처리하고 안정적으로 작동하려면 전력, 냉각 및 데이터라는 세 가지 요소가 필요합니다. 컴퓨팅 밀도를 극대화하려면 이 세 가지 시스템 모두 컴퓨팅 성능에 맞춰 확장되어야 하며, 배관 시스템은 안전하고 안정적으로 작동하도록 함께 설계되어야 합니다.
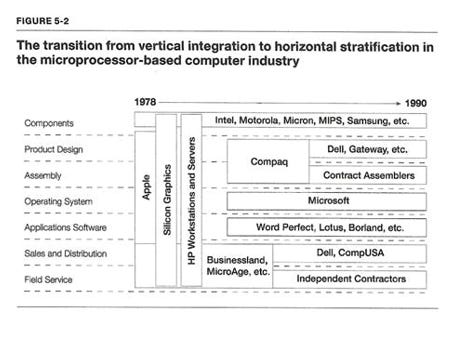
출처: C. Christensen, M Raynor. “혁신가의 해결책: 성공적인 성장 창출 및 유지”(2003) 그림 5.2에서 발췌.
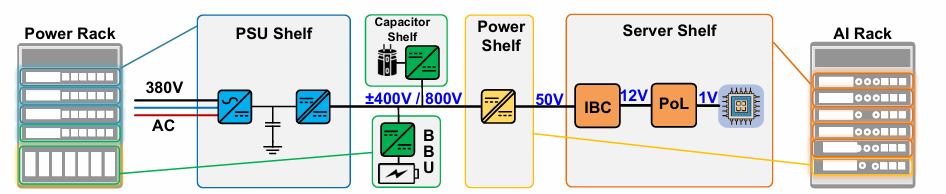
출처: H. Wang. “AI 기반 데이터센터 전원 공급 장치 진화: 아키텍처, 토폴로지 및 제어” APEC 2026
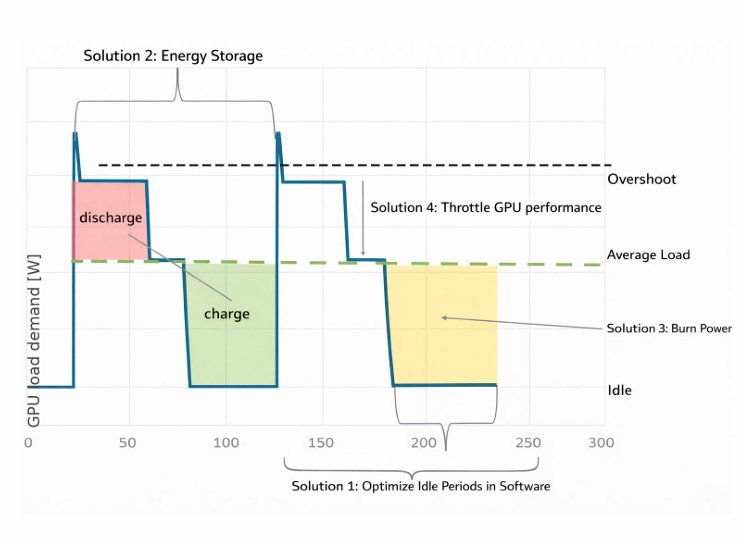
출처: J. Huntington, M. Tu, “GPU 전력 활용도 향상을 위한 800Vdc MGX 가속 컴퓨팅 랙 및 에너지 저장 장치” OCP 2025

-
출처: B. Deckard, S. Van den Broek. “LVDC 아키텍처 기본 사항: 전류/OS 영역, ODCA 섹터 및 IEC 회로” OCP 2026
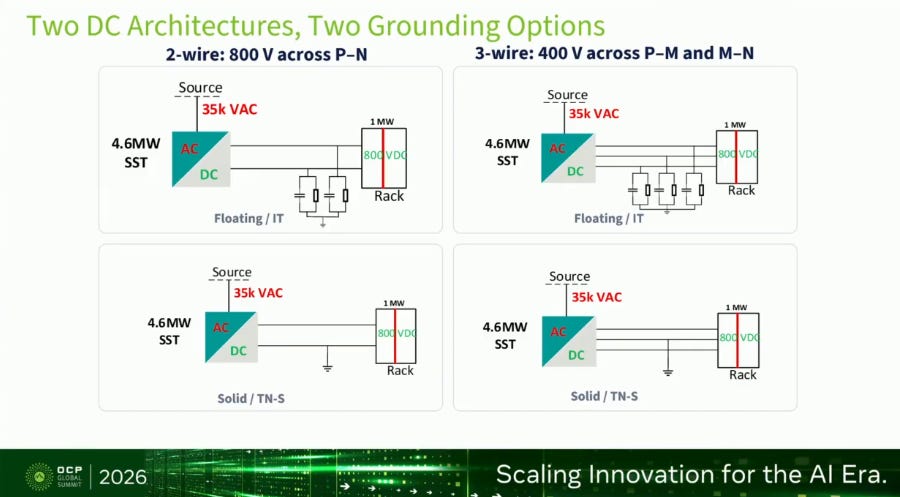

출처: L. Wang, G. Yang, “AI 데이터 센터의 800VDC 접지에서 2선식과 3선식의 비교, 고장 동작 및 보호” OCP 2026
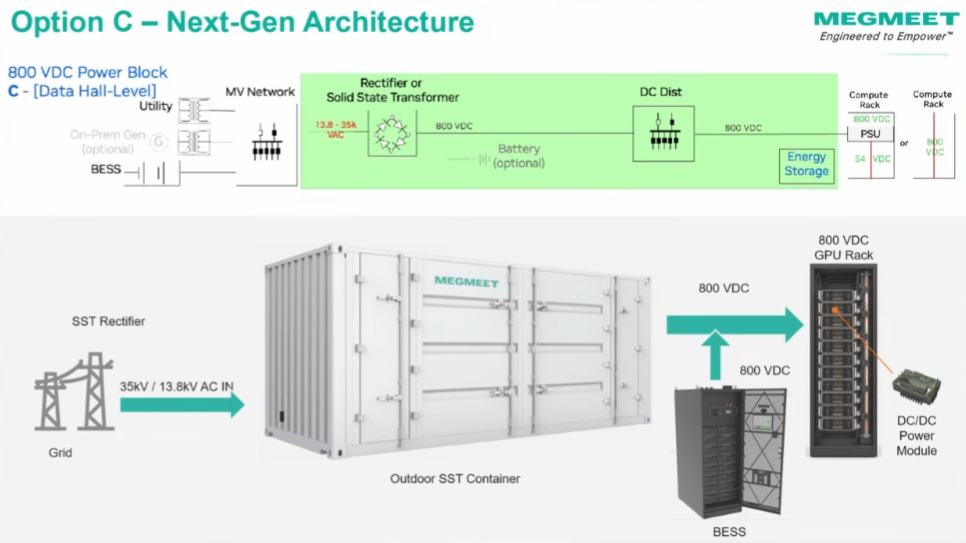
출처: T. Shi. “800VDC로의 전환을 위한 엔지니어링” OCP 2026
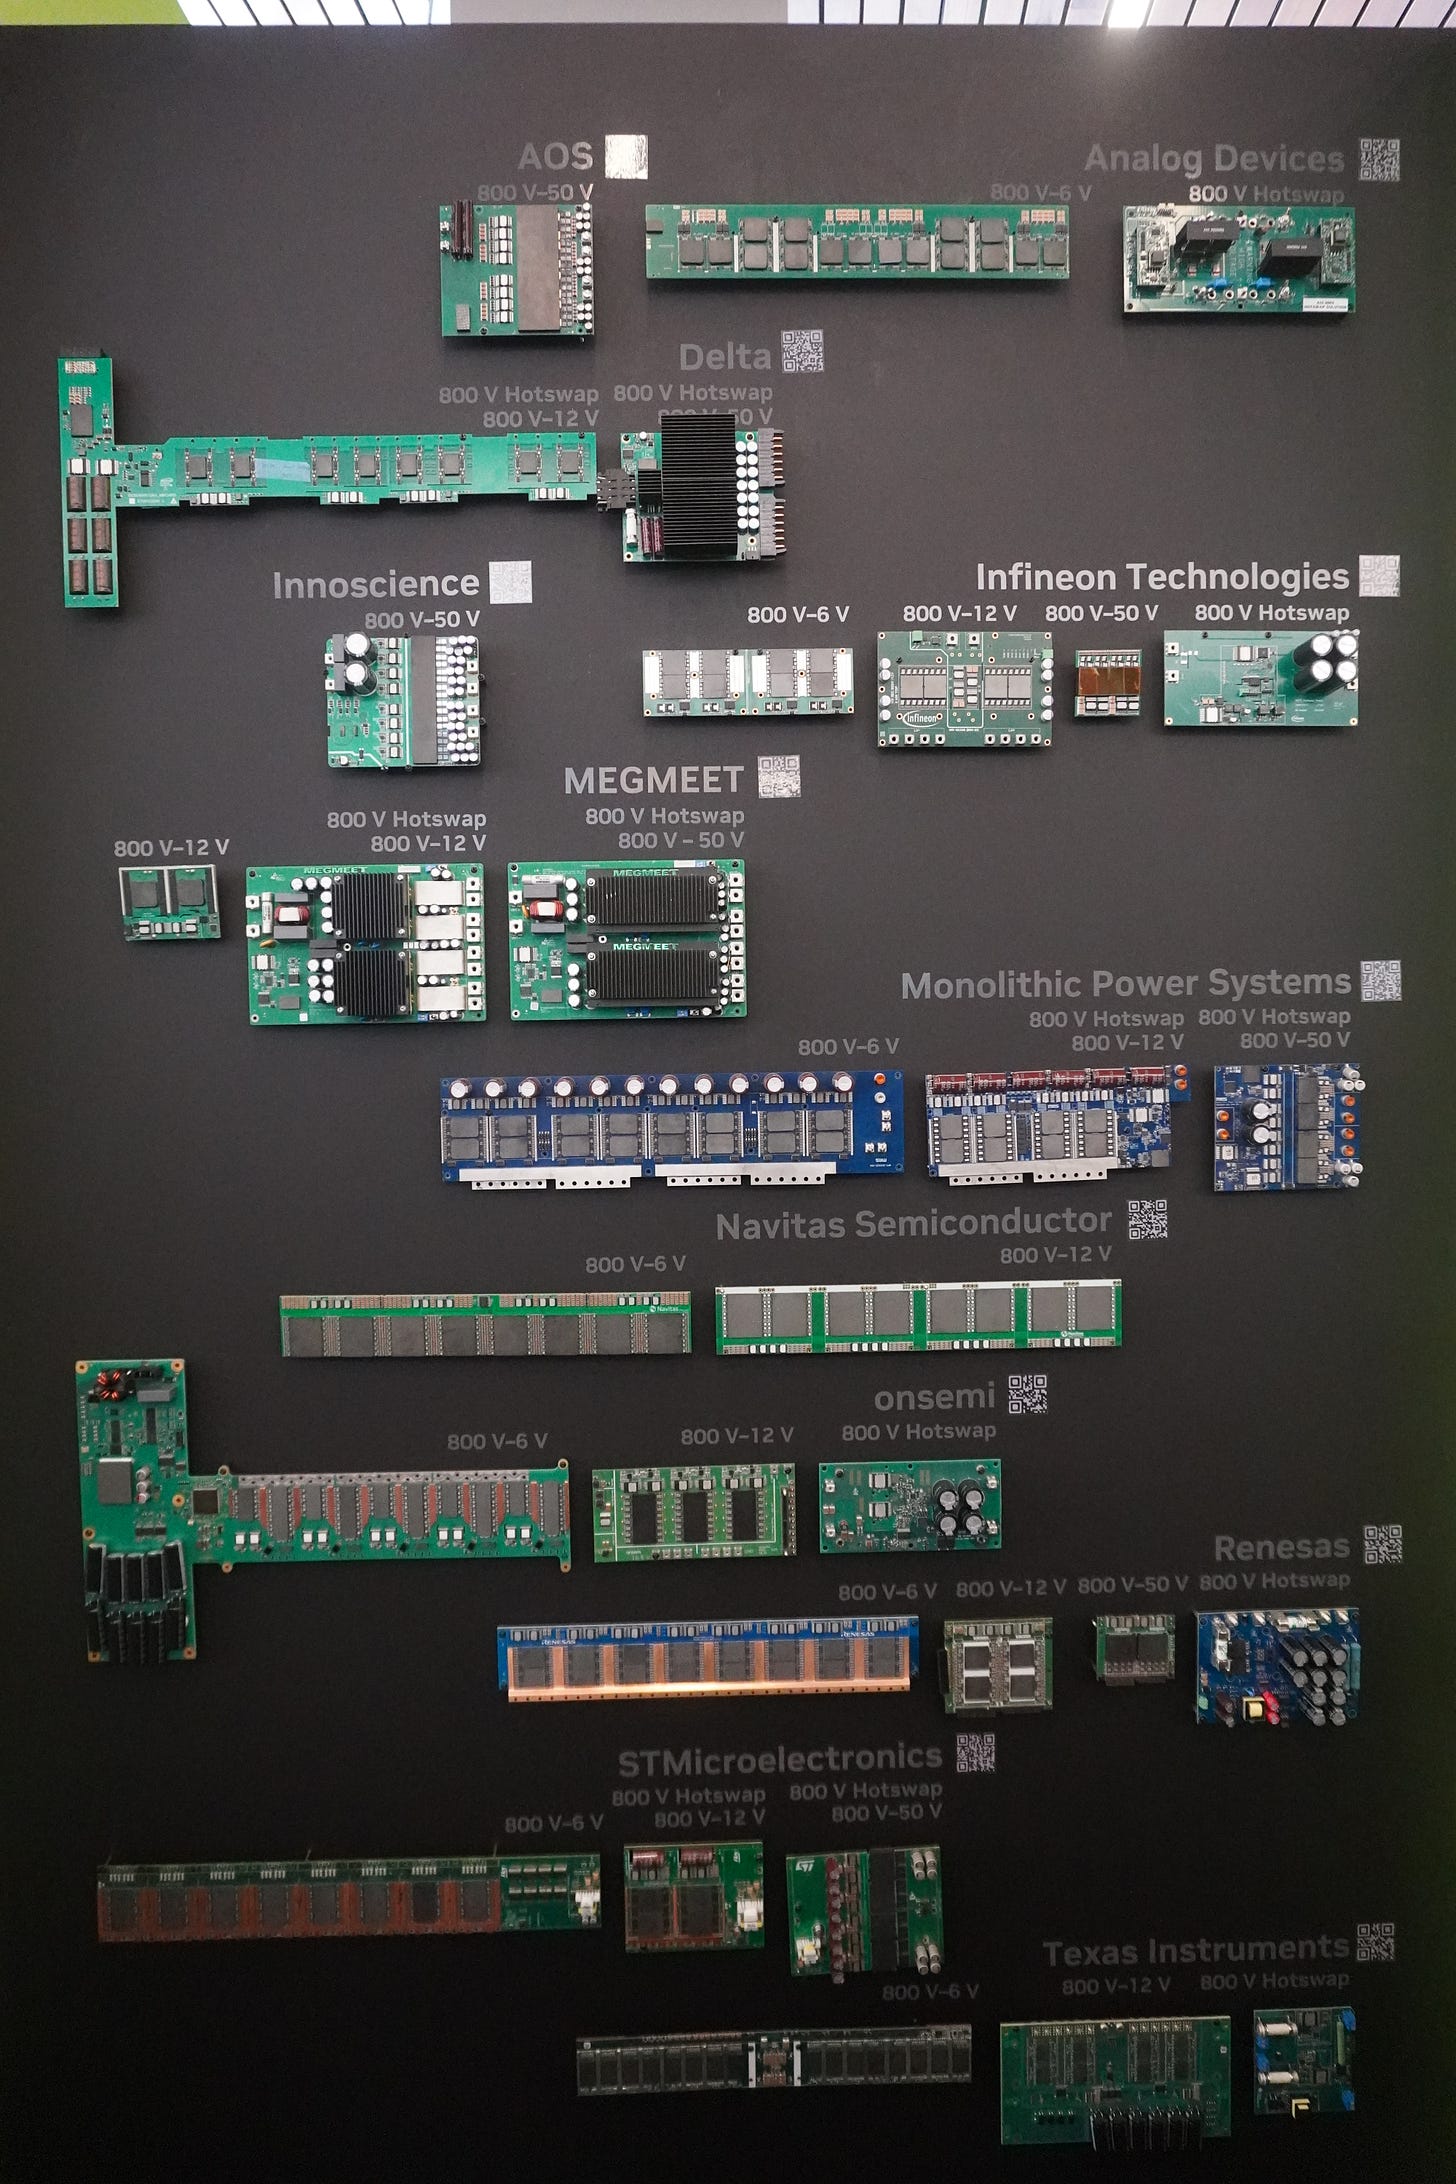
NVIDIA 800V 전력 명예의 전당
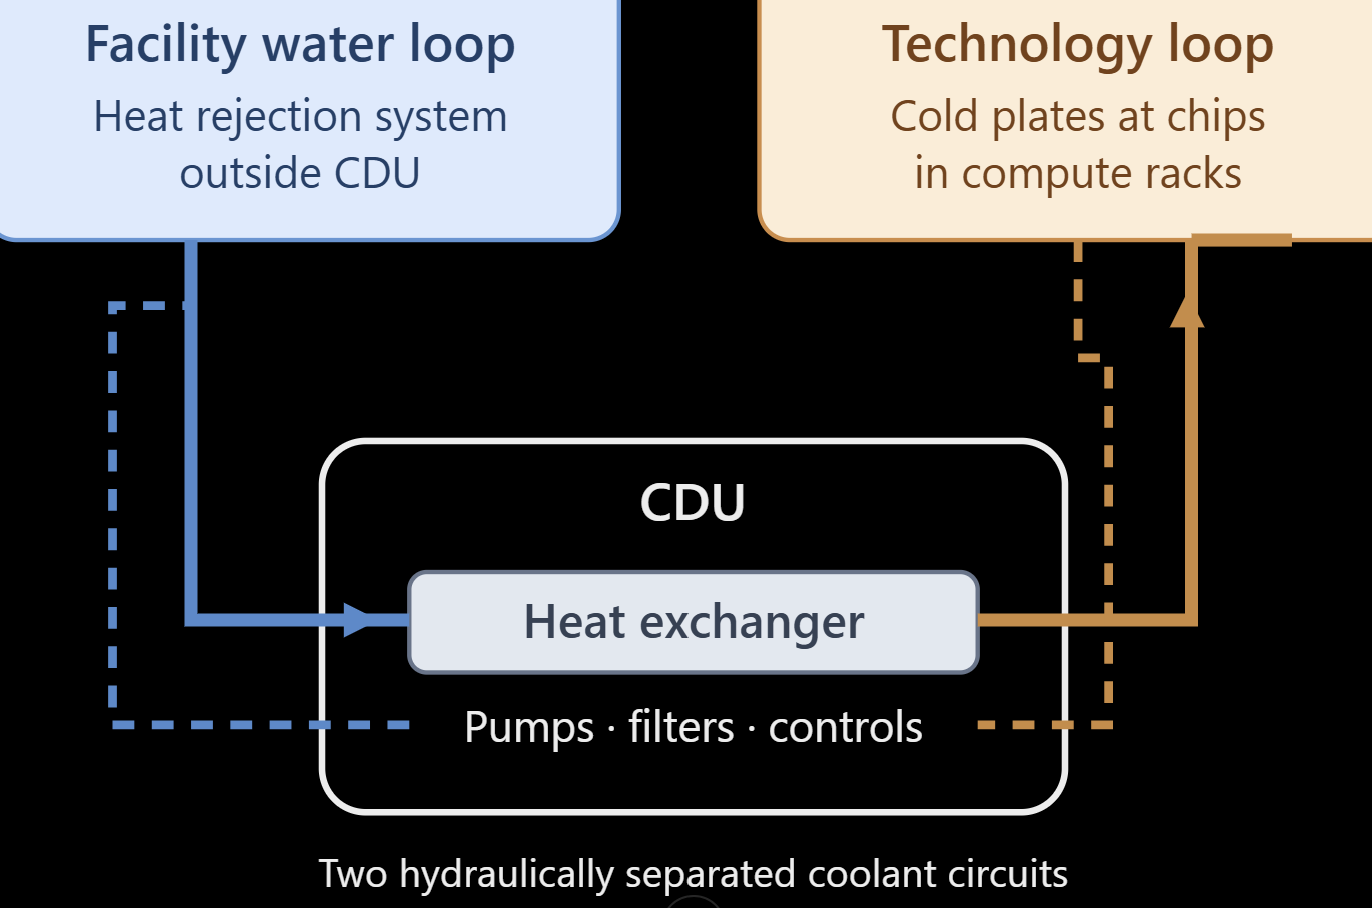
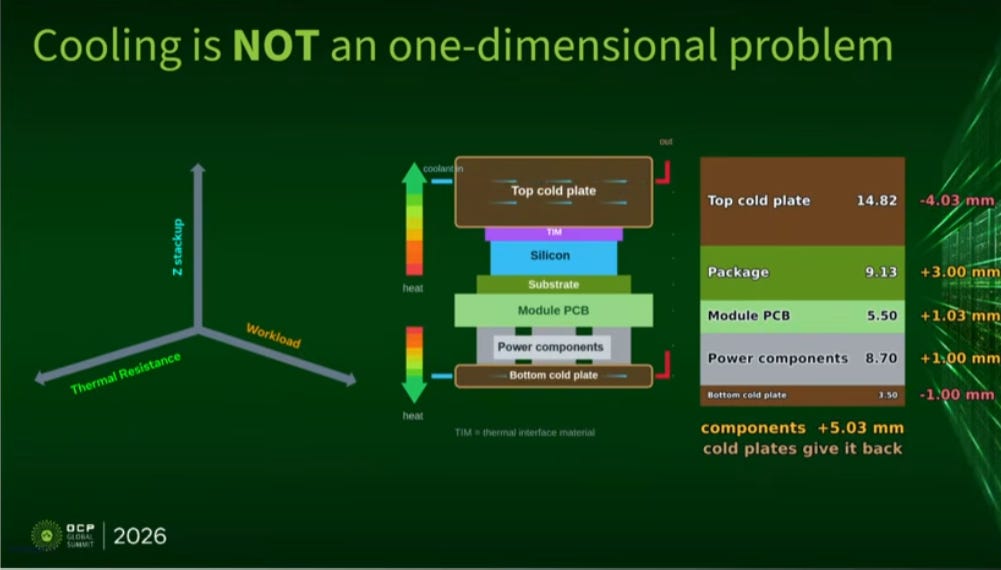
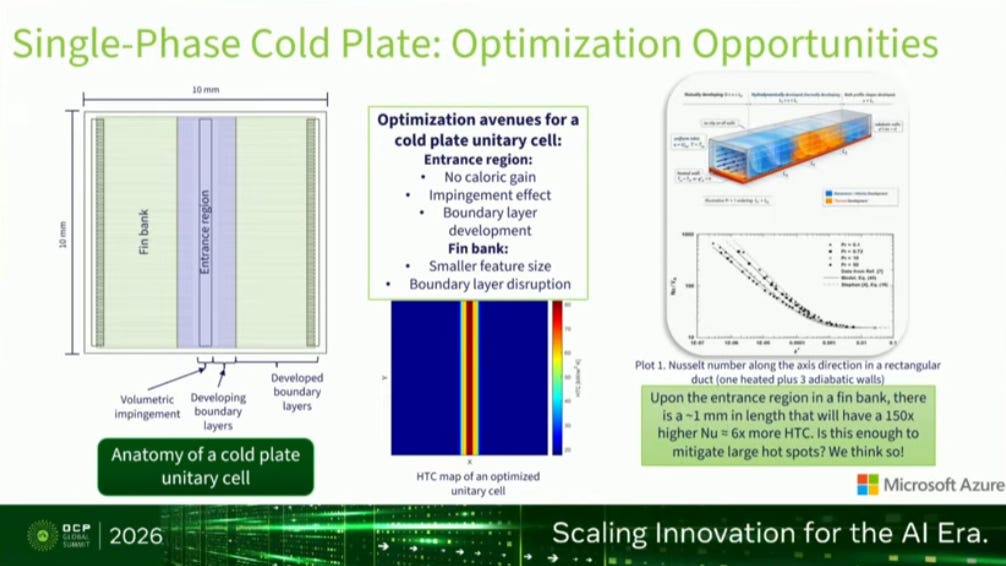
출처: O. Farias. “단상 냉각판 한계 돌파: 통합적 접근 방식” OCP 2026
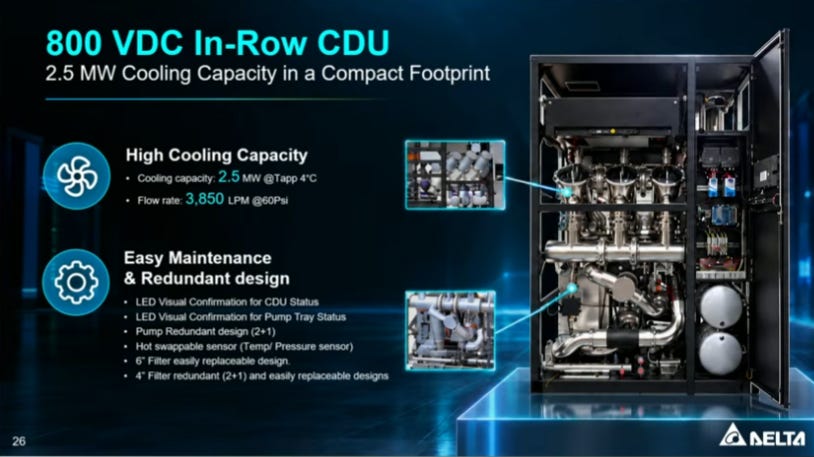
출처: R. Pieper, M. Tu. “Delta가 발표한 데이터 센터용 800VDC 전력 및 냉각 솔루션” OCP 2026
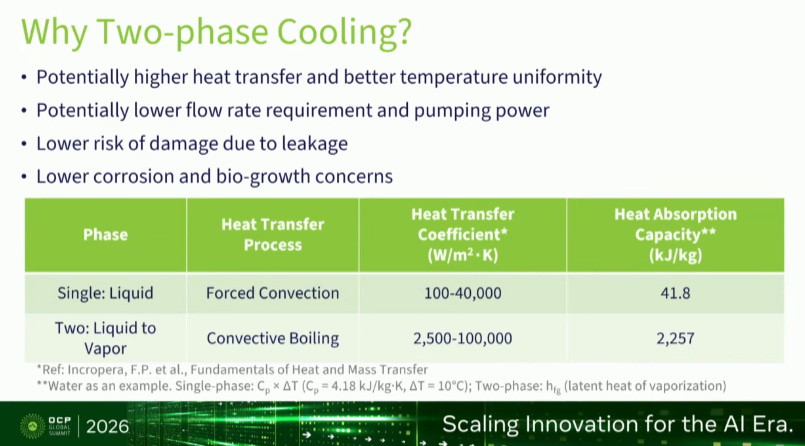
출처: J. Hsieh, Y. Lin. “단상 냉각에서 이상 냉각으로 전환 시 시스템 수준의 과제 및 고려 사항” OCP 2026
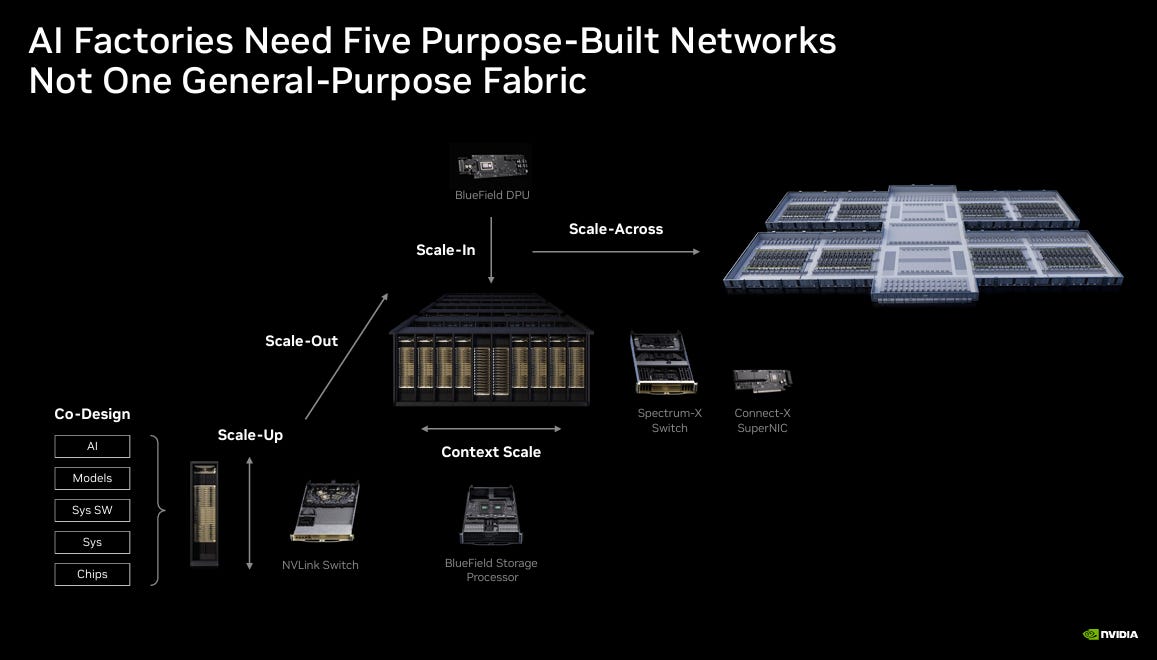
G. 샤이너. "NVIDIA Spectrum-X 이더넷 멀티플레인 네트워크 아키텍처"

출처: C. Miller, R. Annapillai. “AI 데이터 센터를 위한 224G AEC: 도달 범위 확장, 원격 측정 강화 및 구리선 재정의” OCP 2026
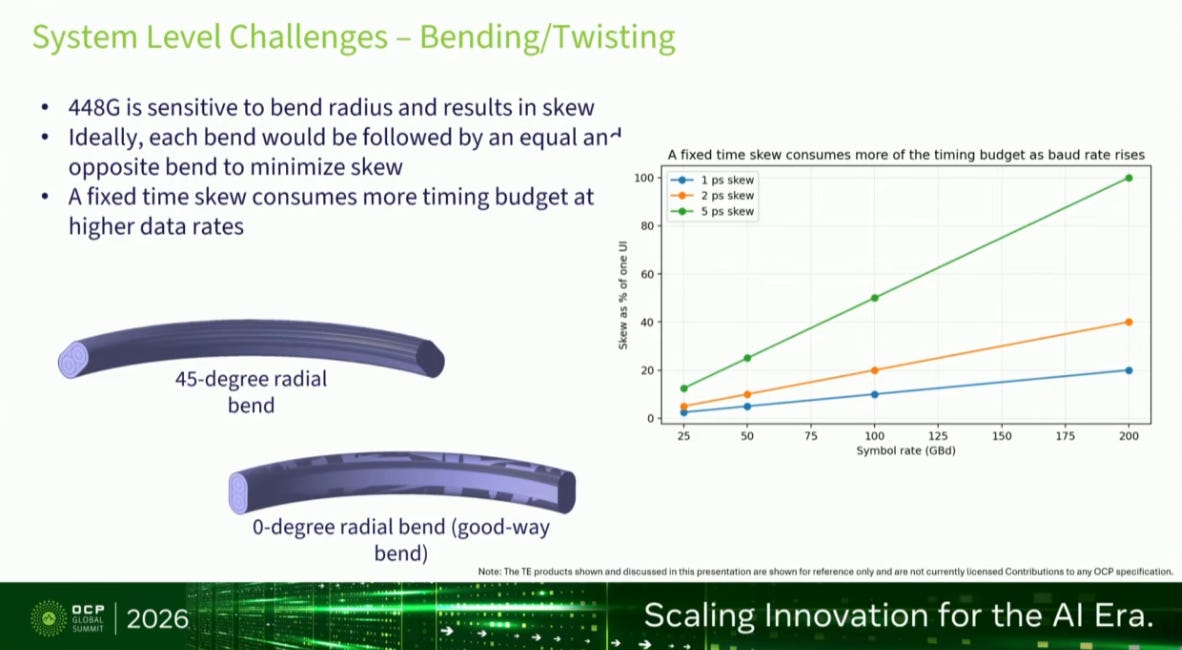
출처: A. Naqvi, U. Saeed. “448G에서 전기적 효율성과 시스템 수준 복잡성의 균형을 맞추는 공동 패키징 구리: OCP 2026”
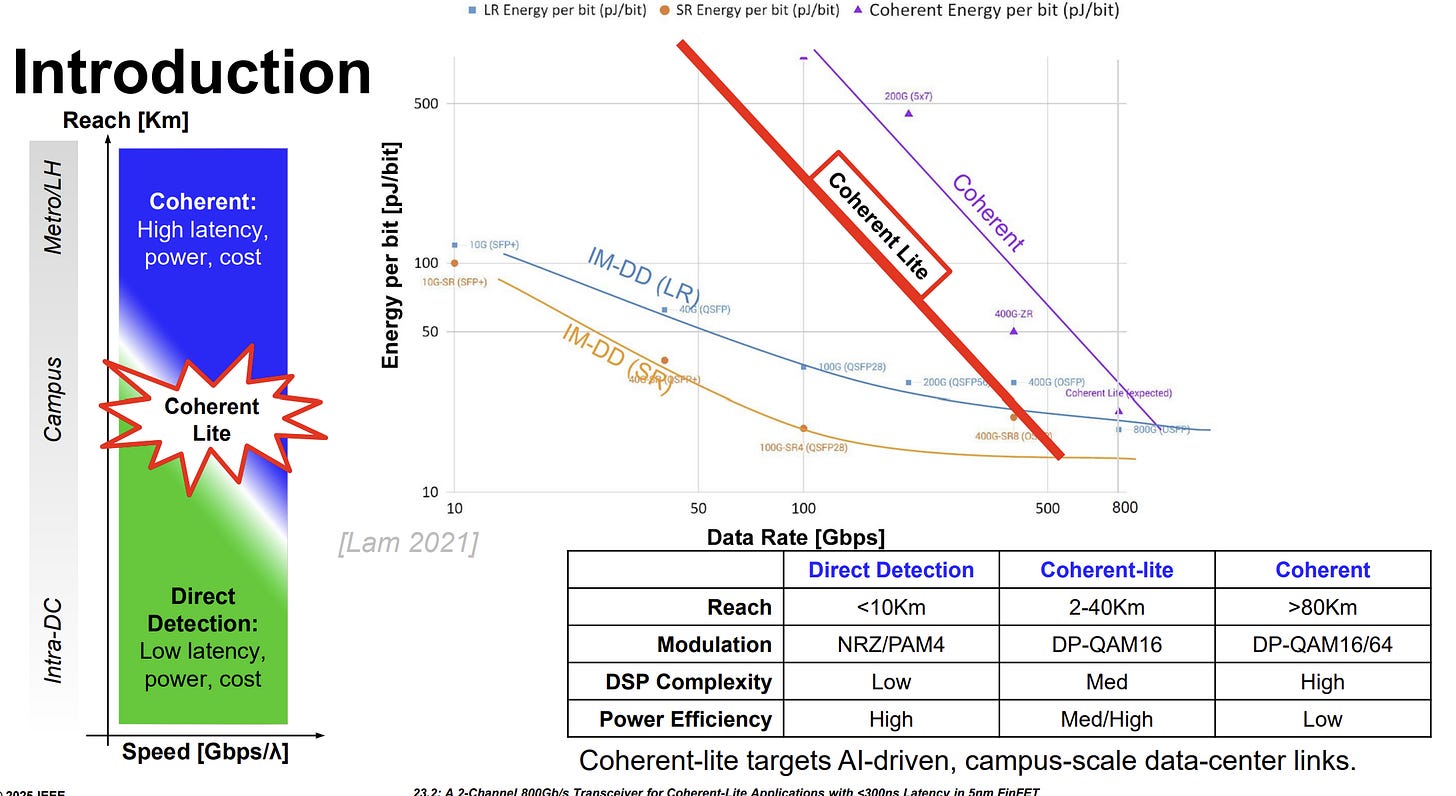
출처: M. Sosio 외. "5nm FinFET에서 300ns 미만의 지연 시간을 갖는 코히런트 라이트 애플리케이션용 2채널 800Gb/s 트랜시버" ISSCC 2026
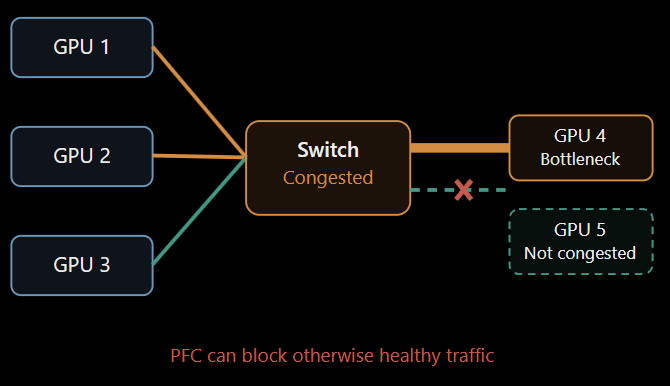
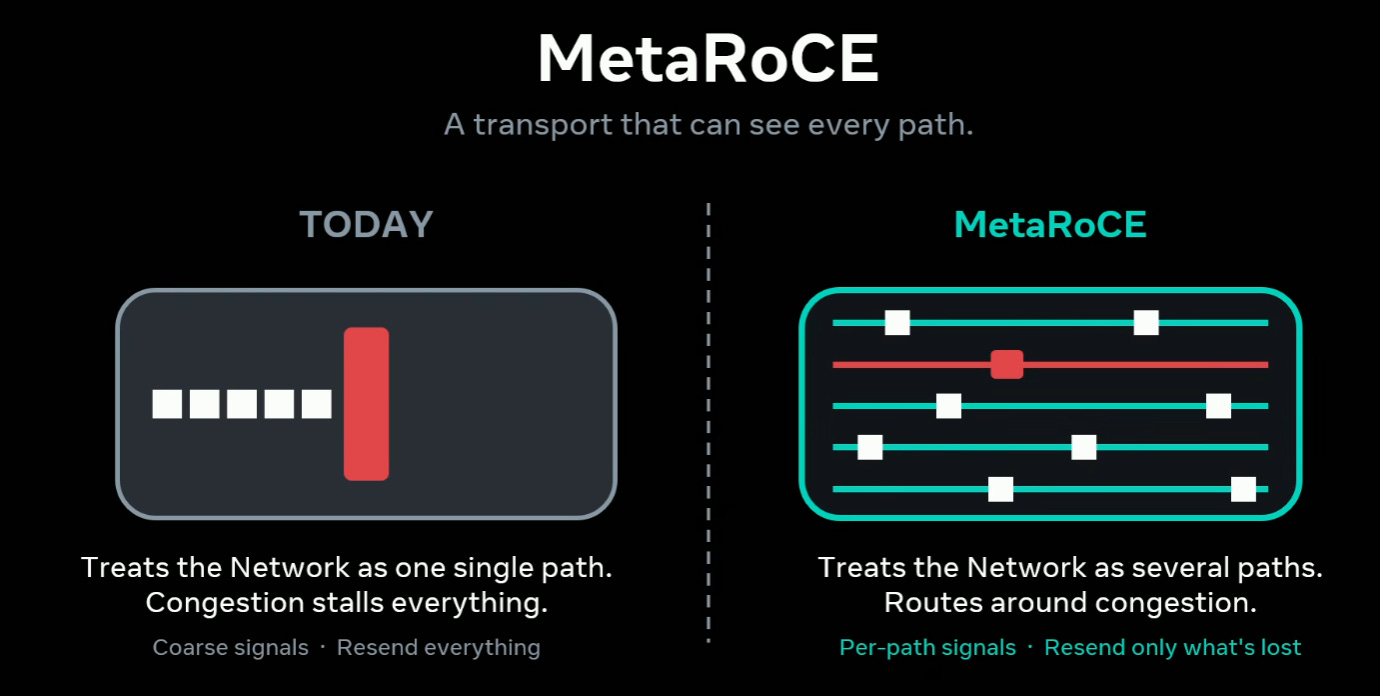
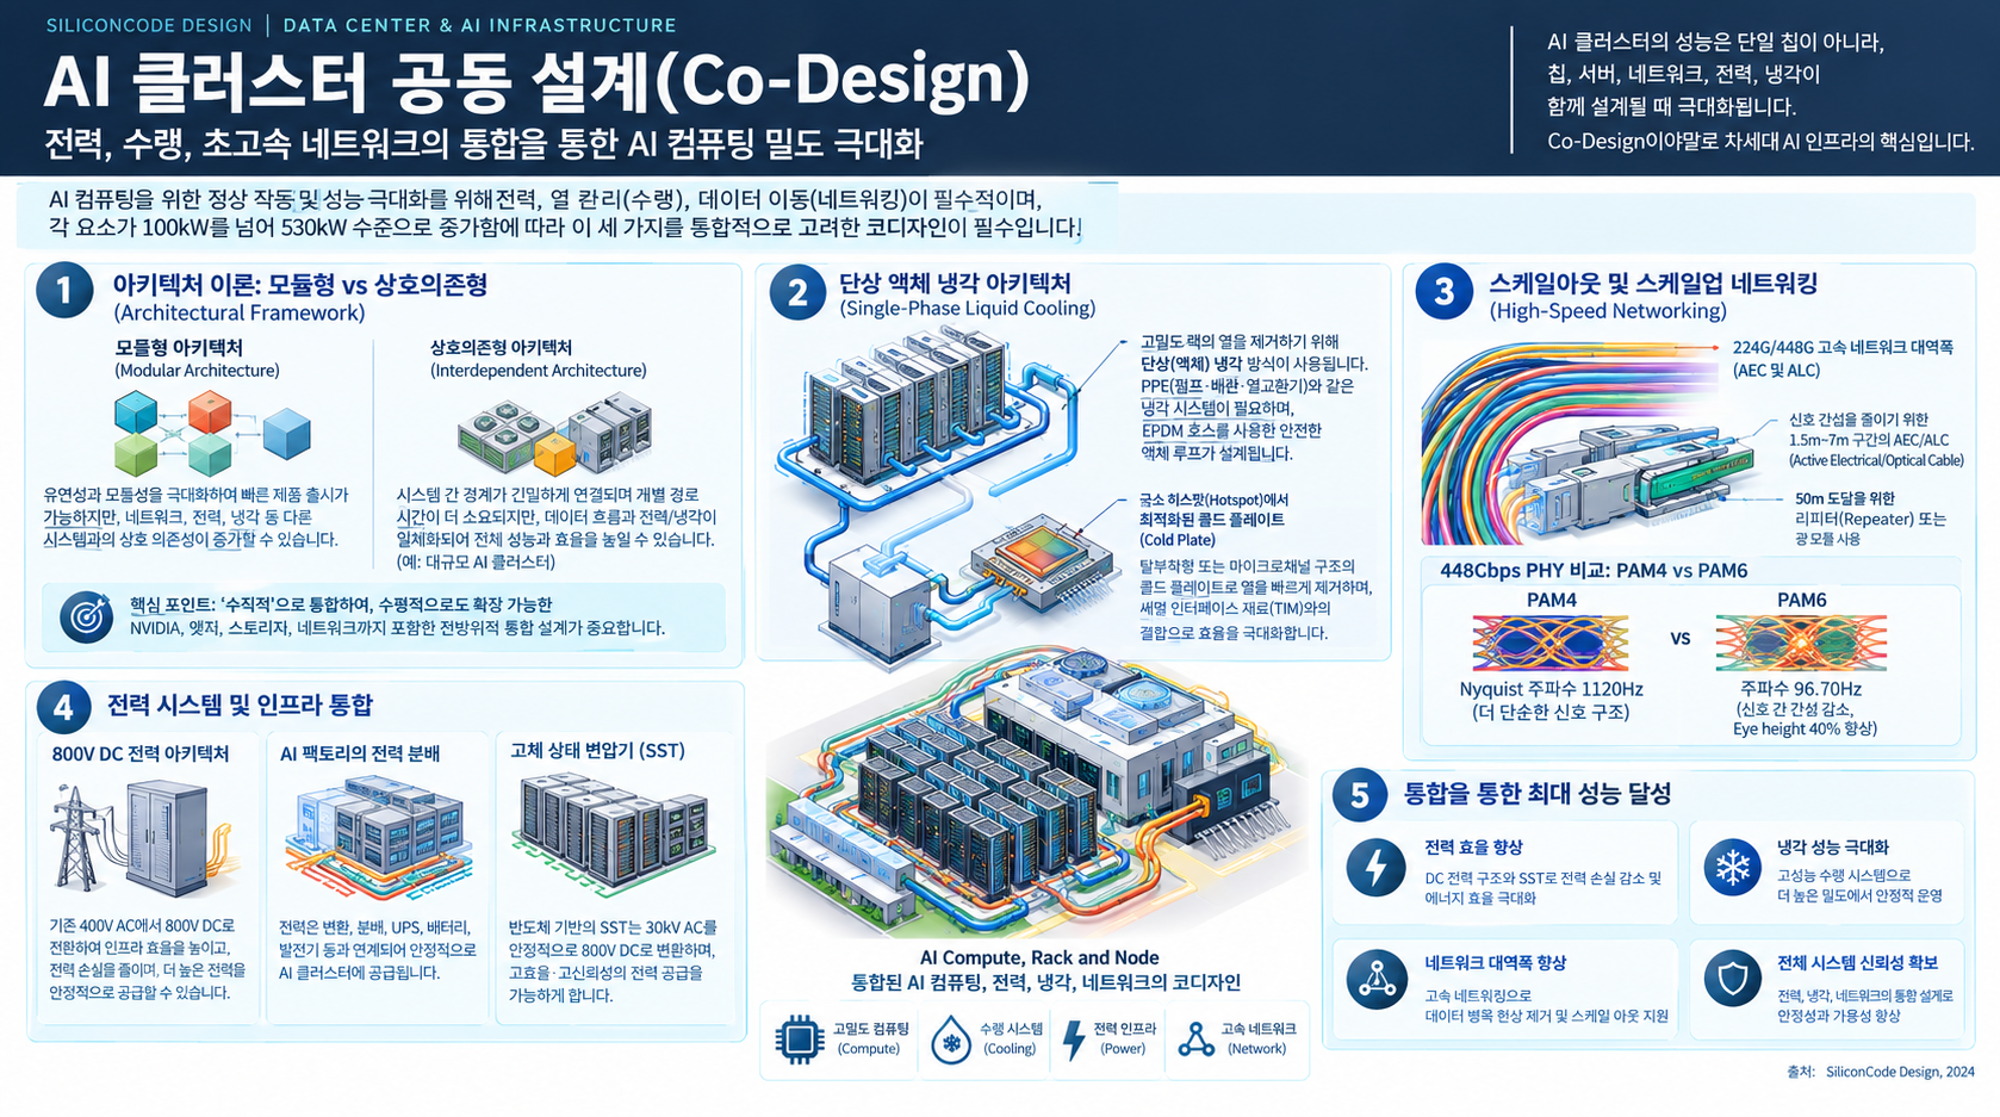
이 글의 중심 질문은 “AI 클러스터에서 무엇을 표준화하고, 무엇을 긴밀하게 공동설계해야 하는가?”입니다. 저자는 전력·냉각·네트워크를 개별 설비가 아니라, GPU의 실제 성능과 배치 밀도를 결정하는 연결된 시스템으로 설명합니다.[1]
아래는 원문의 실제 챕터와 하위 절 순서를 따르되, 반복되는 공동설계 주장은 해당 기술 절에서만 설명하고 결론에서는 산업적 의미만 정리했습니다. ‘원문 내용’과 ‘분석’을 구분했으며, 제품 성능·공급업체·인수 사례는 원문의 소개이지 별도 실증이나 독립 검증 결과는 아닙니다. 연결된 발표 영상 전체와 개별 그림의 세부 수치는 이번 분석 범위에 포함하지 않았습니다.
전체 구성
| 원문 챕터 | 고유 논점 | 핵심 설계 판단 |
| 1. 모듈형·상호의존형 아키텍처 이론 | 표준화와 수직통합이 공존하는 이유 | 어디까지 공개하고 어디를 통합할 것인가 |
| 2. 연산 주변의 주요 인프라 시스템 | 거리와 보조설비가 만드는 확장 한계 | GPU 증가를 실제 수용할 수 있는가 |
| 3. 800V 아키텍처 | 전력 전달 효율과 고장에너지의 상충 | 변환·저장·차단·접지를 어떻게 조합할 것인가 |
| 4. 액체냉각 | 국부 발열과 유압·기구 조건의 결합 | 칩에서 시설까지 열을 어떻게 배출할 것인가 |
| 5. 대규모 고속 네트워킹 | 물리적 링크 품질과 논리적 혼잡 | 데이터를 빠를 뿐 아니라 안정적으로 전달하는가 |
| 6. 결론 | 설계 경계 이동에 따른 가치 재배분 | 어떤 공급업체가 차별화할 수 있는가 |
1. Clayton Christensen’s Modular vs Interdependent Architecture Theory
성능이 부족한 지점은 통합하고, 충분해진 지점은 모듈화한다
원문 내용
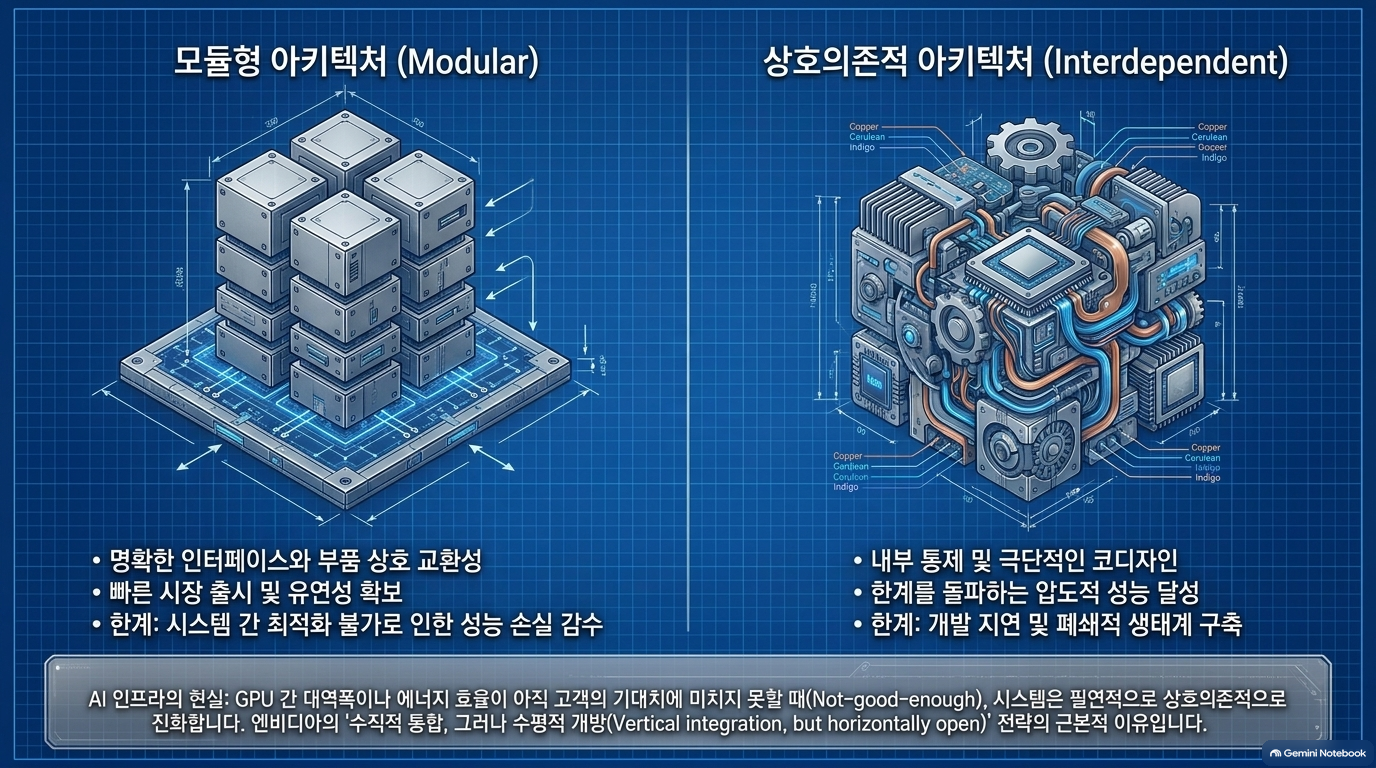
저자는 크리스텐슨과 레이너의 이론을 다음처럼 정리합니다.[1]
| 구분 | 모듈형 아키텍처 | 상호의존형 아키텍처 |
| 구성 방식 | 명확한 인터페이스로 부품을 연결 | 구성요소를 서로 맞추어 설계 |
| 주요 이점 | 교체·업그레이드·시장 출시 용이 | 성능 최적화에 유리 |
| 주요 부담 | 인터페이스를 넘는 최적화가 제한될 수 있음 | 개발·검증 시간과 협업 부담 증가 |
| 적합한 상황 | 주요 성능이 고객 요구를 충분히 충족 | 주요 성능이 아직 부족 |
AI에서는 특히 GPU 간 통신 대역폭과 에너지 효율이 아직 충분하지 않은 성능 영역으로 제시됩니다. 이 때문에 개별 부품의 범용성보다 전체 시스템의 긴밀한 통합이 중요해진다는 설명입니다.[1]
하위 절: Trends in AI Infrastructure
원문은 이 이론을 그대로 적용하기 어려운 이유도 제시합니다.
- 전기·기계·열 인터페이스가 얽혀 있다. 하나의 연결부를 바꾸면 신호 품질뿐 아니라 냉각과 배치도 달라집니다.
- 공급망이 설계를 제약한다. 기술적으로 최적인 부품이라도 공급되지 않거나 신규 공급업체 검증에 수개월이 걸릴 수 있습니다.
- 기업은 개방성과 독점성을 동시에 추구한다. 고객 선택권과 공급망 확장을 제공하면서, 핵심 성능 차별화는 유지하려 합니다.[1]
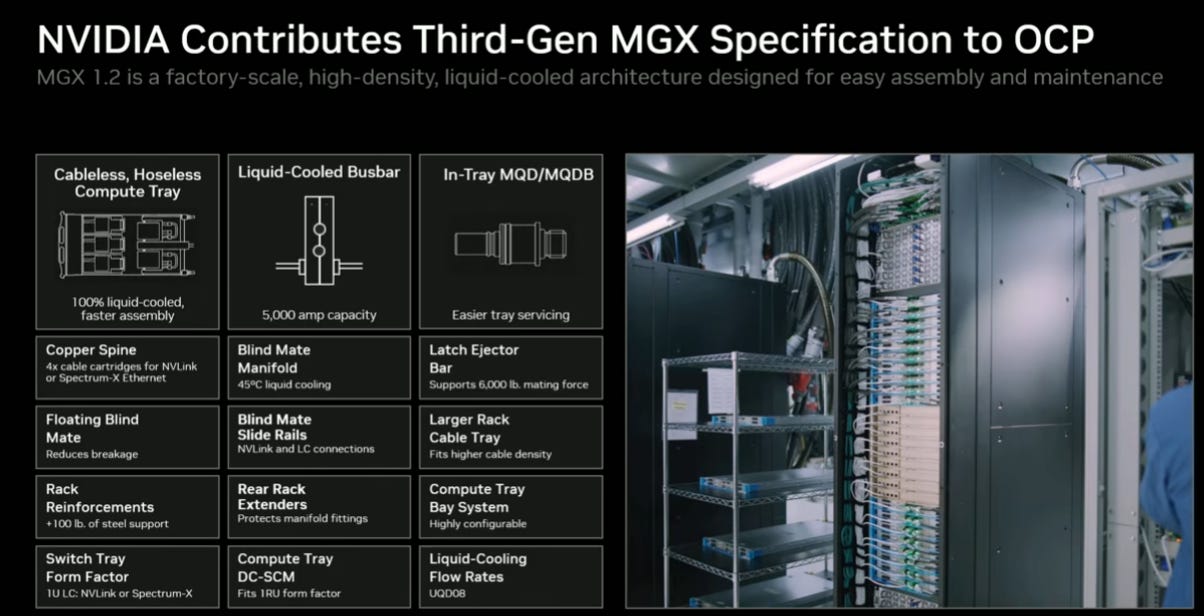
NVIDIA의 MGX 1.2 사양 OCP 기여를 그 사례로 소개합니다. 컴퓨트 트레이·액체냉각 버스바·트레이 내부 MQD 등은 공급업체 참여를 넓히는 방향으로 공개하면서, NVLink·xPU·CUDA·랙 단위 최적화는 핵심 경쟁력으로 유지한다는 해석입니다.[1]
분석
이 장의 핵심은 “개방형 대 폐쇄형”이라는 이분법을 버리는 것입니다.
실제 전략은 다음에 가깝습니다.
조달과 교체가 중요한 경계는 표준화하고, 성능 병목이 발생하는 경계는 공동설계한다.
따라서 사양 공개만으로 공급업체가 완전히 교체 가능해졌다고 판단해서는 안 됩니다. 기구적으로 호환되어도 펌웨어, 제어 방식, 검증 조건, 실제 성능은 특정 생태계에 종속될 수 있습니다.
이 장의 시사점: 개방성을 평가할 때는 공개 문서의 유무보다 대체 부품을 적용했을 때 재설계·재검증이 얼마나 필요한지를 보아야 합니다.
2. Major AI Infra Systems around Compute
확장 한계는 용량뿐 아니라 ‘도달거리’에서 발생한다
원문 내용
전력·냉각·네트워크는 모두 컴퓨트 랙에 필수 자원을 공급하지만, 멀리 전달할수록 불리해진다는 공통점이 있습니다.[1]
| 시스템 | 거리가 늘어날 때의 문제 | 설계에 미치는 영향 |
| 전력 | 버스바의 저항성 전압강하 | 도체·전압·전원 배치 재검토 |
| 냉각 | 열부하를 처리할 배관·유량 요구 증가 | 배관 크기·펌프·CDU 배치 변경 |
| 네트워크 | 신호 품질 저하와 혼잡 | 매체·토폴로지·제어 방식 변경 |
저자는 차세대 컴퓨트 플랫폼의 전력과 데이터 이동량이 증가하면, 이를 지원하는 전력 사이드카·냉각설비·네트워킹 랙도 함께 커져야 한다고 설명합니다.[1]
분석
이 장은 분석 단위를 GPU 또는 단일 랙에서 ‘보조설비를 포함한 클러스터’로 확장합니다.
컴퓨트 랙 하나의 연산 밀도가 높아져도, 이를 지원하는 설비와 케이블 공간이 더 많이 필요하면 데이터홀 전체의 유효 밀도는 기대만큼 개선되지 않을 수 있습니다.
따라서 다음은 다른 지표입니다.
- 컴퓨트 랙 밀도: 해당 랙 안에 얼마나 많은 연산을 넣는가.
- 시설 전체 유효 밀도: 지원설비와 공간 제약까지 포함했을 때 얼마나 많은 유효 연산을 수용하는가.
이 장의 시사점: 증설계획은 GPU 수량표가 아니라 컴퓨트 랙·전력 사이드카·CDU·네트워크 랙의 배치와 용량을 함께 보여주는 계획이어야 합니다. 원문은 이 균형의 필요성을 설명하지만, 모든 시설에 적용할 고정 비율을 제시하지는 않습니다.
3. 800V Architecture
전력 전달 효율을 높일수록 저장·보호·접지를 함께 설계해야 한다
3.1 전력 변환과 분배 구조
원문 내용
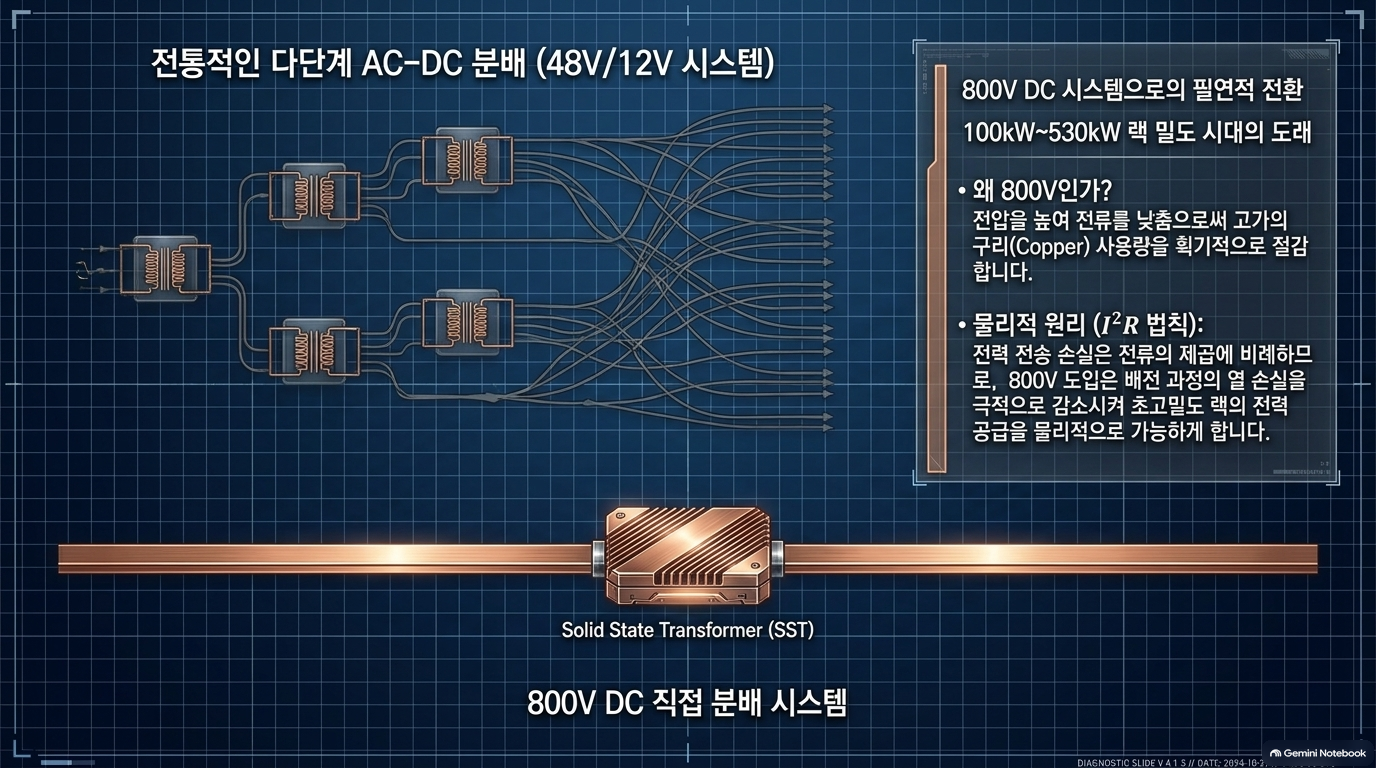
전력계통의 역할은 중전압 AC를 칩과 주변 부품이 사용하는 저전압 DC까지 효율적으로 변환·분배하는 것입니다. 원문은 약 34.5kVac에서 약 0.65Vdc에 이르는 경로를 예로 듭니다.[1]
기존 구조에서는 480VAC를 랙까지 전달한 뒤 48V 또는 12V로 변환했지만, 랙 전력이 100kW를 넘어 더 높아지면서 분배 손실과 랙 내부 변환 부담이 커진다는 설명입니다. 대안으로 800VDC 분배를 소개하며 다음의 설계 선택을 제시합니다.[1]
- 480VAC → 800VDC 변환을 랙·클러스터·데이터센터 중 어디에 둘 것인가.
- 800VDC → 48/12/6V 변환을 랙 내부에 어떻게 분산할 것인가.
- 사이드카, 전력 셸프, 버스바, 케이블, BBU를 어떤 구조로 배치할 것인가.
분석
800V의 의미는 단순한 전압 상승이 아니라 전력 변환 단계와 장비 배치의 재편입니다.
원문의 “100kW 초과 랙에서 유망하다”는 설명은 설계 동향으로 읽어야 합니다. 특정 랙 전력만으로 800V가 반드시 최적이라고 결론 내리려면 기존 시설, 부하 특성, 안전·유지보수 조건과 비용 비교가 추가로 필요합니다.
3.2 Energy Storage Capacity, Fault Detection, and Grounding
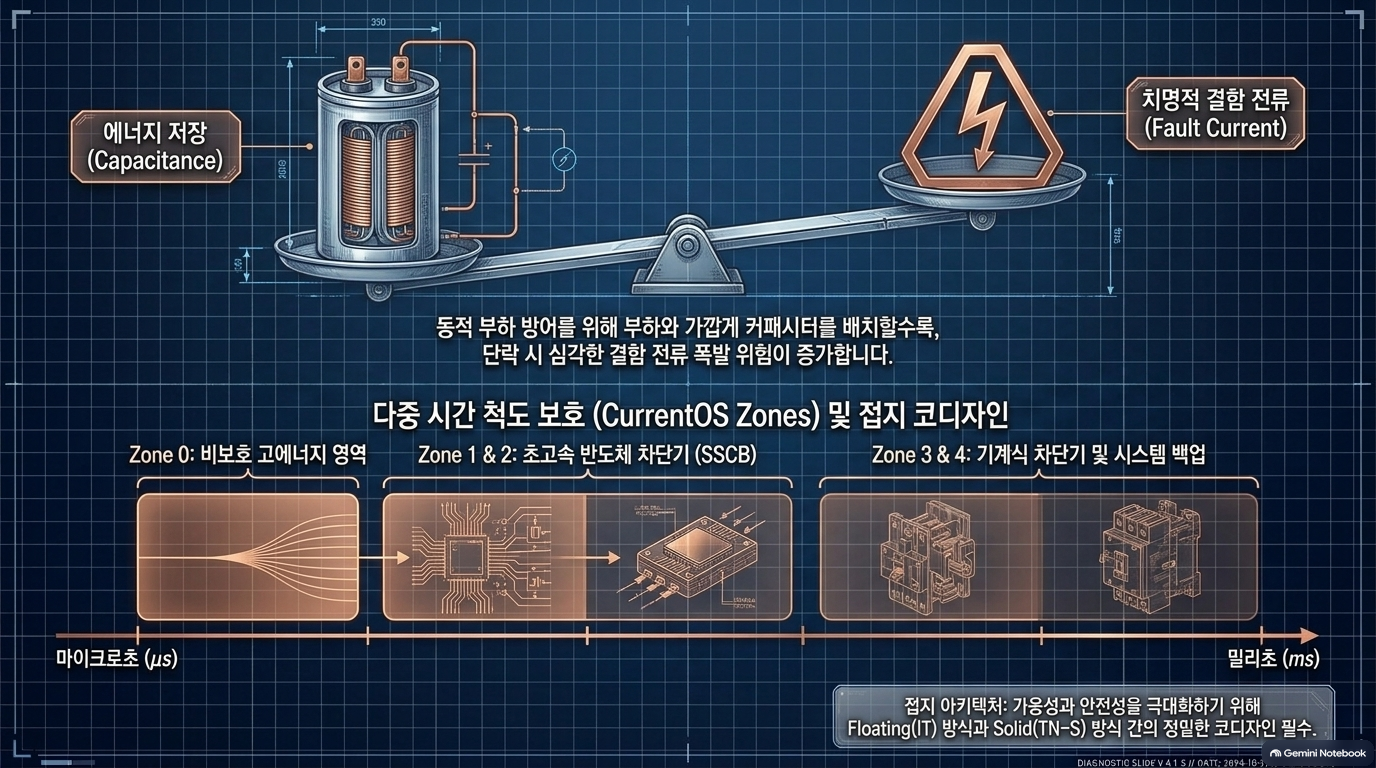
이 절의 핵심은 전력 품질을 개선하는 저장장치가 동시에 고장에너지원이 된다는 것입니다.
① 에너지 저장: 부하 변동 대응
AI 부하의 급격한 전력 요구에 대응하려면 800V 레일에 충분한 에너지 저장이 필요합니다. 커패시터를 부하 가까이에 배치하면 순간적인 전력 공급에 유리하지만, 과도하게 키우면 고장 시 방전 부담이 커집니다.[1]
원문은 커패시터 계열과 함께, 더 긴 외부 전원 장애에 대응하는 BBU도 구분해 설명합니다.[1]
분석: “에너지 저장 용량이 충분한가”만으로는 부족합니다. 어떤 시간대의 변동을 어느 장치가 담당하는지를 정의해야 합니다. 순간 부하 평활화와 정전 백업은 같은 요구가 아닙니다.
② 고장보호: 서로 다른 시간척도 대응
DC에는 AC와 같은 자연적인 전류 영점 교차가 없어 고장전류 차단이 어렵습니다. 원문은 커패시터 방전에 따른 μs 수준 현상과 ms 수준의 과전류를 구분하고, 퓨즈·기계식·하이브리드·반도체 차단장치 등을 소개합니다.[1]
CurrentOS의 구역 개념도 가용 고장전류·에너지와 보호 방식에 따라 회로를 분류하는 사례로 제시됩니다.[1]
분석: 보호장치의 정격뿐 아니라 고장 구역, 검출·차단 시간, 차단 후 서비스 영향 범위가 중요합니다. 단일 차단기를 선정하는 문제가 아니라 보호 협조의 문제입니다.
③ 접지: 안전과 가용성의 균형
원문은 2선식 800V와 3선식 ±400V를 소개하고, 부유·임피던스 접지 계열인 IT와 직접 접지 계열인 TN-S를 비교합니다. 접지 선택은 절연, 고장 검출, 인체 안전, 고장 시 시스템 가용성에 영향을 줍니다.[1]
분석: ±400V는 선간 전압이 더 낮은 400V 시스템이라는 의미가 아닙니다. 비교할 때는 선간 전압과 대지 기준 전압, 절연 조건을 구분해야 합니다.
[확인 필요] 원문에 소개된 Google의 ±400V 선택은 해당 발표 맥락의 설계 방향입니다. 이를 모든 데이터센터의 확정 표준으로 일반화할 수는 없습니다.
3.3 Solid State Transformers
원문 내용
SST는 반도체 기반 전력변환을 이용해 중전압 AC를 800VDC로 변환하는 접근입니다. 별도의 전통적인 50/60Hz 강압 변압기 없이 여러 기능을 통합할 수 있지만, 고주파 자기 절연과 제어회로가 필요합니다.[1]
저자는 기존 대형 변압기의 긴 조달기간을 배경으로 제시하고, Google·Microsoft·NVIDIA가 참여한 OCP SST 사양과 여러 개발업체를 소개합니다.[1]
분석
SST는 “변압기가 사라지는 기술”보다 전력전자 기반으로 변환·절연·제어 기능을 재구성하는 기술로 이해하는 것이 정확합니다.
공간과 제어 측면의 장점이 전체 수명주기 비용 우위까지 입증하는 것은 아닙니다. 원문에는 기존 방식과의 동일 조건 효율·고장률·유지보수 비용 비교가 제시되지 않습니다.
3.4 Key Suppliers across the Power Supply Chain
원문은 전력반도체 업체와 랙 전력 시스템 통합업체를 구분합니다. 후자의 주요 사례는 Delta, MEGMEET, Liteon, Flex입니다.[1]
분석: 이 구분의 의미는 부품 성능 경쟁과 시스템 통합 경쟁이 다르다는 것입니다.
- 반도체 업체: 손실·스위칭·열·보호 소자의 성능.
- 시스템 업체: 셸프·변환기·저장장치·기구·제어의 조합과 검증.
[확인 필요] 제품 용량이나 전시 참여는 특정 고객의 채택, 대량 출하, 시장점유율을 입증하지 않습니다.
4. Liquid Cooling
냉각 대상은 ‘칩 전체’가 아니라 위치별로 다른 열분포다
4.1 기본 구조: 단상 액체냉각
원문 내용
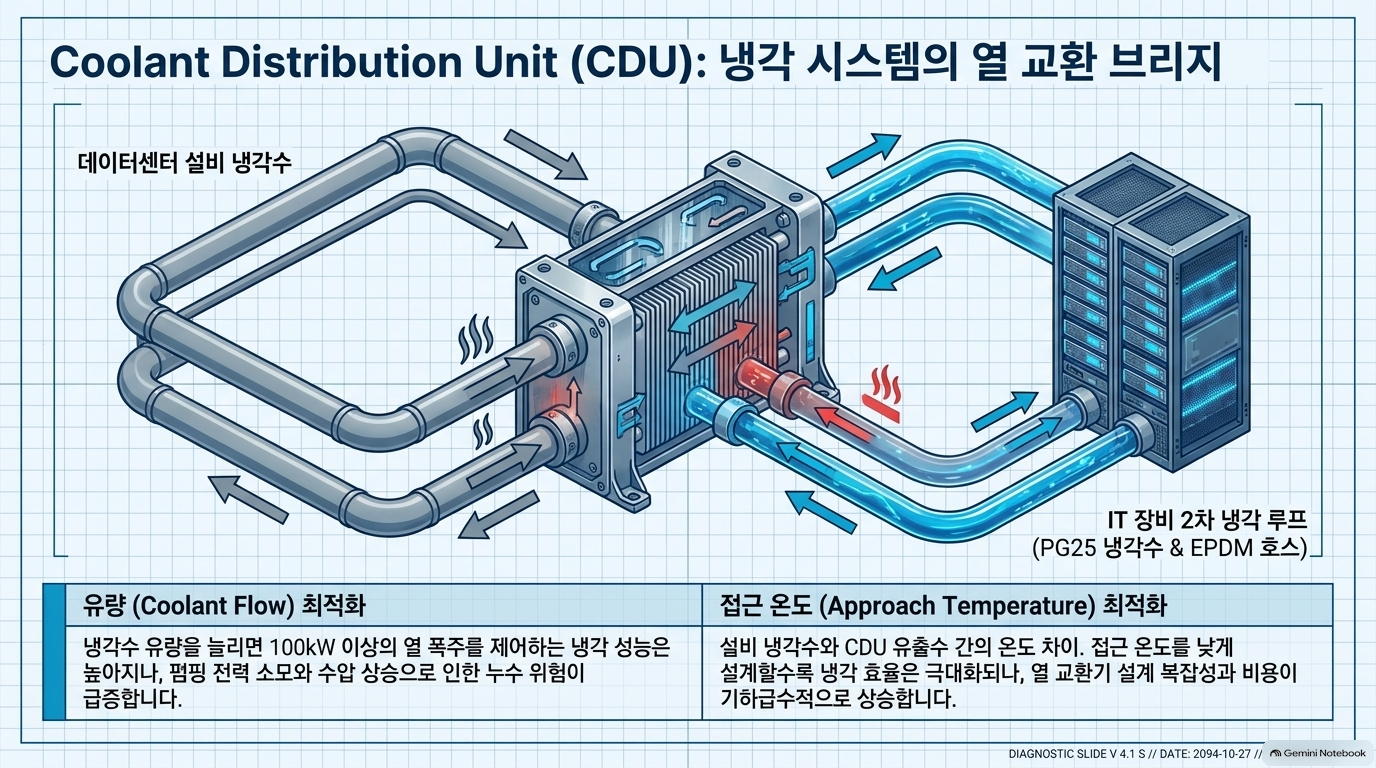
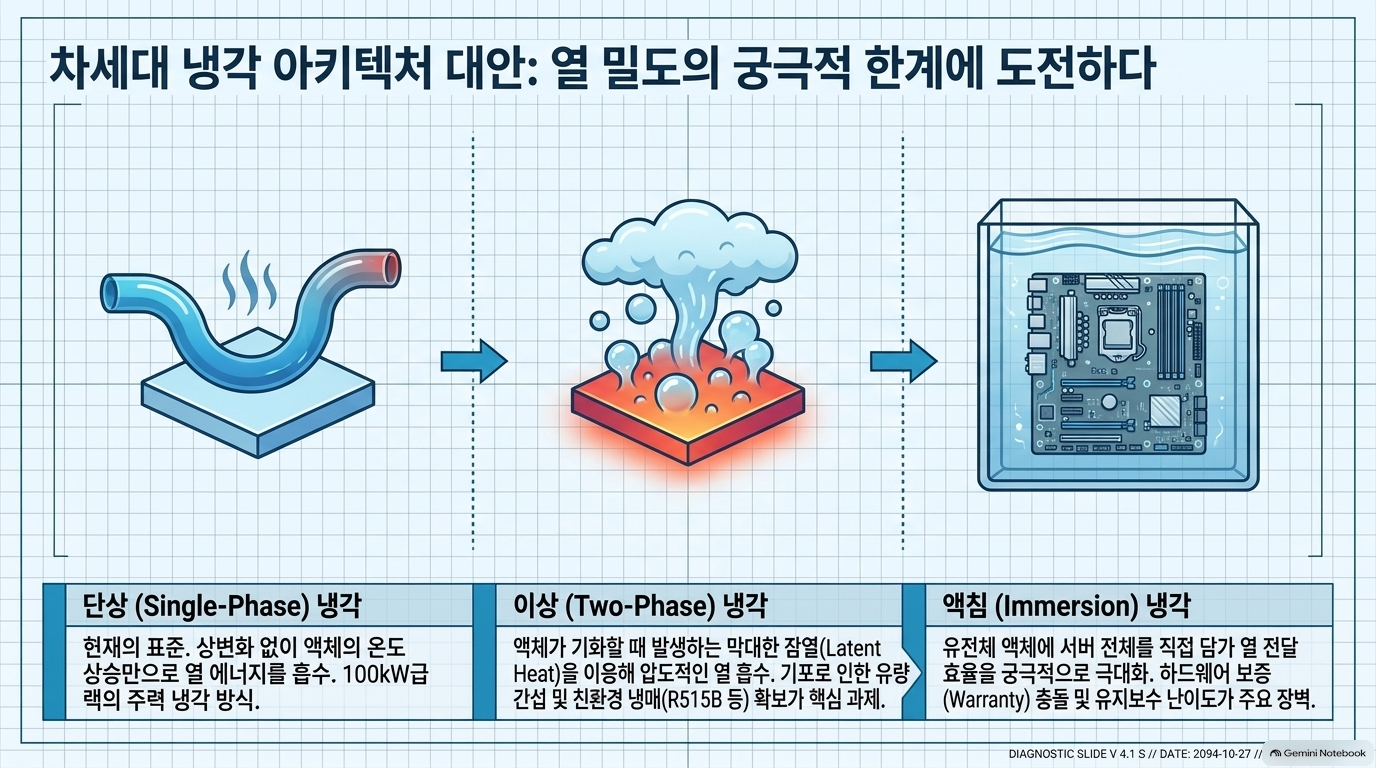
원문은 고밀도 AI 랙에서 단상 액체냉각을 주류 접근으로 설명합니다. 냉각액은 상변화 없이 열을 흡수하고, CDU에서 시설 냉각수 계통으로 열을 전달합니다.[1]
글이 소개하는 대표 구성은 다음과 같습니다.
- 칩·전력부품 등에 접촉하는 콜드플레이트.
- 장비 측 냉각액이 흐르는 2차 루프.
- 시설 냉각수와 장비 측 루프를 연결하는 CDU.
- 호스·매니폴드·퀵디스커넥트 등 유체 연결부.[1]
PG25 냉각액과 과산화물 경화 EPDM 호스도 대표 사례로 소개합니다.[1]
분석
이 구조의 중요한 의미는 시설수와 IT 장비 측 유체 조건을 분리하면서 열을 교환한다는 것입니다. 냉각 용량 외에도 유체 청정도, 부식, 재질 적합성, 누수 대응이 시스템 성능을 좌우합니다.
다만 원문의 재료 사례를 모든 제품에 적용되는 필수 규격으로 읽어서는 안 됩니다.
4.2 Single-Phase Cold Plates
원문 내용
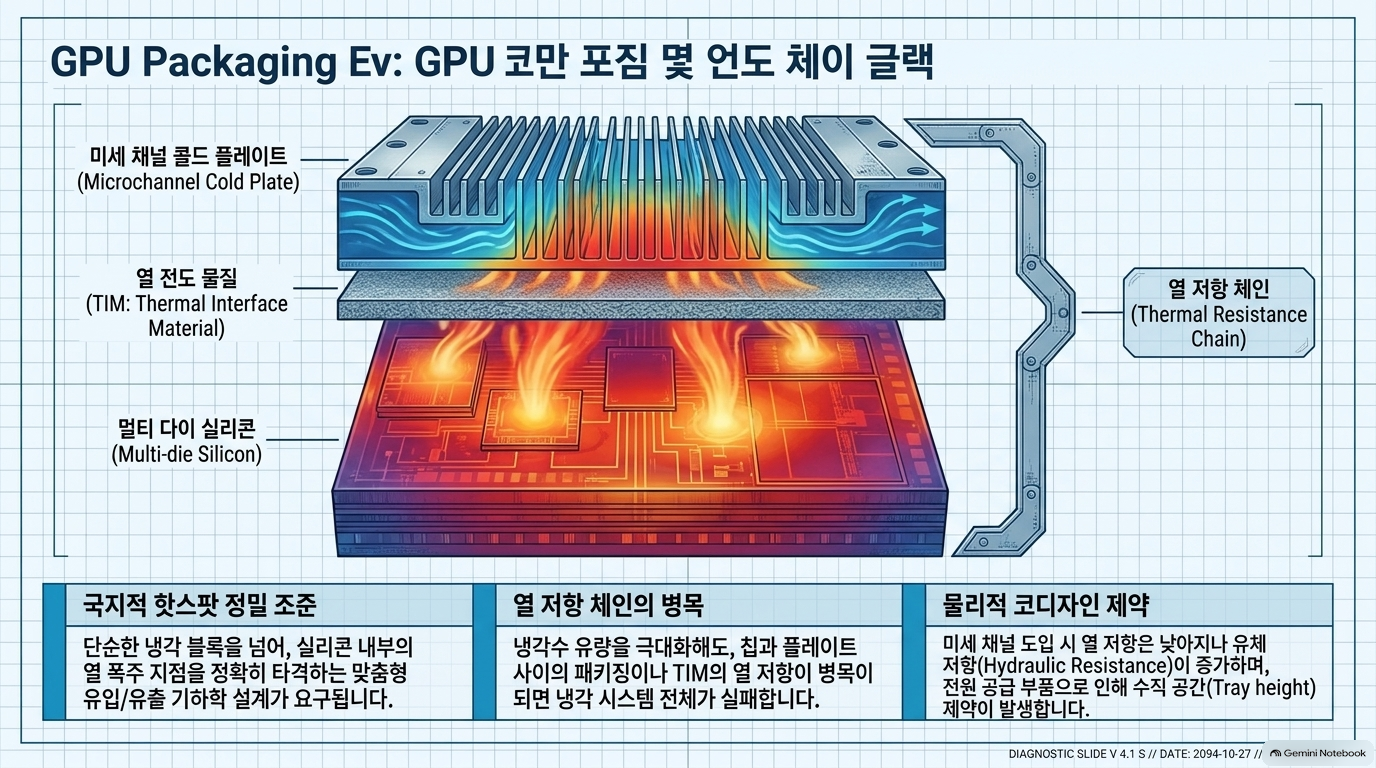
과거의 콜드플레이트가 비교적 균일한 발열을 처리했다면, 멀티다이 칩은 국부적인 핫스폿을 만들기 때문에 위치별 냉각 설계가 중요해집니다.[1]
주요 제약은 다음과 같습니다.
| 설계 항목 | 확인해야 할 내용 |
| 칩과 냉각액 사이 열저항 | 패키지·TIM·콜드플레이트를 통한 열 전달 |
| 트레이 높이 | 부품·전력전달 구조·콜드플레이트의 공간 충돌 |
| 유압 조건 | 유량·압력강하·호스·커넥터의 영향 |
| 기구 정렬 | 매니폴드·퀵디스커넥트·섀시의 체결 적합성 |
개선 방향으로 미세 유로, 핫스폿 지향 입출구 형상, 실제 실리콘이 없을 때의 열 에뮬레이션을 소개합니다. 미세 유로는 열저항을 낮추는 대신 유압저항과 펌핑 부담을 높일 수 있습니다.[1]
또한 장기 크리프, 글리콜 노화, 씰 건전성 시험은 설치·시험 조건에 민감하고, 원문은 시험 표준화의 어려움을 지적합니다.[1]
분석
이 절은 냉각 사양을 총 발열량에서 공간별 열지도와 동작 조건으로 전환합니다.
콜드플레이트의 명목 용량이 충분해도 특정 다이 위에 열이 집중되거나 칩에서 플레이트까지 열이 전달되지 않으면 문제가 남습니다. 따라서 “몇 kW를 냉각한다”보다 다음의 결합이 중요합니다.
열분포 + 접촉 열저항 + 유량·압력 조건 + 기구 공차 + 장기 신뢰성
원문은 기존 공급업체 외에 미세 제트, 하이브리드 본딩, 다이아몬드 열확산체, 맞춤형 미세유체 기술도 소개하지만, 이들을 동일 조건에서 비교한 성능 순위는 제공하지 않습니다.[1]
4.3 Coolant Distribution Units
원문 내용
CDU는 IT 장비와 시설 냉각계통 사이의 열적·유압적 인터페이스입니다. 랙 내부, 열 단위, 중앙집중형으로 배치할 수 있습니다.[1]
주요 설계변수는 다음과 같습니다.
- 유량: 증가시키면 열 제거에 유리할 수 있지만 압력강하와 펌핑전력이 커집니다.
- 접근온도: 시설수 입구와 CDU에서 나가는 장비 측 냉각액 사이의 온도차입니다. 원문은 25℃와 28℃를 예로 듭니다.[1]
원문은 2MW CDU가 액체냉각이 담당하는 부하에 따라 대략 10~25개의 고밀도 AI 랙을 지원할 수 있다고 설명합니다. 차별화 요소로는 설치면적, 신뢰성, 누수·과열 진단을 위한 자동화된 플릿 수준 텔레메트리를 제시합니다.[1]
분석
CDU는 단순한 대형 열교환기가 아니라 여러 랙의 운전 상태와 장애 영향을 묶는 운영 단위입니다. 따라서 최대 냉각 용량만 아니라 부분부하, 정비, 고장 시 지원 범위, 모니터링 연계까지 평가해야 합니다.
[확인 필요] “2MW당 10~25랙”은 고정 환산 기준이 아닙니다. 랙 소비전력 전체와 액체가 실제로 회수하는 열부하는 다를 수 있습니다.
또한 접근온도를 낮추는 것은 열교환 성능 측면의 장점이지만, 그 자체로 시설 전체의 에너지 효율이나 비용 최적을 의미하지 않습니다.
4.4 Future Alternatives: Two-Phase and Immersion
| 방식 | 원문의 설명 | 남아 있는 과제 |
| 2상 냉각 | 액체가 기화하며 열을 흡수 | 냉매의 환경성·안전성·열성능, 기포에 따른 유동 영향 |
| 액침냉각 | 전자장비를 절연액에 담금 | 책임소재·보증·운영 조건 |
원문은 이들을 발전 가능성이 있는 대안으로 소개하지, 단상 냉각을 대체할 확정된 승자로 제시하지 않습니다.[1]
분석: 2상은 열전달 과정, 액침은 장비를 냉각액에 접촉시키는 구성 방식에 관한 분류입니다. 서로 완전히 배타적인 기술 범주로 이해하면 안 됩니다.
4.5 Takeaway — Liquid Cooling Requires Extreme Co-Design
이 절에서 추가되는 고유 주장은 냉각 엔지니어뿐 아니라 칩 물리설계자도 열분포를 고려해야 한다는 것입니다. 전력을 많이 쓰는 블록의 배치부터 핫스폿을 완화할 수 있어야 한다는 설명입니다.[1]
이 장의 시사점: 냉각은 완성된 칩에 나중에 부착하는 설비가 아니라, 칩 배치에서 시설 운전까지 이어지는 설계 입력조건입니다.
5. High-Speed Networking at Scale
‘링크가 불안정한 문제’와 ‘네트워크가 혼잡한 문제’를 구분한다
원문 내용
저자는 데이터 이동의 불안정성을 두 가지로 나눕니다.[1]
- 링크 플랩: 신호 무결성이나 전기·광학 장치 문제로 연결이 반복적으로 끊기고 복구되는 현상.
- 네트워크 수준 불안정: 혼잡으로 패킷 손실과 지연이 발생하는 현상.
분석
이 구분이 중요한 이유는 처방이 다르기 때문입니다.
- 링크 자체가 불안정하면 케이블·커넥터·SerDes·광학부품을 보아야 합니다.
- 링크가 정상이어도 트래픽이 집중되면 토폴로지·라우팅·혼잡제어를 보아야 합니다.
명목 대역폭 증설만으로 두 문제가 동시에 해결되지는 않습니다.
5.1 448Gbps Copper
원문 내용
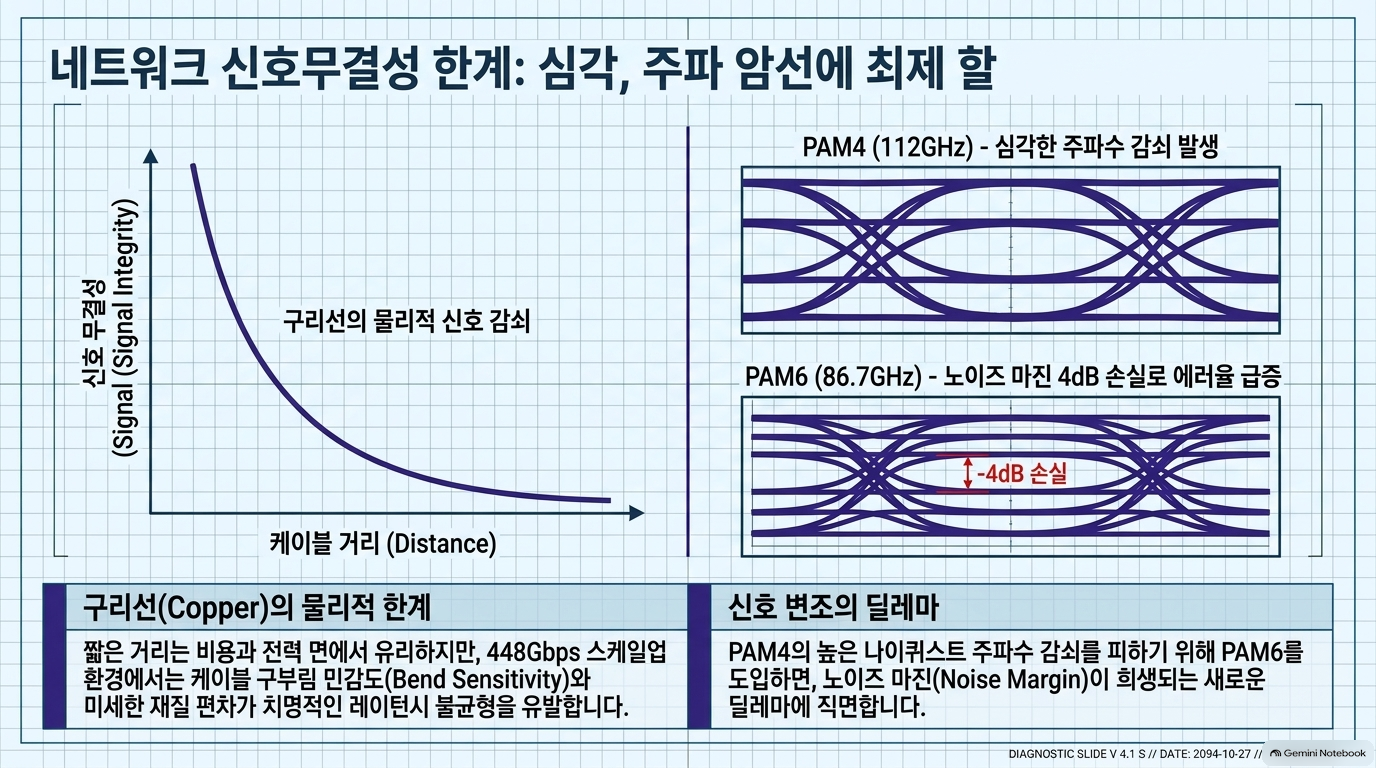
원문은 구리를 단거리에서 비용·전력·신뢰성 측면의 장점이 있는 매체로 설명하면서도, 속도가 높아질수록 도달거리 확보가 어려워진다고 봅니다.[1]
패키지 주변에서는 손실이 큰 PCB 경로를 줄이는 Co-Packaged Copper, CPC를 소개하고, 랙 사이 연결은 다음처럼 구분합니다.[1]
| 연결 방식 | 신호 처리 방식 | 구분할 점 |
| DAC | 수동 구리 연결 | 능동 신호 보정 없음 |
| ACC | 아날로그 이퀄라이저·리드라이버 | 일반적으로 클록 복구 없음 |
| AEC | 리타이머·DSP·CDR | 클록·데이터 복구 수행 |
| AOC | 양 끝에서 전기·광 변환 | 전송 매체가 광섬유 |
실제 제약으로는 누화, 차동쌍 내부 스큐, 삽입손실, 케이블 굽힘, 공급업체별 재료 편차를 제시합니다. 원문에는 굽힘 반경을 지키기 위해 랙 간격을 조정하는 사례와, 동일 부품번호라도 생산지별 재료 특성에 따라 신호 품질이 달라진 사례가 소개됩니다.[1]
또한 448Gbps 장거리 전기 채널에서 PAM4와 PAM6 선택을 논의합니다. PAM6는 필요한 주파수 대역을 낮출 수 있지만 신호 레벨 간 여유가 줄어드는 상충관계가 있습니다.[1]
분석
이 절의 고유한 통찰은 전기적 신호 품질 문제가 물리적 시설 밀도까지 바꾼다는 것입니다.
케이블은 연결 부자재가 아니라 배치 설계의 제약입니다. 커넥터와 케이블의 조합, 실제 굽힘 상태, 패키지·보드 경로까지 포함해 검증해야 합니다.
[확인 필요] 원문에는 224G·448G 신호 속도, 800Gbps AEC, 1.6T 광케이블이 함께 등장합니다. 레인당 속도와 다중 레인 포트·케이블 총속도를 구분해야 하며, 제시된 도달거리를 다른 제품이나 신호 조건에 그대로 적용할 수 없습니다.
5.2 Scale-Across Network Architecture
이 절에는 서로 다른 두 계층의 이야기가 함께 들어 있습니다.
① 데이터센터 간 광전송: Coherent-Lite
원문은 기존 장거리 코히어런트 광통신의 DSP 기능이 비교적 짧은 데이터센터 간 연결에서는 과도한 전력과 지연을 만들 수 있다고 설명합니다. 이에 필요한 기능만 남기는 coherent-lite와 관련 표준화 논의를 소개합니다.[1]
분석: 장거리용 최상위 기능을 그대로 가져오기보다 실제 거리·손실·지연 예산에 맞추어 기능을 줄이는 최적화입니다. 다만 트랜시버 내부 지연이 줄어든다고 데이터센터 간 전체 지연이 동일하게 줄어드는 것은 아닙니다. 전파거리와 경로·스위칭 지연이 별도로 남습니다.
② 클러스터 전송과 혼잡제어: RoCE·MetaRoCE·UET
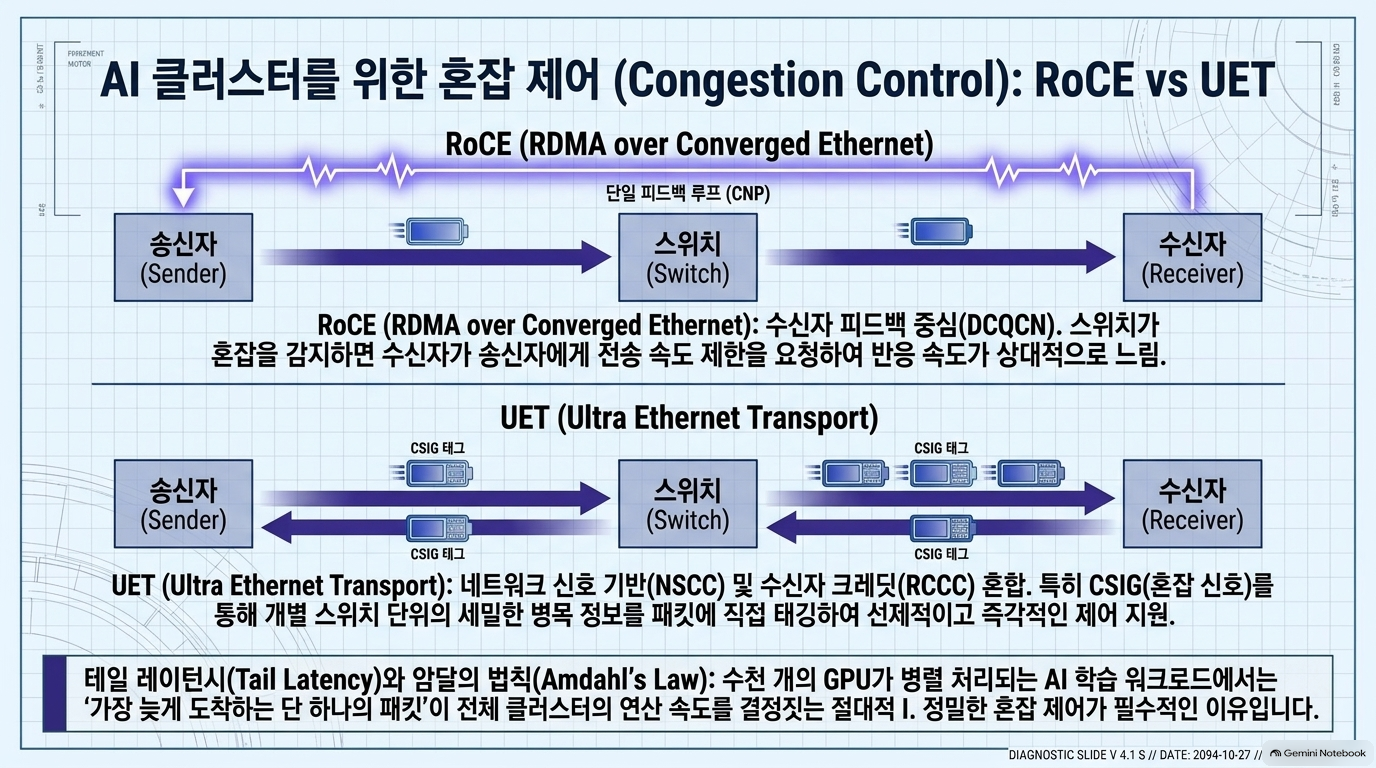
원문은 평균 처리량보다 긴 꼬리 지연, tail latency가 분산 작업의 완료시간을 좌우할 수 있다고 강조합니다. 부하 불균형, 대역폭 불일치, 버스트 트래픽 등이 원인으로 제시됩니다.[1]
소개하는 접근은 다음과 같습니다.
| 접근 | 원문에서 설명하는 제어 방식 |
| RoCE의 DCQCN | 스위치의 ECN 표시와 수신 측 CNP를 통해 송신률 조정 |
| MetaRoCE | 기존 RDMA 애플리케이션 인터페이스와 호환되는 AI scale-out 대상 접근으로 소개 |
| UET의 RCCC | 수신 측이 송신 허용 크레딧을 부여 |
| UET의 NSCC | 네트워크 피드백을 이용해 송신 측 혼잡 윈도 조정 |
| CSIG | 경로상의 혼잡 정보를 패킷의 압축된 태그에 반영 |
위 내용과 UEC 사양 1.1의 발표 시점은 원문의 설명을 따른 것입니다.[1]
분석
이 절의 방향은 “문제가 생기면 전송률을 줄이는 제어”에서 “경로 상태를 더 구체적으로 파악해 전송을 조절하는 제어”로의 발전입니다.
다만 원문의 절 제목은 scale-across이지만, MetaRoCE와 UET 논의에는 데이터센터 내부 scale-out 문제도 포함되어 있습니다. 이를 모두 데이터센터 간 장거리 전송 기술로 묶으면 계층을 혼동하게 됩니다.
이 장의 시사점: 네트워크 평가는 링크 속도 외에 링크 플랩, 혼잡 손실, 꼬리 지연, 장애 우회, 실제 분산 작업 완료시간을 함께 보아야 합니다. 사양 발표가 실제 NIC·스위치의 상호운용성과 운영 성숙도를 보장하는 것은 아닙니다.
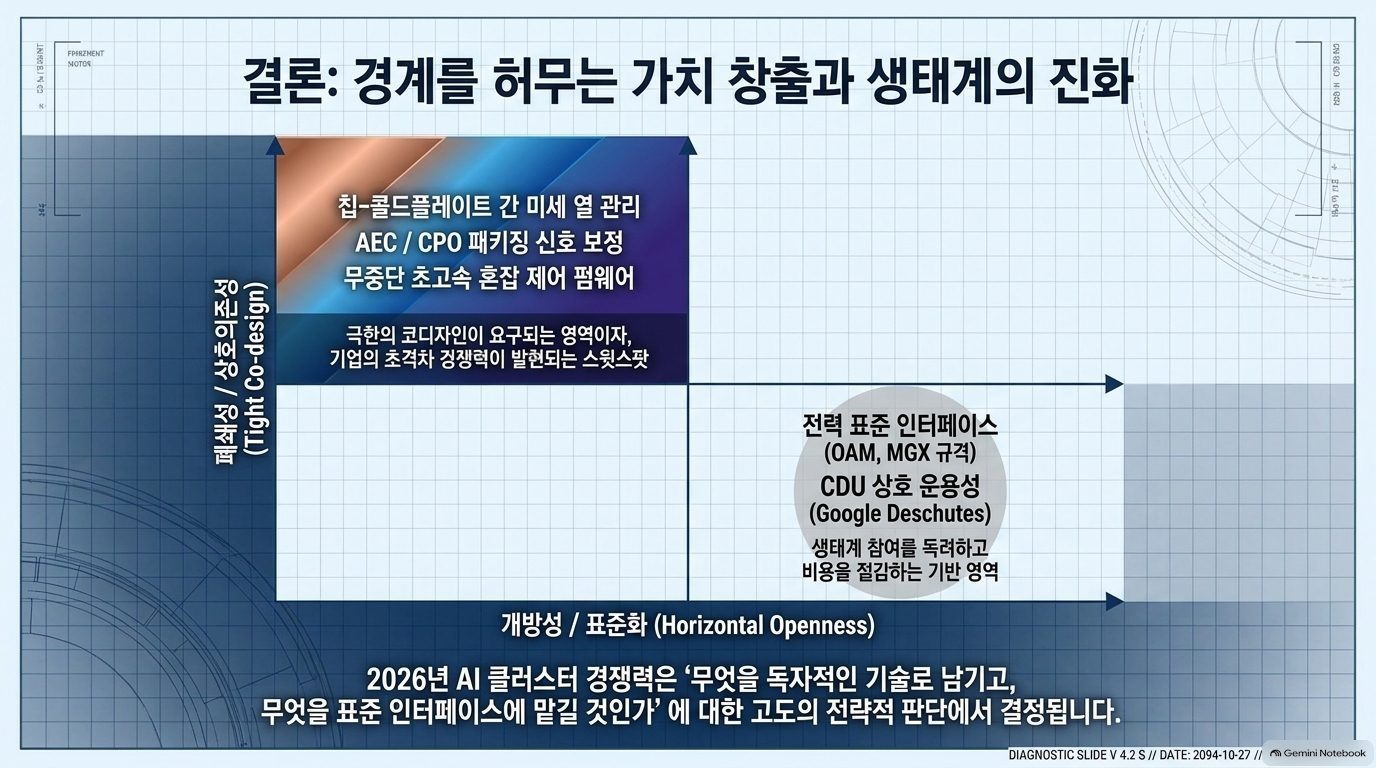
6. Conclusion
산업적 가치는 ‘부품’보다 ‘설계 경계를 다룰 수 있는 능력’으로 이동한다
원문의 결론은 표준화 가능한 인터페이스와 긴밀한 공동설계가 필요한 인터페이스의 경계가 계속 이동하며, 이 변화가 기업의 차별화와 가치 확보에 영향을 준다는 것입니다.[1]
이를 산업 관점에서 해석하면 다음과 같습니다.
| 가치 확보 영역 | 차별화의 근거 |
| 표준 인터페이스 제품 | 공급 안정성·가격·교체 용이성 |
| 성능 병목 부품 | 경쟁 제품이 대체하기 어려운 물리적 성능 |
| 시스템 통합 | 전기·열·기구·제어 간 상충관계 조정 |
| 검증·운영 | 장기 신뢰성, 장애 진단, 상호운용성 확보 |
이 표는 원문의 논지를 바탕으로 한 분석적 정리이며, 업체별 수익성이나 시장점유율을 검증한 결과는 아닙니다.
종합 평가
이 글의 강점은 AI 인프라의 문제를 GPU 사양 경쟁에서 ‘실제 작동 가능한 시스템의 설계’로 옮긴 데 있습니다. 특히 다음 세 가지 연결을 구체적으로 보여줍니다.
- 전력 품질을 개선하는 저장장치가 고장보호 부담을 늘린다.
- 냉각 성능을 높이는 미세 유로가 유압과 펌핑 부담을 늘린다.
- 고속 연결을 위한 케이블 조건이 랙 배치와 시설 밀도를 제한한다.
반면, 이 글은 설계 동향을 이해하는 해설이지 대안 간 우열을 확정하는 비교시험 보고서는 아닙니다. 동일 조건의 비용·효율·신뢰성 비교, 장기 운영 데이터, 제품별 검증 조건은 충분히 제시되지 않습니다.
따라서 실무적으로는 기술 선택의 정답표보다, 설계 검토에서 놓치면 안 되는 상충관계의 지도로 활용하는 것이 적절합니다.
출처
[1] https://open.substack.com/pub/chadw/p/ocp-2026-co-designing-an-ai-cluster — Chad — OCP 2026 - Co-Designing an AI Cluster


'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - OCP 2026: 근패키지 광학(NPO)과 공동패키지 광학(CPO) (0) | 2026.10.25 |
|---|---|
| AI 반도체 - Semianalysis, Huawei–DeepSeek 공생관계 (0) | 2026.10.25 |
| AI 반도체 - Semianalysis, Amazon Trainium3, GB300, B200 (0) | 2026.10.25 |
| AI 반도체 - CPO - 고속 광통신에 대한 종합적인 개요 (0) | 2026.10.24 |
| AI 반도체 - Semianalysis, ASML 하이브리드 본딩 전략 (0) | 2026.10.19 |