https://newsletter.semianalysis.com/p/amazons-trainium-takes-a-strike-at
2026.10.25
[Amazon’s Trainium Takes a Strike at the Training King]
제공된 문서는 아마존의 Trainium 인공지능 칩이 기존의 추론 영역을 넘어 모델 학습(Training) 분야로 영역을 확장하는 과정을 다각도로 분석하고 있습니다. 핵심적으로, 아마존은 과거의 복잡한 XLA 방식에서 벗어나 네이티브 PyTorch 지원 환경을 구축함으로써 연구자들이 친숙하고 유연하게 모델을 실험할 수 있도록 소프트웨어 전략을 대폭 수정했습니다. 또한, 수만 개의 코어를 활용한 철저한 자동 품질 관리(CI) 체계를 도입하여 다양한 허깅페이스 모델과의 수치적 정합성과 안정성을 검증하고 있습니다. 결론적으로 이 글은 하드웨어 성능뿐만 아니라 개발자 친화적인 생태계와 툴을 갖추어나가고 있는 Trainium3의 잠재력과 현재의 과제를 객관적으로 조명하고 있습니다.
Amazon’s Trainium Takes a Strike at the Training King
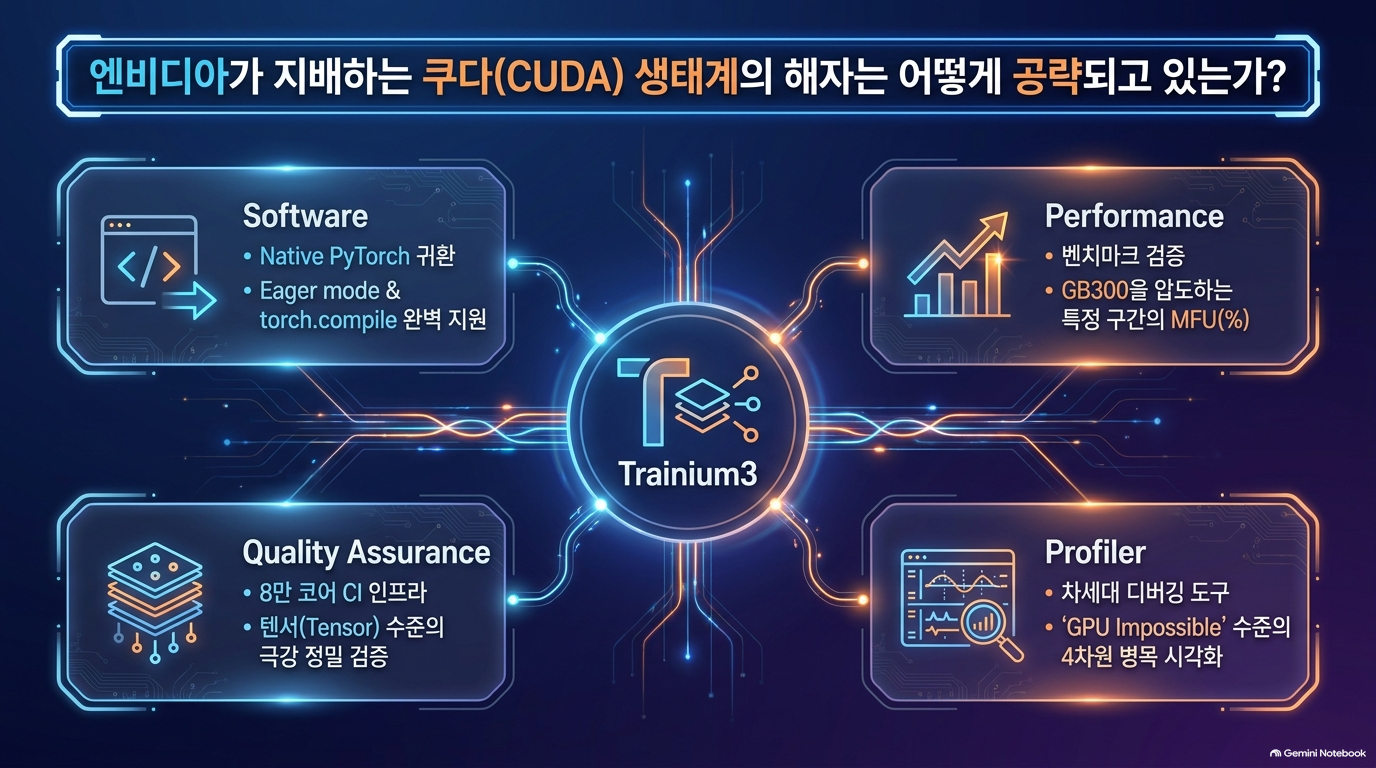
핵심은 “Trainium이 NVIDIA보다 빠르다”가 아니라, “Trainium이 연구자가 사용할 수 있는 학습 플랫폼으로 바뀌고 있다”는 것입니다. 기사에서 평가하는 경쟁력도 칩의 최고 연산성능보다 PyTorch 호환성, 실험 편의성, 수치 신뢰성, 성능 분석 도구에 집중되어 있습니다.
- 저자·발행일: Kimbo Chen·Dylan Patel, 2026년 10월 23일.
- 분석 범위: 열람 가능한 도입부와 기술 본문 8개 섹션. 채용 공고는 제외하고, 프로파일러의 픽셀아트 하위 절은 해당 챕터에 통합했습니다. 말미의 유료 보너스 콘텐츠는 포함하지 않았습니다.
- 근거 구분: 아래 측정값은 SemiAnalysis가 보고한 실험 결과, 개발 계획은 기사에 소개된 AWS 계획입니다. 직접 재현한 벤치마크나 전면적인 독립 검증 결과는 아닙니다.[1]
0. 도입부: 추론용 가속기에서 연구 학습 플랫폼으로
원문의 주장
기사는 Anthropic이 Trainium2·Trainium3를 운영 추론과 강화학습의 rollout에 사용한다고 소개하면서, 추론에서의 활용과 연구 학습에서의 적합성은 별개라고 설명합니다.[1]
둘의 차이는 다음과 같습니다.
| 구분 | 운영 추론 | 연구 학습 |
| 모델 구조 | 상대적으로 변화가 느림 | 실험·절제 연구에 따라 자주 변경 |
| 연산 지원 | 주요 모델의 핵심 연산에 집중 가능 | 다양한 연산과 역전파까지 지원 필요 |
| 최적화 방식 | 사전 컴파일·캐시를 활용하기 쉬움 | 구조 변경 후 실행 준비 시간도 중요 |
| 성공 기준 | 안정적인 서비스 성능 | 실험을 막지 않는 범용성과 반복 속도 |
분석
도입부는 이후 챕터의 평가 기준을 설정합니다. “정해진 모델을 잘 실행한다”는 것과 “새로운 모델 구조를 자유롭게 실험한다”는 것은 다른 역량입니다.
기사의 긍정적 평가는 Trainium이 이 두 번째 영역에 진입하고 있다는 판단입니다. 다만 저자들도 버그를 경험했고, CUDA 생태계의 성숙도에는 아직 미치지 못한다고 명시합니다.[1]
1. Moving Towards a First-Class PyTorch Experience
핵심: 개발자가 하드웨어에 맞추던 방식에서, 하드웨어가 PyTorch에 맞추는 방식으로
원문의 내용
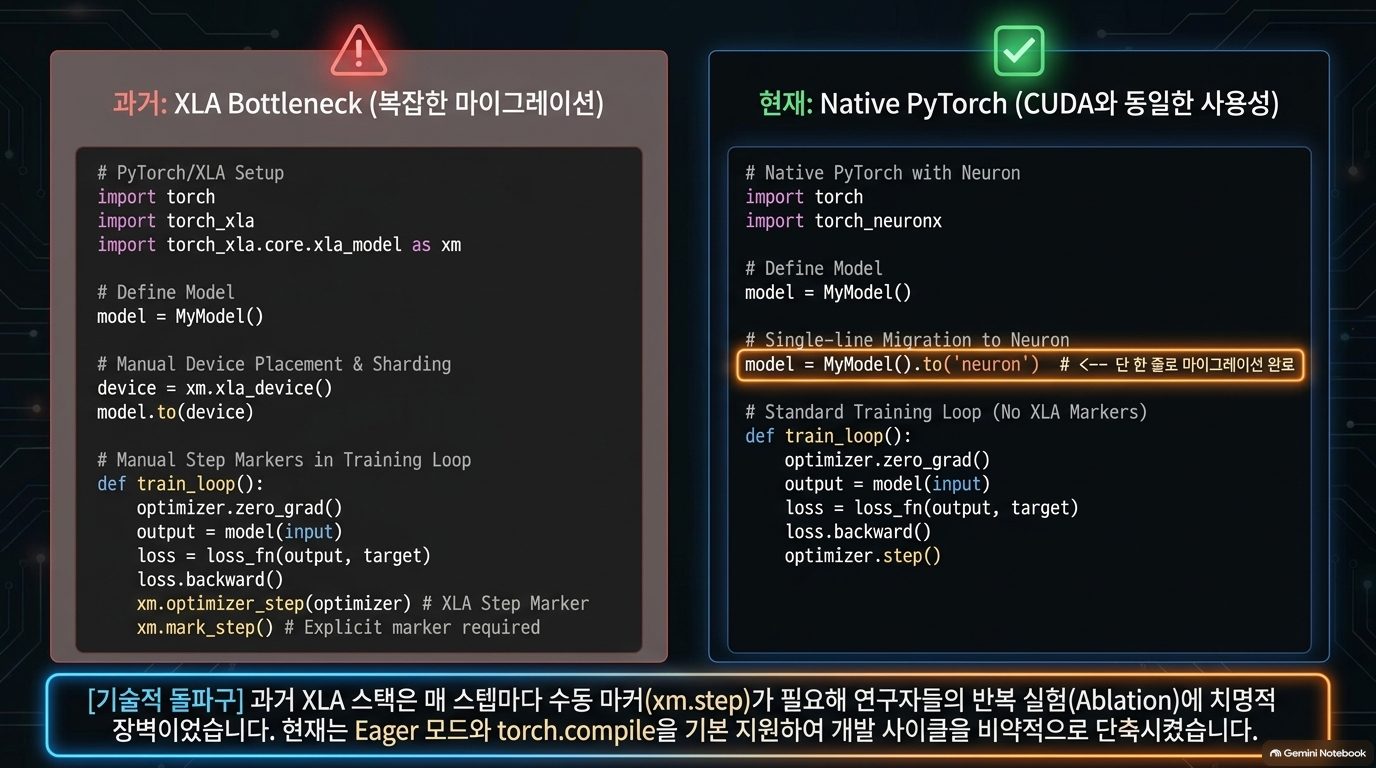
과거 Trainium의 PyTorch/XLA 방식은 지연 실행 기반 그래프 캡처를 사용했고, 학습 루프에 xm.step() 같은 실행 경계 표시를 넣어야 했습니다. 분산 학습에서도 PyTorch의 기본 API 대신 XLA 전용 API에 의존하는 문제가 있었다고 설명합니다.[1]
새로운 TorchNeuron은 다음 방향을 지향합니다.
- 네이티브 PyTorch 방식의 eager 실행.
- torch.compile 활용.
- PyTorch 표준 분산·병렬화 API와의 정합성 확대.
- 개념적으로 .to("cuda")를 .to("neuron")으로 바꾸는 수준의 이식 경험.
- 초기에는 TorchAO MXFP8보다 BF16 학습 경험의 완성도를 우선.[1]
분석
이 변화의 본질은 문법 단순화보다 개발자의 기존 지식과 코드 자산을 보존하는 것입니다.
새 가속기를 도입할 때 연구자가 학습 루프, 분산 처리, 디버깅 방법까지 다시 배워야 한다면, 하드웨어 가격이 낮더라도 전환 비용이 커집니다. TorchNeuron의 전략은 이 비용을 줄이는 데 있습니다.
BF16 우선 전략도 같은 맥락입니다. 가장 공격적인 저정밀 최적화를 먼저 보여주기보다, 더 넓은 연구자가 사용하는 경로를 안정화하겠다는 선택입니다.
해석의 경계
.to("neuron") 변경만으로 모든 CUDA 코드가 동작한다는 보장은 아닙니다. 기사도 이를 고수준·이론적 설명으로 제시하며, torch.cuda.*를 직접 호출하는 코드 등에는 수정이 필요할 수 있다고 인정합니다.[1]
이 챕터의 결론: Trainium의 첫 번째 경쟁 과제는 최고 속도가 아니라 PyTorch 개발 방식과의 거리 축소입니다.
2. Trainium Torch Ecosystem
핵심: 개별 연산 지원보다 기존 라이브러리 생태계에 들어가는 것이 중요하다
원문의 내용
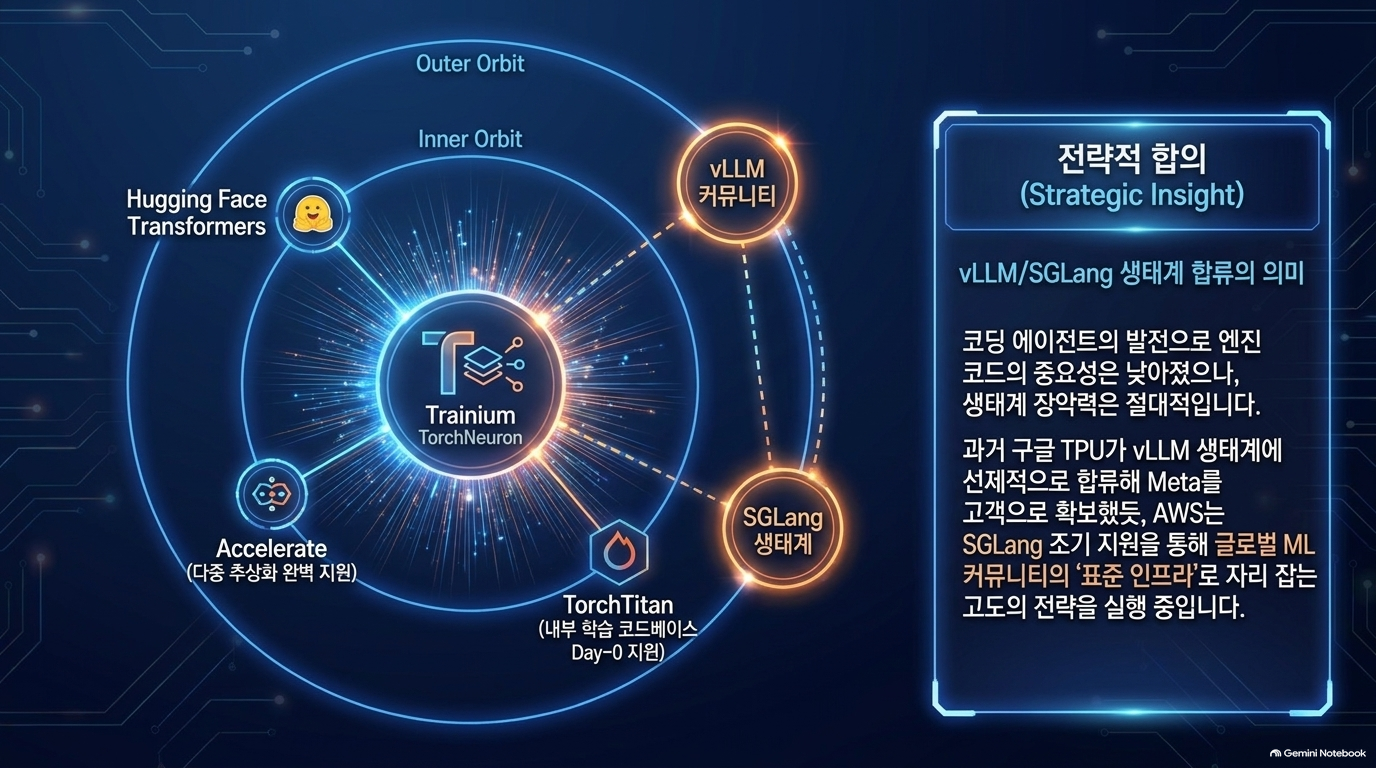
기사는 PyTorch의 가치를 프레임워크 자체와 주변 라이브러리의 결합으로 봅니다. Hugging Face Transformers, PEFT, diffusers, TRL, Accelerate, TorchTitan 등을 언급하며, Trainium의 라이브러리 지원 확대를 긍정적으로 평가합니다.[1]
추론에서는 vLLM·SGLang 커뮤니티에 대한 하드웨어 제공과 초기 접근 지원을 강조합니다. 저자들은 에이전트 코딩으로 엔진 구현이 쉬워지더라도, 신규 모델을 빠르게 수용하고 사용자의 신뢰를 얻는 생태계의 도달 범위는 별개의 자산이라고 봅니다.[1]
분석
1장이 프레임워크 수준의 호환성이라면, 이 장은 실제 연구·서비스 도구 수준의 호환성입니다.
두 가지는 구분해야 합니다.
- PyTorch 연산이 실행되는 것.
- 자신이 쓰는 학습·미세조정·분산 실행 도구가 함께 작동하는 것.
실무에서 전환 여부를 결정하는 것은 후자인 경우가 많습니다. 특정 연산을 실행할 수 있어도, 상위 라이브러리의 장치 처리나 분산 실행 경로에서 막히면 전체 작업을 수행할 수 없기 때문입니다.
해석의 경계
라이브러리 지원이 모든 모델·버전·기능 조합의 완전한 호환성을 뜻하지는 않습니다. 또한 기사에서 소개한 TPU의 신규 모델 지원 사례는 생태계 전략을 설명하기 위한 비교 사례이지, Trainium의 동일한 지원 수준을 입증하는 결과는 아닙니다.[1]
이 챕터의 결론: Trainium의 확산은 독자 도구를 얼마나 많이 만드는가보다 개발자가 이미 사용하는 도구에 얼마나 자연스럽게 연결되는가에 달려 있습니다.
3. TorchTitan Experience
핵심: 실제 모델 학습은 가능했지만, 컴파일 대기 시간이 연구 생산성의 병목이다
원문의 실험
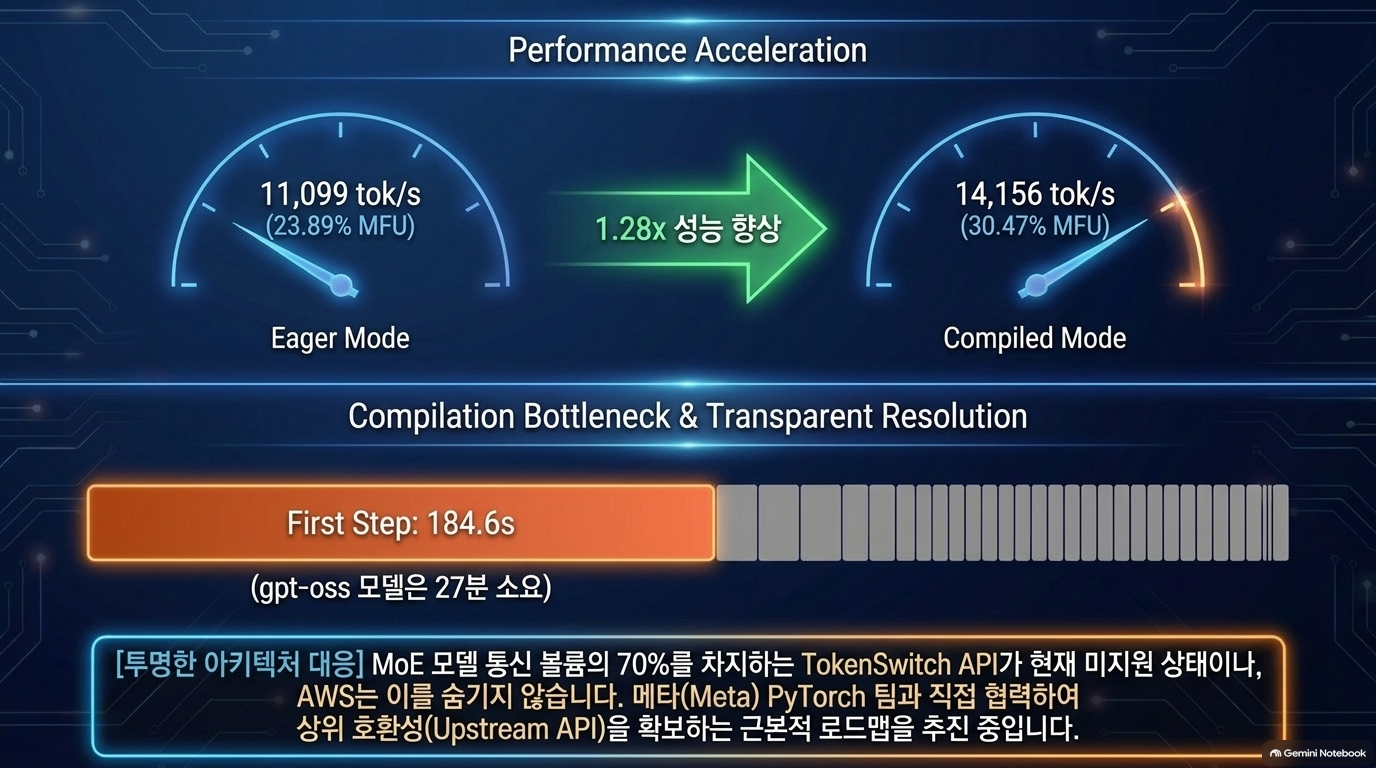
SemiAnalysis는 Qwen3-32B를 Trainium2 칩 16개, LNC=2 논리 코어 총 64개에서 학습했고, 물리 칩 64개인 Trainium3 UltraServer에서도 실행을 시도했다고 설명합니다. 아래 공개 처리량은 Trainium2 측정값입니다.[1]
| 측정 항목 | Eager 모드 | Compiled 모드 |
| 평균 학습 처리량 | 11,099 tokens/s | 14,156 tokens/s |
| MFU | 23.89% | 30.47% |
| 첫 스텝 소요 시간 | 184.6초 | 255.7초 |
Compiled 모드 처리량은 eager 대비 약 1.28배, MFU는 6.58%p 높습니다. 저자들은 모델링 코드의 구조를 일부 변경해도 실행이 잘 이루어졌다고 보고합니다.[1]
별도로 gpt-oss 20B 학습 레시피도 테스트했습니다. GraphTrainer와 SimpleFSDP 구성, attention·MoE용 NKI 커널을 활용하는 레시피는 실행되었으나, 컴파일에는 27분 17초가 소요되었습니다.[1]
분석 ①: 지속 처리량과 실험 시작 비용은 다른 지표다
이 장의 가장 중요한 발견은 학습 처리량 자체보다 첫 실행까지의 대기 시간입니다.
장시간 실행하는 학습에서는 초기 컴파일 비용을 분산할 수 있습니다. 반면 짧은 실험을 반복하거나 모델 구조를 자주 바꾸는 연구에서는 초기 비용이 반복적으로 발생할 수 있습니다.
따라서 이 결과는 다음 두 가지를 동시에 보여줍니다.
- 확인된 장점: 비교적 복잡한 학습 코드와 모델 변경이 실행되는 수준에 도달했다.
- 남은 제약: 연구자가 빠르게 실험을 반복하기에는 실행 준비 시간이 부담스럽다.
분석 ②: MoE의 표준 API 통합은 아직 진행 중이다
기사에 따르면 MoE 통신에 PyTorch의 TokenSwitch 대신 커스텀 NeuronEPTokenDispatcher를 사용하고 있습니다. AWS가 PyTorch 측과 TokenSwitch 지원을 협력하겠다는 계획도 소개됩니다.[1]
이는 기능이 작동하는 상태와 업스트림 표준 API로 통합된 상태가 다르다는 사례입니다.
향후 계획의 해석
AWS는 사전 컴파일된 NKI 커널과 새 컴파일 백엔드로 첫 스텝까지의 시간을 최대 두 자릿수 차수, 즉 최대 약 100배 줄이는 목표를 제시합니다. 이는 기사 시점의 달성 결과가 아닙니다.[1]
이 챕터의 결론: 연구용 Trainium의 실질적 개선 과제는 학습 중 속도뿐 아니라 실험을 시작하는 속도입니다.
4. Training MatMul Performance
핵심: 다양한 행렬 형태에서의 활용률이 좋아졌지만, GPU 대비 절대 속도 우위로 읽으면 안 된다
원문의 실험
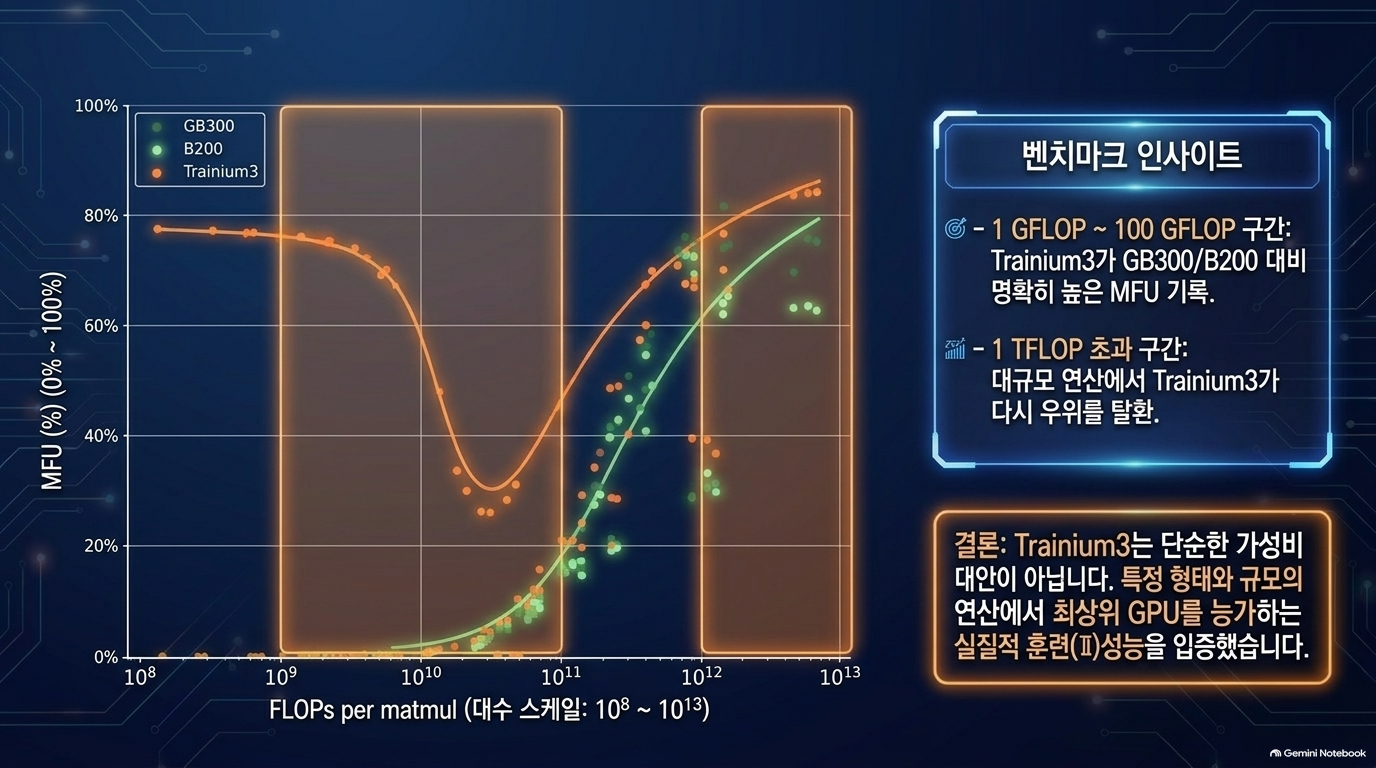
저자들은 Trainium3의 단일 논리 코어, LNC=2 구성에서 nn.functional.linear를 벤치마크하고 GB300·B200과 비교했습니다.
주요 공개 가중치 모델의 projection 연산 형태를 대상으로 하며, M 차원은 1·128·2048로 설정했습니다.[1]
그래프의 지표는 다음과 같습니다.
- 가로축: 행렬곱 1회당 연산량, FLOPs per matmul.
- 세로축: MFU, %.
- 비교 대상: GB300, B200, Trainium3.[1]
본문은 대략 1 GFLOP 수준부터 Trainium3의 MFU가 상대적으로 높게 나타나며, 일부 더 큰 구간에서는 GPU가 앞서고, 1 TFLOP 이후에는 Trainium3가 다시 우세한 양상을 설명합니다.[1]
분석
이 벤치마크의 목적은 특정 대형 행렬 하나의 최고 기록이 아니라 모델 구조를 변경해도 다양한 행렬 형태에서 성능이 크게 무너지지 않는지 확인하는 것입니다.
연구 과정에서는 차원과 배치 크기가 바뀌므로, 좁은 최적 조건에서만 빠른 가속기는 활용에 제약이 있습니다. 그런 점에서 넓은 형태 범위의 측정은 연구 적합성과 연결됩니다.
가장 중요한 주의점
MFU가 높다는 것은 절대 처리량이 높다는 뜻이 아닙니다.
MFU는 각 장치의 이론적 연산성능 대비 활용률이므로, 장치 간 최고 성능과 비교 단위가 다르면 높은 MFU가 더 짧은 실행 시간으로 곧바로 이어지지 않습니다.
따라서 이 그래프만으로 다음을 주장할 수 없습니다.
- Trainium3 칩이 GB300보다 항상 빠르다.
- 전체 모델 학습 시간이 더 짧다.
- 동일 예산이나 동일 전력에서 더 경제적이다.
이 챕터의 결론: 이 결과는 행렬 형태별 하드웨어 활용 효율의 근거이지, 전체 학습 성능·비용의 최종 순위표가 아닙니다.
5. FlexAttention API
핵심: 새로운 attention 구조를 실험할 수 있는지가 범용성의 시험대다
원문의 실험
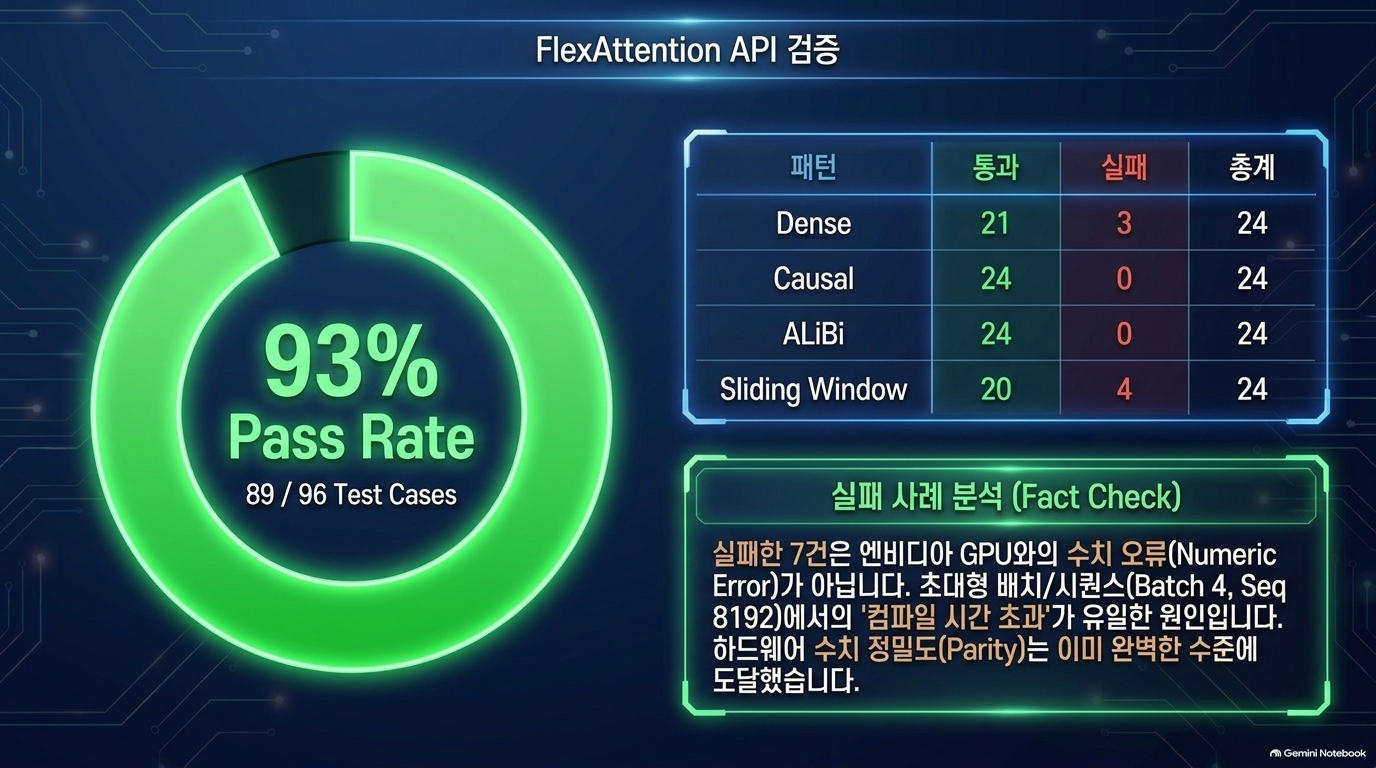
FlexAttention은 PyTorch에서 attention 변형을 표현하면서 역전파 생성과 성능 최적화를 지원하는 고수준 API입니다. 저자들은 attention-gym 벤치마크를 Trainium3에서 실행했습니다.[1]
| 시험 구성 | 값 |
| Batch size | 1, 4 |
| QKV sequence length | 512, 2048, 8192 |
| Attention heads, Q/KV | 8/8, 8/2 |
| Head dimension | 64, 128 |
| Attention mask | Dense, causal, ALiBi, sliding window |
총 96개 중 89개가 통과, 약 93%의 통과율을 기록했습니다. 실패한 7개는 모두 batch size 4·sequence length 8192 조건에서 발생했으며, 기사에 따르면 수치 오류가 아니라 컴파일 시간 예산 초과 때문입니다.[1]
저자들은 벤치마크에 없는 자체 attention 변형도 구현했고, NVIDIA GPU 결과와 수치가 일치했다고 보고합니다.[1]
분석
4장이 기본 연산 효율을 확인했다면, 이 장은 연구자가 연산의 의미와 구조를 바꿀 수 있는가를 확인합니다.
정형화된 모델을 실행하는 것보다, attention 규칙을 바꾸고 역전파까지 정상 처리하는 것이 연구 플랫폼으로서 더 강한 증거입니다.
다만 결과는 두 축으로 나눠 읽어야 합니다.
- 수치 정확성: 통과 사례와 자체 변형에서 긍정적인 결과.
- 실행 가능성: 큰 입력 조건에서는 시간 제한 때문에 완료하지 못한 사례 존재.
해석의 경계
“수치 오류가 아니었다”는 것은 의미가 있지만, 미완료 7개가 검증을 통과했다는 뜻은 아닙니다. 또한 이 시험의 약 93%를 PyTorch 전체 연산 호환율로 확대할 수도 없습니다.
이 챕터의 결론: attention 연구의 유연성은 확인되었으나, 큰 입력 조건의 컴파일 확장성은 미완성입니다.
6. Automated Quality Assurance
핵심: 연산 지원률이 높아도 모델 전체의 실행 성공률은 낮을 수 있다
원문의 내용
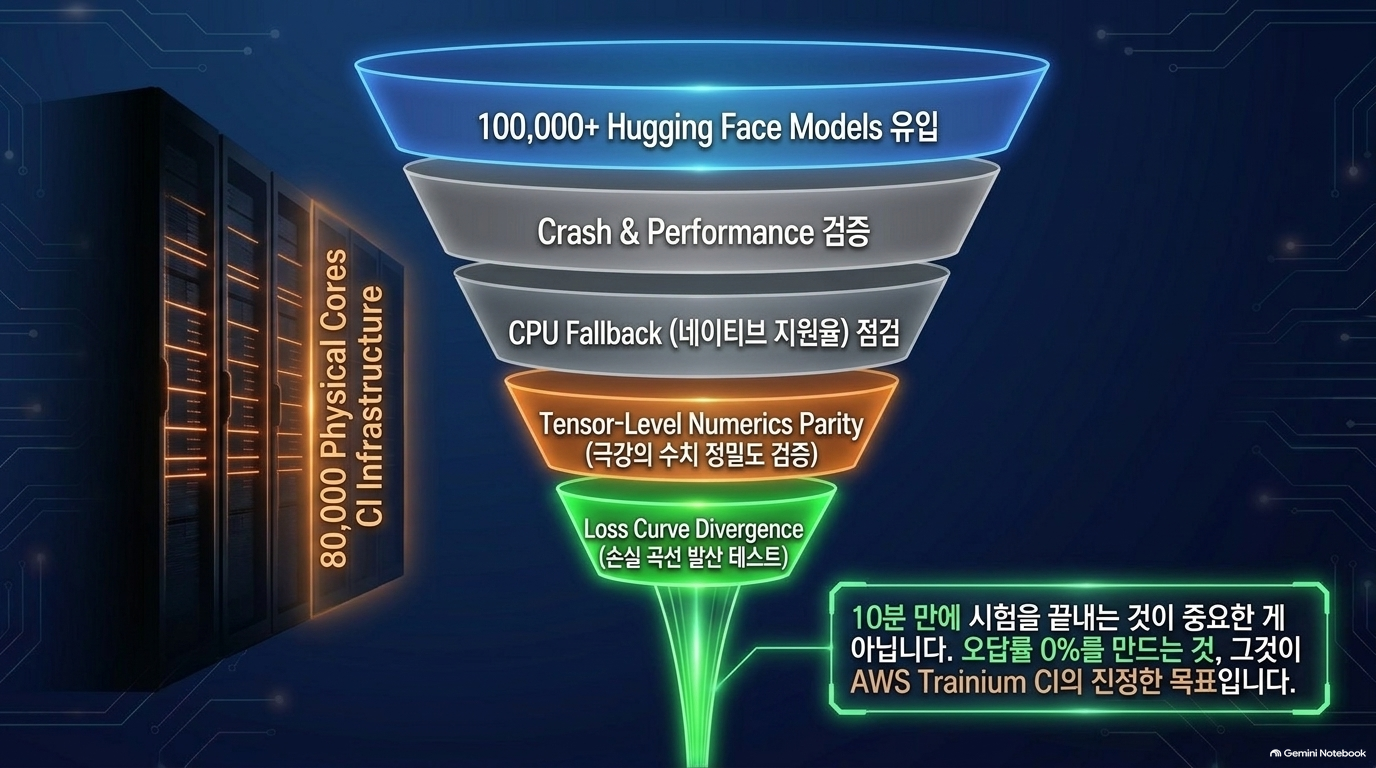
AWS는 다양한 정규화·MLP·MoE·attention 구조를 포함하는 Hugging Face 모델 10만 개 이상을 대상으로 품질 검증 체계를 구성했다고 설명합니다.
기사에서 소개하는 검증 항목은 다음과 같습니다.
- 실행 실패 여부와 성능.
- CPU fallback이 발생하는 연산.
- 그래프 분할 지점.
- CPU·NVIDIA 기준과의 수치 비교.
- 텐서 수준의 일치와 손실 곡선의 발산 여부.[1]
원문 도표에 제시된 주요 수치는 아래와 같습니다.
| 구분 | Eager % | Mean OpCov % | Compile % |
| Text generation | 87.6 | 98.3 | 80.9 |
| Image classification | 48.4 | 98.6 | 41.9 |
| 전체 Total | 78.7 | 98.1 | 69.6 |
| 클래스 동일 가중 Total | 71.1 | — | 58.5 |
표의 전체 규모는 841개 클래스·104,909개 모델입니다. 도입부에서는 자동 품질관리에 최대 80,000개 물리 코어를 배정한다고 소개하지만, 그 숫자만으로 가속기 구성이나 테스트 실행 빈도까지 알 수는 없습니다.[1]
분석 ①: 개별 연산과 전체 모델은 다른 검증 단위다
표에서 가장 주목할 부분은 98.1%의 Mean OpCov와 69.6%의 Compile 값 사이의 차이입니다.
연산 대부분을 지원하더라도, 특정 미지원 연산이나 조합 문제가 전체 모델 실행을 막을 수 있습니다. 따라서 연산 지원 범위가 넓다는 사실만으로 “모델이 거의 모두 작동한다”고 판단하면 안 됩니다.
특히 image classification은 Mean OpCov가 98.6%이지만 Compile 값은 41.9%입니다. 이 차이는 호환성 평가에서 구성요소 수준 지표와 종단 간 지표를 함께 봐야 하는 이유를 보여줍니다.[1]
분석 ②: 평균에는 모델 분포가 반영된다
일반 Total보다 클래스 동일 가중 값이 낮다는 점도 중요합니다. 표본이 많은 분야의 결과만 보면, 상대적으로 지원이 부족한 다른 분야가 가려질 수 있습니다.
다만 원문 표만으로는 각 열의 정확한 통과 판정 기준과 집계 산식을 완전히 재구성하기 어렵습니다. 따라서 해당 비율을 모든 모델에 대한 보편적 성공 확률로 사용해서는 안 됩니다.
조직 운영 측면
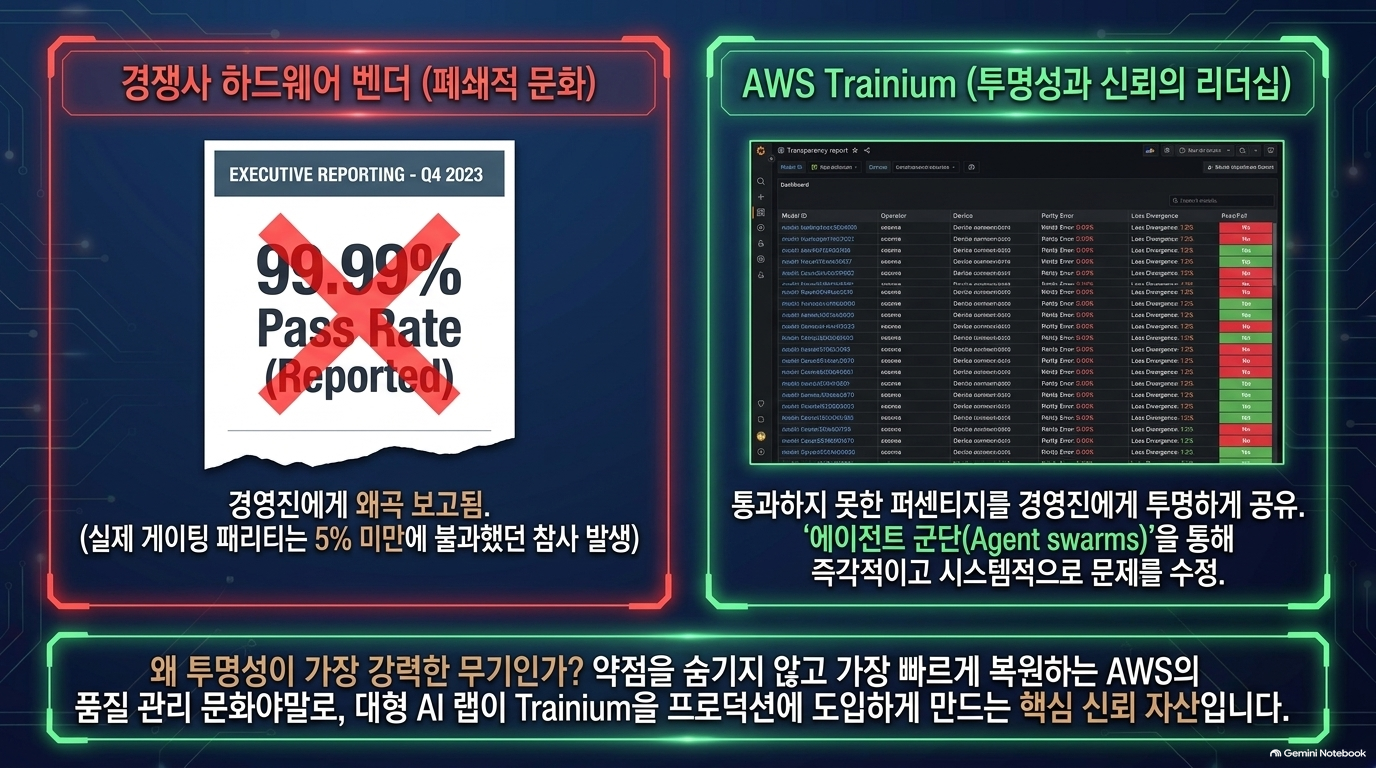
저자들은 다른 업체의 품질 지표가 경영진에게 전달되는 과정에서 과장되었던 경험과 대비하여, AWS가 실패와 격차를 드러내는 점을 긍정적으로 평가합니다. 이 비교는 저자들의 경험담이지, 업체별 품질관리 체계를 동일 조건으로 감사한 결과는 아닙니다.[1]
이 챕터의 결론: QA 투자의 가치는 높은 수치 하나보다 실패를 탐지하고, 수치 오류와 성능 퇴행을 지속적으로 드러내는 체계에 있습니다.
7. Neuron Explorer — Better than Nvidia and AMD Profilers
핵심: 하드웨어 내부의 실행·대기·의존성을 이해하기 쉽게 보여준다
원문의 내용
저자들은 Neuron Explorer의 초기 설정은 혼란스럽지만, 설정 후 성능 분석 경험은 매우 우수하다고 평가합니다.
주요 기능은 다음과 같습니다.
| 기능 | 분석에 주는 정보 |
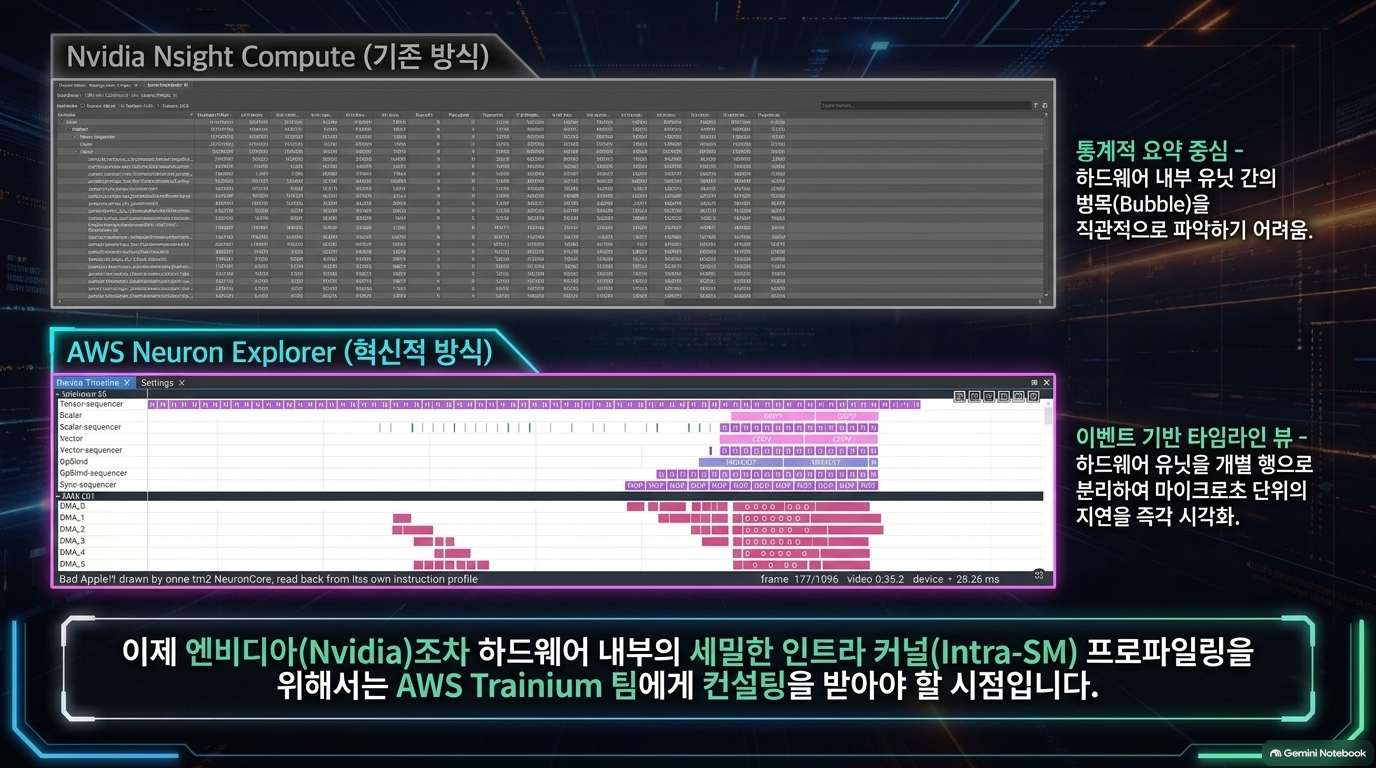
| 하드웨어 유닛별 타임라인 | 어떤 장치가 실행·유휴 상태인지 |
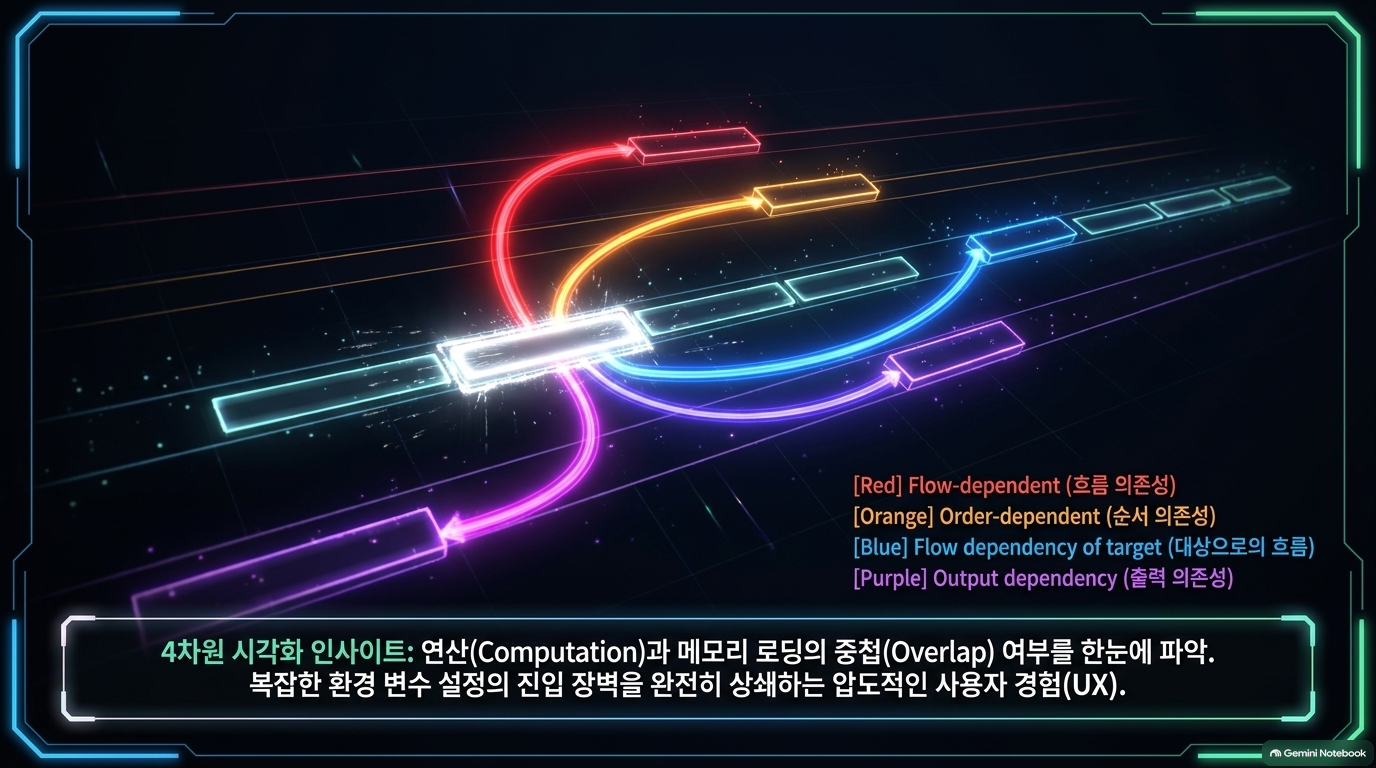
| 연산 간 의존성 표시 | 무엇을 기다리는지, 무엇이 후속 실행을 막는지 |
| 소스 코드 매핑 | 병목이 코드의 어느 부분에 대응하는지 |
| 메모리 뱅크 활용 시각화 | 메모리 사용 양상 |
| 마이크로초 수준 처리량 표시 | 짧은 시간 구간의 데이터 이동 변화 |
특히 연산과 메모리 로딩이 충분히 겹치는지, 의존성 때문에 대기가 발생하는지를 시각적으로 파악하기 쉽다고 설명합니다.[1]
분석
이 장이 강조하는 것은 단순한 측정 정밀도가 아니라 병목의 원인을 해석하는 비용 감소입니다.
총 실행 시간이 길다는 사실만 아는 것과, 특정 데이터 이동 때문에 연산 장치가 기다린다는 사실을 아는 것은 다릅니다. 후자는 커널 수정과 스케줄 조정의 방향을 직접 제시합니다.
픽셀아트 데모의 의미
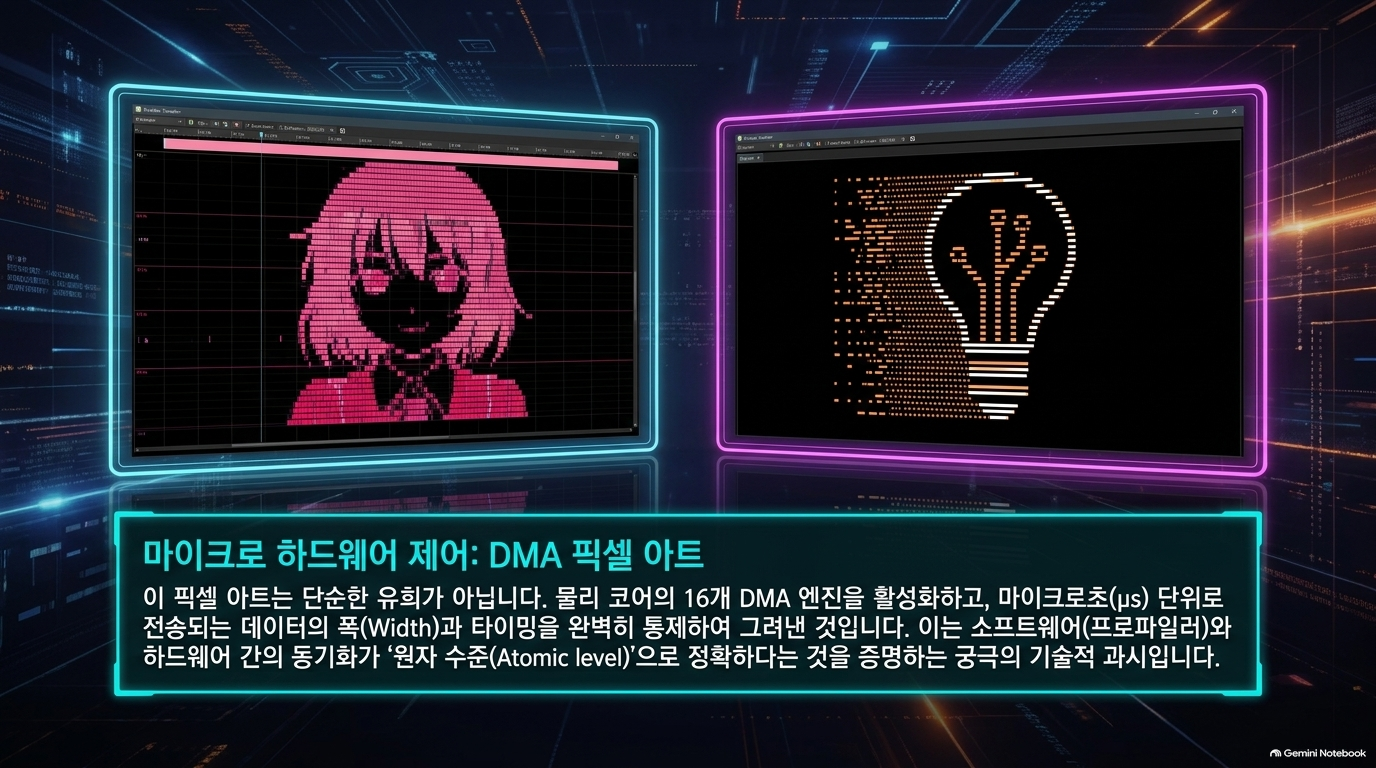
저자들은 물리 코어당 16개 DMA 엔진의 활성 구간과 전송량을 조절하여 실제 하드웨어 실행 트레이스에 그림을 표현했습니다.[1]
이 데모는 다음을 보여줍니다.
- 엔진별 활동이 세밀하게 관측된다.
- 시간축상의 실행 패턴을 구별할 수 있다.
그러나 픽셀아트가 그려진다는 사실 자체가 실제 모델의 성능 개선량을 입증하지는 않습니다. 관측 능력을 보여주는 시연입니다.
“GPU Impossible”의 해석
기사 자체도 NVIDIA의 In-Kernel Event Tracing API와 이를 활용하는 QuACK 프로파일러를 소개합니다. 따라서 제목의 표현을 “GPU에서는 유사한 관측이 기술적으로 불가능하다”로 읽는 것은 과도합니다.[1]
더 정확한 차이는 다음과 같습니다.
Trainium은 하드웨어와 공동 설계한 세밀한 타임라인 분석을 공식 도구에서 통합 제공하며, 저자들은 그 사용 경험을 높게 평가한다.
또한 Nsight Compute의 집계 지표 중심 분석과 이벤트 타임라인은 관측 방식이 다르므로, 사용 경험 평가를 모든 프로파일링 기능의 절대 우위로 일반화할 수 없습니다.
이 챕터의 결론: Neuron Explorer의 강점은 세밀한 관측과 통합된 진단 경험이며, GPU 분석 도구의 모든 기능을 대체한다는 증거는 아닙니다.
8. 종합 판단: 무엇이 입증되었고, 무엇이 남았는가
앞선 논점을 반복하지 않고, 기사의 결론을 증거 수준으로 정리하면 다음과 같습니다.
| 판단 대상 | 기사에서 확보한 근거 | 남은 확인 사항 |
| 실제 학습 실행 | Qwen3-32B·gpt-oss 20B 실행 경험 | 장기 학습의 수렴·안정성 |
| 연구 코드 변경 수용 | 모델 변경·attention 변형 실행 | 더 넓은 구조·커스텀 연산의 지원 |
| 기본 연산 효율 | 행렬 형태별 MFU 측정 | 동일 조건의 절대 속도·전력·비용 |
| 생태계 호환성 | 주요 라이브러리 지원 사례 | 모델·버전·분산 구성별 지원 범위 |
| 품질관리 | 대규모 QA와 실패 현황 공개 | 지표 정의·반복 실행·장기 추세 |
| 최적화 편의성 | 프로파일러 사용 경험과 시연 | 실제 최적화 시간·성능 개선량 |
| 컴파일 개선 | AWS의 개선 목표 | 출시 버전에서의 실측 결과 |
최종 해석
이 기사는 “NVIDIA 학습 지배력이 이미 무너졌다”는 증거가 아니라, “Trainium의 경쟁력이 하드웨어 사양에서 연구용 소프트웨어 경험으로 확장되고 있다”는 현장 평가로 읽는 것이 적절합니다.
제목의 강도에 비해 실제 본문의 판단은 더 조건부입니다. 실행 경험과 도구는 유망하지만, 컴파일 지연·분야별 호환성 편차·CUDA 대비 생태계 성숙도 차이가 남아 있습니다. 또한 이 기사에는 NVIDIA 대비 동일 모델·동일 목표 품질 기준의 전체 학습 시간과 총비용을 확정할 만한 비교가 제시되어 있지 않습니다.[1]
따라서 핵심 질문은 “Trainium이 더 빠른가?”보다 “내 연구 코드를 옮겼을 때, 정확성을 유지하면서 실험을 더 적은 마찰로 반복할 수 있는가?”입니다.
출처
[1] https://newsletter.semianalysis.com/p/amazons-trainium-takes-a-strike-at — Amazon’s Trainium Takes a Strike at the Training King, SemiAnalysis.
'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - Semianalysis, Huawei–DeepSeek 공생관계 (0) | 2026.10.25 |
|---|---|
| AI 반도체 - OCP 2026: AI 클러스터 공동 설계(Co-Designing) (0) | 2026.10.25 |
| AI 반도체 - CPO - 고속 광통신에 대한 종합적인 개요 (0) | 2026.10.24 |
| AI 반도체 - Semianalysis, ASML 하이브리드 본딩 전략 (0) | 2026.10.19 |
| AI 반도체 - TrendForce, AI 수요와 반도체 공급망 변화 (0) | 2026.10.13 |