https://open.substack.com/pub/semianalysis/p/anthropic-subscriptions-offer-5x
2026.10.6
[Anthropic Subscriptions Offer 5x+ More Value Than OpenAI]
제공된 문서는 주요 인공지능 연구소들의 구독 플래그십 모델 경제성 및 이용 한도를 심층 분석한 리포트입니다. 핵심 내용은 API 환산 가치 지표를 활용해 앤트로픽과 오픈AI 같은 기업들의 구독 상품이 실제 사용자에게 제공하는 경제적 효용을 계량적으로 측정하는 데 있습니다. 특히 이 문서는 토큰 사용량과 크레딧 소모율을 실험적으로 추적하는 방법론을 상세히 설명하며, 오픈AI의 최근 대규모 구독 가격 인상 및 한도 축소 정책이 사용자 가치에 미친 영향을 앤트로픽과 비교하여 검증합니다. 궁극적으로 이 분석의 목적은 AI 랩들의 실제 재무 구조와 구독 상품의 수익성을 이해하기 위해, 소비자가 지불하는 비용 대비 얻을 수 있는 진짜 가치를 투명하게 평가하는 기준을 제시하는 것입니다.
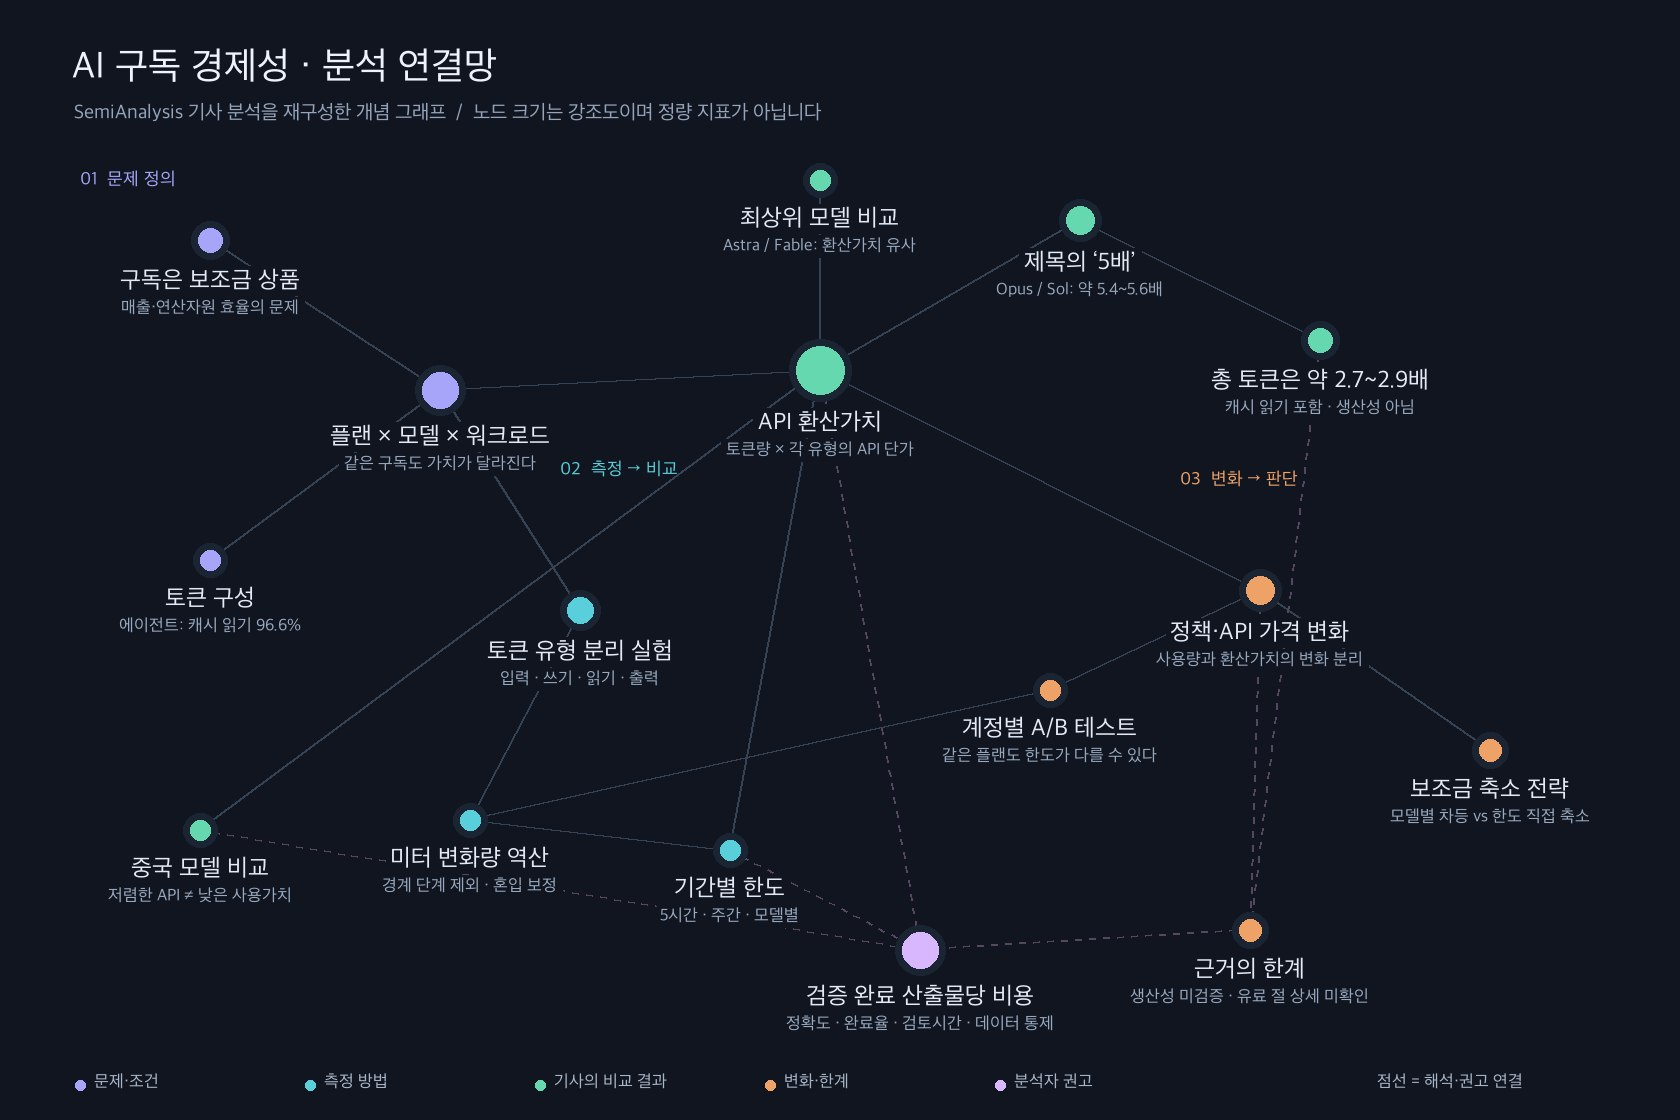
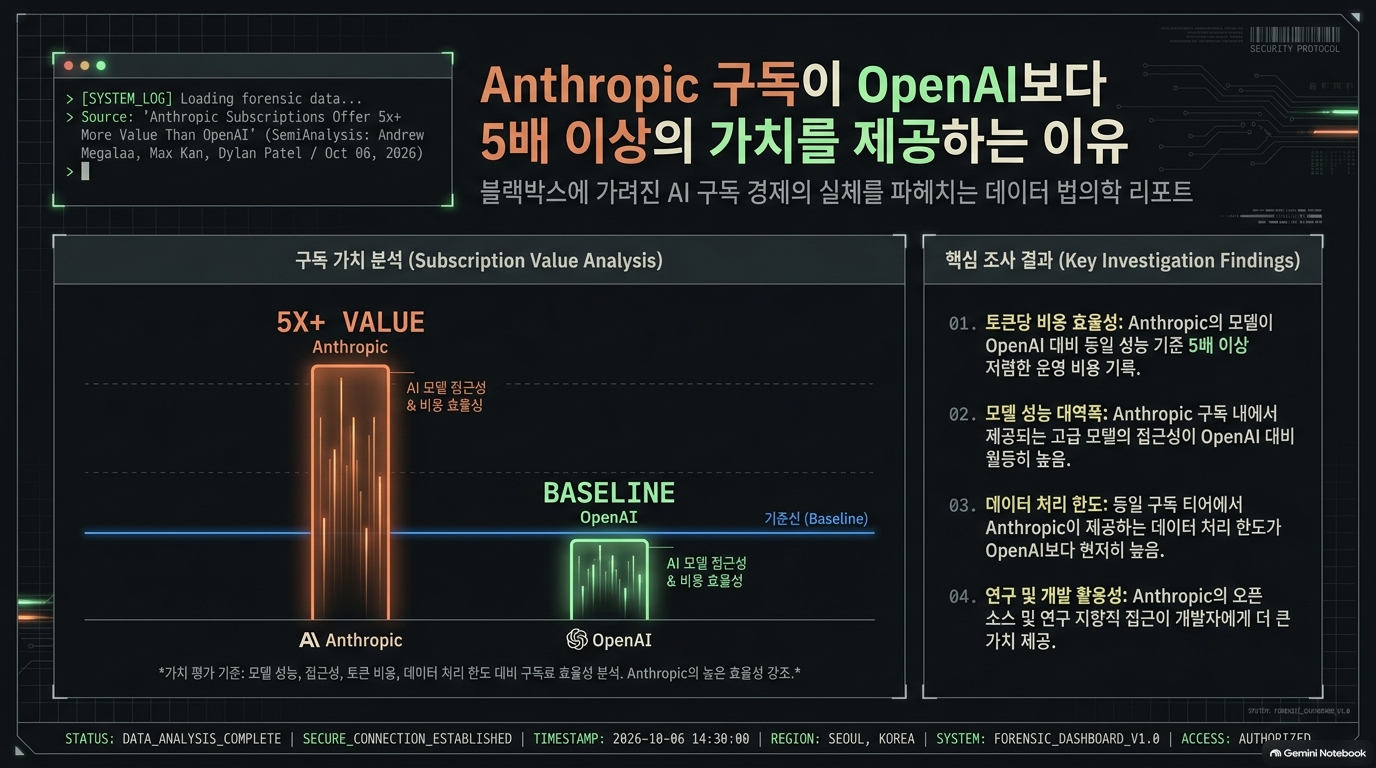
이 글의 핵심은 “Claude가 ChatGPT보다 일을 5배 잘한다”가 아니라, “특정 에이전트 워크로드에서 같은 구독료로 사용할 수 있는 토큰을 각 모델의 API 가격으로 환산하면 Anthropic이 약 5배 이상의 가치를 제공한다”는 것입니다.[1]
실제로 원문 도표의 Opus 5.5와 GPT-6.1 Sol 비교를 계산하면 다음과 같습니다.
- API 가격 환산가치: Anthropic이 약 5.4~5.6배
- 총 토큰 제공량: Anthropic이 약 2.7~2.9배
- 작업 정확도·완료율·생산성: 이 글에서 비교 검증하지 않음
따라서 가격 환산가치, 토큰량, 실제 업무성과를 구분하는 것이 이 글을 읽는 핵심입니다.
분석 범위: 공개된 본문과 핵심 도표를 확인했습니다. 마지막 「Third party plans are worse than first party」 절은 도입 문장 이후 유료 구독 경계가 있어 상세 분석이 불가능합니다. 아래 수치와 정책 변경은 기사의 측정·서술 시점 기준이며, 공급자의 현재 정책을 별도로 검증한 결과는 아닙니다. 모델명은 원문 표기를 그대로 사용했습니다.
1. 도입부 — 구독 요금은 사용자 가격표이면서 AI 기업의 수익성 변수다
핵심 주장
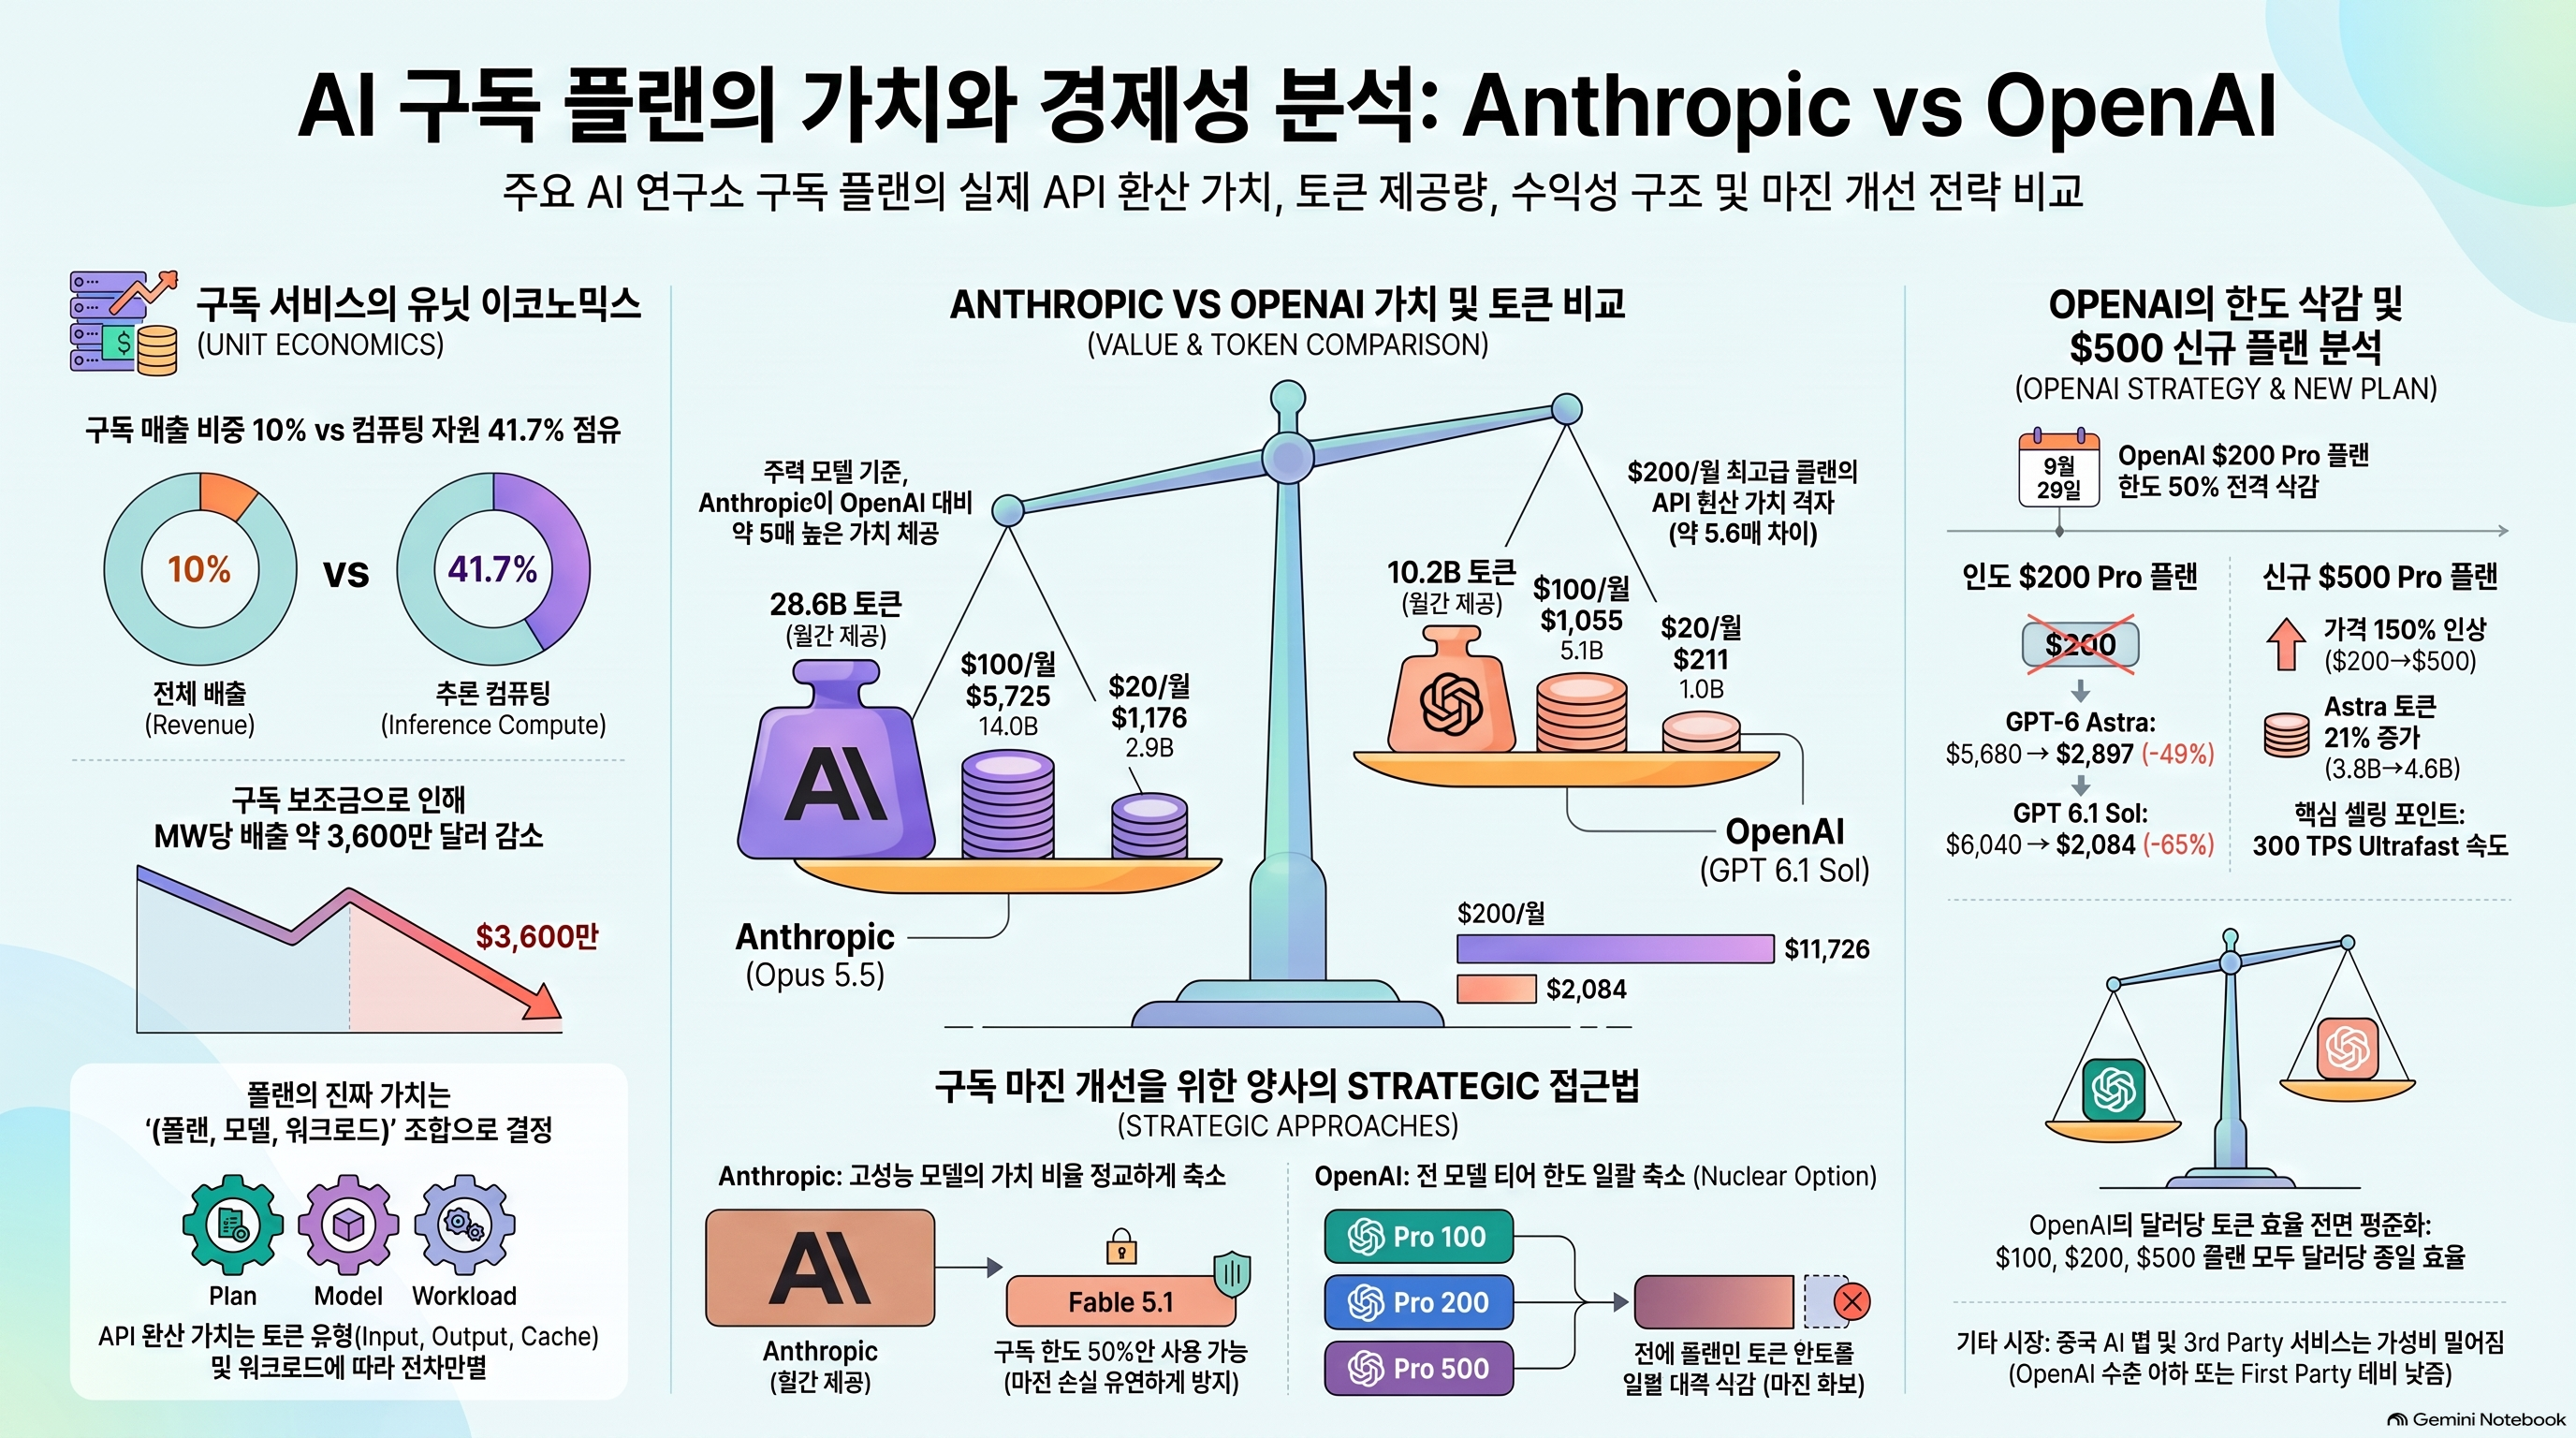
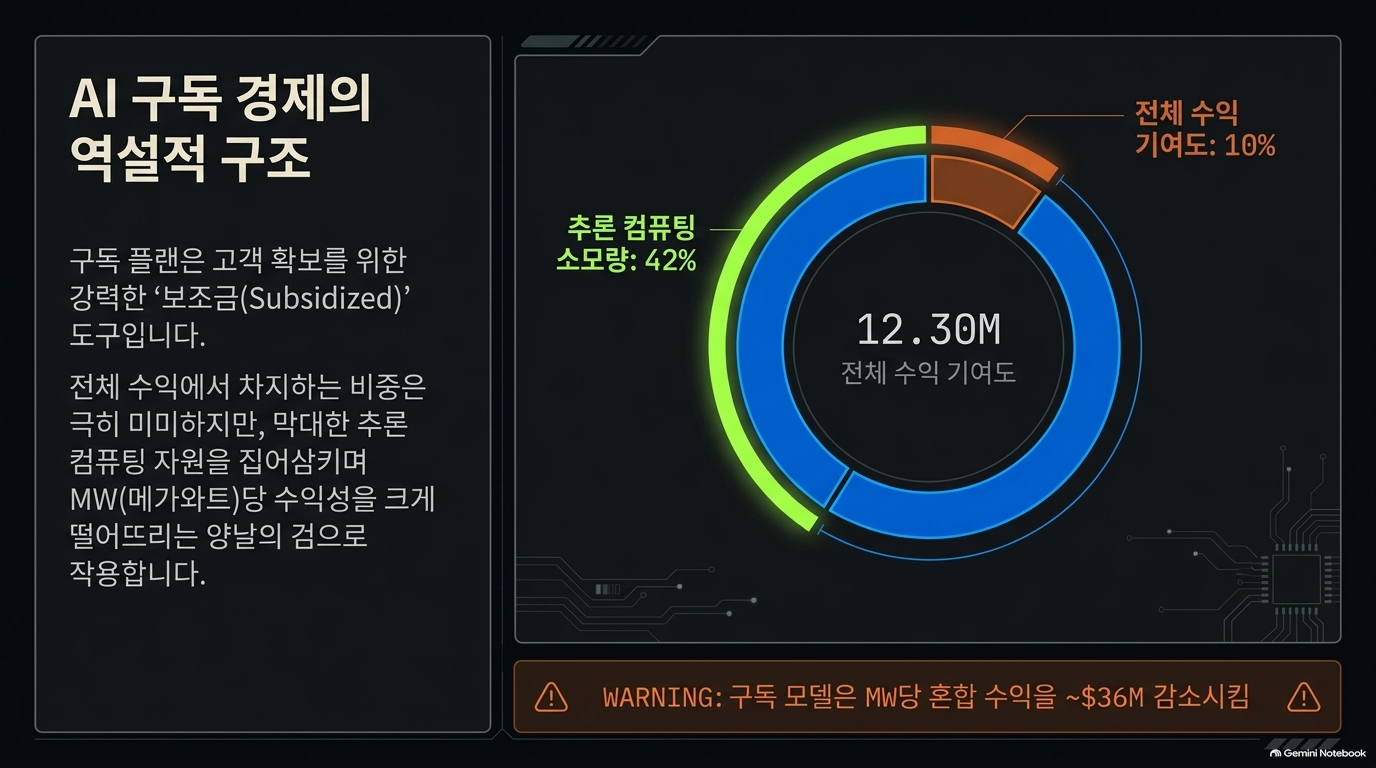
저자들은 AI 구독 서비스를 고객 확보와 마케팅을 위한 보조금 성격의 상품으로 해석합니다. 구독 매출 비중이 작더라도 추론 연산을 많이 소비하기 때문에 기업의 수익성과 연산자원당 매출에 큰 영향을 준다는 논리입니다.[1]
원문 도표에 제시된 Anthropic의 개략 추정치는 다음과 같습니다.[1]
| 구분 | 추론 연산 비중 | 매출 비중 | MW당 매출 | 매출총이익률 |
| 구독 | 41.7% | 10.0% | 1,600만 달러 | 50.0% |
| API | 58.3% | 90.0% | 1억 290만 달러 | 92.2% |
| 혼합 | — | 100% | 6,670만 달러 | 88.0% |
주의: 도표 자체가 모든 숫자를 rough estimates로 표시합니다. 이는 Anthropic의 공시된 사업부 실적이 아니라 SemiAnalysis의 모델 추정입니다.[1]
분석
이 장은 구독 경제성의 양면성을 설명합니다.
- 사용자 관점: API 종량제보다 많은 사용량을 저렴하게 확보할 수 있다.
- 사업자 관점: 같은 연산자원을 API 고객에게 판매하는 것보다 매출 효율이 낮을 수 있다.
도표상 API의 MW당 매출과 혼합 매출의 차이는 3,620만 달러입니다. 다만 이를 곧바로 ‘구독으로 발생한 손실’로 해석하면 안 됩니다. 구독 고객의 전환, 유지, 제품 확산 효과와 연산자원의 대체 판매 가능성은 별도로 평가해야 합니다.
한계와 시사점
[확인 필요] 고객별 사용량 분포와 원가 배분이 공개되어 있지 않아 위 수치를 독립적으로 재현하기는 어렵습니다.
실무 시사점: 구독 한도 축소는 단순한 제품 정책이 아니라, 연산자원 배분과 수익성 개선의 수단으로 읽을 필요가 있습니다.
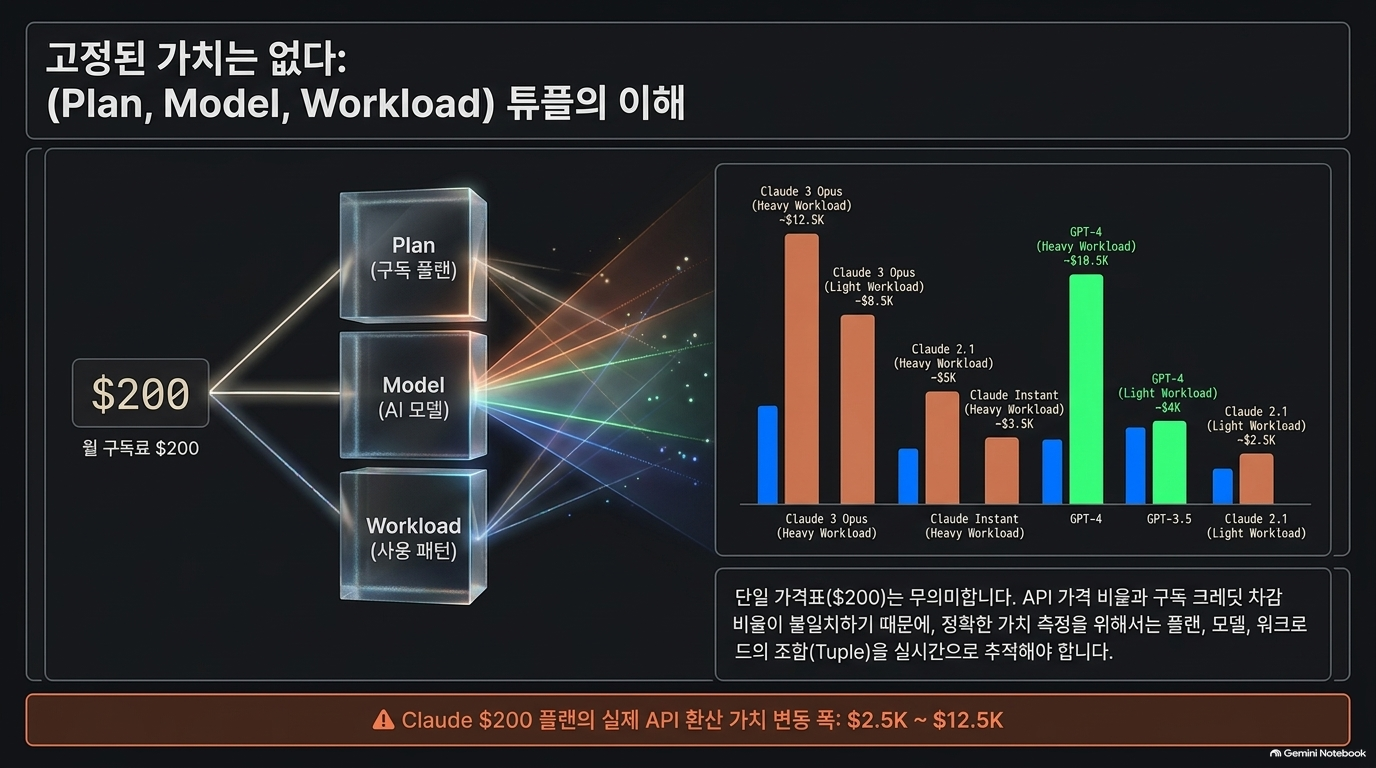
2. 도입부의 두 번째 논점 — 구독 가치는 ‘플랜 × 모델 × 워크로드’로 결정된다
핵심 주장
같은 월 구독료라도 모델과 토큰 구성에 따라 API 환산가치가 달라집니다. 구독 내부의 토큰별 차감 비율이 API 가격 비율과 일치하지 않기 때문입니다.[1]
원문은 월 200달러 Claude Max 20x의 가치를 다음처럼 제시합니다.[1]
| 모델 | 에이전트 사용의 API 환산가치 | 채팅 사용의 API 환산가치 |
| Sonnet 5.5 | 12,529달러 | 7,009달러 |
| Opus 5.5 | 11,726달러 | 9,200달러 |
| Fable 5.1 | 2,485달러 | 2,480달러 |
Fable 5.1은 플랜 전체 사용 한도의 절반까지만 사용할 수 있다는 조건이 붙습니다.[1]
분석
이 장은 글 전체의 가장 중요한 개념을 제시합니다.
구독의 가치는 고정된 금액이 아니라, 사용 패턴에 따른 조건부 값이다.
원문 도표의 워크로드 구성은 다음과 같습니다.[1]
| 토큰 유형 | 에이전트 워크로드 | 채팅 워크로드 |
| 신규 입력 | 0.4% | 2% |
| 캐시 읽기 | 96.6% | 75% |
| 캐시 쓰기 | 2.6% | 13% |
| 출력 | 0.3% | 10% |
에이전트 비중은 표시된 반올림 값입니다.
특히 에이전트 워크로드의 96.6%가 캐시 읽기라는 점이 중요합니다. 여기서 ‘많은 토큰’은 대부분 새로운 답변이 아니라 기존 문맥을 다시 읽는 토큰입니다.
한계와 시사점
[보완 필요] 이 비율은 SemiAnalysis의 사용 패턴을 기반으로 하므로, 모든 사용자에게 대표성을 갖는다고 볼 수 없습니다.
문서 분석처럼 신규 입력이 많거나 긴 보고서 작성처럼 출력이 많은 업무는 원문의 에이전트 시나리오와 다른 결과가 나올 수 있습니다. 구독료만 비교하지 말고 자신의 토큰 구성부터 확인해야 한다는 것이 이 장의 실무적 결론입니다.
3. 「Methodology」 — 불투명한 사용량 미터를 토큰 단가로 역산한다
핵심 주장
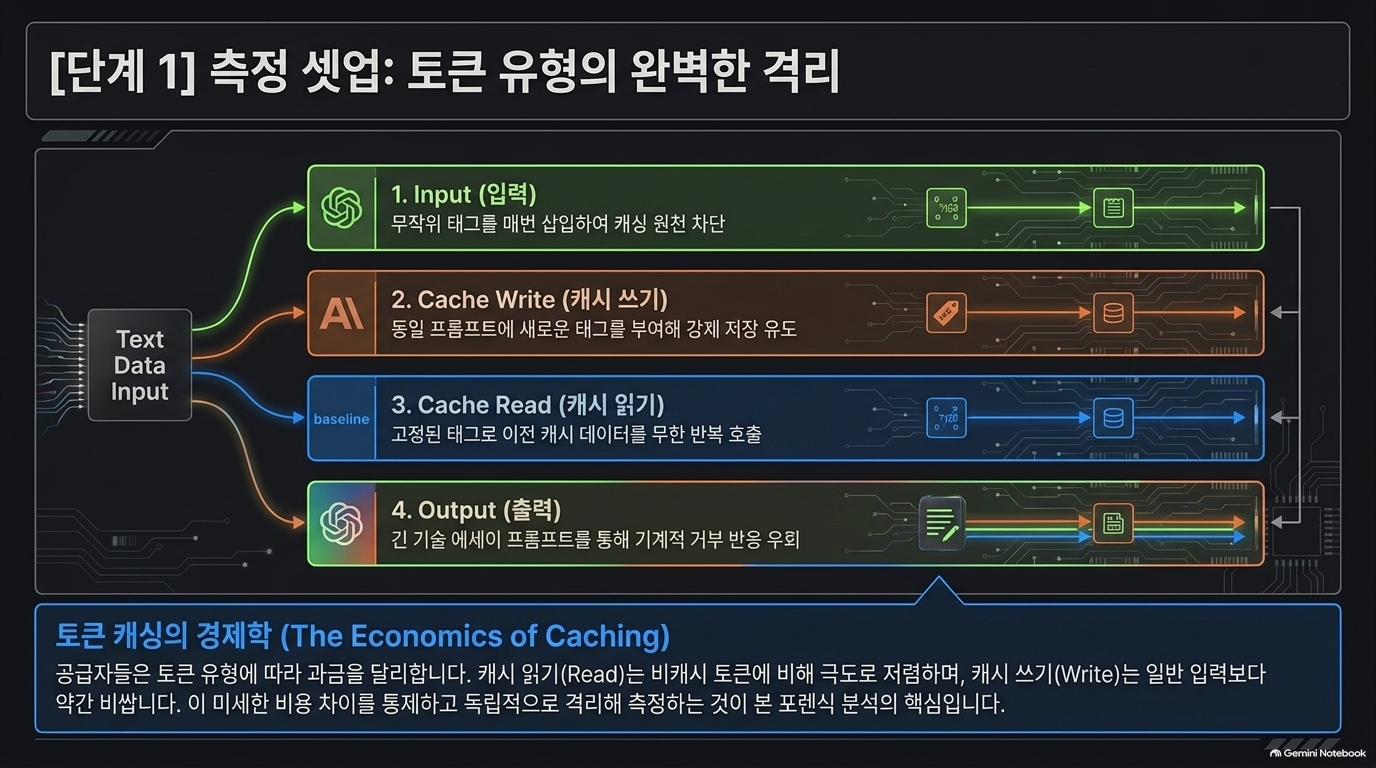
구독 서비스는 API처럼 토큰별 가격을 보여주지 않고, 일정 기간의 사용량 미터를 제공합니다. 저자들은 특정 토큰 유형을 집중적으로 사용하는 실험을 수행해 토큰 소비량과 미터 상승량 사이의 관계를 측정합니다.[1]
원문은 토큰을 네 종류로 구분합니다.[1]
- 신규 입력
- 캐시 쓰기
- 캐시 읽기
- 출력
장문 컨텍스트에 추가 요금이 붙는 모델은 그 경계 아래에서 측정합니다.[1]
「Setup」 — 실험 설계
| 측정 대상 | 원문의 실험 방식 | 목적 |
| 신규 입력 | 『전쟁과 평화』 일부에 매 요청마다 새로운 태그 삽입 | 캐시 재사용 방지 |
| 캐시 쓰기 | 새로운 태그와 캐싱 표시 사용 | 새로운 캐시 항목 생성 |
| 캐시 읽기 | 고정 태그로 같은 문맥 반복 | 첫 쓰기 이후 읽기 집중 |
| 출력 | 긴 기술 에세이를 생성하도록 요청 | 출력 토큰 집중 |
모델이 무의미한 대량 문자열이나 기계적인 반복 요청을 거부할 수 있어 자연어 자료를 사용했다고 설명합니다.[1]
분석
이 접근의 장점은 “사용량이 줄어든 것 같다”는 체감이 아니라 계량 실험으로 한도를 역추정한다는 것입니다.
다만 완전한 단일 변수 실험은 아닙니다. 입력 중심 요청도 출력을 발생시키고, 출력 중심 요청도 입력을 소비합니다. 저자들은 다른 토큰 유형의 측정 단가를 이용해 혼입분을 보정합니다.[1]
[확인 필요] 모델별 반복 수, 계정별 실험 분포, 원시 로그가 공개된 본문에 충분히 제시되지는 않습니다. 측정 원리는 이해할 수 있지만 독립적인 전면 재현에는 추가 자료가 필요합니다.
4. 「Computing the Results」 — 측정값을 월간 사용량과 API 가치로 환산한다
4-1. 토큰 유형별 미터 소비율 측정
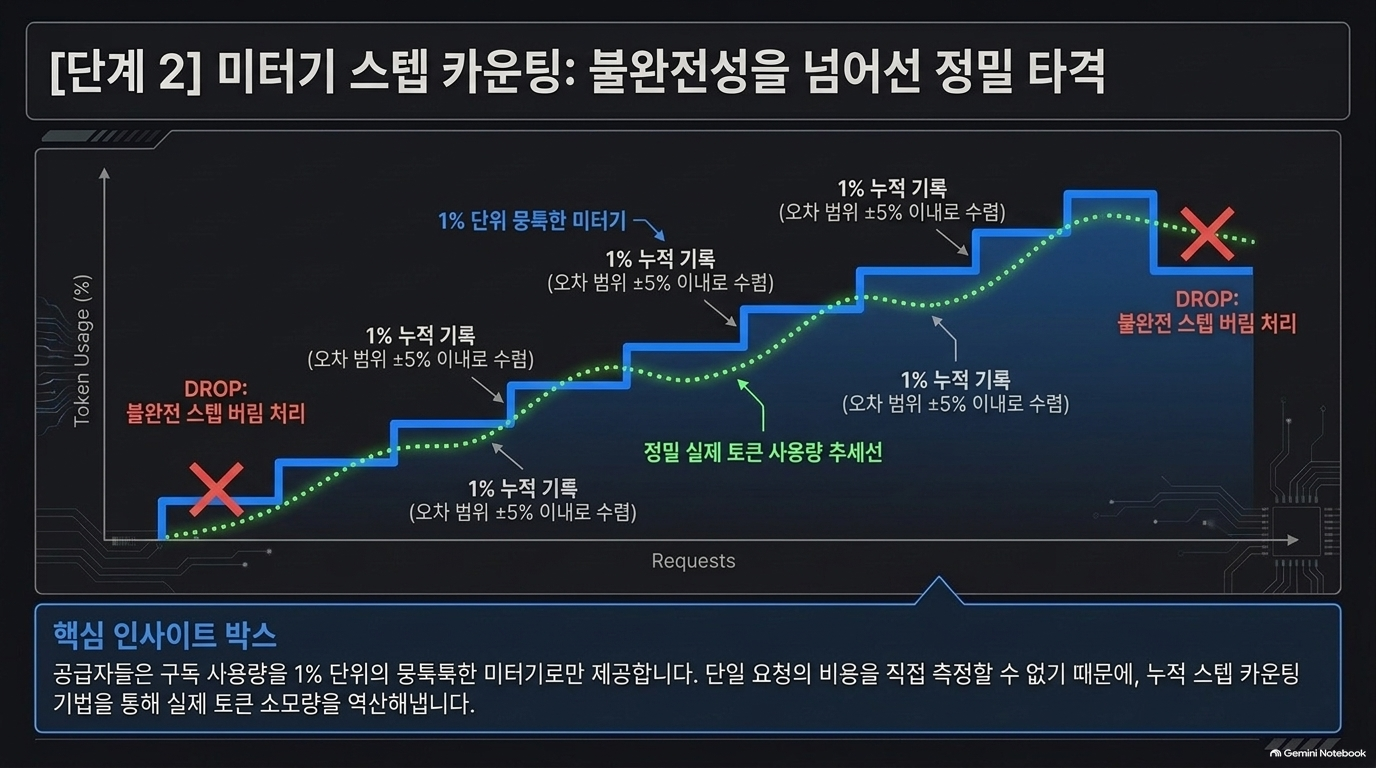
미터는 연속적으로 움직이지 않고 일정 단위로 증가합니다. 저자들은 미터가 한 단계 상승할 때마다 누적 토큰을 기록하고, 완전한 단계들에서 소비한 토큰과 미터 변화량을 이용해 소비율을 계산합니다.[1]
처음과 마지막의 불완전한 단계는 제외합니다.[1]
분석
이 방법은 미터의 계단식 표시에서 발생하는 경계 오차를 줄입니다. 저자들은 측정 범위가 ±5% 이내로 좁아질 때까지 단계를 추가한다고 설명합니다.[1]
하지만 이 ±5%는 측정 해상도와 요청 경계에 따른 오차 범위로 읽어야 합니다. 계정 차이, 정책 변경, 워크로드 대표성까지 포함한 전체 불확실성이나 통계적 신뢰구간을 뜻하지는 않습니다.
또한 5억 캐시 읽기 토큰을 사용해도 미터가 움직이지 않으면 무료로 가정합니다.[1]
[보완 필요] ‘관측 가능한 차감이 없음’과 ‘실제 단가가 정확히 0’은 다릅니다. 극히 낮은 단가나 미터 해상도 문제일 가능성을 남겨두어야 합니다.
4-2. 기간별 한도를 토큰량으로 환산
각 요청 후 5시간·주간·모델별 한도 미터를 읽고, 토큰 유형별로 각 한도의 소비율을 계산합니다.[1]
여기서 중요한 것은 여러 한도가 동시에 적용된다는 점입니다.
- 월간 총량이 충분해도 5시간 한도 때문에 집중 사용이 중단될 수 있습니다.
- 모델별 한도를 소진해도 다른 모델을 위한 전체 한도는 남을 수 있습니다.
원문은 5시간 한도가 주중 여러 차례 초기화되므로 월간 총량은 주간 한도에 의해 제한된다고 설명합니다.[1] 다만 실제 사용자에게는 작업 일정과 짧은 기간의 병목도 중요합니다.
4-3. API 환산가치 계산
원문의 계산 구조를 정리하면 다음과 같습니다.
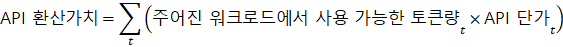
각 토큰 유형의 단위는 일치시켜야 합니다.
분석
이 지표는 “동일한 토큰 사용량을 API로 구매하면 얼마인가”를 보여줍니다. 다음을 직접 보여주지는 않습니다.
- 제공자의 실제 원가
- 사용자가 실제로 절약한 현금
- 작업 완료량과 정확도
- 구독 기능을 API처럼 이용할 수 있는지 여부
즉, 비교용 가격 지표이지 생산성이나 투자수익률의 직접 측정치가 아닙니다.
5. 「Catching a Provider A/B Test」 — 동일한 구독도 계정별로 다를 수 있다
핵심 내용
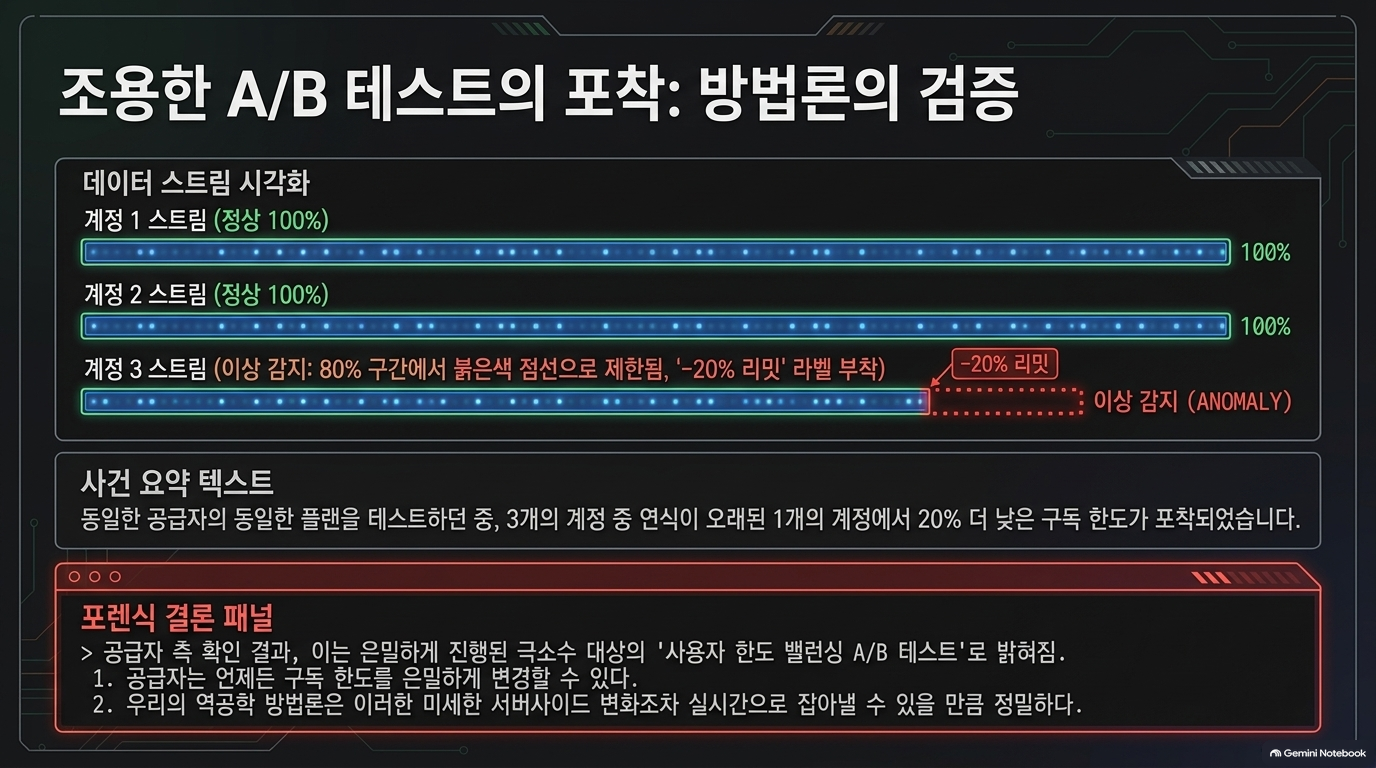
동일한 구독 세 개를 측정했는데, 한 계정의 한도가 다른 두 계정보다 약 20% 낮았습니다. 저자들은 공급자에게 문의했고, 해당 계정이 소규모 한도 A/B 테스트에 포함되어 있었다는 설명을 받았다고 보고합니다.[1]
분석
이 사례는 두 가지를 보여줍니다.
- 같은 상품명과 구독료가 항상 같은 실효 한도를 보장하지 않을 수 있다.
- 미터 기반 측정으로 계정 간 차이를 탐지할 수 있다.
다만 계정 세 개 중 하나에서 발견된 사례를 전체 고객의 발생률로 확대해서는 안 됩니다. 공급자도 이 절에서는 익명으로 처리되어 있어 특정 회사에 귀속할 수 없습니다.[1]
실무 시사점
요금제 평가 기록에는 최소한 다음 조건을 남기는 것이 좋습니다.
- 측정 시점과 계정
- 플랜 및 모델
- 신규·기존 가입 여부
- 프로모션과 한도 초기화
- 실제 사용 클라이언트
- 5시간·주간·모델별 미터
요금제 이름만 같다고 측정 결과를 그대로 이전할 수는 없습니다.
6. 「OpenAI vs Anthropic」 — ‘5배’는 일상용 모델 비교에서 나온다
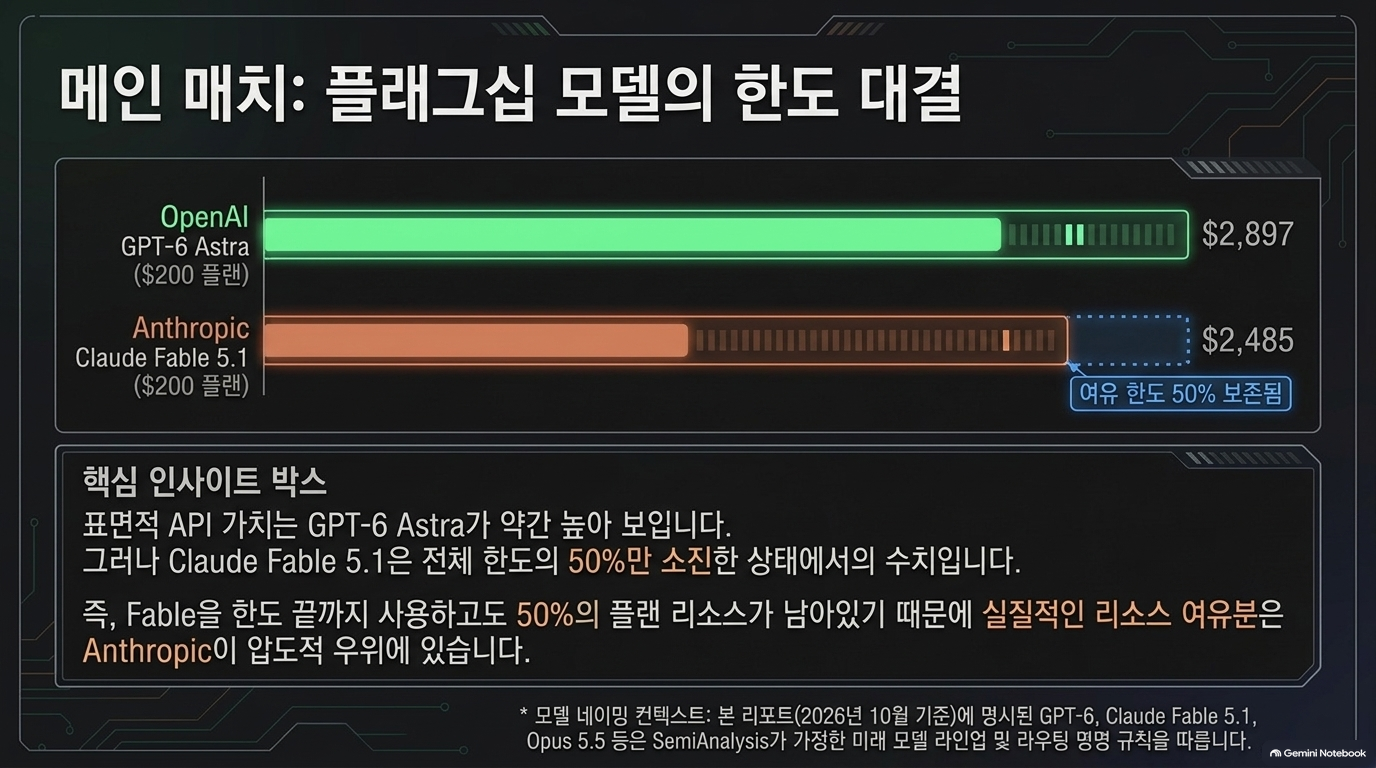
6-1. 최상위 모델: GPT-6 Astra vs Fable 5.1
원문은 에이전트 워크로드에서 다음 값을 제시합니다.[1]
| 월 구독료 | OpenAI: Astra | Anthropic: Fable 5.1 |
| 200달러 | 2,897달러 | 2,485달러 |
| 100달러 | 1,322달러 | 1,273달러 |
| 20달러 | 162달러 | Claude Pro에 미포함 |
최상위 모델끼리는 API 환산가치가 비교적 비슷합니다. 다만 Fable은 전체 한도의 절반까지만 사용하므로, Fable 한도를 소진한 뒤에도 다른 모델을 위한 한도가 남는다고 설명합니다.[1]
해석상 주의
Fable과 다른 모델의 단독 최대 사용량을 그대로 더하면 안 됩니다. 공유 한도의 잔여분에서 다른 모델을 얼마나 사용할 수 있는지를 계산해야 합니다.
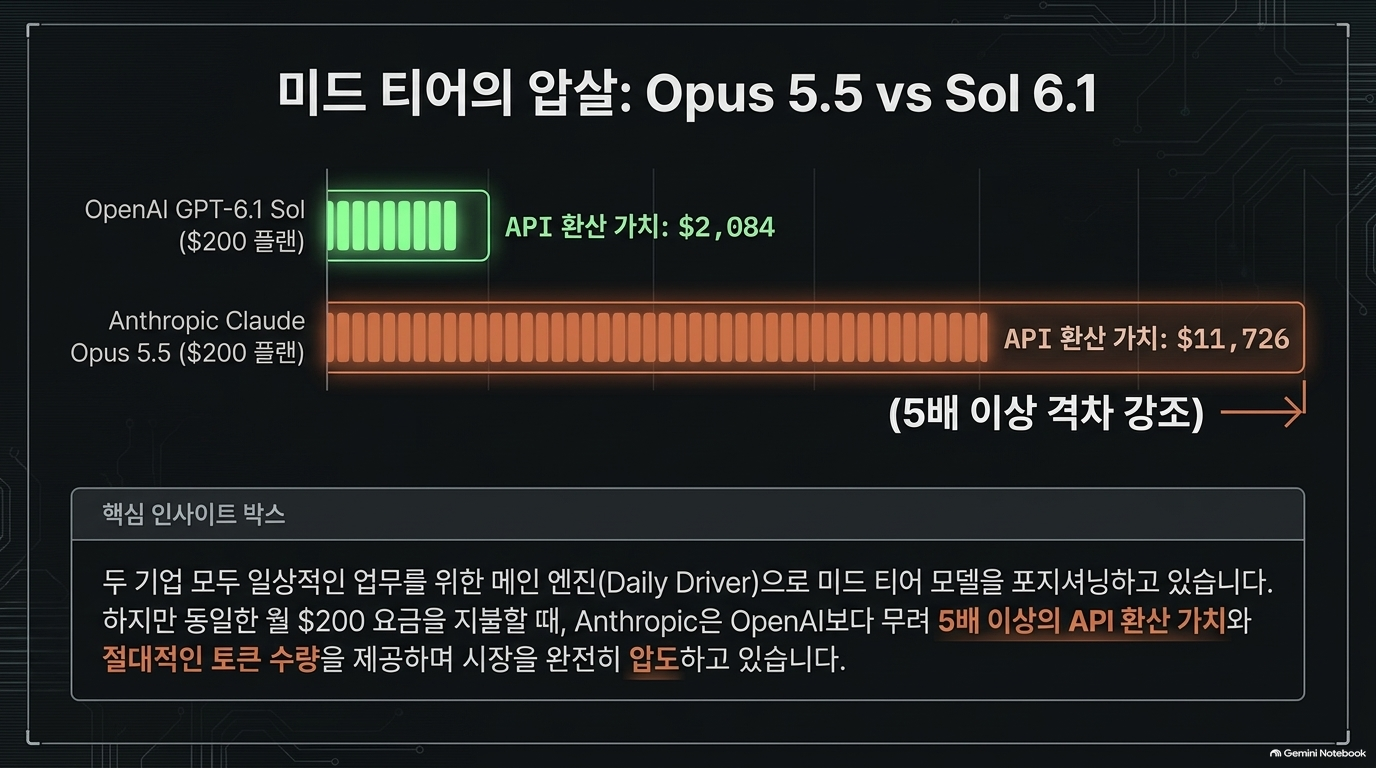
6-2. 일상용 모델: GPT-6.1 Sol vs Opus 5.5
제목의 핵심 근거는 이 비교입니다.[1]
| 월 구독료 | OpenAI API 환산가치 | Anthropic API 환산가치 | Anthropic/OpenAI* |
| 200달러 | 2,084달러 | 11,726달러 | 5.63배 |
| 100달러 | 1,055달러 | 5,725달러 | 5.43배 |
| 20달러 | 211달러 | 1,178달러 | 5.58배 |
원문 도표 수치를 이용해 계산한 비율입니다.
그러나 총 토큰량으로 비교하면 차이는 줄어듭니다.[1]
| 월 구독료 | OpenAI 총 토큰 | Anthropic 총 토큰 | Anthropic/OpenAI* |
| 200달러 | 102억 | 286억 | 2.80배 |
| 100달러 | 51억 | 140억 | 2.75배 |
| 20달러 | 10억 | 29억 | 2.90배 |
반올림된 원문 도표 수치를 이용한 계산입니다. 총 토큰에는 캐시 읽기가 포함됩니다.
분석
차이가 나는 이유는 제공량 차이와 모델별 API 가격 차이가 함께 작용하기 때문입니다.
저자들도 API 가격이 상대적으로 비싸거나 싼 모델은 API 환산가치만으로 평가하면 오해할 수 있다고 인정합니다. 또한 실제 업무의 토큰 효율성을 비교할 신뢰할 만한 자료가 부족하다고 지적합니다.[1]
이 장에서 정당화되는 결론: 지정된 사용 패턴과 측정 시점에서 Anthropic의 사용량 경제성이 우세하다.
정당화되지 않는 결론: Anthropic이 실제 업무를 5배 더 많이, 더 정확하게 수행한다.
7. 「OpenAI’s new $500 plan and massive limit reduction」 — 고가 플랜의 할인 구조가 바뀌었다
핵심 내용
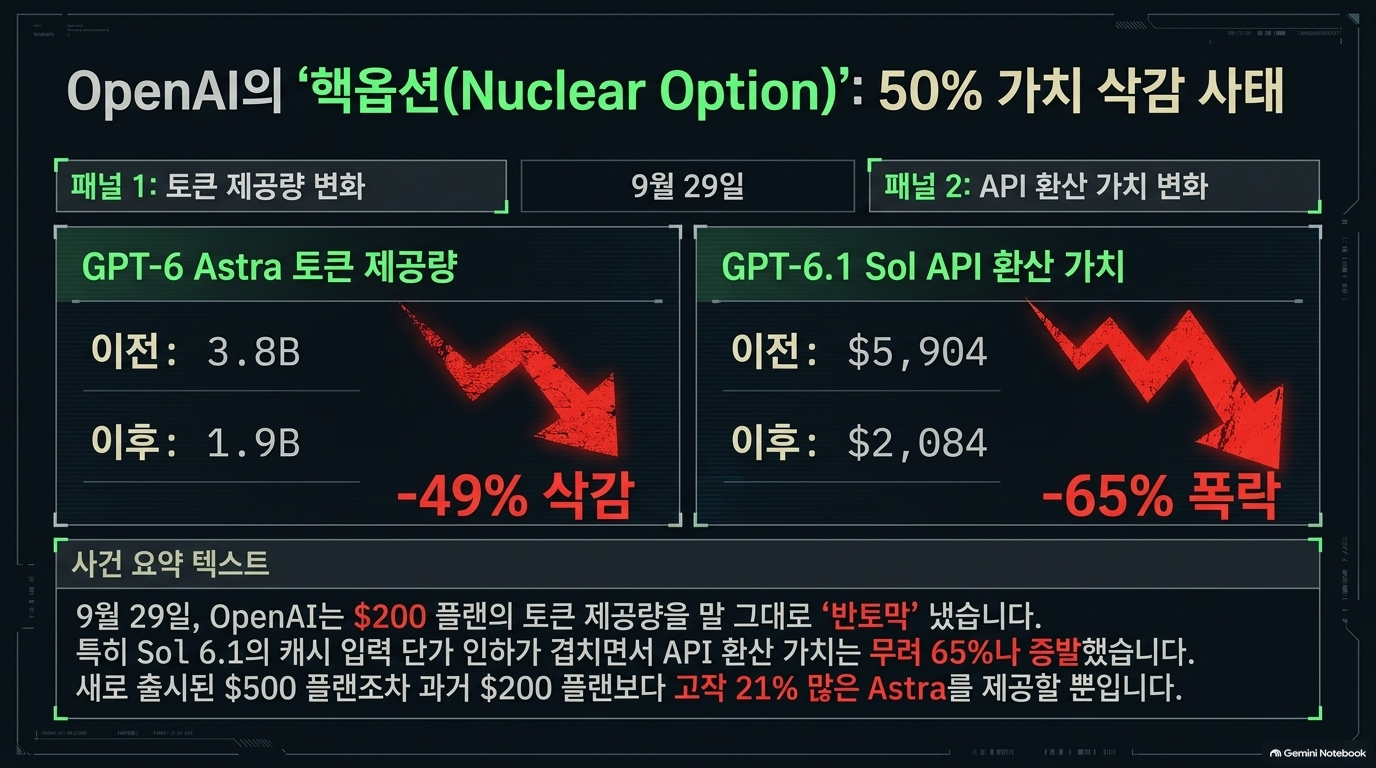
원문 도표는 2026년 9월 29일 변경을 기준으로 월 200달러 플랜의 사용량 감소를 보여줍니다.[1]
| 항목 | 변경 전 | 변경 후 | 도표의 감소율 |
| Astra API 환산가치 | 5,734달러 | 2,897달러 | 약 49% |
| Astra 총 토큰 | 38억 | 19억 | 약 49% |
| Sol 계열 API 환산가치 | 5,904달러 | 2,084달러 | 약 65% |
| Sol 계열 총 토큰 | 196억 | 102억 | 약 48% |
Sol 비교는 GPT-6 Sol에서 GPT-6.1 Sol로 모델도 바뀝니다. 따라서 환산가치 감소에는 사용량 축소와 캐시 입력 API 가격 인하가 함께 반영되어 있습니다.[1]
신설 500달러 플랜
이전 200달러 플랜과 비교하면 다음과 같습니다.[1]
- 구독료: 200 → 500달러, 150% 인상
- Astra 토큰 및 API 환산가치: 약 21% 증가
- Sol 계열 토큰: 약 34% 증가
- Sol 계열 API 환산가치: 약 9% 감소
원문은 신설 플랜의 주요 특징으로 300 TPS Ultrafast를 언급하지만, 그 한도는 당시 시험 중이라고 명시합니다.[1]
분석
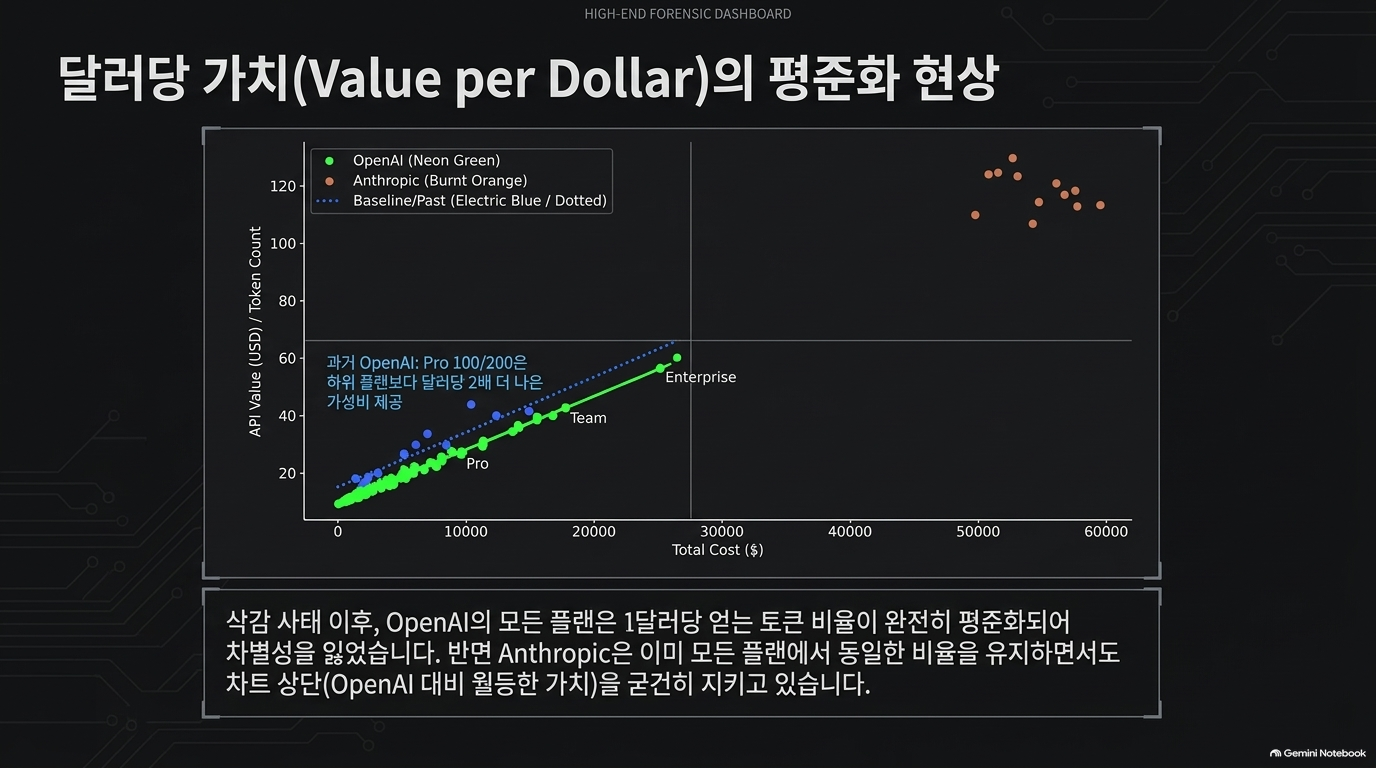
이 장의 요지는 고가 플랜의 사용량당 할인 효과가 줄었다는 것입니다.
다만 500달러 플랜을 토큰량만으로 평가하는 것도 불완전합니다. 속도나 집중 사용 가능성이 실제 업무시간을 줄인다면 별도의 가치가 있을 수 있습니다. 반대로 스트리밍 속도가 빨라져도 도구 실행과 검증이 병목이면 전체 작업시간 개선은 제한될 수 있습니다.
원문은 OpenAI Pro 플랜에 5시간 한도가 없다는 점을 장점으로 인정합니다.[1] 따라서 월간 총량은 Anthropic, 집중 소비의 편의성은 OpenAI에 유리할 수 있다는 구분이 필요합니다.
8. 「Do labs adjust subscription limits based on API pricing changes?」 — API 가격 인하가 구독 혜택 증가를 뜻하지 않는다
핵심 내용
저자들은 모델 API 가격이 내려갔을 때 구독 토큰 한도를 늘려 환산가치를 유지하는지 살펴봅니다.[1]
| 모델 변경 | 원문이 제시한 API 가격 변화 | 구독 한도 대응 |
| Fable 5 → 5.1 | 캐시 읽기 75% 인하 | 토큰 한도 증가 없음 |
| Opus 5 → 5.5 | 입력·출력 20%, 캐시 읽기 60% 인하 | Max 약 20%, Pro 약 50% 토큰 증가 |
| GPT-6 Sol → 6.1 Sol | 캐시 읽기 50% 인하 | 해당 출시 때 토큰 한도 증가 없음 |
원문은 Opus의 토큰 증가도 API 가격 인하를 완전히 상쇄하지는 못했다고 설명합니다.[1]
분석
여기서 중요한 역설이 발생합니다.
사용 가능한 토큰 수가 그대로인데 API 가격만 내려가면, 구독의 API 환산가치는 하락한다.
이 경우 실제 사용능력이 줄어든 것은 아닙니다. 다만 동일한 토큰을 API로 구매하는 대안이 저렴해져 구독의 상대적 할인 효과가 약해진 것입니다.
따라서 평가 시 다음을 분리해야 합니다.
- 실물 사용량: 토큰 한도
- 대체 구매가격: API 환산가치
- 업무 효율: 성공 작업당 비용·시간
API 환산가치 하락을 모두 구독 서비스의 실질적 축소로 해석하면 안 됩니다.
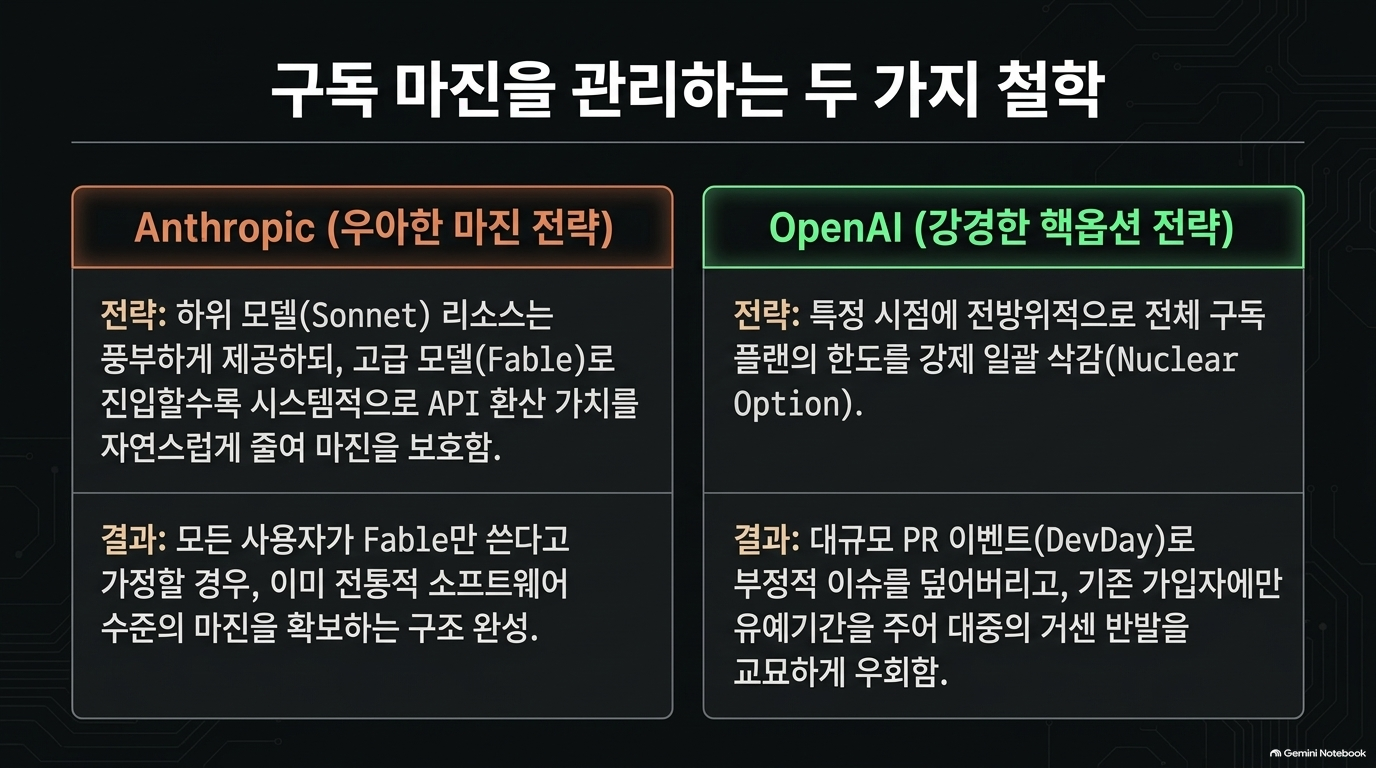
9. 「Two different approaches to increasing subscription margins」 — 양사의 보조금 축소 방식
핵심 주장
저자는 두 회사의 전략을 다음처럼 해석합니다.[1]
| 회사 | 저자의 전략 해석 |
| Anthropic | 고급 모델일수록 제공하는 API 환산가치를 낮춰 점진적으로 보조금 축소 |
| OpenAI | 여러 모델에 걸쳐 사용량 한도를 직접 축소 |
Anthropic은 Sonnet·Opus보다 Fable의 환산가치가 낮고, 이를 고급 모델을 통한 수익성 개선으로 해석합니다.[1]
수익성 시나리오
저자는 API 매출총이익률 92%를 가정해 다음 결과를 제시합니다.[1]
| 사용 시나리오 | Opus 5.5 | Fable 5.1 |
| 해당 모델의 허용 사용량 100% 소비 | 약 −369% | 약 1% |
| 허용 사용량 20% 소비 | 약 6% | 약 80% |
월 200달러와 원문의 API 환산가치를 사용해 계산하면 약 −369.0%·0.6%, 6.2%·80.1%로 재현됩니다.
분석과 한계
이는 실제 회사 손익이 아니라 가정에 따른 시나리오 계산입니다.
특히 Fable은 전체 한도의 절반만 사용할 수 있으므로, 남은 한도를 다른 모델에 사용하면 구독 전체 원가는 더 높아질 수 있습니다. 또한 고객 유지율, 운영비, 실제 추론원가 변화 등은 별도로 검토해야 합니다.
[보완 필요] API 가격과 가정된 API 이익률로 추론원가를 역산한 값은 실제 원가 자료를 대체하지 못합니다.
실무 시사점: 현재의 높은 구독 할인 효과가 장기간 유지된다고 가정해 사업 경제성을 설계하는 것은 위험합니다.
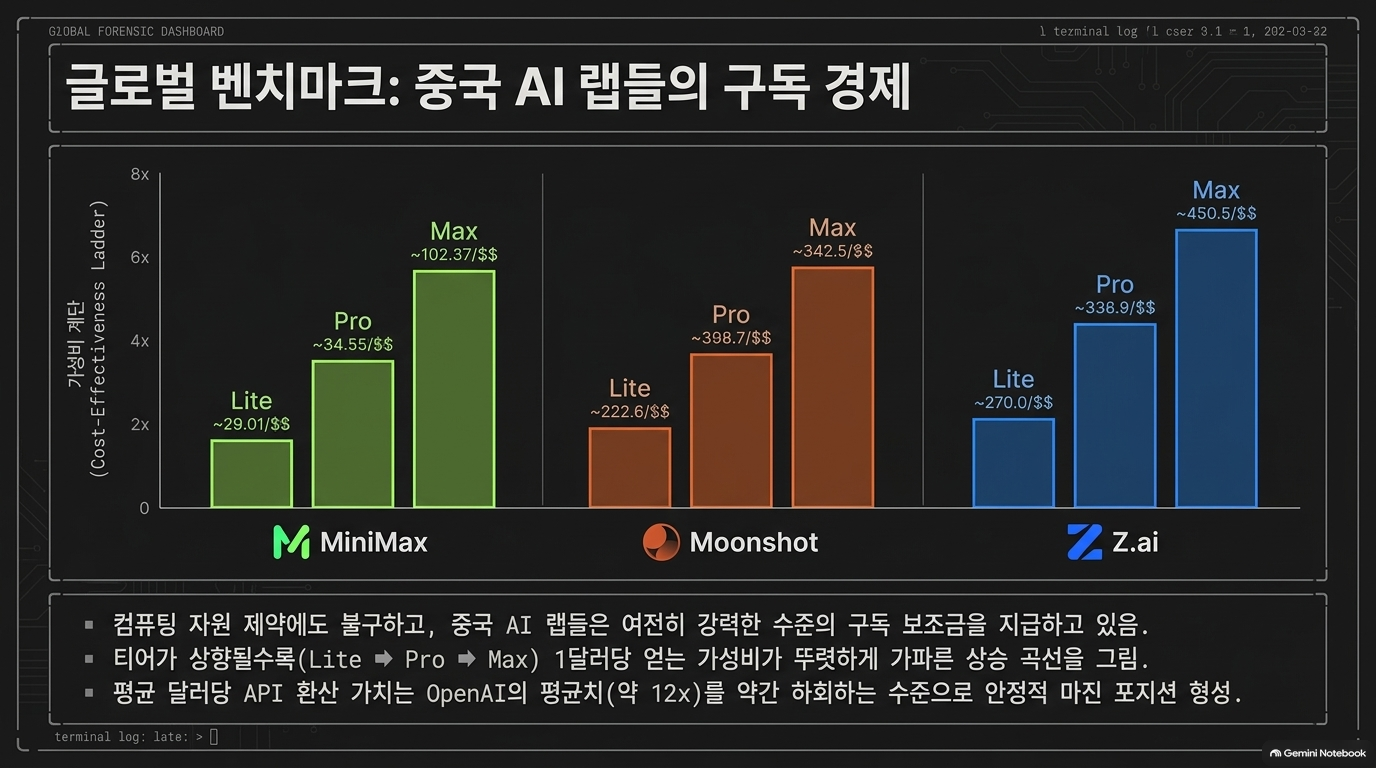
10. 「Chinese subscription plans are still a good deal」 — 모델별 차이를 봐야 한다
핵심 주장
중국 사업자들도 구독 보조금을 제공하지만, 모델별 수준이 크게 다르며 상위 구독으로 갈수록 달러당 가치가 높아지는 경향이 있다고 설명합니다.[1]
비교 도표는 두 축을 사용합니다.[1]
- 가로축: 구독료 1달러당 총 토큰량
- 세로축: 구독료 1달러당 API 환산가치
- 두 축 모두 로그 스케일
도표에서는 MiniMax-M3가 큰 토큰 제공량과 높은 환산가치를 보이고, GLM-5.3-Flash는 토큰량이 많지만 API 환산 배수는 낮은 위치에 있습니다. Kimi K3와 GLM-5.3도 모델·플랜별로 서로 다른 위치에 나타납니다.[1]
분석
이 장은 “API 환산 배수가 낮으면 나쁜 상품”이라는 판단이 성립하지 않는다는 점을 보여줍니다.
원래 API 가격이 저렴한 모델은 많은 토큰을 제공해도 환산가치가 낮게 나올 수 있습니다. 반대로 API 가격이 높은 모델은 상대적으로 적은 토큰으로도 높은 환산가치를 얻습니다.
실무 시사점 — 분석자 권고
국내 공공기관이나 민감자료 업무에서는 가격과 별도로 다음을 확인해야 합니다.
- 데이터 처리·저장 위치
- 입력자료의 학습 이용 여부와 보존·삭제 정책
- 국외 이전 및 위탁 조건
- 보안 통제와 감사 로그
- 한국어·도메인 업무의 실제 완료율
- 지원되는 이용 방식과 계약 조건
이 항목들은 원문이 검증한 결과가 아니라 도입 판단을 위한 추가 검토 기준입니다.
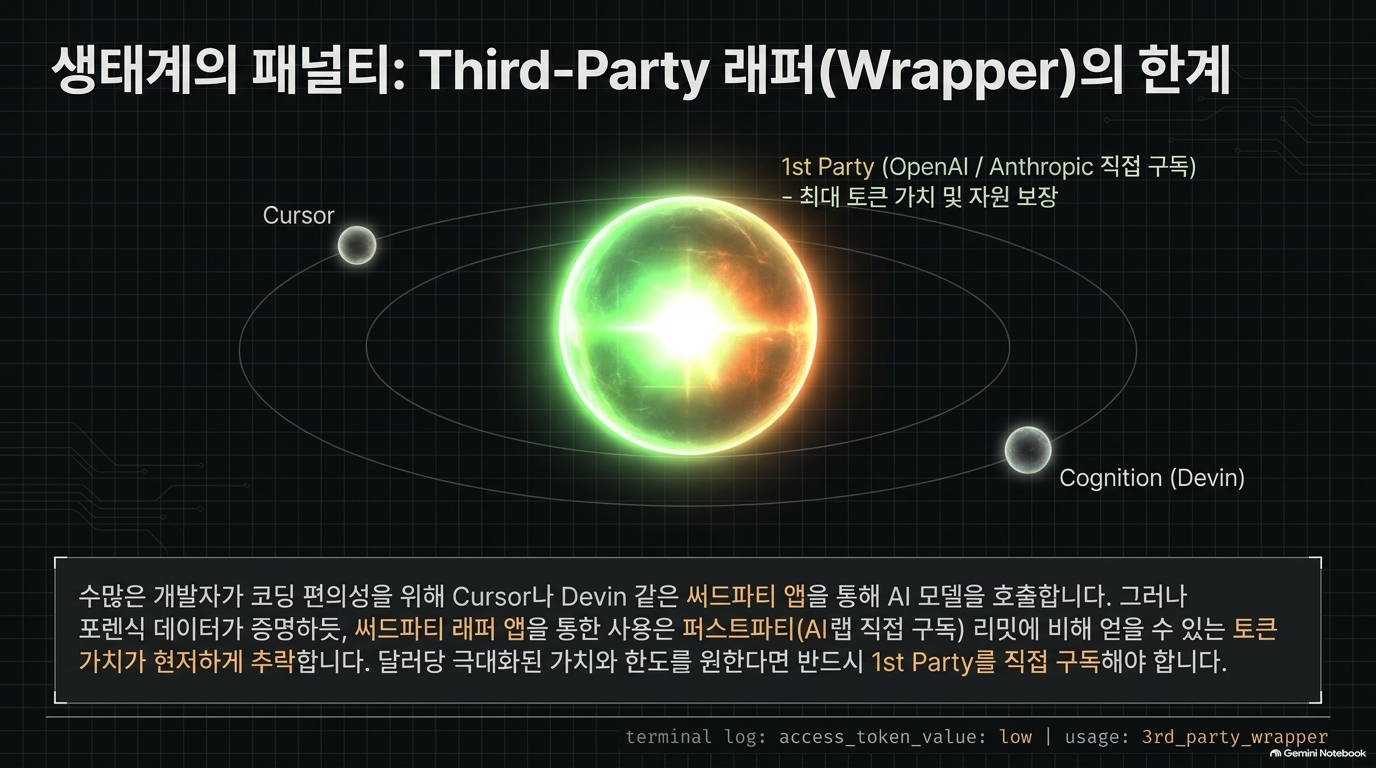
11. 「Third party plans are worse than first party」 — 상세 근거는 확인 불가
공개된 본문은 OpenAI·Anthropic의 직접 구독과 Cursor·Cognition의 Devin 같은 제3자 상품을 비교하겠다는 도입까지만 제공합니다.[1]
따라서 확인할 수 있는 것은 다음 범위입니다.
- 절 제목은 제3자 플랜의 가치가 더 낮다는 결론을 예고합니다.
- 상세 수치와 비교 조건은 공개 구간에서 확인할 수 없습니다.
- IDE 통합, 오케스트레이션, 실행환경 등의 부가가치를 얼마나 반영했는지도 확인할 수 없습니다.
[확인 필요] 제목만으로 “Cursor나 Devin을 쓰면 손해”라고 결론 내릴 수 없습니다. 상세 경제성 분석에는 해당 본문과 비교 조건이 필요합니다.
종합 평가
이 글의 기여와 한계
| 평가 항목 | 판단 |
| 구독 한도 측정 방법 | 미터와 토큰량을 연결하는 구체적인 역산 방법 제시 |
| 경제성 비교 | 플랜·모델·워크로드를 함께 봐야 한다는 점이 핵심 기여 |
| 제목의 ‘5배’ | 특정 일상용 모델과 에이전트 워크로드의 API 환산가치 비교 |
| 실제 생산성 | 작업 정확도·완료율·검증시간은 비교하지 않음 |
| 재현성 | 공개 본문만으로 계정·원시 로그·전체 실험을 재현하기에는 부족 |
| 정책의 지속성 | 시점·계정·프로모션·모델 가격 변경에 민감 |
| 제3자 상품 비교 | 유료 경계로 상세 검증 불가 |
| 이해관계 | 자사 Tokenomics Model과 구독 대시보드를 소개하는 상업적 맥락 포함 |
사용자 업무에 적용할 판단 기준
문서 분석·감리·AI 컨설팅 업무에서는 API 환산가치보다 다음 지표를 최종 판단 기준으로 삼는 편이 적절합니다.
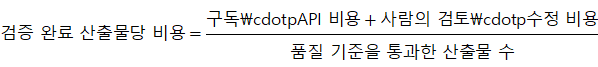
이는 분석자 제안 지표이며 원문에서 측정한 값은 아닙니다.
| 업무 유형 | 우선 평가할 항목 |
| 장문 RFP·보고서 분석 | 신규 입력 처리량, 근거 추적 정확도, 누락률 |
| 반복 코딩·에이전트 작업 | 캐시 재사용, 재시도량, 한도 소진, 완료율 |
| 긴 보고서 작성 | 출력 한도, 사실 오류, 수정 부담 |
| 마감 직전 집중 작업 | 짧은 기간 한도, 지연, 복구·초기화 조건 |
| 공공·민감정보 업무 | 계약, 데이터 처리 위치, 권한, 감사 가능성 |
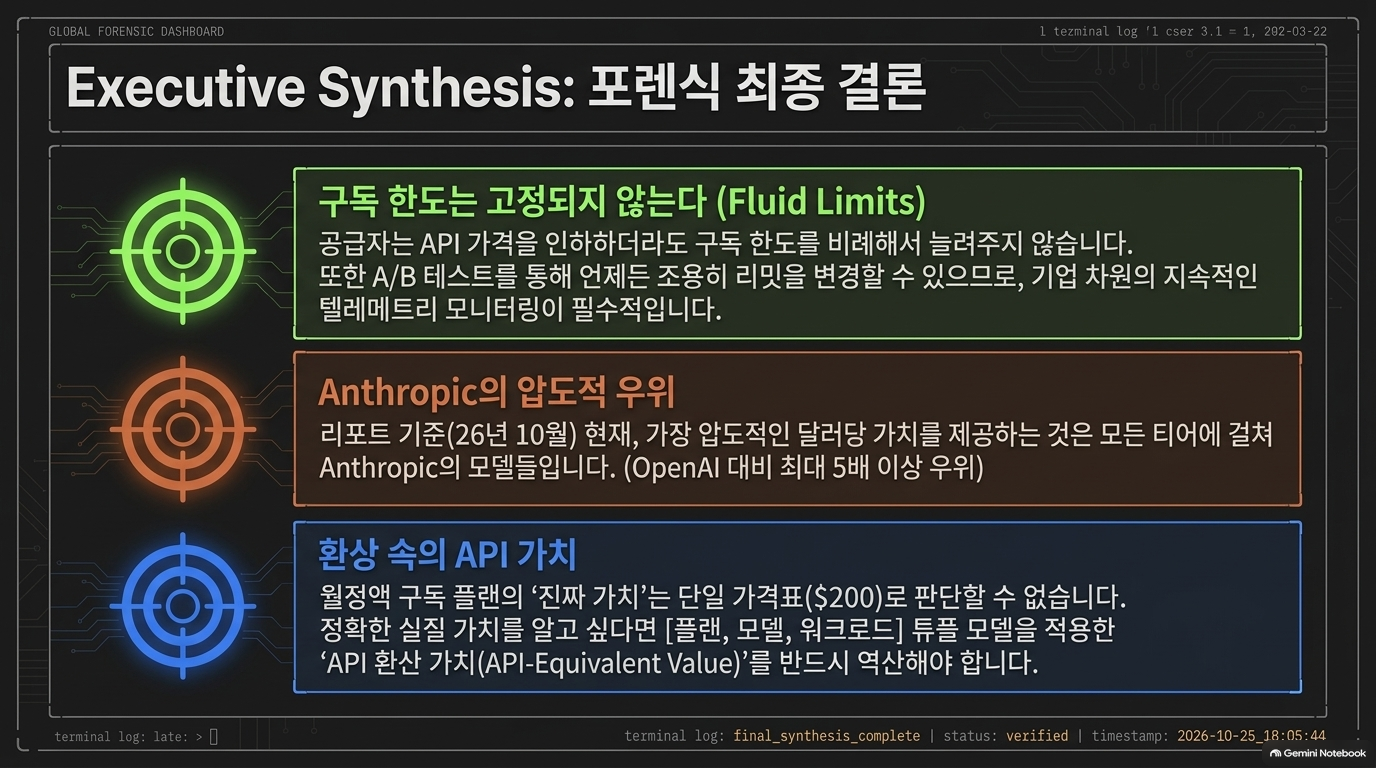
최종적으로 이 글은 “어느 AI가 더 우수한가”를 입증하는 글이 아니라, “불투명한 구독 한도를 어떻게 측정하고 가격으로 비교할 것인가”를 설명하는 글입니다. Anthropic의 사용량 경제성 우위는 제시된 조건에서 뚜렷하지만, 실제 구매 결정은 사용 패턴·집중 사용 가능성·검증 완료 작업당 비용까지 포함해야 합니다.
Sources
[1] https://open.substack.com/pub/semianalysis/p/anthropic-subscriptions-offer-5x — SemiAnalysis — Anthropic Subscriptions Offer 5x+ More Value Than OpenAI

'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - TrendForce, DRAM 부족이 기업용 SSD 공급 제약으로 확산되는 구조 (0) | 2026.10.07 |
|---|---|
| AI 반도체 - Semianalysis, 인텔 팬서 레이크 분해 (0) | 2026.09.27 |
| AI 반도체 - Semianalysis, ClusterMAX 3.0:글로벌 GPU 클라우드 평가 보고서 (0) | 2026.09.26 |
| AI 반도체 - EPOCH AI, 화웨이와 엔비디아의 연간 연산 공급량 격차 (0) | 2026.09.26 |
| AI 반도체 - Semianalysis, 중국 AI 인프라 폭발 (0) | 2026.09.26 |