https://epoch.ai/publications/huaweis-roadmap-to-2031
2026.9.24
[Will Huawei catch up to Nvidia by 2030?]
이 보고서는 2030년까지 화웨이가 엔비디아의 AI 컴퓨팅 성능을 추월할 수 있을지를 분석하며, 결론적으로 화웨이가 기술 격차를 좁히기 어려울 것으로 전망합니다. 현재 화웨이는 개별 칩의 성능과 생산량 모두에서 엔비디아에 크게 뒤처져 있으며, 미국의 수출 규제로 인해 고대역폭 메모리(HBM) 수급과 미세 공정 도입에 심각한 제약을 받고 있습니다. 화웨이는 이를 극복하기 위해 로직폴딩(LogicFolding)이라 불리는 수직 적층 기술과 대규모 시스템 확장 전략인 슈퍼포드(SuperPoD)를 내세우고 있으나, 엔비디아 역시 더 빠른 속도로 차세대 아키텍처를 선보이며 앞서나가고 있습니다. 결국 고성능 칩 제조에 필수적인 첨단 장비 및 부품의 부재가 화웨이의 야심 찬 로드맵 실현을 가로막는 결정적인 병목 현상으로 작용할 것입니다.
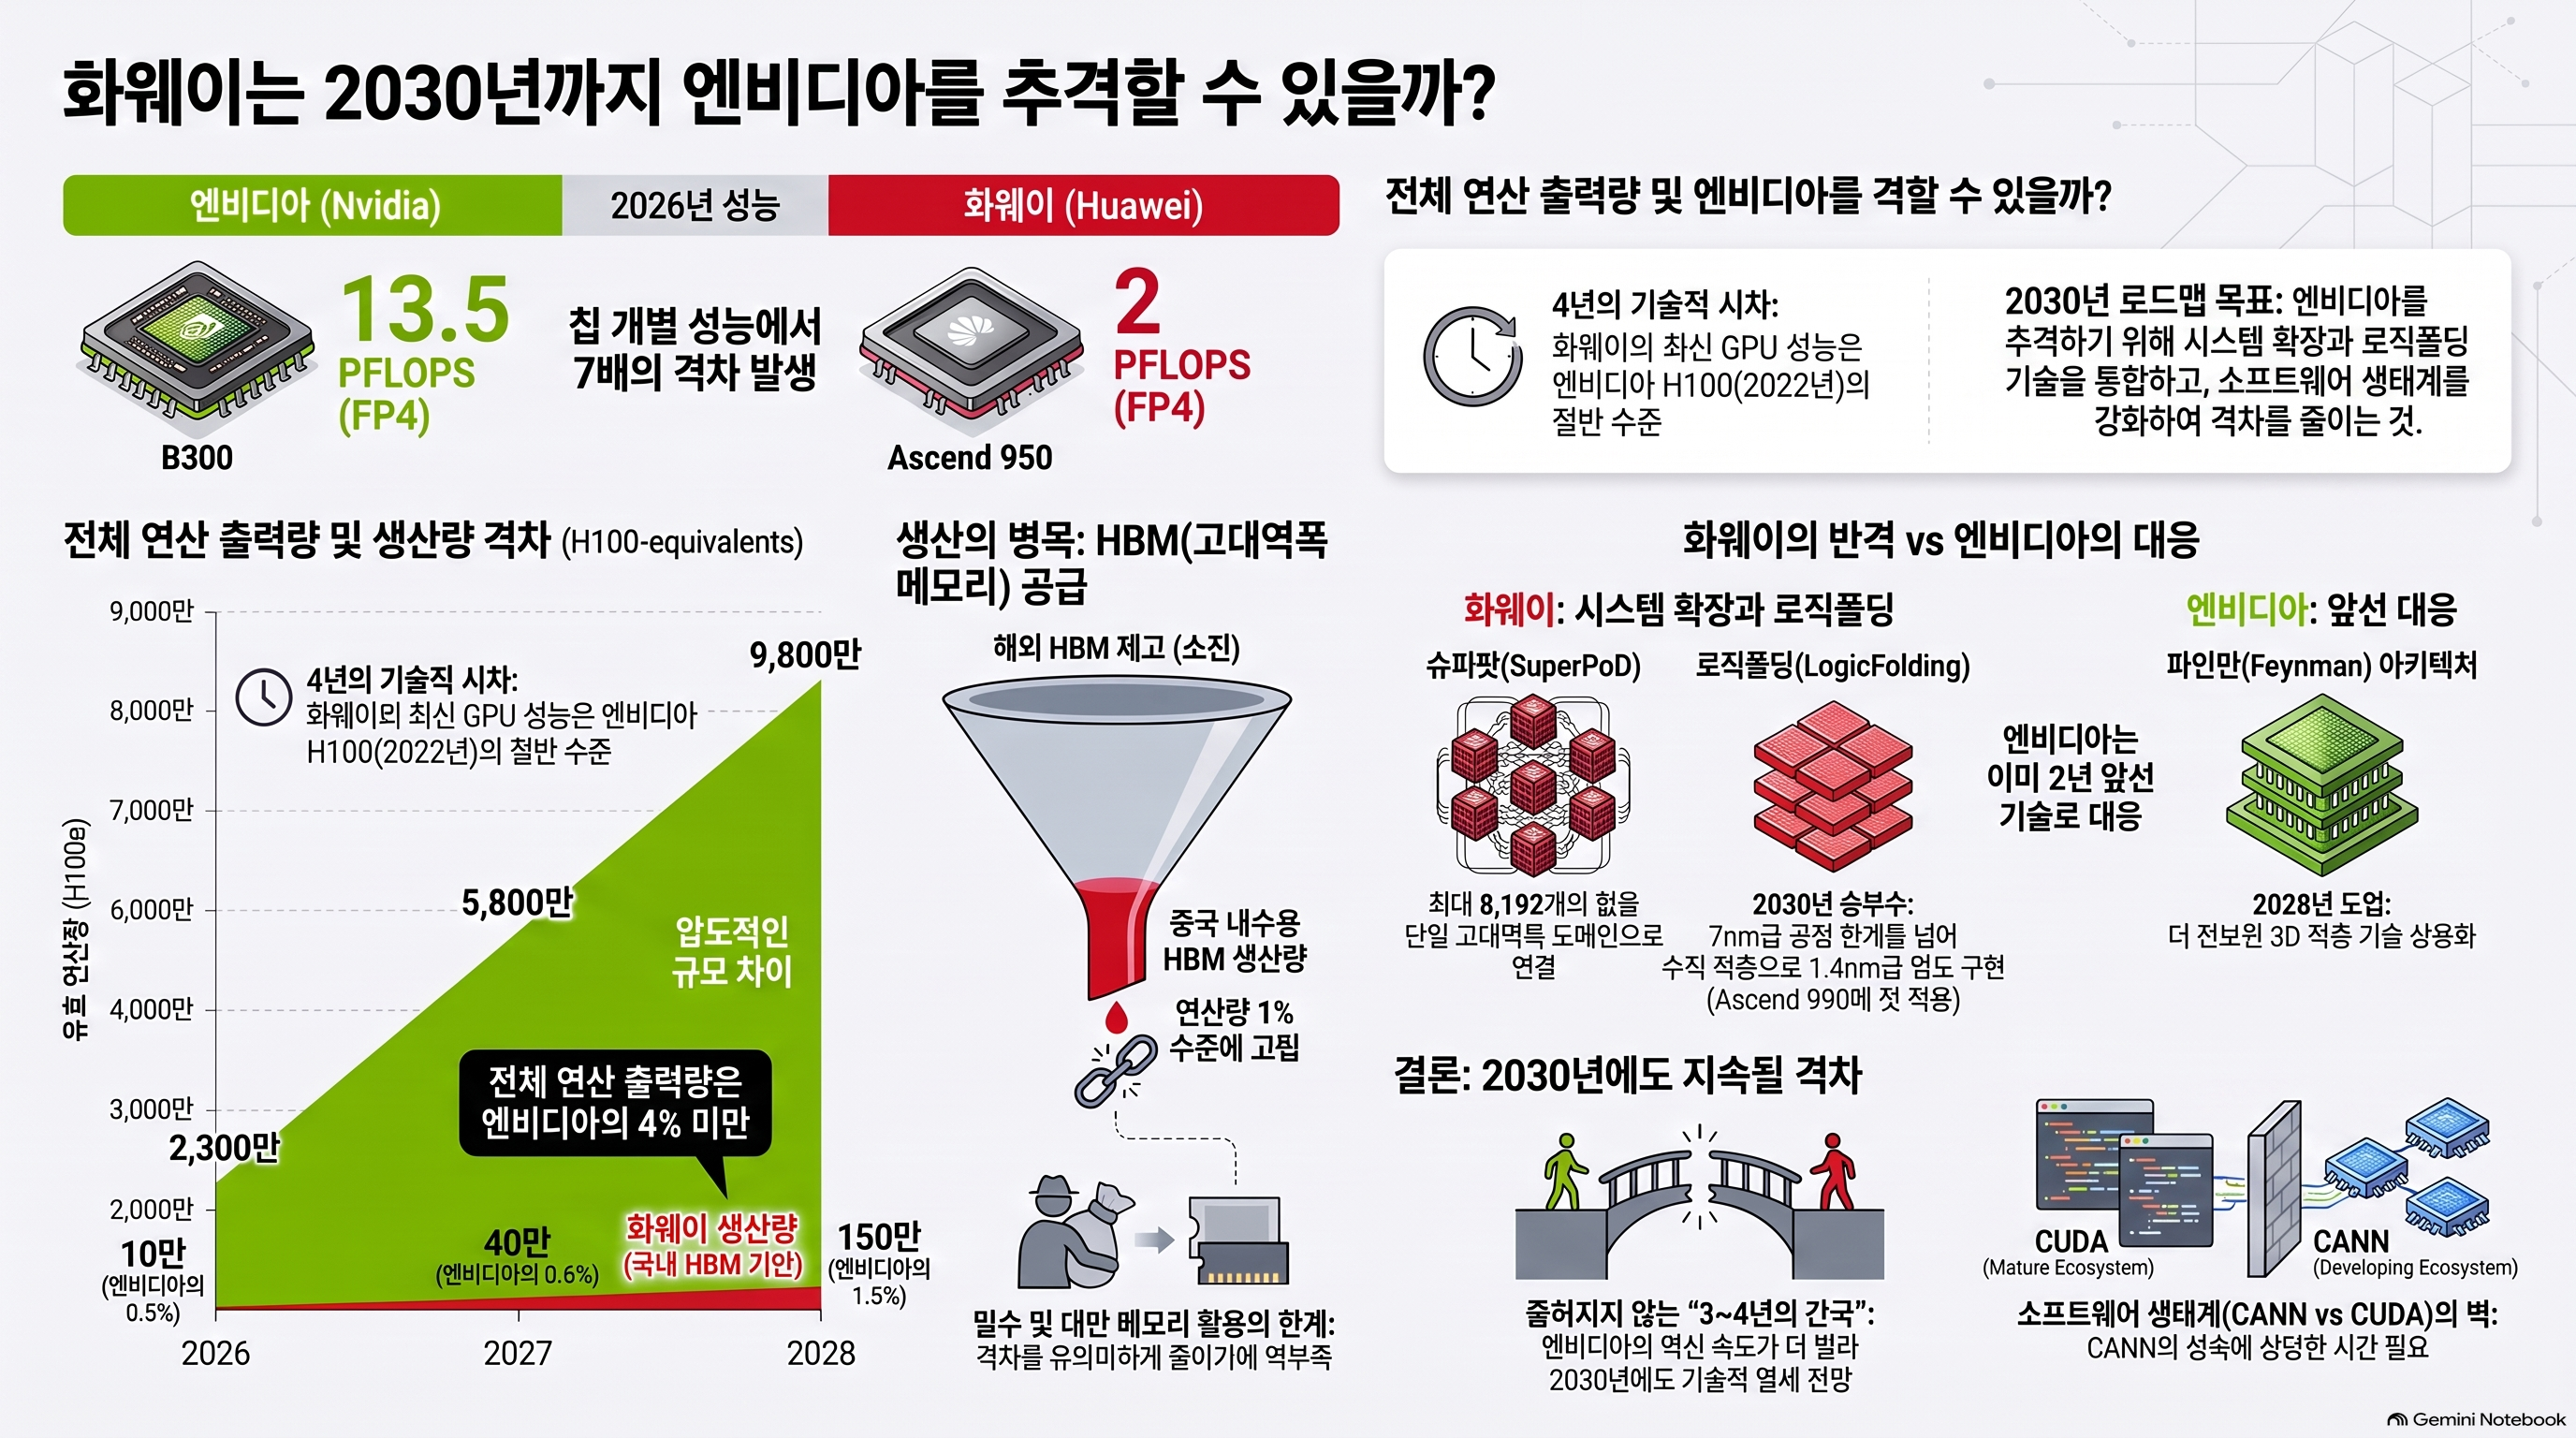
Epoch AI의 판단은 화웨이가 AI 칩 성능과 생산량을 모두 늘리더라도 2030년까지 엔비디아를 따라잡기는 어렵다는 것입니다. 여기서 비교하는 것은 단순 출하량이 아니라 칩당 연산 성능 × 생산량으로 환산한 연간 연산 공급량입니다. 따라서 아래 수치는 실측 시장점유율이 아닌, 로드맵과 공급망 가정을 넣은 추정치로 읽어야 합니다.[1]
| 쟁점 | 원문의 분석 |
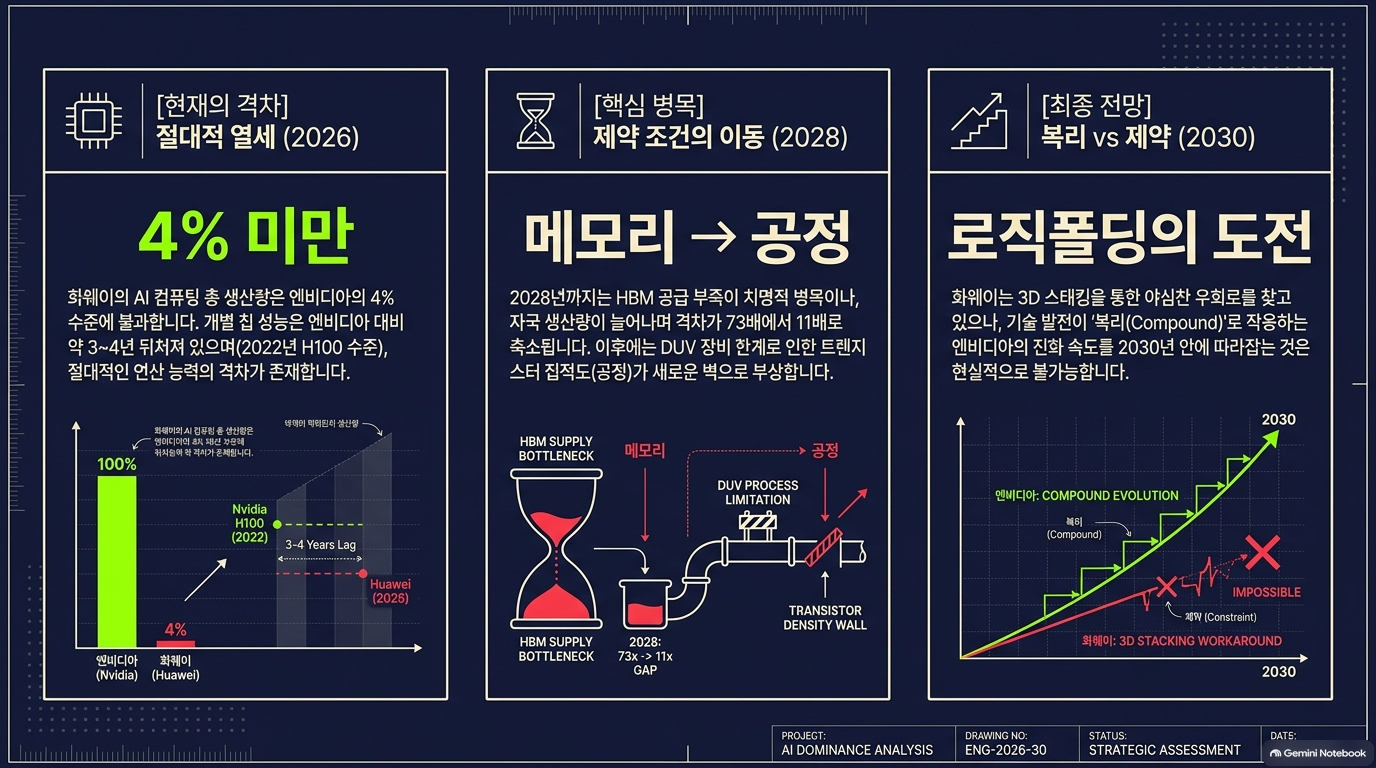
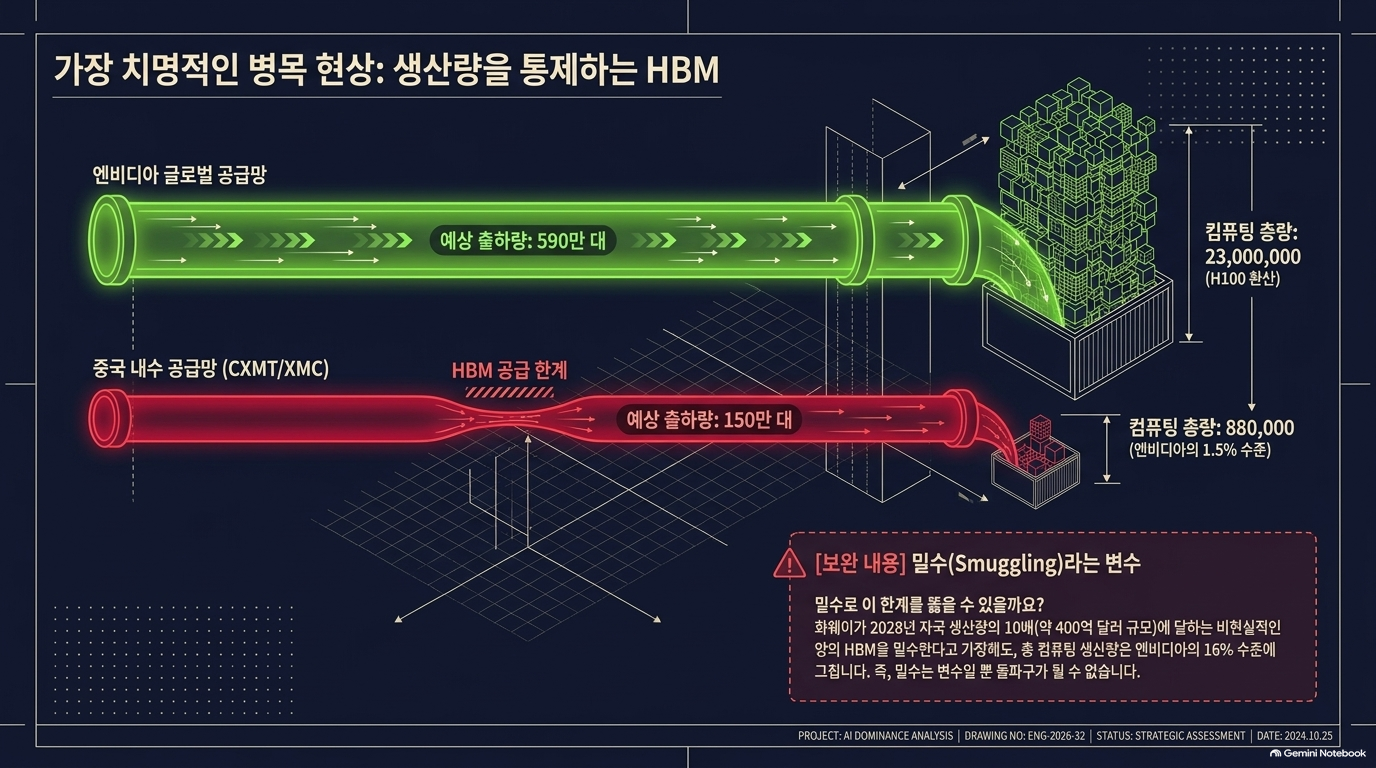
| 2026년 출발점 | 화웨이 Ascend 출하량을 150만 개, 엔비디아를 590만 개로 추정합니다. 이를 H100급 연산량으로 환산하면 각각 88만 대 상당 대 2,300만 대 상당으로, 화웨이는 엔비디아의 4% 미만입니다.[1] |
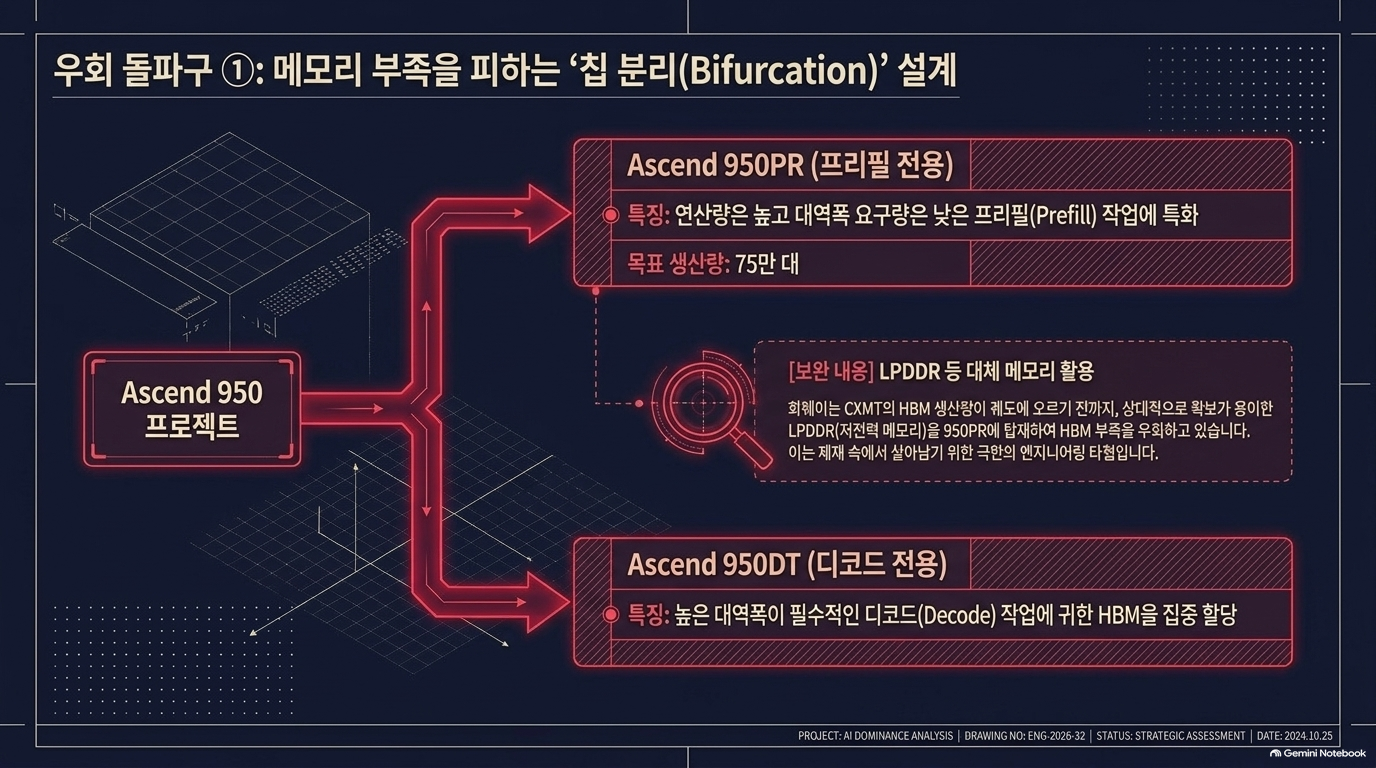
| 당장의 병목: HBM | 2026년 화웨이 출하 추정량 중 중국산 HBM을 사용하는 물량은 약 24만 개뿐입니다. 나머지는 비HBM 메모리나 외국산 HBM 재고·기타 조달 경로에 의존한다는 모델입니다.[1] |
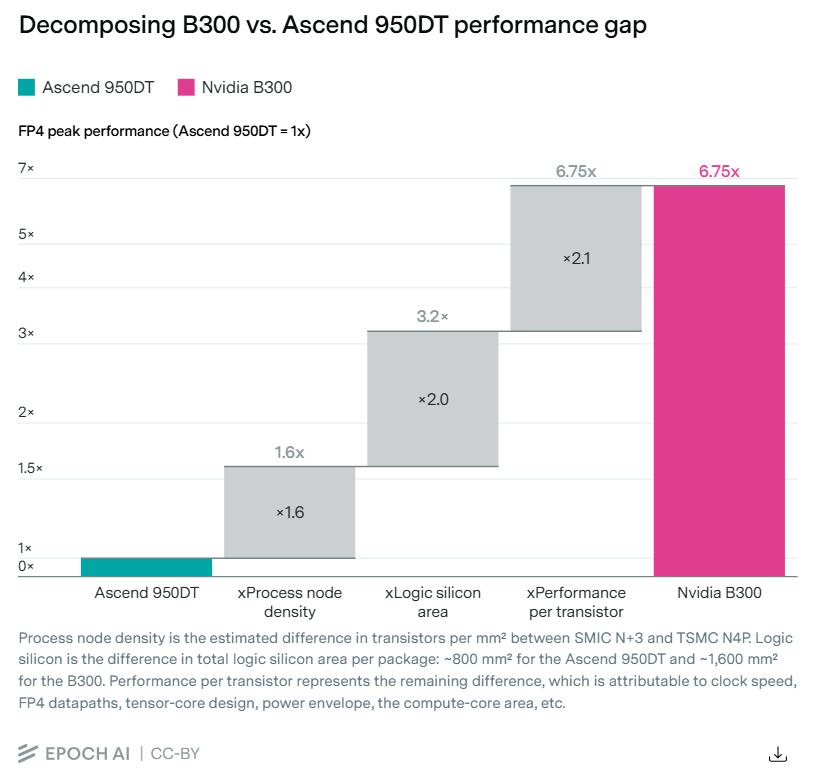
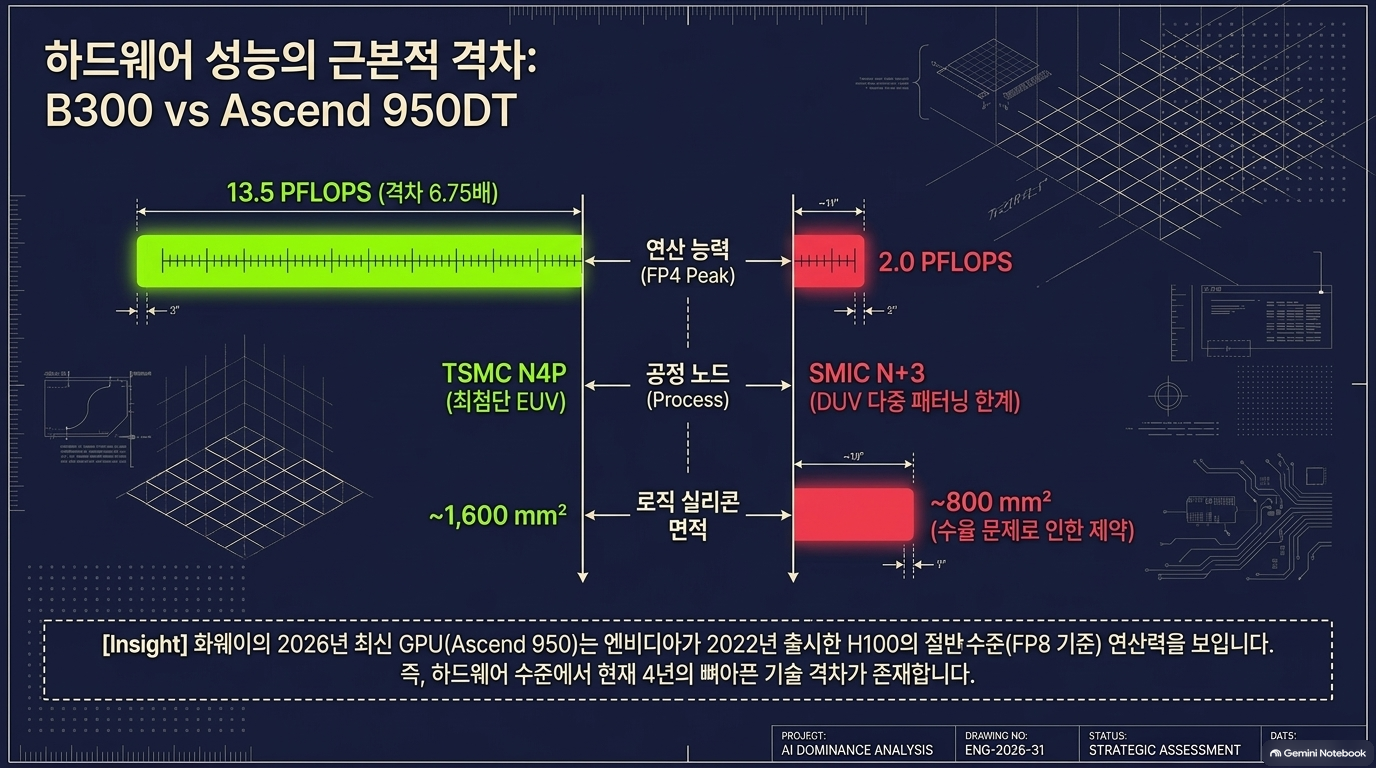
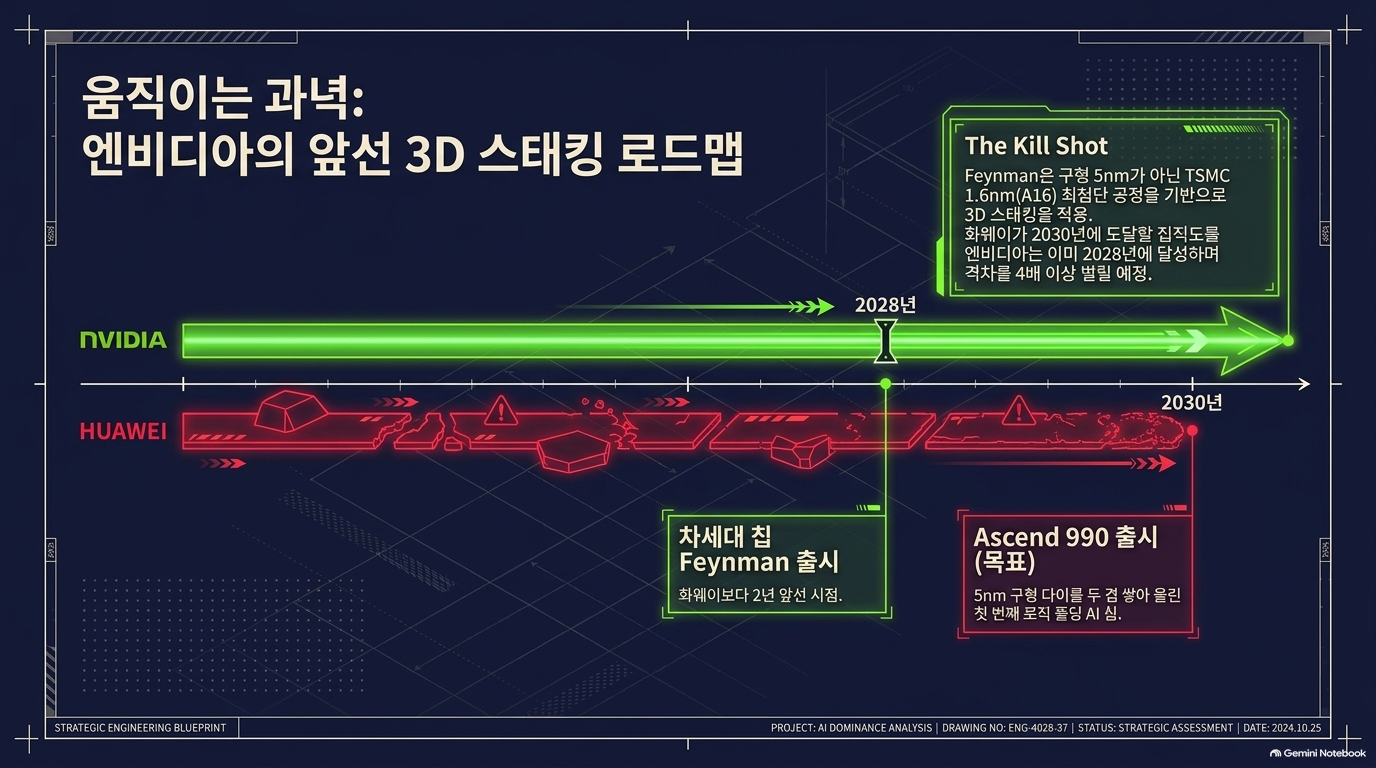
| 성능 격차 | Ascend 950DT의 FP8 성능은 과거 H100의 약 절반이며, FP4 이론 성능은 엔비디아 B300의 약 7분의 1이라고 비교합니다. 보고서는 화웨이 칩의 성능 수준이 엔비디아보다 대략 3~4년 뒤처진다고 봅니다.[1] |
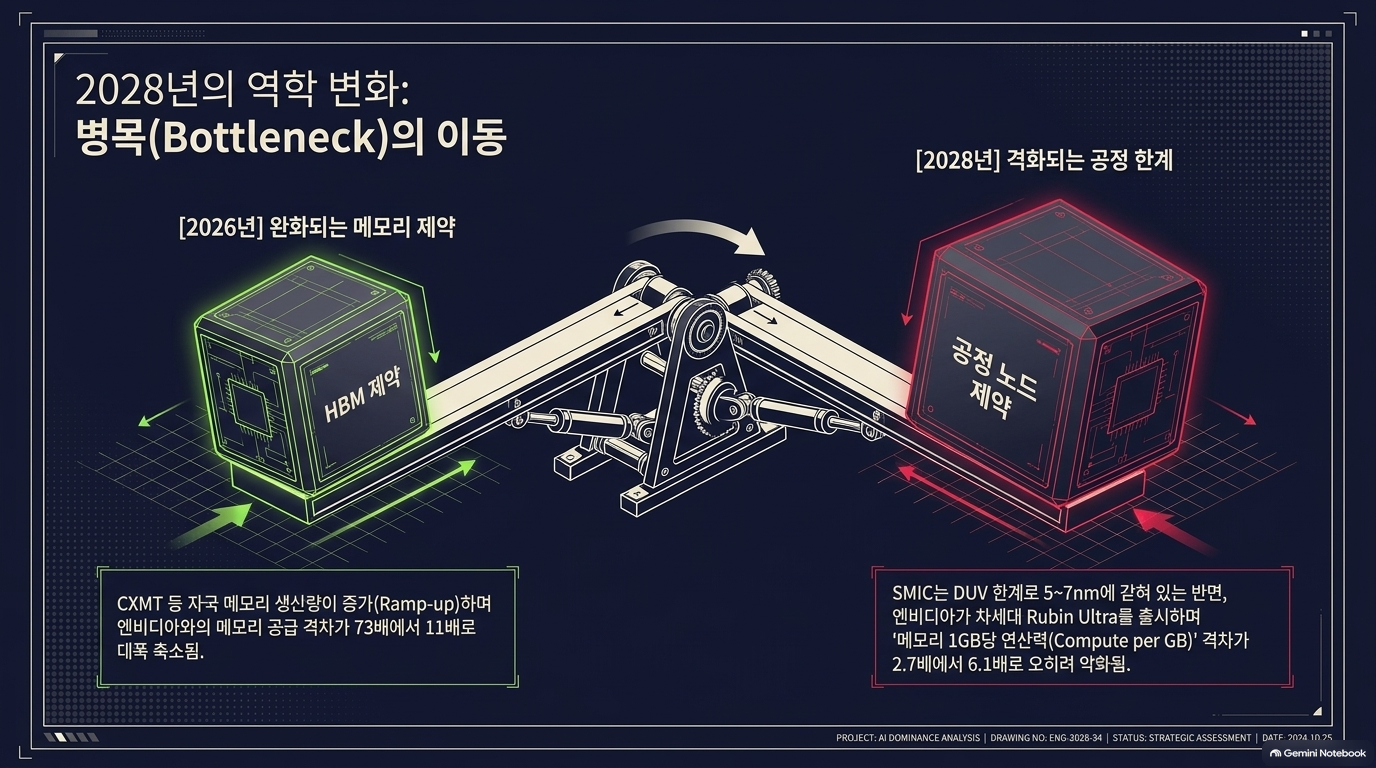
| 2028년 이후 병목 변화 | 중국산 HBM 생산이 늘면 메모리 공급 격차는 줄지만, 메모리 1GB당 탑재하는 연산 성능의 격차가 더 중요해진다는 분석입니다. 즉 “HBM을 더 확보하면 해결된다”는 구조가 아닙니다.[1] |
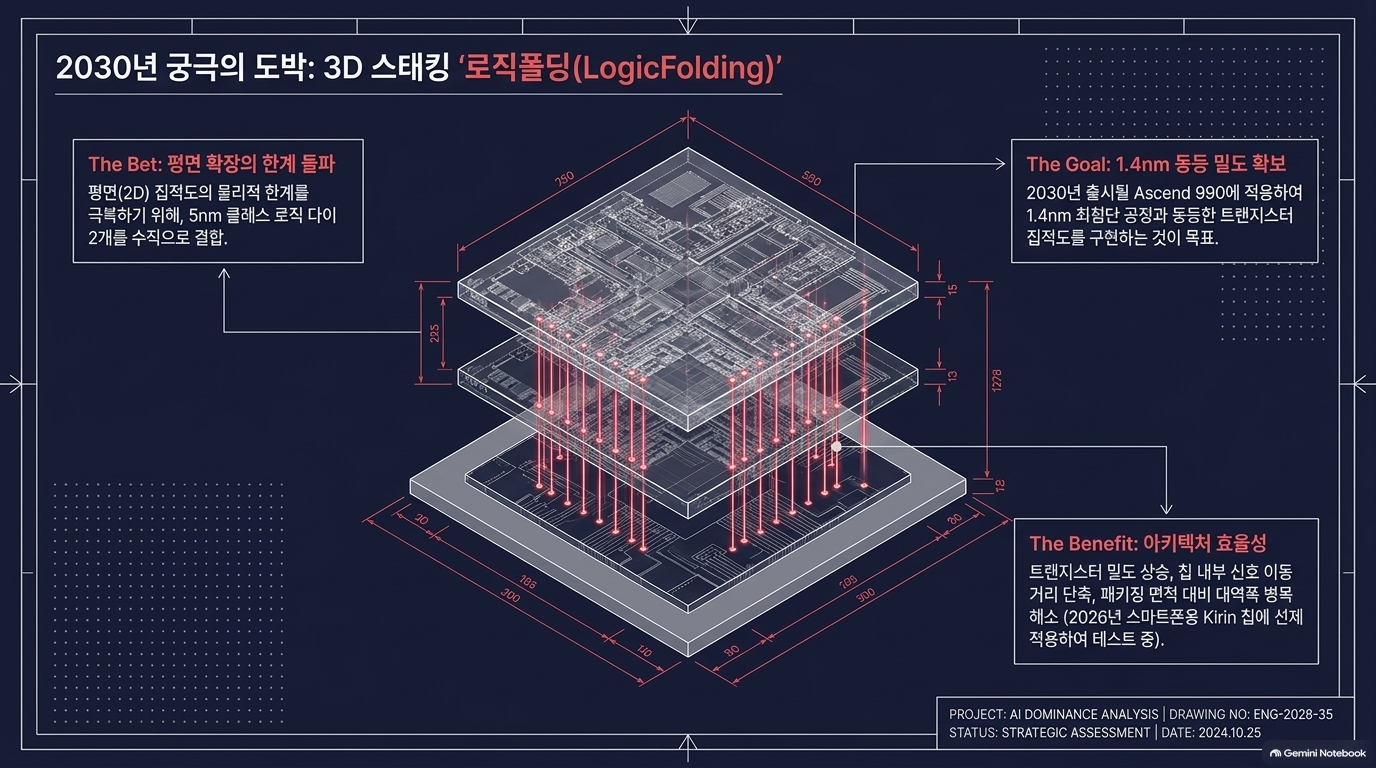
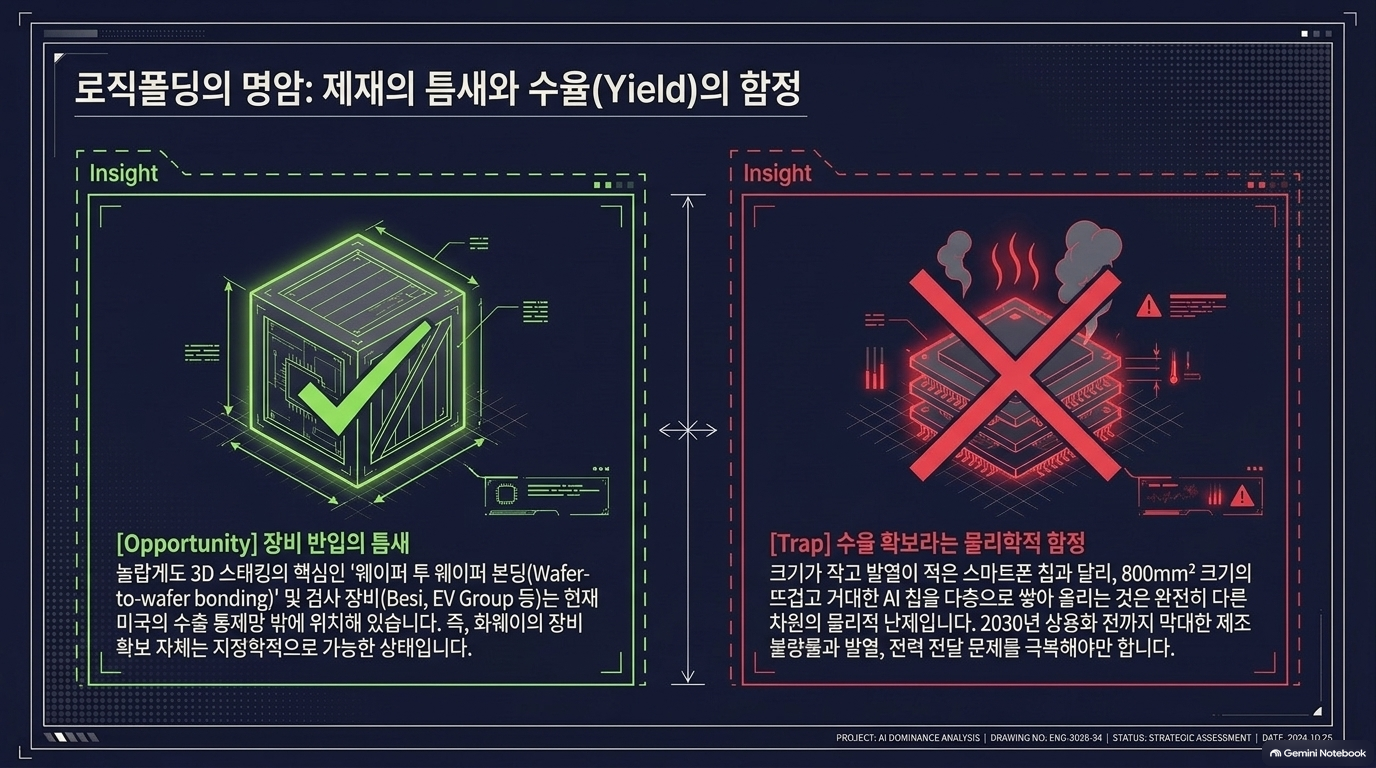
| 장기 승부수 | 화웨이는 로직을 수직 적층하는 LogicFolding으로 공정 미세화 제약을 우회하려 합니다. 다만 이를 적용한 첫 Ascend 칩은 2030년 계획이며, 대형 AI 칩에서의 수율·발열·전력·양산이 관건입니다.[1] |
이 글에서 주목할 부분
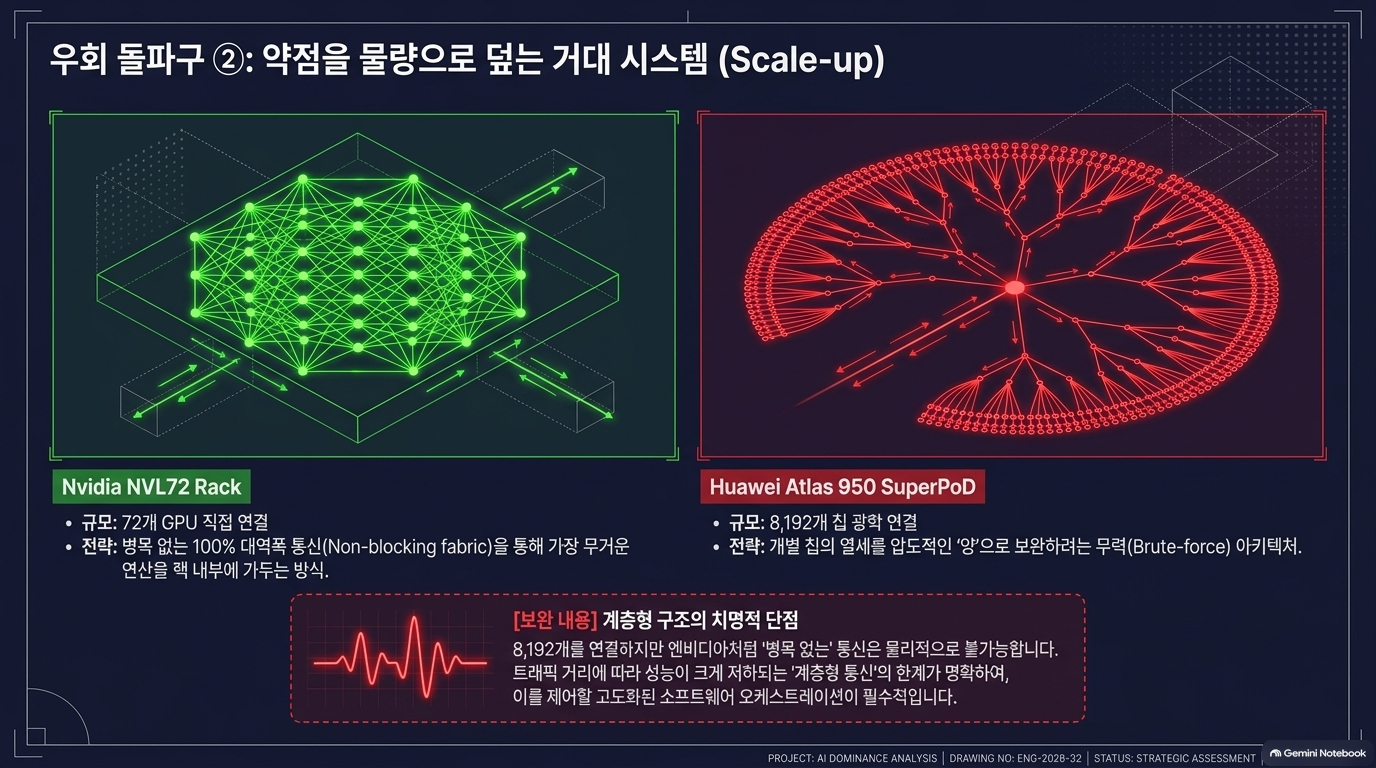
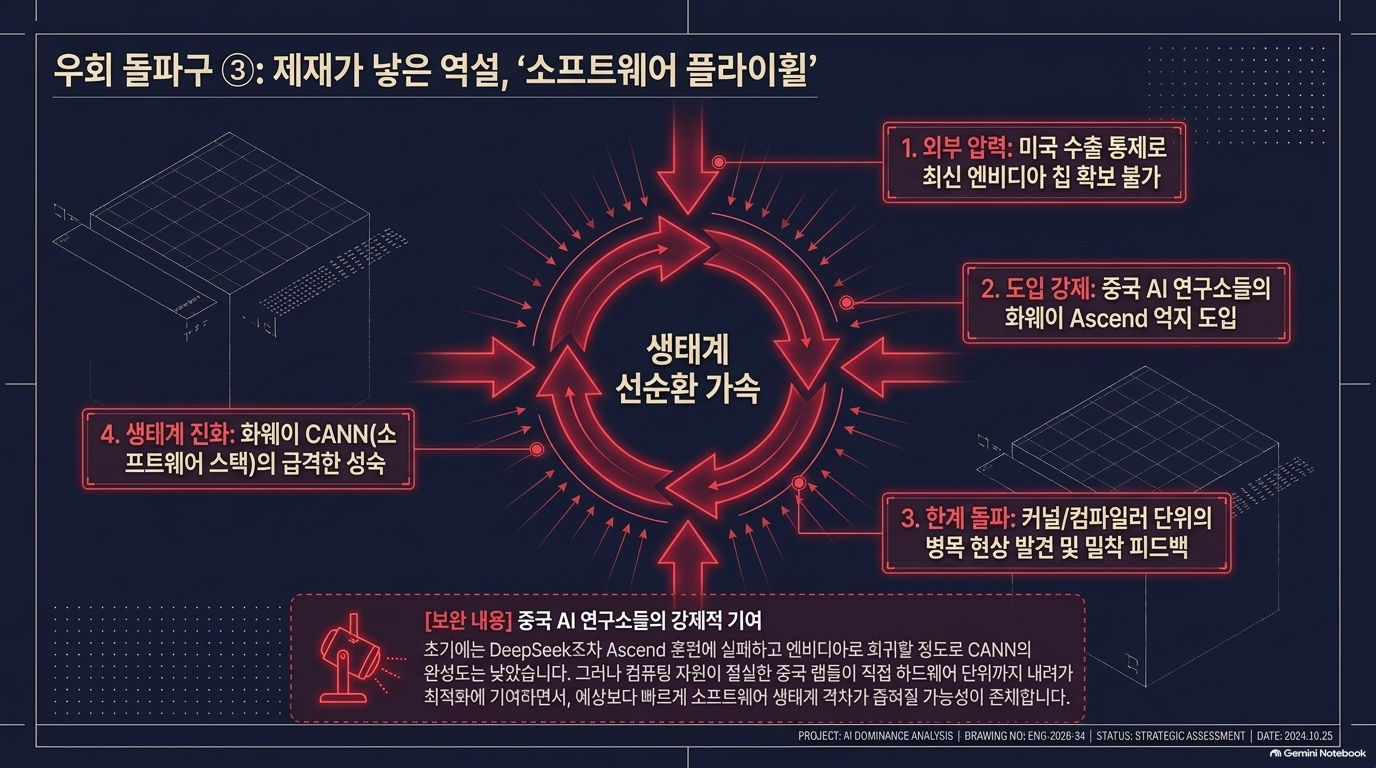
1. 화웨이의 대응은 칩 한 개의 경쟁보다 시스템 전체의 최적화에 가깝습니다. 낮은 대역폭의 메모리를 쓰는 950PR은 연산 집약적인 추론 prefill에, HBM을 쓰는 950DT는 메모리 대역폭이 중요한 작업에 맞추는 식입니다. 더 많은 칩을 SuperPoD로 묶고 CANN 소프트웨어를 개선해 칩당 열세를 보완하려는 전략도 함께 분석합니다.[1]
2. ‘8,192개 칩 연결’은 ‘72개 GPU보다 우수하다’는 뜻이 아닙니다. 원문에 따르면 엔비디아의 랙 내 연결과 화웨이의 대규모 계층형 연결은 네트워크 구조가 달라 칩 수나 칩당 접속 대역폭을 그대로 비교할 수 없습니다. 화웨이 시스템의 실제 경쟁력 판단에는 칩 간 위치별 대역폭, 혼잡, 작업 배치 및 실사용 성능 자료가 더 필요하다고 지적합니다.[1]
3. LogicFolding의 의미는 ‘1.4nm 공정 확보’가 아닙니다. 기존 5~7nm급 로직 층을 쌓아 단위 면적당 트랜지스터 밀도를 높이겠다는 목표입니다. 같은 밀도를 달성하더라도 첨단 평면 공정과 전력효율·수율·비용이 같아지는 것은 아니라는 점을 원문도 명시합니다.[1]
해석할 때의 주의점
1. 2026년 ‘4% 미만’과 2028년 ‘약 1~1.5%’는 서로 다른 시나리오입니다. 전자는 재고·비HBM 제품 등을 포함한 출하 추정이고, 후자는 주로 중국산 HBM만으로 뒷받침되는 생산량을 보는 기준입니다. 같은 조건의 시계열로 이어 붙이면 오해가 생깁니다.[1]
2. 원문의 2030년 화웨이 2,100만~3,200만 H100 상당 추정은 낙관적인 메모리 증설 가정을 둔 개략 계산이며, 비교 대상은 엔비디아의 2028년 추정 생산량입니다. “2030년 화웨이가 2030년 엔비디아의 21~32%”라는 뜻이 아닙니다.[1]
3.H100 상당량은 주로 이론상 연산 성능을 공통 척도로 환산한 값입니다. 실제 학습·추론 처리량, 메모리 병목, 네트워크, 전력, 소프트웨어 활용률까지 입증하는 실측 벤치마크는 아닙니다.[1]
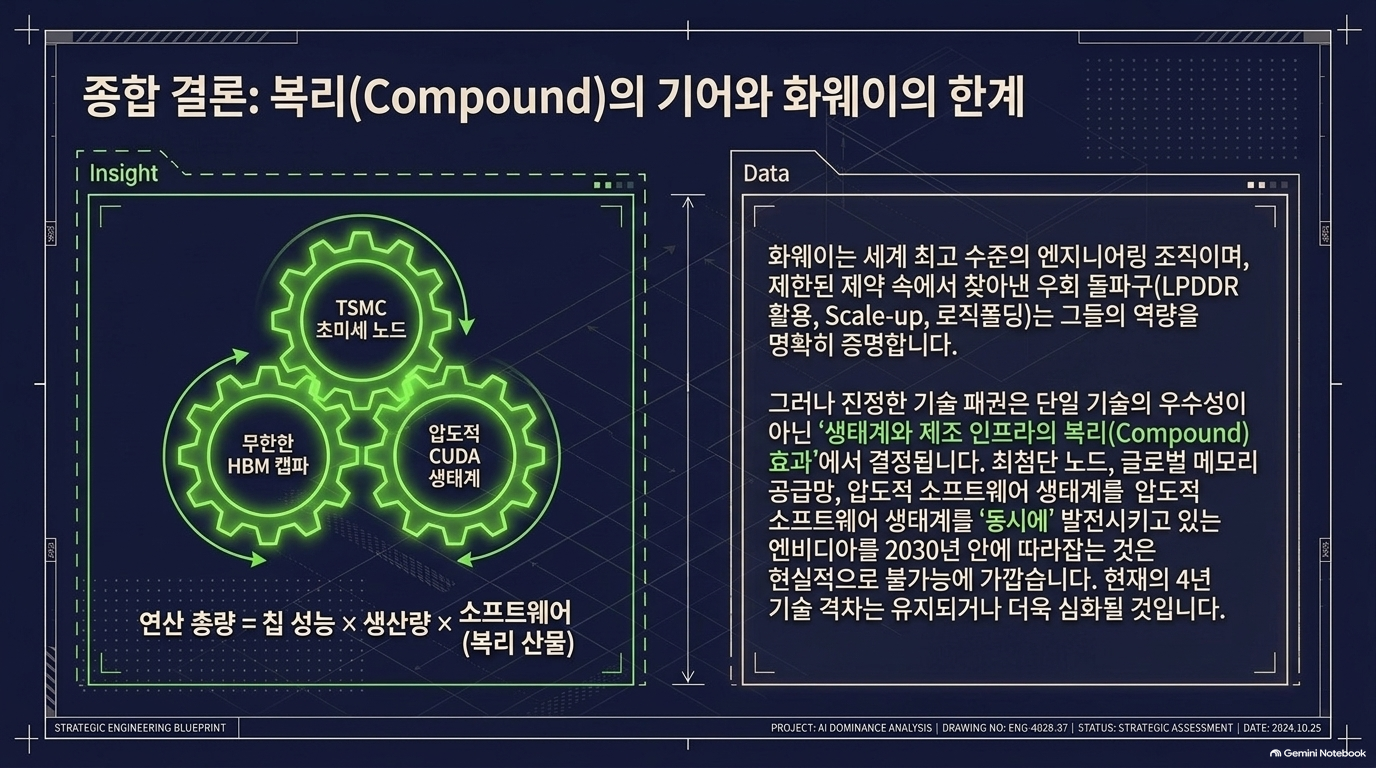
종합하면, 이 보고서의 가장 설득력 있는 통찰은 경쟁 병목이 단기에는 HBM 공급, 이후에는 HBM당 연산 성능과 시스템 활용률로 이동한다는 점입니다. 반면 2030년의 정확한 격차 수치는 양사의 미출시 제품 사양과 생산 수율에 크게 좌우되므로, 확정 전망보다는 가정이 공개된 시나리오 분석으로 활용하는 것이 적절합니다.[1]
Sources
[1] https://epoch.ai/publications/huaweis-roadmap-to-2031 — Will Huawei catch up to Nvidia by 2030?, Epoch AI
'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - Semianalysis, 인텔 팬서 레이크 분해 (0) | 2026.09.27 |
|---|---|
| AI 반도체 - Semianalysis, ClusterMAX 3.0:글로벌 GPU 클라우드 평가 보고서 (0) | 2026.09.26 |
| AI 반도체 - Semianalysis, 중국 AI 인프라 폭발 (0) | 2026.09.26 |
| AI 반도체 - TrendForce, HBM 밖으로 확장되는 KV 캐시: QLC SSD POD (0) | 2026.09.24 |
| AI 반도체 - HBM을 넘어선 3D-DRAM: AI 추론 가속기의 메모리 병목을 풀 수 있을까? (0) | 2026.09.23 |