https://newsletter.semianalysis.com/p/clustermax-30-the-industry-standard
2026.9.24
[ClusterMAX 3.0: The Industry Standard GPU Cloud Rating System Returns]
이 보고서는 SemiAnalysis에서 발표한 ClusterMAX 3.0으로, 전 세계 GPU 클라우드 서비스 제공업체들의 역량을 심층적으로 분석하고 순위를 매긴 업계 표준 평가서입니다. 저자들은 단순한 사양 비교를 넘어 실제 구동 성능, 네트워크 안정성, 하드웨어 신뢰성, 그리고 보안성이라는 네 가지 핵심 축을 바탕으로 77개 기업을 직접 테스트하여 플래티넘부터 '참가상' 수준까지 등급을 분류했습니다. 특히 인공지능 모델 학습에 필수적인 관리형 클러스터의 품질을 검증하기 위해 파괴적인 장애 유도 테스트와 복합적인 벤치마크를 수행하며, 급변하는 엔비디아 블랙웰(Blackwell) 세대로의 전환기에 대응하는 공급업체들의 기술적 성숙도를 집중적으로 조명합니다. 결과적으로 이 자료는 거대한 자본이 투입되는 AI 인프라 시장에서 기업들이 최적의 연산 자원을 선택하고 위험을 관리할 수 있도록 돕는 포괄적인 기술 지침서이자 시장 분석가들을 위한 전략적 보고서입니다.
첨부 보고서는 원문의 핵심인 하드웨어 성능 → 운영 신뢰성 → 관리형 서비스 품질의 이동을 잘 포착했습니다. 다만 이 결과를 더 깊게 해석하려면 사업자 순위 자체보다 다음 질문이 중요합니다.
GPU가 정상 동작하는 순간의 최고 성능이 아니라, 계약 기간 동안 고객의 학습·추론 작업을 얼마나 안정적으로 완료시키는가?
이는 기술 벤치마크인 동시에 운영체계, 계약 구조, 자본조달 능력을 함께 평가하는 문제입니다.[1]
1. 평가 대상은 ‘GPU’가 아니라 ‘작업 완료 능력’
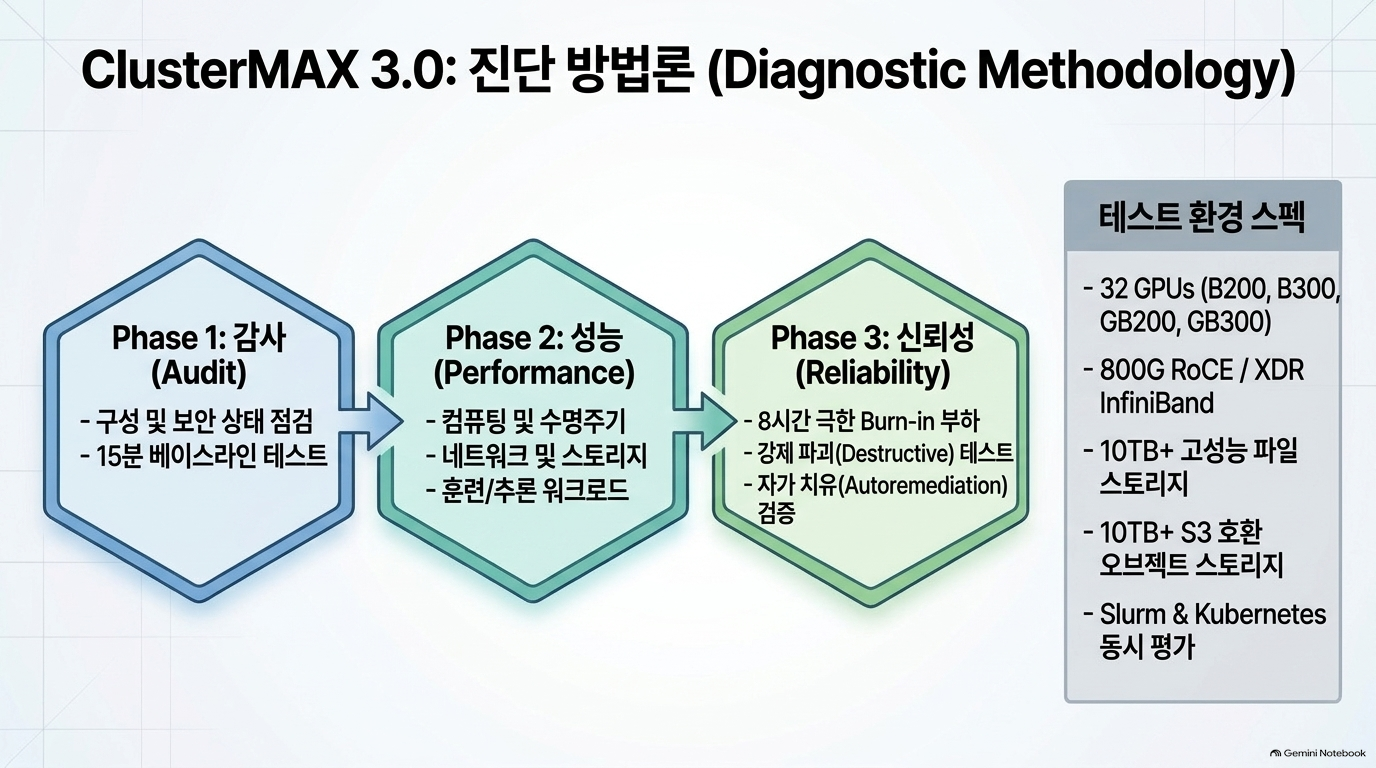
첨부 보고서 p.4는 감사·성능·신뢰성의 3단계를 제시합니다. 이를 구매자 관점에서 재해석하면 다음과 같습니다.[1]
| 단계 | 실제로 답하는 질문 | 통과해도 남는 위험 |
| 구성 감사 | 필요한 GPU·드라이버·네트워크·스토리지·보안 설정이 존재하는가? | 설정이 맞아도 부하 상황에서 성능이 나오지 않을 수 있음 |
| 성능 시험 | 연산, 통신, I/O 및 실제 학습·추론 작업이 목표 수준에 도달하는가? | 단기 성능이 좋아도 장시간 운전 중 장애가 날 수 있음 |
| 신뢰성 시험 | 오류가 발생했을 때 감지·격리·복구하고 작업을 재개할 수 있는가? | 짧은 시험만으로 장기 운영 실적 전체를 증명할 수 없음 |
원문은 8시간 동안 GPU 연산과 네트워크 통신에 동시에 부하를 가하고, 오류를 주입한 뒤 스케줄러와 헬스체크의 반응을 본다고 설명합니다. 특히 테스트 중 발생하는 실제 하드웨어 장애만 기다리지 않고 인위적으로 오류를 넣는 이유는, 제한된 시험 기간에도 복구 체계를 관찰하기 위해서입니다.[1]
심화 시사점: GPU 조달에서 ‘장비 수량’, ‘이론 FLOPS’, ‘단일 NCCL 최고 대역폭’은 공급능력의 일부일 뿐입니다. 구매자가 확보해야 하는 성능은 작업 실패·재시작·체크포인트 복원·대기 시간을 포함한 유효 작업량(goodput)입니다. 따라서 입찰 성능시험과 서비스 수락시험을 동일한 문서로 취급해서는 안 됩니다.
2. Blackwell/NVL72 전환은 장애의 ‘단위’를 바꾼다
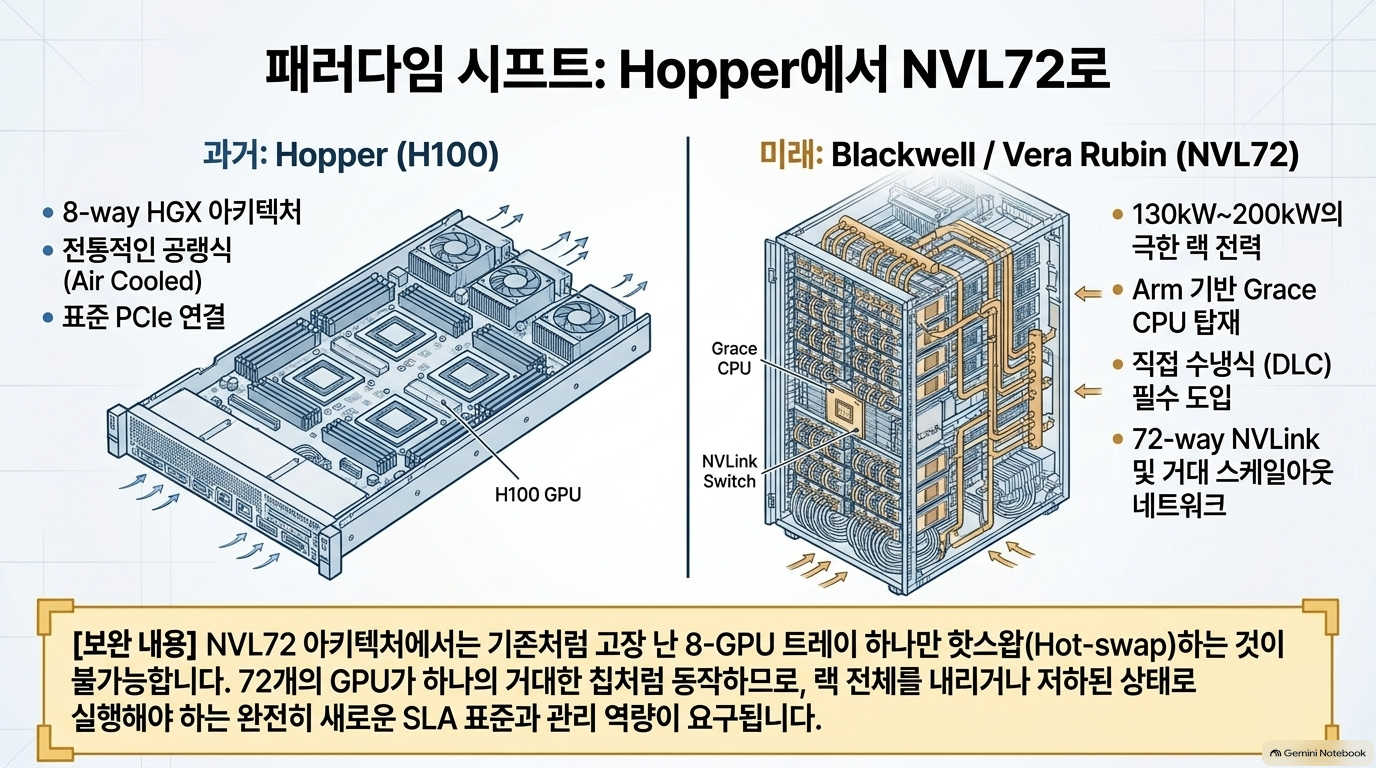
첨부 보고서 p.3의 핵심 방향은 맞지만, “고장 난 8-GPU 트레이를 핫스왑할 수 없다”는 설명은 구성 단위가 부정확합니다. 원문은 HGX를 8-GPU 노드, NVL72를 4-GPU 노드 18개로 이루어진 랙으로 구분합니다. NVL72에서는 장애 노드를 별도 예비 노드로 바꿔 같은 NVLink 도메인에 즉시 편입하는 방식이 어려워, 손상된 상태로 랙을 운전할지·작업 배치를 바꿀지·수리할지를 결정해야 합니다.[1]
이 차이는 SLA에 직접 영향을 줍니다.
- HGX형 클러스터: 장애 감지 → 노드 격리 → 예비 노드 교체 → 작업 재개 시간을 중점 측정.
- NVL72형 클러스터: 노드 단위 장애뿐 아니라 NVLink 도메인과 랙에서 사용 가능한 GPU 집합을 측정.
- 토폴로지 민감 작업: 물리적으로 사용 가능한 GPU 수가 남아 있어도, 필요한 연속된 토폴로지를 확보하지 못하면 작업은 수행되지 않을 수 있음.
원문은 일례로 GB300 NVL72에 대해 노드별 SLA와 랙별 상태를 함께 고려하는 ‘NVL64+’ 관행을 소개합니다. 이는 모든 사업자에 적용되는 공인 표준값이 아니라, SemiAnalysis가 관찰한 계약 설계 패턴입니다.[1]
도출되는 계약 원칙: 가용률의 분모를 ‘GPU가 켜져 있는 시간’으로만 잡지 말고, 합의된 규모와 토폴로지의 작업을 스케줄링할 수 있는 시간까지 정의해야 합니다. 그렇지 않으면 공급자는 GPU가 일부 살아 있다는 이유로 정상 서비스를 주장하고, 고객은 실제 작업을 실행하지 못하는 분쟁이 생길 수 있습니다.
3. 자동 복구는 ‘빠른 재부팅’이 아니라 ‘올바른 조치’다
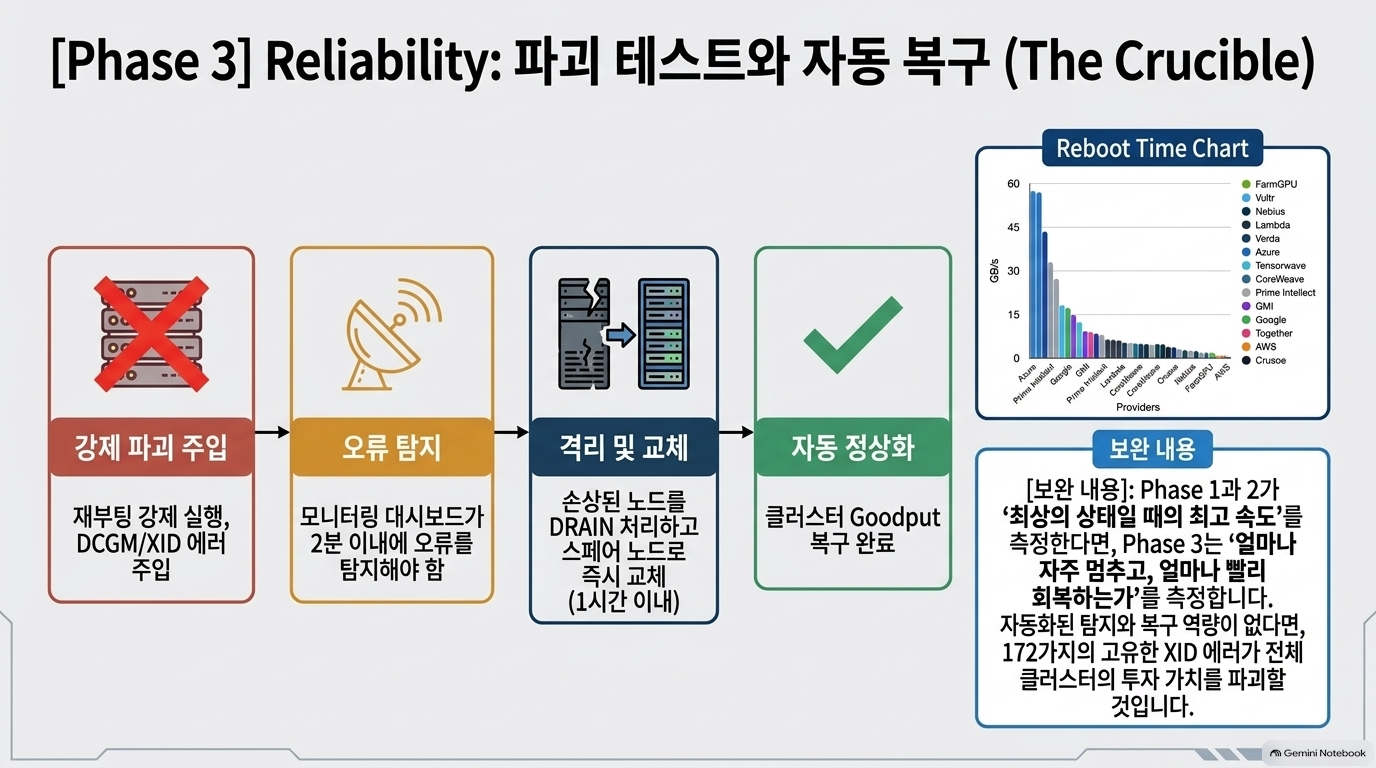
첨부 보고서 p.9는 2분 내 감지·1시간 내 교체라는 흐름으로 설명합니다. 그러나 원문의 해당 기대치는 표준 HGX 노드의 핫스페어 교체와 NVL72의 장애 격리를 구분합니다. 모든 NVL72 장애를 1시간 내 노드 교체 대상으로 해석하면 잘못된 SLA가 됩니다. 실제로 원문에서 Nebius의 GB300 노드는 오류 감지는 빨랐지만 자동 복귀까지 8시간 40분이 걸렸고, 저자들은 자동 복귀 과정 자체를 긍정적으로 평가했습니다.[1]
따라서 자동 복구 역량은 하나의 시간값이 아니라 아래 사건 기록으로 검증해야 합니다.
| 사건 단계 | 확인할 증적 | 잘못 설계했을 때의 위험 |
| 탐지 | XID/DCGM·네트워크·스토리지 이벤트와 최초 발생 시각 | 결함을 정상으로 표시 |
| 판정 | 오류 종류와 작업 영향 범위의 매핑 | 경미한 오류마다 전체 노드를 재부팅 |
| 격리 | DRAIN·cordon 및 신규 작업 차단 기록 | 불량 노드에 작업을 계속 배치 |
| 복구 | 재부팅·수리·교체·재편입의 근거와 시각 | 대시보드는 정상이나 실제 작업은 실패 |
| 작업 재개 | 체크포인트 복원과 학습·추론 재개 기록 | 인프라 복구를 고객 업무 복구로 오인 |
AWS 시험 사례는 역설을 잘 보여줍니다. 헬스체크용 DaemonSet이 GPU 노드에 배치되지 못하자 정상 노드를 불량으로 판단해 교체를 반복했고, 다른 조건에서는 필요하지 않은 IMEX 구성의 실패까지 심각한 오류로 취급했습니다. 자동화의 수준이 높아도 판정 규칙이 틀리면 장애를 줄이는 대신 만들어낼 수 있습니다.[1]
4. 성능 병목은 개별 장비보다 계층 간 연결에서 나타난다
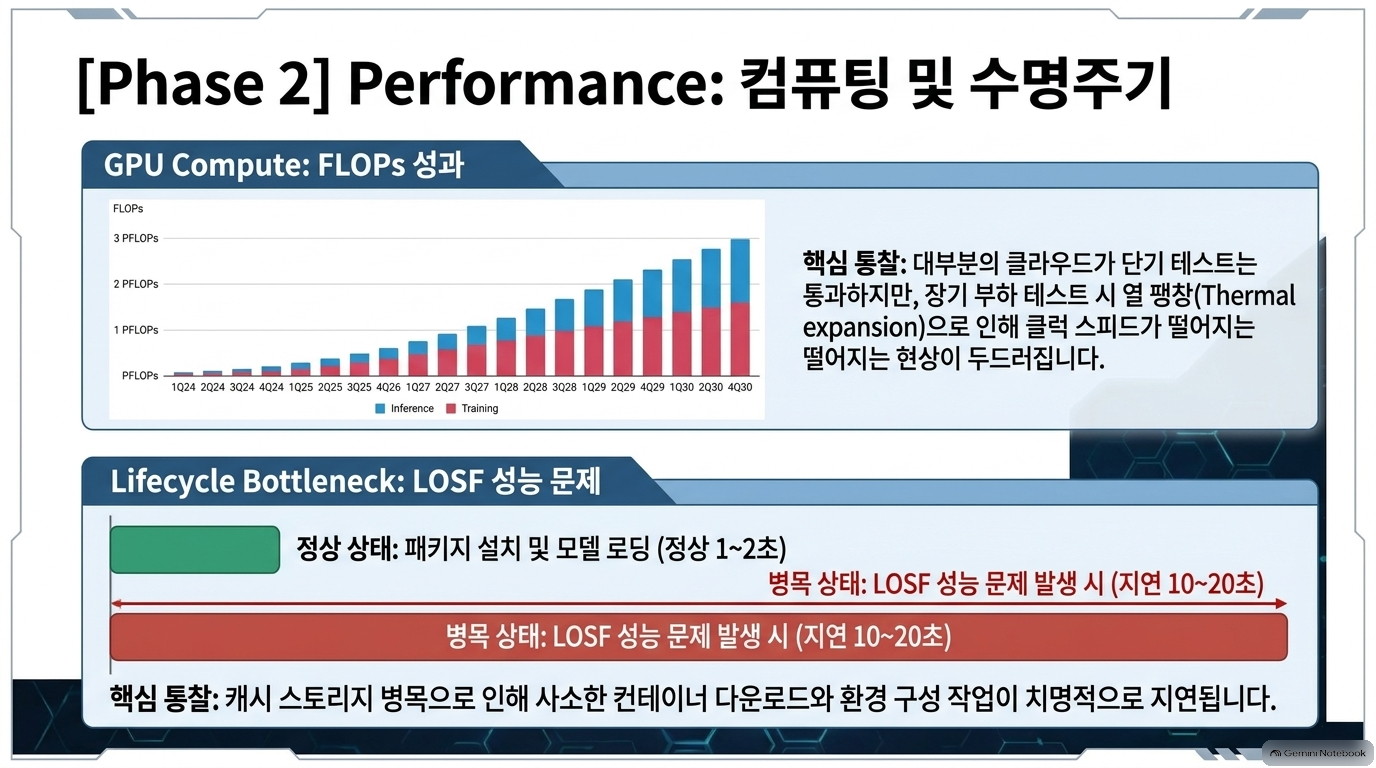
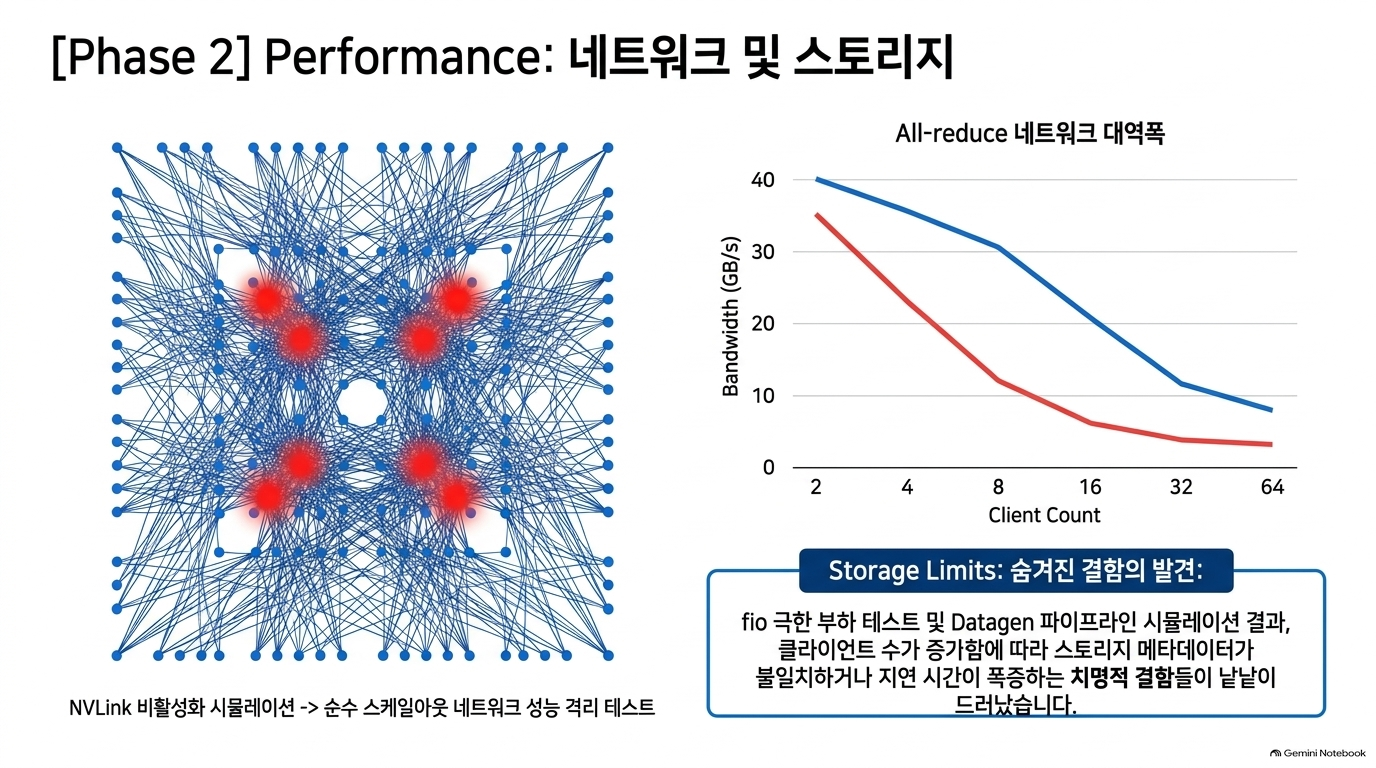
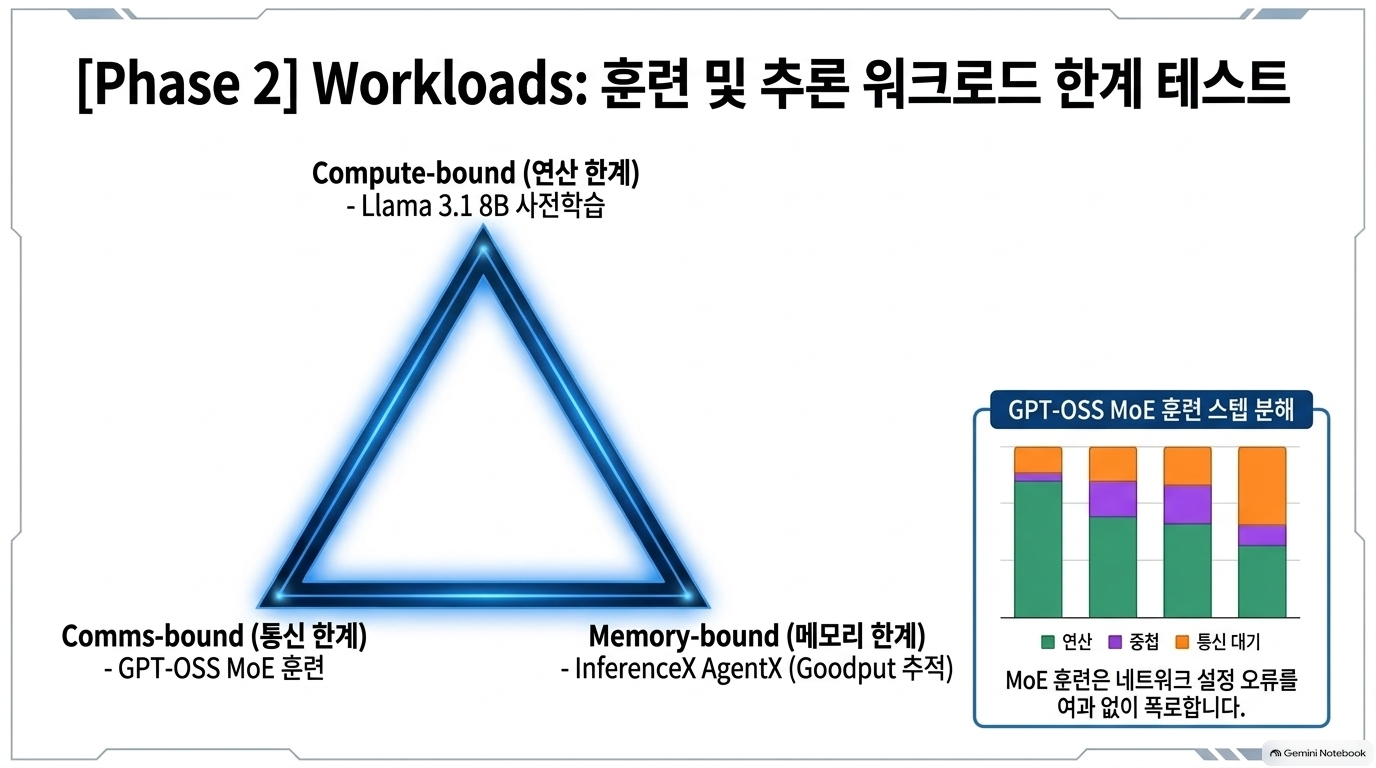
첨부 보고서 p.6~8은 연산·네트워크·스토리지·실제 워크로드를 나눠 설명합니다. 더 중요한 분석 단위는 계층 간 인과관계입니다.[1]
GPU 정상 → RDMA 장치 할당 오류 → NCCL 통신 정지 → MoE 학습 지연 → GPU 유휴 증가 → 유효 작업량 감소
원문은 Google Cloud 시험에서 NCCL의 자동 GID 선택 때문에 작업이 멈췄고 설정 수정으로 동작한 사례, 일부 환경에서 플러그인 설정이 성능에 영향을 준 사례를 제시합니다. 스토리지 역시 단순 최대 처리량보다 클라이언트 수를 늘렸을 때의 지연, 메타데이터 정합성, 체크포인트 저장·복원 결과가 중요합니다.[1]
도출되는 수락시험 설계: 벤치마크별 합격 판정만으로 끝내지 말고, 동일 환경에서 ① 통신 집약 MoE 학습, ② 체크포인트 저장·복원, ③ 다중 노드 추론, ④ 장애 발생 후 재개를 연결해 시험해야 합니다. 그래야 특정 계층의 결함이 최종 워크로드에 미치는 영향을 볼 수 있습니다.
5. 등급은 기술 점수인 동시에 ‘관리 책임의 범위’를 반영한다
첨부 보고서 p.10~12의 사업자 비교에서 중요한 것은 AWS와 CoreWeave의 GPU 스펙 차이가 아닙니다. 고객이 어느 범위까지 직접 통합·설정·복구해야 하는가입니다.[1]
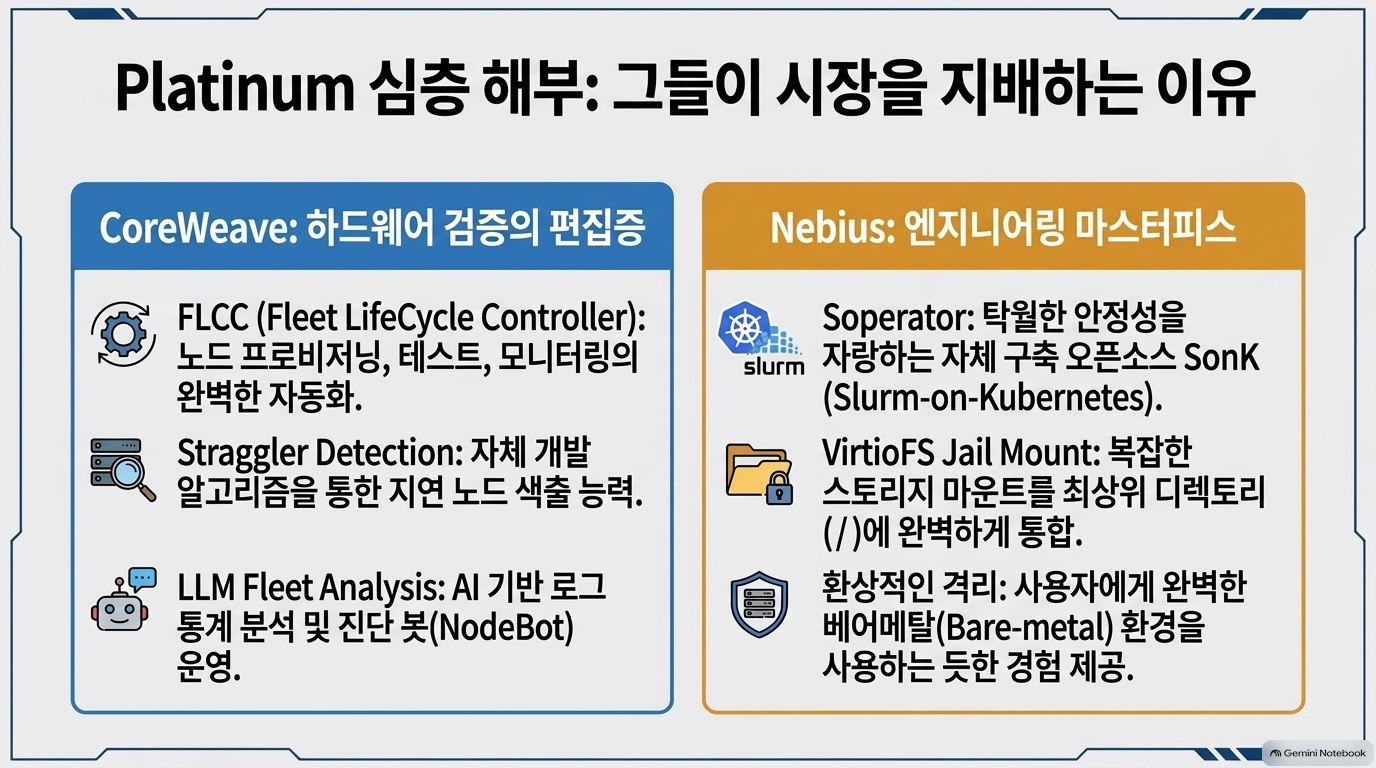
- CoreWeave: 노드 투입 전 검증, 유휴 노드의 반복 번인, 지연 노드 탐지 등 운영 지식을 제품 내부에 축적.
- Nebius: Soperator와 스토리지 마운트 방식으로 Slurm-on-Kubernetes 사용 시의 운영 마찰을 줄임. 다만 스토리지 문제가 시험 중 발견되어 조정됐고, NVL72 자동 복귀 속도에도 개선 여지가 남음.
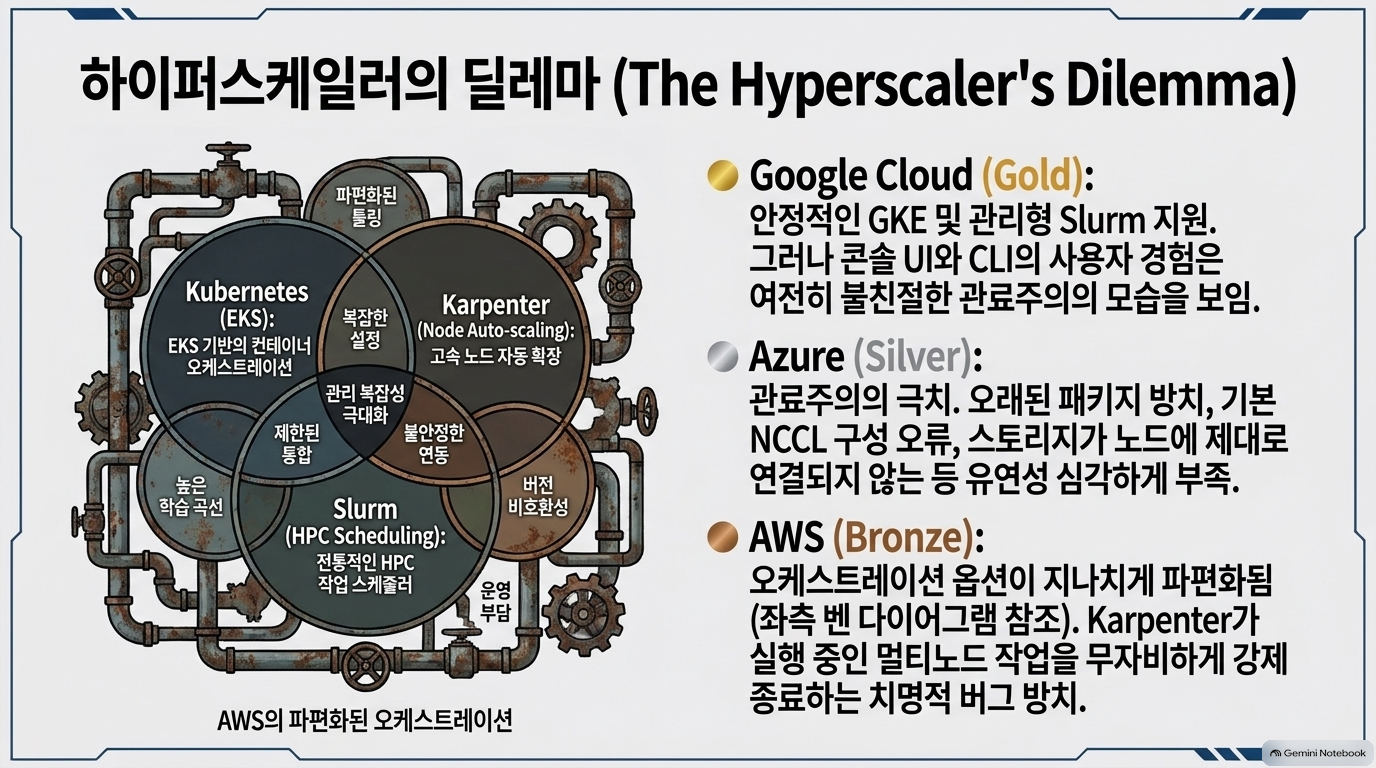
- AWS: 풍부한 서비스 선택지와 기술 역량에도, 서비스 간 연결과 기본 구성이 사용자의 작업을 방해한 사례가 보고됨.
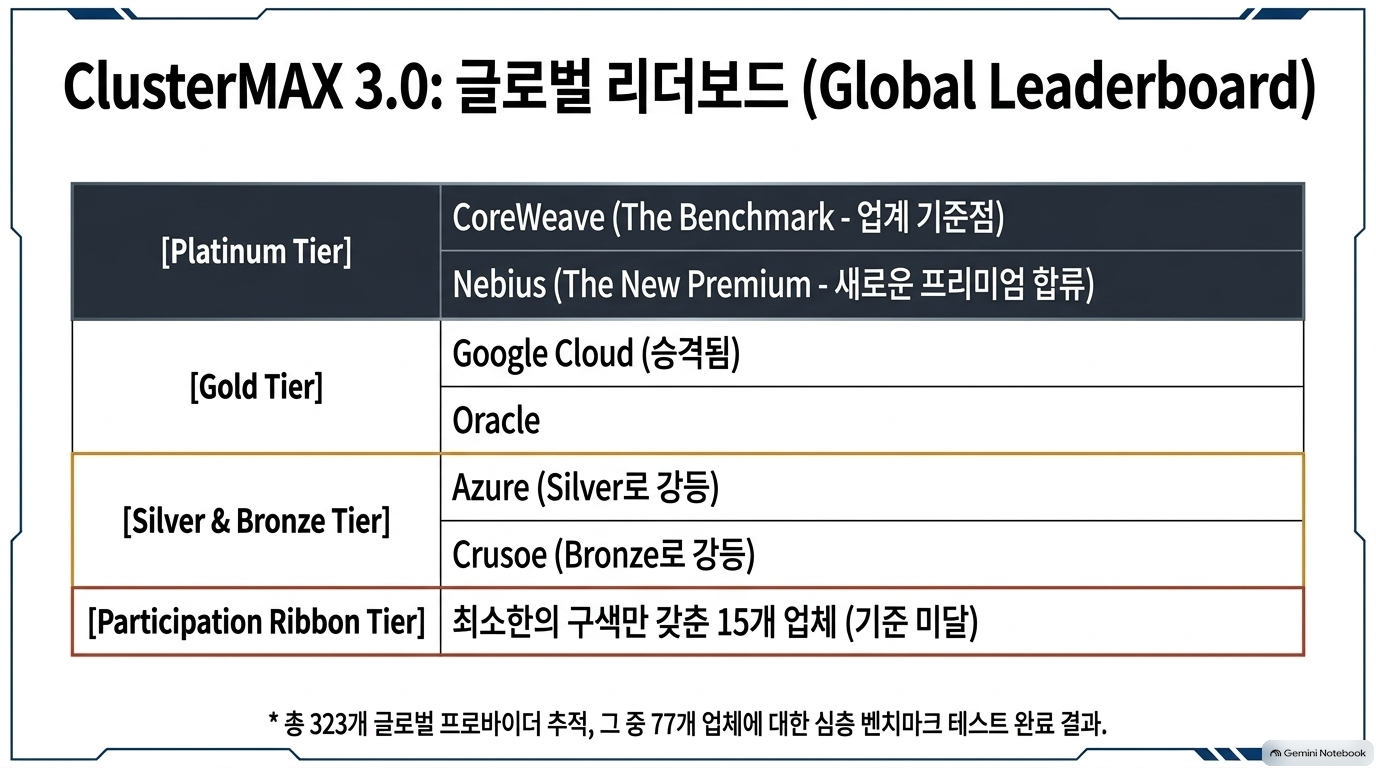
즉 Platinum은 ‘무결점’, Bronze는 ‘GPU 성능 불량’이라는 뜻이 아닙니다. 공급자가 운영 복잡성을 얼마나 흡수해 고객에게 일관된 서비스로 제공하는가에 관한 평가로 읽는 편이 정확합니다. 또한 평가 대상은 관리형 클러스터이며, 베어메탈 공급이나 토큰 과금형 추론 서비스 전체의 순위가 아닙니다.[1]
6. 기술·금융·계약은 하나의 위험 사슬이다
첨부 보고서 p.13의 자본조달 논의는 기술 분석의 부록이 아닙니다. 원문에 따르면 대규모 클러스터 사업에서는 고객 계약의 신용도, 구축 일정, 계약 해지권, 대출 조건이 서로 연결됩니다.[1]
이를 구매자 관점에서 풀면 다음과 같습니다.
구축 지연 → 수락시험 지연 → 고객 사용 개시 지연 → 매출·상환계획 영향 → 공급자 재무 부담 증가 → 예비품·지원인력·증설 여력에 압박 가능성.
마지막 연결은 모든 사업자에게 실증된 사실이 아니라 계약 실사에서 검증해야 할 위험 경로입니다. 따라서 구매 시 기술 제안서와 가격표만 비교하지 말고, 확정된 전력·장비 인도 일정, 예비부품 확보 방식, 현장 수리 권한, 구축 실패 시 해지·대체 조달 조항을 함께 검토해야 합니다. 특히 ‘발표한 MW’와 ‘수락시험을 통과해 제공 가능한 GPU 용량’을 분리할 필요가 있습니다.[1]
7. 첨부 보고서를 인용할 때 바로잡을 부분
| 위치 | 보완 판단 | 권장 표현 |
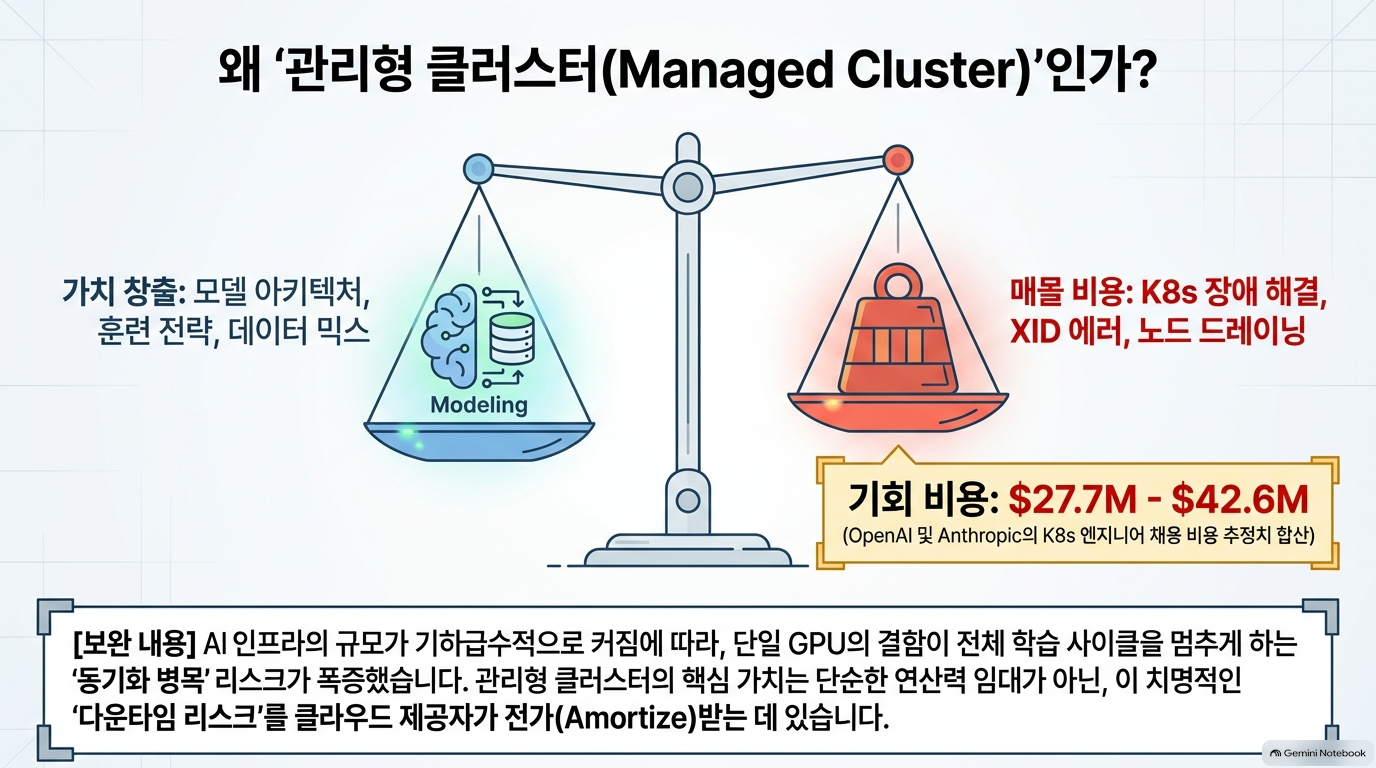
| p.2 | [보완 필요] 2,770만~4,269만 달러는 관리형 클러스터의 절감액이나 기회비용 실측치가 아님 | 원문에서 집계한 OpenAI·Anthropic의 Kubernetes 관련 공개 채용 공고 급여 범위 합계 |
| p.3 | [보완 필요] NVL72의 고장 단위를 ‘8-GPU 트레이’로 설명 | HGX 8-GPU 노드와 NVL72 4-GPU 노드/랙을 구분 |
| p.9 | [보완 필요] ‘2분 탐지·1시간 교체’를 모든 장애에 일률 적용 | 시스템 유형·오류 종류별 탐지, 격리, 교체·복귀 기준을 별도로 정의 |
| p.10 | [보완 필요] ‘77개 업체 심층 벤치마크 테스트 완료’는 원문보다 강한 주장 | 77개 사업자 상세 검토, 323개 시장 추적. 모두에게 동일한 실측 시험을 마쳤다는 뜻은 아님 |
| p.12 | [보완 필요] Karpenter가 ‘멀티노드 작업을 무자비하게 강제 종료’한다는 일반화 | 시험한 AWS 구성에서 예약 종료시각보다 앞서 4노드 MPIJob이 강제 퇴거된 사례로 한정 |
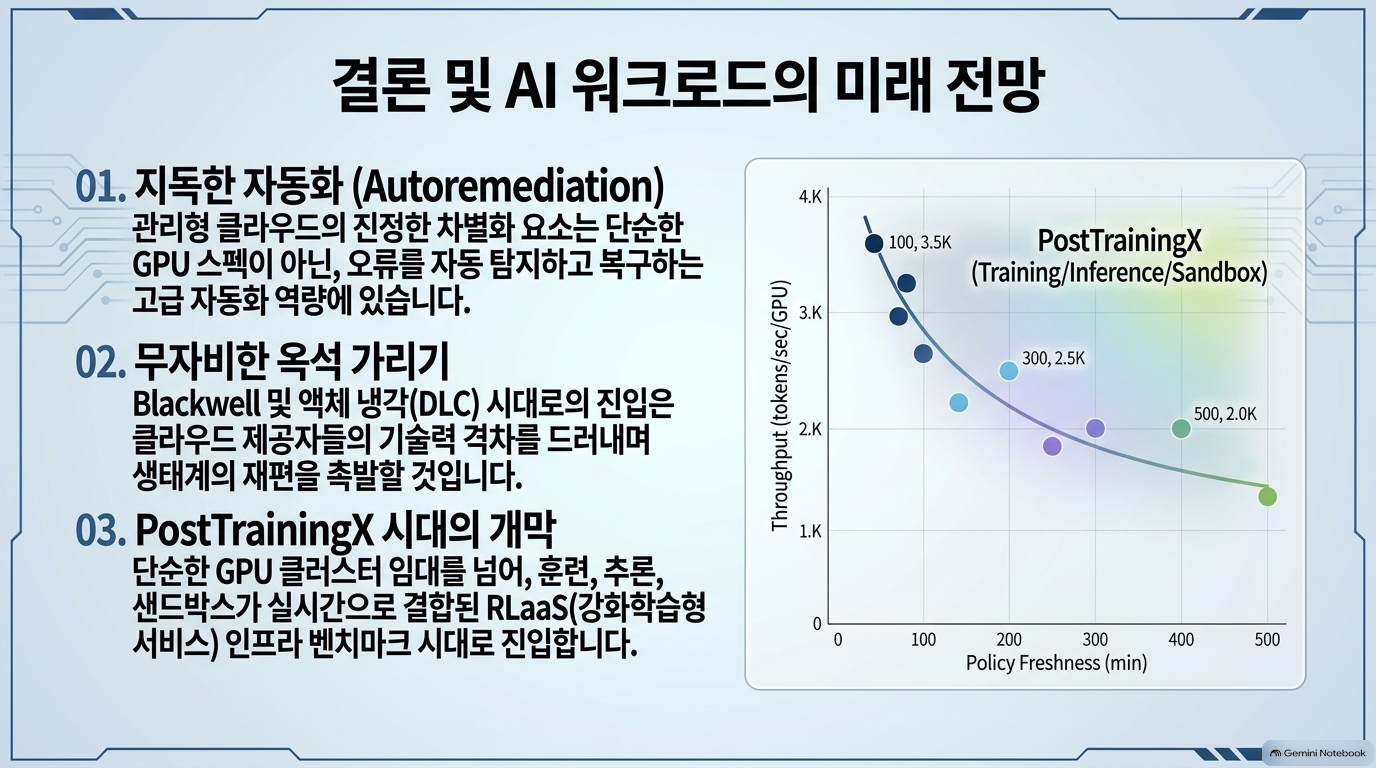
| p.6·9·15 도표 | [확인 필요] 그래프의 데이터 출처·재현 방법이 표시되지 않음 | 원자료가 확보되지 않으면 실측 비교 그래프가 아닌 개념도로 명시 |
특히 p.9의 사업자별 ‘Reboot Time Chart’는 막대와 업체명이 보이지만 각 막대의 측정값·시험 조건·원자료 연결이 없습니다. p.15의 PostTrainingX 산점도도 실제 사업자 측정 결과로 인용해서는 안 됩니다. 원문은 PostTrainingX를 향후 확대할 평가 체계로 설명합니다.[1]
최종 판단과 적용 우선순위
이 보고서에서 가장 가치 있는 메시지는 “GPU 클라우드 품질의 최소 단위를 GPU가 아니라 복구 가능한 워크로드로 바꾸자”는 것입니다. 이를 실제 발주·실사에 적용한다면 우선순위는 다음과 같습니다.
- [높음] 수락 기준 재정의: GPU 수량 외에 토폴로지, 실제 학습·추론 작업 완료, 체크포인트 복원, 장애 후 재개를 포함.
- [높음] 장애별 SLA 분리: HGX·NVL72의 장애 단위와 탐지·격리·복귀 기준을 구분하고, 고객 작업에 미친 영향을 기록.
- [높음] 교차계층 시험: GPU·네트워크·스토리지·스케줄러를 개별 통과시키는 데 그치지 않고 동시 부하와 오류 주입으로 연결 검증.
- [중간] 공급 지속성 실사: 설치 용량·실제 가용 용량, 현장 예비품, 구축 일정과 계약상 구제수단 확인.
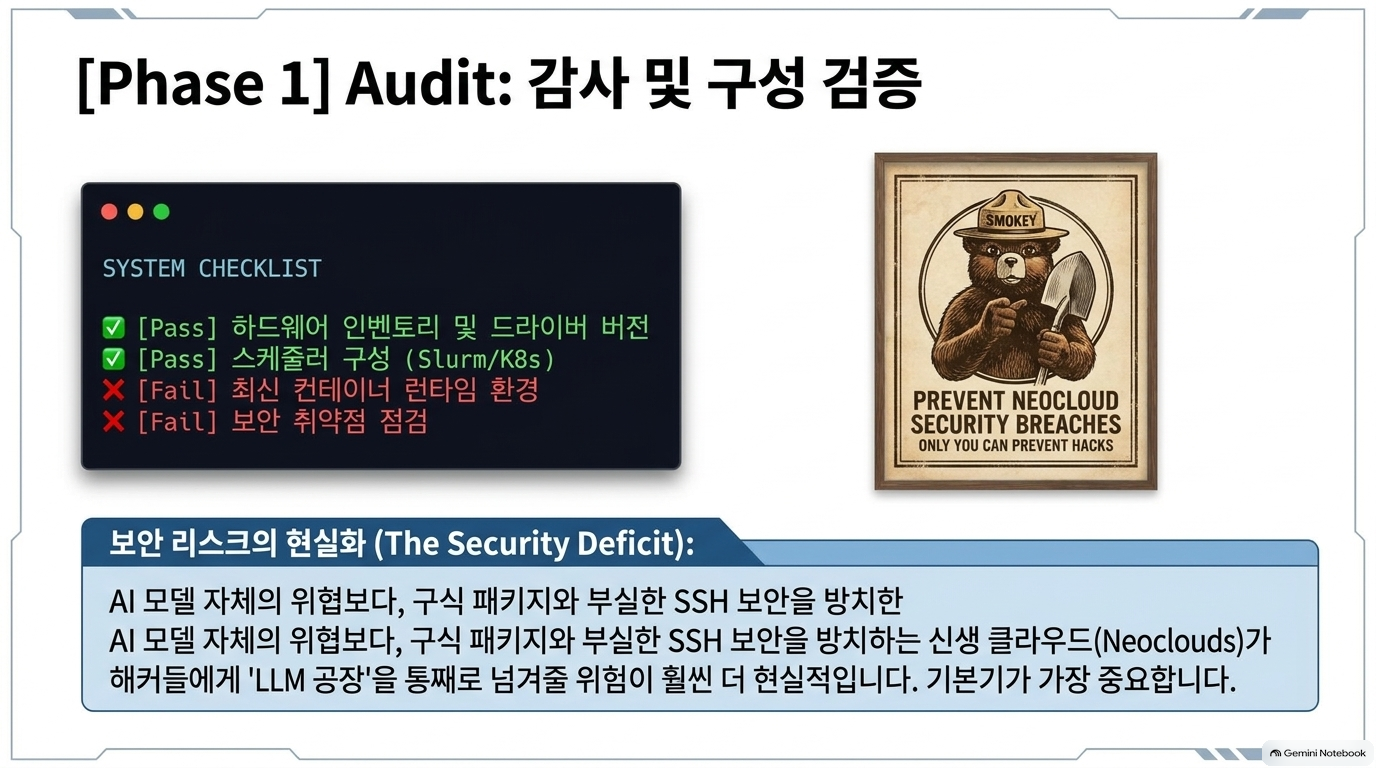
- [중간] 공개 도구의 역할 한정: cmax audit는 구성 상태를 확인하는 출발점이지, 전체 성능·장기 신뢰성·사업자 등급을 재현하는 공개 검증 패키지는 아님.[1][3]
근거 범위: 위 사업자별 사례는 SemiAnalysis가 공개한 시험과 인터뷰에 대한 분석입니다. 개별 사업자의 현재 모든 리전·상품·계약에 동일하게 적용된다는 결론은 아니며, 조달 결정에는 대상 구성의 별도 실측과 계약 확인이 필요합니다.[1]
Sources
- 첨부 보고서: 2026 Global GPU Cloud Diagnostic, pp. 2–15.
- [1] SemiAnalysis, ClusterMAX 3.0: The Industry Standard GPU Cloud Rating System Returns
- [2] ClusterMAX, Evaluation Criteria
- [3] SemiAnalysisAI, 공개 ClusterMAX CLI 저장소



'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - Semianalysis, 인텔 팬서 레이크 분해 (0) | 2026.09.27 |
|---|---|
| AI 반도체 - EPOCH AI, 화웨이와 엔비디아의 연간 연산 공급량 격차 (0) | 2026.09.26 |
| AI 반도체 - Semianalysis, 중국 AI 인프라 폭발 (0) | 2026.09.26 |
| AI 반도체 - TrendForce, HBM 밖으로 확장되는 KV 캐시: QLC SSD POD (0) | 2026.09.24 |
| AI 반도체 - HBM을 넘어선 3D-DRAM: AI 추론 가속기의 메모리 병목을 풀 수 있을까? (0) | 2026.09.23 |