https://newsletter.semianalysis.com/p/intel-panther-lake-teardown
2026.9.26
[Intel Panther Lake Teardown
Taking a look inside Intel’s latest consumer chip and 18A process node]
이 보고서는 인텔의 차세대 공정 기술인 18A 노드를 적용한 팬서 레이크(Panther Lake) 칩의 내부 구조를 정밀 분석한 기술 해설서입니다. 인텔은 업계 최초의 후면 전력 공급(BSPD) 방식인 파워비아(PowerVia)와 새로운 4개 층의 리본펫(RibbonFET) 구조를 도입함으로써, 반도체 제조 분야의 기술적 주도권을 되찾으려는 강력한 의지를 보여주고 있습니다. 분석팀은 칩을 직접 분해하여 전력망과 신호망을 분리하는 혁신적인 상호 연결 구조를 검증하고, 이를 경쟁사인 삼성전자의 SF2 공정과 비교하며 각사의 재료 선택과 공정 설계의 차이점을 상세히 조명합니다. 궁극적으로 이 자료는 미세 공정의 한계를 극복하기 위해 도입된 게이트-올-어라운드(GAA) 기술과 고급 패키징 기법이 실제 실리콘 칩에서 어떻게 구현되었는지를 보여주는 중요한 이정표 역할을 합니다.
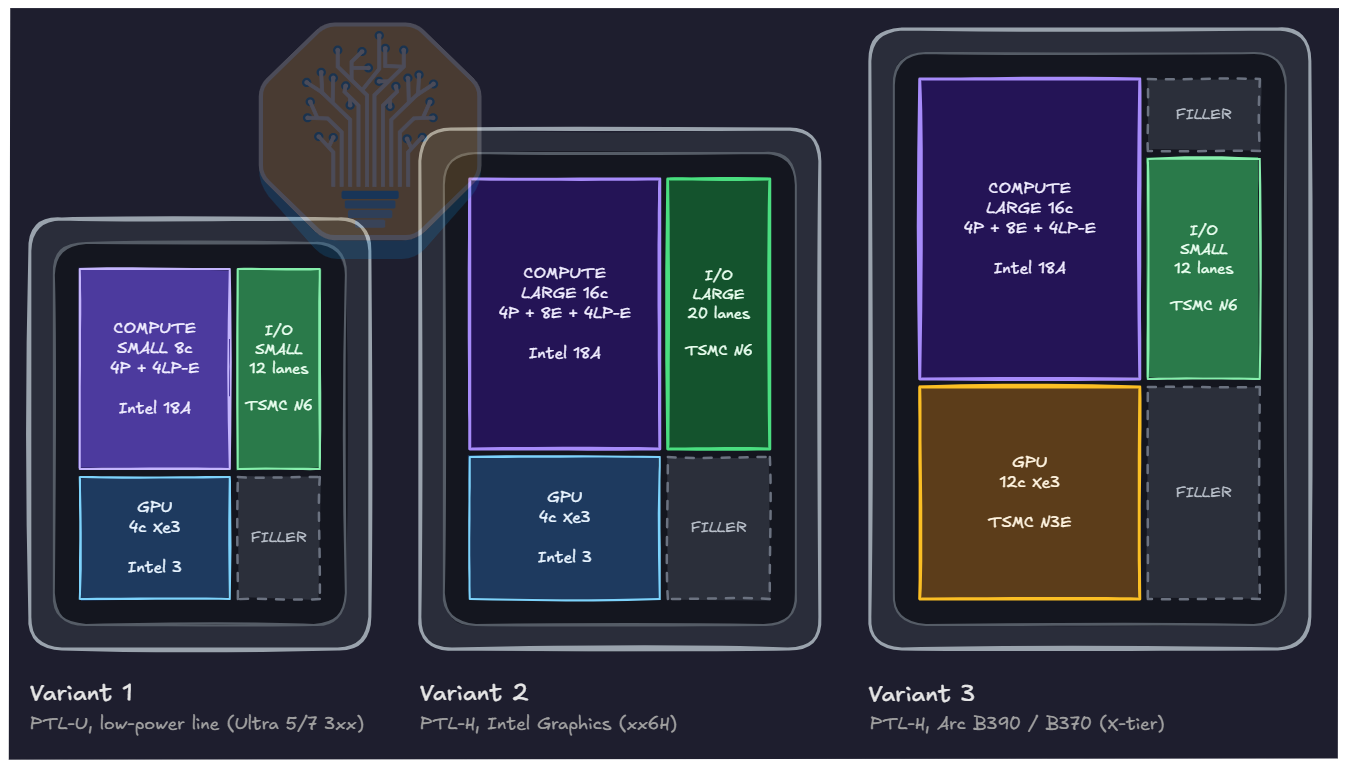
이 그림은 Intel Panther Lake의 세 가지 패키지 구성을 비교합니다. 큰 테두리 안의 색상별 사각형은 각각 별도로 만든 컴퓨트·GPU·I/O 타일이고, 점선 FILLER는 기능 타일이 아닌 빈 공간을 채우는 부분으로 표시돼 있습니다.
| 구성 | 보라색: 컴퓨트 타일 | 파란색·주황색: GPU 타일 | 초록색: I/O 타일 |
| Variant 1 — PTL-U, 저전력형 | 4 P코어 + 4 저전력 E코어, Intel 18A | Xe3 코어 4개, Intel 3 | 12레인, TSMC N6 |
| Variant 2 — PTL-H, Intel Graphics | 4 P코어 + 8 E코어 + 4 저전력 E코어, Intel 18A | Xe3 코어 4개, Intel 3 | 20레인, TSMC N6 |
| Variant 3 — PTL-H, Arc B390/B370 | 4 P코어 + 8 E코어 + 4 저전력 E코어, Intel 18A | Xe3 코어 12개, TSMC N3E | 12레인, TSMC N6 |
읽을 때 중요한 점은 두 가지입니다. 첫째, 18A는 그림의 컴퓨트 타일에 적용된 공정이지 패키지의 모든 타일에 적용된 공정이 아닙니다. 둘째, 가장 큰 GPU를 탑재한 Variant 3가 가장 큰 I/O 타일을 쓰는 것은 아닙니다. 그림상으로는 12-Xe GPU + 12레인 I/O 조합이고, 4-Xe GPU + 20레인 I/O 조합은 Variant 2입니다. 여기서 레인은 그림에 표기된 I/O 구성 수치이지 CPU 코어 수나 Xe 코어 수가 아닙니다.
※사각형의 상대적인 크기는 구성 차이를 직관적으로 보여주기 위한 배치도로 보아야 합니다. 이 그림만으로 타일의 정확한 면적이나 성능 비율을 산출할 수는 없습니다.
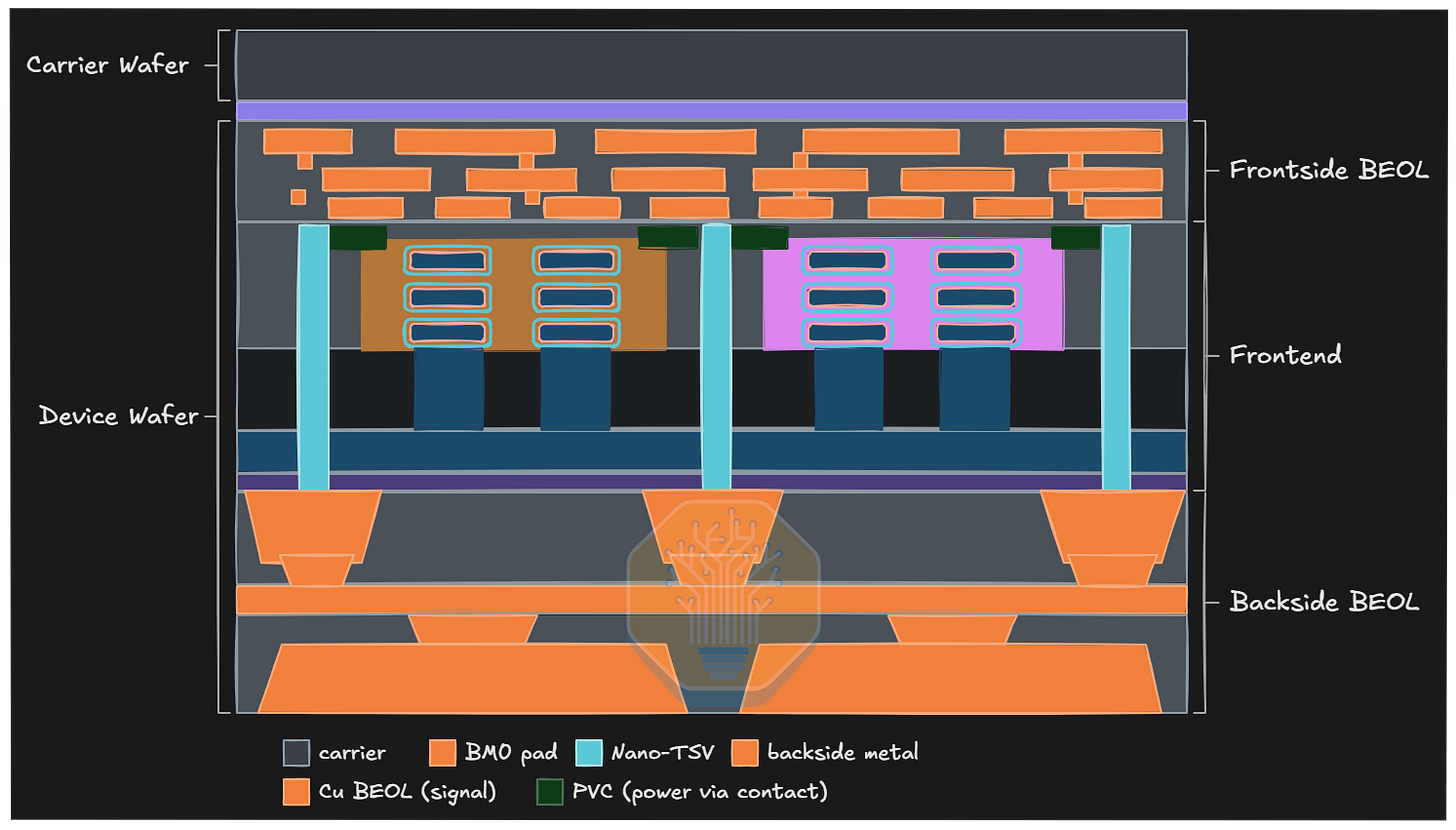
이 그림은 Intel 18A의 PowerVia(후면 전원 공급) 개념 단면도입니다. 핵심은 신호는 트랜지스터 위쪽 전면 배선으로, 전원은 아래쪽 후면 배선으로 나누어 전달한다는 것입니다.
- 맨 위 회색 Carrier wafer: 제조 중 소자 웨이퍼를 뒤집고 원래 기판을 얇게 제거할 때 지지하는 층입니다.
- 상단 Frontside BEOL: 주황색 구리 배선들이 있는 신호 배선층입니다. 트랜지스터 간 신호를 연결합니다.
- 중앙 Frontend: 실제 트랜지스터가 있는 영역입니다. 그림 속 가로로 겹친 작은 구조가 나노시트 채널을 도식화합니다.
- 청록색 세로 기둥 Nano-TSV: 트랜지스터 근처의 전원 접점에서 아래쪽 후면 배선으로 이어지는 미세 수직 연결입니다. 상단의 진녹색 PVC는 power via contact, 즉 그 접속부로 표시돼 있습니다.
- 하단 Backside BEOL: 넓은 주황색 금속선과 패드가 있는 전원 분배층입니다. 이곳에서 공급한 전원이 nano-TSV를 거쳐 트랜지스터에 도달합니다.
따라서 그림을 경로로 읽으면 신호: 트랜지스터 ↔ 위쪽 전면 Cu 배선, 전원: 아래쪽 후면 금속 → nano-TSV → 트랜지스터 접점입니다. 전원선을 전면의 혼잡한 신호 배선층에서 분리해 배선 여유와 전원 공급 특성을 개선하려는 설계입니다.
※ 주의: 이는 원리를 보여주는 개념도입니다. 각 층의 두께, 기둥의 간격, 트랜지스터와 배선의 실제 개수나 정확한 비율을 나타내는 실측 단면은 아닙니다.
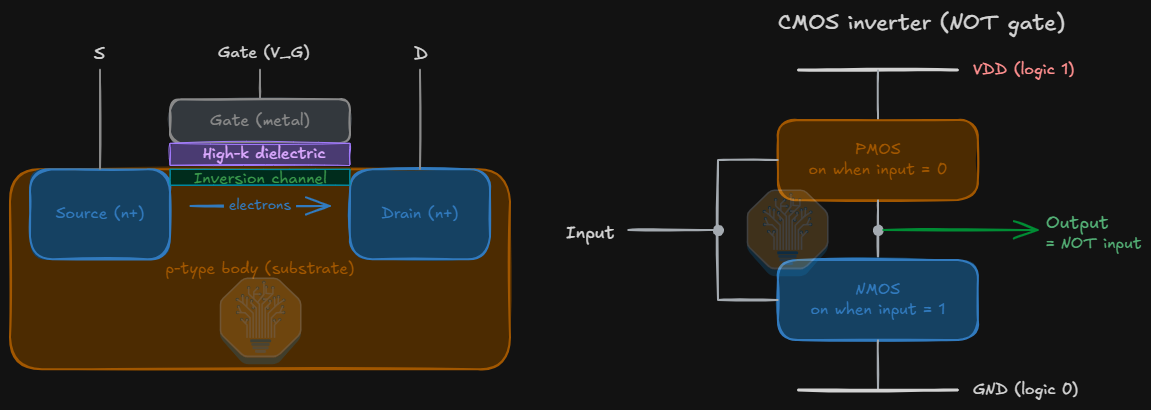
이 그림은 트랜지스터 한 개가 전압으로 전류를 제어하는 방식(왼쪽)과, 두 종류의 트랜지스터로 입력을 반전시키는 방식(오른쪽)을 연결해 설명합니다.
왼쪽: 평면형 NMOS 트랜지스터
파란 영역은 소스(S)와 드레인(D), 갈색은 p형 반도체 몸체, 그 사이 위쪽에는 게이트 금속과 절연막(high-k dielectric)이 있습니다. 게이트에 충분히 높은 전압을 걸면 절연막 바로 아래 p형 표면에 전자가 모여 반전 채널이 형성됩니다. 그러면 소스와 드레인이 전기적으로 이어져 전류가 흐를 수 있습니다. 게이트 전압을 낮추면 채널이 사라져 전류 흐름이 억제됩니다.
그림의 파란 화살표는 전자 이동 방향(소스 → 드레인)입니다. 관례적인 전류 방향은 그 반대이므로 둘을 구분해야 합니다. 또한 게이트와 채널 사이에는 절연막이 있어, 정상 동작에서 게이트가 채널로 전류를 직접 흘려보내는 구조는 아닙니다.
오른쪽: CMOS 인버터(NOT 게이트)
위의 PMOS는 전원 VDD에, 아래의 NMOS는 GND에 연결됩니다. 두 게이트에는 같은 입력을 넣고, 두 트랜지스터가 만나는 중간 지점에서 출력을 꺼냅니다.
| 입력 | PMOS | NMOS | 출력 |
| 0 | 켜짐 | 꺼짐 | 1 — VDD 쪽으로 연결 |
| 1 | 꺼짐 | 켜짐 | 0 — GND 쪽으로 연결 |
즉 출력은 입력의 반대(NOT input)입니다. 현실의 전압 전환 순간에는 두 소자가 잠깐 함께 도통할 수 있으므로, 표는 안정된 논리 상태를 설명한 것입니다.
앞서 본 Panther Lake의 RibbonFET과 연결하면, 이 그림의 왼쪽은 원리를 이해하기 위한 평면형 트랜지스터입니다. RibbonFET은 채널을 수평 나노시트로 만들고 게이트가 채널을 둘러싸도록 바꾸지만, 오른쪽처럼 NMOS와 PMOS를 조합해 논리를 만드는 기본 원리는 같습니다.

이 그림은 트랜지스터의 채널 형태가 평면형 → FinFET → GAAFET으로 바뀌면서, 게이트가 채널을 제어하는 범위가 넓어지는 과정을 보여줍니다. 위쪽의 작은 단면도와 노란 화살표가 각 구조의 게이트 제어 방향을 요약합니다.
| 구조 | 채널 형태 | 게이트가 감싸는 면 | 의미 |
| Planar | 실리콘 표면의 평평한 채널 | 윗면 1면 | 채널이 짧아질수록 드레인의 영향으로 꺼진 상태의 누설을 억제하기 어려워짐 |
| FinFET | 위로 솟은 지느러미(fin)형 채널 | 윗면과 양옆, 3면 | 게이트가 채널을 더 강하게 제어 |
| GAAFET | 수평으로 쌓은 나노시트 채널 | 각 시트의 사방 | 게이트가 채널을 둘러싸 단채널 효과와 누설을 더욱 억제하기 유리 |
아래 범례에서 보라색은 게이트, 파란색은 채널, 초록색은 소스, 빨간색은 드레인, 연회색은 게이트 절연막, 황갈색은 소자 사이를 분리하는 STI 산화막입니다. 왼쪽의 분홍색 점선은 평면형 구조에서 강조한 누설 경로입니다.
핵심은 게이트가 더 많은 면에서 채널에 전기장을 가할수록, 트랜지스터를 끌 때 채널을 더 확실히 차단할 수 있다는 것입니다. 앞서 본 Intel 18A의 RibbonFET이 오른쪽 GAAFET에 해당합니다.
※ 다만 이 그림은 구조 원리를 설명하는 개념도이므로, 실제 누설전류나 성능 개선폭을 그림만으로 정량화할 수는 없습니다.
1. 전체 구조: 두 기술 축이 패키지에서 만난다
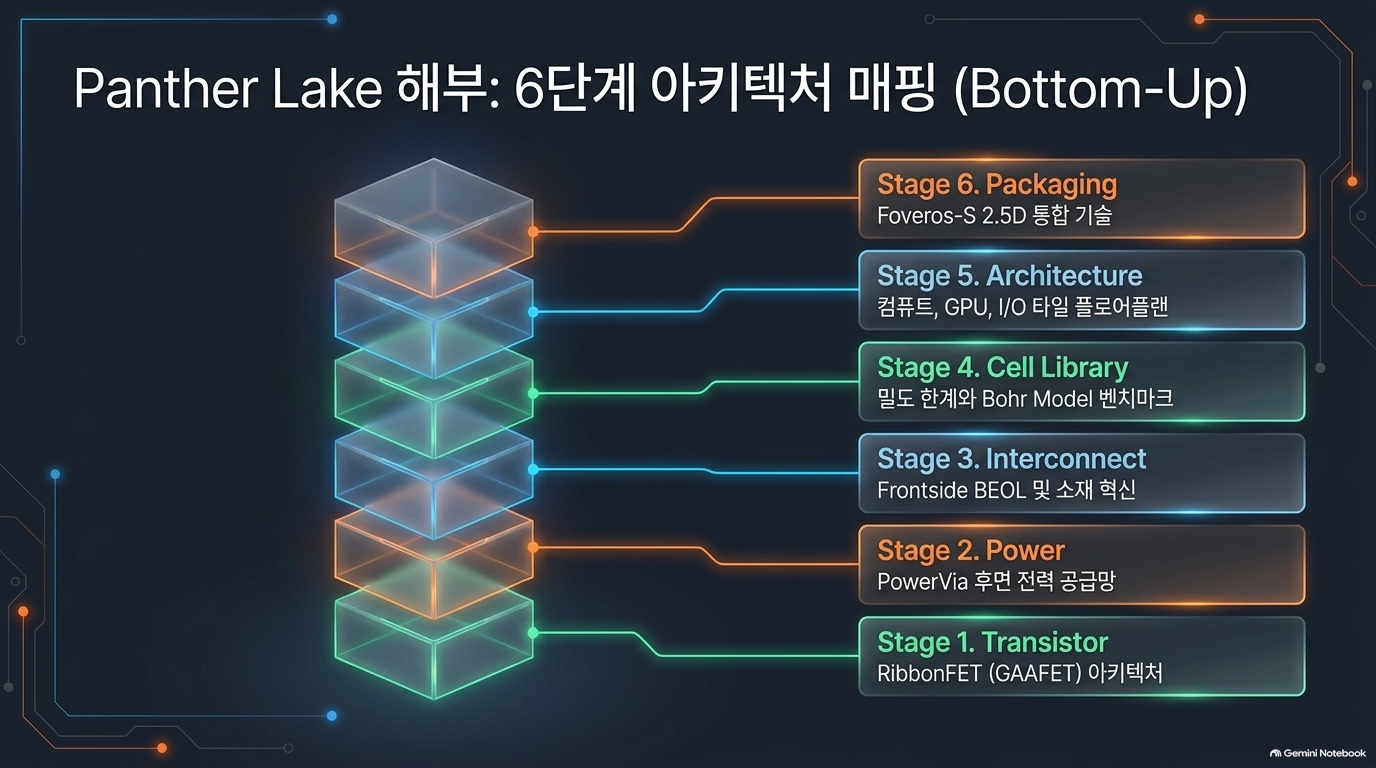
앞서 본 Planar→FinFET→GAAFET 그림은 트랜지스터 제어 방식의 발전 축입니다. PowerVia 단면 그림은 별개의 전원 공급·배선 축입니다. 타일 구성 그림은 이 둘을 실제 제품으로 묶는 시스템·제조 축입니다.
소자 축 Planar → FinFET → 18A RibbonFET(GAAFET)
└─ 채널 제어·구동력·누설의 절충
배선/전원 축 전면 신호·전원 공존 → 18A 전면 신호/후면 전원 분리
└─ 라우팅·전원 강하·열·공정의 절충
제품 축 18A 컴퓨트 + Intel 3 또는 N3E GPU + N6 I/O
└─ Foveros-S 조립, D2D 연결, 수율·원가
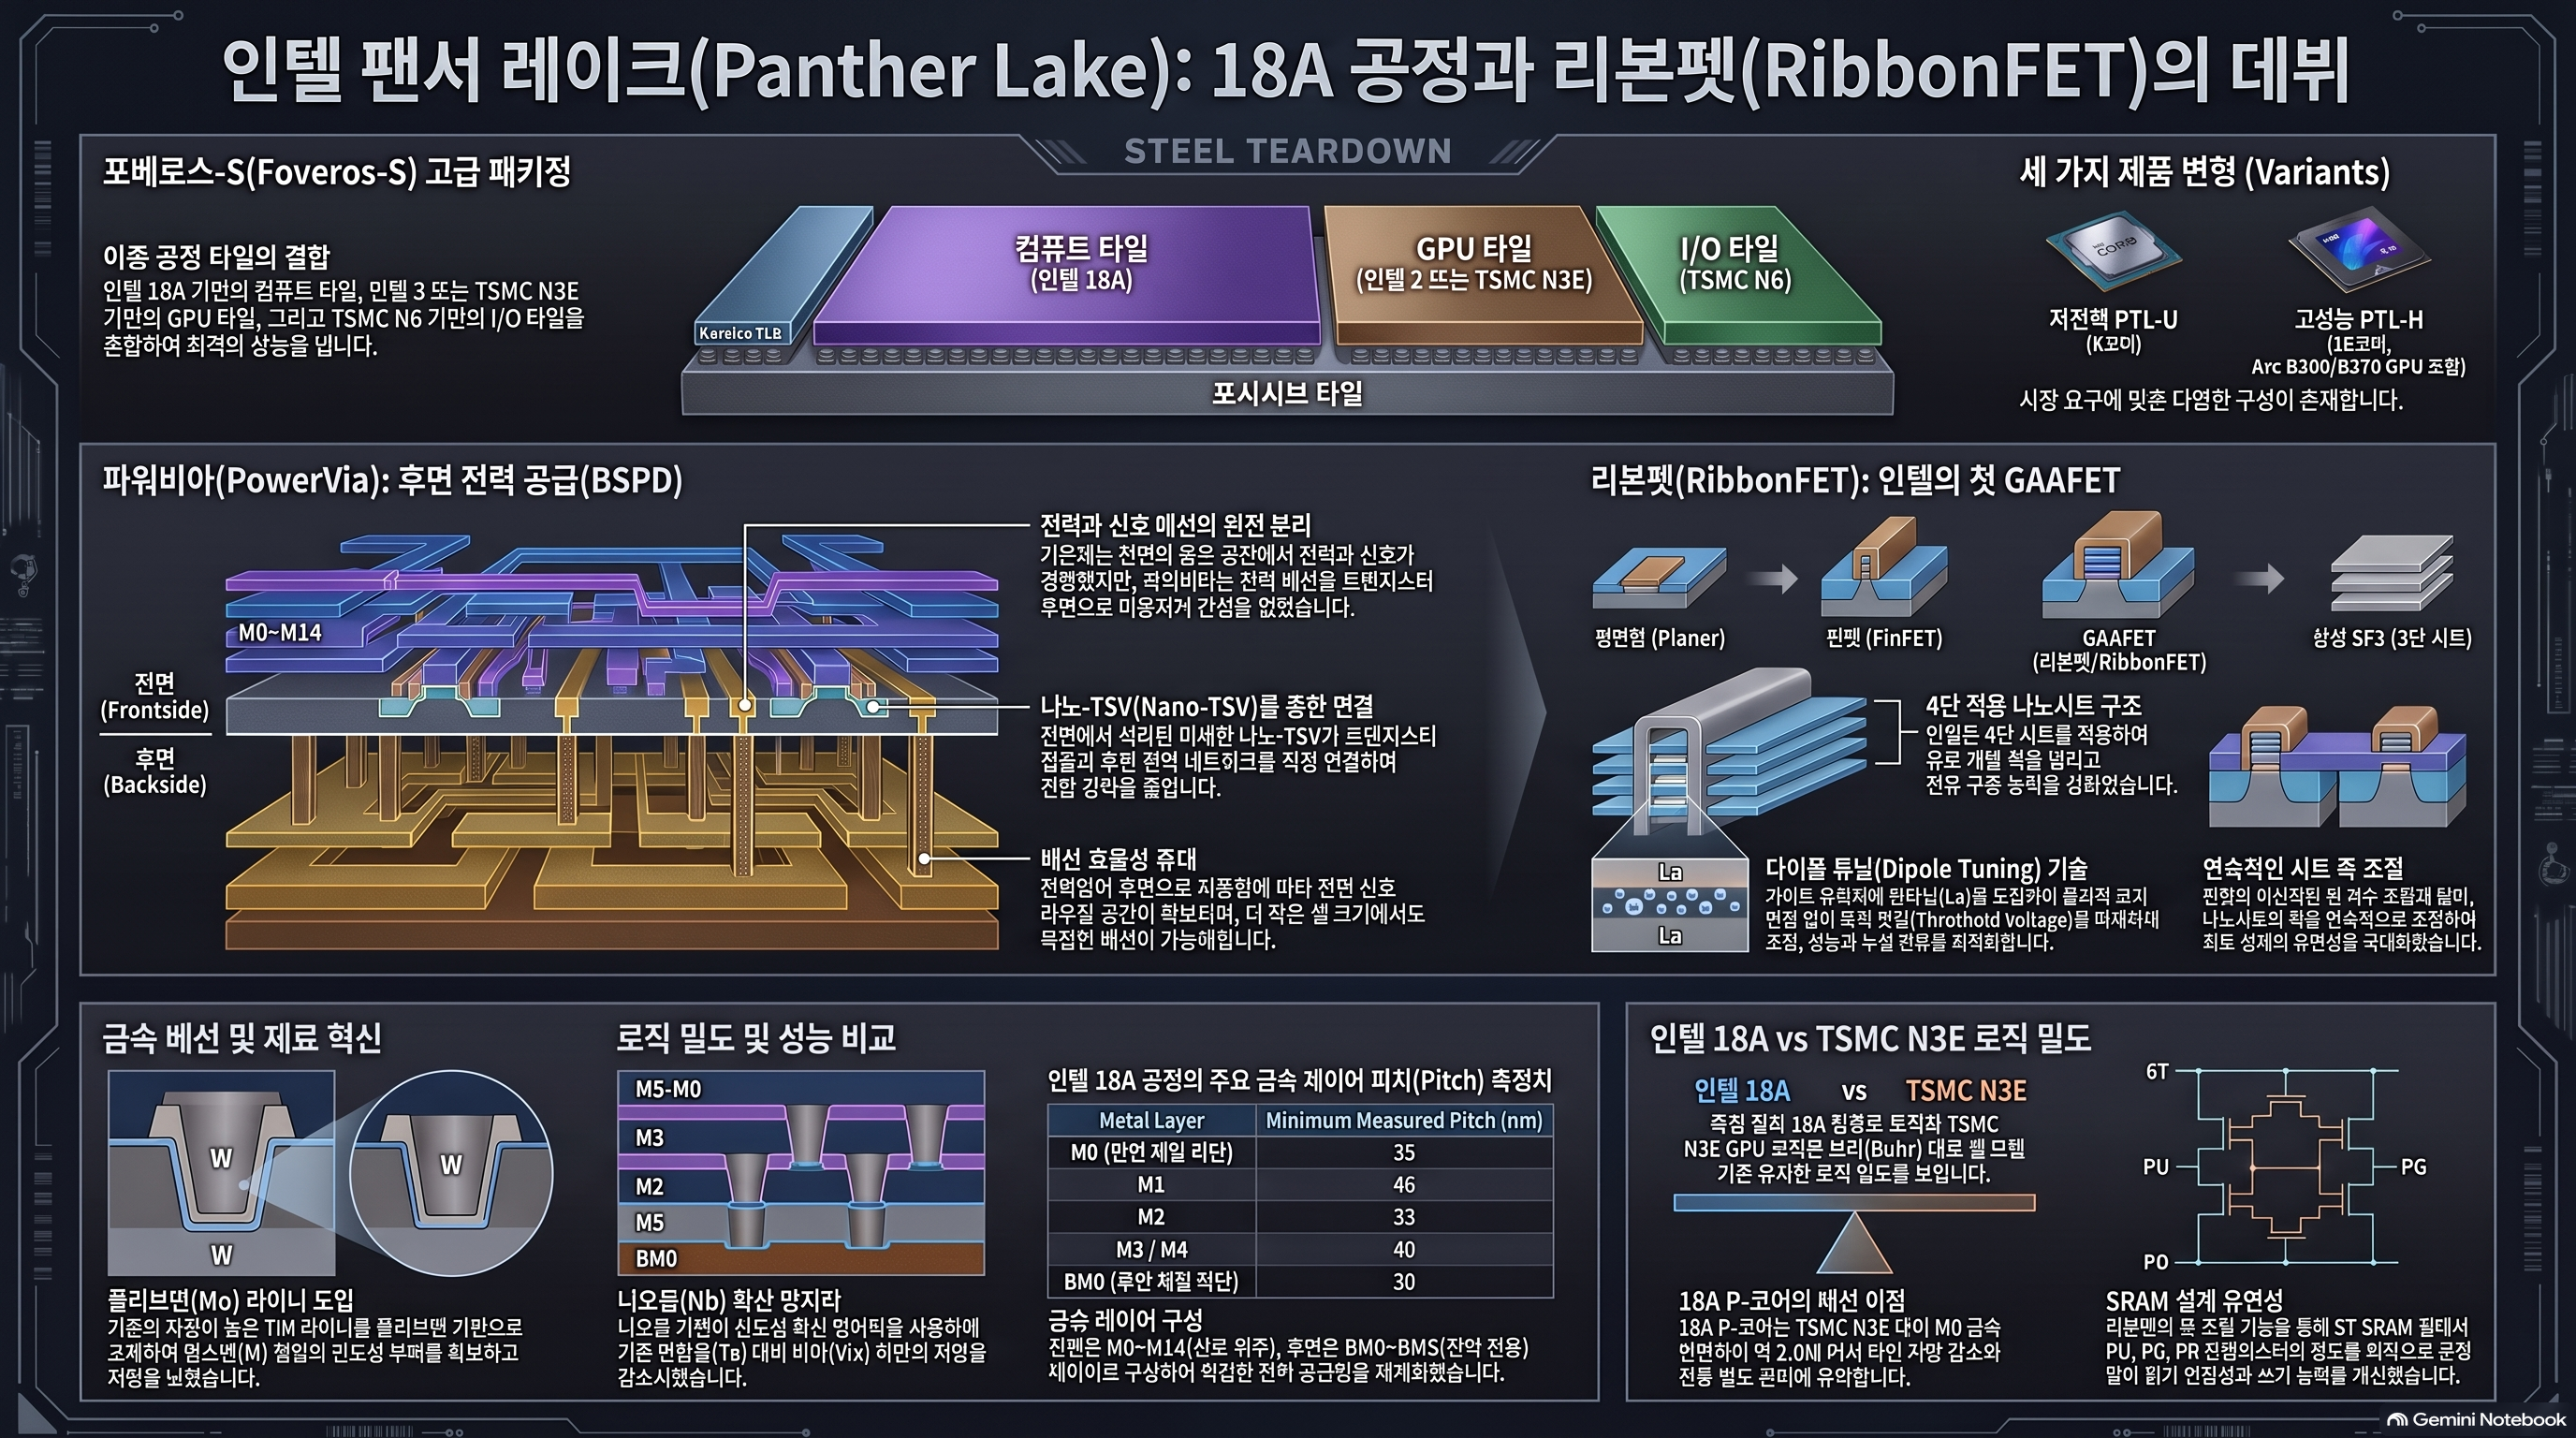
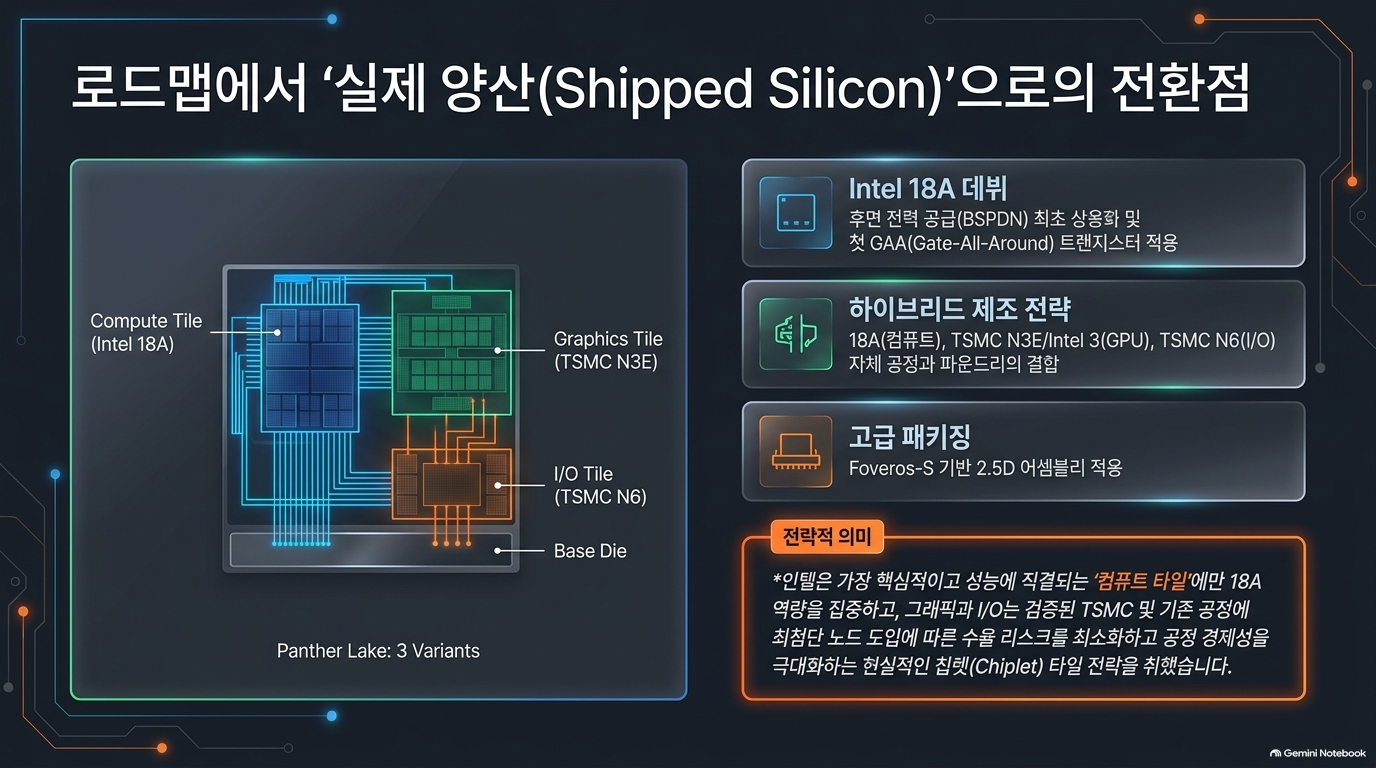
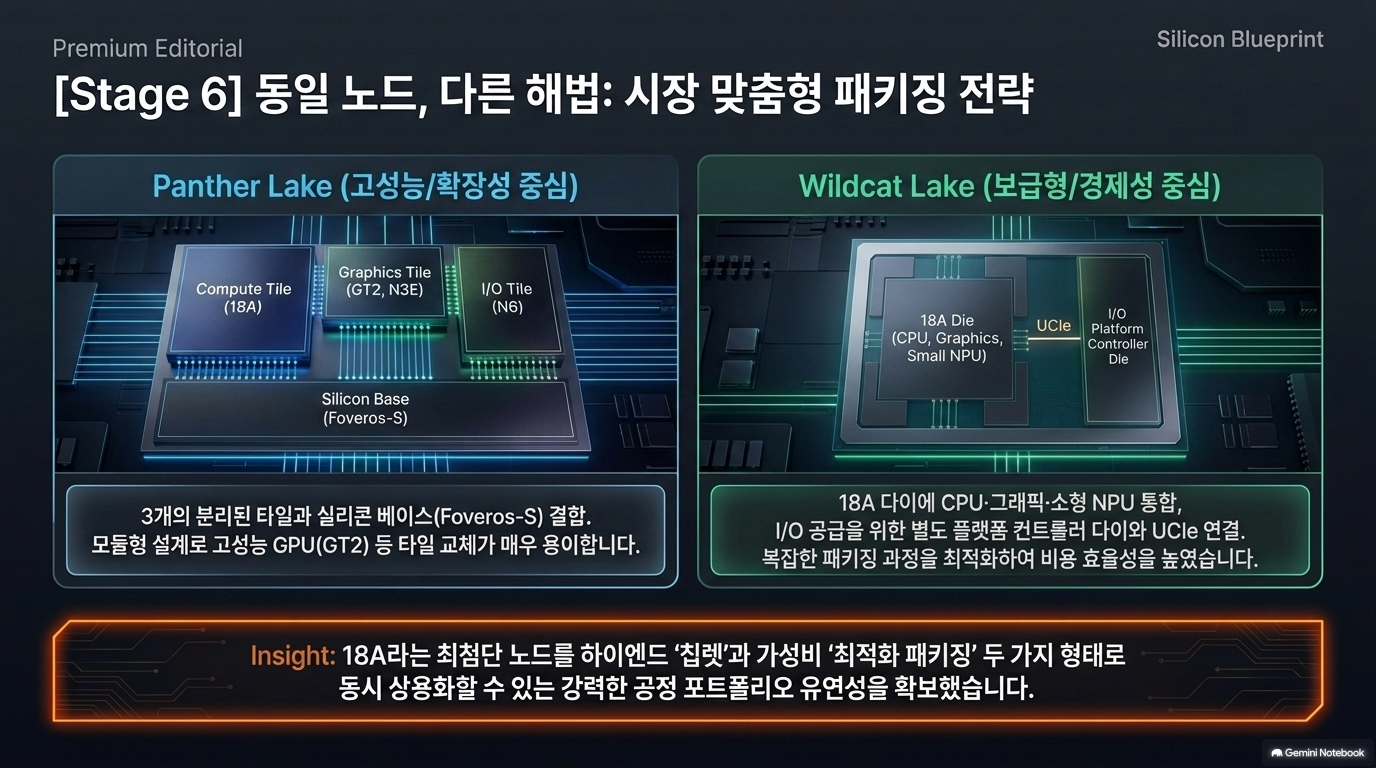
Panther Lake에는 18A 컴퓨트 타일, Intel 3의 4-Xe 또는 TSMC N3E의 12-Xe GPU 타일, TSMC N6 I/O 타일이 있고, 이들이 수동 베이스 위에 조립됩니다. 따라서 “Panther Lake는 18A 제품”이라는 말은 맞지만, “Panther Lake의 모든 실리콘이 18A”라는 뜻은 아닙니다.[1]
2. Stage 1 — RibbonFET: 게이트 제어 개선을 ‘시트 개수 경쟁’으로 축소하면 안 된다
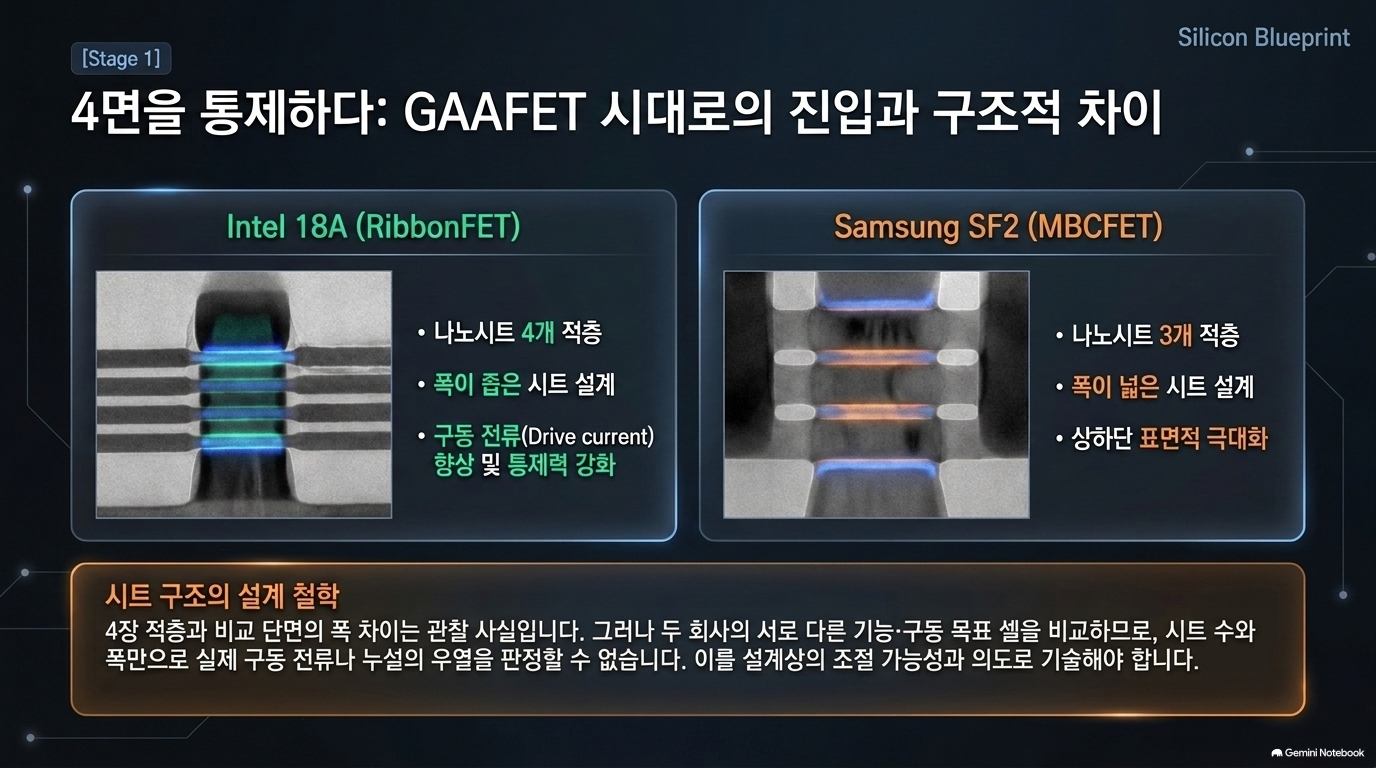
평면형 소자에서는 게이트가 채널의 윗면에서 제어하고, FinFET은 솟아오른 채널의 세 면에서 제어합니다. 18A의 RibbonFET은 수평 나노시트 각각을 게이트가 둘러싸는 GAAFET입니다. SemiAnalysis의 Panther Lake 단면에는 네 장의 리본이 관찰됩니다.[1]
게이트가 짧은 채널을 더 잘 제어하면 드레인이 채널에 미치는 영향을 억제하고, 주어진 속도에서 누설을 낮추거나 문턱전압 선택의 여지를 늘릴 수 있습니다. 하지만 네 장이라는 개수만으로 구동 전류가 결정되지는 않습니다. 시트 폭·두께, 전류가 흐르는 표면의 성질, 소스·드레인 접점, 게이트 저항과 문턱전압이 함께 작용합니다. 원문의 Intel 18A와 Samsung SF2 비교 영상도 서로 동일한 기능·구동 목표의 셀을 맞대어 측정한 것이 아닙니다.[1]
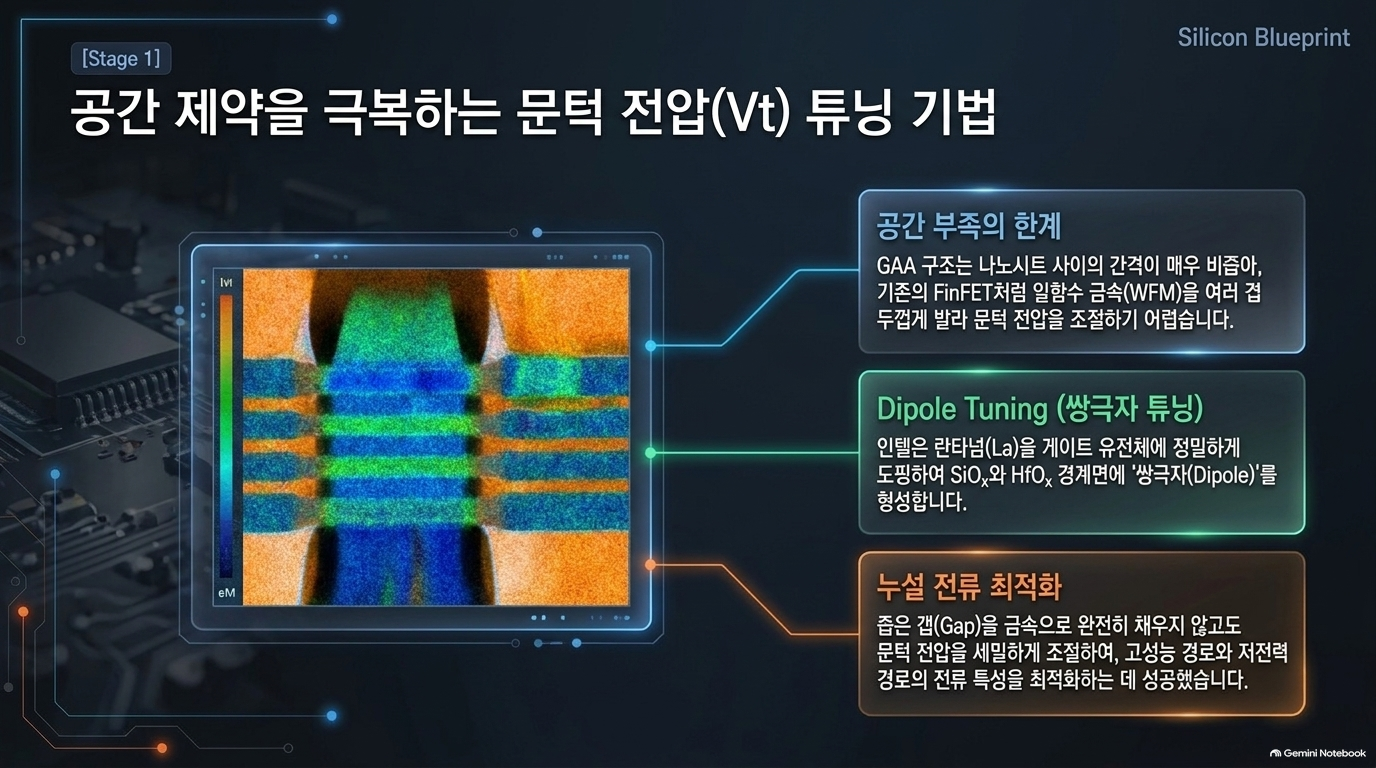
실무적으로 더 중요한 발견은 시트 폭을 회로별로 조절한다는 점입니다. FinFET에서 핀의 개수는 불연속적으로 바뀌지만, 나노시트의 폭은 설계 규칙 안에서 보다 세밀한 구동력 조절 수단이 됩니다. Intel은 이를 P-core·LP E-core 로직뿐 아니라 SRAM의 pull-up(PU), pass-gate(PG), pull-down(PD) 소자에 다르게 적용합니다. SRAM에서는 읽기 교란을 막으면서도 쓰기가 가능해야 하므로, ‘가장 강한 소자’가 아니라 세 소자의 상대적 강도와 보조 회로의 균형이 목적입니다.[1]
[보완 내용 — 첨부 보고서 4~5쪽] “Intel 4장·Samsung 3장 → Intel의 구동력·누설 우위”라는 서술은 관찰된 형상과 실측되지 않은 성능 우열을 분리해야 합니다. 반면 La를 활용한 문턱전압 조정 논점은 중요합니다. 시트 간격이 좁아 일함수 금속(WFM)을 마음대로 두껍게 할 수 없으므로, SiOₓ/HfOₓ 계면의 쌍극자 조정은 고속·저누설 소자 옵션을 확보하는 방법입니다. 다만 단면·EDS가 재료 배치를 보여준다고 해서 각 옵션의 전기적 분포나 장기 안정성까지 증명하는 것은 아닙니다.[1]
새로운 함의: 18A의 소자 경쟁력은 “4장 리본” 한 항목보다 시트 폭 × 문턱전압 옵션 × 접점 저항 × 실제 셀 라이브러리의 조합에서 평가해야 합니다. 개별 트랜지스터의 잠재력을 회로 설계자가 얼마나 활용할 수 있는지가 관건입니다.
3. Stage 2 — PowerVia: 신호와 전원의 분리가 만드는 이득과 부채
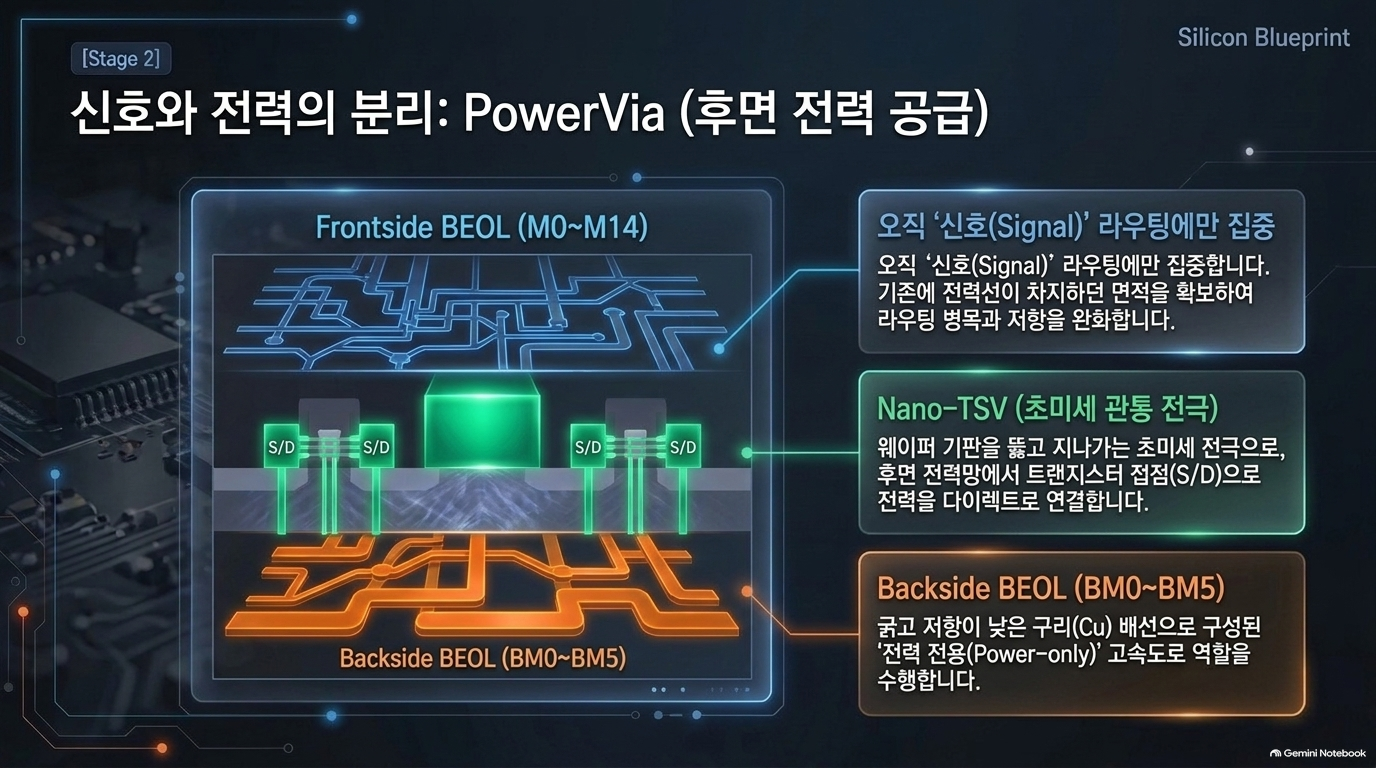
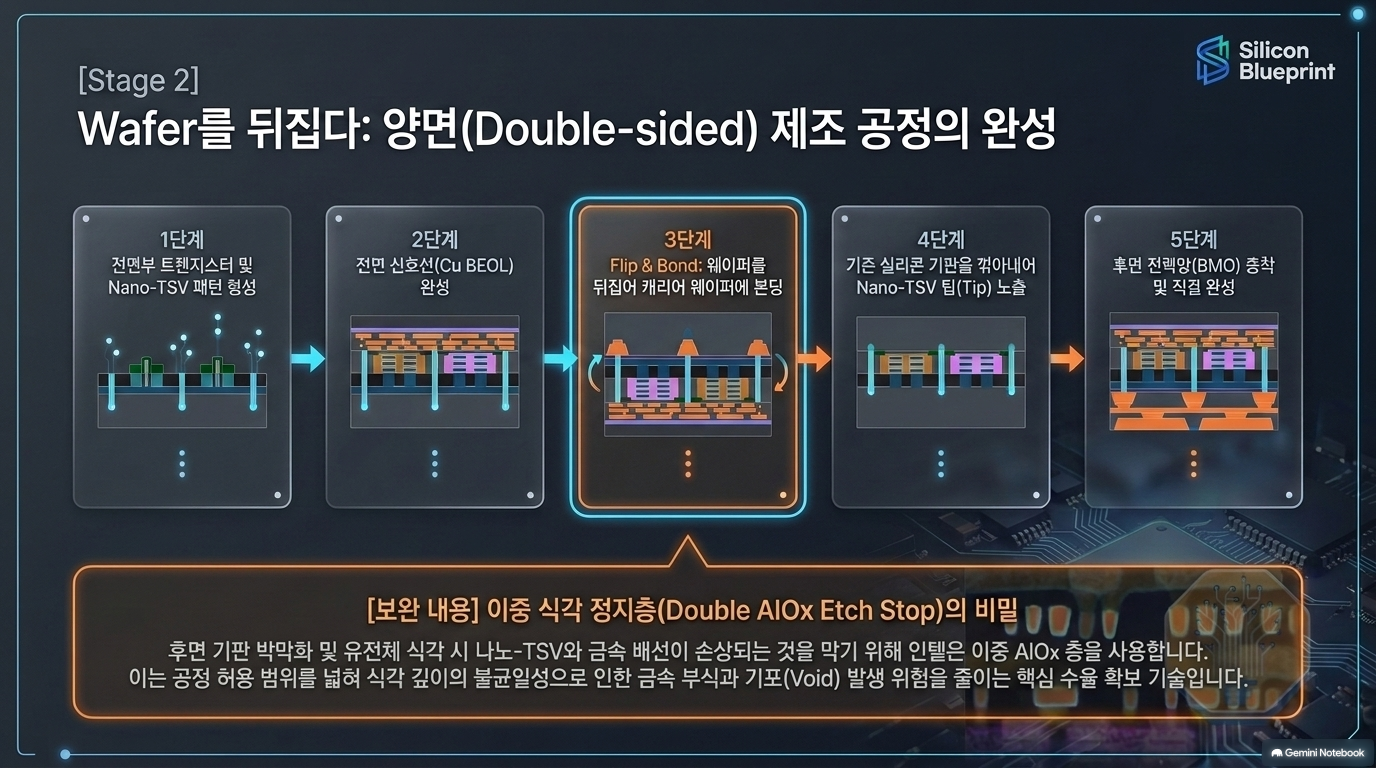
두 번째 그림의 위쪽 전면 배선은 주로 M0–M14 신호망, 아래쪽 후면 배선은 BM0–BM5 전원망입니다. 후면 Cu 레일의 전원은 nano-TSV를 거쳐 로컬 소스·드레인 접점으로 전달됩니다. 이 구조는 전면에서 신호와 전원 배선이 경쟁하던 문제를 줄이려는 것입니다.[1][5]
물리적 기대효과는 세 가지입니다.
- 전면 배선 여유: 전원망이 차지하던 자원을 신호 배선에 돌릴 수 있습니다.
- 전원 무결성: 넓은 후면 전원 경로를 통해 저항성 전압 강하와 동적 공급 변동을 완화할 여지가 있습니다.
- 셀 설계 자유도: 전면 전원 레일을 위해 신호선의 폭·간격을 무리하게 희생하지 않고도 작은 셀을 구성할 수 있습니다.[1][4][5]
그렇지만 전원망을 ‘공짜 공간’으로 옮긴 것은 아닙니다. nano-TSV의 가로 착지 면적은 표준 셀 안에 남습니다. 제조 중에는 전면에서 TSV를 형성하고 신호 배선을 완성한 뒤 캐리어를 접합하고 웨이퍼를 뒤집어 기판을 제거하며, 완제품에 남은 캐리어와 절연 구조는 열 방출 경로에도 영향을 줍니다.[1]
이 점에서 PowerVia의 성공은 단순한 전기적 이득이 아니라 다음 부등식을 만족하는지의 문제입니다.
라우팅·전원 공급 이득 > TSV 면적 + 양면 가공 복잡도 + 기생용량·열 비용 + 추가 결함 위험
Intel의 기술자료에 나오는 전압 강하·라우팅·블록 면적 개선치는 Intel이 제시한 비교 설계 결과입니다. SemiAnalysis의 해체 사진이 그 개선율을 Panther Lake 완제품에서 독립적으로 재측정한 것은 아닙니다.[1][4]
[보완 내용 — 보고서 6~7쪽] 보고서의 ‘전면은 신호 전용, 후면은 전원 전용’ 도식은 주 전원망의 기능 분리를 설명하는 그림으로 읽어야 합니다. 이를 모든 층·모든 접점에서 전원과 신호가 완전히 배타적이라는 문자 그대로의 명제로 확대하지 않는 편이 정확합니다. 또한 ‘775 µm 기판 제거’는 공개 원문의 확인된 제거 두께로 찾지 못했고, 이중 AlOₓ 식각 정지층은 기판 전체를 박막화하는 과정과 구분되는 배선 개구부의 금속 착지 보호 기술입니다. 결함을 ‘원천 차단’한다기보다 식각 변동에 대한 공정 여유를 넓힌다고 표현해야 합니다.[1]
4. Stage 3 — 금속과 접점: 무엇이 ‘선’이고 무엇이 ‘접점’인지 구분해야 한다
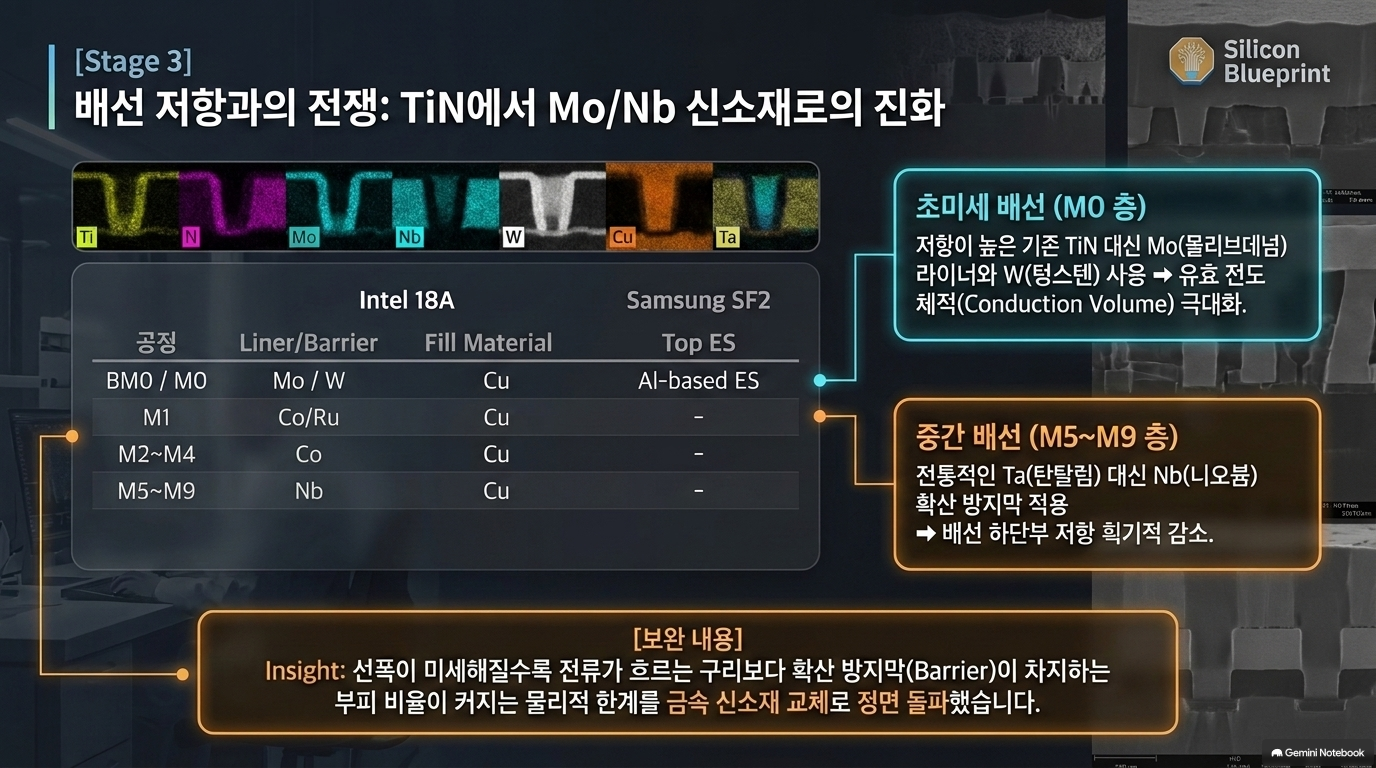
첨부 보고서 8쪽의 가장 큰 문제는 Mo/W 접점·비아와 Cu 배선 및 층별 장벽재가 한 표에서 뒤섞인 점입니다. 원문의 구조를 전류 경로 순서로 풀면 다음과 같습니다.[1]
| 위치 | 주요 재료·구성 | 왜 중요한가 |
| 트랜지스터 S/D 접점 → M0 | Ti계 계면, W 접점, Mo 라이너/W 비아, Cu M0 | 좁은 접속부에서 라이너가 차지하는 면적과 수직 저항을 관리 |
| 전면 저층 배선 | Cu 배선; M0–M1의 Co/Ru, M2–M4의 Co 계열 라이너 | 충전 결함·접착·저항·신뢰성의 균형 |
| 전면 M5–M9 | Cu 배선의 Nb 계열 장벽 선택 | 특히 비아 바닥의 장벽 저항을 줄이려는 접근 |
| 후면 전원 경로 | Cu 레일, Mo 라이너/W nano-TSV | 별도 전원망에서 로컬 접점으로 공급 |
선폭이 작아질수록 라이너·확산 방지막이 전체 단면에서 차지하는 비율이 커집니다. 따라서 재료 선택의 핵심은 금속의 벌크 저항률 하나가 아니라, 공정 후 전류가 실제로 흐를 수 있는 단면·계면 저항·Cu 충전 결함·장기 신뢰성입니다.[1]
이중 AlOₓ 정지층도 같은 논리입니다. 보호층을 늘리면 식각 깊이 변동에 대응하기 쉽지만, 막 형성·제거 단계, 계면, 기생용량이 추가됩니다. ‘공정 안정성 향상’과 ‘저항·용량 및 비용의 증가 가능성’을 동시에 평가해야 합니다.[1]
5. Stage 4 — 셀 밀도: 18A의 인상적인 성과지만 비교 범위가 좁다
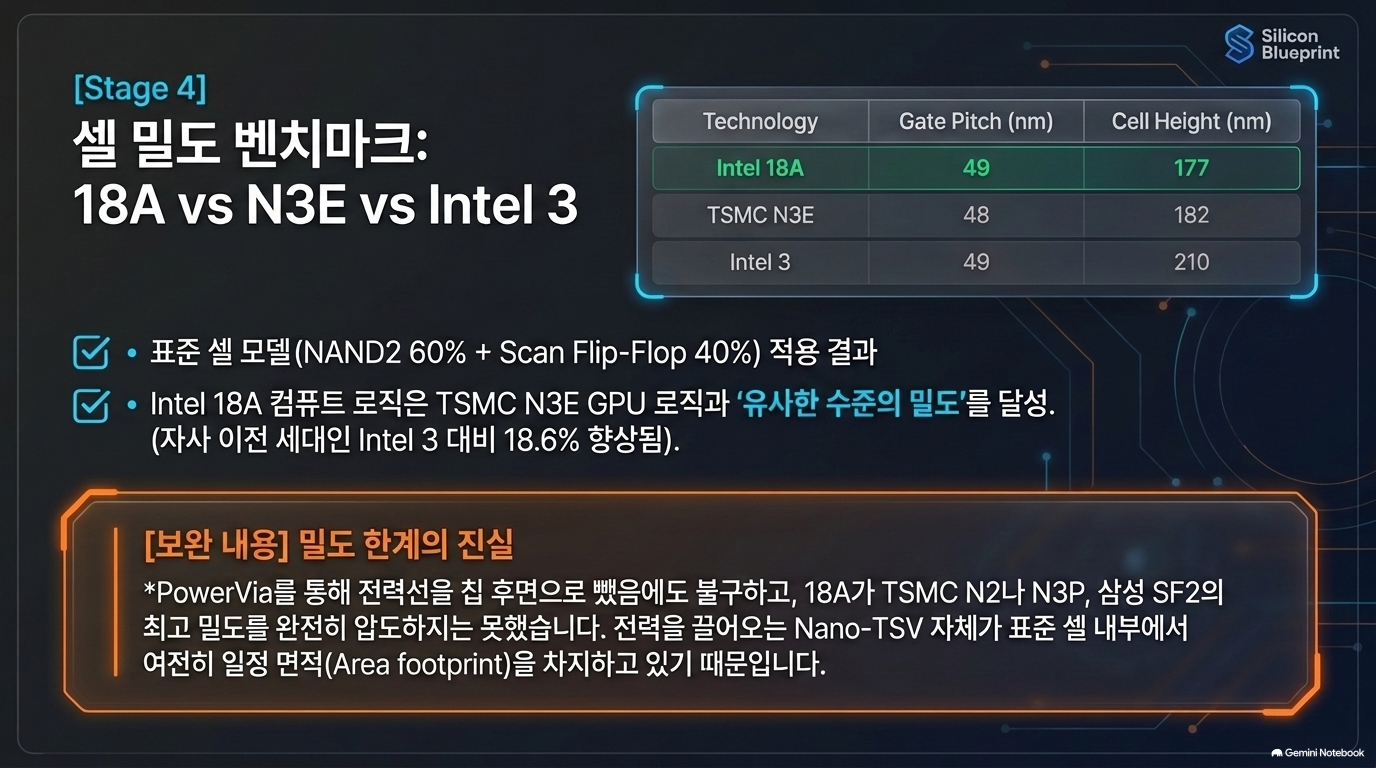
SemiAnalysis가 측정한 대표 로직 영역과 NAND2·스캔 플립플롭 60:40 가중 Bohr 모델 결과는 다음과 같습니다.[1]
| 실제 분석 영역 | 셀 높이 | 게이트 피치 | 대표 셀 밀도 |
| Intel 18A, Panther Lake CPU 로직 | 177 nm | 49 nm | 169.9 MTr/mm² |
| TSMC N3E, Panther Lake GPU 로직 | 182 nm | 48 nm | 168.7 MTr/mm² |
| Intel 3, Panther Lake GPU 로직 | 210 nm | 49 nm | 143.2 MTr/mm² |
이 특정 모델에서 18A는 N3E와 약 0.7% 차이로 유사하며 Intel 3 비교 영역보다 약 18.6% 높습니다. 중요한 것은 비교가 서로 다른 공정에 똑같은 회로를 포팅한 실험이 아니라, 출하 칩의 CPU 로직 대 GPU 로직 형상을 비교한 것이라는 점입니다. 셀 혼합비·배선 가능성·SRAM·아날로그·빈 공간이 달라지면 전체 다이 밀도는 달라집니다.[1]
앞선 설명의 수치도 정정합니다. 18A P-core 분석 영역의 출하 칩 M0 피치는 37 nm, LP E-core는 35 nm입니다. 원문 도표를 확대해 확인했습니다. 한 값으로 묶어 “출하 라이브러리 M0은 36 nm”라고 한 이전 설명은 부정확합니다. 더구나 원문의 그림 표와 그림 설명 사이에도 PDK 명목 M0 피치 표기가 일치하지 않아, 그 명목값은 해당 원문만으로 단정하지 않겠습니다.[1]
더 깊은 해석: 18A가 5-track 로직셀로 작은 셀 높이를 얻으면서도 전면 M0을 극단적으로 좁히지 않는 것은 PowerVia와 셀 설계의 공동 최적화로 볼 수 있습니다. 하지만 단면적이 큰 금속은 저항에는 유리해도 용량을 늘릴 수 있습니다. 따라서 “금속이 굵다 → 회로가 빠르다”가 아니라 저항·용량·팬아웃·배선 길이를 포함한 타이밍 분석으로 검증해야 합니다.[1]
Intel의 공식 자료에 나타나는 Intel 3 대비 1.3배 칩 밀도도 이 60:40 대표 셀 형상 비교와 다른 측정·설계 범위의 제조사 수치입니다. 서로 다른 분모를 하나의 ‘18A 개선율’로 합치면 안 됩니다.[1][4]
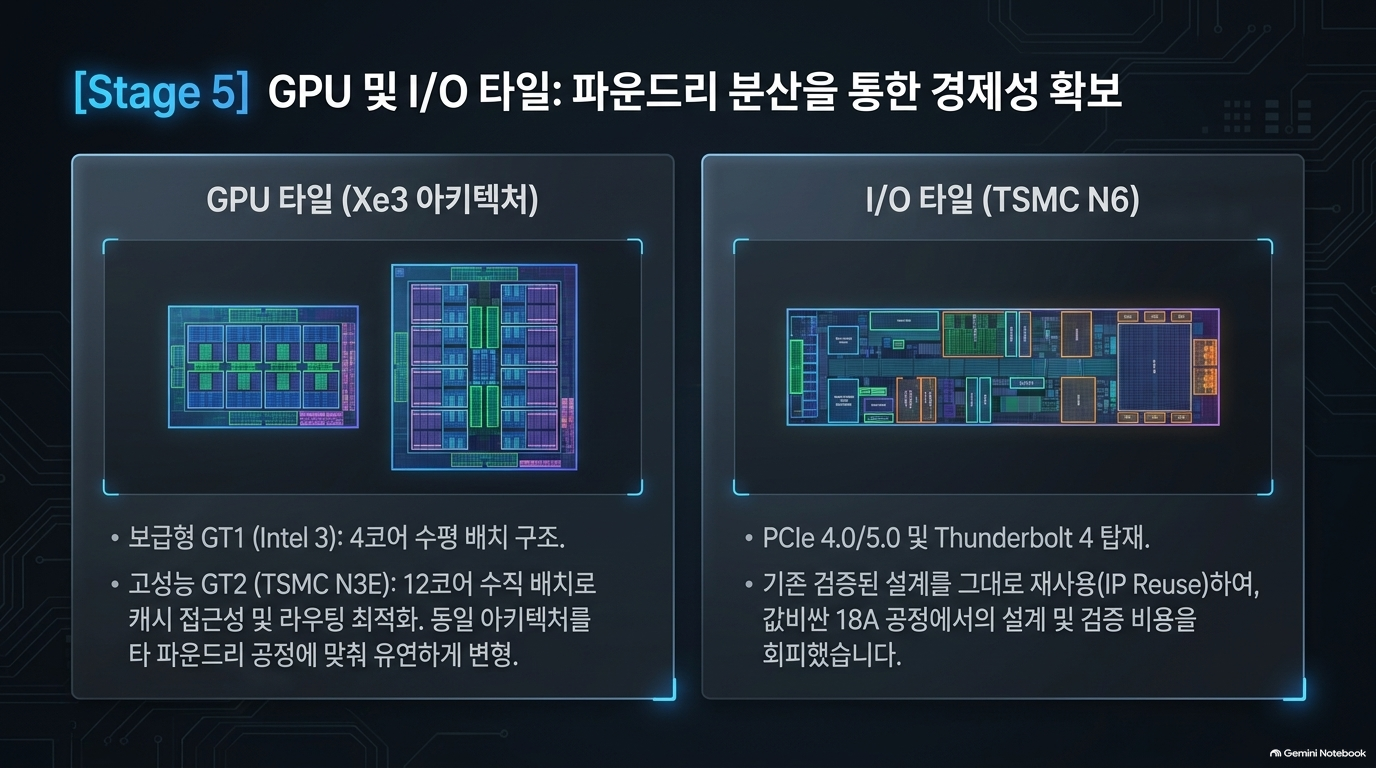
6. Stage 5 — 컴퓨트·NPU·GPU: 공정 효과보다 설계 재편의 기여를 분해해야 한다
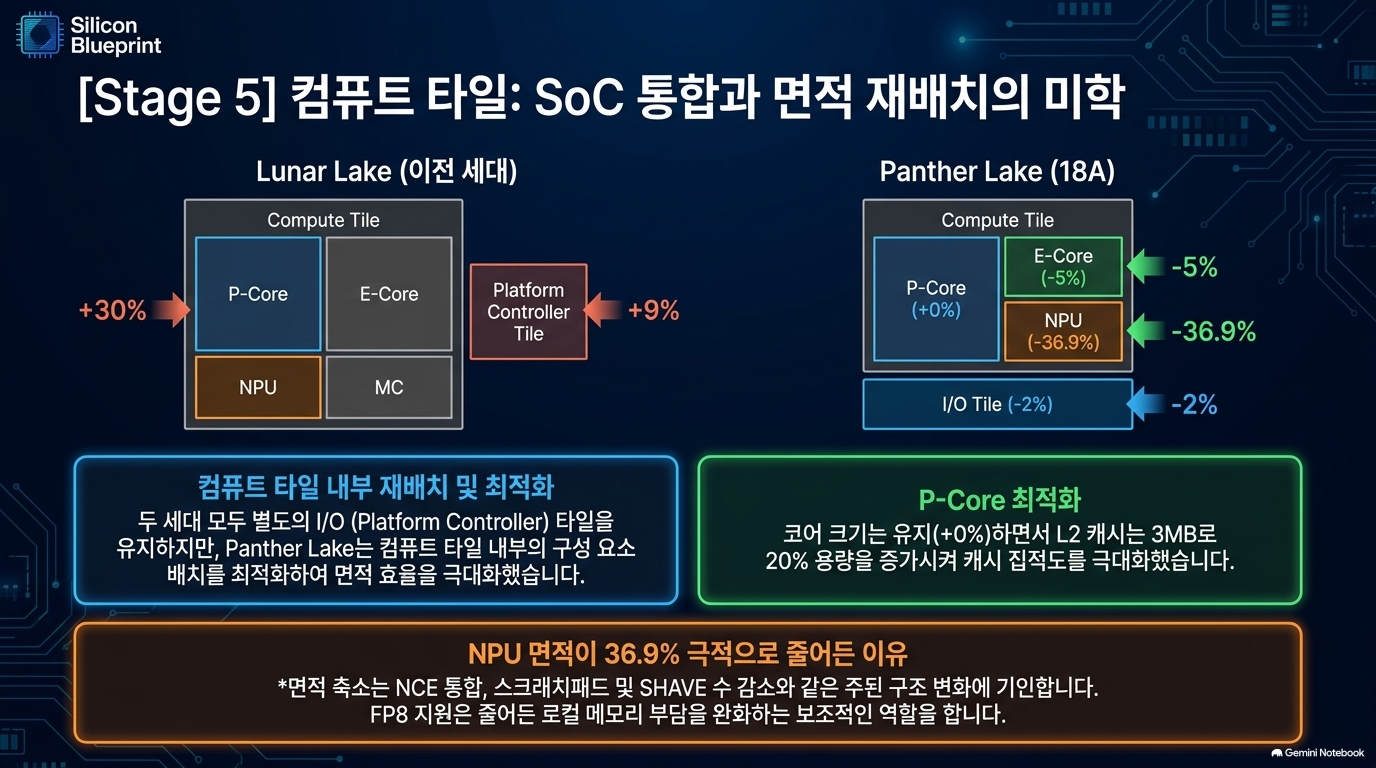
SemiAnalysis의 플로어플랜에서 Panther Lake-U 컴퓨트 타일은 Lunar Lake 비교 타일보다 136.377 → 91.093 mm², 약 33.2% 작습니다. 하지만 이는 18A만의 축소율이 아닙니다. 아키텍처, 캐시 배열, NPU 구성 및 비교 제품의 기능 배치가 함께 변했습니다.[1]
CPU·캐시
P-core 한 개의 플로어플랜 면적은 4.431 → 4.427 mm²로 사실상 유지되는데, L2는 2.5 → 3 MiB입니다. 이는 저장 구조를 같은 코어 영역에 더 효율적으로 넣은 성과로 해석할 수 있습니다. 동시에 캐시 용량 증가는 저장 누설과 조회 에너지를 늘릴 수 있어, 실제 이득은 작업집합과 L3·DRAM 접근 감소에 따라 달라집니다.[1]
NPU: ‘같은 INT8 MAC 수, 더 작은 NPU’의 조건
NPU 전체는 17.956 → 11.332 mm², 약 36.9% 축소됐습니다. 반면 각 NCE의 외곽 영역은 커졌고, NCE 수와 scratchpad·SHAVE DSP 수는 줄었습니다. 원문 면적 분해상 NCE 외곽의 절감 5.526 mm² 안에 scratchpad 절감 2.829 mm²가 포함됩니다. 두 절감치를 합산하면 이중 계상입니다.[1]
핵심 성능 질문은 연산기를 얼마나 많이 넣었느냐보다 얼마나 자주 데이터를 재사용할 수 있느냐입니다.
NCE 통합 → 중복 주변 회로·메모리 감소 → 면적 절감
→ 로컬 저장 여유 감소 가능성
→ 모델에 따라 타일 분할·DRAM 왕복 증가 가능성
→ 지속 처리량/지연시간/전력은 워크로드별로 달라짐
Native FP8 지원은 FP16 대비 피연산자 저장·전송량을 줄일 가능성이 있지만, 정확도·스케일링·연산자 지원·메모리 병목을 확인하지 않고 ‘모든 AI 추론 성능이 동일하다’고 결론 낼 수 없습니다. 첨부 보고서 10쪽의 면적 축소 원인을 FP8 하나로 설명한 문장은 NCE 구조 변화 중심으로 고쳐야 합니다.[1]
GPU: 같은 Xe3 이름, 다른 물리 구현
GT1은 Intel 3의 4-Xe, GT2는 N3E의 12-Xe 타일입니다. GT1의 Xe 코어 블록이 GT2의 것보다 훨씬 넓지만, 블록 면적에는 로직 외에 캐시·라우팅·배치 차이가 섞여 있습니다. 원문의 GT1 4 MiB와 GT2 16 MiB L2 구성, 캐시 매크로·뱅크 효율 차이도 GPU 타일 면적을 좌우합니다. 따라서 그 면적 격차를 공정 트랜지스터 밀도 격차로 환산해서는 안 됩니다.[1]
전세대 비교의 정확성
첨부 보고서 10쪽은 Lunar Lake에 별도 SoC 타일이 있다가 Panther Lake에서 처음 없어졌다는 인상을 줍니다. 그러나 Intel의 Lunar Lake 자료상 CPU·GPU·NPU는 이미 컴퓨트 타일에 들어 있으며 별도의 것은 Platform Controller Tile입니다. 원문의 ‘별도 SoC 타일 제거’ 논점은 Meteor Lake·Arrow Lake와 비교할 때 적용됩니다. Lunar Lake와의 비교는 동일한 이름의 타일 유무보다 메모리·저전력 도메인·GPU 경계 및 기능 배치의 실제 변화에 집중해야 합니다.[1][6]
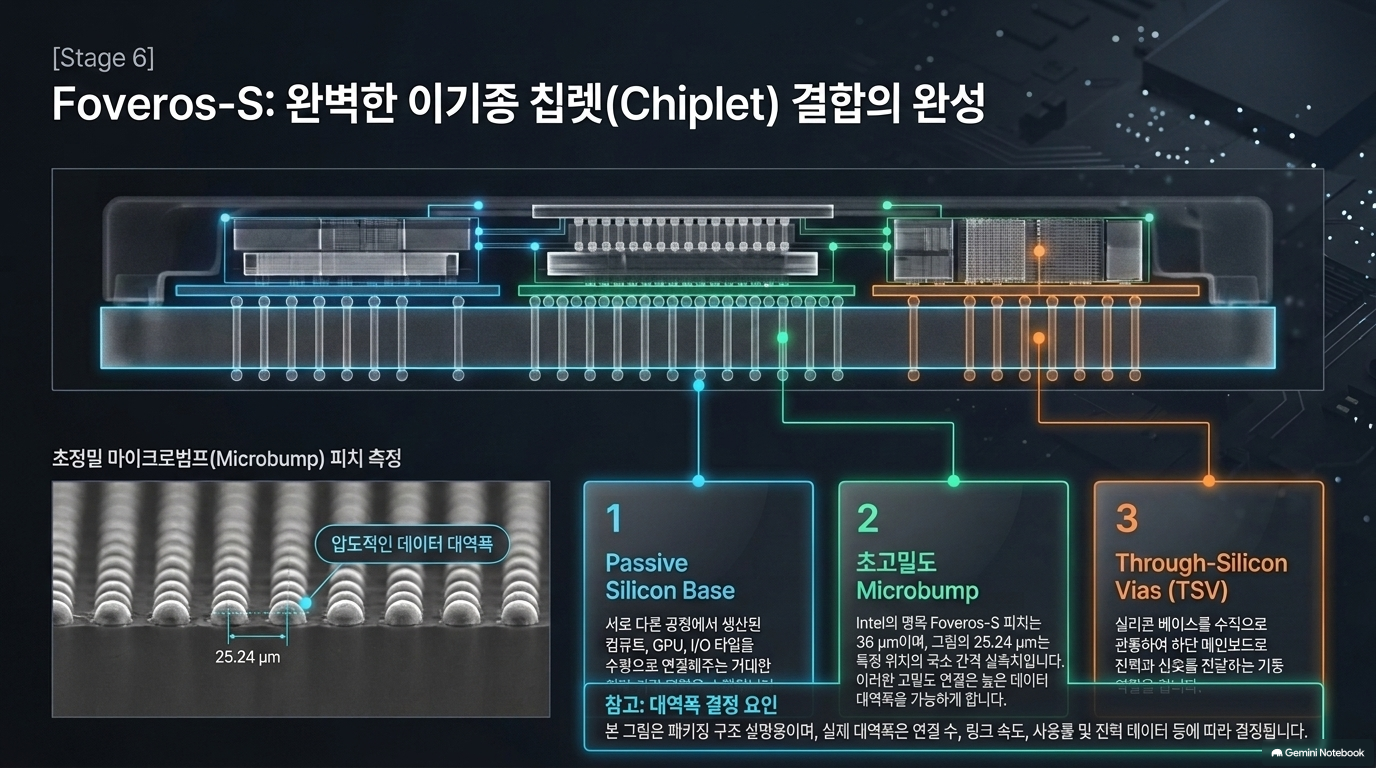
7. Stage 6 — Foveros-S: 미세 범프가 대역폭·원가를 자동 보장하지 않는다
Foveros-S는 세 활성 타일을 수동 실리콘 베이스 위에 나란히 배치합니다. microbump는 활성 타일과 베이스를 연결하고, 베이스의 재배선층(RDL)은 타일 사이 신호를, 베이스 TSV는 패키지 기판 방향 연결을 담당합니다. 이것은 앞서 본 트랜지스터 근처 전원용 nano-TSV와 다른 위치·용도의 TSV입니다.[1][2]
Intel 기술자료의 Foveros-S 명목 microbump 피치는 36 µm이고, 원문은 컴퓨트 타일 가장자리의 국소 간격 약 25.24 µm를 관찰합니다. 두 수치의 정의와 위치를 맞추지 않은 채 ‘명목 사양 초과’나 ‘압도적 대역폭’으로 단정할 수 없습니다. 대역폭은 실사용 연결 수 × 링크 속도 × 인코딩·이용률 등의 정보가 있어야 검증됩니다.[1][2]
패키징 경제성도 양면적입니다.
- 이점: 새 공정 18A의 적용 면적을 컴퓨트에 집중; 다른 공정 타일 재사용; 조립 전에 불량 다이를 걸러낼 기회.
- 비용: 수동 베이스, D2D 송수신 회로, 접합·검사, 조립 손실, 타일 간 통신 전력.[1]
따라서 필요한 지표는 단순한 컴퓨트 타일 면적이 아니라 양품 완제품 1개당 제조·조립·검사 비용입니다. 실제로 원문 표에서 비교 구성의 컴퓨트+GPU 실리콘 합계는 4-Xe 구성 122.596 mm², 12-Xe 구성 144.705 mm²로 달라집니다. 이 값들조차 I/O 타일과 수동 베이스 면적은 제외하므로 곧바로 총 웨이퍼 원가 또는 패키지 원가가 아닙니다.[1]
8. 이 자료에서 도출되는 핵심 교차 분석
A. 18A의 혁신은 단일 요소가 아니라 ‘연동된 공정 선택’이다
RibbonFET은 소자 특성을, PowerVia는 전원 경로와 신호 배선 가능성을, Mo/W·Cu·Co/Ru·Nb의 구역별 선택은 접속 저항과 제조성을 다룹니다. 어느 한 층의 이득이 다른 층의 비용을 상쇄할 때 제품 이득이 생깁니다. 예컨대 PowerVia로 신호 배선 혼잡이 줄어도 nano-TSV가 셀 공간을 차지하고, 전기적 손실이 줄어도 캐리어·절연 구조가 열 경로를 복잡하게 만들 수 있습니다.[1][4]
B. ‘N3E 수준 로직셀 밀도’는 의미 있지만 ‘TSMC와 동등한 제품’은 아니다
18A의 대표 셀 밀도가 비교한 N3E GPU 로직 영역과 유사하다는 것은 Intel의 공정·라이브러리 구현이 실물에서 경쟁 가능한 한 지점에 도달했다는 증거입니다. 그러나 동일 기능 셀, 전체 제품 성능, SRAM·아날로그 비중, 수율까지 통제한 대조시험이 아닙니다. 원문 역시 18A가 N3P·N2·SF2의 최고 밀도를 선도한다고 결론 내리지 않습니다.[1]
C. AI PC 경쟁력은 TOPS보다 데이터 이동과 전력 상태 전환에서 갈릴 수 있다
NPU는 면적을 줄이는 대신 로컬 저장 자원을 재편했고, GPU는 큰 L2와 타일 간 링크를 조합했습니다. CPU·NPU·GPU가 실제 추론 파이프라인에서 데이터를 어디에 보관하고 몇 번 이동시키는지에 따라 에너지와 지연시간이 달라집니다. 특히 타일을 가로지르는 GPU 메모리 접근, NPU의 scratchpad 부족 시 DRAM 왕복, 유휴 도메인의 수면·기상 비용은 peak TOPS나 면적표에서 보이지 않는 변수입니다.[1]
D. 수율은 ‘18A 웨이퍼 수율’과 ‘완제품 수율’로 나눠야 한다
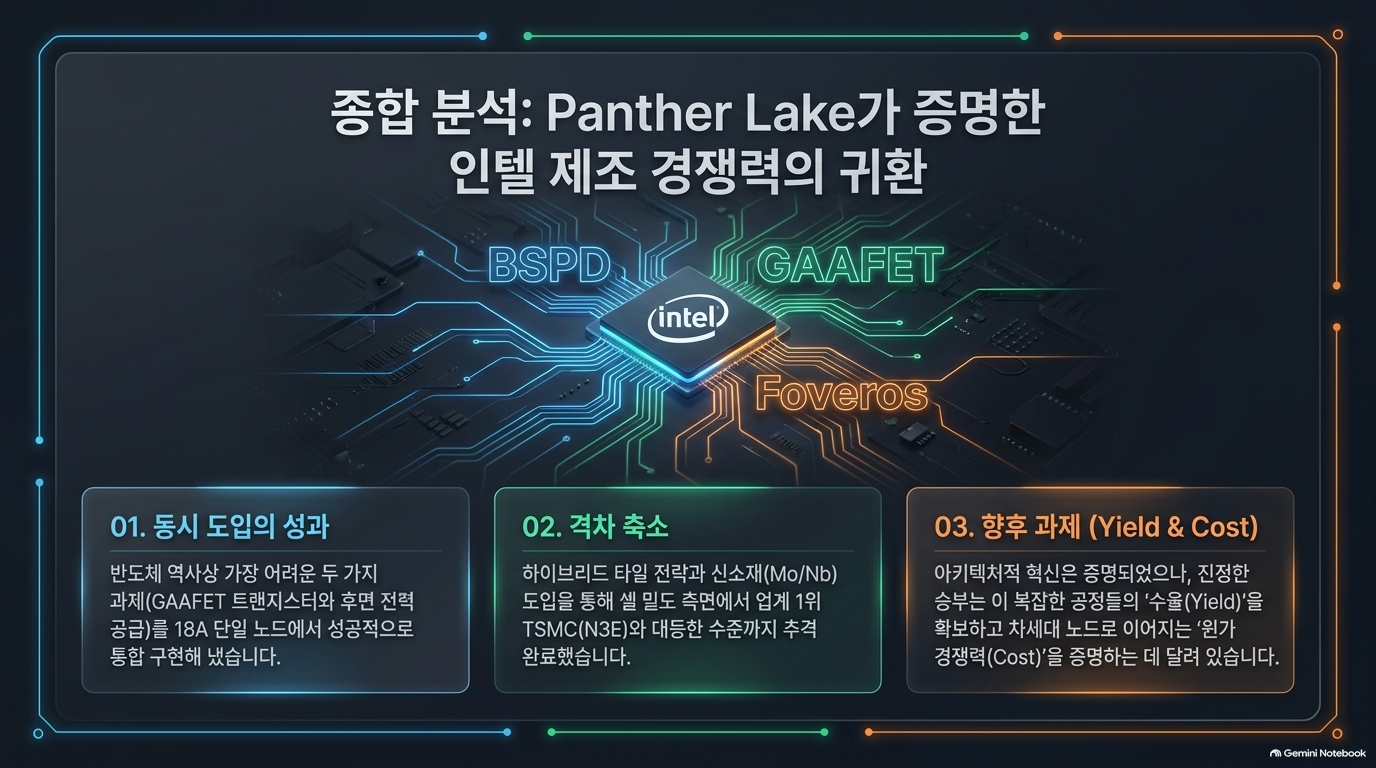
칩렛 구성은 각 다이를 선별할 수 있지만 패키지 접합에도 불량이 생길 수 있습니다. 경쟁력 판단에는 18A 컴퓨트 양품률, 다른 타일 양품률, 조립 후 양품률, 재검사·폐기 비용이 모두 필요합니다. 첨부 보고서가 마지막 쪽에 배치한 Yield & Cost는 부수적 향후 과제가 아니라 ‘Intel 제조 경쟁력의 귀환’이라는 결론의 필수 검증 조건입니다.[1]
9. 후속 검증 매트릭스
| 판단하려는 주장 | 현재 확보된 증거 | 추가로 필요한 검증 |
| 18A가 실제 출하 가능한가 | RibbonFET·nano-TSV·후면 배선·패키지의 실물 단면 | 제품군·물량·기간별 반복 생산 및 신뢰성 |
| 소자/배선이 전력 효율을 개선하는가 | 구조와 재료 관찰; Intel의 설계 비교 자료 | 동일 기능·전압·온도·누설 기준 PPA, 지속 부하 열 측정 |
| N3E보다 우수한가 | 서로 다른 CPU/GPU 영역의 대표 셀 밀도 비교 | 동등한 회로·라이브러리 조건의 배치배선 결과와 전체 칩 구성 비교 |
| NPU 축소에도 추론 성능이 유지되는가 | 36.9% 면적 절감, NCE·메모리 구조 재편 | 모델별 정확도·지연시간·지속 처리량·DRAM 트래픽·와트당 성능 |
| Foveros-S가 경제적인가 | 타일 재사용·선별 가능성, 국소 패키지 치수 | 양품 완제품당 비용, D2D 에너지, 조립 수율, 실제 링크 대역폭 |
최종 판정: 첨부 보고서의 “Intel 제조 경쟁력의 귀환”은 출하 가능한 선단 공정의 재확립이라는 뜻으로는 설득력이 있습니다. 이를 최고 공정 우위 또는 지속 가능한 사업상 우위로 확장하려면, 해체 분석이 제공하지 않는 제품 PPA·양산 수율·완제품 원가의 비교 증거가 필요합니다.[1]
출처와 범위
- [1] SemiAnalysis, Intel Panther Lake Teardown — 단면·재료·셀 치수·플로어플랜·패키지 관찰. 공개 본문 기준이며 유료 후속 구간은 분석 범위 밖입니다.
- [2] Intel Foundry, Foveros Technology Brief — 명목 Foveros-S 구조·피치.
- [3] Intel, Hot Chips 2026 Architecture Overview — Wildcat Lake와 UCIe.
- [4] Intel Foundry, Intel 18A Process Node Family Technology Brief — 제조사 제시 공정·전력·열 비교.
- [5] imec, Backside power delivery — 후면 전원망의 기술적 동기.
- [6] Intel, Lunar Lake Architecture Fact Sheet — Lunar Lake 타일 구성의 확인.
'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - Semianalysis, ClusterMAX 3.0:글로벌 GPU 클라우드 평가 보고서 (0) | 2026.09.26 |
|---|---|
| AI 반도체 - EPOCH AI, 화웨이와 엔비디아의 연간 연산 공급량 격차 (0) | 2026.09.26 |
| AI 반도체 - Semianalysis, 중국 AI 인프라 폭발 (0) | 2026.09.26 |
| AI 반도체 - TrendForce, HBM 밖으로 확장되는 KV 캐시: QLC SSD POD (0) | 2026.09.24 |
| AI 반도체 - HBM을 넘어선 3D-DRAM: AI 추론 가속기의 메모리 병목을 풀 수 있을까? (0) | 2026.09.23 |