반응형
https://arxiv.org/abs/2601.11822
2026.1.16
[RAPID-Serve: Resource-efficient and Accelerated P/D Intra-GPU Disaggregation]
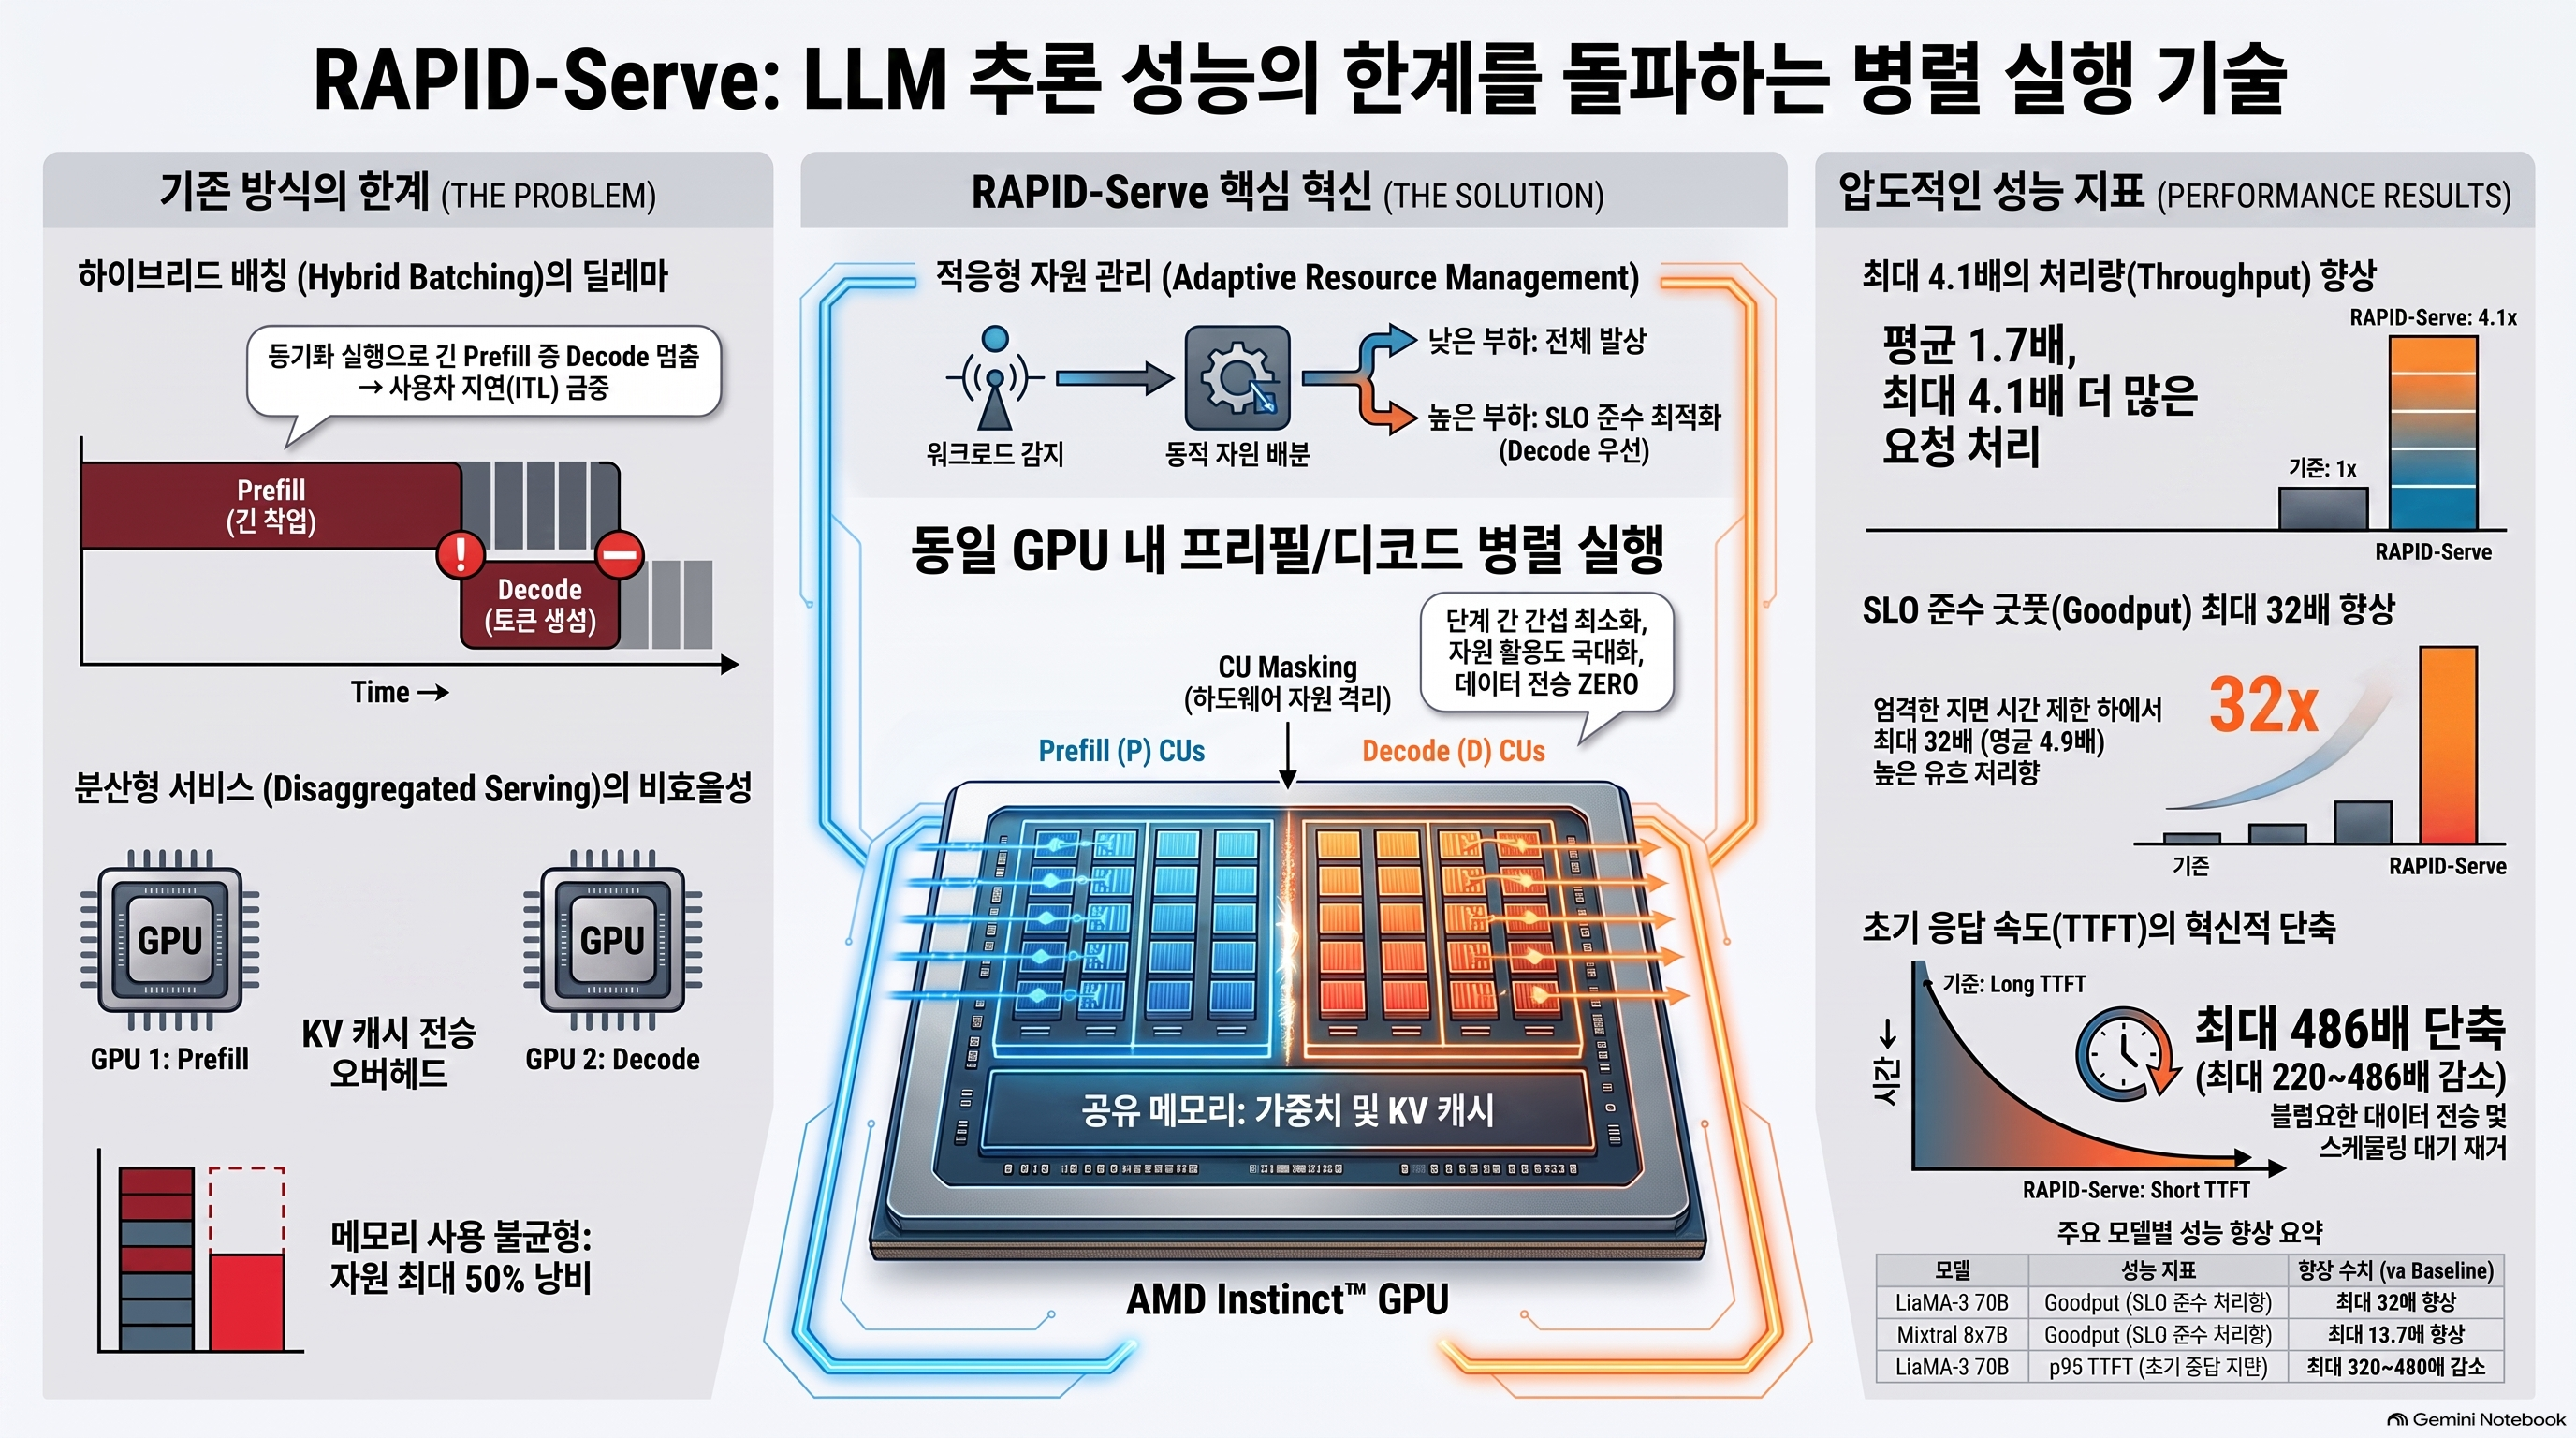
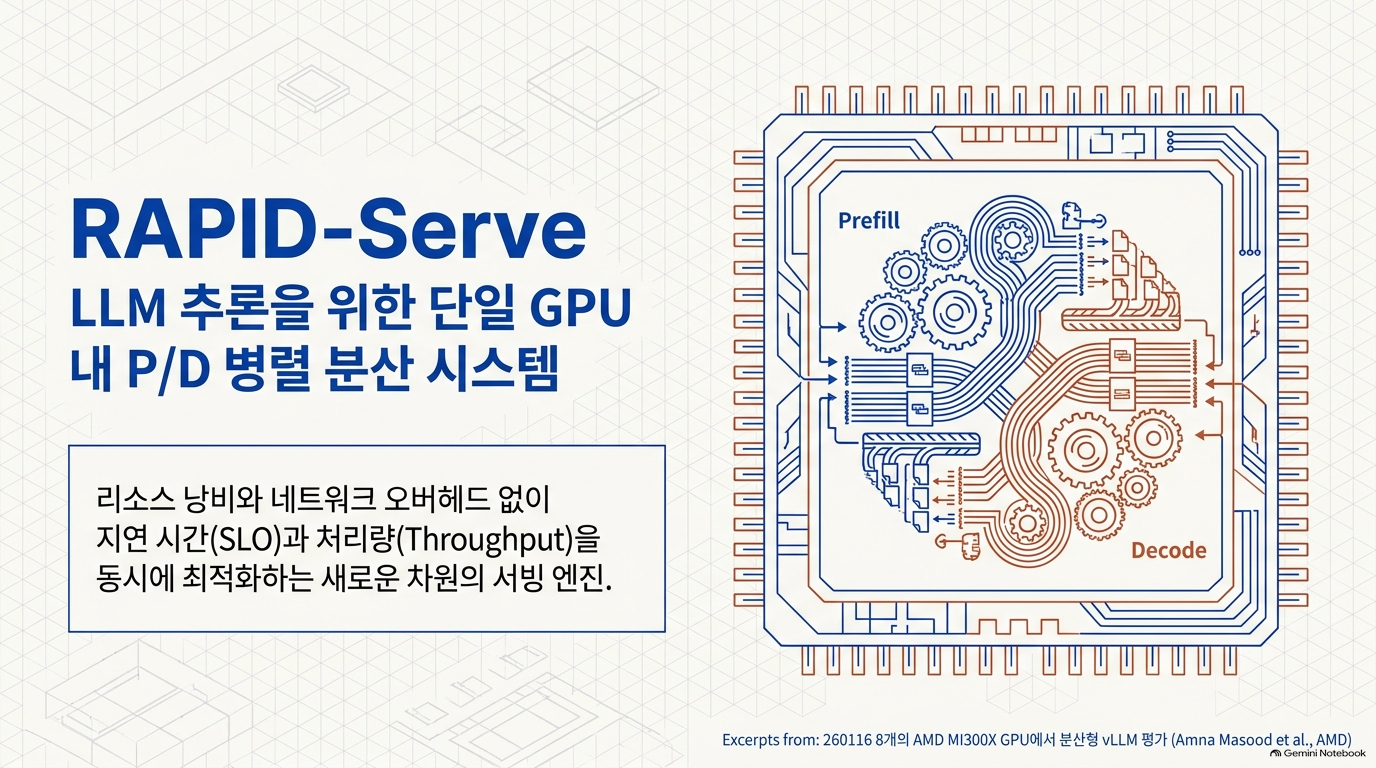
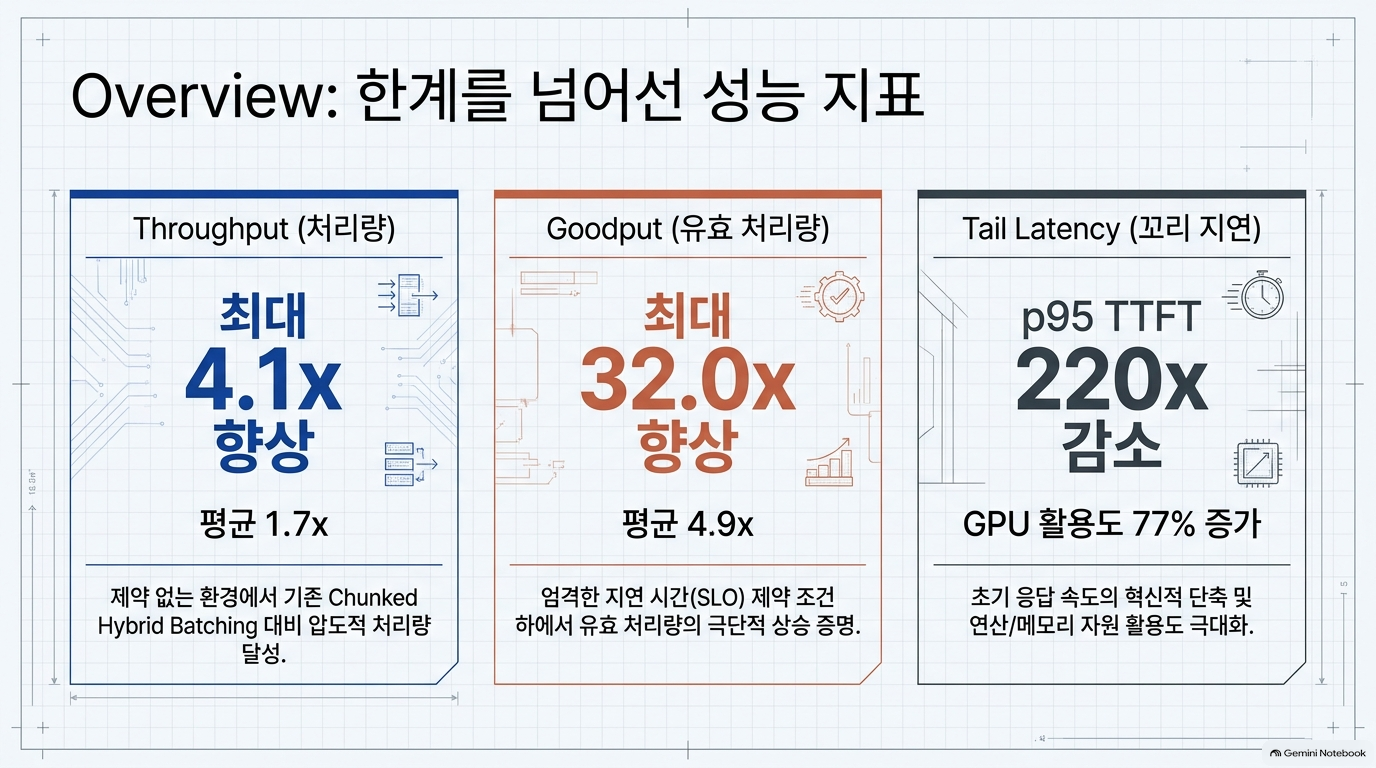
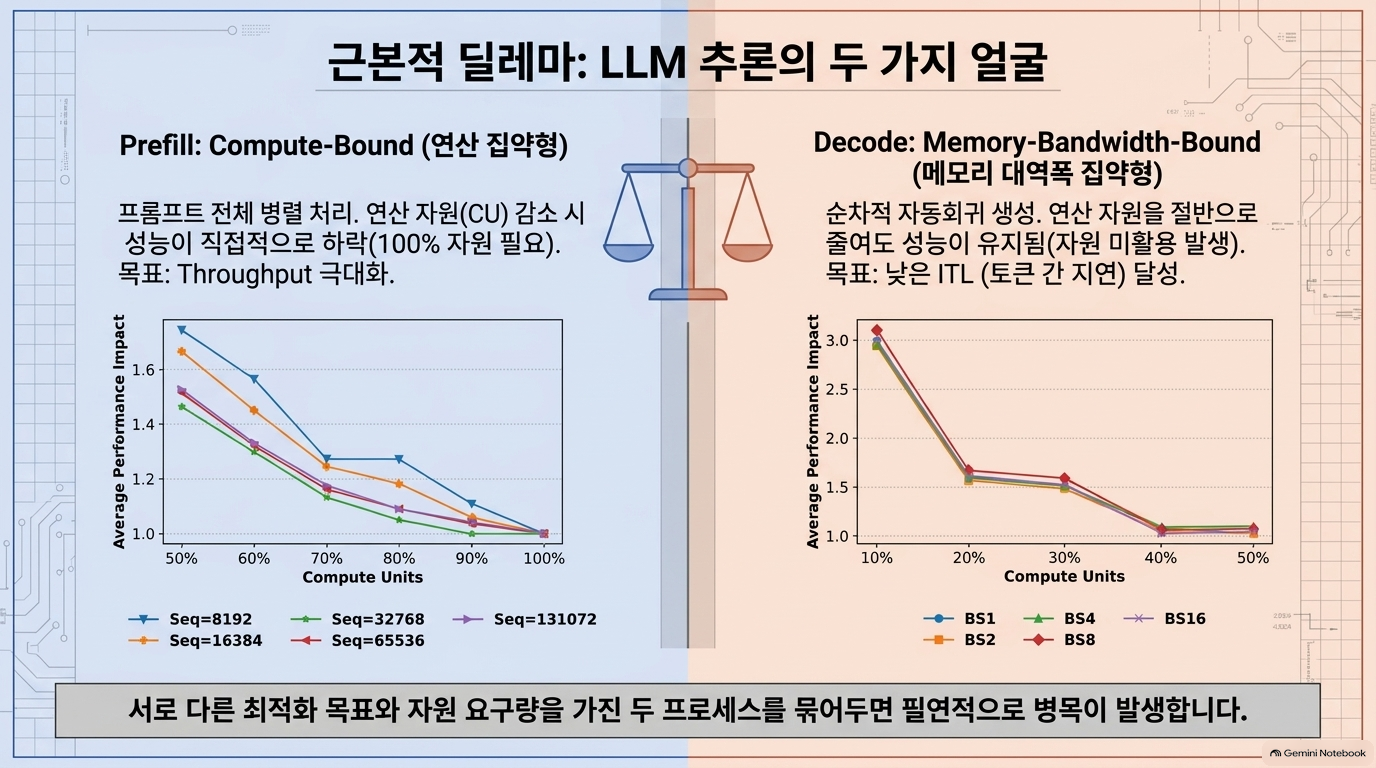
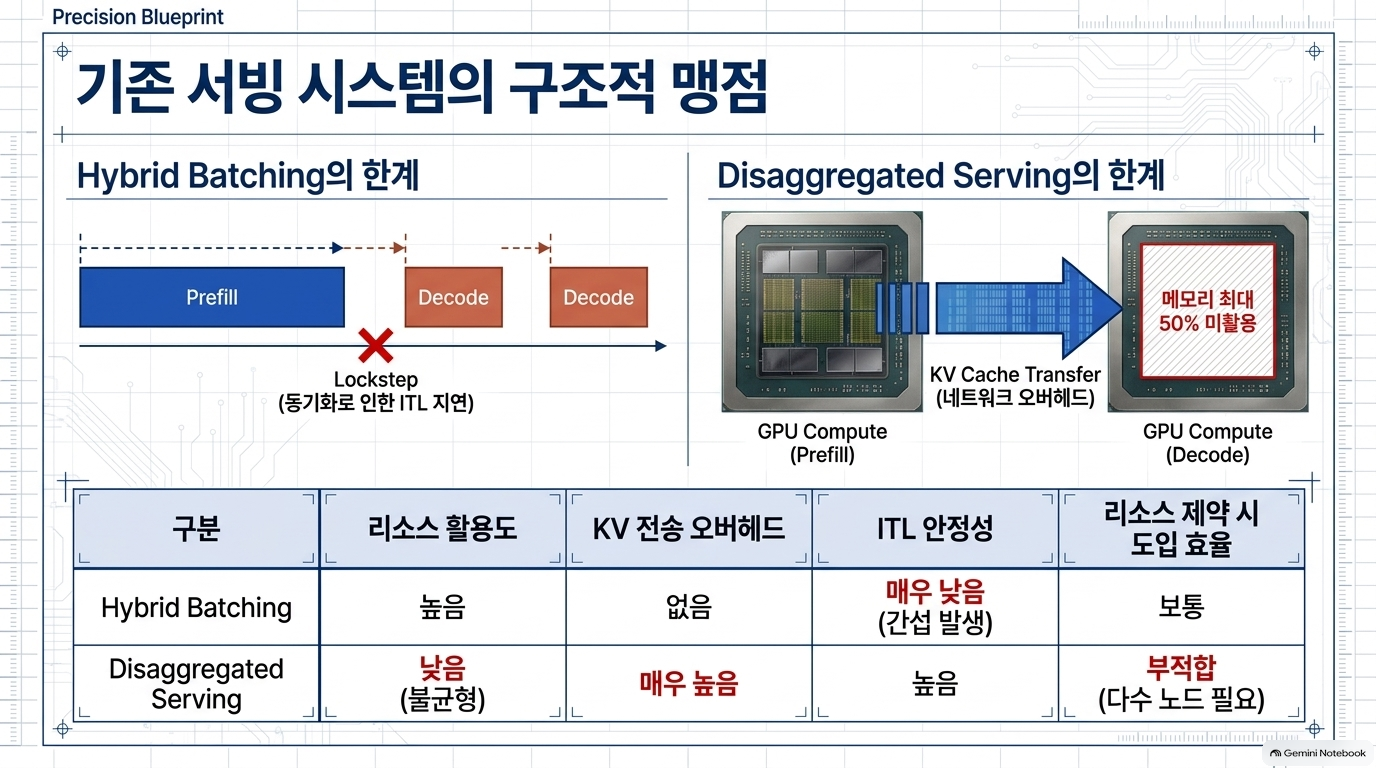
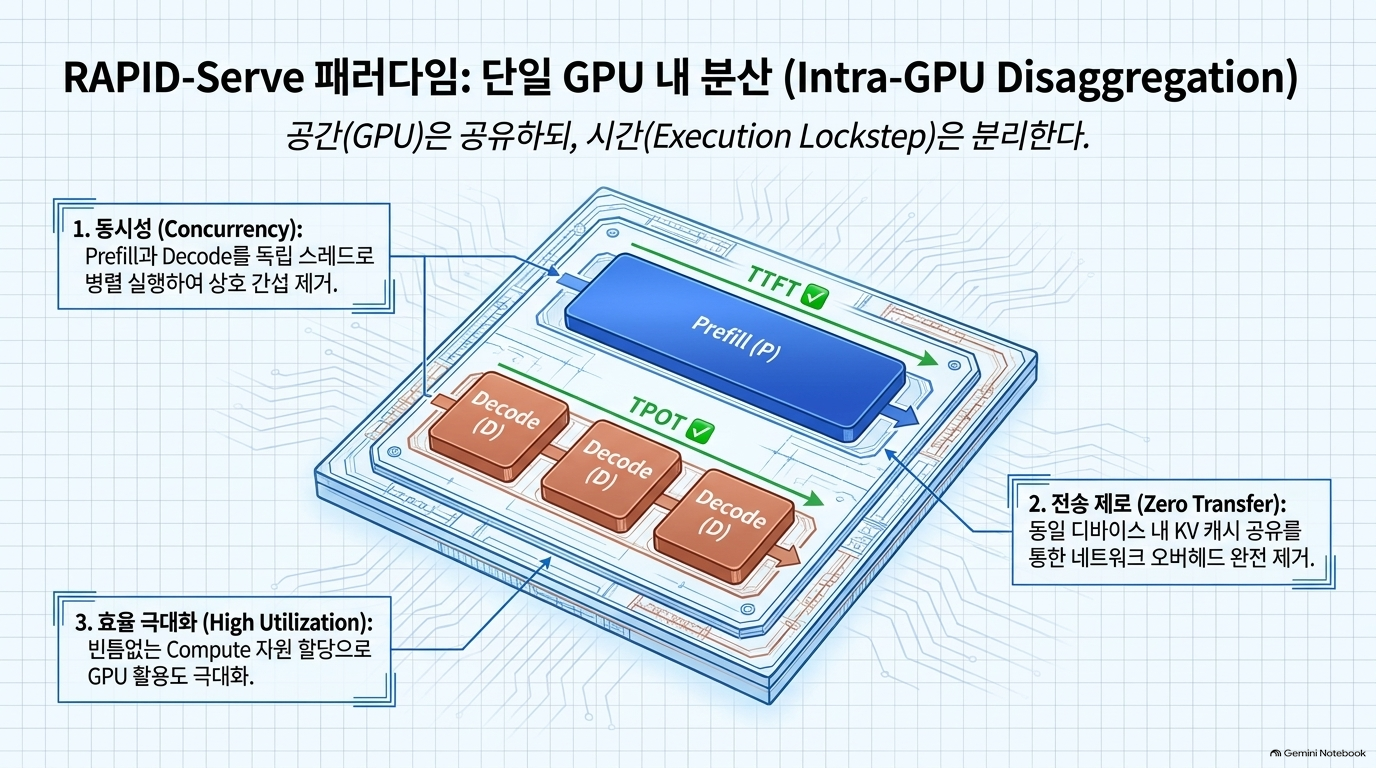
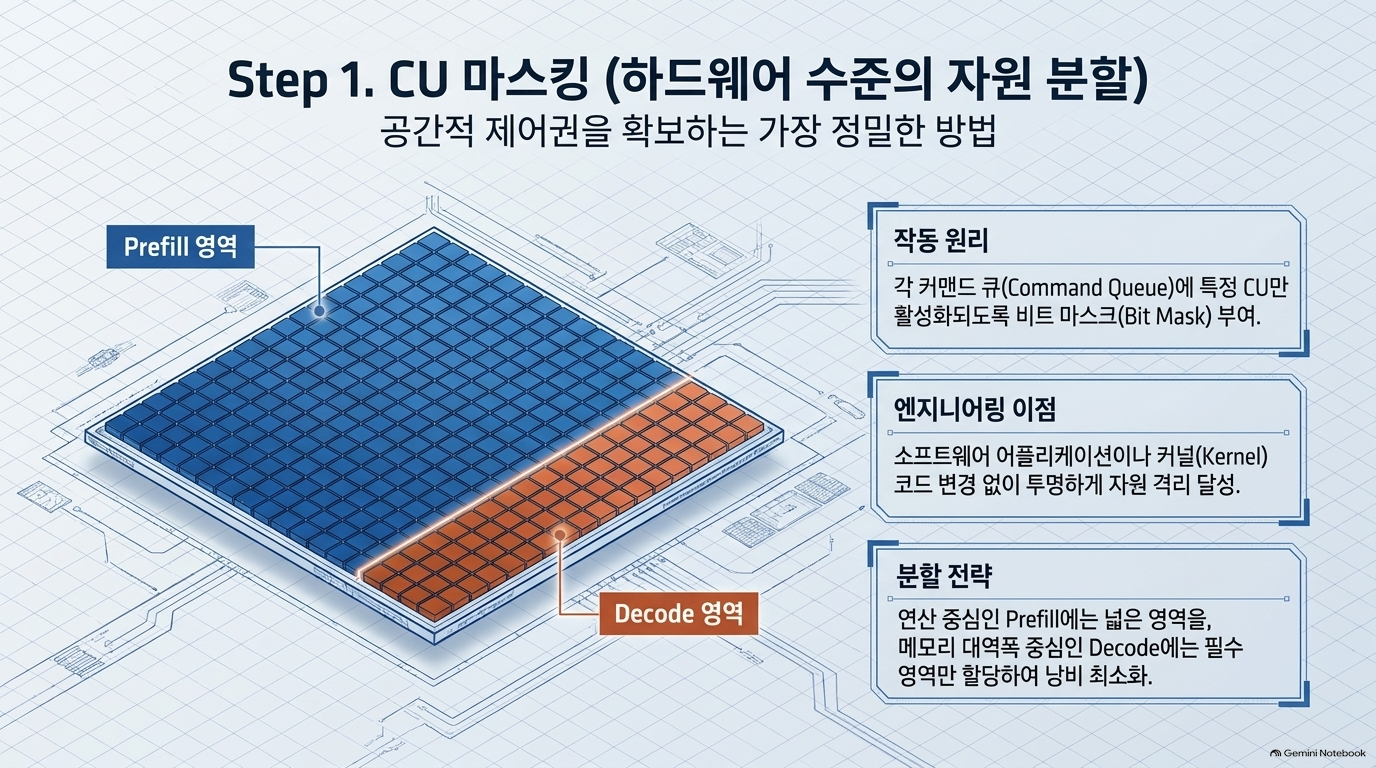
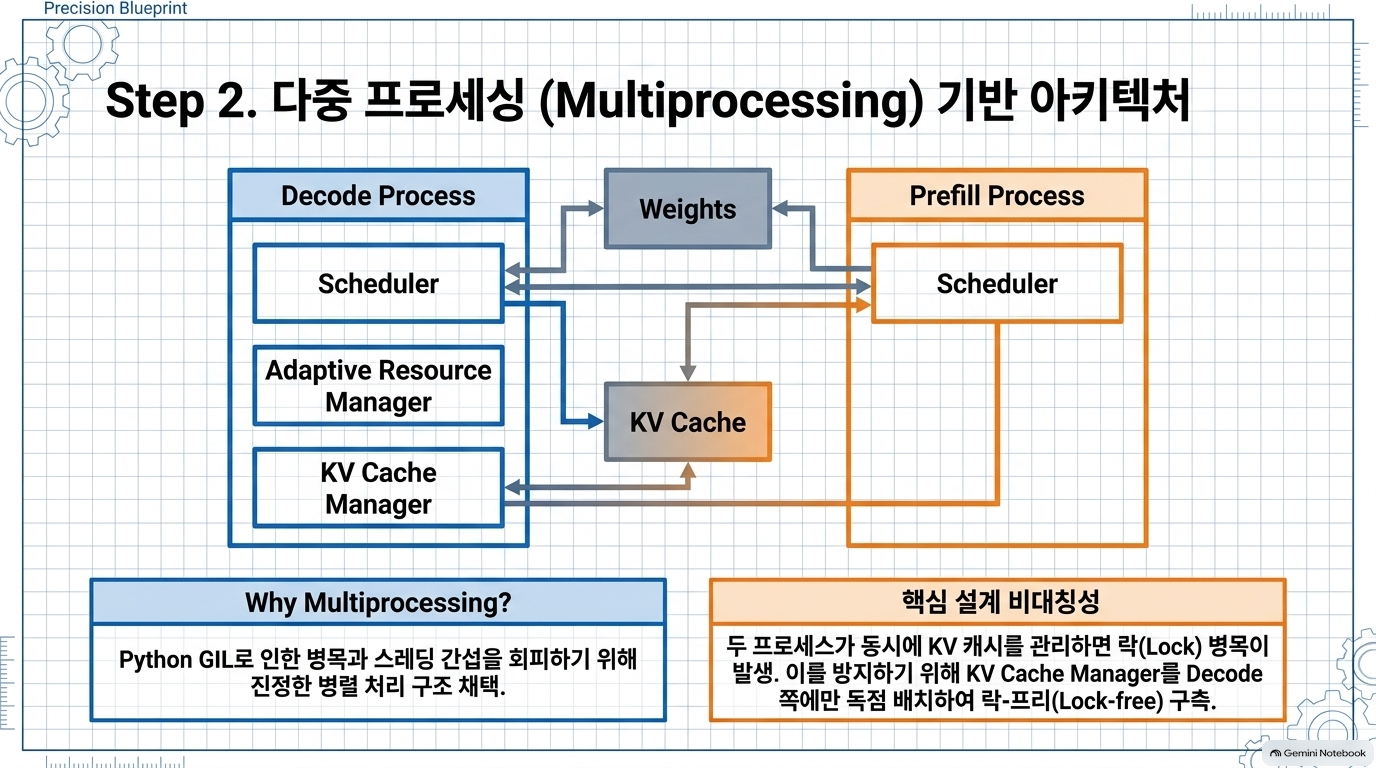
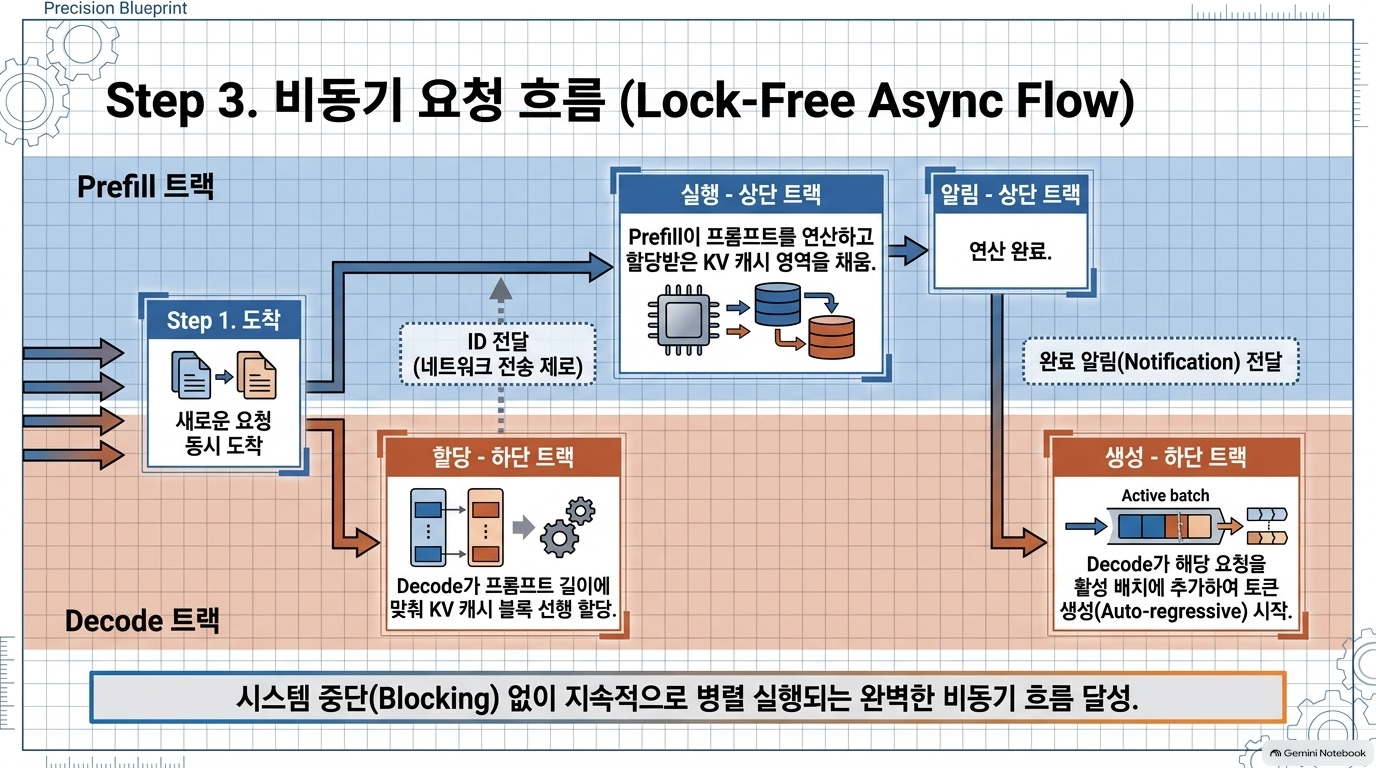
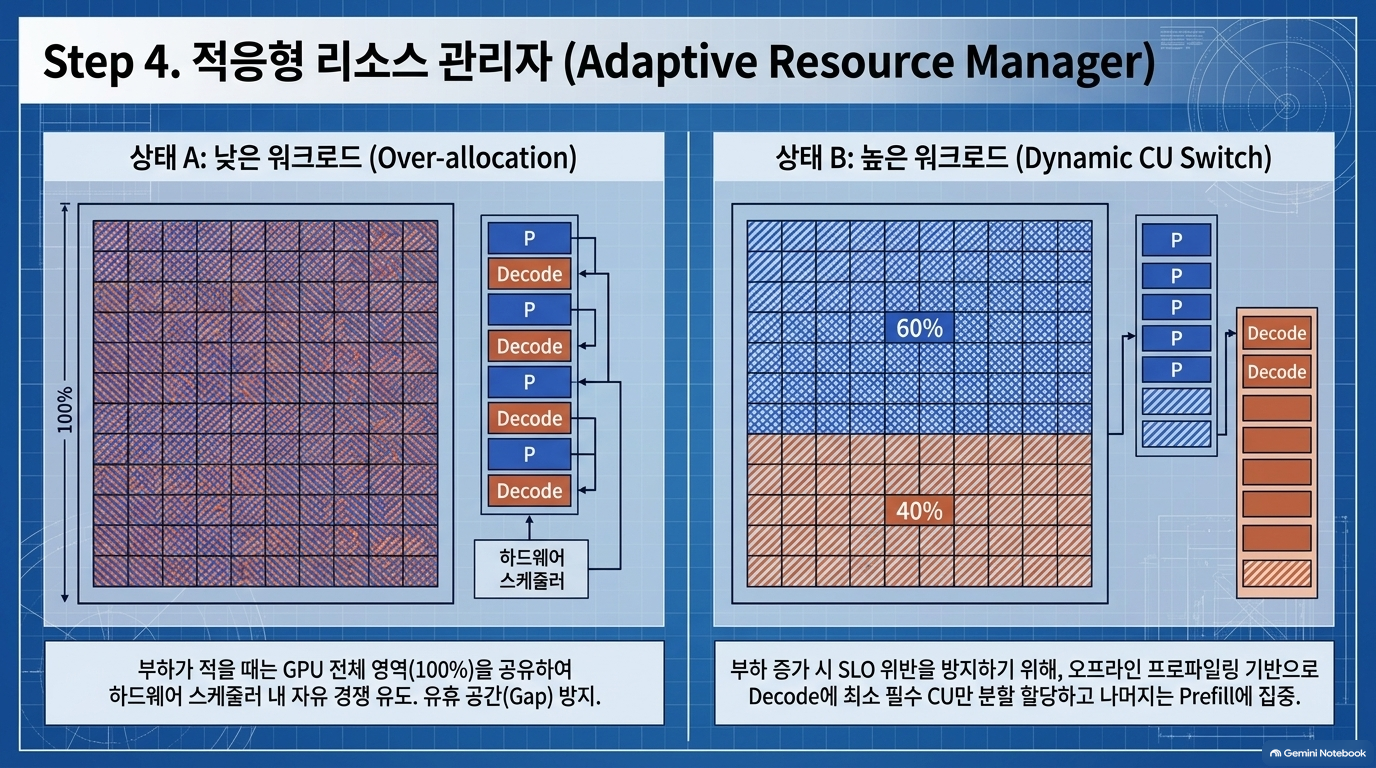
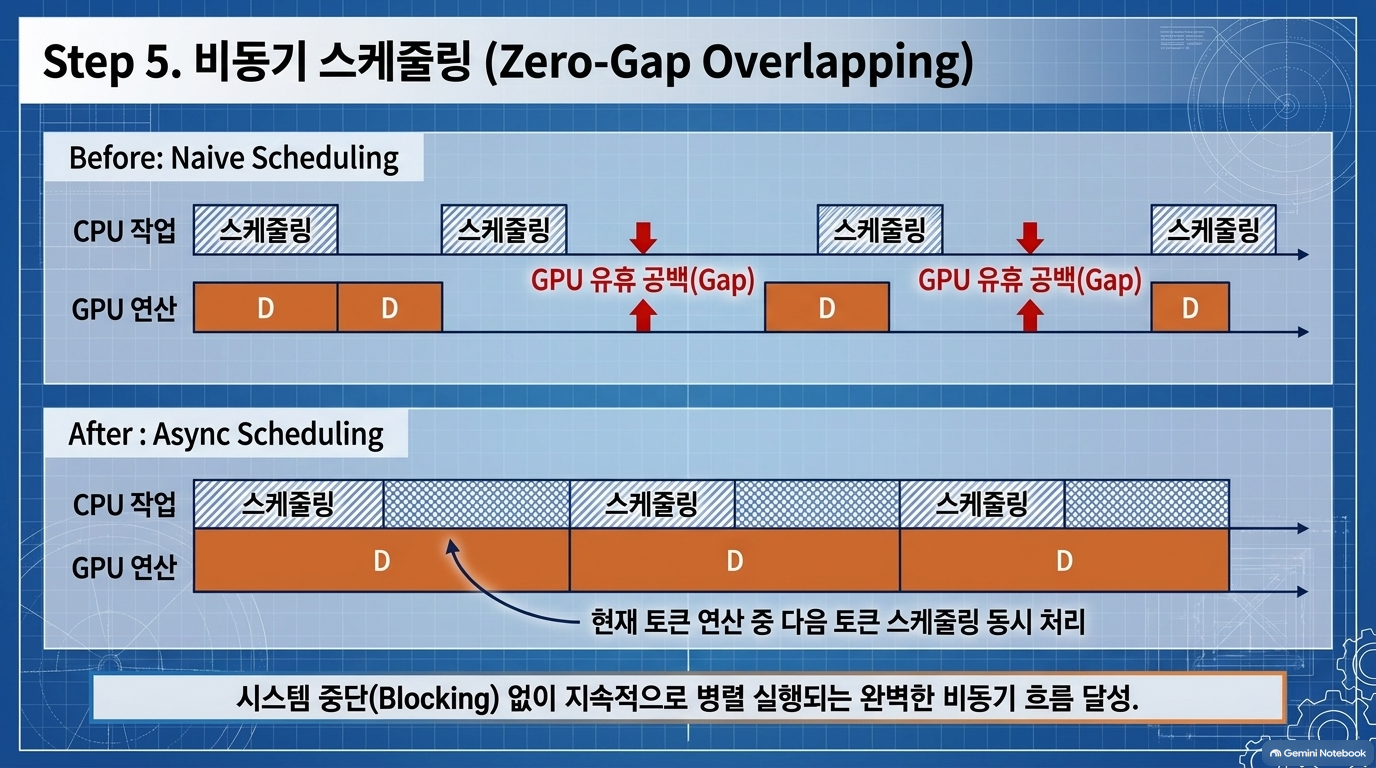
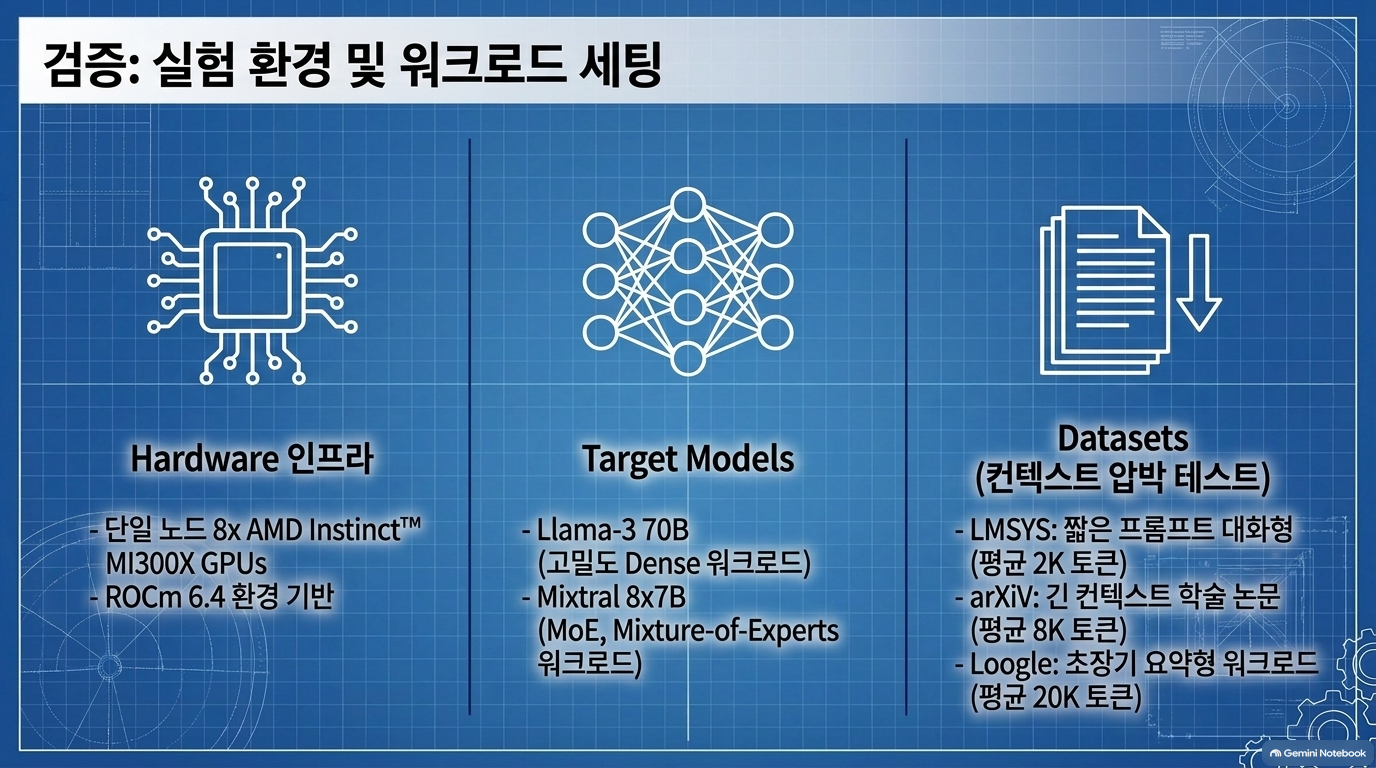
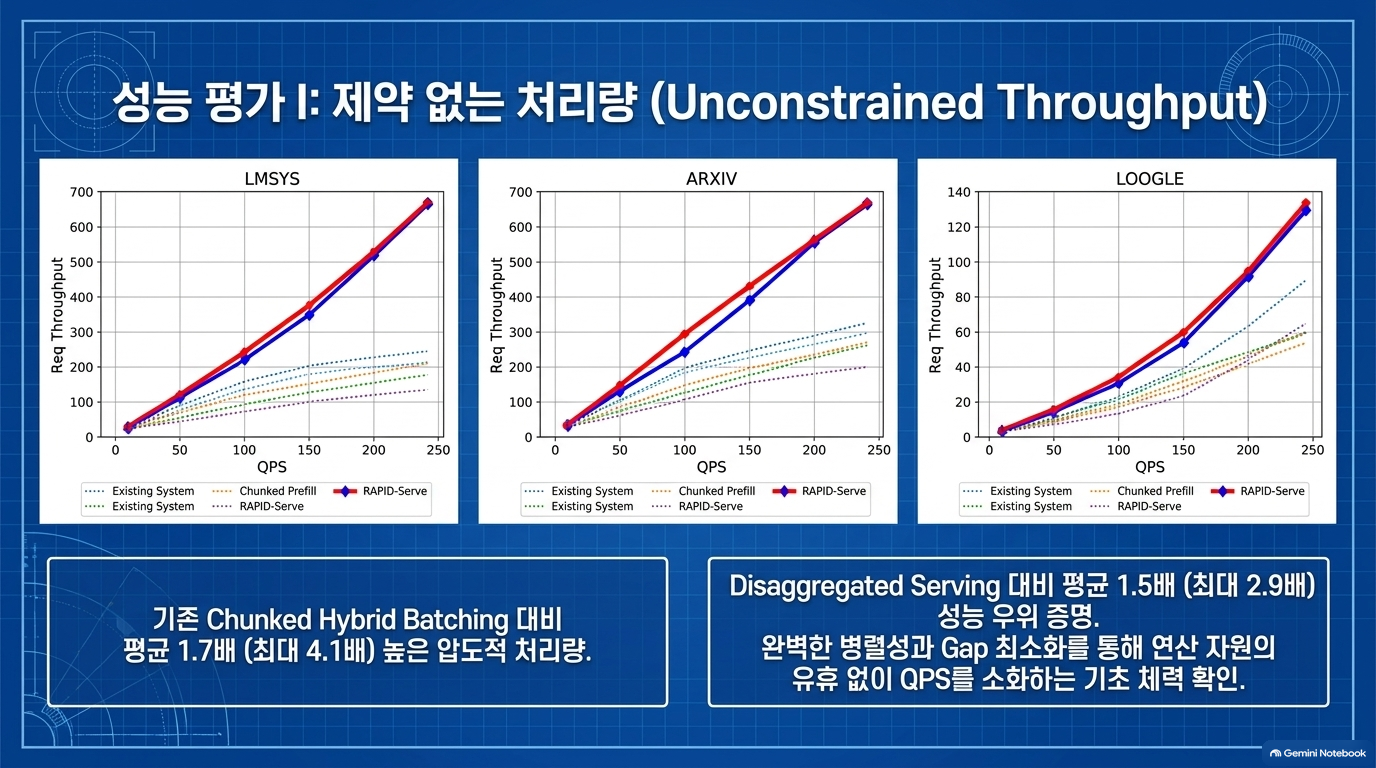
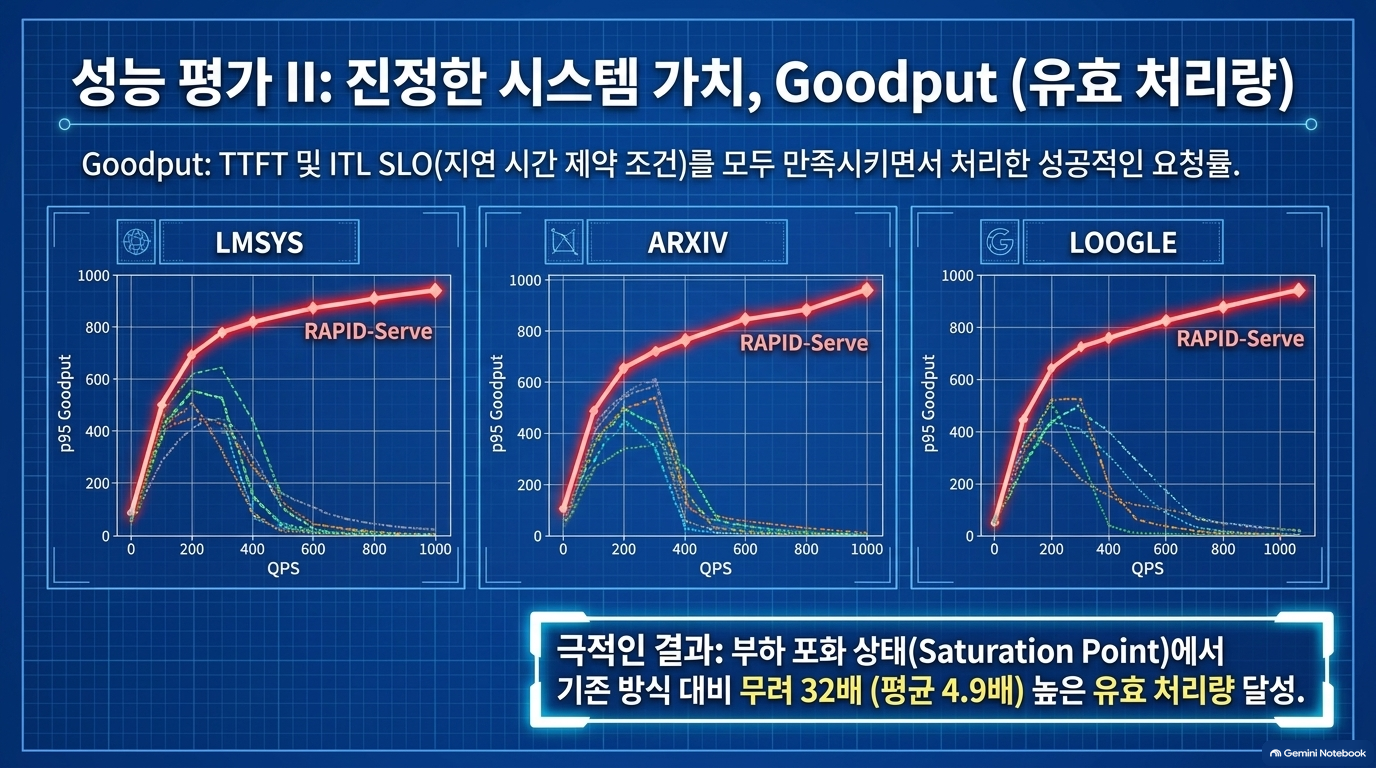
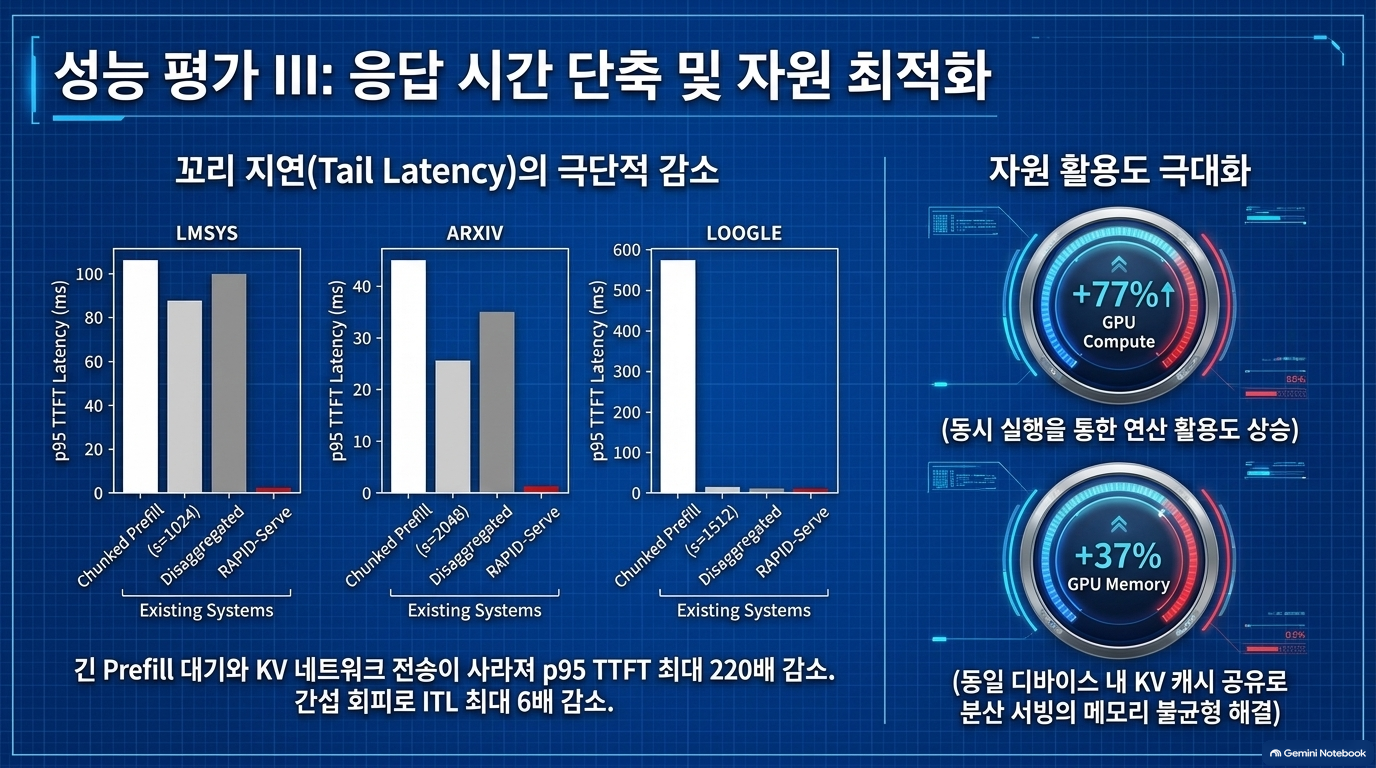
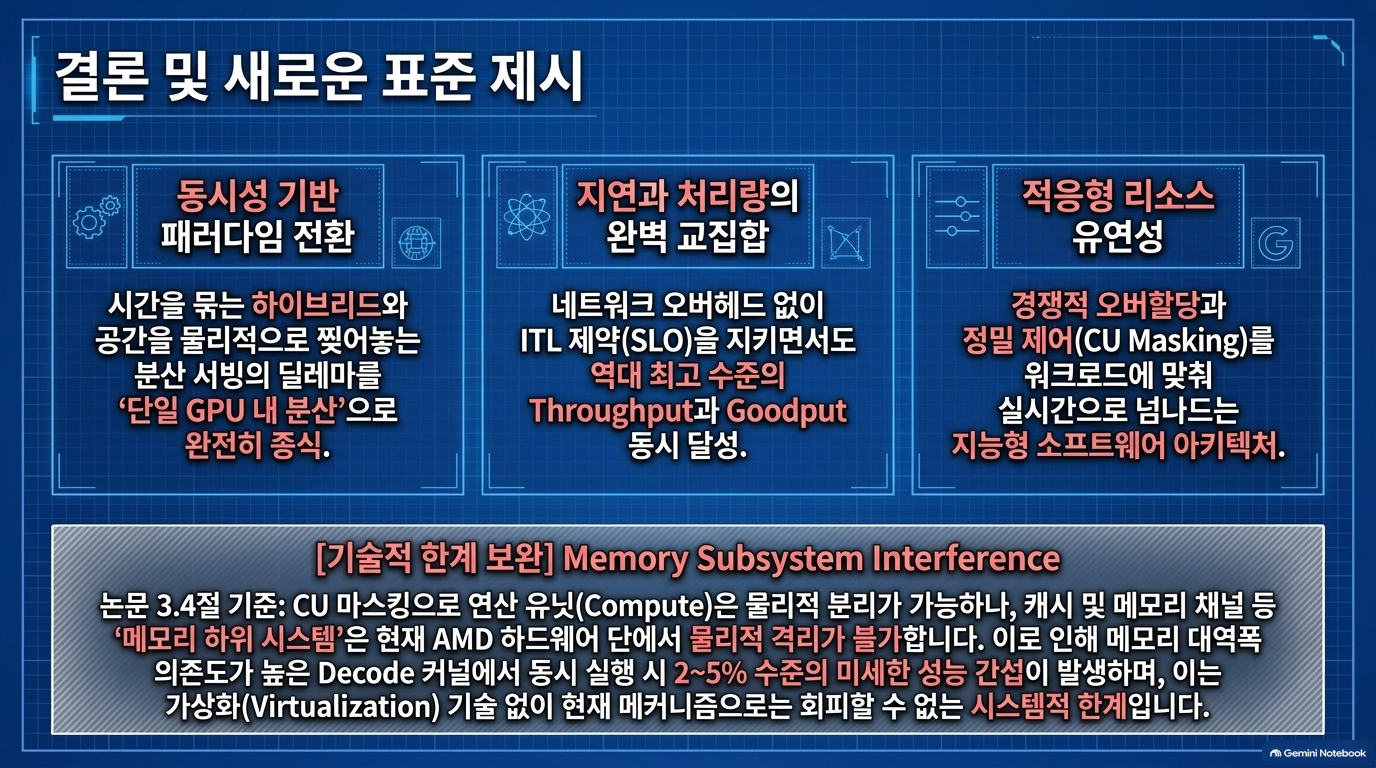
이 논문은 대규모 언어 모델(LLM) 추론의 두 단계인 프리필(prefill)과 디코드(decode)를 단일 GPU에서 동시에 실행하여 시스템 효율을 극대화하는 RAPID-Serve 기술을 소개합니다. 기존의 하이브리드 배칭은 지연 시간이 늘어나고 분산형 서비스는 데이터 전송 부하가 발생하는 한계가 있었으나, 이 방식은 컴퓨팅 유닛(CU) 마스킹을 통해 자원을 정밀하게 배분함으로써 두 기술의 장점만을 결합했습니다. 특히 워크로드에 맞춰 자원을 유연하게 할당하는 적응형 자원 관리를 도입하여, 한정된 자원 환경에서도 처리량(throughput)을 대폭 향상시키고 서비스 수준 목표(SLO)를 효과적으로 충족합니다. 결과적으로 AMD Instinct GPU 환경에서 기존 방식 대비 최대 32배의 유효 처리량 개선을 입증하며 차세대 추론 시스템의 효율적인 설계 방향을 제시합니다.
728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| 추론 서빙(Serving) 최적화 - AI 첫 응답 속도(TTFT) 최적화 (0) | 2026.08.28 |
|---|---|
| 추론 서빙(Serving) 최적화 - 클라우드 환경에서 대규모 언어 모델(LLM)을 위한 효율적인 서버리스 추론 서비스 구현 (0) | 2026.08.28 |
| 추론 서빙(Serving) 최적화 - Kairos: 분산형 LLM 서빙 스케쥴 (0) | 2026.08.28 |
| LLM - 추론 최적화 - Naver D2: 검색 AI 모델 서빙 성능 극대화하기 (0) | 2026.08.27 |
| 토큰 경제 - 시타델 증권(Citadel Securities), AI 인프라 투자의 정당성 (0) | 2026.08.24 |