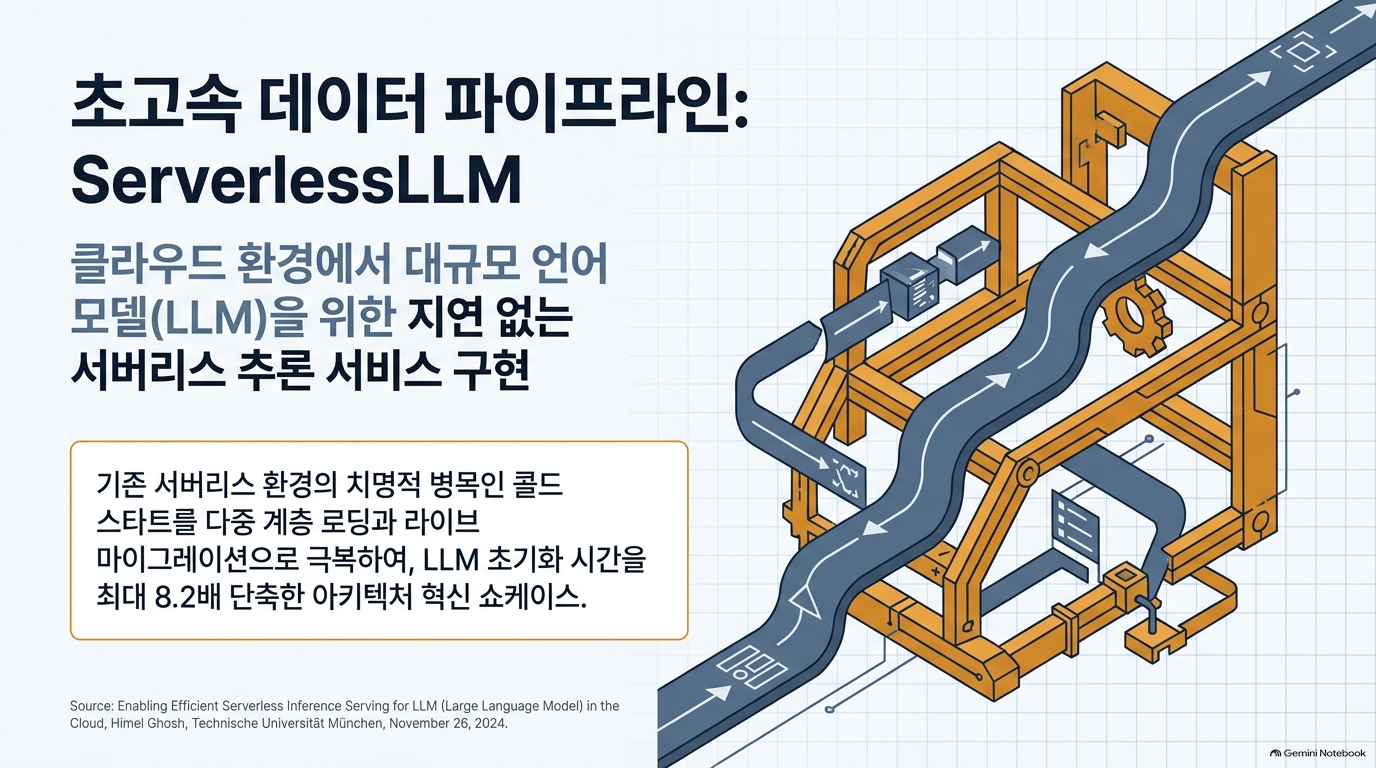
추론 서빙(Serving) 최적화 - 클라우드 환경에서 대규모 언어 모델(LLM)을 위한 효율적인 서버리스 추론 서비스 구현
07.AI/4.AI 비용 2026. 8. 28. 17:39반응형
https://arxiv.org/pdf/2411.15664
2024.11.23
[Enabling Efficient Serverless Inference Serving for LLM (Large Language Model) in the Cloud]
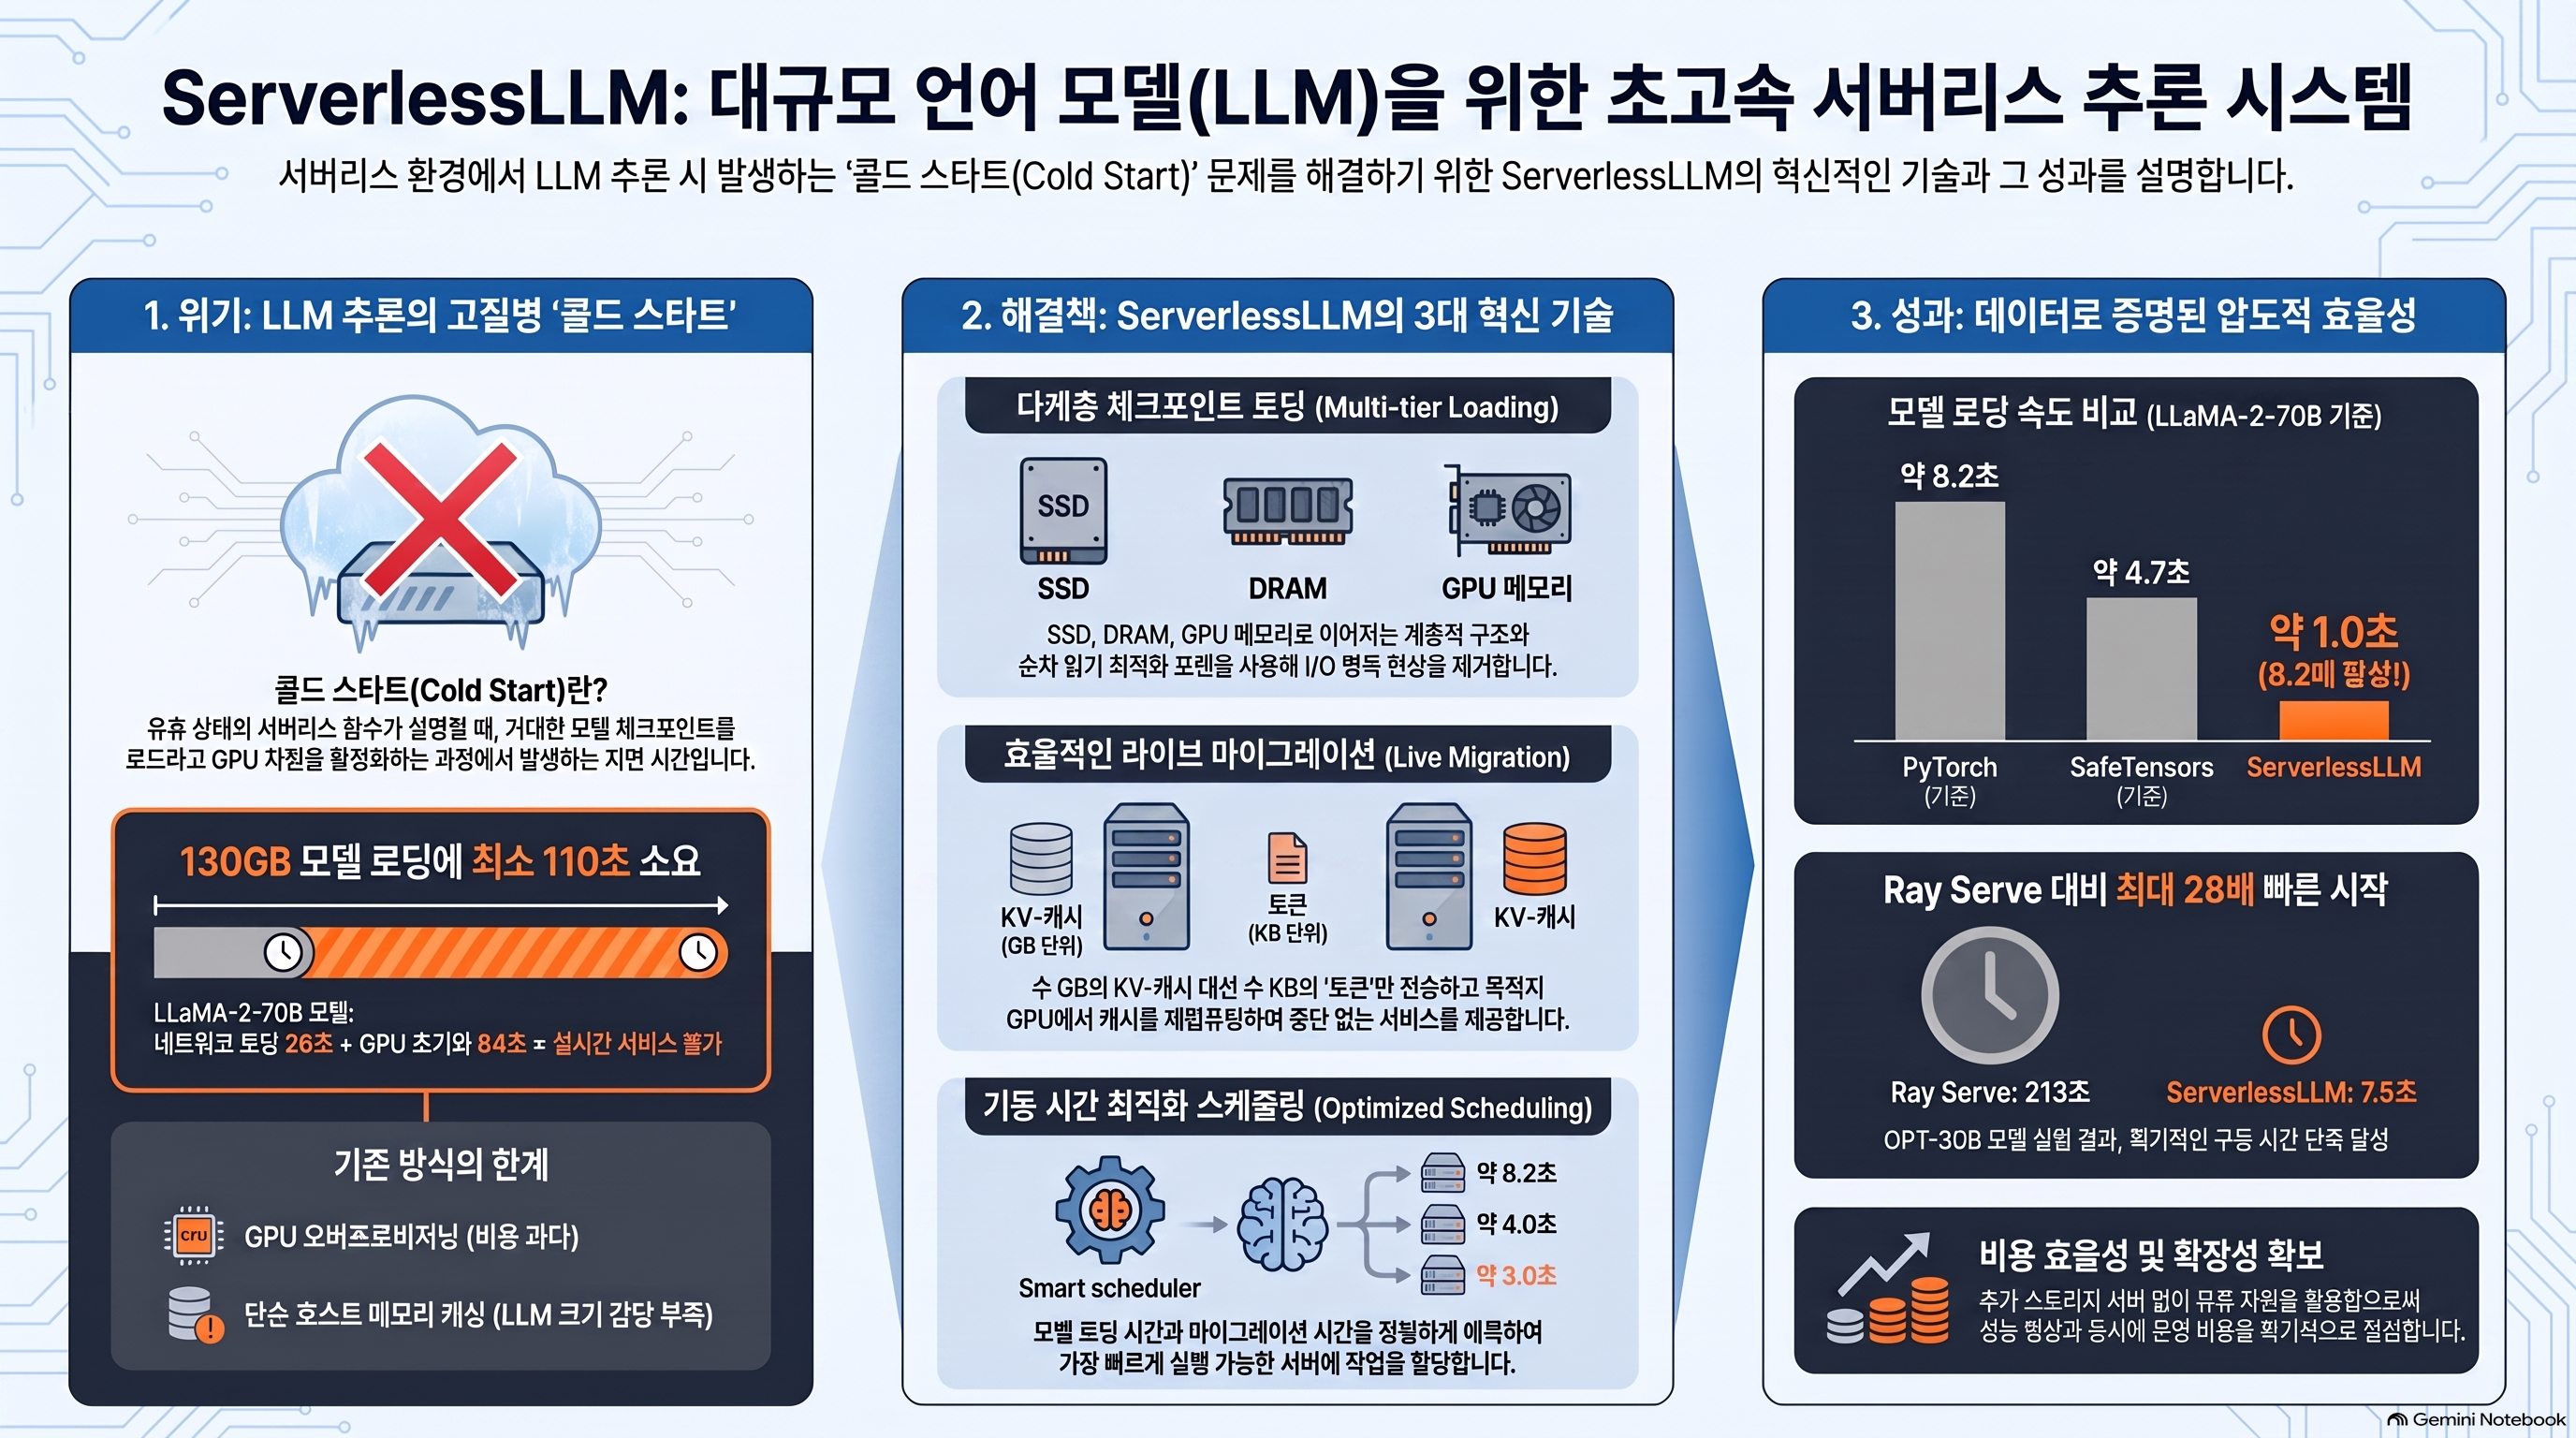
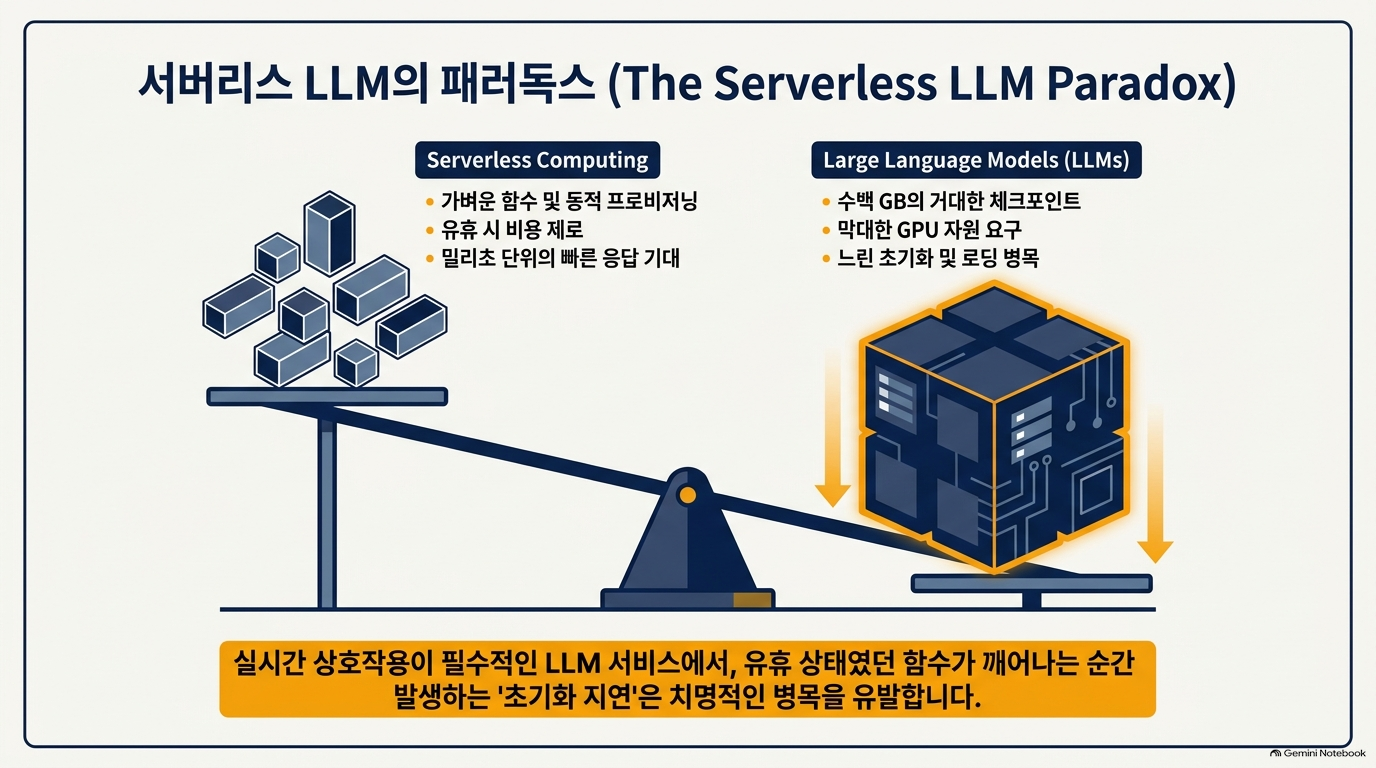
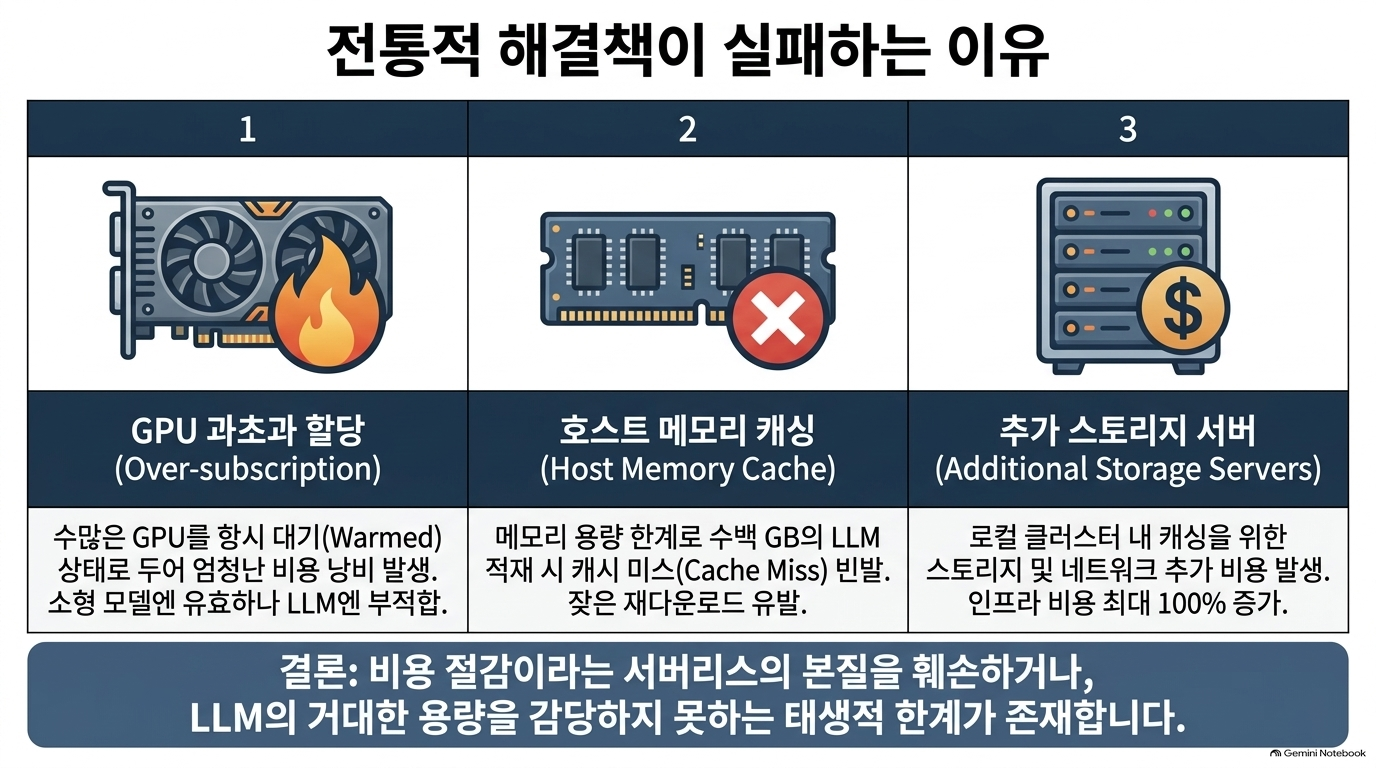
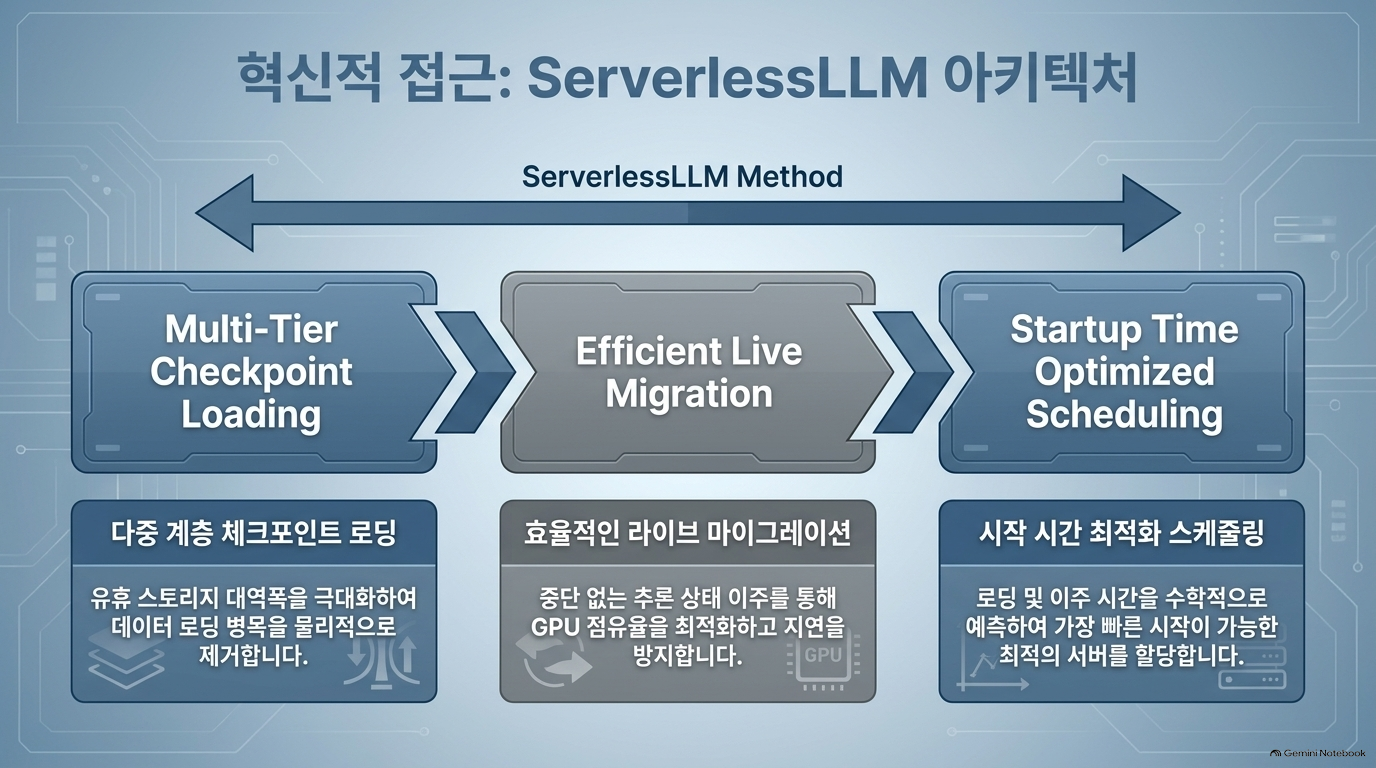
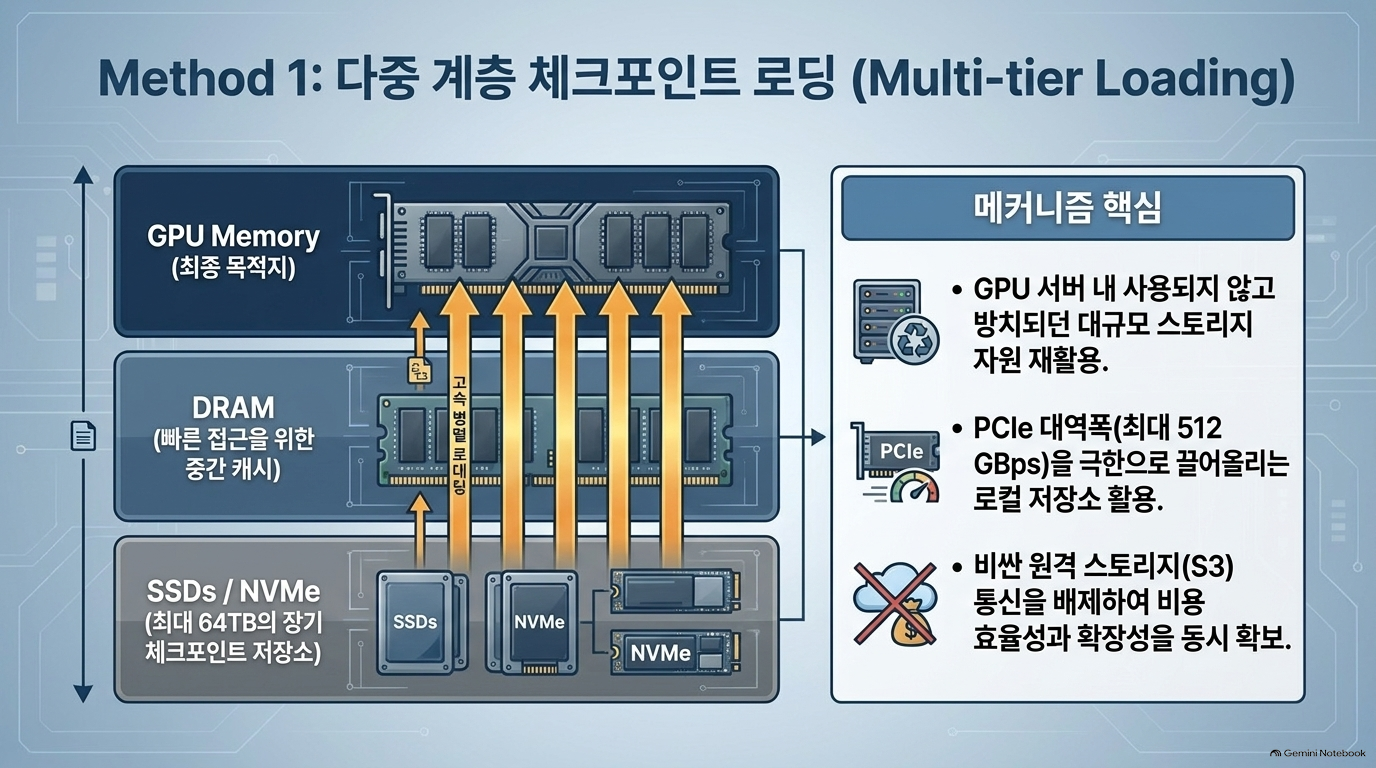
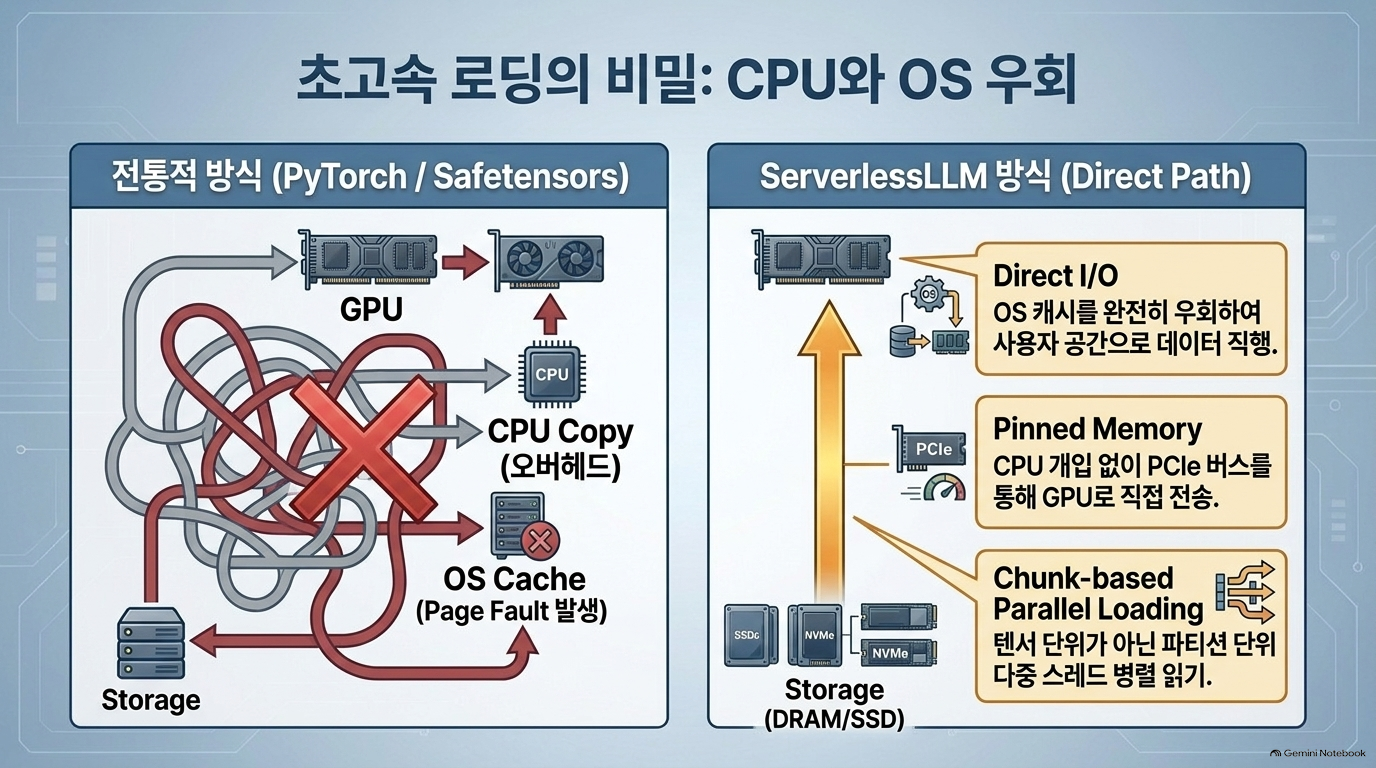
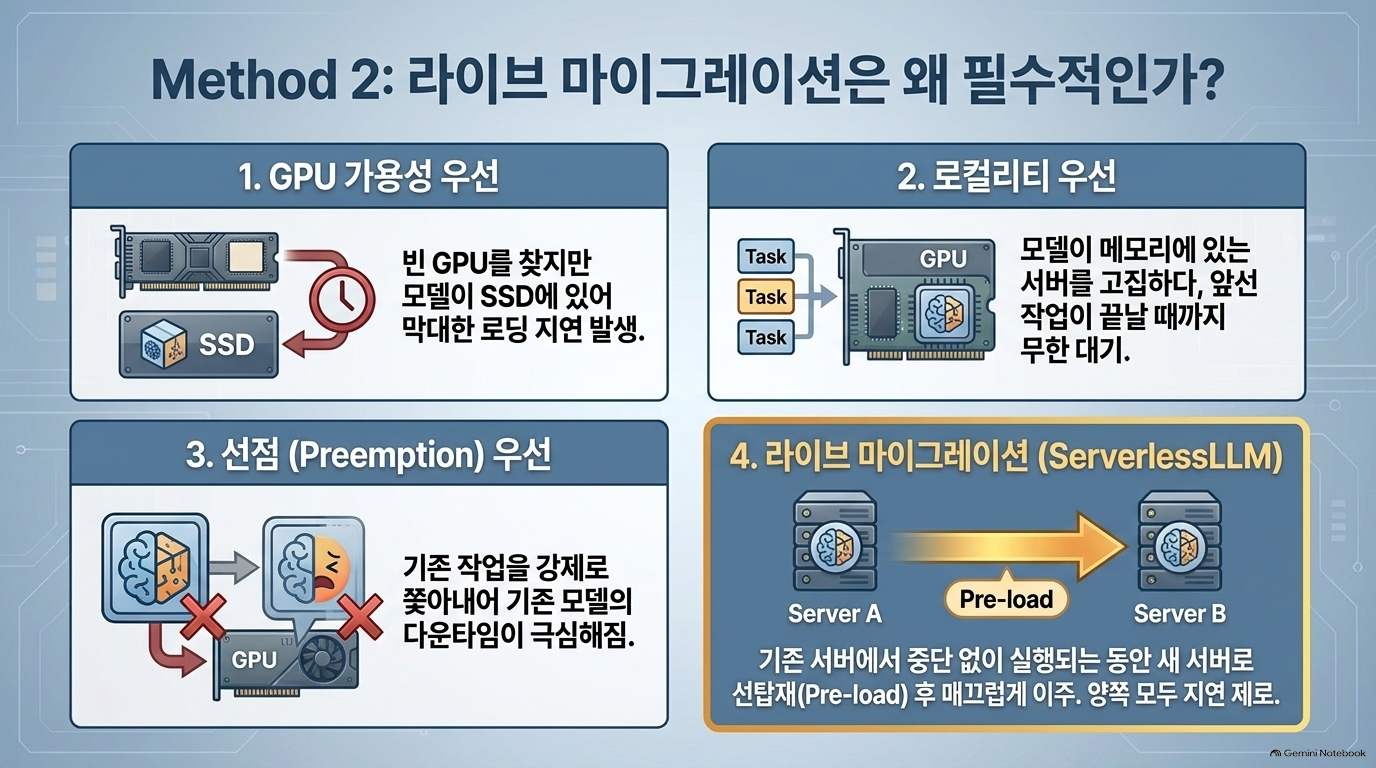
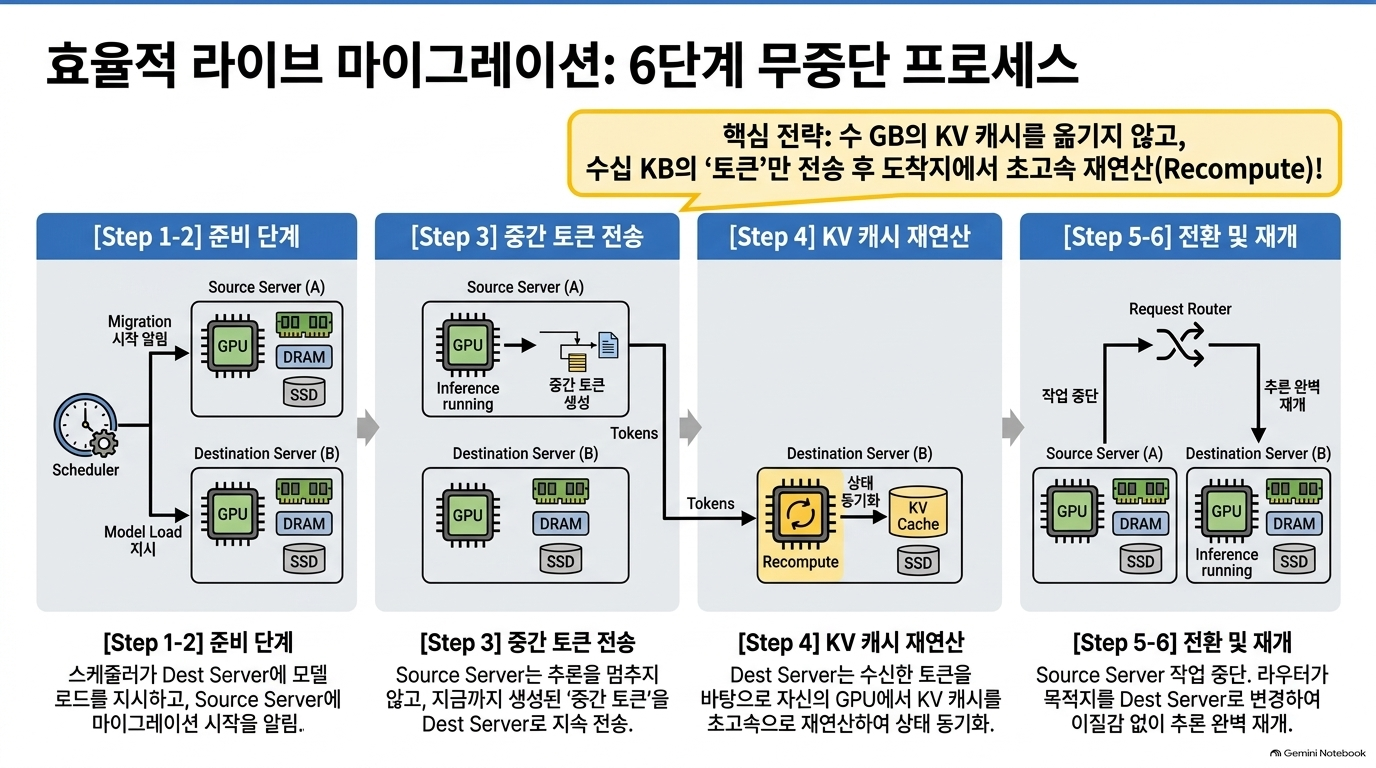
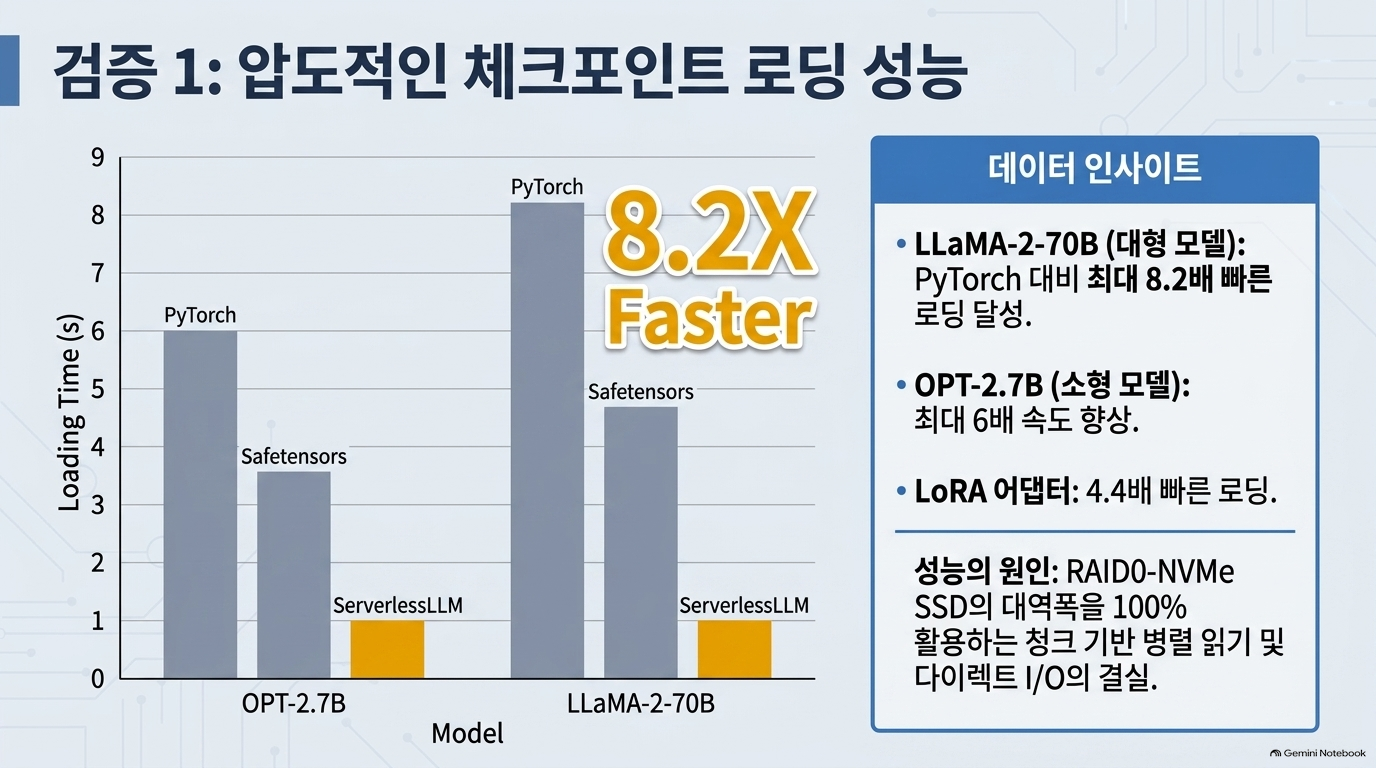
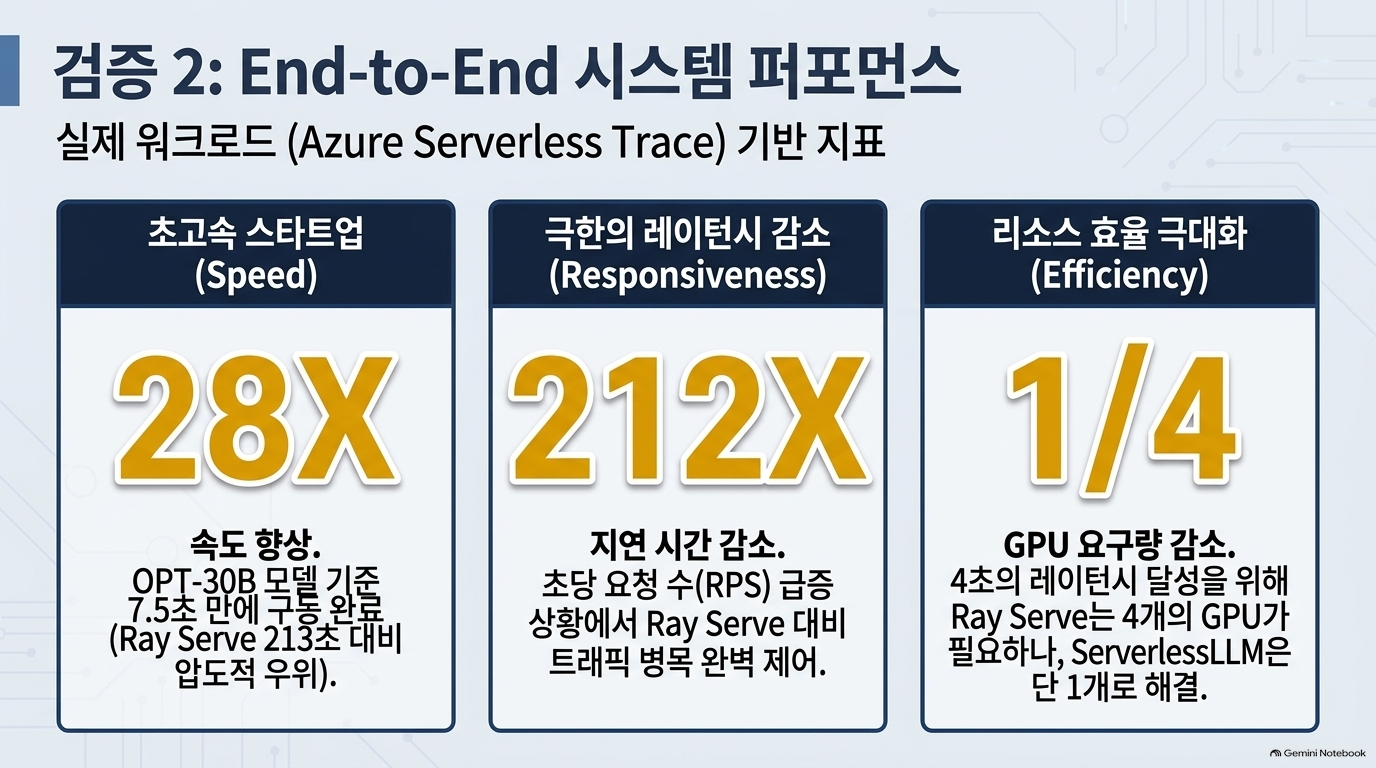
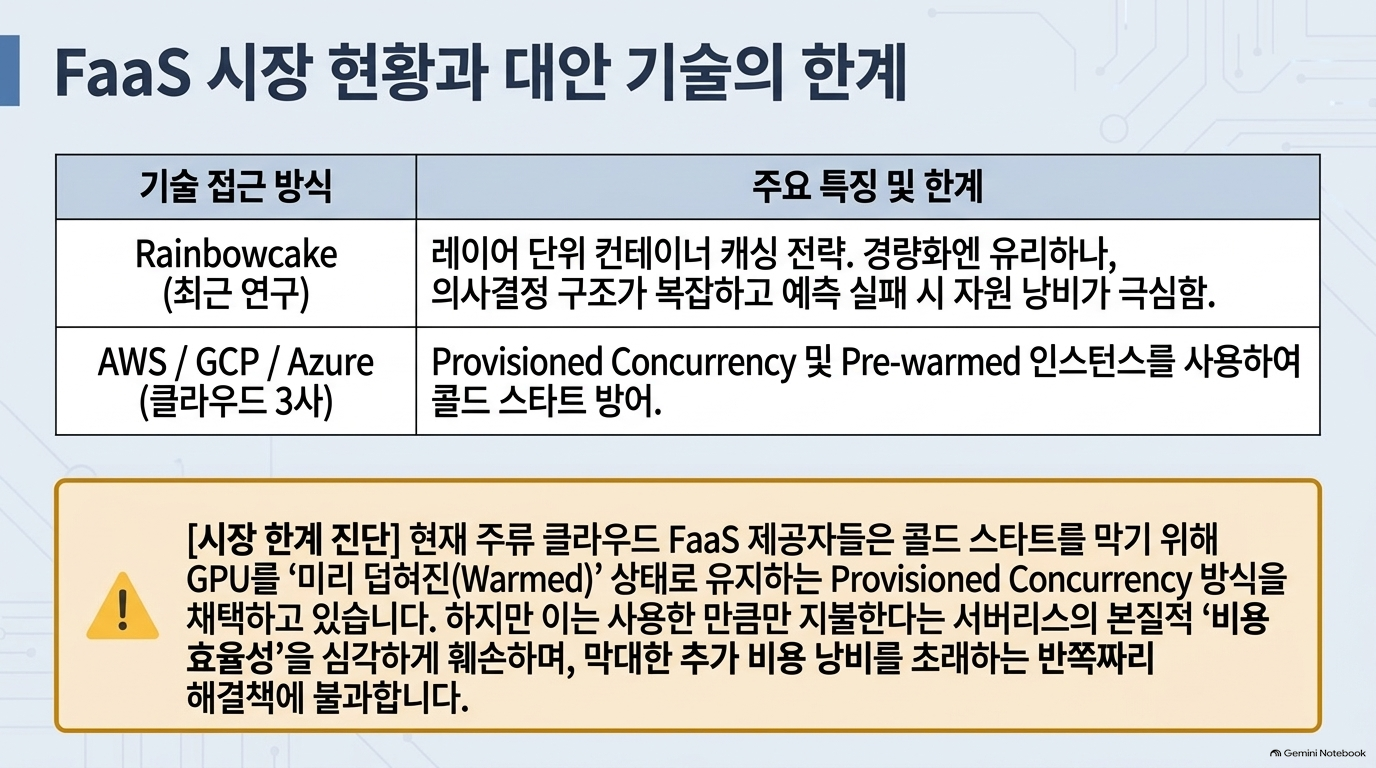
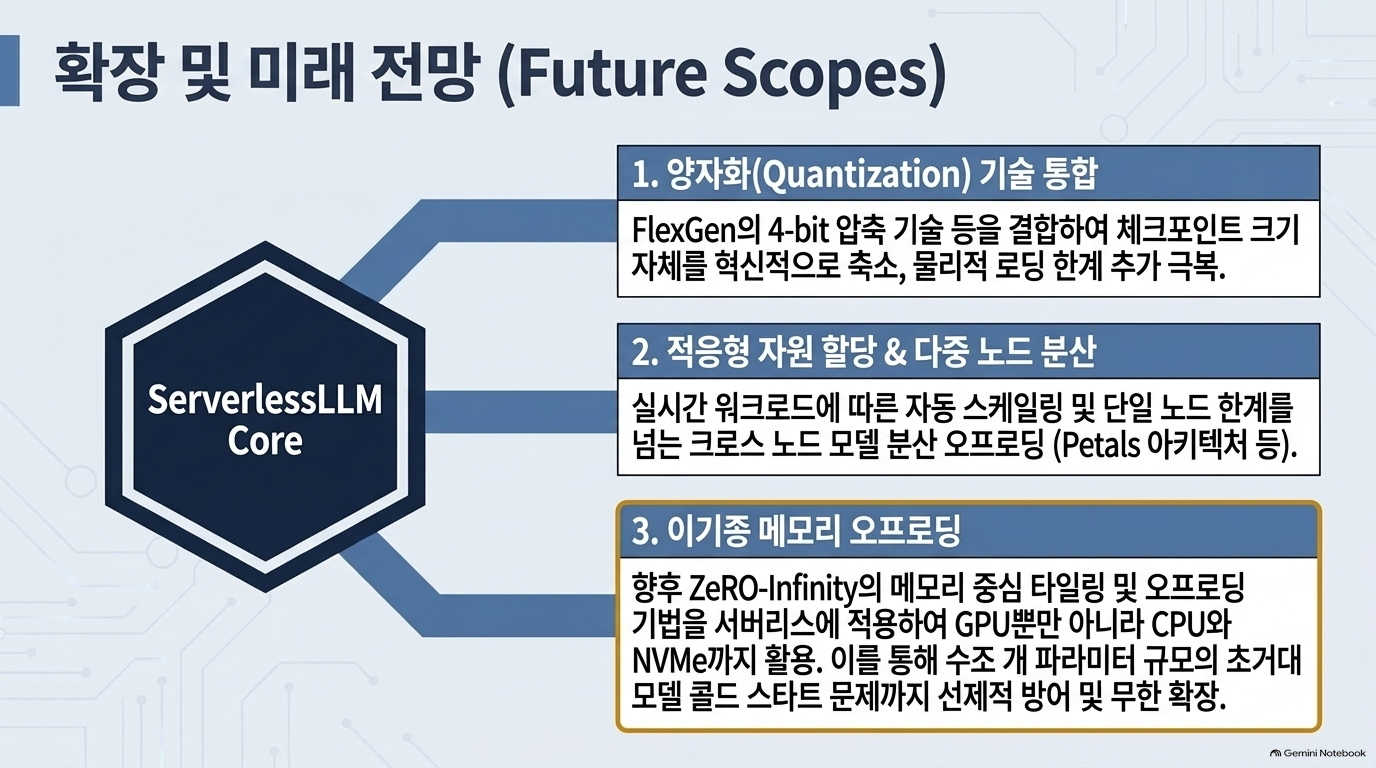
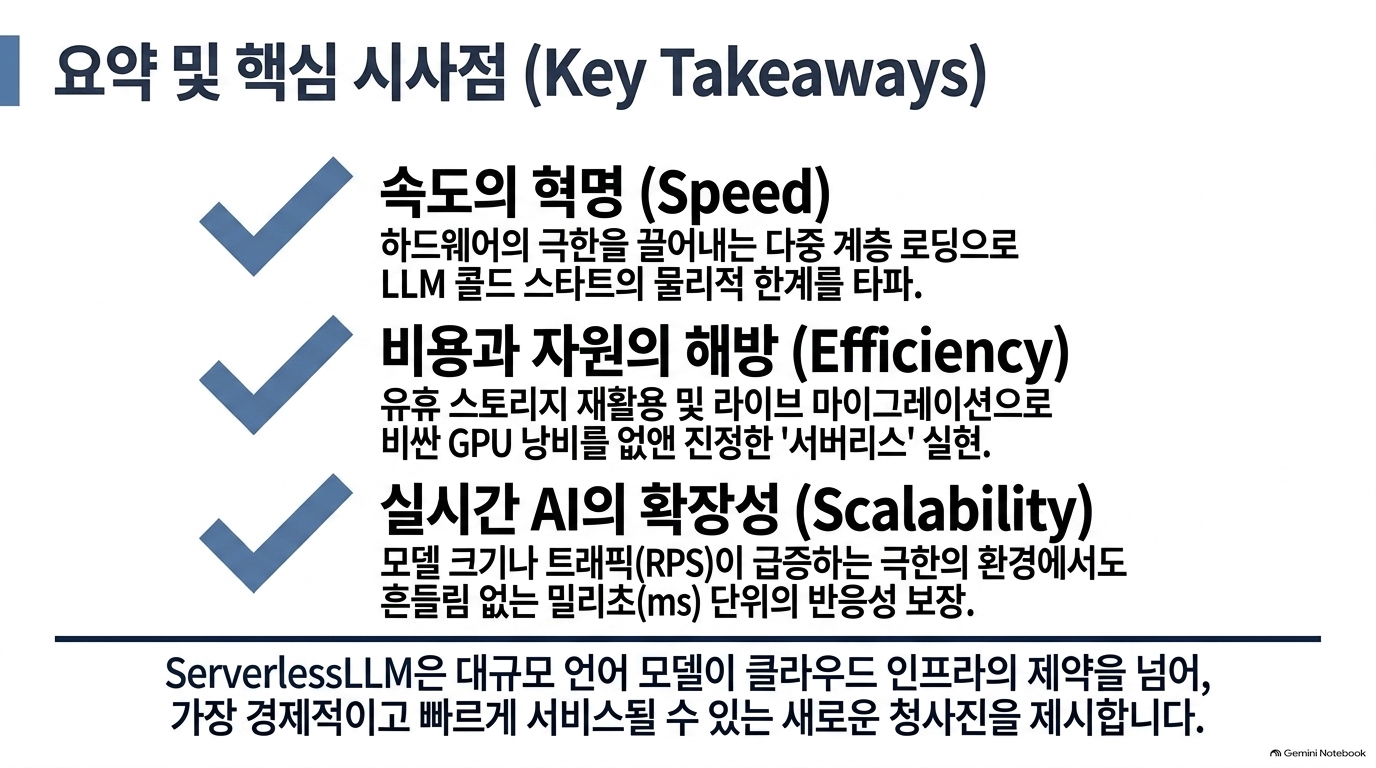
이 보고서는 클라우드 환경에서 대규모 언어 모델(LLM)을 실행할 때 발생하는 콜드 스타트(Cold Start) 지연 시간 문제를 해결하기 위한 기술적 방안들을 체계적으로 검토합니다. 핵심 솔루션인 ServerlessLLM은 미사용 상태인 GPU 서버의 다계층 저장 구조를 활용하고, 데이터를 병렬로 전송하는 최적화된 체크포인트 로딩 방식을 도입하여 기존보다 최대 8배 빠른 속도를 구현합니다. 또한, 모델의 추론 상태를 유연하게 옮기는 라이브 마이그레이션과 가동 시간을 최소화하는 지능형 스케줄러를 통해 자원 효율성을 극대화하고 서비스 중단을 방지합니다. 결과적으로 이 소스는 방대한 크기의 인공지능 모델을 서버리스 환경에서도 실시간 서비스가 가능하도록 만드는 성능 혁신과 비용 절감의 구체적인 방법론을 제시하고 있습니다.


728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| 토큰 경제 - AI 에이전트는 토큰을 어떻게 쓰고 있는가 (0) | 2026.08.29 |
|---|---|
| 추론 서빙(Serving) 최적화 - AI 첫 응답 속도(TTFT) 최적화 (0) | 2026.08.28 |
| 추론 서빙(Serving) 최적화 - RAPID-Serve: P/D GPU 내 분산 처리 (0) | 2026.08.28 |
| 추론 서빙(Serving) 최적화 - Kairos: 분산형 LLM 서빙 스케쥴 (0) | 2026.08.28 |
| LLM - 추론 최적화 - Naver D2: 검색 AI 모델 서빙 성능 극대화하기 (0) | 2026.08.27 |