반응형
https://d2.naver.com/helloworld/0525182
2026.8.11
[우리 팀만의 vLLM 플러그인 만들기 1편 - 검색 AI 모델 서빙 성능 극대화하기]
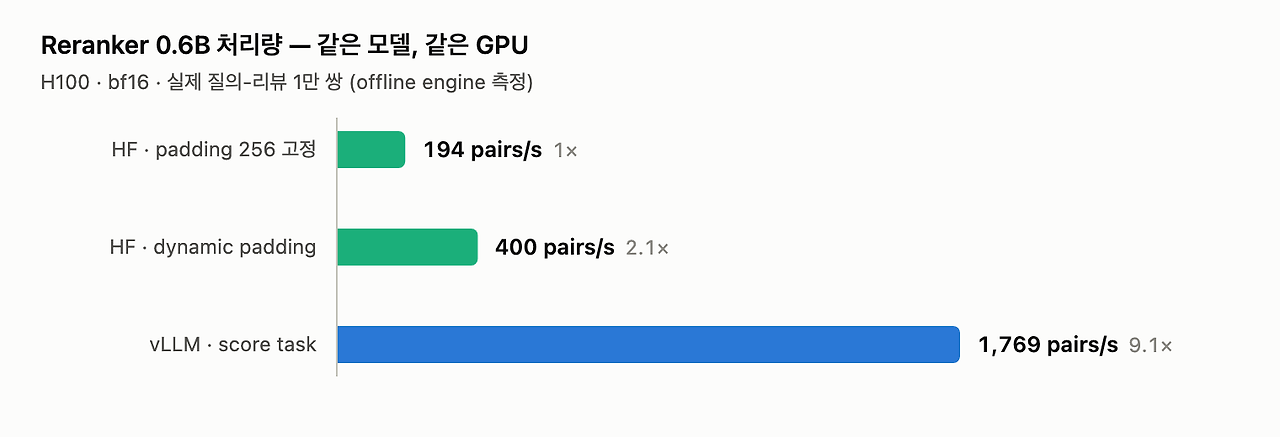
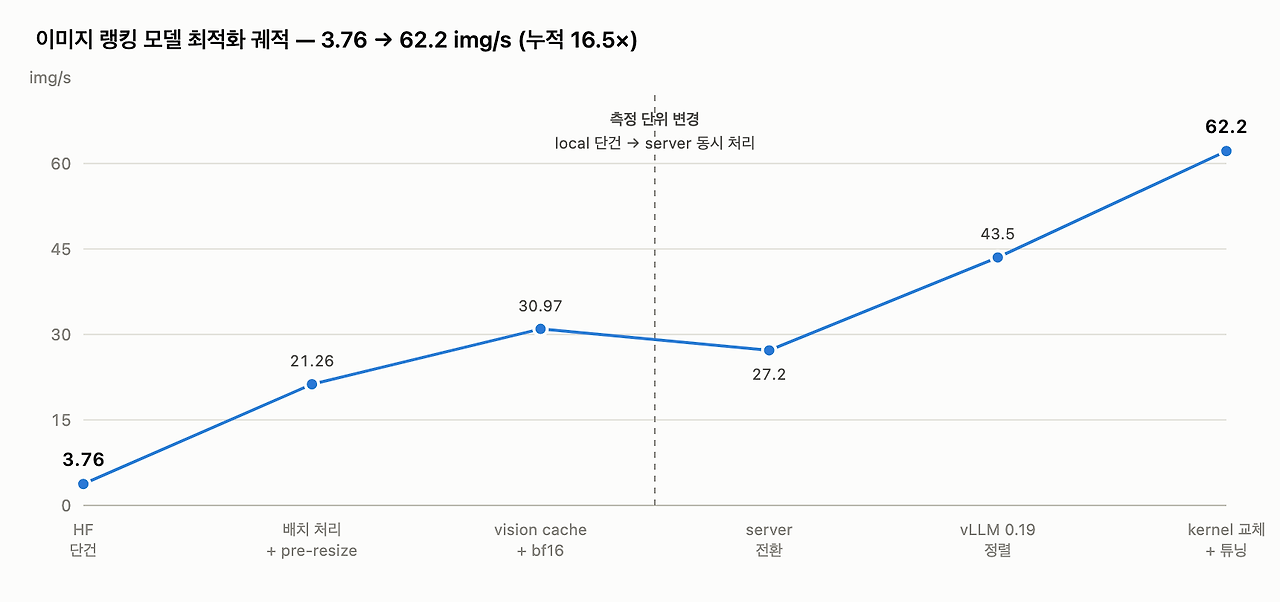
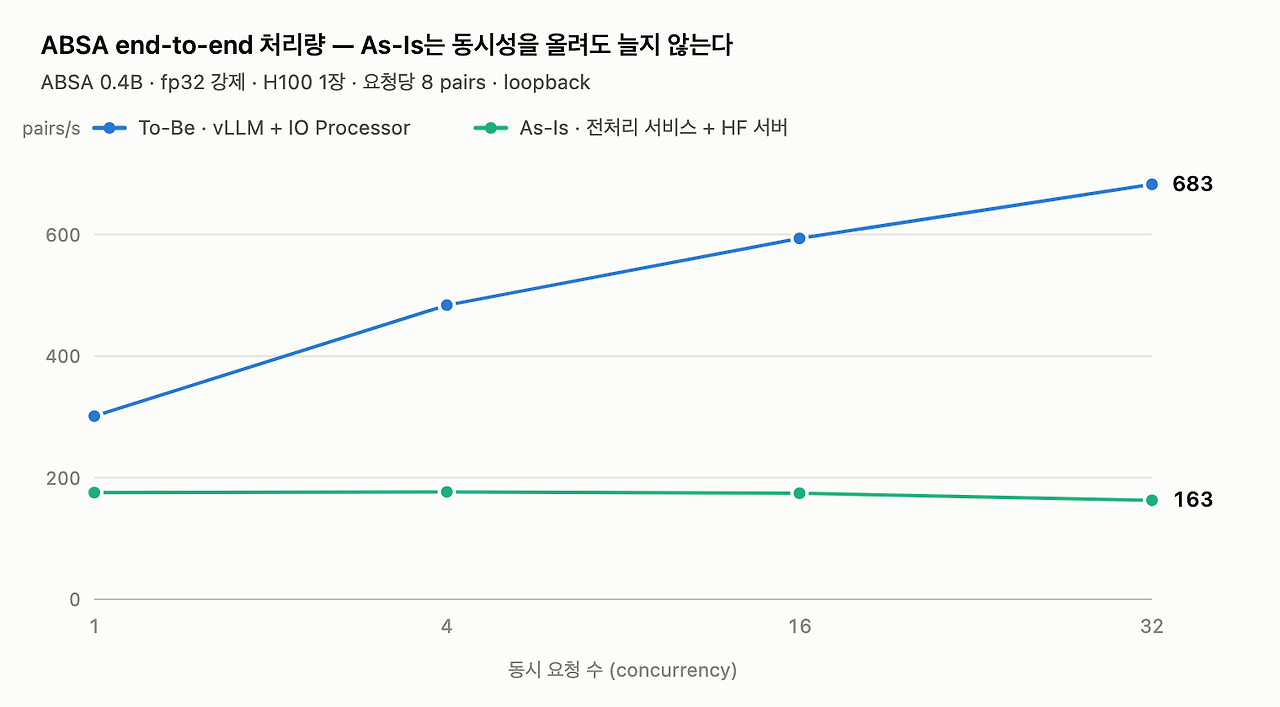
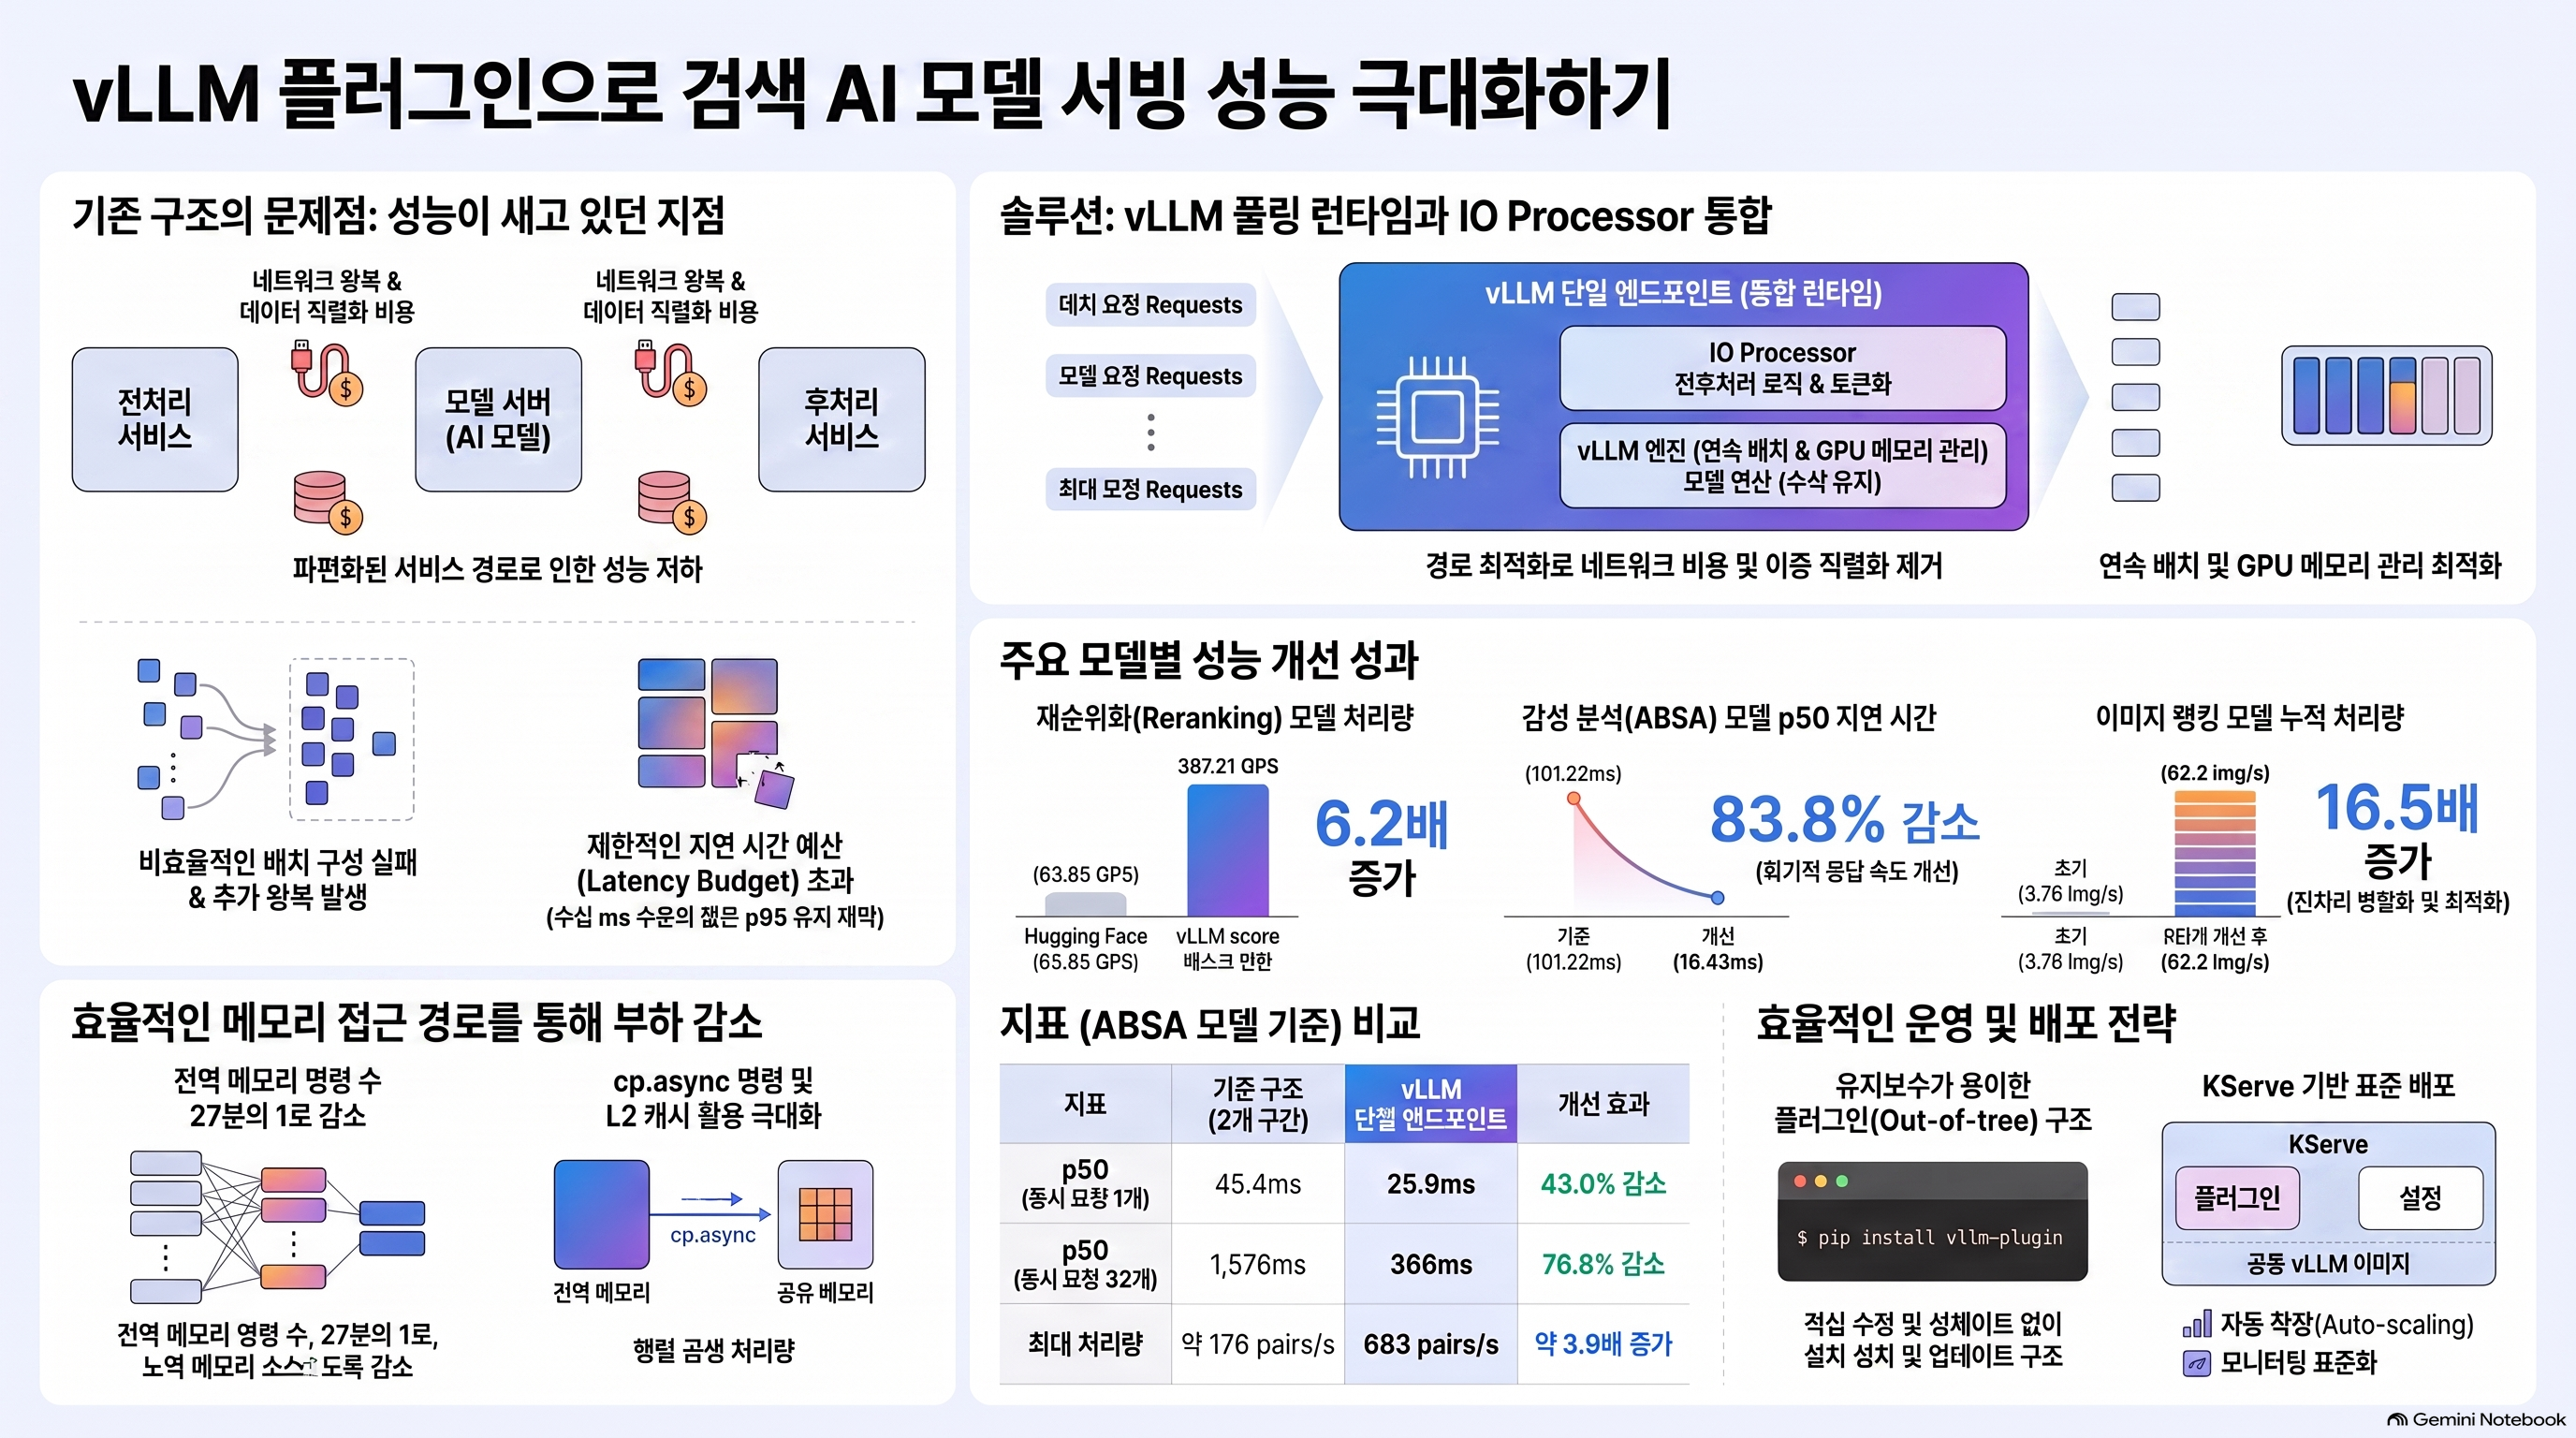
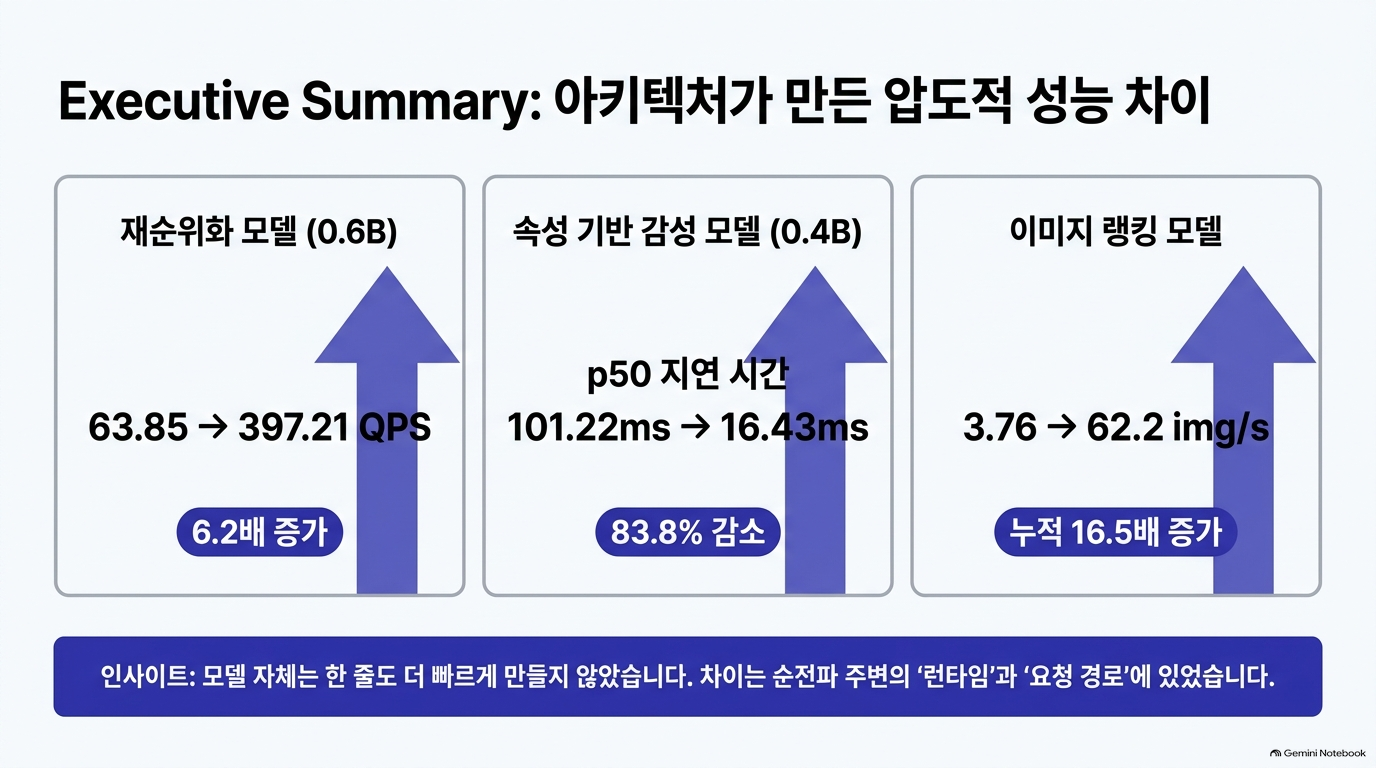
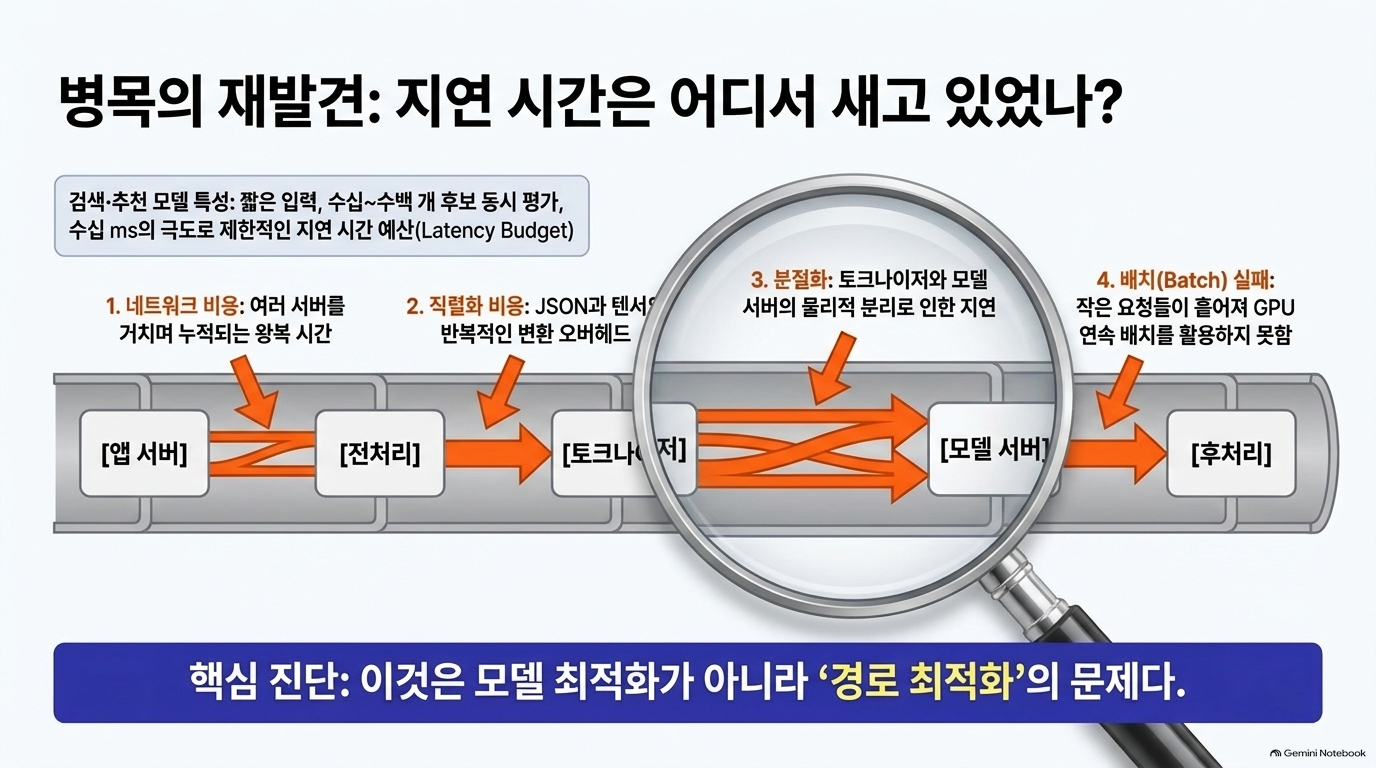
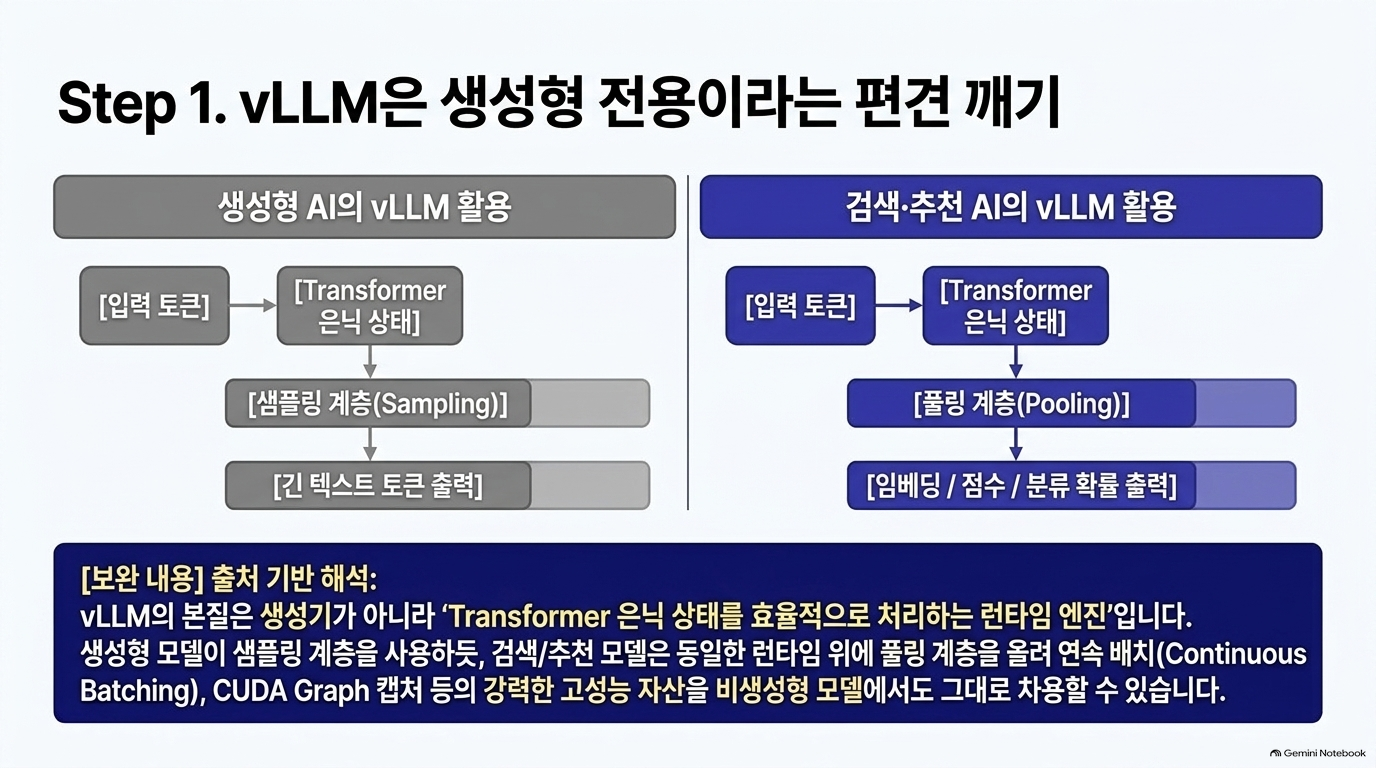
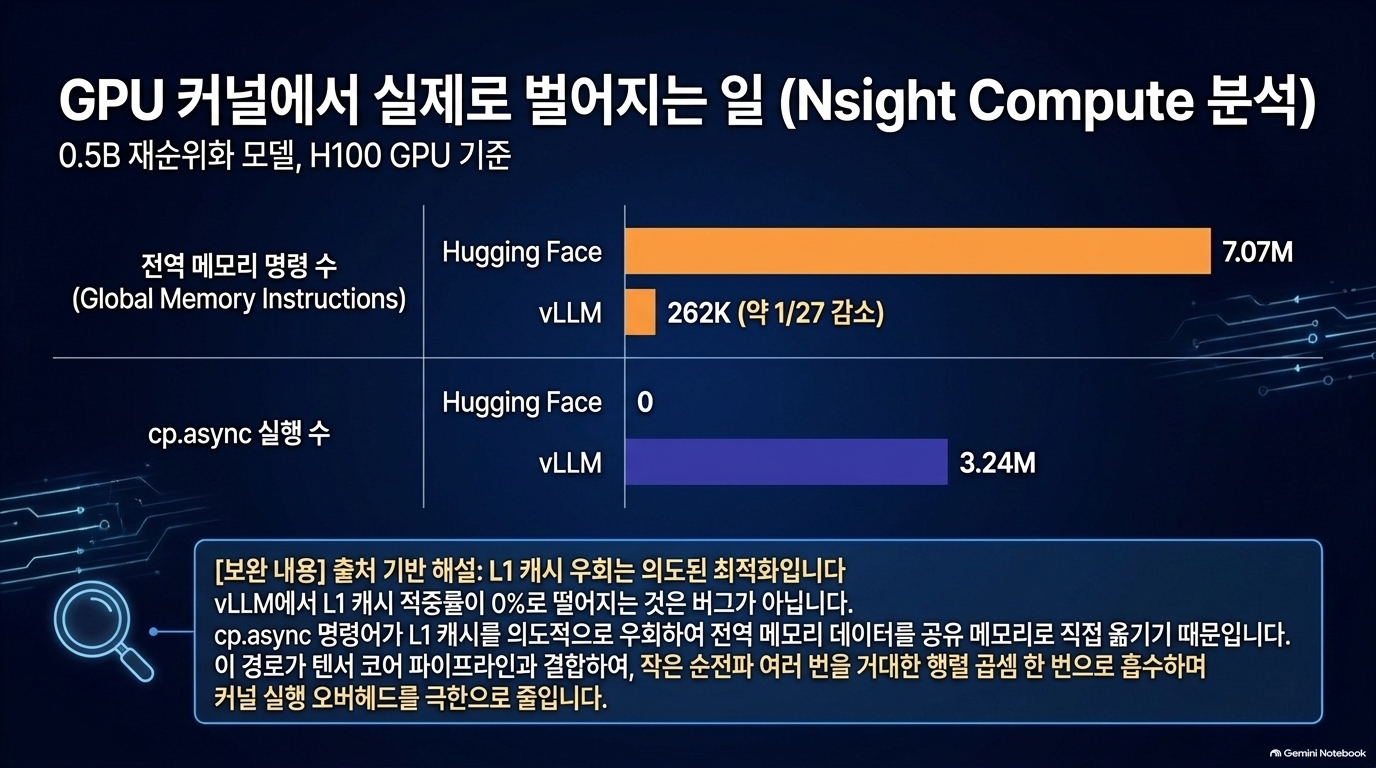
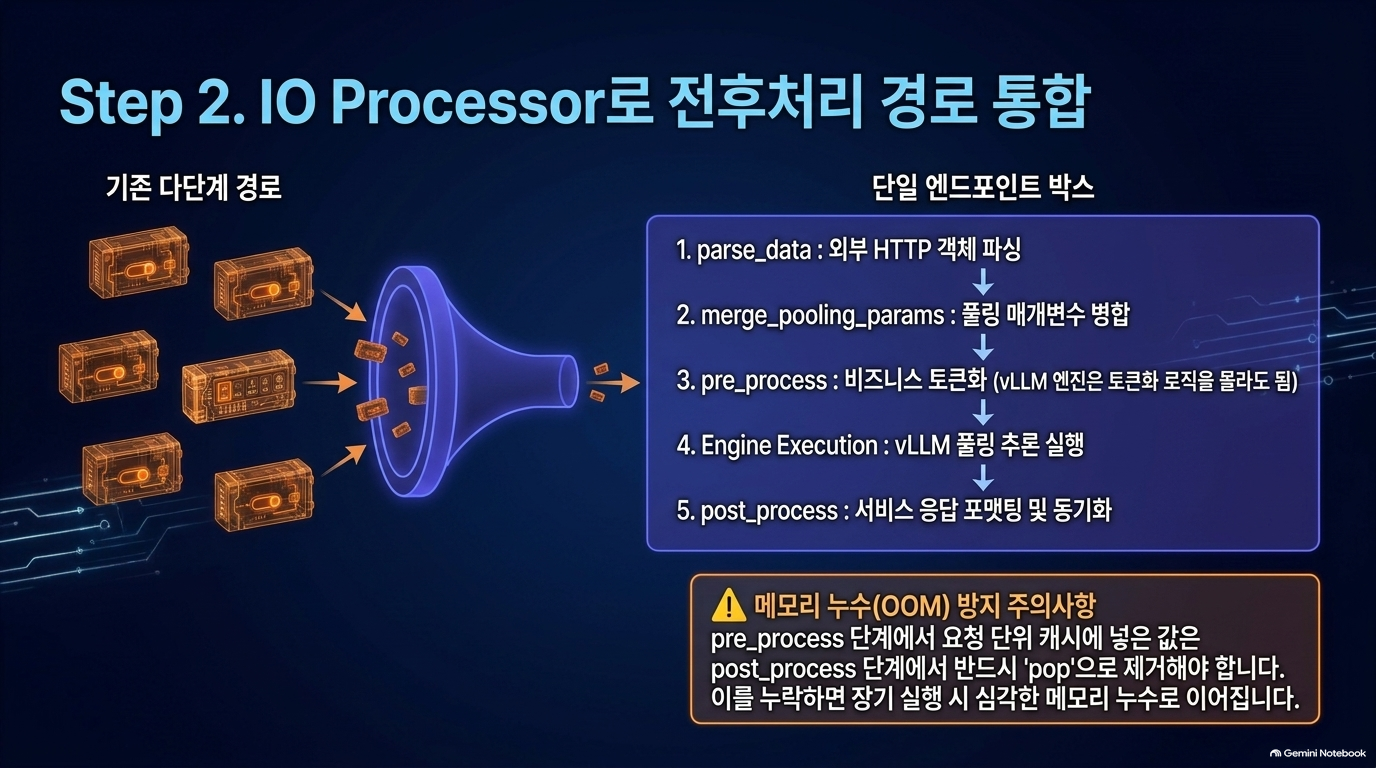
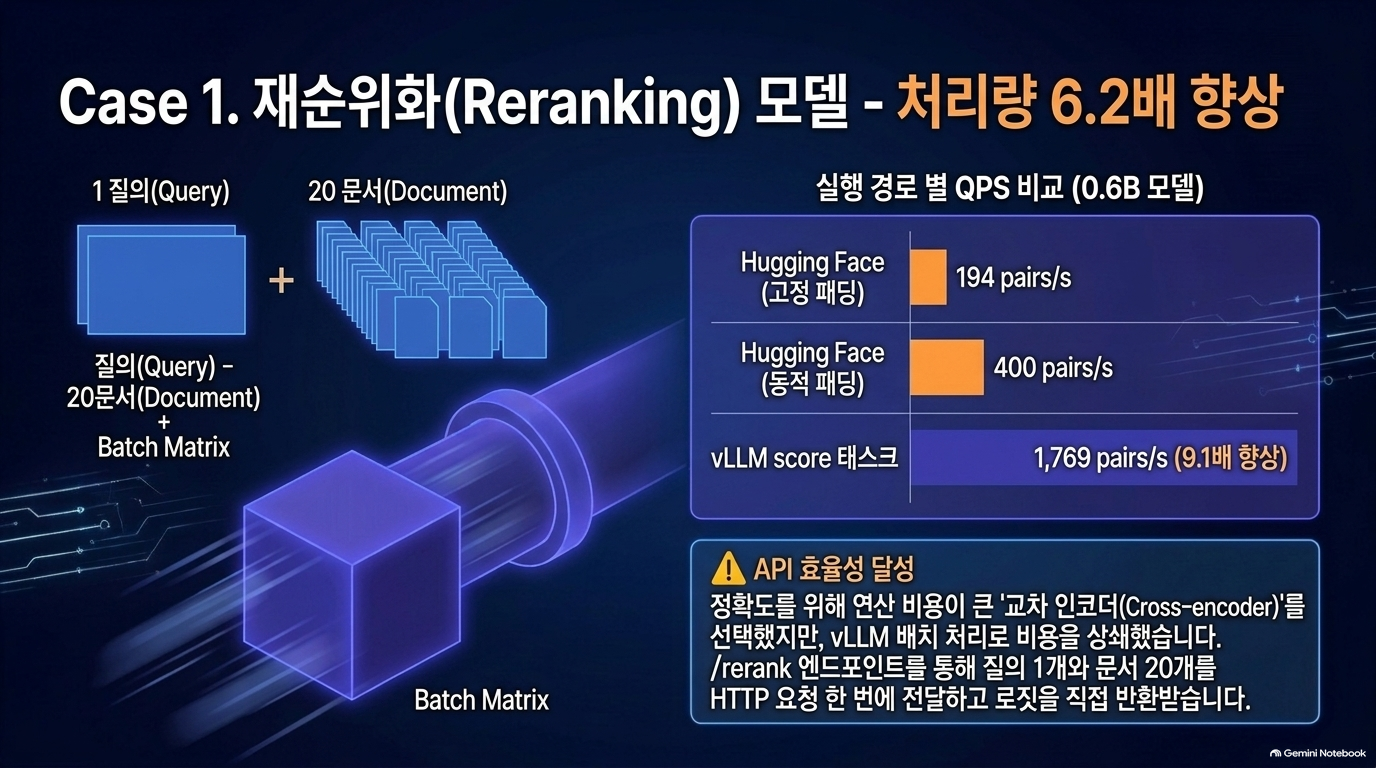
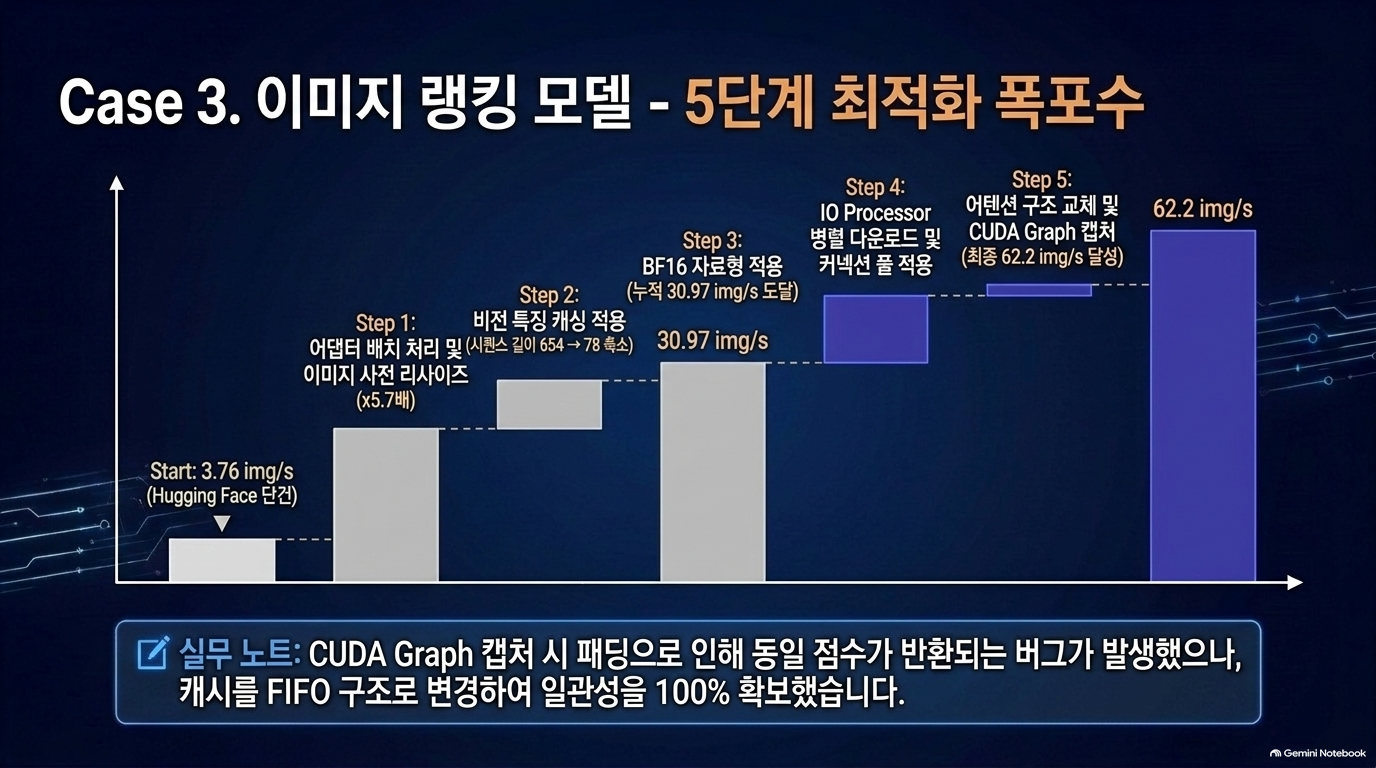
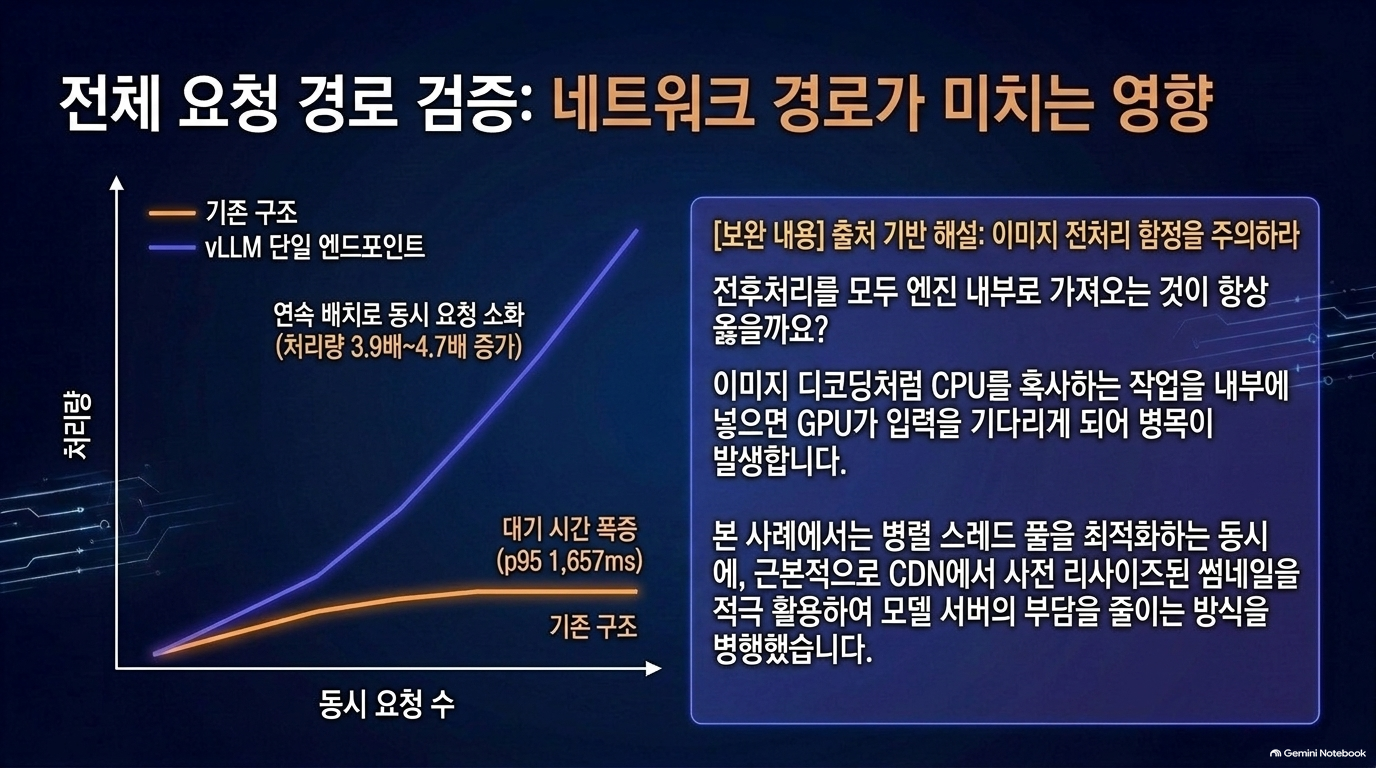
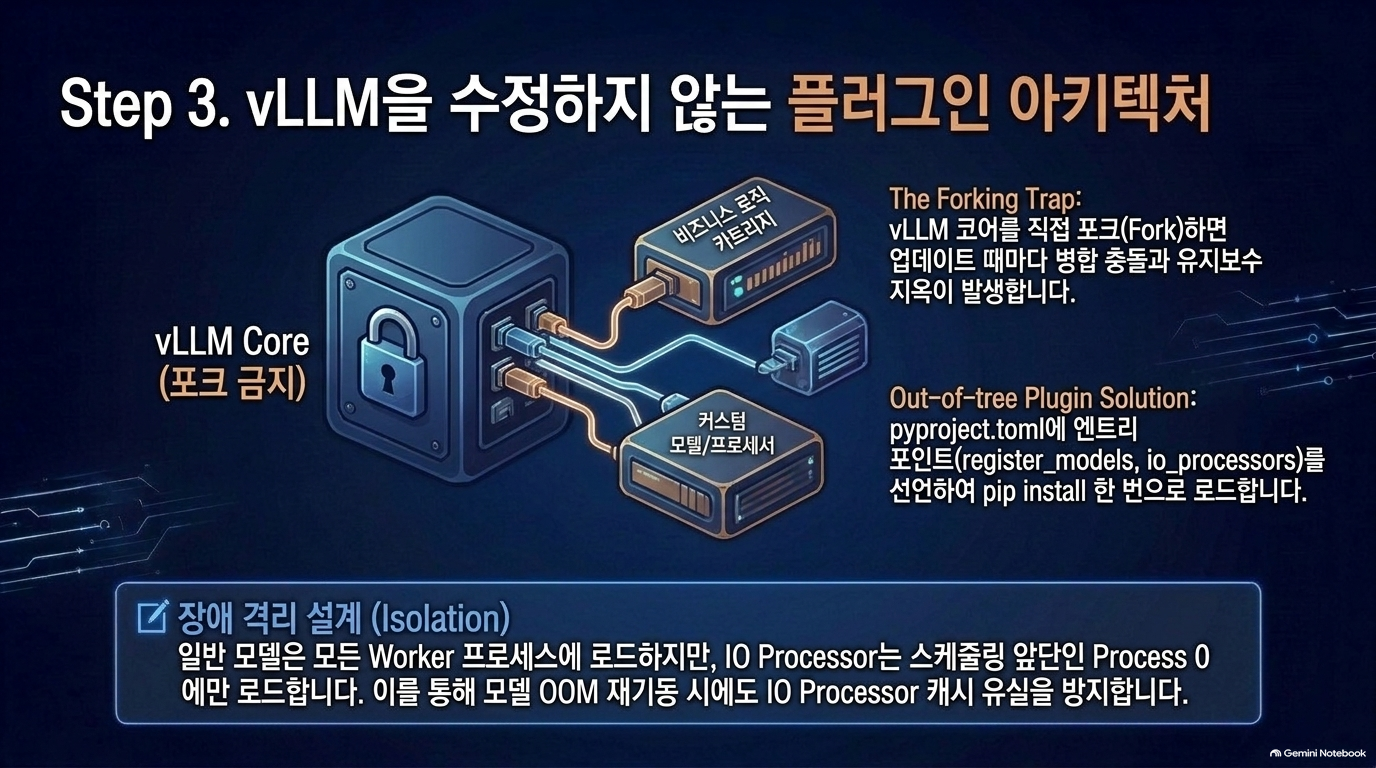
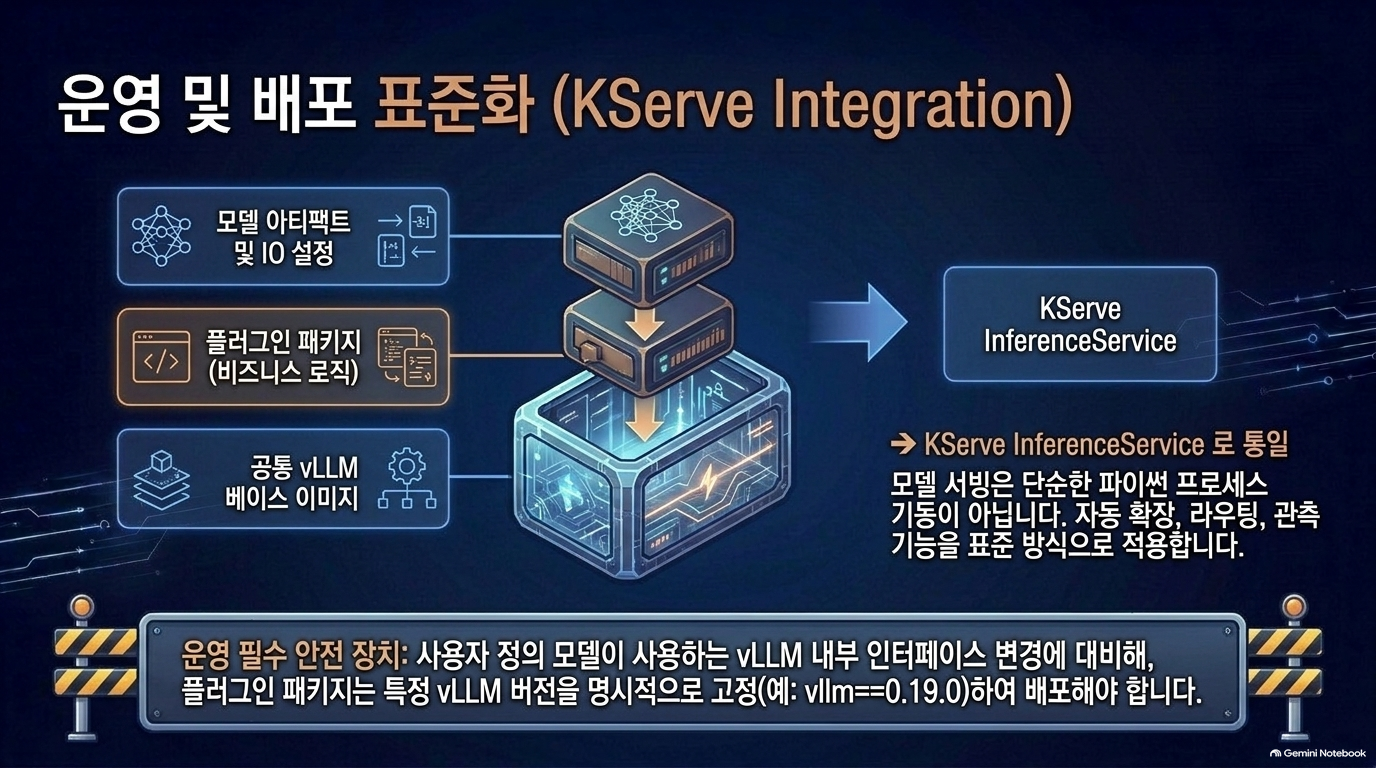
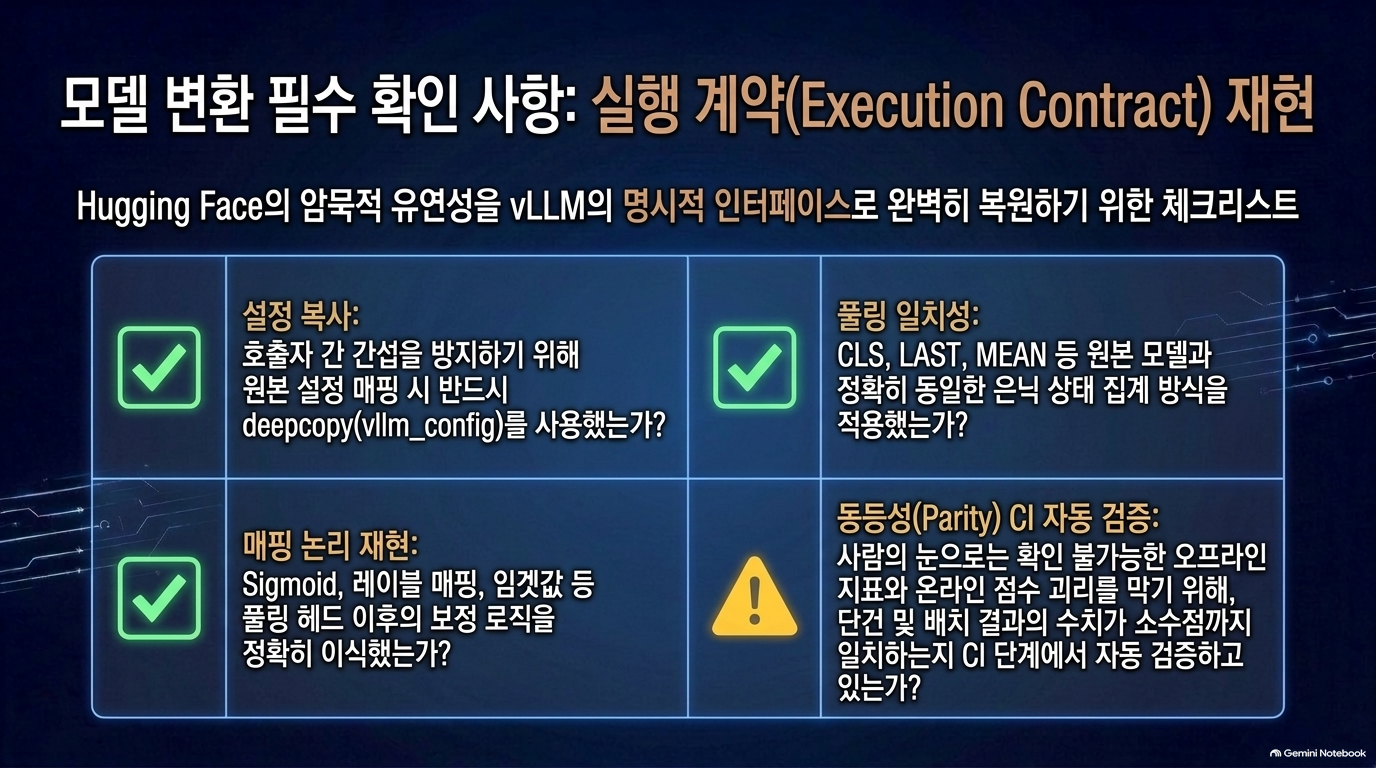
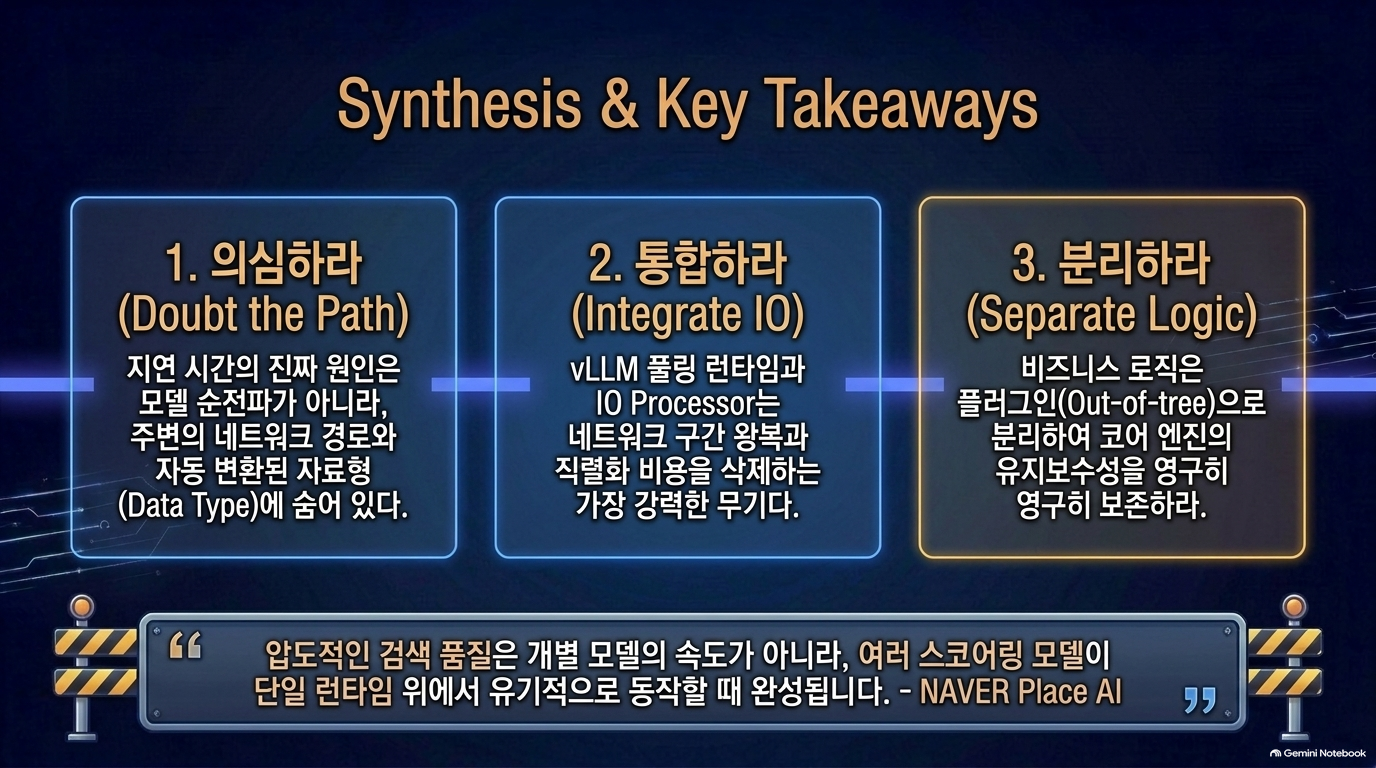
이 글은 네이버 플레이스 AI 팀이 vLLM 기반의 커스텀 플러그인을 개발하여 검색 및 추천 모델의 서빙 성능을 비약적으로 향상시킨 과정을 상세히 다룹니다. 핵심은 모델 자체를 수정하는 대신, 런타임 최적화와 IO Processor를 통한 요청 경로 통합을 통해 불필요한 네트워크 지연과 데이터 직렬화 비용을 제거한 것에 있습니다. 이를 통해 재순위화 및 감성 분석 모델 등에서 처리량은 최대 16.5배 증가하고 지연 시간은 80% 이상 감소하는 성과를 거두었습니다. 결과적으로 vLLM의 연속 배치와 커널 최적화 기술을 활용하면서도, 독자적인 플러그인 구조를 유지해 유지보수 효율성과 운영 안정성을 동시에 확보한 사례를 제시합니다.



728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| 추론 서빙(Serving) 최적화 - RAPID-Serve: P/D GPU 내 분산 처리 (0) | 2026.08.28 |
|---|---|
| 추론 서빙(Serving) 최적화 - Kairos: 분산형 LLM 서빙 스케쥴 (0) | 2026.08.28 |
| 토큰 경제 - 시타델 증권(Citadel Securities), AI 인프라 투자의 정당성 (0) | 2026.08.24 |
| 토큰 경제 - AI 토큰은 데이터센터를 어떻게 여행하는가? (0) | 2026.08.22 |
| 토큰 경제 - EPOCH AI, 앤스로픽(Anthropic)의 사례로 보는 대규모 컴퓨팅 인프라 구축 병목 (0) | 2026.08.17 |