반응형
https://arxiv.org/pdf/2607.02043
https://github.com/sudokara/Kairos (404 Not Found, 2026.8.28 확인)
2026.7.2
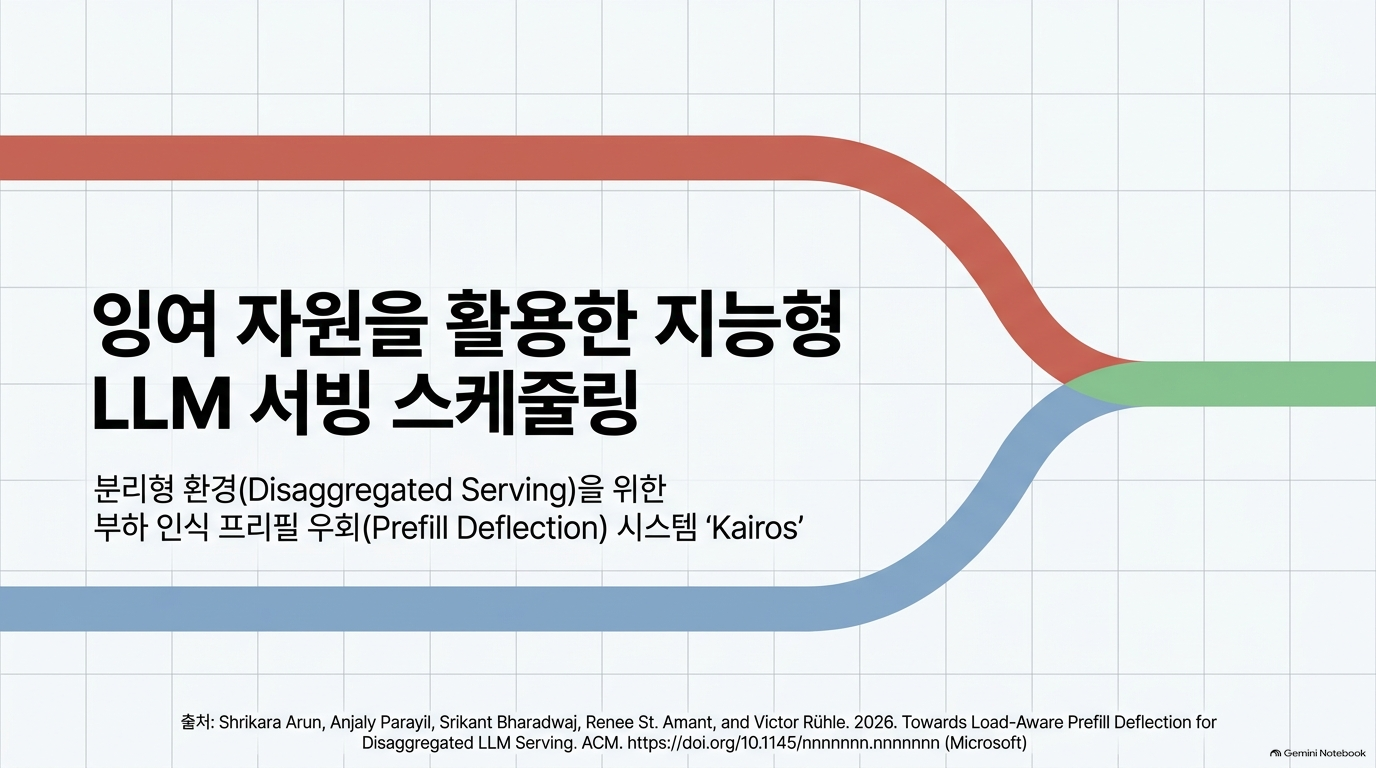
[Towards Load-Aware Prefill Deflection for Disaggregated LLM Serving]
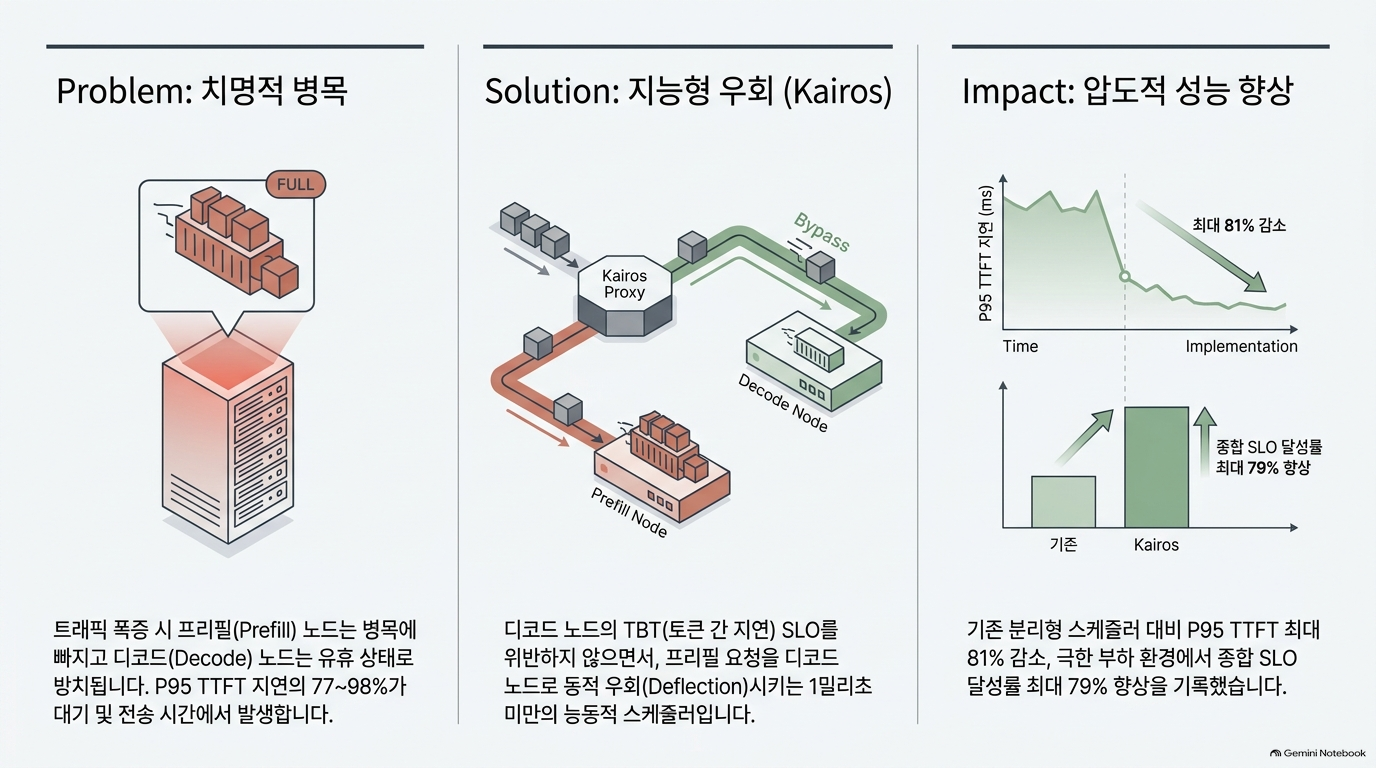
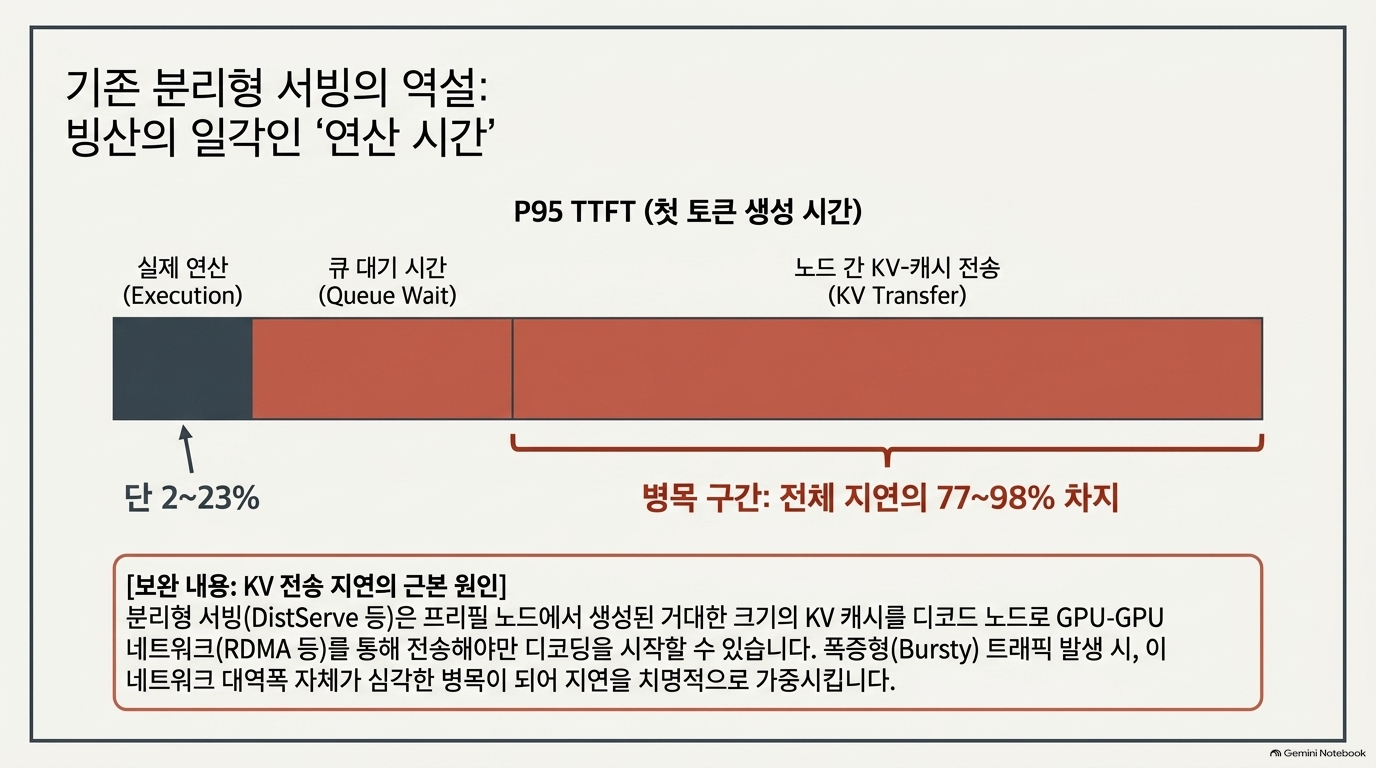
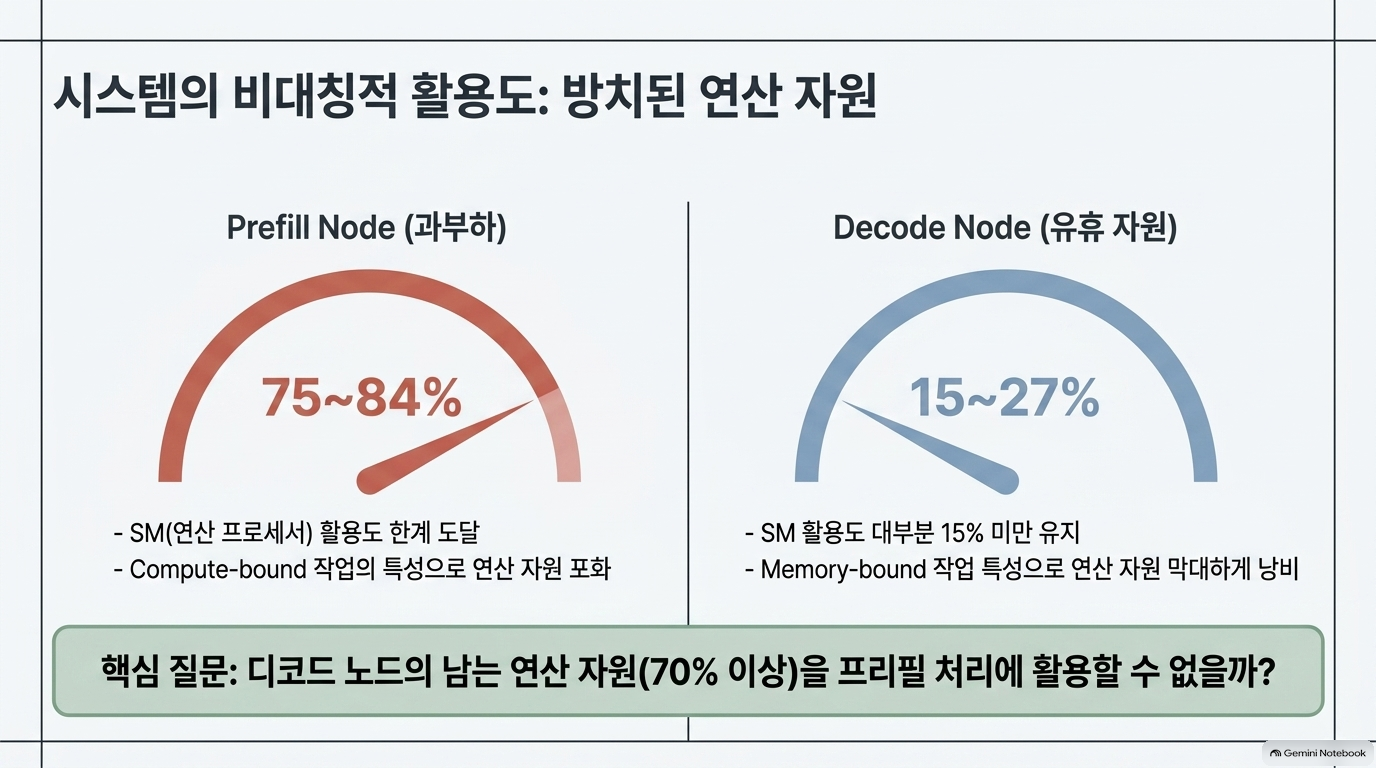
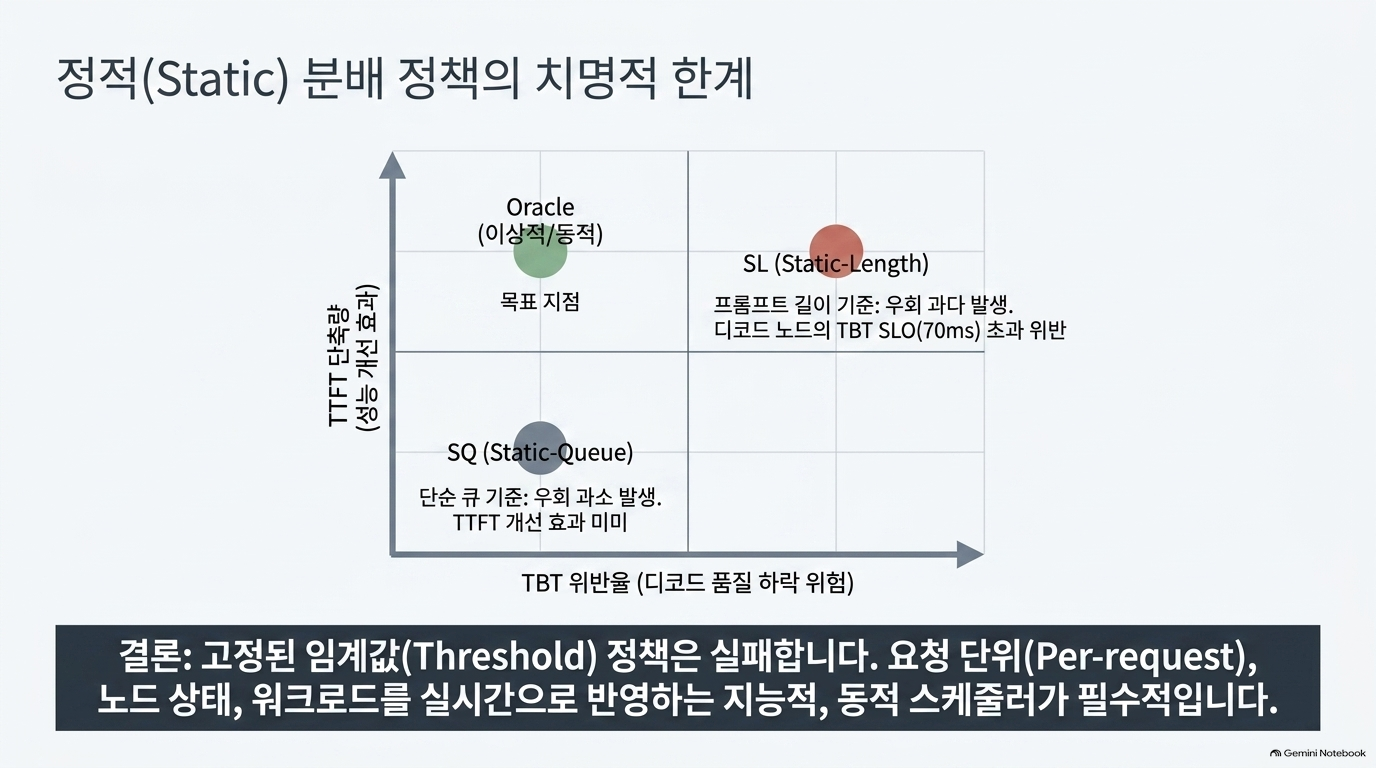
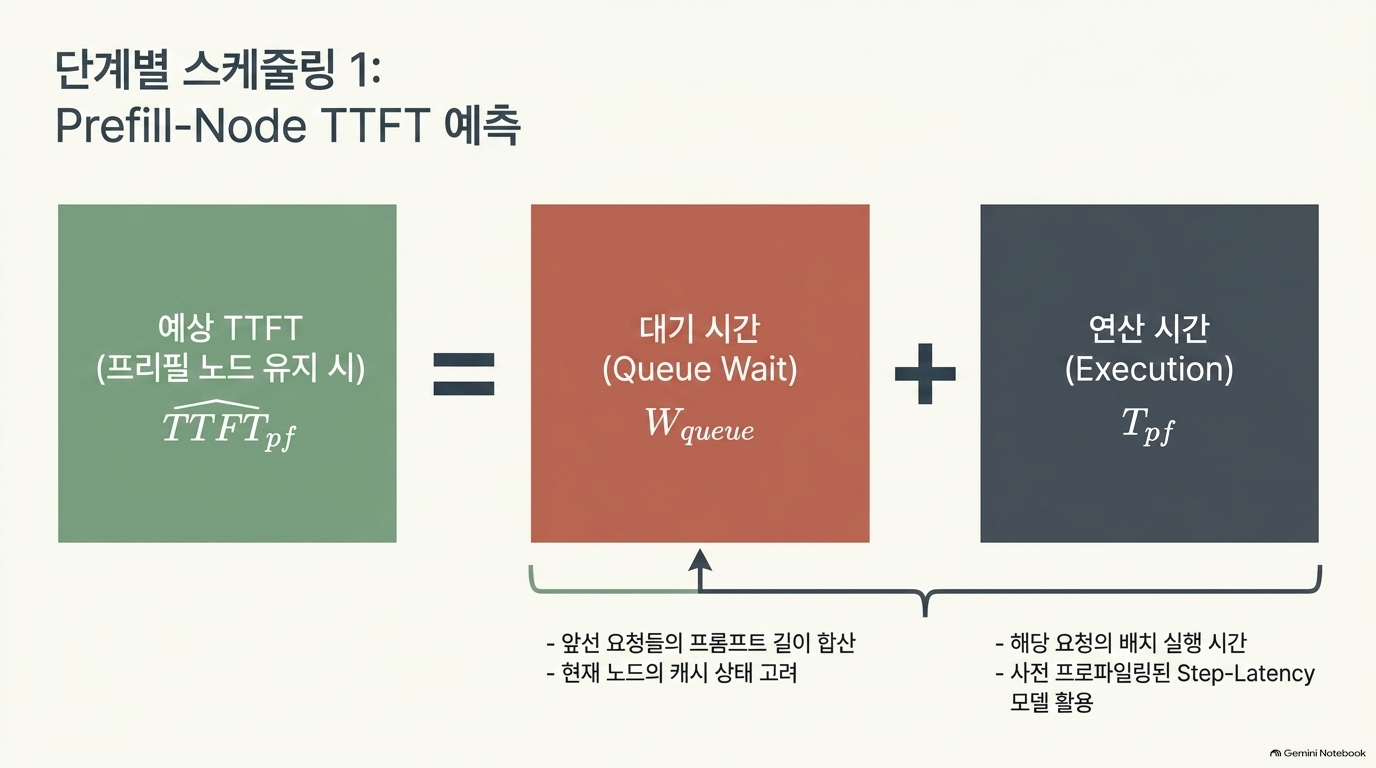
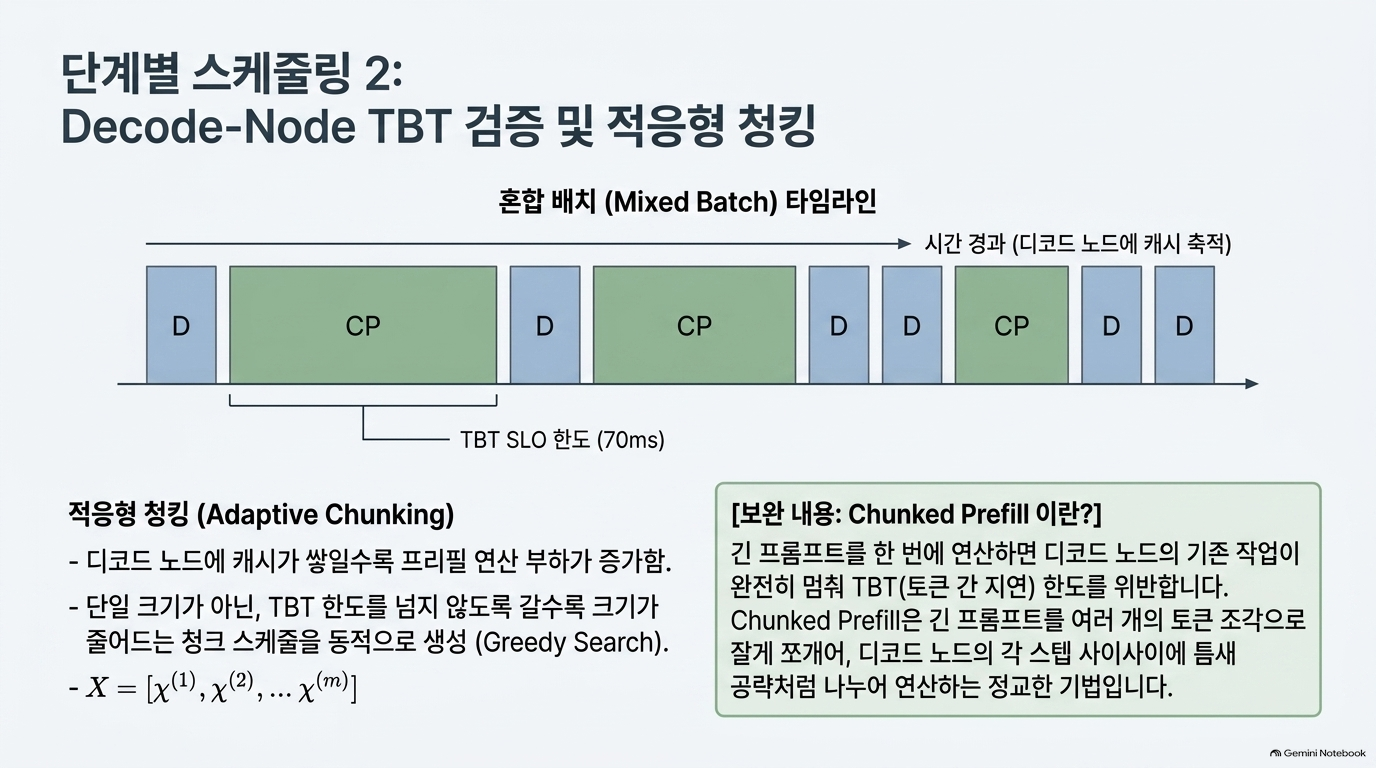
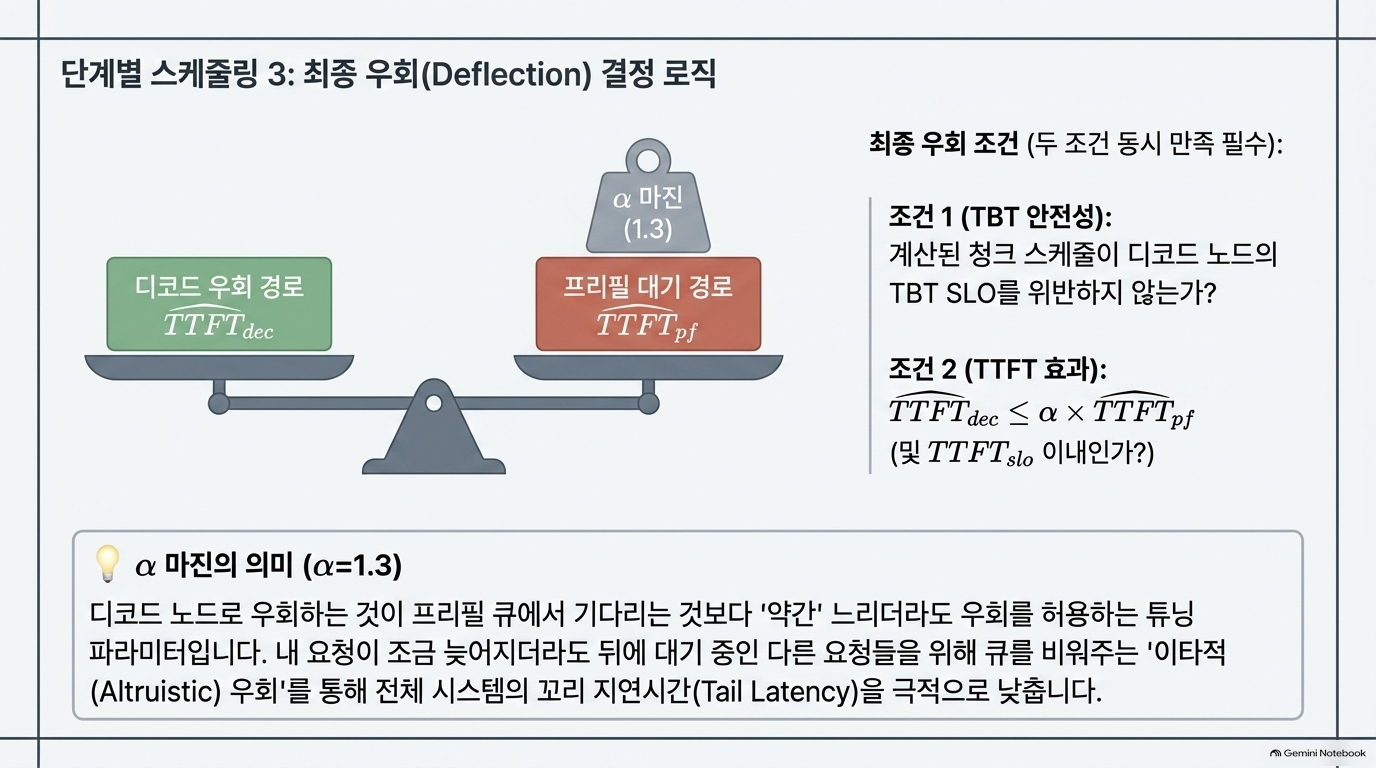
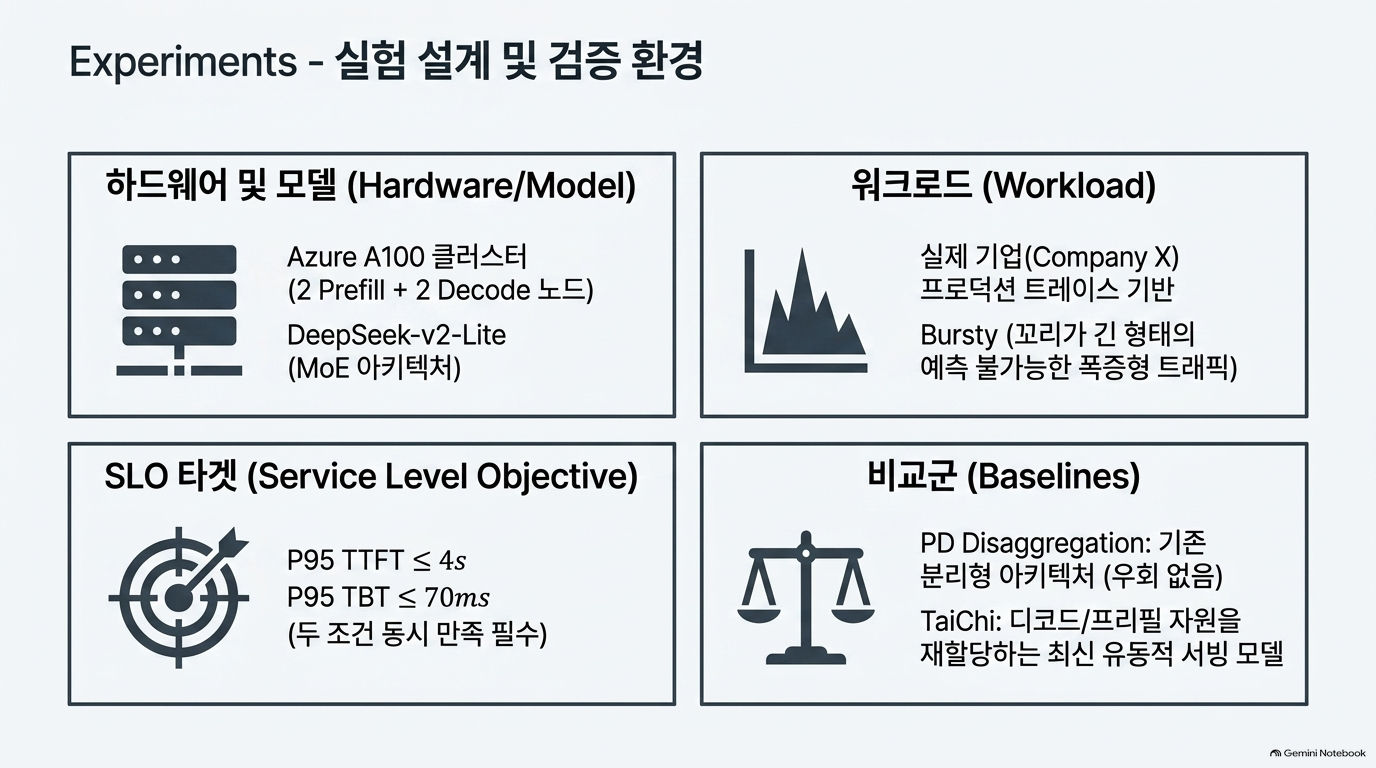
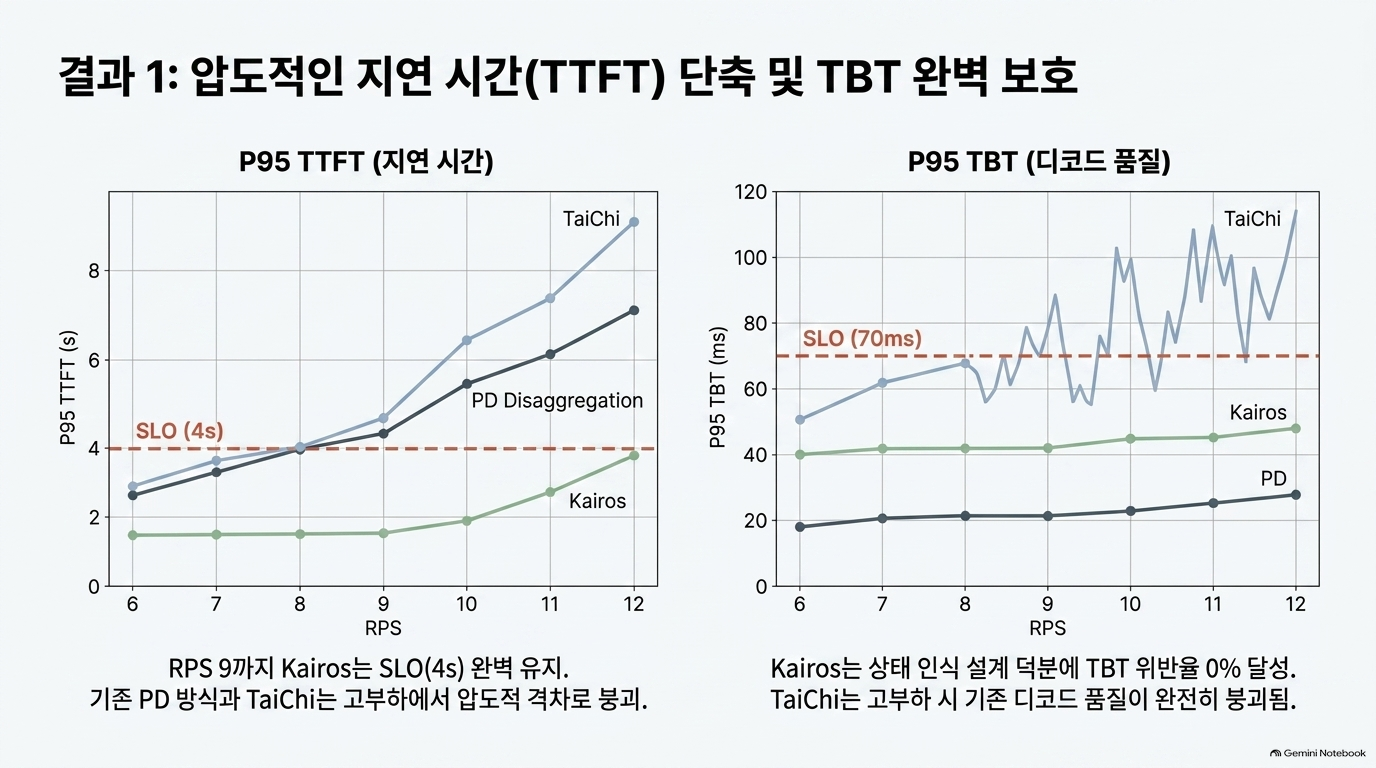
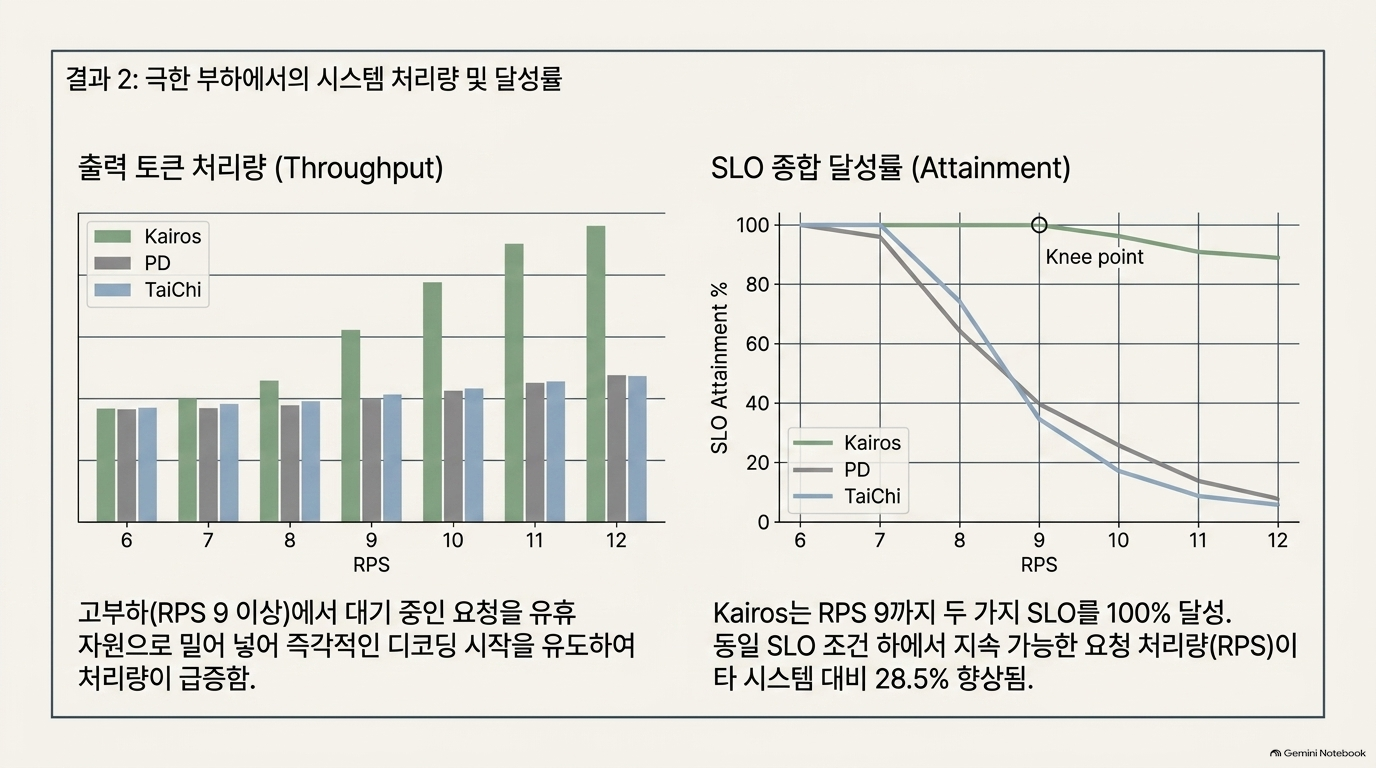
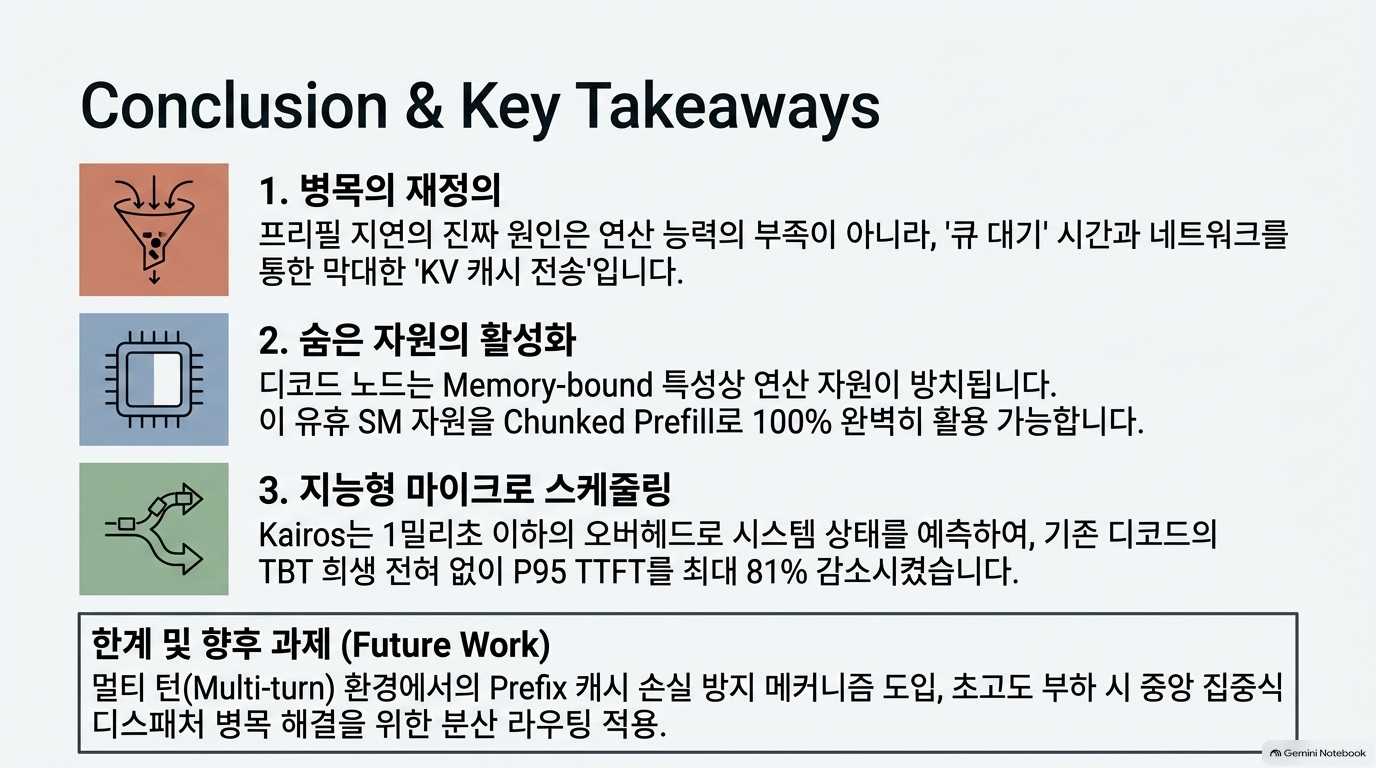
이 논문은 대규모 언어 모델(LLM) 서비스에서 발생하는 성능 병목 현상을 해결하기 위해 개발된 카이로스(Kairos)라는 혁신적인 스케줄링 프레임워크를 소개합니다. 기존의 분산형 서버 구조는 연산 집약적인 프리필(prefill) 단계와 메모리 대역폭이 중요한 디코드(decode) 단계를 서로 다른 GPU 풀에 할당하여 간섭을 방지하지만, 이 과정에서 프리필 노드의 병목 현상과 디코드 노드의 자원 유휴 문제가 발생합니다. 저자들은 디코드 노드의 남는 계산 능력을 활용하여 프리필 작업을 청크(chunk) 단위로 쪼개어 처리하는 가변적 프리필 굴절(deflection) 전략을 제안하며, 이는 데이터 전송 오버헤드를 제거하는 효과를 거둡니다. 특히 카이로스는 실시간으로 서비스 수준 목표(SLO)를 모니터링하여 기존 생성 작업의 속도를 저해하지 않는 범위 내에서만 작업을 재할당하는 부하 인지형 알고리즘을 핵심으로 삼습니다. 결과적으로 이 시스템은 실제 운영 환경과 유사한 부하 상황에서 첫 토큰 생성 시간(TTFT)의 꼬리 지연 시간을 최대 81%까지 단축시키는 동시에 전체적인 서비스 성능을 획기적으로 향상시킵니다.


728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| 추론 서빙(Serving) 최적화 - 클라우드 환경에서 대규모 언어 모델(LLM)을 위한 효율적인 서버리스 추론 서비스 구현 (0) | 2026.08.28 |
|---|---|
| 추론 서빙(Serving) 최적화 - RAPID-Serve: P/D GPU 내 분산 처리 (0) | 2026.08.28 |
| LLM - 추론 최적화 - Naver D2: 검색 AI 모델 서빙 성능 극대화하기 (0) | 2026.08.27 |
| 토큰 경제 - 시타델 증권(Citadel Securities), AI 인프라 투자의 정당성 (0) | 2026.08.24 |
| 토큰 경제 - AI 토큰은 데이터센터를 어떻게 여행하는가? (0) | 2026.08.22 |