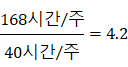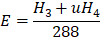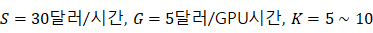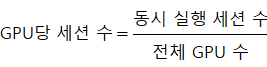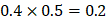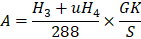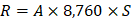2026.10.2 [How many AI agents could run on the AI chips shipped through 2027?]
이 보고서는 2027년까지 출하될 AI 하드웨어가 실행할 수 있는 인공지능 에이전트의 규모를 추정하고, 그것이 미래의 AI 인프라 수요와 경제에 미칠 영향을 분석합니다. 핵심 주제는 고대역폭 메모리(HBM)의 물리적 공급량을 바탕으로, 첨단 모델과 오픈소스 모델이 동시에 구동할 수 있는 동시 에이전트 수의 한계를 계산하는 것입니다. 궁극적인 목적은 현재 기술 기업들이 쏟아붓는 막대한 자본과 구축 중인 데이터 센터의 규모가 향후 폭발적으로 늘어날 실제 AI 서비스 수요와 균형을 이룰 수 있는지 평가하는 데 있습니다.
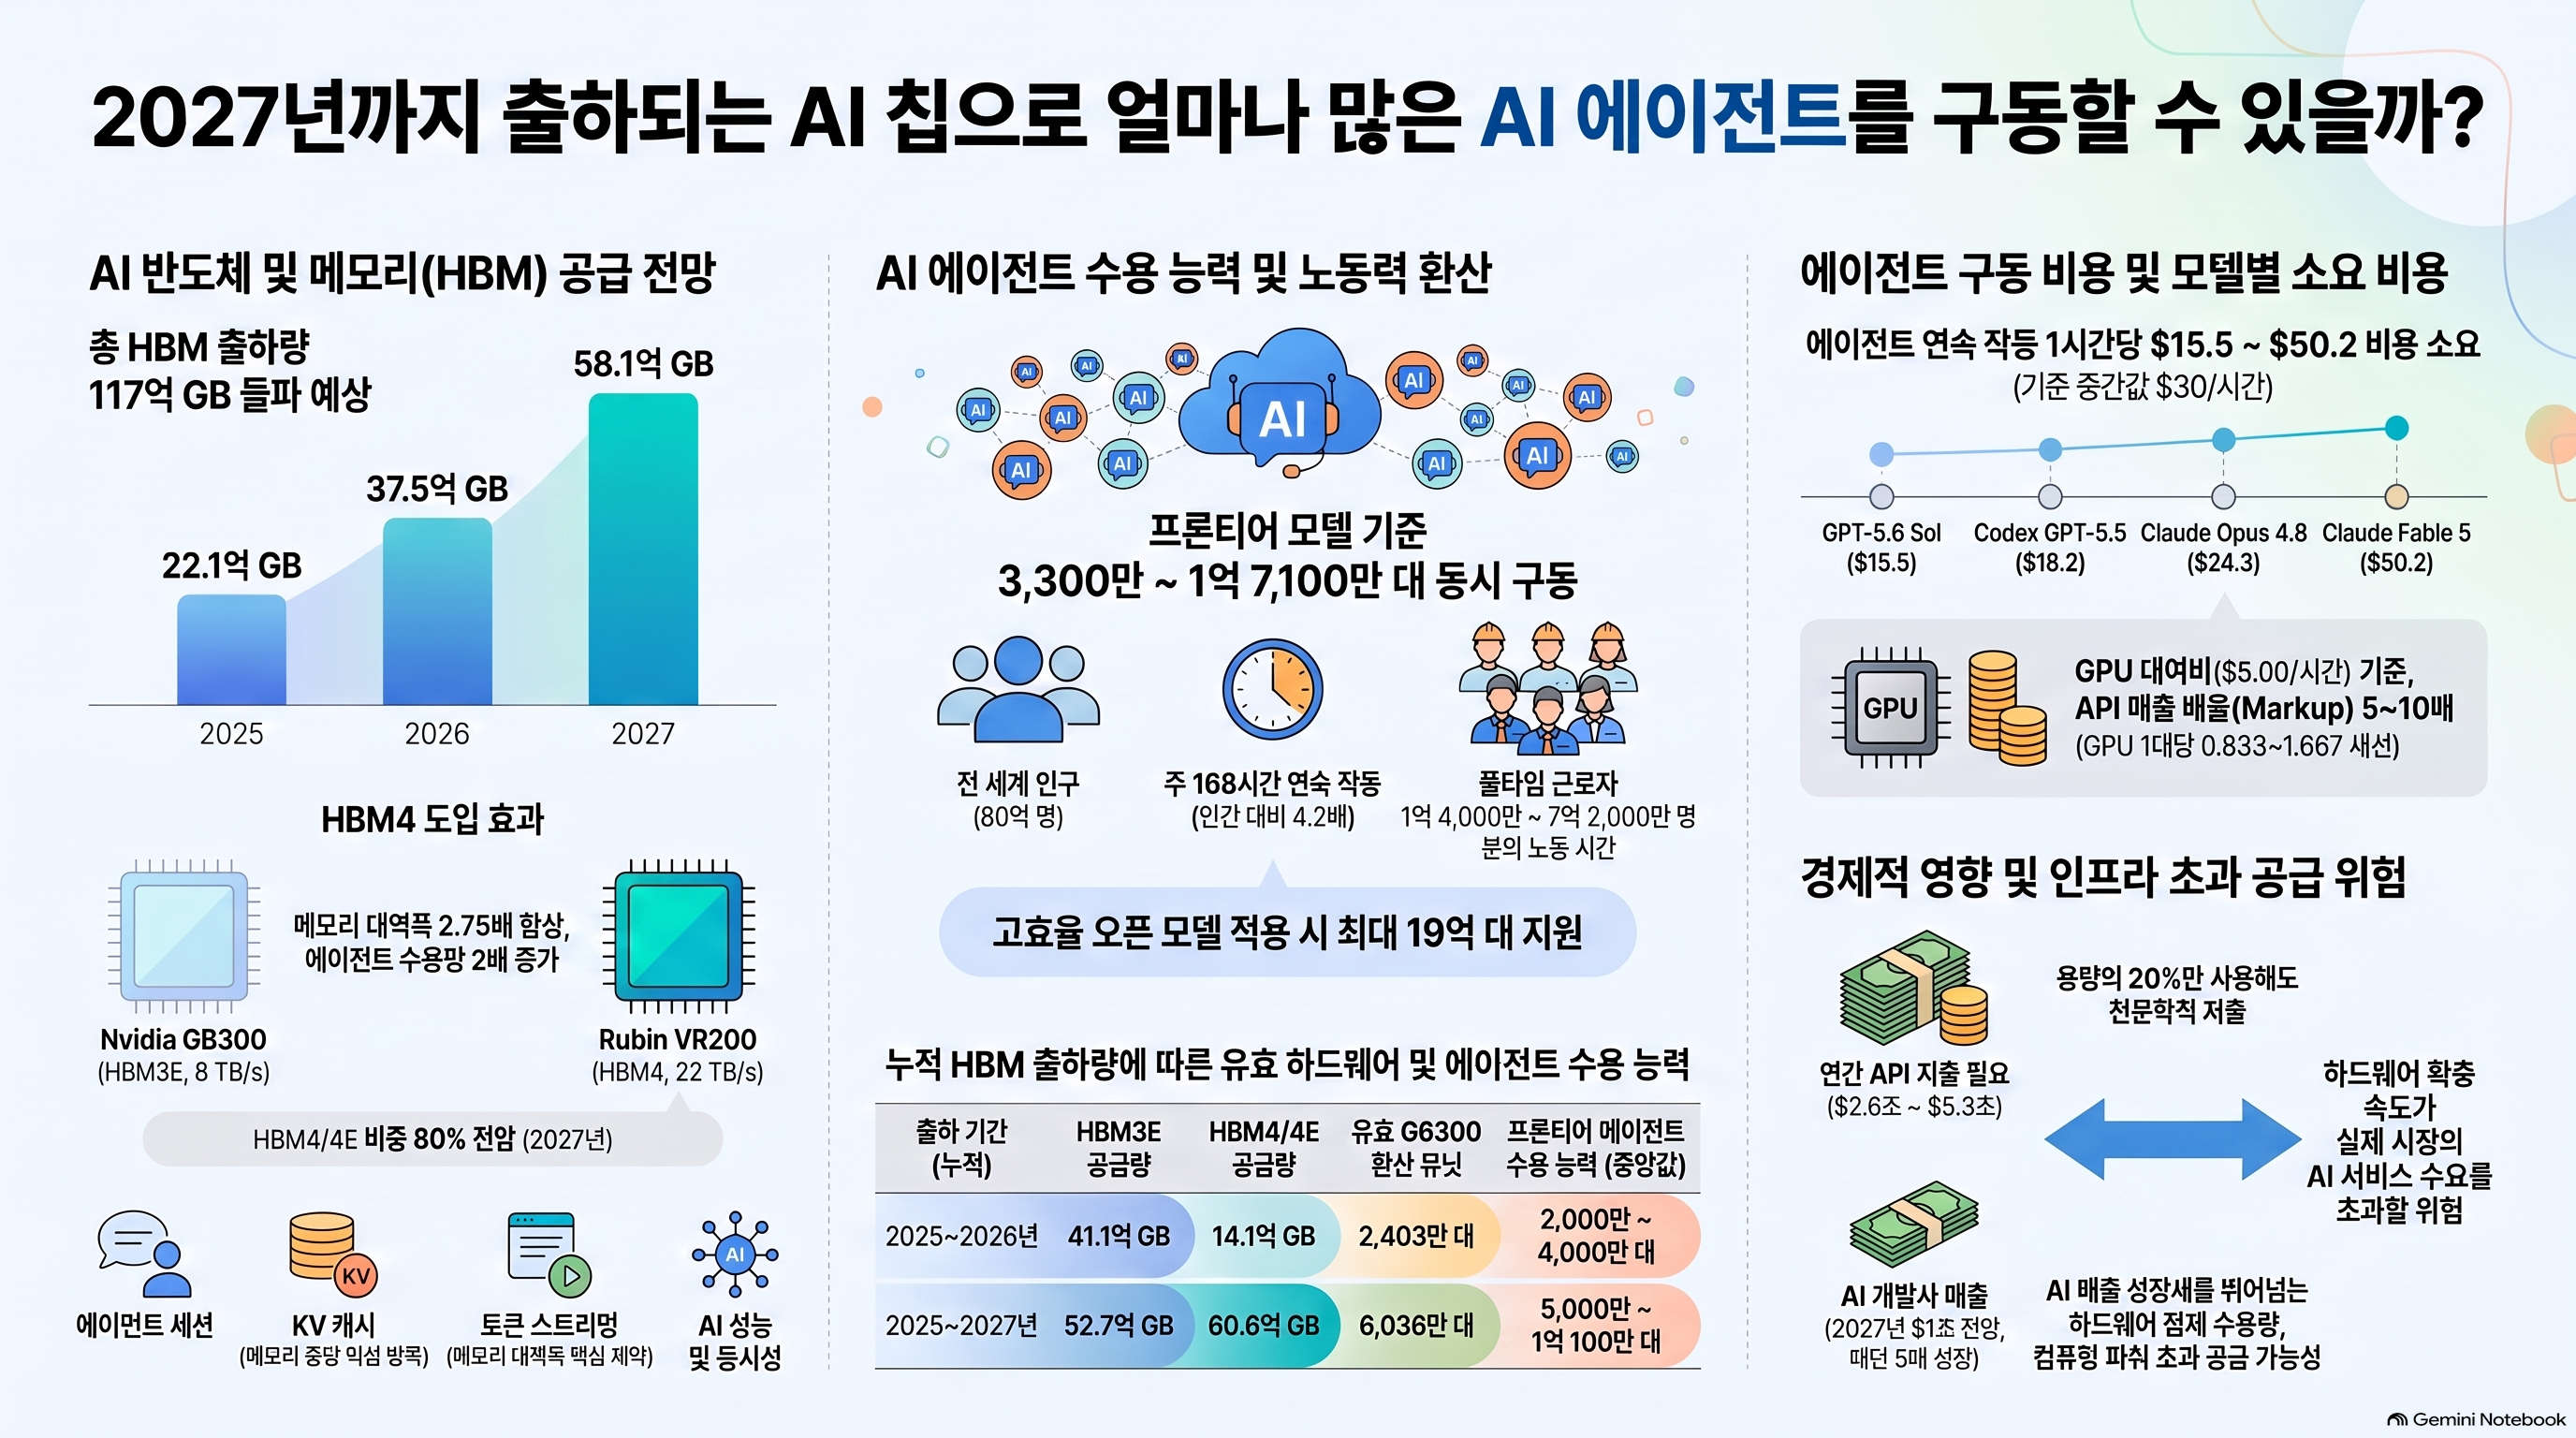
이 글은 “현재 AI 에이전트가 몇 개 존재하는가?”가 아니라, “2025~2027년에 출하되는 AI 하드웨어가 최종적으로 몇 개의 에이전트를 동시에 실행할 수 있는가?”를 추정합니다. HBM 공급량, 모델 서빙 벤치마크, 에이전트의 시간당 API 비용을 결합한 공급 측 시나리오 분석입니다.[1]
논지를 한 문장으로 정리하면 다음과 같습니다.
AI 인프라의 잠재 처리 용량은 매우 크지만, 이를 경제적으로 흡수하려면 사용자가 AI에 위임하는 업무량과 지불 의사가 크게 늘어나야 한다.
다만 에이전트 수 → 노동시간 → 생산성 → 매출은 서로 다른 지표입니다. 이 글이 정량적으로 추정하는 것은 주로 앞의 두 단계이며, 생산성과 매출 실현은 별도의 문제입니다.
아래는 원문의 실제 절과 부록 순서에 따른 분석입니다. 수치는 원문 기준이며, 주요 산식은 별도로 재계산해 확인했습니다.
1. Overview — 연구의 전체 주장
1.1 핵심 내용
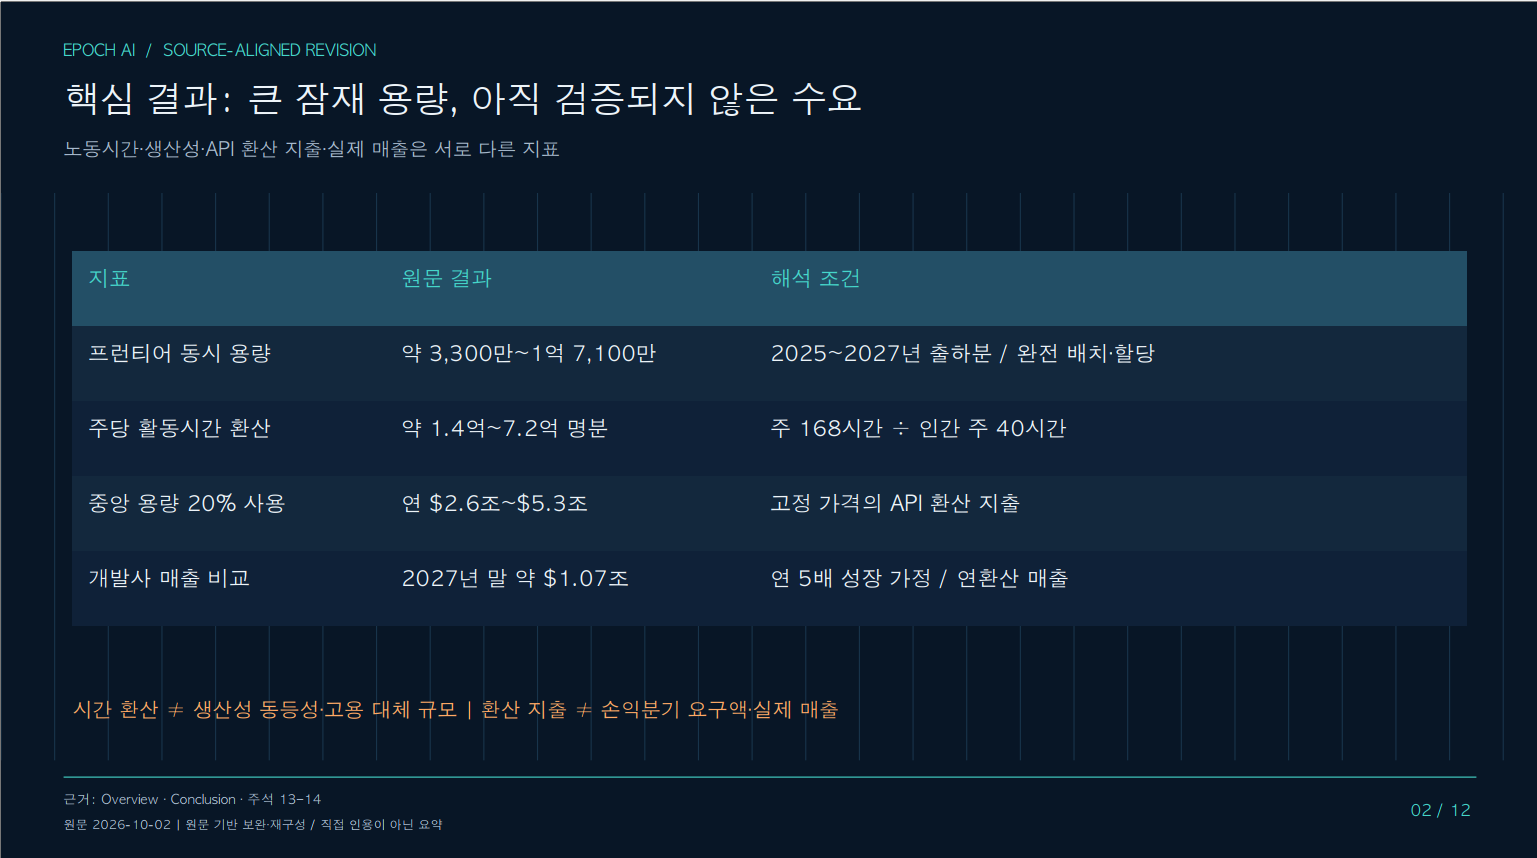
원문은 네 가지 결과를 먼저 제시합니다.[1]
구분
원문의 추정·관측 결과
정확한 해석
프런티어 모델 용량
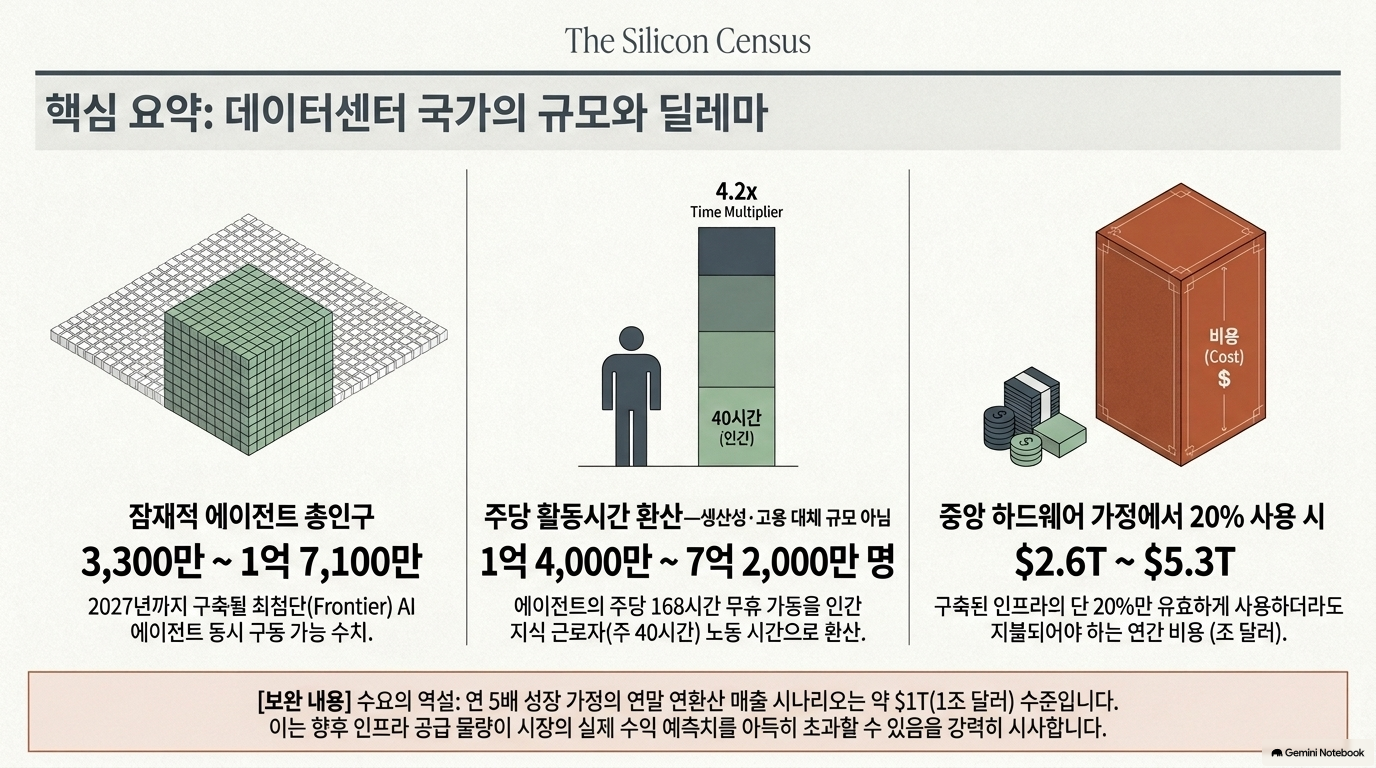
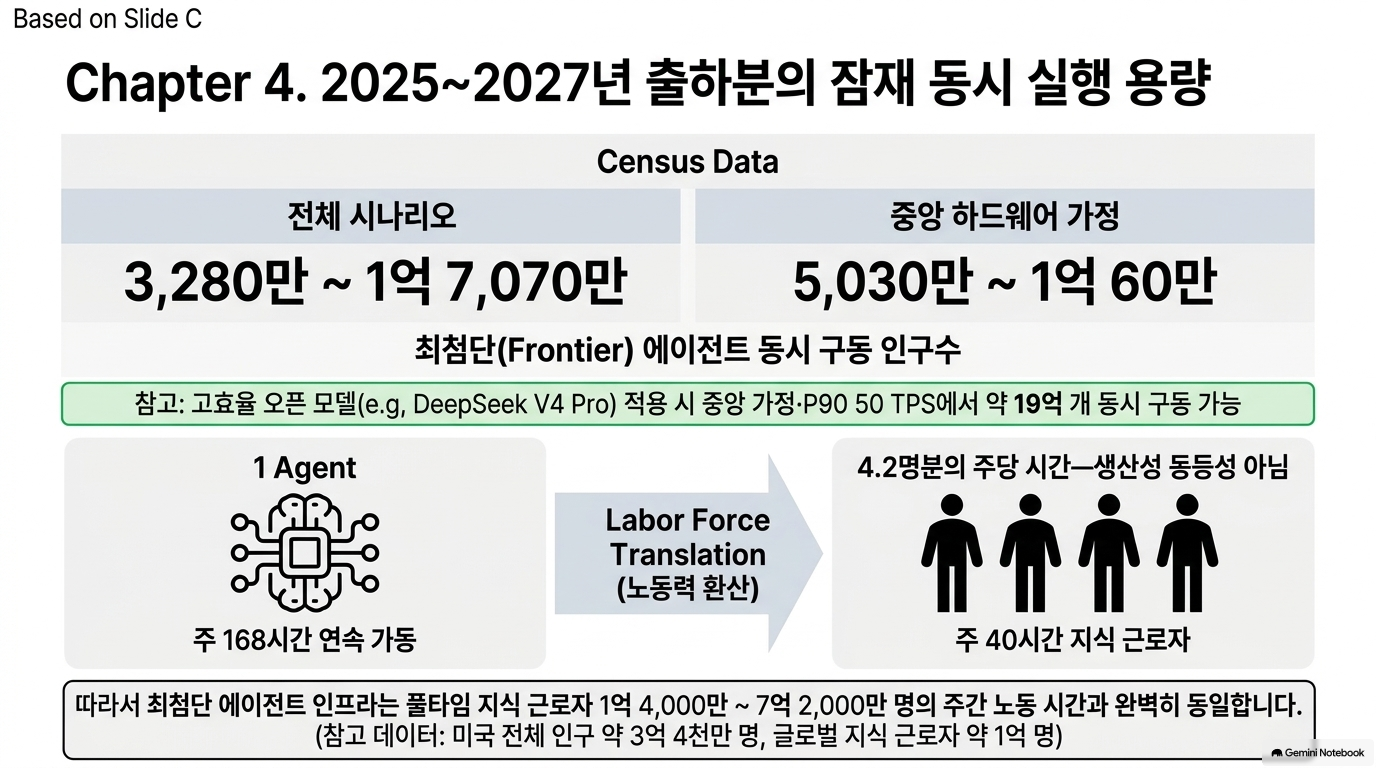
2027년까지 출하되는 하드웨어로 수천만~1억 수천만 개 동시 실행
전량 배치·해당 워크로드 전량 할당 조건의 잠재 용량
노동시간 환산
주당 근무시간 기준 약 1억 4,000만~7억 2,000만 명의 정규직에 해당
생산성이나 일자리 대체 인원이 아닌 시간 환산
효율적인 공개 모델
DeepSeek V4 Pro 기준 약 19억 개 동시 실행 가능
동일 하드웨어를 특정 모델에 할당하는 대안 시나리오
수요·지출
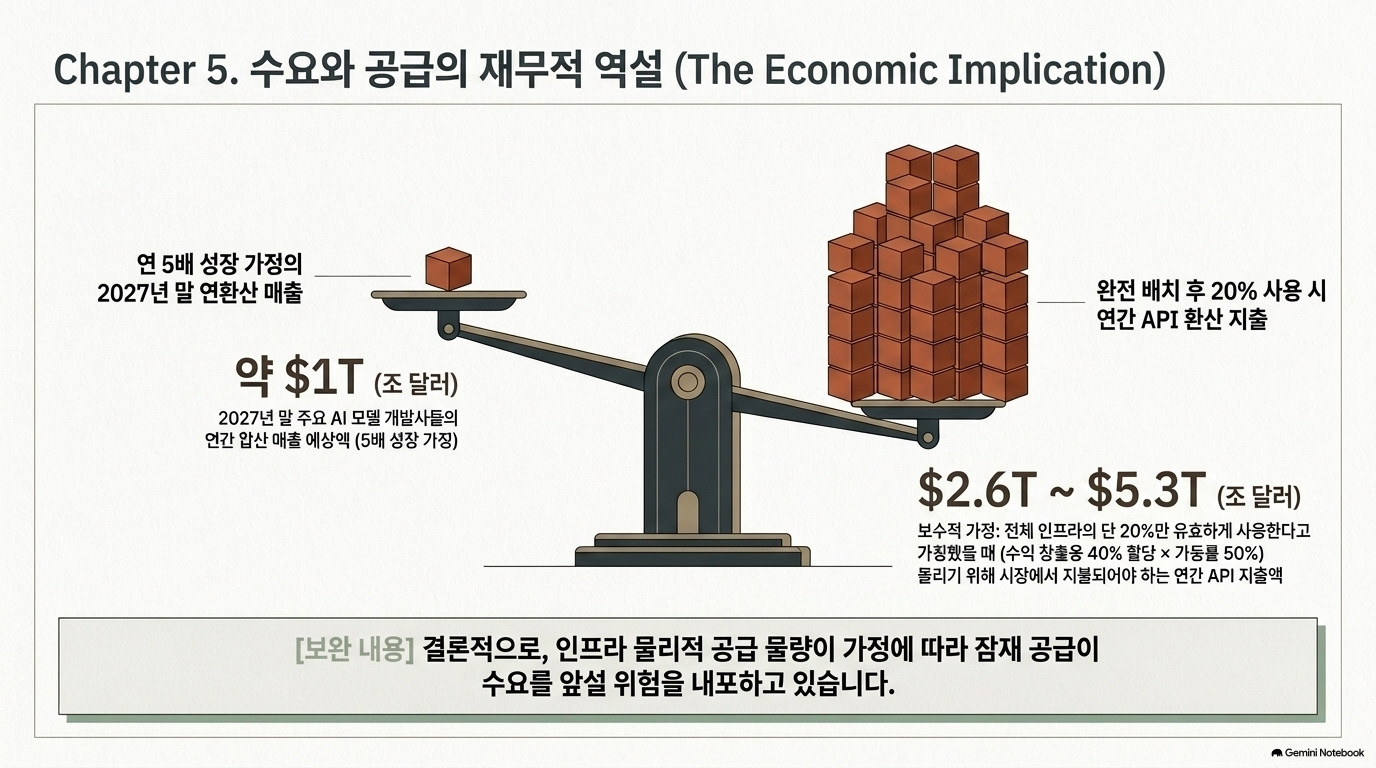
중앙 하드웨어 시나리오 용량의 20% 사용 시 연 2.6~5.3조 달러의 API 환산 지출
실제 매출·투자 손익분기점이 아님
1.2 분석
이 연구의 중요한 관점은 “모델의 지능 수준”이 아니라 “그 지능을 얼마나 많이 병렬 제공할 수 있는가”입니다.
그러나 여기서 ‘population’은 다음과 다릅니다.
등록된 에이전트 계정 수
설치된 에이전트 소프트웨어 수
일간 활성 에이전트 수
실제 경제적 업무를 성공적으로 수행하는 에이전트 수
분석적 판단:이 글은 에이전트 보급률 조사보다 AI 인프라의 잠재 공급량과 수요 간 정합성 평가에 가깝습니다.
2. Potential agent capacity and spending — 잠재 용량과 지출 규모
2.1 핵심 주장
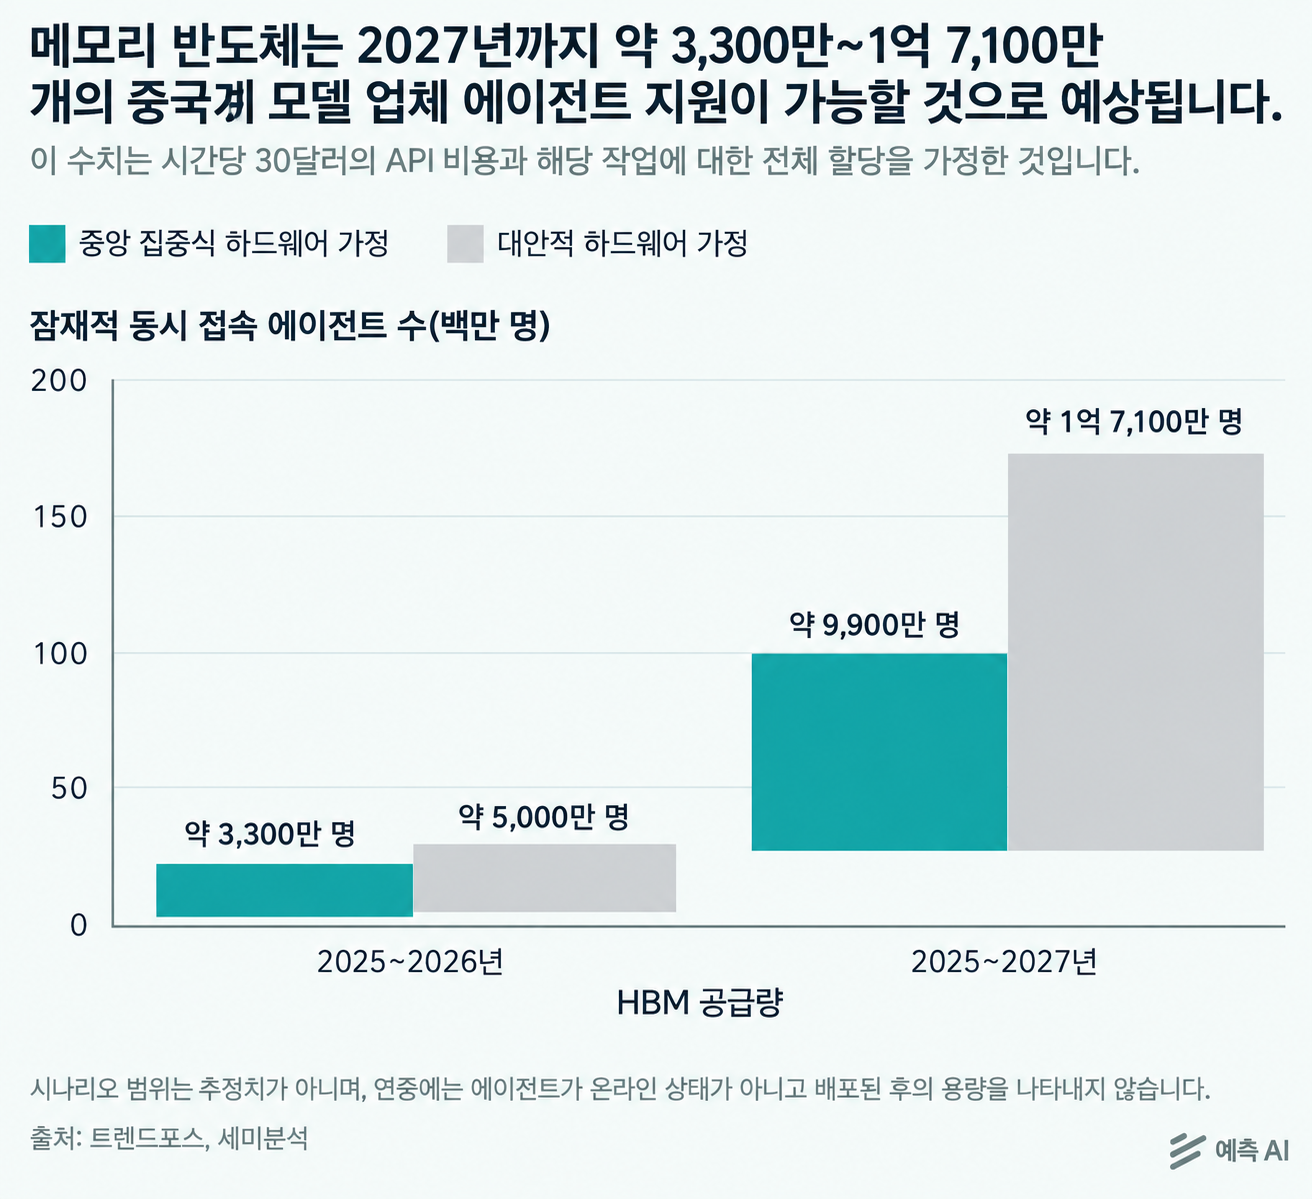
2025년부터 출하된 HBM 기반 하드웨어를 누적하면, 최종 배치 후 다음 규모의 프런티어 모델 에이전트를 지원할 수 있다고 봅니다.[1]
누적 출하 범위
잠재 동시 에이전트 수
2025~2026년
약 1,600만~5,600만 개
2025~2027년
약 3,000만~1억 7,000만 개
이 범위는 하드웨어 성능 향상과 서빙 비용 가정을 함께 변화시킨 결과입니다. 통계적 신뢰구간이 아닙니다.[1]
2.2 노동시간 환산 논리
원문은 에이전트가 일주일 내내 작동할 수 있다고 가정합니다.[1]
따라서 동시 실행 에이전트 수에 4.2를 곱해 정규직 노동시간으로 환산합니다.
중요한 한계:이 계산은 다음을 입증하지 않습니다.
에이전트 1시간이 인간 1시간과 같은 가치를 생산한다.
같은 업무를 같은 정확도로 처리한다.
사람이 개입하지 않아도 된다.
해당 규모의 일자리가 대체된다.
오히려 원문도 결과물의 품질이 달라질 수 있음을 명시합니다.[1]
2.3 Figure 1의 의미
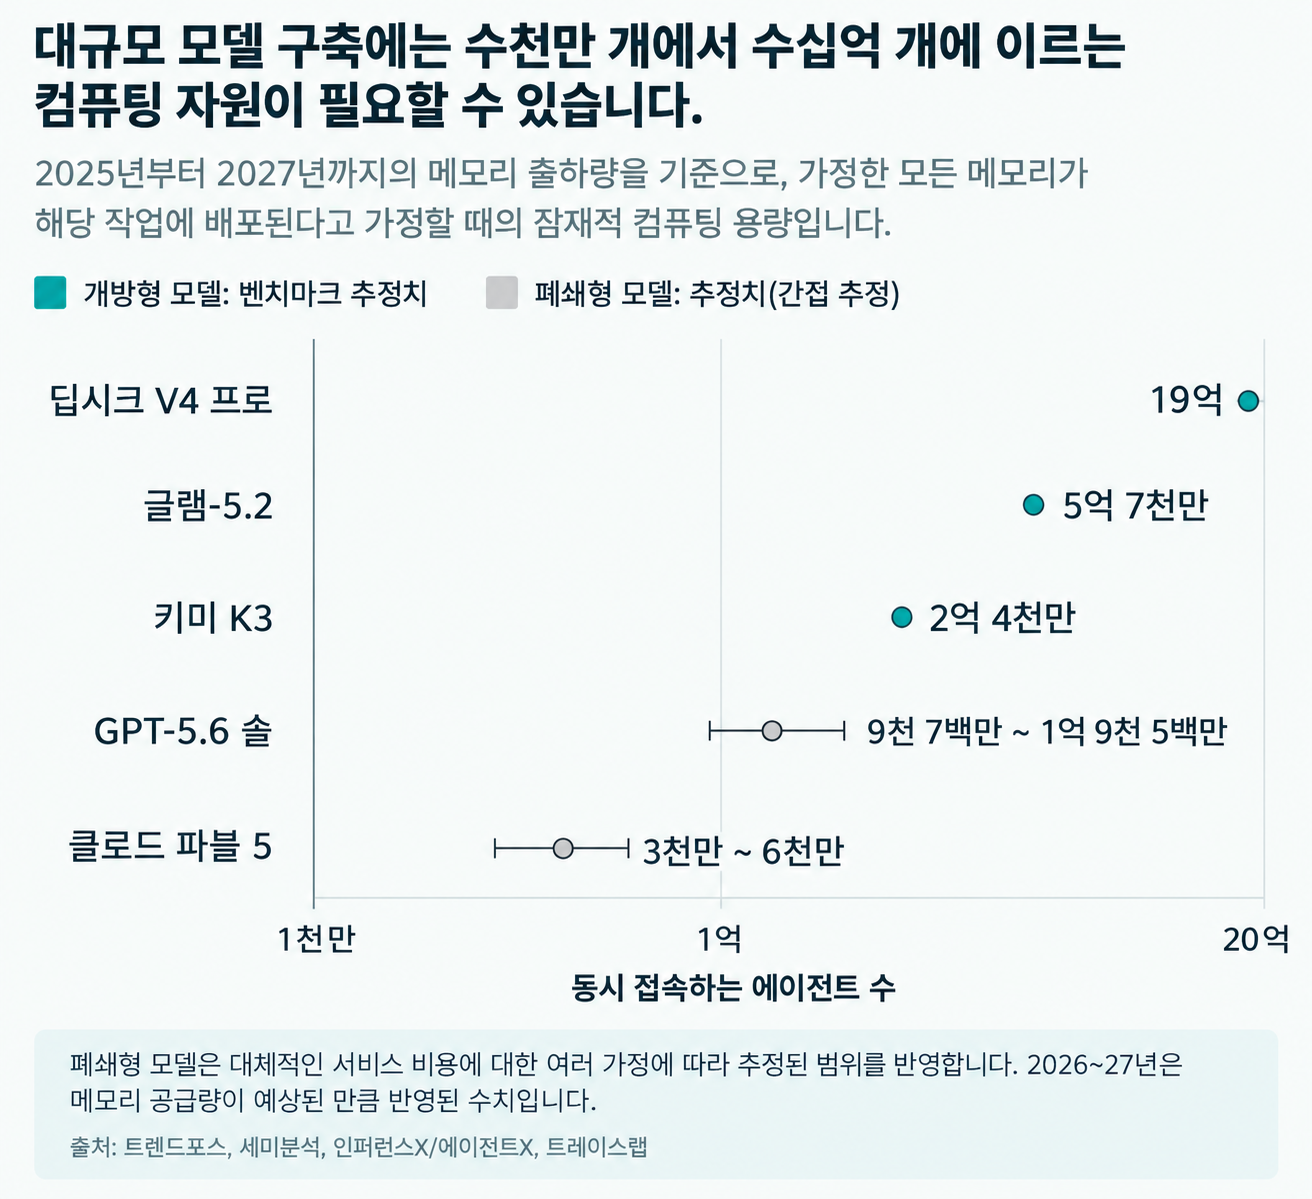
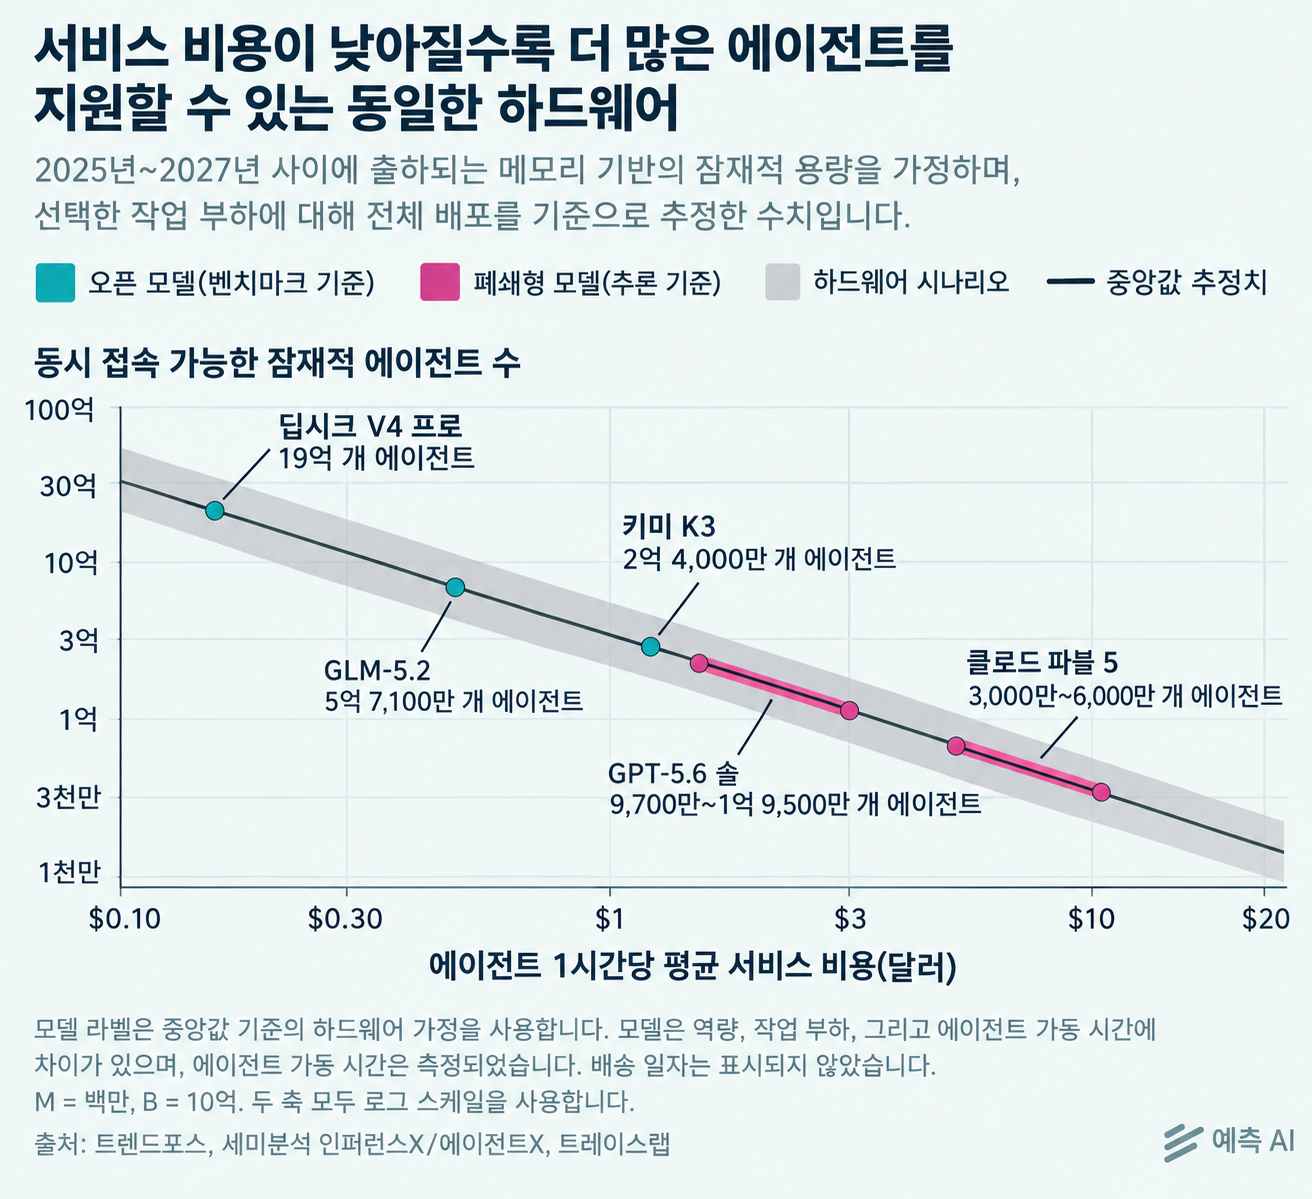
중앙 하드웨어 가정에서, 동일 공급량을 각각의 모델에 할당하면 다음 용량이 제시됩니다.[1]
모델
잠재 동시 실행 용량
DeepSeek V4 Pro
약 19억 개
GLM-5.2
약 5억 7,100만 개
Kimi K3
약 2억 4,000만 개
GPT-5.6 Sol
약 9,700만~1억 9,500만 개
Claude Fable 5
약 3,000만~6,000만 개
해석상 주의:이 숫자들을 합산하면 안 됩니다. 각각 같은 하드웨어 풀의 대안적 사용 방식입니다. 또한 공개 모델은 벤치마크 기반, 비공개 모델은 비용 역산 기반이어서 추정 방식도 다릅니다.[1]
2.4 분석
이 절의 핵심 질문은 다음과 같습니다.
“그만큼 많은 에이전트를 실행할 수 있다는 사실과, 그만큼 많은 에이전트를 유료로 사용할 시장이 존재한다는 사실은 같은가?”
원문의 답은 아직 불확실하다입니다. 공급 가능량이 수요보다 먼저 확대될 수 있다는 위험을 제기하는 것이지, 공급 과잉이 확정되었다고 선언하는 것은 아닙니다.
3. How we estimate agent capacity — 추정 모형
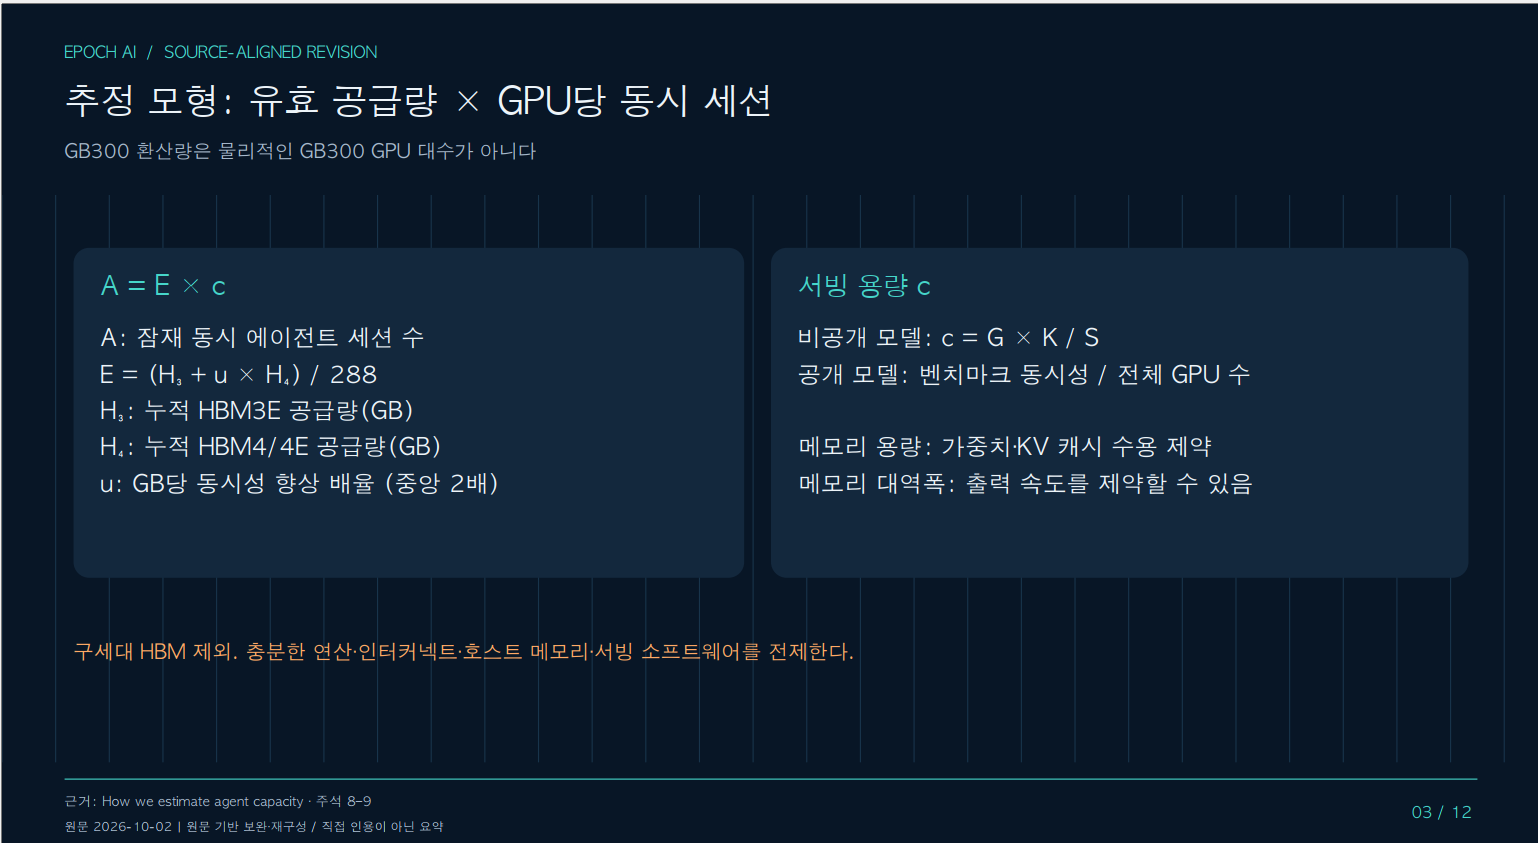
3.1 전체 산식
잠재 동시 에이전트 수
는 다음 두 요소의 곱입니다.[1]
: 유효 하드웨어 공급량, GB300 환산 단위
: GB300 환산 단위당 동시 에이전트 세션 수
즉, 공급량 × 단위 하드웨어의 처리 용량이라는 구조입니다.
3.2 하드웨어 공급량
변수
의미
주요 가정
누적 HBM3E 공급량, GB
2025년부터 포함
누적 HBM4/4E 공급량, GB
미래 출하량·세대 비중 포함
HBM4/4E의 GB당 에이전트 수 증가 배율
중앙 2배, 민감도 1~4배
288
GB300 GPU의 메모리 용량
공통 환산 단위
이 ‘GB300 환산량’은 물리적인 GB300 GPU 대수와 동일하지 않습니다. HBM4의 성능 향상을 가중한 유효 처리 용량입니다.[1]
3.3 비공개 모델의 처리 용량
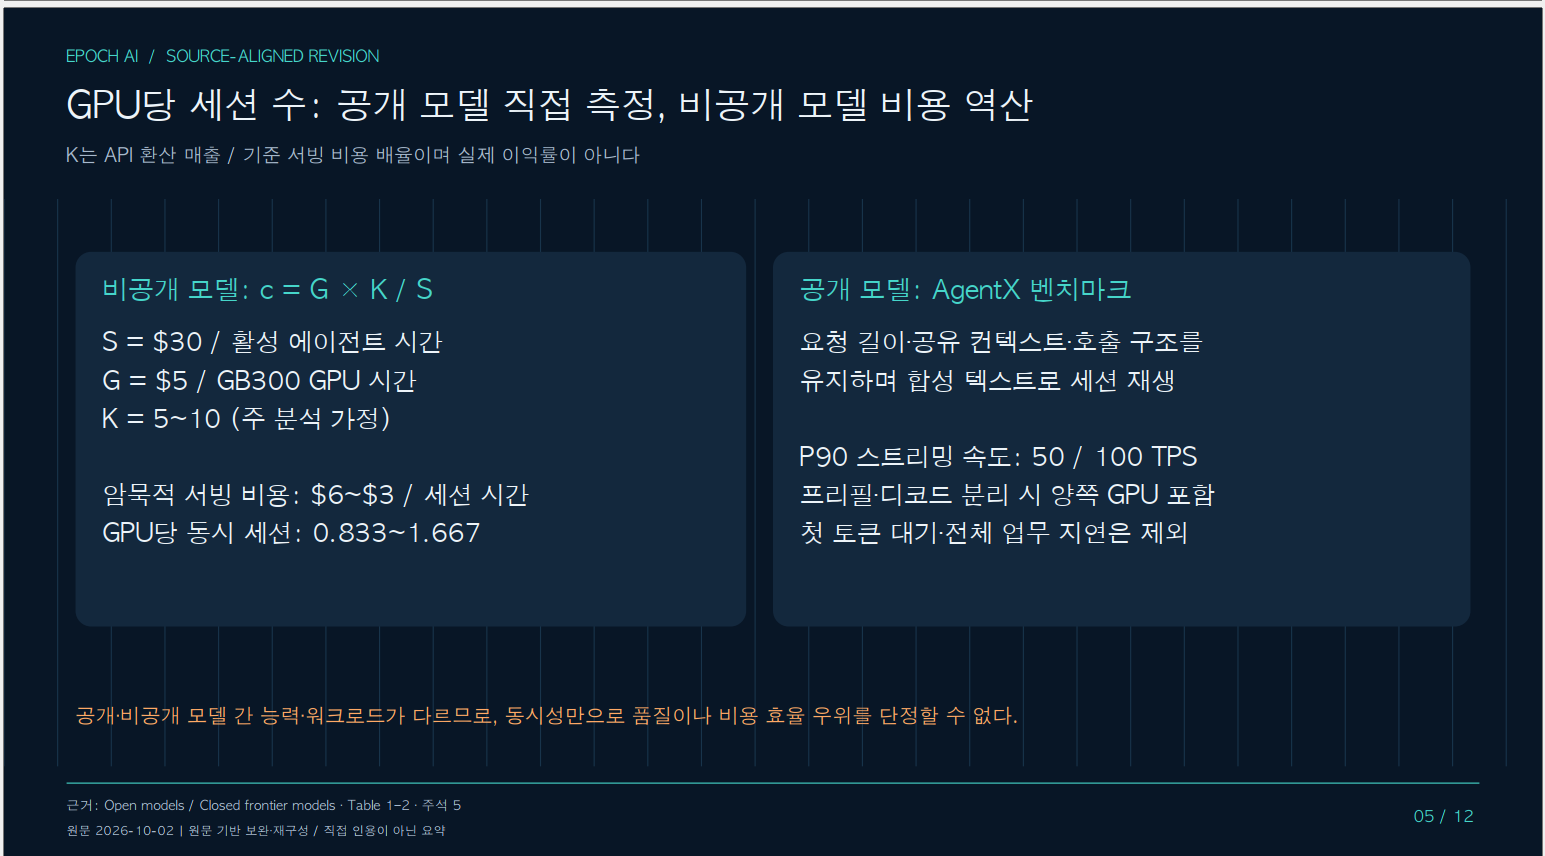
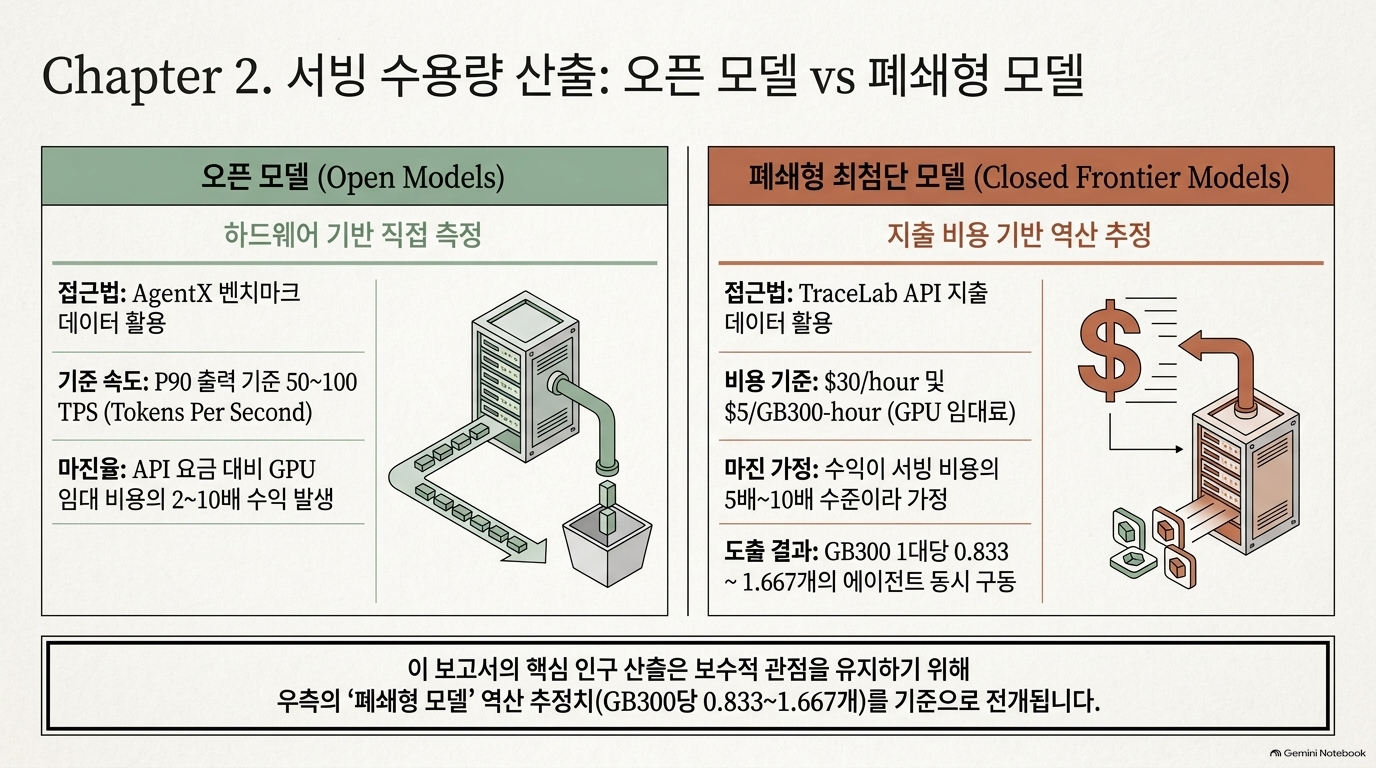
비공개 모델은 하드웨어 벤치마크 대신 비용을 역산합니다.[1]
: 활성 에이전트 1시간의 API 환산 지출
: GB300 GPU 1시간의 기준 임대 비용
: API 환산 매출 ÷ 기준 서빙 비용
주요 가정은 다음과 같습니다.[1]
따라서 GPU당 약 0.833~1.667개 동시 세션이 도출됩니다.
3.4 분석: 가장 중요한 불확실성
이 모형은 이해하기 쉽지만, 비공개 모델의 물리적 처리 용량을 가격과 비용 비율로 추론한다는 한계가 있습니다.
특히
는 실제 공급자의 이익률이 아닙니다. 공개 모델의 가상 API 청구액과 GPU 임대 비용을 비교해 참고 범위를 설정한 가정입니다.[1]
또한 다음 구분이 중요합니다.
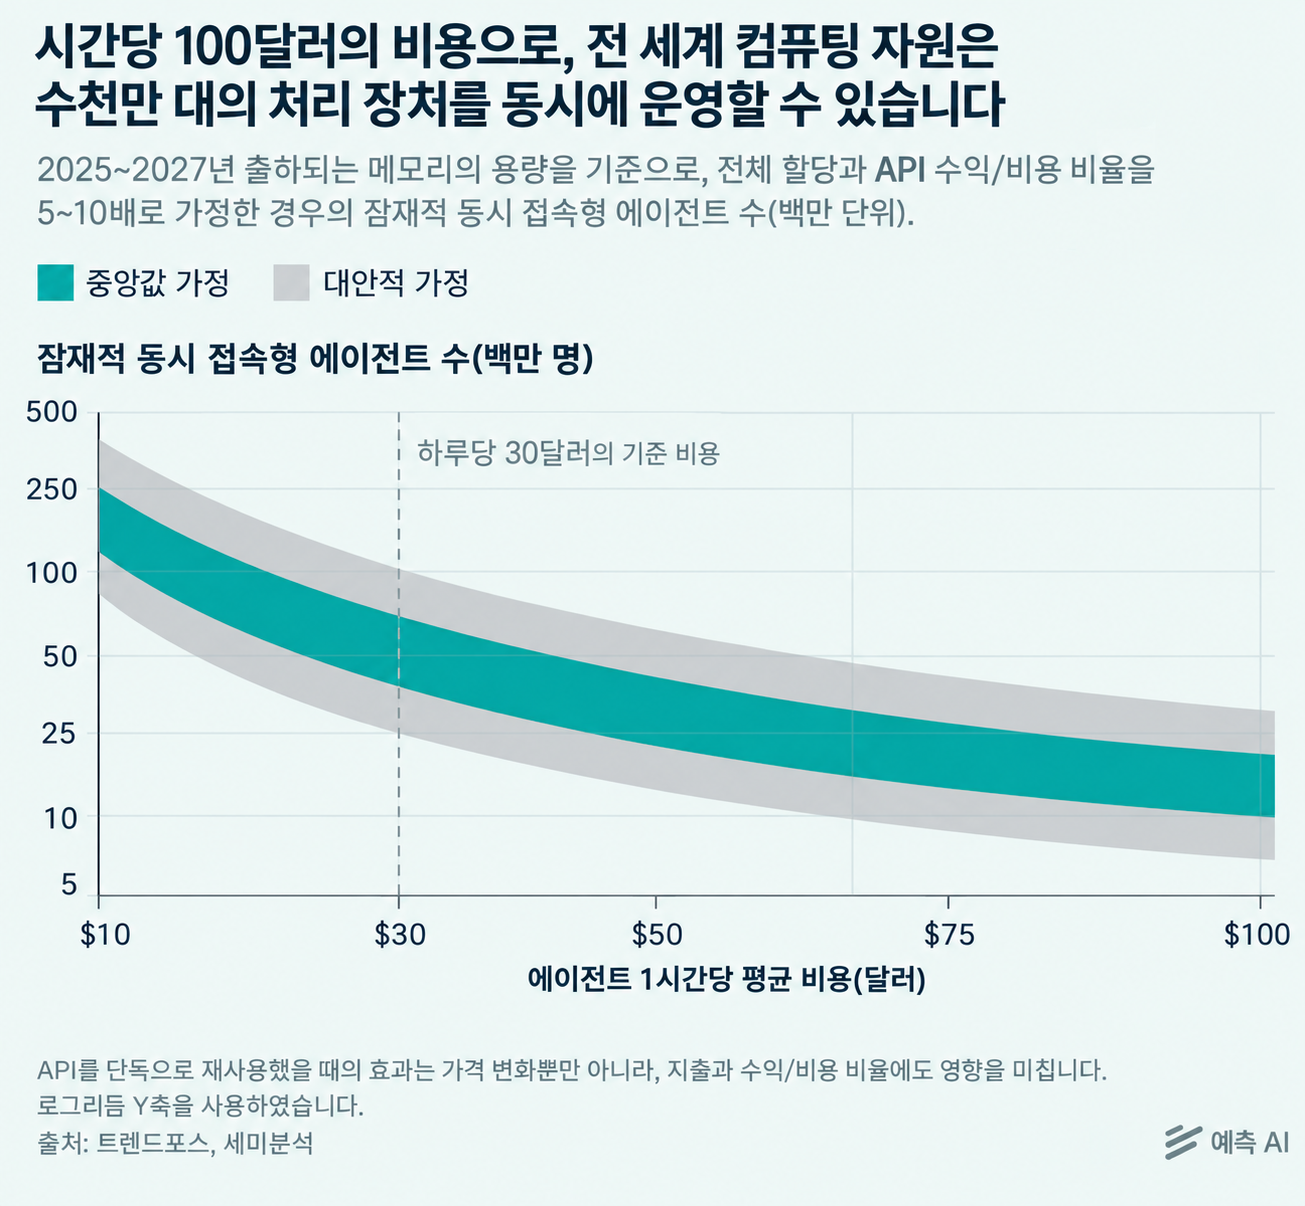
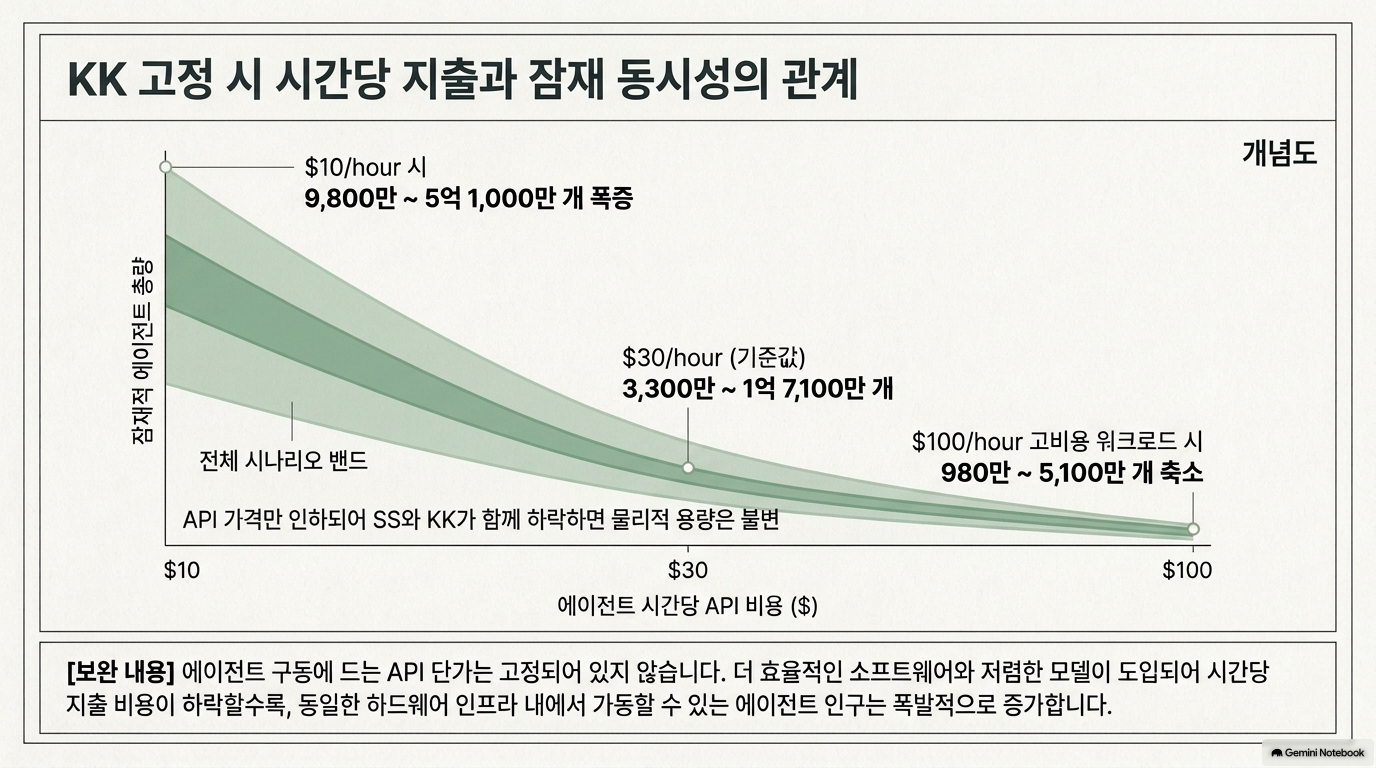
API 가격만 상승하면 물리적 처리 용량이 감소하는 것은 아닙니다.
가격만 오르면
와
가 함께 증가할 수 있어
는 그대로입니다. “시간당 비용이 높으면 에이전트 수가 감소한다”는 결과는
를 고정한 조건에서 성립합니다.[1]
4. Estimating agent sessions per GPU today — 현재 GPU당 에이전트 수
이 절은 연구의 실증적 기반입니다. 에이전트의 정의, 공개 모델 벤치마크, 비공개 모델의 실제 사용 기록을 연결합니다.
4.1 What counts as an agent? — 무엇을 하나의 에이전트로 세는가
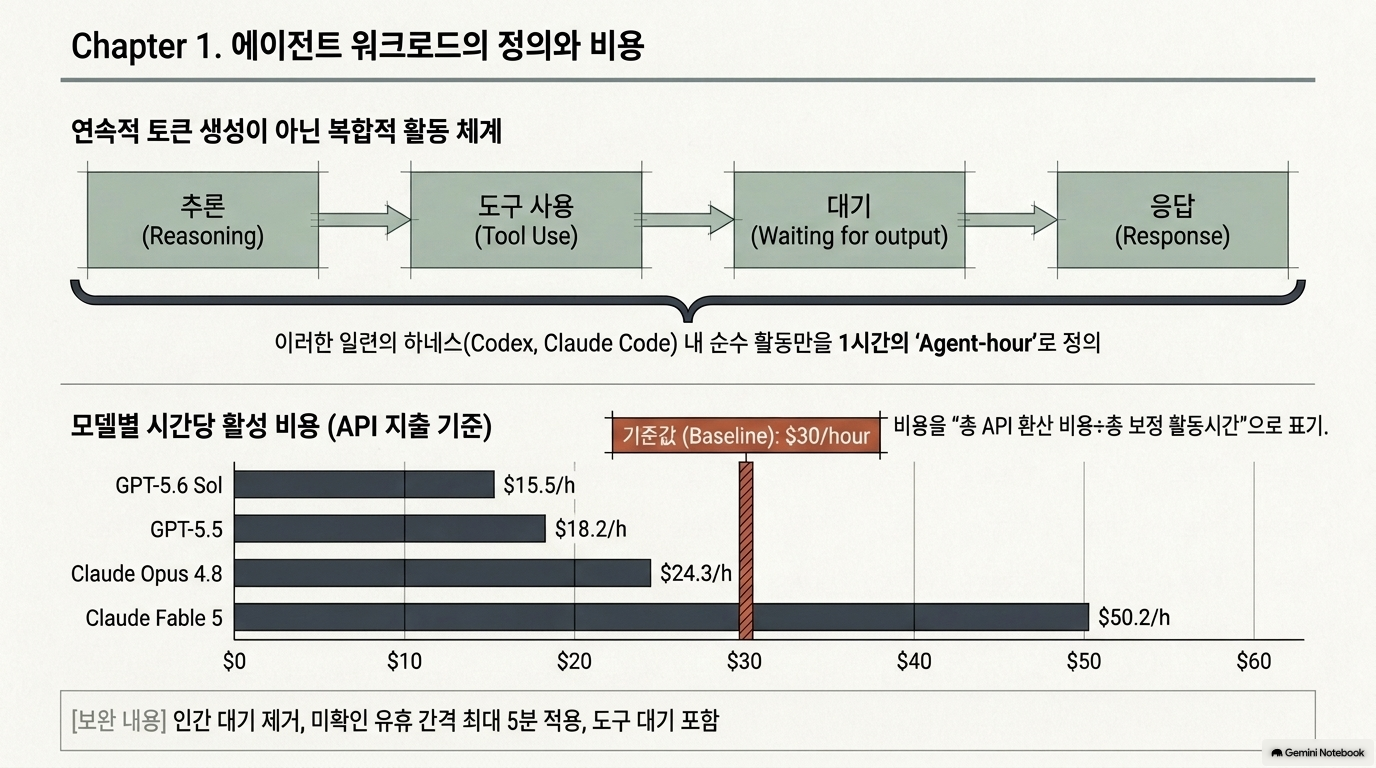
원문에서 에이전트는 Codex·Claude Code 같은 하네스에서 실행되는 모델 호출과 도구 사용을 포함하는 워크로드입니다.[1]
지속적으로 토큰을 생성하는 스트림만을 뜻하지 않습니다.
도구 실행을 기다리는 시간도 연속 세션에 포함됩니다.
사람이 응답하기를 기다리는 시간은 제거합니다.
기타 미확인 유휴 구간에는 시간 상한을 적용합니다.[1]
계수 단위에도 차이가 있습니다.
데이터
계수 방식
AgentX
주 에이전트와 하위 에이전트를 하나의 세션 트리로 계수
TraceLab
집계 그룹이 전체 세션 트리를 항상 포괄하지는 않음
분석:따라서 ‘동시 에이전트 수’는 매 순간 추론 중인 독립 프로세스 수와 같지 않습니다. 도구 대기와 하위 에이전트 구조를 포함하는 워크로드 동시성으로 이해해야 합니다.
4.2 Open models — 공개 모델은 벤치마크로 직접 측정
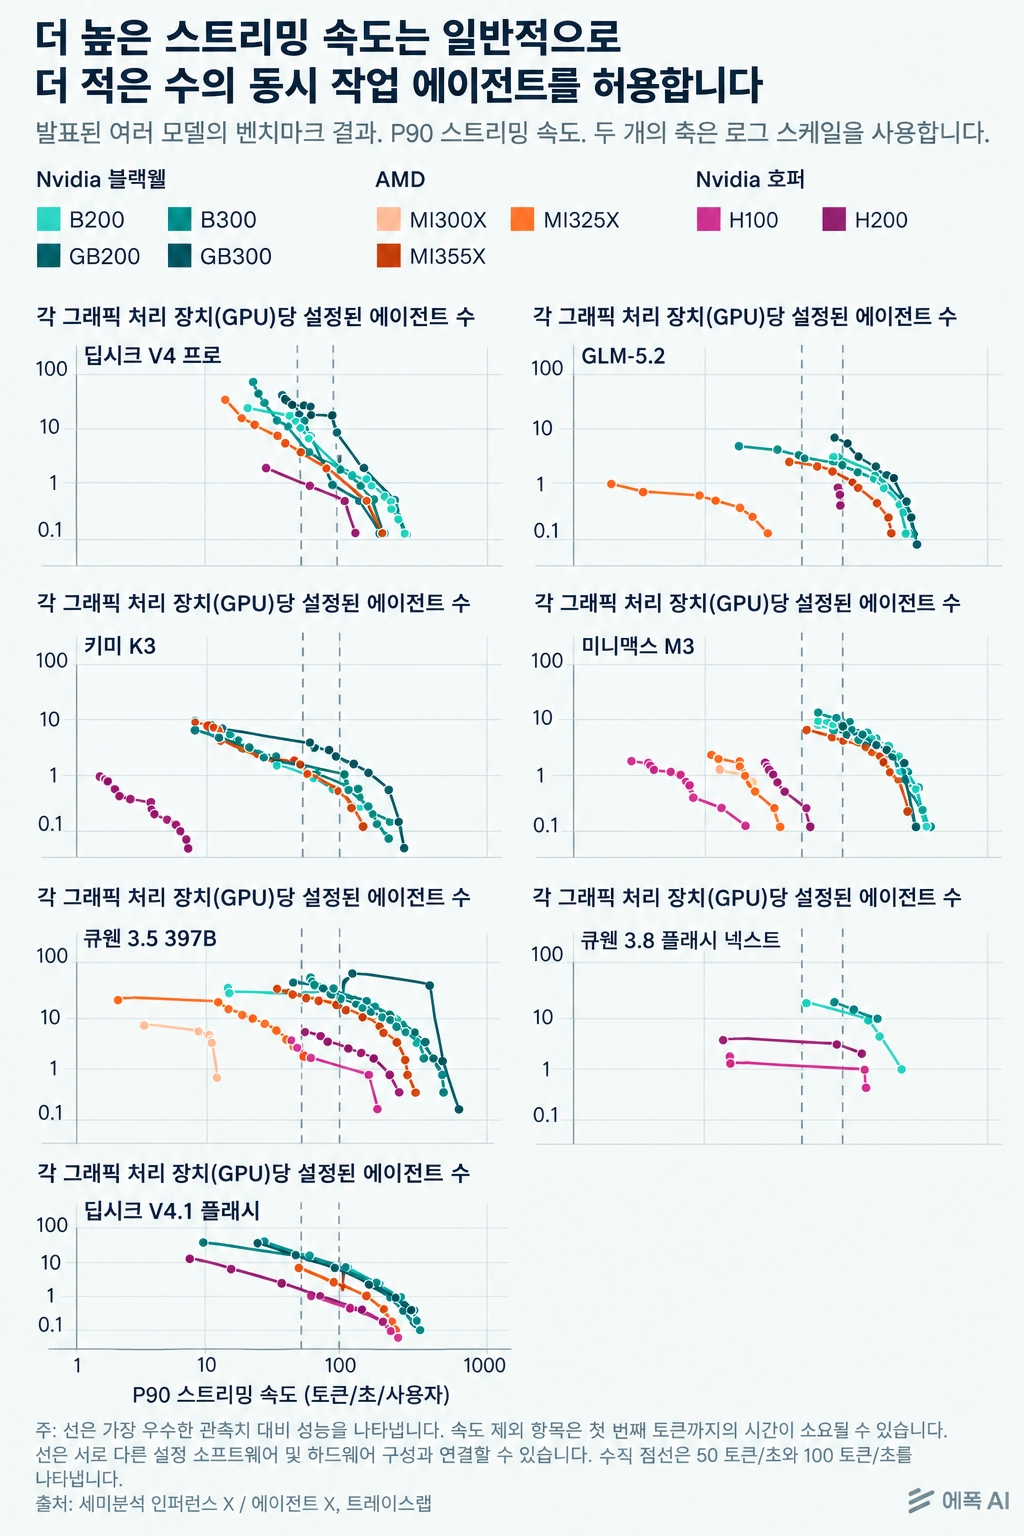
원문은 SemiAnalysis의 InferenceX AgentX를 사용합니다. Claude Code 세션의 요청 길이, 공유 컨텍스트, 호출 시점·구조를 유지하면서 합성 텍스트로 재생하는 벤치마크입니다.[1]
핵심 측정치는 다음과 같습니다.
프리필과 디코드를 분리한 구성에서는 양쪽 GPU를 모두 포함합니다.[1]
속도 조건
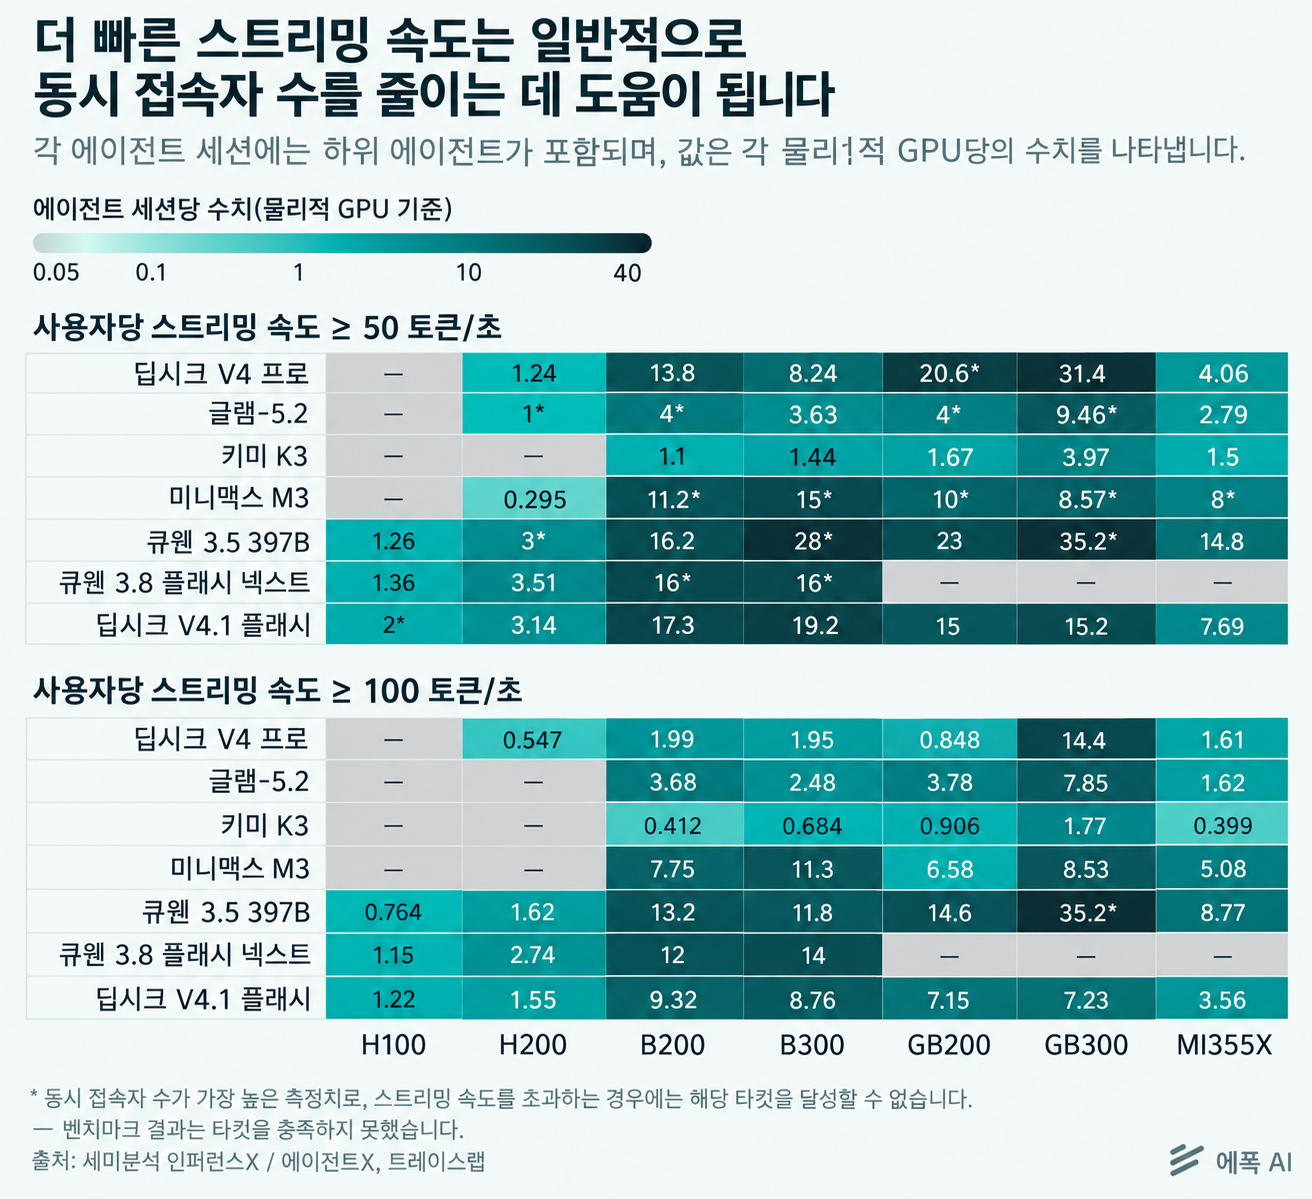
주요 기준은 사용자당 50·100 TPS이며, 200 TPS는 부록의 민감도 분석입니다. 기준은 느린 쪽의 스트리밍 성능을 나타내는 P90 지표입니다.[1]
여기서 TPS는 다음을 포함하지 않습니다.
첫 토큰이 나오기까지의 대기시간
도구 실행시간
업무 전체 완료시간
분석:높은 TPS와 높은 업무 처리 성능은 별개입니다. 이 벤치마크는 서빙 용량을 측정하며, 해당 모델이 같은 업무를 같은 품질로 완수하는지는 직접 평가하지 않습니다.
4.3 Closed frontier models — 비공개 모델은 사용 기록의 비용으로 역산
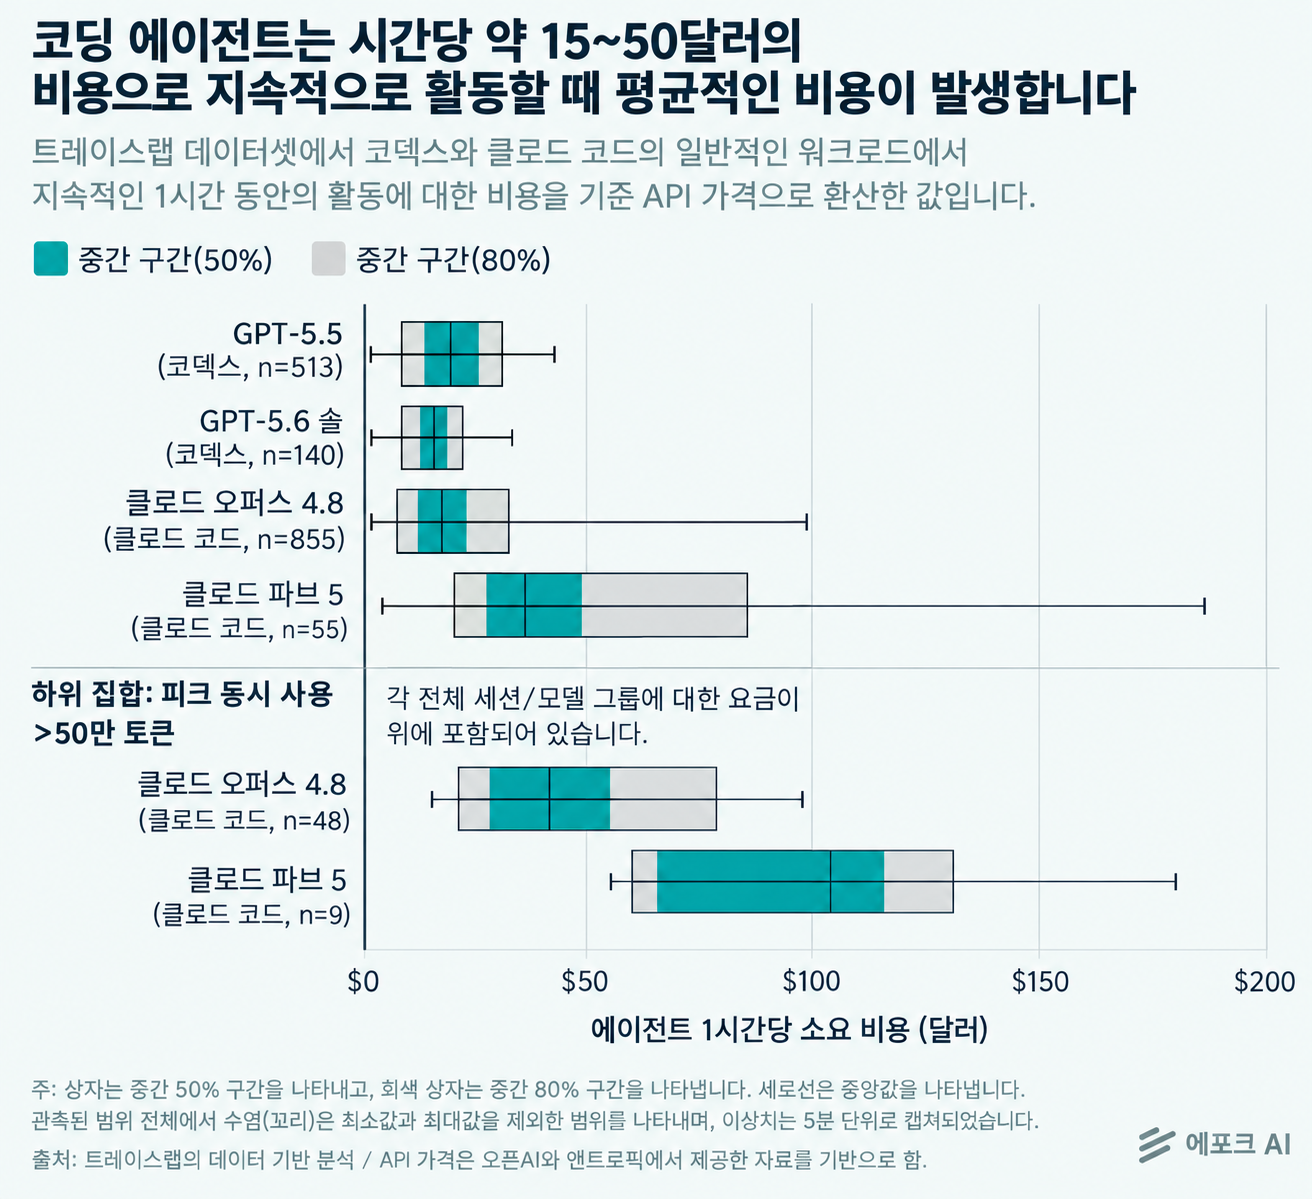
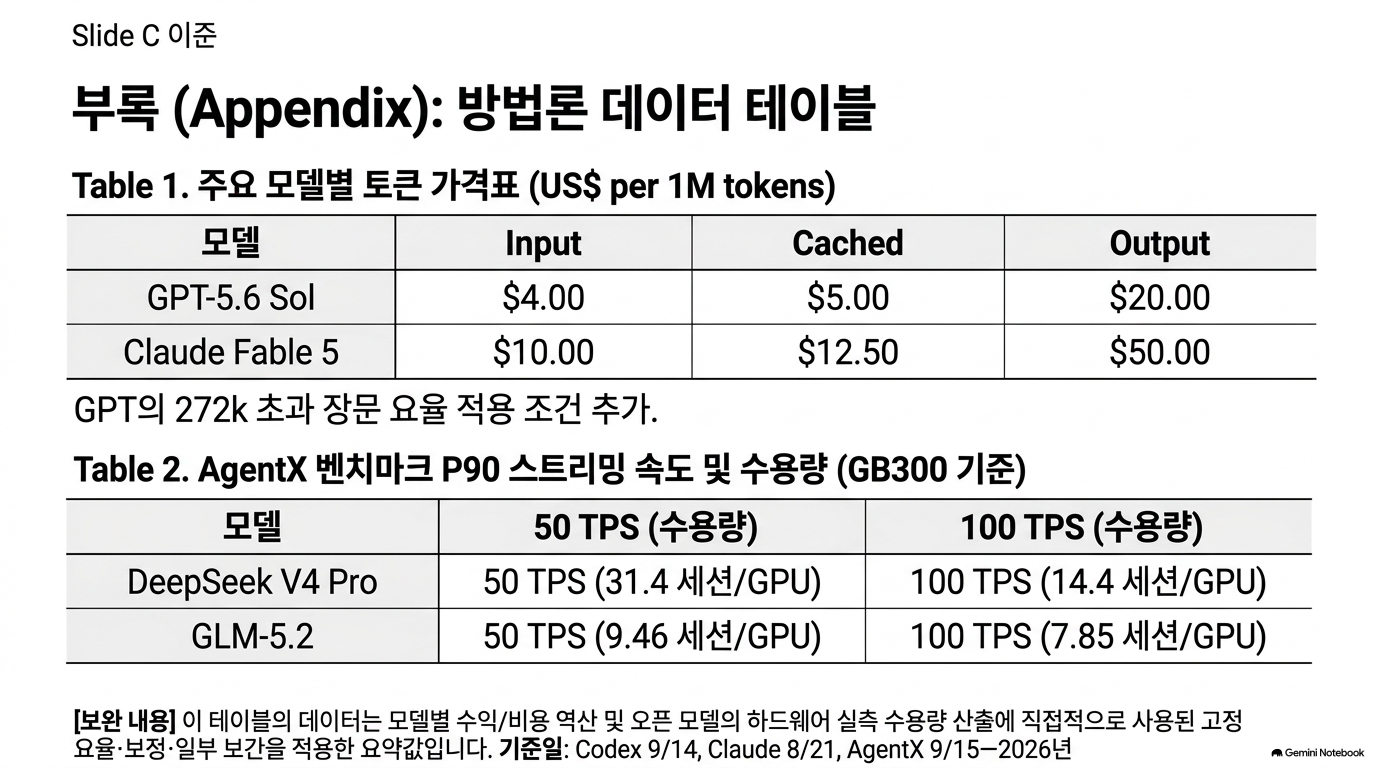
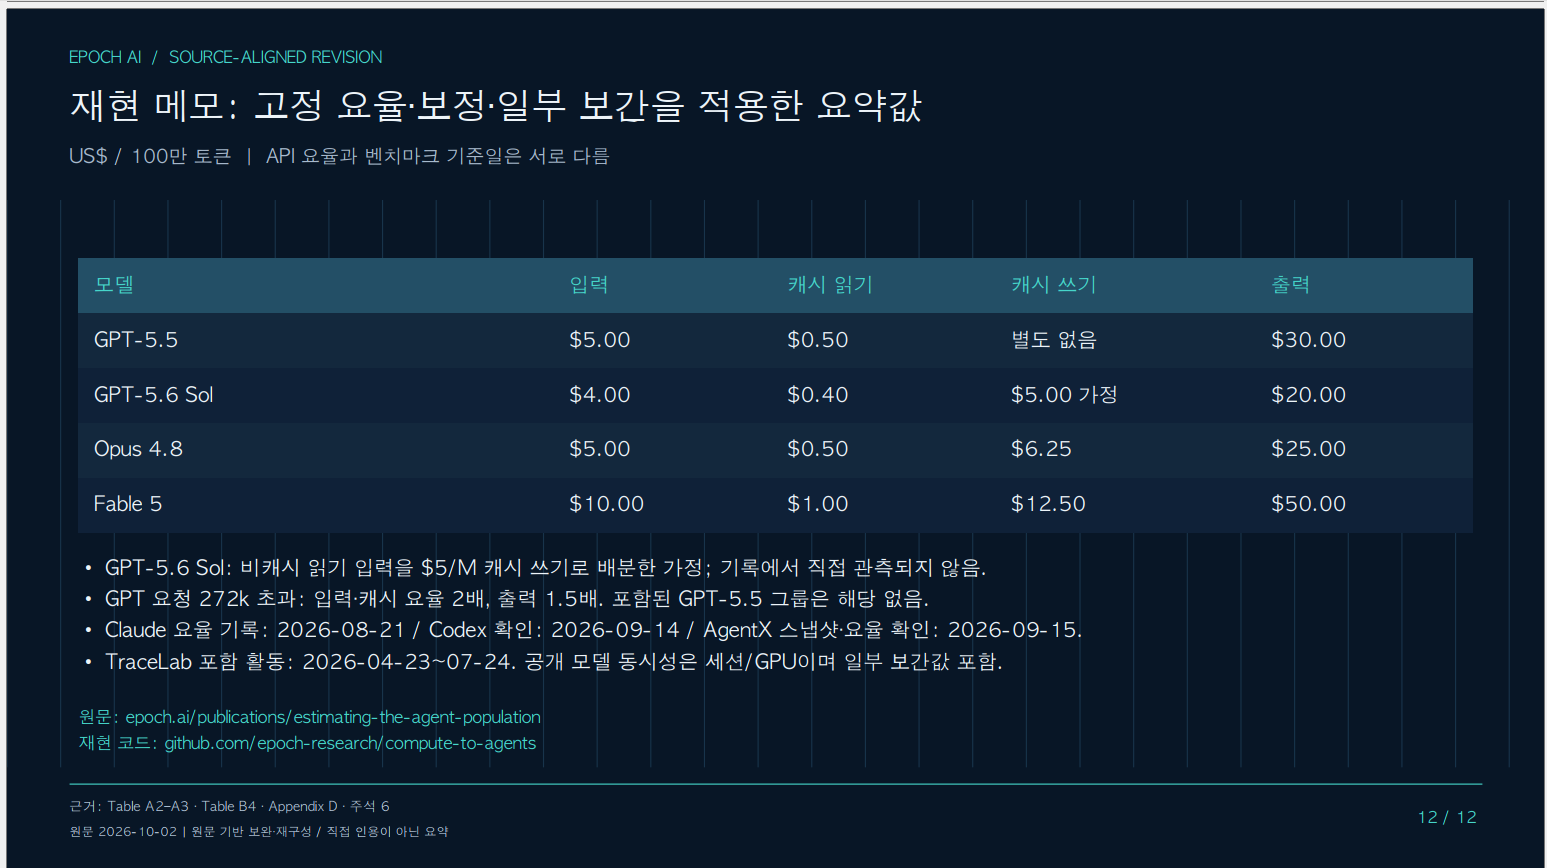
TraceLab 기록에서 인간 대기시간 등을 보정한 뒤, 총 API 환산 비용을 총 활성 시간으로 나눕니다.[1]
모델·하네스
전체 세션/모델 그룹 수
보정 활동시간
시간당 API 환산 비용
GPT-5.5 · Codex
1,069
866.4시간
$18.19
GPT-5.6 Sol · Codex
206
319.7시간
$15.50
Opus 4.8 · Claude Code
1,947
1,010.0시간
$24.34
Fable 5 · Claude Code
168
100.8시간
$50.16
네 모델의 전체 집계는 3,390개 세션/모델 그룹이며, 원래 에이전트 세션은 3,382개입니다. 하나의 원래 세션이 여러 모델 그룹에 포함될 수 있습니다.[1]
원문은 이 비용 분포를 참고해 시간당 30달러를 대표 가정으로 선택합니다.[1]
분석상 중요한 세 가지
평균의 분모 위 비용은 개별 세션의 시간당 비용을 단순 평균한 값이 아니라, 총 비용 ÷ 총 보정 시간입니다.[1]
모델과 하네스 효과가 섞여 있음 Codex와 Claude Code의 차이를 모델 가격만으로 설명할 수 없습니다. 요청 패턴·컨텍스트·도구 사용이 다를 수 있으므로, 이 표만으로 특정 모델의 비용 효율 우위를 확정하기 어렵습니다.
실제 청구액과 다를 수 있음 고정 API 요율과 캐시 유지 가정 등을 적용한 환산 비용입니다. 구독·협상 할인 등을 반영한 실제 고객 지출이 아닙니다.[1]
4.4 공개 모델의 매출/비용 배율 비교
원문은 공개 모델 벤치마크의 GPU 임대 비용과 가상 API 매출을 비교해
의 참고 범위를 제시합니다.[1]
모델·요율
50 TPS의
100 TPS의
DeepSeek V4 Pro · 비혼잡 시간
4.4배
2.1배
DeepSeek V4 Pro · 혼잡 시간
8.8배
4.2배
GLM-5.2
10.5배
9.3배
Kimi K3
4.1배
2.9배
MiniMax M3
4.8배
4.1배
분석:이 표는 5~10배 가정이 완전히 임의적이지 않다는 근거를 제공하지만, 비공개 프런티어 모델의 실제 원가를 검증하지는 못합니다. 이론적 캐시 재사용과 예측 가능한 벤치마크 부하도 실제 운영과 차이가 있습니다.
4.5 AgentX와 TraceLab의 비교 가능성
원문은 두 데이터셋의 캐시 입력·비캐시 입력·출력 토큰 소비 분포를 비교합니다. 다만 공통 Claude 모델을 합칠 때 모델별 비중을 조정하지 않았으며, 유휴시간과 캐시 처리 방식도 다릅니다.[1]
판단:이는 유사한 워크로드인지 확인하는 보조 검증입니다. 두 데이터셋이 완전히 동일하거나, 모든 산업의 에이전트 업무를 대표한다는 증거는 아닙니다.
5. Estimating future capacity from high-bandwidth memory — HBM 기반 미래 용량
5.1 HBM을 공통 공급 지표로 삼는 이유
원문은 HBM이 여러 AI 가속기에서 공통적으로 사용되며, 생산 확대의 병목이기도 하다는 점에 주목합니다.[1]
추론에서 HBM의 역할은 크게 두 가지입니다.
용량:모델 가중치와 각 요청의 KV 캐시를 저장
대역폭:가중치·KV 캐시를 읽으며 토큰을 생성하는 속도에 영향
따라서 긴 컨텍스트는 메모리 사용량을 증가시키고, 대역폭 제약은 동일한 출력 속도에서 수용할 수 있는 동시성을 제한할 수 있습니다.[1]
분석: FLOPS만으로 에이전트 용량을 추정하지 않고, 컨텍스트와 메모리 병목을 반영했다는 점이 이 연구의 강점입니다.
5.2 HBM4 성능 향상 가정
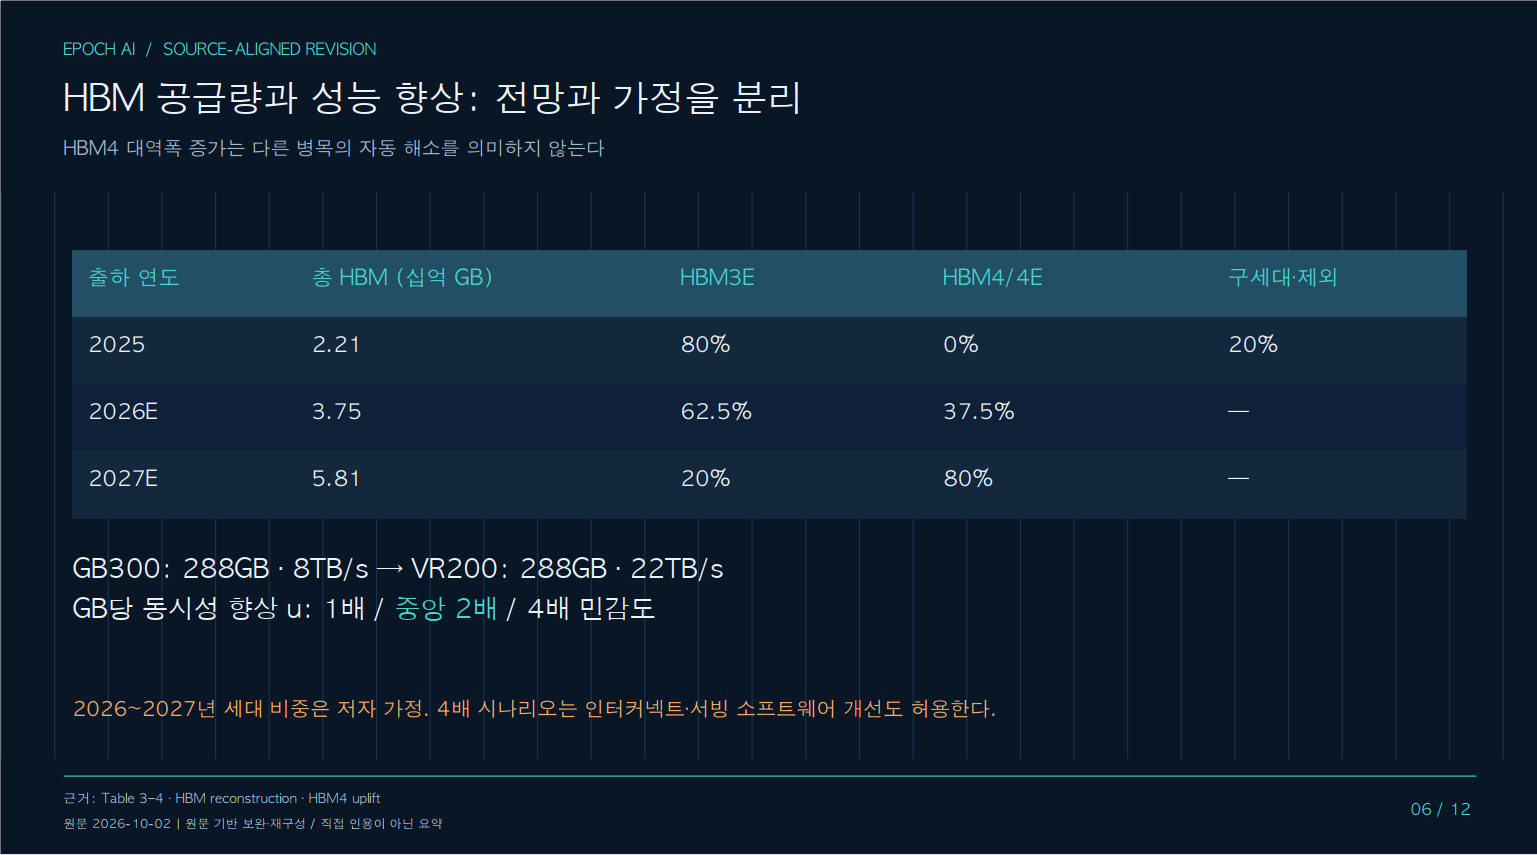
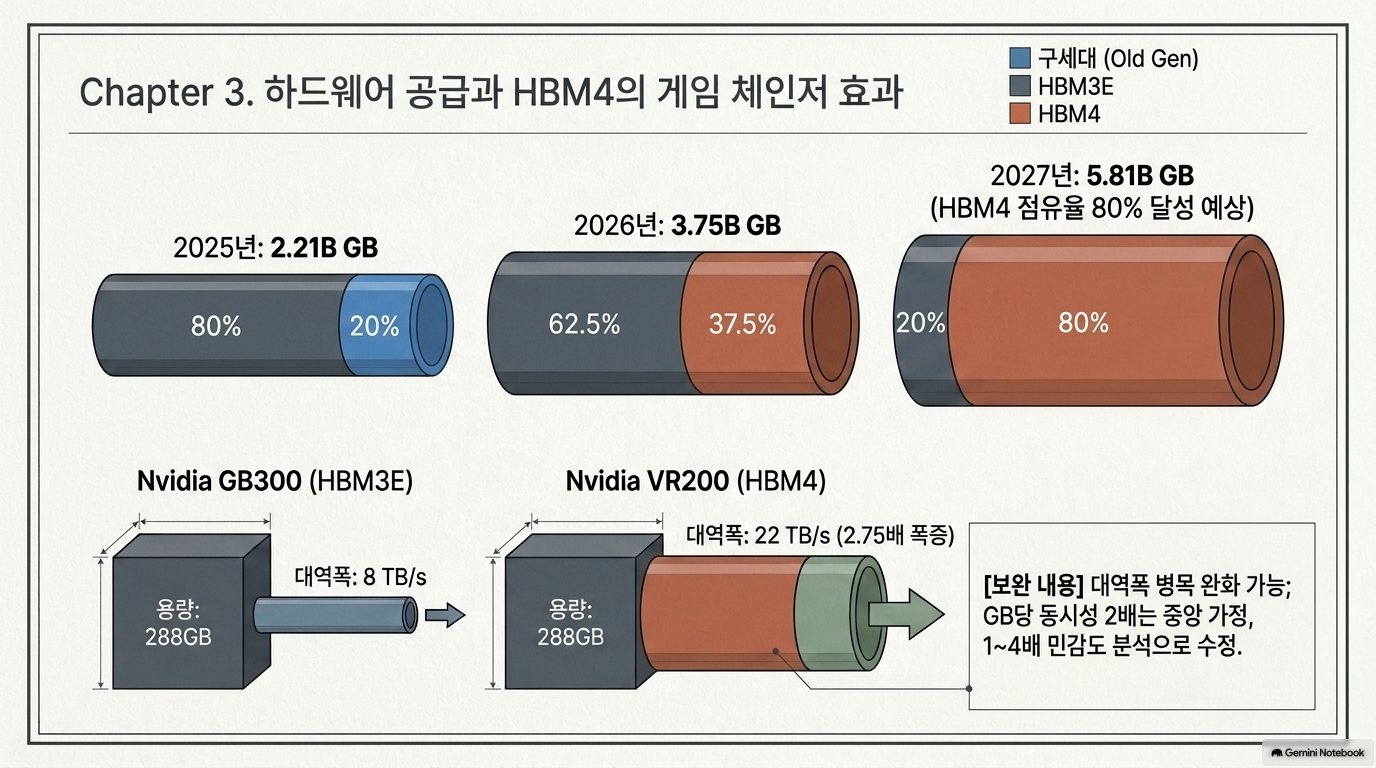
원문에 따르면 GB300과 VR200은 모두 288GB 메모리를 가지지만, 대역폭은 각각 8TB/s와 22TB/s입니다. 이를 배경으로 HBM4/4E 시스템의 GB당 세션 수가 중앙 시나리오에서 2배 증가한다고 가정합니다.[1]
시나리오
HBM4/4E의 GB당 세션 수
보수적
HBM3E와 동일
중앙
2배
상향
4배
주의:대역폭이 증가했다고 동시성이 같은 비율로 증가하는 것은 아닙니다. 메모리 용량, 인터커넥트, 연산, 서빙 소프트웨어 등 다른 병목에 따라 결과가 달라집니다. 4배 시나리오는 대역폭 외 개선도 허용하는 가정입니다.[1]
5.3 미래 HBM 공급량 재구성
출하 연도
총 HBM 공급량, 십억 GB
HBM3E 비중
HBM4/4E 비중
2025
2.21
80%
0%
2026E
3.75
62.5%
37.5%
2027E
5.81
20%
80%
원문은 TrendForce의 출하·사용량 증가 자료를 연결해 공급량을 재구성하며, 2026~2027년의 연간 세대별 비중은 저자의 가정입니다.[1]
또한 2025년의 구세대 HBM 20%는 추정 대상에서 제외합니다.[1]
[확인 필요: 원문 Table 4·Appendix B] 이 값은 확정 출하 통계만의 합산이 아닙니다. 증가율 대용치, 전망치, 세대 전환 가정이 결합되어 있습니다.
5.4 중앙 추정과 전체 범위
누적 출하 범위
향상 없음
중앙
상향
2025~2026년
1,600만~3,190만
2,000만~4,010만
2,820만~5,630만
2025~2027년
3,280만~6,560만
5,030만~1억 60만
8,530만~1억 7,070만
단위는 동시 에이전트 수이며, 모든 경우 시간당 30달러·
·완전 배치·완전 할당 조건입니다.[1]
핵심 구분:대표적인 전체 범위는 약 3,300만~1억 7,100만 개지만, 중앙 하드웨어 가정의 범위는 약 5,000만~1억 개입니다. 두 범위를 혼용해서는 안 됩니다.
5.5 공개 모델의 용량
DeepSeek V4 Pro의 GB300 벤치마크는 다음 동시성을 제시합니다.[1]
50 TPS: GPU당 약 31.4세션
100 TPS: GPU당 약 14.4세션
중앙 하드웨어 공급량에 적용하면 재계산 결과는 다음과 같습니다.
출력 속도 조건
2027년까지 누적 공급의 중앙 용량
50 TPS
약 18.97억 세션
100 TPS
약 8.70억 세션
분석:모델과 서비스 수준에 따라 용량이 크게 달라집니다. 다만 이를 프런티어 모델과 동일한 업무 품질을 제공하는 ‘대체 인력’ 규모로 해석할 근거는 없습니다. 원문도 모델 간 능력·워크로드·속도 조건이 다름을 명시합니다.[1]
6. Conclusion — 공급량을 흡수할 AI 수요가 있는가
6.1 20% 사용 시나리오
원문은 다음 두 조건을 곱합니다.[1]
전체 하드웨어의 40%를 매출을 발생시키는 추론에 할당
그 추론 용량의 50%를 실제 에이전트 활동으로 사용
여기서 사용률은 추정된 에이전트 용량 대비 실제 활동 비율이지, GPU FLOPS 사용률이 아닙니다.[1]
중앙 하드웨어 가정에서 API 환산 연간 지출은 다음과 같습니다.[1]
누적 출하 범위
20% 유효 사용 시 연간 지출
2025~2026년
약 1.1~2.1조 달러
2025~2027년
약 2.6~5.3조 달러
이는 해당 하드웨어가 배치된 후의 연간 환산치입니다. 2027년 한 해에 실제 발생할 지출이라는 뜻이 아닙니다.
6.2 매출 성장 시나리오와 비교
원문은 주요 모델 개발사의 연환산 매출 관측값 합계 약 1,105억 달러를 출발점으로, 각 관측 시점에서 연 5배 성장한다고 가정하면 2027년 말 연환산 매출이 약 1.07조 달러에 이를 수 있다고 계산합니다.[1]
다만 다음 한계가 있습니다.
연 5배 성장은 예시 시나리오이지 확정 예측이 아닙니다.
연말 연환산 매출이지 해당 연도의 누적 매출이 아닙니다.
개발사 매출에는 에이전트 API 외 제품도 포함됩니다.
잠재 용량의 API 환산 지출과 실제 기업 매출은 비교 범위가 다릅니다.[1]
분석:이 비교는 수요 확대가 얼마나 커야 하는지 보여주는 규모 비교입니다. 그 자체로 투자 실패나 공급 과잉 시점을 확정할 수는 없습니다.
6.3 배치 지연과 단기 부족
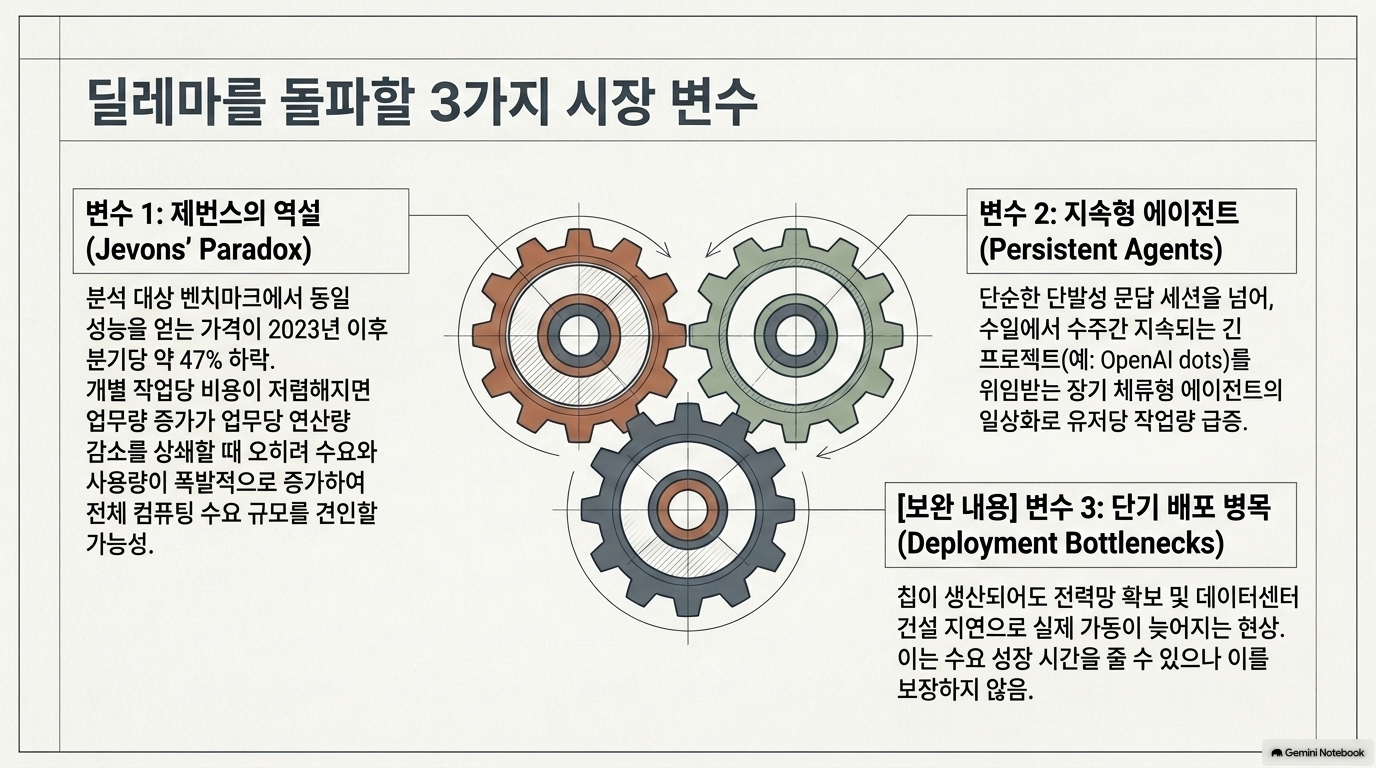
원문은 전력과 데이터센터 공간 제약으로 칩이 있어도 가동하지 못할 수 있다는 사례를 제시합니다.[1]
따라서 다음 두 상태는 양립할 수 있습니다.
현재 서비스 용량은 부족하지만, 출하된 하드웨어가 모두 배치되면 잠재 공급량은 매우 클 수 있다.
분석:공급 평가에서는 HBM 출하, 가속기 완성, 데이터센터 설치, 실제 가동을 각각 구분해야 합니다.
6.4 효율 개선과 제번스 역설
원문은 고정 벤치마크 성능에서 AI 이용 가격이 빠르게 하락하고 있다는 별도 Epoch 분석을 인용합니다. 효율 개선은 같은 업무에 필요한 하드웨어를 줄이지만, 가격 하락으로 업무량이 더 크게 증가하면 전체 연산 수요는 늘 수 있다고 설명합니다.[1]
중요한 구분은 다음과 같습니다.
가격 하락률은 연산량 감소율과 같지 않습니다.
더 많은 에이전트를 실행할 수 있다고 매출이 같은 비율로 증가하지는 않습니다.
제번스 역설은 가능한 수요 반응이지 자동으로 보장되는 결과가 아닙니다.
분석:결국 투자 논리는 ‘더 좋은 모델’만이 아니라, 더 많은 경제적 업무 위임에 의존합니다.
7. Appendix A — 벤치마크와 사용 기록의 보완 자료
7.1 첫 토큰 대기시간
Kimi K3의 특정 GB300 구성에서는 다음 값이 제시됩니다.[1]
P90 스트리밍 속도 목표
P90 첫 토큰 대기시간
50 TPS
39.8초
100 TPS
12.4초
200 TPS
4.6초
각 행은 서로 다른 배치 구성이므로, 출력 속도를 높이면 첫 토큰 지연이 이 비율로 줄어든다는 인과관계를 뜻하지 않습니다.[1]
실무적 의미:대화형 서비스의 SLO는 TPS뿐 아니라 첫 토큰 지연·전체 응답시간·도구 실행시간·업무 완료시간을 별도로 관리해야 합니다.
7.2 긴 컨텍스트의 비용
입력 컨텍스트가 한 번이라도 50만 토큰을 초과한 그룹에서는 시간당 환산 비용이 다음과 같습니다.[1]
Opus 4.8: $38.99
Fable 5: $104.75
이 값은 해당 긴 요청 하나의 비용이 아니라 그룹 전체의 비용과 시간을 기준으로 하며, 전체 모델 행에도 이미 포함되어 있습니다.[1]
분석:문서 누적·장기 작업·반복적인 컨텍스트 확장이 에이전트 비용을 높일 수 있음을 보여줍니다. 다만 표본이 작으므로 일반적인 장문 업무 전체의 평균으로 확대 해석해서는 안 됩니다.
7.3 재현성의 한계
원문은 고정 요율, 캐시 유지, 유휴시간 상한, 일부 캐시 쓰기 비용 배분 가정을 명시합니다.[1]
평가:가정을 공개했다는 점은 강점입니다. 그러나 실제 서비스 청구액이나 실시간 운영 용량을 직접 측정한 결과와는 구분해야 합니다.
8. Appendix B — 계산과 민감도 분석
8.1 어떤 변수가 용량을 바꾸는가
비공개 모델의 용량은 다음 구조입니다.[1]
변수 변화
다른 조건 고정 시 영향
적격 HBM 공급 증가
용량 증가
HBM4 향상 배율 증가
용량 증가
매출/비용 배율 증가
추정 용량 증가
시간당 API 지출 증가
추정 용량 감소
해당 워크로드 할당 비율 감소
가용 용량 감소
8.2 지출 계산에서
가 상쇄되는 점
연간 API 환산 지출은 다음과 같습니다.[1]
여기에
를 대입하면,
즉,
를 고정하면 시간당 지출
가 상쇄됩니다.[1]
분석적 의미: 2.6~5.3조 달러라는 값은 고객 수요를 독립적으로 추정한 결과가 아닙니다. 하드웨어 용량과 서빙 비용·가격 비율을 API 지출로 환산한 값입니다. 따라서 “시장 규모가 반드시 그만큼 필요하다”보다 “현재 가격·비용 관계에서 이 용량을 사용하면 그 정도 청구 규모가 된다”가 정확합니다.
8.3 비Nvidia 하드웨어 보정
주 추정은 모든 적격 HBM에 Nvidia 기준 성능을 적용합니다. 부록은 다른 가속기의 GB당 처리 성능이 더 낮을 경우를 추가로 시험합니다.[1]
제시된 예시 조합에서는 전체 용량이 주 추정보다 7.5~25% 낮아집니다.[1]
평가:혼합 가속기 환경의 불확실성을 인정한 보완입니다. 다만 특정 타사 가속기의 실제 성능을 검증한 표가 아니라 예시 민감도 분석입니다.
9. Appendix C·D — HBM 사양과 재현 코드
Appendix C: HBM 사양
세대별 대표 제품의 용량·대역폭을 정리합니다. 원문은 이것이 세대 전체의 고정 한계가 아니라 대표 사양이며, 실제 GPU는 메모리 공급업체의 최대 사양보다 낮은 속도로 동작할 수 있다고 명시합니다.[1]
분석: HBM 스택 사양을 시스템 수준의 실효 에이전트 성능으로 바로 변환해서는 안 됩니다.
Appendix D: 재현 코드
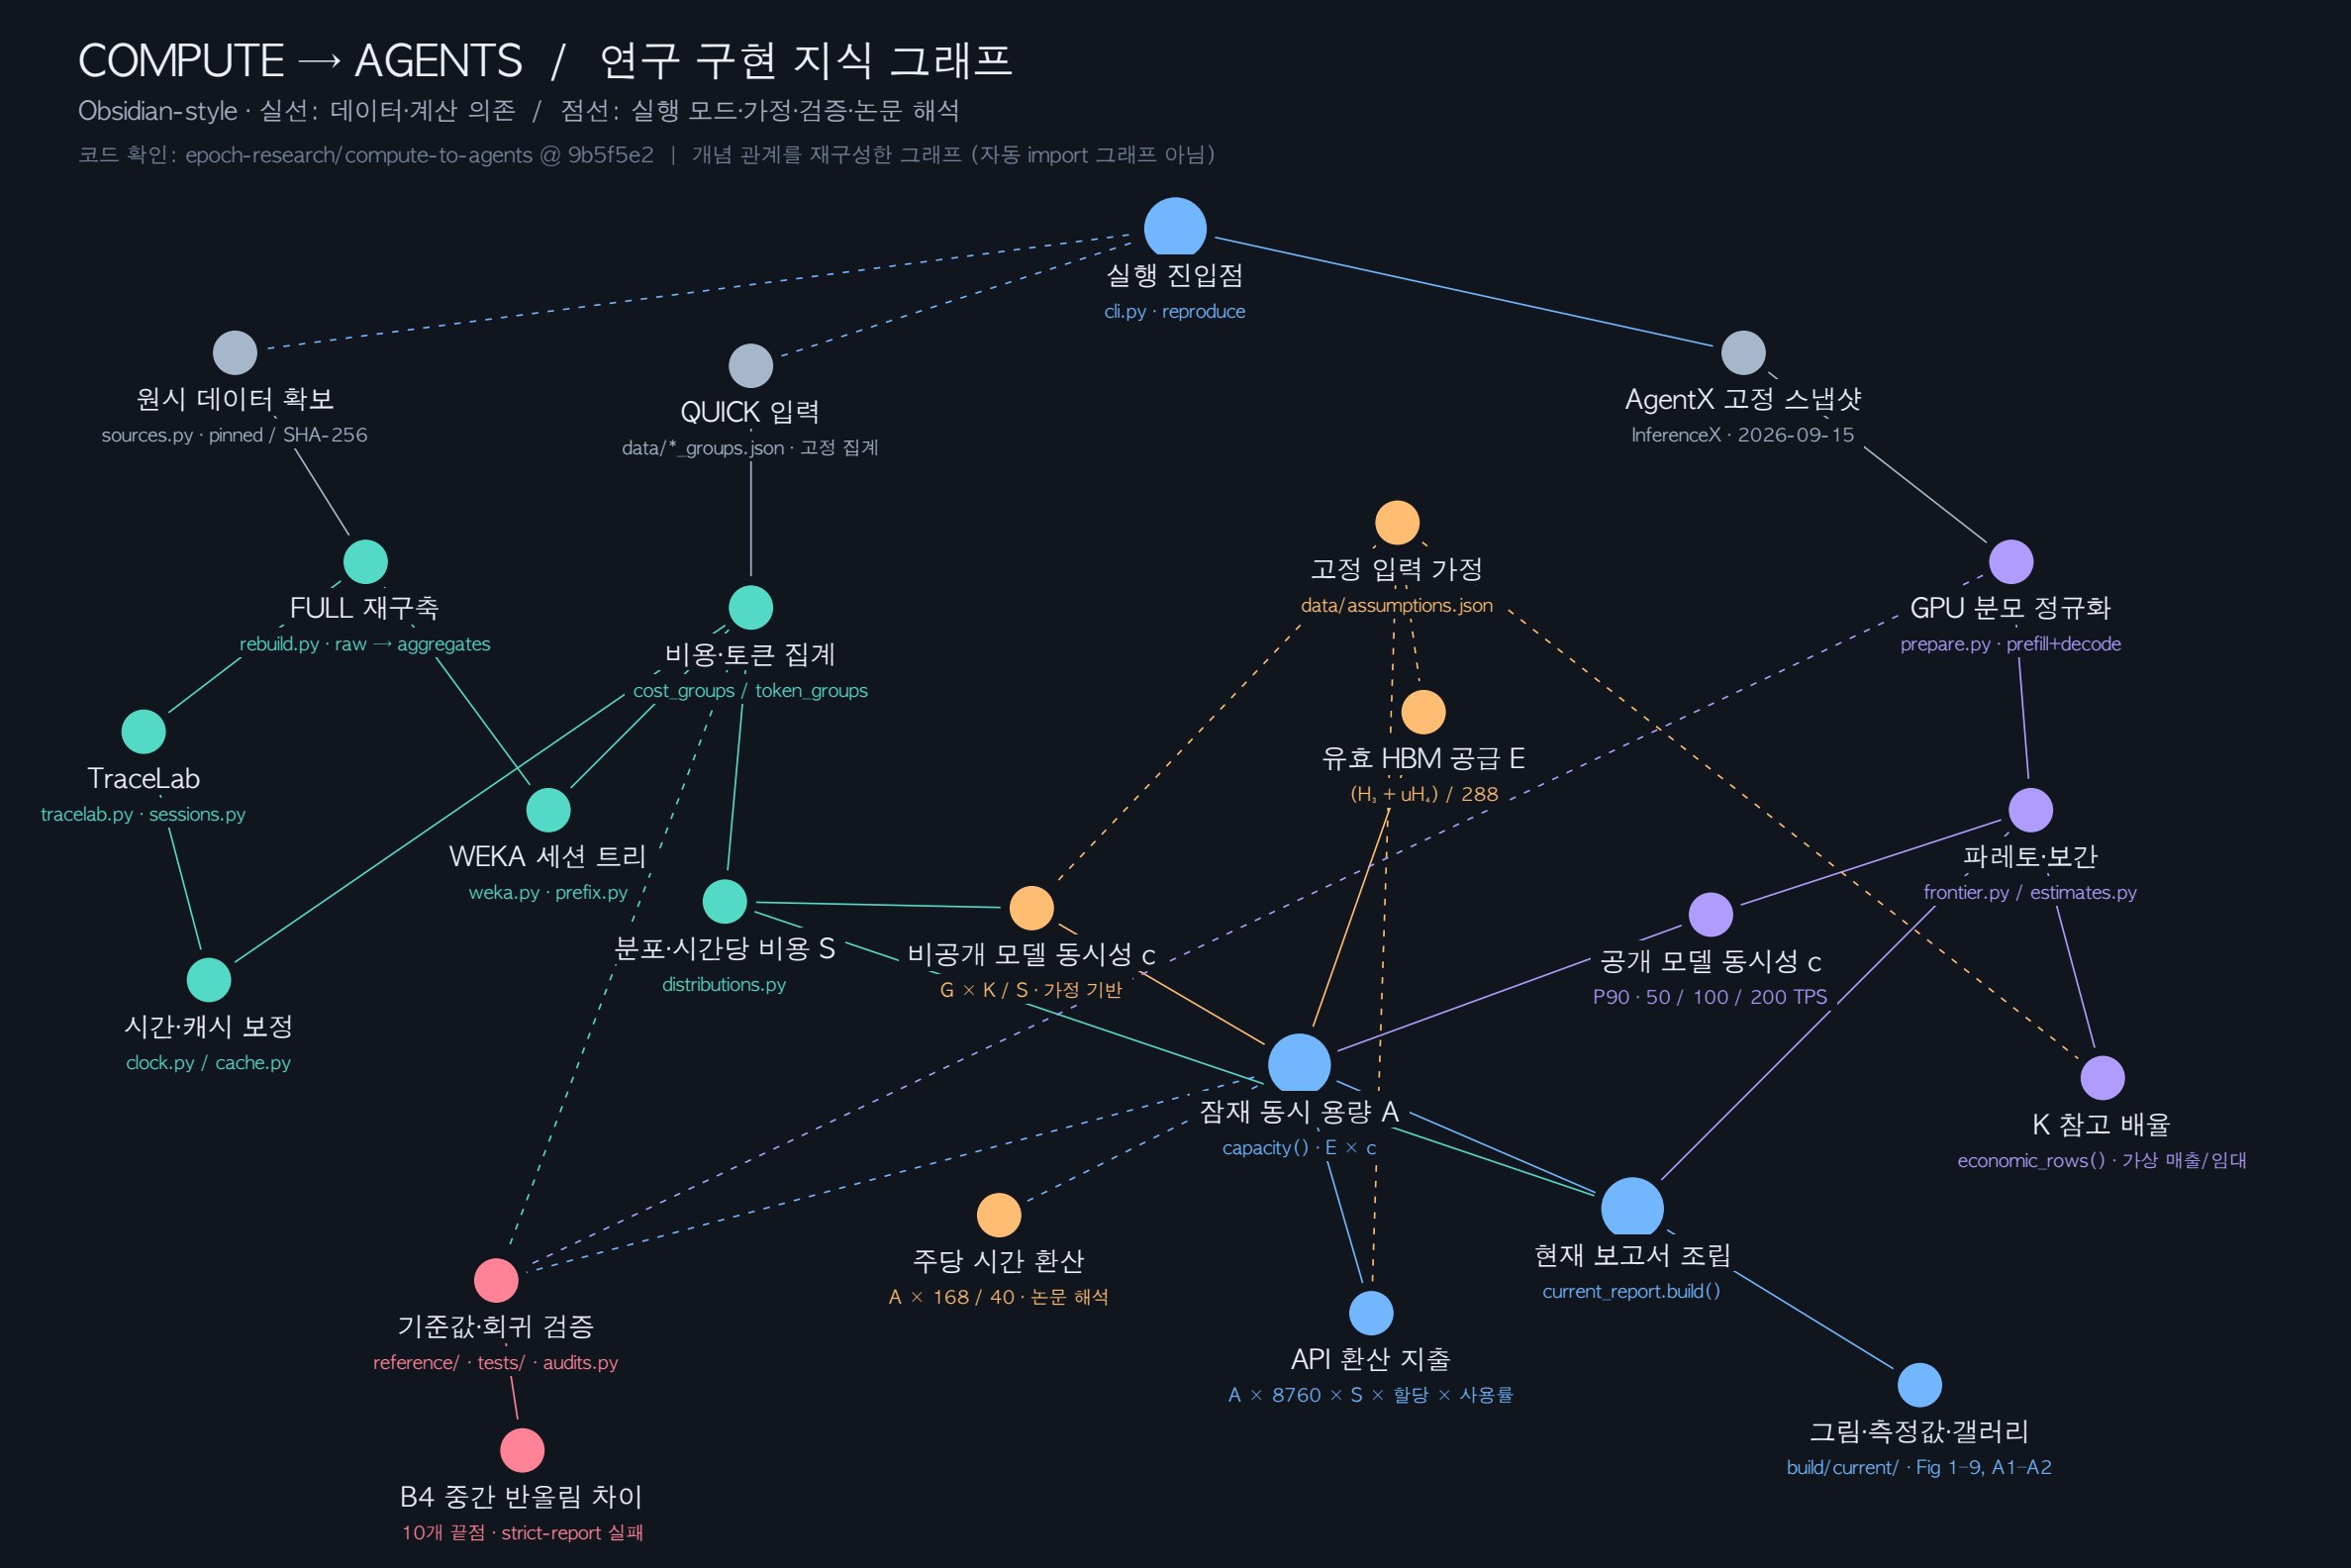
그림과 사용 기록 분석을 재현하기 위한 코드 저장소를 공개합니다.[1]
평가:계산의 추적 가능성을 높이는 요소입니다. 다만 이번 분석에서는 원문의 주요 산식을 재계산했으며, 저장소 전체 실행이나 원시 기록 재분석까지 수행한 것은 아닙니다.
10. 종합 평가 — 강점과 보완할 부분
평가 항목
판단
문제 설정
에이전트 공급 용량을 경제적 수요와 연결한다는 점에서 유용
하드웨어 접근
FLOPS만이 아니라 HBM 용량·대역폭을 고려한 점이 강점
공개 모델 근거
실제 서빙 벤치마크 기반이지만, 합성 재생·특정 워크로드 조건
비공개 모델 근거
사용 기록 기반 비용은 유용하나, 물리적 용량은 가정으로 역산
미래 공급량
출하 전망·세대 비중·성능 향상 가정에 민감
노동시간 환산
계산은 명확하지만 생산성·대체 고용 규모와는 다름
경제적 해석
수요 확대의 필요성을 보여주지만 실제 시장 예측·손익 분석은 아님
범위 표현
신뢰구간이 아닌 시나리오 범위로 읽어야 함
최종 해석
이 글이 보여주는 것은 “수억 명의 노동자를 대체할 AI가 확보된다”가 아닙니다.
보다 정확한 결론은 다음과 같습니다.
예정된 AI 하드웨어 공급은 매우 큰 에이전트 동시 실행 용량을 제공할 수 있다. 그러나 그 용량이 실제 경제적 가치로 전환되려면, 업무 위임의 확대·충분한 품질·지불 의사·배치 인프라가 함께 충족되어야 한다.
따라서 이 연구는 AI 공급 용량의 규모를 이해하는 데 강하지만, 생산성·고용·매출을 직접 예측하는 자료로 사용하기에는 추가 근거가 필요합니다.