https://arxiv.org/pdf/2601.13187
https://www.science.org/doi/10.1126/science.adw3000
2026.1.19
[Scientific production in the era of Large Language Models]
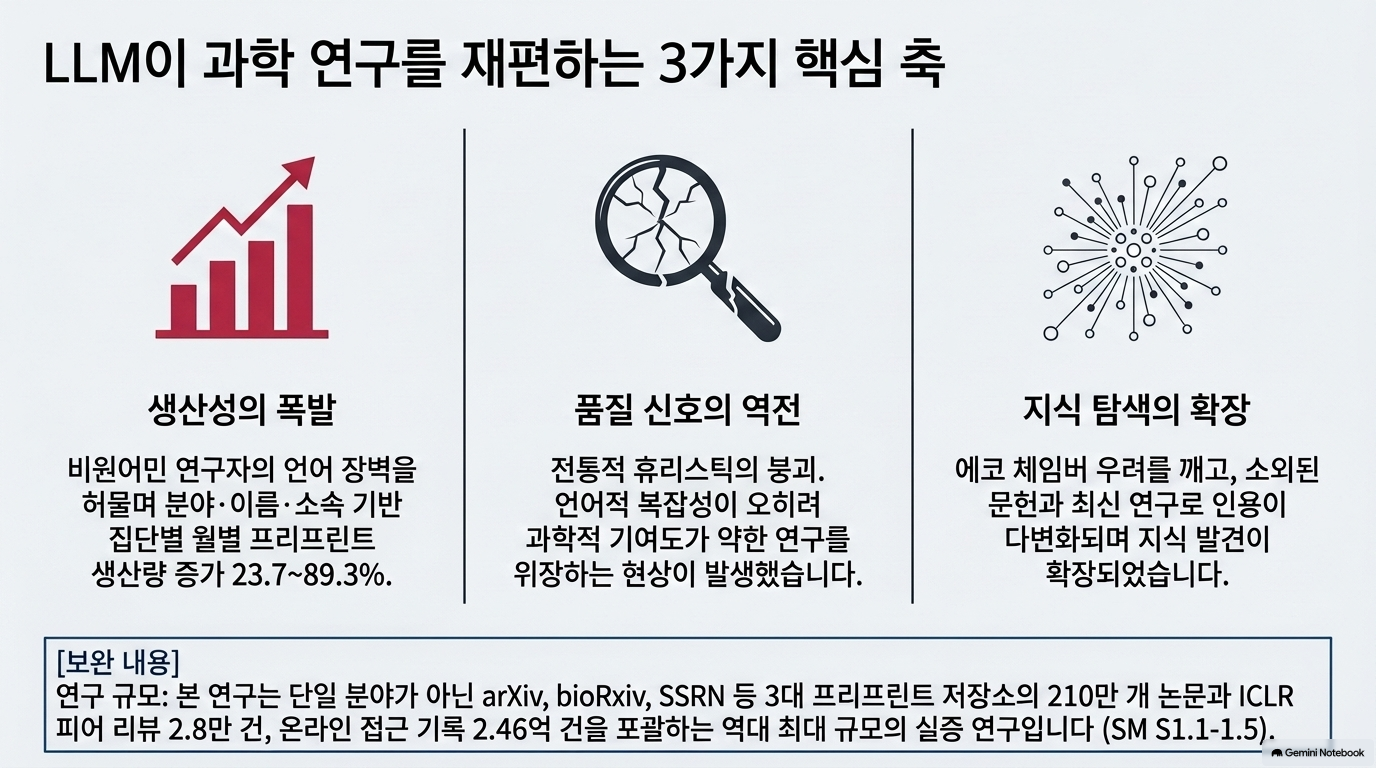
이 연구는 대형 언어 모델(LLM)이 학술 연구 생산성에 미치는 영향을 대규모 데이터셋을 통해 분석하며, 이 기술이 연구 산출물의 양을 크게 증가시키는 동시에 작문 복잡성과 실제 연구 품질 간의 전통적인 상관관계를 뒤집는 현상을 발견했다고 설명합니다. 또한, LLM의 도입은 특히 영어 비원어민 연구자들에게 두드러진 생산성 향상을 가져다주며, 학자들이 더 최신이거나 덜 인용된 문헌 및 도서를 폭넓게 참고하도록 돕는 등 지식 탐색의 지평을 다변화하는 것으로 나타났습니다. 결론적으로 저자들은 이러한 변화가 학계의 평가 방식과 제도적 틀에 근본적인 변화를 요구하며, 향후 과학 정책과 연구 생태계가 표면적인 문장력보다 실질적인 연구 품질을 검증하는 방향으로 진화해야 함을 강조합니다.
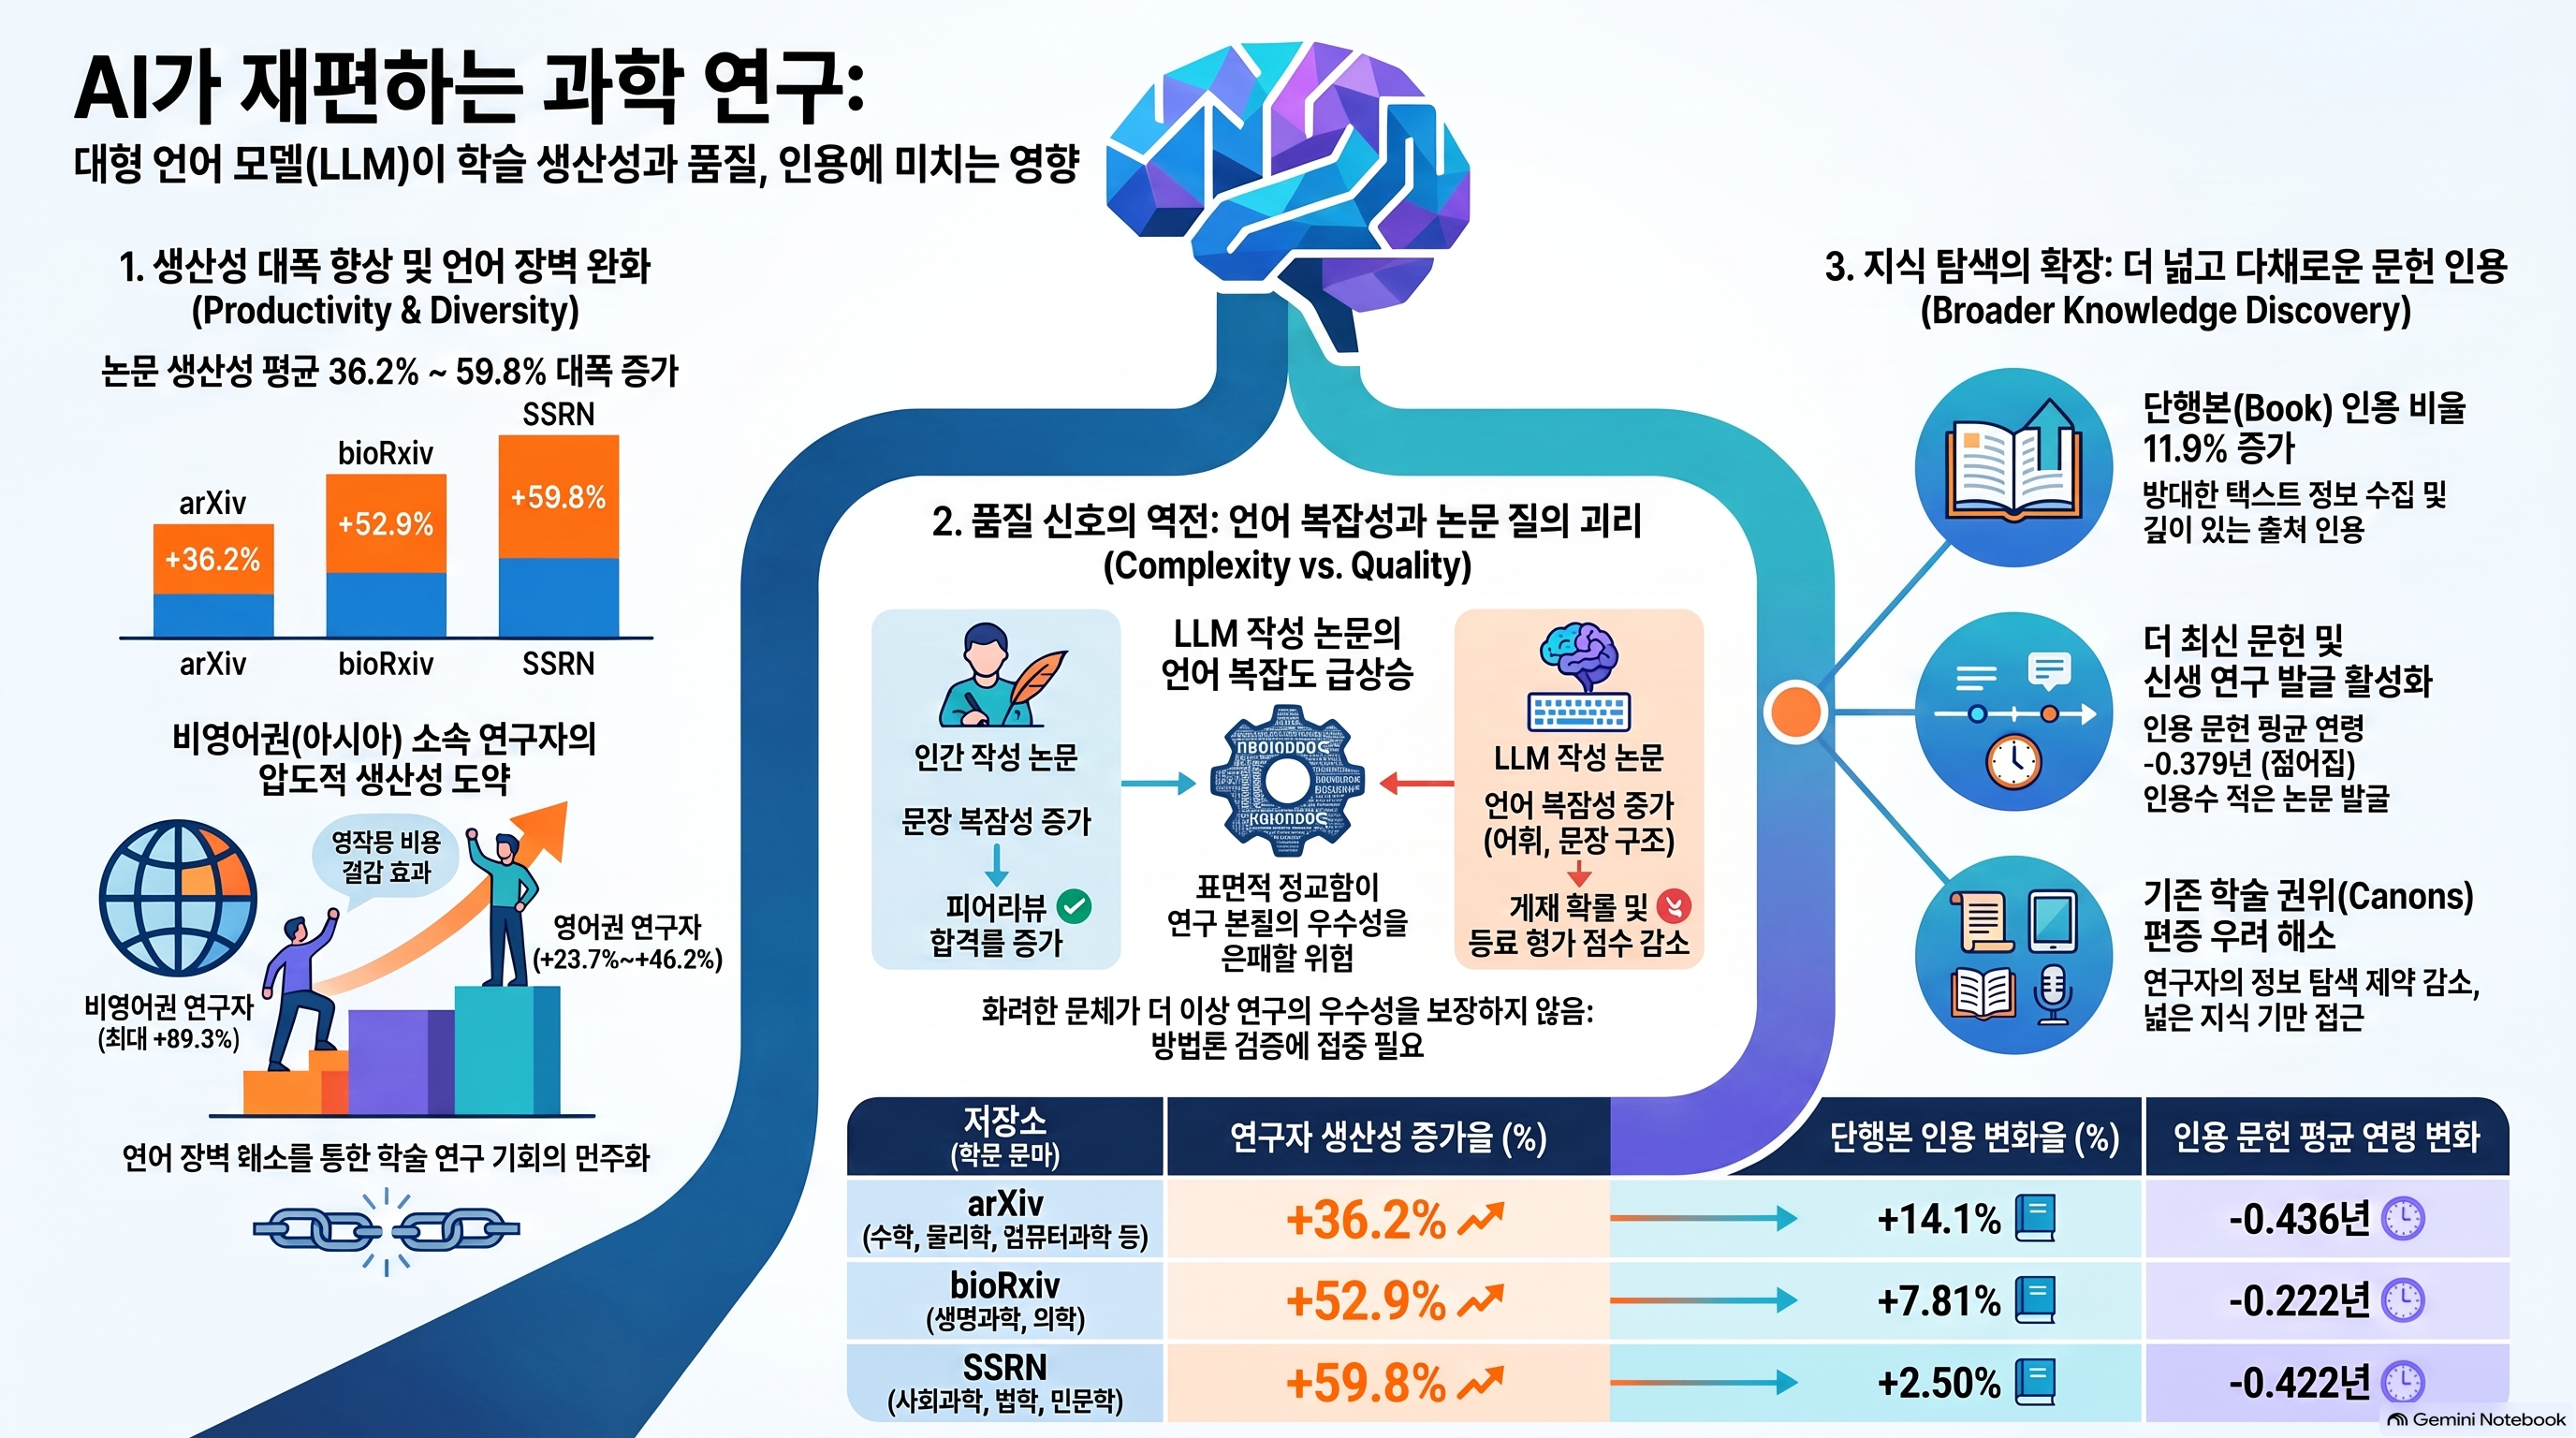
- 이 논문의 핵심은 “LLM이 과학을 더 잘하게 만든다”는 단순한 주장이 아닙니다. 보다 정확하게는, LLM 사용이 논문 생산량·과학적 글쓰기의 평가 신호·문헌 탐색 방식을 동시에 바꾸고 있으며, 이에 따라 연구평가 체계도 바뀌어야 한다는 주장입니다.[1]
| 항목 | 내용 |
| 제목 | Scientific production in the era of Large Language Models |
| 저자 | Keigo Kusumegi, Xinyu Yang, Paul Ginsparg, Mathijs de Vaan, Toby Stuart, Yian Yin |
| 소속 | Cornell University, University of California Berkeley |
| 게재 | Science, 390(6779), pp.1240–1243, 2025 |
| arXiv 버전 | 2601.13187v1, 2026년 1월 19일 제출 |
| 연구 성격 | 대규모 관찰자료를 활용한 과학계량학·연구생산성 분석 |
- 서지정보는 arXiv에서 확인했습니다. 2026년에 arXiv에 올라왔지만, Science 최종판은 2025년 12월 18일에 발표된 연구입니다.[2]
분석 범위
- 아래는 제공하신 14페이지 저자 원고의 실제 절 구성을 따라 분석한 것입니다. 페이지는 Science 편집본이 아니라 제공된 PDF 기준입니다. PDF에서 언급한 별도 보충자료(SM)의 상세 분석·표는 포함되어 있지 않아, 그 부분은 본문에 기술된 범위에서만 평가했습니다. Science 최종판 웹페이지는 접근 차단으로 직접 대조하지 못했습니다.
- 핵심 결과 세 가지
- LLM 사용으로 분류된 연구자는 비사용자로 분류된 연구자보다 논문 생산량 증가가 크게 관찰된다.
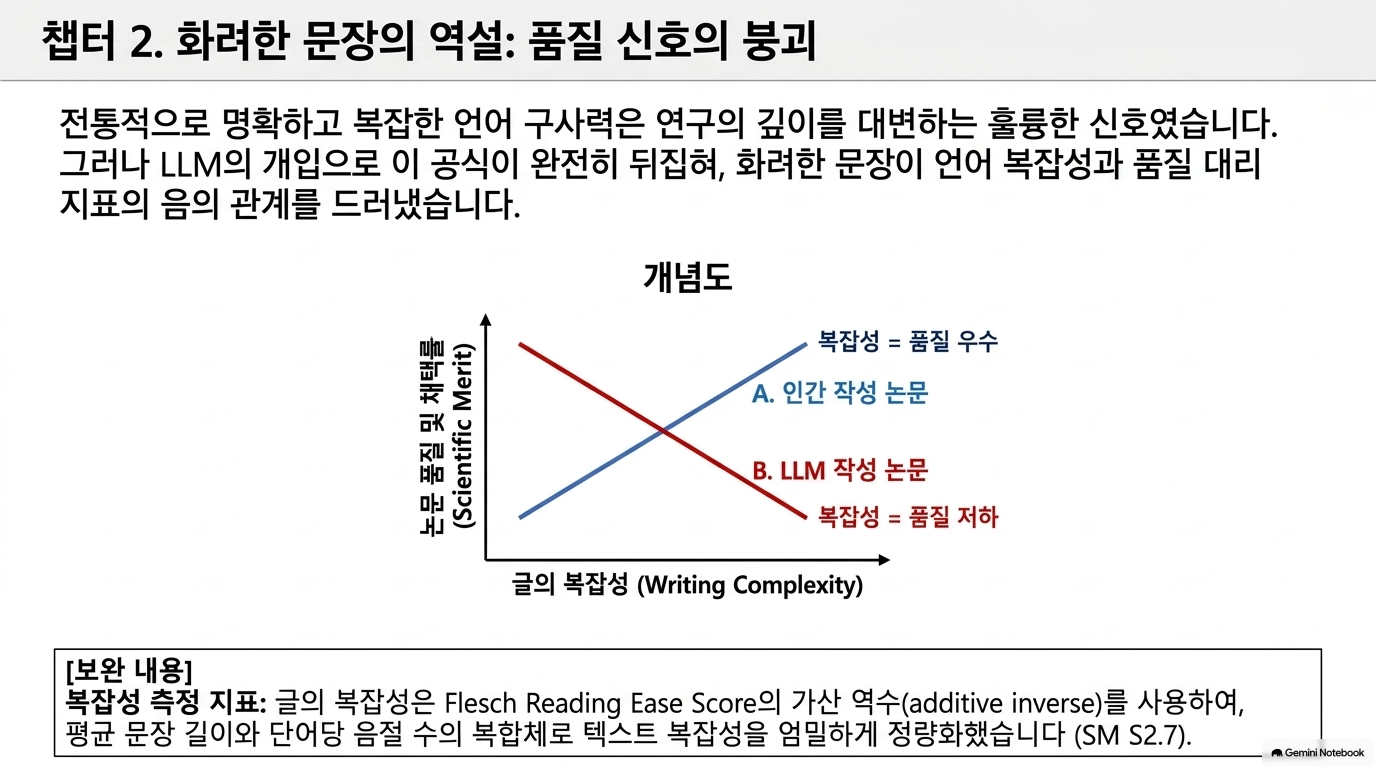
- LLM 보조 논문에서는 언어적 복잡성이 연구의 질을 나타내는 기존 신호로 작동하지 않으며, 오히려 부정적 관계가 나타난다.
- LLM 사용자는 책·더 최근의 연구·피인용이 적은 연구를 더 많이 탐색하고 인용하는 경향을 보인다.[1]
- 단, 저자들은 이 결과에 대해 인과적 식별을 제공하지 못한다고 명시합니다. 따라서 “LLM 때문에 생산성이 증가했다”와 “LLM 사용과 생산량 증가가 연관된다”를 구분해야 합니다.[1, p.7]
2. 서론 — 개별 AI 성공 사례에서 과학 전체의 변화로
원문 위치: p.2, 제목 없는 도입부
2.1 연구 질문
- 기존 AI 연구는 단백질 구조 예측, 신소재 발견 등 특정 과학 과제의 성공을 주로 다뤘습니다. 이 논문은 질문의 수준을 바꿉니다.
- LLM의 확산이 개별 과제뿐 아니라 과학적 지식의 생산·전달·탐색이라는 전체 시스템에 어떤 변화를 일으키는가?[1, p.2]
- 이를 세 가지 관측 대상으로 구체화합니다.
- 생산: 연구자가 얼마나 많은 논문을 내는가?
- 평가: 글쓰기 특성과 연구의 질 사이의 관계가 어떻게 달라지는가?
- 탐색: 어떤 선행연구를 읽고 인용하는가?
2.2 데이터 구성
| 자료 | 규모 | 역할 |
| arXiv | 약 120만 프리프린트 | 수학·물리·컴퓨터과학 등 |
| bioRxiv | 약 22.1만 프리프린트 | 생물학·생명과학 |
| SSRN | 약 67.6만 프리프린트 | 사회과학·법학·인문학 |
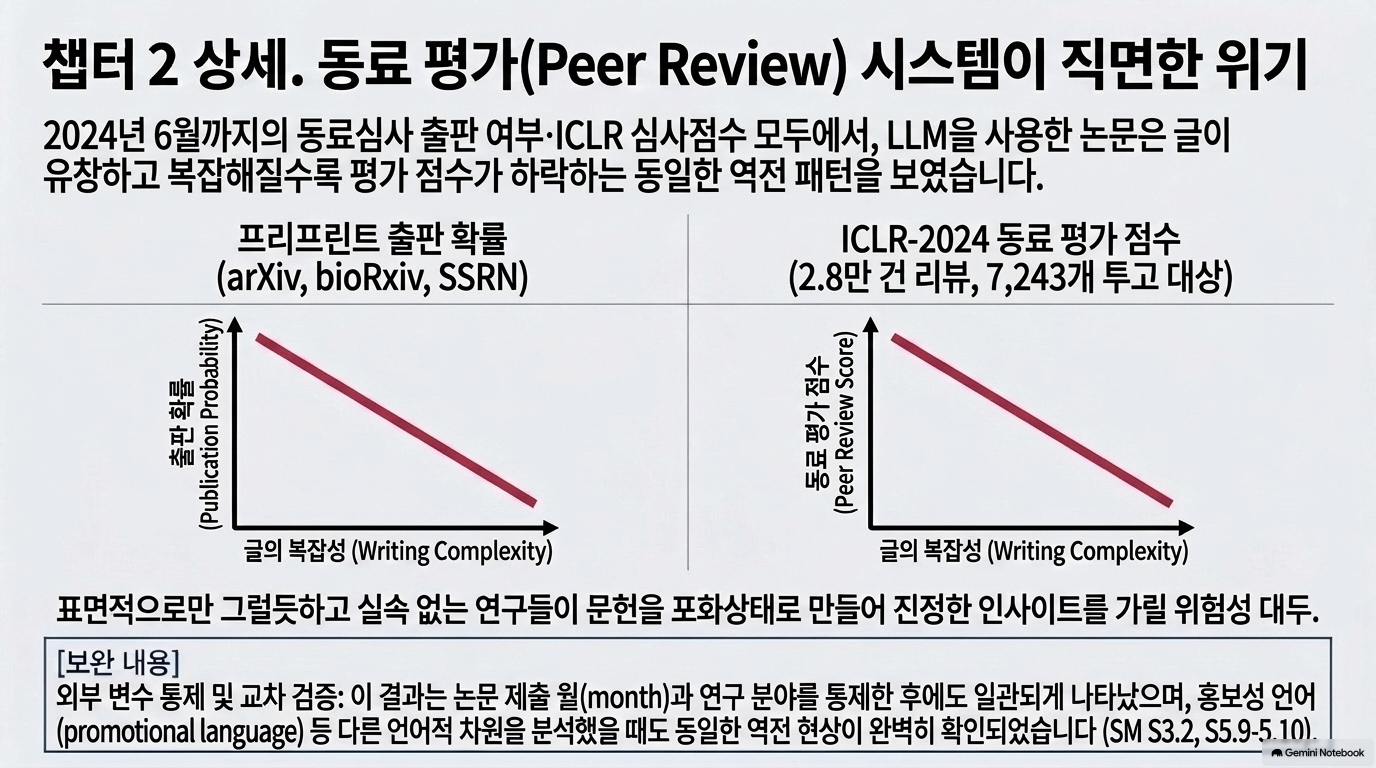
| ICLR 2024 | 7,243개 투고, 약 2.8만 심사보고서 | 심사점수 기반 품질 분석 |
| arXiv 온라인 접근 기록 | 약 2.46억 건 | 문헌 탐색 행동 분석 |
| 선행문헌 인용 연결 | 약 1.016억 건 | 실제 인용 행동 분석 |
- 프리프린트 수집 범위는 2018년 1월부터 2024년 6월이며, 분석별 표본과 관측 기간은 다릅니다.[1, pp.2, 5–6]
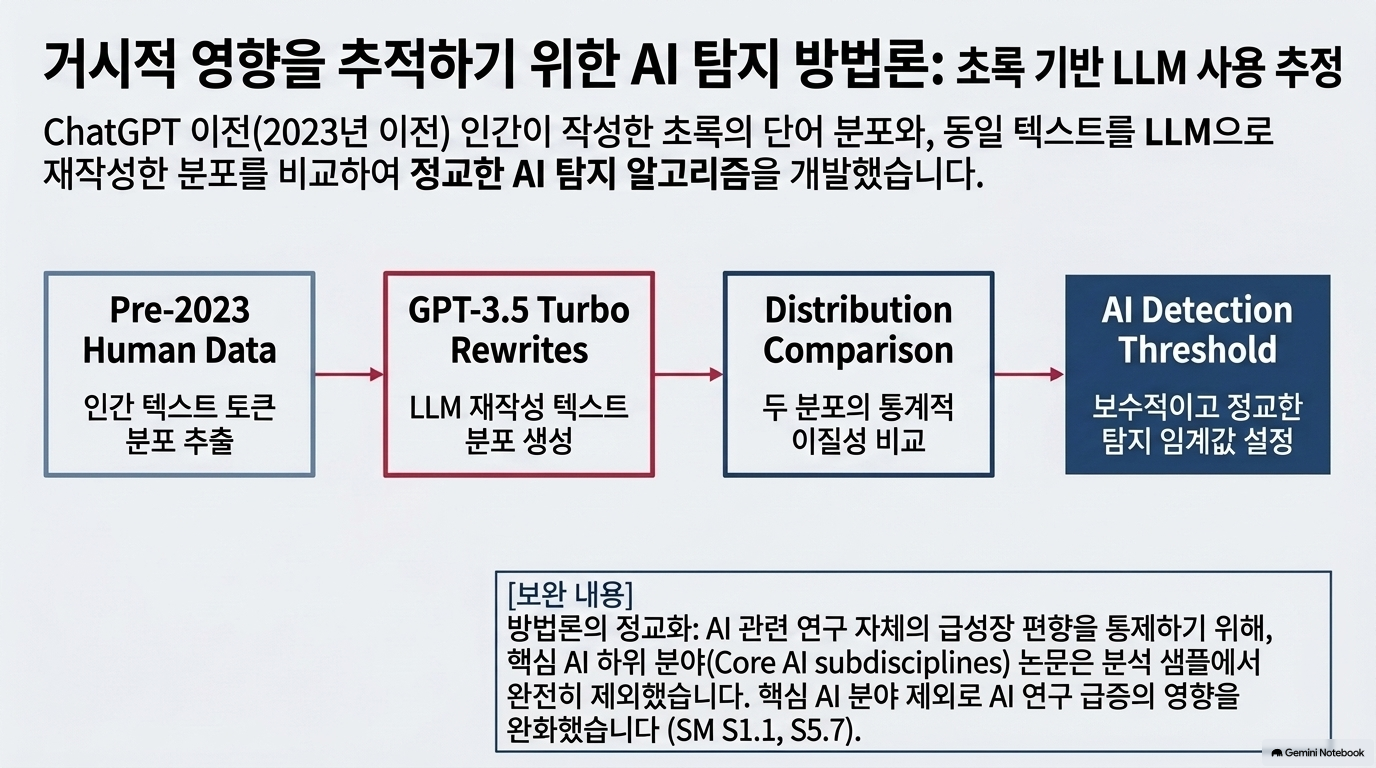
2.3 LLM 사용을 어떻게 측정했는가?
- 연구자가 직접 신고한 사용 이력이 아니라 초록의 단어 분포를 이용한 통계적 탐지입니다.
- 2023년 이전 초록에서 인간 작성 텍스트의 단어 분포를 추정합니다.
- GPT-3.5-turbo-0125로 해당 초록을 다시 작성하게 합니다.
- 인간 텍스트와 LLM 재작성 텍스트의 분포 차이를 비교합니다.
- 이후 초록에서 LLM 보조 작성의 통계적 흔적을 추정합니다.[1, p.2]
- 분석적 평가: 대규모 자료에 적용하기 좋은 설계지만, 측정 대상은 엄밀히 말해 “실제 LLM 사용 전체”가 아니라 “초록에 남아 있는 특정 LLM 문체의 흔적”입니다. 코딩·통계분석·아이디어 구상에만 LLM을 썼거나, 생성 문장을 대폭 수정한 연구자는 탐지되지 않을 수 있습니다.
- 따라서 이하의 “비사용자”도 실제로 사용하지 않은 사람이라기보다 사용 흔적이 탐지되지 않은 사람으로 읽는 편이 정확합니다.
3. 결과 ① — LLM 사용과 과학적 생산성
원문 절: “LLM usage and scientific productivity” / pp.2–3, Fig.1–2
3.1 분석 설계
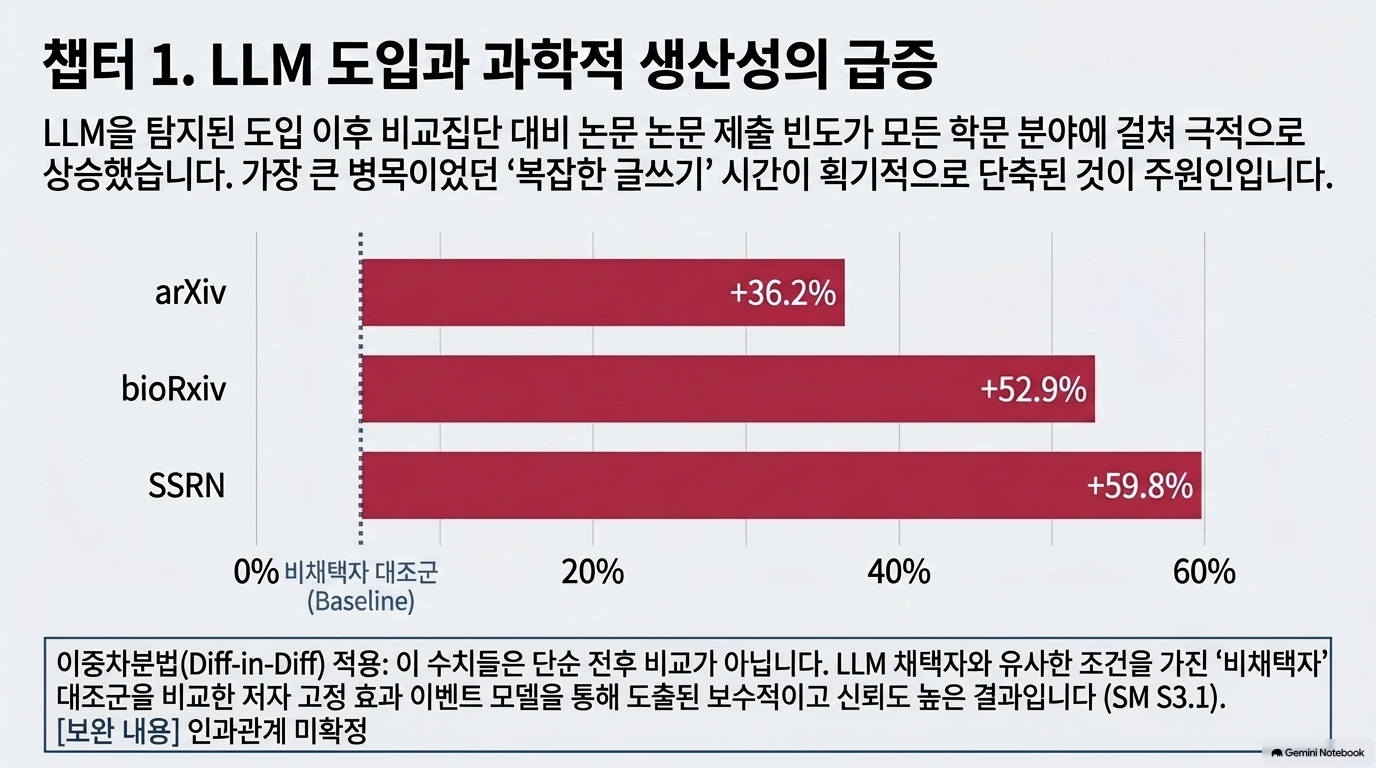
- 저자들은 AI 연구 자체의 급성장이 결과를 설명하지 않도록 핵심 AI 하위 분야의 원고를 제외합니다. 이후 처음으로 LLM 보조 작성이 탐지된 원고를 기준으로 저자의 도입 시점을 정하고, 도입 전후 월별 프리프린트 제출량을 유사한 비도입 연구자와 비교합니다.[1, pp.2–3]
- 주요 설계는 저자 고정효과를 포함한 이벤트 연구와 stacked difference-in-differences입니다. Fig.1은 총 168,553명의 저자를 분석 대상으로 제시합니다.[1, p.11]
3.2 주요 결과
| 저장소 | LLM 도입과 연관된 생산량 증가 추정 |
| arXiv | 36.2% |
| bioRxiv | 52.9% |
| SSRN | 59.8% |
- 탐지 방법과 판정 임계값을 바꾸면 추정치는 달라지지만, 양의 연관성은 유지된다고 보고합니다.[1, pp.3, 11]
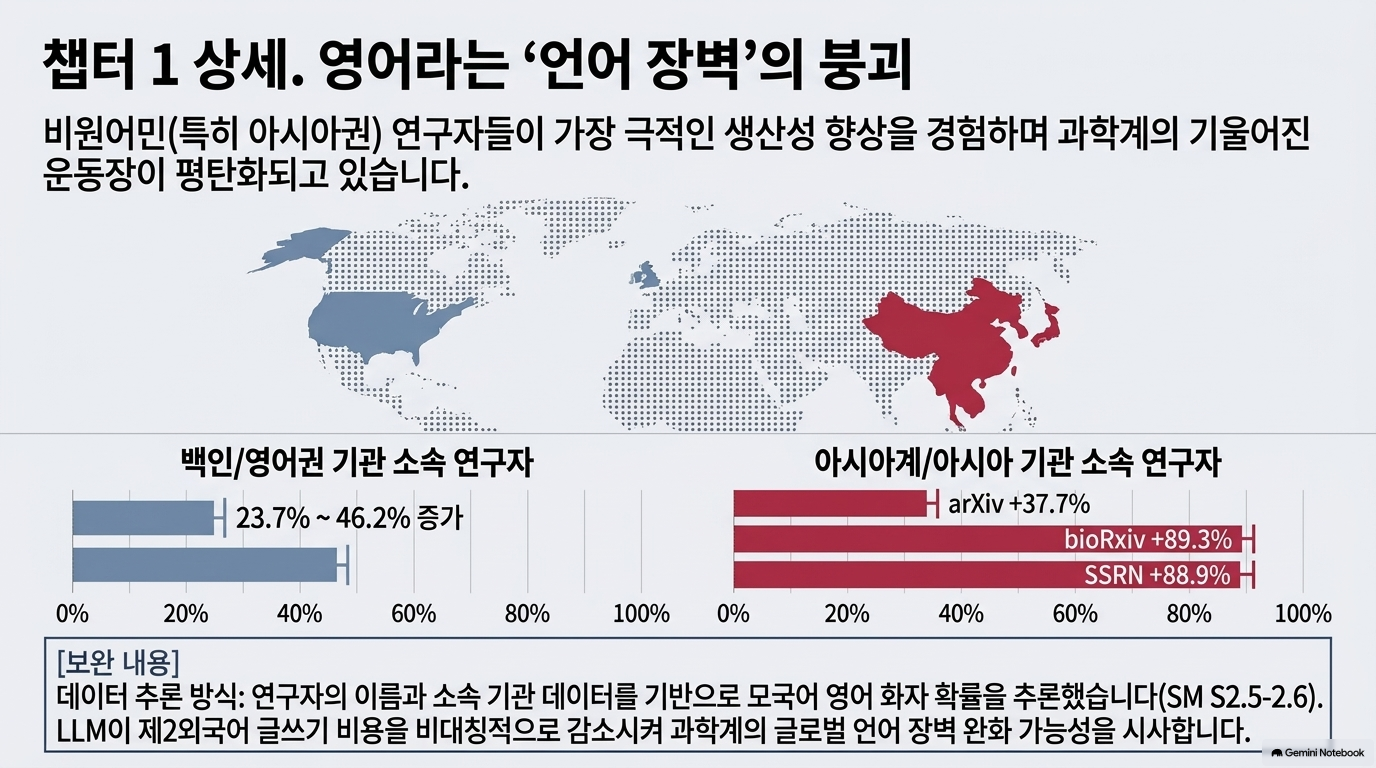
3.3 언어적 장벽에 따른 차이
- 저자들은 LLM이 특히 영어 논문 작성 비용이 높은 연구자에게 도움이 될 것이라고 가정합니다. 이를 이름과 소속기관 국가를 이용해 간접적으로 분석합니다.[1, p.3]
- Fig.2의 설명에 제시된 비교는 다음과 같습니다.
| 집단 — 이름·소속 기반 추정 | arXiv | bioRxiv | SSRN |
| 아시아계 이름·아시아 기관 소속 | 37.7% | 89.3% | 88.9% |
| Caucasian 이름·영어권 기관 소속 | 23.7% | 40.0% | 46.2% |
- 다만 아시아계 연구자의 아시아 기관 소속과 영어권 기관 소속 간 차이는 bioRxiv에서만 통계적으로 유의했다고 본문은 설명합니다.[1, pp.3, 12]
3.4 의미와 한계
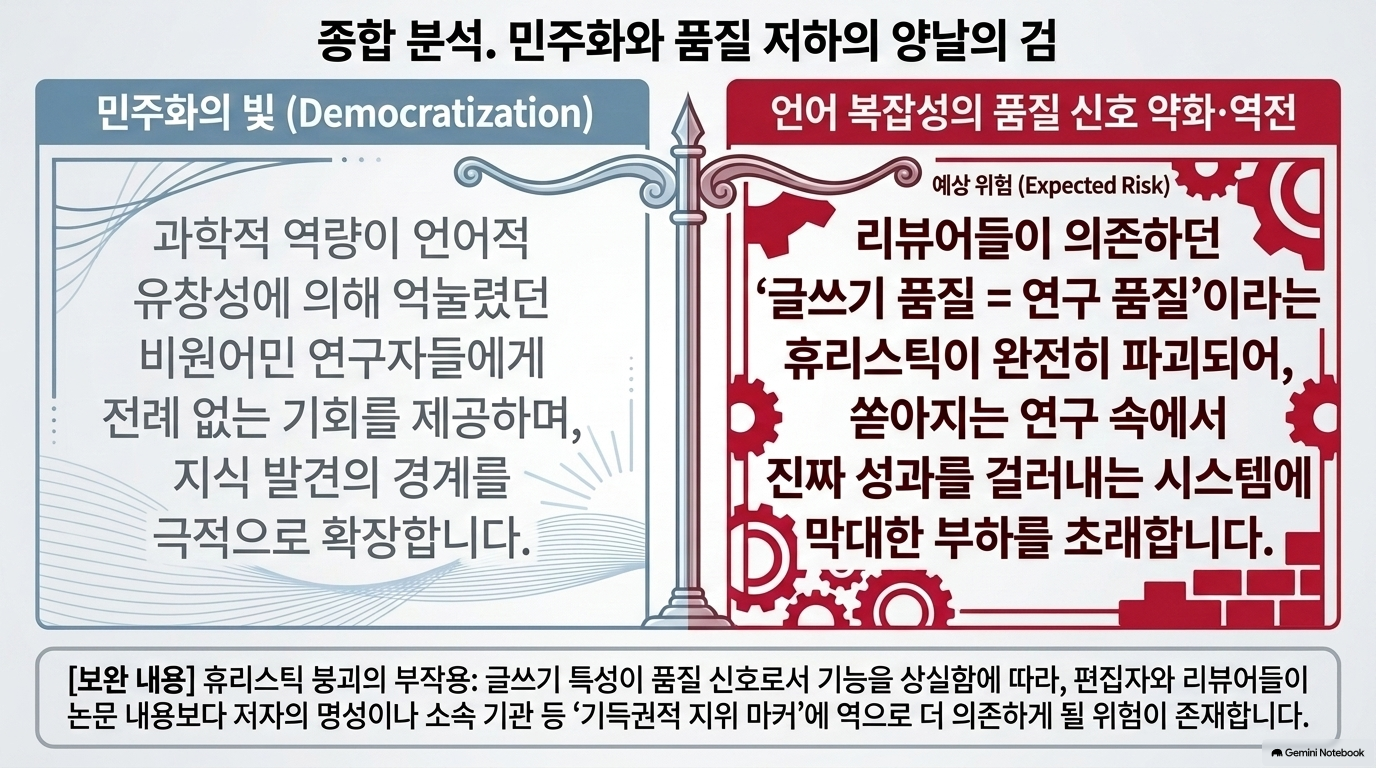
- 의미: 논문 작성에 필요한 언어적 비용이 낮아지면, 연구 역량이 있어도 영어 표현 때문에 불리했던 집단의 참여 장벽이 완화될 수 있습니다.
- 그러나 이 연구에서 생산성은 “월별 프리프린트 수”입니다. 다음은 직접 측정하지 않았습니다.
- 투입 노동시간 대비 성과
- 독창적 발견의 수
- 재현 가능성
- 논문당 실질적 기여
- 연구비 대비 효과
- 따라서 논문 생산량 증가를 과학적 가치 증가와 동일시해서는 안 됩니다.
- 또한 이름·기관은 모국어 능력의 직접 측정값이 아닙니다. 결과는 언어 장벽 완화 가설과 부합하지만, 그 메커니즘을 확정하지는 못합니다.
- [확인 필요: 원문 수치 불일치] 본문 p.3은 아시아계 이름·아시아 기관 집단의 arXiv 수치를 43.0%로 서술하지만, Fig.2 설명 p.12는 37.7%로 제시합니다. 같은 그림 설명에서 43.0%는 동아시아계 이름 집단 전체의 값입니다. 두 집단을 구분해 인용해야 합니다.[1]
4. 결과 ② — 과학적 글쓰기와 출판 성과
원문 절: “LLM use, scientific writing, and publication outcomes” / pp.4–5, Fig.3
4.1 핵심 질문
- 이 절은 논문의 가장 중요한 평가체계 논점입니다.
- 매끄럽고 복잡한 과학적 문장이 연구의 질을 보여주는가, 아니면 연구의 약점을 가리는가?[1, p.4]
- 전통적으로 정교한 글쓰기는 주제에 대한 이해와 연구자의 노력에 관한 불완전한 신호였습니다. LLM이 이를 낮은 비용으로 만들어낼 수 있다면, 그 신호의 가치도 달라질 수 있다는 논리입니다.
4.2 측정 방법
| 개념 | 실제 측정 |
| 글쓰기 복잡성 | Flesch Reading Ease 점수의 부호를 반전한 값 |
| 구성 요소 | 평균 문장 길이, 단어당 음절 수 |
| 프리프린트의 품질 대리지표 | 2024년 6월까지 동료심사 저널·학회에 출판되었는지 |
| ICLR의 품질 대리지표 | 전문가 심사점수 |
- 프리프린트 분석은 로지스틱 회귀, ICLR 심사점수 분석은 OLS 회귀를 사용합니다.[1, pp.4, 13]
4.3 발견한 세 가지 패턴
| 관측 대상 | 결과 |
| 글쓰기 복잡성 분포 | LLM 보조 원고가 더 복잡함 |
| 비LLM 분류 원고 | 복잡성이 높을수록 출판 가능성이 높음 |
| LLM 보조 분류 원고 | 복잡성이 높을수록 출판 가능성·심사점수가 낮음 |
- 저자들은 어휘적 복잡성, 형태적 복잡성, 홍보성 언어 등에서도 유사한 패턴을 확인했다고 보고합니다.[1, pp.4–5, 13]
4.4 어떻게 해석해야 하는가?
- 이 결과를 “AI로 쓴 논문은 모두 질이 낮다”로 읽으면 잘못입니다.
- 실제 핵심은 다음과 같습니다.
- LLM 보조 작성 집단 안에서는 문장의 복잡성을 연구 품질의 긍정적 신호로 사용할 수 없으며, 관측된 관계는 오히려 반대 방향이다.
- 또한 Flesch 기반 복잡성은 논리적 엄밀성·설명의 명료성·과학적 정확성과 다릅니다. 긴 문장과 음절이 많은 단어가 많다는 사실이 곧 좋은 글이라는 뜻은 아닙니다.
- 분석적 해석: 이 연구는 과학적 글쓰기의 가치가 없어졌다는 것이 아니라, 표현의 외형을 생산하는 비용이 낮아지면서 외형만으로 연구자의 이해 수준을 추론하기 어려워졌다는 문제를 드러냅니다.
4.5 평가체계에 대한 함의
- 저자들은 문체라는 빠른 평가 신호가 약해지면, 심사자가 저자 명성이나 소속기관 같은 지위 신호에 더 의존할 위험을 지적합니다. 이는 LLM의 참여 장벽 완화 효과를 상쇄할 수 있습니다.[1, p.5]
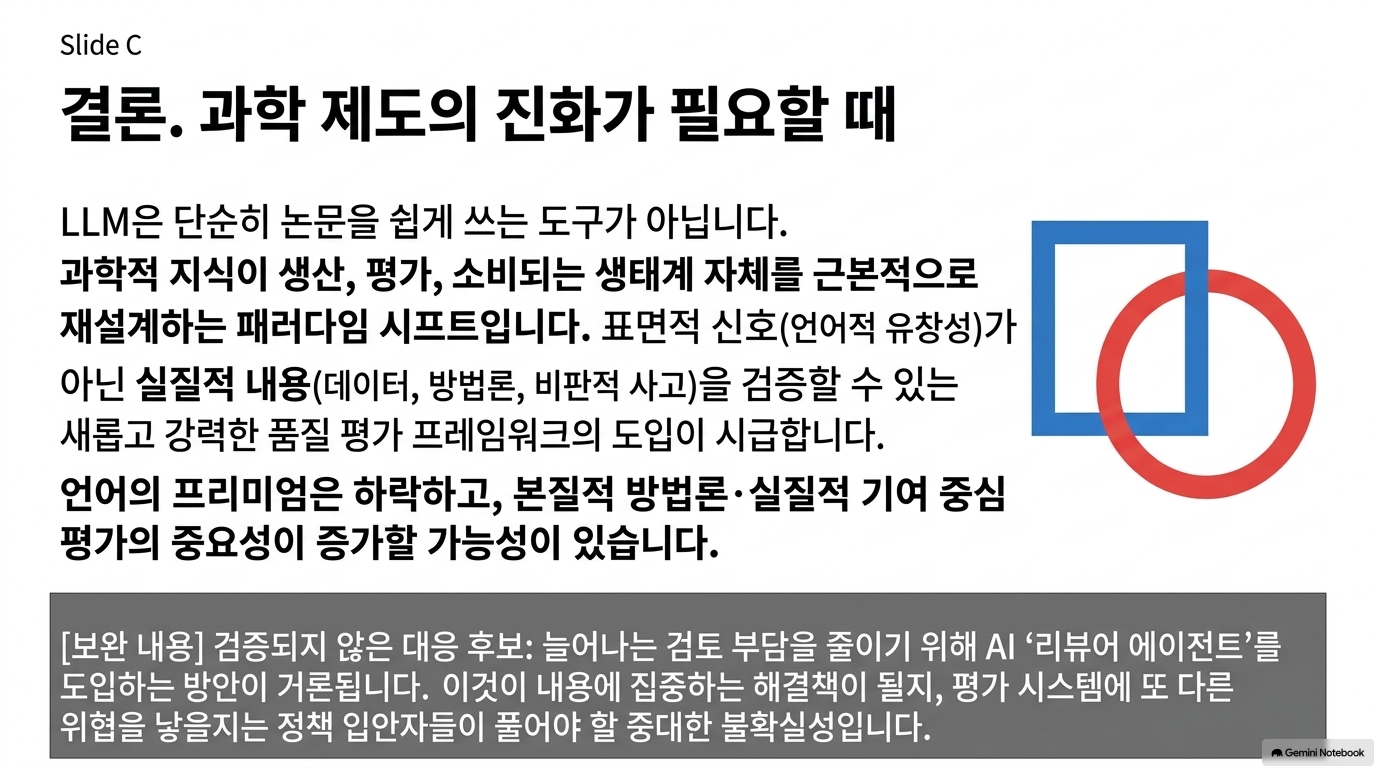
- 또한 방법론 불일치·주장 검증·신규성 검토를 지원하는 reviewer agent를 가능한 대응으로 제안하지만, 그 효과와 부작용은 불확실하다고 명시합니다.[1, p.5]
- 실무 권고 — 본 분석의 제안
- 연구·보고서 평가에서는 다음을 별도로 확인하는 편이 타당합니다.
- 주장과 원자료 사이의 연결
- 연구설계와 결론의 정합성
- 통계적·실질적 유의성
- 코드·데이터·절차의 재현 가능성
- 선행연구 대비 실제 기여
- 한계와 반례의 명시
4.6 품질 지표의 한계
- 출판 여부와 심사점수는 유용하지만 과학적 진실이나 장기적 가치 자체는 아닙니다.
- 특히 2023년 이후 프리프린트를 2024년 6월 시점의 출판 여부로 평가하면, 아직 심사 중인 좋은 논문도 미출판으로 분류될 수 있습니다. 저자들은 월·분야 통제 등을 실시했다고 설명하지만, 모든 교란요인을 배제하지는 못한다고 인정합니다.[1, p.4]
- [확인 필요: 표본 수] Fig.3 설명은 전체 원고를 264,125개로 제시하지만, 같은 설명에 나열된 네 구성 표본을 도구로 합산하면 276,040개입니다. 본문 PDF만으로 이 차이의 원인을 판단할 수 없으므로, 전체 표본 수는 보충자료 또는 최종판에서 재확인이 필요합니다.[1, p.13]
5. 결과 ③ — 문헌 탐색과 인용 행동
원문 절: “LLM use and Citation Behavior” / pp.5–6, Fig.4
5.1 상반된 가설
- 저자들은 두 가능성을 비교합니다.
- 탐색 확장: LLM이 연구자의 시간·주의력 제약을 줄여 다양한 문헌을 발견하게 한다.
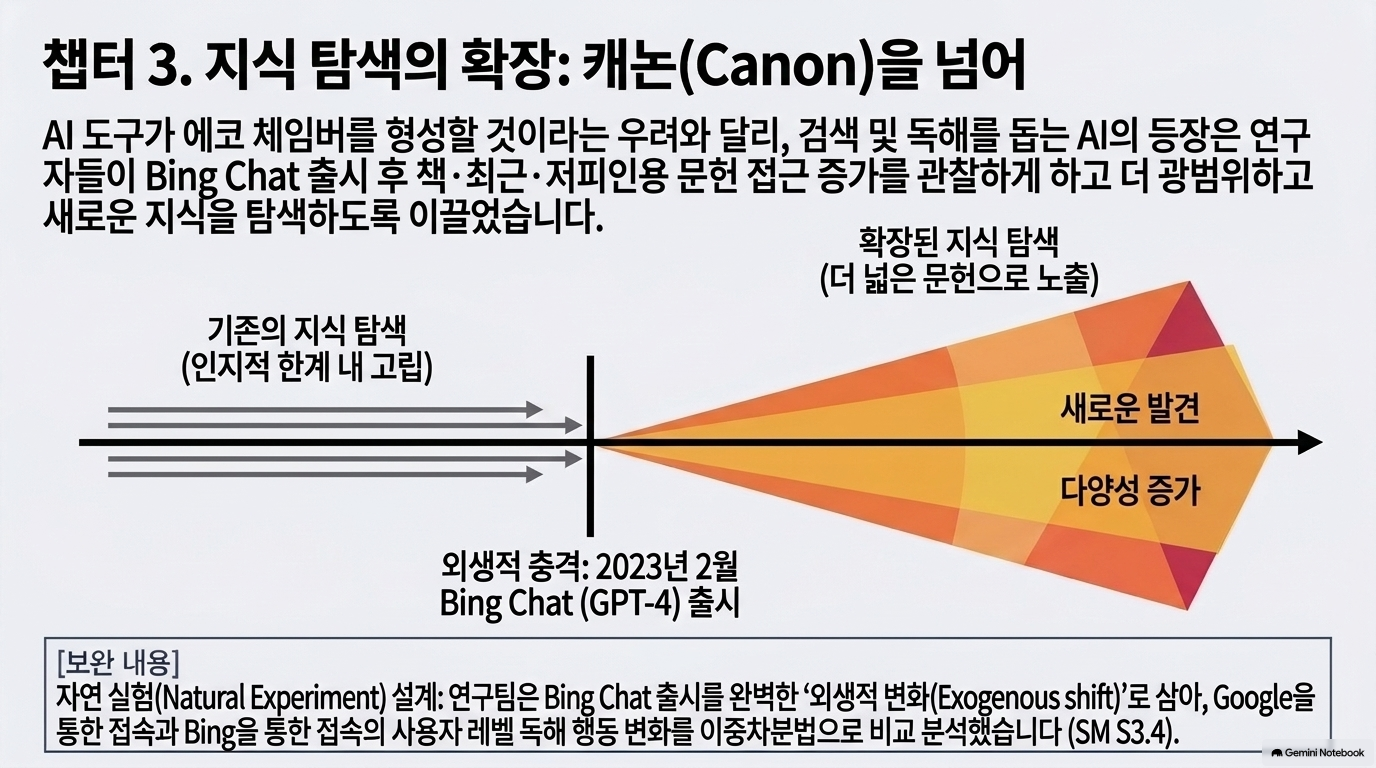
- 집중 강화: 학습자료에서 유명한 연구가 과대표집되어, 이미 잘 알려진 논문에 관심이 더 집중된다.[1, p.5]
5.2 온라인 탐색 분석
- 2023년 2월 Bing Chat 출시 전후의 arXiv 접근 기록을 사용해, Bing에서 유입된 접근과 Google에서 유입된 접근의 변화를 비교합니다.[1, pp.5–6]
| 지표 | 보고된 변화 |
| 책에 대한 접근 | 26.3% 증가 |
| 접근 문헌의 중앙 연령 | 0.18년 감소 |
| 접근 문헌의 기존 피인용 수준 | 더 낮은 피인용 문헌 쪽으로 이동 |
- 이는 AI 기반 검색 도입 이후 Bing 유입의 탐색 구성이 달라졌다는 결과입니다.[1, p.6]
- 주의: Bing 유입 기록이 모든 방문자의 실제 Bing Chat 사용을 직접 증명하는 것은 아닙니다. 출시를 기준으로 한 비교 설계와 개별 사용 여부 확인은 구분해야 합니다.
5.3 실제 인용 행동 분석
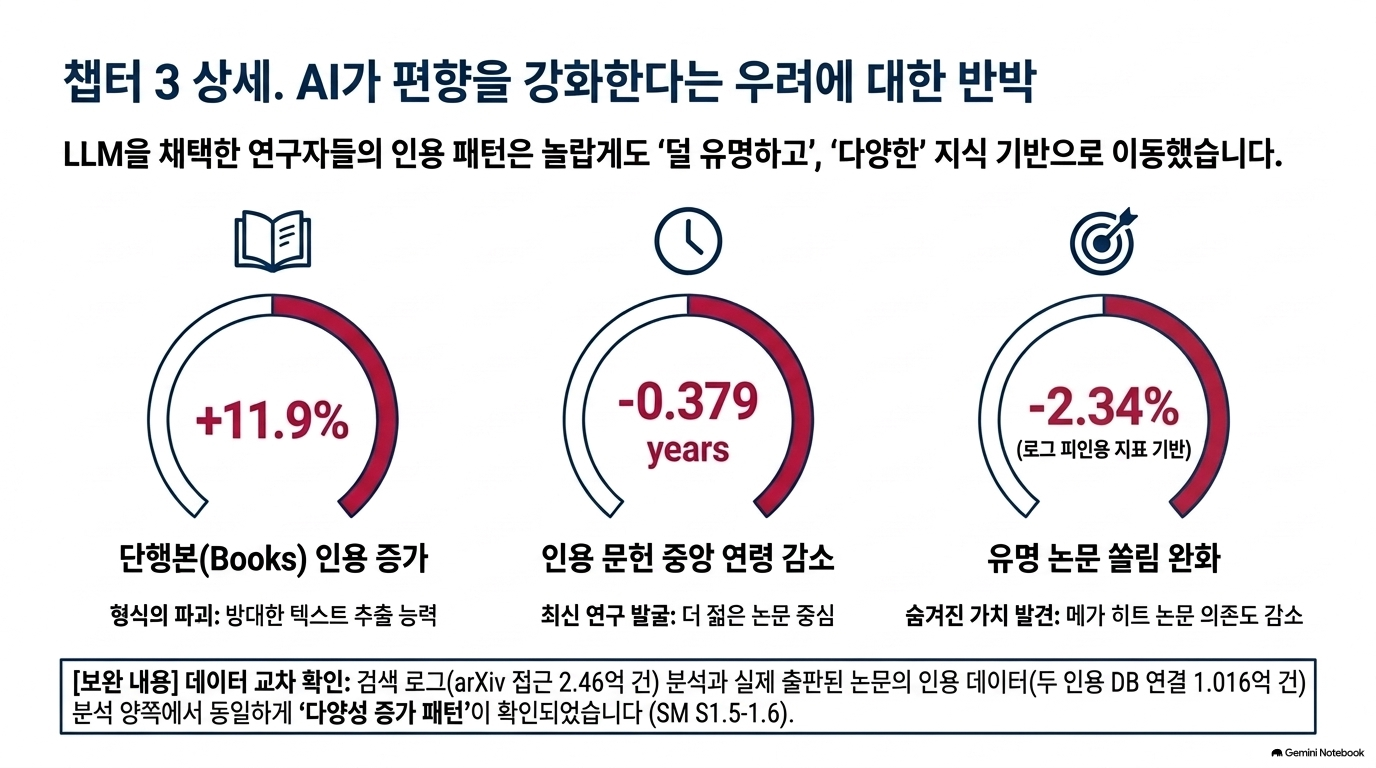
- 탐색 변화가 논문 참고문헌에도 나타나는지 확인하기 위해 OpenAlex·Semantic Scholar와 프리프린트를 연결했습니다.[1, p.6]
| 지표 | 전체 결과 |
| 책 인용 | 11.9% 증가 |
| 참고문헌의 중앙 연령 | 0.379년 감소 |
| 참고문헌의 피인용 수준 | 저자가 2.34% 감소로 보고 |
- 마지막 지표는 단순 피인용 수 평균이 아니라 참고문헌별 log(피인용 수+1)의 평균에 기반한 지표이므로, “원시 인용 횟수가 정확히 2.34% 줄었다”로 해석하면 안 됩니다.[1, pp.6, 14]
- 저장소별 책 인용 결과는 다음과 같습니다.
| 저장소 | 책 인용 변화 | 통계적 유의성 |
| arXiv | +14.1% | 유의 |
| bioRxiv | +7.81% | 유의 |
| SSRN | +2.50% | 유의하지 않음, P=0.605 |
- SSRN에서는 참고문헌 피인용 수준 감소도 유의하지 않았습니다.[1, p.14]
5.4 무엇이 입증되었고, 무엇은 아닌가?
- 뒷받침되는 해석: 관측된 자료에서는 LLM 사용과 관련해 참고문헌의 형식·연령·기존 인용 수준이 달라지며, 유명 문헌으로의 집중이 일률적으로 강화되지는 않습니다.
- 입증되지 않은 확장 해석:
- 모든 LLM 검색이 편향을 줄인다.
- 인용 문헌의 정확성·관련성이 향상되었다.
- 학제 간 다양성이 증가했다.
- 최신 연구를 인용하면 연구 품질이 높아진다.
- 논문의 “다양성”은 주로 책·문헌 연령·피인용 수준이라는 관측 차원에 기반합니다. 주제·국가·학파·방법론의 다양성을 포괄적으로 측정한 것은 아닙니다.
- 실무적 의미: LLM 문헌 탐색은 발견 단계의 보조수단으로 활용하되, 문헌 존재 → 원문 확인 → 주장과의 관련성 → 인용 정확성 검증을 분리해야 합니다. 이 절은 탐색 확장을 보여주지만 인용 검증을 대체할 근거는 제공하지 않습니다.
6. 한계와 후속 연구
원문 절: “Limitations and Future Directions” / pp.6–7
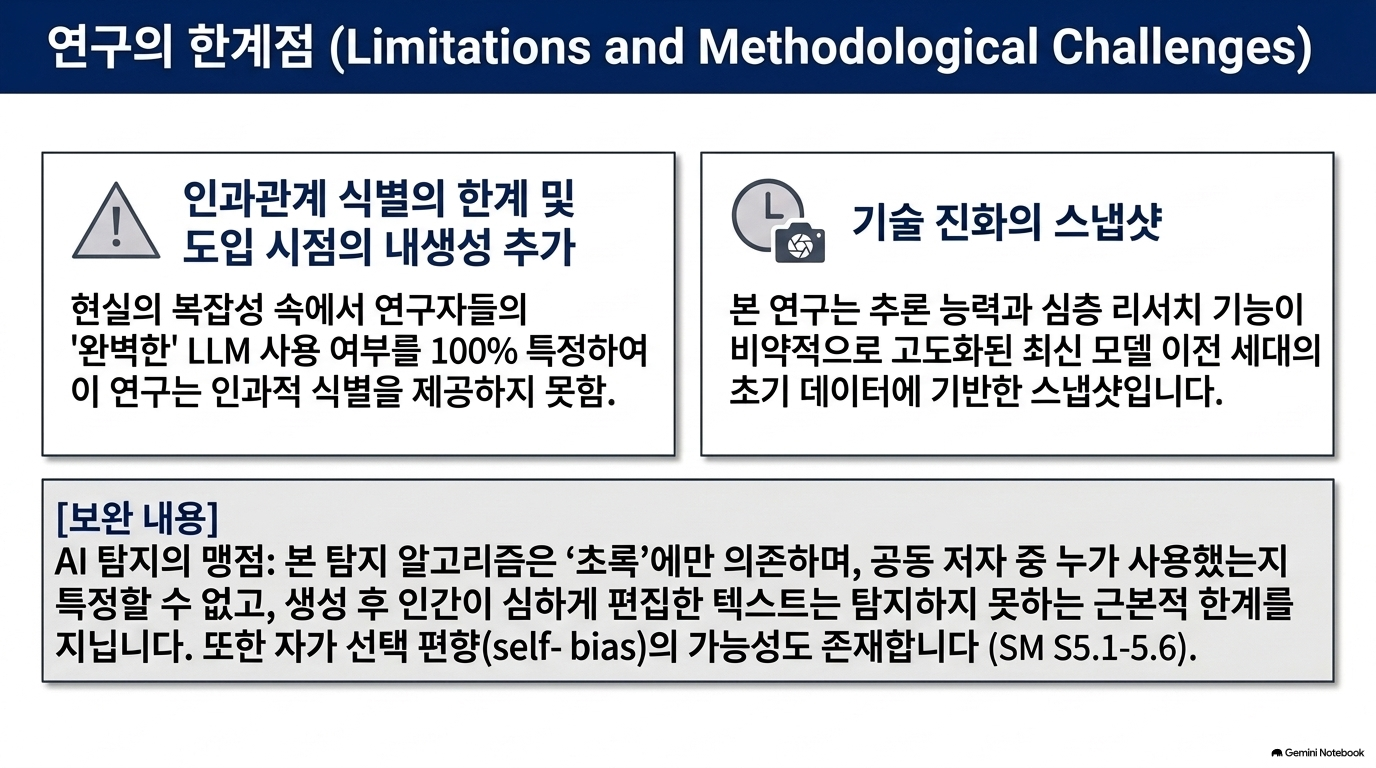
6.1 저자가 명시한 핵심 한계
| 한계 | 결과 해석에 미치는 영향 |
| 인과적 식별 부재 | LLM이 결과를 일으켰다고 확정할 수 없음 |
| 초록 기반 탐지 | 본문 및 비작성 용도의 사용을 놓칠 수 있음 |
| 공동저자 중 사용자 불명 | 개인별 사용 효과를 정확히 귀속하기 어려움 |
| 대폭 수정된 생성문 탐지 어려움 | 사용자가 비사용자로 분류될 수 있음 |
| 비무작위 도입 | 적극적·생산적인 연구자가 먼저 도입했을 가능성 |
| 도입 시점의 내생성 | 처음 탐지된 논문 제출 시점 자체가 생산량과 연결됨 |
- 이 한계들은 저자가 직접 인정한 사항입니다.[1, p.7]
- 특히 도입 시점의 내생성이 중요합니다. 도입은 외부에서 기록된 날짜가 아니라 논문 제출을 통해 관측됩니다. 논문을 많이 내는 사람일수록 사용 흔적이 더 빨리 관측될 가능성이 있다는 측정 문제를 고려해야 합니다.
6.2 기술 세대에 따른 한계
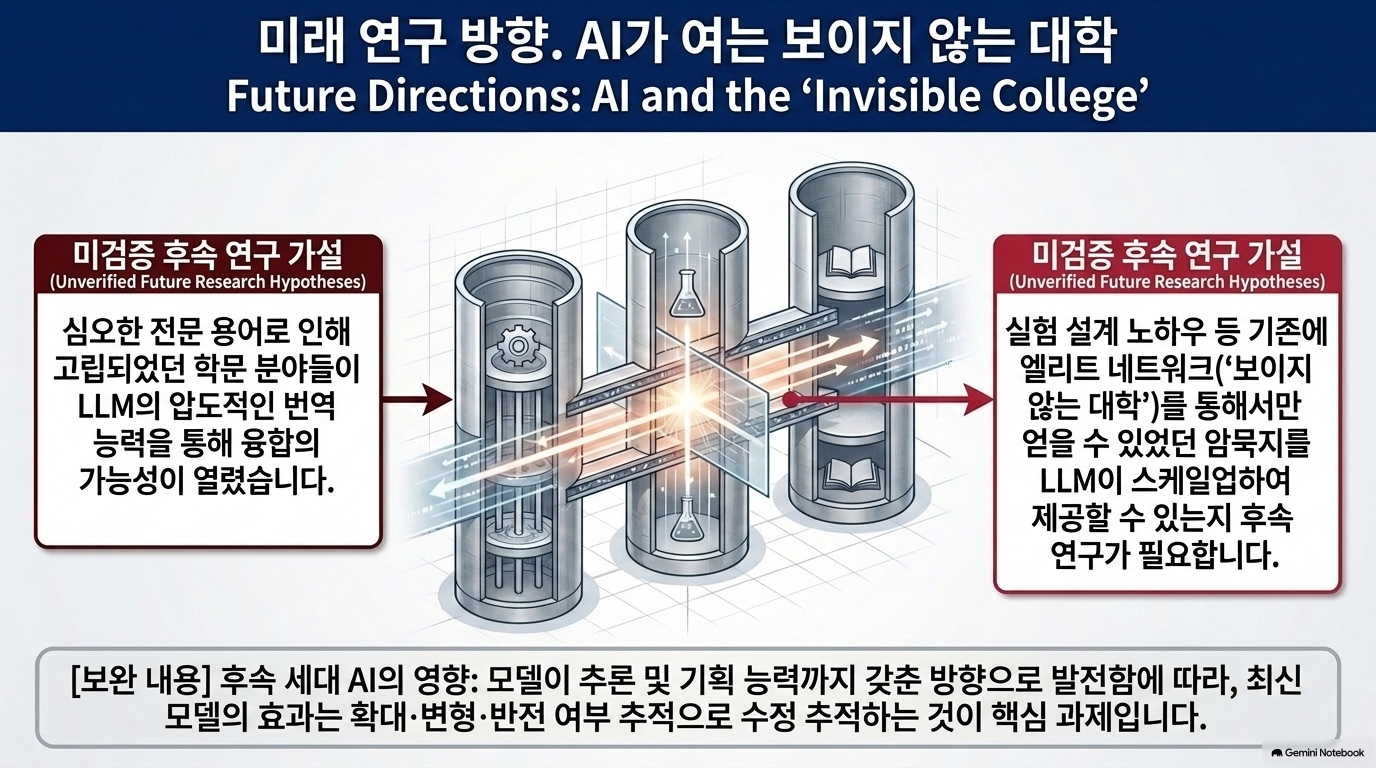
- 이 연구는 고도화된 추론 모델과 deep research 기능이 확산되기 전 자료를 분석합니다. 저자들은 향후 효과가 확대·변형·반전될 수 있으므로 지속 추적이 필요하다고 설명합니다.[1, p.7]
- 따라서 여기서 제시된 증가율을 현재 모든 모델·연구환경에 그대로 적용해서는 안 됩니다.
6.3 미래 연구 가설
- Invisible colleges의 대체·보완: 비공식 인맥을 통해 전달되던 실험설계, 분야 관행, 암묵적 지식을 LLM이 제공할 수 있는가?
- 학제 간 장벽 완화: 전문용어와 분야별 지식체계의 장벽을 낮춰 협업을 촉진할 수 있는가?[1, p.7]
- 둘 다 흥미로운 연구 방향이지만, 이 논문에서 검증된 결과가 아니라 후속 연구 가설입니다.
7. 결론 — 생산의 민주화와 평가의 재설계
원문 절: “Conclusion” / pp.7–8
- 저자들은 LLM이 논문 생산을 늘리고, 비영어권 연구자의 장벽을 낮추며, 선행문헌 발견의 범위를 넓힐 수 있다고 종합합니다. 동시에 언어 복잡성이 품질을 나타내는 신호로 약해지는 만큼, 평가체계는 방법론적 검증과 실질적 기여에 더 집중해야 한다고 주장합니다.[1, pp.7–8]
- 분석적 종합: 이 논문의 가장 중요한 함의는 다음과 같습니다.
- 표현을 생산하는 능력의 희소성이 낮아질수록, 근거를 검증하고 기여를 판별하는 능력의 중요성은 커진다.
- 이는 논문뿐 아니라 정책보고서·컨설팅 산출물·감리 문서에도 적용할 수 있는 관점입니다. 다만 이러한 분야로의 확장은 본 연구의 직접 실증 결과가 아니라 분석적 시사점입니다.
8. 연구평가·AI 거버넌스 관점의 적용
- 아래는 논문 결과를 바탕으로 한 실무 권고이며, 논문에서 효과를 검증한 제도는 아닙니다.
| 우선순위 | 적용 과제 | 권고 내용 |
| 높음 | 평가 기준 재설계 | 문체·분량과 증거·방법론·재현성을 별도 평가 |
| 높음 | AI 사용 이력 관리 | 작성·번역·코딩·분석·문헌 탐색 등 사용 목적을 구분 |
| 높음 | 인용 검증 | 문헌 존재뿐 아니라 인용 문장과 원문 내용의 정합성 확인 |
| 높음 | 성과지표 보완 | 논문 수와 검증된 기여·재현 가능성을 함께 측정 |
| 중간 | 심사 보조 AI | 오류 탐지에 활용하되 최종 판단과 책임은 명확히 유지 |
| 중간 | 참여 형평성 | 영어 표현 지원과 학문적 기여 평가를 분리 |
| 후순위 | 장기 모니터링 | 모델 세대·분야별 생산량, 품질, 인용 행태 변화를 추적 |
최종 평가
- 강점
- 서로 다른 학문 분야의 대규모 자료를 결합했습니다.
- 생산량·평가·탐색을 함께 분석해 과학 생산 시스템의 변화를 보여줍니다.
- 출판 여부뿐 아니라 독립적인 심사점수 자료로 주요 패턴을 확인했습니다.[1]
- 주의점
- LLM 사용은 직접 관측이 아니라 문체 기반 추정입니다.
- 생산량은 연구의 실질적 가치와 다릅니다.
- 출판·심사점수는 품질의 대리지표입니다.
- 탐색 확대는 인용의 정확성을 보장하지 않습니다.
- 인과관계는 확정되지 않았으며, 일부 수치의 원문 내부 불일치도 있습니다.[1]
- 한 문장 결론:
이 논문은 LLM이 연구의 질을 일률적으로 높이거나 낮춘다는 연구가 아니라, 논문을 만드는 비용과 연구를 평가하는 신호가 달라지고 있음을 보여주는 연구입니다.
출처
- [1] https://arxiv.org/pdf/2601.13187 — Scientific production in the era of Large Language Models — 원문 PDF
[2] https://arxiv.org/abs/2601.13187 — arXiv 서지정보 및 버전 이력
'07.AI > 3.AI 노동' 카테고리의 다른 글
| 2026 - 노동 - 컴퓨터 작업 수행 AI와 화이트 칼라 업무 변화 (0) | 2026.10.07 |
|---|---|
| 2026 - 노동 - EPOCH AI, 2025~2027년에 출하되는 AI 하드웨어가 최종적으로 몇 개의 에이전트를 동시에 실행할 수 있는가? (0) | 2026.10.06 |
| 2026 - 노동 - HAI, 인공지능이 전 세계 일자리에 미치는 영향, 다음 단계는 무엇일까요? (0) | 2026.09.26 |
| 2026 - 노동 - HAI, 인공지능은 노동 수요를 어떻게 변화시키는가? 41개국 사례 연구 (0) | 2026.09.26 |
| 2026 - 노동 - Brookings, AI 시대의 노동 정책 방향 (0) | 2026.09.16 |