https://epoch.ai/publications/the-plunging-price-of-thought
2026.9.22
[The plunging price of thought]
제공된 문헌은 인공지능의 성능 비용이 역사상 그 어떤 기술보다도 훨씬 빠른 속도로 하락하고 있음을 분석하고 증명하는 연구 보고서입니다. 이 문헌은 2023년 이후 수학, 과학, 게임 등 다양한 분야의 벤치마크를 활용해 인공지능 연산 비용이 분기마다 약 47%씩 급감하고 있다는 점을 정량적으로 밝혀내며, 이러한 가격 하락세가 전력이나 DNA 시퀀싱 등 과거의 혁신 기술들과 비교할 때 유례없이 가파르다는 점을 강조합니다. 또한, 본 보고서는 최첨단 성능(SOTA)이 처음 달성된 직후에 비용이 가장 빠르게 떨어지는 경향이 있다는 점을 분석하는 한편, 벤치마크 최적화(벤치맥싱)나 지표 측정의 한계점 같은 복잡한 요인들도 함께 다루며 인공지능이 지닌 경제적 충격과 기술적 추세를 입체적으로 조명합니다.
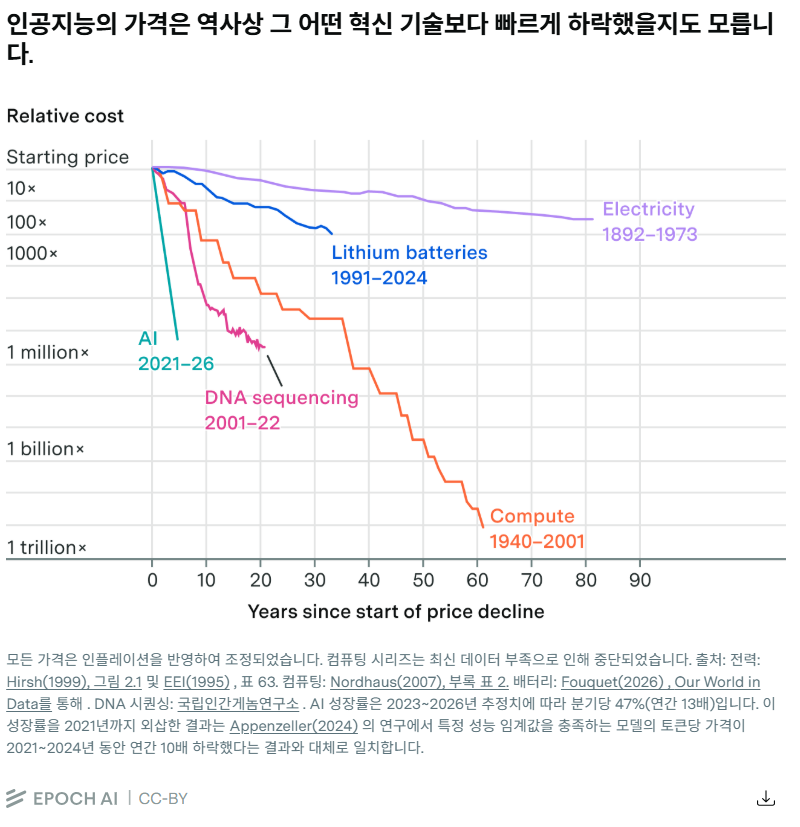
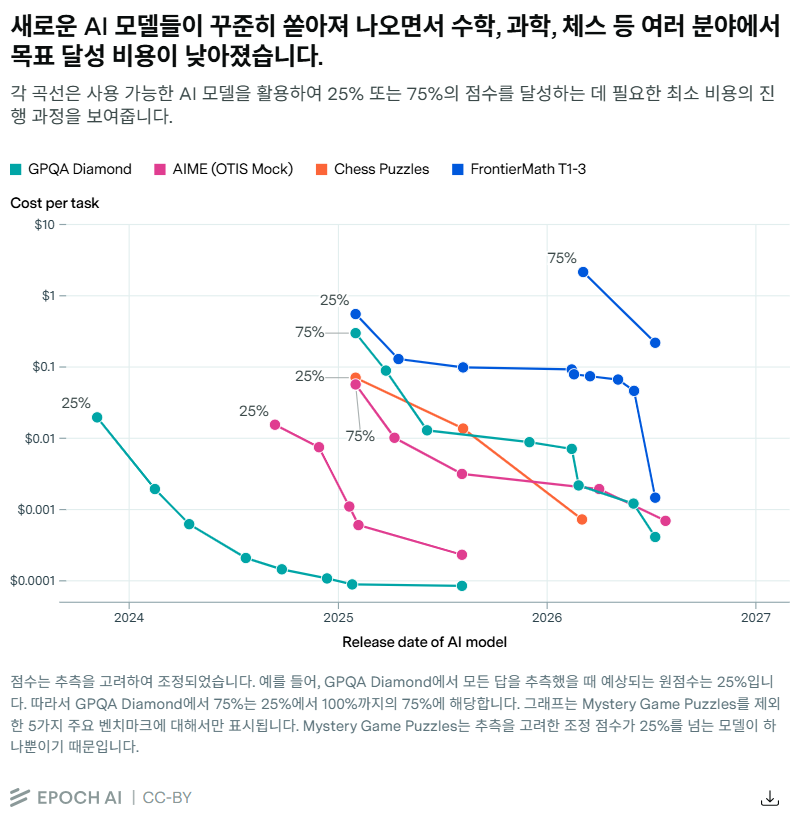
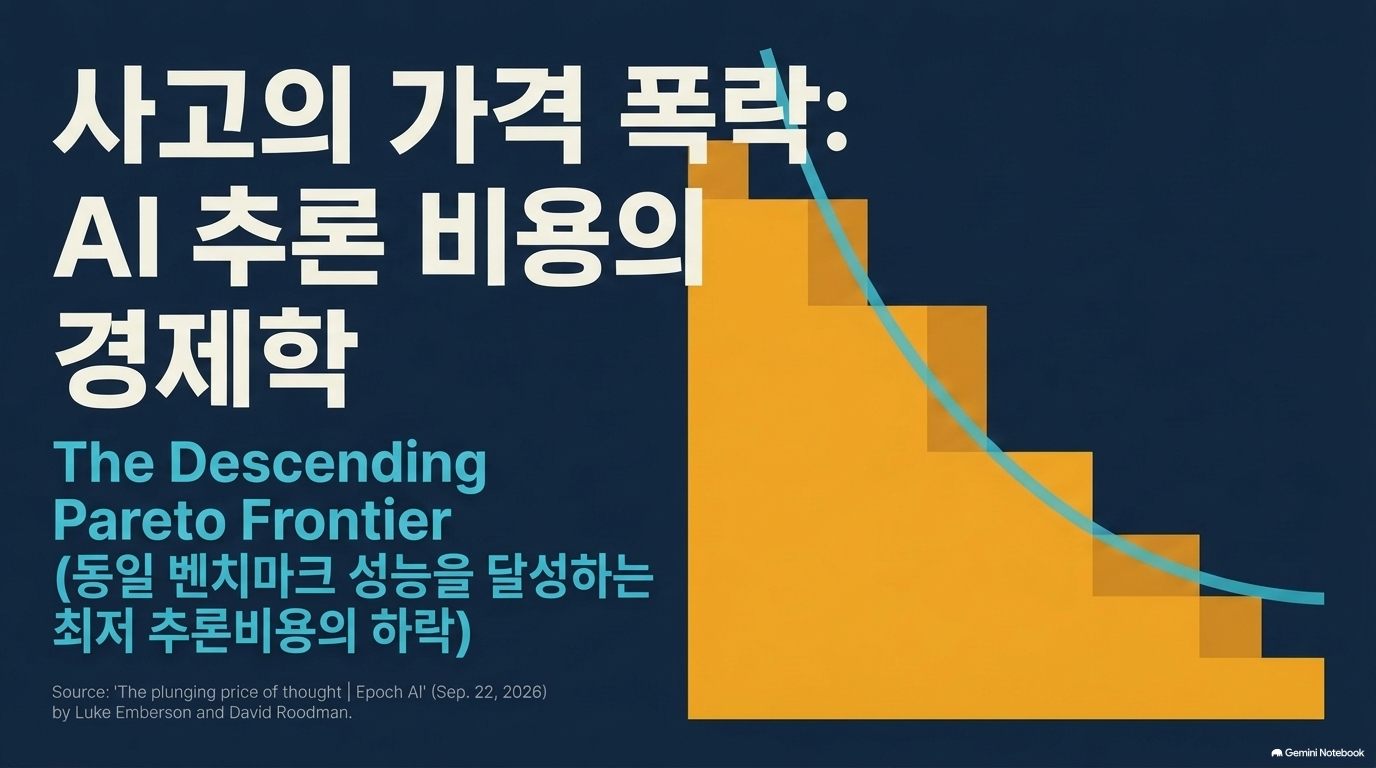
이 글의 분석 대상은 막연한 ‘AI 가격’이 아닙니다. 특정 벤치마크에서 일정한 성능을 달성할 수 있는 가장 저렴한 모델·추론 설정의 비용입니다. 연구진은 이 비용–성능 프런티어가 2023년 이후 얼마나 빠르게 이동했는지를 추정합니다. 따라서 결론인 분기당 약 47% 비용 하락은 모든 모델의 API 가격이나 조직의 AI 총소유비용에 적용되는 수치가 아닙니다.[1]
아래는 원문의 장·절 순서를 따른 분석입니다. ‘원문 주장’과 ‘분석적 해석’을 구분했습니다.
1. Key takeaways — 핵심 발견
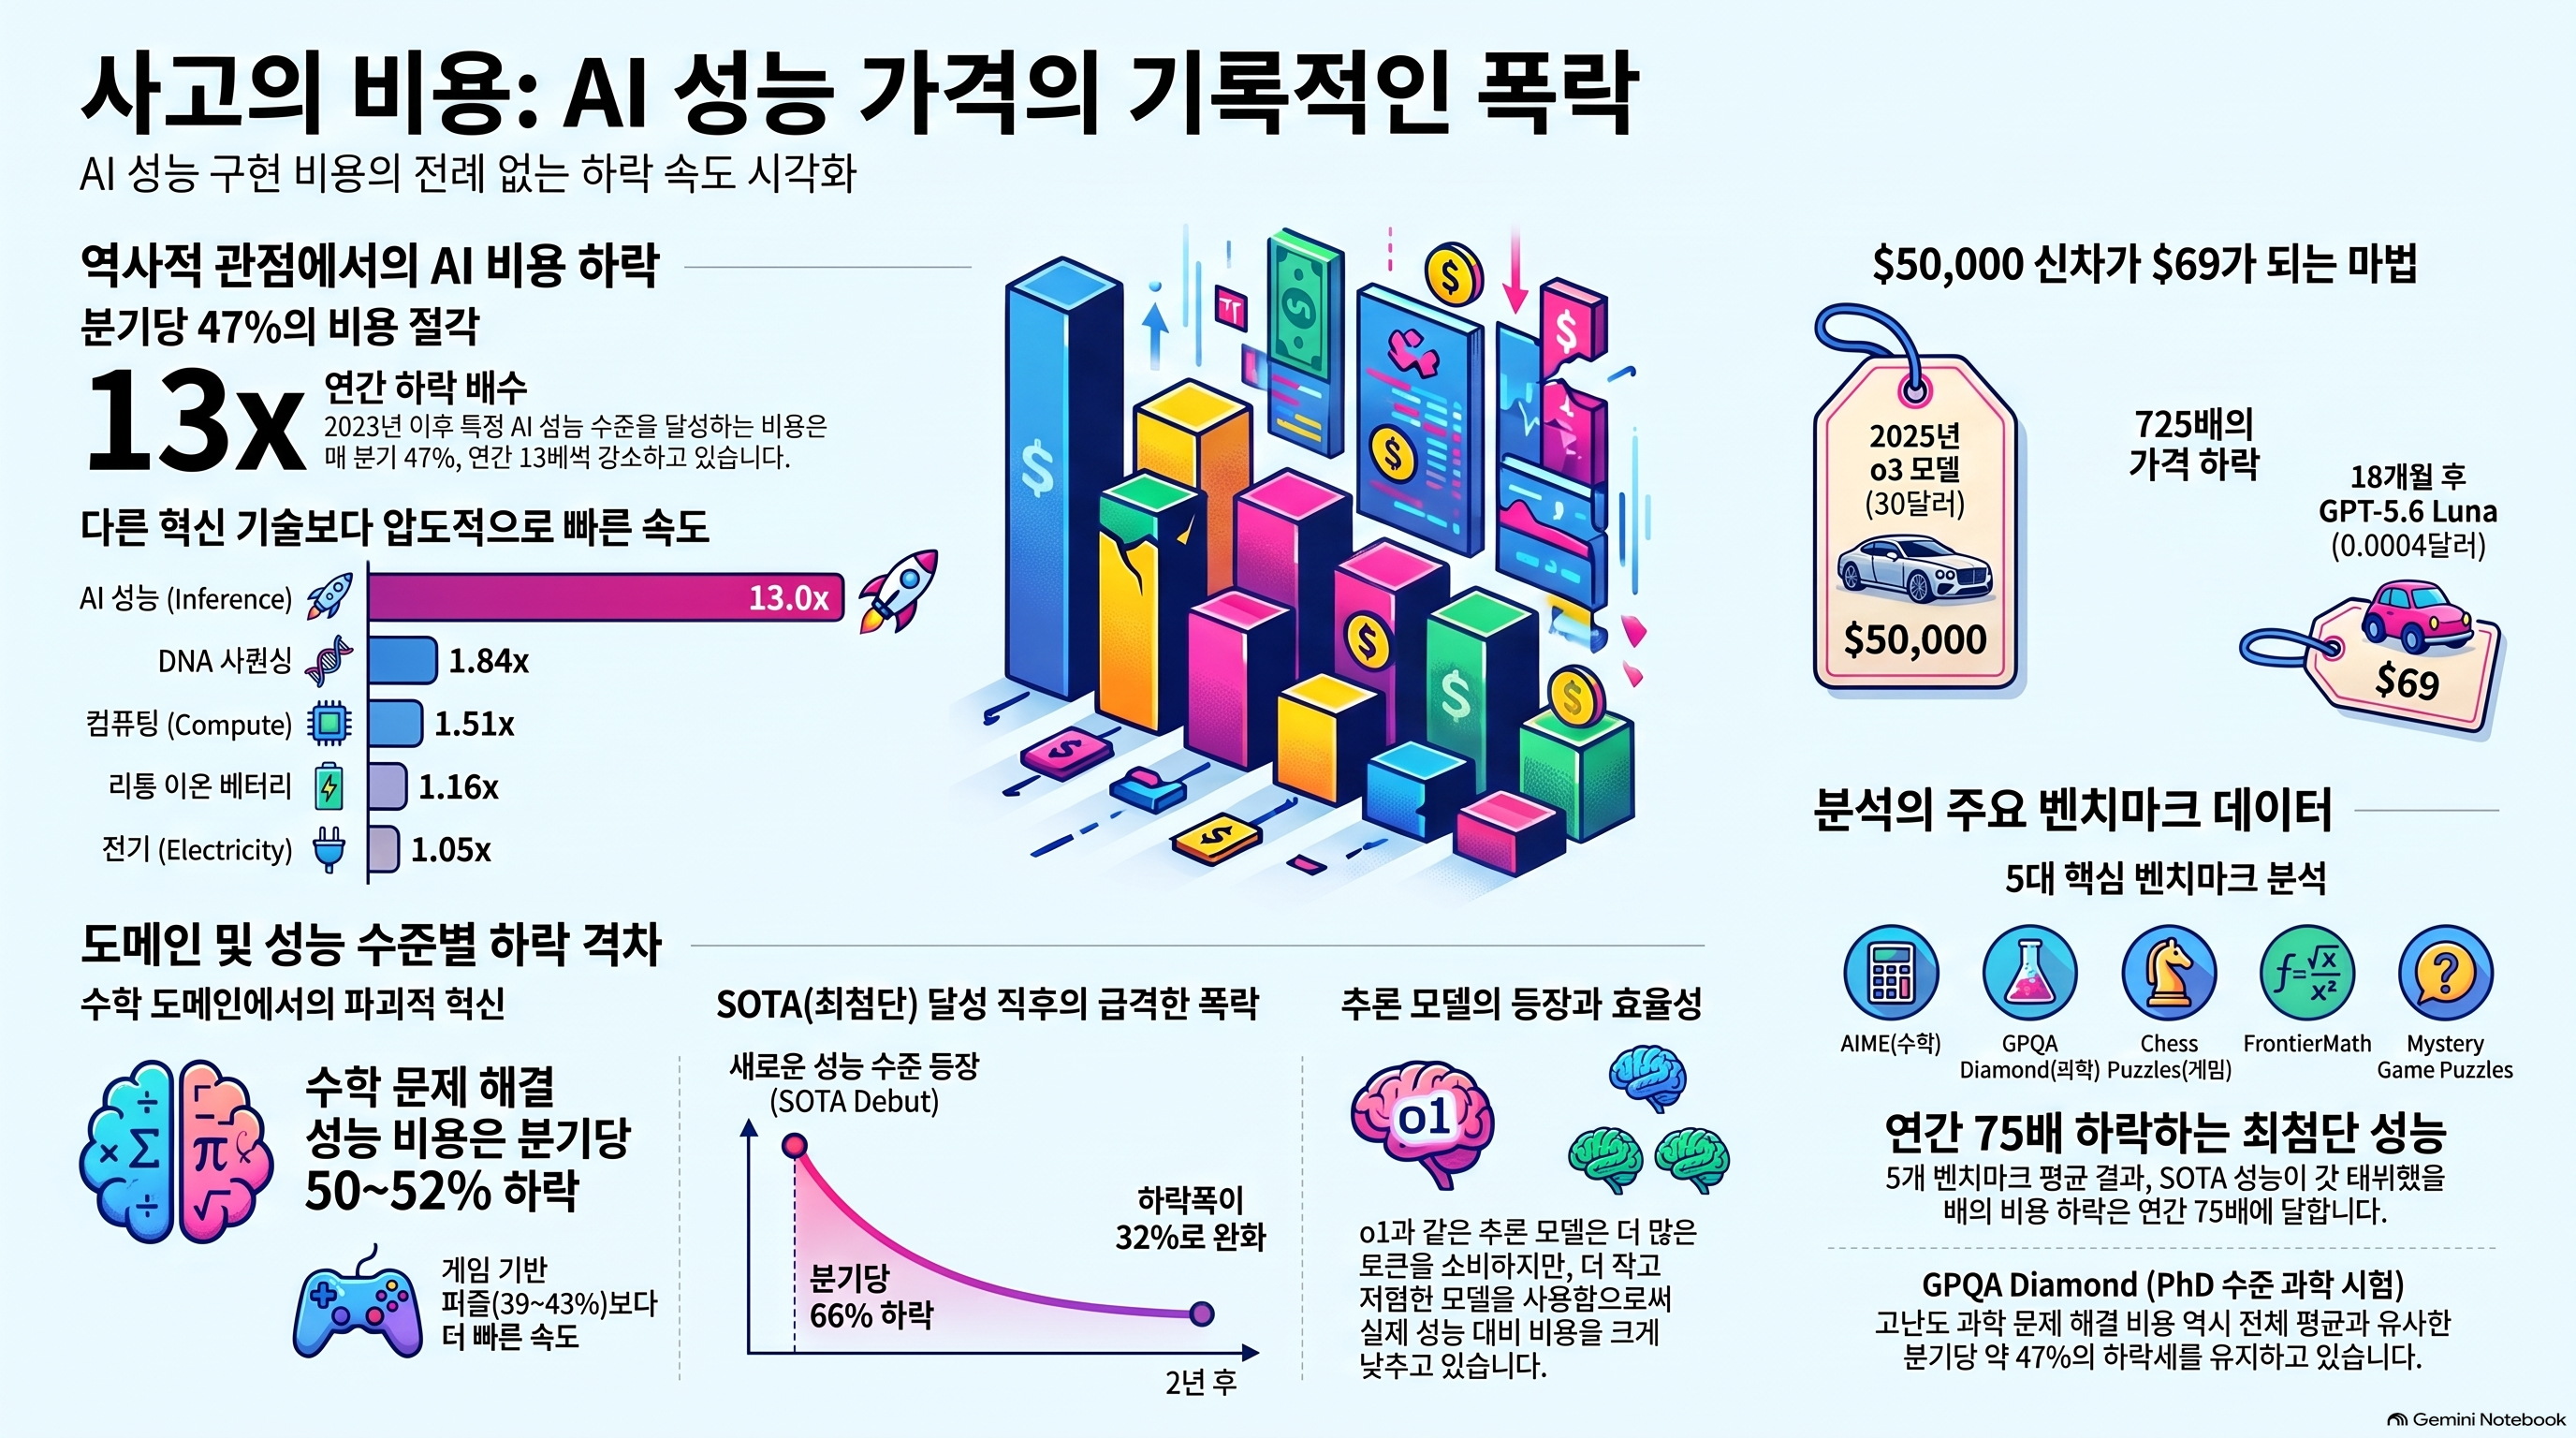
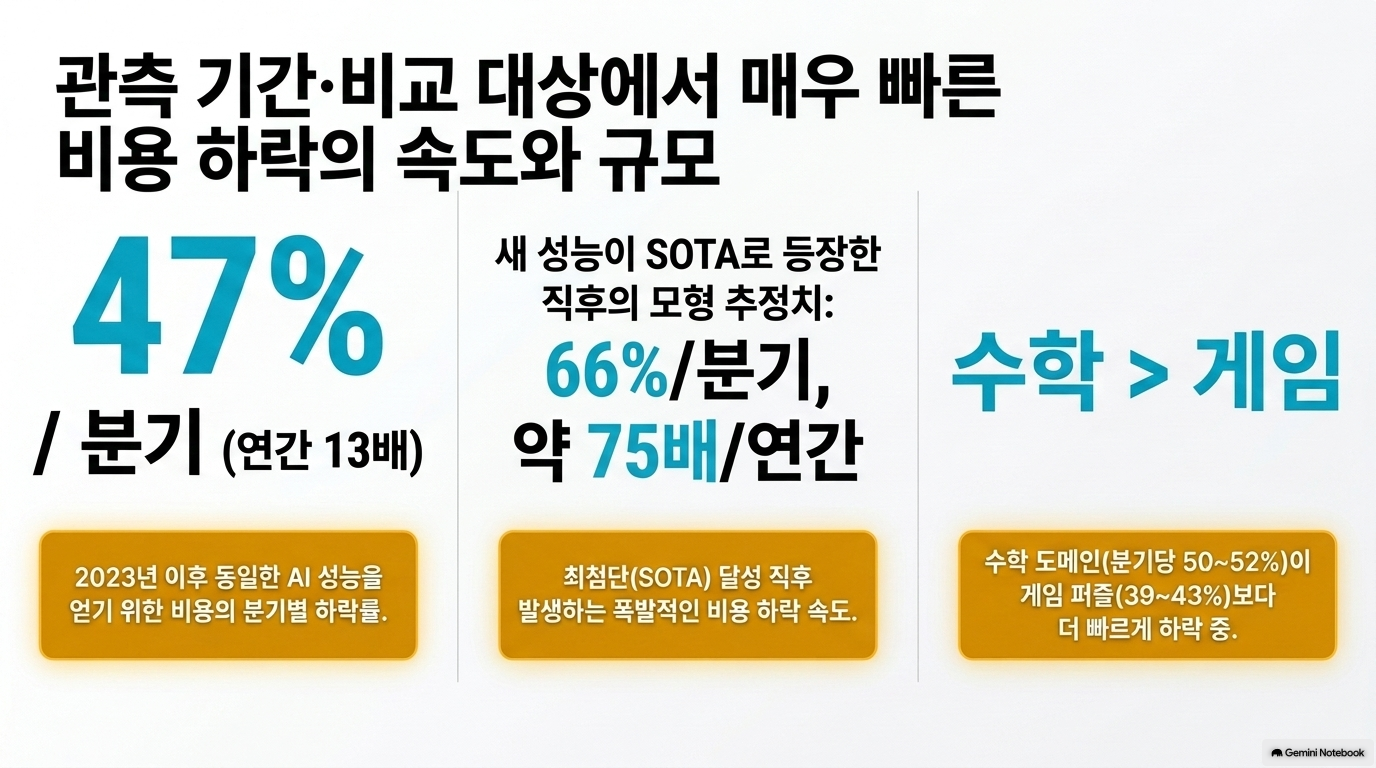
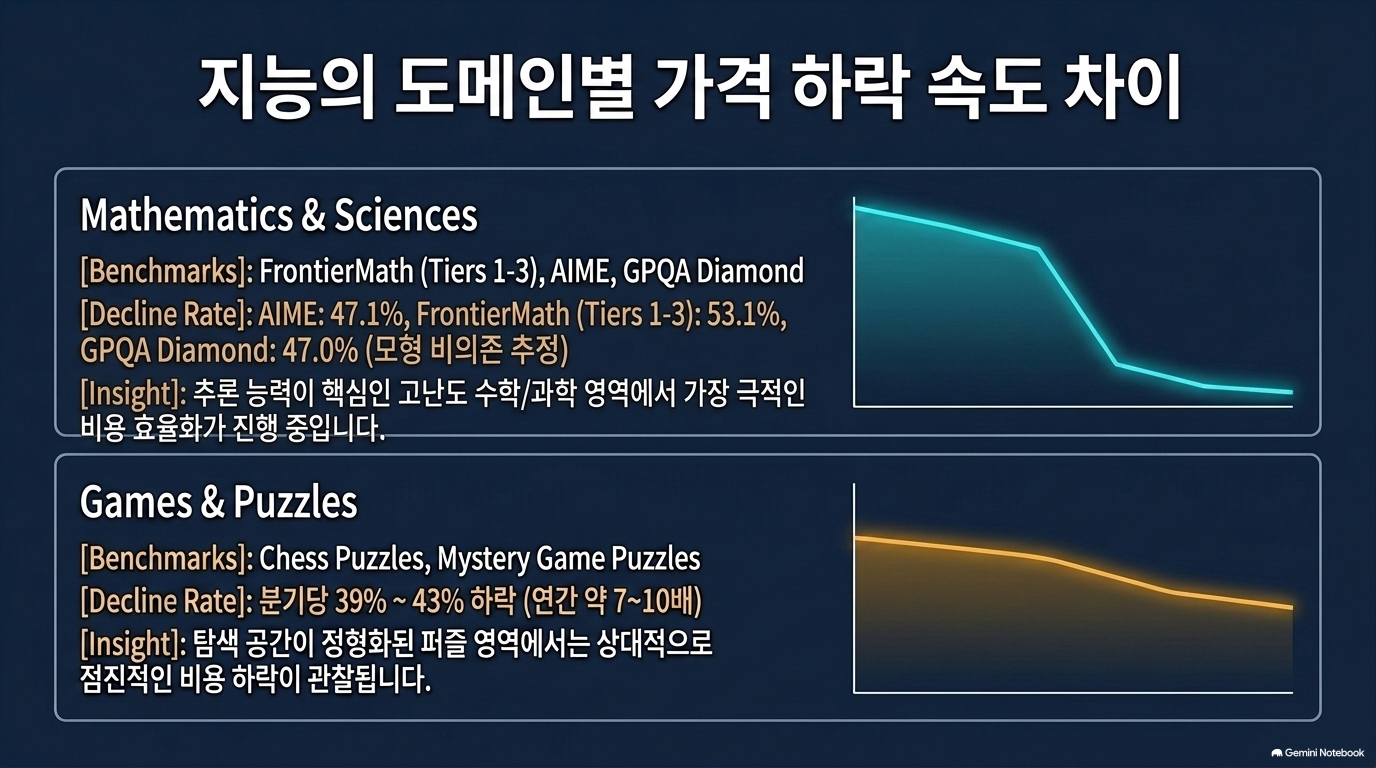
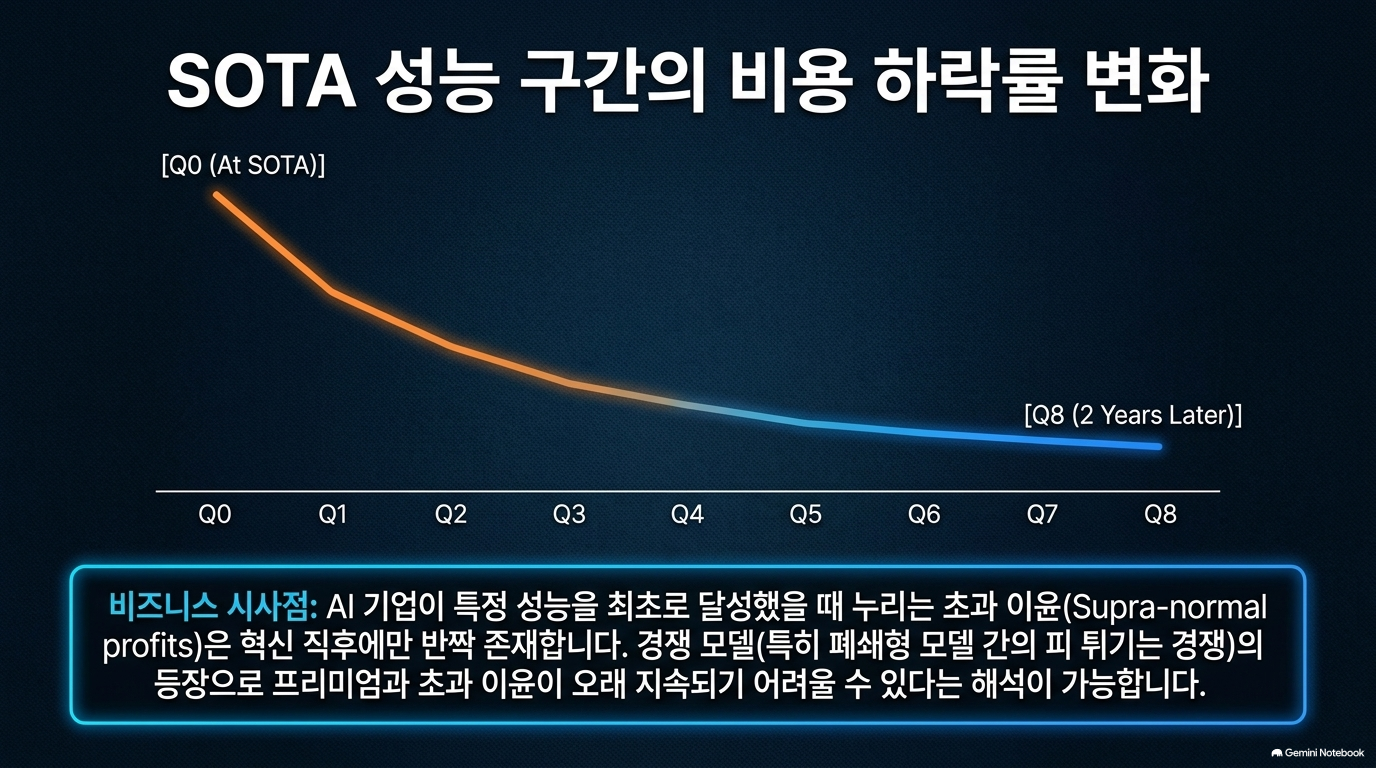
원문 주장. 주요 벤치마크 5개에서 동일 성능을 달성하는 최저비용은 평균 분기당 47%, 연간 약 13배 하락했습니다. 분야별로는 게임 퍼즐보다 수학 문제에서 하락이 빠릅니다. 새로운 최고 성능(SOTA)이 처음 등장한 시점에는 해당 성능의 비용이 분기당 평균 66%씩 하락하지만, 2년 뒤에는 하락률이 32%로 완만해진다는 결과도 제시합니다.[1]
분석적 해석. 여기서 ‘연 13배’는 매년 같은 모델의 요금표가 13분의 1이 된다는 뜻이 아닙니다. 동일한 성능 목표를 만족하는 최저비용 선택지가 시간이 지나며 교체된 결과입니다. 이 차이가 이후 모든 장을 읽는 기준입니다.
2. Overview — 문제 제기와 연구 범위
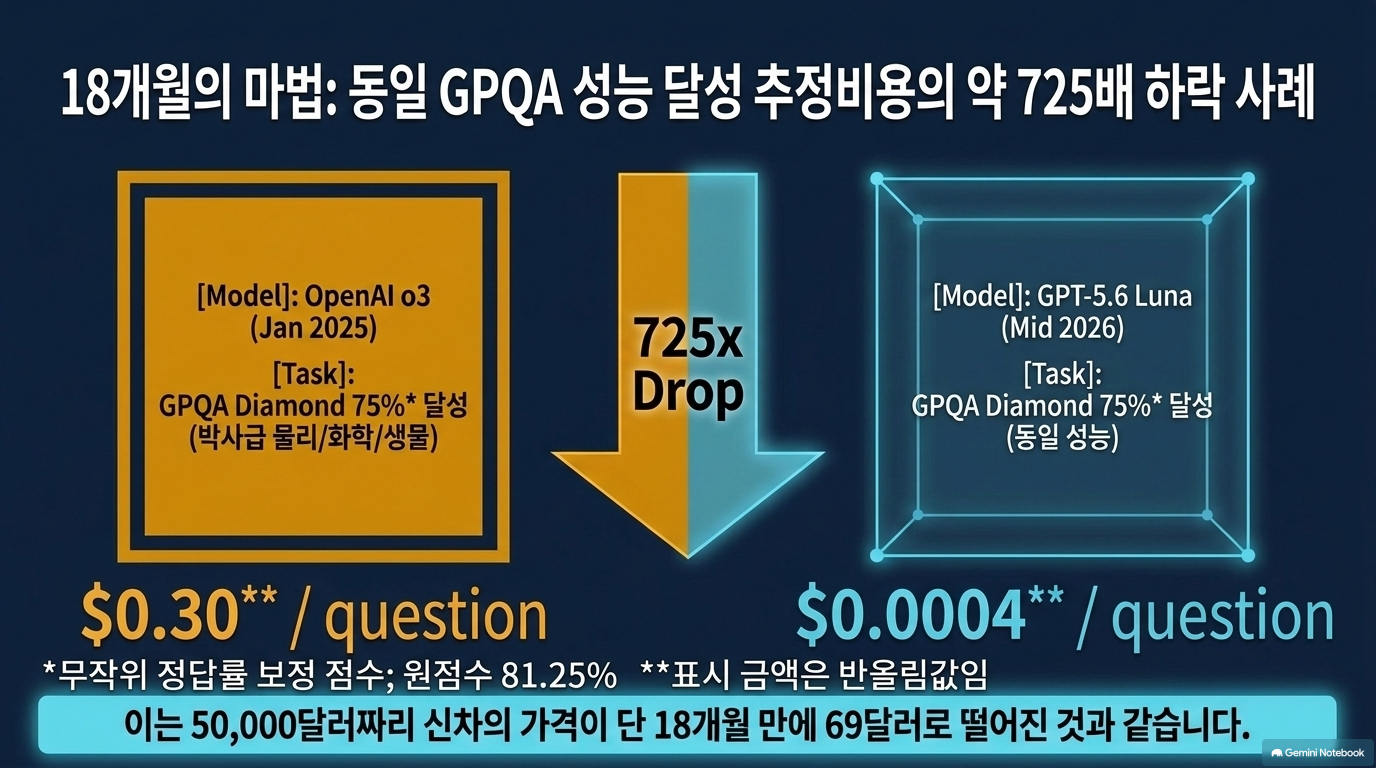
원문은 AI 산업이 칩·전력 등의 투입재 수요와 가격을 높이는 동시에, 데이터센터가 제공하는 AI 추론 서비스의 성능 대비 가격은 급락하고 있다는 대비로 시작합니다. GPQA Diamond에서 비슷한 성능을 얻는 문항당 추정비용 사례로 2025년의 약 0.30달러와 18개월 미만 뒤의 약 0.0004달러를 제시합니다. 단일 사례로 전체 추세를 단정하지 않기 위해 수학·과학·게임의 5개 주요 벤치마크를 분석합니다.[1]
이 장은 결론의 적용 범위도 미리 제한합니다. 벤치마크에 특화된 학습, 실제 업무와 시험 성능의 차이, 지속적으로 최저가 모델을 갈아타지 않는 사용자 행동, 불완전한 데이터 때문에 47%를 정확한 상수로 읽어서는 안 된다고 밝힙니다.[1]
수치 판독 주의: GPQA 사례에서 원문은 하락 폭을 약 725배라고 표현하지만, 본문에 표시된 반올림 금액인 0.30달러와 0.0004달러를 그대로 나누면 750배입니다. 두 금액과 배수 중 적어도 하나가 표시 과정에서 반올림된 것으로 보아야 하며, 표시값만으로 725배를 재현할 수는 없습니다. 또한 각주에 따르면 사례의 ‘75%’는 4지선다 무작위 정답률을 보정한 척도로, 실제 정답률로는 81.25%에 해당합니다.[1]
3. Previous work — 기존 연구와 이 글의 차별점
기존 연구 상당수는 일정 성능 이상의 모델이 받는 토큰당 가격을 비교했습니다. 그러나 추론 모델은 답변 전 더 많은 토큰을 쓰고, 추론량 설정에 따라 비용과 성능이 달라집니다. 따라서 토큰 하나의 단가가 낮더라도 문제 하나를 목표 품질로 해결하는 총 추론비용이 반드시 낮지는 않습니다.[1]
4. Data — 비용–성능 곡선을 어떻게 만들었나
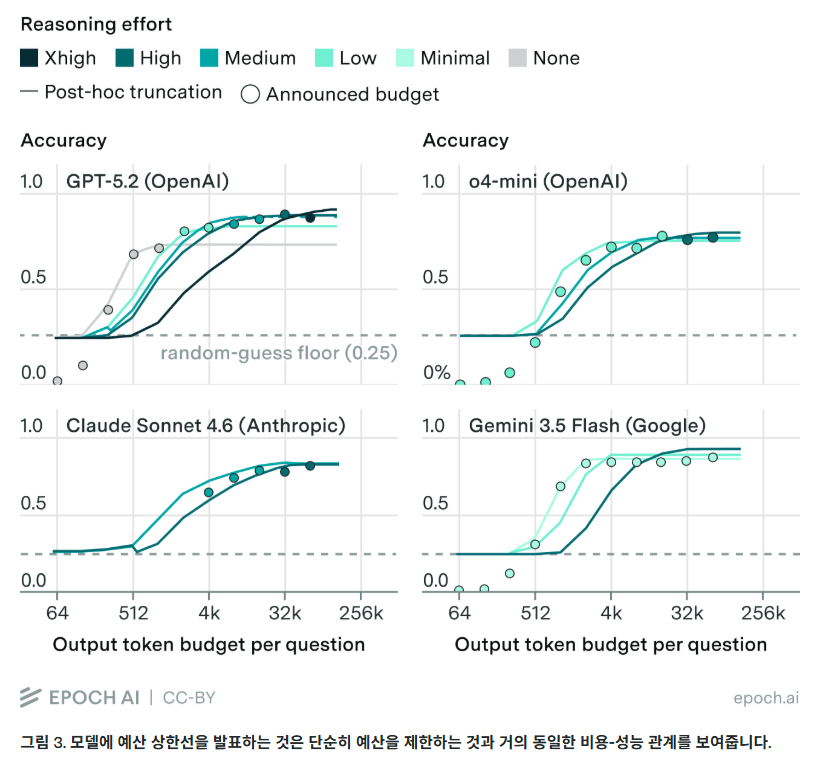
연구진은 같은 모델도 추론 수준을 낮음·중간·높음 등으로 바꾸거나 출력 토큰 예산을 제한하면 여러 성능·비용 조합을 낼 수 있다고 봅니다. 모든 예산에서 평가를 새로 돌리는 대신, 고예산 평가의 문제별 기록—정답 여부와 사용 토큰 수—을 이용해 더 낮은 예산이었다면 몇 문제를 풀었을지 추정합니다. 시간 내 답하지 못한 문항에는 문제 유형에 따른 추측 정답 확률을 부여합니다.[1]
이 방식의 핵심 위험은 모델에 예산을 미리 알려주었을 때의 행동과, 기존 답변을 예산 지점에서 가상으로 잘랐을 때의 결과가 다를 수 있다는 점입니다. 연구진은 예산을 명시한 추가 평가를 통해 이를 점검했고, 여러 추론 수준을 함께 고려하면 비용–성능 가능 범위의 상당 부분을 포착할 수 있다고 판단합니다. 과거 평가에 부족했던 저추론·소형 모델 결과도 보강했습니다. 직접 실행한 일부 공개 가중치 모델의 비용은 임대 하드웨어 비용으로 추정했으며, API에서도 이용 가능한 5개 모델을 대조한 결과 비용 차이가 각각 30% 미만이었다고 보고합니다.[1]
평가: 연구의 중요한 기여는 단일 ‘모델 가격’ 대신 목표 품질별 달성비용을 비교하도록 데이터 구조를 바꾼 것입니다. 반면 일부 저예산 지점과 공개 가중치 모델 비용은 직접 관측한 시장 거래가격이 아니라 시뮬레이션·하드웨어 비용 추정을 포함합니다.
5. Modeling — 프런티어의 정의와 모형 선택
5-1. The challenge — 무엇을 프런티어라고 부르는가
각 평가 결과에는 성능 a, 모델 출시 시점 t, 비용 c가 있습니다. 연구진은 이를 두 방향에서 봅니다.[1]
성능 프런티어 A(tⓜ,c): 그때까지 나온 모델 중 예산 c이하에서 얻을 수 있는 최고 성능.
비용 프런티어 C(tⓜ,a): 그때까지 나온 모델 중 목표 성능 a이상을 얻는 최저비용.
이 프런티어는 새 모델이 등장할 때 계단식으로 움직입니다. 소수의 최고 기록이나 빠진 평가 하나가 결과를 크게 바꿀 수 있고, 모델 평가 대상도 무작위로 선정되지 않았습니다. 날짜별 프런티어 값에는 강한 상관관계도 있습니다. 연구진은 이런 사유로 신뢰할 만한 표준오차·유의성 검정을 제시하기 어렵다고 판단하여, 결과를 정밀한 통계적 추론이 아닌 거친 측정치로 취급합니다.[1]
5-2. The models / Nonlinear models — 어떤 곡면을 적합했는가
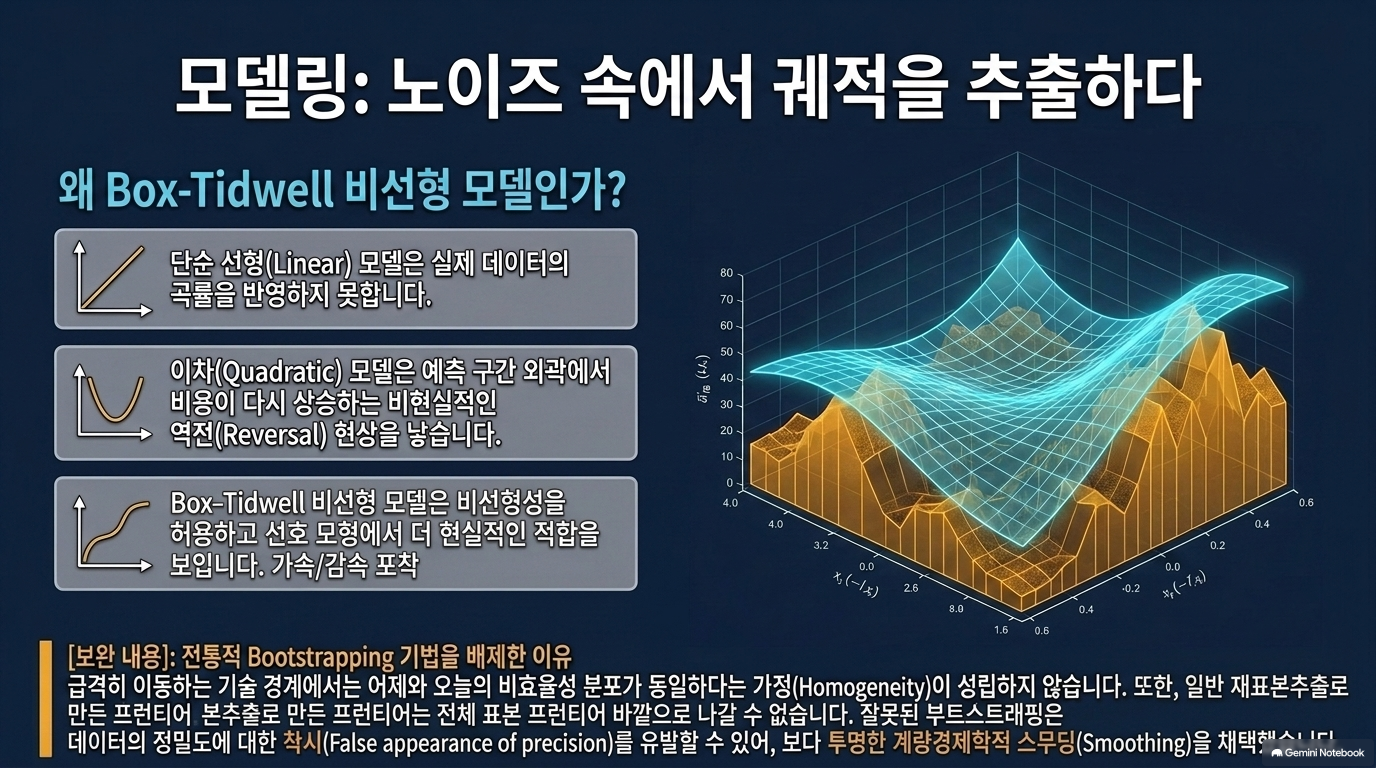
원문은 경험적 프런티어에 부드러운 곡면을 맞추는 방법, 관측된 모든 점을 반드시 감싸도록 강제하는 envelope 방법, 전체 평가 결과를 적합하는 방법을 비교합니다. 성능이 0~100%로 제한된다는 점에는 로지스틱 모형을, 비용에는 로그비용 모형을 활용합니다. 시간과 성능의 관계가 단순한 직선이 아닐 가능성을 다루기 위해 이차식 및 Box–Tidwell 변환도 시험합니다.[1]
연구진이 선호하는 것은 경험적 비용 프런티어에 적합한 비포락(non-envelope) Box–Tidwell 모형입니다. 모든 관측점을 포락하도록 강제하면 일부 극단값에 지나치게 좌우될 수 있고, 전체 데이터 적합은 애초의 관심 대상인 ‘가장 저렴한 선택지’를 제대로 나타내지 못하기 때문입니다. 이차식은 관측 범위 가장자리에서 비용 추세가 비현실적으로 역전되는 문제가 있다고 설명합니다.[1]
평가: ‘47%’는 한 회귀계수를 그대로 읽은 결과만이 아닙니다. 어떤 프런티어를 만들고, 어느 성능·시점 범위에 가중치를 두며, 어떤 모형으로 평활화할지에 관한 분석 설계의 산물입니다.
6. On bootstrapping / Extracting estimates — 불확실성과 하락률 계산
연구진은 통상적인 재표본추출 부트스트랩도 채택하지 않습니다. 기존 관측치를 중복하거나 누락해 만든 표본의 프런티어는 원본 표본의 프런티어보다 바깥으로 나갈 수 없어, 새롭고 더 좋은 모델이 나타나는 실제 생성 과정을 잘 모사하지 못한다는 판단입니다. 대안적 부트스트랩 역시 시기별 ‘비효율성’ 분포가 비슷하다는 가정에 의존하는데, 빠르게 변하는 AI 시장에는 그 가정이 약하다고 봅니다.[1]
하락률 계산에서는 성능 목표를 고정한 채 시간이 한 분기 지났을 때 최저비용이 얼마나 변하는지 봅니다. 모형을 쓰지 않는 추정은 각 시점·성능 격자에서 프런티어 비용의 분기 후 비율을 구해 기하평균합니다. 성능을 종속변수로 둔 모형에서도 같은 성능을 유지하는 데 필요한 비용 변화율을 역으로 계산합니다.[1]
평가: 신뢰구간이 없다는 사실은 결과를 무시할 이유가 아니라, 47.0%와 45%의 미세한 차이에 과도한 의미를 부여하지 말아야 할 이유입니다.
7. Results — 관측된 하락 속도
7-1. Average rates of decline — 평균 추정치
주요 벤치마크 모형 비의존 추정 선호 Box–Tidwell 비용 프런티어 모형
AIME (OTIS Mock) 47.1% 50.0%
체스 퍼즐 43.0% 43.4%
FrontierMath 1–3단계 53.1% 52.4%
GPQA Diamond 47.0% 49.3%
비공개 게임 퍼즐 44.0% 38.7%
5개 단순 평균 47.0% 47.0%
두 접근의 평균이 같다고 해서 벤치마크별 추정도 일치하는 것은 아닙니다. 예컨대 비공개 게임 퍼즐의 추정치는 44.0%와 38.7%로 차이가 납니다. 다른 모형을 적용하면 평균 추정치의 차이는 더 커집니다.[1]
보조 벤치마크도 일률적이지 않습니다. 모형 비의존 분기 하락률은 SWE-bench Verified 27.5%, FrontierMath Tier 4의 한 버전 26.0%, 다른 버전 65.1% 등으로 분산됩니다. 따라서 주요 5개 평균을 코딩·최상위 수학을 포함한 모든 과업의 대표값으로 쓰면 안 됩니다.[1]
7-2. Variation in the rate of cost decline — 최고 성능의 가격은 왜 빨리 떨어지나
선호 모형의 추정에서는 AIME, FrontierMath 1–3단계, GPQA Diamond의 SOTA에 가까운 성능에서 비용 하락이 특히 빠릅니다. 5개 주요 벤치마크 평균은 해당 성능이 처음 SOTA로 등장한 시점 분기당 66.3%, 8분기 뒤 32.4%입니다. 그러나 체스와 비공개 게임 퍼즐은 같은 감속 양상을 보이지 않습니다.[1]
원문은 신기록 성능에 잠시 붙는 프리미엄이 경쟁 모델의 추격으로 사라지는 상황을 가능한 설명으로 제안합니다. 이는 가격 패턴에 대한 해석이지, 기업의 가격 책정 동기나 경쟁 효과를 분리해 인과적으로 검증한 결과는 아닙니다.[1]
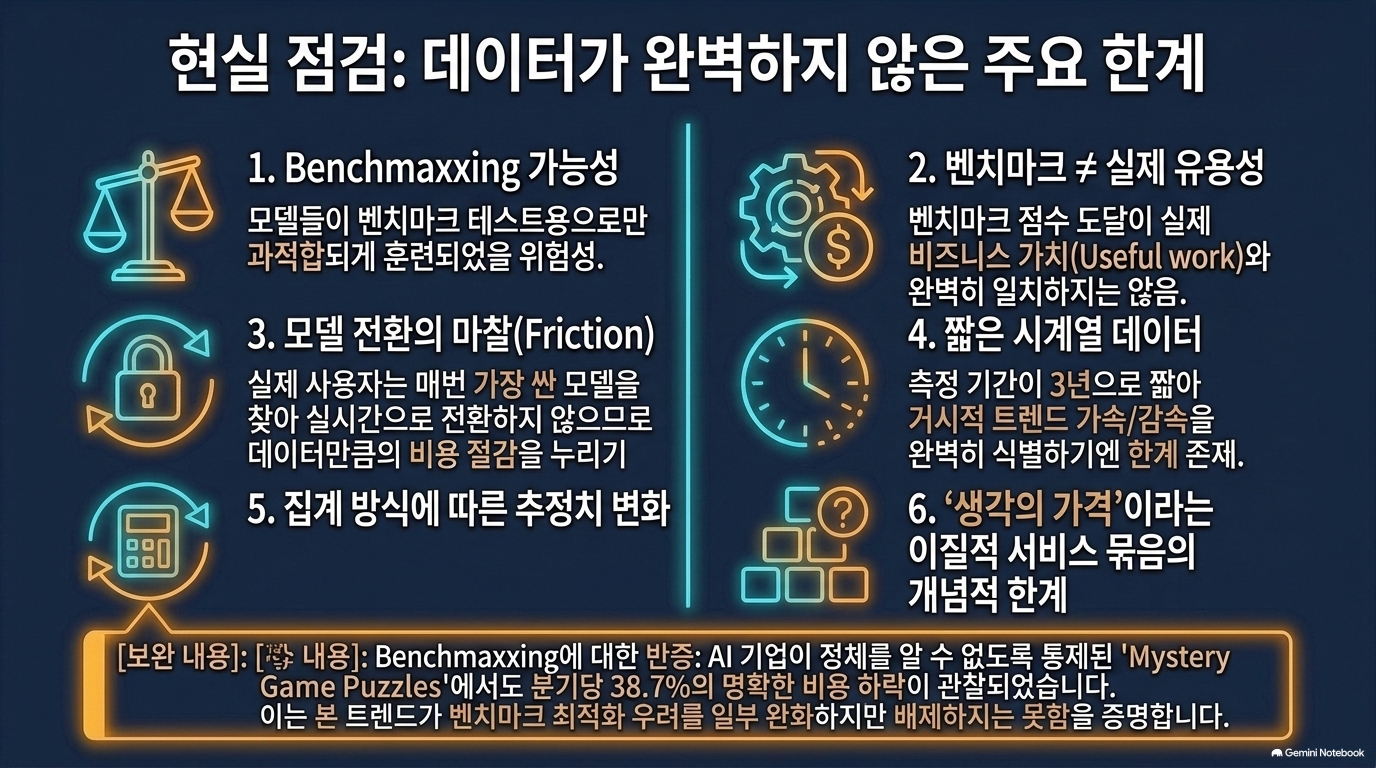
8. Limitations — 저자들이 명시한 한계
이 장은 연구를 실무에 적용할 때 특히 중요합니다.[1]
한계 무엇이 달라질 수 있는가
벤치마크 최적화 공개 시험 성능의 비용 하락이 새로운 실제 과업에서 재현되지 않을 수 있음
정답률과 유용성의 차이 시험 정답이 업무의 완결성·안전성·검수 필요량을 대표하지 않음
프런티어 사용자 가정 조직이 모델을 계속 비교·전환하지 않으면 최저비용 추세를 누리지 못함
짧은 관측 기간 약 3년 자료로 장기 하락 속도와 감속 형태를 단정하기 어려움
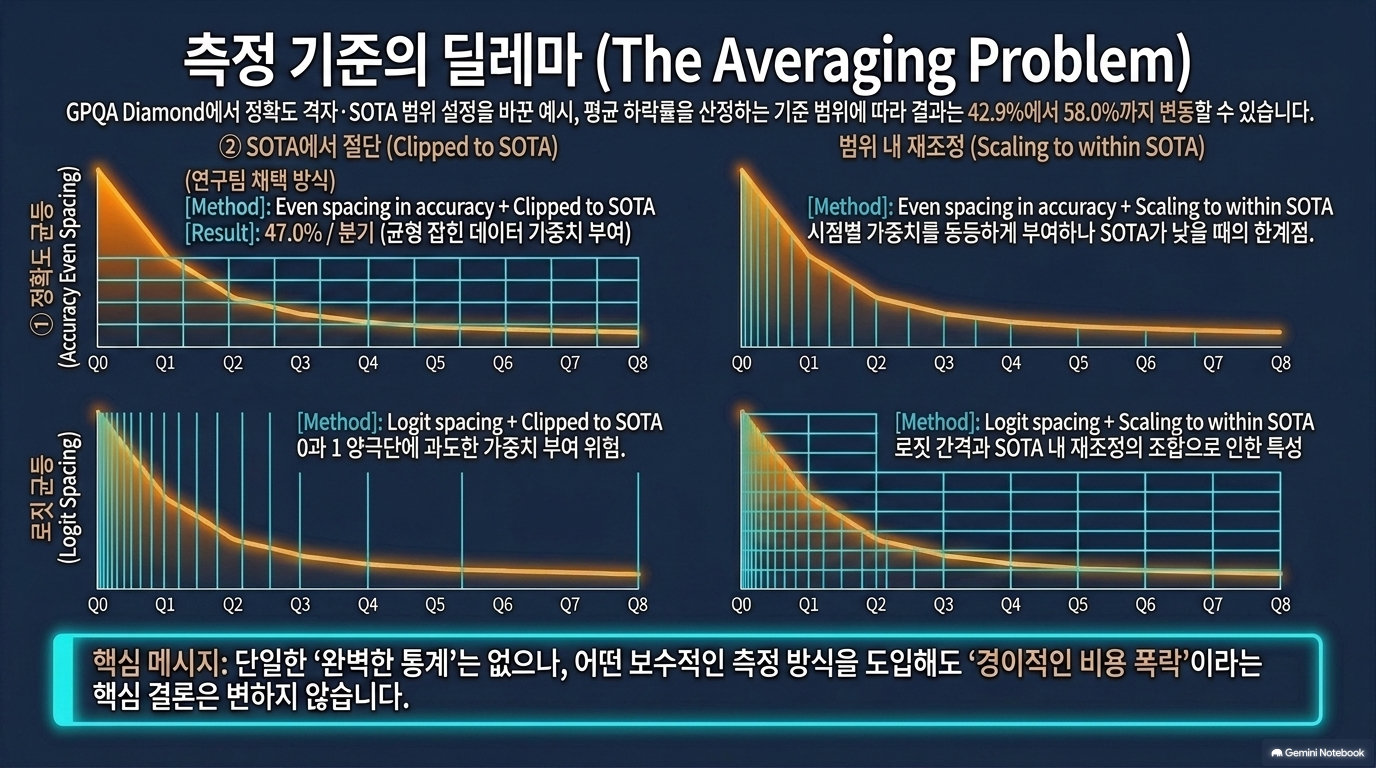
집계 방식의 선택 성능 구간을 어떻게 배치·가중하느냐에 따라 제시된 하락률이 달라짐
‘생각의 가격’의 모호성 다양한 AI 서비스를 묶은 지표를 전기 1kWh처럼 단일 상품의 가격으로 읽기 어려움
특히 원문은 집계 격자 설정을 바꾼 사례에서 42.9~58.0%라는 분기별 추정 범위를 보여줍니다. 또한 2026년 9월 수정에서 다른 변혁 기술의 가격과 비교할 때 서로 다른 성격의 재화를 비교하는 문제를 한계에 추가했습니다.[1]
9. Discussion and conclusion — 결론과 산업적 의미
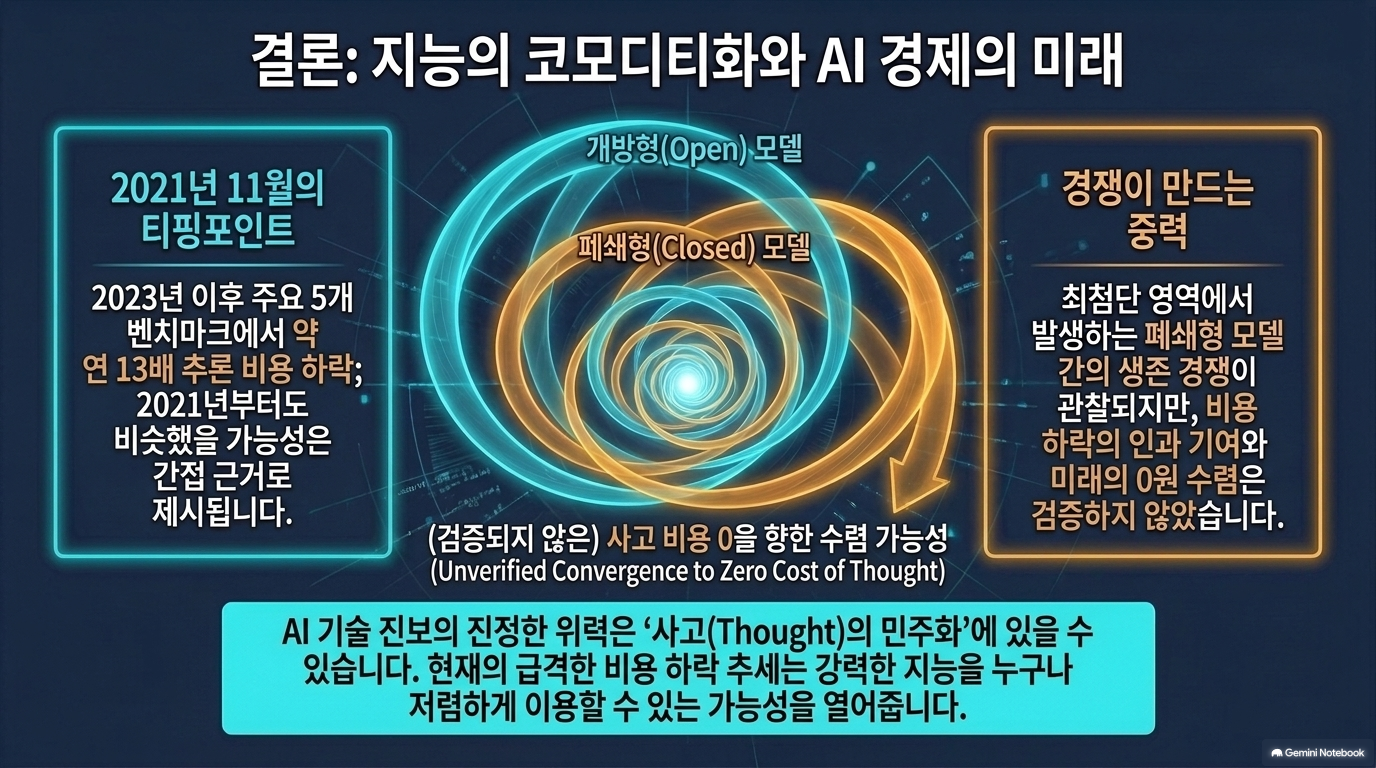
저자들은 2023년 이후 주요 5개 벤치마크의 약 47%/분기 하락을 핵심 결론으로 유지합니다. 상업적 LLM 추론이 시작된 2021년부터도 비슷한 속도였을 가능성을 제기하지만, 그 이전 기간을 뒷받침하는 근거는 주 분석과 달리 더 거친 토큰 가격·성능 비교입니다. 두 기간을 동일한 강도의 실증 결과로 취급해서는 안 됩니다.[1]
전기·배터리·컴퓨팅·DNA 시퀀싱보다 빠른 하락이라는 비교는 현상의 규모를 전달합니다. 산업적으로는 특정 최고 성능 모델의 가격 프리미엄이 오래 유지되기 어려울 수 있다는 시사점을 냅니다. 다만 저자들도 그 산업 역학 자체는 연구 범위를 벗어난다고 밝힙니다.[1]
10. Appendix / Notes / Updates — 본문 판단을 뒷받침하는 부분
Appendix는 시도했으나 채택하지 않은 확률적 프런티어 분석(SFA)과 성능 프런티어 모형의 결과를 제시합니다. SFA에서는 일부 벤치마크의 발전이 거의 없거나 비용이 오히려 상승한 것처럼 추정되어, 연구진은 빠르게 이동하는 프런티어와 성긴 평가 자료를 이 모형이 안정적으로 구별하지 못한다고 판단합니다. 이는 대안 모형을 시험했으나 결과가 불안정했다는 사실을 공개한 부분입니다.[1]
Notes는 GPQA 사례의 추측 정답률 보정, 일부 외부 평가 자료를 사용하지 못한 이유 등을 설명합니다. Updates에는 2026년 9월 23일의 문헌 추가와 ‘생각의 가격’ 개념에 관한 한계 보강이 기록돼 있습니다.[1]
종합 판단: 이 연구를 어떻게 활용할 것인가
이 연구의 가장 견고한 메시지는 “고정된 AI 성능 목표를 달성하는 최저 추론비용이 빠르게 떨어졌다”는 방향성입니다. 반면 정확히 분기당 47%가 앞으로도 지속된다, 실제 공공업무 처리비용도 연 13배씩 감소한다, 특정 공급자의 계약 단가가 같은 속도로 인하된다는 결론은 이 글의 자료만으로 도출할 수 없습니다.[1]
공공 AI 사업에 적용한다면 고정 모델의 토큰당 단가만 비교하기보다, 동일한 업무 평가셋·품질 기준 아래의 적격 처리건당 비용을 비교하는 것이 이 연구의 문제의식에 가깝습니다. 재시도, 사람 검수, 보안·운영 비용을 더해 별도로 측정해야 한다는 것은 본 연구의 측정 결과가 아니라 실무 적용을 위한 확장 제안입니다.
Sources
[1] https://epoch.ai/publications/the-plunging-price-of-thought — Epoch AI, The plunging price of thought


'07.AI > 4.AI 비용' 카테고리의 다른 글
| 네오 클라우드 - 크루소(Crusoe), 전력부터 실제 AI 서비스까지 누가 빠르고 안정적으로 연결하는가 (0) | 2026.10.05 |
|---|---|
| 토큰 경제 - BCG, AI 컴퓨팅 파워는 상품이 되고 있는가? (0) | 2026.10.03 |
| LLM - 추론 최적화 - StreamingLLM : 어텐션 싱크(Attention Sink)를 활용한 효율적인 스트리밍 언어 모델 (0) | 2026.09.18 |
| LLM - 추론 최적화 - 어텐션 싱크(Attention Sink)와 정보 검색 불균형 (0) | 2026.09.18 |
| LLM - 추론 최적화 - AnchorKV: 앵커-잔여 KV 캐시 압축 (0) | 2026.09.18 |