LLM - 추론 최적화 - StreamingLLM : 어텐션 싱크(Attention Sink)를 활용한 효율적인 스트리밍 언어 모델
07.AI/4.AI 비용 2026. 9. 18. 05:17반응형
https://arxiv.org/pdf/2309.17453
2024.4.7
[Efficient Streaming Language Models with Attention Sinks]
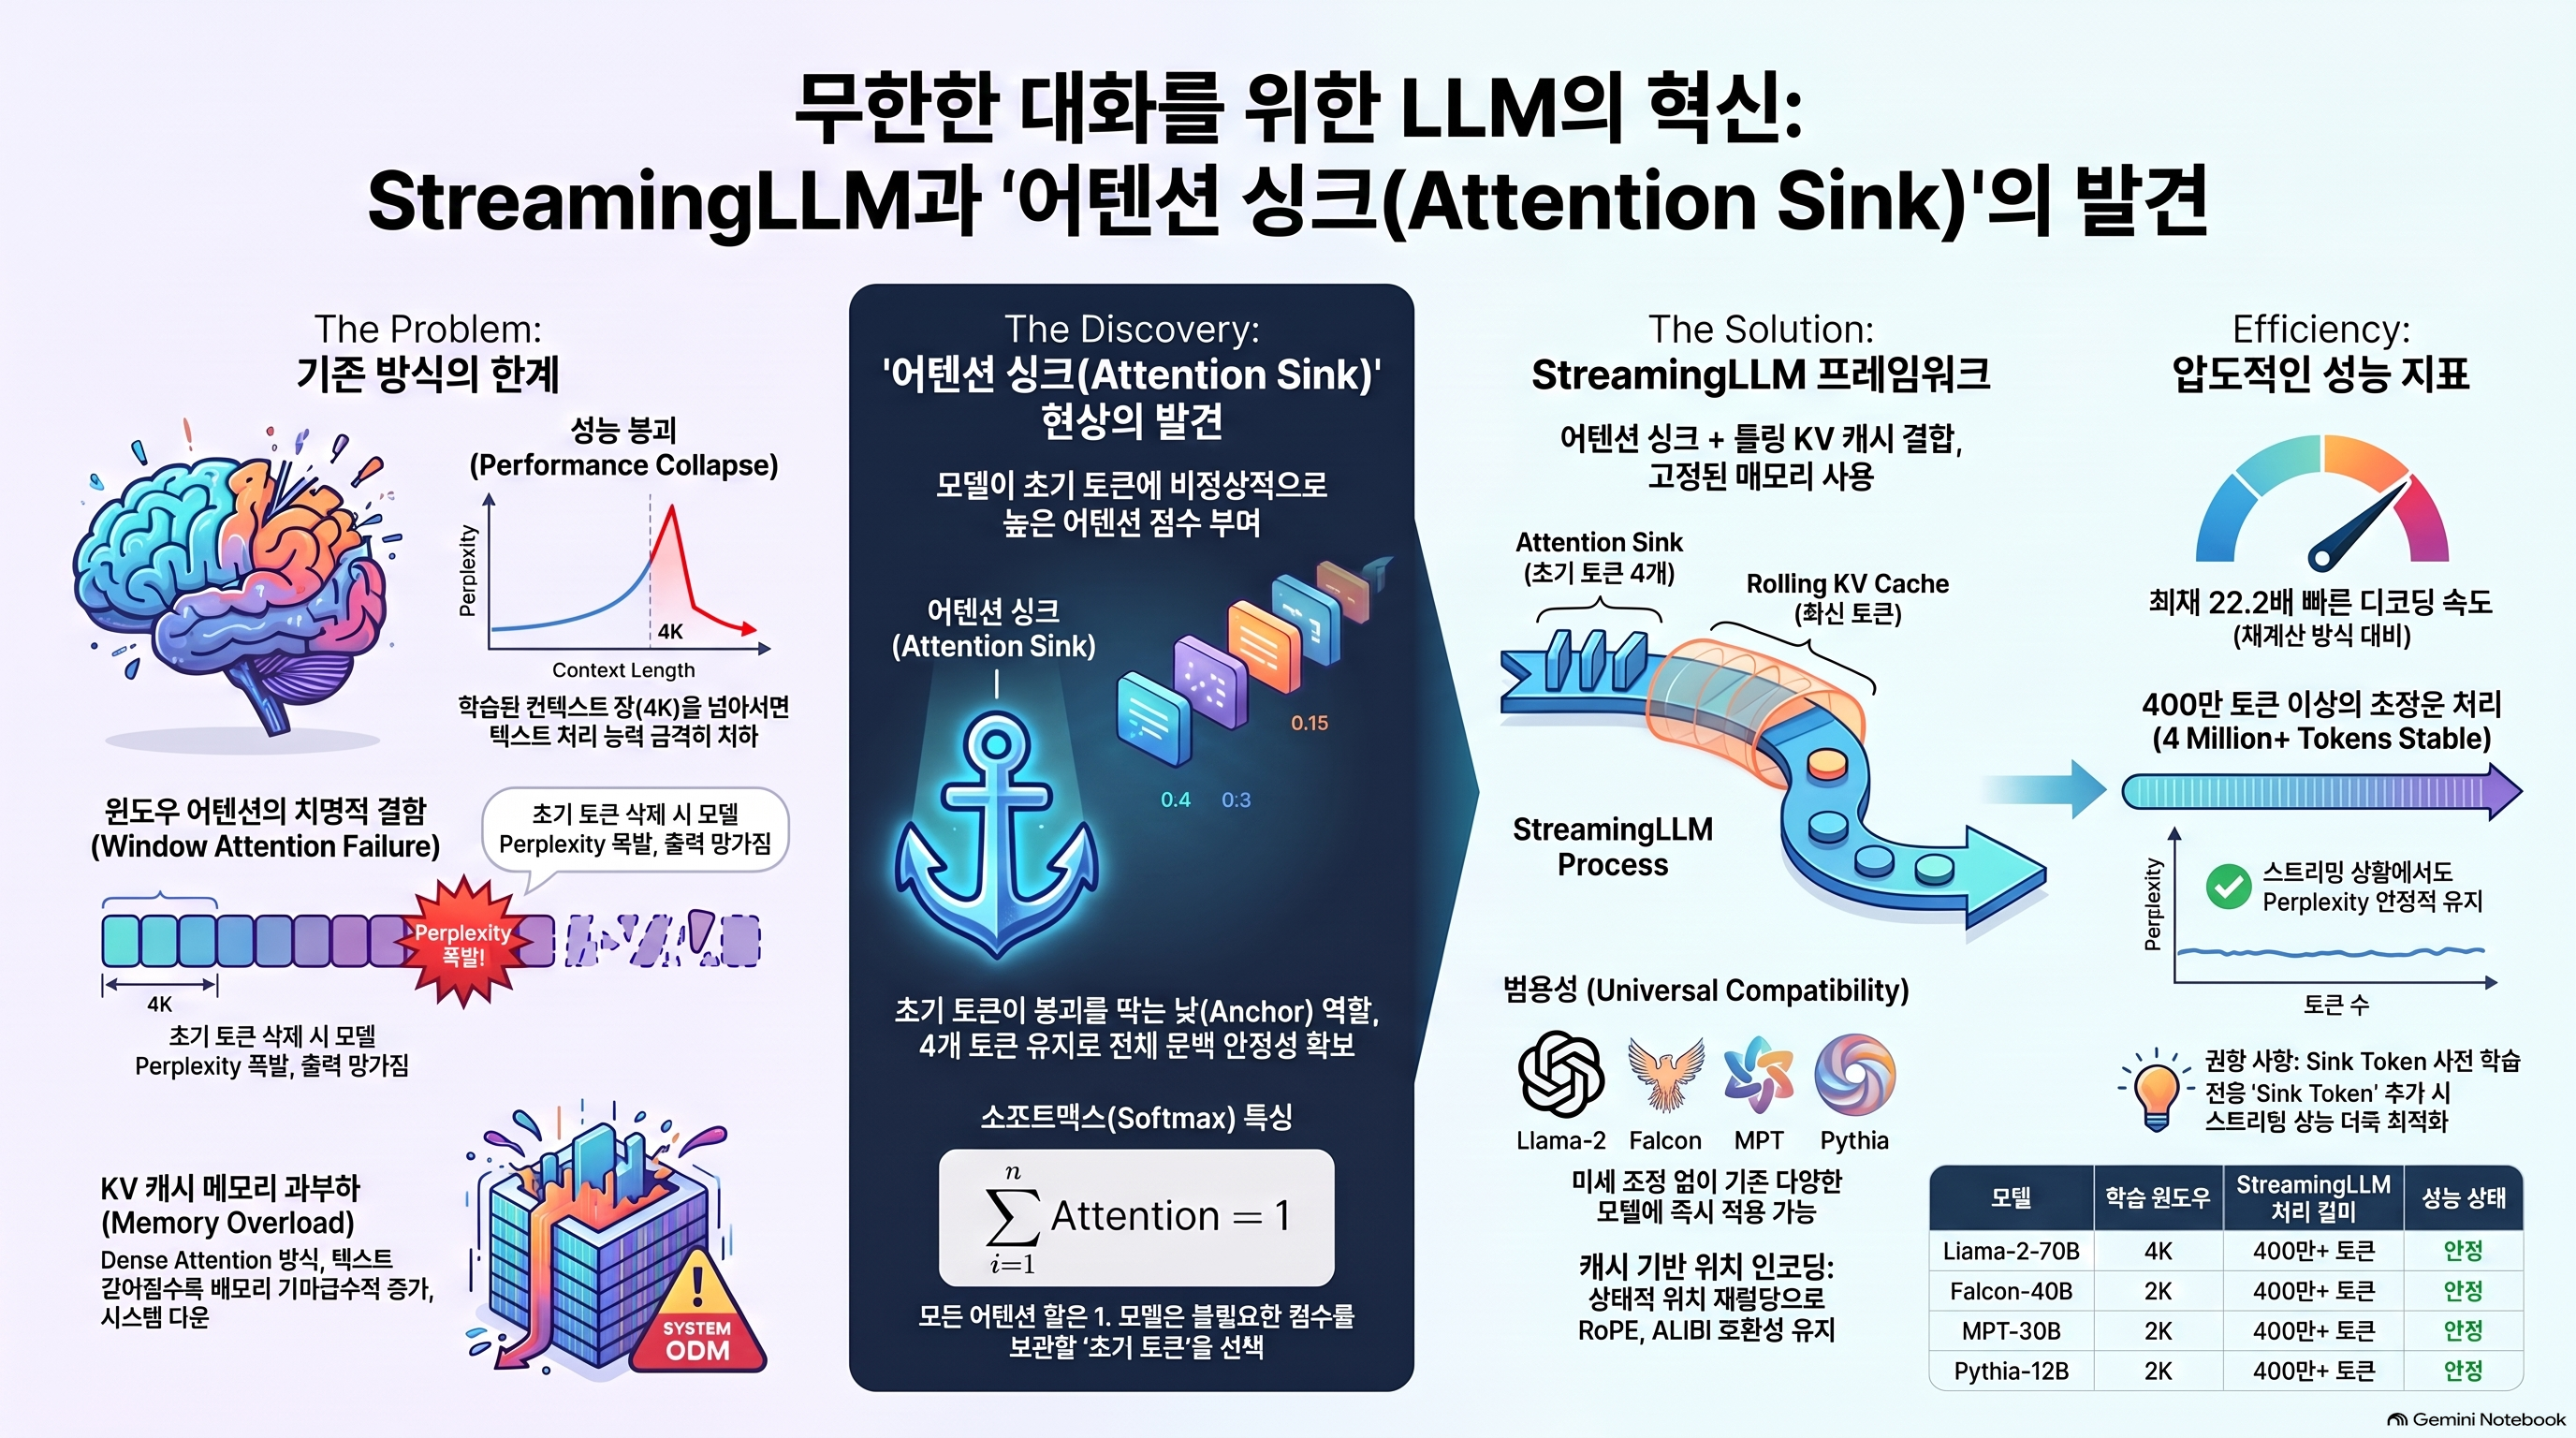
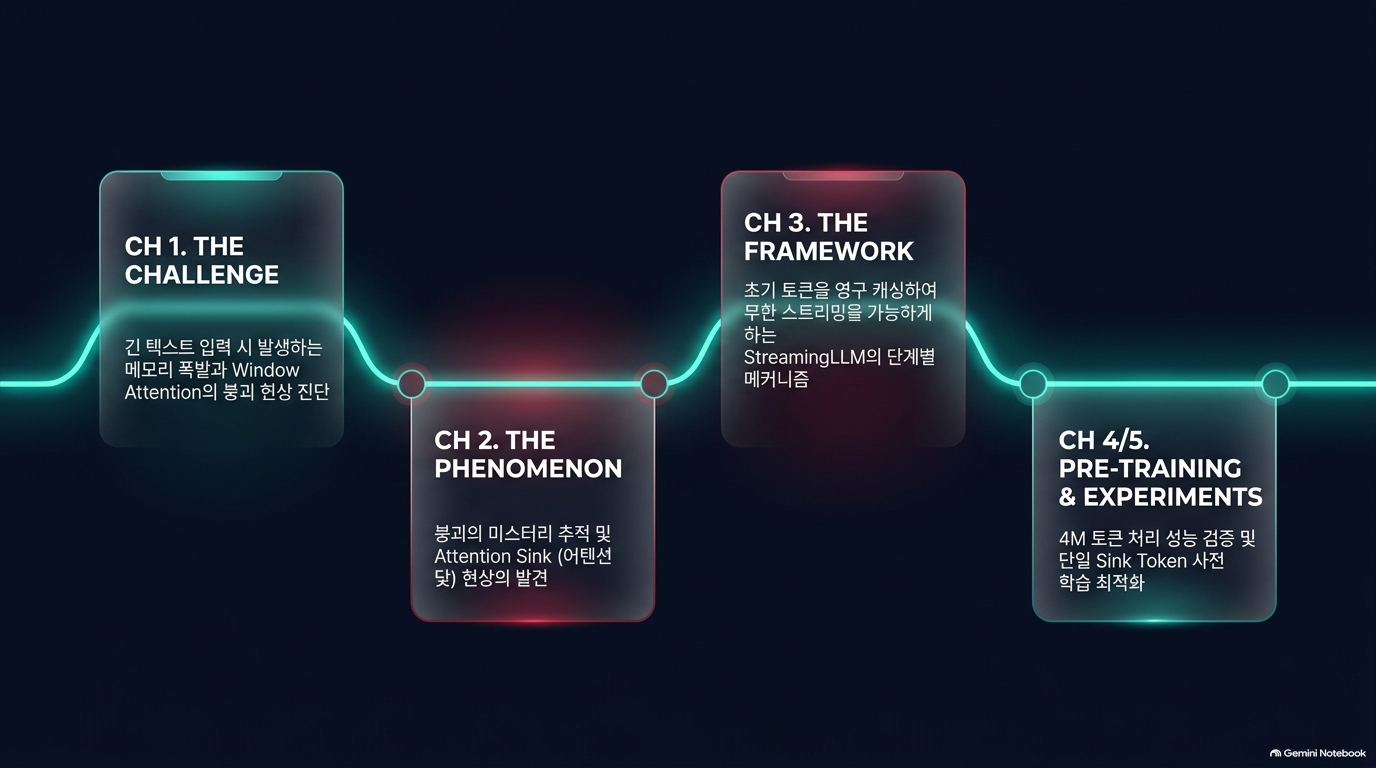
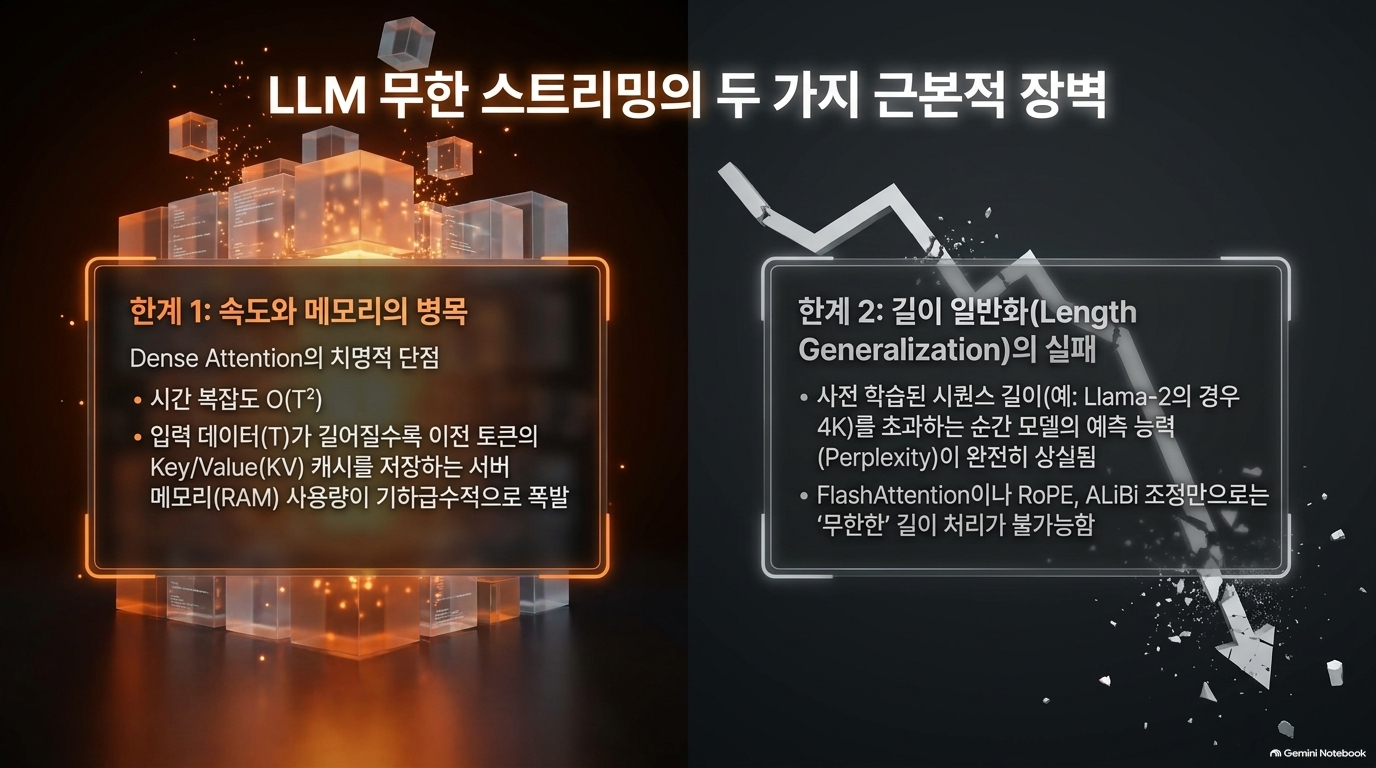
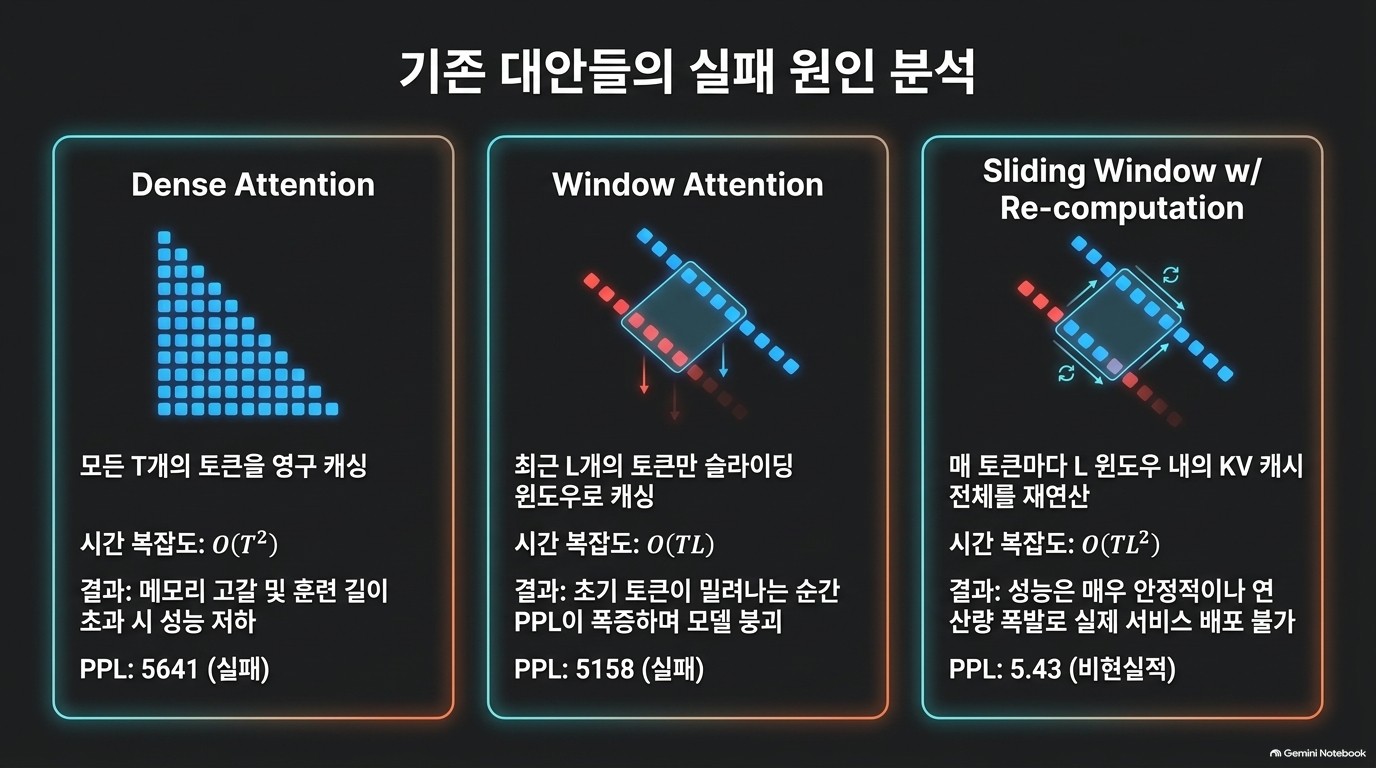
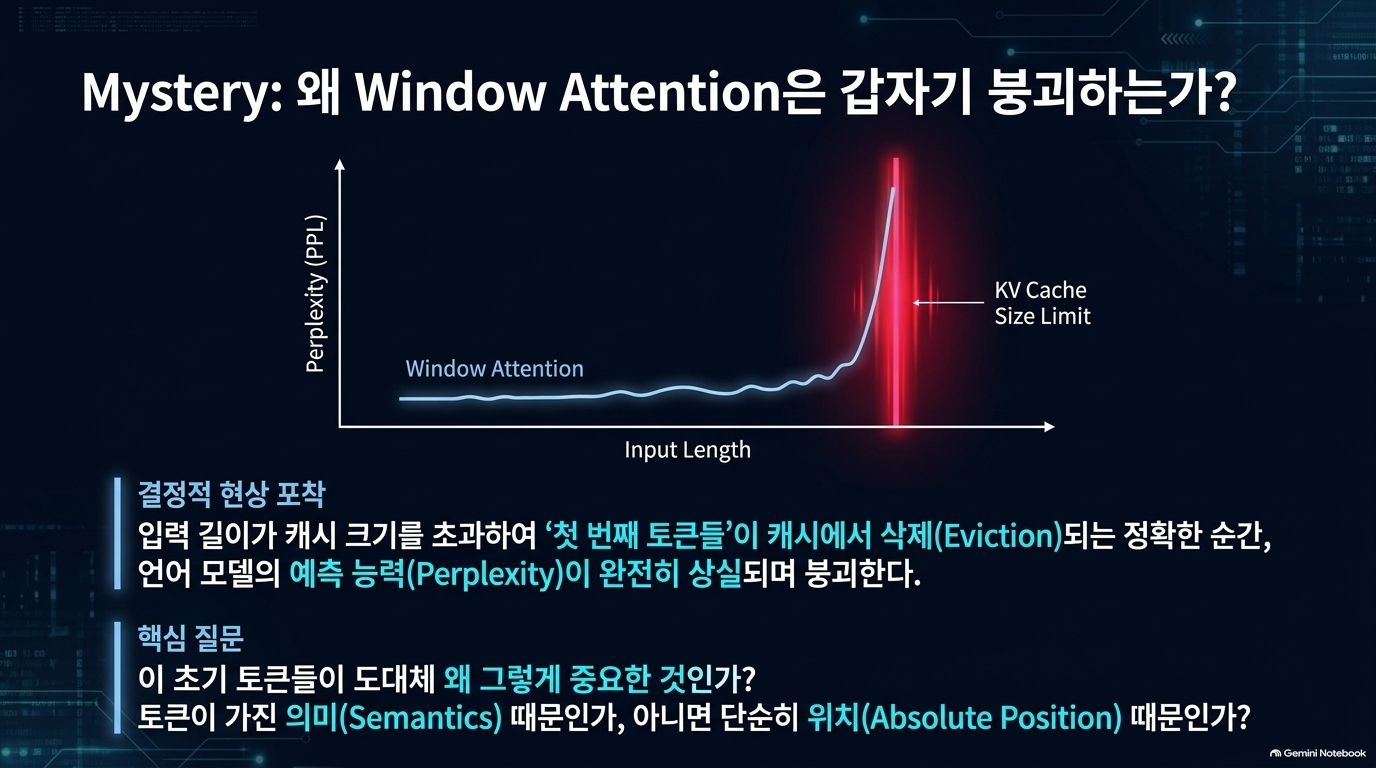
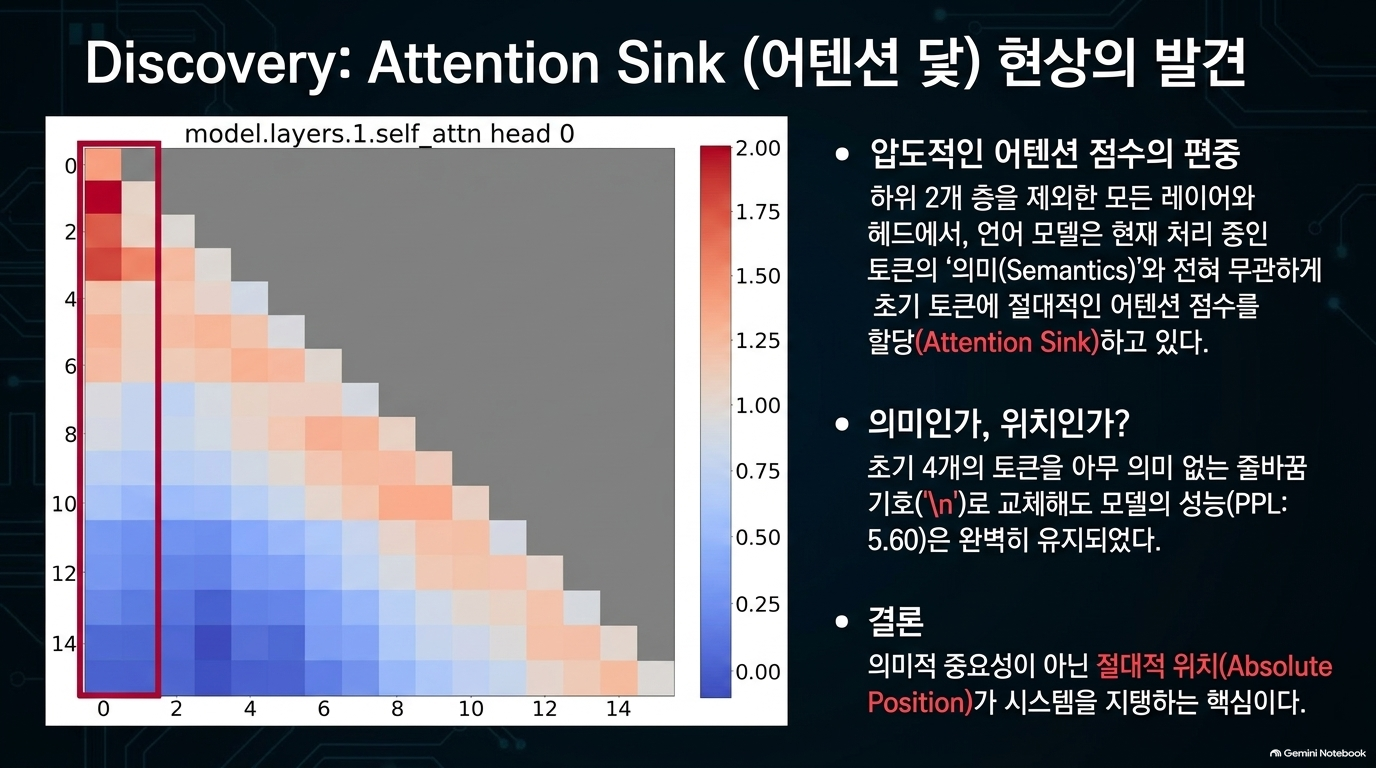
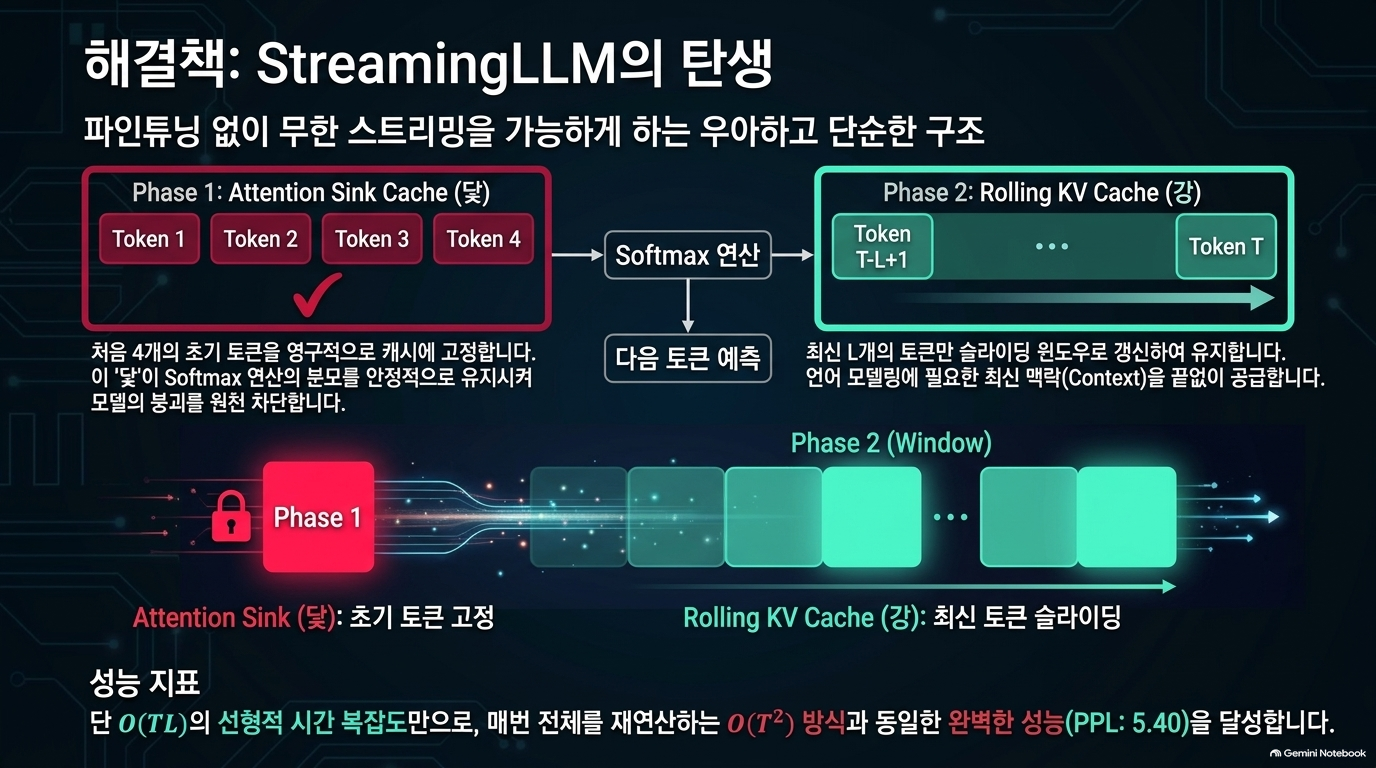
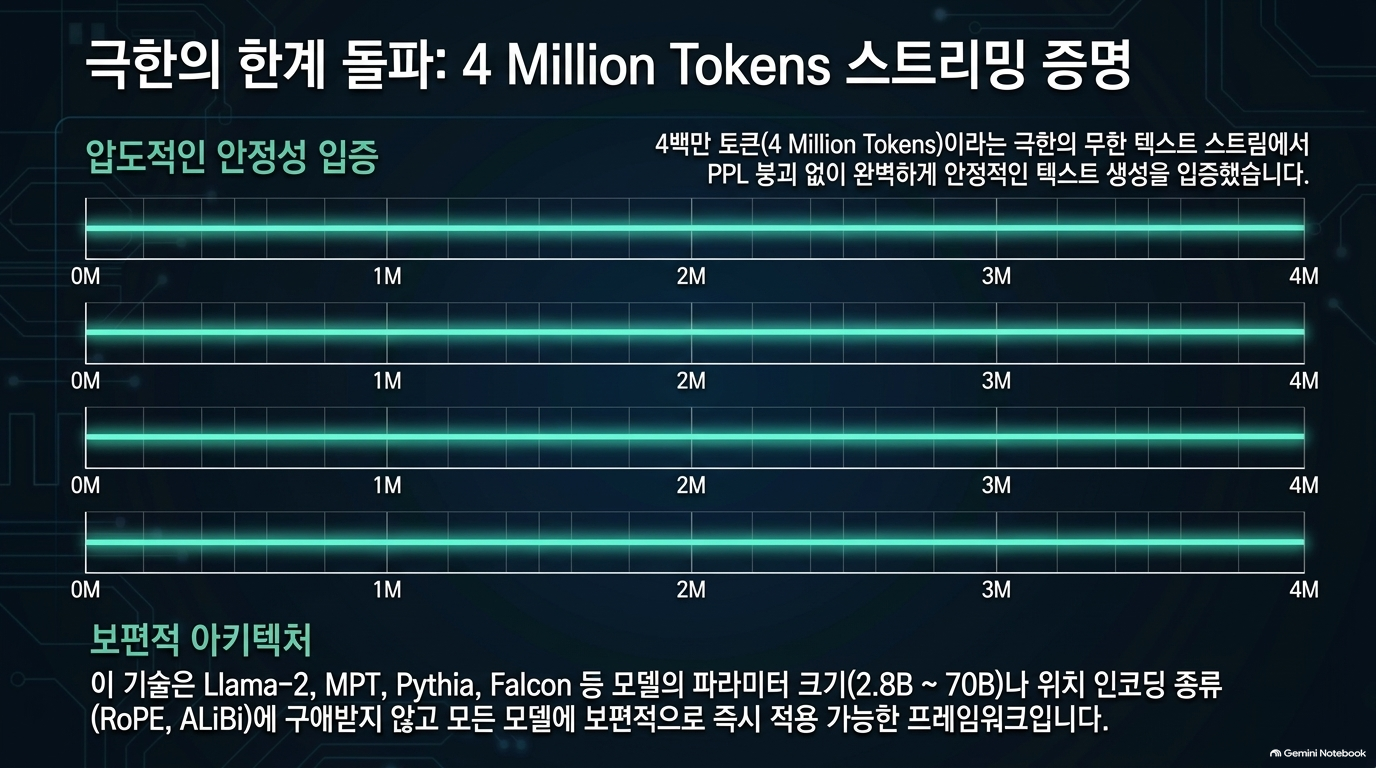
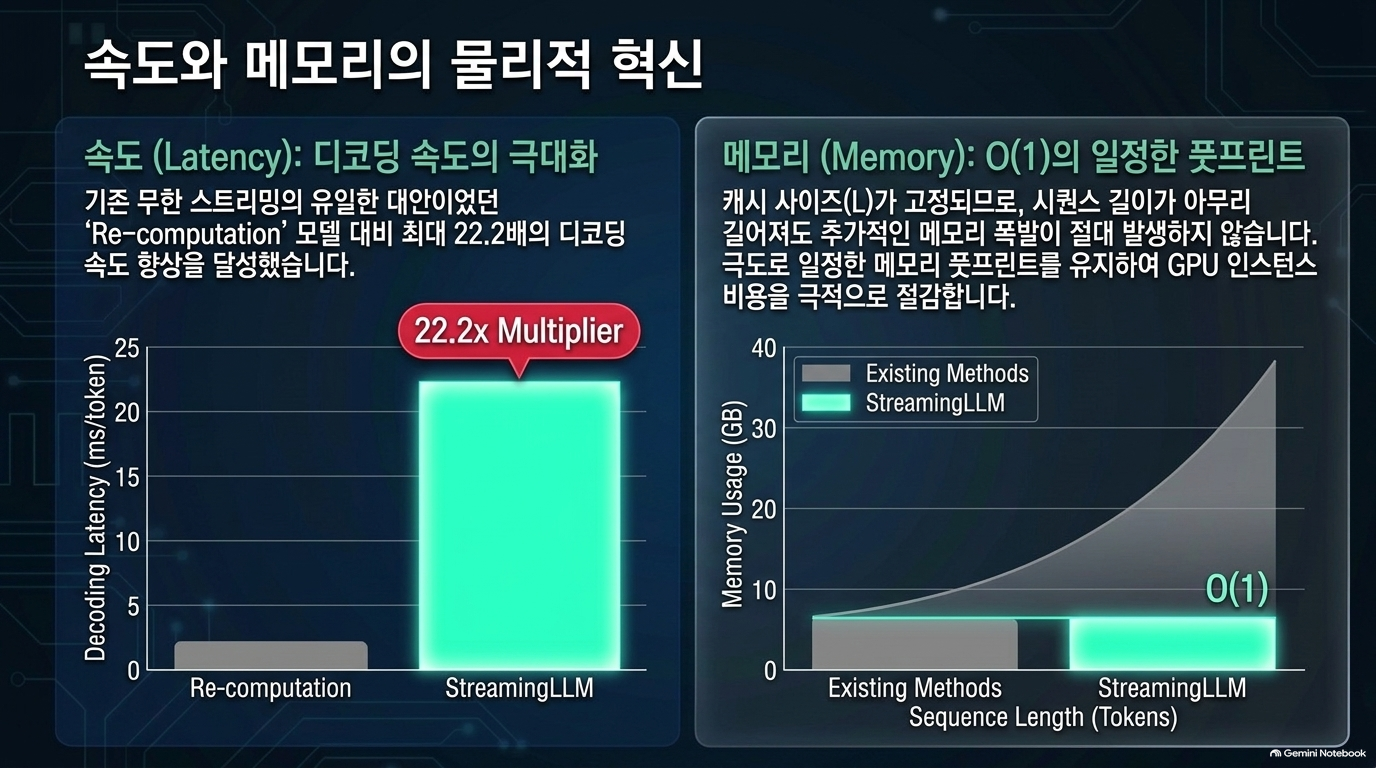
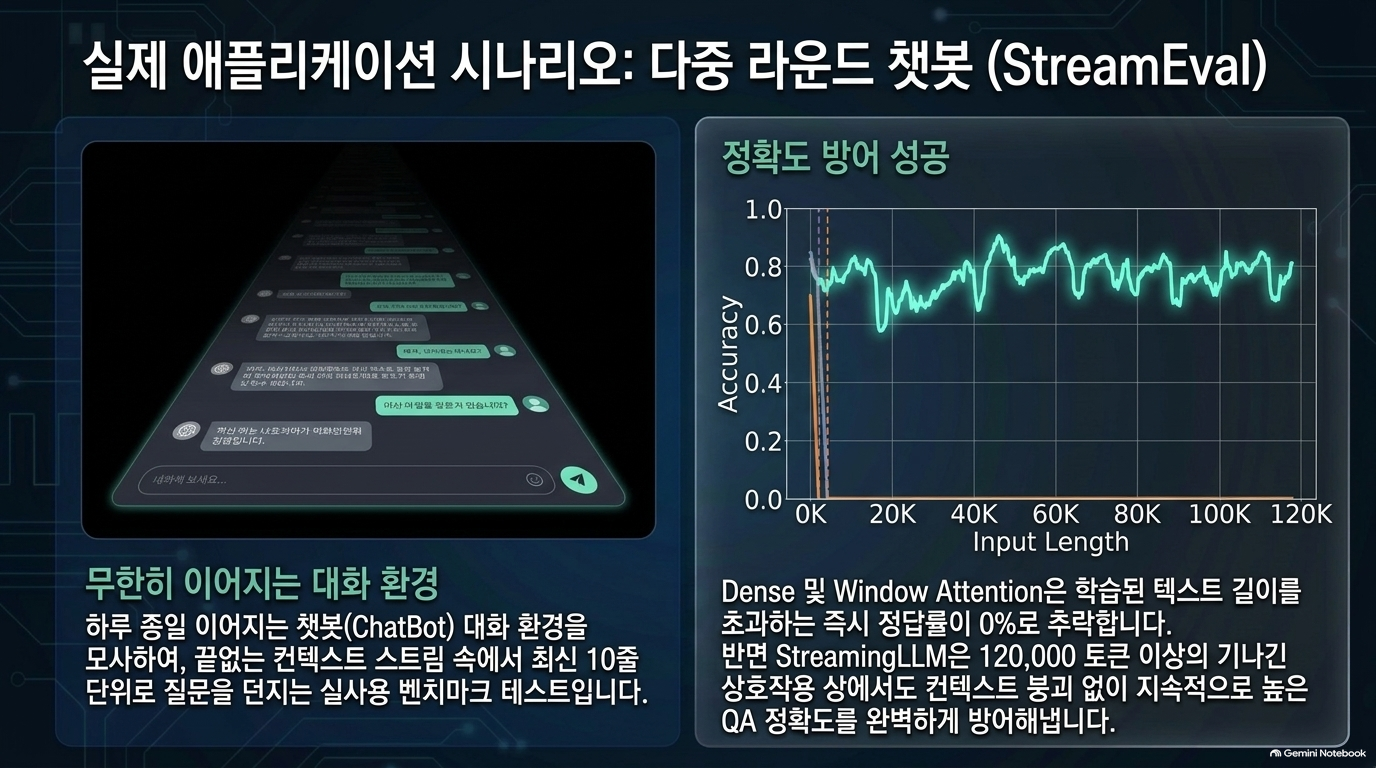
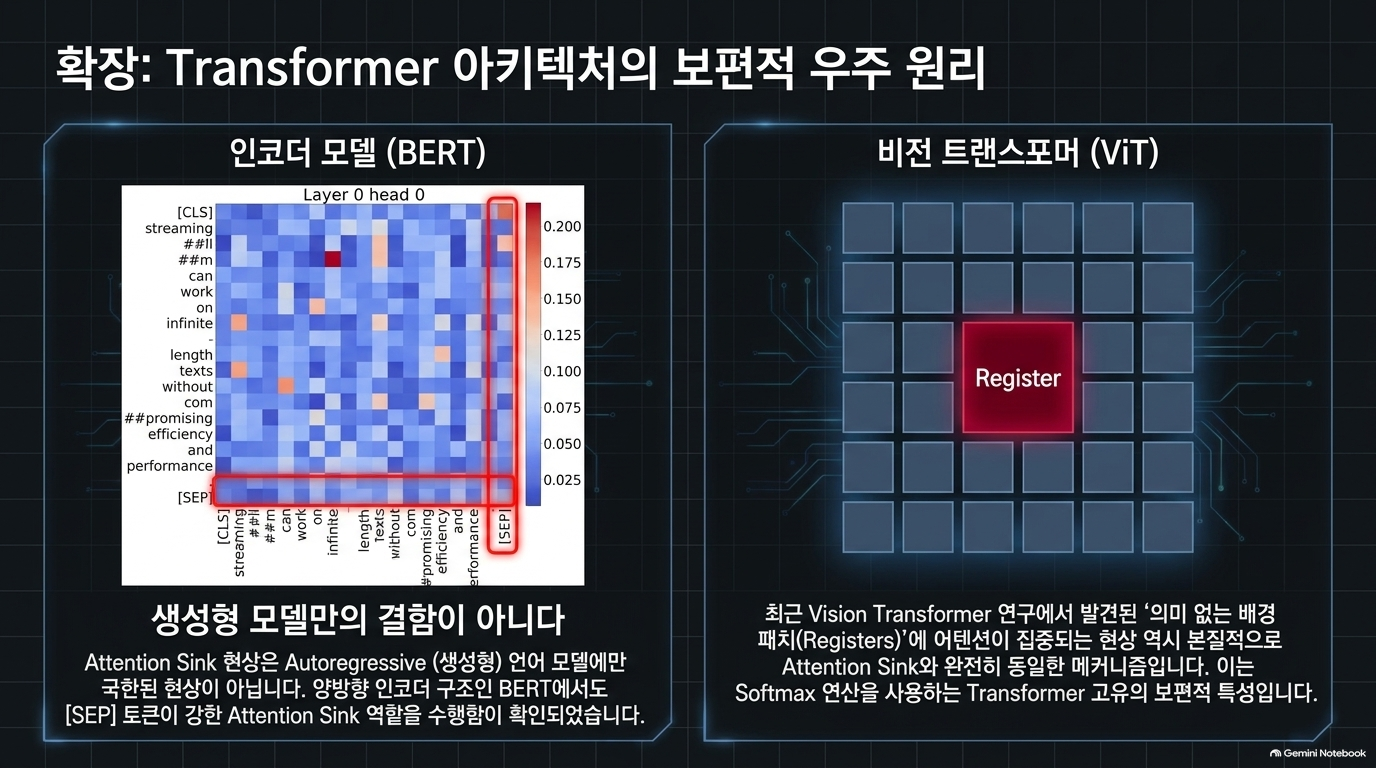
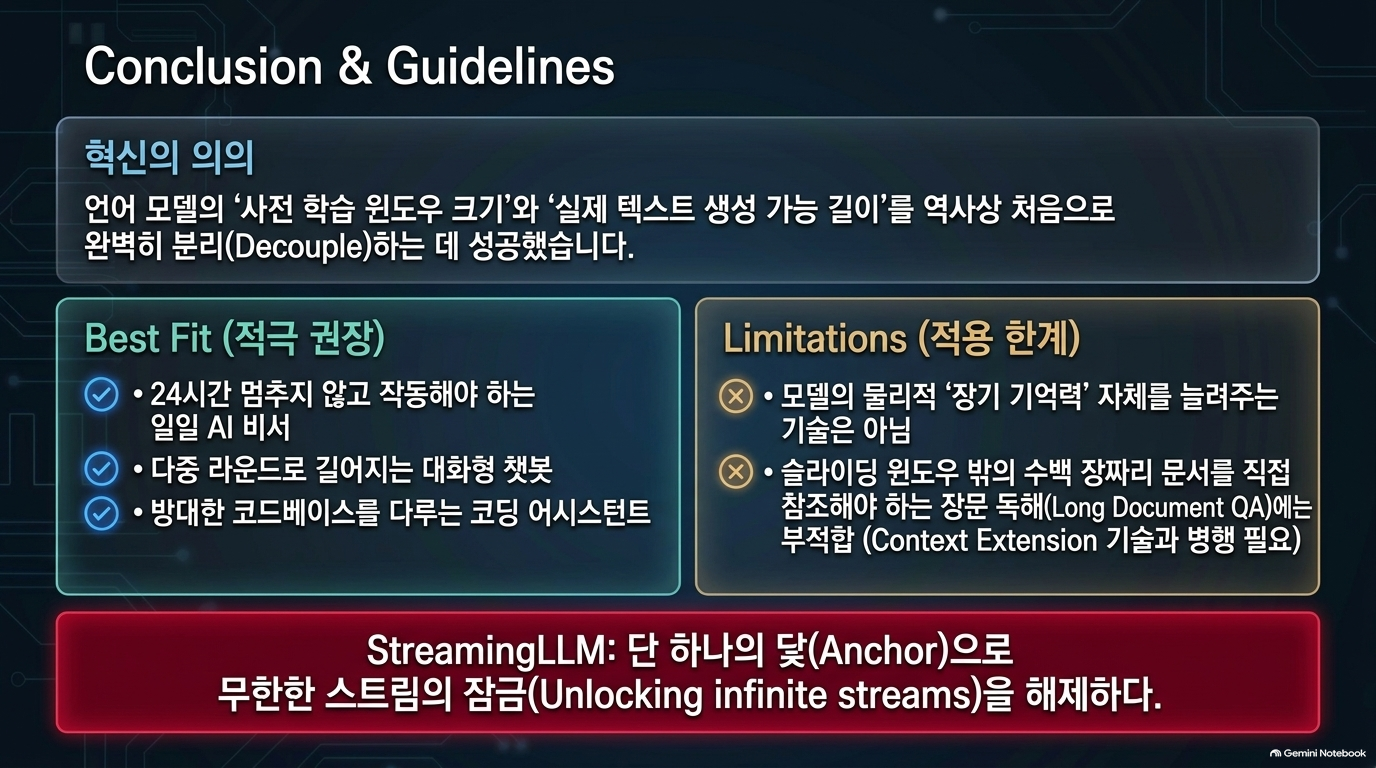
이 논문은 거대 언어 모델(LLM)이 사전 학습된 길이를 초과하는 무한한 텍스트 스트림을 처리할 때 발생하는 성능 저하와 메모리 병목 현상을 해결하기 위한 StreamingLLM 프레임워크를 제안합니다. 연구진은 모델이 의미와 상관없이 초기 토큰에 과도한 주의력을 집중한다는 어텐션 싱크(Attention Sink) 현상을 발견하였으며, 이를 보존하는 것이 긴 문맥에서도 모델의 안정성을 유지하는 핵심임을 밝혀냈습니다. StreamingLLM은 초기 토큰 일부와 최신 토큰의 KV 캐시만을 유지함으로써 추가적인 미세 조정 없이도 기존 방식보다 최대 22.2배 빠른 속도로 수백만 토큰을 효율적으로 처리할 수 있게 합니다. 결과적으로 이 연구는 모델 설계 시 학습된 문맥 창의 한계를 극복하고 실시간 대화나 장기적인 상호작용이 필요한 서비스에 LLM을 안정적으로 배치할 수 있는 실질적인 방안을 제시합니다.



728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| LLM - 추론 최적화 - 어텐션 싱크(Attention Sink)와 정보 검색 불균형 (0) | 2026.09.18 |
|---|---|
| LLM - 추론 최적화 - AnchorKV: 앵커-잔여 KV 캐시 압축 (0) | 2026.09.18 |
| LLM - 추론 최적화 - GPT-6 Astra, 루프형 트랜스포머(Looped Transformers) (0) | 2026.09.17 |
| 토큰 경제 - Brookings, 토큰 격차(token divide) 문제 (0) | 2026.09.16 |
| LLM - 추론 최적화 - 랜덤 어텐션: 효율적인 추론을 위한 KV 캐시 제거 재고 (0) | 2026.09.13 |