반응형
https://arxiv.org/pdf/2609.08574
https://github.com/sararizwan7/Attention-Mechanisms-in-1M-Context-Window
2026.9.8
[Do New Attention Mechanisms Actually Fix Attention Sinks at Million-Token Context?]
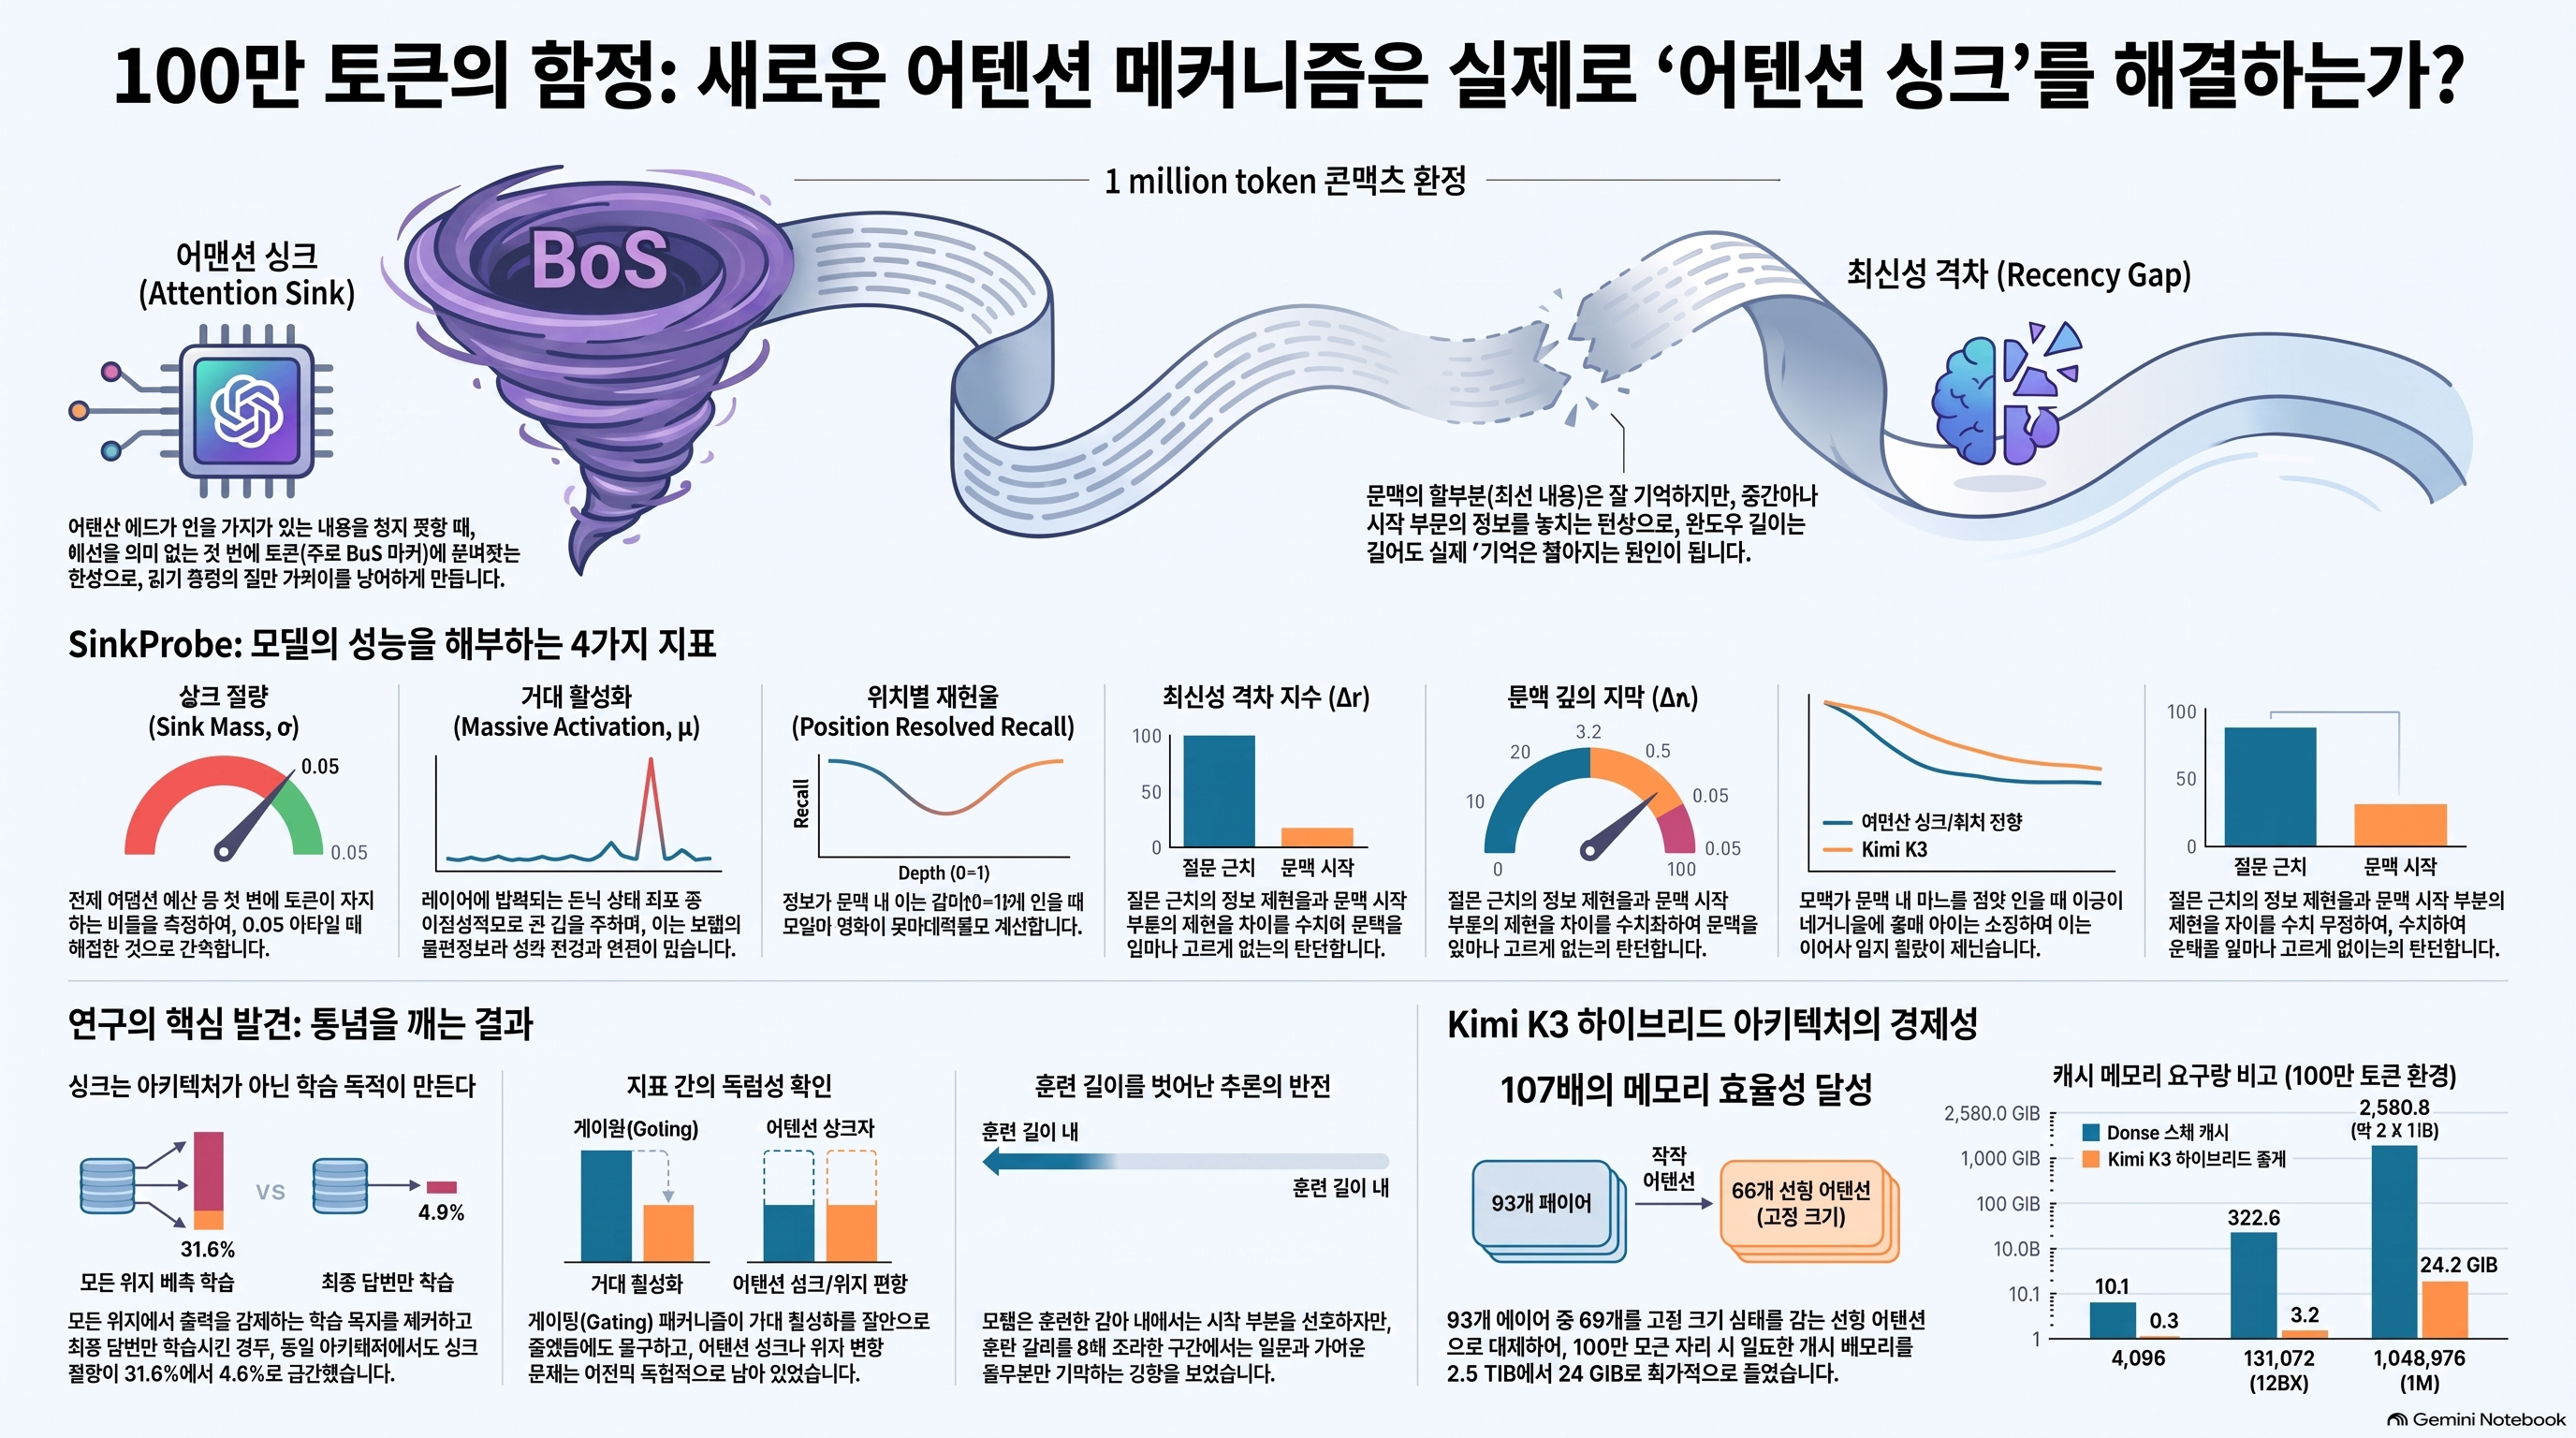
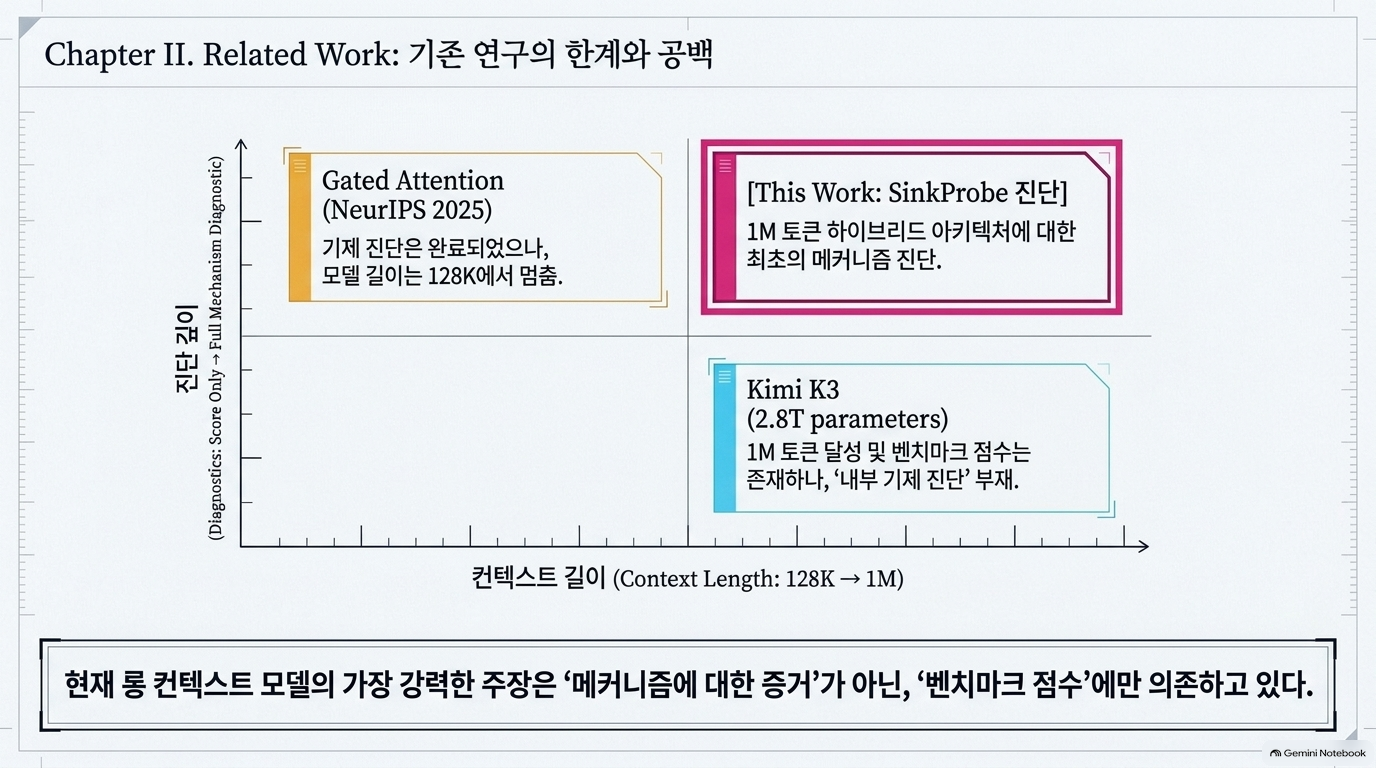
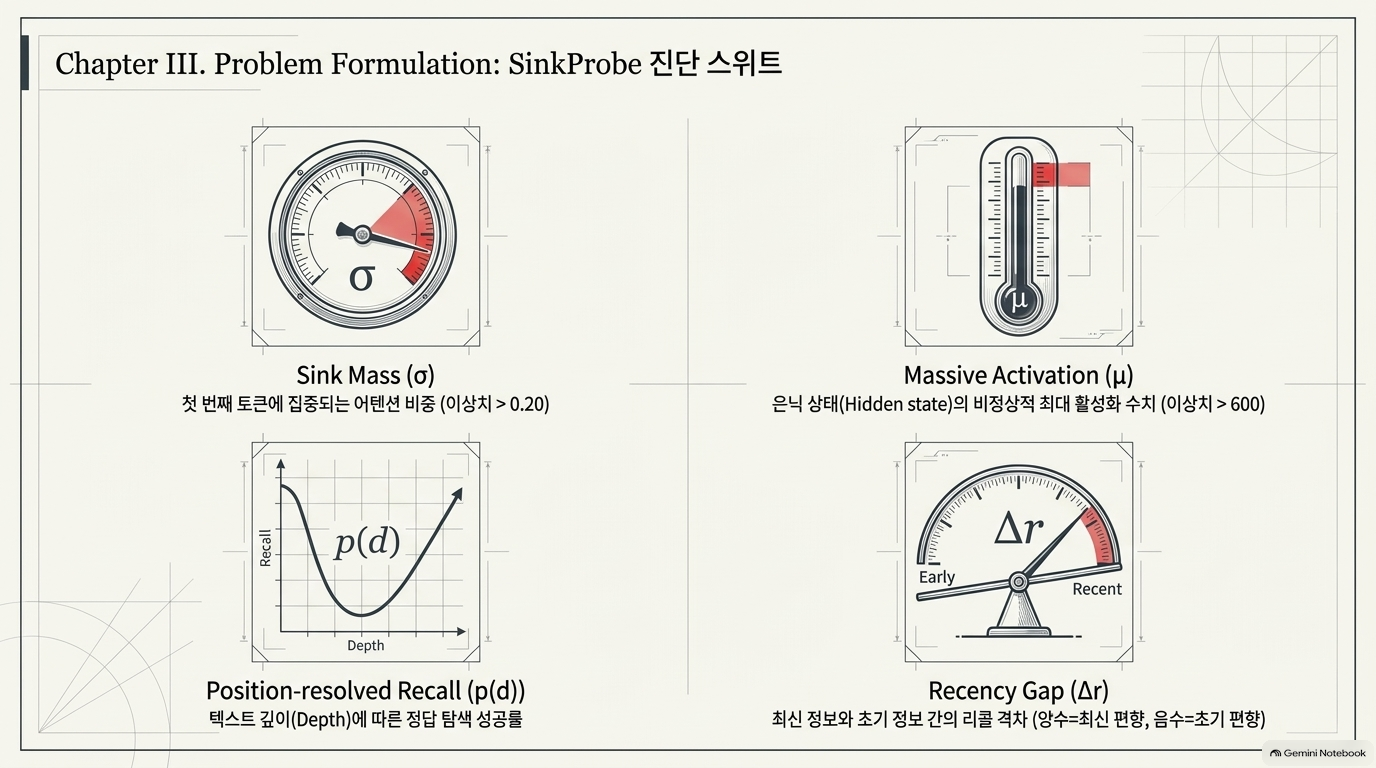
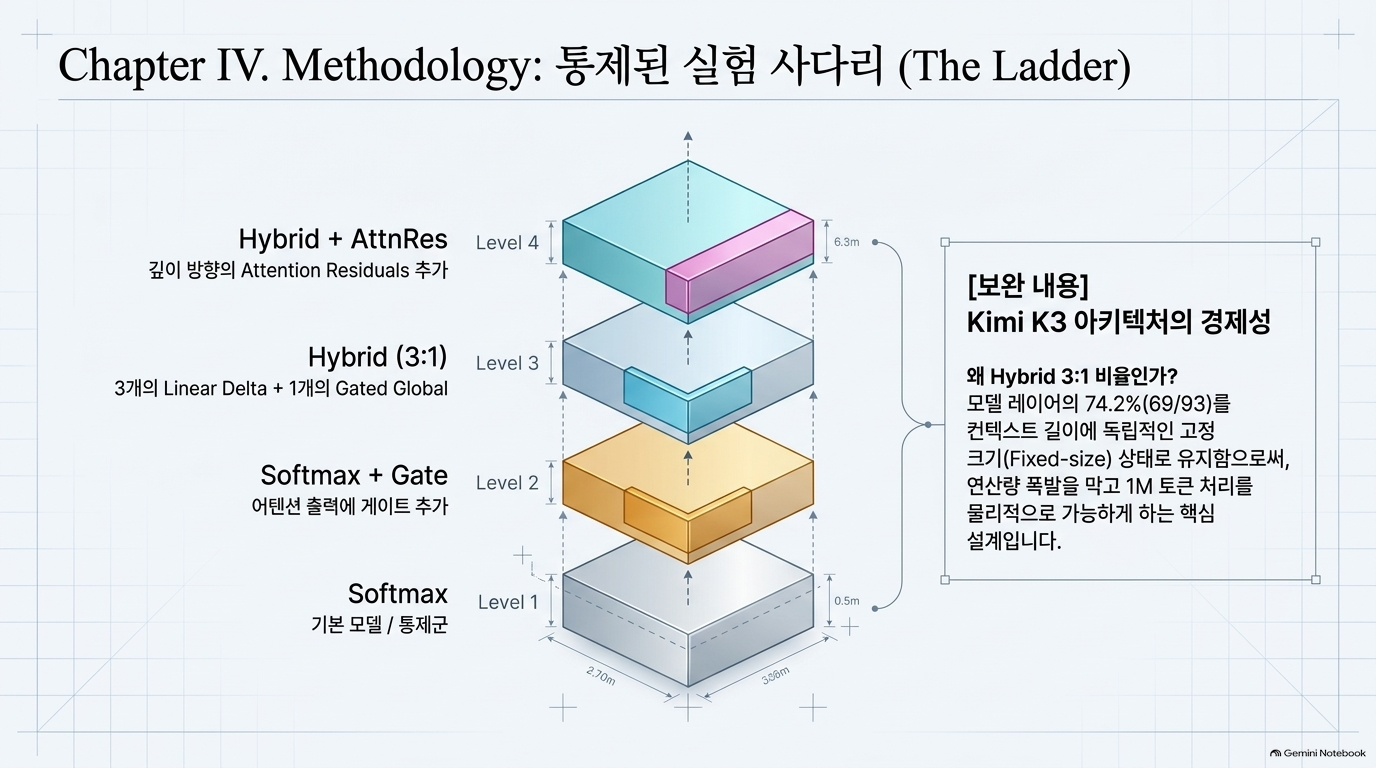
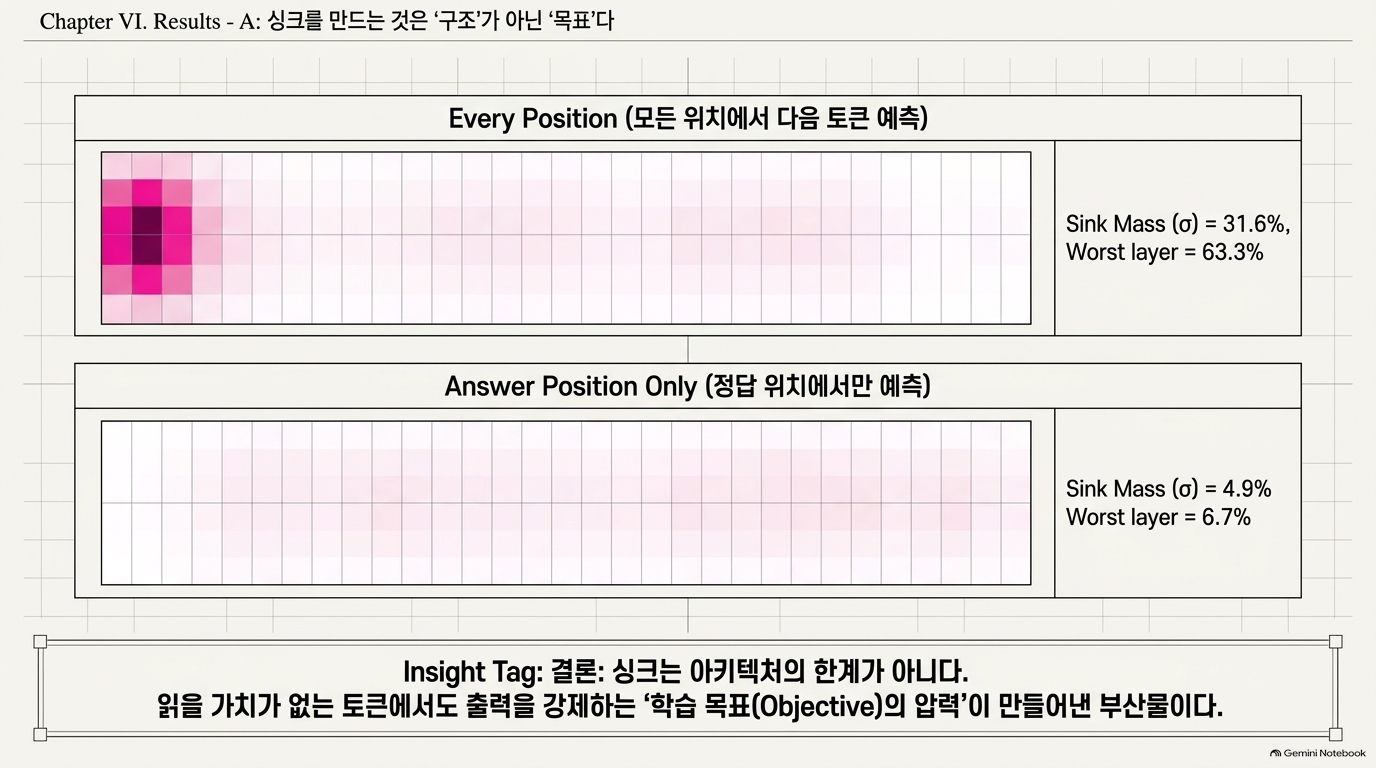
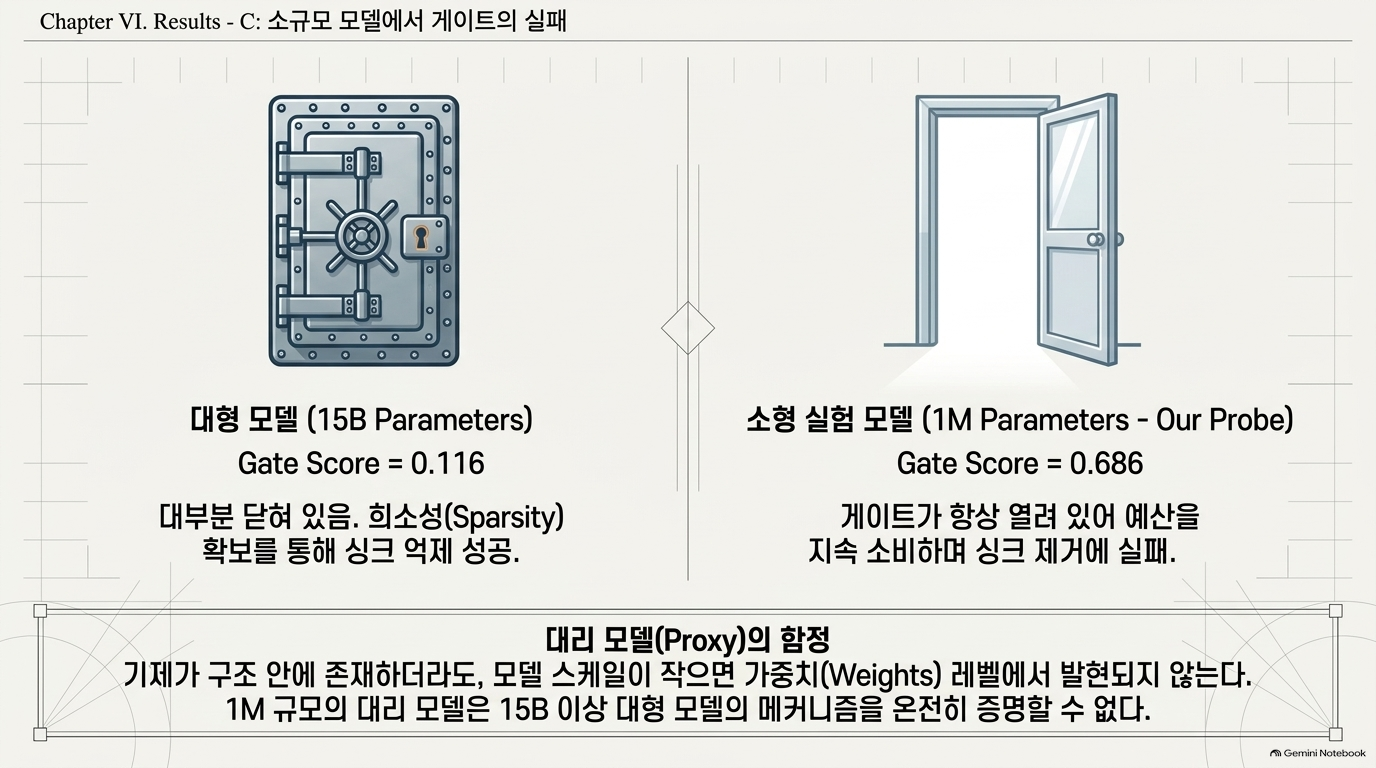
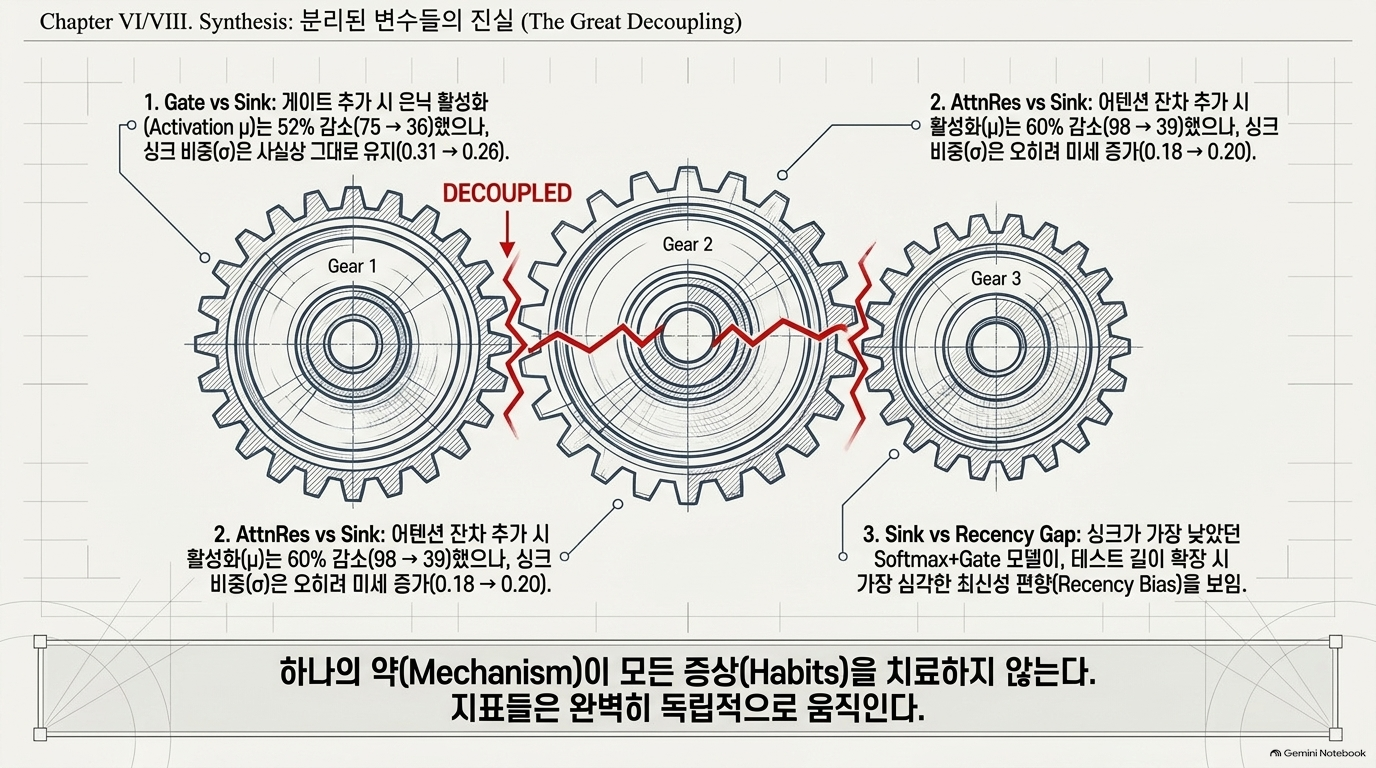
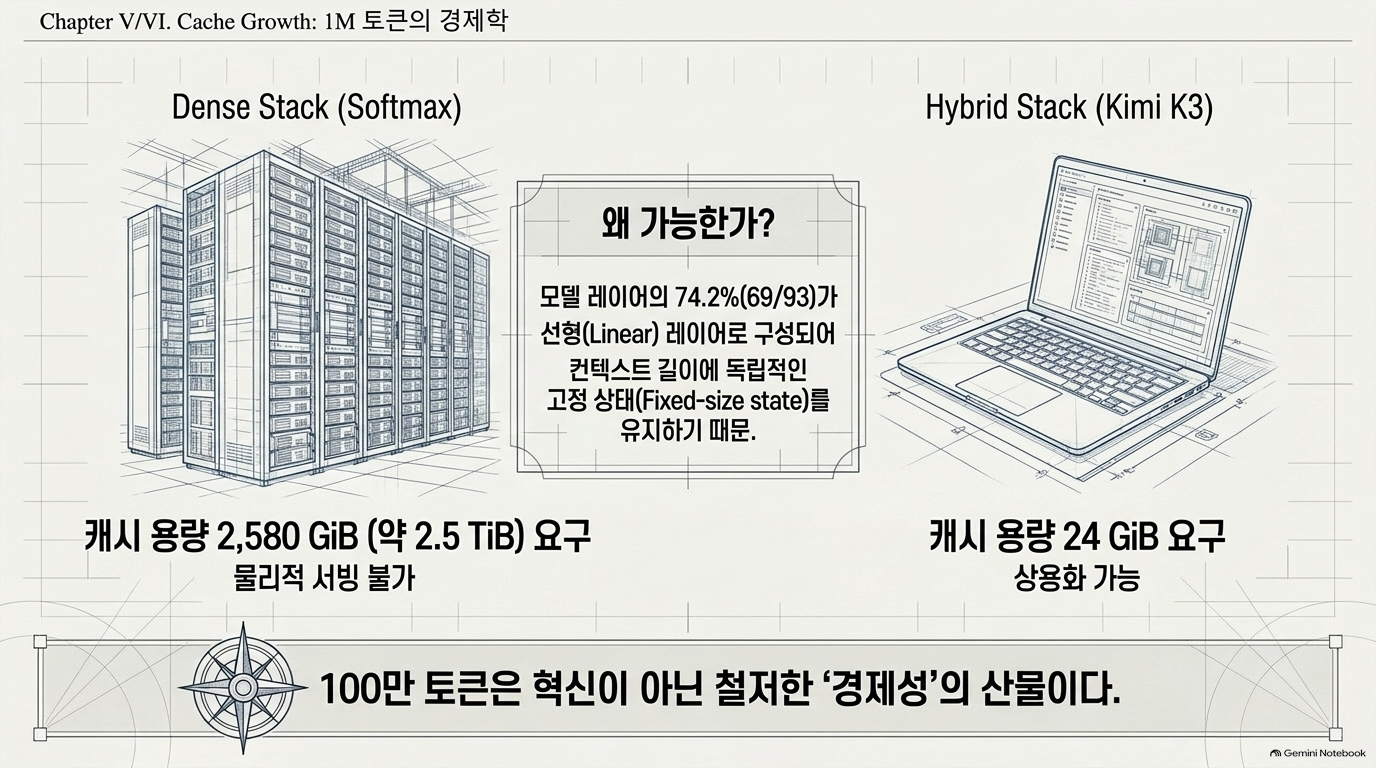
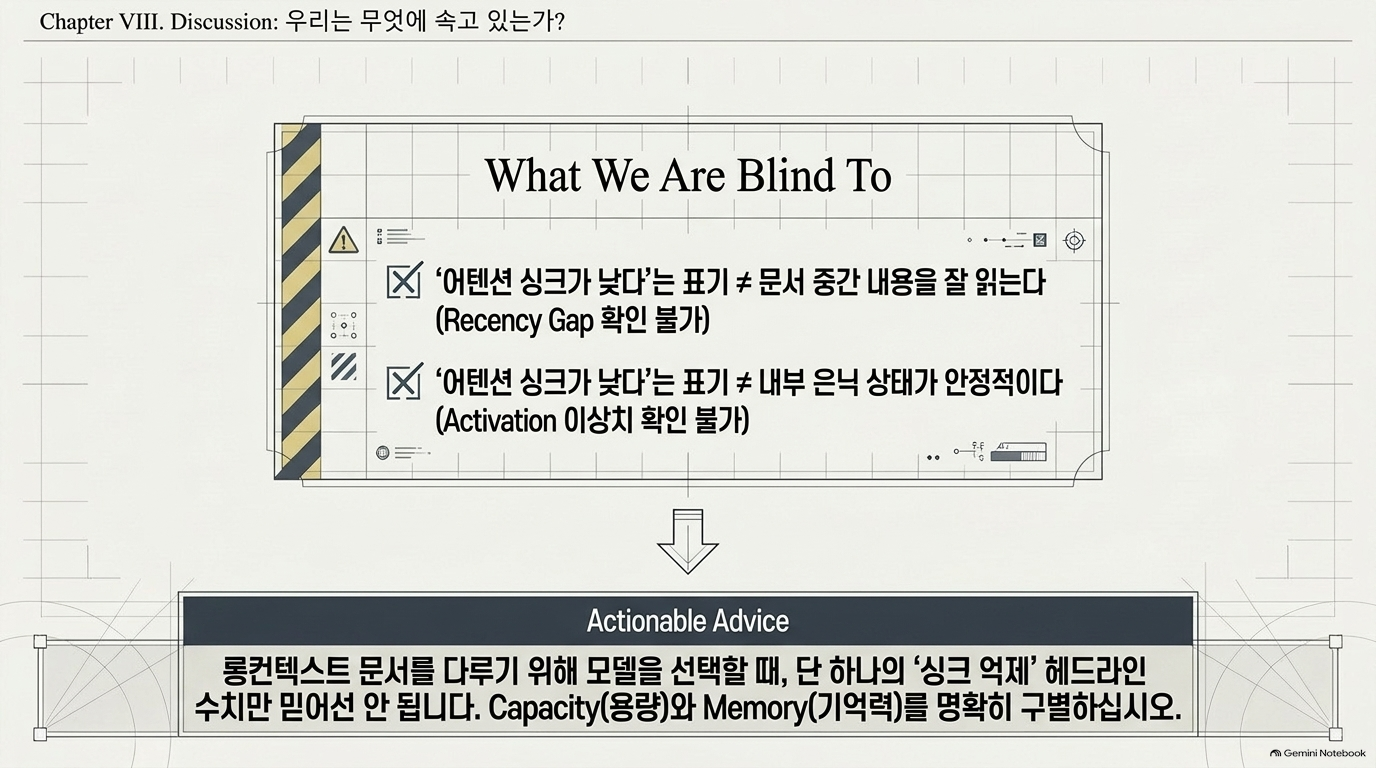
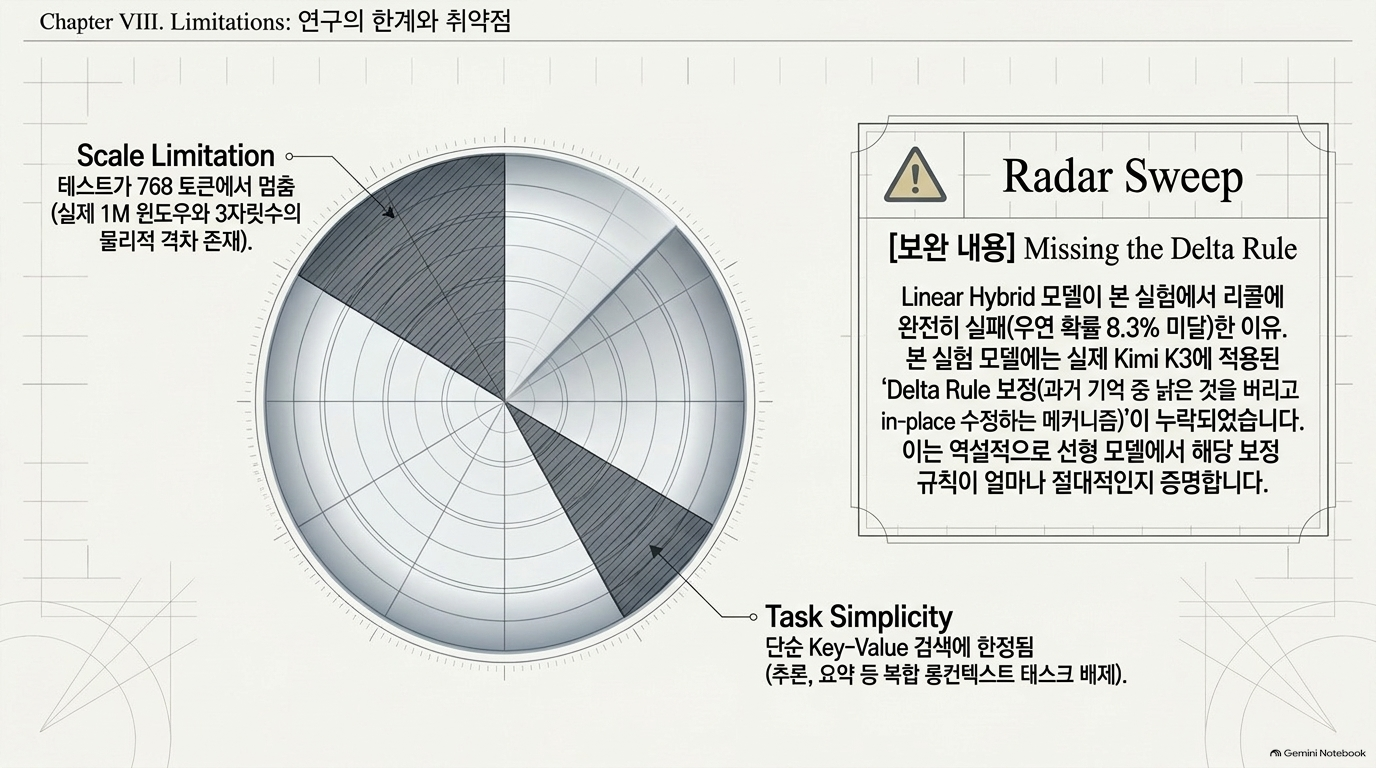
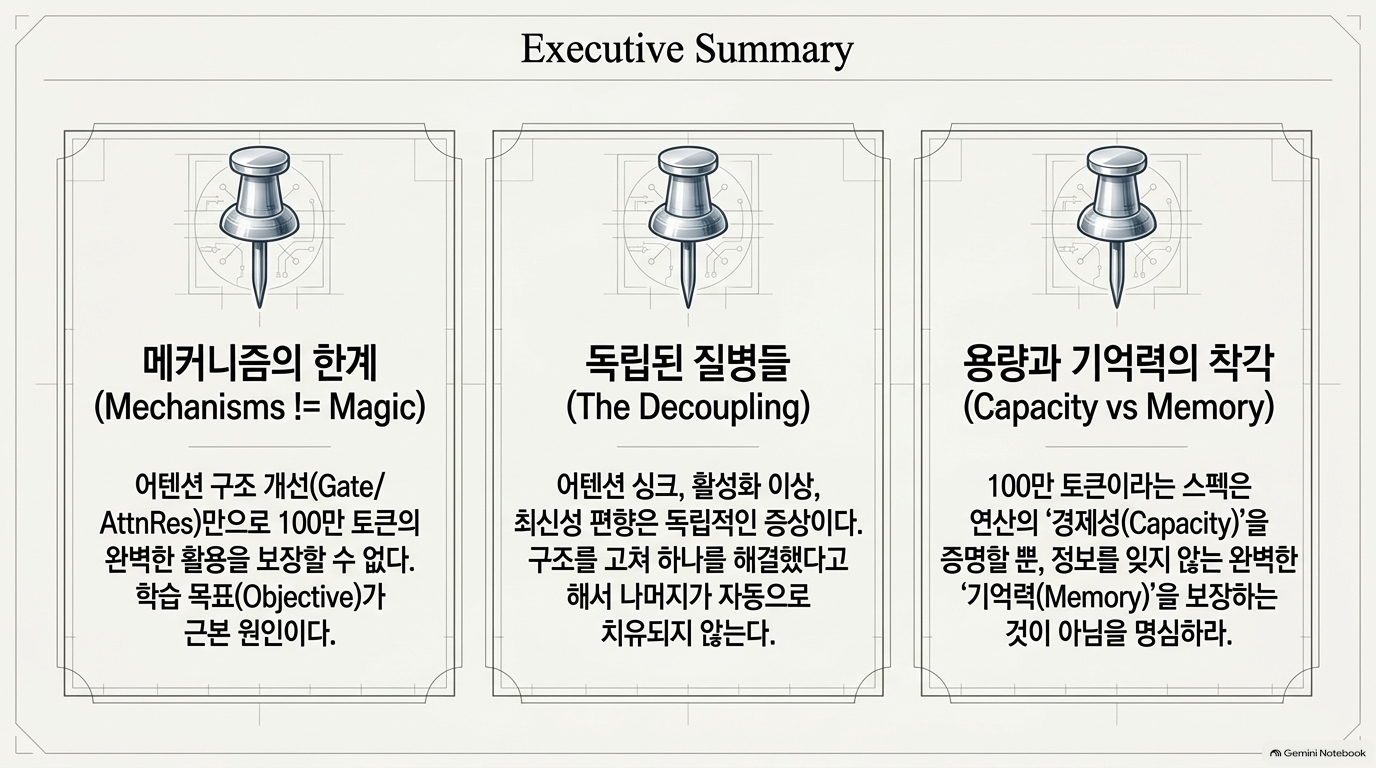
이 논문은 백만 토큰에 달하는 거대 문맥 언어 모델이 직면한 두 가지 핵심 결함인 어텐션 싱크(Attention Sink)와 정보 검색의 불균형 문제를 심층 분석합니다. 연구진은 모델이 무의미한 첫 번째 토큰에 주의력을 낭비하는 현상과 문맥의 위치에 따라 기억력이 감퇴하는 현상이 서로 독립적인 기제임을 실험적으로 증명하며, 기존의 게이팅이나 선형 어텐션 기술이 이러한 문제들을 실제로 해결하는지 검증하는 SinkProbe 진단 도구를 제안합니다. 실험 결과에 따르면 싱크 현상은 아키텍처 자체보다 학습 목적 함수에 의해 발생하며, 특정 지표가 개선되더라도 문맥 중앙의 정보를 놓치는 위치 편향은 여전히 해결되지 않은 과제로 남을 수 있음을 경고합니다. 결론적으로 이 연구는 모델의 가용 메모리와 실제 문맥 창 사이의 간극을 줄이기 위해 단순한 벤치마크 점수를 넘어선 정밀한 메커니즘 측정이 필수적임을 강조합니다.




728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| LLM - 추론 최적화 - StreamingLLM : 어텐션 싱크(Attention Sink)를 활용한 효율적인 스트리밍 언어 모델 (0) | 2026.09.18 |
|---|---|
| LLM - 추론 최적화 - AnchorKV: 앵커-잔여 KV 캐시 압축 (0) | 2026.09.18 |
| LLM - 추론 최적화 - GPT-6 Astra, 루프형 트랜스포머(Looped Transformers) (0) | 2026.09.17 |
| 토큰 경제 - Brookings, 토큰 격차(token divide) 문제 (0) | 2026.09.16 |
| LLM - 추론 최적화 - 랜덤 어텐션: 효율적인 추론을 위한 KV 캐시 제거 재고 (0) | 2026.09.13 |