https://arxiv.org/pdf/2608.02901
2026.8.3
[AnchorKV: Anchor-Residual KV Cache Compression]
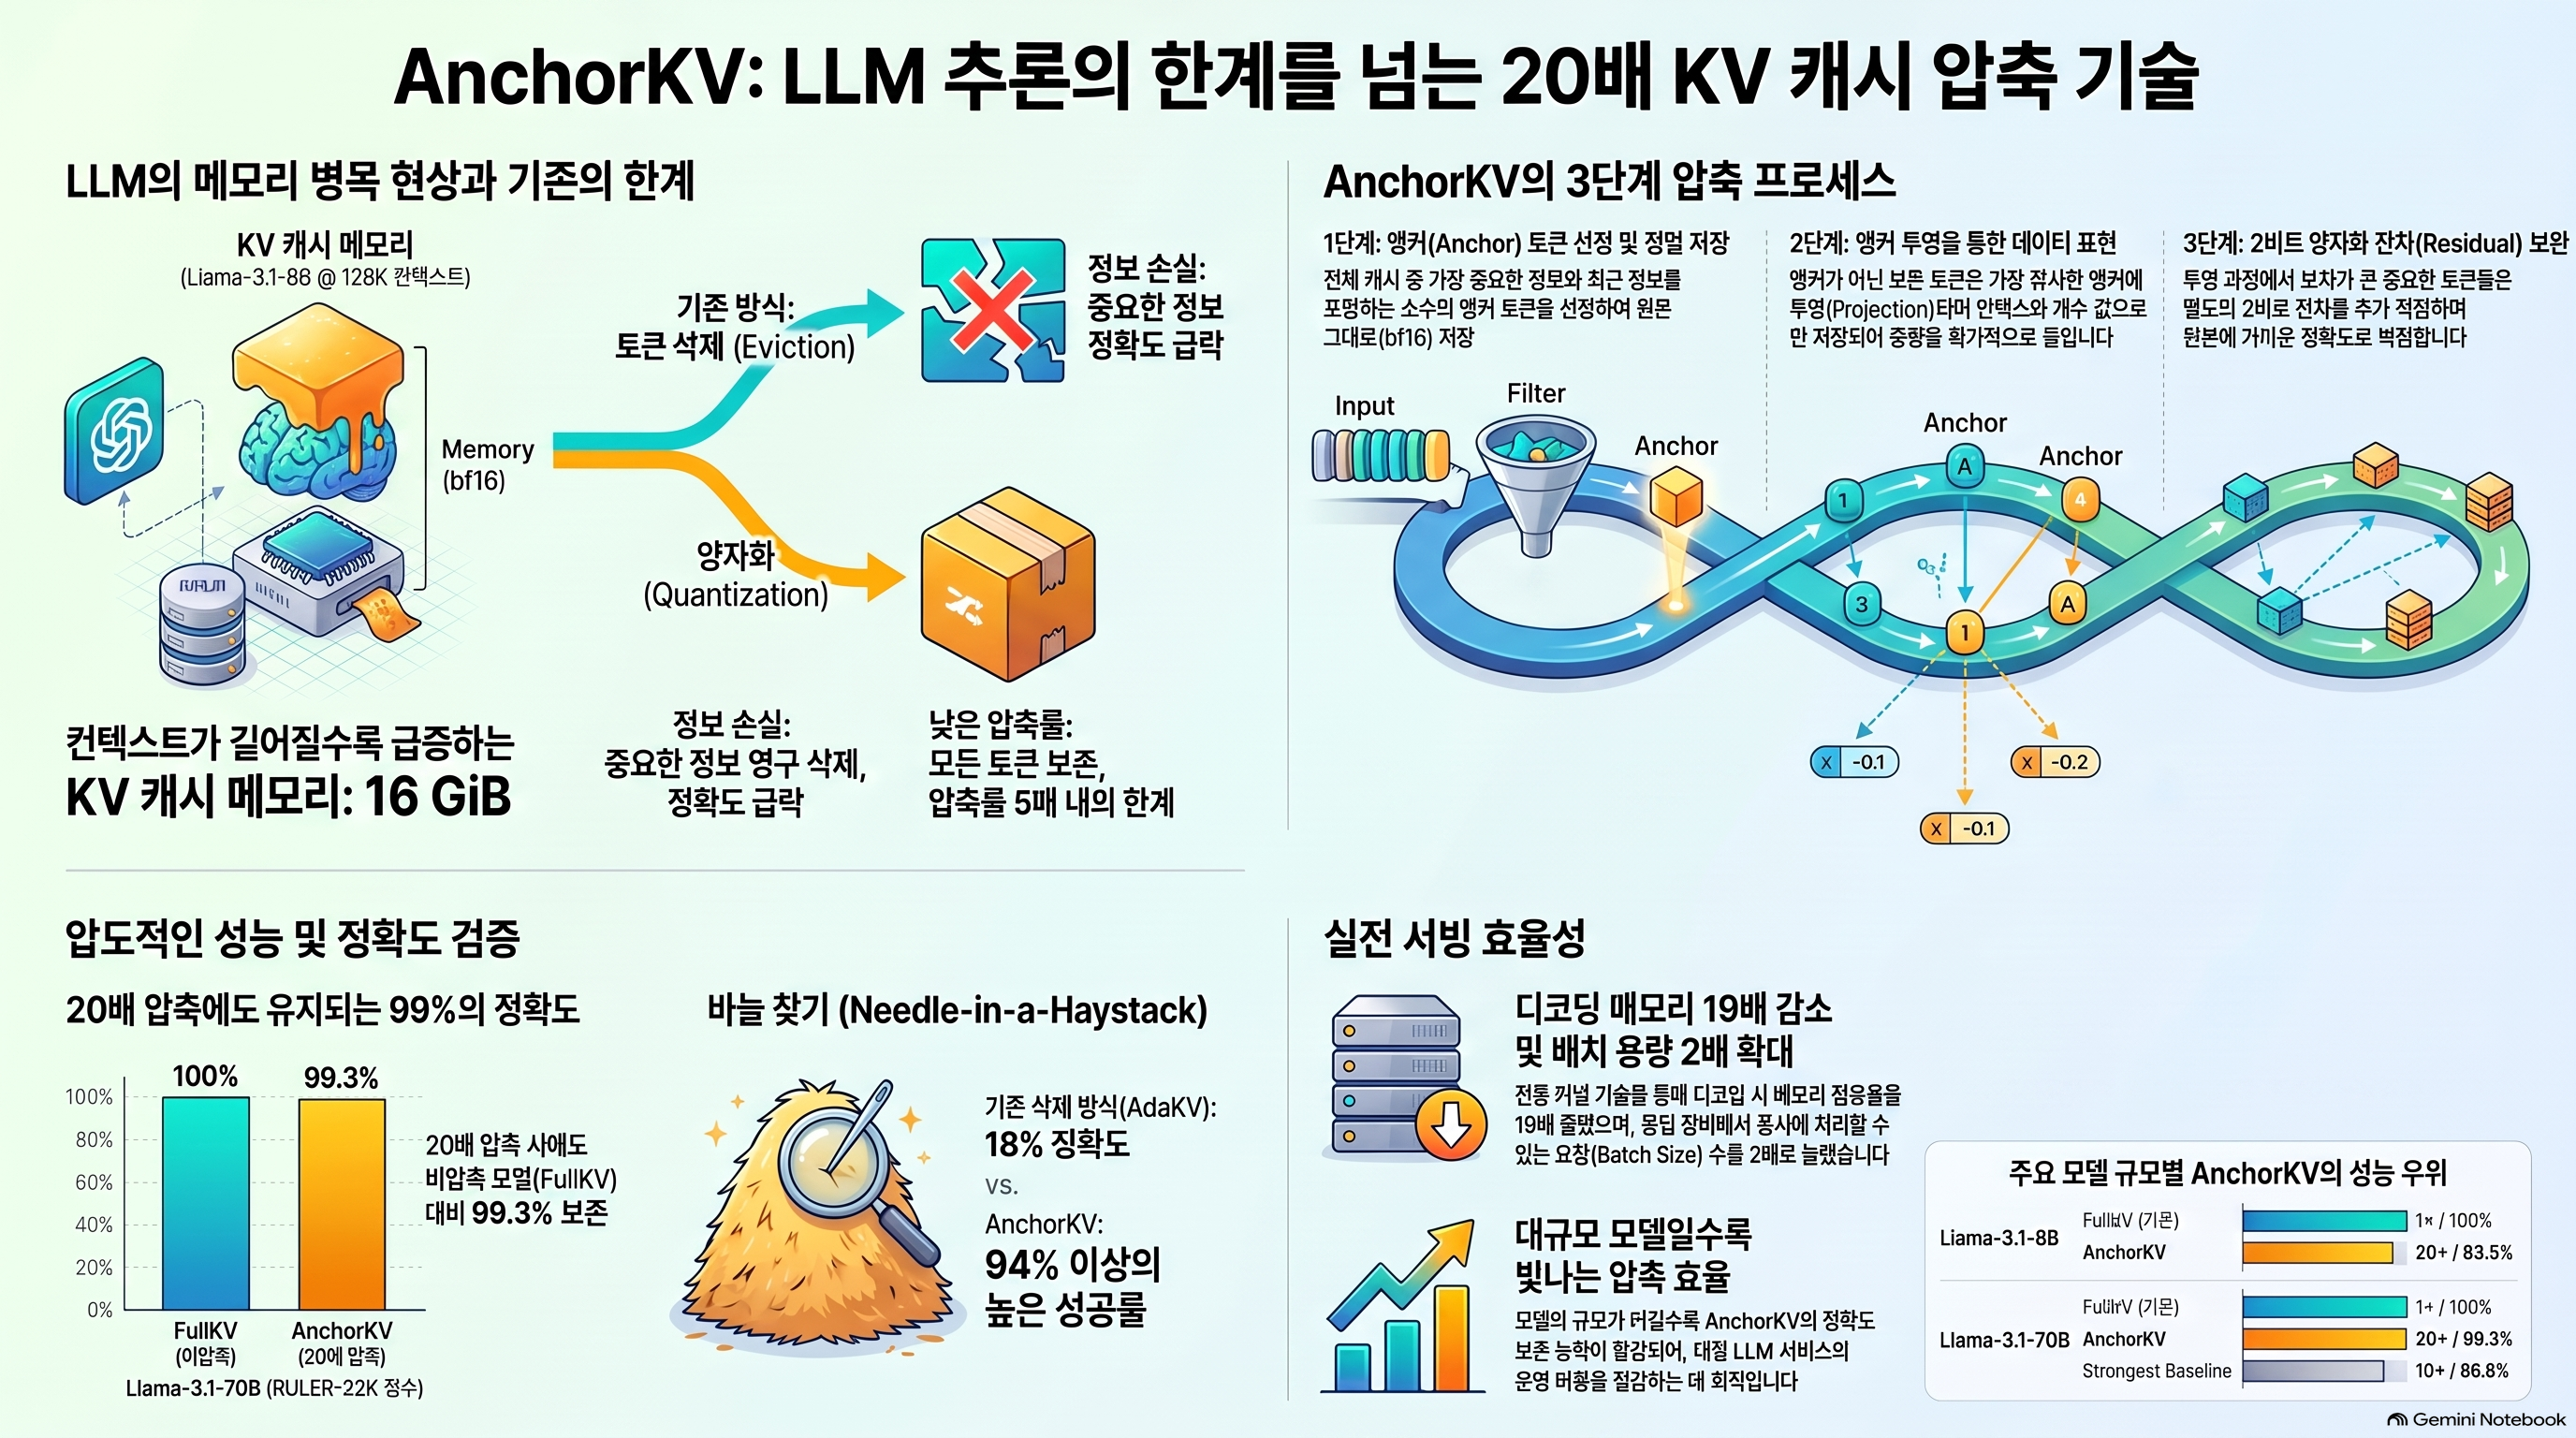
AnchorKV는 대규모 언어 모델(LLM)이 긴 문맥을 처리할 때 발생하는 메모리 병목 현상을 해결하기 위해 제안된 혁신적인 KV 캐시 압축 기술입니다. 기존 방식들이 중요도가 낮은 토큰을 아예 삭제하여 정보 손실을 초래하거나 단순 양자화로 압축률에 한계를 보였던 것과 달리, 이 모델은 단 하나의 토큰도 버리지 않고 전체 문맥을 유지하면서 메모리 점유율을 최대 20배까지 줄입니다. 구체적으로는 소수의 핵심적인 앵커(Anchor) 토큰을 정확하게 저장한 뒤, 나머지 토큰들을 가장 유사한 앵커와의 상관관계 및 잔차(Residual) 데이터로 표현하는 방식을 취합니다. 특히 어텐션 출력 오차에 민감한 토큰에 우선적으로 잔차 예산을 할당함으로써, 압축 후에도 모델의 정확도와 성능을 거의 완벽하게 보존하면서 대용량 데이터를 효율적으로 서비스할 수 있게 합니다.
서지 정보
- 제목: AnchorKV: Anchor-Residual KV Cache Compression
- 저자: Malik Khalaf, Yara Shamshoum(공동 1저자), Nitzan Hodos, Yuval Sieradzki, Assaf Schuster — Technion(이스라엘 공대) 컴퓨터과학과
- 이 논문은 심사 대기 중인 프리프린트이며, 코드는 논문이 채택되면 공개될 예정입니다.
"KV token을 버리지 않고, 대부분의 token을 소수의 대표 KV vector + scalar coefficient로 표현하고, reconstruction error가 실제 attention output에 큰 영향을 주는 token에만 residual을 추가 저장한다."
| 접근 | Token 보존 | 표현 정밀도 | 핵심 문제 |
| Full KV | 100% | BF16 | 메모리 비용 |
| Eviction | 일부 | 높음 | 버린 token은 이후 접근 불가 |
| Quantization | 100% | 낮음 | bit를 낮추면 정확도 저하 |
| AnchorKV | 100% | token별 adaptive | reconstruction/metadata/kernel 비용 |
Eviction의 문제:
token을 버리기 때문에 나중에 필요한 token을 복구할 수 없음
Quantization의 문제:
모든 token을 낮은 precision으로 표현하기 때문에 압축률을 극단적으로 높이기 어려움
AnchorKV:
Full KV
 │
 ├── 일부 token → exact anchor
 │
 ├── 대부분 token → anchor index + scalar
 │
 └── 중요한 residual만 → 2-bit residual
Abstract
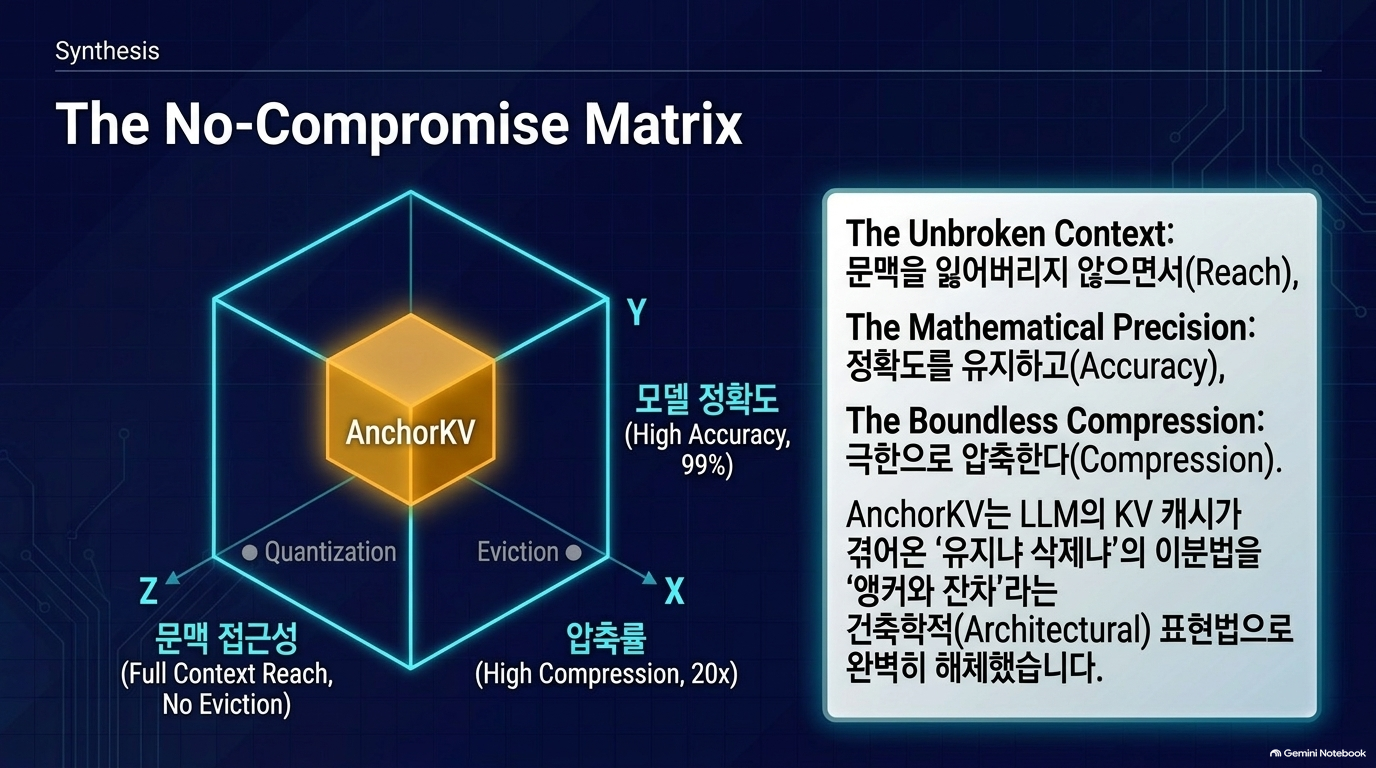
KV 캐시는 긴 컨텍스트 LLM 추론의 주된 메모리 병목이며, 기존 접근은 토큰을 영구 폐기하는 축출(eviction) 방식과 모든 토큰을 저정밀로 유지하는 양자화 방식으로 양극화되어 있습니다. AnchorKV는 토큰을 하나도 버리지 않고도 캐시를 20배 압축하는 방법으로, 소수의 앵커를 정확히 저장하고 나머지 토큰은 가장 유사한 앵커를 통해 표현하며, 모델 출력에 가장 큰 영향을 주는 근사만 선별적으로 보정(잔차 저장)합니다. 70B 규모에서 전체 캐시 성능의 99%를 유지한다고 보고합니다.
1. Introduction
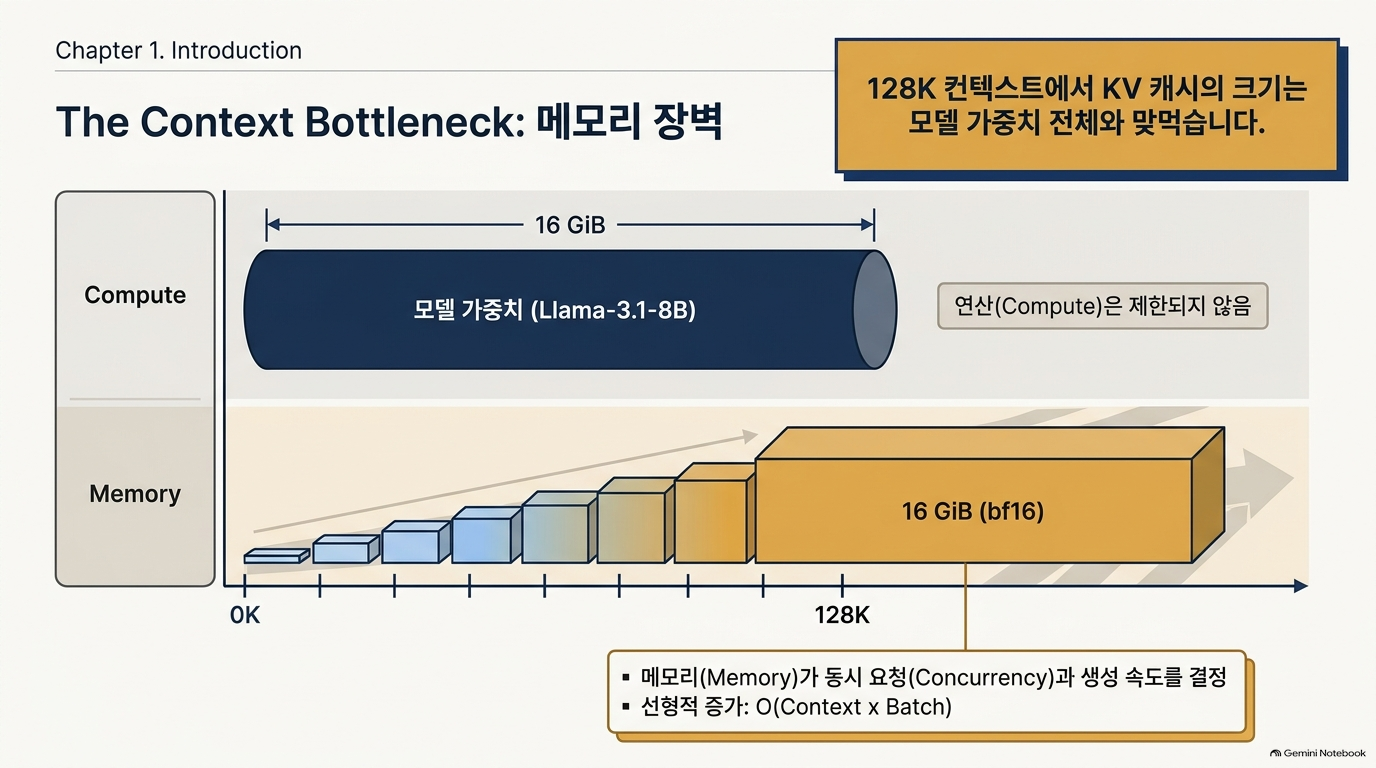
긴 컨텍스트 추론에서는 128K 토큰 기준 Llama-3.1-8B 단일 요청이 bf16으로 16GiB 캐시를 차지하는데, 이는 모델 가중치 자체와 맞먹는 크기입니다. 따라서 디바이스가 동시에 처리 가능한 요청 수와 속도를 결정하는 것은 모델이 아니라 캐시라는 문제의식에서 출발합니다.
두 기존 계열의 한계를 지적합니다:
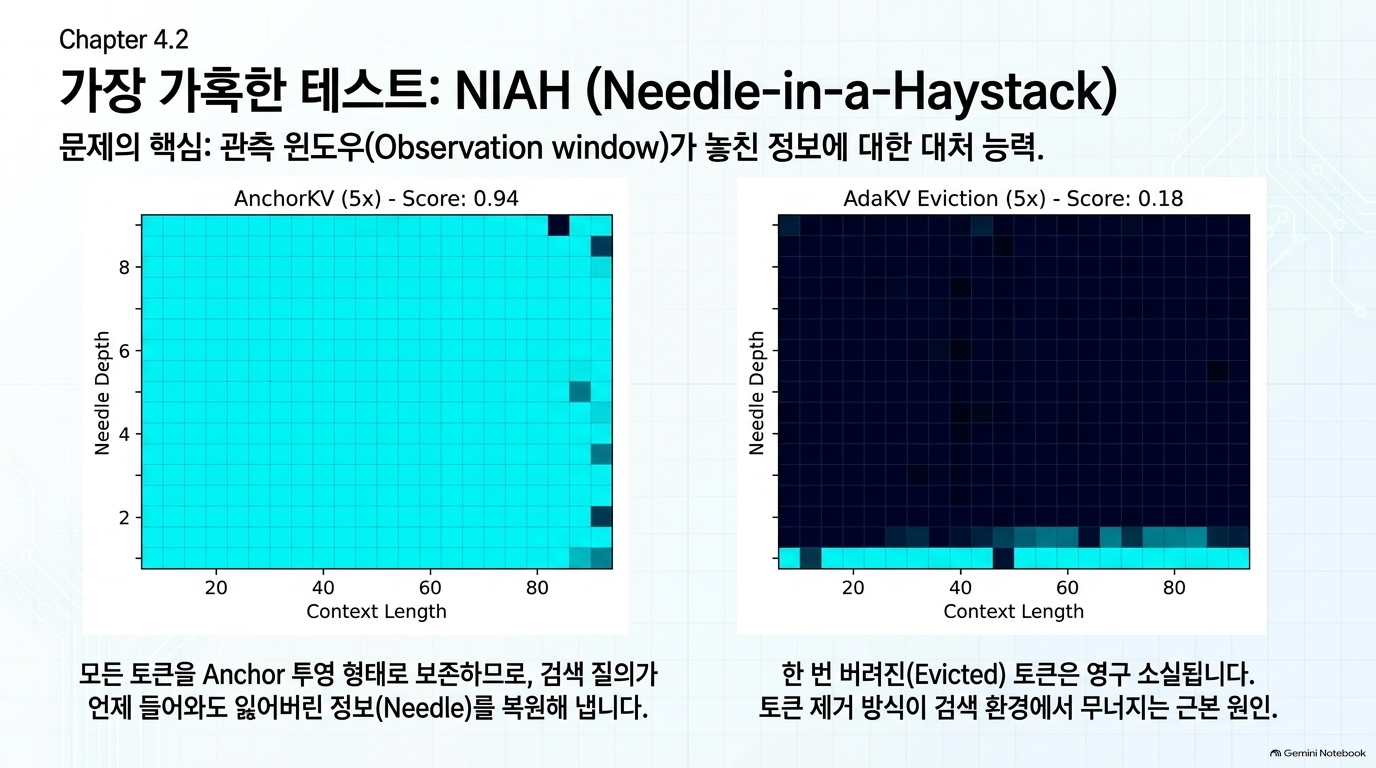
- 축출(Eviction) 계열: 쿼리가 무엇을 필요로 할지 알기 전에 토큰 점수를 매기기 때문에, 프롬프트 마지막 쿼리들이 무시한 토큰이 나중 쿼리에 필요해지면 이미 사라진 상태가 된다는 점이 논문 4.2절 실험에서 드물지 않은 지배적 실패 양상으로 나타남을 미리 언급합니다.
- 양자화 계열: 모든 토큰을 접근 가능하게 유지하지만, 1~2비트로 정밀도를 낮추면 정확도가 떨어져 압축률이 제한되며, 저자들의 비교에서는 5배 부근에서 한계에 도달한다고 밝힙니다.
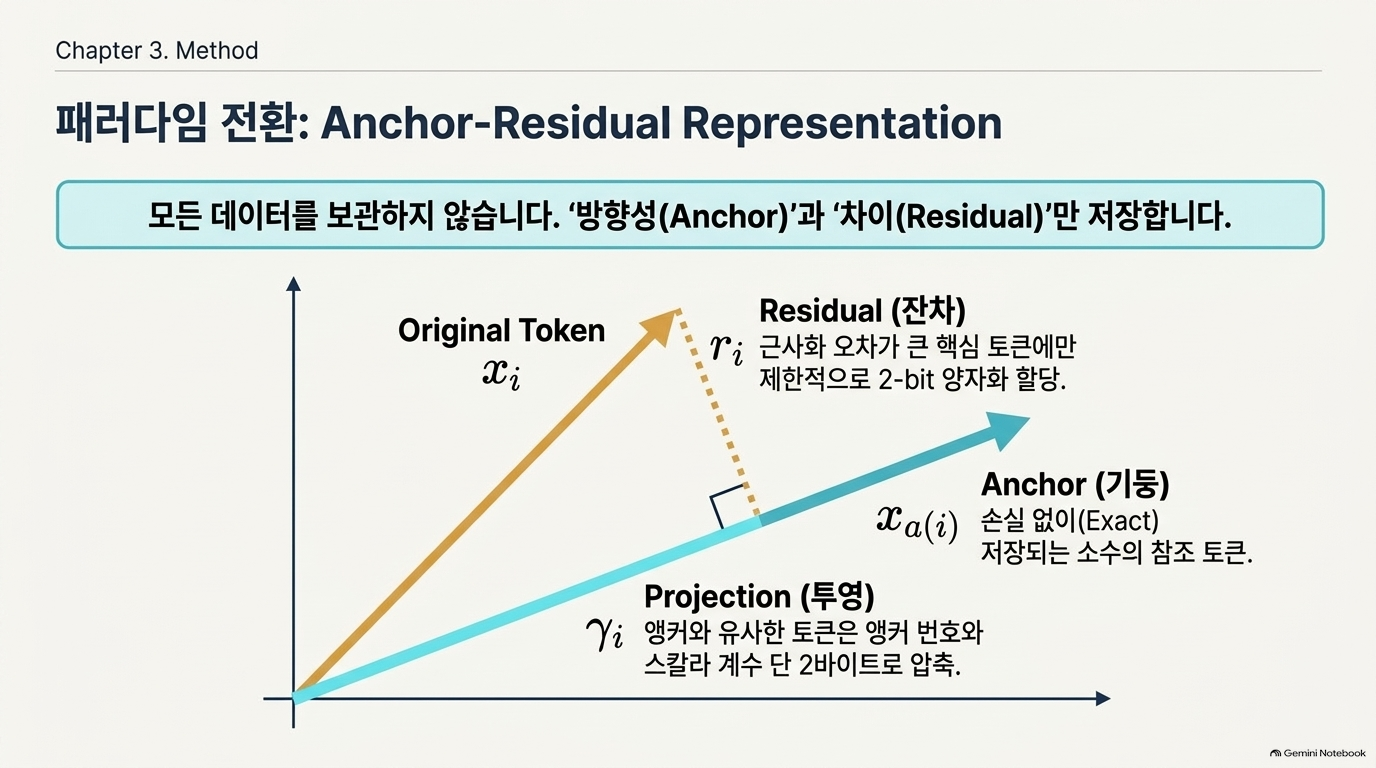
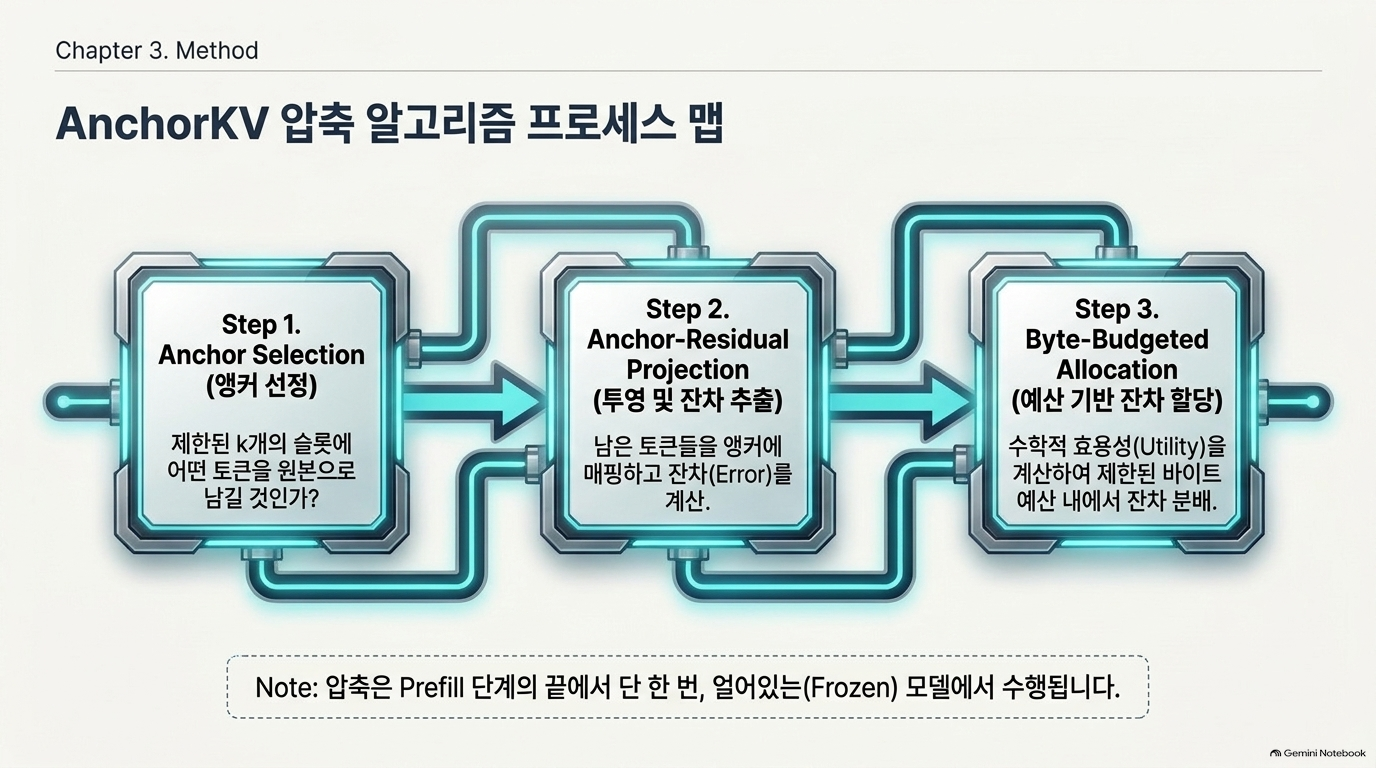
AnchorKV의 핵심 아이디어: 각 KV 헤드가 소수의 앵커 토큰을 정확히 저장하고, 나머지 토큰은 가장 가까운 앵커의 스케일된 사본으로 표현하며(벡터 전체 대신 몇 바이트만 소요), 남는 바이트 예산은 근사 오차가 attention 출력에 가장 큰 영향을 주는 토큰들의 양자화된 잔차를 저장하는 데 사용됩니다. 압축은 프리필(prefill) 종료 시 고정된 모델에 대해 한 번만 수행되며, 사용자는 유지 비율(θ)이라는 단일 knob만 설정하면 정확한 바이트 회계가 이를 저장 계획으로 변환합니다.
핵심 수치: 동일 설정 하에서 AnchorKV 20배는 모든 축출 기법의 10배보다 높은 점수를 기록해, 절반의 메모리로 동일 정확도를 달성했고, Llama-3.1-70B에서는 20배 압축 시 RULER 점수의 99.3%를 유지(최강 베이스라인은 86.8%)했으며, 이 유지율은 모델 규모가 커질수록(캐시 비용이 가장 큰 영역일수록) 오히려 개선됩니다.
2. Related Work
2.1 Token Eviction (토큰 축출)
H2O류의 누적 attention mass 기반 방식, 관찰 윈도우로 프리필 시점 점수를 매기는 SnapKV, 레이어별로 예산을 분배하는 PyramidKV, 헤드별로 분배하는 AdaKV 등이 이 계열에 속합니다. AnchorKV는 SnapKV와 동일한 관찰 윈도우 스코어링 메커니즘을 재사용하지만, "유지할지 말지"가 아니라 "몇 바이트를 줄지"를 결정하는 데 사용하며, 축출의 이진적(binary) 결정이 비가역적이라는 점을 비판합니다.
2.2 Quantization and Low-Rank Projection (양자화 및 저랭크 투영)
채널별/이상치 인식 비트폭 축소나 레이어·은닉 차원 방향의 저랭크 투영이 이 계열에 속하며, AnchorKV는 전체 컨텍스트 유지라는 목표는 공유하지만 이 계열이 1~2비트로 갈수록 정확도가 떨어져 비교 실험에서 5배 부근에 갇히는 반면, AnchorKV는 토큰당 바이트 수를 가변적으로 조절해 20배까지 도달한다고 차별점을 제시합니다. 잔차 코덱에는 이 계열에서 도입된 무작위 회전(rotation) 기법을 이미 활용하고 있어 두 축이 상호 보완적이라고 설명합니다.
2.3 Shared Representations (공유 표현)
축출된 상태를 인접 토큰에 병합하거나 유사 토큰을 그룹화하고, 공유 중심점(centroid)/코드북에 대해 코딩하는 방식이 이 계열이며, AnchorKV는 이 계열과 가장 가깝지만, 토큰이 공유 표현으로 뭉치면 softmax가 이들을 구별할 수 없게 되는 반면 AnchorKV는 각 토큰에 고유 계수를 부여해 두 토큰이 동일해지지 않도록 하고, 출력 오차가 가장 큰 토큰에는 잔차를 추가로 부여한다는 차이를 설명합니다.
3. Method
3.1 Anchor-Residual Representation (앵커-잔차 표현)
각 KV 헤드가 프리필 종료 시 k개의 앵커 위치를 선택해 키/값을 정확히 저장하고, 나머지 모든 벡터는 코사인 유사도가 가장 큰 단일 앵커의 span에 직교 투영되어 앵커 인덱스와 스칼라 계수(γ)만으로 표현됩니다. 투영 후 남는 잔차(residual)는 선별된 위치(R) 집합에 한해 양자화되어 추가로 저장되며, 재구성 벡터는 앵커 투영값에 (해당되는 경우) 양자화 잔차를 더한 형태입니다.
잔차 양자화: 양자화 전 무작위 Hadamard 변환으로 잔차 에너지를 좌표 전반에 분산시켜 이상치 민감도를 낮추고, 토큰별 absmax 스케일로 정규화한 뒤 단위 가우시안 소스용 4레벨 Lloyd–Max 코드북으로 2비트/좌표 양자화를 수행합니다.
3.2 AnchorKV Cache Compression
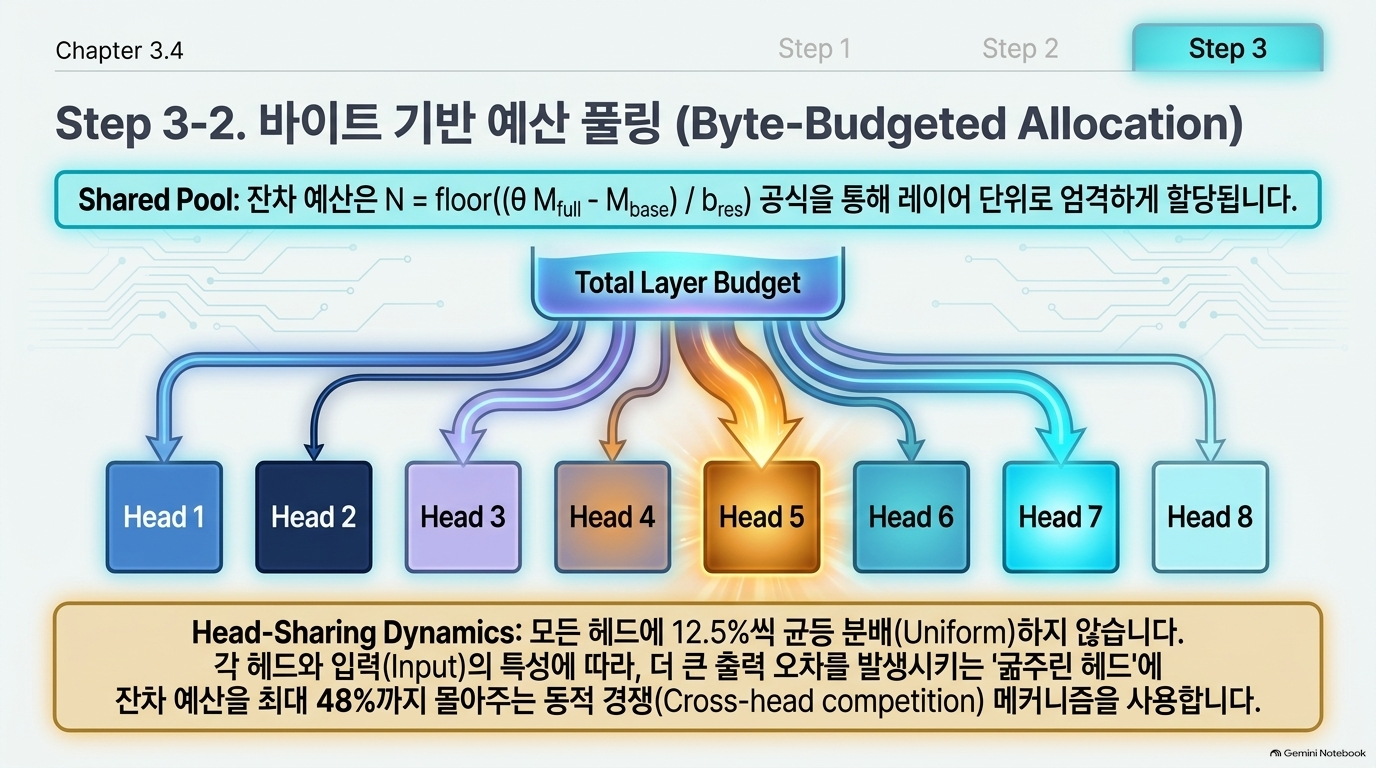
압축은 프리필 종료 시 한 번, 세 단계로 실행됩니다: (1) 각 KV 헤드가 k개 앵커 선택 (2) 나머지 위치를 앵커에 할당·투영 (3) 일부 위치에 양자화 잔차 할당(출력 오차를 가장 많이 회복하는 곳에 배분). 헤드는 앵커는 독립적으로 선택하지만 레이어당 단일 잔차 예산을 두고 서로 경쟁합니다.
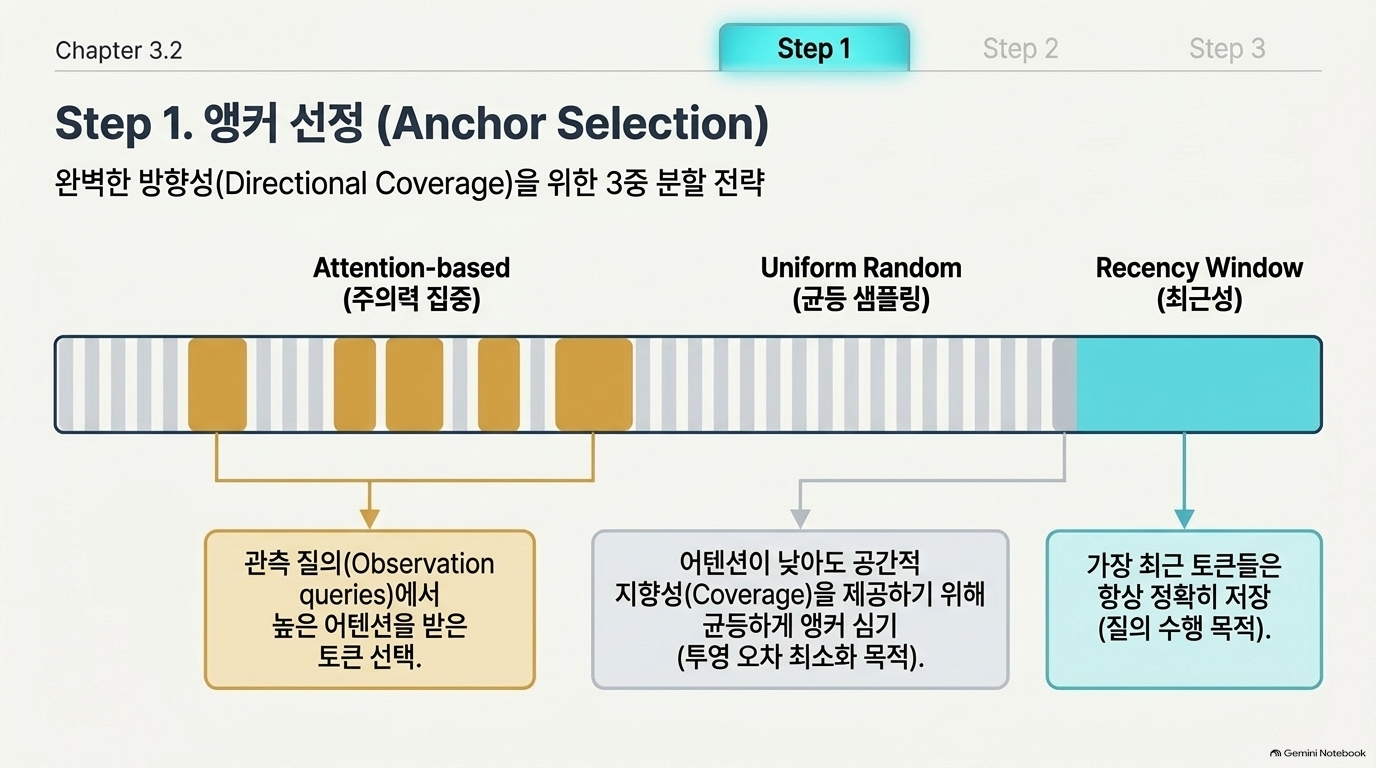
앵커 선택: 최근 W개 위치는 항상 정확히 저장되어(recency window) 앵커 예산에 포함되며, 관찰 쿼리 역할과 무료 앵커 방향 역할을 동시에 수행합니다. 나머지 위치는 SnapKV 방식으로 attention 점수를 매기고(위치 커널로 풀링), 남은 슬롯의 일정 비율(ρ)은 최고 점수 순으로, 나머지는 컨텍스트 전체에서 균등 무작위로 샘플링합니다. 균등 샘플링을 섞는 이유는, attention 기반 선택만으로는 방향적 커버리지(투영 기준으로서의 다양성)가 부족하기 때문입니다.
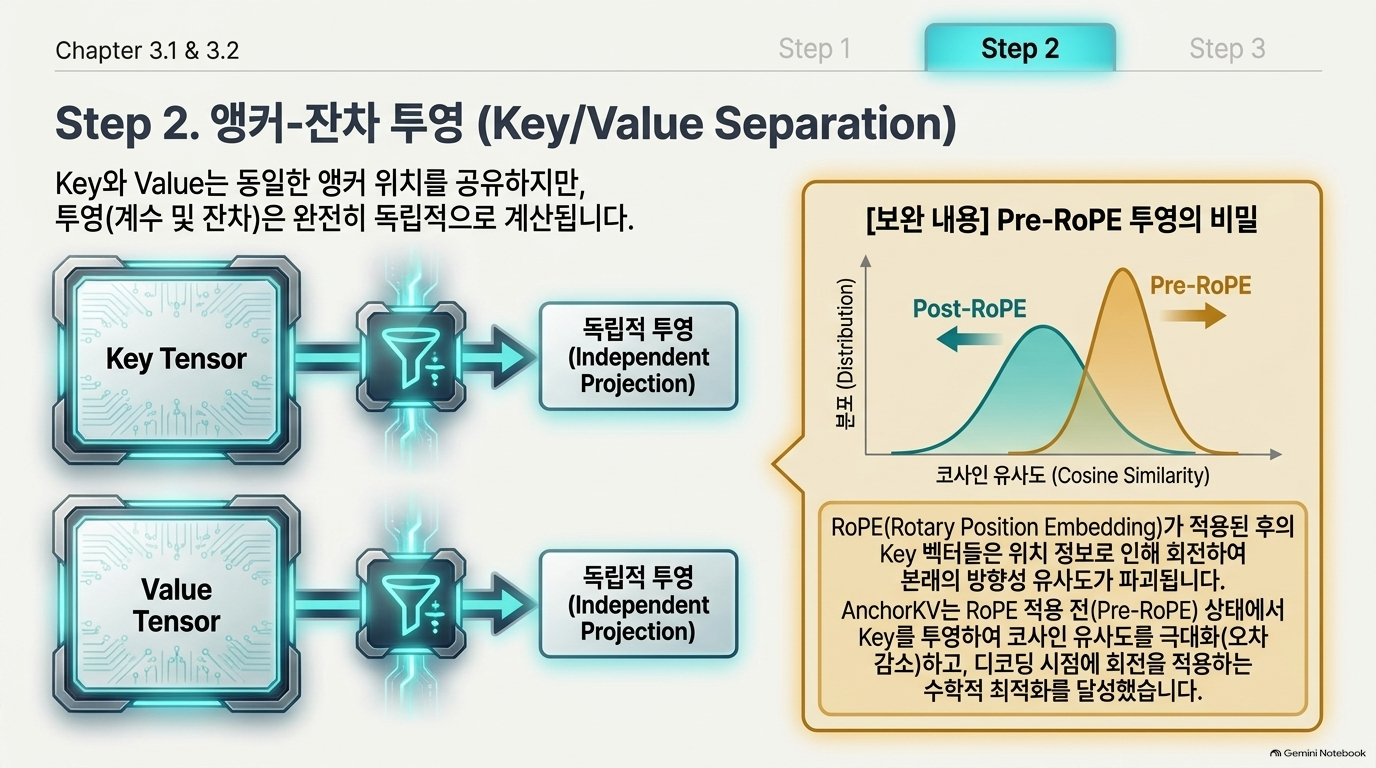
RoPE 이전 투영: 위치 회전이 방향 유사도를 약화시키므로 키 투영은 RoPE 적용 전에 수행하되, 앵커 점수 매기기는 RoPE 적용 후 키를 사용해 실제 모델 attention을 반영합니다. RoPE는 위치별 선형 사상이므로 분해에 그대로 적용되어, 키는 회전 전에 저장하고 디코딩 시 회전시킬 수 있습니다.
3.3 Attention-Output-Aware Residual Scoring (어텐션-출력 인식 잔차 스코어링)
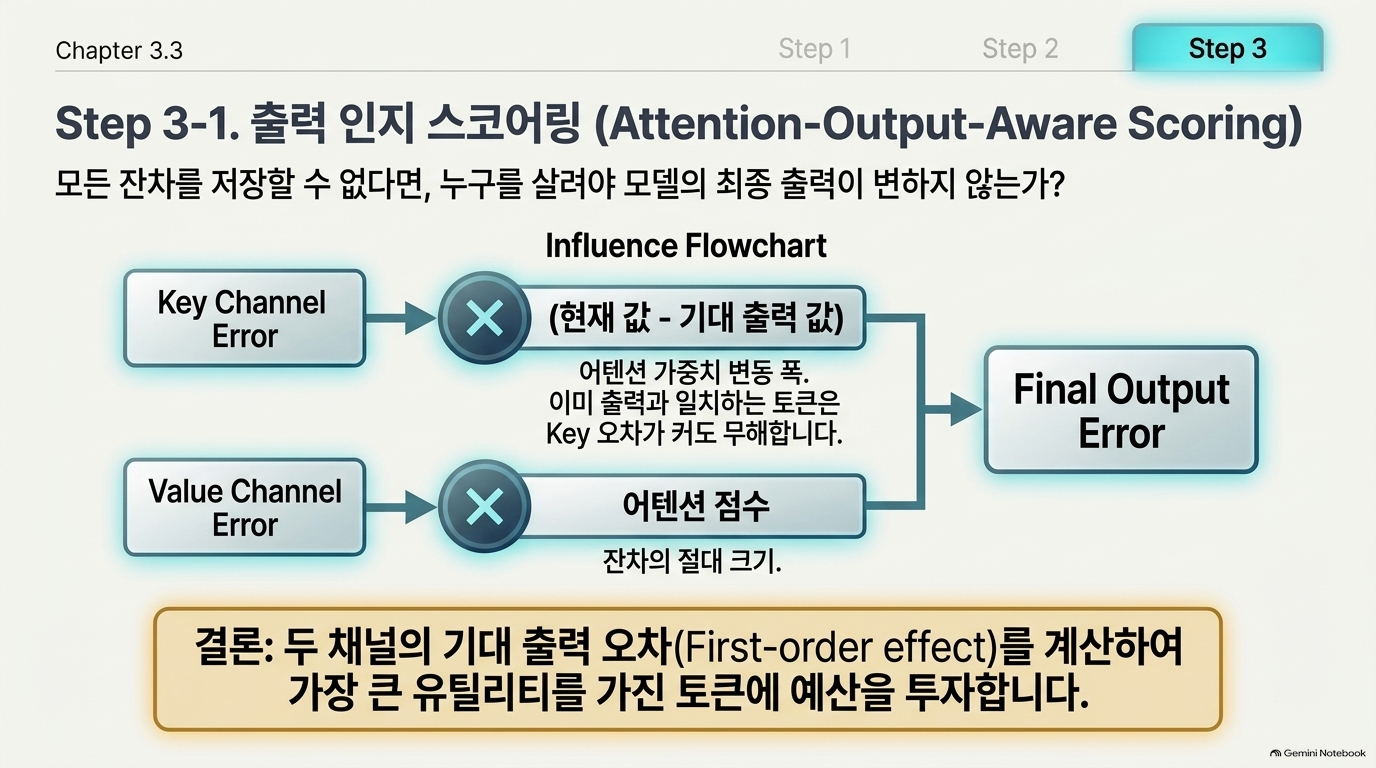
잔차 크기나 attention 점수 단독으로는 저장 가치를 판단할 수 없다는 문제의식에서, AnchorKV는 1차 근사(softmax 야코비안)를 통해 잔차가 attention 출력에 미치는 영향을 직접 추정합니다. 키 오차는 attention 가중치를 통해 간접적으로 작용하며 (Vt − y)로 조절되는 반면, 값 오차는 출력에 직접 작용하여 키·값 잔차를 별도로 스코어링합니다.
비상관(incoherence) 근사 하에서 토큰별 기여가 독립·가산적이라고 가정하면, 관찰 윈도우의 쿼리들을 이용해 위치별 효용(utility) 점수를 프리필 종료 시 단일 패스로 추정할 수 있습니다.
왜 모든 토큰을 유지하는가: 어떤 위치도 softmax에서 빠지지 않으므로 압축된 캐시는 정확한 캐시의 섭동(perturbation)이며, 출력 오차는 키 유도 오차(EK)와 값 유도 오차(EV)의 합으로 상한이 잡힙니다. 앵커는 정확하므로 섭동은 전적으로 비앵커 위치에서 발생하며, EK는 최악의 로짓 섭동으로, EV는 attention 가중 평균으로 제어됩니다. 값 측면에서는, EV가 앵커 집합 밖의 값 질량(동일한 유지 집합을 가진 축출 기법이 폐기로 인해 치르는 비용과 동일한 항)에 남아있는 최대 상대 투영 오차를 곱한 값으로 제한되며, 이 계수는 언제나 1 이하이고 비앵커 위치가 가까운 앵커나 잔차를 얻을수록 줄어듭니다.
3.4 Byte-Budgeted Residual Allocation (바이트 예산 기반 잔차 할당)
유지 비율 θ가 레이어별 바이트 예산을 고정하며, 앵커와 메타데이터를 먼저 확정한 뒤 남는 예산으로 잔차 개수(N)를 계산하는 정확한 바이트 회계식을 사용해, 압축된 크기가 예산을 절대 초과하지 않도록 합니다. 키는 N/2개, 값은 나머지 슬롯을 받으며, 각 측면 내에서는 레이어 내 모든 KV 헤드에 걸쳐 효용이 높은 잔차를 선택(풀링)해, 추정 출력 오차가 큰 헤드가 더 많은 잔차 예산을 받을 수 있도록 합니다. θ만이 사용자 노출 파라미터이며 나머지(k, W, ρ, κ)는 고정됩니다.
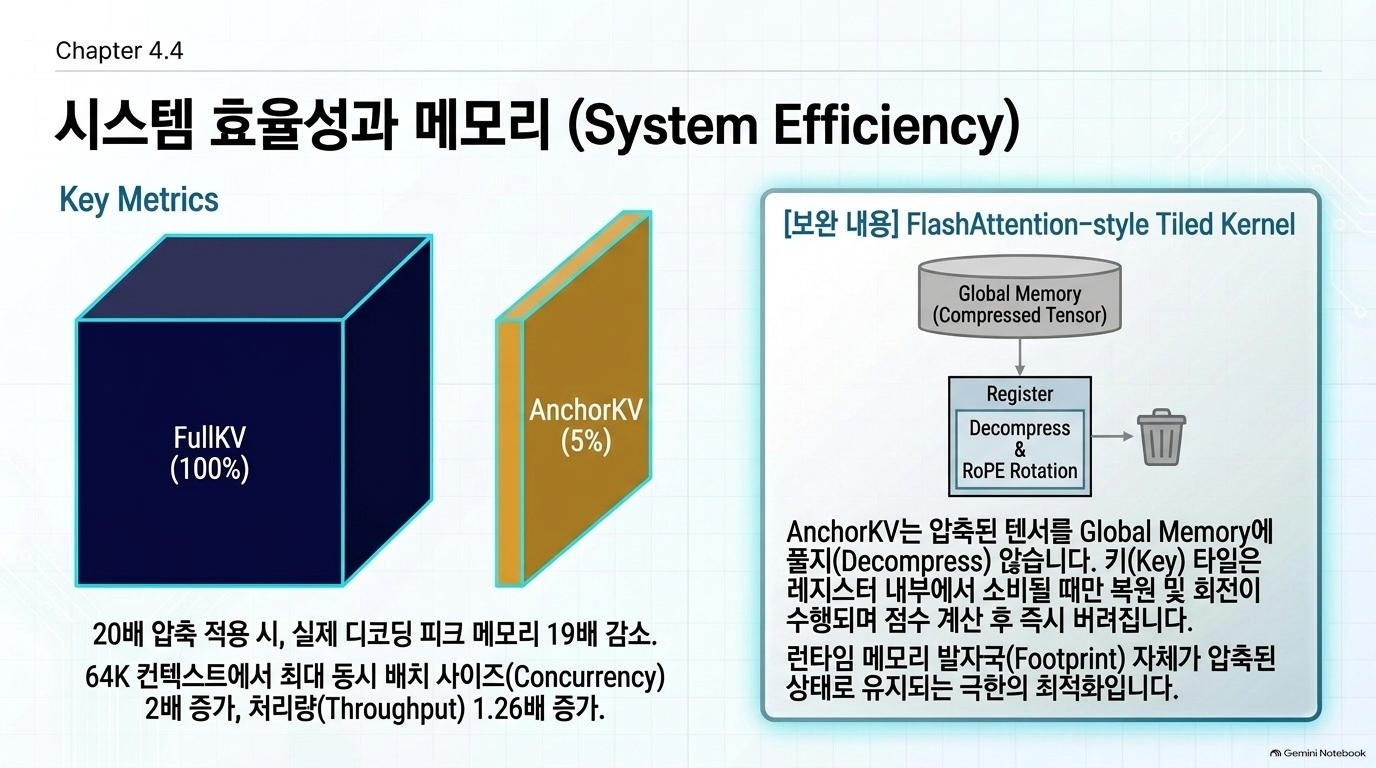
저장·디코딩: 앵커는 bf16으로, 키는 RoPE 적용 전 상태로 저장되고, 재구성은 FlashAttention 스타일의 타일 커널에 융합되어 각 타일이 소비하는 키·값만 재구성하므로 조밀한(dense) 캐시가 전혀 материализе되지 않아, 런타임 메모리 사용량이 곧 압축된 크기가 됩니다.
4. Experiments
4.1 Setup
- 모델: Llama-3.1-8B-Instruct, Llama-3.1-70B-Instruct, Mistral-Small-3.1-24B-Instruct, 모두 128K 컨텍스트 윈도우 기준 공개 체크포인트 사용
- 벤치마크: RULER(13개 합성 과업, 32K/64K), LongBench(실제 문서 기반 과업), Needle-in-a-Haystack(64자리 패스키, 짧은 패스키는 대부분 방법에서 포화 상태이므로 제외)
- 베이스라인: FullKV(비압축), 축출 계열 SnapKV/PyramidKV/AdaKV(KVPress 프레임워크 기본 설정), 양자화 계열 TurboQuant. 두 계열의 단위(토큰 예산 vs 비트 폭)가 다르므로 모두 바이트로 환산해 레이어당 동일 footprint로 매칭
- 구현: 모든 모델·과업에 동일 설정 사용 — W=32, k=S/128, ρ=0.7, κ=7, 앵커 bf16, 잔차 2비트; NVIDIA A100-80GB, 배치 크기 1, 그리디 디코딩
[수치 확인 필요] TurboQuant는 논문 제출 시점까지 공식 코드가 공개되지 않아 저자들이 커뮤니티 재현 구현에 의존했고, 실제로는 논문이 기술한 정확한 채널 분할 대신 상위 크기 채널은 fp16으로, 나머지는 균일 비트 양자화 + 128토큰 fp16 최근 윈도우 방식을 사용했을 때만 보고된 품질에 근접했다고 명시합니다. 즉 TurboQuant 비교 수치는 공식 구현이 아닌 재현 구현 기준이므로, 엄밀한 비교를 원한다면 원 저자 공식 코드 공개 여부를 직접 확인할 필요가 있습니다.
4.2 Main Results
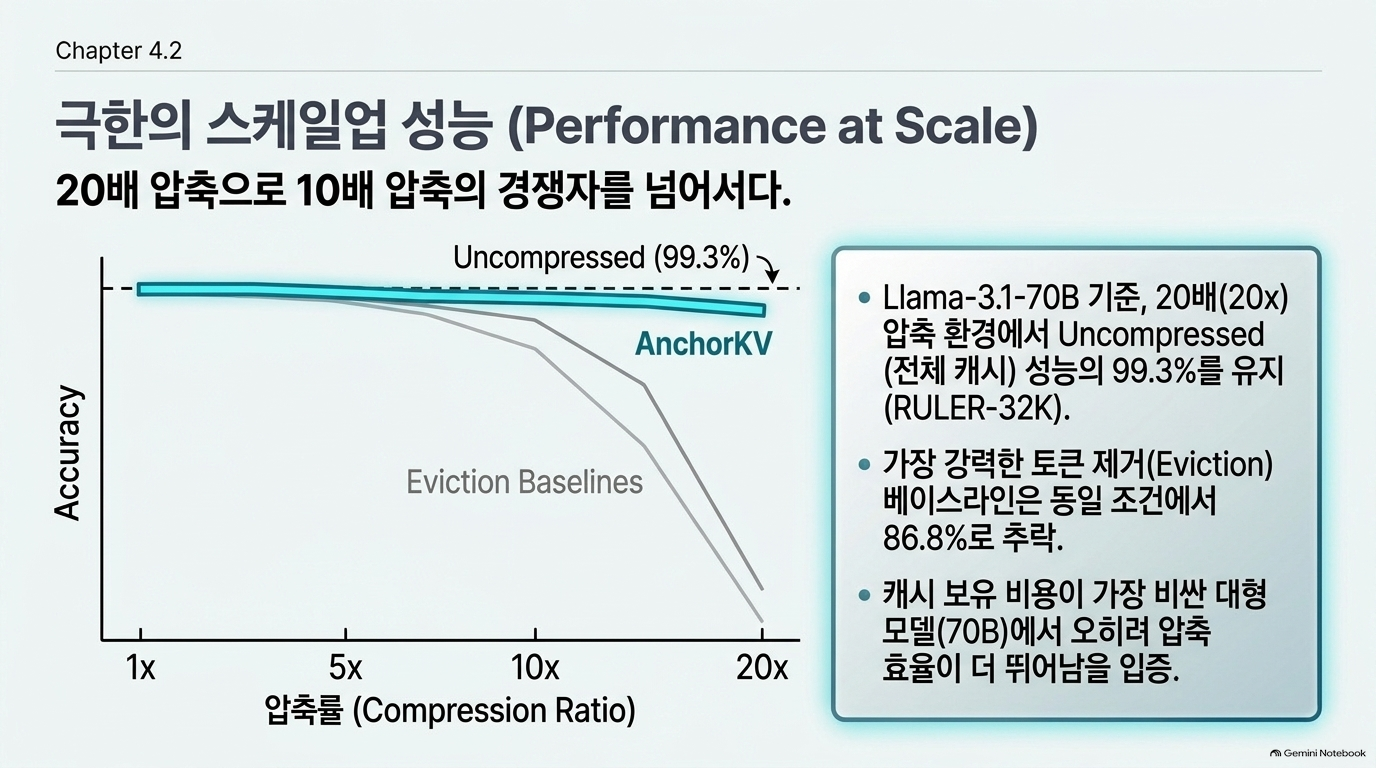
9개 모델-벤치마크 조합 전 패널에서 두 가지 일관된 경향이 나타납니다: 첫째, AnchorKV는 압축률이 높아져도 비압축 캐시에 근접한 성능을 유지하는 반면 축출 베이스라인은 급격히 저하되고, 둘째 AnchorKV 20배가 모든 축출 베이스라인의 10배를 능가합니다. TurboQuant도 FullKV에 근접하지만 3.5비트 고정 표현으로 5배 부근에서 상한에 도달합니다.
RULER-32K 20배 기준 AnchorKV는 Llama-8B/Mistral-24B/Llama-70B에서 각각 FullKV 점수의 93.5%, 95.3%, 99.3%를 유지했고, 70B에서는 압축 캐시가 94.4점(비압축 95.0점)을 기록한 반면 최강 축출 베이스라인은 86.8%에 그쳤으며, Mistral-24B에서는 최강 축출 베이스라인이 두 컨텍스트 길이 모두에서 67% 미만에 머물러 이 경향이 단순히 "모델이 강해서"가 아님을 보였습니다. LongBench에서도 AnchorKV는 8B에서 94.1%, 70B에서 98.4%를 유지했습니다.
과업별 분석: 20배 압축 시 AnchorKV는 13개 RULER 과업 중 12개에서 최강 축출 베이스라인과 동등하거나 우수했고 최저점도 FullKV의 60%를 넘었으나, 축출 베이스라인들은 4개 과업에서 70% 미만, 3개 과업에서는 16% 미만으로 붕괴했습니다. 격차가 가장 큰 곳은 방해 요소 대비 검색과 전체 컨텍스트 집계 과업(cwe, single_3, multikey_3)으로, 각각 67, 88, 45 퍼센트포인트 차이를 보였습니다.
Needle-in-a-Haystack: 5배 압축에서 AnchorKV는 평균 0.94(비압축 0.99)를 기록한 반면 최강 축출 베이스라인 AdaKV는 평균 0.18로 거의 모든 곳에서 실패했습니다.
4.3 Ablations and Analysis
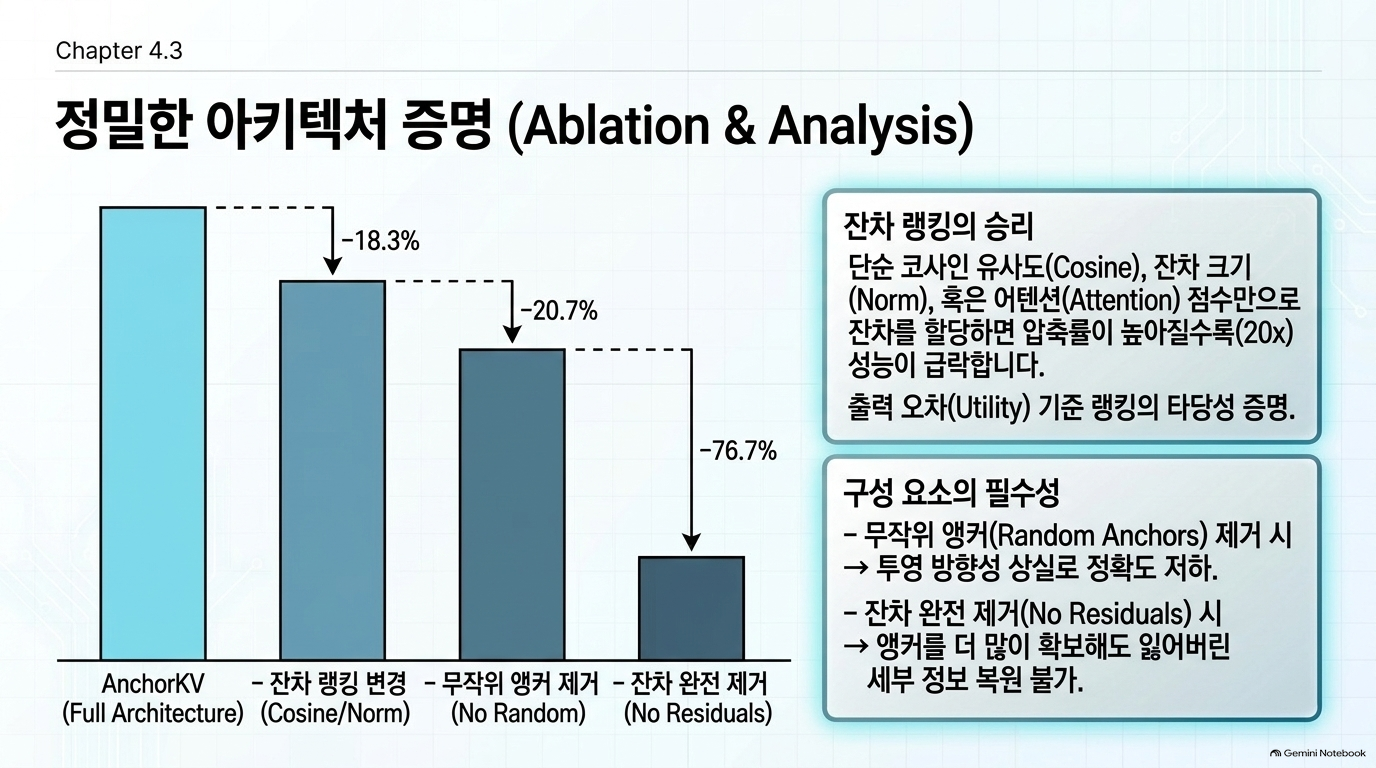
잔차 랭킹 비교: Eq.6의 효용 지표를 코사인 유사도, 잔차 노름, attention 점수, 무작위 순위로 대체해 비교한 결과, 효용 지표가 모든 압축률에서 최고 성능을 보였고 무작위가 가장 낮았으며, 5배에서는 차이가 크지 않지만 예산이 타이트해질수록(20배에서 최대) 격차가 벌어졌습니다.
구성 요소 제거: 무작위 앵커 제거, 헤드별 균등 잔차 예산(풀링 제거), 잔차 없이 앵커에만 예산 투입, Hadamard 회전·Lloyd-Max 코드북 없는 단순 2비트 양자화 등 각 요소를 하나씩 제거했을 때 모두 정확도가 하락했으며, 단순 양자화 제거가 압축률 전반에 걸쳐 가장 큰 손실을 야기했습니다.
RoPE 이전 투영 검증: RoPE 적용 전후 앵커까지의 코사인 유사도를 측정한 결과 회전 적용 후 중앙값이 0.27 낮아졌으며, 이 순서는 8개 깊이 밴드와 4개 RULER 카테고리 전체에서 일관되게 나타나, 키를 RoPE 이전에 투영하는 설계 선택을 뒷받침합니다.
4.4 Efficiency and Memory
압축된 표현에서 직접 디코딩하며 조밀한 캐시를 재구성하지 않아, 20배 목표에서 정상 상태 디코드 최대 메모리가 약 19배 감소합니다. 디코드 지연 시간은 짧은 컨텍스트에서는 더 높지만 64K 이상에서는 비압축과 비슷한 수준이며, 작아진 메모리 footprint 덕분에 64K에서 최대 배치 크기가 두 배가 되고 처리량이 1.26배 향상됩니다.
5. Conclusion
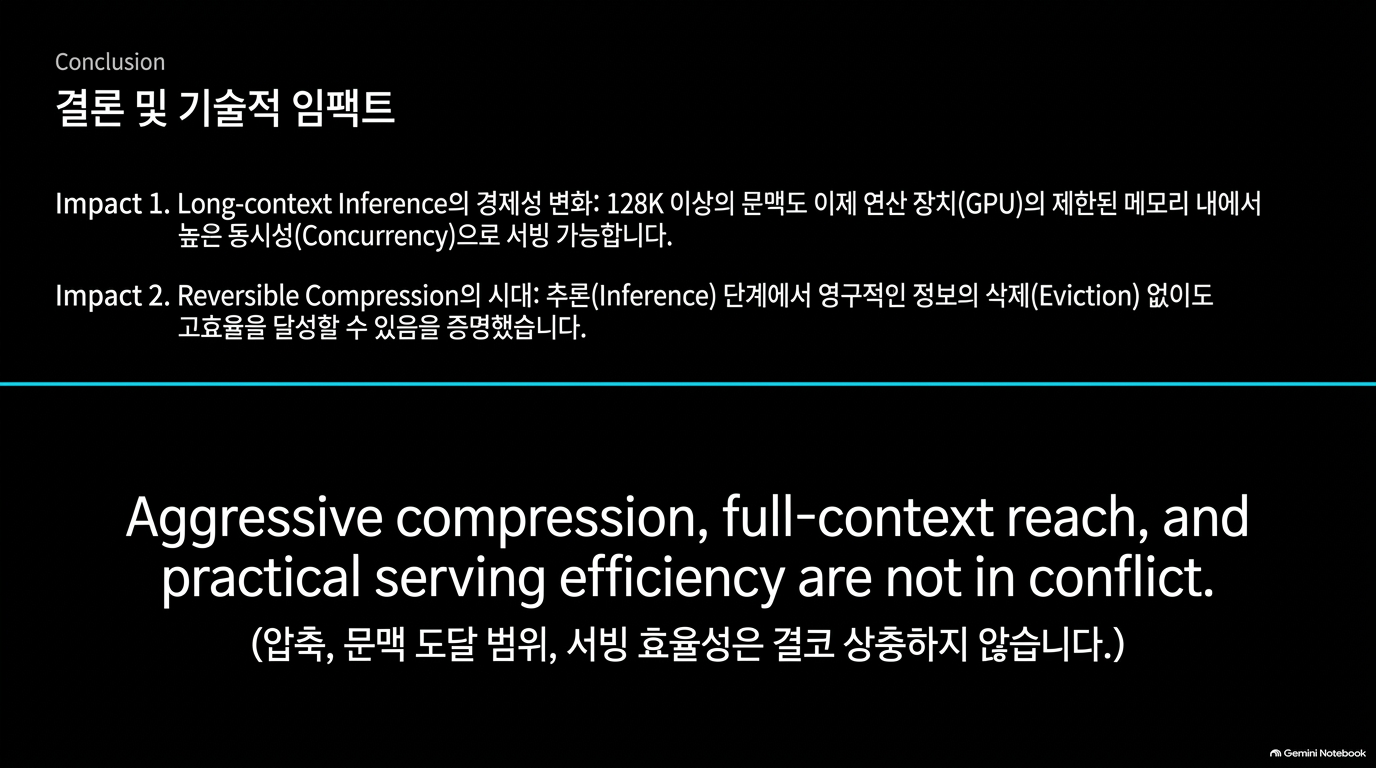
AnchorKV는 모든 토큰을 유지하면서도 메모리를 일부만 사용하는 KV 캐시 압축 기법으로, 각 토큰을 앵커-잔차 형태로 저장하고 attention 출력을 가장 잘 보존하는 곳에 잔차를 배분합니다. 20배 압축에서 모든 축출 베이스라인의 10배 압축을 능가하고, 70B 규모에서는 비압축 정확도의 최대 99.3%를 유지하며, 타일 기반 구현이 이 절감을 디코딩 단계까지 이어가 고정된 메모리 예산 하에서 더 높은 처리량과 더 많은 동시 요청을 지원한다고 결론짓습니다.

'07.AI > 4.AI 비용' 카테고리의 다른 글
| LLM - 추론 최적화 - StreamingLLM : 어텐션 싱크(Attention Sink)를 활용한 효율적인 스트리밍 언어 모델 (0) | 2026.09.18 |
|---|---|
| LLM - 추론 최적화 - 어텐션 싱크(Attention Sink)와 정보 검색 불균형 (0) | 2026.09.18 |
| LLM - 추론 최적화 - GPT-6 Astra, 루프형 트랜스포머(Looped Transformers) (0) | 2026.09.17 |
| 토큰 경제 - Brookings, 토큰 격차(token divide) 문제 (0) | 2026.09.16 |
| LLM - 추론 최적화 - 랜덤 어텐션: 효율적인 추론을 위한 KV 캐시 제거 재고 (0) | 2026.09.13 |