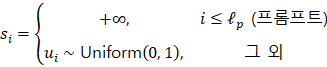2026.9.3 [Random Attention: Rethinking KV Cache Eviction for Efficient Reasoning]
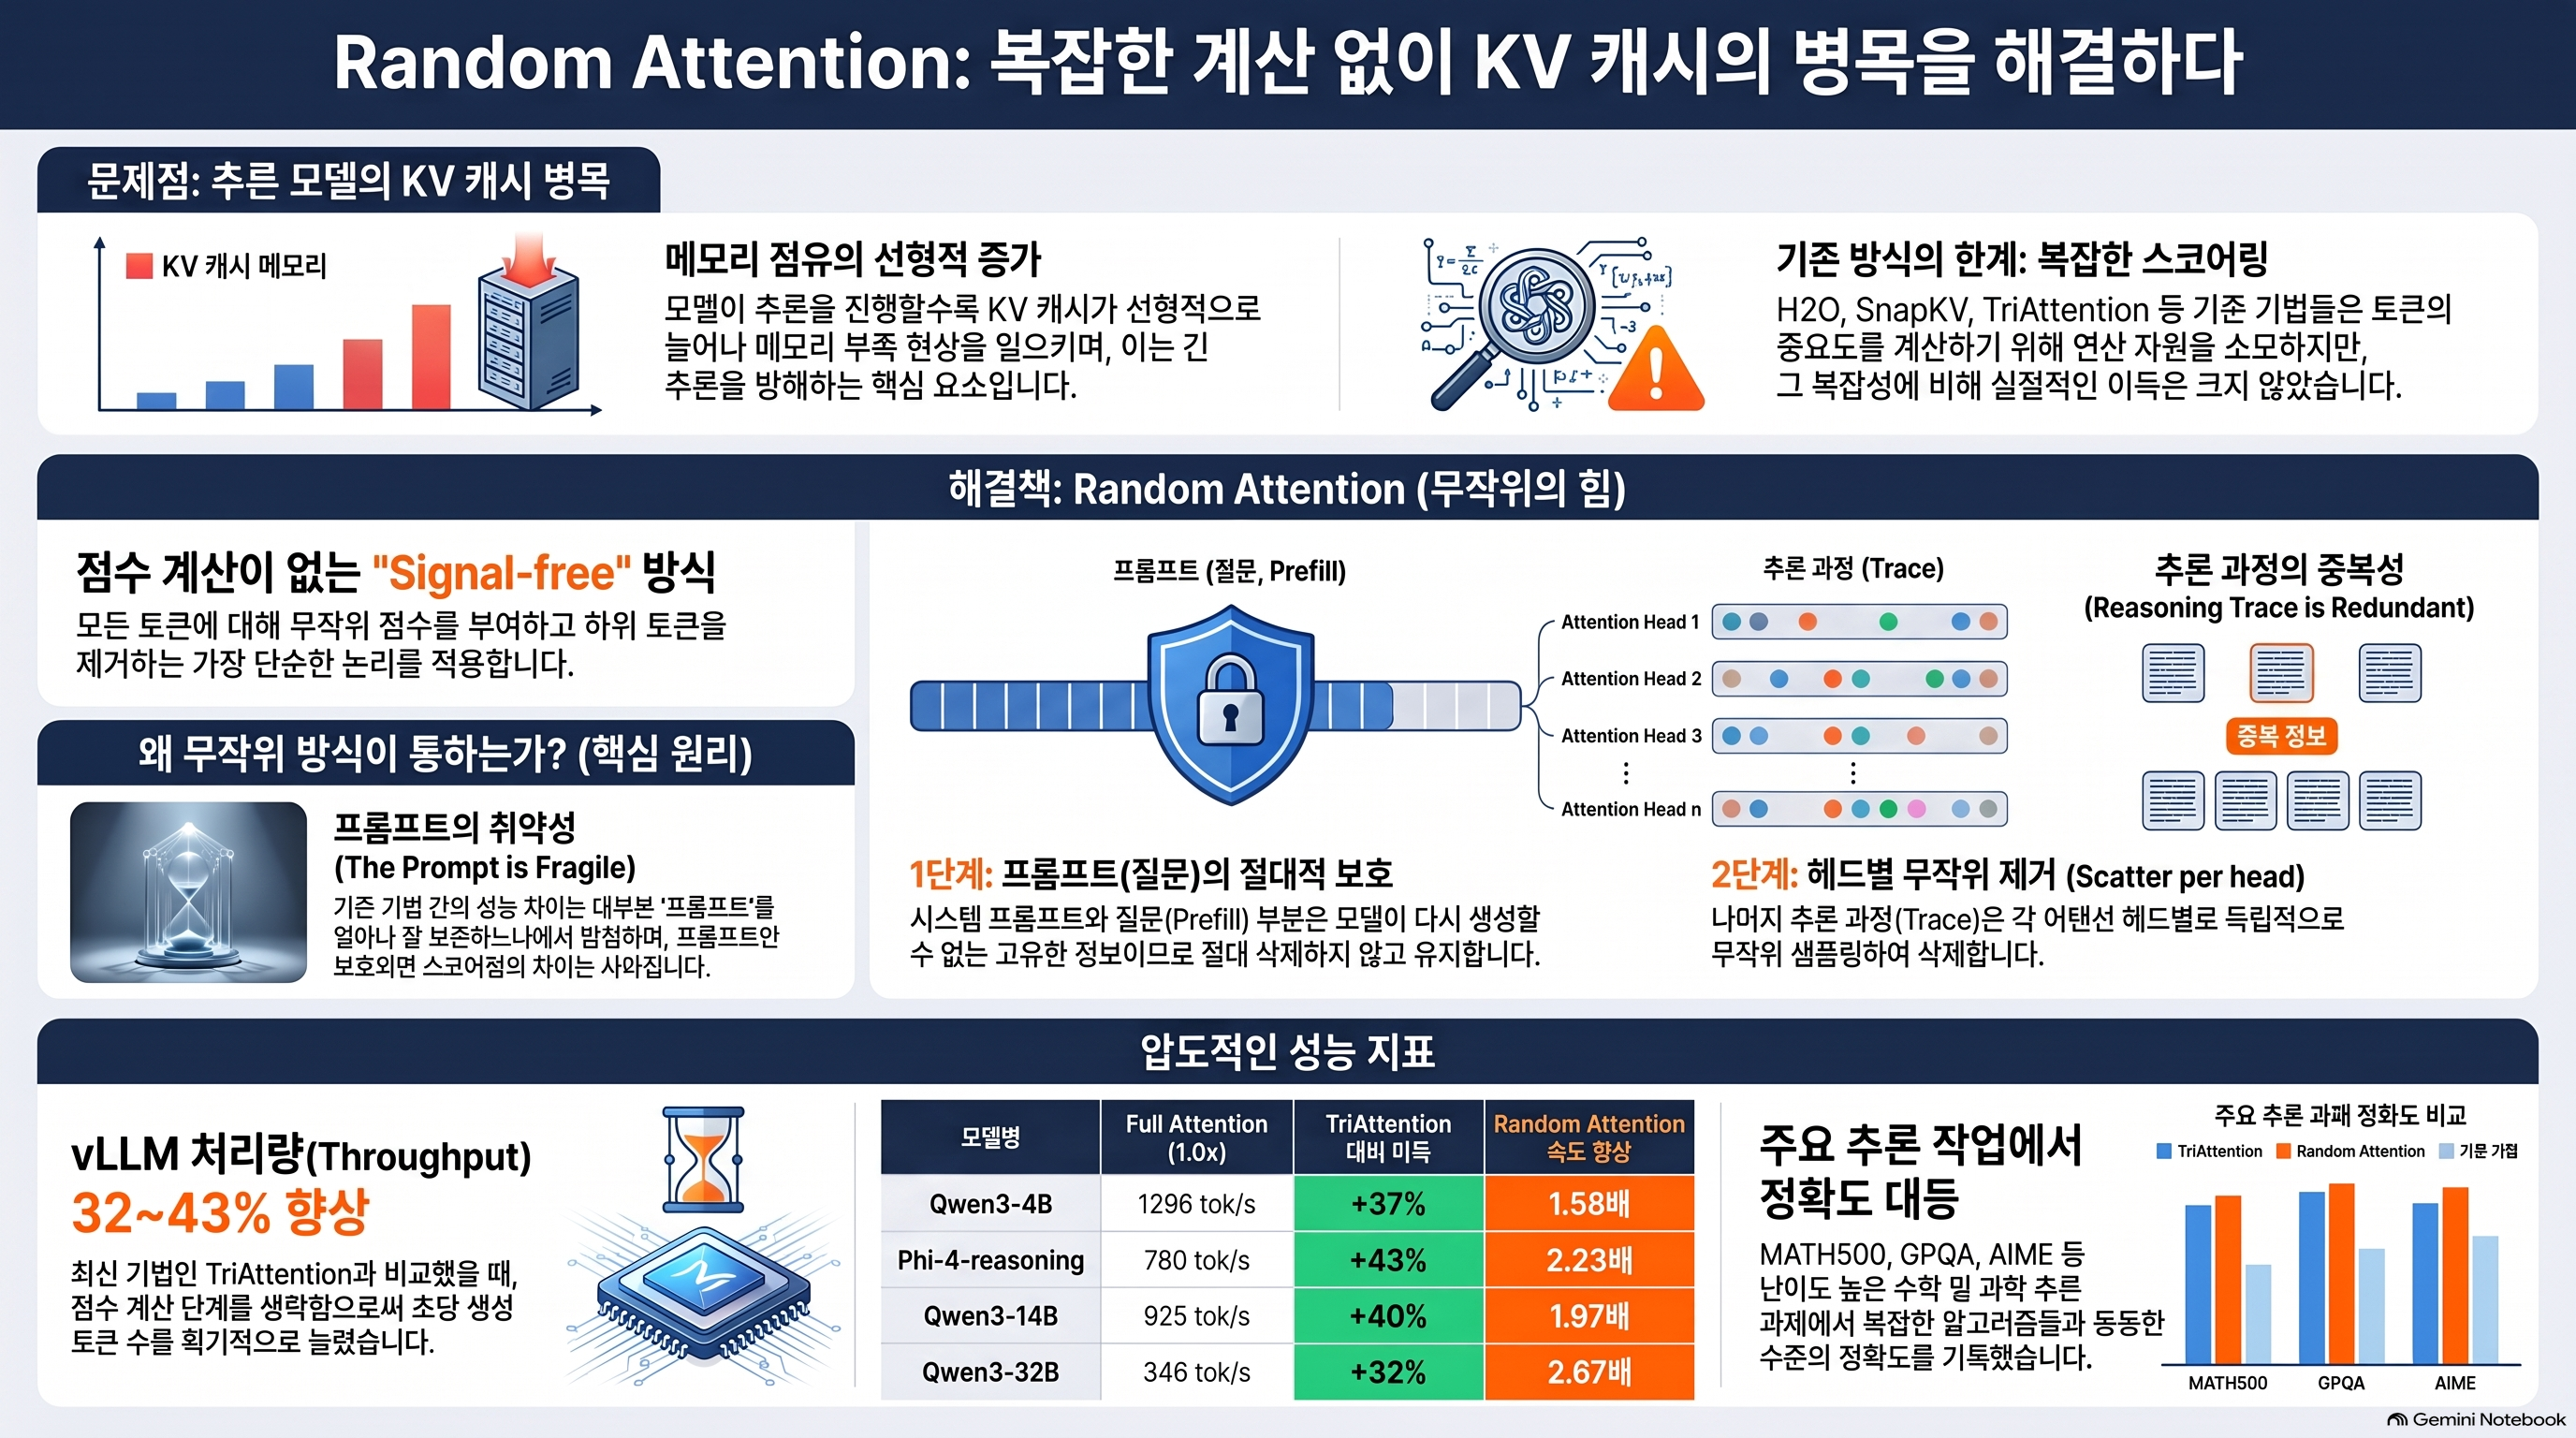
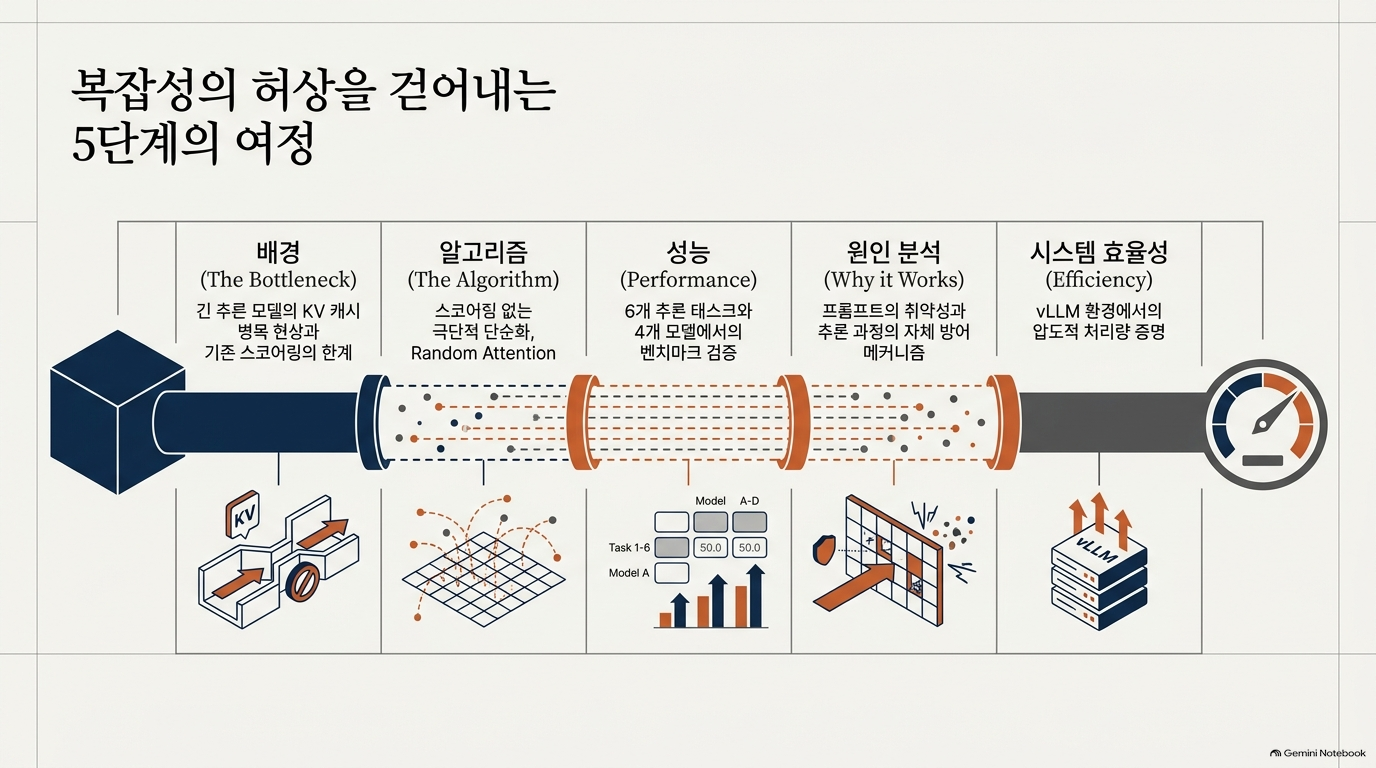
이 연구는 거대 언어 모델(LLM)이 복잡한 추론을 수행할 때 발생하는 메모리 병목 현상을 해결하기 위해 무작위 어텐션(Random Attention)이라는 혁신적인 KV 캐시 제거 방식을 제안합니다. 기존 기술들은 다음에 중요할 토큰을 예측하여 점수를 매기고 선별하는 복잡한 알고리즘을 사용했으나, 본 논문은 이러한 선택 신호가 성능 유지에 거의 기여하지 않는다는 사실을 실험적으로 증명합니다. 대신 연구진은 질문이 포함된 프롬프트를 영구 보존하고 나머지 추론 과정의 데이터는 각 어텐션 헤드에서 무작위로 삭제하는 단순한 전략만으로도 최첨단 기법들과 대등한 정확도를 기록했습니다. 추론 과정은 텍스트 자체의 반복성과 여러 어텐션 헤드에 걸친 데이터 중복성 덕분에 무작위 추출만으로도 필요한 정보를 충분히 보존할 수 있는 자가 보호 기제(self-protection)를 갖추고 있습니다. 결과적으로 이 방식은 별도의 계산 과정이 필요 없어 연산 효율이 극대화되며, 실제 배포 환경에서 기존 방식보다 32~43% 더 높은 처리량(throughput)을 달성하여 효율적인 장문 추론의 새로운 표준을 제시합니다.
초록 (Abstract)
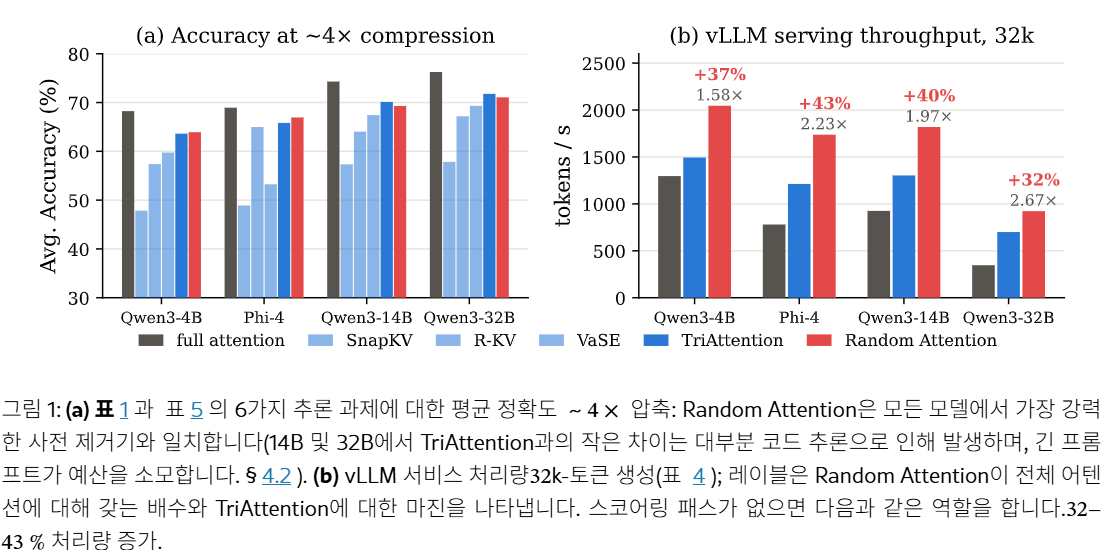
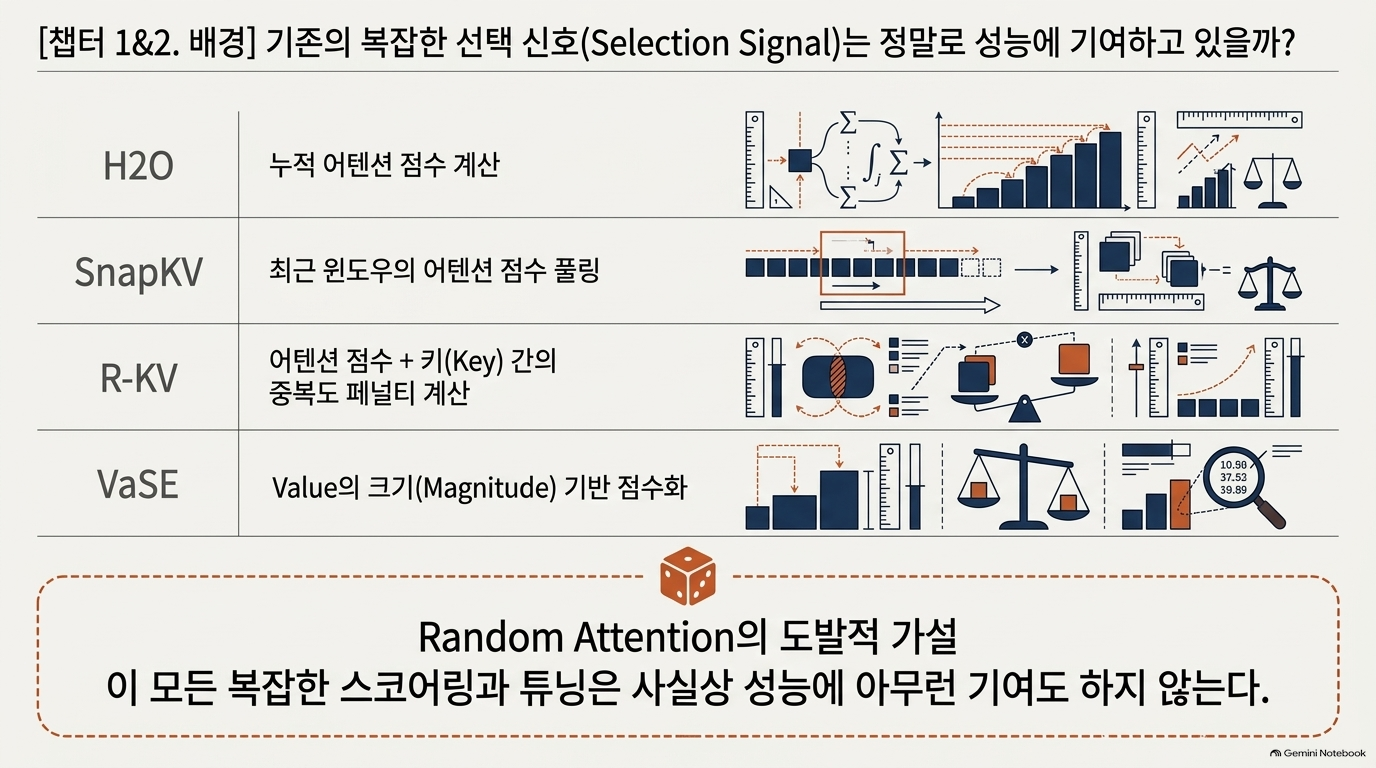
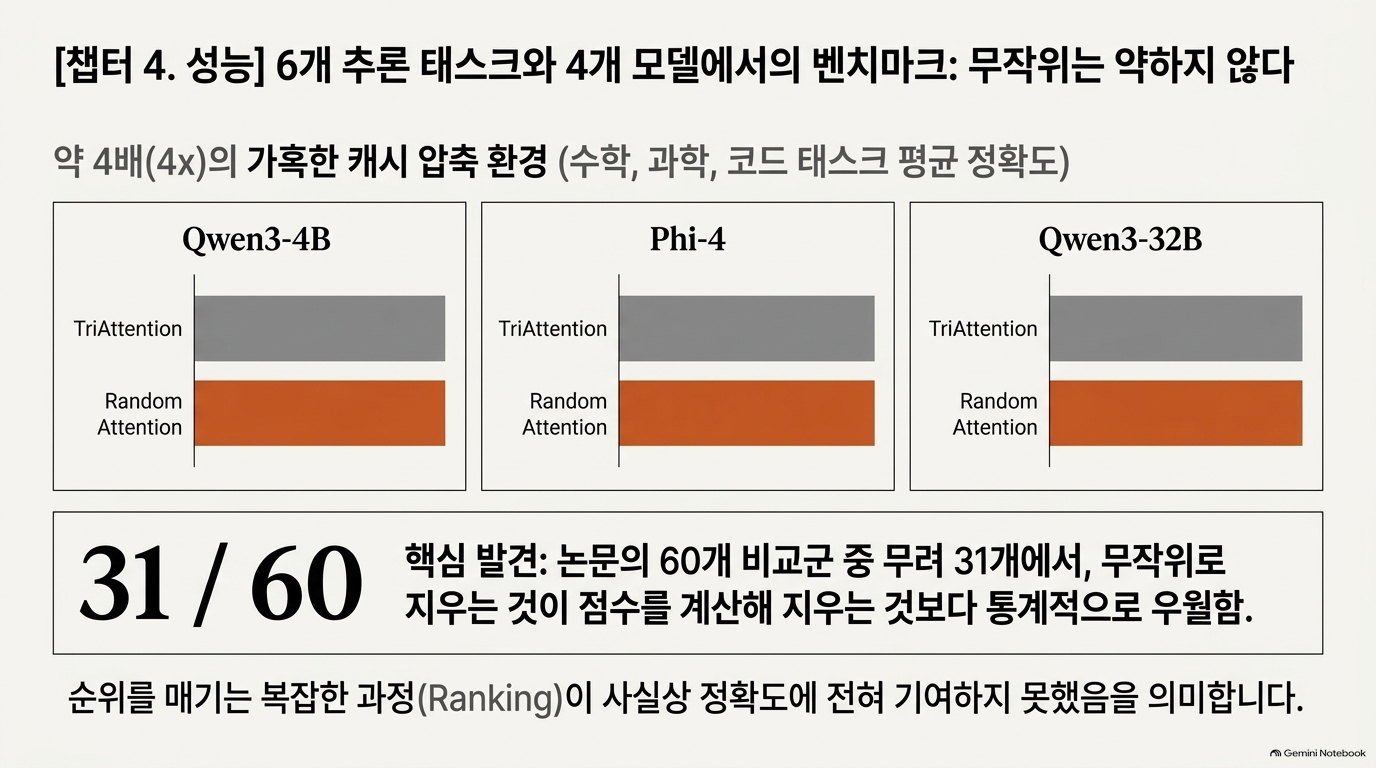
추론에 특화된 LLM은 매우 긴 사고 과정을 생성하기 때문에 KV 캐시가 심각한 메모리 병목이 되는데, 기존 압축 기법들은 모두 "각 캐시 토큰에 중요도 점수를 매기고 상위 점수만 남긴다"는 동일한 패러다임을 공유한다. 저자들은 이 점수화(선택 신호)가 실제로는 거의 기여하지 않음을 보이고, 프롬프트는 보존하되 나머지는 각 어텐션 헤드 내에서 완전히 균등 무작위로 제거하는 Random Attention을 제안한다. 4개 모델·6개 추론 과제에서 기존 최강 기법과 동등한 성능을 내며 vLLM 서빙에서는 32~43% 더 높은 처리량을 낸다.
1장 서론 (Introduction)
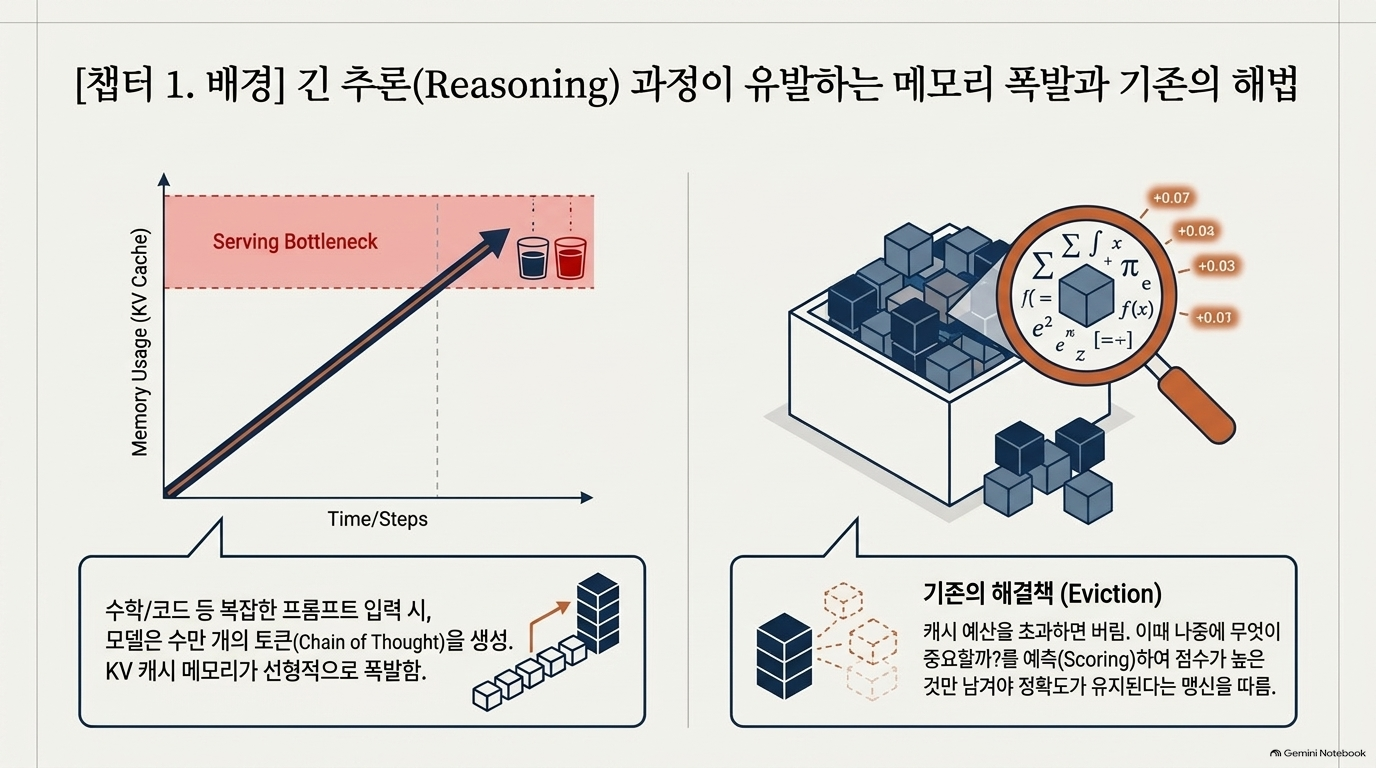
배경: 추론 모델(DeepSeek-R1, OpenAI o1 계열, Phi-4-reasoning 등)은 수만 토큰짜리 사고 체인을 생성하며, KV 캐시가 생성 길이에 비례해 선형으로 늘어나 메모리 병목이 됨.
기존 흐름의 계보: accumulated attention(H2O) → recent-window attention(SnapKV) → attention+redundancy(R-KV) → value magnitude(VaSE) → position 통계(TriAttention) 순으로 "더 나은 점수"를 찾는 연구가 이어져 왔음.
이 논문의 반박 실험: Qwen3-4B/14B/32B, Phi-4-reasoning 4개 모델 × 수학·과학·코드 6개 과제에서, Random Attention은 60개 baseline 비교 중 31개에서 유의미하게 앞섰고, 뒤진 경우는 코드 추론 1개(Qwen3-32B)뿐이었으며, 이 열세도 선택 신호 자체보다는 프롬프트 길이 때문임이 4.2절에서 밝혀짐.
설명 메커니즘 2가지 예고:
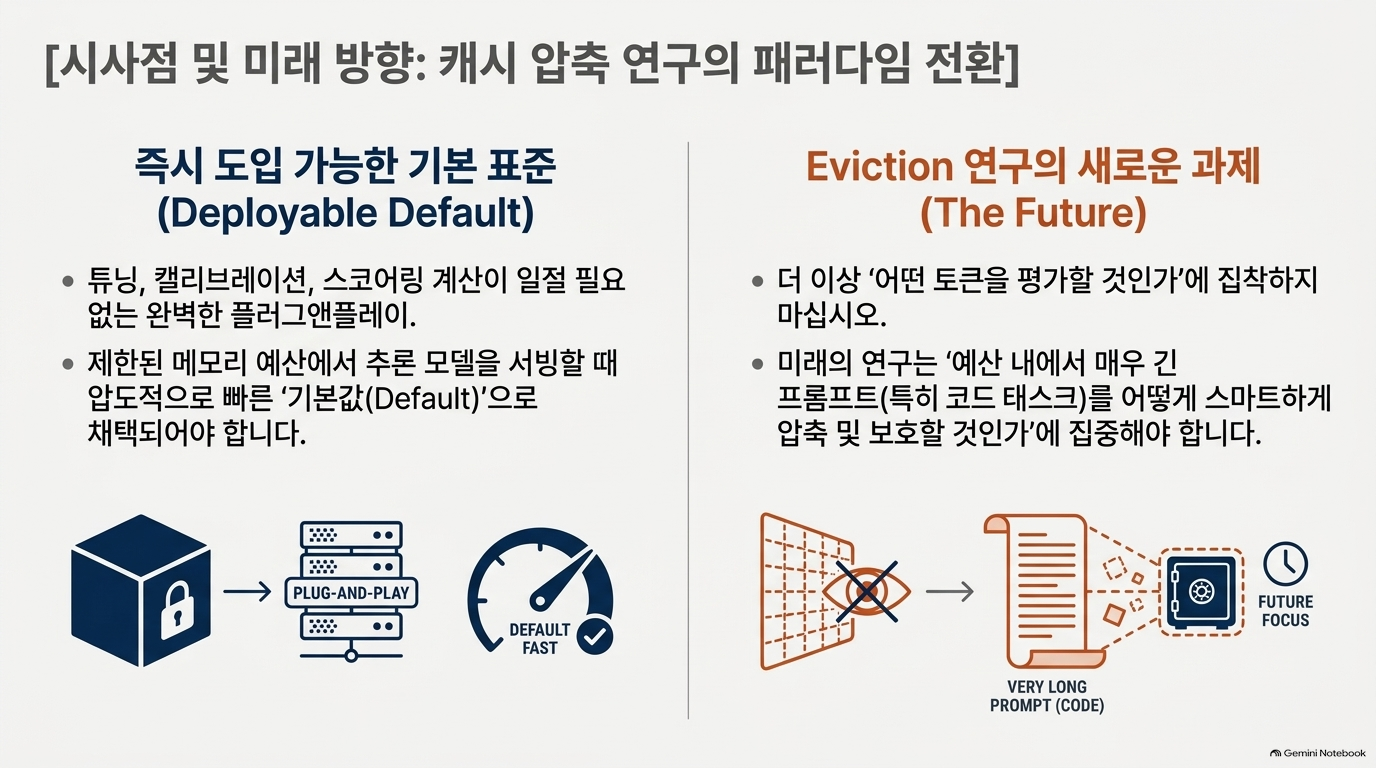
실무적 함의 2가지: (1) Random Attention 자체가 튜닝·보정 없이 바로 쓸 수 있는 배포 가능한 기본값, (2) 향후 연구는 "무엇을 보호할지"(긴 프롬프트 예산 배분, 한 번만 언급되고 다시 등장하지 않는 희귀 사실 복원)에 집중해야 함을 시사.
2장 예비 개념 (Preliminaries)
항목
내용
Setting
디코딩 중 발생하는 KV 캐시 축출(eviction)을 다룸 — 200토큰짜리 질문에 1만 토큰 이상의 사고 체인이 뒤따르는 상황. eviction은 예산 초과 시 KV 쌍을 영구히 버리는 것으로, 모든 쌍을 메모리에 유지한 채 일부에만 attend하는 sparse-attention selection과는 다름
Notation
디코드 스텝 tt t, 캐시된 KV 쌍 (ki,vi)(k_i, v_i) (ki,vi), 어텐션 가중치 αi(t)\alpha_i^{(t)} αi(t) (softmax), layer·head별로 독립적으로 eviction 결정
Periodic eviction (K, r)
예산 𝐾K + 최근 버퍼 𝑟r(𝑟≪𝐾r≪K)를 유지. 버퍼가 차면(매 𝑟r 스텝) eviction 트리거 → 후보군에 점수 𝑠 𝑖 si부여 → top-𝐾K만 유지. Eviction은 단조적(monotonic, 한 번 버려지면 복구 불가)
Baselines as choices of s
StreamingLLM(점수 없음, sink+최근 창), H2O(si= 누적 어텐션), SnapKV(최근 w개 쿼리의 max-pool 어텐션), R-KV(SnapKV 점수 + 중복도 페널티 1−cˉi), VaSE(value range 기준 상위 고정 + 나머지는 SnapKV 점수 비례 샘플링), TriAttention(위치 거리 기반 삼각함수 점수 + 헤드별 보정)
[보완 내용 — 출처: 일반 트랜스포머 서빙 지식]논문은 KV 캐시 자체의 정의를 전제하고 시작합니다. 간단히 보완하면, Transformer의 self-attention은 매 디코딩 스텝마다 이전 모든 토큰의 Key·Value 벡터가 필요한데, 이를 매번 재계산하지 않도록 저장해두는 것이 KV 캐시입니다. 시퀀스가 길어질수록 캐시 크기가 선형으로 증가해 GPU 메모리를 압박하는 것이 이 논문 전체의 문제의식입니다.
3장 Random Attention (제안 방법)
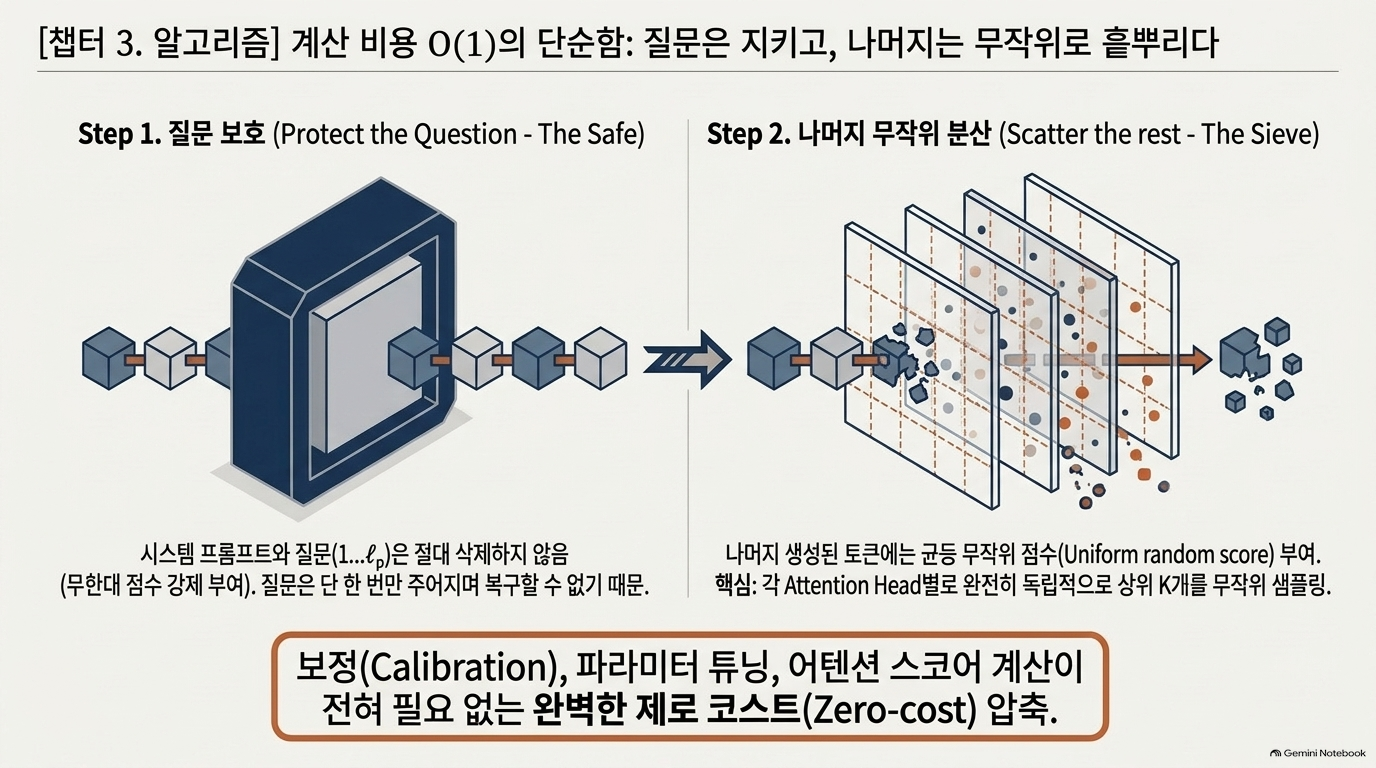
핵심 아이디어는 "질문(프롬프트)은 한 번만 등장하므로 지워지면 복구 불가 / 사고 트레이스는 계속 반복·재진술되므로 복구 가능"이라는 비대칭성을 이용하는 것입니다.
두 가지 구조적 선택:
질문 보호: 프리필 전체(시스템 프롬프트+챗 템플릿+질문, 위치 1,…,ℓp)는 절대 축출하지 않음.
나머지는 헤드별 무작위 분산: 남은 모든 캐시 위치에 i.i.d. 균등 난수 점수를 부여하고, 각 KV 헤드가 독립적으로 top-K를 유지.
수식으로는:
si={+∞,ui∼Uniform(0,1),i≤ℓp (프롬프트)그외
Algorithm 1 (한 번의 eviction, layer당 실행):
s ← rand(B, H_kv, S) — 캐시 위치·헤드별 i.i.d. 균등 점수
s[:, :, 0:ℓ_p] ← +∞ — 질문 강제 보존
keep ← topk(s, K) — 헤드별 독립 top-K
return keep
한 번의 eviction 비용은 rand 연산 1회와 topk 연산 1회뿐이며, 저자들은 이를 "적을 수 있는 가장 약한 선택 신호"이자 배포 가능한 방법인 동시에 영가설(null hypothesis) 역할을 한다고 규정합니다. 즉 어떤 새로운 선택 신호도 동일 예산·동일 프롬프트 보호 조건에서 이를 이기지 못하면 실질적 정보를 뽑아내지 못하는 것입니다.
수학·과학: Random Attention이 VaSE·SnapKV를 모든 모델에서 유의미하게 이기고, R-KV도 Qwen3-4B에서 유의미하게 이김. 어떤 선택 신호도 이 과제들에서 유의미하게 앞서지 못함.
경쟁 수학(AIME/HMMT): 표본이 작고 어려워 승부가 갈리지 않음(±5점 표준편차) — 압축이 심해질 때만 격차가 벌어짐(→4.3절).
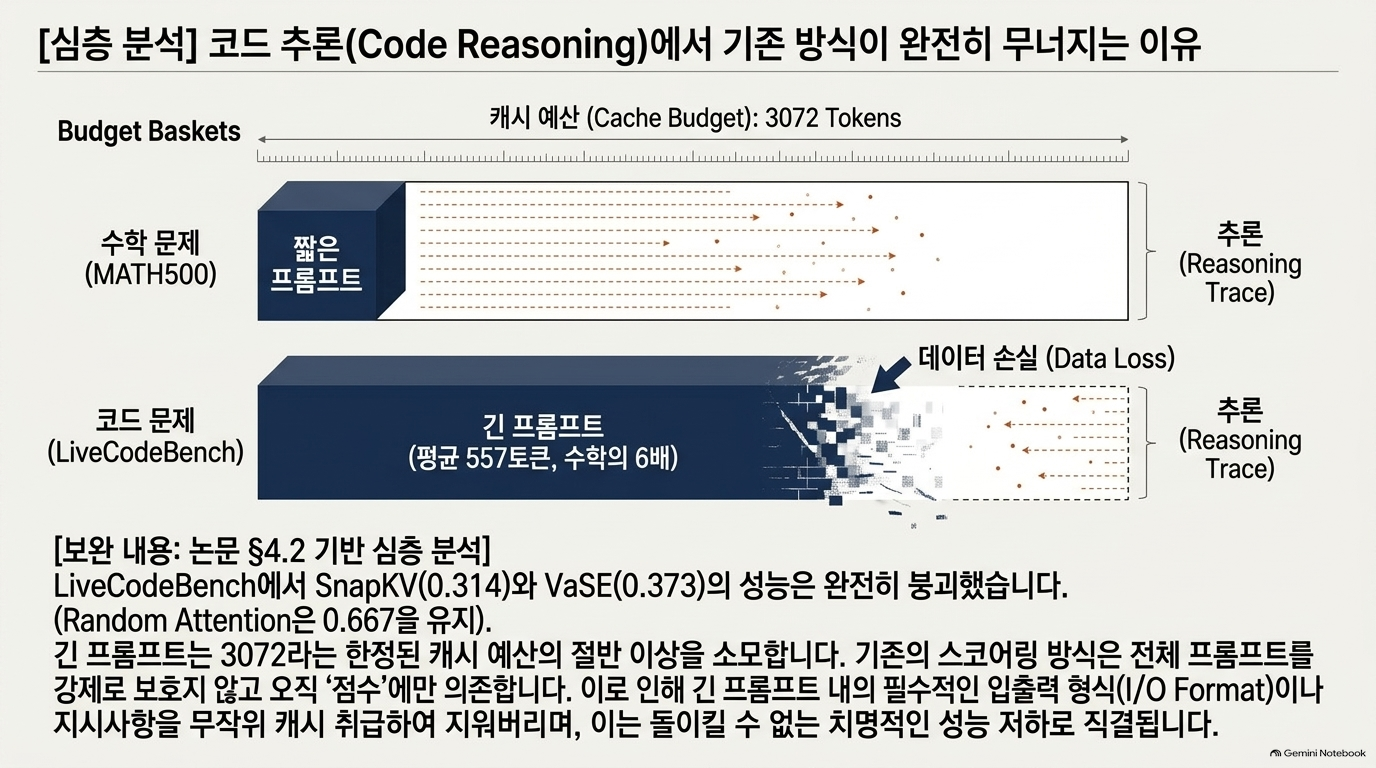
코드 추론: 유일하게 큰 격차가 나는 과제로, SnapKV는 20~35점을 잃음. 원인은 LiveCodeBench 프롬프트가 평균 557토큰으로 MATH500의 6배에 달해, 프롬프트를 못 지키는 selector가 크게 손해 보기 때문. TriAttention만 Qwen3-32B에서 약 3점 앞서는데(전체 그리드에서 유일하게 유의미한 baseline 승리), 이는 Random Attention이 모든 프롬프트 토큰을 통째로 보호하다 보니 코드 프롬프트의 "스캐폴딩"(입출력 형식 등) 압축 여지를 못 살리기 때문.
4.3 압축 강도 증가 시 격차 확대
2×~16× 압축 구간(Qwen3-4B, Phi-4-reasoning, 수학·과학 4개 과제)에서, 2배 압축에서는 모든 방법이 완전 어텐션에 근접하지만 예산이 빡빡해질수록 Random Attention은 TriAttention과 동률을 유지하는 반면 VaSE와의 격차는 벌어짐.
5장 왜 선택 신호가 거의 소용없는가 (핵심 설명 장)
캐시 내용을 두 종류로 나눕니다: 프롬프트(한 번만 등장, 취약함) vs 작업 상태/사고 트레이스(계속 재진술됨, 중복성이 높음).
5.1 프롬프트가 취약한 부분이다
Table 2(발췌)로 "점수만 사용 vs 점수+프롬프트 보호"를 비교:
방법
MATH500(Qwen3-4B) 점수만
+프롬프트 보호
개선폭
SnapKV
0.703
0.829
+12.6
R-KV
0.810
0.812
+0.2
VaSE
0.809
0.812
+0.3
Random Attention
0.459
0.874
+41.5
프롬프트를 원래 적게 지키던 SnapKV일수록 개선폭이 컸고(최대 22.5점), 원래 많이 지키던 R-KV는 거의 개선이 없었음(최대 1.9점). 모든 방법이 동일하게 프롬프트를 보호하도록 통일하면 세 baseline 간 격차는 2.2점 이내로 좁혀짐 — 즉 방법들 간 차이의 대부분은 "점수의 우수성"이 아니라 "프롬프트 보호 여부"였다는 결론입니다.
5.2 작업 상태는 스스로를 보호한다
이중 중복성:
텍스트 차원: 모델이 사고 과정에서 이미 사용 중인 정보를 계속 재진술함 (R-KV의 관찰을 재확인).
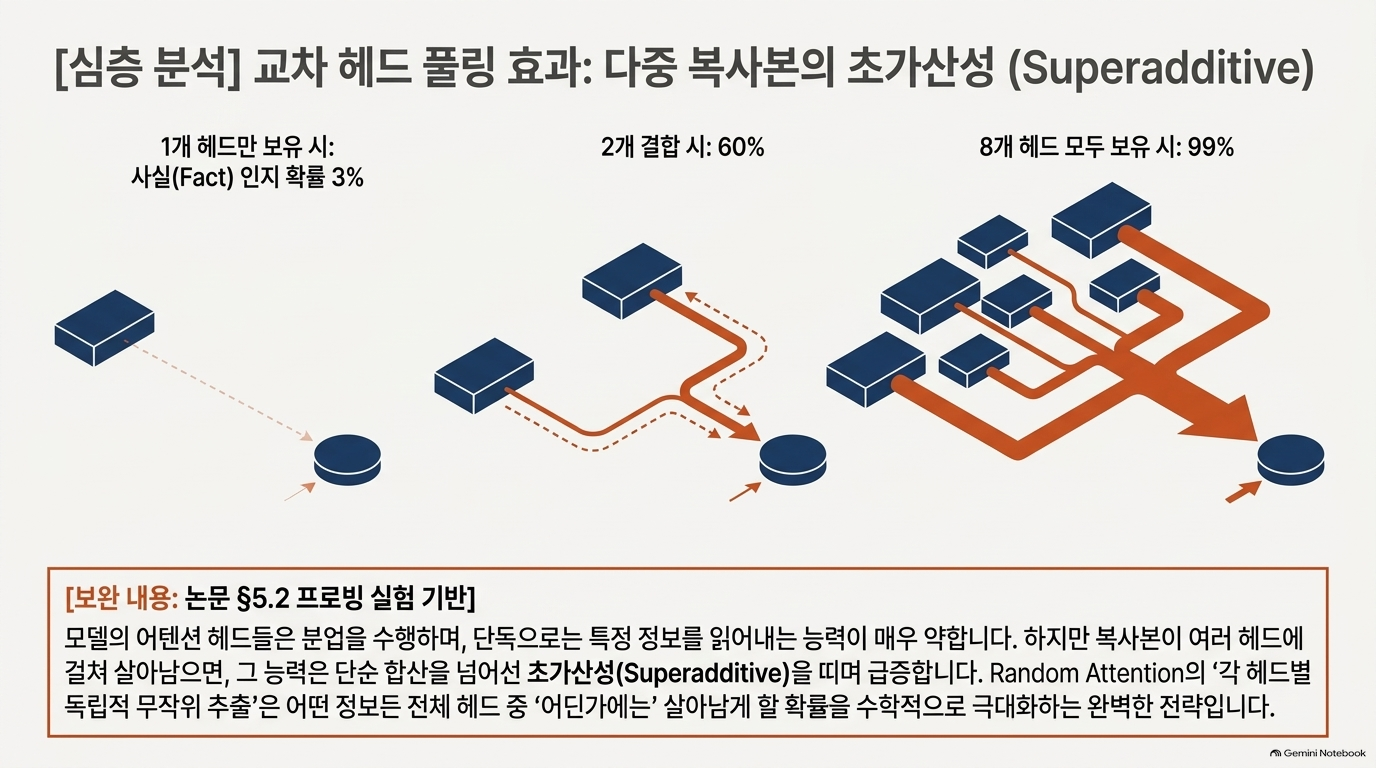
헤드 차원: 모든 KV 헤드가 각 토큰의 사본을 독립적으로 보관하며, eviction은 헤드마다 별도로 어느 사본이 죽을지 결정하므로, 모든 헤드가 동시에 그 토큰을 버릴 때만 정보가 완전히 소실됨.
Planted-fact probe 실험: MATH500 실제 추론 트레이스에 가짜 사실(예: "zq = 4729")을 삽입하고 질문 시점의 회수 여부를 측정. 지표는 Retrieval(정답 재생성 비율)과 식 (4)의 Recall
R=∑i(LPikept−LPidel)∑i(LPi−LPidel) (R=1이면 완전 보존, R=0이면 완전 소실).
헤드 간 풀링(pooling): Qwen3-4B의 8개 KV 헤드 중 사실을 단독 보유해도 쓸모 있는 헤드는 3개뿐이며 최고 단일 헤드조차 3% 확률로만 값을 재현하지만, 두 헤드를 합치면 60%, 세 헤드면 83%, 8개 전부면 99%까지 상승 — 초가산적(superadditive) 효과.
사본의 형태는 무관함: 사실을 토큰 단위로 헤드에 분산시켜도 회수율은 거의 변하지 않음(0.33 vs 온전한 문장 0.39), 실제 MATH500 트레이스에서도 블록 크기를 1~64토큰으로 바꿔도 정확도 손실 없음(256에서만 저하) — 중요한 것은 헤드당 남은 "덩어리 개수"이지 덩어리의 모양이나 위치가 아님.
5.3 선택 신호가 여전히 유용한 경우
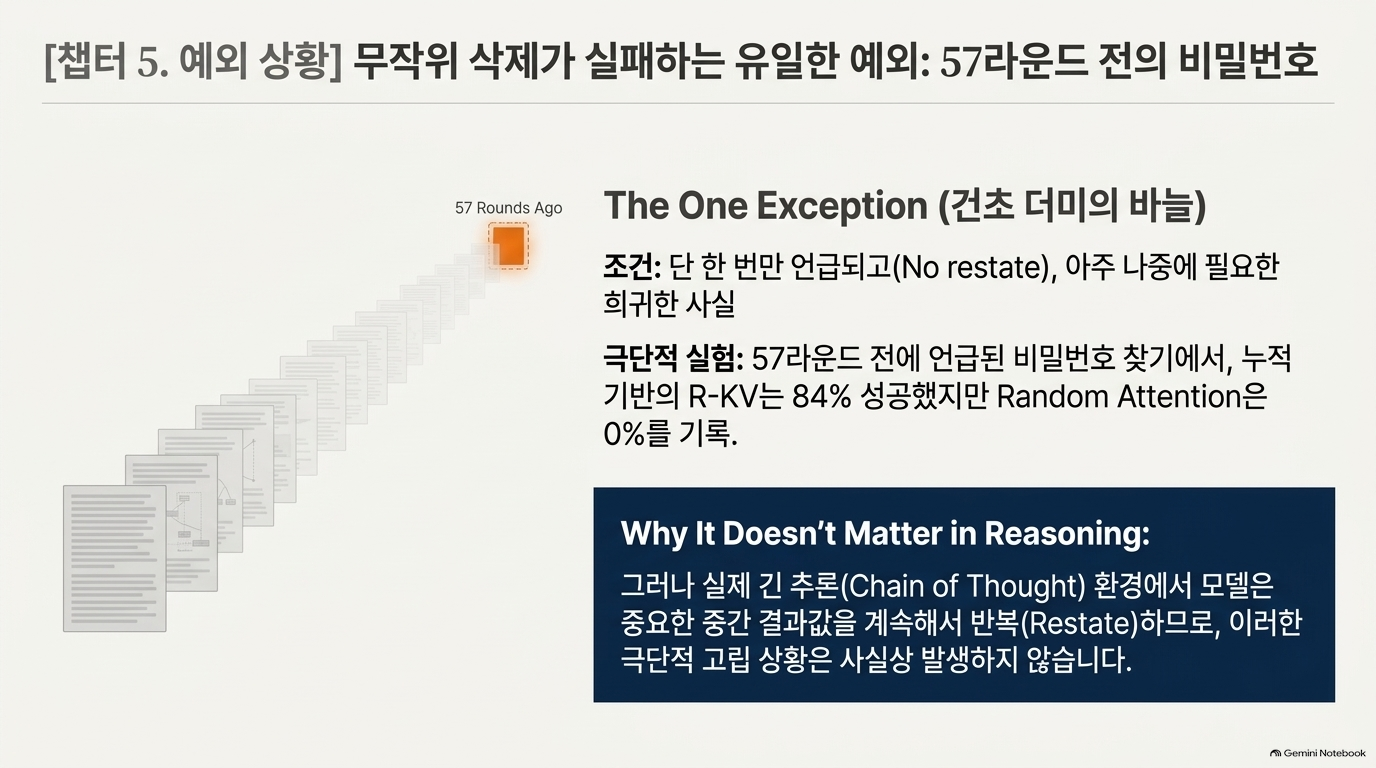
Table 3(패스코드 실험, 57번의 압축 라운드 전에 한 번만 언급): Random Attention 회수율 0.000, R-KV(누적 어텐션 기반) 0.836, VaSE 0.344, SnapKV·TriAttention은 거의 0. 즉 "한 번만 언급되고 다시 등장하지 않는 희귀 사실"을 찾는 능력(needle-finding)은 실제로 존재하지만, 이는 종합 성능과는 별개의 능력이며 실제 사고 트레이스에서는 드물게 발생하는 경우입니다.
6장 효율성 평가 (Efficiency Evaluation)
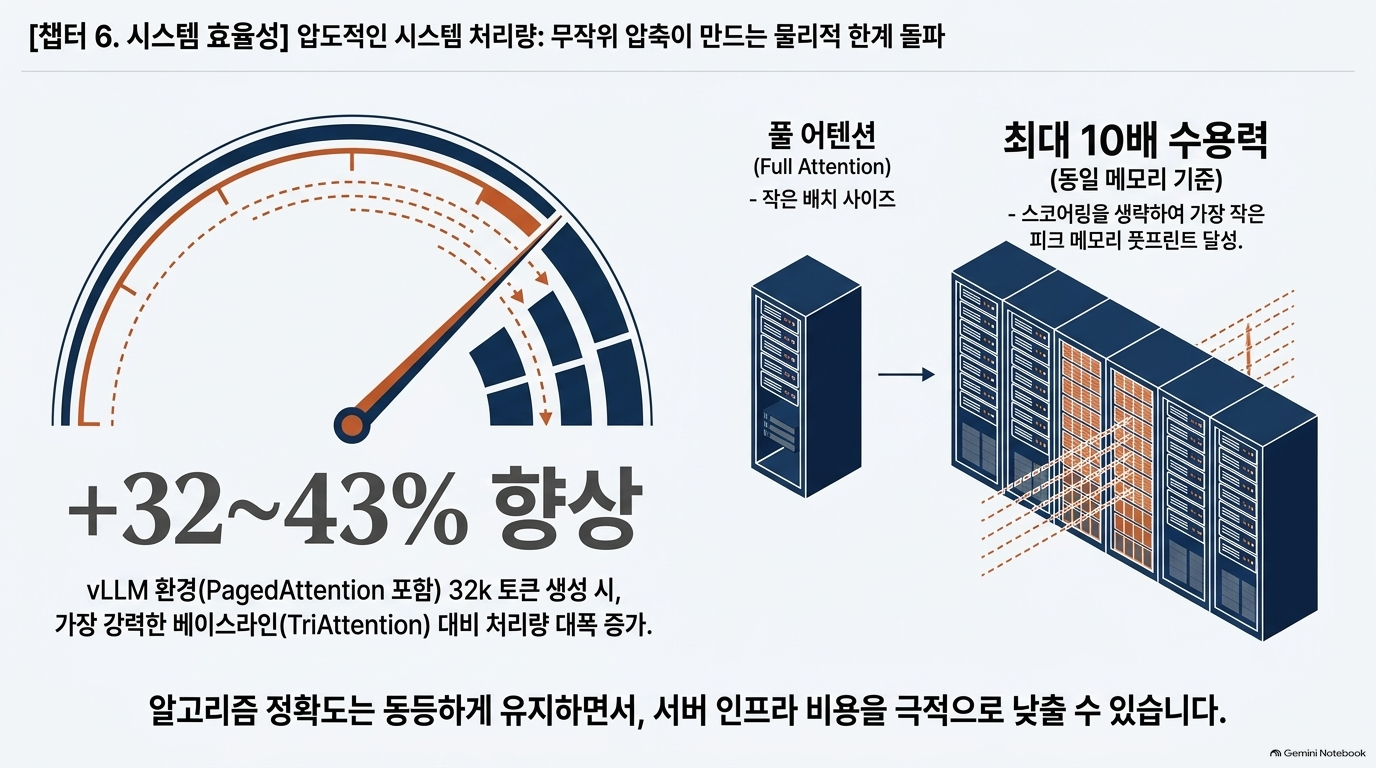
vLLM+PagedAttention 서빙(Table 4): H200 1장, K=2048, 1k 프롬프트, 32k 생성 기준. Random Attention은 완전 어텐션 대비 1.6~2.7배, TriAttention 대비 32~43% 더 높은 처리량을 냄.
동일 메모리 비교: 예산이 만들어주는 배치 크기 증가분은 모든 evictor가 공유하지만, 스코어링 패스가 없는 Random Attention이 가장 큰 배치·최소 메모리 사용으로 10.0×(Qwen3-4B), 8.8×(Qwen3-14B) 처리량 달성.
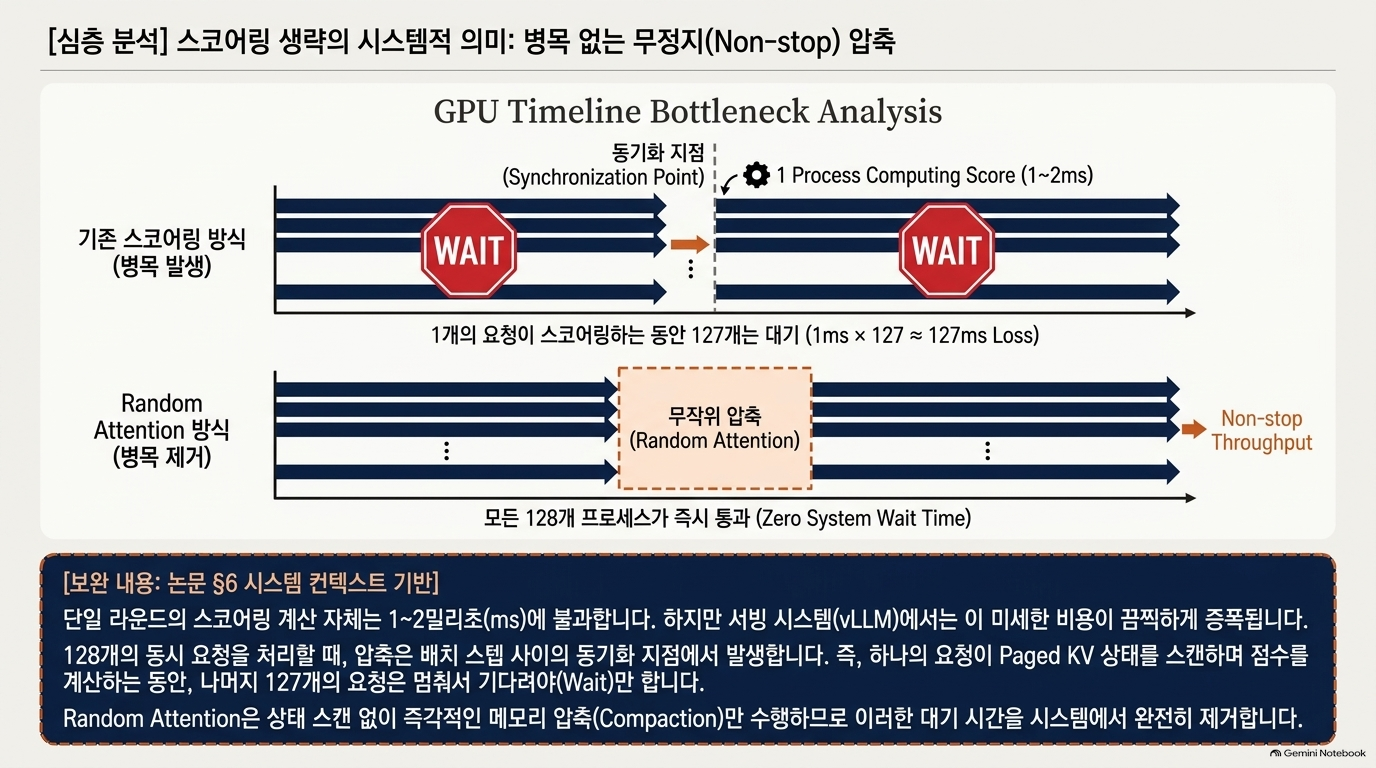
왜 32~43% 이득인가: 단일 스트림에서 eviction 라운드 하나의 비용은 Random Attention 0.30ms, TriAttention 1.47~1.64ms로 크지 않지만, 서빙 시 128개 동시 요청이 배치 동기화 지점에서 모두 대기해야 하므로 이 작은 비용이 누적되어 큰 처리량 차이로 이어짐.
[보완 내용 — 출처: vLLM/PagedAttention 원 논문(Kwon et al., 2023), 본문 인용] PagedAttention은 KV 캐시를 OS의 가상 메모리처럼 페이지 단위로 관리해 메모리 단편화를 줄이는 서빙 기법입니다. 이 논문 6장의 효율성 수치는 이 서빙 인프라 위에서 측정된 것이며, "스코어링 패스가 없다"는 것이 왜 특히 페이지 기반 서빙에서 큰 이득이 되는지(캐시 상태를 다시 읽는 추가 패스가 필요 없음)는 Appendix G에서 더 자세히 다룹니다.
7장 관련 연구 (Related Work)
긴 컨텍스트 이해용 KV 캐시: Quantization(KIVI, KVQuant), Eviction(H2O, SnapKV류 및 헤드/레이어별 적응 예산), Query-aware selection(Quest, 메모리는 안 줄임). 무작위성 관련 선행 연구(Wu et al. 2026의 prefix-sharing eviction, Roy et al. 2026의 coverage 샘플링, Garcia 2026의 "경계만 지키면 점수는 부차적"이라는 관찰)와의 차이점: 이 논문은 짧은 프롬프트+긴 생성이라는 반대 상황을 다루며, 지켜야 할 것은 경계가 아니라 프롬프트 전체.
긴 추론용 KV 캐시: R-KV, VaSE, TriAttention, LazyEviction, SpeContext(경량 증류 모델로 중요 KV 예측), 그리고 동시대 연구인 Prefix Sliding(Muennighoff et al. 2026 — 이 논문의 recency+prompt 베이스라인과 동일한 정책을 채택). 기존 평가들은 무작위/최근성 베이스라인이 스코어 기반 선택에 크게 뒤진다고 보고했는데, 이 논문은 그 원인이 "무작위 베이스라인이 프롬프트를 잃었기 때문"이라는 교란 요인(confound)임을 지적.
8장 결론 (Conclusion)
추론용 KV 캐시 축출은 그동안 "무엇이 중요할지 순위를 매기는 문제"로 다뤄져 왔지만, 이 순위화는 사실상 거의 기여하지 않는다는 것이 이 논문의 결론입니다. 프롬프트를 지키고 헤드 내에서 완전 무작위로 축출하는 정책이 4개 모델·6개 과제에서 최강 베이스라인과 동등하며 vLLM 서빙에서 32~43% 더 빠릅니다. 남는 과제는 (1) 코드처럼 긴 프롬프트의 예산 배분, (2) 한 번만 언급되고 재진술되지 않는 희귀 사실의 복원입니다.
논문 말미의 AI 사용 성명에서는 초고 작성·분석 코드 구현·표 조판에는 생성형 AI를 사용했으나 실험 설계·가설 선정·측정값 산출에는 사용하지 않았고, 보고된 통계는 저자들이 공개된 로그에서 재계산했다고 명시하고 있습니다.