반응형
https://cohere.com/blog/megakernels
2026.9.9
[Inside the megakernel serving engine for North Mini Code]
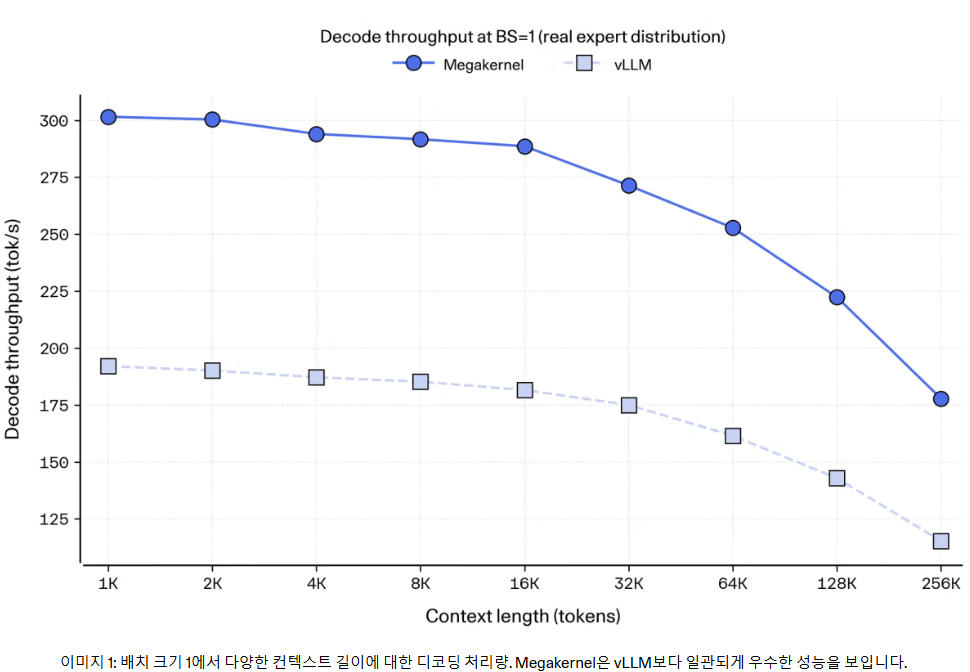
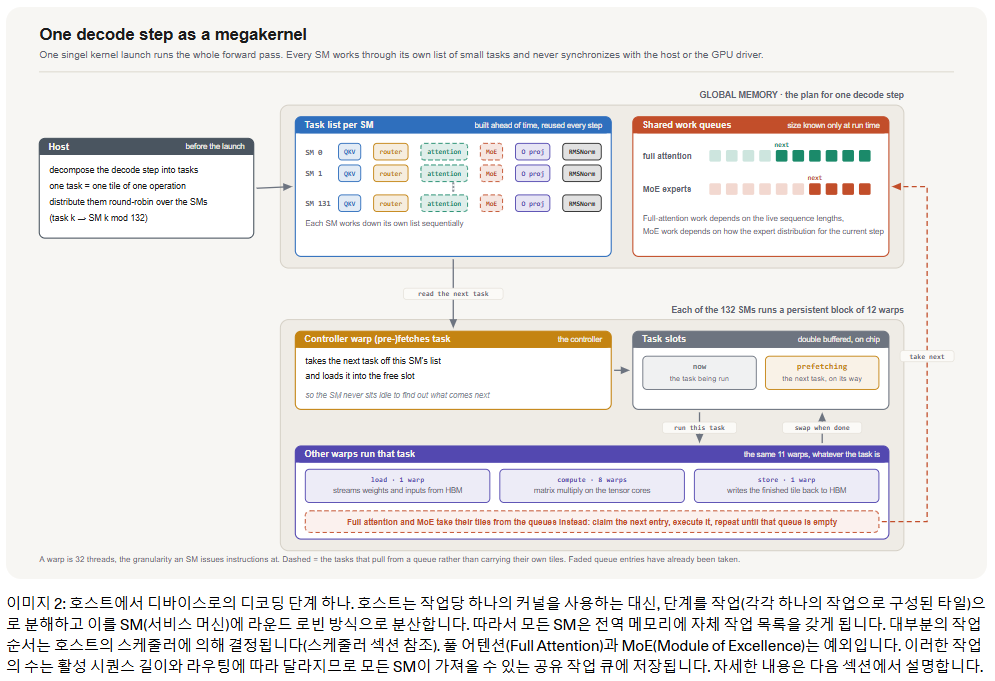
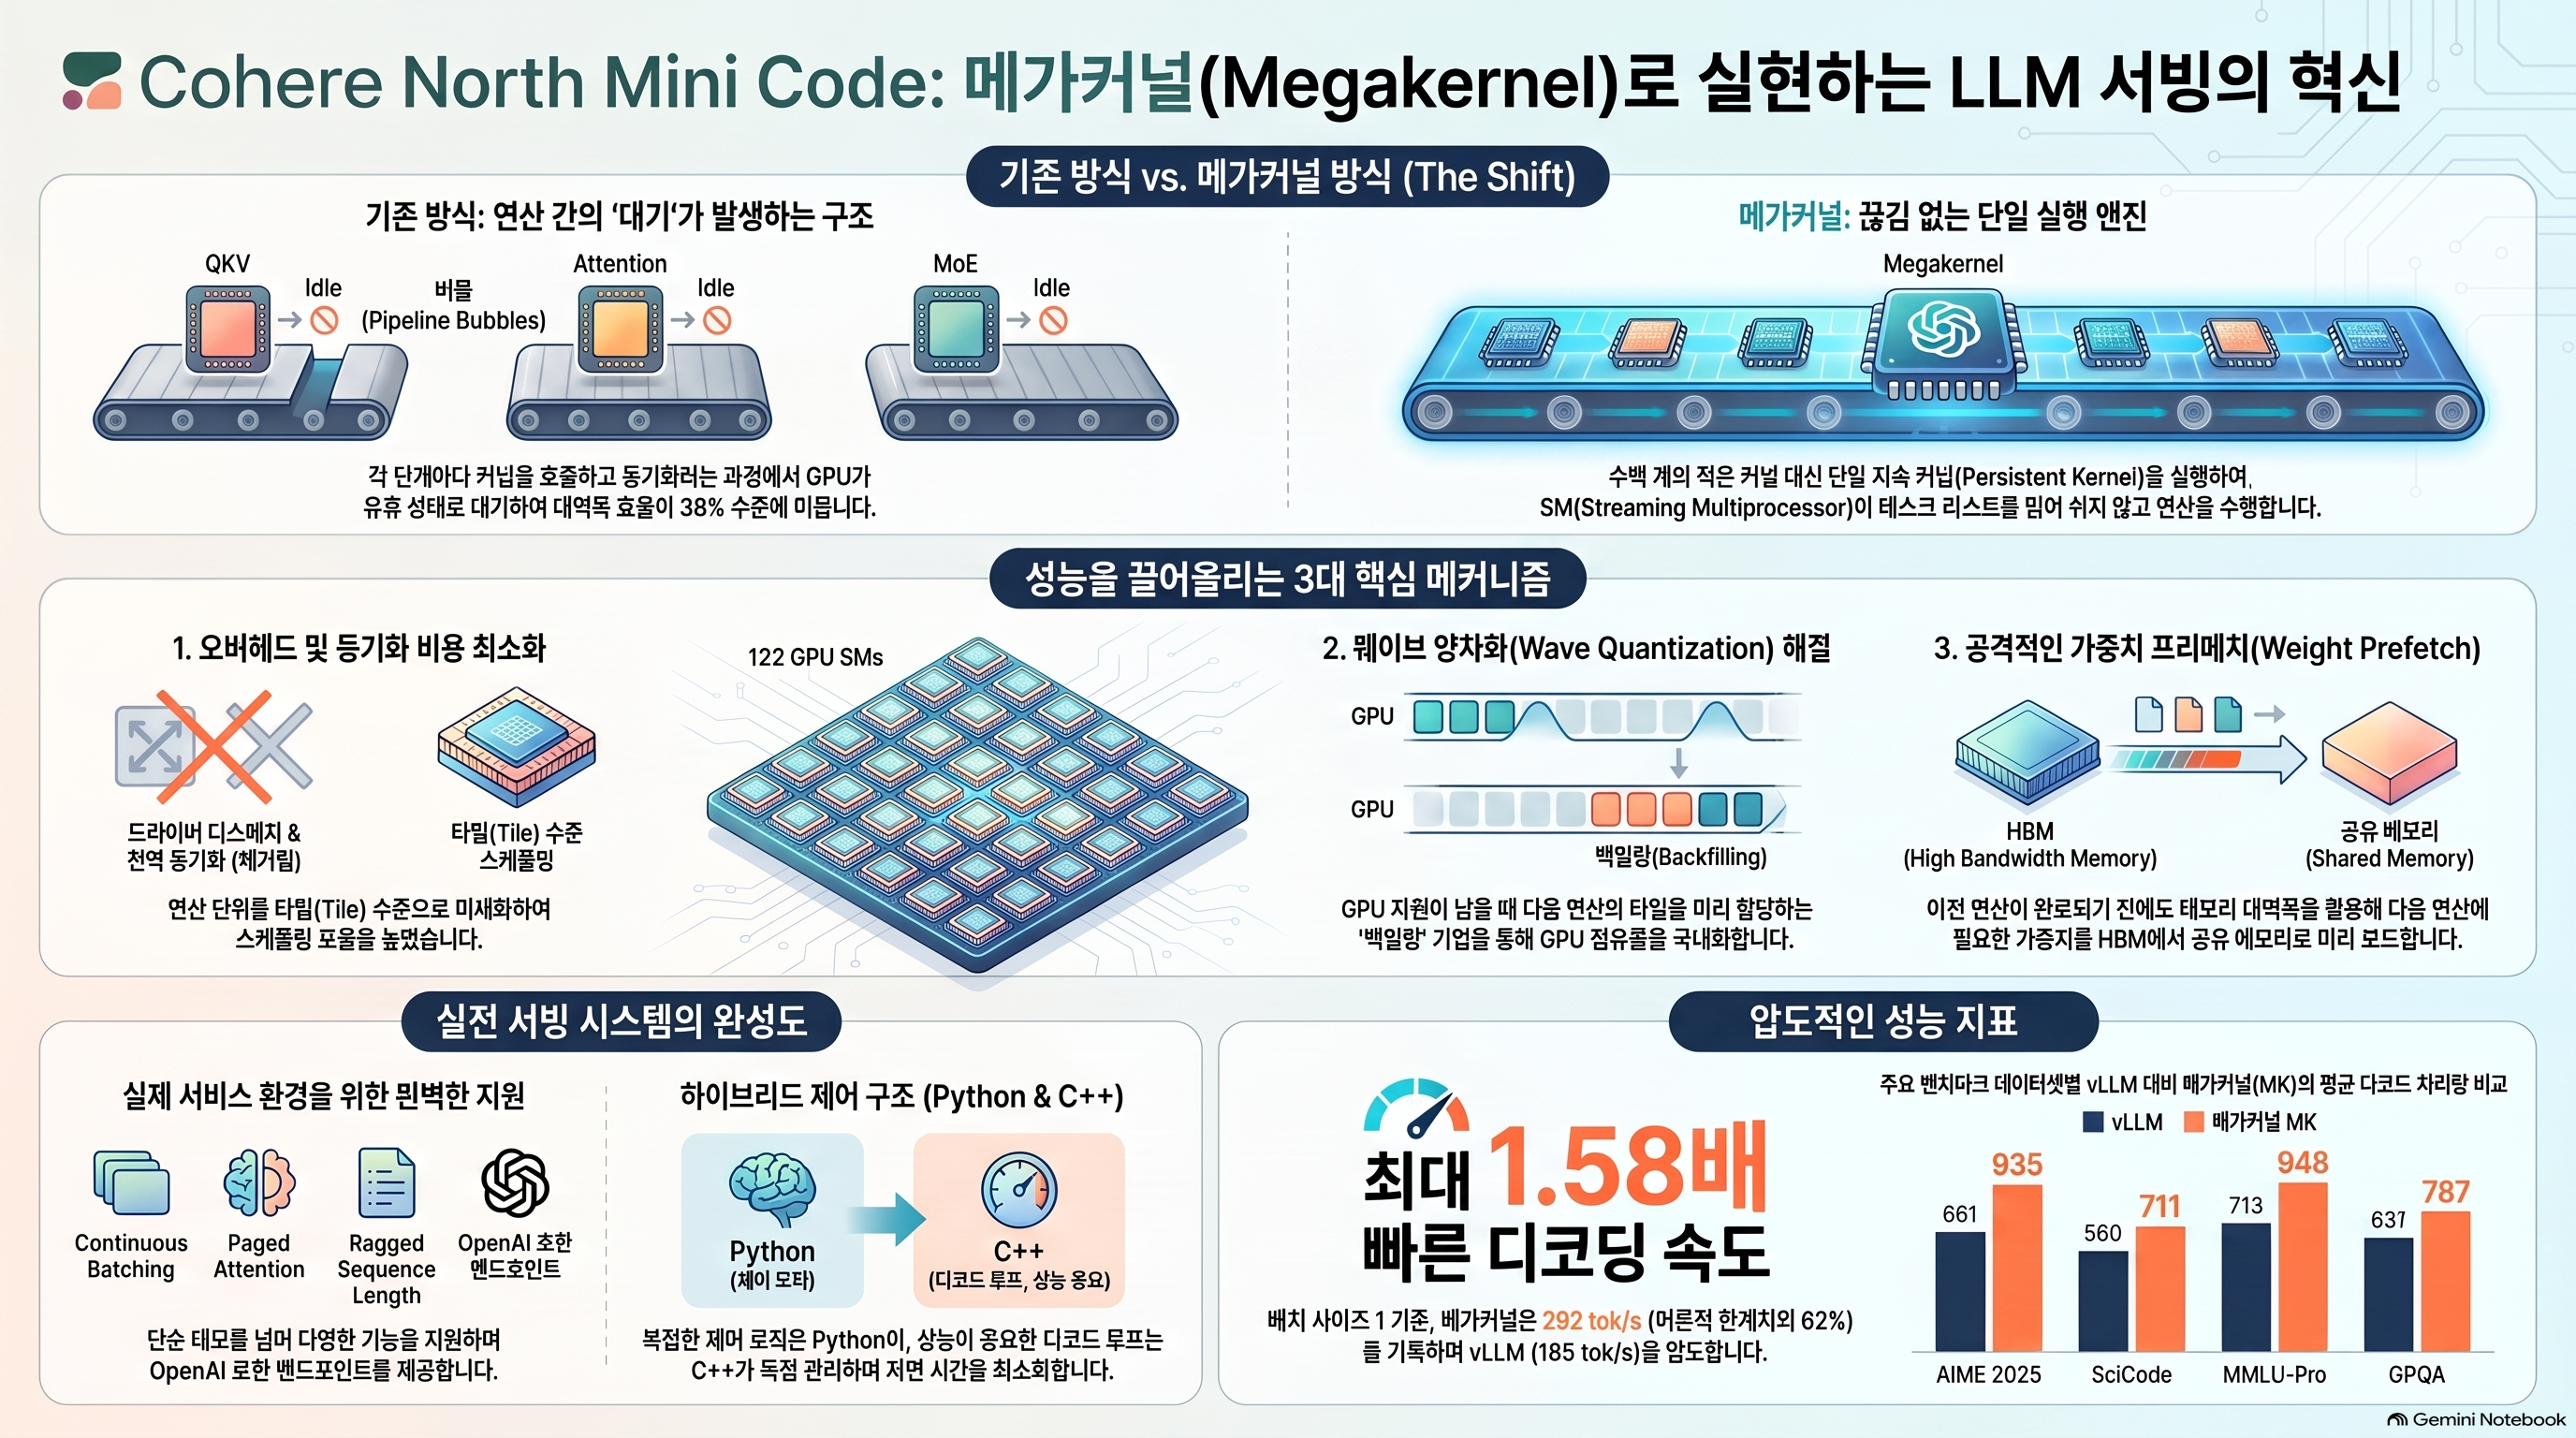
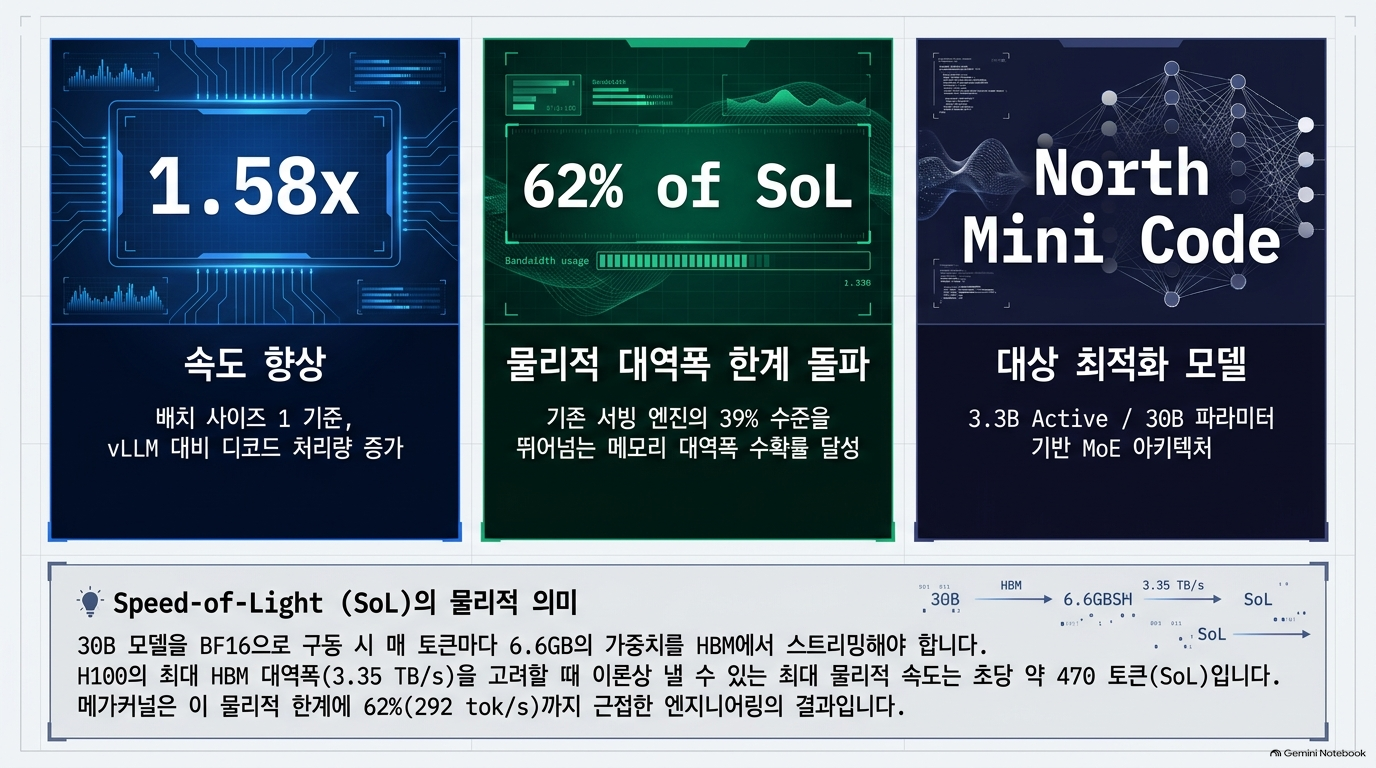
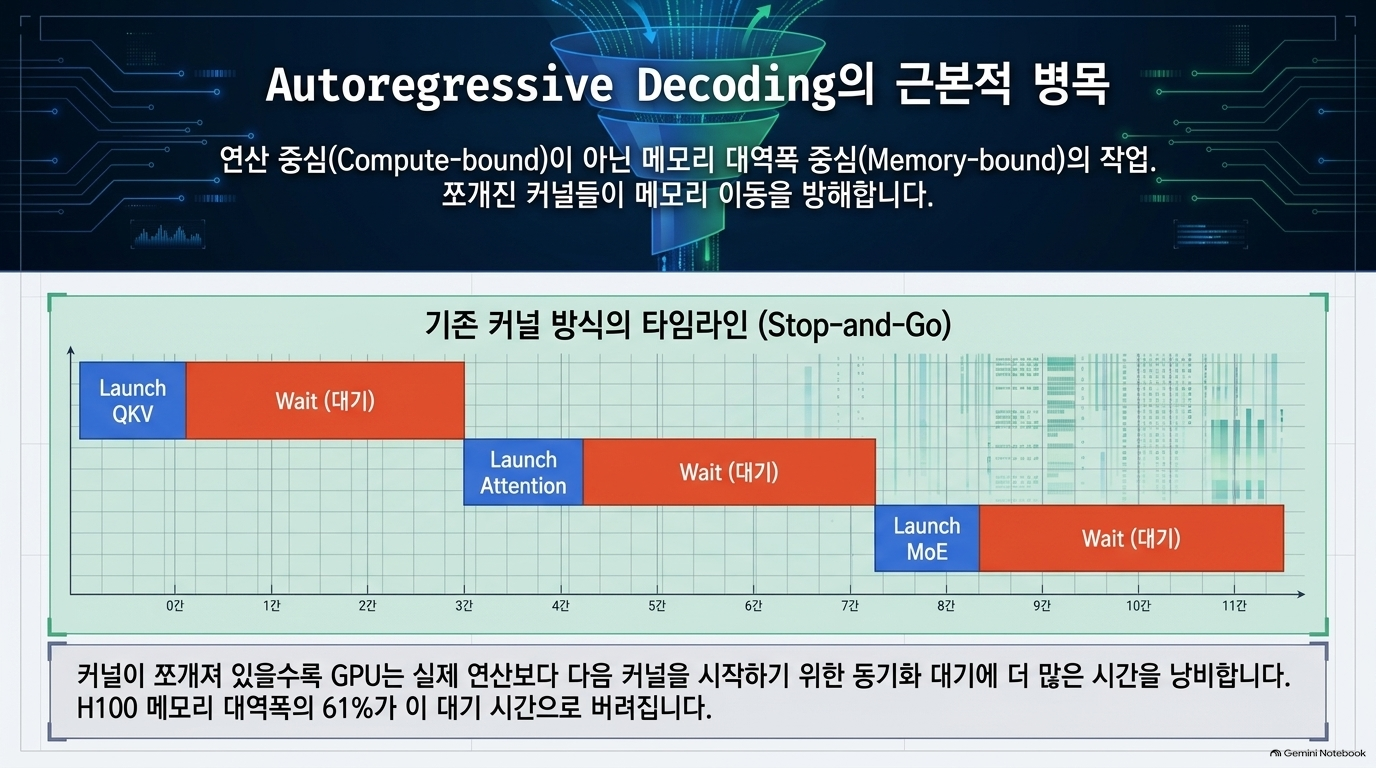
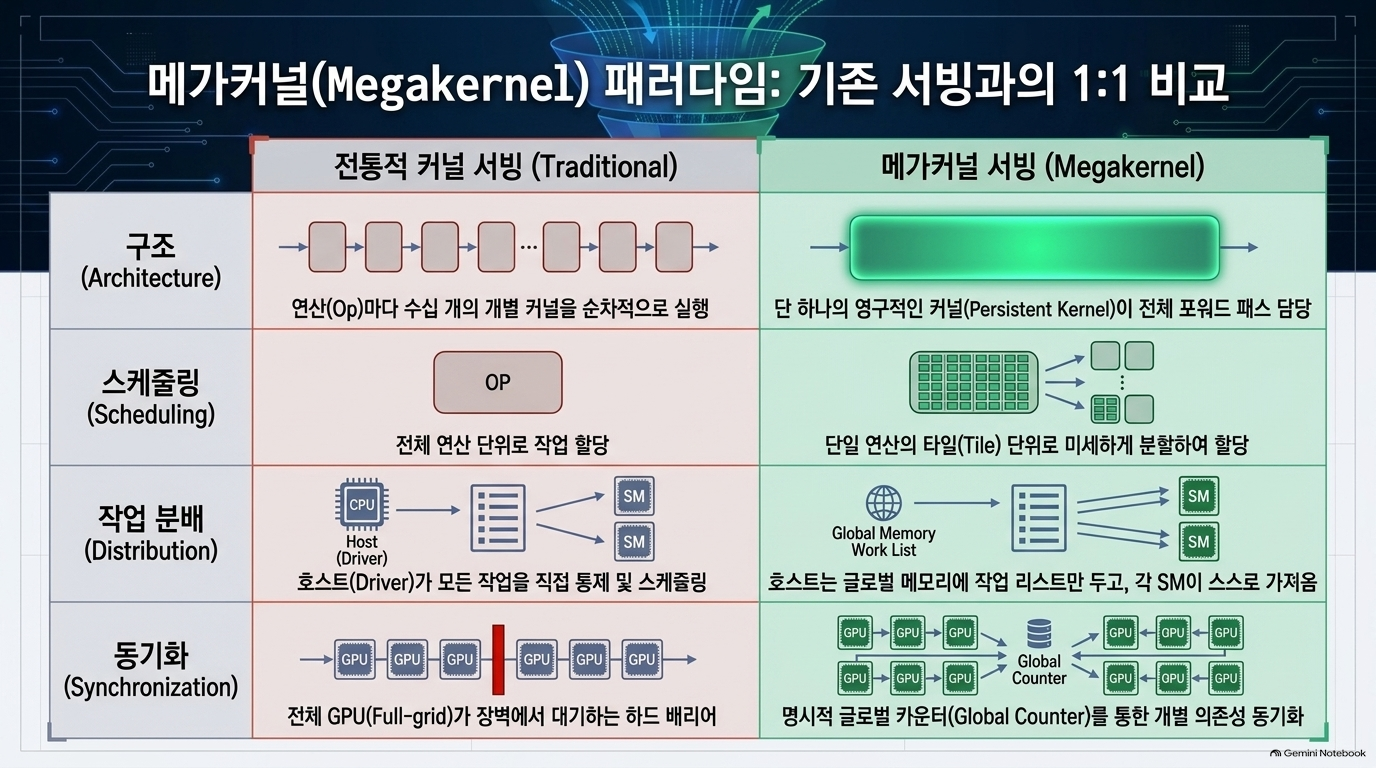
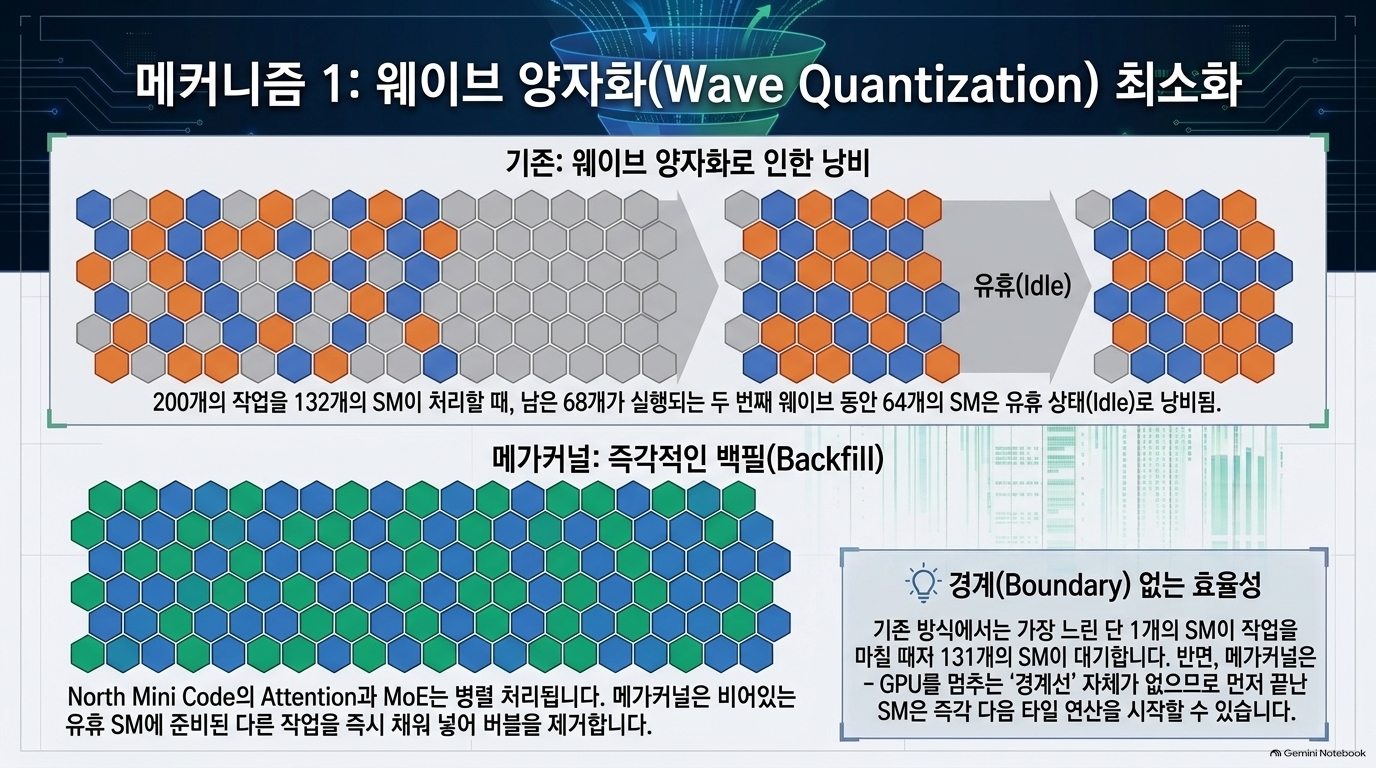
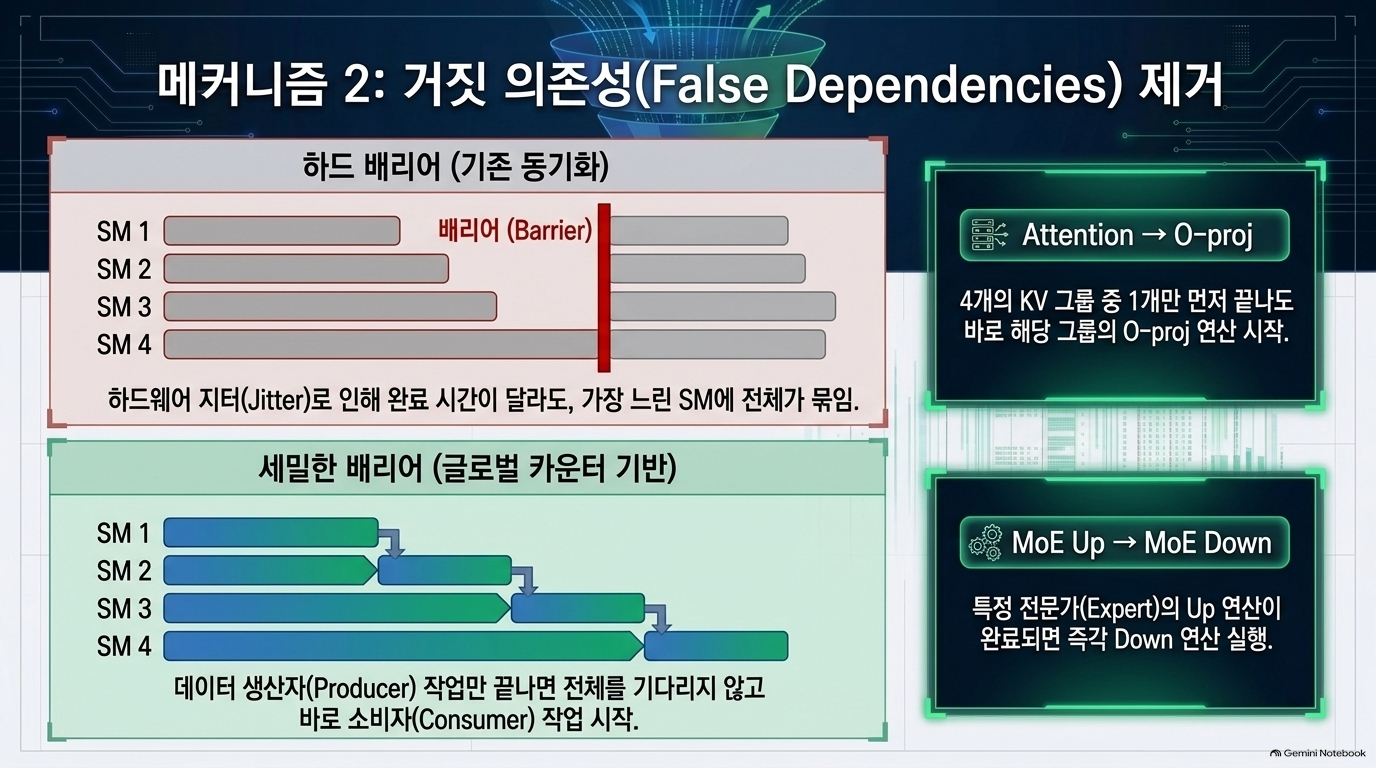
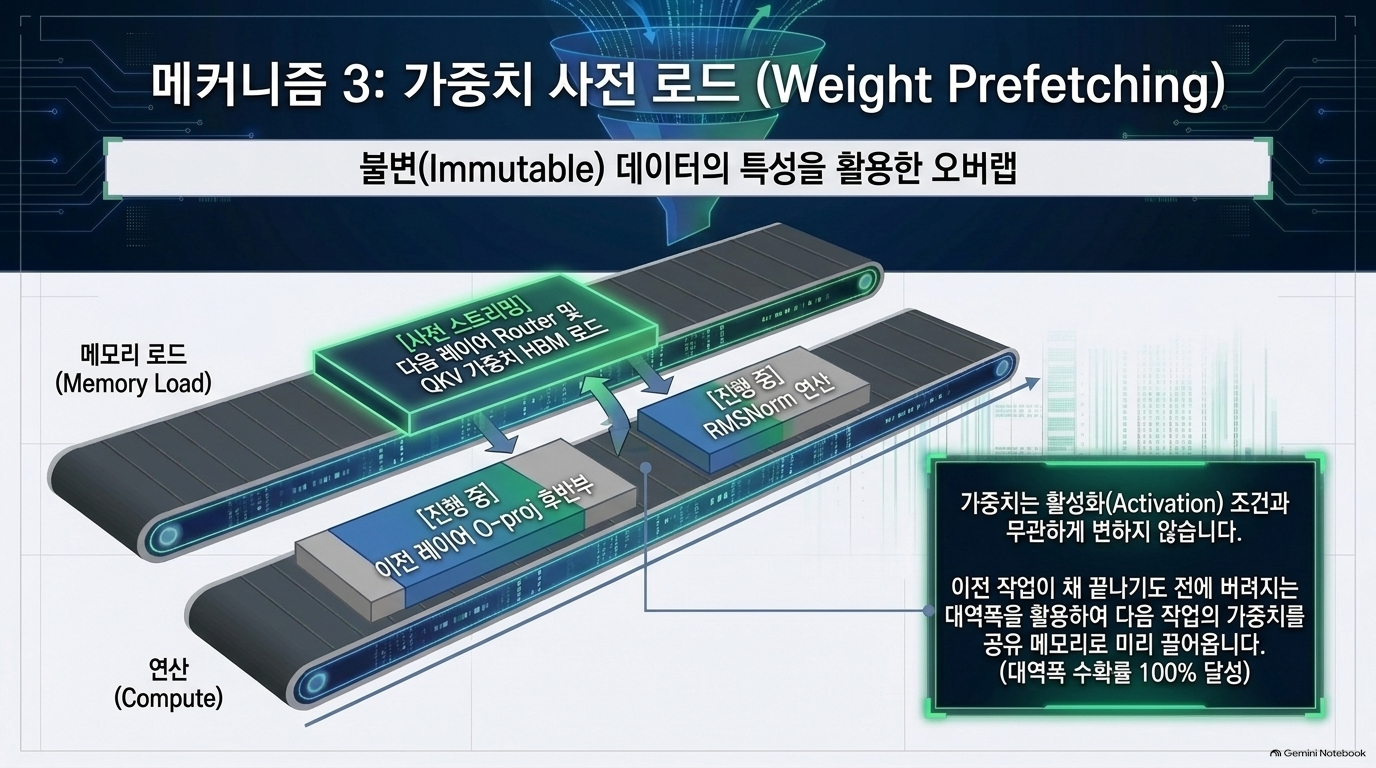
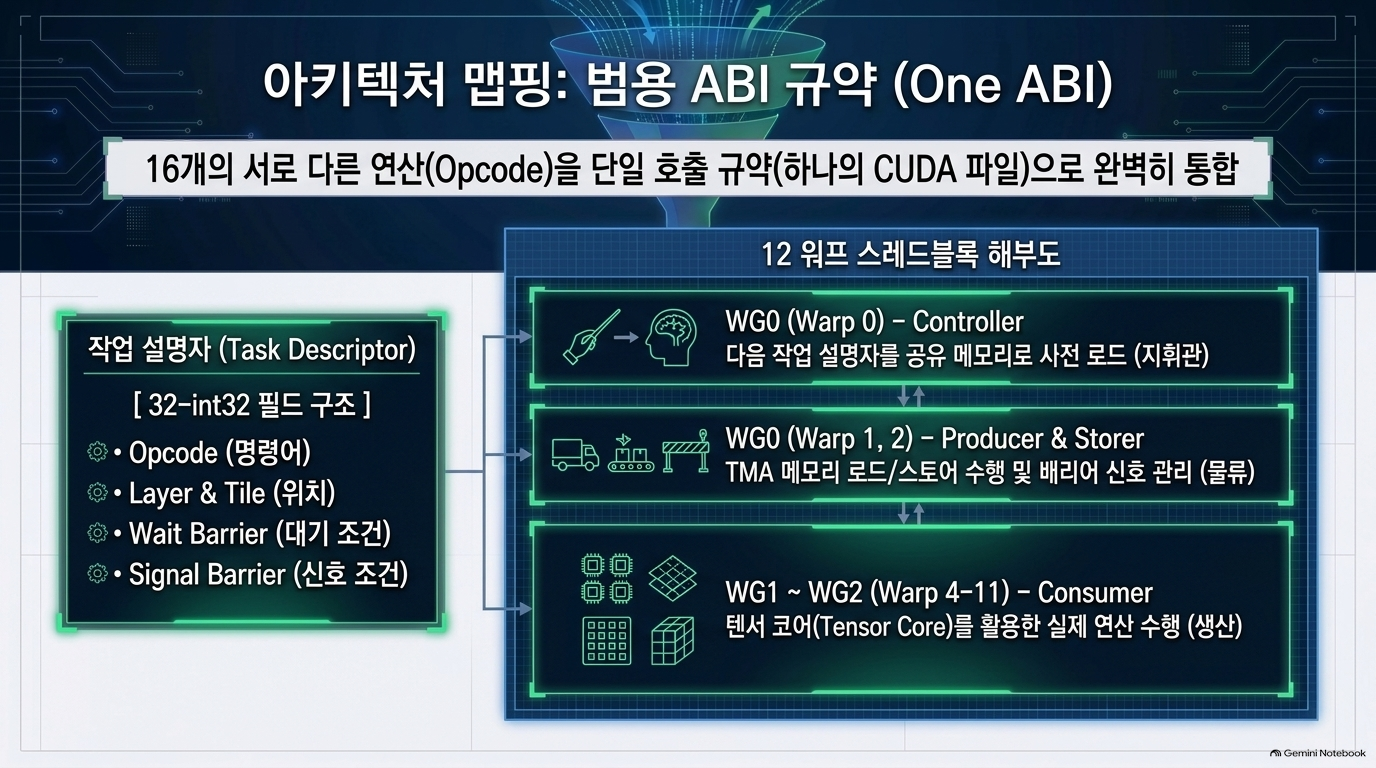
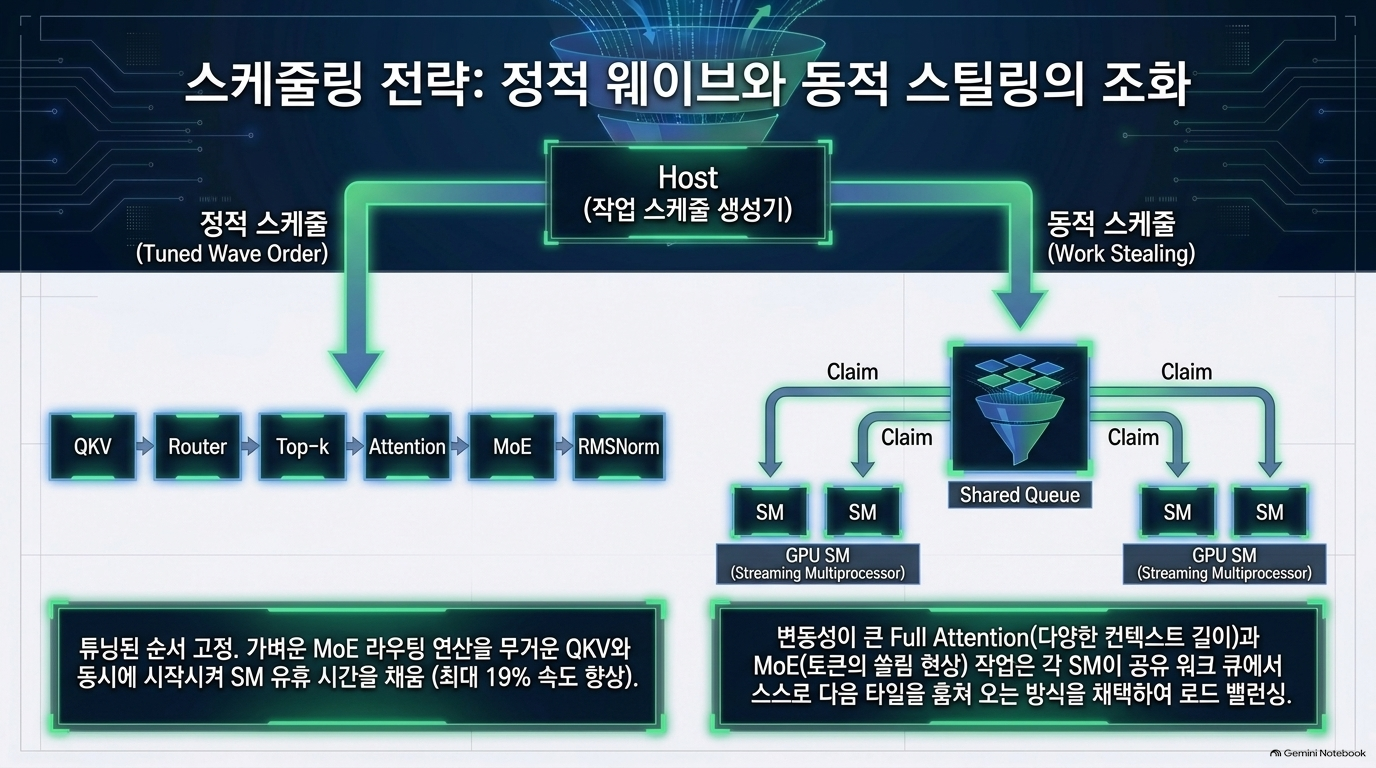
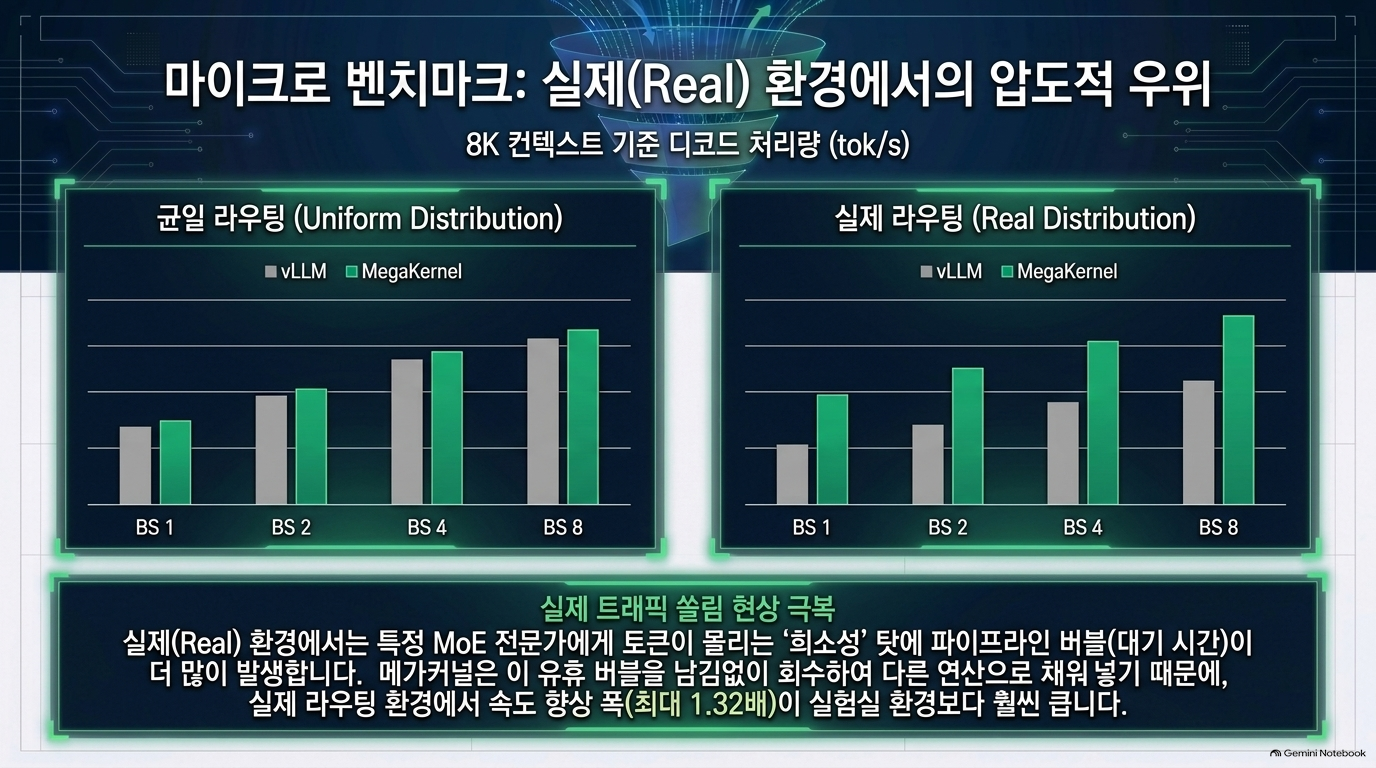
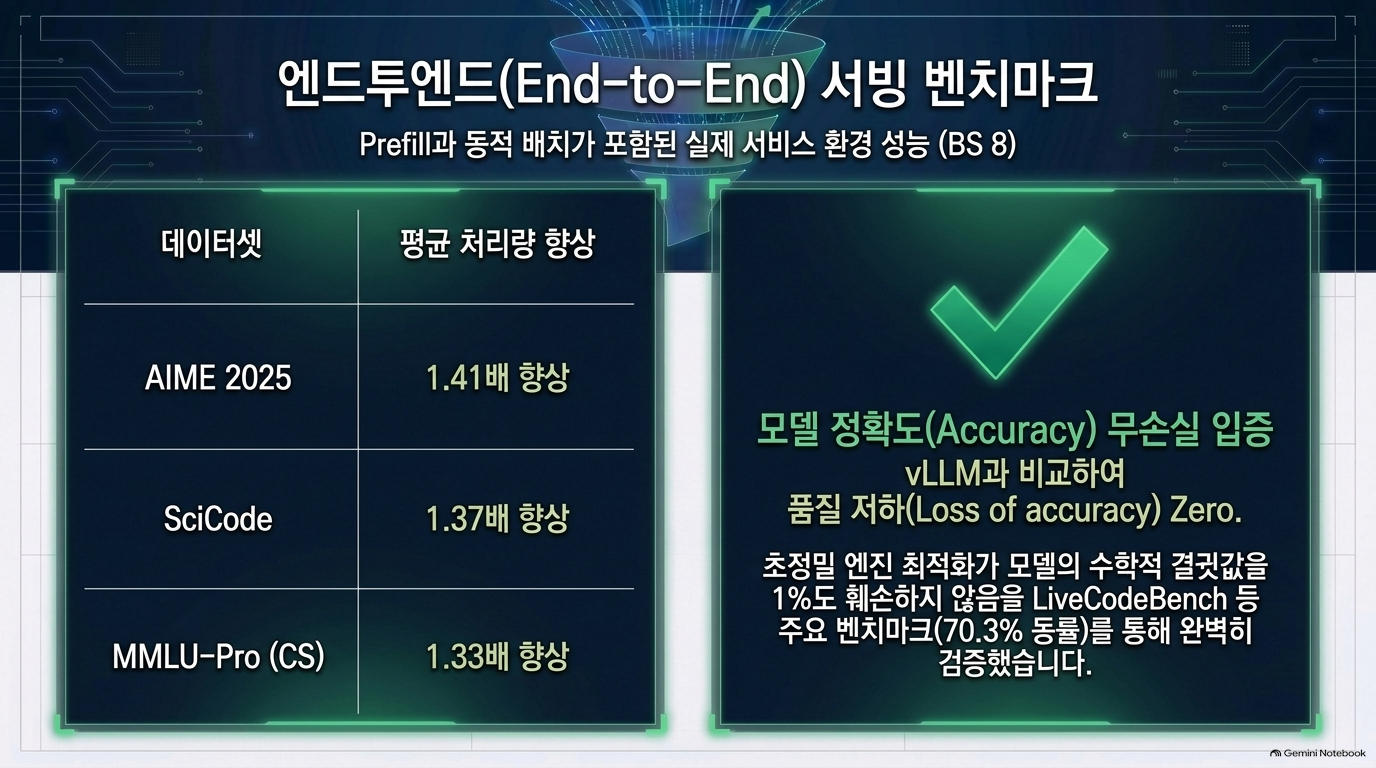
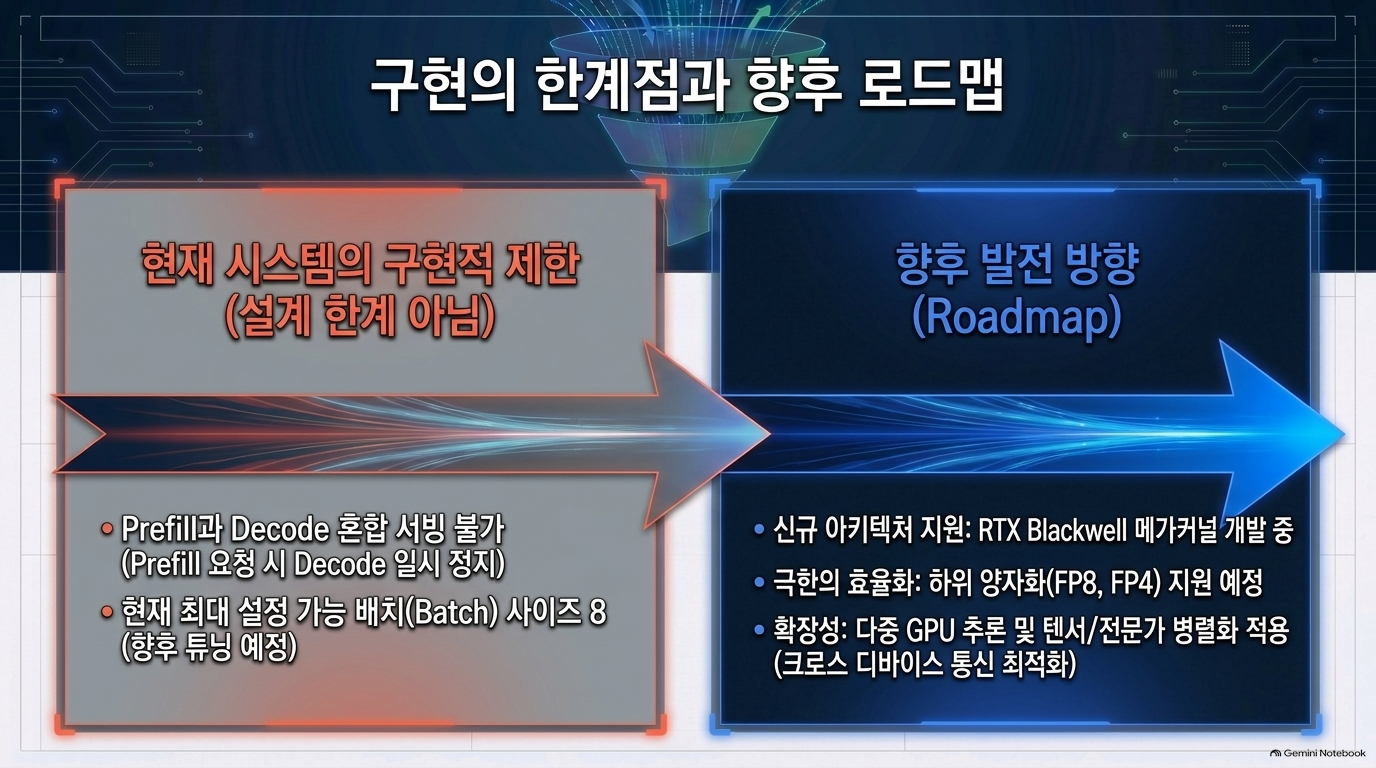
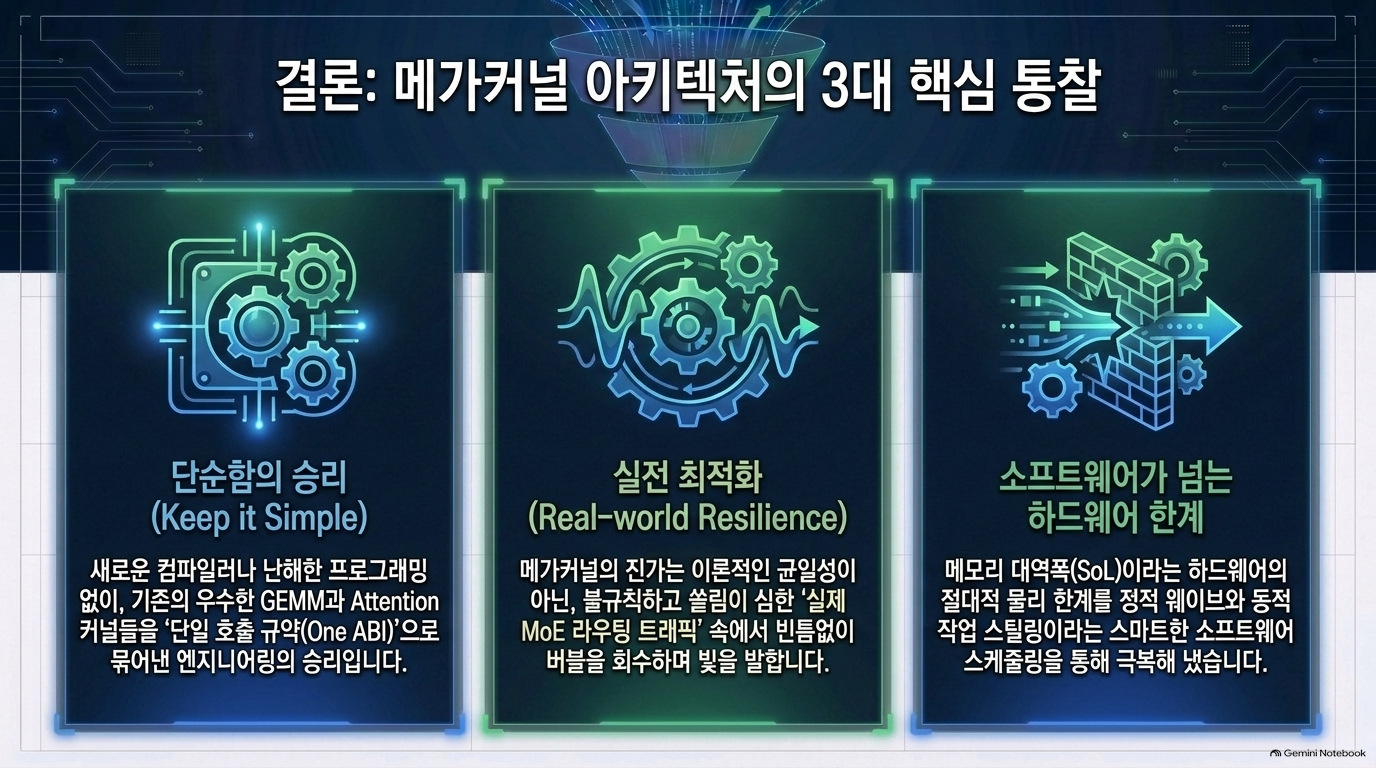
이 글은 코히어(Cohere)의 새로운 메가커널 서빙 엔진이 대규모 언어 모델인 'North Mini Code'의 추론 속도를 어떻게 혁신적으로 향상시켰는지 설명하는 기술 보고서입니다. 핵심 전략은 여러 개의 작은 연산을 개별적으로 실행하는 대신, 전체 과정을 단일 상주 커널(Single Persistent Kernel)로 통합하여 하드웨어의 메모리 대역폭 활용도를 극대화하고 동기화 지연을 제거하는 것입니다. 이를 통해 기존 vLLM 방식보다 최대 1.58배 빠른 토큰 생성 속도를 달성했으며, 정적 스케줄링과 동적 작업 할당을 결합한 작업 인터프리터(Task Interpreter) 구조를 통해 복잡한 MoE 모델의 효율성을 높였습니다. 결과적으로 이 기술은 효율적인 자원 배분과 가중치 사전 로딩(Weight Prefetching)을 통해 실제 비즈니스 환경에서 인공지능 서비스의 응답 성능을 비약적으로 끌어올리는 것을 목적으로 합니다.
728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| 토큰 경제 - Brookings, 토큰 격차(token divide) 문제 (0) | 2026.09.16 |
|---|---|
| LLM - 추론 최적화 - 랜덤 어텐션: 효율적인 추론을 위한 KV 캐시 제거 재고 (0) | 2026.09.13 |
| 에이전트 AI - EPOCH AI, GPT-5.6의 경우 장시간 지연 시간은 제곱에 비례하지만, Claude 5의 경우에는 거의 선형적으로 증가 (0) | 2026.09.13 |
| 2026 - ramp, 9월 AI 지출 보고서 (0) | 2026.09.12 |
| LLM - 추론 최적화 - 잠재 추론을 활용한 테스트 시간 컴퓨팅 성능 향상: 순환 깊이 접근법 (0) | 2026.09.09 |