2026.9.12
[Evolving Pinterest’s Embedding Retrieval Platform]
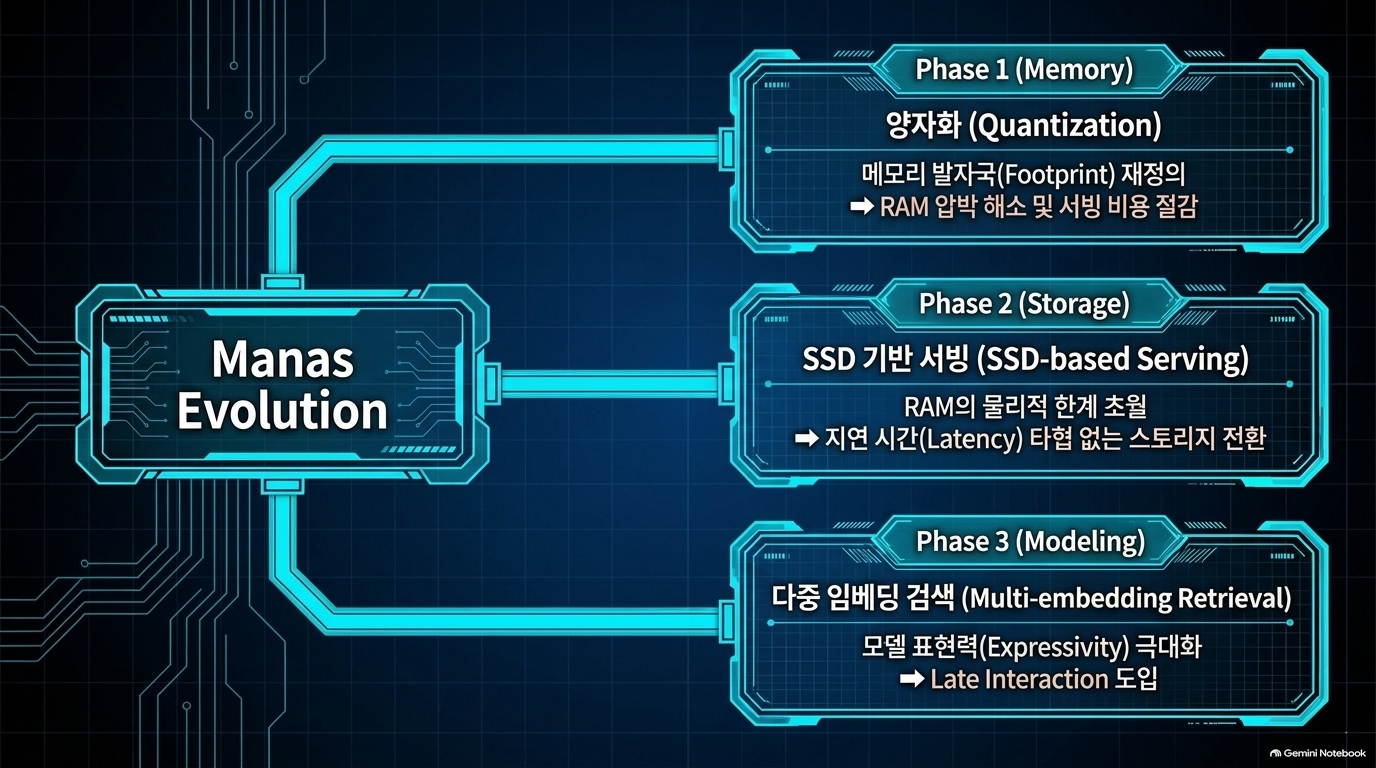
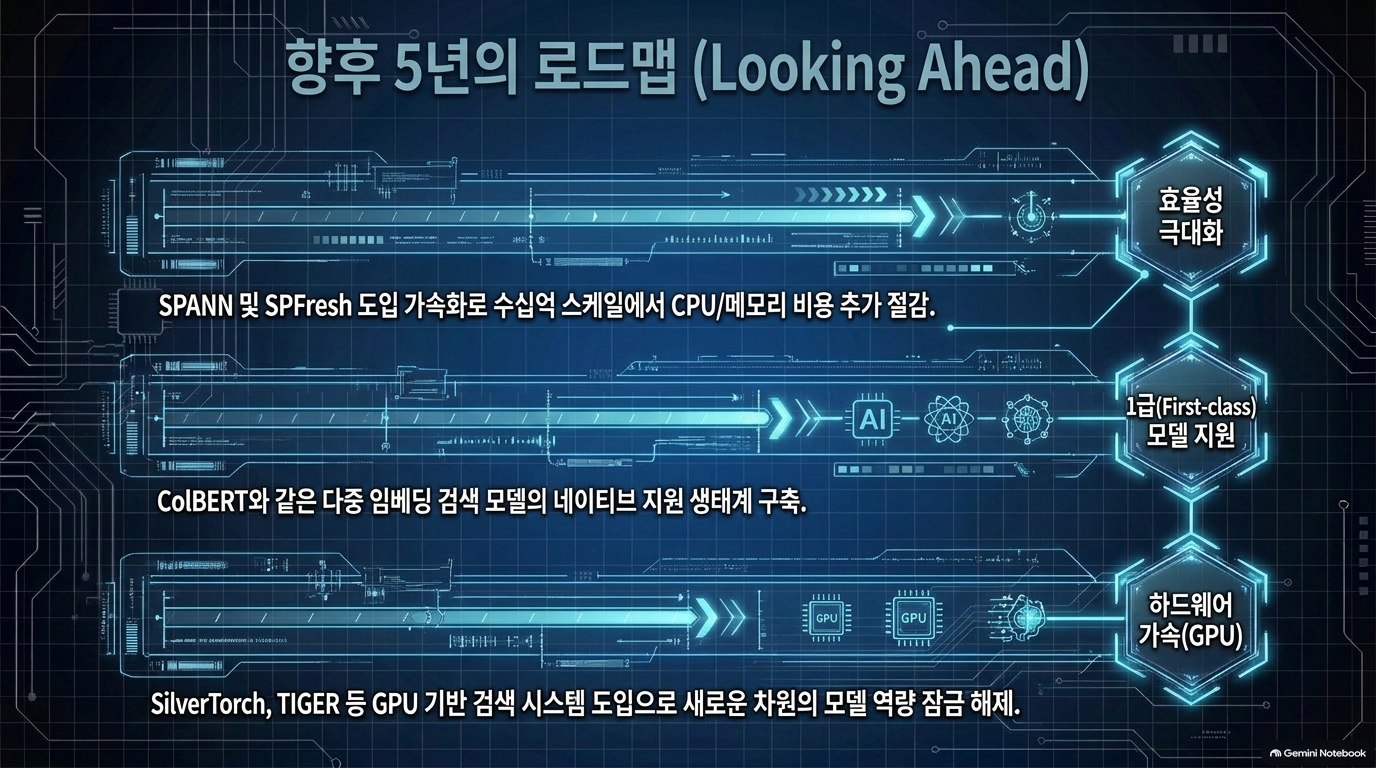
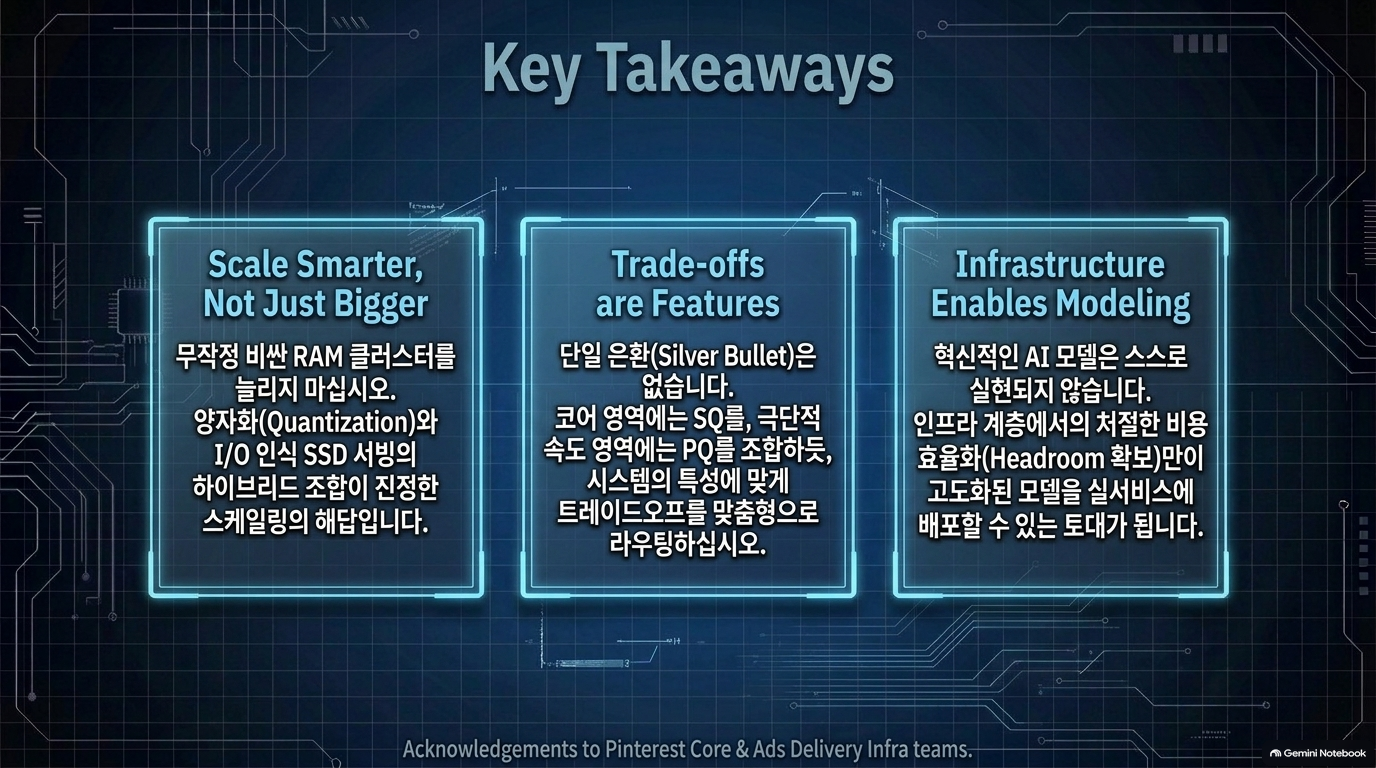
핀터레스트(Pinterest)의 검색 플랫폼인 마나스(Manas)가 수십억 개의 데이터를 효율적으로 처리하기 위해 진화해 온 과정을 설명하는 기술 블로그 글입니다. 이 시스템은 비용 절감을 위해 데이터 용량을 압축하는 양자화(Quantization) 기술과 인덱스를 메모리가 아닌 디스크에 저장하는 SSD 기반 서빙 방식을 도입하여 하드웨어 효율성을 극대화했습니다. 동시에 기술적 정교함을 더하기 위해 단일 벡터 모델의 한계를 넘어선 다중 임베딩 검색(Multi-embedding Retrieval)을 지원함으로써 사용자에게 더욱 정밀하고 풍부한 추천 결과를 제공하고자 합니다. 결과적으로 이 자료는 인프라의 비용 효율성과 검색 모델의 표현력이라는 두 마리 토끼를 잡기 위한 핀터레스트 엔지니어링 팀의 전략적 로드맵을 잘 보여줍니다.
신뢰성 평가: 높음 (공식 기업 기술 블로그 · 1차 소스)
출처 확인
Pinterest Engineering Blog는 핀터레스트의 공식 사내 기술 블로그입니다. 핀터레스트 공식 커뮤니티 포럼에서도 Pinterest Engineering이 올리는 글의 주소로 medium.com/@Pinterest_Engineering을 공식 채널로 안내하고 있어, 이 계정의 공식성은 교차 확인됩니다. 게시일은 2026-09-11(약 2주 전), 저자 4명 모두 실명과 직함(Staff/Senior/SWE II)을 명시했고, 같은 퍼블리케이션이 최근까지도 꾸준히 새 글을 발행하는 활성 채널입니다.
콘텐츠 성격 — 자체 발표 데이터라는 한계
기사 안의 수치(PQ/SQ 압축률, SPANN+PQ 4.5배 속도, CPU 40% 절감 등)는 전부 회사 자체 벤치마크·A/B 실험 결과입니다. 제3자가 독립적으로 재현·검증한 수치가 아니므로, "동료심사 논문" 수준의 검증이 아니라 "기업의 자체 성과 발표" 수준의 신뢰도로 봐야 합니다.
기술적 정합성 — 높음
글에서 다루는 SPANN·DiskANN은 실제 존재하는 기법으로, Microsoft Research가 발표한 메모리-디스크 하이브리드 벡터 인덱싱 시스템이며 Microsoft·Peking University·Tencent·Baidu 연구팀이 NeurIPS에 공개한 방식으로, 기존 최고 성능 기법인 DiskANN 대비 약 2배 빠르다는 결과가 보고되어 있습니다. ColBERT(레이트 인터랙션), PQ/SQ 양자화 등도 학계에 실재하는 기법이라 기사의 기술 서술 자체는 지어낸 내용이 아니라 실제 업계 흐름과 일치합니다.
종합: 신뢰할 만한 1차 소스이며 기술 설명도 정확하지만, 성능 수치는 검증되지 않은 자체 발표치라는 점만 감안하면 됩니다.

핵심 분석
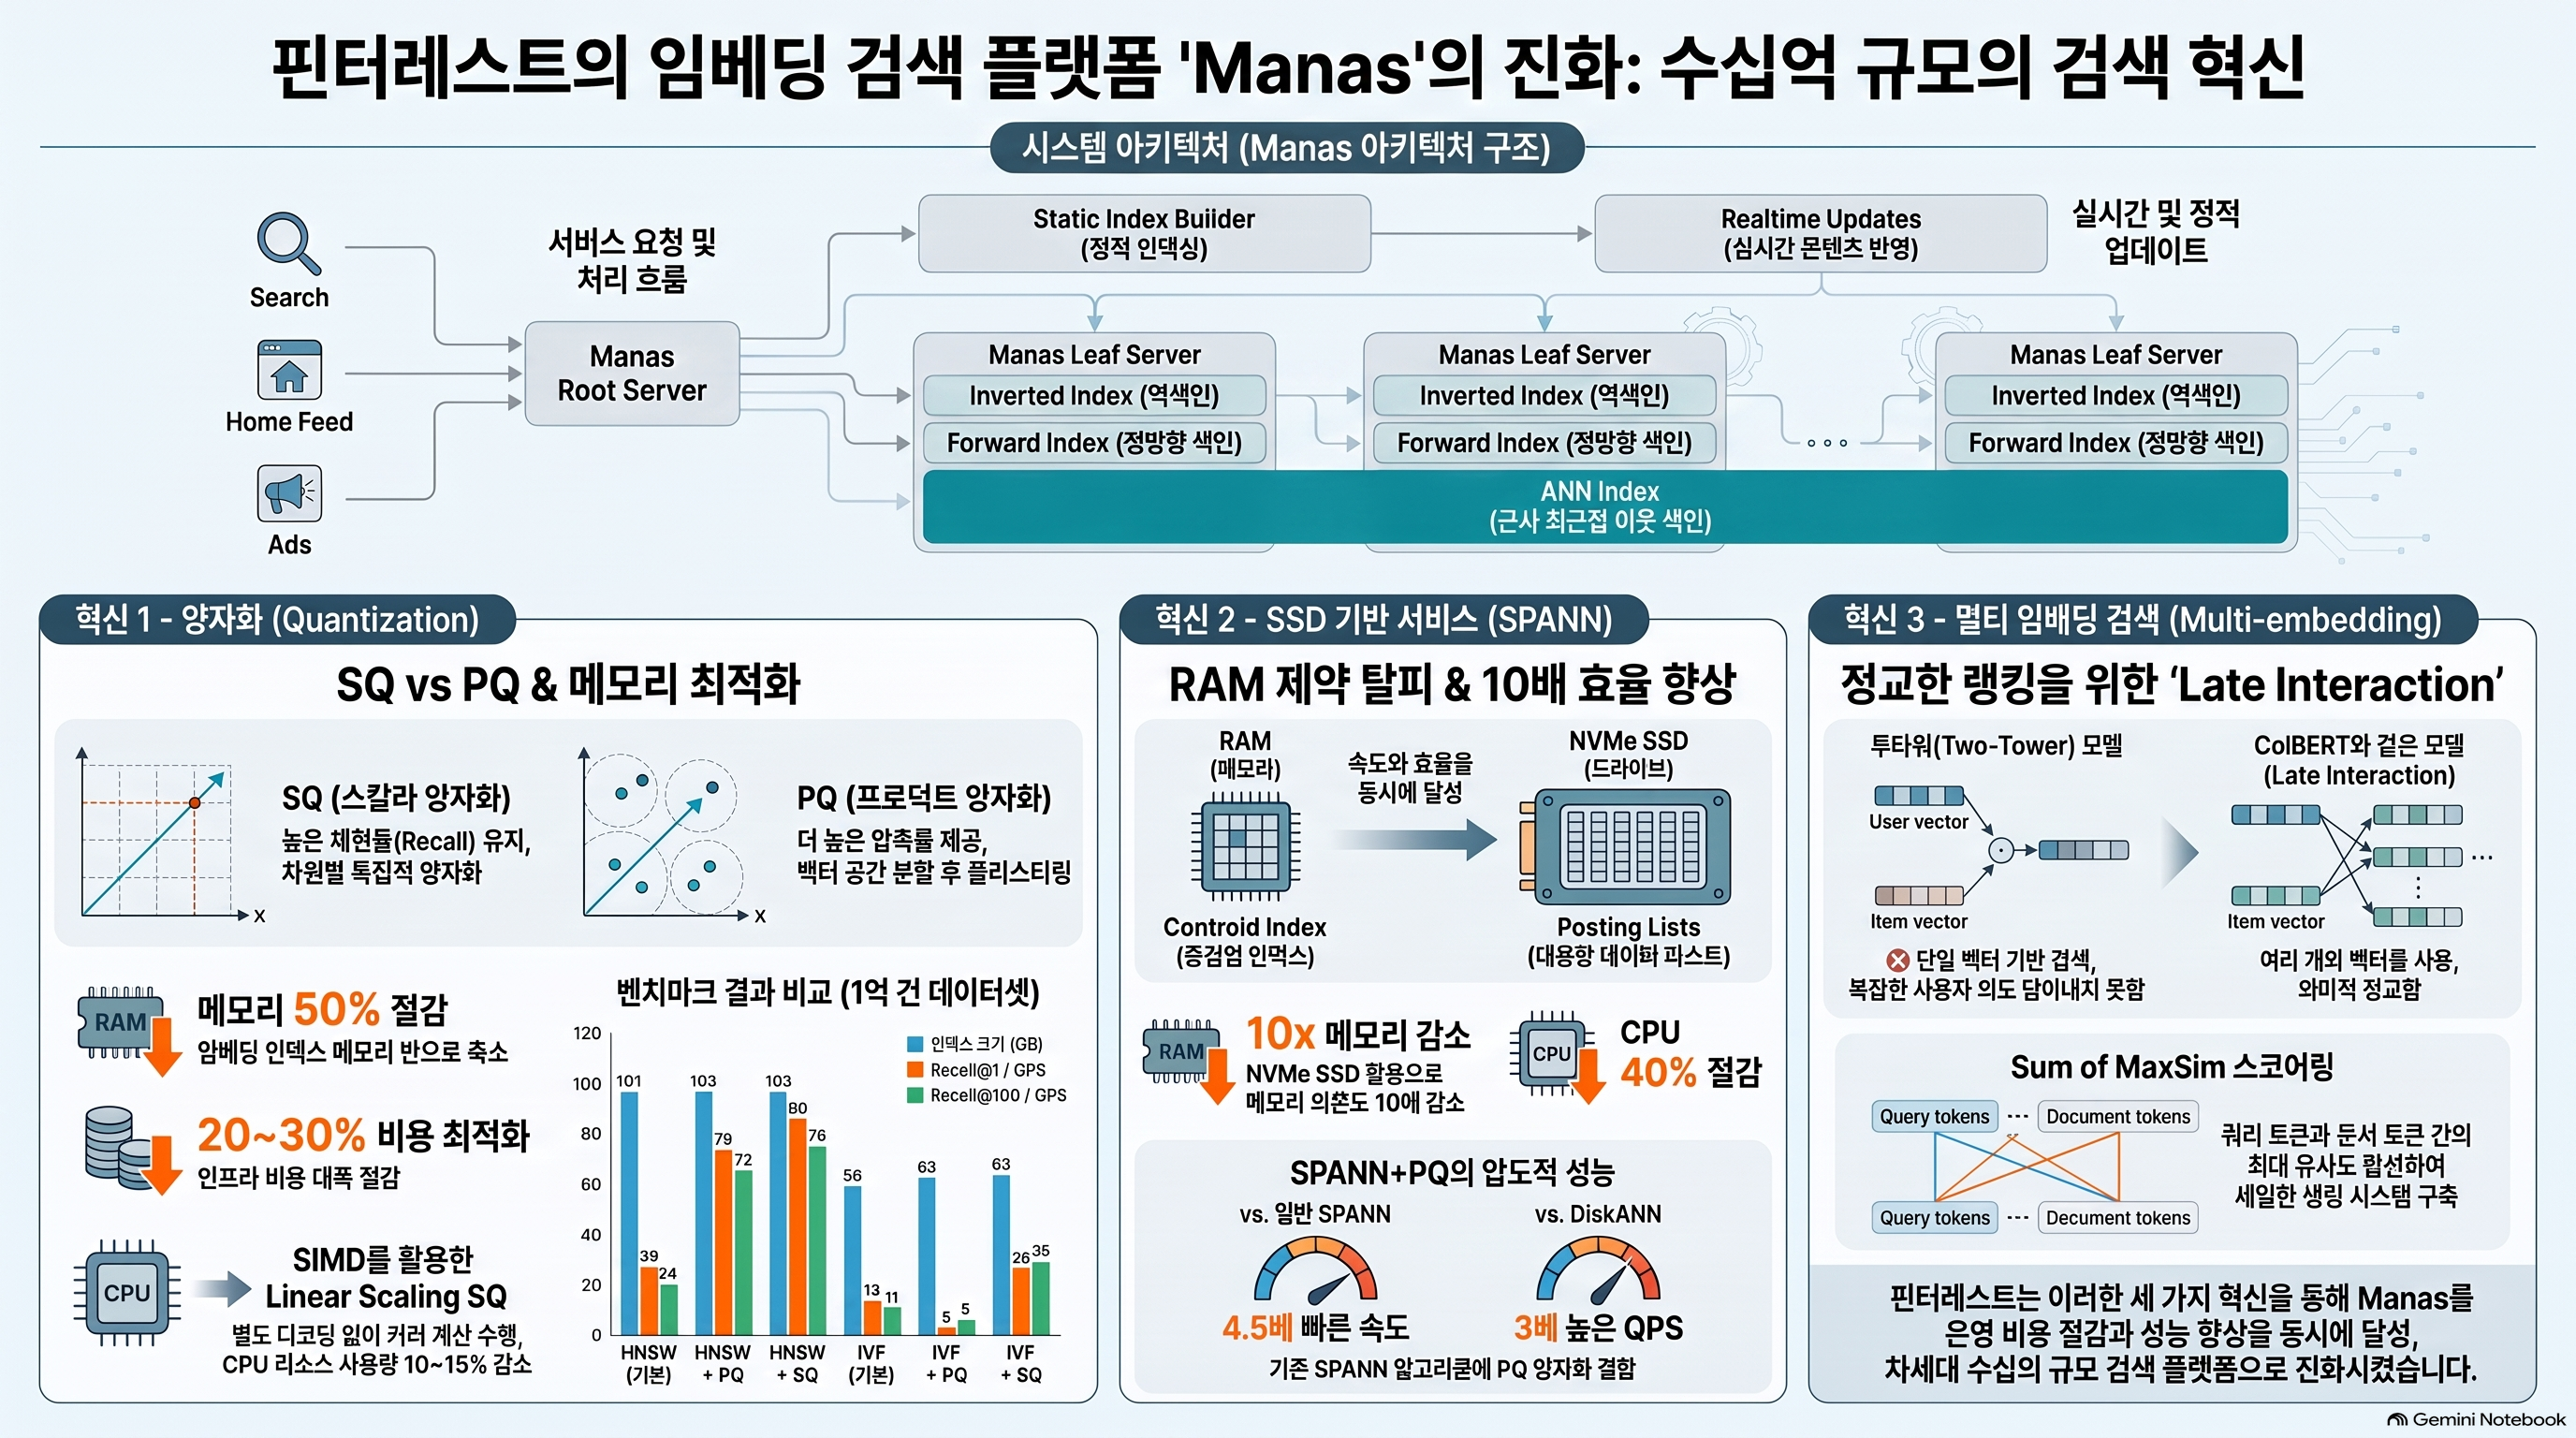
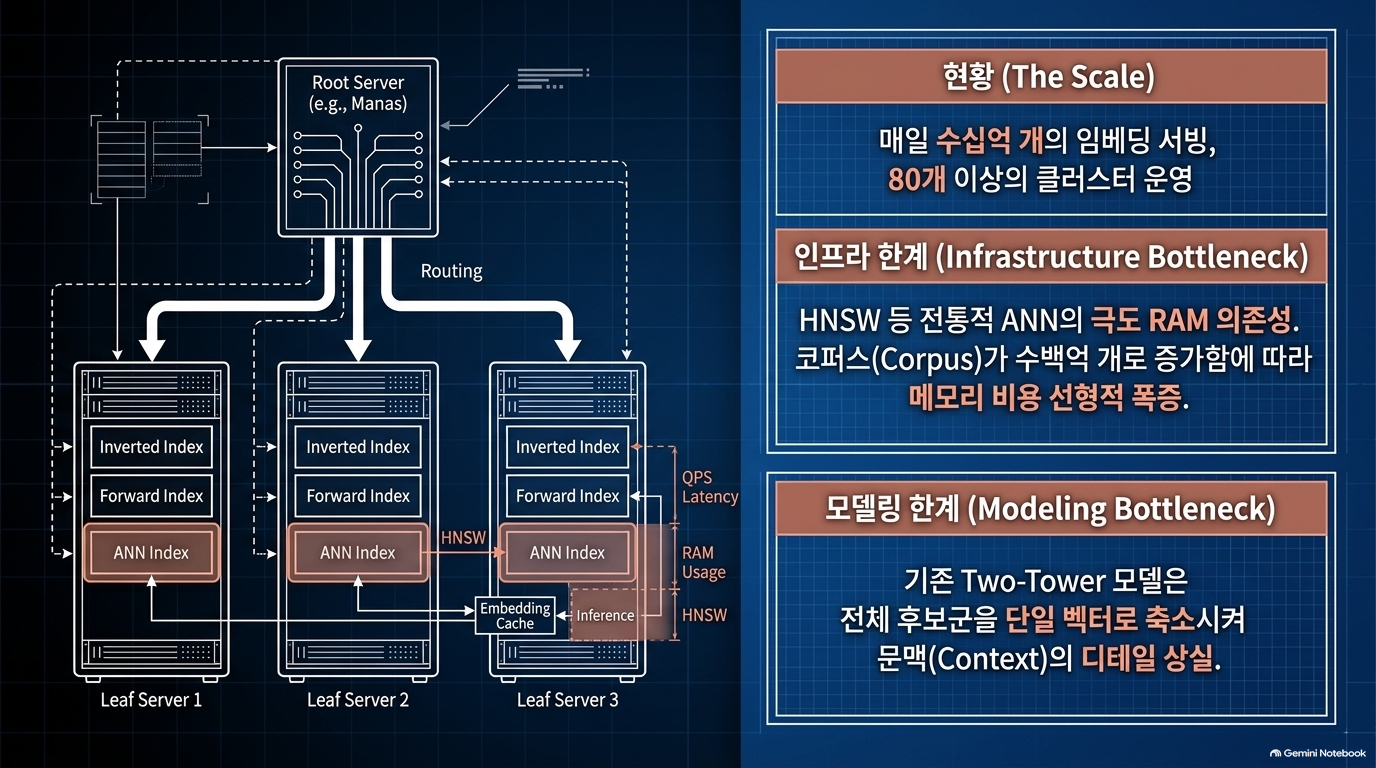
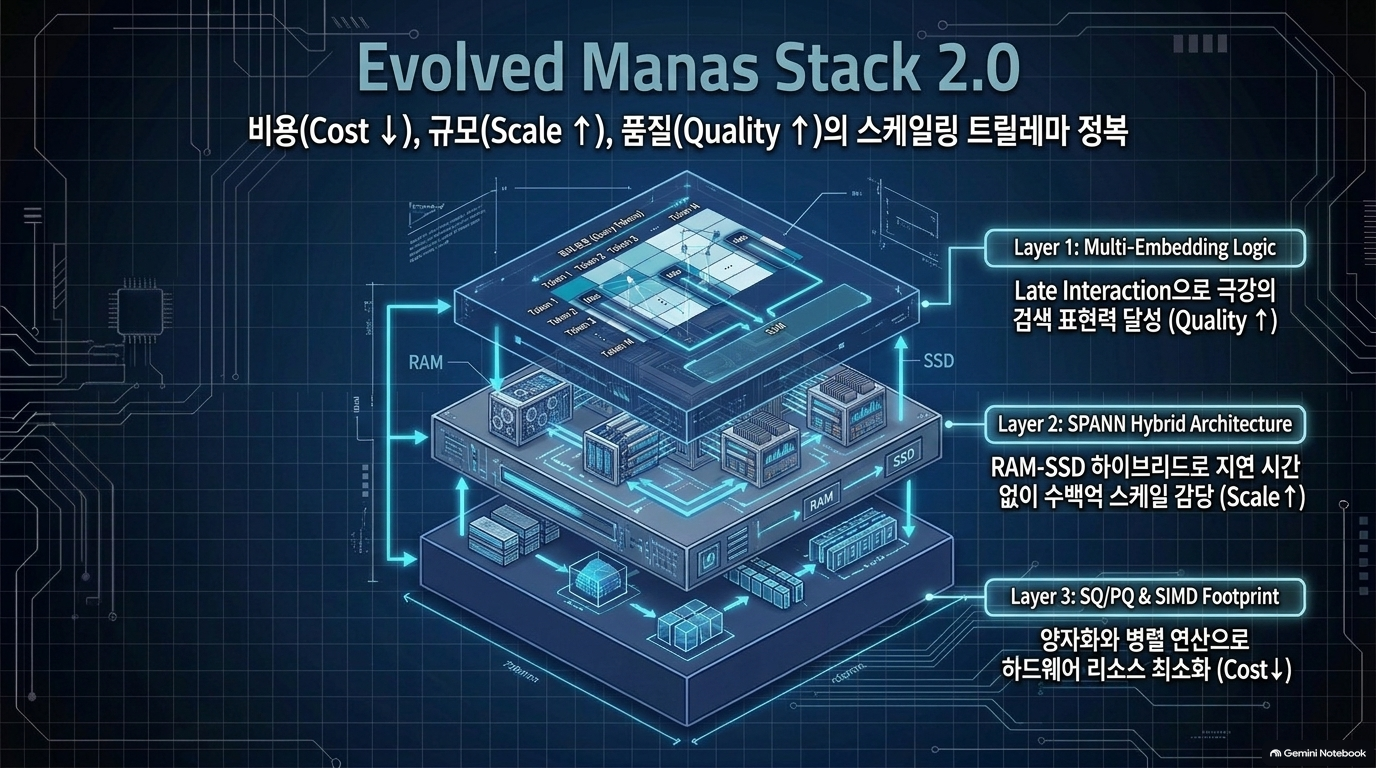
이 글의 주제는 단순한 벡터 검색 엔진 교체가 아닙니다. Pinterest는 자체 분산 검색 플랫폼 Manas에서 검색 품질을 유지하면서 임베딩 규모에 따른 메모리·CPU 비용을 낮추고, 장기적으로는 단일 벡터의 점곱을 넘어서는 검색 모델을 수용하려 합니다. 이를 위해 양자화 → SSD 기반 ANN → 다중 임베딩 검색이라는 세 축을 병행합니다. Manas는 현재 80개 이상의 클러스터에서 수십억 개 임베딩을 서비스하며, 콘텐츠의 실시간 갱신과 토큰·임베딩 혼합 질의도 지원합니다.[1]
| 축 | 해결하려는 제약 | 원문의 접근과 결과 | 현재 상태 |
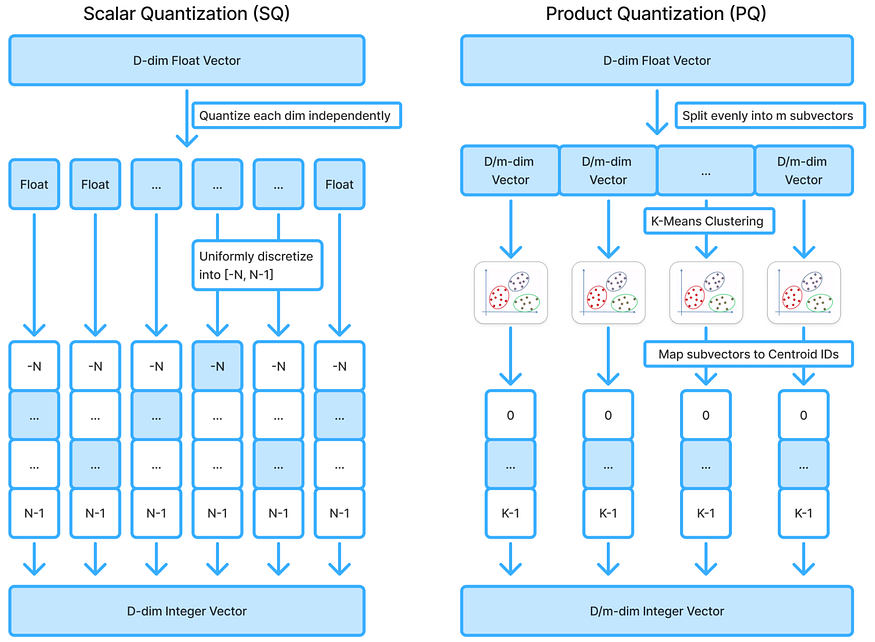
| 양자화 | HNSW 등의 인메모리 인덱스 비용 | SQ·PQ를 용도별로 적용. 주요 사례의 임베딩 인덱스 메모리 50% 이상 절감, 서빙 비용 20~30% 절감 | 주요 제품 사례에 적용 |
| SSD 서빙 | 인덱스 전체를 RAM에 두는 구조 | 메모리에는 중심점 인덱스, SSD에는 큰 posting list를 두는 SPANN 채택 | 구현·예비 평가 단계; 전체 확대는 향후 계획 |
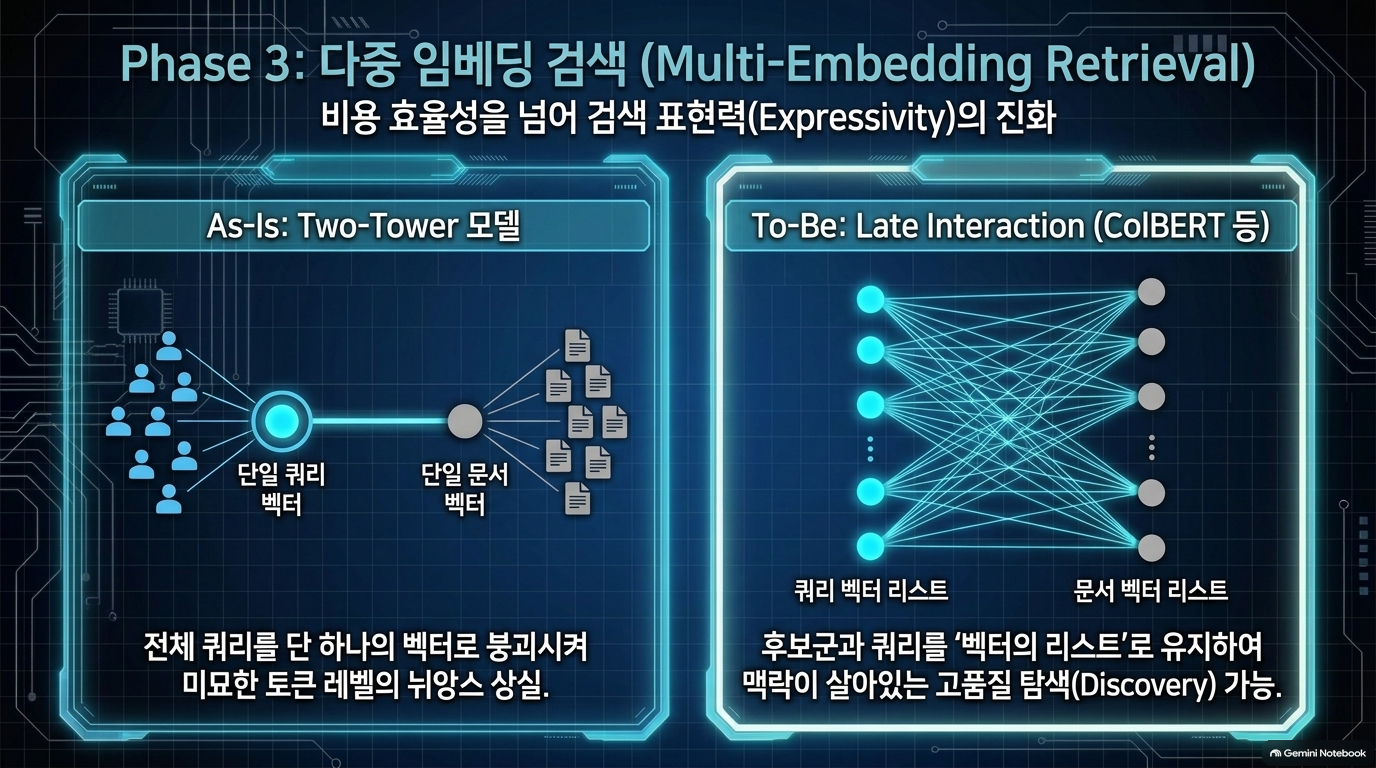
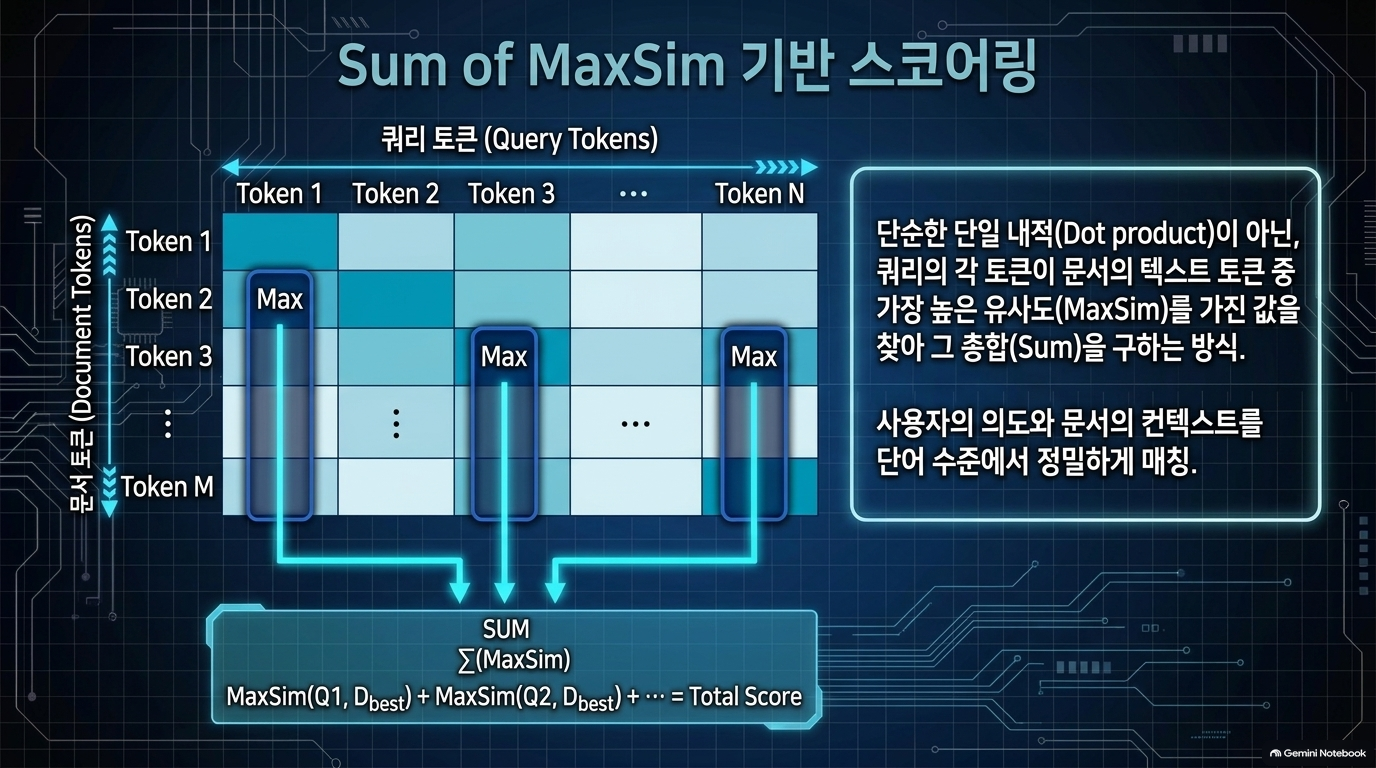
| 다중 임베딩 | 후보당 벡터 하나와 점곱 하나로 제한되는 two-tower 검색 | 여러 질의·후보 벡터의 상호작용을 계산하는 Sum of MaxSim 질의 지원 | 제품팀과 파일럿 준비 중 |
세 축의 성숙도가 서로 다르다는 점이 중요합니다. 양자화의 비용 절감은 운영 적용 결과인 반면, SSD의 대규모 확대와 다중 임베딩의 제품 효과는 아직 확정된 성과로 읽으면 안 됩니다.[1]
1. 양자화: 압축률보다 검색 품질을 함께 최적화
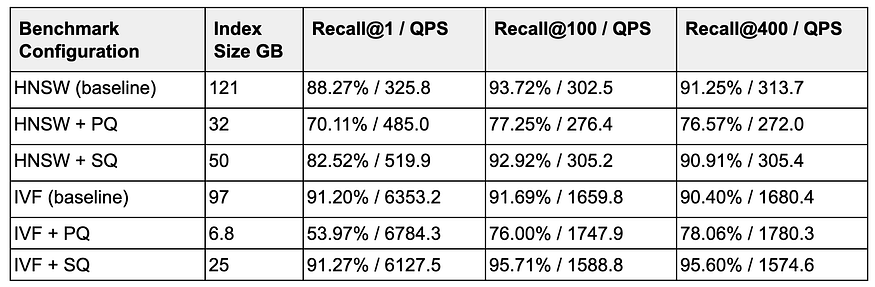
1억 개 GraphSage 임베딩을 사용한 오프라인 비교에서 PQ는 HNSW 인덱스 74%, IVF 인덱스 93%를 줄였지만 recall은 70~80% 수준이었습니다. SQ는 각각 59%, 75%를 줄이면서 recall을 일관되게 90% 이상 유지했습니다. Pinterest는 이 결과만으로 한 방식을 일괄 채택하지 않고, 사례별 온라인 A/B 실험을 통해 사용자 참여 지표에 미치는 영향을 확인한 뒤 SQ와 PQ를 배포했습니다.[1]
기술적으로 눈여겨볼 부분은 Linear Scaling SQ입니다. 일반적인 SQ에서 거리 계산 전 복호화가 CPU 병목이 될 수 있어, 스케일링과 SIMD 정수 연산을 활용해 이를 줄였습니다. 원문은 적용 사례에서 질의당 연산 자원 10~15% 감소를 보고합니다. 즉, 저장 용량뿐 아니라 압축된 표현으로 얼마나 효율적으로 검색하느냐까지 최적화한 것입니다.[1]
2. SSD 서빙: 저장 매체 변경보다 I/O 횟수 통제가 핵심
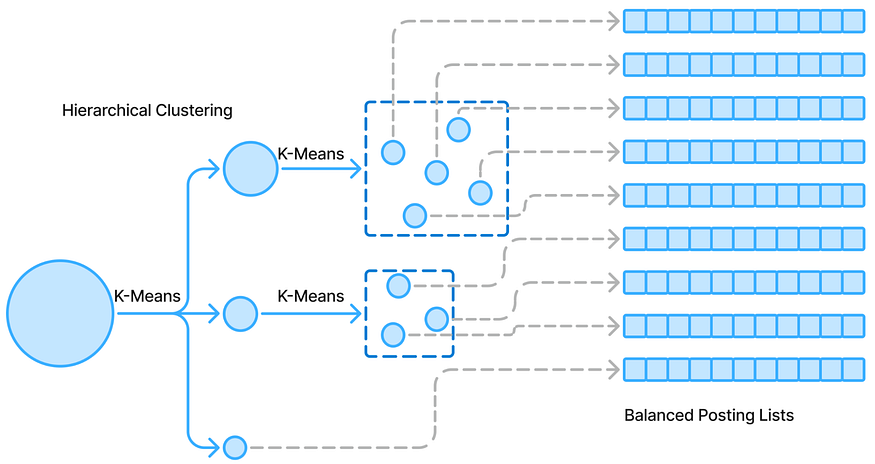
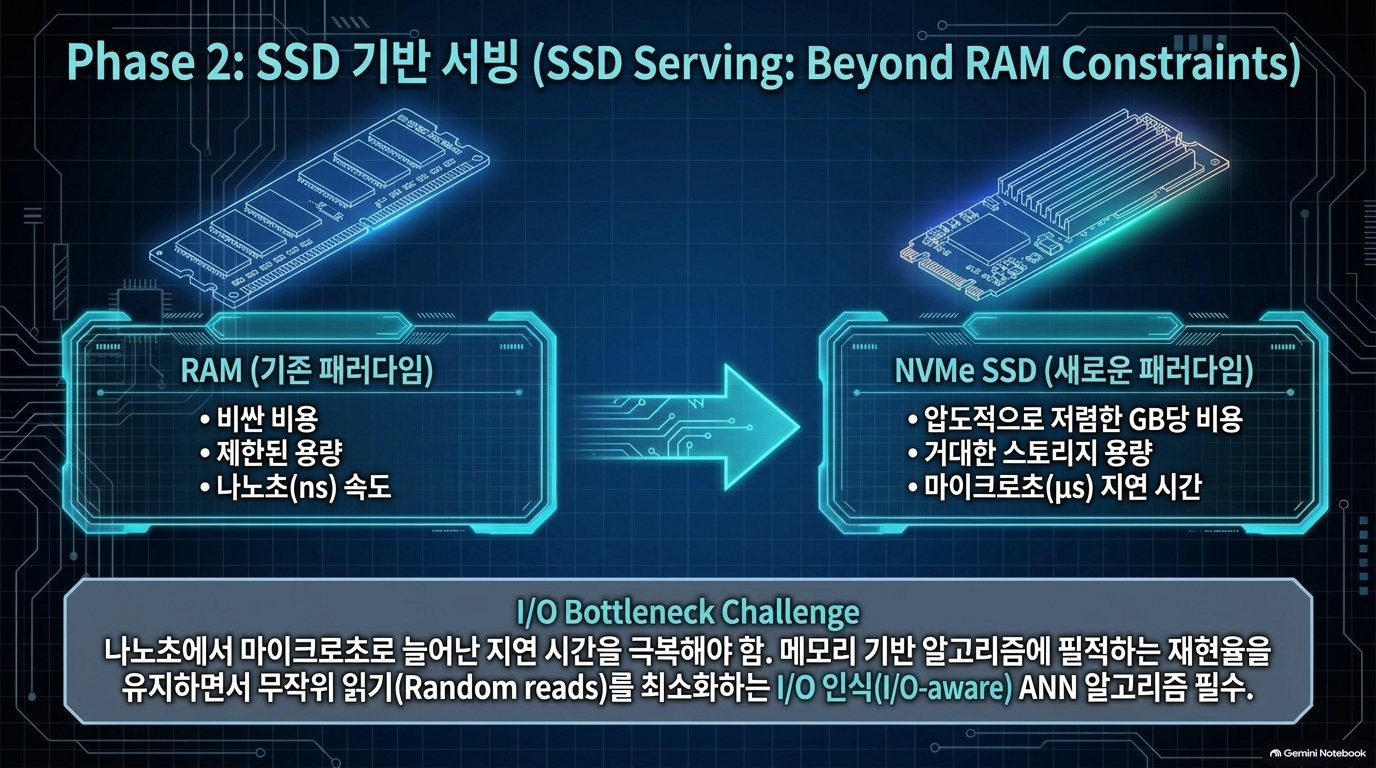
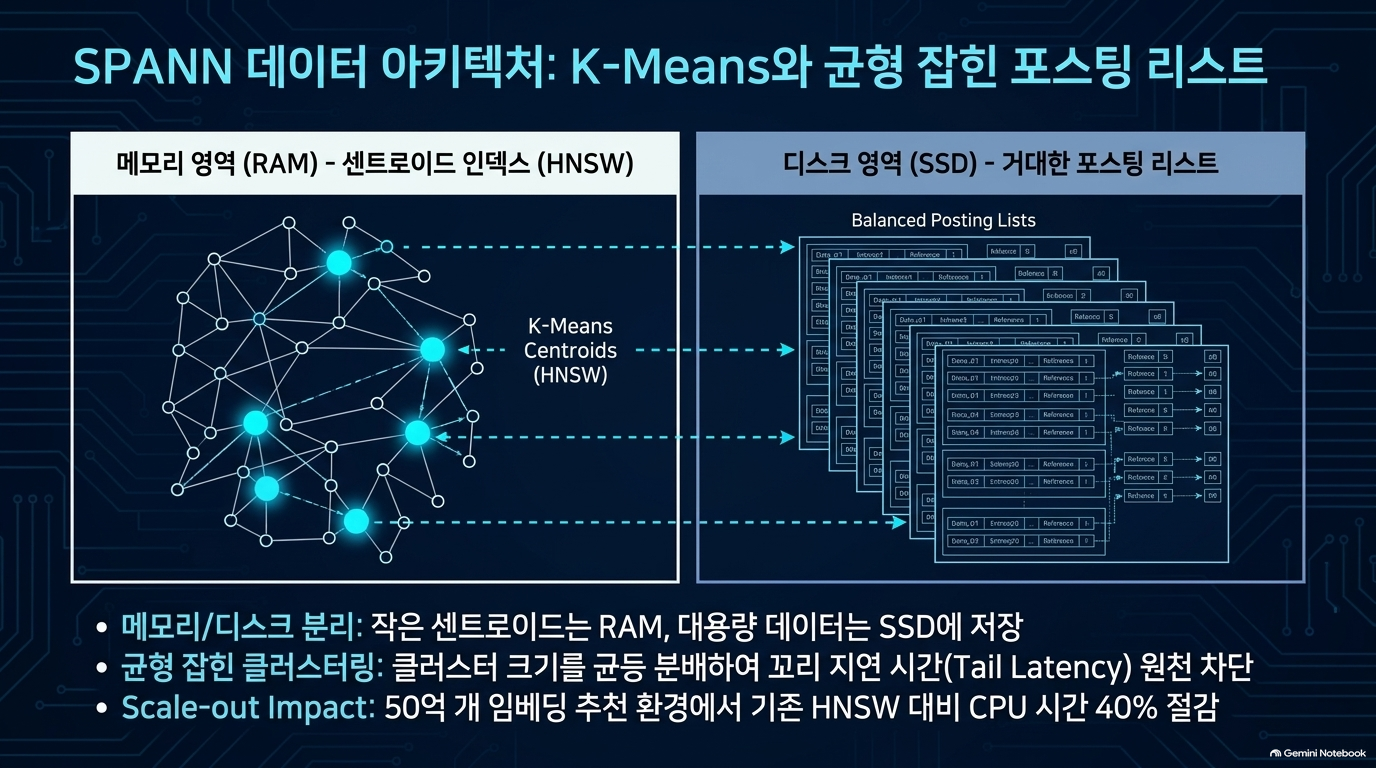
Pinterest가 선택한 SPANN 구조는 작은 centroid 인덱스를 메모리의 HNSW로 검색하고, 큰 posting list를 SSD에서 읽습니다. 균형 잡힌 계층적 클러스터링으로 posting list 길이의 편차를 줄여 tail latency를 억제합니다. SSD가 저렴하더라도 무작위 읽기가 많아지면 질의 지연이 커지므로, 핵심 설계 변수는 질의당 디스크 접근량입니다.[1]
원문의 실험 수치는 비교 대상을 구분해야 합니다.
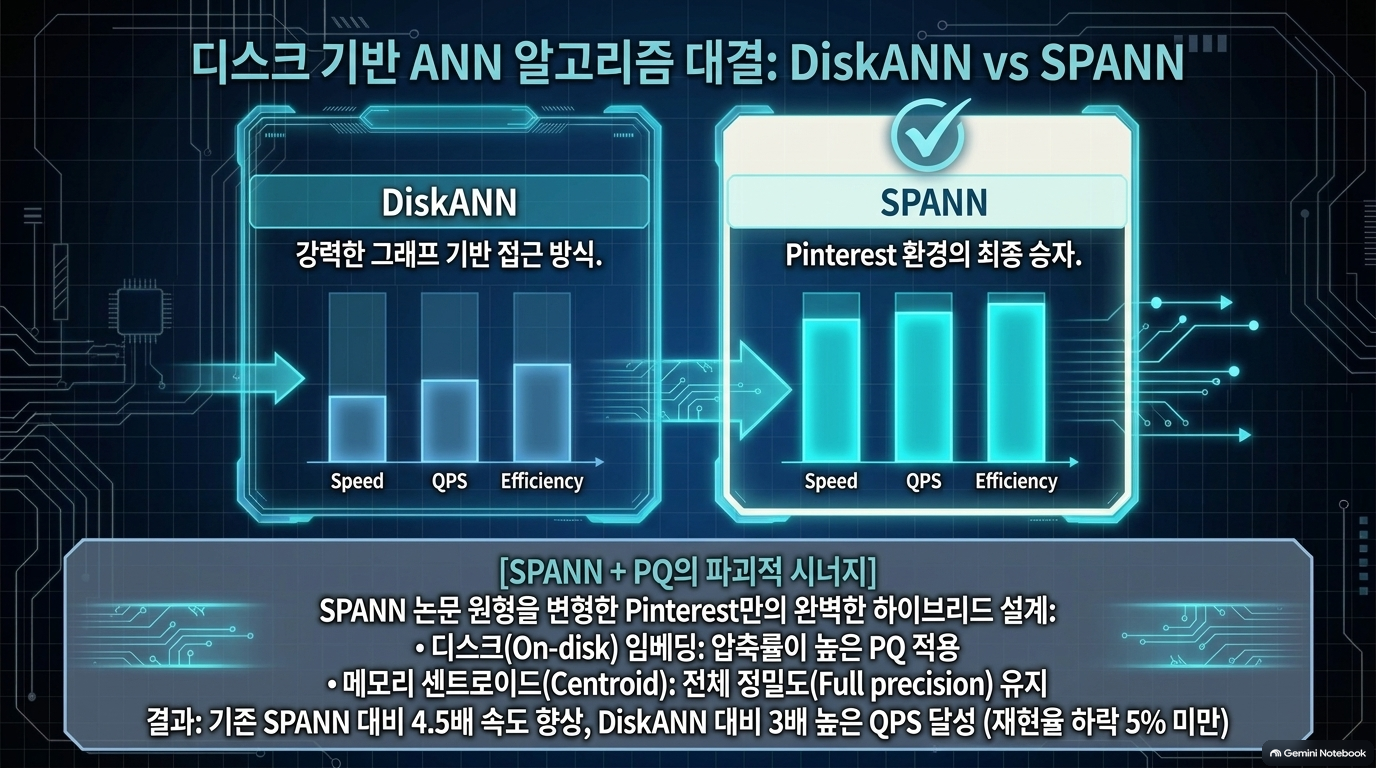
- 1억 임베딩 Search 데이터 실험에서, 디스크 임베딩에는 PQ를 적용하고 중심점은 원래 정밀도로 유지한 SPANN+PQ가 기본 SPANN보다 4.5배 빠르고, DiskANN보다 QPS 3배 이상·지연시간 약 3분의 1을 보였습니다. 다만 recall은 약 5% 하락했습니다.[1]
- 50억 임베딩 Pin 추천 사례의 예비 평가에서는 구현된 SPANN이 HNSW 대비 프로덕션 질의의 CPU 시간 40% 이상 절감, recall 5% 미만 하락을 보였습니다.[1]
- 글 앞부분의 메모리 사용량 10분의 1과 CPU 40% 절감은 SSD 서빙의 초기 실험 요약입니다. 이를 모든 Manas 클러스터에서 이미 실현한 운영 성과로 일반화해서는 안 됩니다.[1]
3. 다중 임베딩: 검색 단계의 표현력을 높이는 전환
기존 two-tower 방식은 질의와 후보를 각각 하나의 벡터로 압축하고 점곱으로 비교합니다. 반면 ColBERT 계열의 late interaction은 각각을 여러 벡터로 표현하고, 각 질의 벡터가 후보 벡터 중 가장 잘 맞는 것과의 유사도를 구해 합산합니다(Sum of MaxSim). 이는 단일 벡터로 뭉개지기 쉬운 세부 의미를 검색 단계에서 반영하려는 선택입니다.[1]
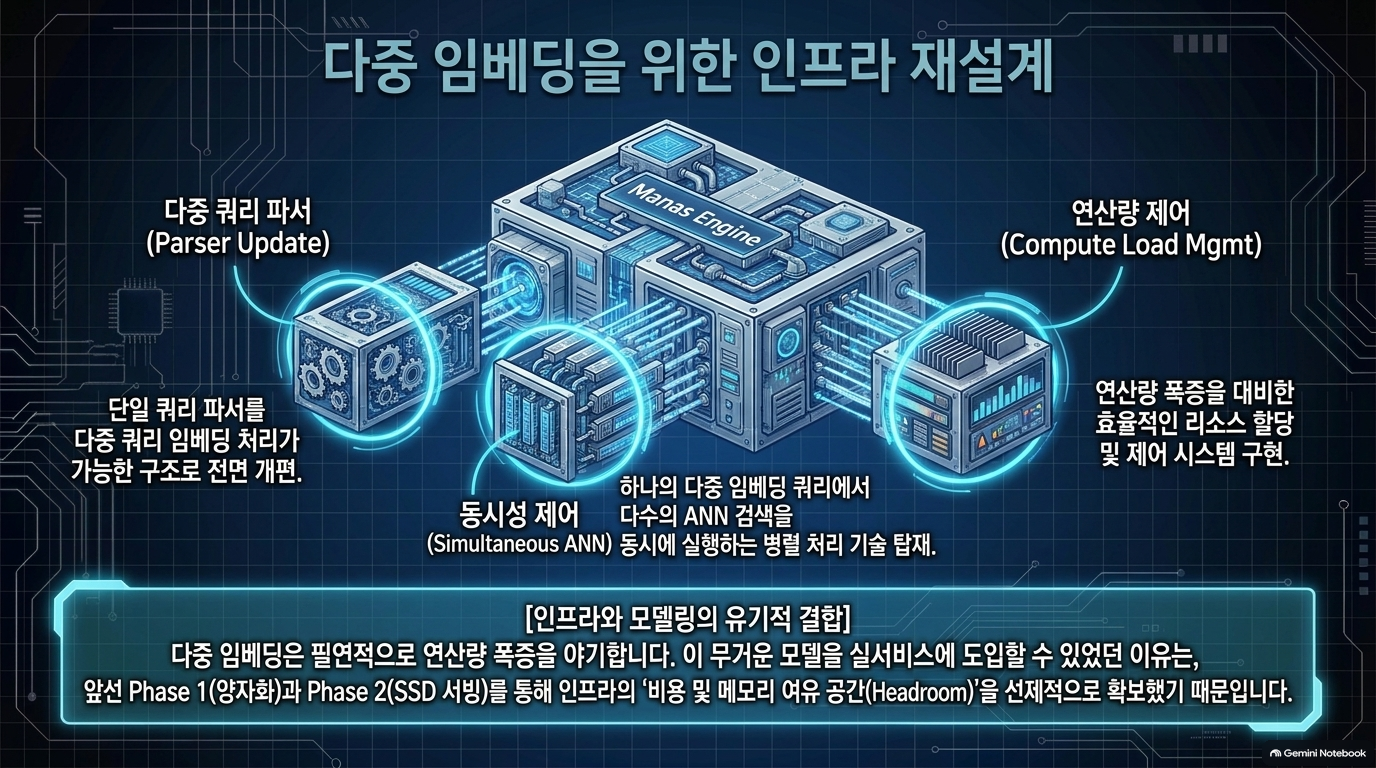
하지만 모델 변경만으로 끝나지 않습니다. Manas는 새 질의 유형, 복수 질의 임베딩을 해석하는 파서, 여러 ANN 검색의 동시 실행을 지원하도록 수정됐습니다. 원문 시점에는 제품 파일럿을 준비 중이며, 다중 임베딩으로 인한 실제 참여율 개선이나 추가 비용의 정량 결과는 제시하지 않습니다.[1]
실무적 시사점과 검증 과제
이 사례의 설계 원칙은 검색 품질·인프라 비용·모델 표현력의 공동 최적화입니다. 특히 양자화는 오프라인 recall과 온라인 사용자 지표를 함께 봤다는 점에서 참고할 만합니다. 반면 SSD 검색과 다중 임베딩을 다른 환경에 도입하려면 다음 수치가 별도로 필요합니다.
- 동일 조건 비교: recall@k, p95/p99 지연시간, QPS, 질의당 SSD 읽기량과 CPU 비용을 같은 데이터·하드웨어에서 비교.
- 품질 손실의 영향: 원문의 ‘recall 5% 하락’이 최종 추천·검색 품질과 사용자 지표에 어떤 영향을 주는지 검증.
- 운영 적합성: 기존 Manas의 ‘수초 내 검색 가능’한 갱신 특성이 SSD 기반 인덱스에서도 유지되는지 확인. 원문은 이를 입증하는 갱신 성능 수치를 제공하지 않습니다.
- 다중 임베딩의 순효익: 표현력 향상분이 후보별 벡터·복수 ANN 탐색으로 늘어나는 저장 및 서빙 비용을 상쇄하는지 측정.
결론: 이미 검증된 성과의 중심은 양자화의 비용 절감입니다. SPANN은 유망한 예비 성과, 다중 임베딩은 기능 구현 후 제품 검증을 앞둔 단계로 구분해서 평가하는 것이 정확합니다.[1]
Sources
[1] https://medium.com/pinterest-engineering/evolving-pinterests-embedding-retrieval-platform-aede4e831e01 — Pinterest Engineering, Evolving Pinterest’s Embedding Retrieval Platform (2026-09-11)


'07.AI > 12. AI 모델' 카테고리의 다른 글
| LLM - 딥시크 (DeepSeek) - DeepSeek-V4 Pro (0) | 2026.09.24 |
|---|---|
| LLM - SpaceXAI(xAI), Grok 4.7 (0) | 2026.09.23 |
| LLM - Anthropic, Claude Opus 5.5 (0) | 2026.09.23 |
| LLM - 오픈 웨이트(Open Weight) - 오픈 모델의 현재 힘의 균형 (0) | 2026.09.22 |
| 사후 학습 (Post-training) - O'Reilly Radar, GPT-3보다 ChatGPT가 크게 개선될 수 있었던 파이프라인 (0) | 2026.09.22 |