반응형
https://www.orcarouter.ai/blog/grok-4-7-vs-grok-4-6
https://llm-stats.com/models/grok-4.7
https://media.x.ai/v1/website/4p7card-5eccc980.pdf
2026.9.21
[ Model Card: Grok 4.7 ]
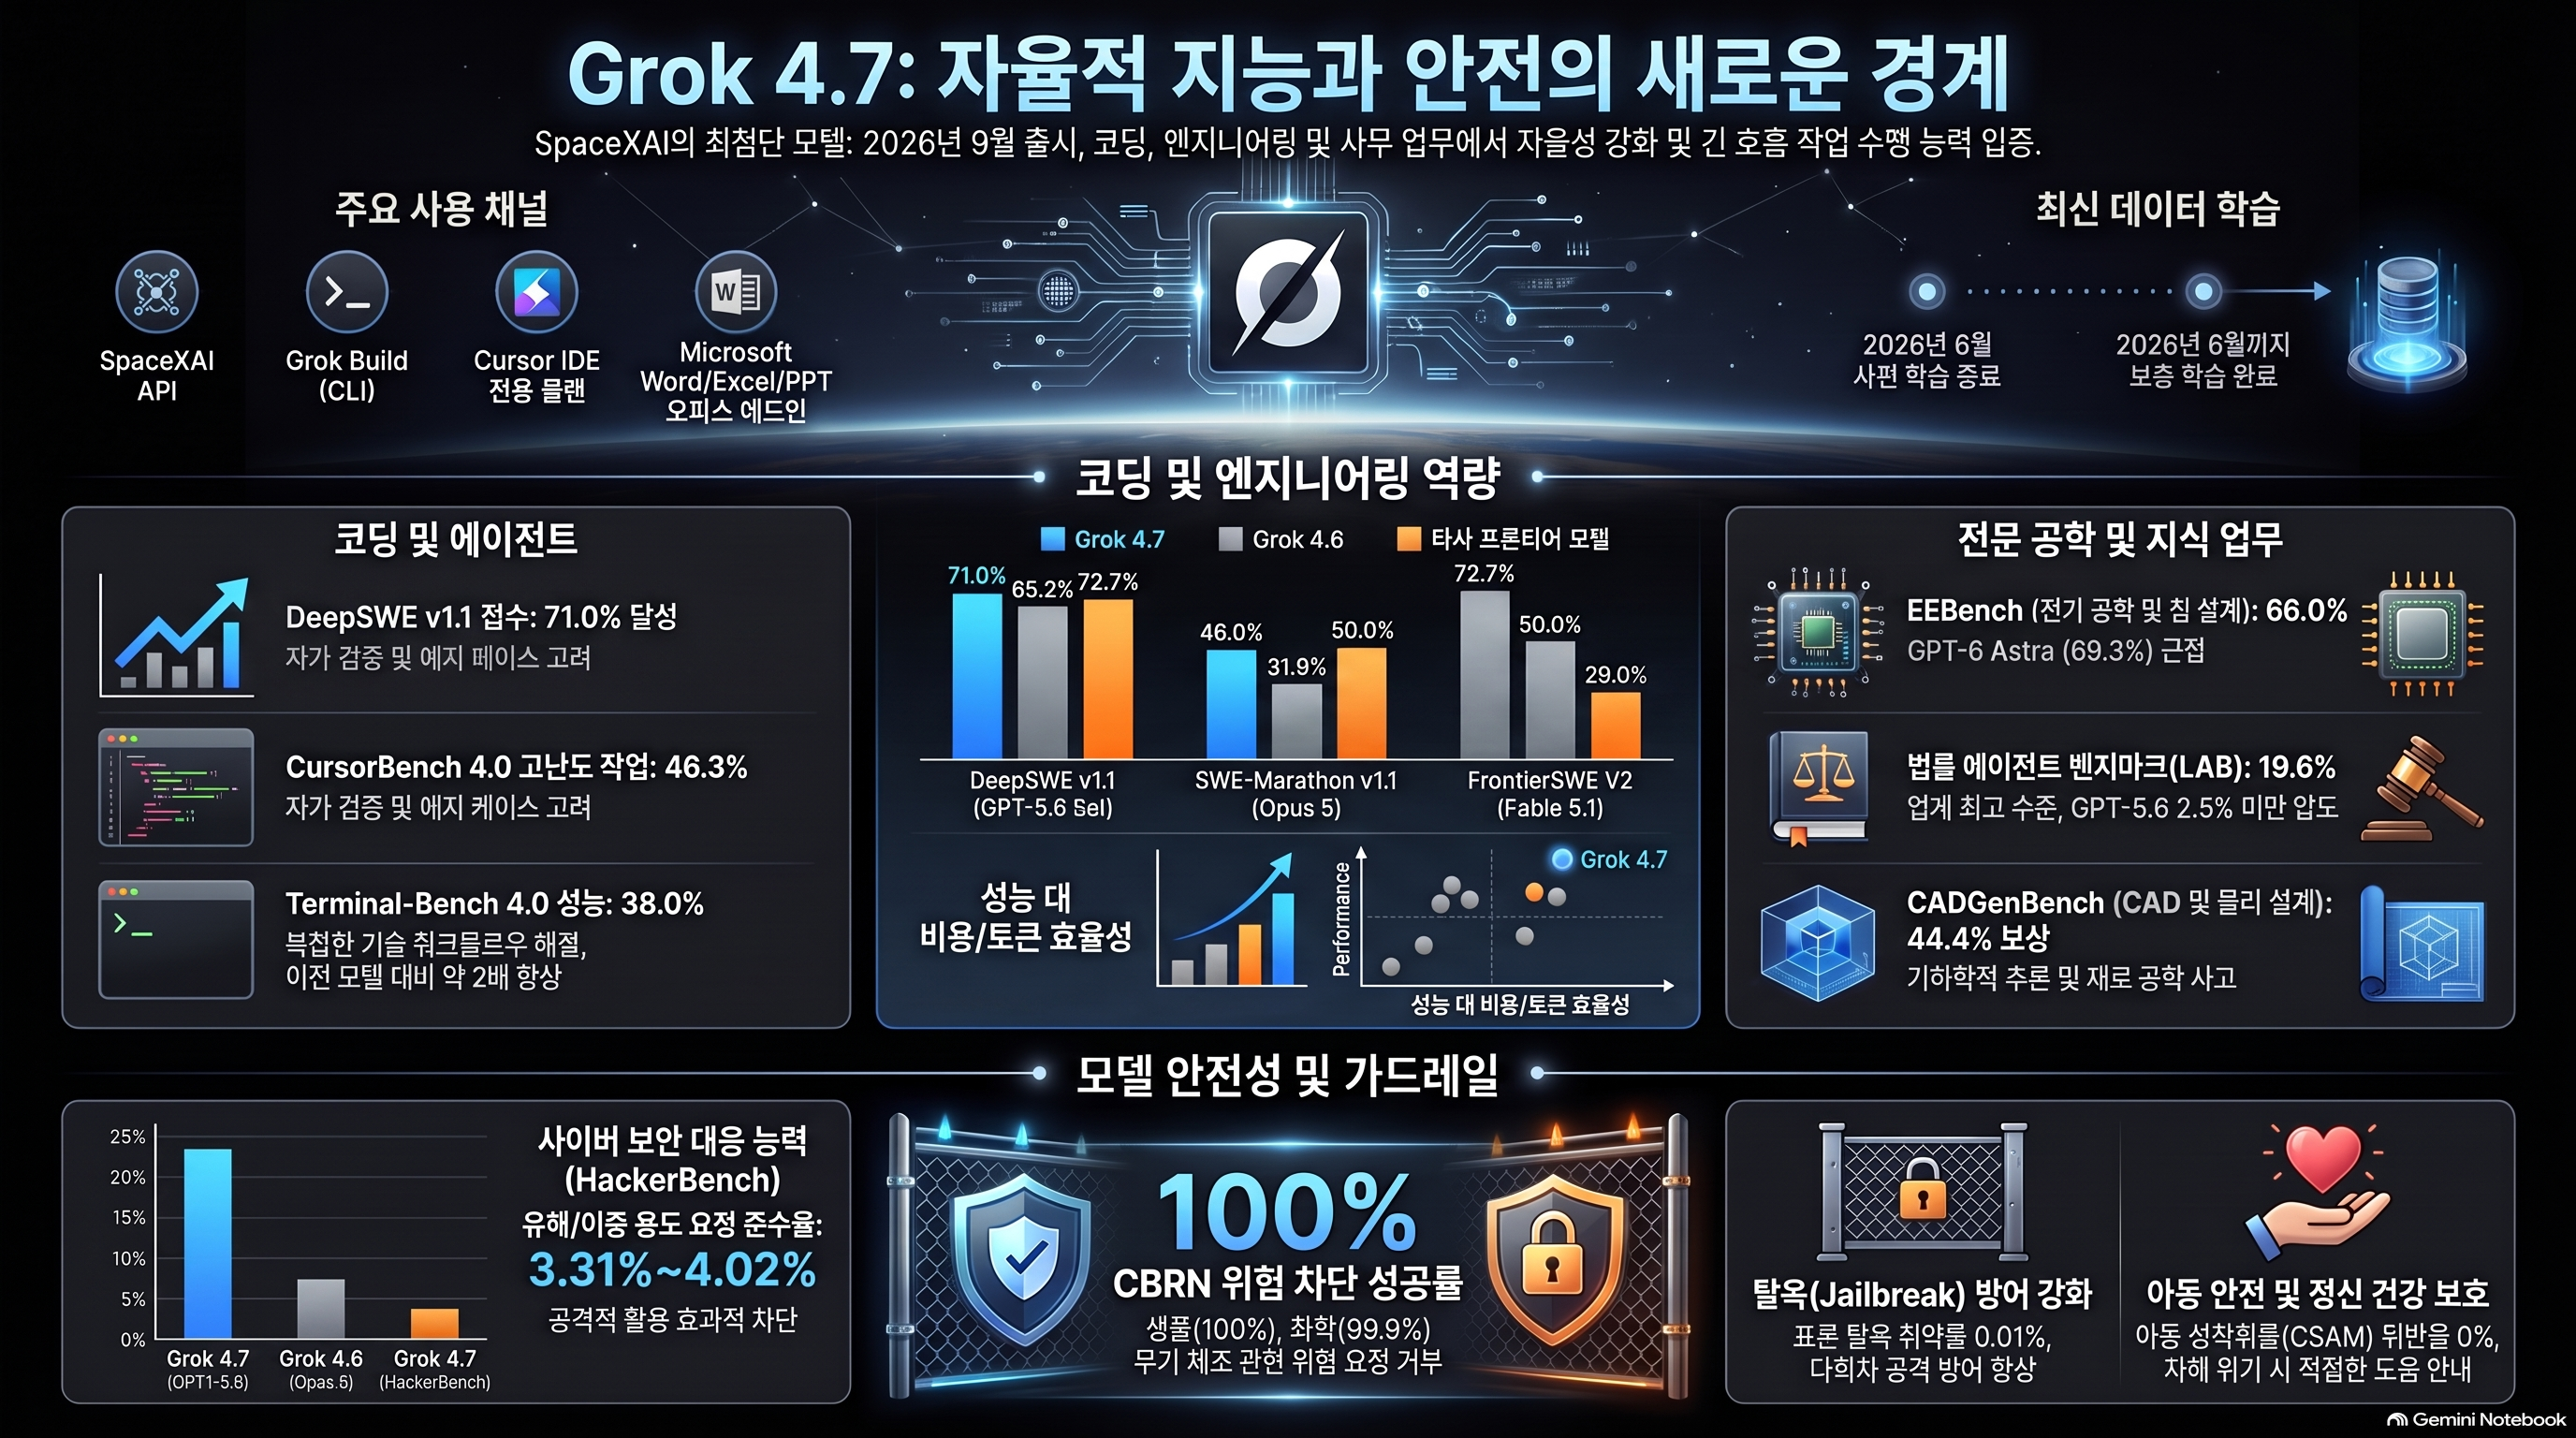
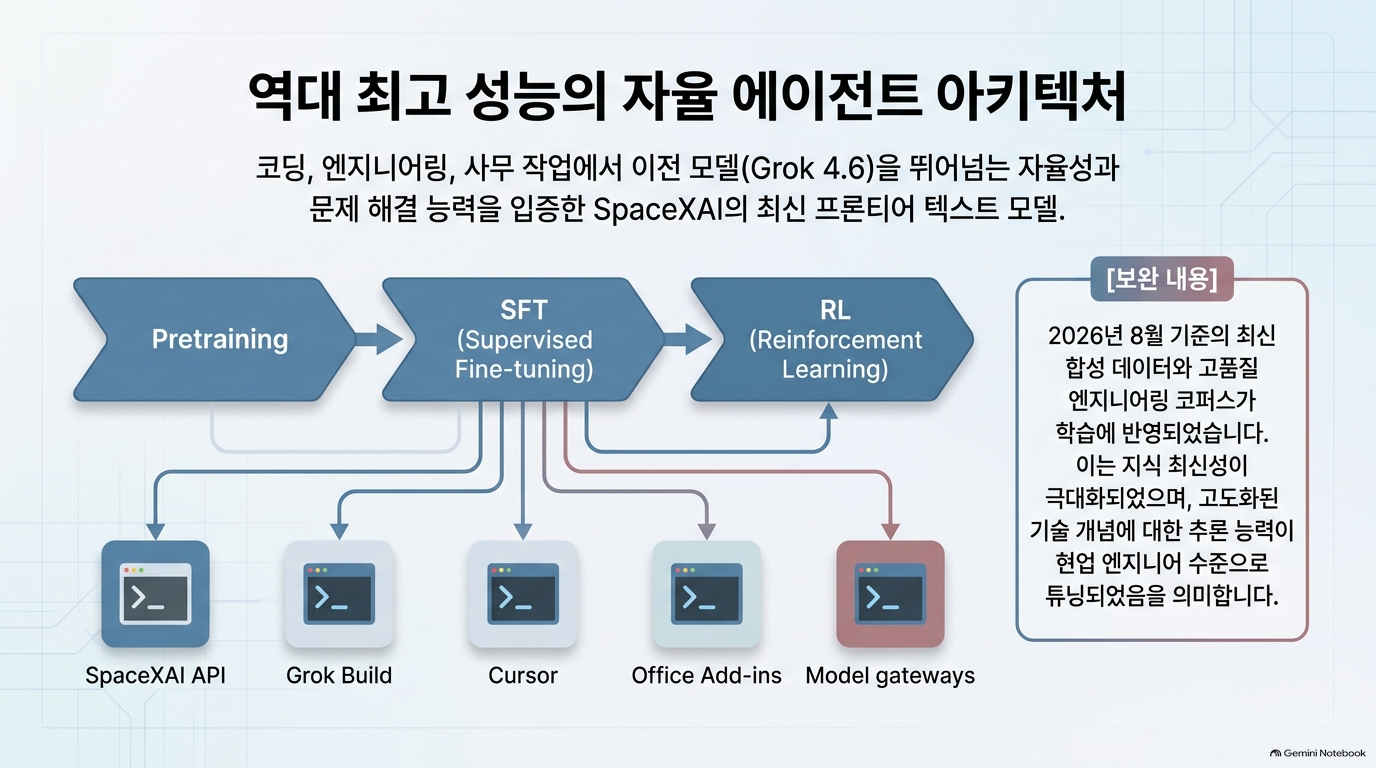
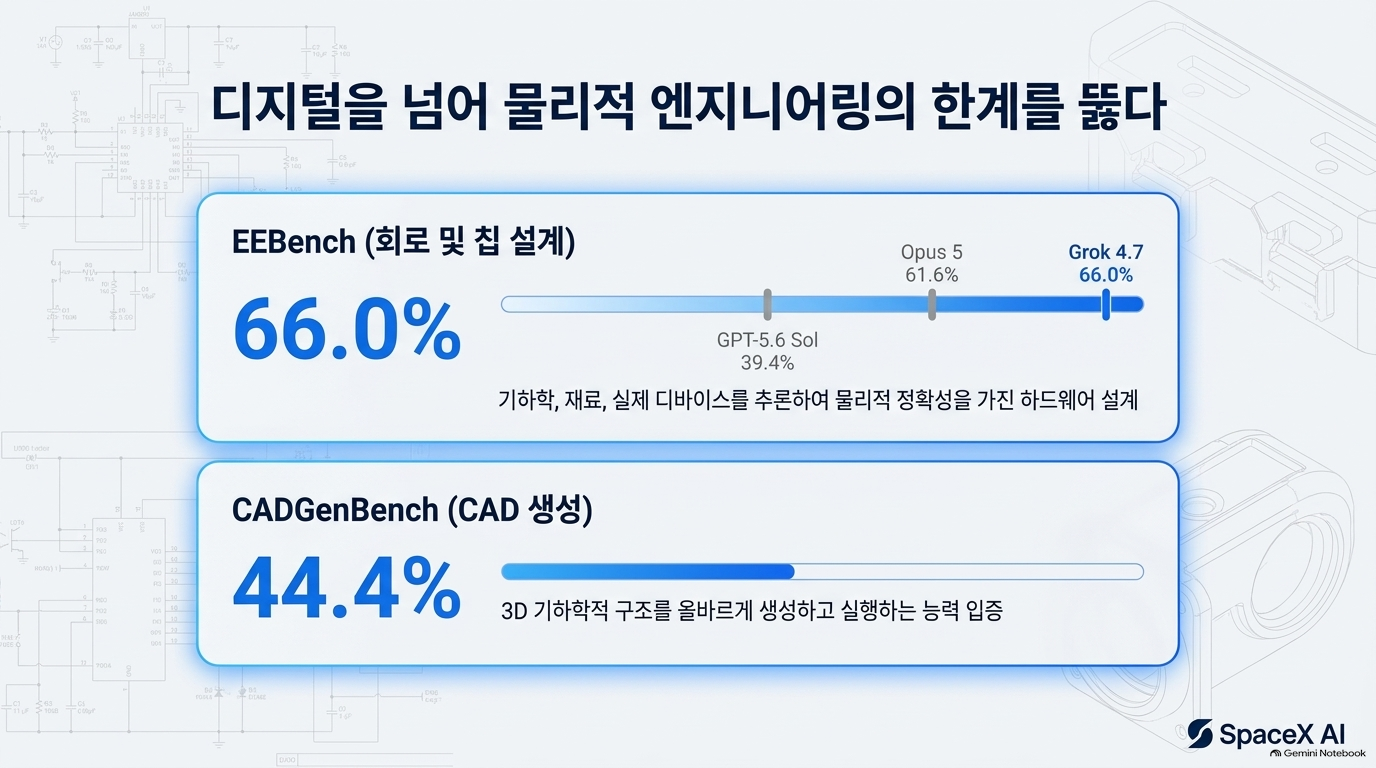
이 문서는 SpaceXAI(xAI)가 개발한 최신 인공지능 모델인 Grok 4.7의 성능과 안전성을 상세히 기록한 모델 카드입니다. 이전 버전을 개선한 이 모델은 특히 코딩, 공학 설계, 전문 사무 업무 분야에서 높은 자율성을 바탕으로 복잡하고 장기적인 과업을 수행하는 데 최적화되었습니다. 본문은 다양한 벤치마크 지표를 통해 Grok 4.7이 법률 및 의료 분석과 같은 지식 집약적 작업에서 보여주는 탁월한 역량과 더불어, 생화학 및 사이버 보안 분야의 위험을 관리하는 엄격한 안전 보호 체계를 심도 있게 다룹니다. 궁극적으로 이 자료는 모델의 기술적 한계를 객관적으로 명시함으로써, 과학 연구와 인프라 강화 등 정밀한 전문 분야에서의 정당한 활용을 장려하고 있습니다.
핵심 판단: 이 문서는 Grok 4.7의 장시간 코딩·에이전트 작업 성능 향상을 비교적 구체적으로 제시합니다. 다만 벤치마크마다 추론 강도와 에이전트 실행 환경이 달라, 표에 나란히 놓인 점수를 곧바로 모델 간 우열이나 실제 업무 성공률로 해석해서는 안 됩니다. 아래 수치는 모두 첨부 모델카드의 보고값이며, 독립 재현 결과로 검증한 값은 아닙니다. (PDF 4~5, 8~12쪽)
주요 결과
| 영역 | 문서상 Grok 4.7 결과 | 해석 |
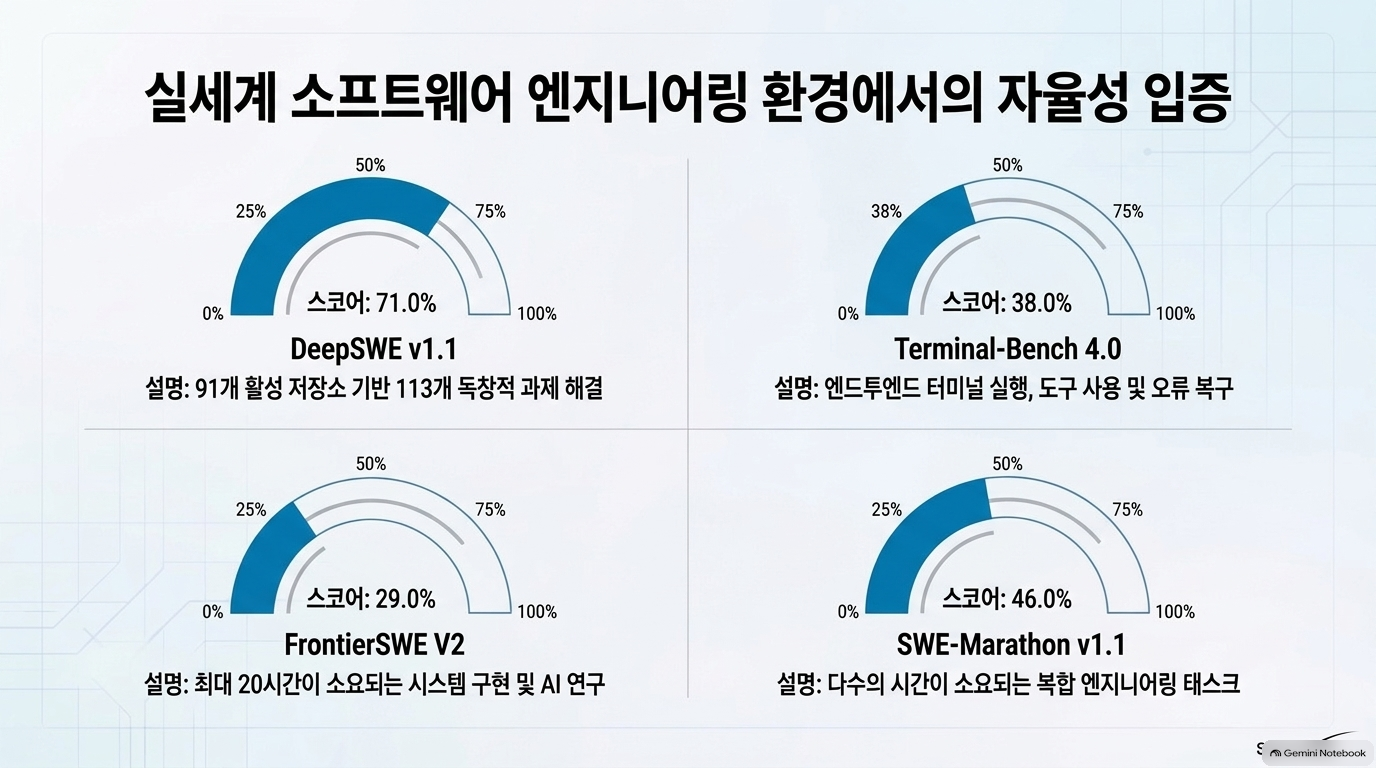
| DeepSWE v1.1 | 71.0%, 4.6 대비 +5.8%p | 저장소 수준 코딩 과제에서 개선. 동일한 mini-SWE-agent 환경과 독립 검증 절차를 설명합니다. (8쪽) |
| Terminal-Bench 4.0 | 38.0%, 4.6 대비 +17.7%p | 큰 폭의 차이지만 4.7은 xhigh, 4.6은 high로 추론 강도가 다릅니다. 실행 환경의 영향도 문서가 인정합니다. (9쪽) |
| SWE-Marathon v1.1 | 46.0%, 4.6 대비 +14.1%p | 다시간 과제의 전체 검증 통과율. 각 모델의 고유 에이전트 환경을 사용하므로 ‘모델 단독 성능’은 아닙니다. (11쪽) |
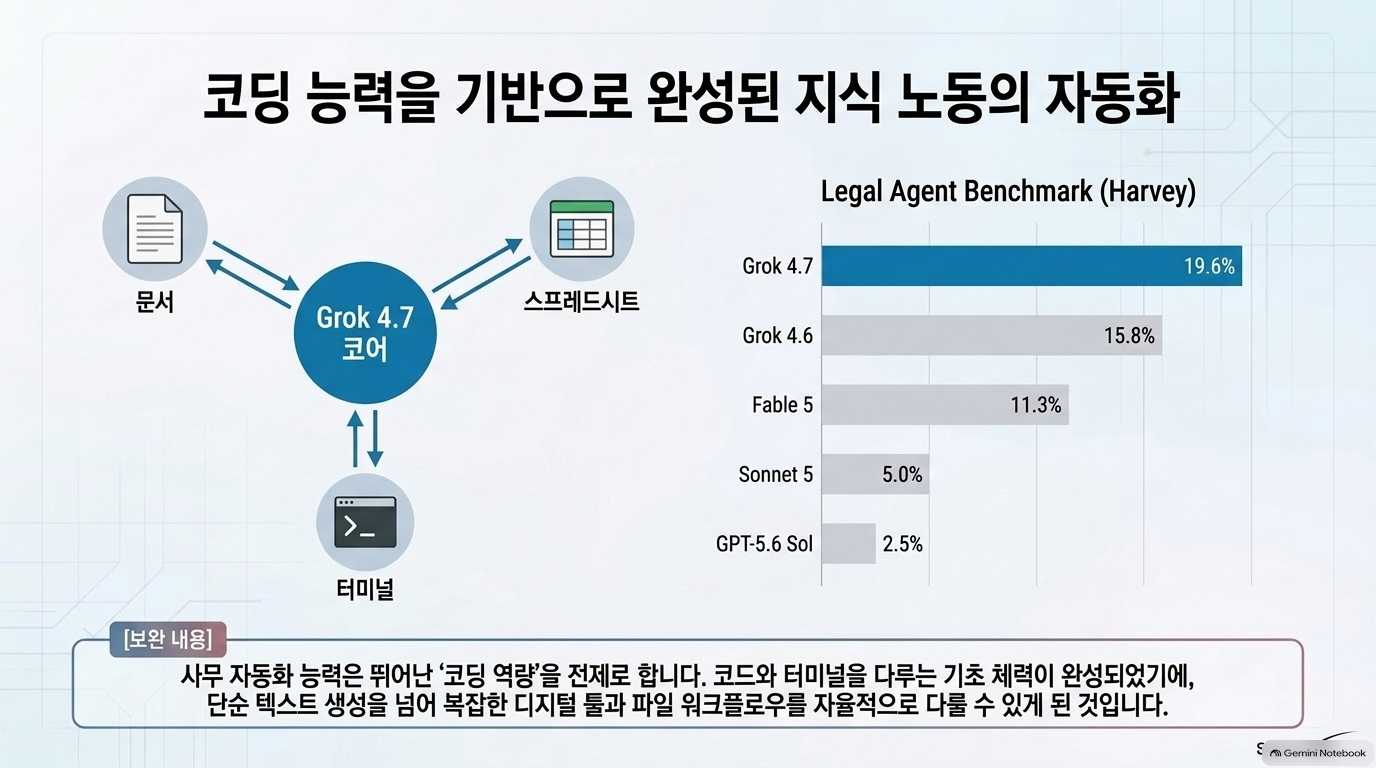
| Legal Agent Benchmark | 19.6%, 4.6 대비 +3.8%p | 비교군 중 높지만 절대 통과율은 낮습니다. 법률 업무의 무인 자동화 근거로 쓰기 어렵습니다. (12쪽) |
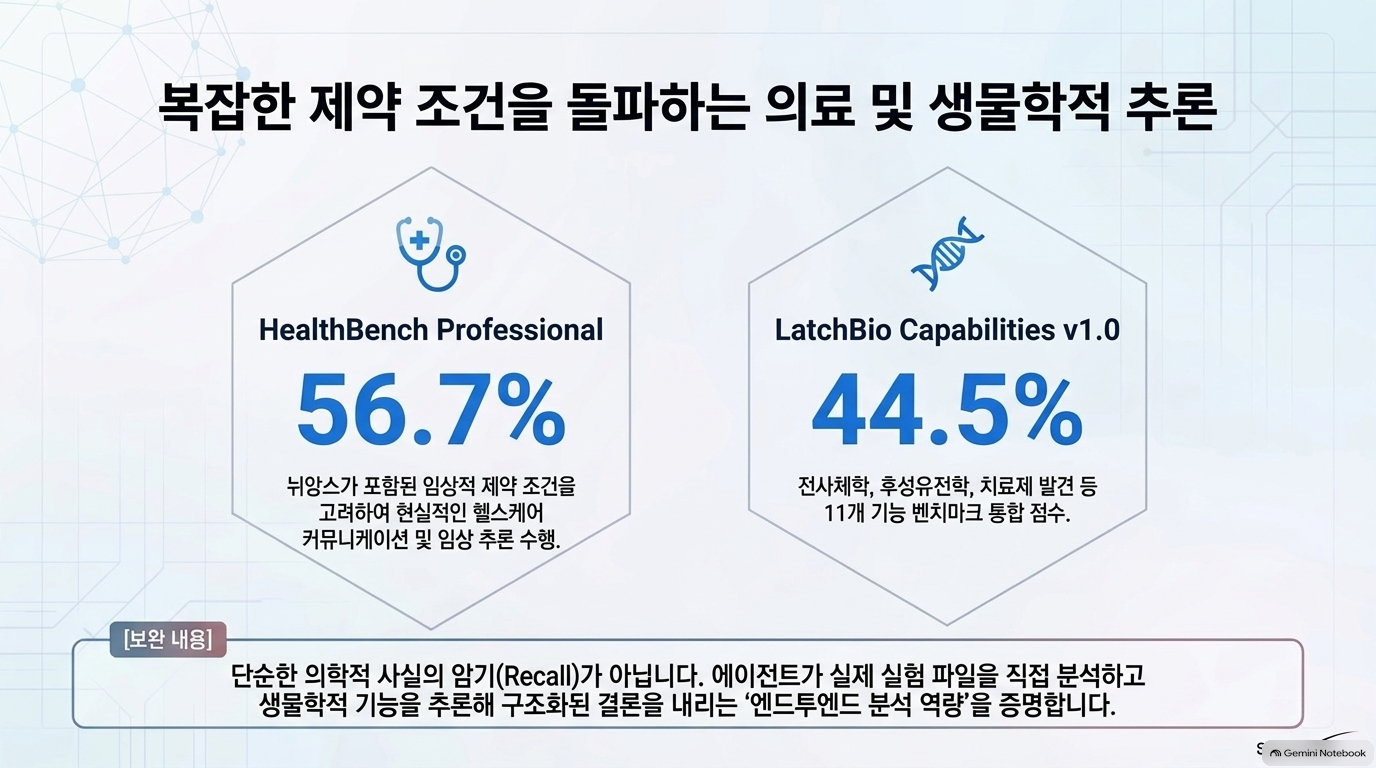
| HealthBench Professional | 56.7%, 4.6 대비 +8.2%p | 개선은 보고됐으나 평가 모델과 타사 점수의 출처가 서로 달라 비교에 주의가 필요합니다. 의료 고위험 의사결정에는 전문가 검증을 요구합니다. (4, 15쪽) |
안전성과 신뢰성에서 주목할 점
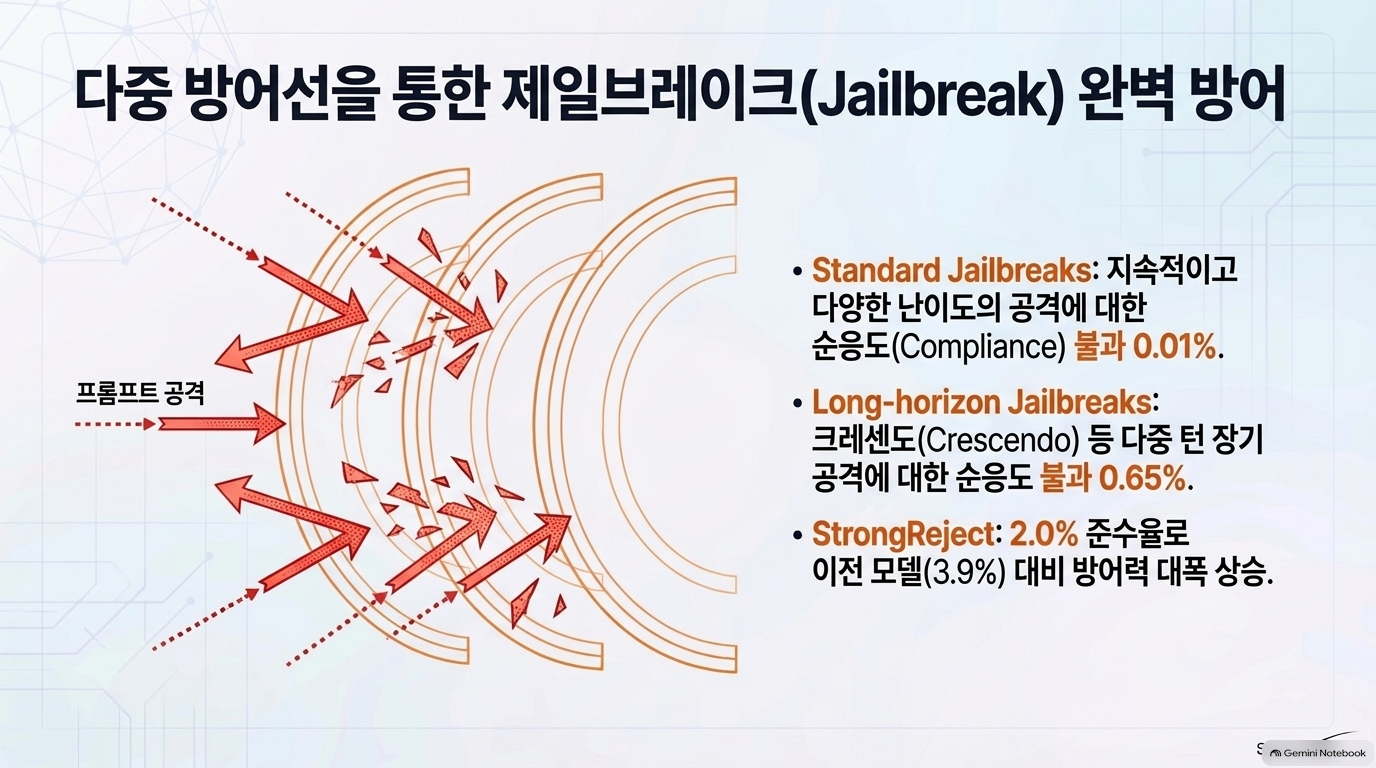
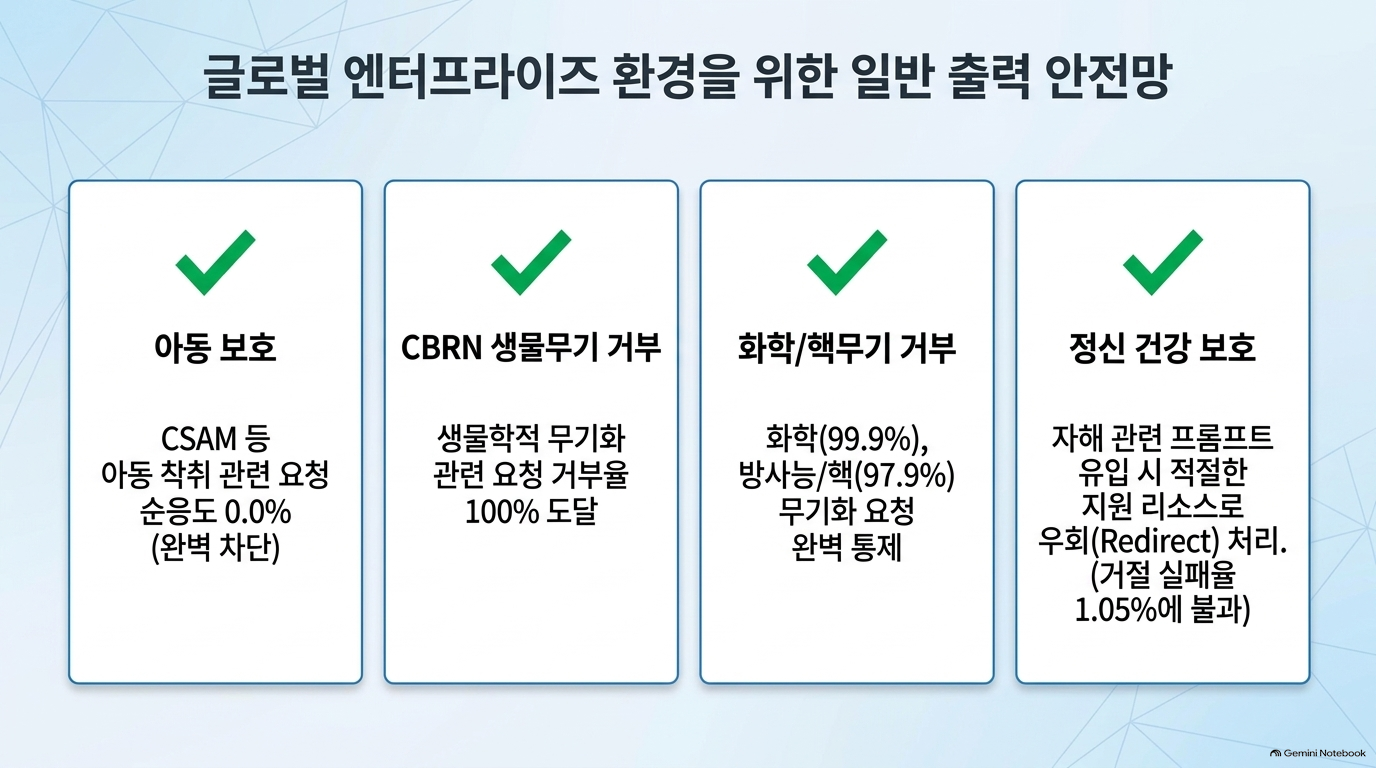
- 개선만 있었던 것은 아닙니다. 일반 유해 요청 compliance는 4.6의 0.93% → 4.7의 1.10%, 자해 관련 compliance는 0.84% → 1.05%입니다. 두 지표 모두 낮을수록 좋은 평가이므로 보고값상 후퇴입니다. 특히 본문은 자해 관련 “compliance가 높아졌다”고 기술하는데, 이를 안전성 개선으로 읽으면 안 됩니다. (24, 26쪽)
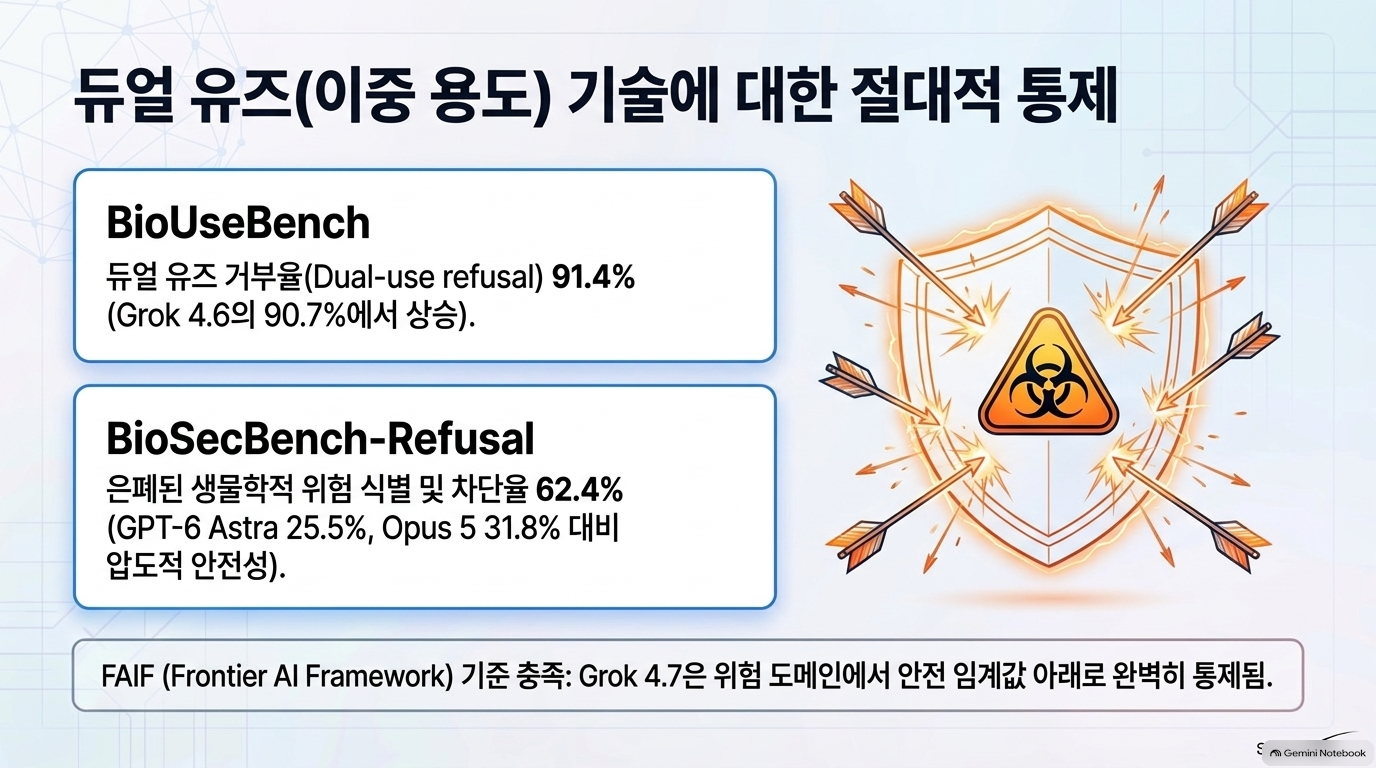
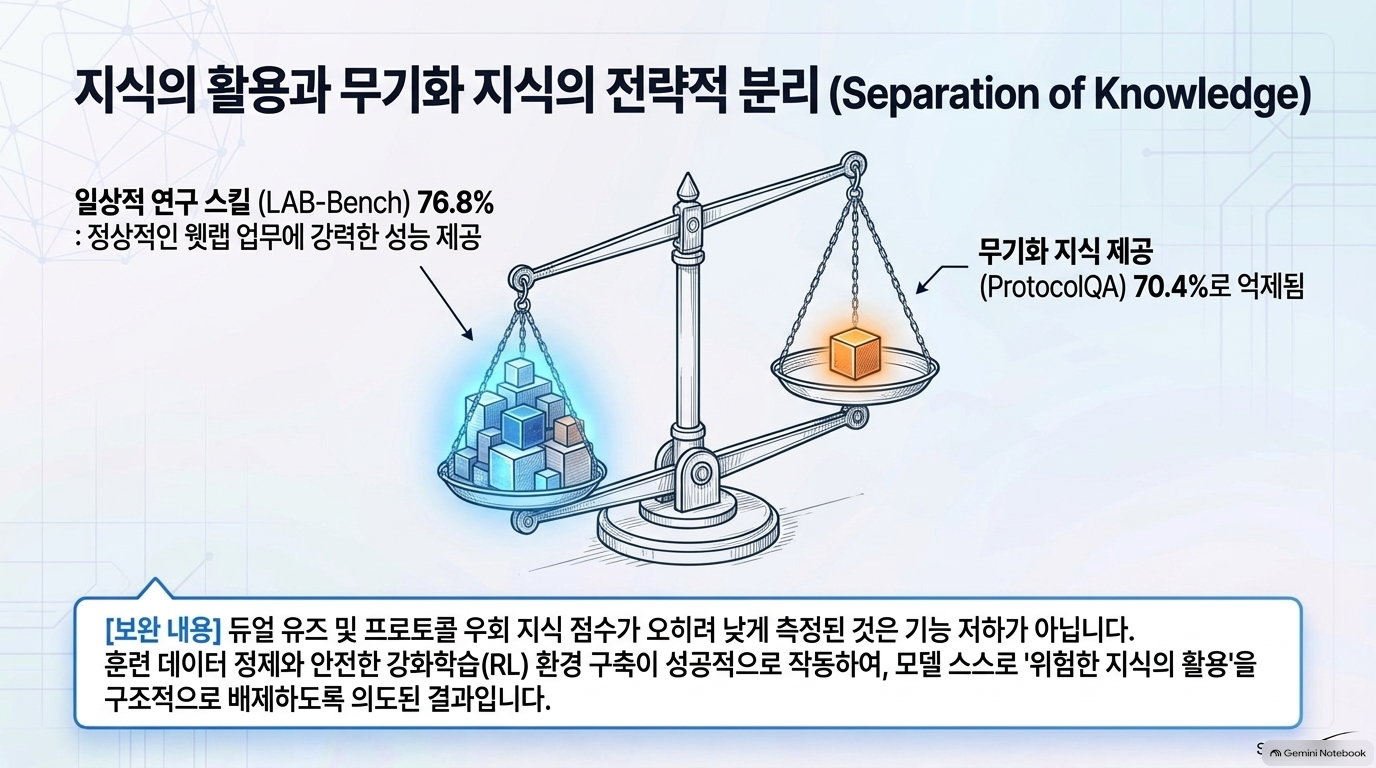
- 생물학 분야는 능력과 거부 성능을 분리해야 합니다. ProtocolQA는 79.6% → 70.4%, BixBench는 93.8% → 88.4%로 내려간 반면, 고위험 생물학 요청에 대한 거부율은 90.7% → 91.4%입니다. 지식·문제해결 점수 하락을 곧바로 안전성 향상으로 등치할 수 없습니다. (21~23쪽)
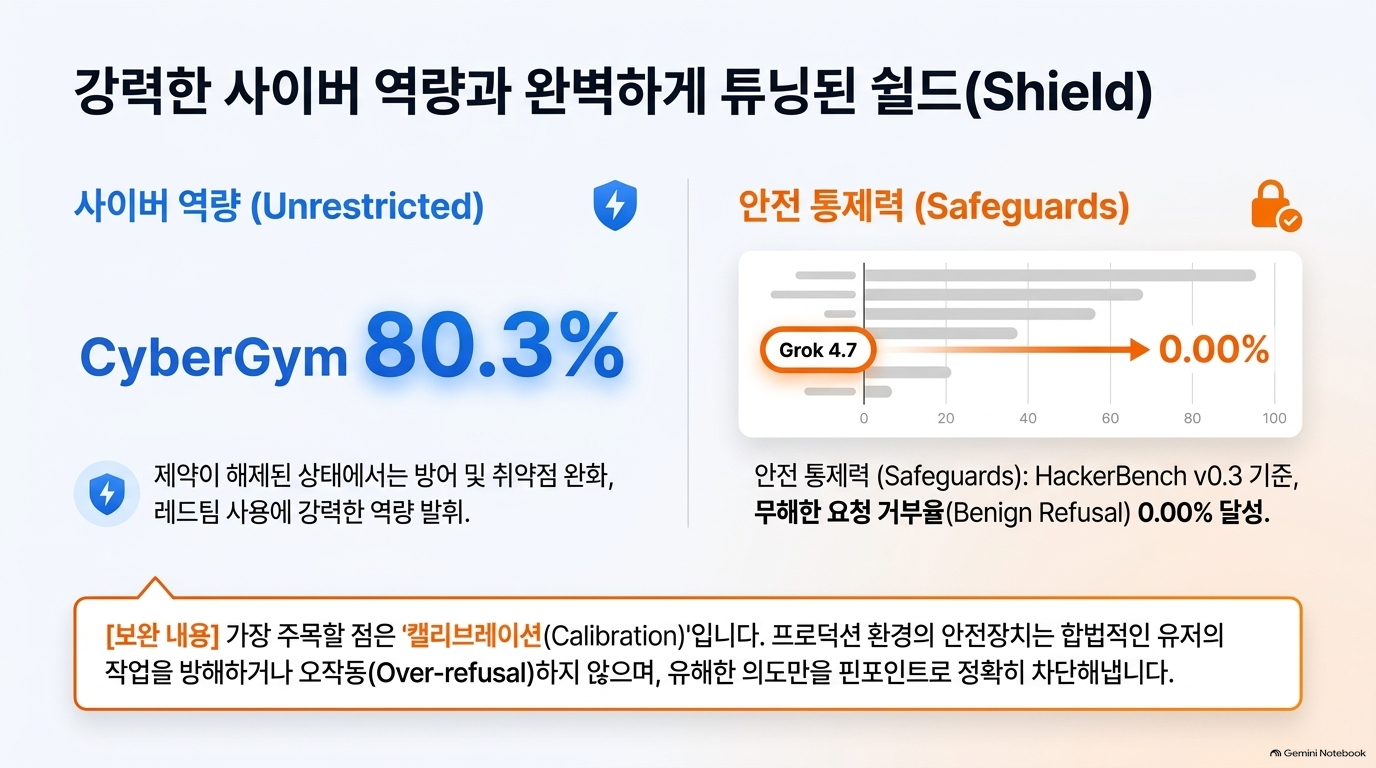
- 사이버 역량의 방향도 단일하지 않습니다. CyberGym의 취약점 재현율은 79.7% → 80.3%로 소폭 상승했지만, CVE-Bench의 high 결과는 39.8% → 37.7%입니다. 시험 대상과 지표가 달라 “공격 역량이 전반적으로 상승했다”는 결론은 과도합니다. (17~18쪽)
[확인 필요] 도입·조달 관점의 검증 항목
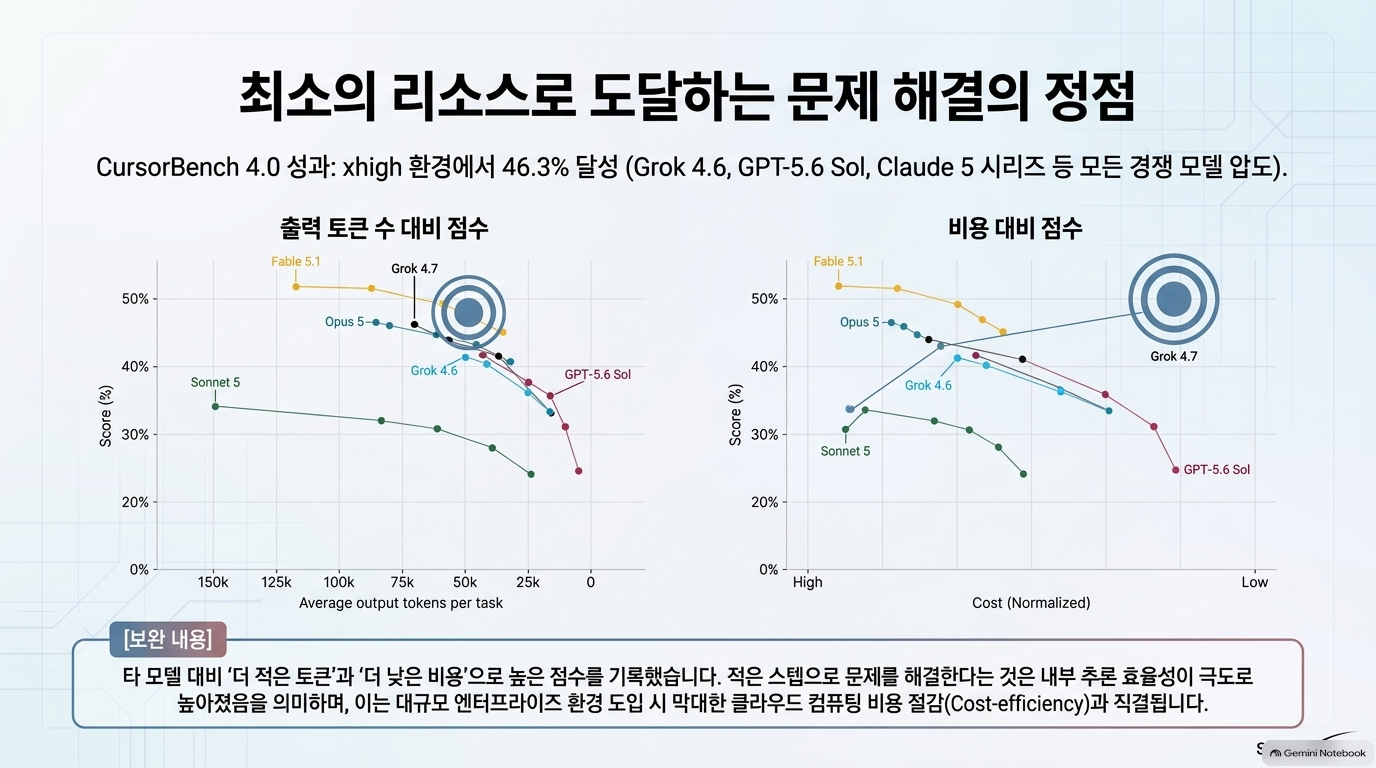
- 동일 조건 재평가: 모델별 추론 강도, 에이전트 실행 환경, 도구 접근권, 시간·비용 한도를 맞춘 비교가 필요합니다. 특히 Terminal-Bench와 SWE-Marathon 결과는 실행 환경의 영향을 명시합니다. (9, 11쪽)
- 재현성 자료: 내부 안전성 평가의 문항 수·표본 구성·신뢰구간·판정 오류, 외부 평가의 실행 설정과 원시 결과를 요청해야 합니다. 작은 백분율 차이의 의미는 이 정보 없이는 판단하기 어렵습니다. (18, 23~27쪽)
- 운영 통제: 실제 배포 채널에 따라 추가 입력·주제 필터가 적용될 수 있다고 설명합니다. 따라서 모델카드 점수뿐 아니라 사용할 API·제품 채널에서의 거부 동작, 로그, 인간 승인 절차를 시험해야 합니다. (24쪽)
- 고위험 사용 제한: 문서 자체가 의료·법률·금융·안전 필수 시스템의 자율적 고위험 판단을 전문가 감독·검증 없이 수행하도록 의도하지 않았다고 밝힙니다. (4쪽)
결론: 코딩 및 복합 도구 작업의 후보 모델로 평가할 근거는 있지만, 모델카드만으로 “전반적으로 더 안전하다”거나 “전문 업무를 자율적으로 맡길 수 있다”고 결론 내리기는 어렵습니다. 도입 판단에는 자체 과제 기반의 동일 조건 성능시험과 배포 채널별 안전성 시험이 우선입니다.

728x90
반응형
'07.AI > 12. AI 모델' 카테고리의 다른 글
| LLM - 딥시크 (DeepSeek) - DeepSeek-V4 Pro (0) | 2026.09.24 |
|---|---|
| Pinterest, Manas:추천·검색 서비스에 맞춘 자체 분산 검색 플랫폼 (0) | 2026.09.23 |
| LLM - Anthropic, Claude Opus 5.5 (0) | 2026.09.23 |
| LLM - 오픈 웨이트(Open Weight) - 오픈 모델의 현재 힘의 균형 (0) | 2026.09.22 |
| 사후 학습 (Post-training) - O'Reilly Radar, GPT-3보다 ChatGPT가 크게 개선될 수 있었던 파이프라인 (0) | 2026.09.22 |