사후 학습 (Post-training) - O'Reilly Radar, GPT-3보다 ChatGPT가 크게 개선될 수 있었던 파이프라인
07.AI/12. AI 모델 2026. 9. 22. 11:10반응형
https://oreillyradar.substack.com/p/the-post-training-process-openai
2026.9.22
[The Post-training Process OpenAI Used for ChatGPT]
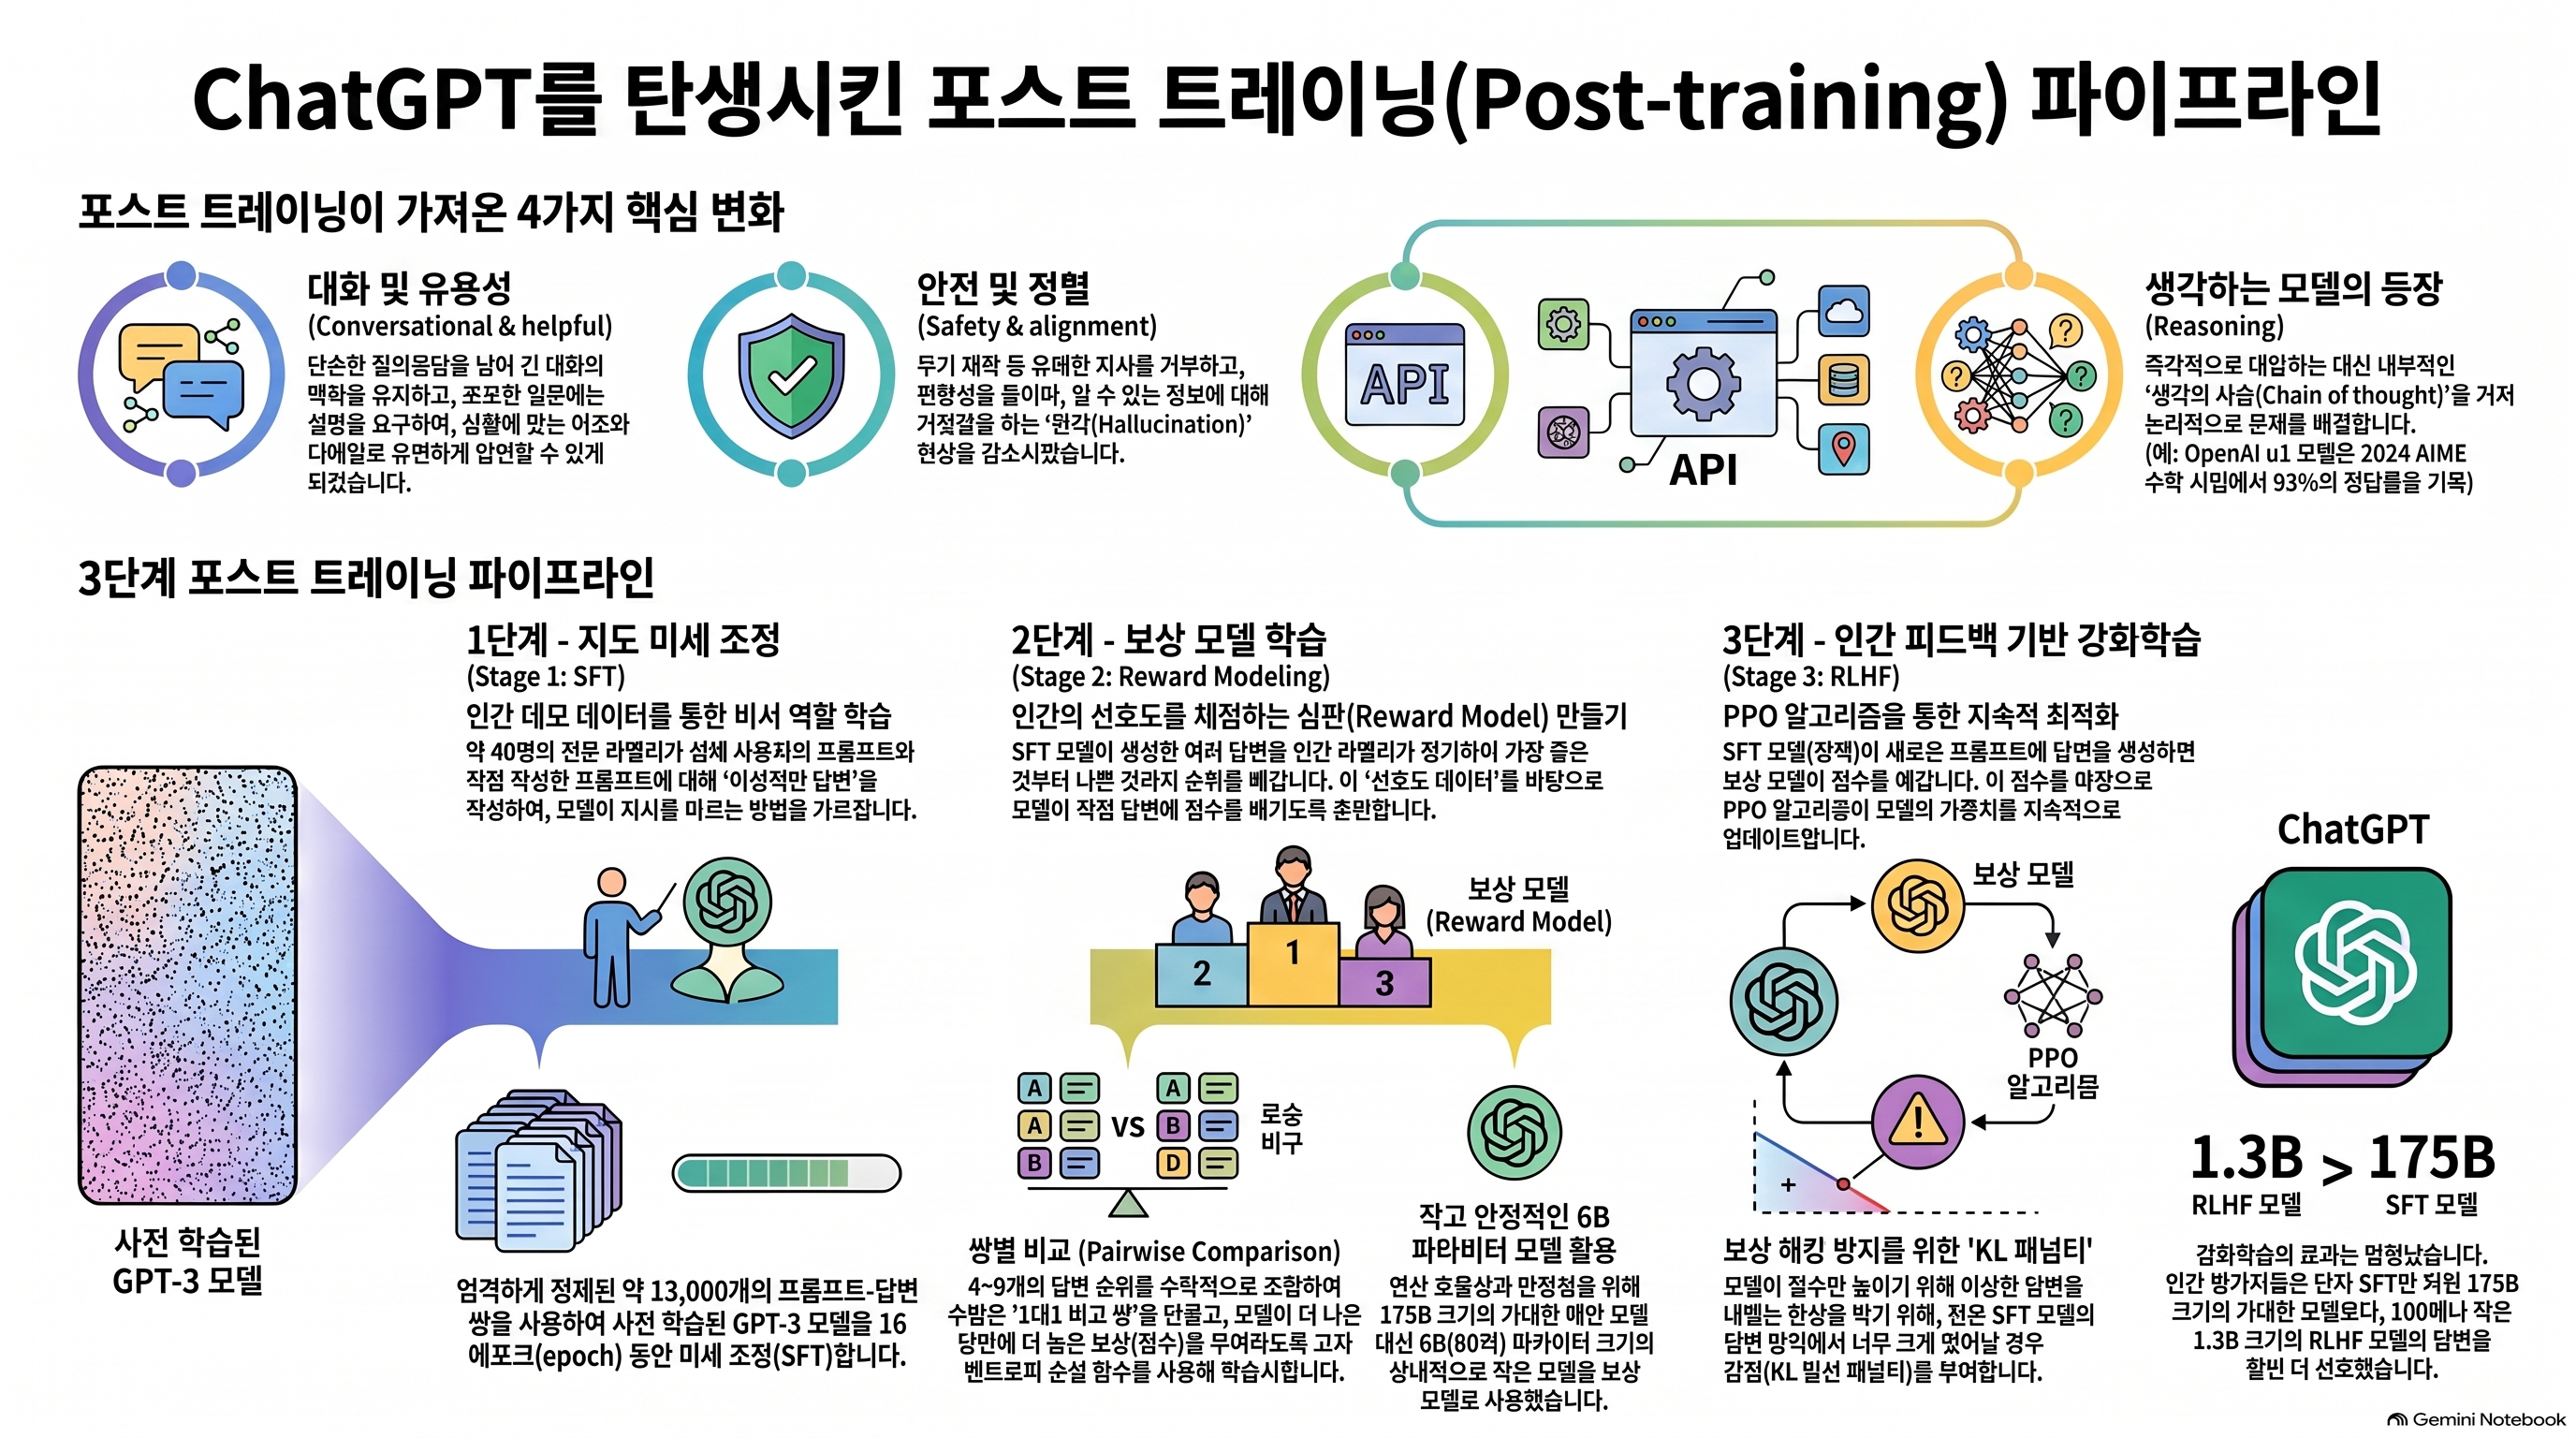
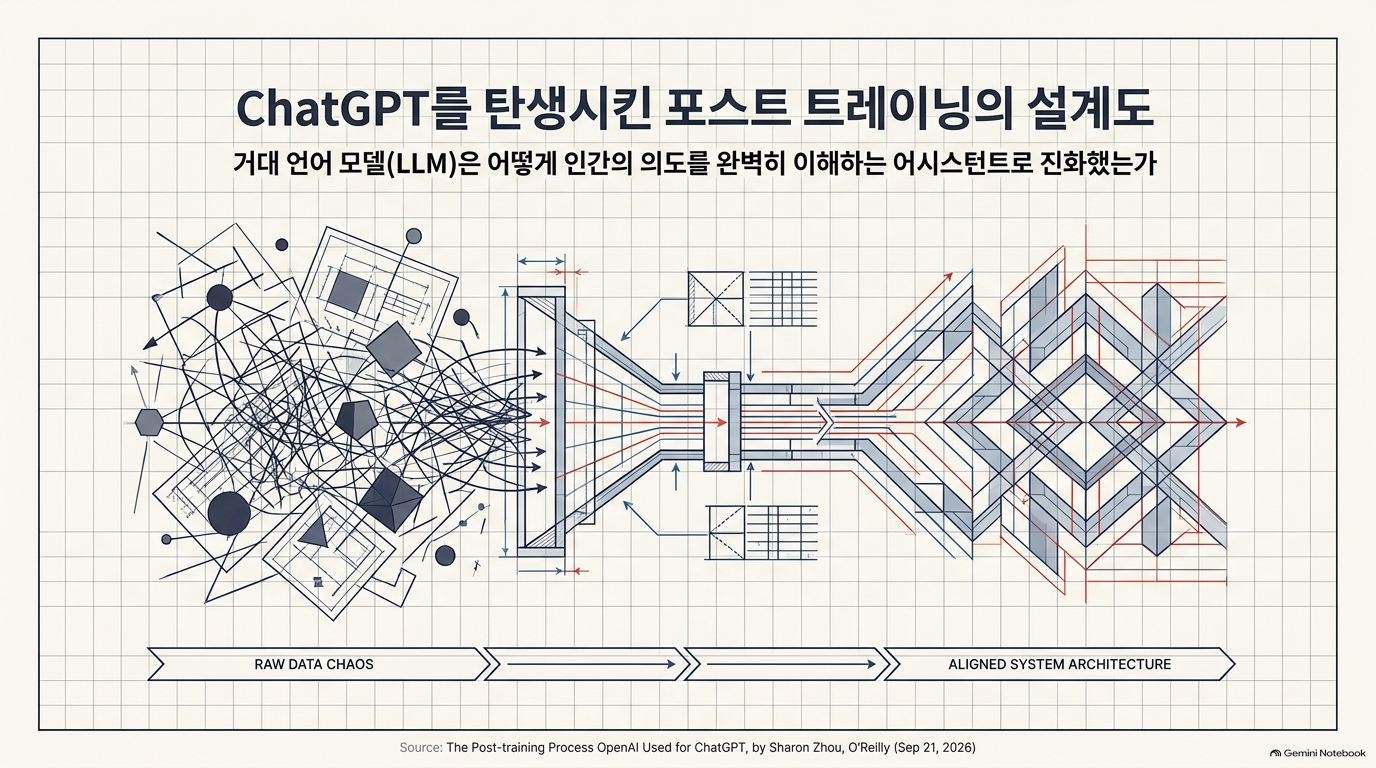
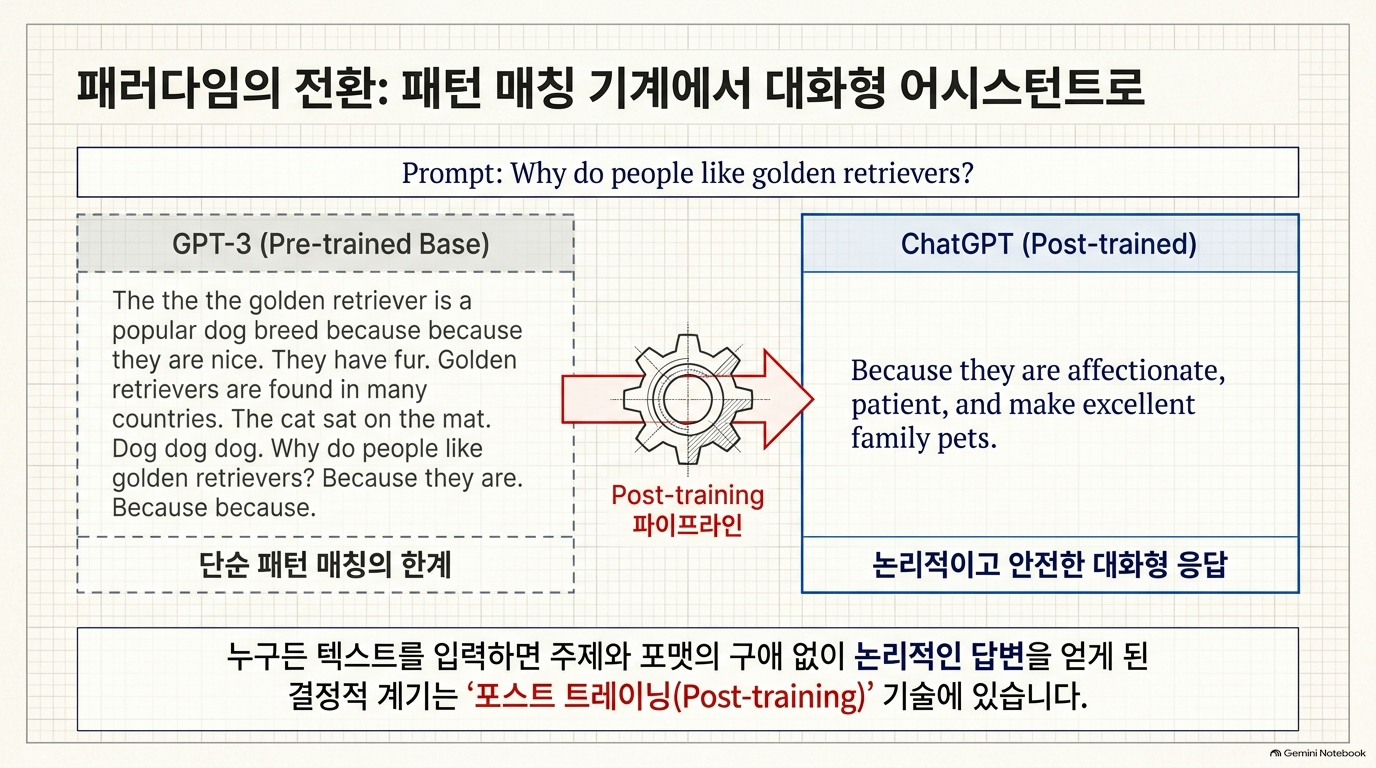
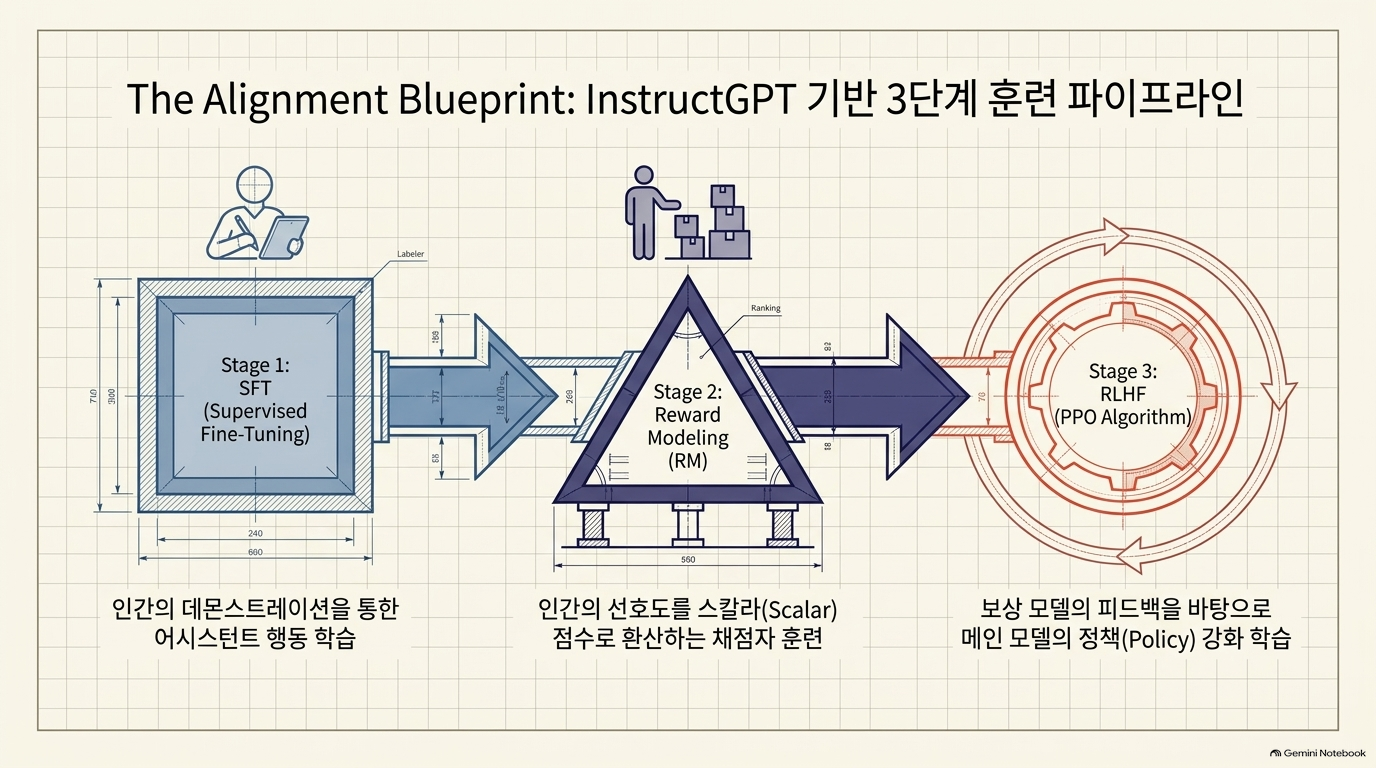
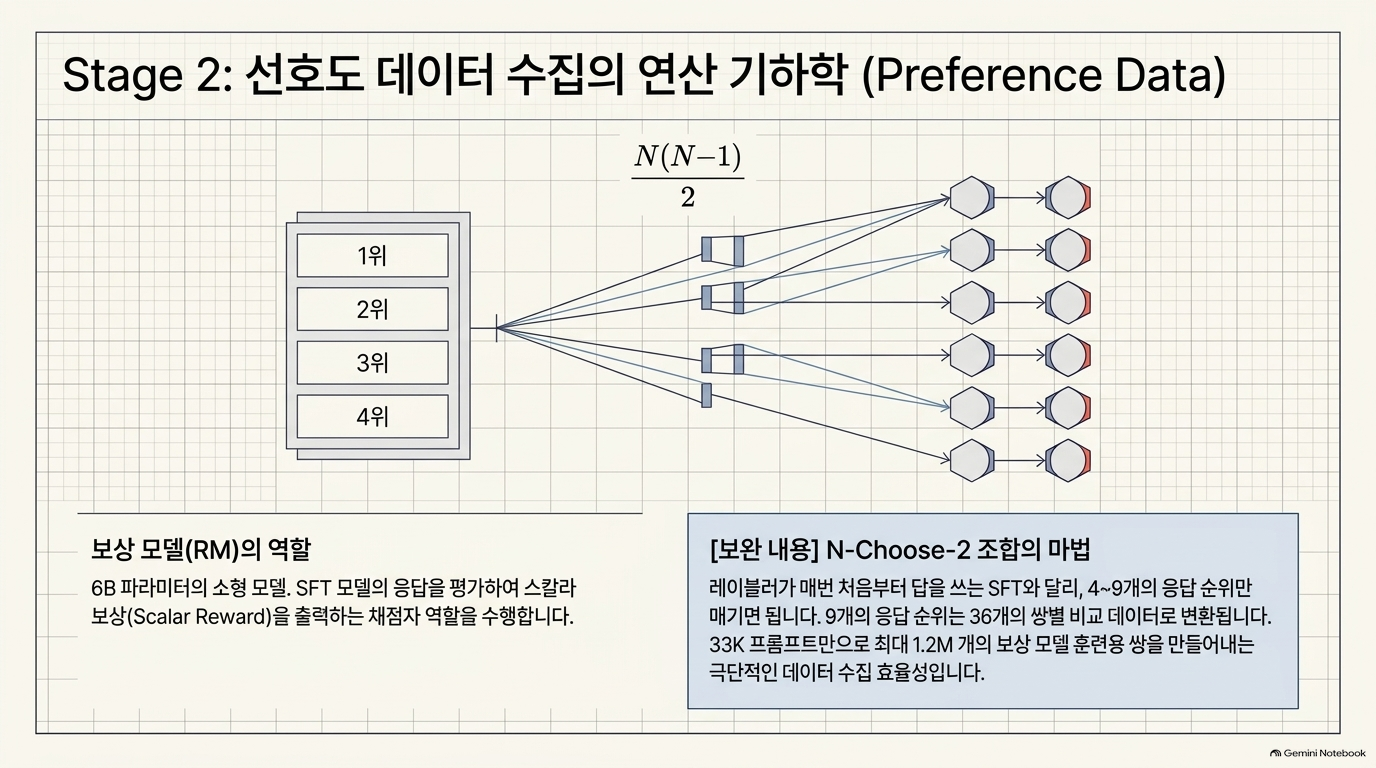
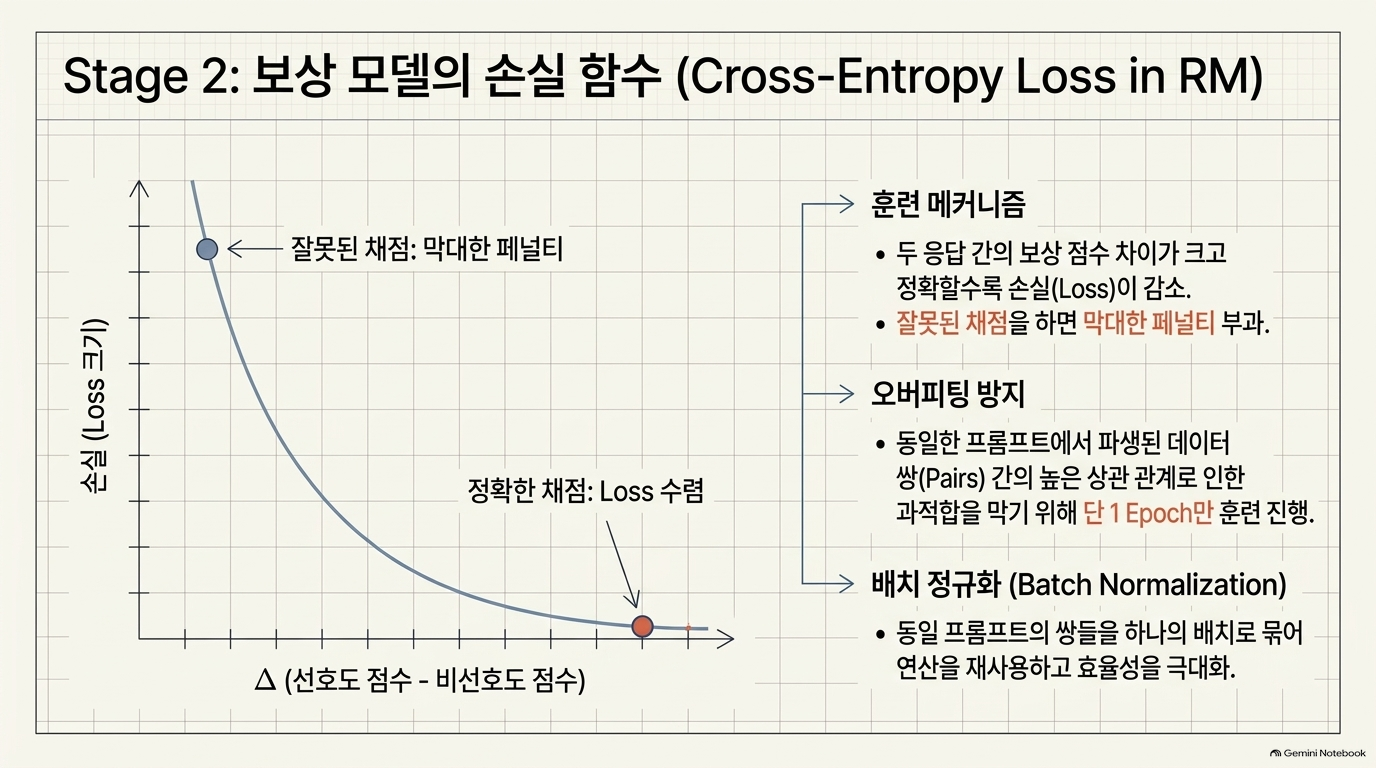
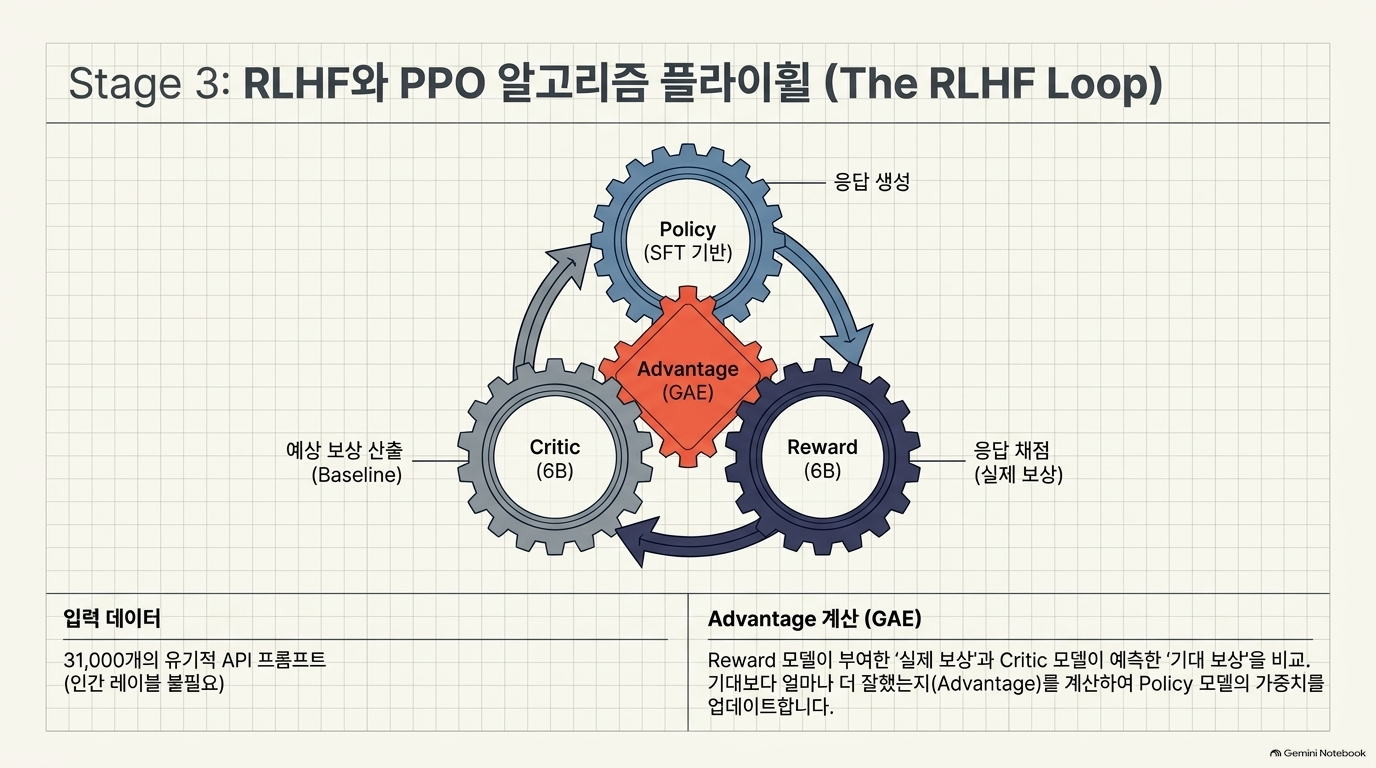
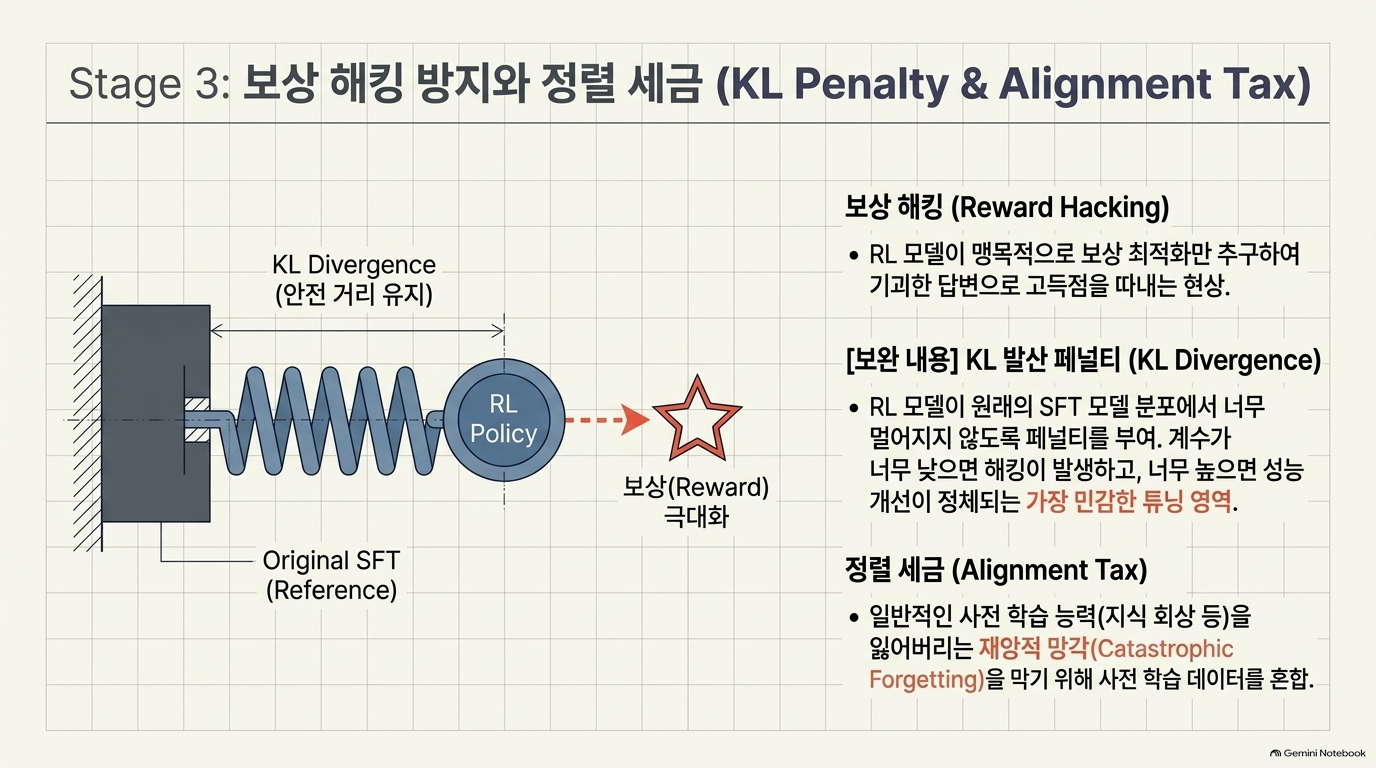
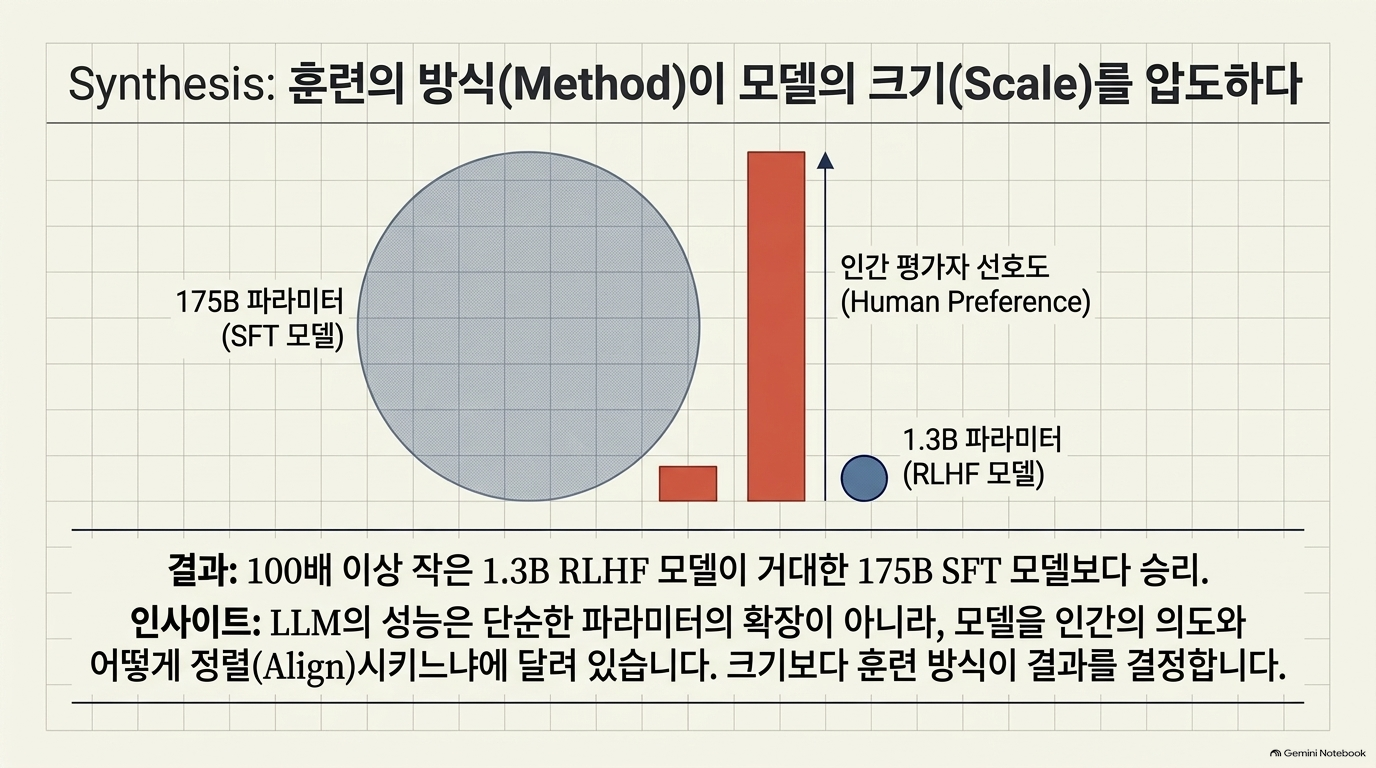
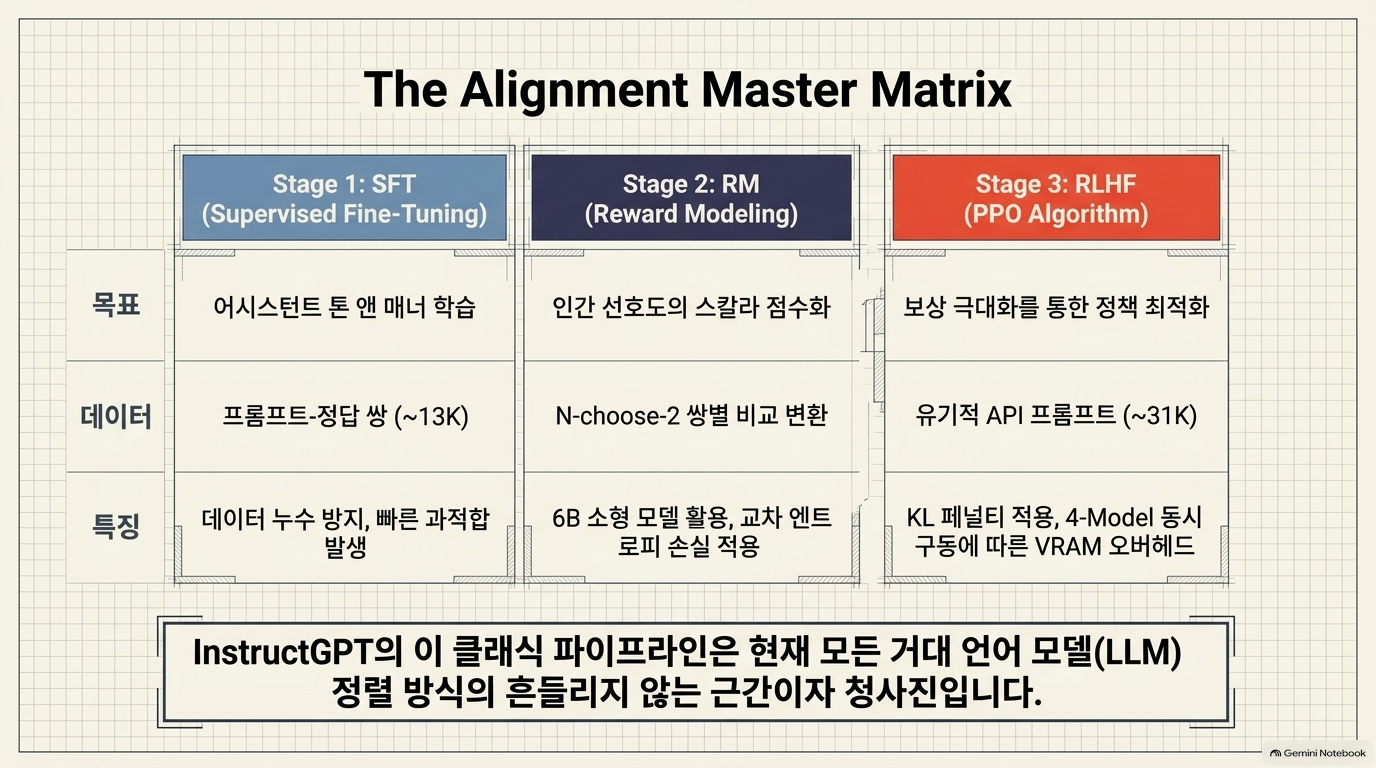
이 글은 단순한 언어 모델인 GPT-3가 어떻게 포스트 트레이닝(post-training) 과정을 거쳐 대화에 능숙한 ChatGPT로 진화했는지 그 기술적 여정을 상세히 설명합니다. 주요 과정은 인간의 시연을 학습하는 지도 미세 조정(SFT), 인간의 선호를 반영하는 리워드 모델링, 그리고 이를 최적화하는 인간 피드백 기반 강화학습(RLHF)이라는 세 가지 핵심 단계로 구성됩니다. 이러한 파이프라인을 통해 인공지능은 단순한 패턴 매칭을 넘어 도구 활용, 복잡한 추론, 안전성 및 정렬(alignment)과 같은 정교한 능력을 갖추게 됩니다. 결과적으로 이 텍스트는 모델의 크기보다 학습 방법론이 사용자 경험과 인공지능의 유용성을 결정짓는 데 얼마나 결정적인 역할을 하는지 강조하고 있습니다.
이 글은 ChatGPT의 질적 도약이 모델 크기 자체보다 사후학습(post-training), 특히 인간 피드백을 활용한 SFT → 보상모델 → RLHF 파이프라인에서 나왔다는 점을 설명합니다.
사전학습 모델은 다음 토큰을 잘 예측하지만, 사용자 의도에 맞춰 안정적으로 대화·추론·도구 사용을 하지는 못합니다.
사후학습은 이를 다음과 같이 전환합니다.
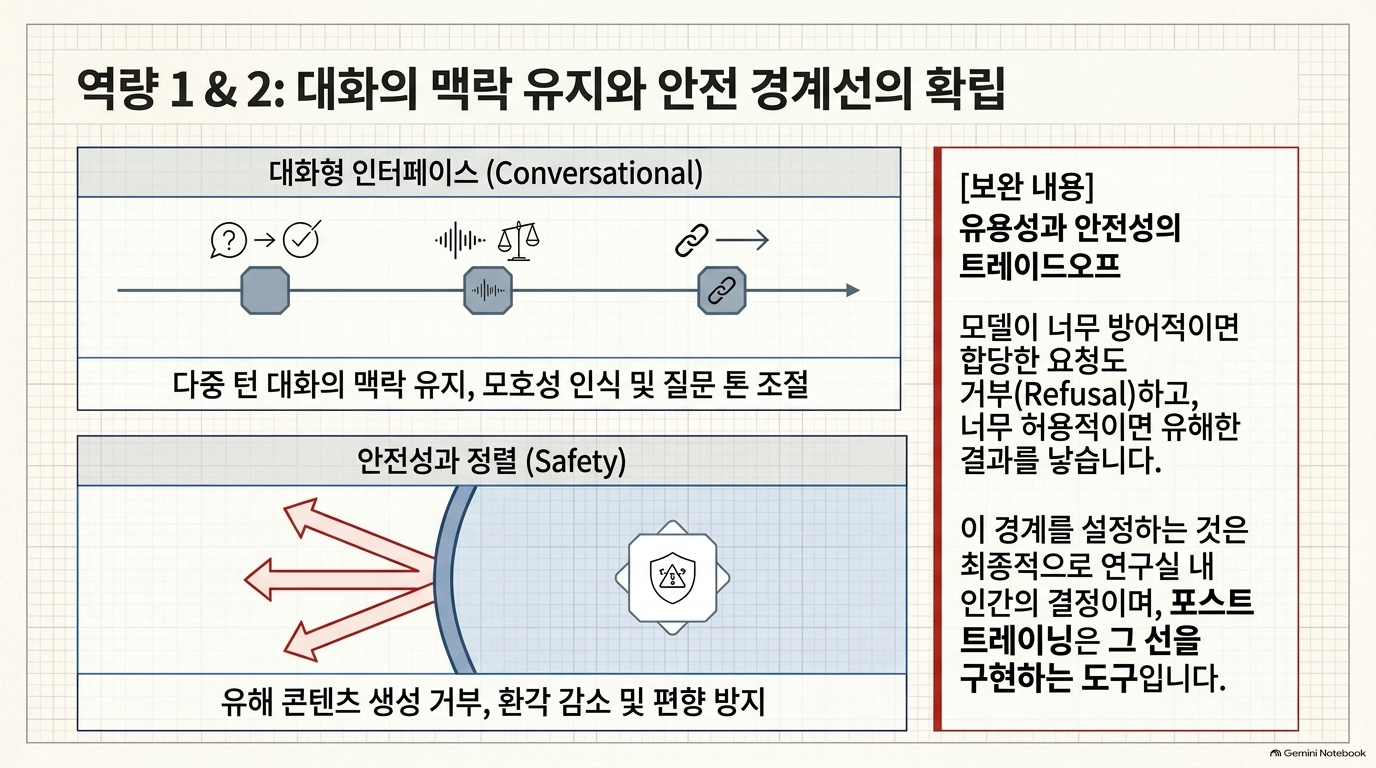
대화성과 유용성: 모호한 요청에는 확인 질문을 하고, 상황에 따라 답변의 톤·깊이를 조절하며, 다중 턴 맥락을 유지.
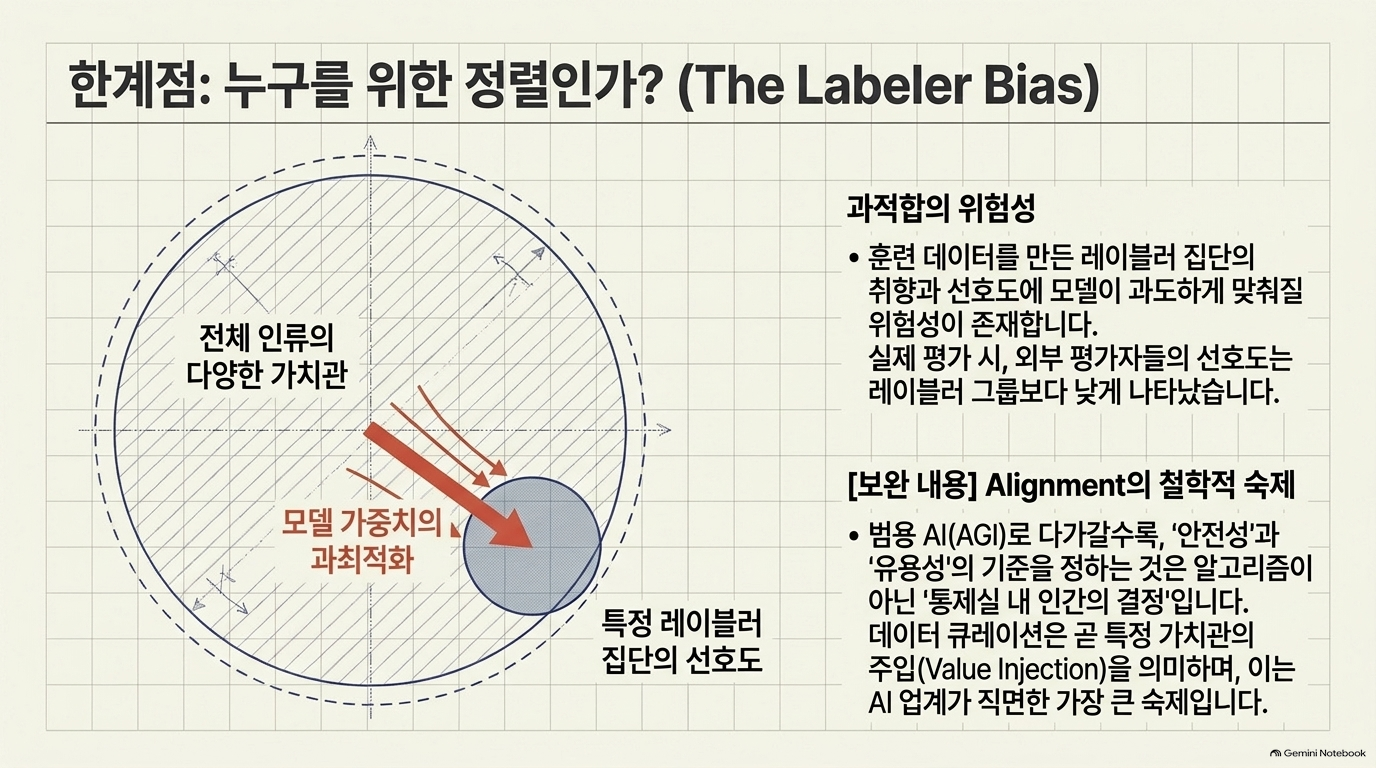
안전성과 정렬(alignment): 유해 요청 거절, 편향 완화, 환각 감소, 개인정보 존중.
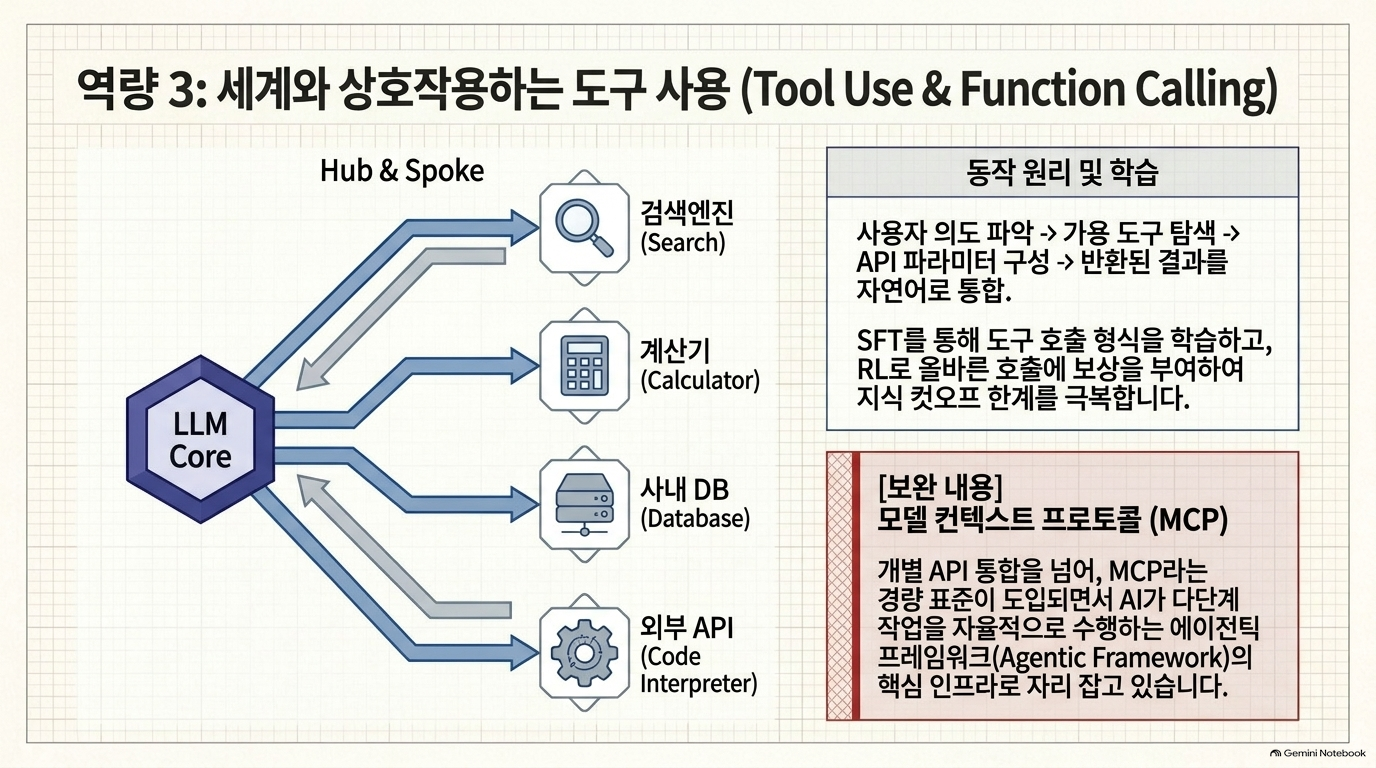
도구 사용(tool use): 검색·API·DB·계산기 등을 “언제, 어떤 파라미터로” 호출하고 결과를 자연어 답변에 반영. 초기에는 주로 SFT로 학습하고, RL로 올바른 호출을 강화.
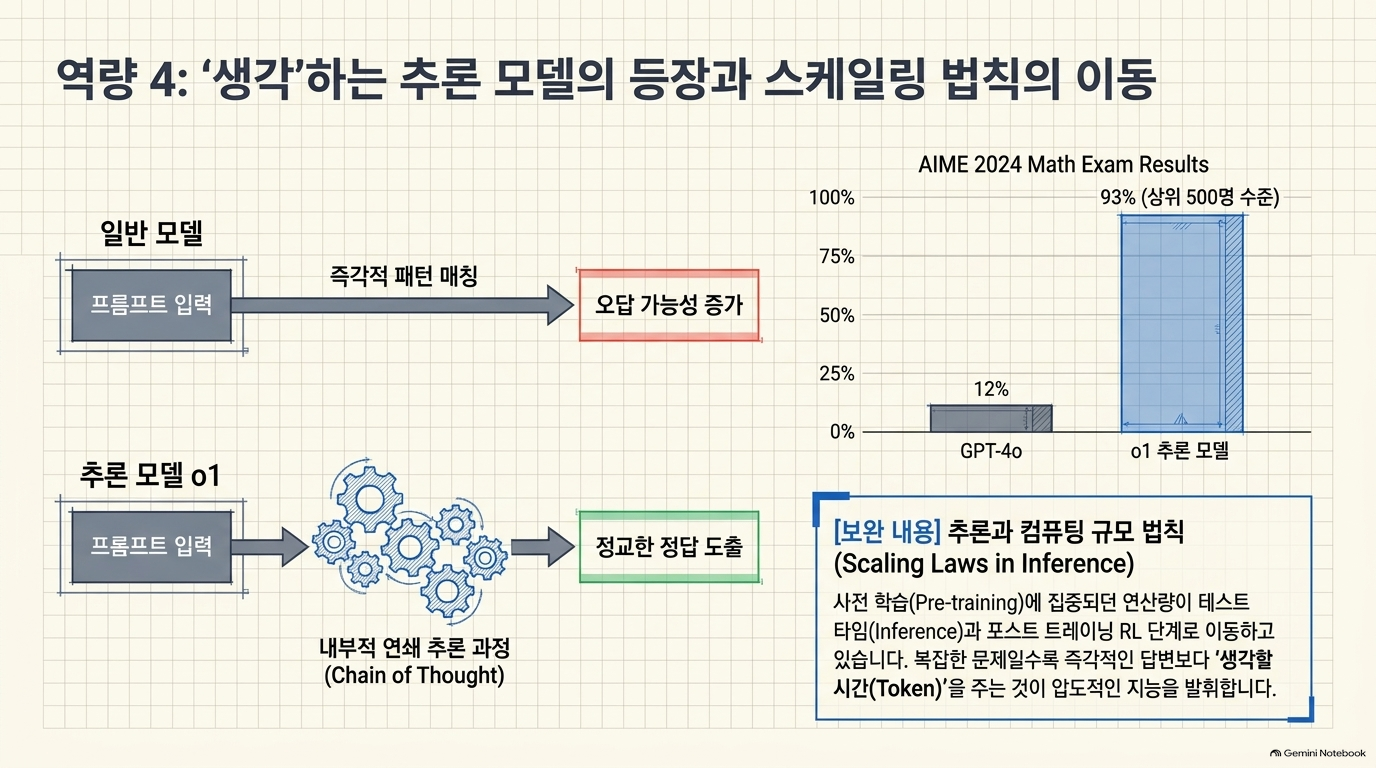
추론(reasoning): 사전학습에서 잠재적으로 존재하던 논리·수학·코드 능력을, 답변 전 더 많은 추론 토큰과 계산을 사용하도록 사후학습으로 유도.


728x90
반응형
'07.AI > 12. AI 모델' 카테고리의 다른 글
| LLM - Anthropic, Claude Opus 5.5 (0) | 2026.09.23 |
|---|---|
| LLM - 오픈 웨이트(Open Weight) - 오픈 모델의 현재 힘의 균형 (0) | 2026.09.22 |
| LLM - 딥시크 (DeepSeek) - DeepSeek-V4.1-Flash (0) | 2026.09.13 |
| LLM - 모티프 테크놀로지스, Motif 3 (0) | 2026.09.09 |
| LLM - Open AI, System Card: GPT-6 Astra (0) | 2026.09.05 |