반응형
https://arxiv.org/pdf/2608.09119
2026.8.10
[Motif 3: Technical Report]
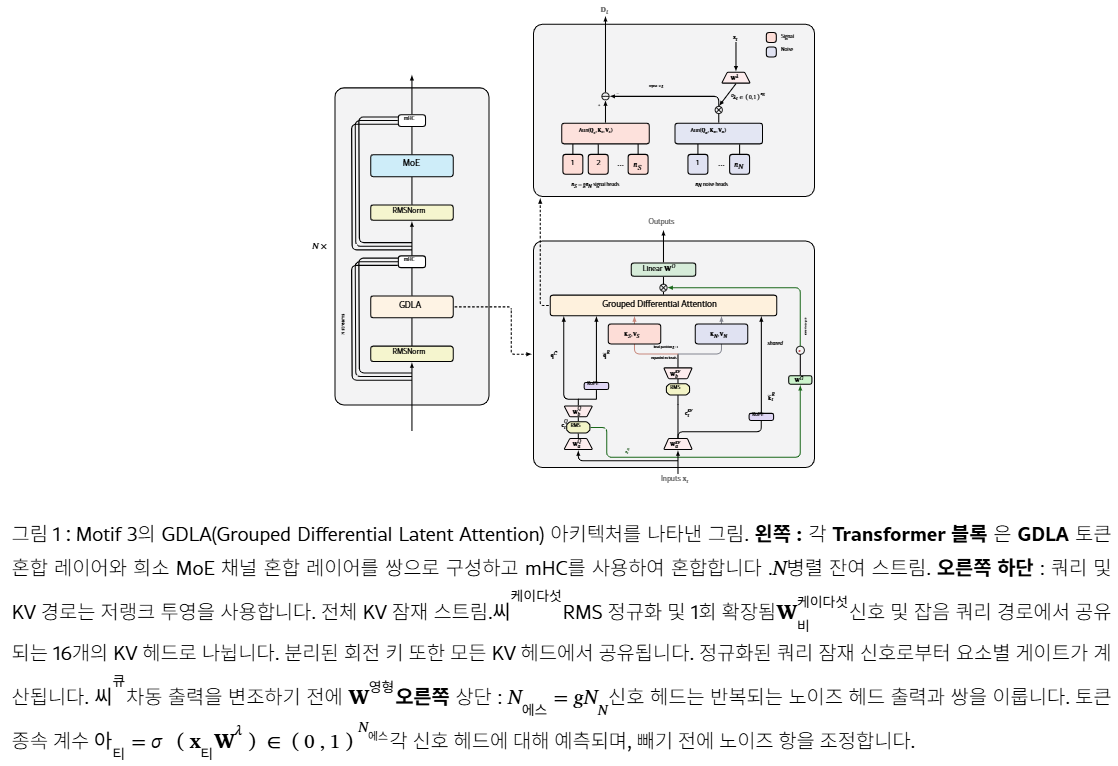
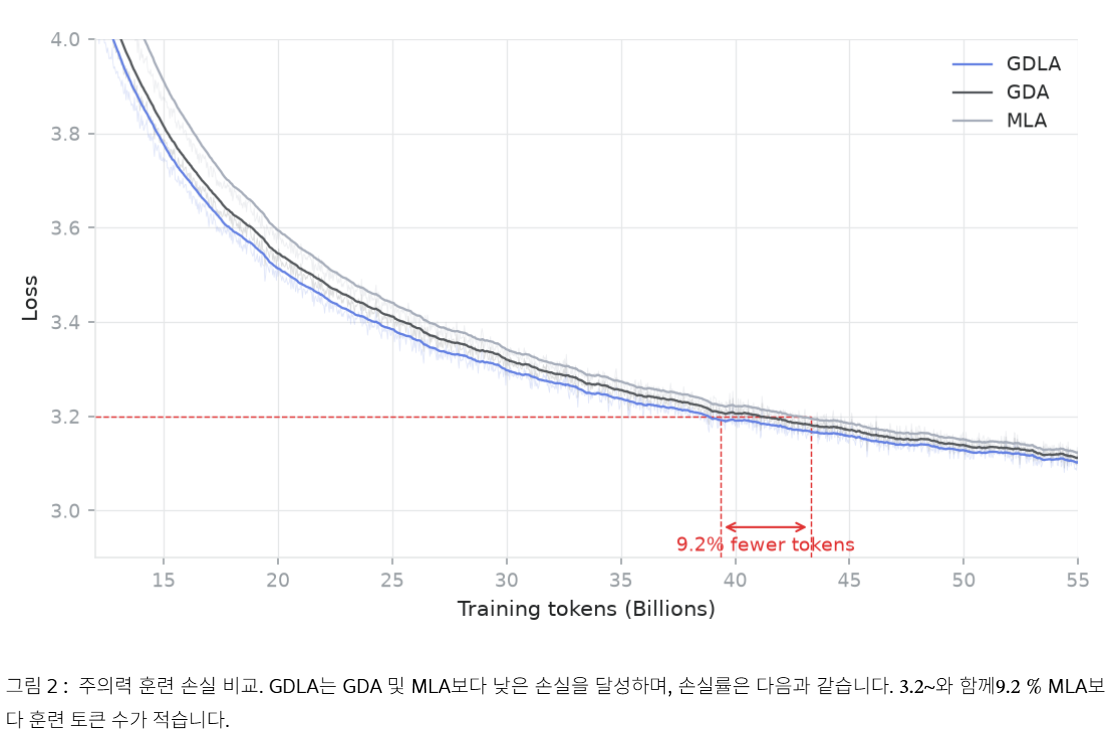
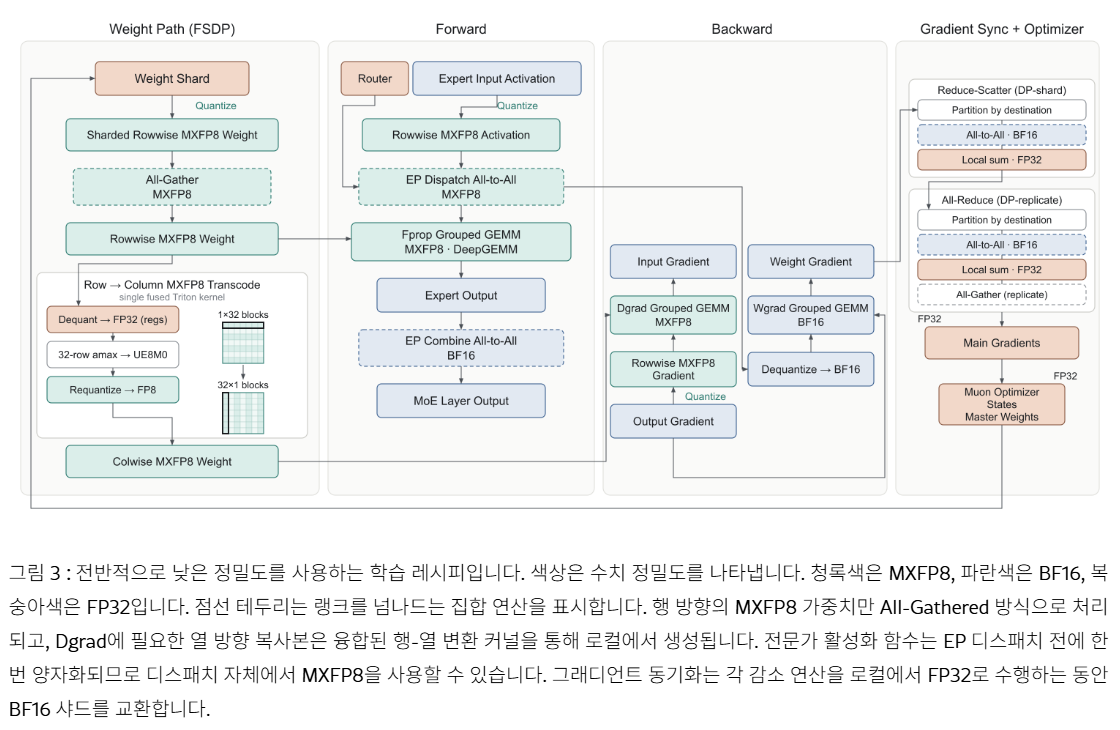
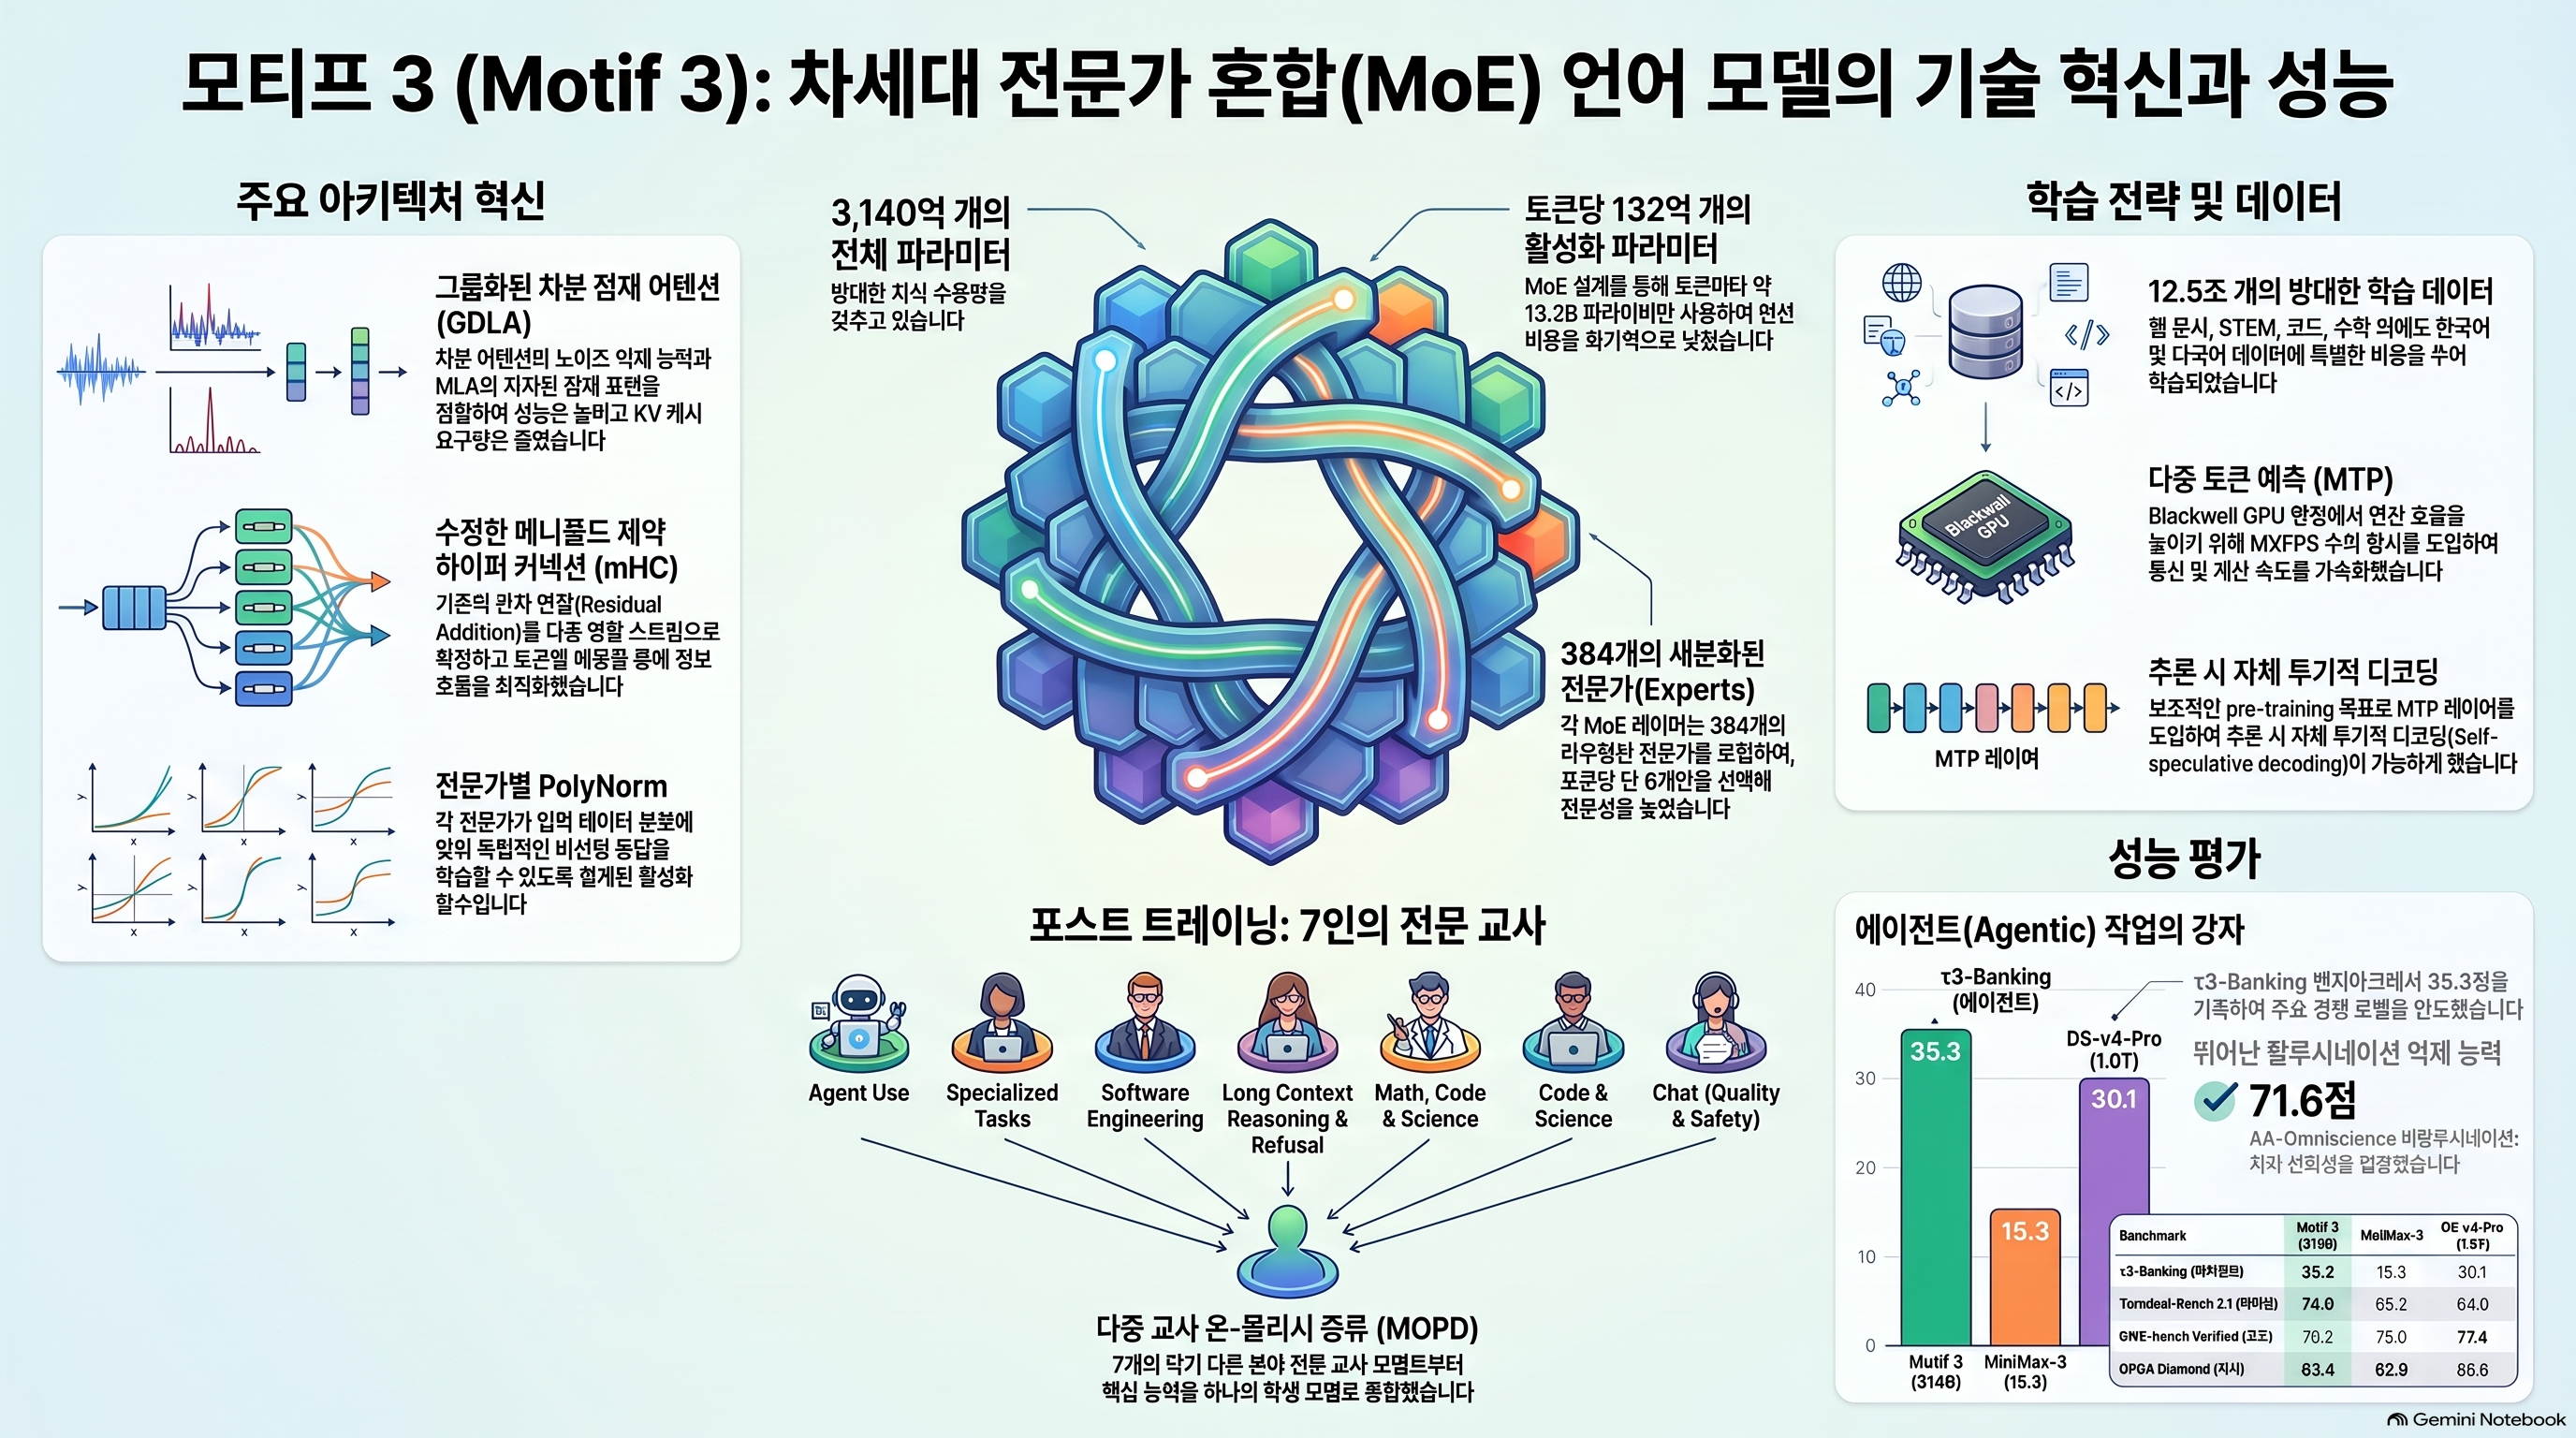
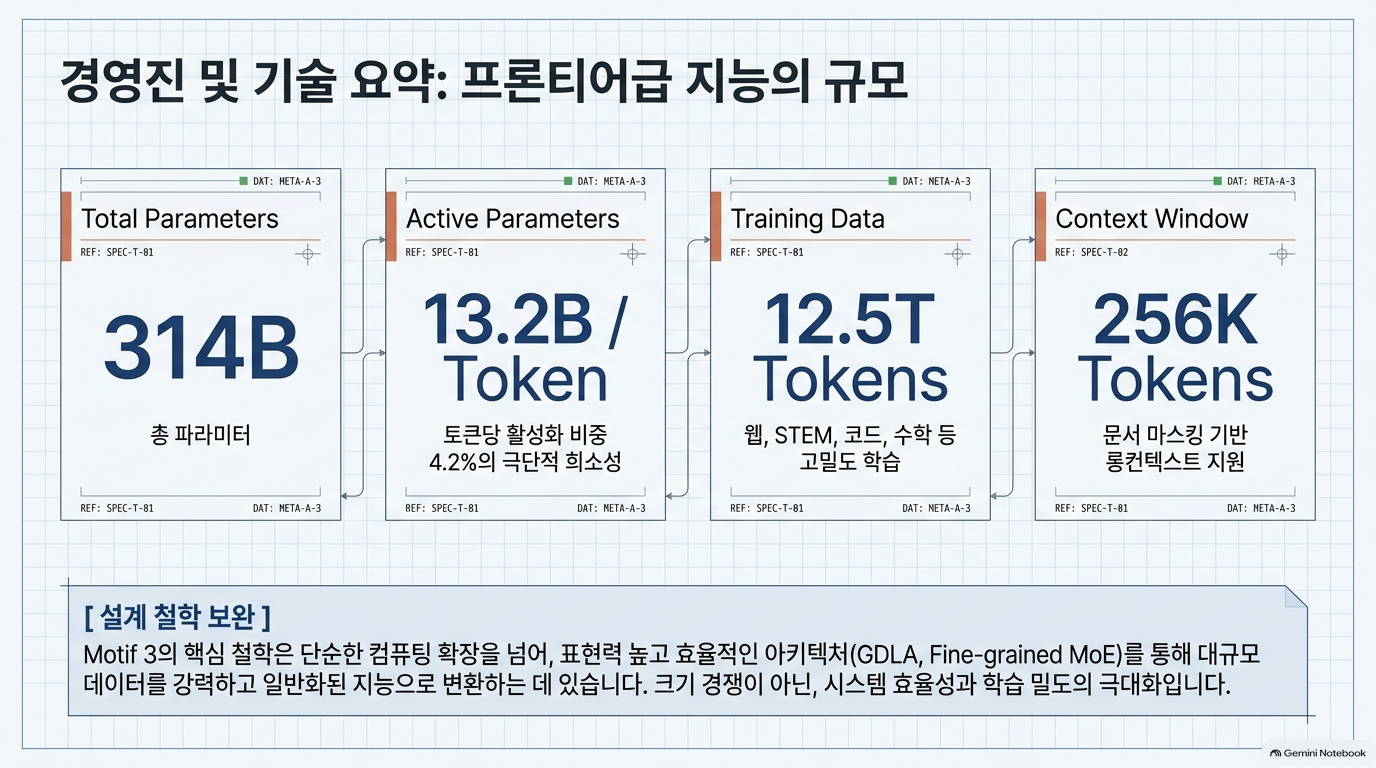
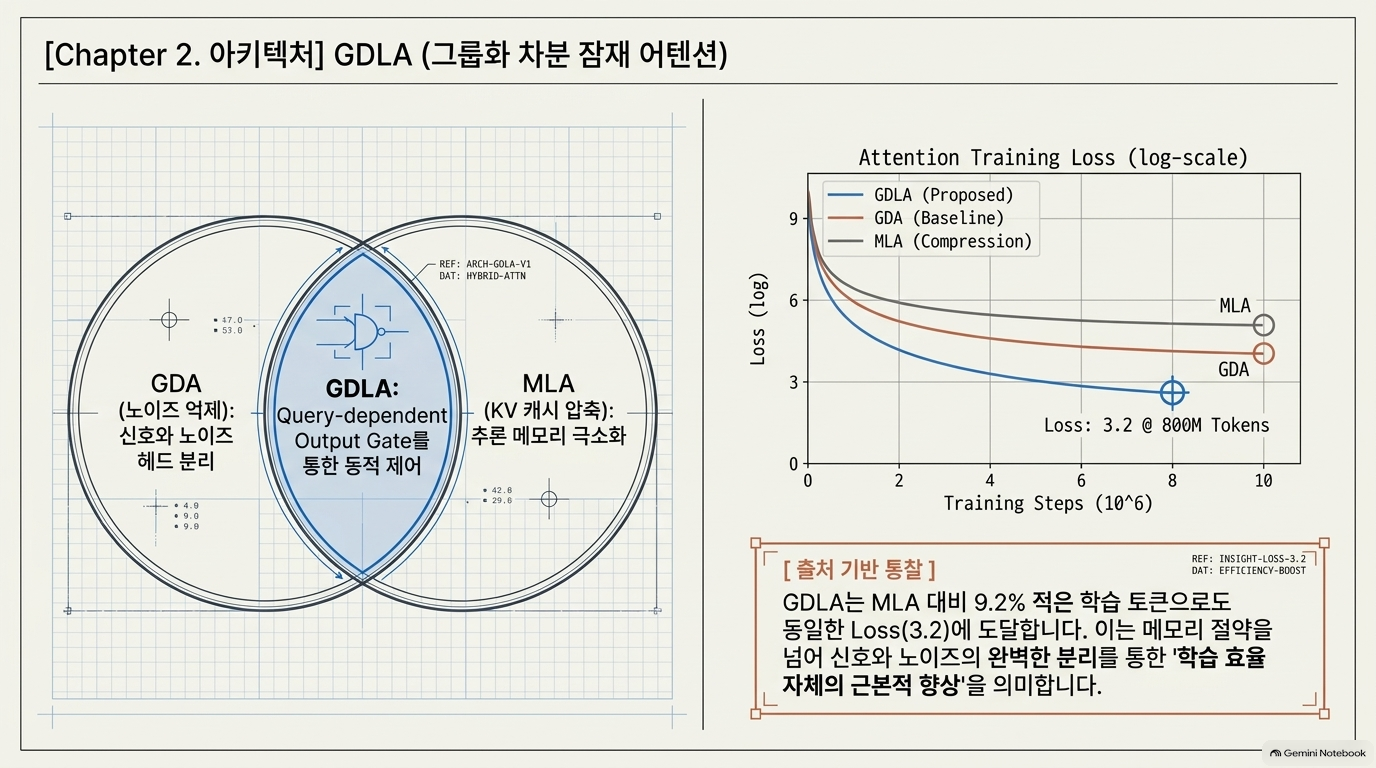
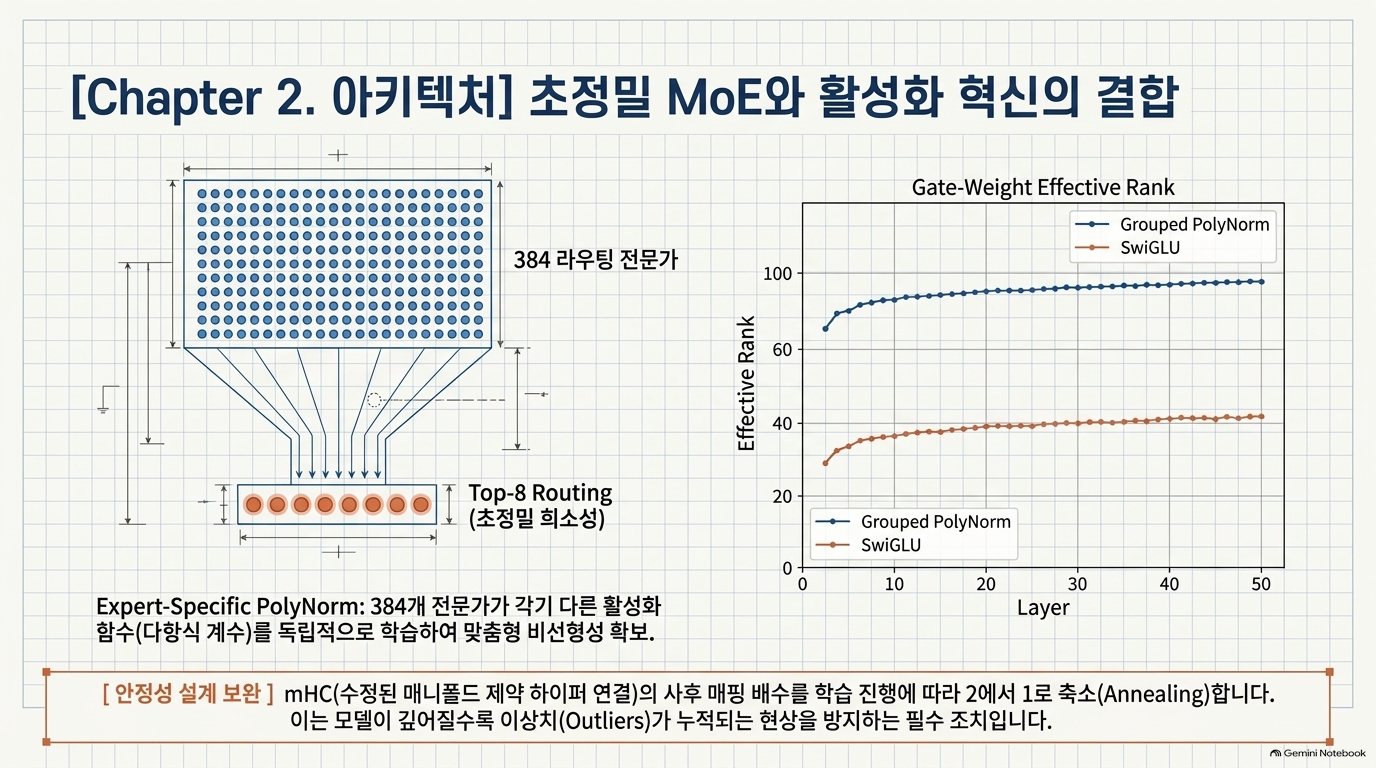
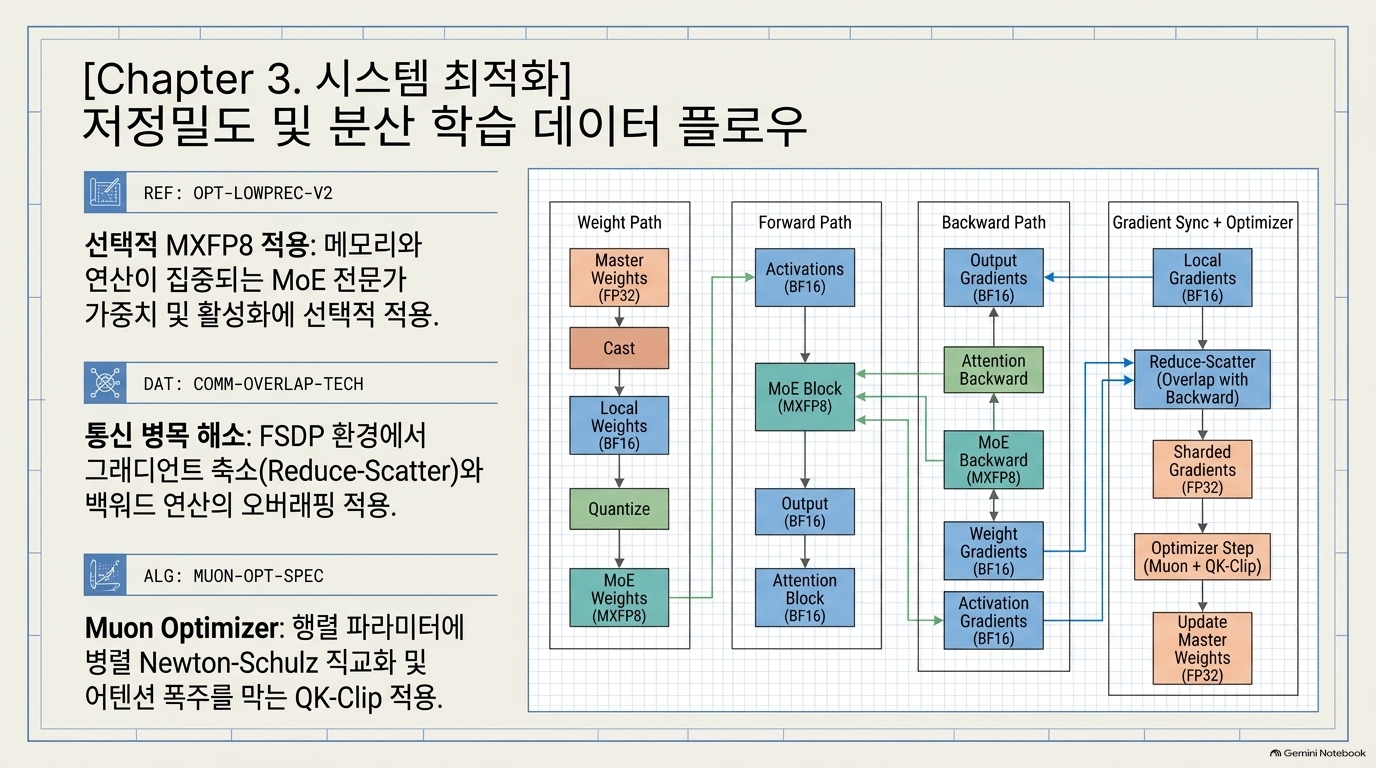
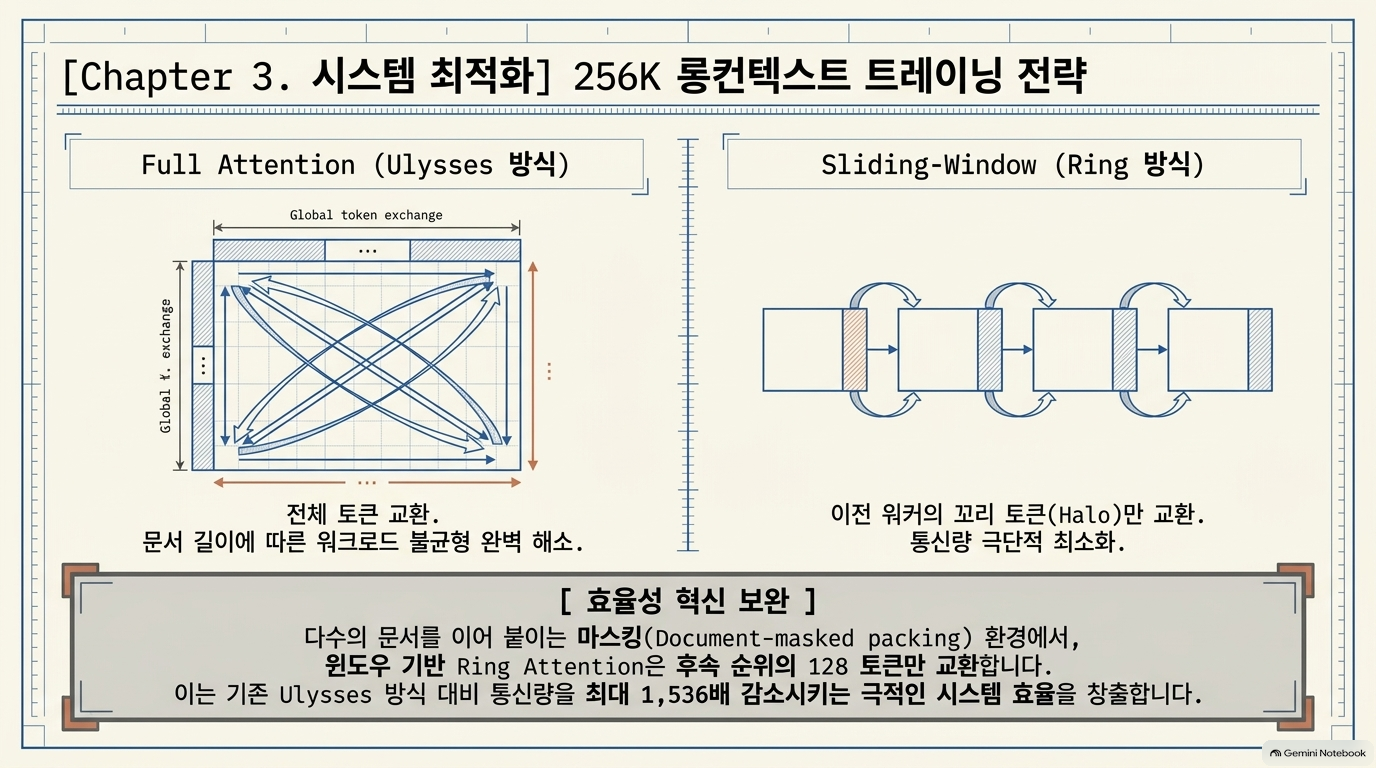
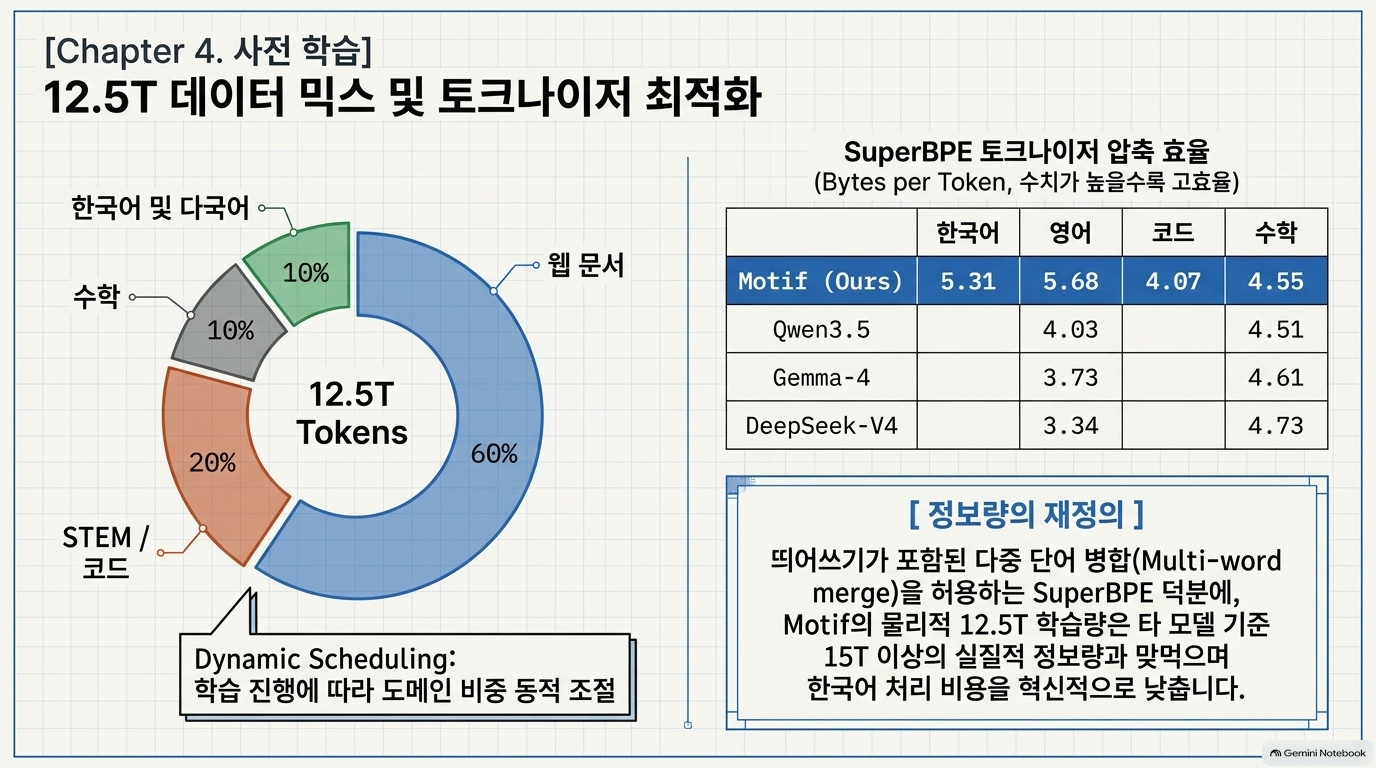
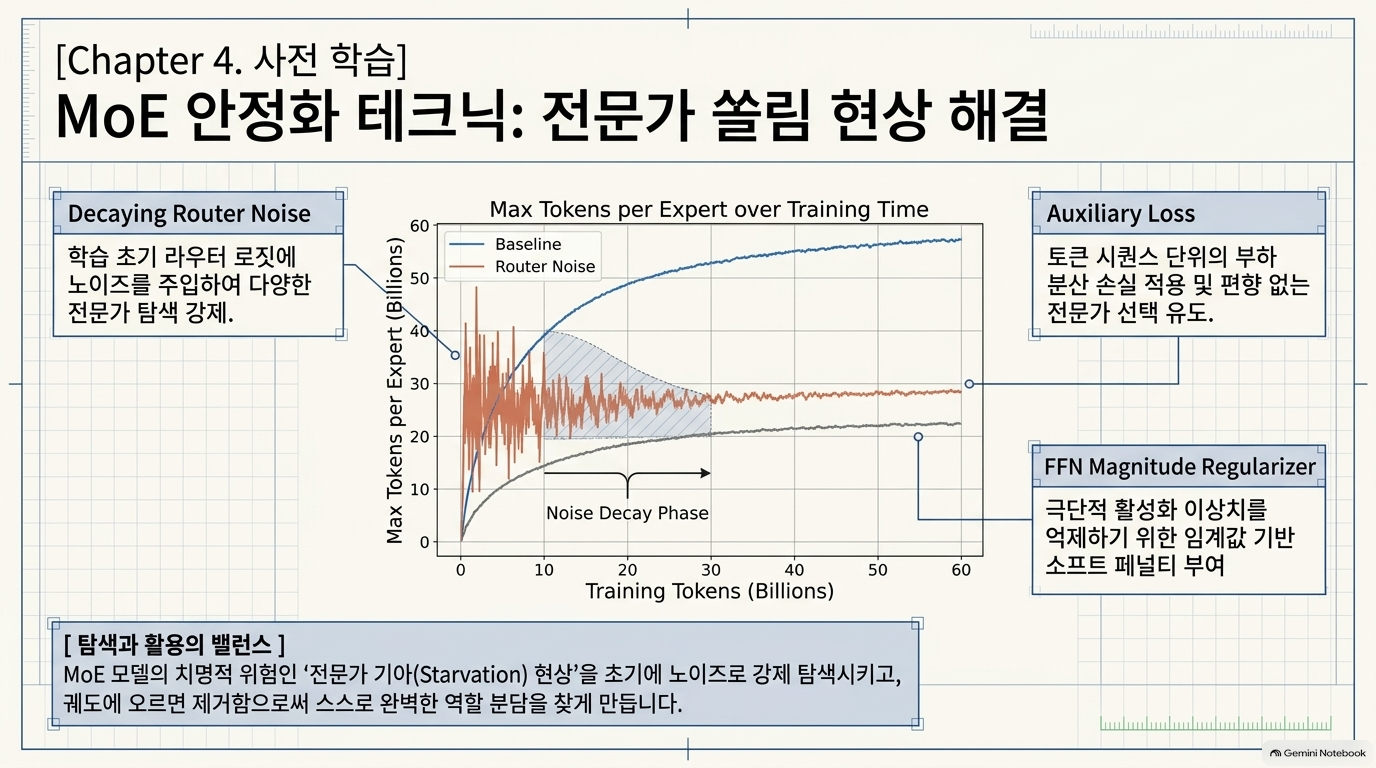
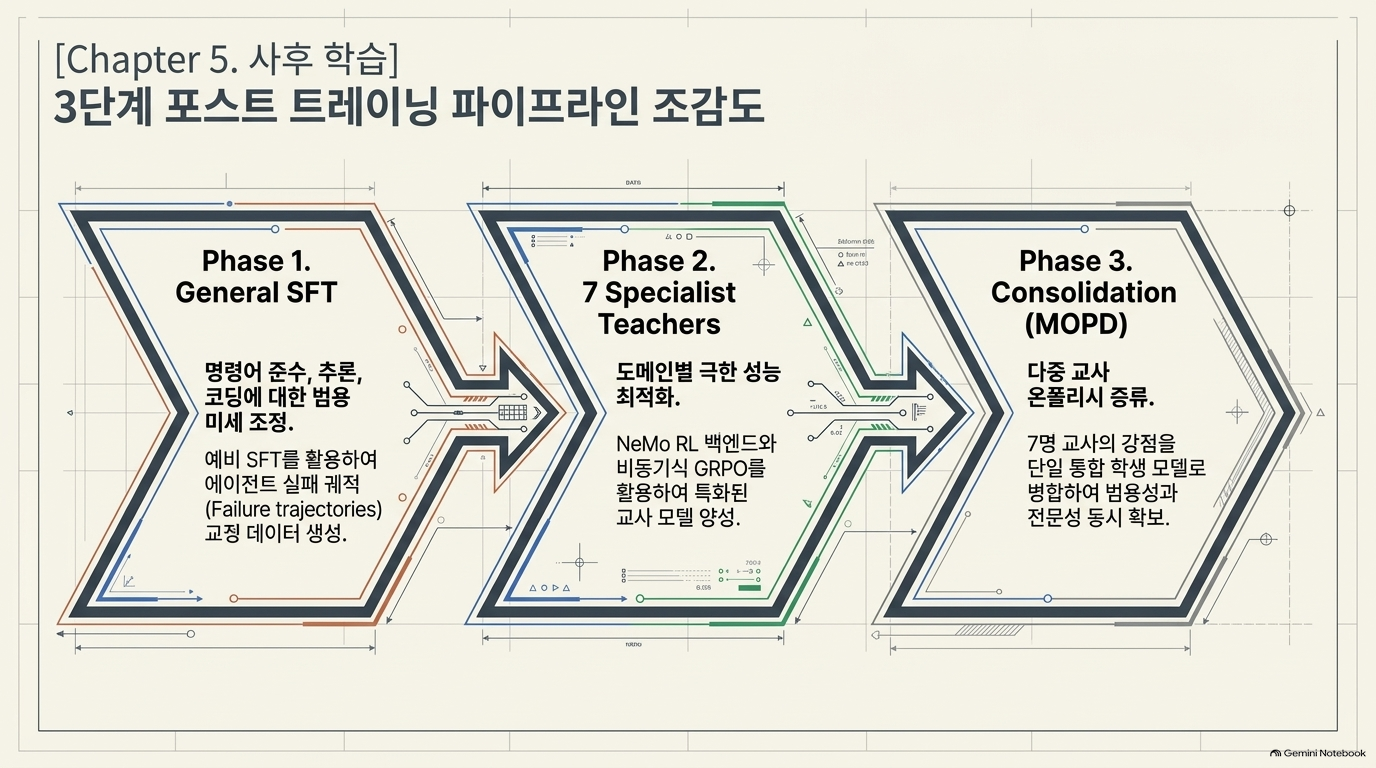
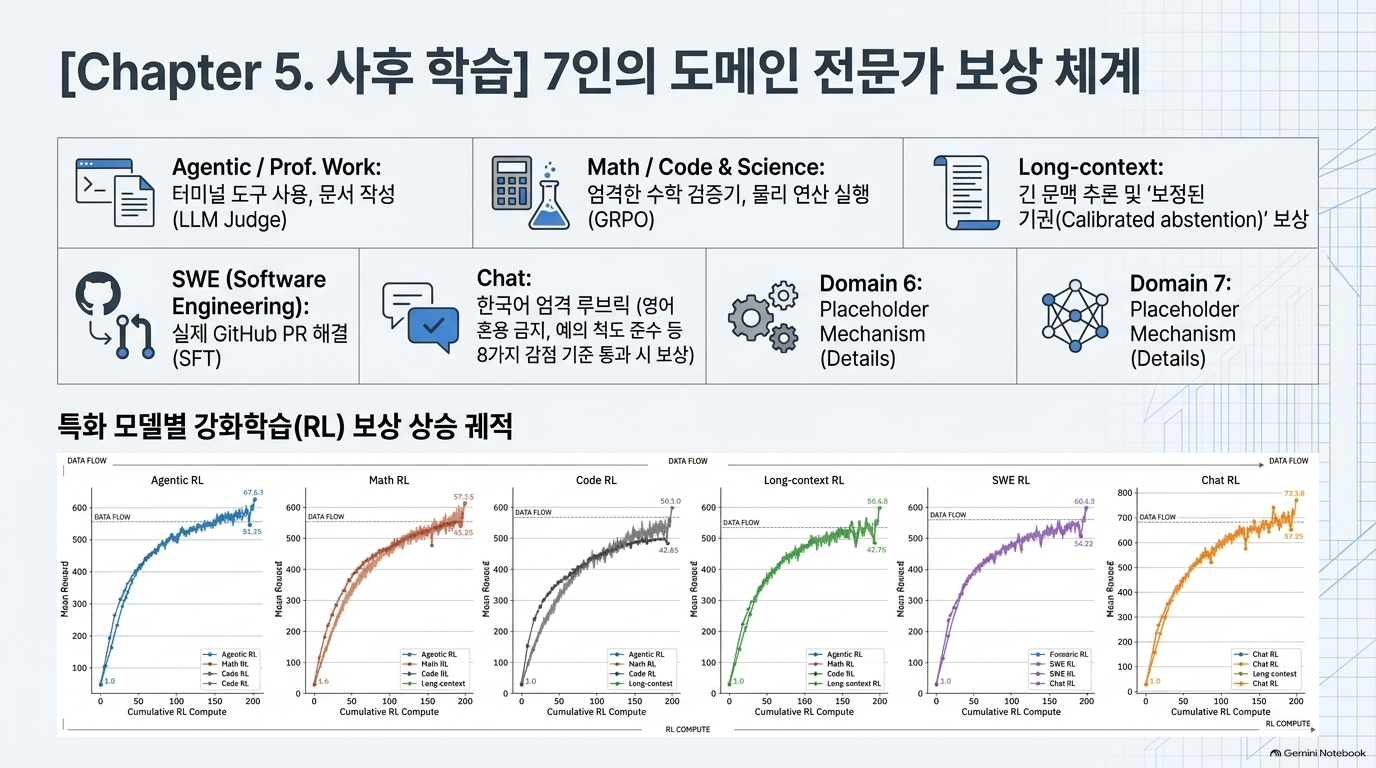
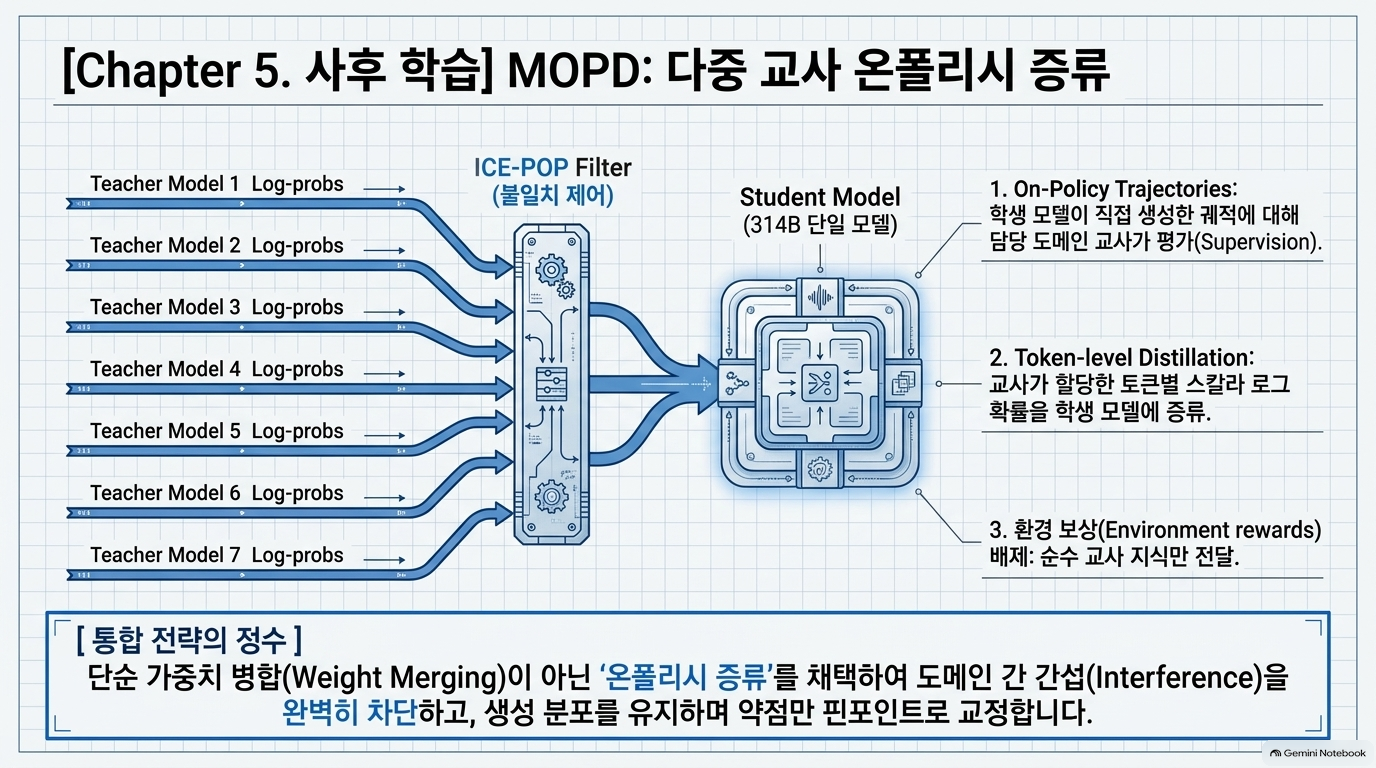
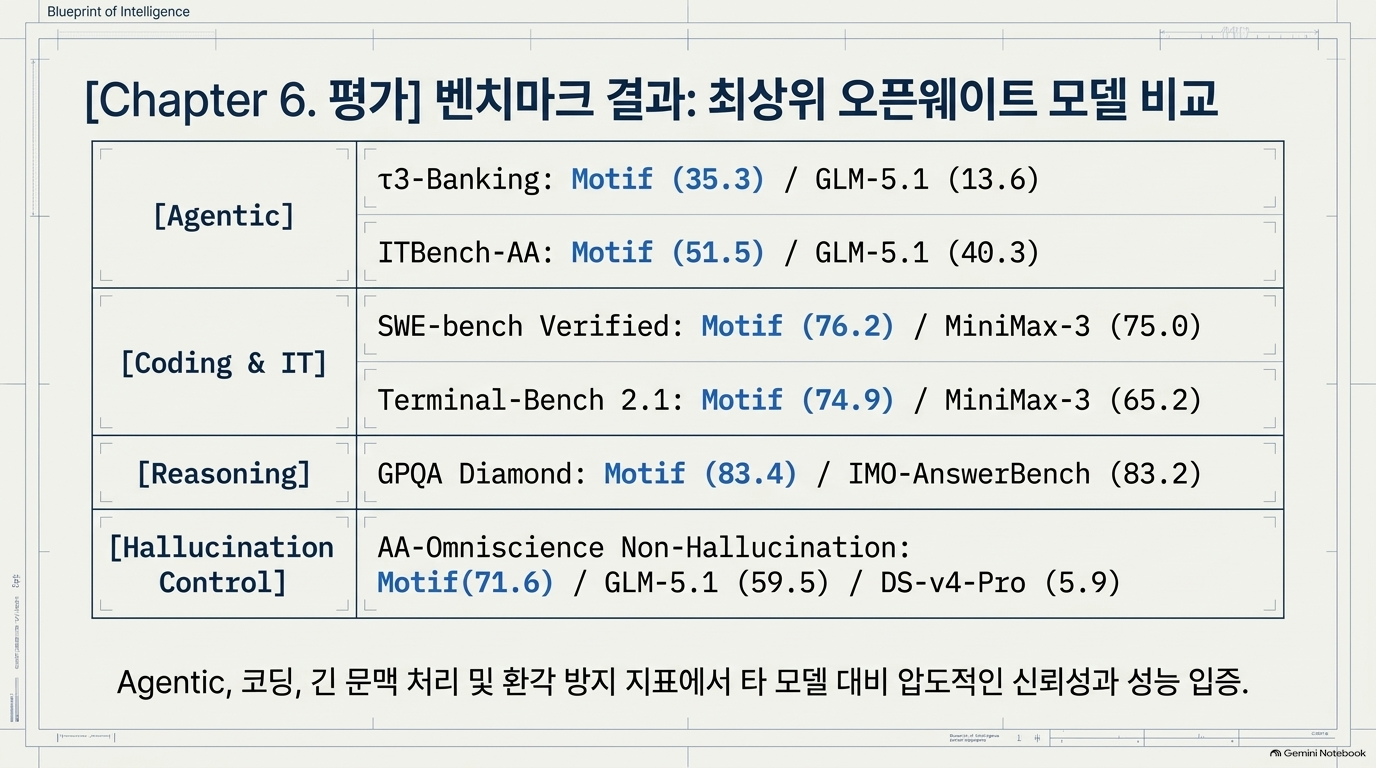
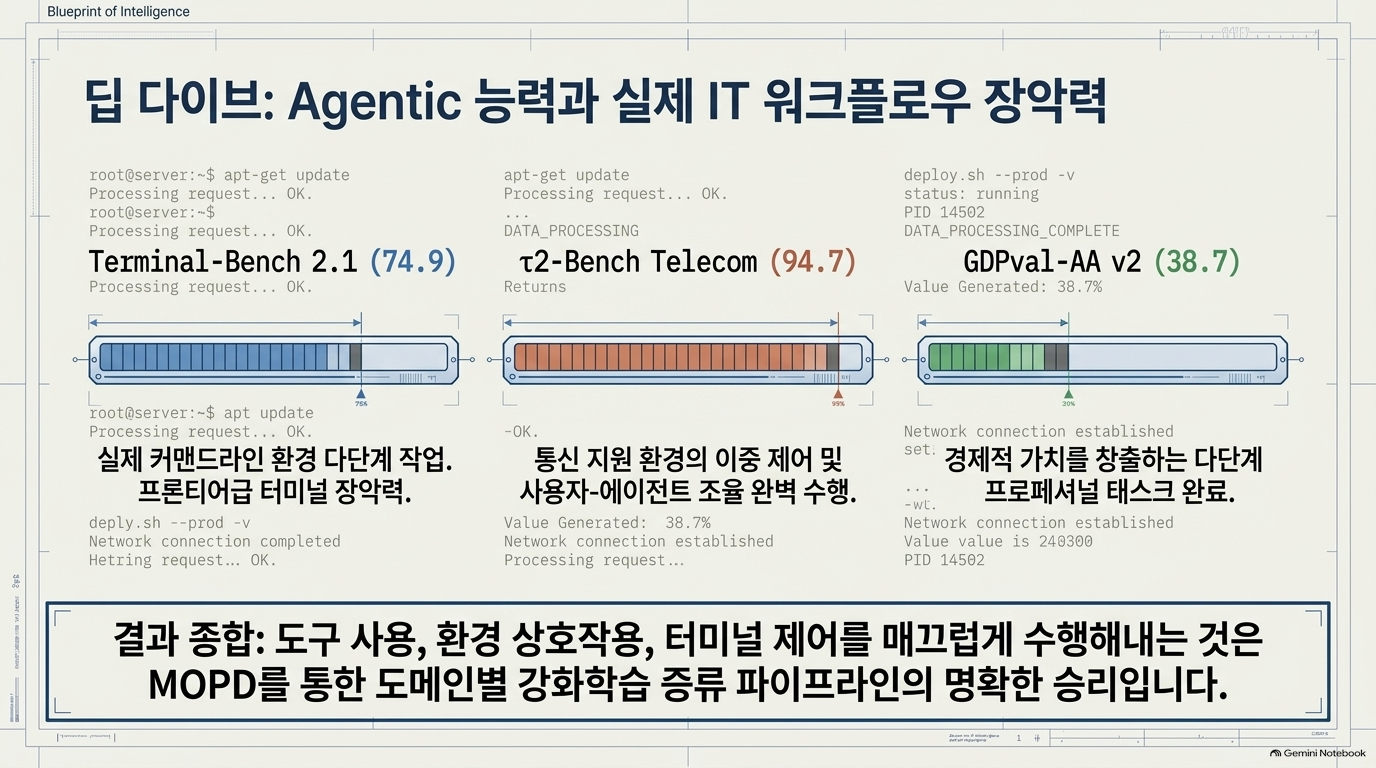
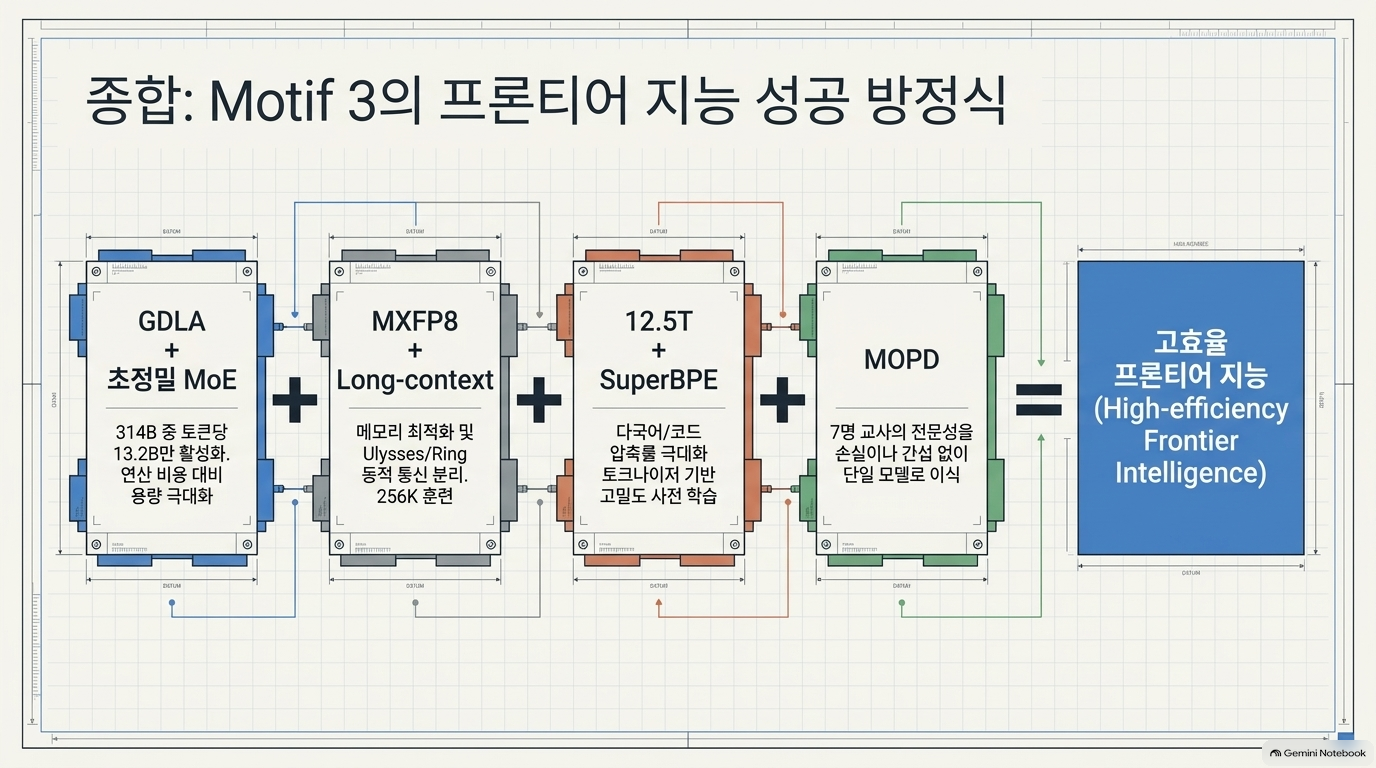
Motif 3: 기술 보고서는 3,140억 개의 파라미터를 보유한 거대 언어 모델의 설계와 훈련 과정을 상세히 기록한 문서입니다. 이 모델은 세밀한 희소 전문가 구조(fine-grained MoE)를 채택하여 토큰당 연산량을 효율적으로 제한하면서도 방대한 지식 용량을 확보한 것이 특징입니다. 핵심 기술인 그룹화된 차분 잠재 어텐션(GDLA)은 데이터의 노이즈를 억제하고 메모리 사용량을 획기적으로 줄여, 최대 256K에 이르는 초장문 문맥을 안정적으로 처리할 수 있게 합니다. 또한, 단순한 지식 습득을 넘어 강화 학습 기반의 일곱 가지 전문 교사 모델로부터 지식을 전수받는 다중 교사 온포리시 증류(MOPD) 기법을 통해 코딩, 수학, 추론 및 도구 활용 능력을 비약적으로 고도화했습니다. 결과적으로 이 보고서는 혁신적인 아키텍처와 정교한 포스트 트레이닝 파이프라인이 결합되어 어떻게 최첨단 성능의 개방형 모델이 탄생했는지를 체계적으로 보여줍니다.

728x90
반응형
'07.AI > 12. AI 모델' 카테고리의 다른 글
| 사후 학습 (Post-training) - O'Reilly Radar, GPT-3보다 ChatGPT가 크게 개선될 수 있었던 파이프라인 (0) | 2026.09.22 |
|---|---|
| LLM - 딥시크 (DeepSeek) - DeepSeek-V4.1-Flash (0) | 2026.09.13 |
| LLM - Open AI, System Card: GPT-6 Astra (0) | 2026.09.05 |
| LLM - Open AI, GPT 6 Astra 사이버 보안 역량 (0) | 2026.09.05 |
| LLM - Google DeepMind, Gemini 3.7 Flash (0) | 2026.09.05 |