https://arxiv.org/pdf/2610.05750
Code: https://github.com/NVIDIA/NeMo-Retriever/tree/main/retrieval-bench
2026.10.5
[Beyond Semantic Similarity: Performance and Costs of Agentic Retrieval for Complex Tasks]
본 문헌은 전통적인 표면적 의미 유사성에만 의존하는 방식의 한계를 극복하기 위해 대형 언어 모델과 검색기를 결합한 에이전트 기반 검색의 성능과 비용을 종합적으로 분석합니다. 연구진은 제한된 맥락 내에서 추론 능력과 동적 탐색 패턴을 활용하는 ReAct 에이전트 구조가 복잡하고 추론 중심적인 탐색 과제에서 기존 방식보다 훨씬 뛰어난 일반화 성능을 발휘함을 입증합니다. 그럼에도 불구하고 이 혁신적인 접근법은 훨씬 더 많은 연산 지연 시간과 방대한 토큰 소비 비용을 수반하므로, 대규모 실무 환경에 적용하기 위해서는 향후 효율성 개선이 필수적이라는 점을 강조합니다.
논문: Beyond Semantic Similarity: Performance and Costs of Agentic Retrieval for Complex Tasks
저자: Reza Esfandiarpoor 외 10명 — NVIDIA 및 University of Edinburgh
분석 기준: arXiv 2610.05750v1, 2026년 10월 5일 제출본. 본문 1~5장과 실험표 1~3을 기준으로 분석했습니다.[1][2]
핵심 결론: 복잡한 검색에서는 임베딩 모델만 바꾸기보다, LLM이 검색 결과를 읽고 질의를 수정하며 반복 탐색하도록 만드는 것이 효과적입니다. 그러나 논문의 실험에서는 검색 품질 향상과 함께 상당한 지연·토큰 비용이 발생했습니다. 따라서 “모든 검색을 에이전트로 대체하자”보다는 “복잡한 검색에 선택적으로 적용하자”는 실무적 해석이 적절합니다.
아래에서 논문이 보고한 사실과 분석자의 해석·권고를 구분합니다.
1장. Introduction — 의미 유사도만으로 해결하기 어려운 검색
1.1 문제의식
저자들은 검색 과제가 다음과 같이 변화하고 있다고 봅니다.[2]
- 과거: 명확하고 구체적인 검색어에 대응하는 문서 찾기
- 현재: 추상적인 업무 목표나 복잡한 문제를 해결하는 데 필요한 근거 찾기
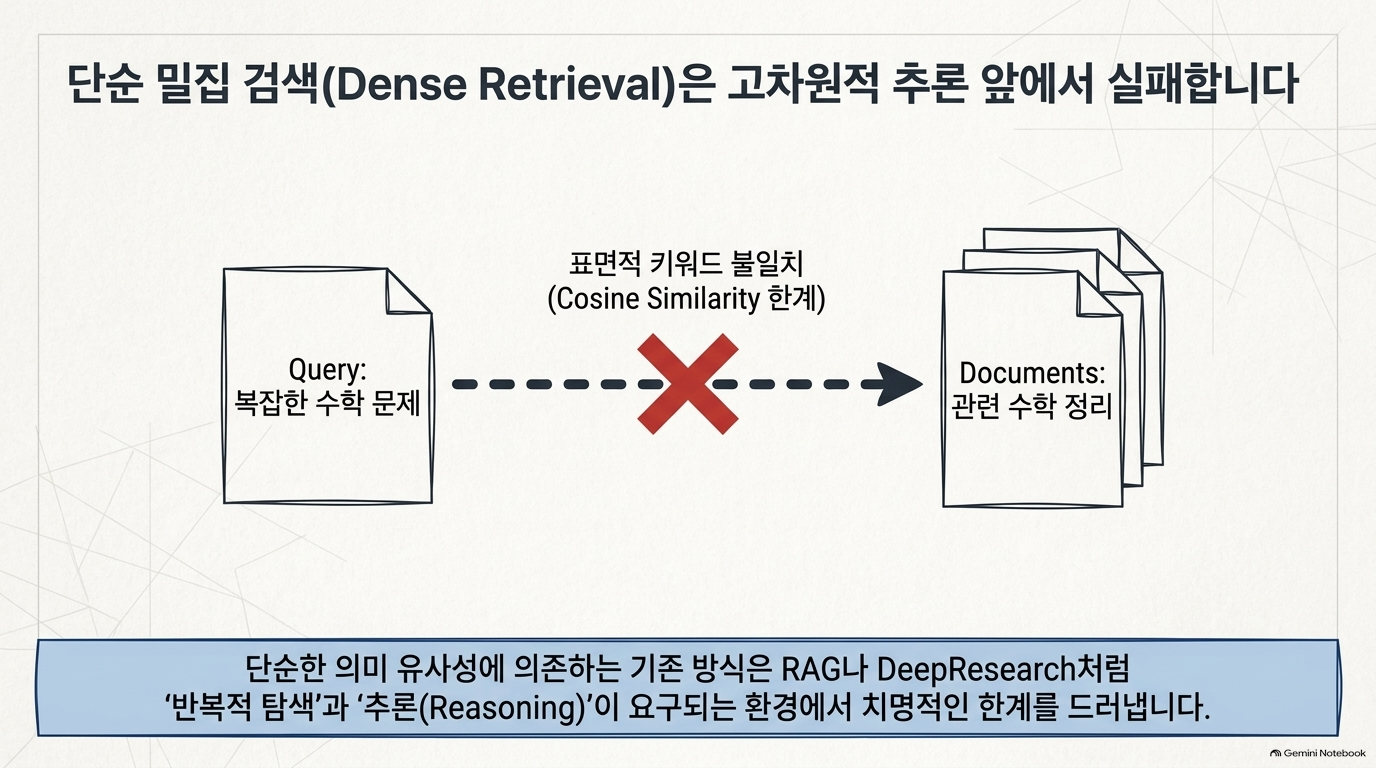
논문이 제시하는 대표 사례는 수학 문제에서 해결에 유용한 정리를 검색하는 것입니다. 문제 설명과 필요한 정리는 표현이나 주제가 직접적으로 비슷하지 않을 수 있으므로, 단순한 의미 유사도만으로는 관련성을 포착하기 어렵다는 주장입니다.[2]
여기서 핵심은 다음의 차이입니다.
문서가 질문과 비슷한가?와 문서가 질문을 해결하는 데 필요한가?는 같은 판단이 아닙니다.
1.2 제안하는 접근
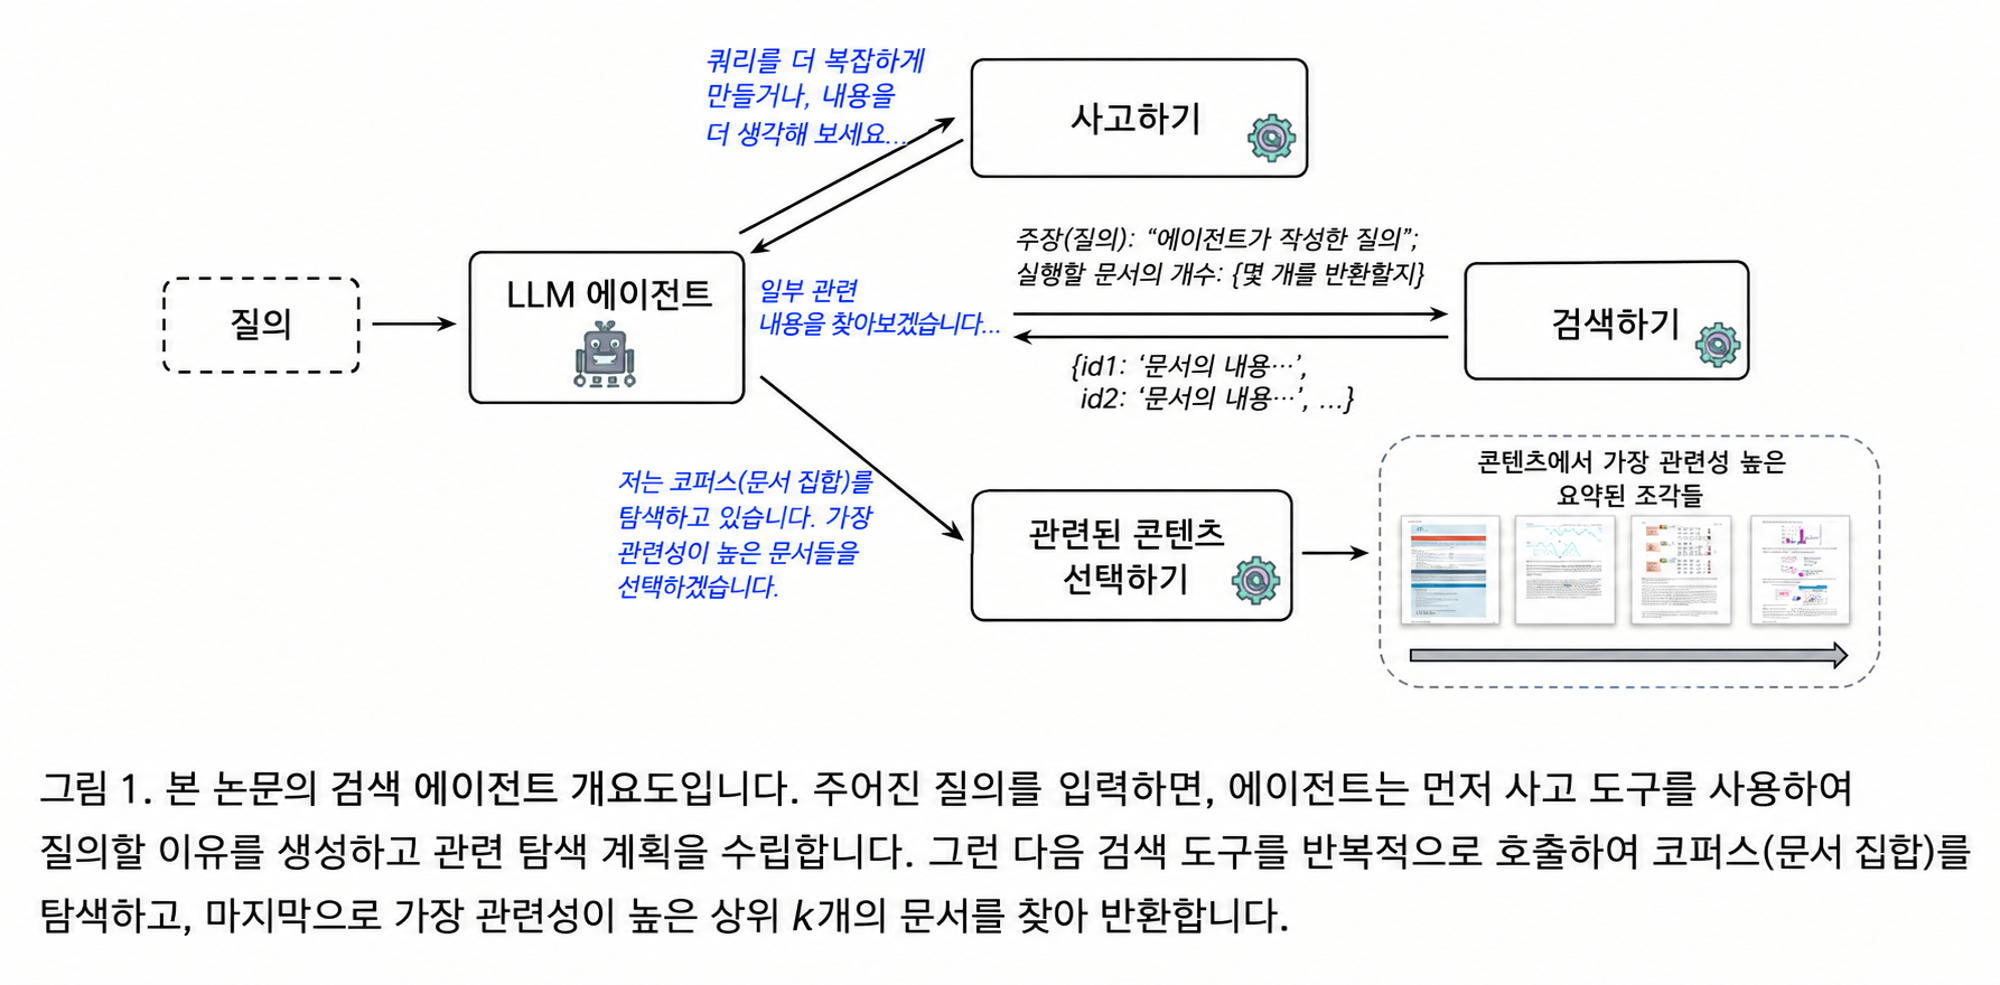
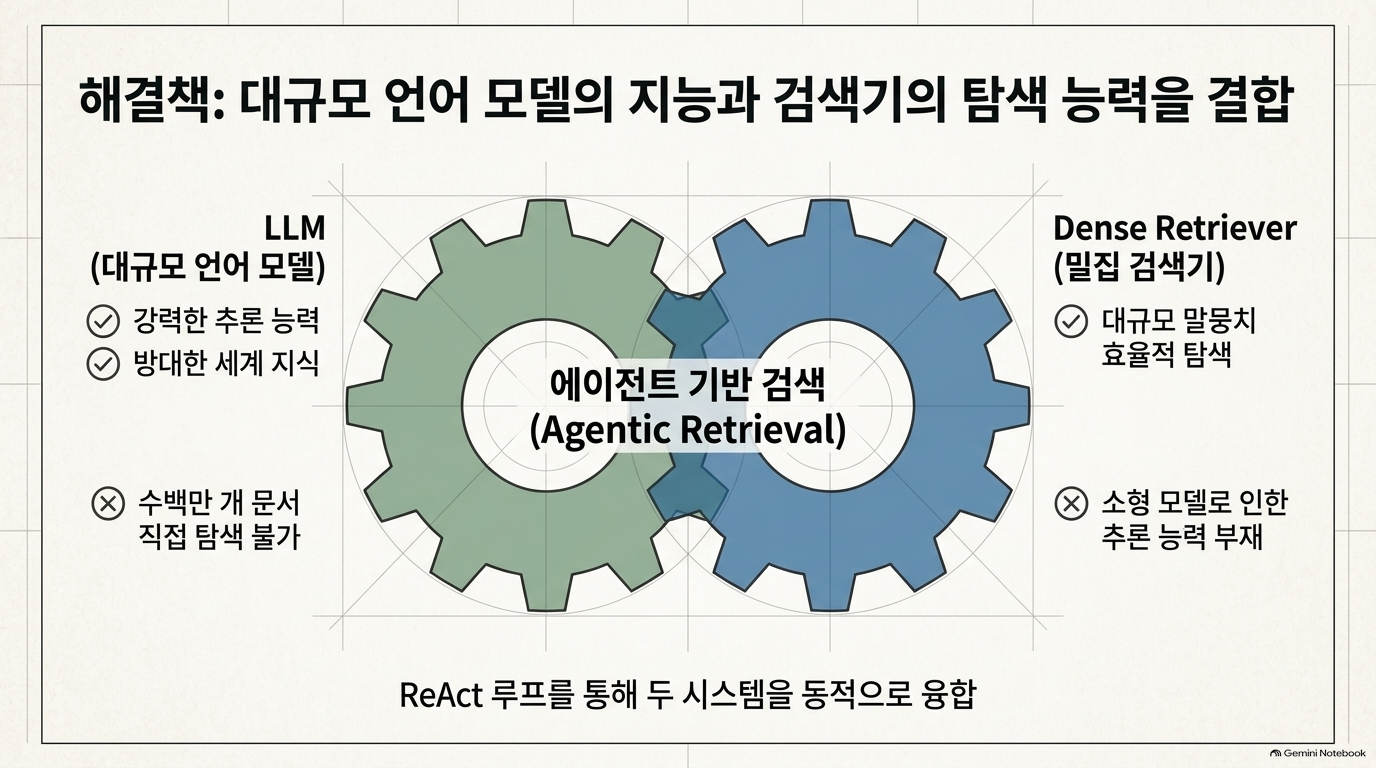
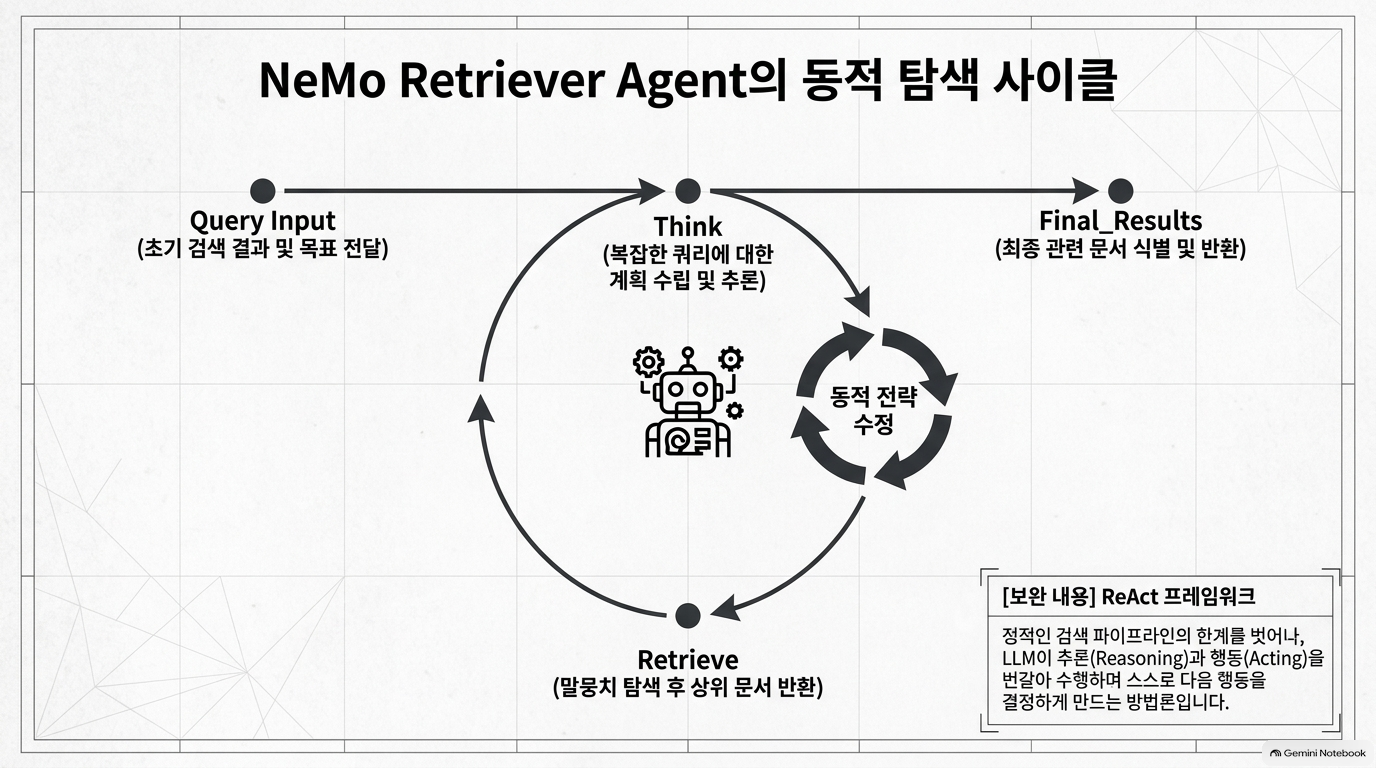
LLM의 추론·세계지식과 검색기의 대규모 문서 탐색 능력을 ReAct 반복 구조로 결합합니다. LLM이 검색 결과를 관찰하고, 다음 검색 질의를 결정하며, 필요한 문서를 추가로 찾도록 합니다.[2]
논문은 기여를 세 가지로 정리합니다.[2]
| 기여 | 논문이 제시하는 근거 |
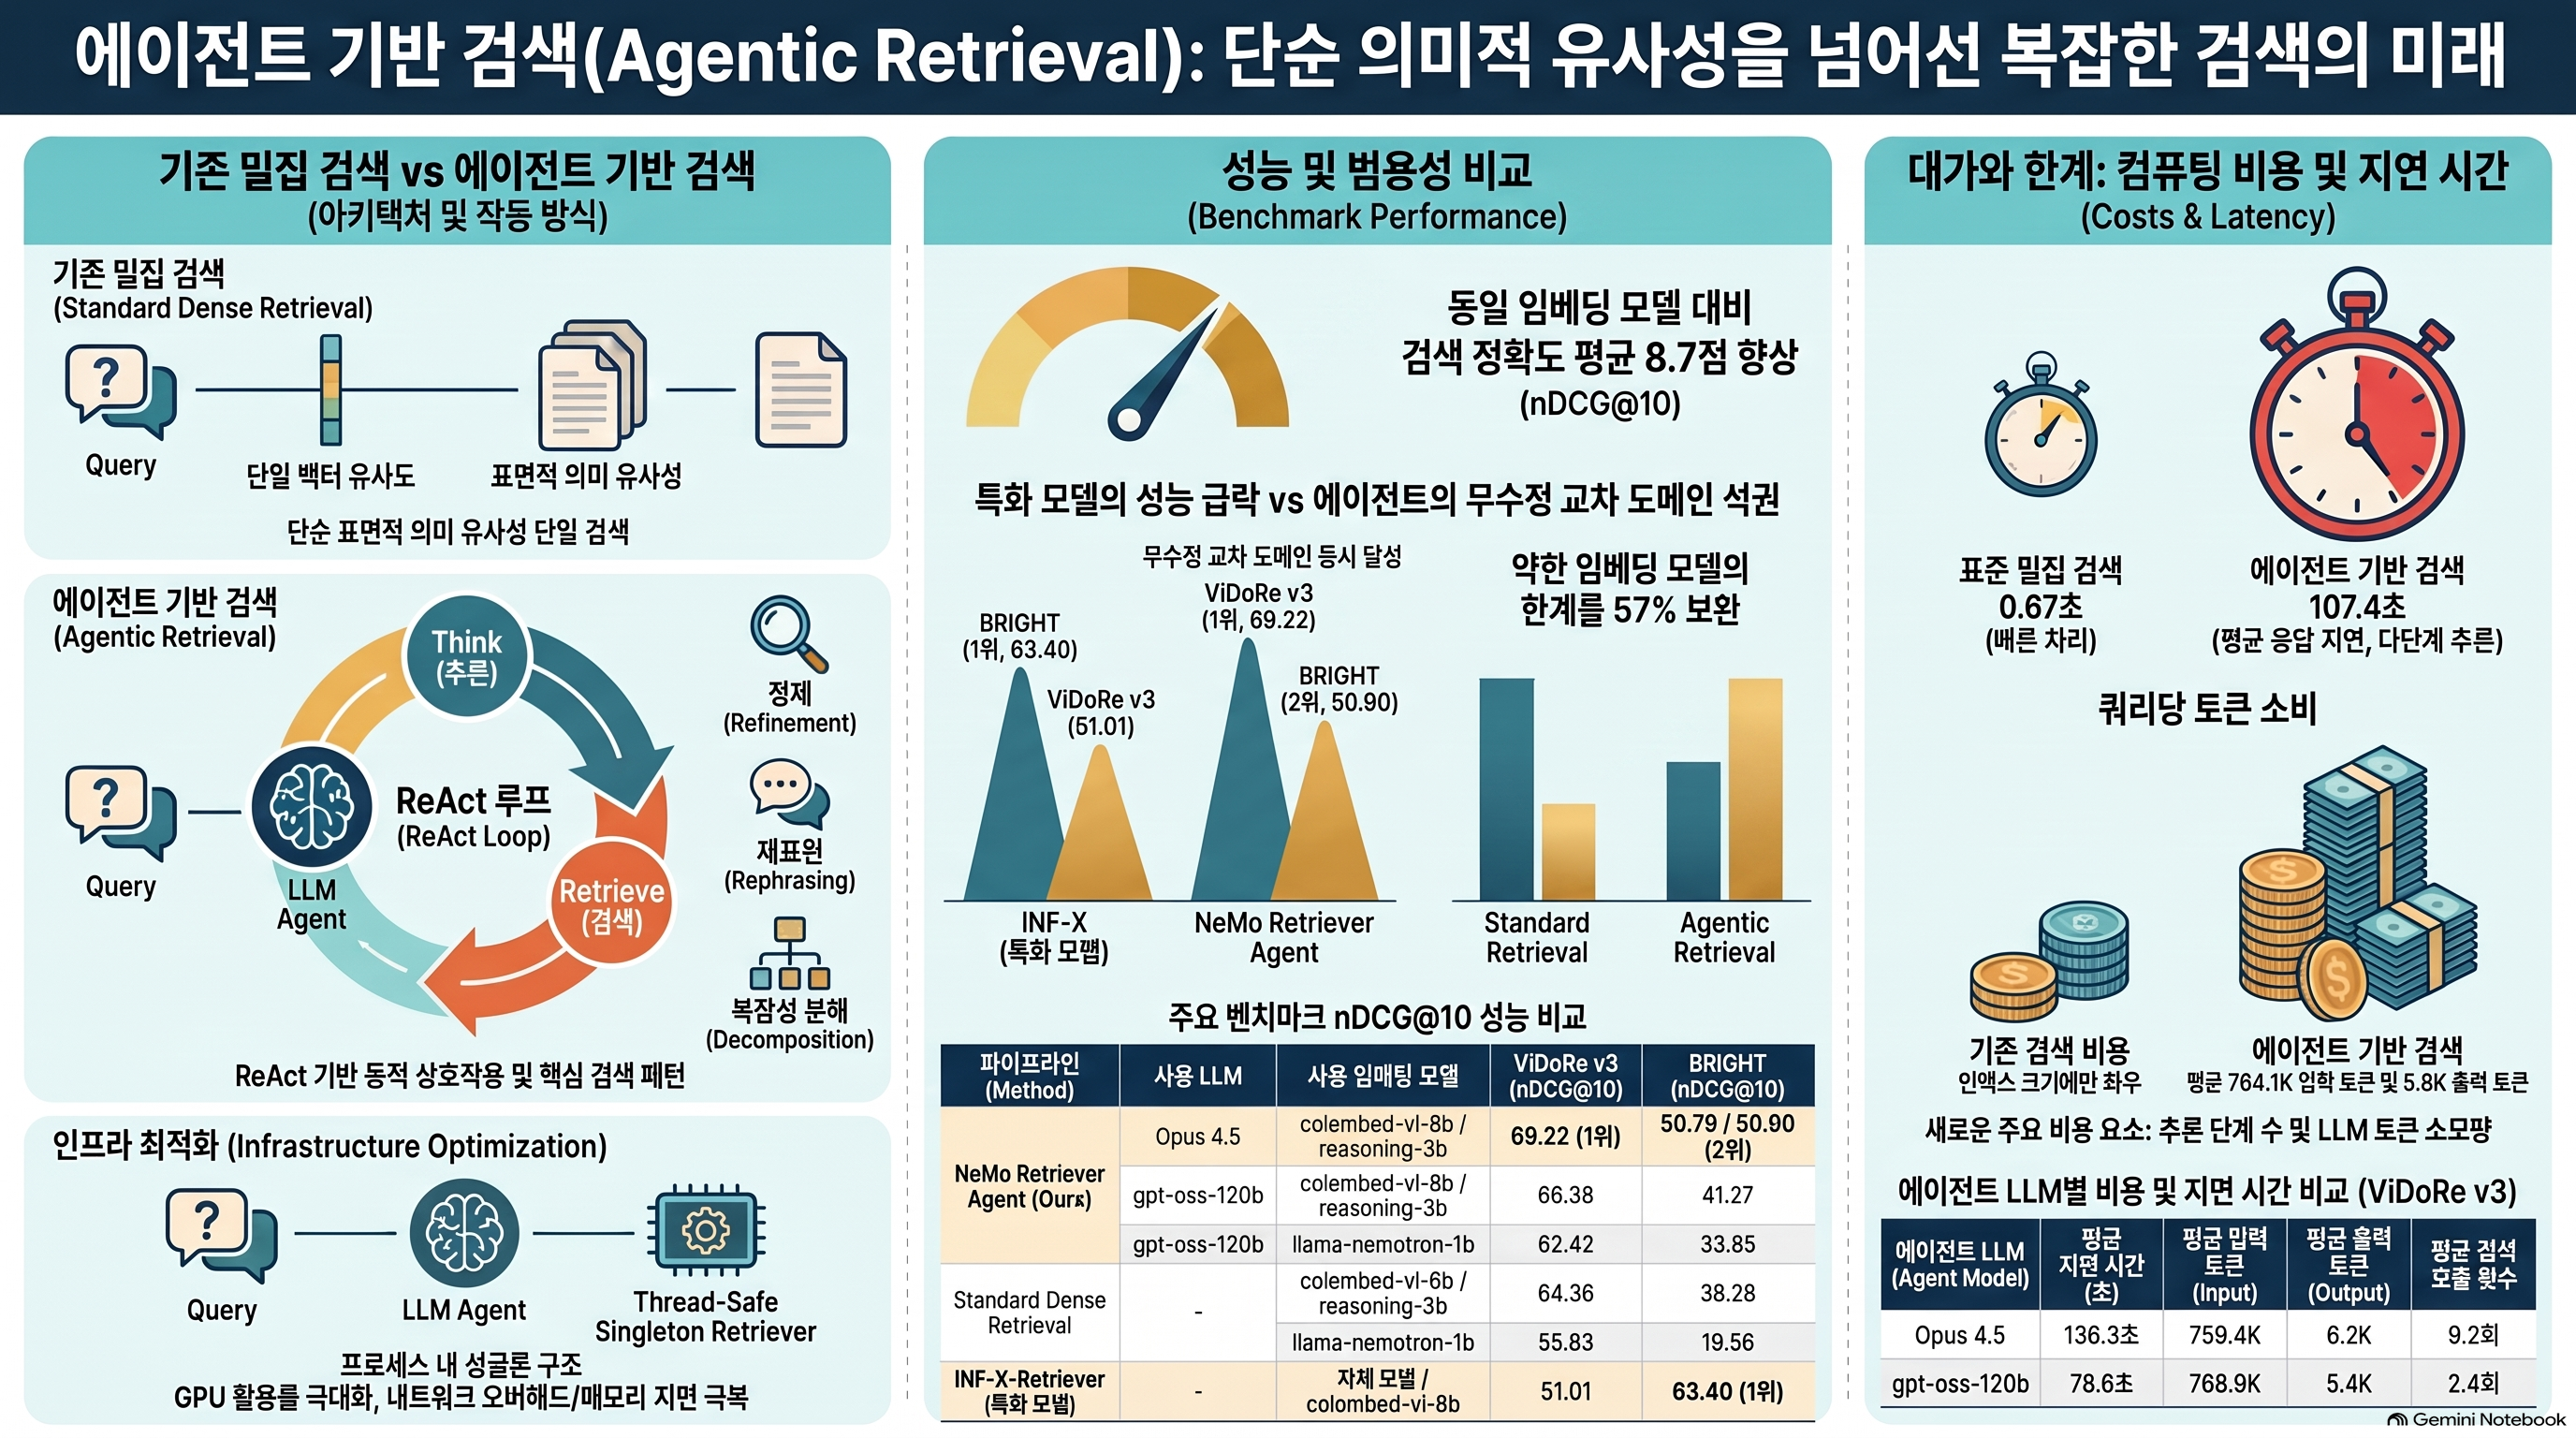
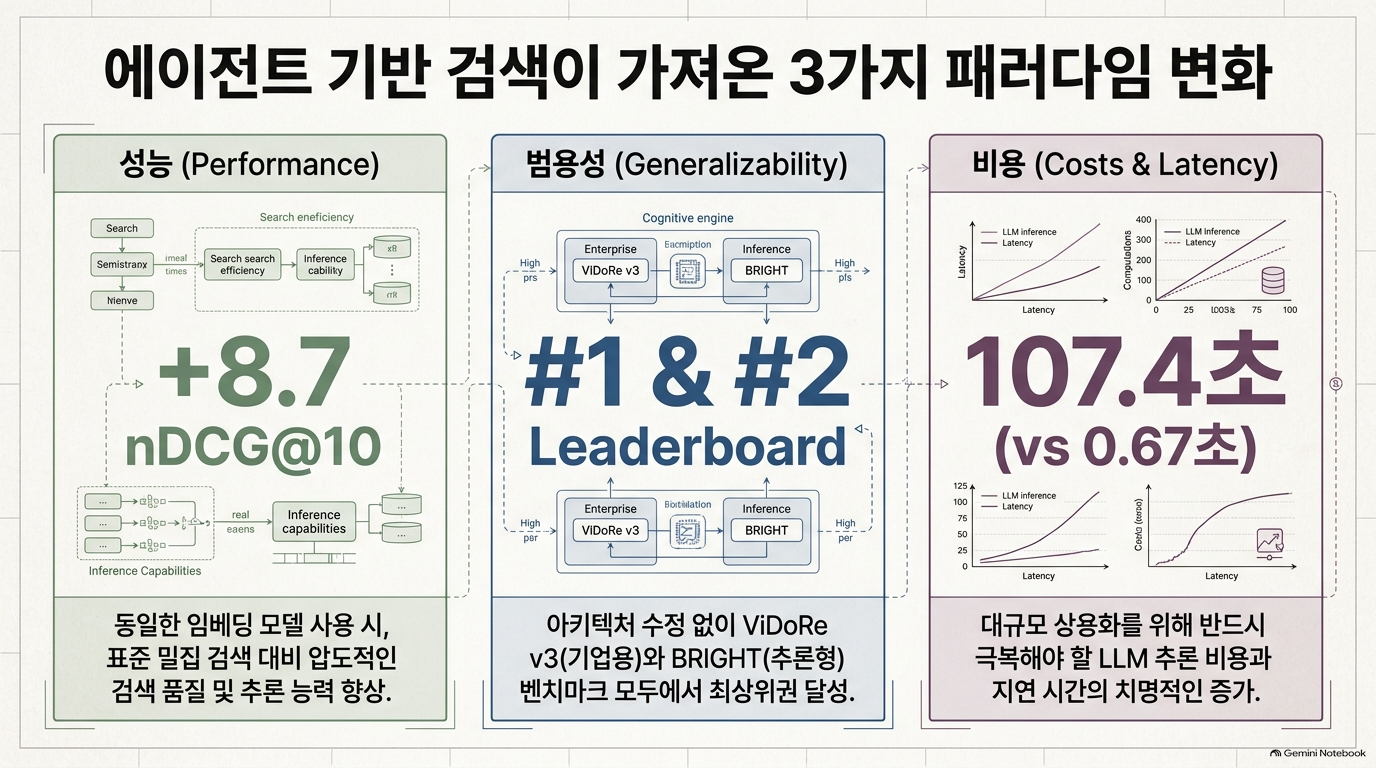
| 검색 효과성 | 동일 임베딩 모델 대비 최상위 에이전트의 nDCG@10 평균 약 8.7점 개선 |
| 일반화 가능성 | ViDoRe v3와 BRIGHT에 동일 에이전트 파이프라인 적용 |
| 비용 분석 | 검색 지연과 입력·출력 토큰 소비량 보고 |
1.3 분석
이 장의 중요한 전환은 검색을 단일 유사도 계산이 아니라, 증거를 모으는 적응적 과정으로 본다는 것입니다.
다만 저자의 “표면적 의미 유사도”라는 표현을 지나치게 확대해서는 안 됩니다. 논문 자체도 추론 과제에 특화된 임베딩 모델을 사용합니다. 따라서 실험이 뒷받침하는 범위는 “평가한 복잡한 과제에서는 단일 검색보다 반복적 LLM 탐색을 추가하는 것이 유리했다”이지, “모든 임베딩 검색은 추론 관계를 포착하지 못한다”는 보편적 명제가 아닙니다.[2]
실무 시사점 — 분석자 해석
법령·정책·감리 문서에서도 질문과 정답 근거의 표현이 다를 수 있습니다. 예를 들어 “요구사항 충족 여부”를 판단하려면 요구사항뿐 아니라 변경 승인, 설계, 시험 결과까지 연결해야 합니다. 이런 문제는 단순 검색보다 하위 질문 생성 → 근거 탐색 → 누락 확인 구조에 적합합니다. 다만 이 논문이 공공 감리·법률 업무에서 효과를 직접 검증한 것은 아닙니다.
2장. Retrieval Agent — 검색 자체를 에이전트화하는 구조
2.1 기존 질의 재작성과의 차이
기존의 정적 질의 재작성은 대체로 다음 구조입니다.[2]
textCopy
원래 질문 → LLM의 질의 재작성 → 검색 → 결과
논문의 에이전트는 검색 결과를 다음 행동의 입력으로 사용합니다.[2]
| 원래 질문 + 최초 검색 결과 ↓ 추론·검색 전략 결정 ↓ 추가 검색 ↓ 결과 관찰·질의 수정 ↓ 필요하면 반복 → 최종 문서 순위 |
차이는 검색 결과를 보고 계획을 바꿀 수 있는가입니다.
2.2 최초 검색 결과를 먼저 제공하는 이유
에이전트에게 질문만 주는 것이 아니라, 원래 질문으로 검색한 초기 문서도 함께 제공합니다. 저자들은 이를 통해 불필요한 검색을 줄이고, 에이전트가 코퍼스의 성격을 파악하게 한다고 설명합니다.[2]
예를 들어 초기 결과가 수학 정리인지, 함수 명세인지 파악하면 이후 질의를 그 문서 유형에 맞게 구성할 수 있습니다.[2]
분석: 초기 검색 결과는 후보 문서이면서 동시에 코퍼스의 특성을 알려주는 관찰 자료입니다. 반대로 초기 결과가 편향되면 후속 탐색도 그 방향에 고착될 가능성이 있습니다. 이 위험은 논문에서 별도 실험으로 검증하지 않습니다.
2.3 세 가지 도구
| 도구 | 입력·역할 | 주의할 점 |
| Retrieve | 검색 질의와 정수 k를 받아 상위 k개 문서 및 고유 ID 반환 | 검색기는 계속 사용되며, 에이전트가 이를 대체하지 않음 |
| Think | 추론·계획을 위한 문자열 입력 | 환경을 변경하지 않고 별도 결과를 반환하지 않음 |
| Final_Results | 관련성 순으로 정렬한 k개 문서 ID와 선정 근거 반환 | 문서 수가 잘못되면 오류를 반환하고 재시도 요구 |
위 구조와 도구 동작은 2장에 명시되어 있습니다.[2]
중요한 평가 경계: 이 시스템의 최종 산출물은 답변이 아니라 검색 문서 목록과 순위입니다. 따라서 검색 성능 향상을 곧바로 답변 정확도나 환각 감소 효과로 바꿔 해석할 수 없습니다.
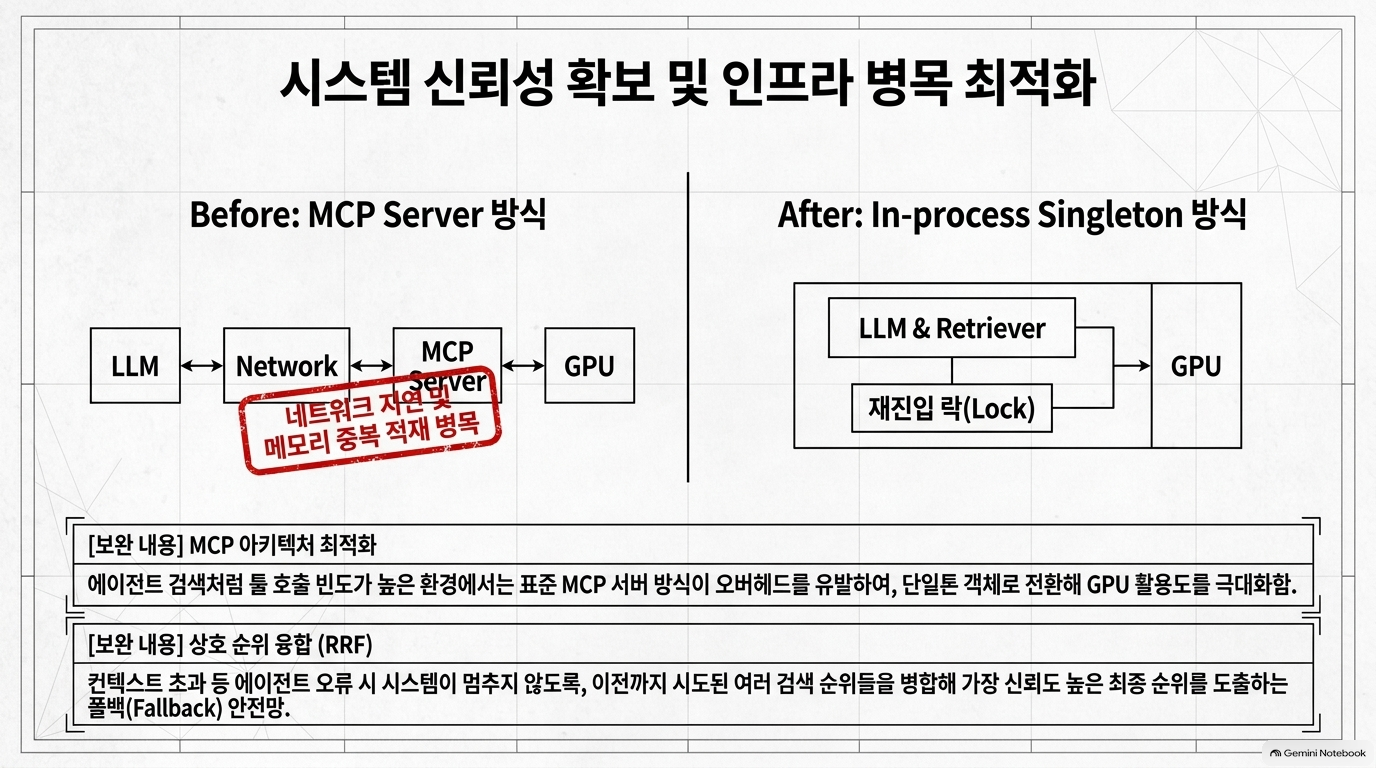
2.4 Reliability — 오류 시 RRF로 대체
컨텍스트 한도 초과나 콘텐츠 위반 오류 등으로 에이전트가 최종 문서를 선택하지 못하면, 오류 이전에 수행한 검색의 순위 목록들을 Reciprocal Rank Fusion, RRF로 병합합니다.[2]
textCopy
정상 종료 → 에이전트가 선정한 문서 순위
오류 발생 → 기존 검색 순위들을 RRF로 병합
분석: 이는 “에이전트가 실패해도 검색 결과를 반환하는” 가용성 보완책입니다. 하지만 RRF 결과가 에이전트의 최종 판단과 같은 품질을 보장하는 것은 아닙니다.
[확인 필요: §2 Reliability] 본문에는 오류 발생률, RRF 전환 비율, 정상 종료와 대체 경로의 성능 차이가 제시되지 않습니다.[2]
2.5 Infrastructure — MCP에서 동일 프로세스 검색기로 전환
저자들의 실험 구현에서는 MCP 사용 시 서버 생성, GPU 메모리에 임베딩 적재, 클라이언트·서버 생명주기 관리, 네트워크 왕복이 반복 비용을 유발했습니다. 이를 동일 프로세스의 thread-safe singleton retriever로 대체합니다.[2]
주요 구현 특징은 다음과 같습니다.[2]
- 모델과 코퍼스 임베딩을 한 번만 적재
- 재진입 잠금으로 접근 보호
- 여러 동시 에이전트에 동일 retrieve() 인터페이스 제공
분석: 교훈은 “MCP는 비효율적이다”가 아니라 “빈번하게 호출하는 로컬 검색 도구는 배치·공유·생명주기 설계가 중요하다”입니다. 논문에서 관찰한 오버헤드는 해당 MCP 구성의 결과이며, 모든 MCP 배포 방식의 필연적 특성으로 일반화할 수 없습니다.
또한 개선된 GPU 활용률·실험 처리량에 대한 정성적 설명은 있지만, 전환 전후를 비교하는 정량 성능표는 없습니다.[2]
3장. Experiments — 성능·일반화·비용 검증
3.1 Setup — 무엇을 평가했는가
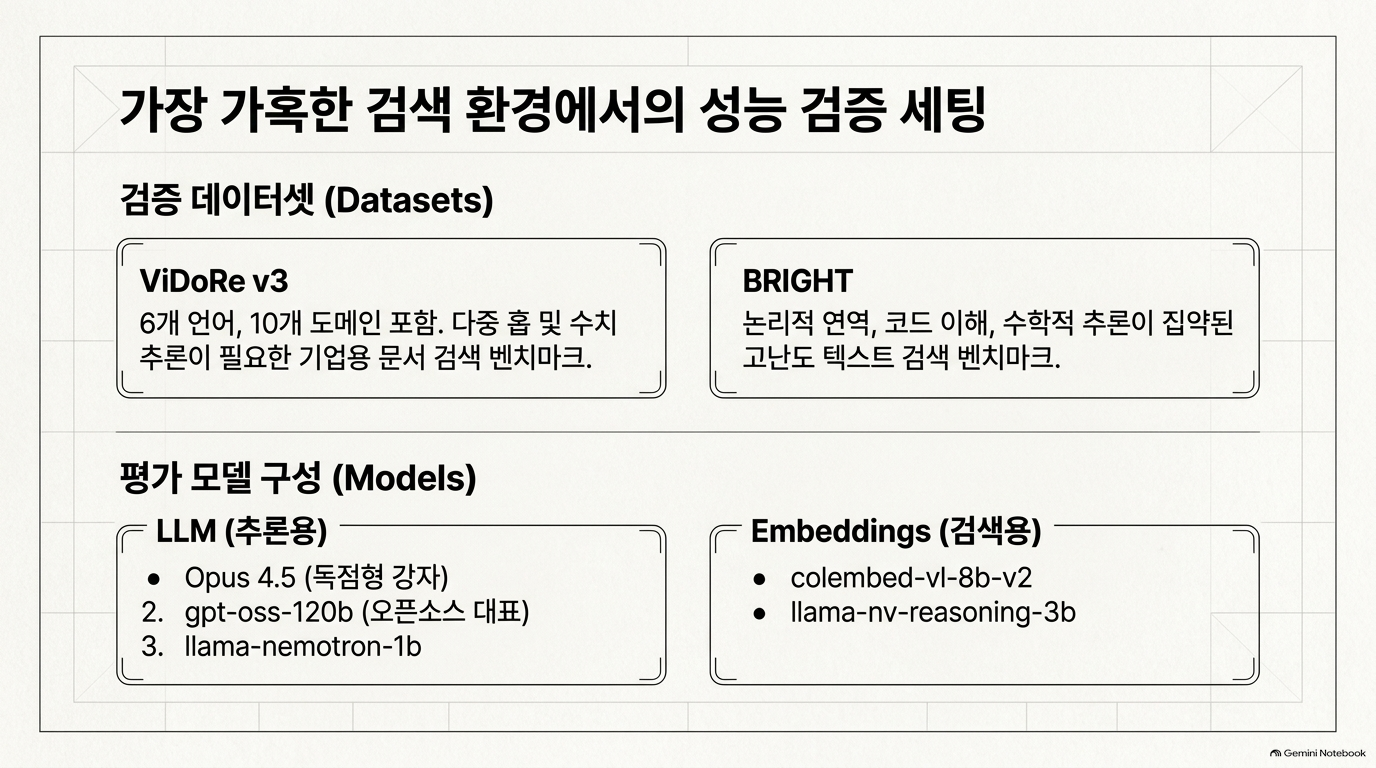
데이터셋
| 벤치마크 | 평가 대상 | 특징 |
| ViDoRe v3 | 기업·기관 문서 검색 | 6개 언어, 10개 도메인, 7개 질의 유형 |
| BRIGHT | 추론 집약적 텍스트 검색 | 논리적 추론, 코드 이해, 수학적 추론 |
ViDoRe v3에는 금융·제약·정부 에너지 보고서 등이 포함되며, 질의 유형에는 추출형·다중 홉·수치 추론 등이 포함됩니다.[2]
모델 구성
- 에이전트 LLM: Opus 4.5, gpt-oss-120b
- ViDoRe v3 검색기: colembed-vl-8b-v2
- BRIGHT 검색기: llama-nv-reasoning-3b
- 두 벤치마크의 소형 검색기 비교: llama-nemotron-1b[2]
해석상 주의: “동일 파이프라인으로 일반화했다”는 표현은 모든 구성요소가 동일했다는 뜻이 아닙니다. 에이전트 구조는 동일하지만, 주력 검색기는 벤치마크별로 다릅니다.[2]
3.2 Results — 동일 검색기에서도 성능이 개선되는가
논문 표 1의 결과와, 이를 기준으로 계산한 개선 폭입니다. 개선 폭은 nDCG@10 점수 차이이며 상대 개선율이 아닙니다.[2]
| 벤치마크·검색기 | 단일 검색 | gpt-oss 에이전트 | Opus 에이전트 |
| ViDoRe · colembed-vl-8b-v2 | 64.36 | 66.38 (+2.02) | 69.22 (+4.86) |
| ViDoRe · llama-nemotron-1b | 55.83 | 62.42 (+6.59) | 미보고 |
| BRIGHT · llama-nv-reasoning-3b | 38.28 | 41.27 (+2.99) | 50.79 (+12.51) |
| BRIGHT · llama-nemotron-1b | 19.56 | 33.85 (+14.29) | 미보고 |
발견 ① 에이전트 구조가 검색기의 활용도를 높임
보고된 모든 조합에서 에이전트 검색이 동일 검색기의 단일 검색보다 높습니다.[2]
최상위 검색기와 Opus를 사용한 두 벤치마크의 개선 폭을 단순 평균하면 다음과 같습니다.
textCopy
(4.86 + 12.51) / 2 = 8.685점 ≈ 8.7점
따라서 초록의 “평균 8.7점 개선”은 표 1과 정합적입니다. 다만 이는 두 벤치마크 점수 차이의 평균이지, 모든 개별 질의를 합산한 개선량이라고 해석해서는 안 됩니다.
발견 ② 추론 난도가 높은 BRIGHT에서 LLM 차이가 큼
동일 주력 검색기 기준 Opus와 gpt-oss의 차이는 다음과 같습니다.
- ViDoRe v3: 2.84점
- BRIGHT: 9.52점
- 두 차이의 평균: 6.18점
논문은 이를 추론 능력의 중요성을 보여주는 결과로 설명합니다. ViDoRe에서 추가 검색 호출 수는 질의당 평균 Opus 9.2회, gpt-oss 2.4회이며, 탐색량 차이가 성능 차이의 한 원인일 수 있다고 제안합니다.[2]
분석: 탐색량과 성능 차이는 관찰됐지만, 더 많이 검색해서 좋아졌는지, 더 좋은 질의를 생성해서 좋아졌는지는 분리되지 않았습니다. 동일 검색 횟수·동일 토큰 예산 조건의 비교가 필요합니다.
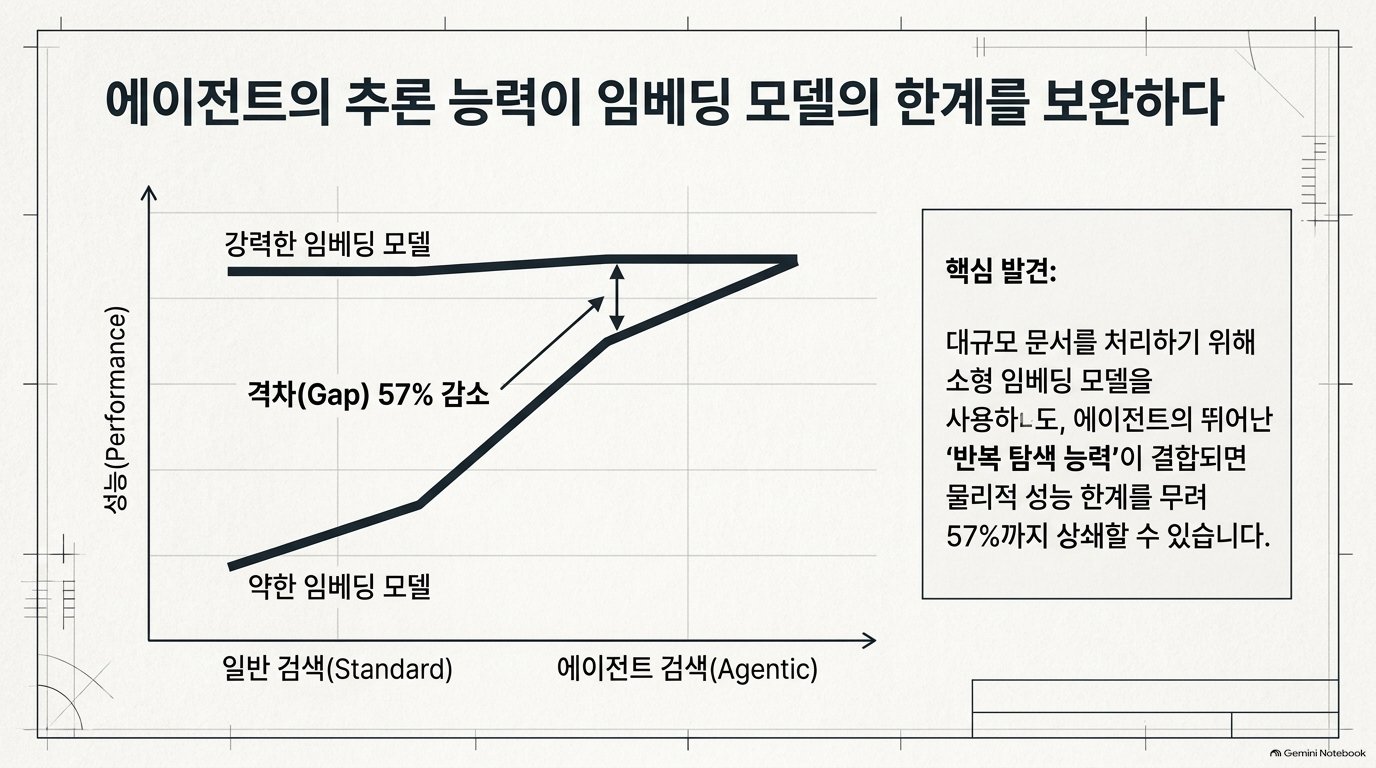
발견 ③ 작은 임베딩 모델의 약점을 일부 보완
gpt-oss 조건에서 강한 검색기와 작은 검색기 사이의 점수 격차가 줄어듭니다.[2]
| 벤치마크 | 단일 검색의 모델 간 격차 | 에이전트의 모델 간 격차 | 격차 감소율 |
| ViDoRe v3 | 8.53점 | 3.96점 | 약 53.6% |
| BRIGHT | 18.72점 | 7.42점 | 약 60.4% |
두 감소율의 평균은 약 57.0%로, 논문의 설명과 일치합니다.
분석: 이는 “작은 검색기로도 일부 성능을 회복할 수 있다”는 근거입니다. 하지만 LLM 비용이 추가되므로 전체 시스템이 더 저렴해진다는 증거는 아닙니다.
3.3 Analysis — 일반화와 비용의 교환관계
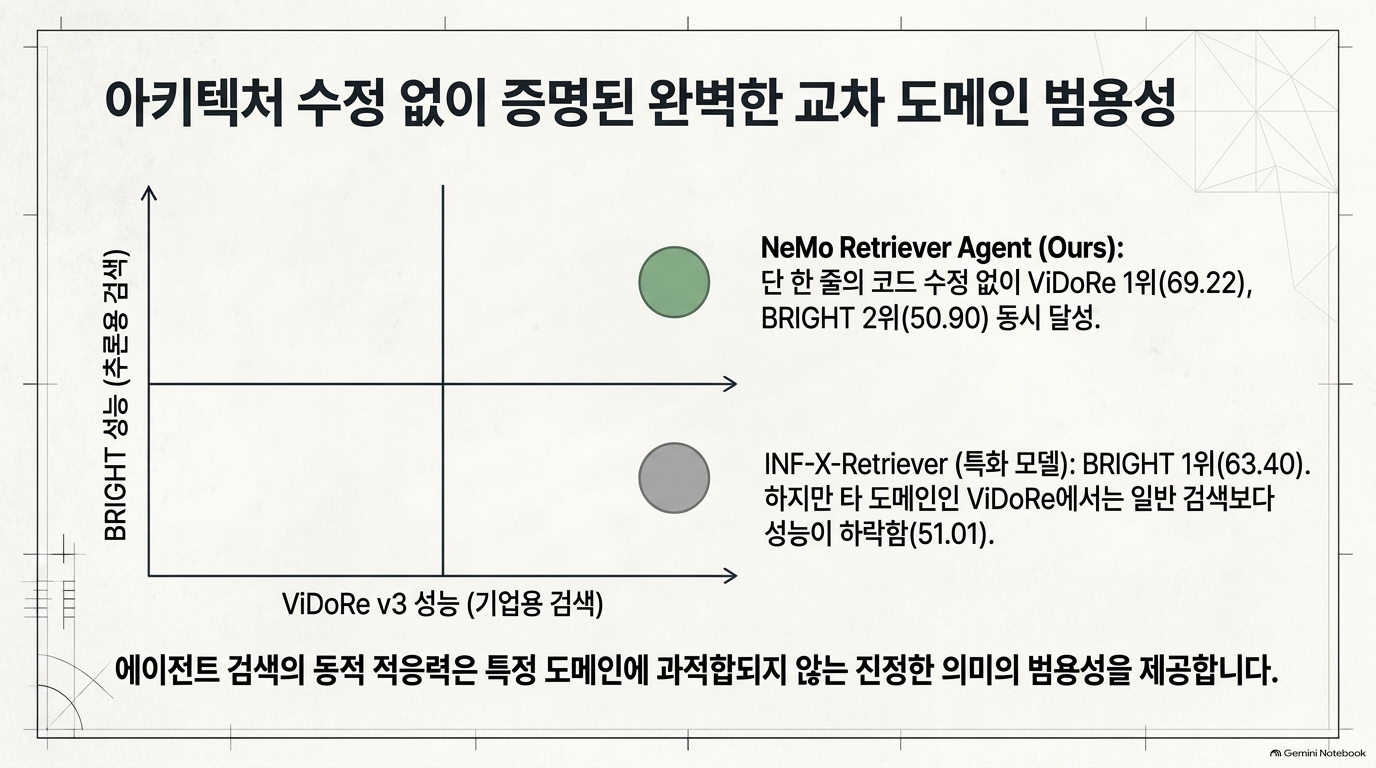
A. Generalizability — 전문화된 파이프라인과 비교
논문 표 2는 다음 결과를 보고합니다.[2]
| 파이프라인 | ViDoRe v3 | BRIGHT |
| NeMo Retriever Agent | 69.22 | 50.90 |
| INF-X-Retriever | 51.01 | 63.40 |
| INF-X + nemotron-colembed-vl-8b-v2 | 62.31 | 미보고 |
| Dense only · 동일 colembed 검색기 | 64.36 | 미보고 |
저자의 주장은 BRIGHT에 특화된 INF-X가 ViDoRe에서는 성능이 낮아지는 반면, NeMo 에이전트는 두 벤치마크에서 경쟁력 있는 결과를 낸다는 것입니다.[2]
분석: 두 벤치마크에서의 적용 가능성을 보여주는 근거는 있지만, 다음 경계를 유지해야 합니다.
- NeMo가 모든 벤치마크에서 최고인 것은 아닙니다. BRIGHT에서는 INF-X가 더 높습니다.
- 미보고 결과는 0점이나 실패가 아니라 평가 결과가 제시되지 않은 것입니다.
- 본문의 순위는 2026년 3월 13일 기준이며, 현재 순위라는 뜻이 아닙니다.[2]
[확인 필요: 표 1·표 2] NeMo의 BRIGHT 점수가 표 1에서는 50.79, 표 2에서는 50.90으로 0.11점 차이가 납니다. 본문에는 차이의 원인이 설명되지 않으므로, 성능 개선 산식에는 표 1을 사용하고 표 2는 비교표 그대로 보존하는 것이 적절합니다.[2]
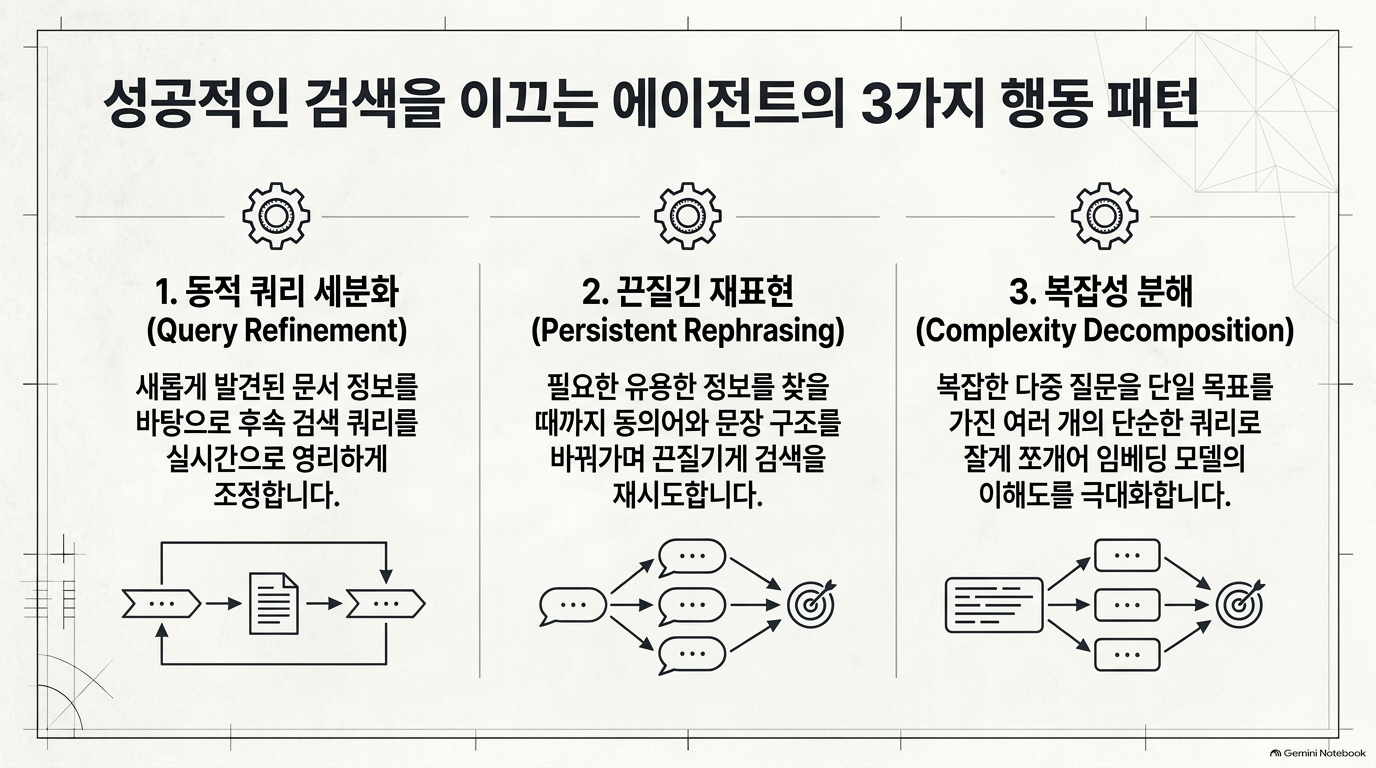
B. Successful Search Patterns — 성공적인 검색 행동
논문은 반복적으로 관찰한 성공 패턴을 세 가지로 정리합니다.[2]
| 패턴 | 의미 |
| Query Refinement | 새로 찾은 정보를 반영해 다음 질의를 수정 |
| Persistent Rephrasing | 유용한 정보를 찾을 때까지 표현을 바꿔 탐색 |
| Complexity Decomposition | 복합 질문을 목표가 명확한 하위 질문으로 분해 |
분석: 실무 설계에 유용한 행동 유형이지만, 각 패턴의 독립적 기여를 측정한 제거 실험은 없습니다. 따라서 “질의 분해가 몇 점을 개선했다” 같은 인과적 수치로 확대할 수 없습니다.
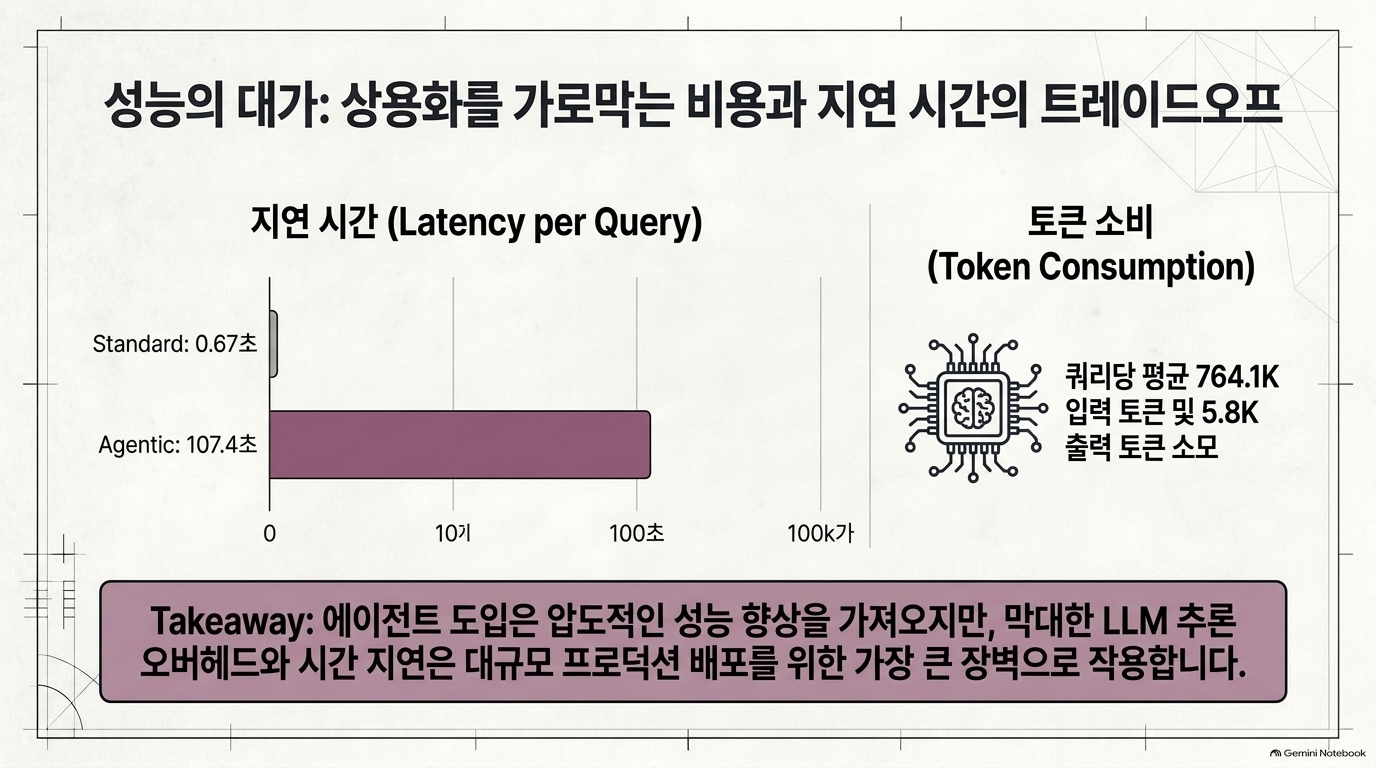
C. Costs — 성능 향상의 대가
표 3의 비용 측정은 ViDoRe v3에 대한 질의당 평균입니다.[2]
| 항목 | Opus 4.5 | gpt-oss-120b |
| 지연 | 136.3초 | 78.6초 |
| 입력 토큰 | 759.4K | 768.9K |
| 출력 토큰 | 6.2K | 5.4K |
단일 검색은 0.67초, 두 에이전트의 평균 지연은 107.45초입니다. 이를 계산하면 단일 검색 대비 약 160.4배입니다.[2]
주목할 점은 gpt-oss가 검색을 적게 수행했는데도 입력 토큰 소비는 Opus보다 약간 높다는 것입니다. 즉, 검색 호출 횟수만으로 토큰 비용을 설명할 수 없습니다. 모델별 입력 표현·토큰 계산·컨텍스트 누적 방식 등을 추가로 확인해야 합니다.
[확인 필요: §3.3 Costs]
- 입력 토큰 누적량을 단일 요청의 컨텍스트 길이로 해석해서는 안 됩니다.
- 표는 화폐 단위 비용을 제시하지 않습니다.
- 캐시 적용·청구 기준·세부 토큰 집계 방식은 본문에서 충분히 설명하지 않습니다.
- 평균 지연만으로 p95·p99나 동시 사용자 환경의 응답시간을 판단할 수 없습니다.[2]
4장. Discussion — 검색 시스템 설계에 대한 교훈
4.1 복잡한 검색은 다른 접근을 요구함
저자들은 좁고 명확한 검색에는 의미 유사도가 유효하지만, RAG·DeepResearch의 복잡한 검색에는 반복 탐색과 중간 추론이 필요하다고 주장합니다.[2]
분석자 권고: 단순 검색을 없애기보다 기본 검색 + 복잡한 질의의 에이전트 전환으로 설계하는 편이 타당합니다. 다만 이러한 선택적 전환 구조의 효과는 이 논문에서 직접 평가하지 않았습니다.
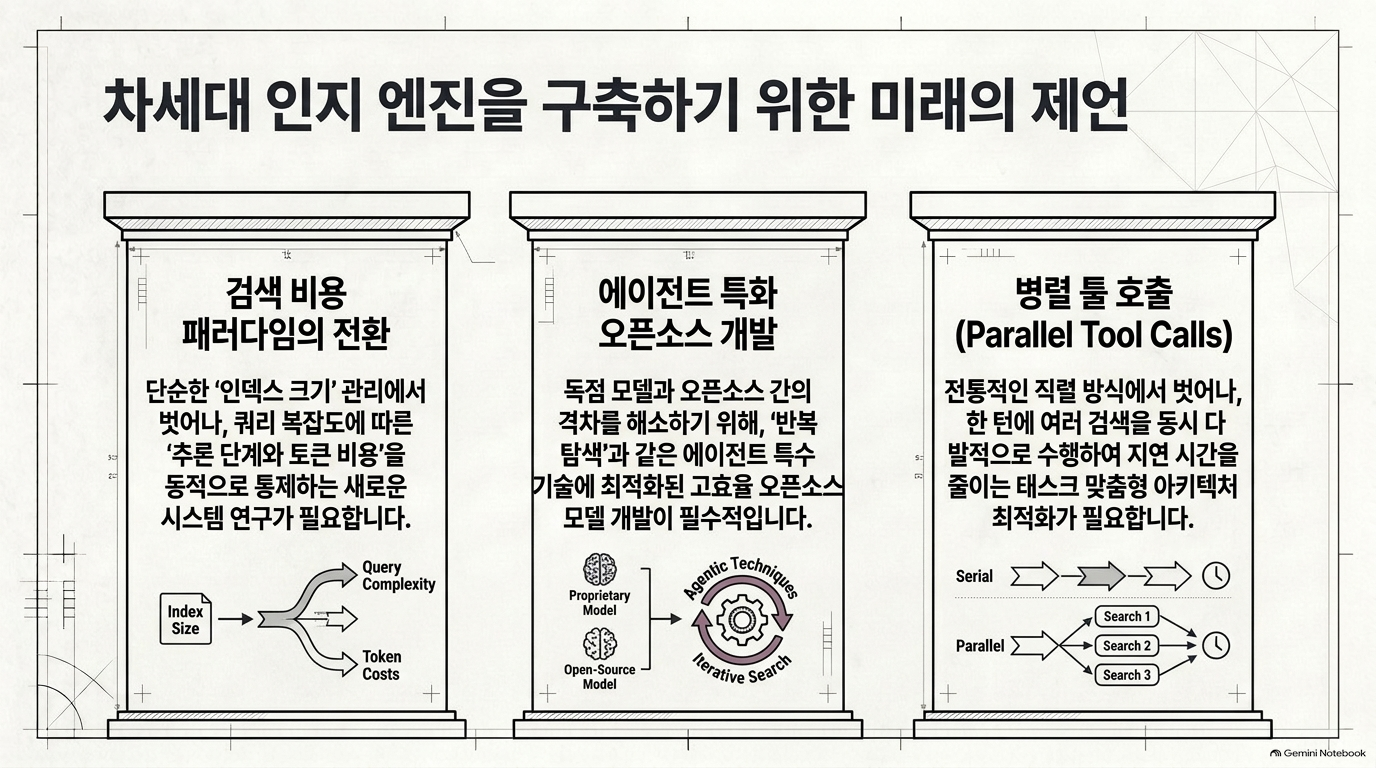
4.2 비용 관리 대상이 인덱스에서 행동 예산까지 확장됨
기존 검색 비용이 코퍼스·인덱스 규모와 밀접했다면, 에이전트 검색에는 추론 단계 수와 토큰 소비량이 새로운 비용 변수로 추가됩니다.[2]
따라서 운영에서는 다음을 별도로 관리할 필요가 있습니다.
- 검색 호출 예산
- 입력·출력 토큰 예산
- 최대 실행시간
- 추가 근거를 찾지 못할 때의 종료 기준
- 정상 종료·오류·예산 소진의 구분
위 항목은 분석자 권고이며, 논문이 검증한 최적 설정은 아닙니다.
4.3 검색 전용 모델의 가능성
저자들은 검색 에이전트의 역할이 비교적 명확하고 필요한 능력이 특정되어 있으므로, 범용 대형 모델보다 효율적인 검색 특화 모델을 개발할 여지가 있다고 봅니다.[2]
분석: 유망한 연구 방향이지만, 이 논문은 검색 특화 LLM을 학습하거나 그 효과를 검증한 연구는 아닙니다.
4.4 과제에 맞는 인프라와 병렬 호출
저자들은 동일 프로세스 검색기와 함께, 검색에서는 여러 질의를 한 턴에 병렬 호출하는 방식이 단계 수를 줄이고 다음 판단에 더 많은 정보를 제공할 수 있다고 제안합니다.[2]
분석: 서로 독립적인 하위 질의에는 병렬화가 적합하지만, 앞선 결과를 보고 다음 질의를 만드는 과정은 순차 의존성이 있습니다. 따라서 무조건 병렬화보다 의존성을 기준으로 병렬·순차를 구분해야 합니다.
4.1 Related Work — 연구의 위치
논문은 자신의 접근을 두 흐름과 구분합니다.[2]
| 기존 흐름 | 논문의 차별화 지점 |
| LLM 기반 질의 확장·재작성 | 고정된 단계가 아니라 결과를 관찰하며 동적으로 탐색 |
| 검색기를 사용하는 업무 에이전트 | 업무 수행 전체보다 재사용 가능한 검색 구성요소 자체를 에이전트화 |
핵심 기여는 새로운 검색 임베딩 알고리즘보다 검색기의 사용 전략을 동적으로 결정하는 계층에 있습니다.
5장. Conclusion — 무엇이 입증됐고 무엇이 남았는가
저자들은 두 복잡한 검색 벤치마크에서 에이전트 방식의 효과와 적용 범위를 확인했으며, 높은 계산 비용이 대규모 배포의 주요 한계라고 결론짓습니다.[2]
이를 증거 수준별로 정리하면 다음과 같습니다.
| 구분 | 판단 |
| 실험으로 확인 | 보고된 조합에서 동일 검색기 대비 nDCG@10 개선 |
| 제한적으로 확인 | 두 벤치마크에 동일 에이전트 구조 적용 가능 |
| 관찰·가설 | 탐색량 차이가 LLM 간 성능 차이의 원인일 가능성 |
| 향후 연구 | 검색 특화 모델, 비용 제어, 과제별 인프라 최적화 |
| 입증되지 않음 | 답변 정확도 향상, 환각 감소, 운영 비용 절감, 공공 업무의 신뢰성 |
종합 평가 최종 판단: 이 논문은 “검색기의 교체 없이도 적응적 탐색으로 복잡한 검색 품질을 높일 수 있다”는 근거를 제공합니다. 반면 “에이전트 검색이 곧 신뢰할 수 있는 답변이나 경제적인 운영을 보장한다”는 근거는 아닙니다. 실무 도입의 핵심은 에이전트 사용 여부보다 적용 조건·근거 검증·행동 예산·실패 처리의 명확한 설계입니다.


'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - Opik, MCP 서버 최적화 - 에이전트를 거쳐도 정보의 의미와 전달을 잃지 않는 제품 설계 (0) | 2026.10.18 |
|---|---|
| AI 에이전트 - O'Reilly,2026년 AI 트랜드 보고서, AI 모델, Agent, 보안 및 바이오 (0) | 2026.10.18 |
| 에이전트 AI - 재귀적 자기 개선(RSI), Google DeepMind, AI 의식 평가 프레임워크 (0) | 2026.10.11 |
| 에이전트 AI - 개인용 에이전트: OpenAI, Dots (0) | 2026.10.10 |
| 2026 - 10.8 The State of AI Report 2026 주요 내용, 토론 및 여백 메모 (0) | 2026.10.10 |