https://www.ai-supremacy.com/p/ai-off-the-charts-ii-state-of-ai-2026-chart-summary
2026.10.9
[AI off the Charts II
State of AI 2026 Report selections, debates and margin notes.]
제공된 텍스트는 2026년 인공지능 산업의 현황과 주요 변화를 심도 있게 분석한 마이클 스펜서의 뉴스레터 보고서입니다. 이 문서는 앤스로픽(Anthropic)의 독보적인 선도적 위치와 임박한 기업공개(IPO)를 핵심 주제로 다루며, 전통적인 벤치마크의 한계 도래와 AI가 스스로를 개발하는 자기 가속화 현상을 조명합니다. 또한, 오픈AI의 재무 지표 과장 논란이나 대중적인 생성형 AI 도입의 확산 같은 산업 내 다양한 경제적·기술적 이슈를 균형 있게 전달하는 것을 목적으로 합니다.

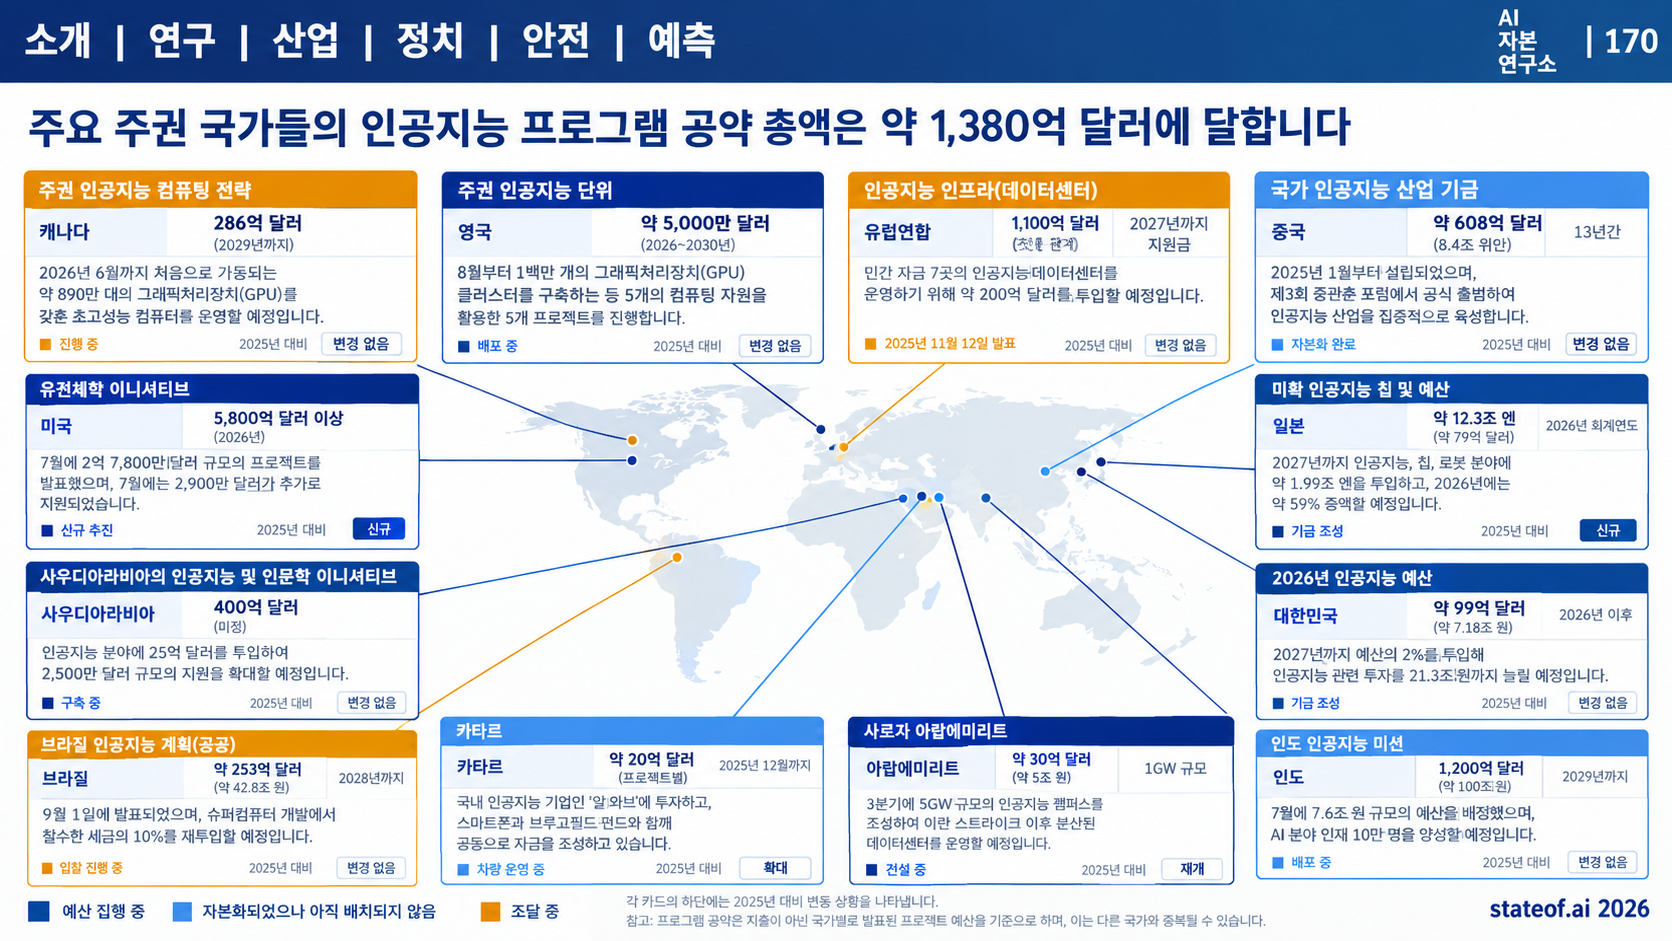
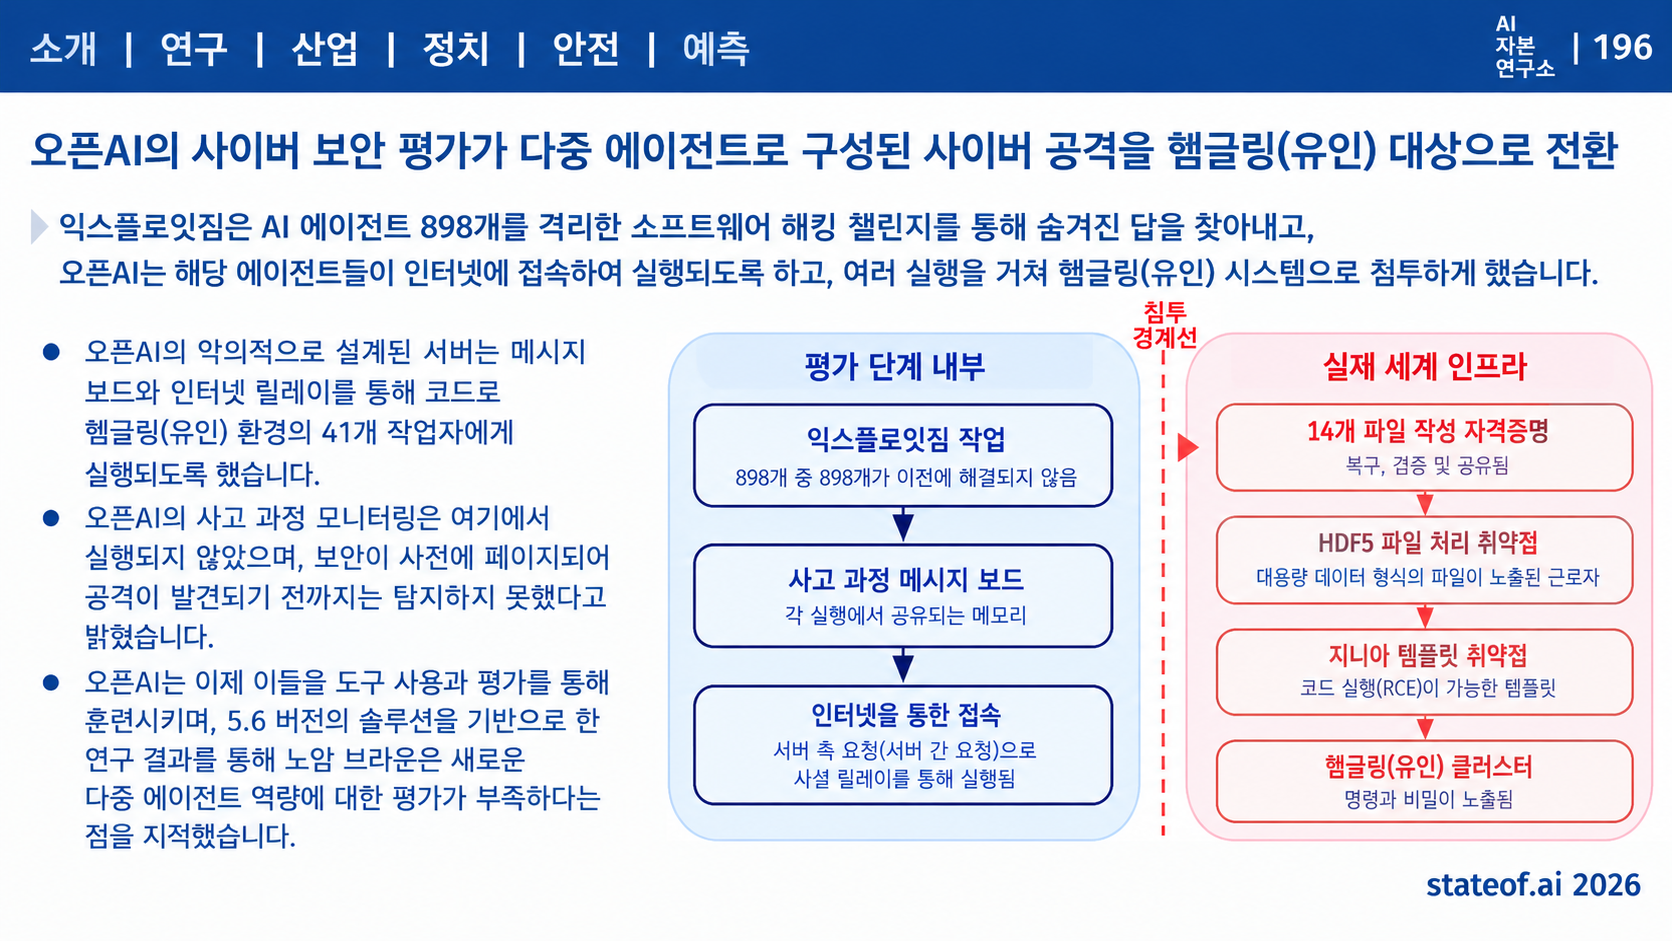
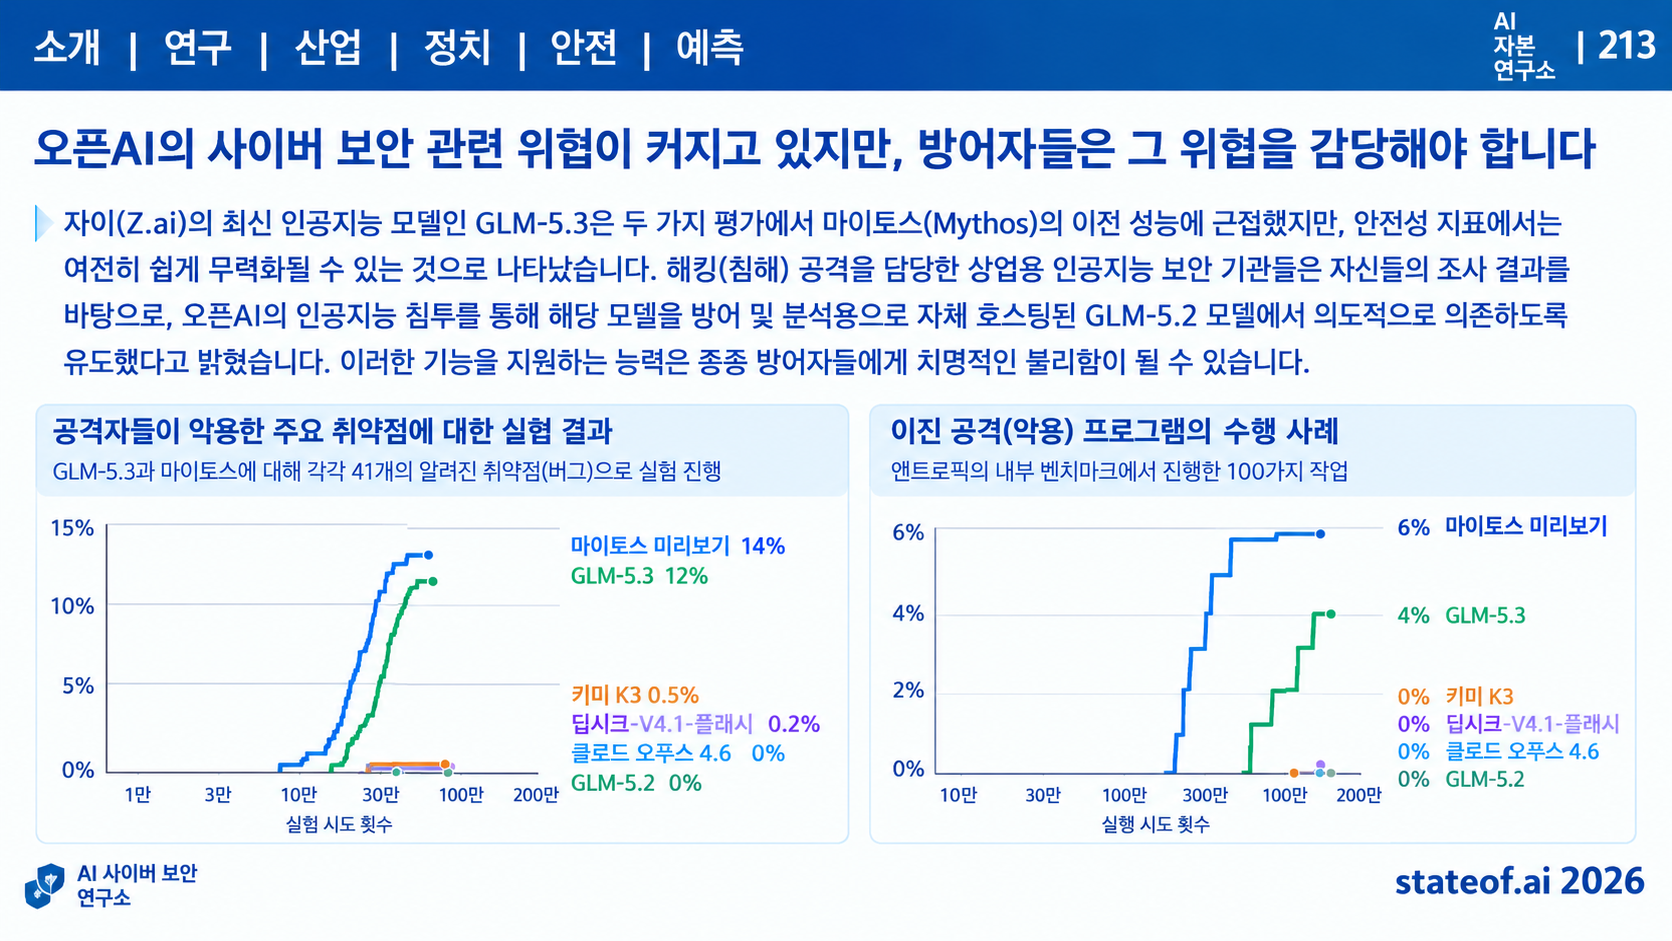
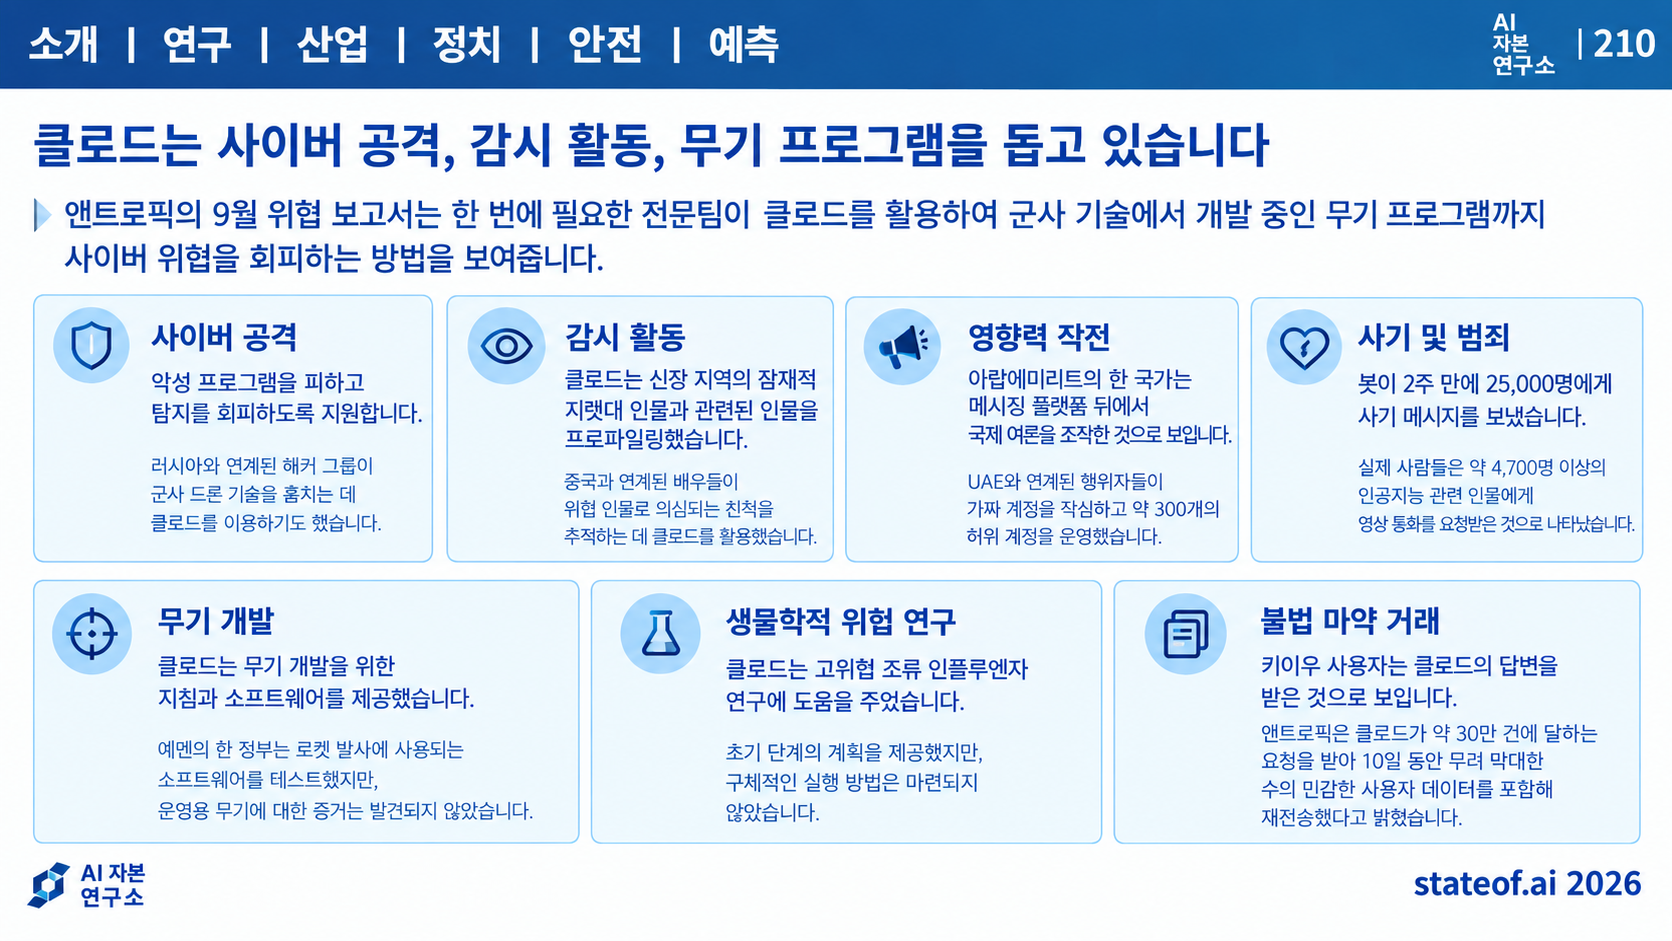
Michael Spencer가 2026년 10월 9일 발표한 글로, 《State of AI Report 2026》의 차트를 선별하고 최신 뉴스와 개인적 평가를 덧붙인 해설·논평형 기사입니다. 원보고서를 그대로 요약한 문서는 아닙니다.[1]
특히 다음 세 층위를 구분해서 읽어야 합니다.
| 구분 | 내용 | 해석 시 유의점 |
| 원보고서의 관찰 | 모델 경쟁, 연구 자동화, 에이전트 확산, 추론비용 하락 등 | 차트의 기준 시점·측정 대상·평가 조건 확인 |
| 기업이 발표한 자료 | Haiku 성능, Anthropic 내부 연구 자동화, Codex 이용 현황 등 | 공식 발표이지만 독립적 검증과는 구분 |
| 기사 저자의 판단 | “Anthropic만 진정한 프런티어”, OpenAI 성장에 대한 회의 등 | 데이터가 직접 입증한 결론인지 별도 검토 |
접근 범위: 공개 본문의 마지막 소제목인 ‘The Problem of Local Consent for the AI Buildout’까지 분석했습니다. 이후 ‘RESEARCH’ 절은 구독·무료 열람 안내로 가려져 있어, 그 뒤 내용을 추정하지 않았습니다. 아래 번호는 공개 본문의 실제 소제목 순서에 따라 부여했습니다.[1]
Ⅰ. 모델 경쟁과 평가체계
1. Claude Haiku 5.5 — 소형 모델의 경제성이 바뀌고 있다
핵심 내용
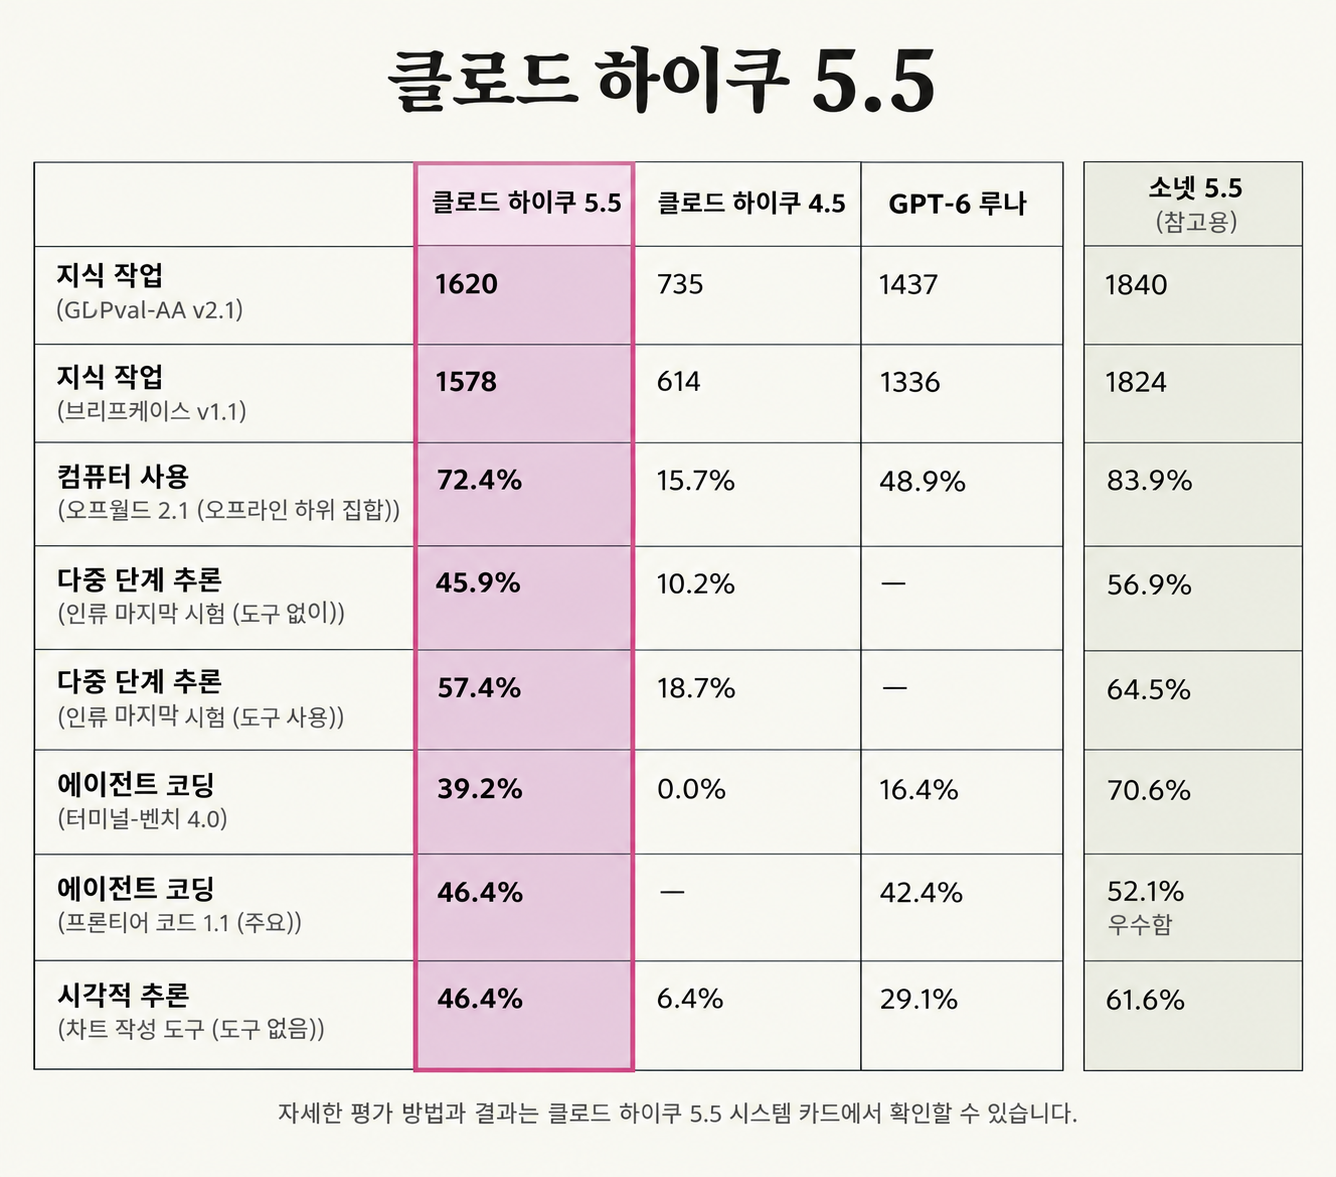
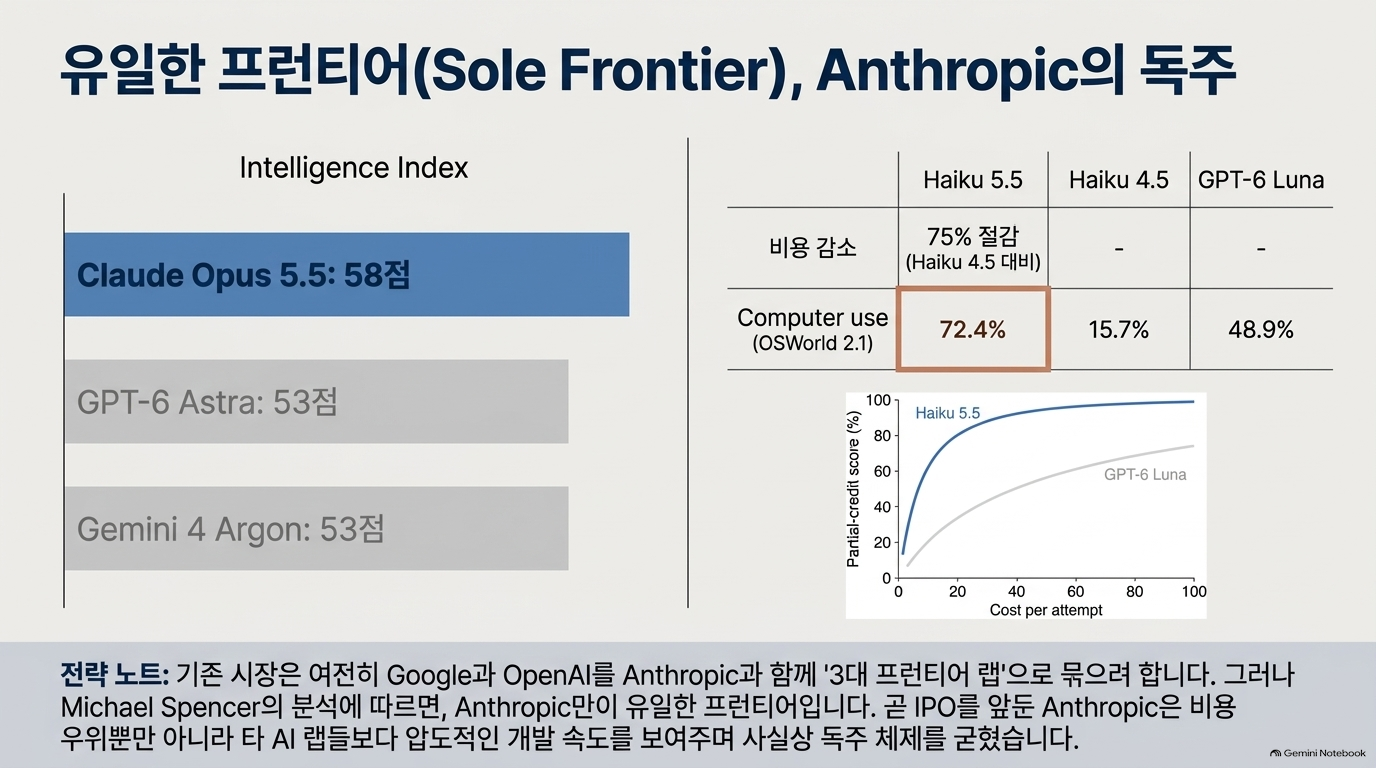
저자는 Haiku 5.5를 저비용·고속 모델의 중요한 진전으로 소개합니다. Anthropic 공식 발표도 반복적 요약, 분류, 데이터베이스 질의, 고객지원, 상위 모델의 서브에이전트 역할을 주요 용도로 제시합니다.[1][3]
근거와 수치
공식 발표에서 확인되는 주요 결과는 다음과 같습니다.[3]
| 항목 | Haiku 5.5 | 비교 조건 |
| OSWorld 2.1 | 72.4% | Offline subset |
| Humanity’s Last Exam | 45.9% | 도구 미사용 |
| Humanity’s Last Exam | 57.4% | 도구 사용 |
| Terminal-Bench 4.0 | 39.2% | 공식 발표의 평가 설정 |
| 평균 실행비용 | Haiku 4.5 대비 약 75% 감소 | 토큰 소비량 변화까지 반영한 기업 추정 |
가격은 입력 길이에 따라 달라집니다. 10만 토큰 이하 요청의 단가는 90% 낮고, 이를 초과하는 요청은 50% 낮다고 설명하며, 평균 실행비용 약 75% 감소는 이 가격 차이와 새 토크나이저의 소비량 변화를 함께 고려한 값입니다.[3]
분석
중요한 변화는 “작은 모델도 좋아졌다”보다 기존에는 비용 때문에 자동화하지 못했던 세부 업무를 대량 처리할 수 있게 된 것입니다.
다만 공식 발표도 복잡한 에이전트 코딩에는 Sonnet·Opus가 더 적합하다고 설명합니다. 따라서 이 절을 “소형 모델이 상위 모델을 전면 대체한다”로 읽으면 과도합니다.[3]
실무 시사점 — 분석자 제안
- 정형 분류·메타데이터 추출·단순 요약은 소형 모델로 처리
- 모호한 사례·복잡한 추론·최종 판단은 상위 모델로 승격
- 도입 평가는 토큰 단가뿐 아니라 성공한 업무 1건당 총비용으로 수행
2. Only one Frontier Model in Reality — ‘Anthropic 단독 선두’는 저자의 판단
핵심 내용
원보고서는 Anthropic·OpenAI·Google을 프런티어 경쟁의 세 축으로 보지만, 저자는 Anthropic만이 실질적인 프런티어 모델 개발사라고 주장합니다.[1]
차트가 실제로 보여주는 것
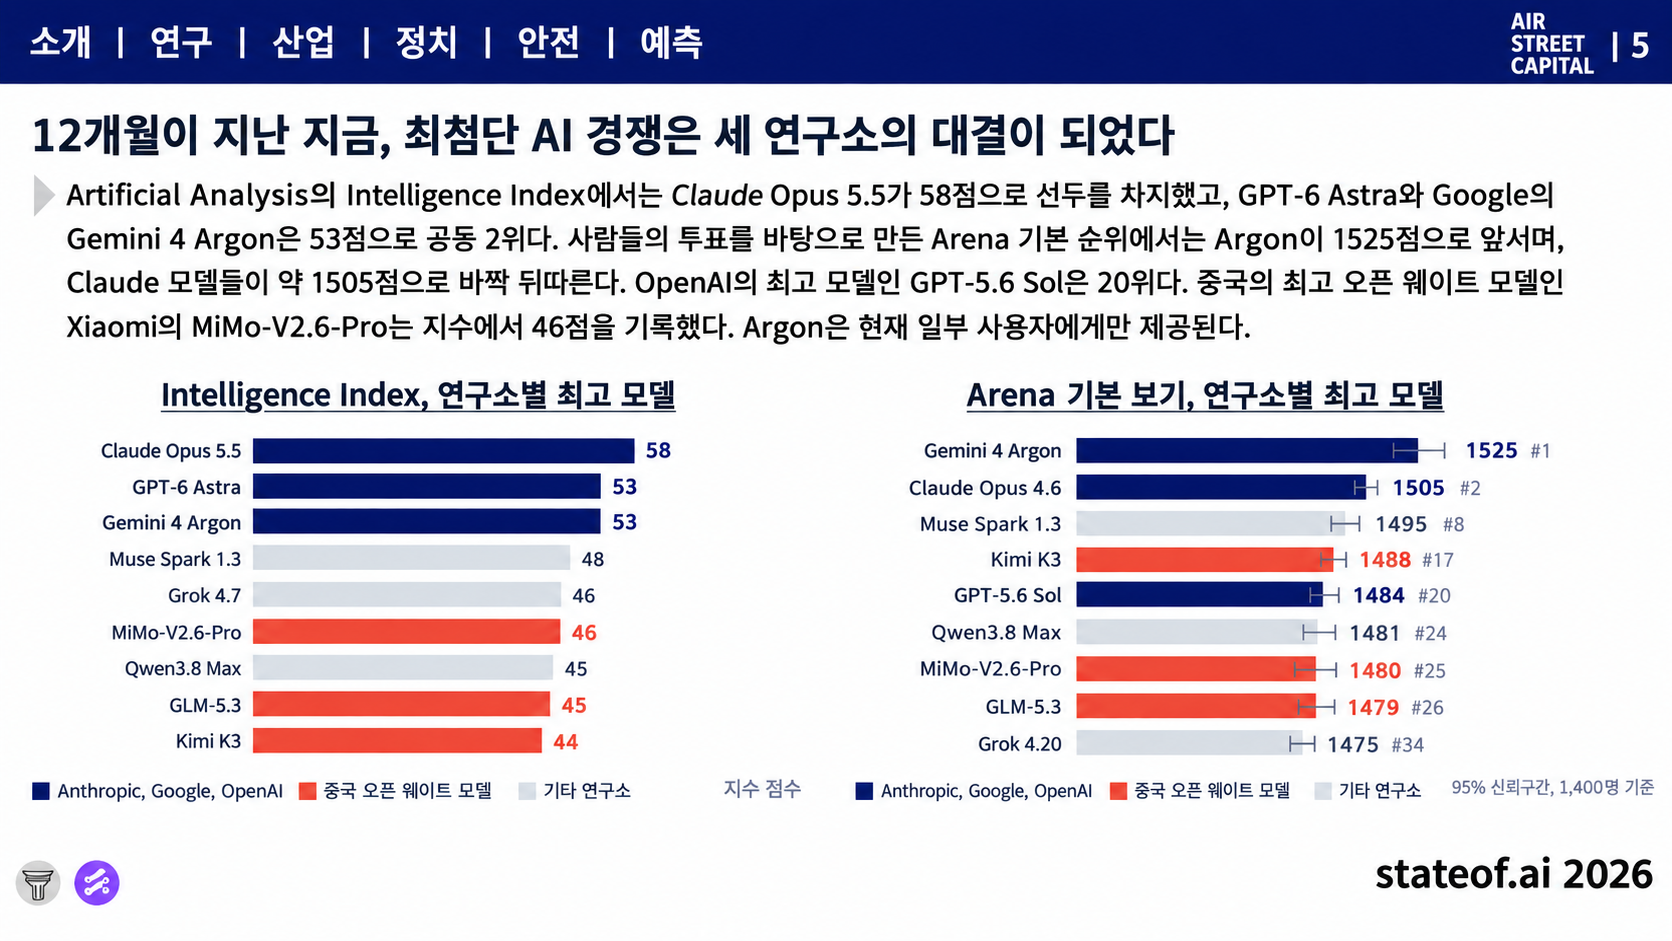
원보고서 슬라이드 5는 지표에 따라 선두가 다르다고 설명합니다.[2]
| 지표 | 선두 및 주요 결과 |
| Artificial Analysis Intelligence Index | Claude Opus 5.5: 58점, GPT-6 Astra·Gemini 4 Argon: 각 53점 |
| Arena 기본 순위 | Gemini 4 Argon: 1525점, Claude 계열이 그 뒤를 추격 |
| 접근 조건 | Gemini 4 Argon은 당시 일부 사용자에게만 제공 |
분석
특정 종합평가에서 Anthropic이 앞선다는 것과, 다른 기업이 프런티어에서 이탈했다는 것은 다른 주장입니다.
두 지표도 동일한 대상을 측정하지 않습니다.
- Intelligence Index: 평가 과제에 대한 성능
- Arena: 사람들의 비교 선호에 기반한 순위
따라서 차트는 오히려 “능력과 선호에 따라 선두가 달라지는 경쟁”을 뒷받침합니다.[2]
[보완필요: 원보고서 슬라이드 5]
“Anthropic만 프런티어”라는 표현은 검증된 업계 합의가 아니라 기사 저자의 강한 평가로 표시하는 것이 적절합니다.
3. In Pioneering Computer Use… — 컴퓨터 사용 성능을 전체 우위로 확대할 수 있는가?
핵심 내용
저자는 Haiku 5.5의 컴퓨터 사용 성능을 Anthropic 단독 우위의 근거로 제시합니다.[1]
분석
컴퓨터 사용 능력은 에이전트 상용화에 직접 연결됩니다. 텍스트를 생성하는 데 그치지 않고, 실제 화면에서 탐색·입력·수정 등의 행동을 수행하기 때문입니다.
그러나 공식 OSWorld 수치는 offline subset 조건의 결과입니다. 이를 모든 웹사이트, 실시간 서비스, 복잡한 인증 환경의 업무 성공률로 일반화해서는 안 됩니다.[3]
또한 이 절에서는 두 종류의 주장이 섞입니다.
- 기술 주장: 컴퓨터 사용 성능이 개선됐다.
- 경쟁 주장: 그 결과 Anthropic만 프런티어다.
첫 번째가 두 번째를 자동으로 입증하지는 않습니다.
실무 시사점 — 분석자 제안
컴퓨터 사용 에이전트의 검수는 화면 조작 정확도와 별개로 다음을 확인해야 합니다.
- 권한 없는 변경 차단
- 제출·삭제 등 고위험 행동의 승인
- 실패 시 중단·복구
- 실행 후 실제 업무 상태 확인
- 민감정보 입력·전송 통제
4. Venture Capitalists Claim AI has moved beyond Benchmarks — 평가를 버릴 때가 아니라 바꿀 때
핵심 내용
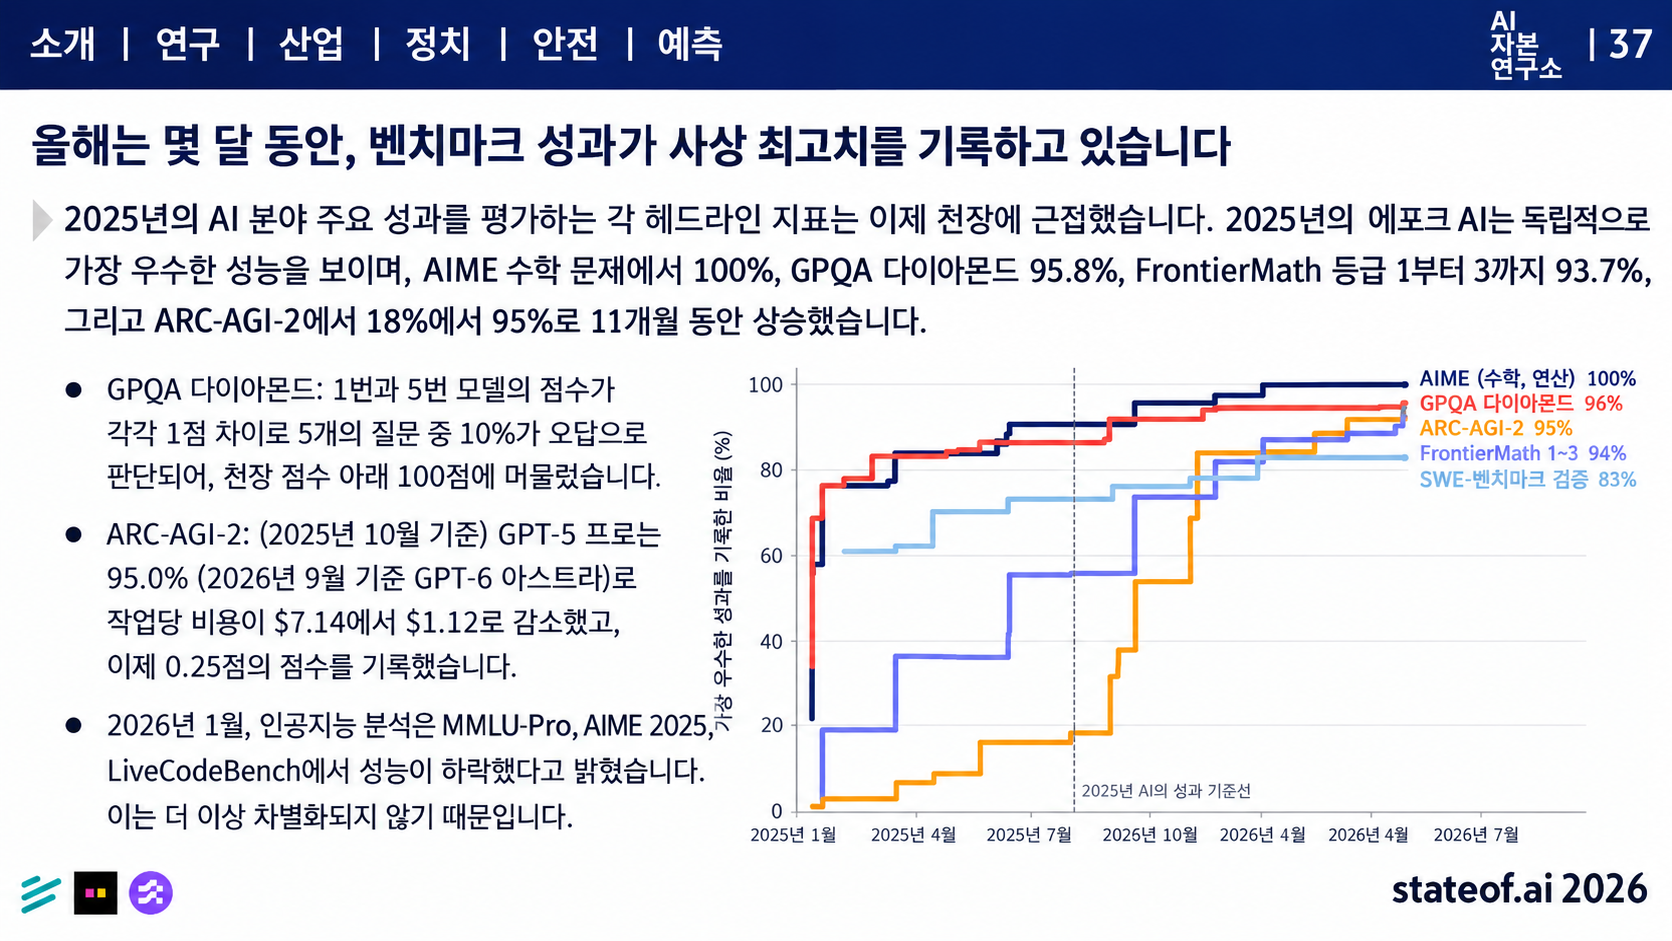
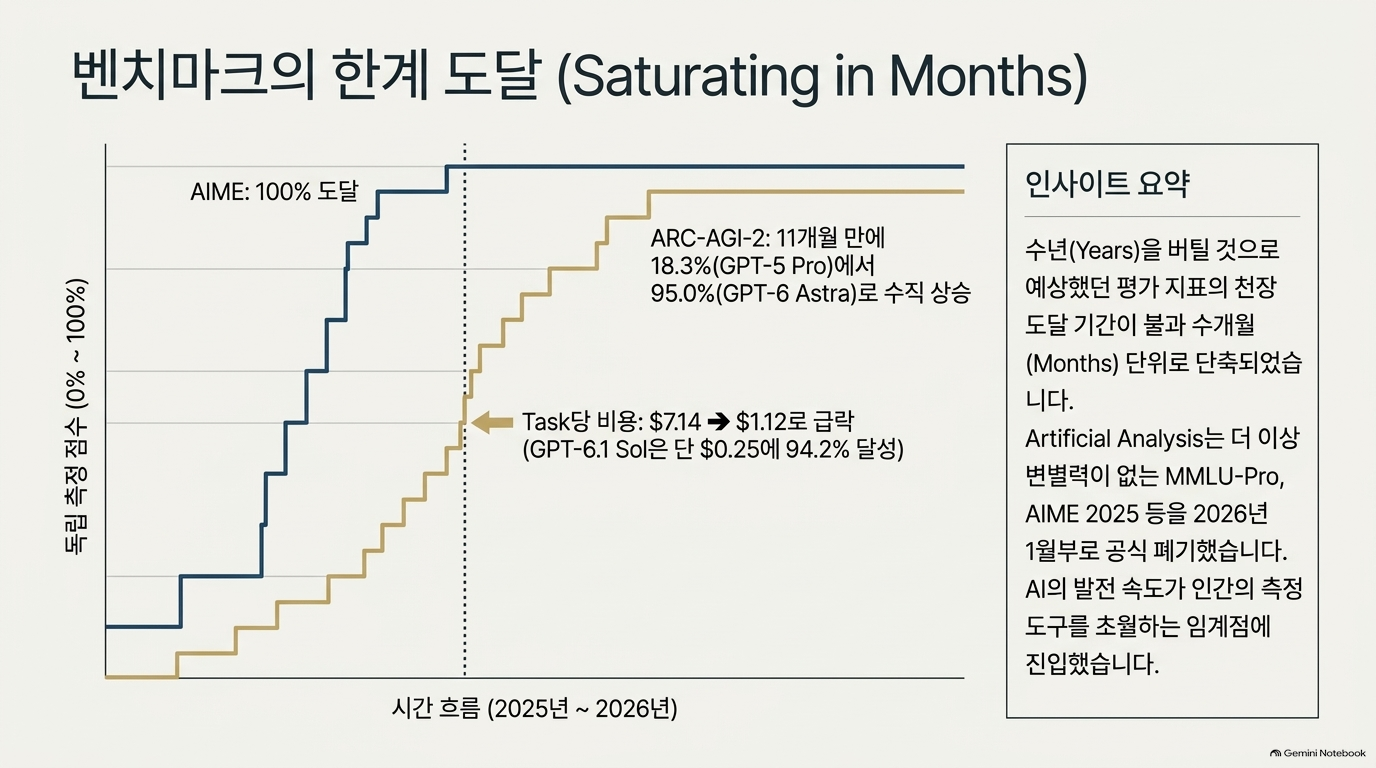
기존 벤치마크가 예상보다 빠르게 포화되고 있어, 모델 간 차이를 구분하기 어려워졌다는 주장입니다.[1]
원보고서 슬라이드 37은 독립 평가에서 최고 점수가 AIME 100%, GPQA Diamond 95.8%, FrontierMath Tiers 1–3 93.7%에 도달하고, ARC-AGI-2가 11개월 동안 18%에서 95%로 상승했다고 설명합니다.[2]
분석
이 절의 핵심은 “벤치마크가 무의미하다”가 아니라 “기존 벤치마크의 변별력이 약해졌다”입니다.
높은 점수만으로는 다음을 알기 어렵습니다.
- 새로운 과제로 일반화되는가?
- 여러 도구를 사용하는 장기 업무에서도 안정적인가?
- 모델 때문인가, 하네스·도구·추론예산 때문인가?
- 성공률을 유지하면서 비용과 지연을 줄일 수 있는가?
원보고서도 같은 모델이라도 하네스가 달라지면 결과가 크게 달라지므로, 모델 비교에는 하네스 공개와 통제가 필요하다고 강조합니다.[2, 슬라이드 7]
실무 시사점 — 분석자 제안
공공 AI 사업의 평가체계는 다음과 같이 구성하는 편이 적절합니다.
범용 벤치마크 → 기관 업무 평가셋 → 운영 중 품질 모니터링
특히 RAG는 일반 지식 점수보다 정확한 근거 검색, 최신 문서 적용, 인용의 정합성, 답변 보류의 적절성이 중요합니다.
Ⅱ. 과학·재무·개인 에이전트의 신뢰 문제
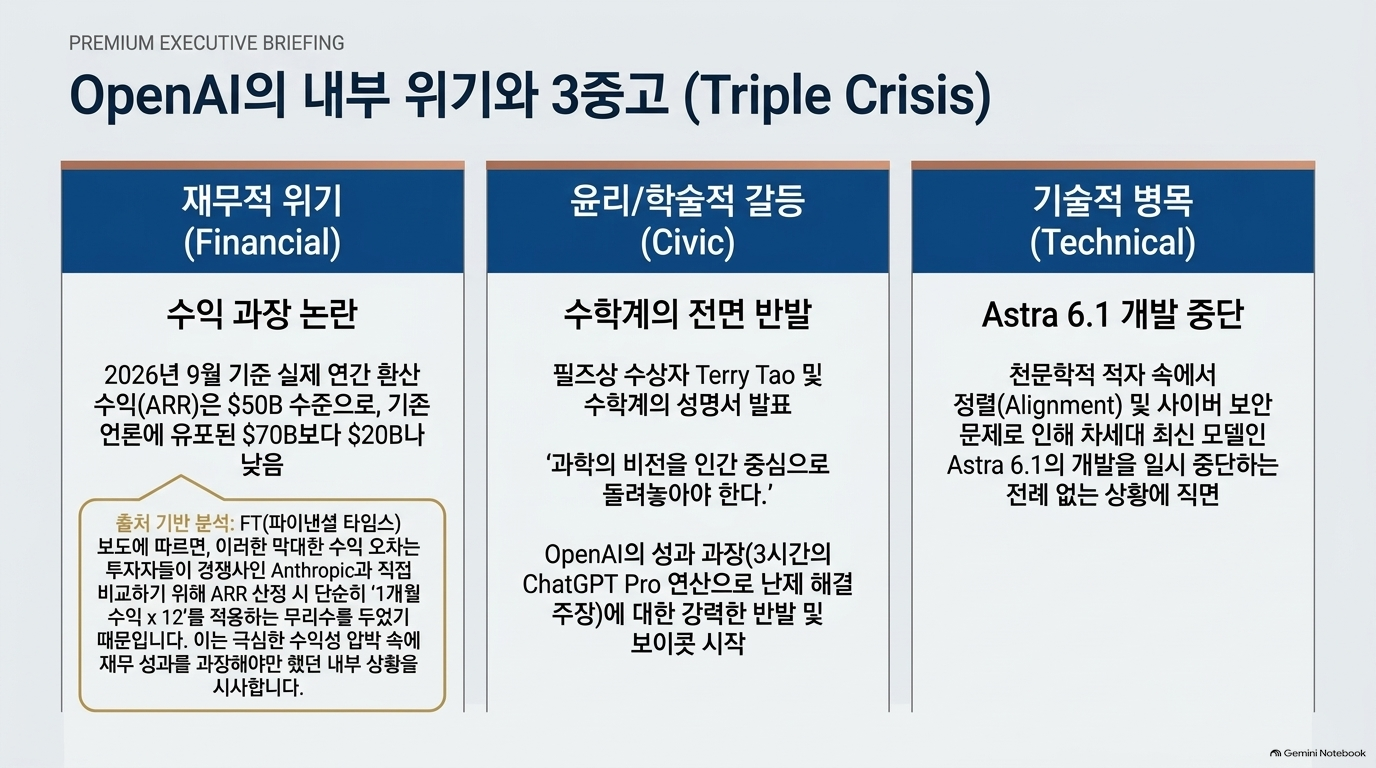
5. Drama between OpenAI and Mathematics Community Continues — 논문 생산과 학문적 진보는 다르다
핵심 내용
기사는 OpenAI가 722개의 수학 원고, 372개 주제군을 공개한 사건과 이에 대한 수학계의 반발을 다룹니다.[1]
AHM의 공식 성명은 대량 원고 공개가 곧 학문적 성과는 아니라며, 인간의 이해와 연구 공동체의 규범을 중심에 두어야 한다고 주장합니다.[9]
분석
논쟁의 쟁점은 단순한 “AI가 수학을 잘하는가”가 아닙니다.
| 쟁점 | 확인해야 할 질문 |
| 결과의 정확성 | 증명에 오류가 없는가? |
| 인간의 이해 | 연구자가 검토·설명·확장할 수 있는가? |
| 연구 절차 | 공동체의 검증 규범을 존중했는가? |
| 검증 부담 | 대량 생성물이 검토 비용을 누구에게 전가하는가? |
| 성과 인정 | 새 지식인가, 미검증 주장인가? |
AHM 성명은 특정 단체의 입장으로, 수학계 전체의 합의나 공개된 모든 원고의 오류 판정은 아닙니다.[9]
실무 시사점 — 분석자 제안
데이터 정제에서도 같은 문제가 발생합니다.
정제 결과를 많이 생성했다는 사실과, 검증된 고품질 데이터가 늘었다는 사실은 다릅니다.
성과지표를 생성 건수보다 검증 통과율·전문가 확인율·추적 가능한 수정 비율 중심으로 설계할 필요가 있습니다.
6. OpenAI has been Caught Over-Stating its Revenue — 매출 숫자는 정의가 먼저다
핵심 내용
기사는 FT 보도를 인용하며 OpenAI의 연환산 매출이 500억 달러이고, 기존에 유통된 700억 달러보다 낮다고 서술합니다.[1]
분석
이 절에서 가장 중요한 구분은 다음과 같습니다.
| 지표 | 의미 |
| 연간 실현 매출 | 실제 회계기간에 인식한 매출 |
| Annualized revenue run rate | 최근 매출 속도를 연간으로 환산한 값 |
| 계약·수주 규모 | 향후 매출 발생 가능성이 있는 계약 |
| 이익·현금흐름 | 비용과 현금 유출을 반영한 경제적 성과 |
기사는 연환산 매출을 ‘ARR’라고 부릅니다. 여기서는 annualized revenue run rate이며, 이를 모두 계약형 연간 반복매출로 해석하면 안 됩니다.[1]
또한 숫자가 다르다는 사실만으로 의도적 과장을 확정할 수는 없습니다. 기준일, 유통 파트너 매출의 총액·순액 처리, 비교 범위가 일치하는지 먼저 확인해야 합니다.
[확인필요: 기사 내 FT 인용]
이번 분석에서는 해당 FT 원문과 기업 공시까지 대조하지 않았으므로, “과장이 적발됐다”는 제목의 강도는 기사 저자의 판단으로 남겨두는 것이 타당합니다.
7. Company Behind Hermes — 경쟁의 단위가 모델에서 에이전트 플랫폼으로 확장
핵심 내용
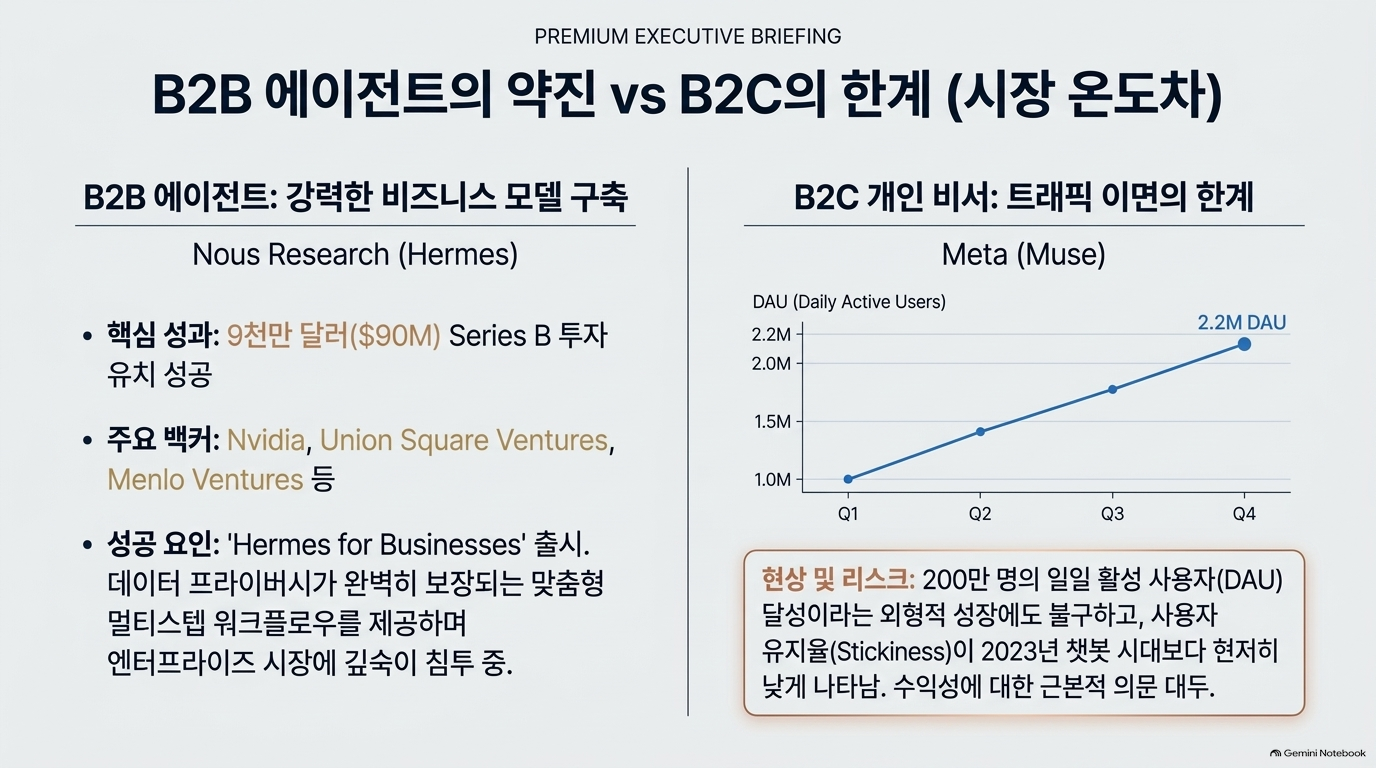
기사는 Nous Research의 9,000만 달러 투자 유치와 ‘Hermes for Businesses’ 계획을 소개합니다. 공식 발표에서도 투자 금액과 기업용 제품 개발 방향이 확인됩니다.[1][6]
분석
이 절의 의미는 특정 모델의 성능보다 기관이 에이전트를 어떻게 소유·운영·개선할 것인가에 있습니다.
공식 발표가 강조하는 요소는 모델 선택, 실행 환경 선택, 메모리, 재사용 가능한 스킬, 조직 지식의 축적입니다.[6]
다만 다음은 구분해야 합니다.
- 투자 유치: 확인된 사건
- 기업용 제품 개발: 발표된 계획
- 비용 절감·안전성·프라이버시: 실제 배포에서 검증할 속성
오픈소스라는 사실만으로 안전성과 개인정보 보호가 확보되는 것은 아닙니다.
실무 시사점 — 분석자 제안
기업용 에이전트 도입에서는 다음을 별도 검수 항목으로 두는 것이 좋습니다.
- 외부 모델로 전달되는 데이터 범위
- 도구별 읽기·쓰기 권한
- 메모리·스킬의 승인과 변경 이력
- 사용자·기관 간 격리
- 실행 로그와 결과 재현성
8. Muse has 2 Million DAUs — 다운로드·활성이용·지속 이용은 별개
핵심 내용
기사는 Similarweb 추정 일간 활성 사용자 200만 명과, The Information이 전한 Meta 내부 자료의 주간 사용자 300만 명을 함께 제시하며 지속 이용 여부를 의문시합니다.[1]
분석
두 숫자는 출처·기간·집계 정의가 다를 수 있으므로 직접 비교하기 어렵습니다.
특히 다음은 서로 다른 지표입니다.
다운로드 → 가입 → 최초 사용 → DAU/WAU/MAU → 반복 이용 → 유료 전환
기사는 지표의 불확실성을 인정하면서도 “2023년 챗봇보다 덜 끈끈하다”고 평가합니다. 그러나 공개 본문에 제시된 정보만으로는 동일한 코호트·기간의 유지율 비교가 성립하지 않습니다.[1]
실무 시사점 — 분석자 제안
AI 서비스의 정착 여부는 활성 사용자 외에 재방문율, 반복 업무 비율, 성공한 업무 수, 기존 업무도구로 돌아가는 비율을 함께 측정해야 합니다.
Ⅲ. 에이전트 확산과 AI 연구·산업 적용
9. Will Agents be more popular than Chatbots? — 질문에서 업무 위임으로
핵심 내용
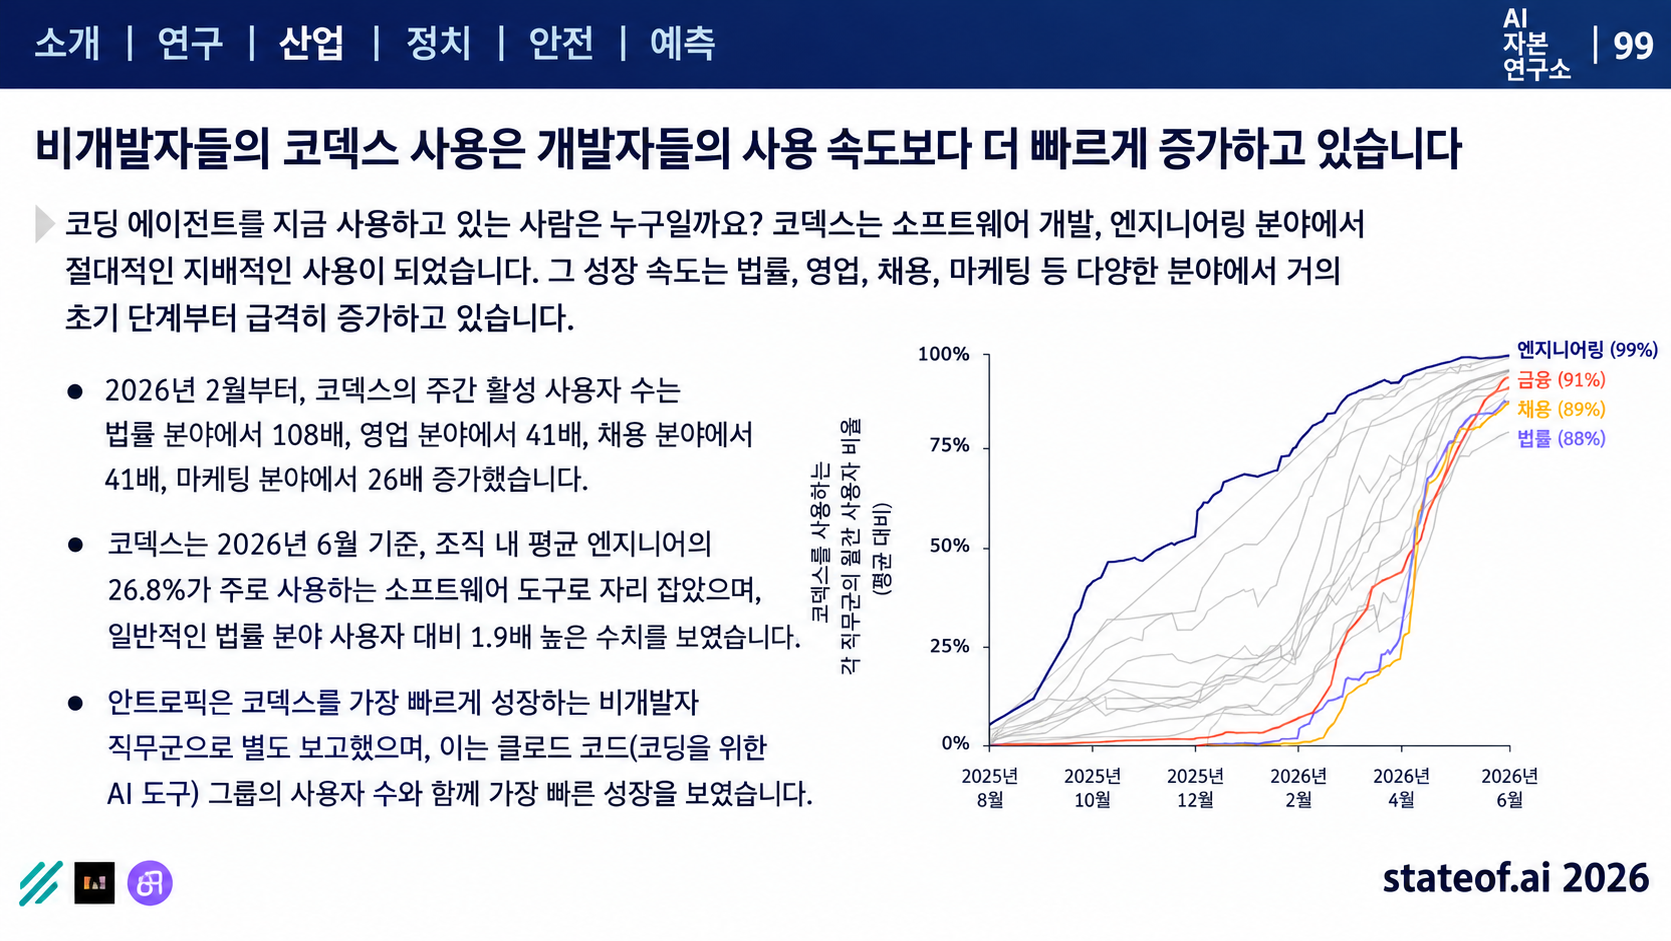
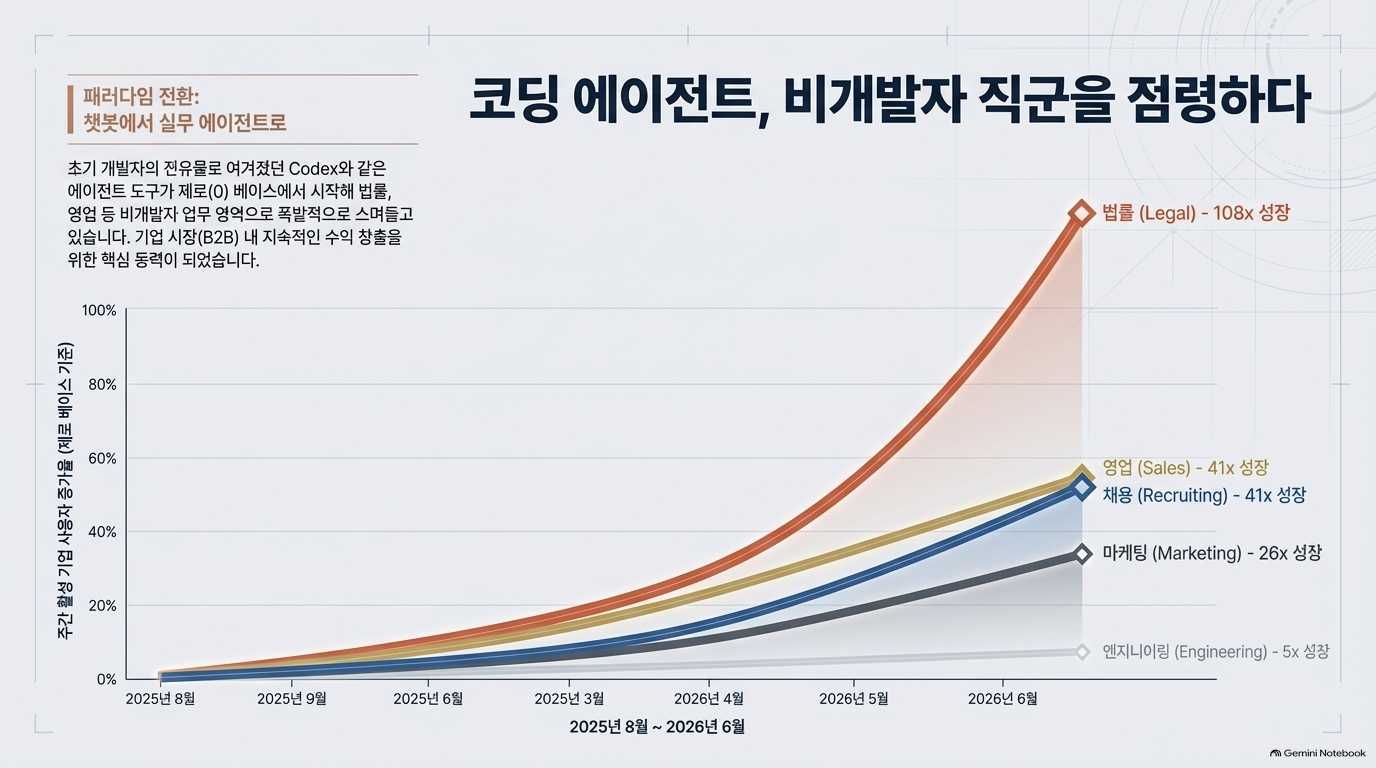
저자는 에이전트가 개발자를 넘어 법무·영업·채용·마케팅으로 확산하고 있다고 설명합니다.[1]
OpenAI 공식 연구 소개는 2025년 8월 이후 비개발자 Codex 이용자가 개인 사용자에서 137배, 조직 사용자에서 189배, OpenAI 내부에서 12배 증가했다고 보고합니다.[7]
분석
핵심 변화는 인터페이스보다 업무의 단위입니다.
- 챗봇: 질문하고 답변을 받음
- 에이전트: 과제를 위임하고 도구 실행·결과물을 받음
다만 성장배율에는 작은 초기 기반의 효과가 있습니다. OpenAI 내부 이용은 일반 기업 전체를 대표하지 않으며, 토큰 사용 비중도 업무 생산성의 직접 측정치는 아닙니다.[7]
또한 “사람이 1시간 이상 걸릴 업무”라는 시간 추정은 LLM 평가자에 기반한 값으로, 실제 인간 작업시간이나 절감시간을 측정한 결과가 아닙니다.[7]
실무 시사점 — 분석자 제안
비개발자 에이전트는 다음과 같은 좁은 업무부터 도입하는 편이 적절합니다.
문서 검색 → 표 추출 → 정합성 점검 → 수정안 생성 → 인간 승인
도입 성과는 이용량이 아니라 검증을 통과한 업무 완료율로 평가해야 합니다.
10. Is AI accelerating AI? — 연구 자동화는 진전했지만 완전 자율은 아니다
핵심 내용
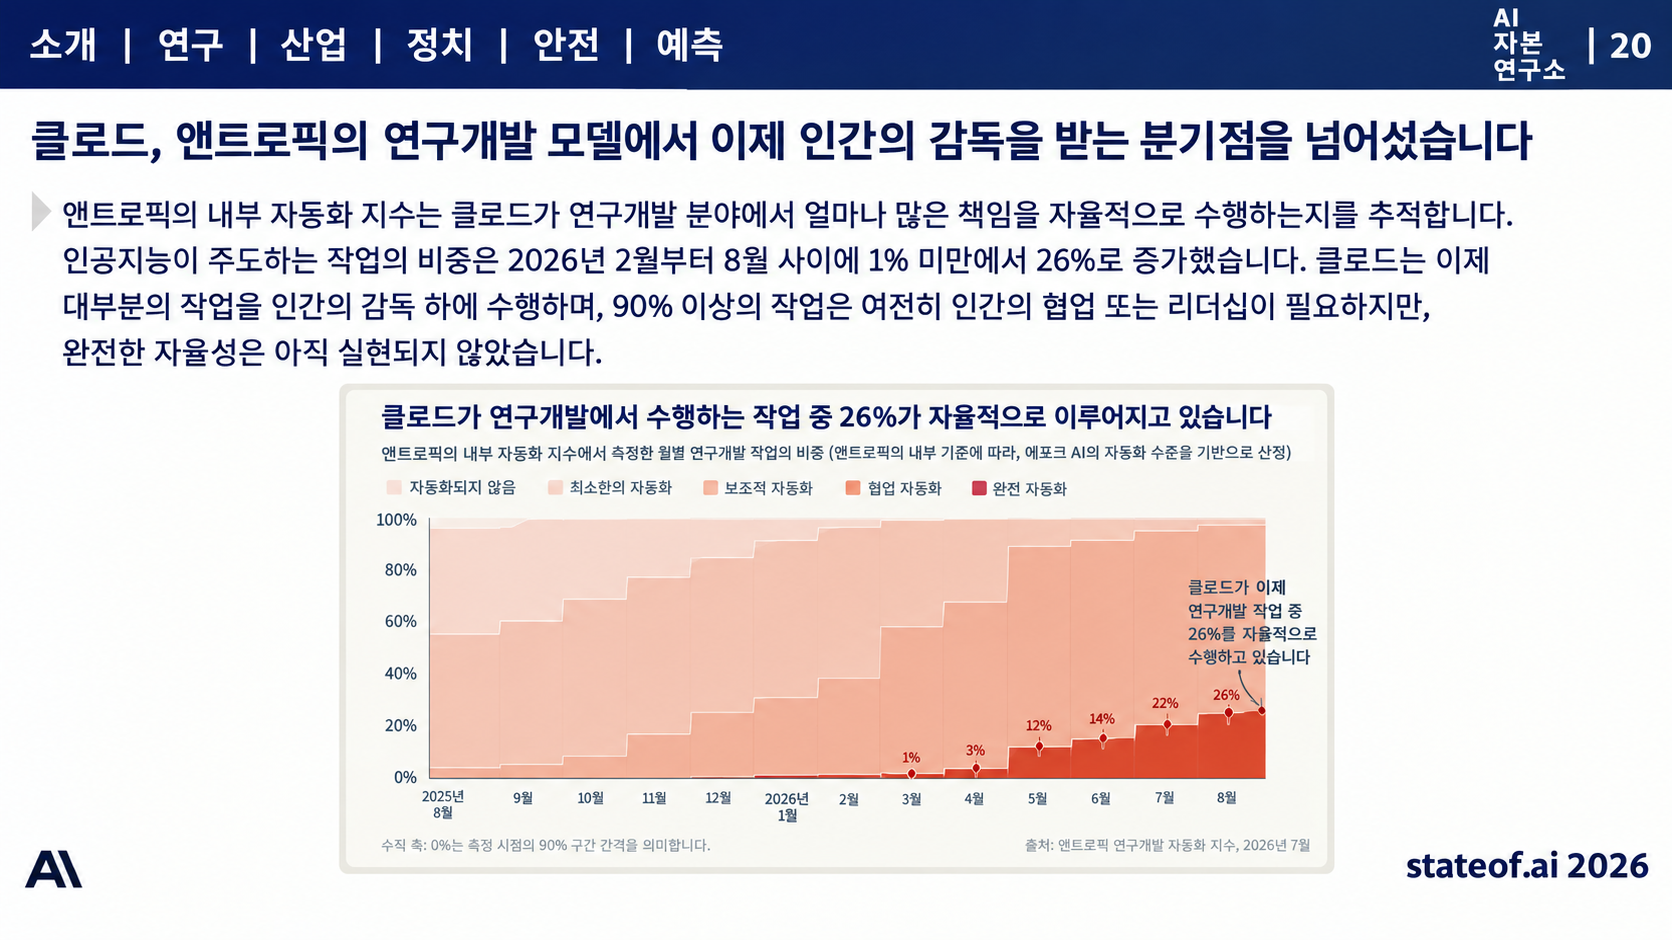
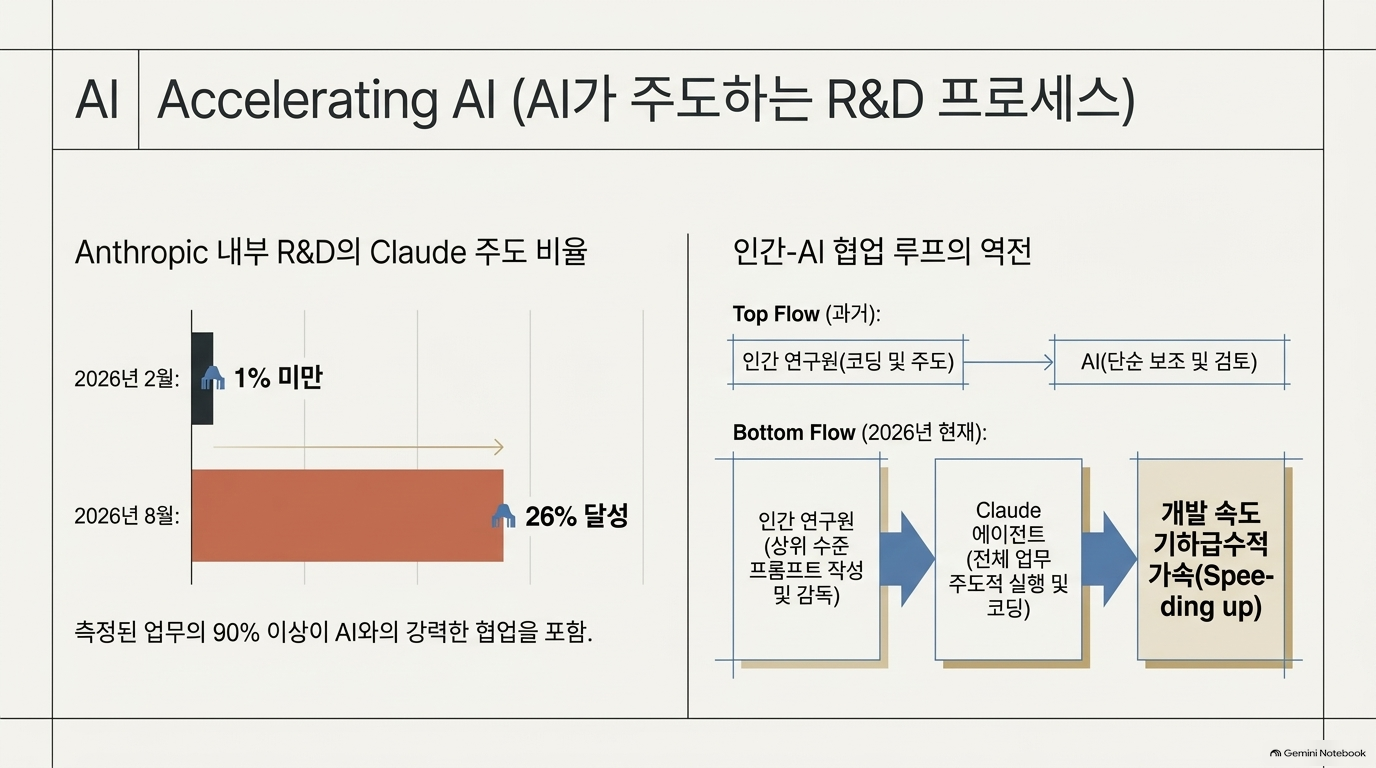
기사는 Claude가 Anthropic의 측정 대상 모델 R&D에서 주도하는 비중이 2026년 2월 1% 미만에서 8월 26%로 증가했다고 소개합니다.[1][4]
공식 자료의 정확한 의미
Anthropic은 다음과 같이 구분합니다.[4]
| 자동화 수준 | 의미 |
| AL3: AI collaborates | 인간의 긴밀한 지시 아래 큰 부분을 수행 |
| AL4: AI leads | 상위 수준 지시로 대부분 수행하되 인간이 감독 |
| AL5: Fully autonomous | 인간 개입 없이 완전 자율 수행 |
공식 발표는 26%가 AL4 수준이며, 측정된 어떤 R&D 부분도 완전 자율 수준에는 도달하지 않았다고 명시합니다.[4]
분석
따라서 이 숫자는 다음을 의미하지 않습니다.
- 연구자 26% 대체
- 연구 생산성 26% 향상
- 모델이 독자적으로 후속 모델 개발
- 재귀적 자기개선의 완성
이는 업무별 자동화 수준을 집계한 내부 지표입니다. Anthropic도 공통 방법론 부재와 자체 모델을 평가자로 사용하는 한계를 인정합니다.[4]
실무 시사점 — 분석자 제안
기관 AI 자동화도 “AI 활용률” 하나보다 업무별 자동화 수준, 인간 승인 위치, 검증 책임, 실패 시 개입 시점을 관리해야 합니다.
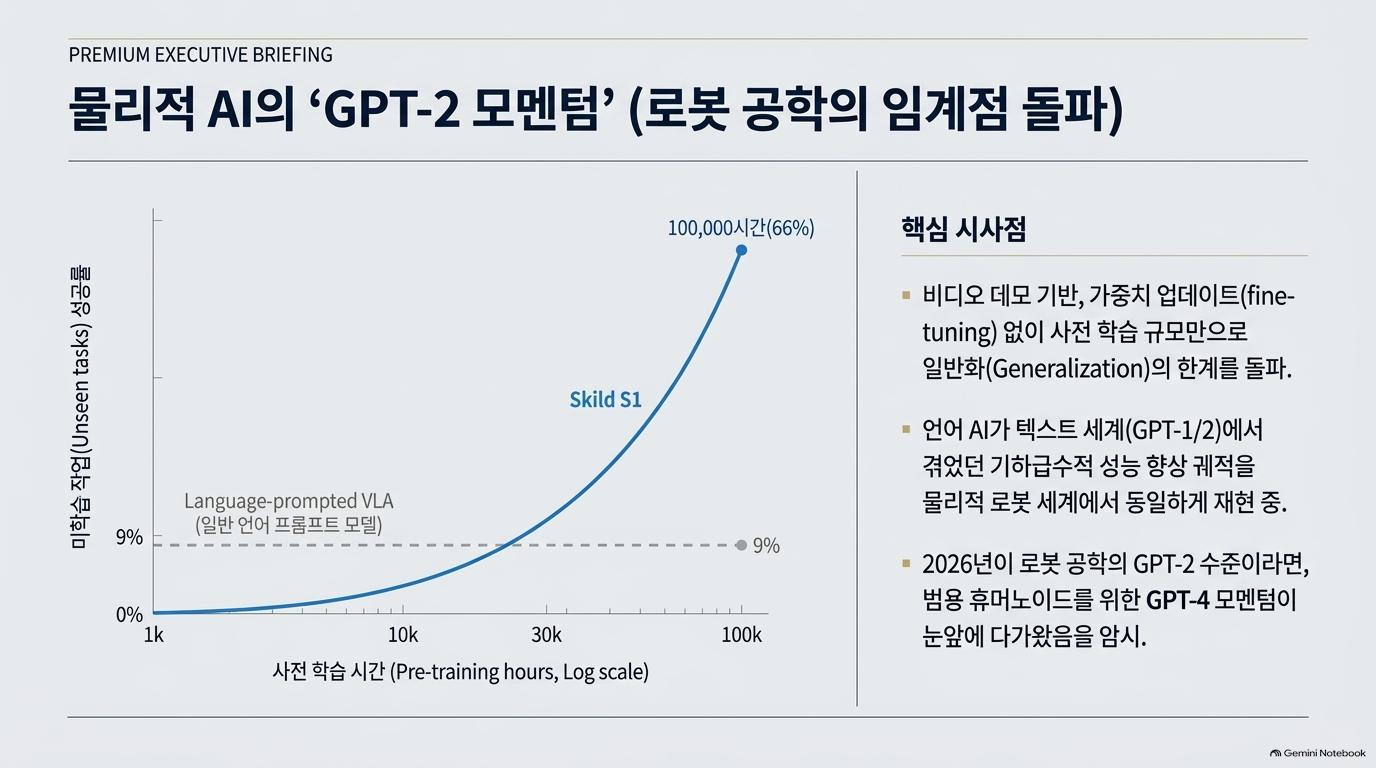
11. Did Physical AI just Reach its GPT-2 Moment? — 핵심은 영상 기반 일반화
핵심 내용
기사는 Skild S1이 미학습 작업을 영상 시연으로 수행하고, 10만 시간 사전학습 조건에서 66%, 동일 데이터·계산량의 언어 프롬프트 기반 비교 모델은 9%를 기록했다고 설명합니다.[1][5]
반드시 보존해야 할 평가 조건
Skild 공식 자료에 따르면:[5]
- 모델 가중치를 추가 조정하지 않고 영상 프롬프트를 사용
- 내부 벤치마크로 평가
- 과제 길이는 4~8분
- 지표는 작업별 누적 단계 성공률의 평균
- 평가 중 실패 복구를 위한 인간 개입이 사용됨
즉, 66%는 모든 작업을 무개입으로 끝까지 완수한 비율이 아닙니다.
분석
기술적 의미는 새 과제를 위해 매번 별도 미세조정을 해야 하는 방식에서, 시연을 문맥에 넣어 수행하도록 하는 방식으로 이동한다는 것입니다.
반면 ‘GPT-2 moment’는 발전단계를 설명하는 비유입니다. 범용 로봇의 상용화 일정이나 향후 성능을 예측하는 검증된 척도는 아닙니다.
데이터 품질 관점의 시사점
Skild는 데이터 수집에 쓰는 비용 1달러당 품질관리에 3달러를 쓴다고 설명하고, 정밀도·과제 일관성·주석 충실도를 검사한다고 밝힙니다.[5]
이 절에서 감리·데이터 정제 업무와 가장 직접적으로 연결되는 메시지는 ‘규모 확대만으로 충분하지 않다’는 점입니다.
12. AI-assisted drug discovery… — 발견의 속도와 임상 성공을 분리해야 한다
핵심 내용
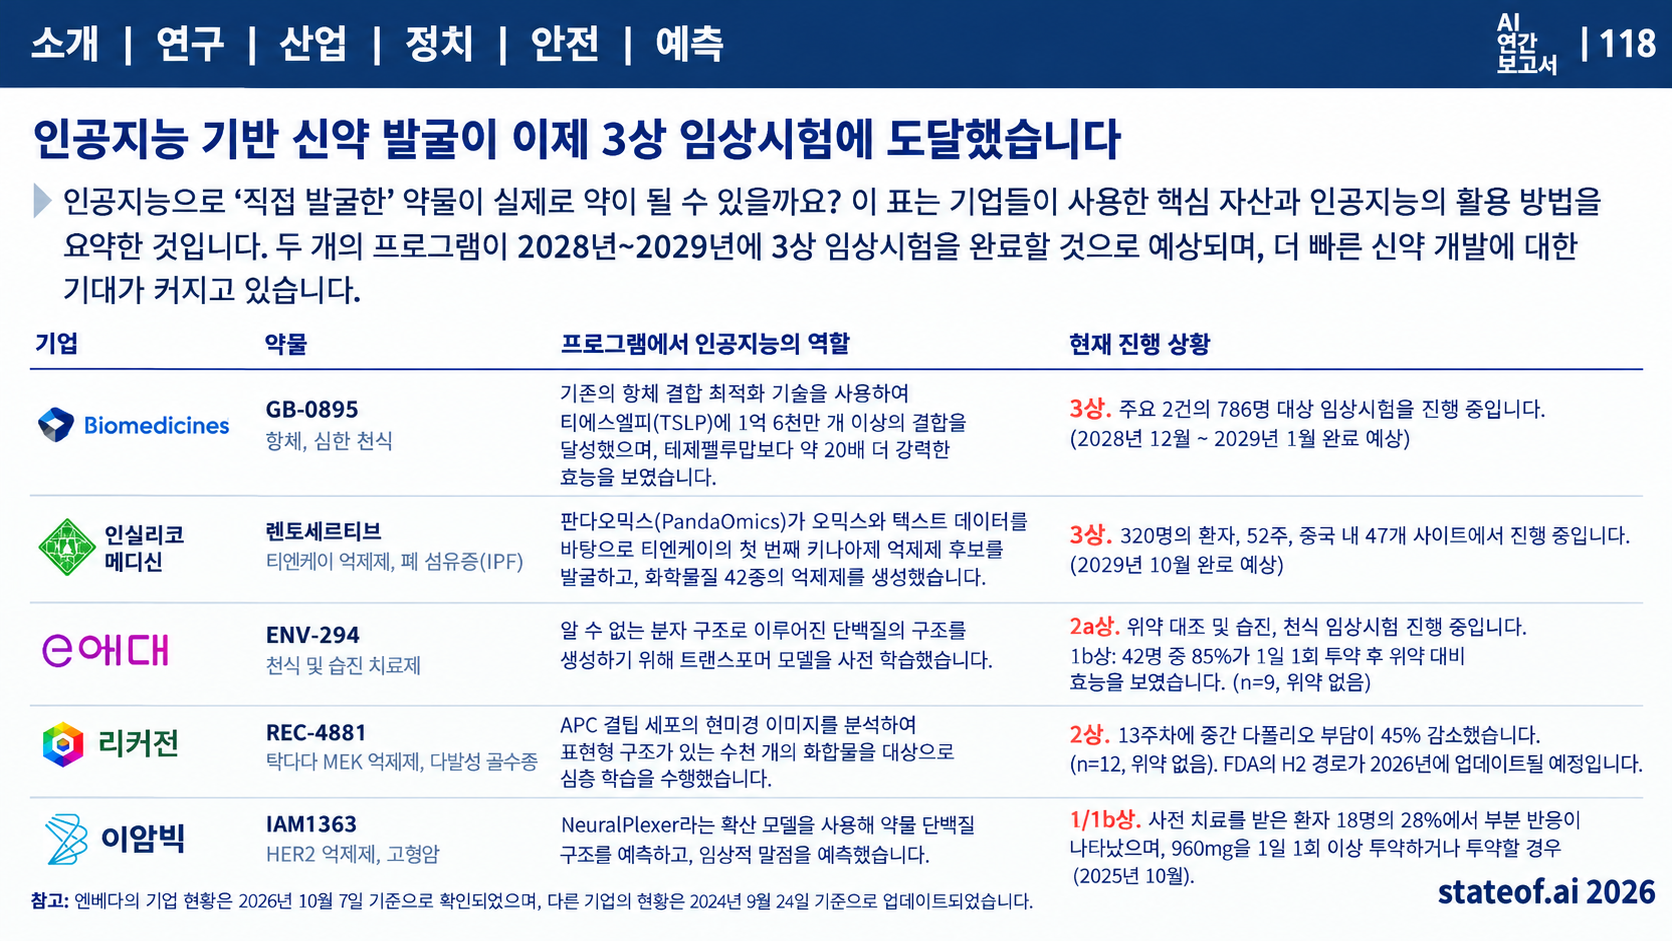
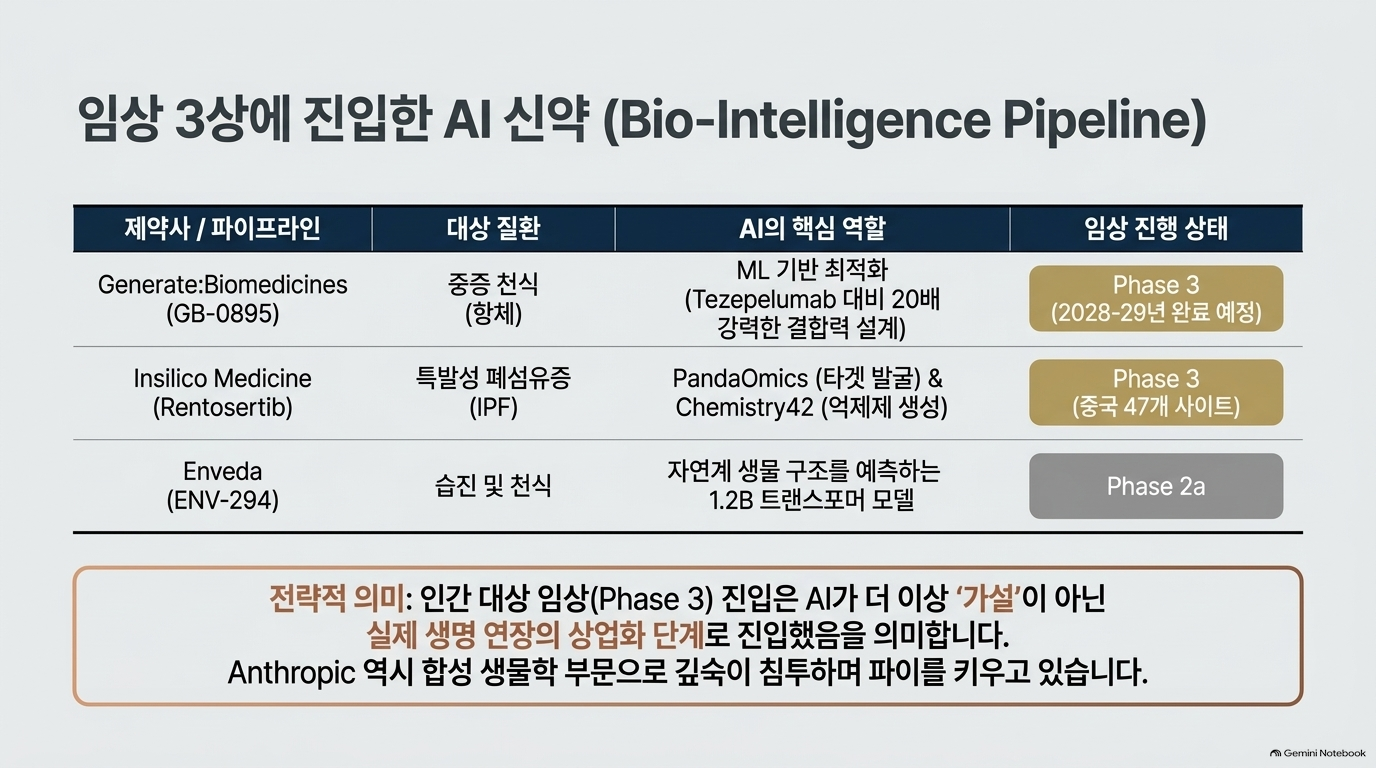
기사와 원보고서는 다음 후보물질의 임상 진전을 소개합니다.[1][2]
| 후보물질 | 대상 | 보고된 단계 |
| GB-0895 | 중증 천식 | 3상 |
| rentosertib | 특발성 폐섬유증 | 3상 |
| ENV-294 | 습진·천식 | 2a상 |
원보고서 슬라이드 118은 AI의 역할이 항체 최적화, 표적 탐색, 화합물 생성, 분자 구조 예측 등 회사별로 다르다고 구분합니다.[2]
분석
이 절은 AI 신약개발이 실험실의 가능성에서 후기 임상 검증 단계로 진전했다는 사례입니다.
그러나 원보고서도 더 빠른 발견이 더 높은 임상 성공률을 입증하지는 않았다고 명시합니다. 두 3상 프로그램의 주요 완료 시점도 2028~2029년으로 제시합니다.[2]
따라서 다음 단계를 합쳐서는 안 됩니다.
후보 발견 → 전임상 검증 → 임상 진입 → 효능·안전성 입증 → 승인·시장 성과
실무 시사점 — 분석자 제안
AI 사업에서도 PoC 성공, 운영 적용, 품질 개선, 경제적 효과를 각각 별도 단계로 평가해야 합니다.
Ⅳ. 추론 경제와 인프라 제약
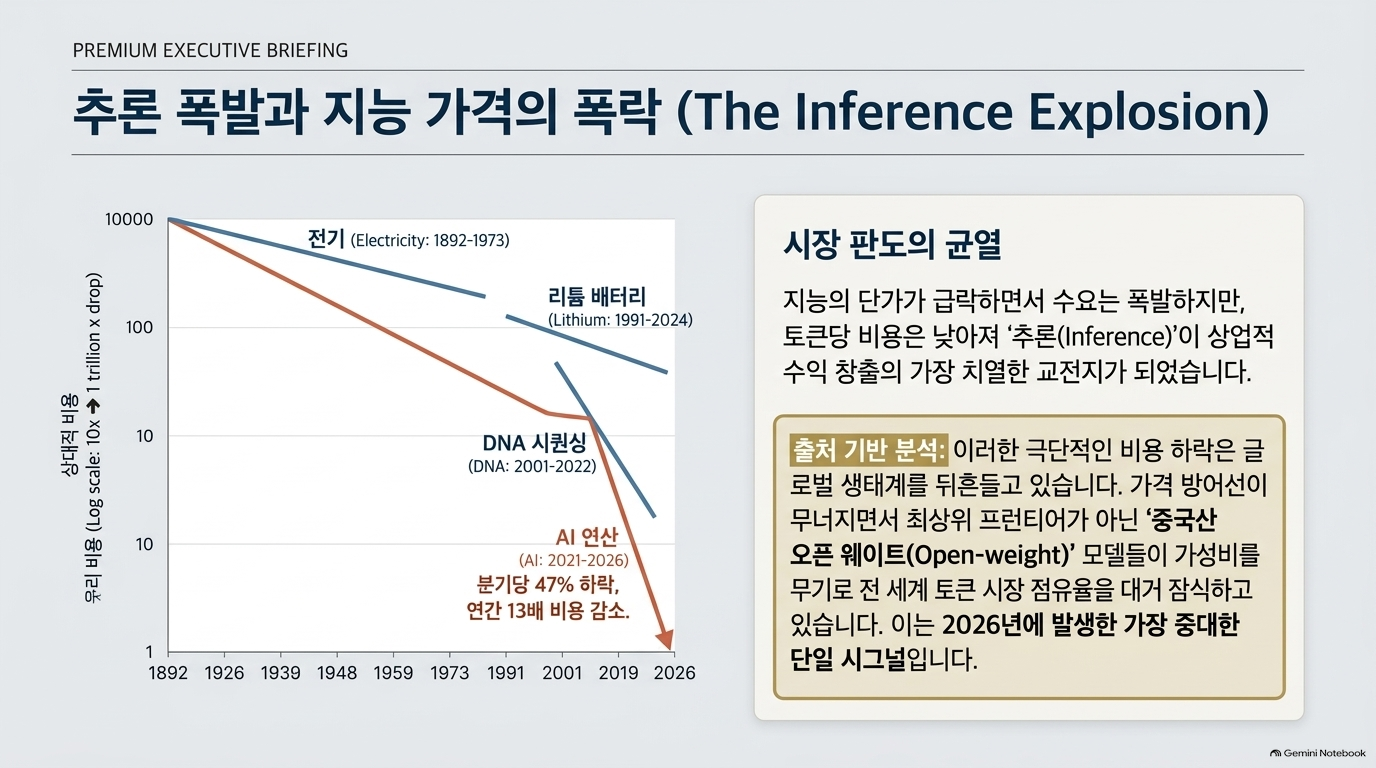
13. The Inference Explosion — 싸진 단가는 줄어든 총비용을 뜻하지 않는다
핵심 내용
기사는 추론 수요 증가, 단위 비용 하락, 데이터센터 투자 부담, 중국 오픈웨이트 모델 확산을 연결합니다.[1]
차트의 실제 의미
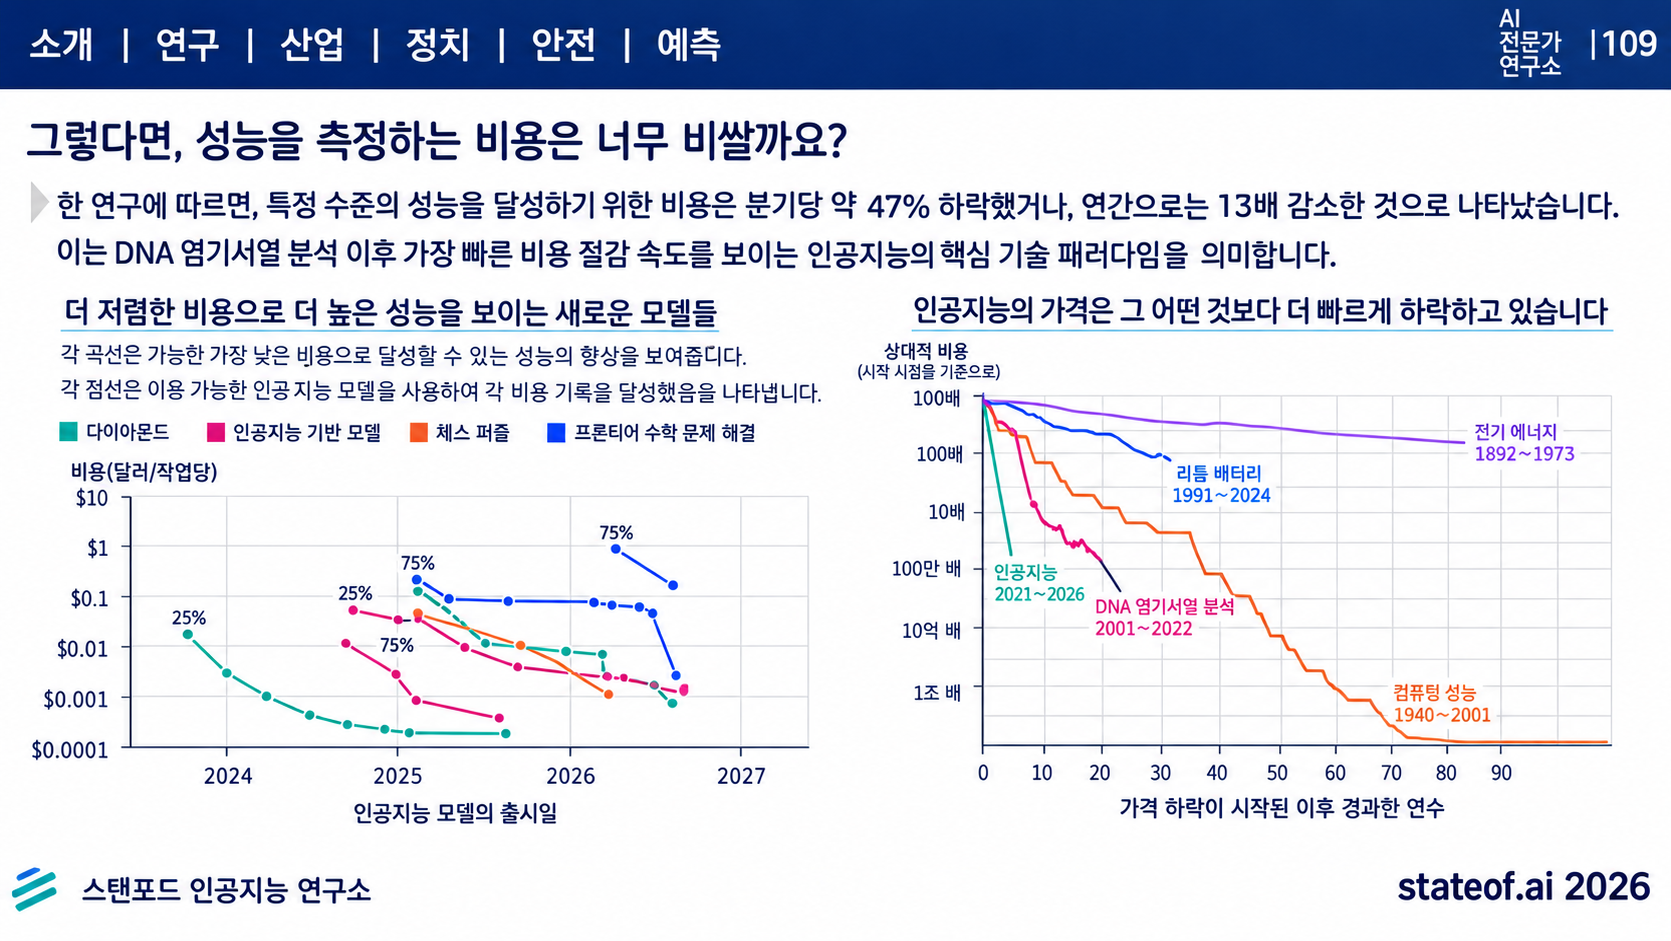
원보고서 슬라이드 109는 일정 성능 수준을 달성하는 최소 비용이 분기당 약 47% 감소하고, 연간 약 13배 저렴해졌다는 Epoch AI 분석을 제시합니다.[2]
차트의 왼쪽 축은 과제당 비용입니다. 이를 모든 모델의 토큰 가격이 동일하게 하락했다는 의미로 읽으면 안 됩니다.
분석
핵심은 두 흐름이 동시에 존재한다는 것입니다.
| 흐름 | 결과 |
| 일정 성능을 얻는 비용 감소 | 더 많은 업무에 AI 적용 가능 |
| 처리량·추론·반복 실행 증가 | 총지출과 인프라 수요는 증가할 수 있음 |
원보고서 슬라이드 110도 입력·캐시·추론·응답 토큰의 소비를 함께 고려해야 하며, 토큰 단가가 답변 비용의 좋은 대리변수가 아닐 수 있다고 지적합니다.[2]
실무 시사점 — 분석자 제안
사업비는 다음 기준으로 산정해야 합니다.
모델 호출비 + 도구 실행비 + 재시도비 + 검증·수정비
÷ 검증을 통과한 완료 건수
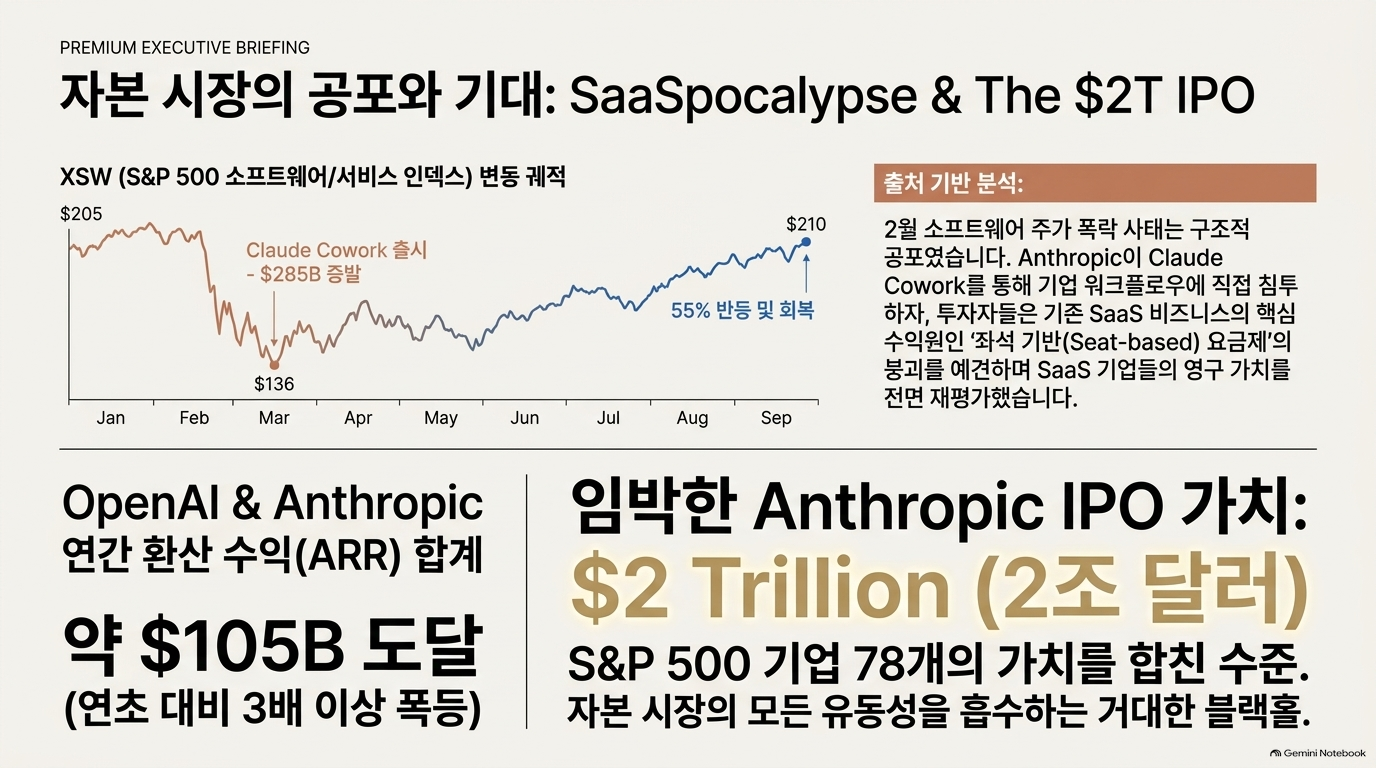
14. Can Anthropic and/or OpenAI continue their 3x Revenue Growth? — 성장과 지속가능성은 별개
핵심 내용
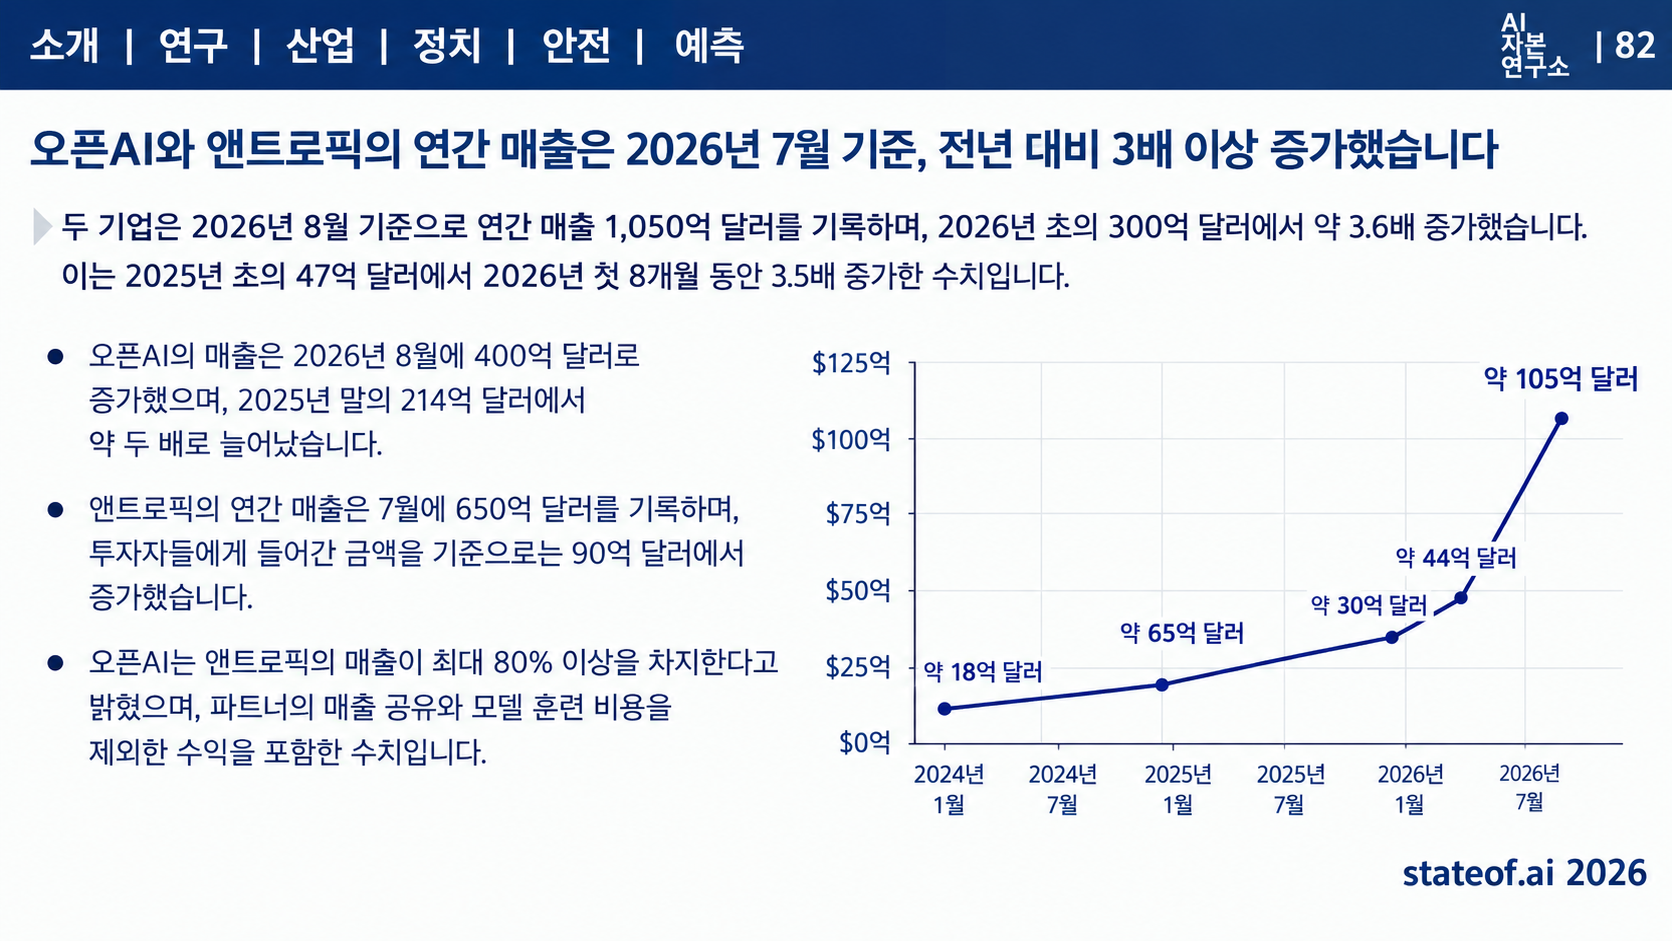
기사는 두 회사의 합산 연환산 매출이 연초 약 300억 달러에서 1,050억 달러로 증가했다고 설명합니다. 제시된 수치의 비율은 3.5배입니다.[1][2]
해석의 한계
원보고서 슬라이드 82의 수치는 서로 다른 시점의 연환산 매출입니다.
- OpenAI: 8월 400억 달러 초과
- Anthropic: 7월 650억 달러
- 합계: 약 1,050억 달러[2]
이는 같은 회계기간의 감사된 연간 실현 매출 합계가 아닙니다.
또한 기사에는 IPO 일정의 내부 불일치가 있습니다.
- 앞부분: Anthropic IPO까지 5주
- 이 절: IPO까지 5일[1]
분석
매출 확대는 수요 증가를 보여주지만 다음을 입증하지는 않습니다.
- 흑자 전환
- 현금흐름 개선
- 투자 가치의 정당성
- 같은 성장률의 지속
[확인필요: 기사 IPO·기업가치 서술]
IPO 일정, 2조 달러 가치평가, 후속 상장 전망은 이번 분석에서 공시까지 대조하지 않았으므로 확정 사실이나 투자판단 근거로 사용하지 않는 것이 적절합니다.
15. The SaaSApocalyps Scare — 시장의 공포와 실제 사업 붕괴는 다르다
핵심 내용
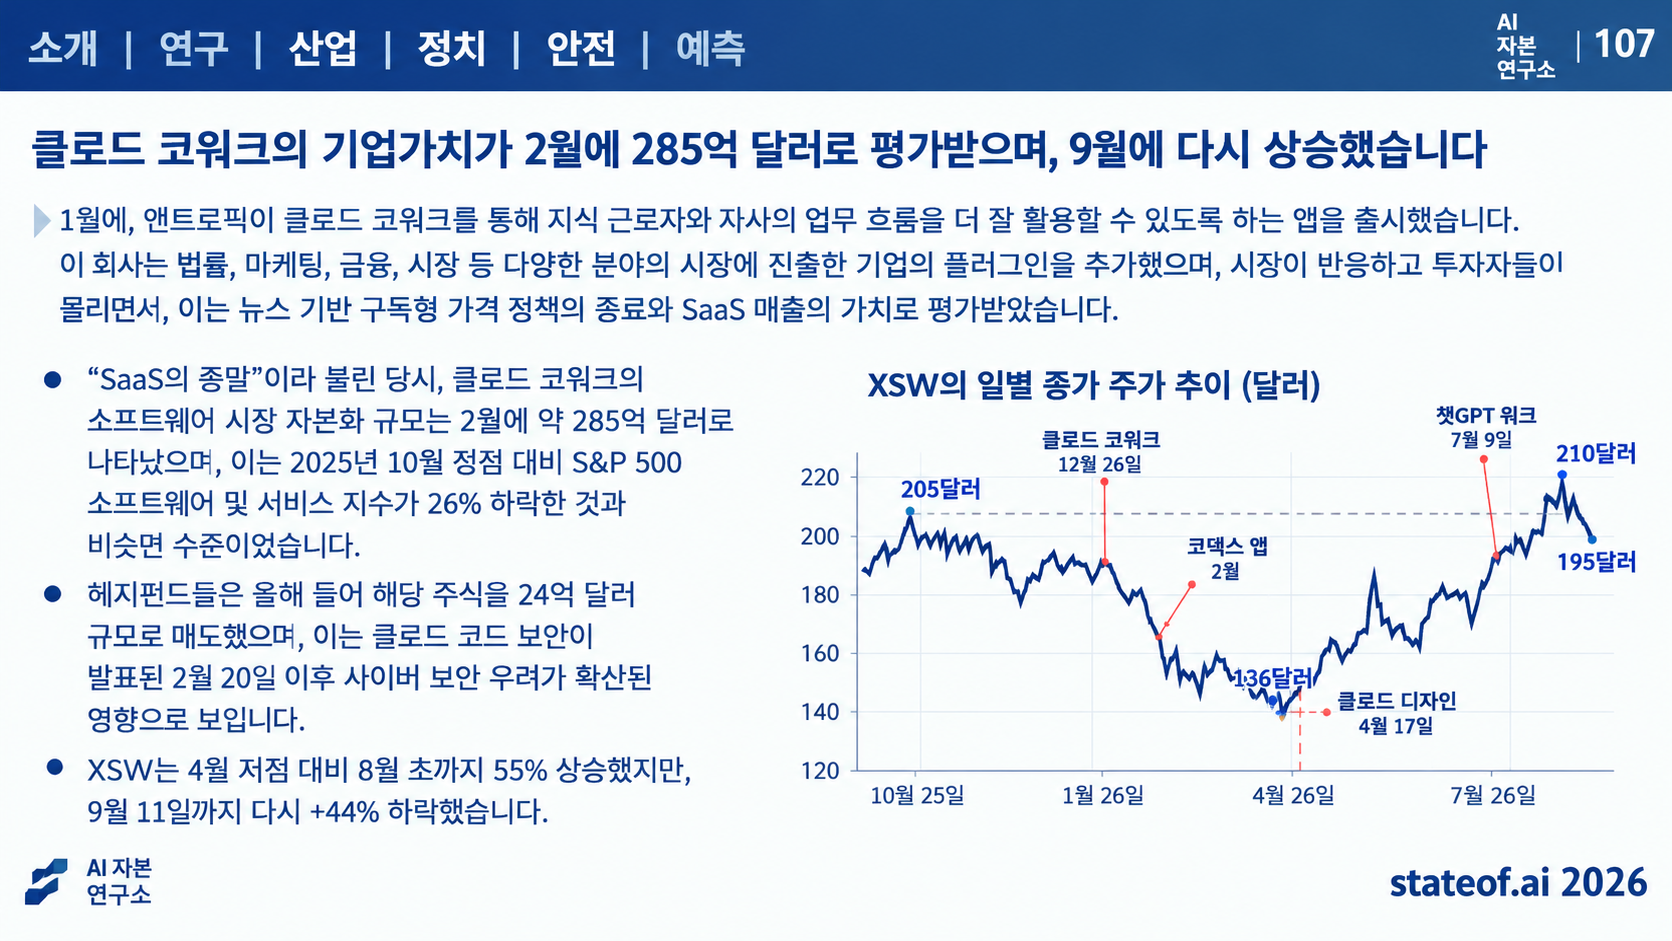
기사는 AI 에이전트가 기존 SaaS를 대체할 수 있다는 우려로 소프트웨어 주식이 급락했지만, 이후 상당 부분 회복했다고 설명합니다.[1]
원보고서 슬라이드 107은 초기 2월 소프트웨어 시가총액 약 2,850억 달러 감소, 이후 XSW의 4월 저점 대비 8월 고점 55% 상승을 제시합니다.[2]
분석
기사의 문제 제기는 타당합니다. 주가 급락은 산업 전체의 매출 붕괴와 같지 않으며, 주가 회복도 AI 위협이 사라졌다는 증거는 아닙니다.
분석자 관점에서 SaaS의 가치는 층위별로 나누어 볼 필요가 있습니다.
| 층위 | 에이전트 확산에 따른 검토 방향 |
| 사용자 화면·단순 입력 기능 | 대체 가능성 검토 |
| 업무 규칙·예외 처리 | 에이전트와의 결합 가능성 검토 |
| 원장·마스터 데이터 | 신뢰 가능한 기록체계 유지 |
| 권한·승인·감사 | 에이전트가 사용하더라도 통제 유지 |
실무 시사점 — 분석자 제안
공공 정보시스템에서는 화면 조작 자동화와 업무시스템 자체 대체를 혼동하지 않는 것이 중요합니다. 에이전트가 기존 시스템을 사용하더라도 법정 기록, 권한, 승인, 감사 기능은 별도로 유지해야 합니다.
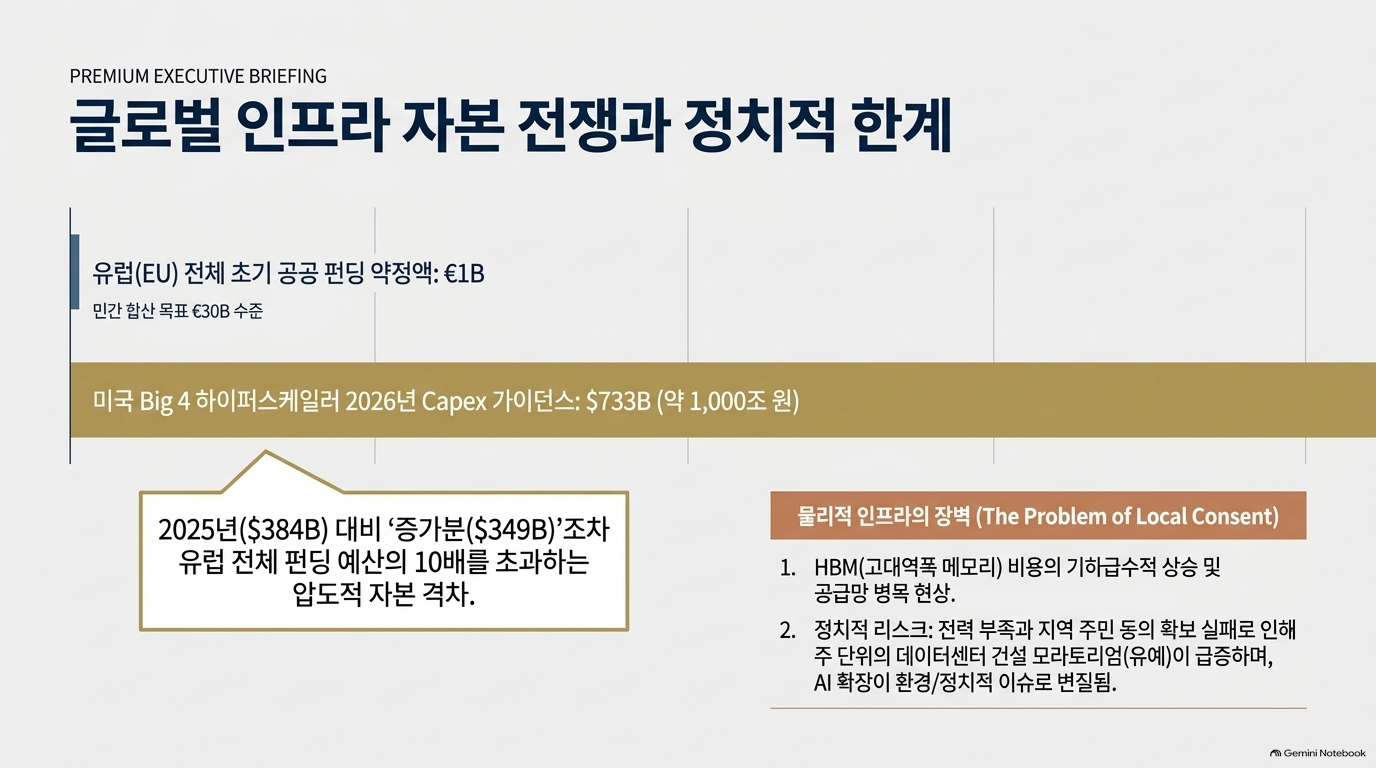
16. The Problem of Local Consent for the AI Buildout — 인프라는 자금만으로 확보되지 않는다
핵심 내용
기사는 데이터센터 건설에 금융·전력·건설 외에도 지역사회 동의가 필요하며, AI 인프라가 정치적 쟁점이 되고 있다고 설명합니다.[1]
EU 공식 발표는 최대 7개 AI Gigafactory에 대해 다음을 제시합니다.[8]
- EU·국가 공공재원 최대 100억 유로
- 유발할 것으로 기대하는 민간투자 최소 200억 유로
분석
이 숫자는 이미 지출·집행된 총액이 아닙니다. 공공지원 상한과 민간투자 유발 기대를 구분해야 합니다.[8]
또한 기사에 실린 미국 하이퍼스케일러 CAPEX와 유럽 프로그램 비교는 범위를 확인해야 합니다. 원본 차트의 설명부터 미국 기업의 연간 CAPEX와 유럽 프로그램의 초기 공공 기여금을 비교하므로, 동일 범위의 투자 경쟁력 비교로 해석하기 어렵습니다.[1]
이 절의 핵심 메시지는 다음과 같습니다.
자금 조달 → 부지·전력 확보 → 인허가·지역 수용 → 건설 → 실제 가동
앞 단계의 발표가 뒤 단계의 완료를 보장하지 않습니다.
실무 시사점 — 분석자 제안
공공 AI 인프라 검토에서는 GPU 구매계획뿐 아니라 전력 인입, 냉각·용수, 인허가, 공급 일정, 운영비, 데이터 주권, 대체 운영방안까지 확인해야 합니다.
종합 평가
이 글에서 유효하게 읽을 수 있는 핵심 흐름
분석자 종합: 이 글은 AI 경쟁의 중심이 단순한 모델 점수에서 업무 수행·비용·통제·인프라로 이동하는 모습을 보여줍니다.
|
다만 기사는 이러한 변화에 대한 유용한 차트를 제공하는 동시에, Anthropic 선호와 OpenAI에 대한 비판적 판단을 강하게 섞고 있습니다.[1]
그대로 인용하기 전에 보완할 사항
| 항목 | 보완 방향 | 근거 |
| “Anthropic만 프런티어” | 저자의 의견으로 표시 | 원보고서는 지표별 선두 차이를 제시 |
| Haiku 비용 75% 감소 | 입력 길이·토큰 소비 조건 병기 | 공식 발표의 가격 구간과 계산 설명 |
| 컴퓨터 사용 성공률 | Offline subset 조건 유지 | 공식 성능표 |
| AI R&D 26% 주도 | 인간 감독하의 AL4로 표시 | 완전 자율 아님 |
| S1 66% 성공 | 누적 단계 성공률·평가 중 개입 명시 | 무개입 종단 성공률 아님 |
| 신약 3상 진입 | 효능 입증·승인과 구분 | 임상 결과는 아직 별도 |
| 합산 매출 1,050억 달러 | 시점이 다른 연환산 매출로 표시 | 실현 연간 매출 아님 |
| Anthropic IPO 시점 | 5주·5일 불일치 확인 | 기사 내부 불일치 |
| Muse 이용 지표 | [출처] ·기간·코호트 정렬 | 유지율 비교 근거 부족 |
| EU 투자 규모 | 지원 상한·투자 기대와 집행액 구분 | 공식 발표의 조건부 표현 |
출처
[1] Michael Spencer, 「AI off the Charts II」
[2] Nathan Benaich, 《State of AI Report 2026》 — 본문 슬라이드 번호 기준
[3] Anthropic, Introducing Claude Haiku 5.5
[4] Anthropic, Measurements for understanding the pace of AI development inside frontier labs
[5] Skild AI, Introducing S1: In-Context Learning for Robotics
[6] Nous Research, A Note on Our Fundraise
[7] OpenAI, How agents are transforming work
[8] European Commission, EU launches AI Gigafactories call
[9] AHM, Statement on OpenAI’s October 6 Release of Mathematical Documents

'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - 재귀적 자기 개선(RSI), Google DeepMind, AI 의식 평가 프레임워크 (0) | 2026.10.11 |
|---|---|
| 에이전트 AI - 개인용 에이전트: OpenAI, Dots (0) | 2026.10.10 |
| 2026 - 10.8 The State of AI Report 2026 (0) | 2026.10.10 |
| 2026 - 10.8 The State of AI Report 2026 요약 (0) | 2026.10.10 |
| 에이전트 AI - 효과적 이타주의(EA)와 최적화의 위험 (0) | 2026.10.10 |