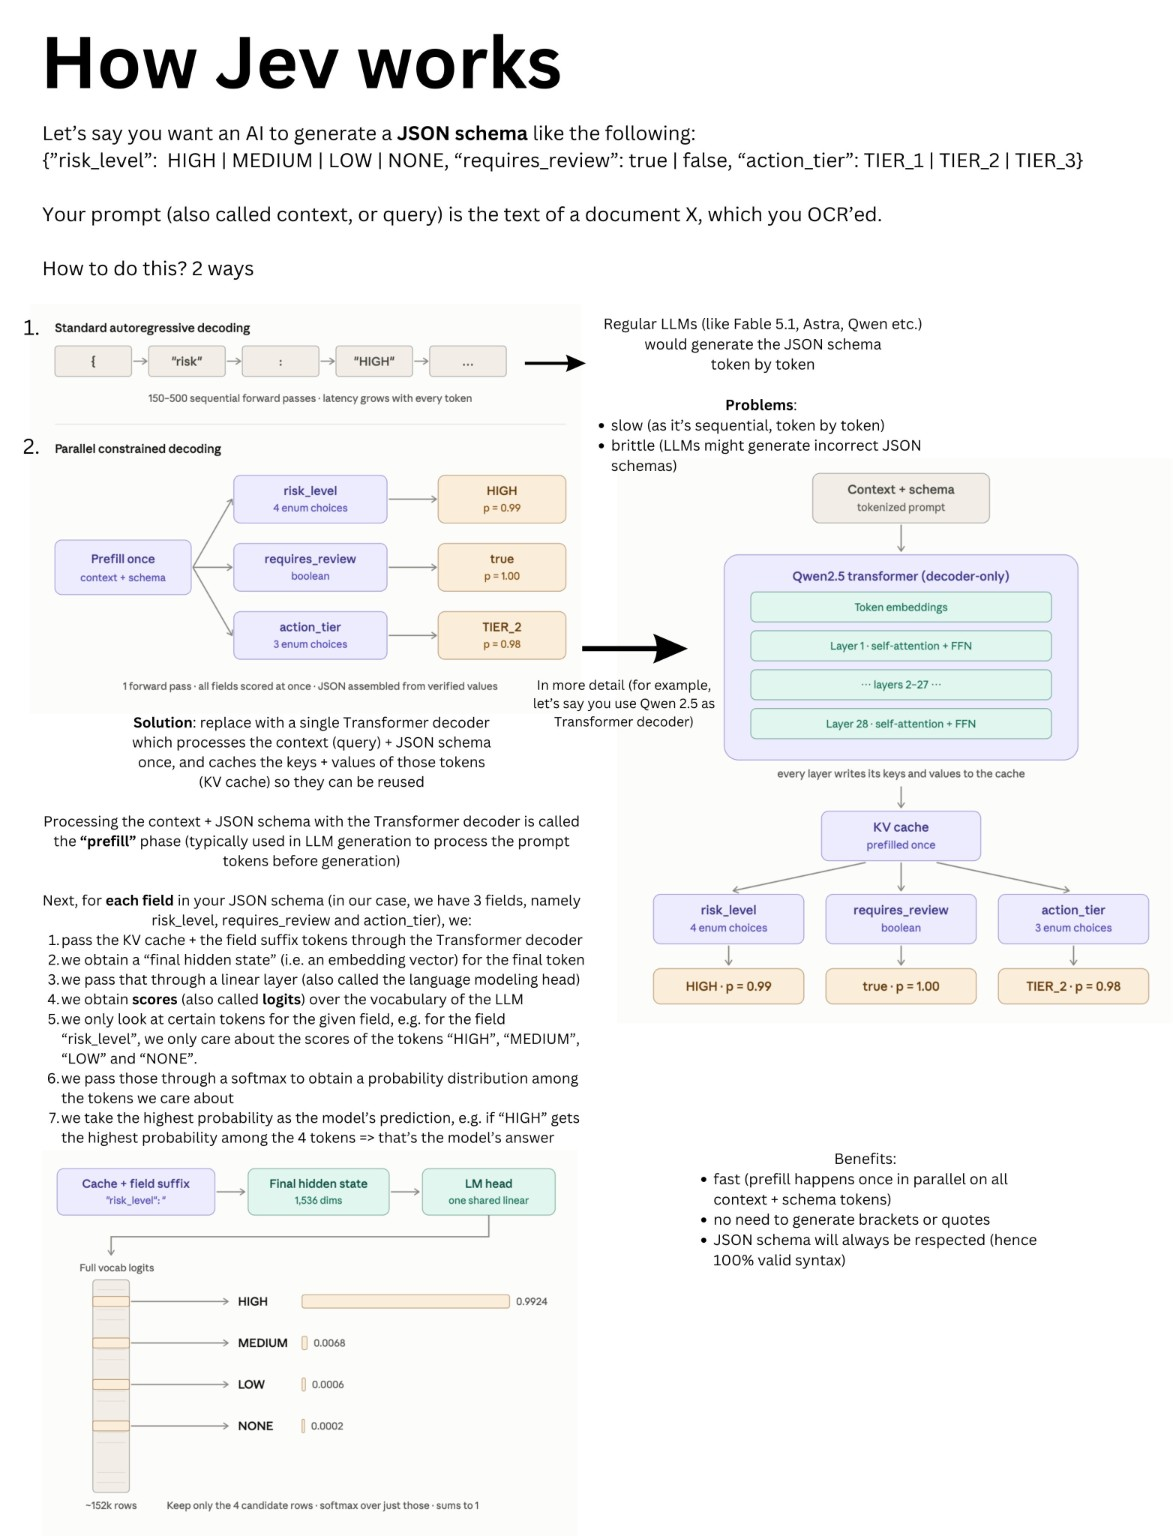
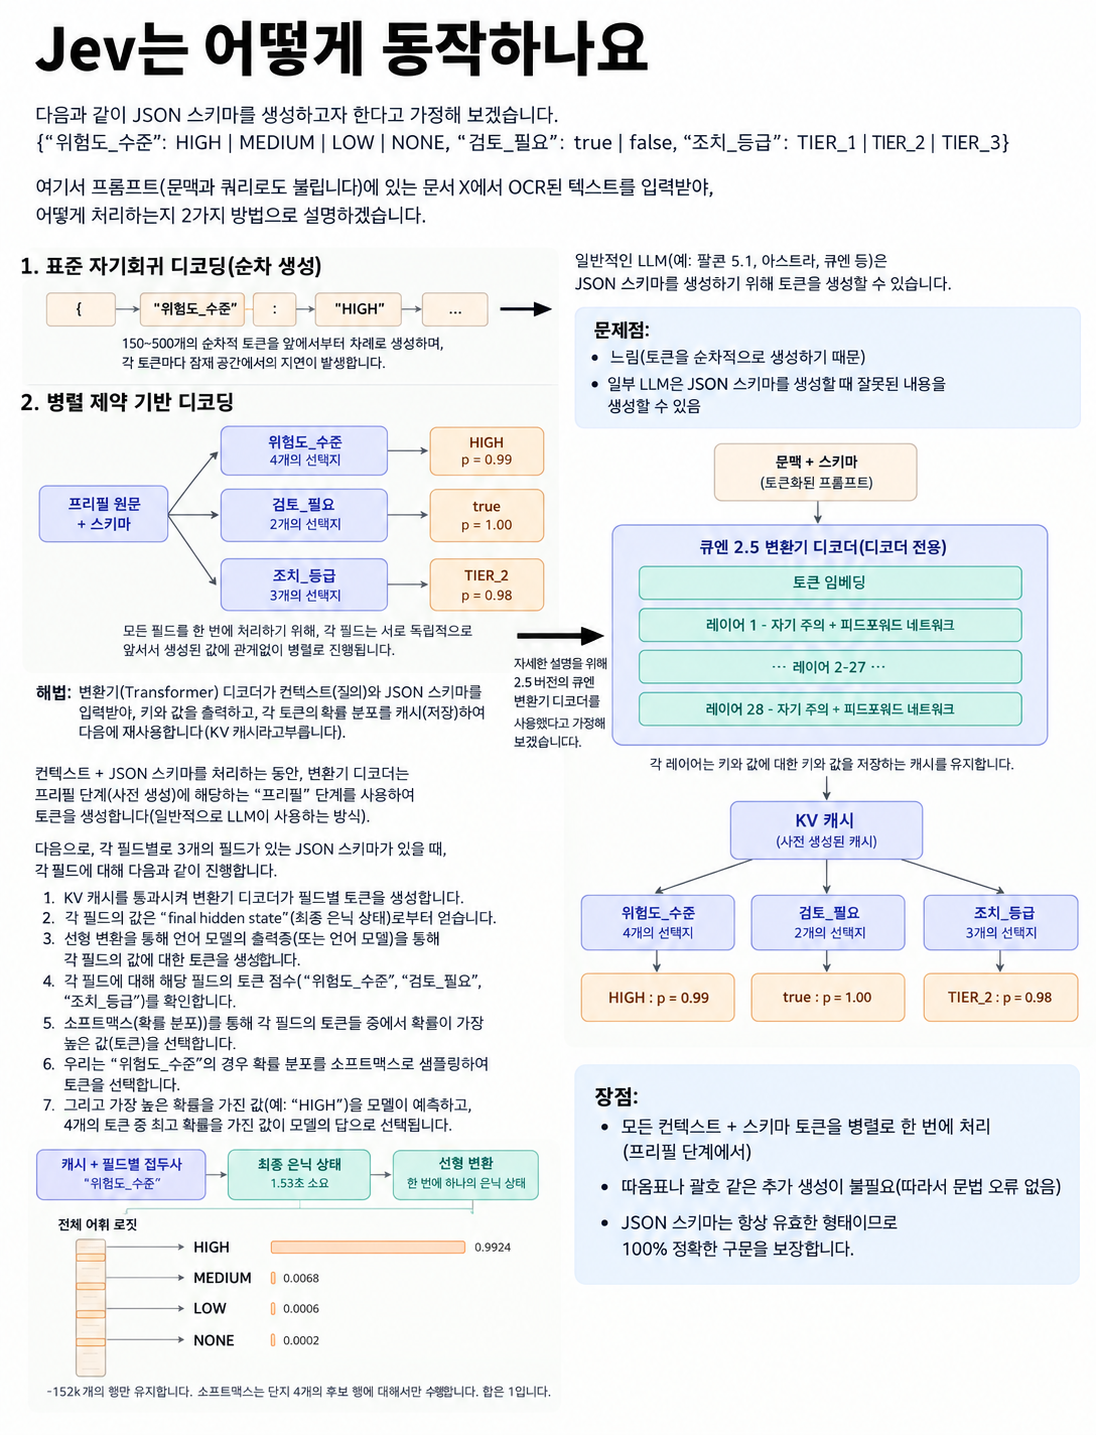
이 그림은 문서를 분석해 정해진 항목으로 분류할 때, JSON 전체를 토큰 단위로 생성하지 말고 각 필드의 허용값만 평가한 뒤 프로그램으로 JSON을 조립하자는 구조를 설명합니다.
제목은 “How Jev works”이며, OCR로 추출한 문서를 다음 항목으로 판단하는 예시입니다.
| 필드 | 허용값 | 의미 |
| risk_level | HIGH, MEDIUM, LOW, NONE | 위험 수준 |
| requires_review | true, false | 검토 필요 여부 |
| action_tier | TIER_1, TIER_2, TIER_3 | 조치 등급 |
핵심은 ‘자유로운 문장 생성’을 ‘제한된 선택지에 대한 분류’로 바꾸는 것입니다. 다만 그림만으로 Jev의 실제 구현이나 성능이 검증되지는 않습니다. 아래에서는 그림의 설명과 기술적 해석을 구분합니다.
2. 두 방식의 차이
① 일반적인 자기회귀 생성 — JSON을 순서대로 작성
그림 상단의 흐름은 다음과 같습니다.
| 문서 입력 ↓ { → "risk_level" → : → "HIGH" → , → 다음 필드 → … ↓ 완성된 JSON |
모델이 이전에 생성한 토큰을 바탕으로 다음 토큰을 순차적으로 생성합니다. 필드의 값뿐 아니라 중괄호·따옴표·필드명·구분자도 출력해야 합니다.
그림은 이 방식의 문제로 다음을 제시합니다.
- 속도: 출력이 길어질수록 순차 생성 단계가 늘어남.
- 형식 안정성: 별도 제약 없이 생성하면 잘못된 JSON이나 허용되지 않은 값이 나올 수 있음.
단, 자기회귀 생성 자체가 잘못된 JSON을 필연적으로 만든다는 뜻은 아닙니다. 자기회귀 방식에도 문법·스키마 제약을 적용할 수 있습니다. 따라서 그림의 비교는 사실상 ‘제약 없는 순차 생성’과 ‘허용값 기반 병렬 평가’의 비교로 읽는 편이 정확합니다.
② 병렬 제약 평가 — 필드의 값만 선택
그림의 대안은 다음과 같습니다.
| 문서 + 스키마 ↓ 공통 입력 처리(Prefill) ↓ KV cache 재사용 ├─ risk_level 후보 평가 ─────→ HIGH ├─ requires_review 후보 평가 → true └─ action_tier 후보 평가 ────→ TIER_2 ↓ 코드로 JSON 조립 |
이 방식은 모델에게 JSON 문자열 전체를 쓰게 하지 않습니다. 모델이 필드별로 선택한 값을 프로그램이 정해진 구조에 넣습니다.
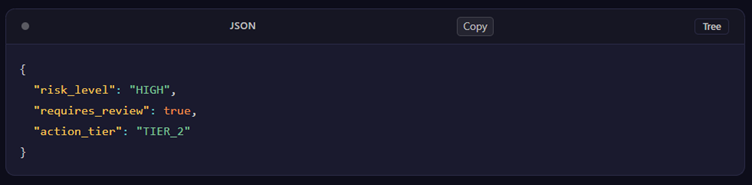
모델은 의미 판단을 담당하고, 프로그램은 출력 형식을 담당하는 역할 분리입니다.
3. 내부 동작: Prefill → KV cache → 후보 점수
단계 1. 문서와 스키마를 한 번 처리
그림은 문서와 스키마를 Transformer에 입력하는 단계를 Prefill이라고 설명합니다.
이때 각 층에서 계산된 Attention의 Key와 Value를 KV cache에 저장합니다. 공통 입력에 대한 계산 결과를 이후 필드 평가에서 재사용하려는 것입니다.
여기서 Key·Value는 JSON의 키·값이 아니라, Transformer Attention 내부의 벡터입니다.
단계 2. 필드별 질문을 붙여 평가
각 필드에는 서로 다른 접미 입력이 붙습니다. 그림의 예시는 다음과 같은 형태입니다.
"risk_level": "
공통 문서 정보와 해당 필드 입력을 이용해 마지막 토큰의 은닉 상태(hidden state)를 얻습니다.
중요한 점은 캐시 자체가 분류 결과를 제공하는 것은 아니라는 것입니다. 각 필드 입력에 대한 추가 모델 계산이 필요하며, 이 계산을 병렬로 묶을 수 있다는 취지입니다.
단계 3. LM head로 후보 점수를 산출
은닉 상태를 LM head에 통과시키면 어휘별 점수인 logits가 나옵니다.
그중 risk_level에 대해서는 다음 후보의 점수만 이용합니다.
HIGH / MEDIUM / LOW / NONE
선택한 후보 점수에 Softmax를 적용하고, 가장 높은 값을 갖는 후보를 최종 선택합니다.
그림 하단에는 다음 분포가 표시되어 있습니다.
| 후보 | 그림에 표시된 값 |
| HIGH | 0.9924 |
| MEDIUM | 0.0068 |
| LOW | 0.0006 |
| NONE | 0.0002 |
이 수치는 그림에 제시된 예시입니다. 평가 데이터·측정 조건·확률 보정 정보가 없으므로 실제 정확도나 검증된 성능으로 해석할 수는 없습니다.
4. 기술적으로 보완해서 읽어야 할 부분
| 그림의 표현 | 분석 및 보완 |
| “JSON schema를 생성한다” | [설명] 의 실제 목적은 이미 정해진 스키마에 맞는 JSON 데이터 객체를 생성하는 것입니다. 상단의 HIGH \| MEDIUM … 표기는 허용값을 설명하는 약식 표현이지, 유효한 JSON 또는 정식 JSON Schema는 아닙니다. |
| “1 forward pass” | 본문의 상세 설명에는 Prefill 이후 각 필드 접미 입력을 Transformer에 통과시키는 단계가 있습니다. 따라서 전체가 무조건 한 번의 모델 실행으로 끝난다고 단정하기보다, 공통 Prefill 1회 + 필드별 평가를 병렬 배치하는 구조로 이해해야 합니다. |
| “150–500 sequential forward passes” | 그림에 제시된 수치일 뿐입니다. 출력 토큰 수·토크나이저·추론 방식 등의 조건이 없어, 이 짧은 JSON에도 동일하게 적용된다고 볼 수 없습니다. |
| 후보 이름을 토큰 하나로 평가 | HIGH, MEDIUM, TIER_2 같은 문자열이 해당 입력 문맥에서 단일 토큰인지 확인해야 합니다. 여러 토큰이면 첫 토큰 점수만으로 전체 후보를 정확히 비교할 수 없습니다. |
| p = 0.99 등의 확률 | 허용 후보 안에서 정규화한 모델 점수입니다. 현실에서 판단이 맞을 확률 99%라는 의미는 아닙니다. 후보 집합이 부적절하거나 문서가 불충분해도 높은 값이 나올 수 있습니다. |
| “100% valid syntax” | 올바른 직렬화 코드로 JSON을 조립하면 문법 오류를 방지할 수 있습니다. 그러나 문법 적합성 ≠ 전체 스키마 적합성 ≠ 판단 정확성입니다. 필수값·조건부 규칙·필드 간 정합성은 별도 확인이 필요합니다. |
| Qwen2.5의 28개 층·1,536차원 | 그림에서 사용한 특정 모델 구성의 예시로 보아야 합니다. 모든 Qwen2.5 모델의 공통 사양으로 일반화하면 안 됩니다. |
| 각 필드를 독립적으로 선택 | 필드 간 관계가 누락될 수 있습니다. 예컨대 업무 규칙이 HIGH → requires_review=true를 요구한다면, 개별 후보 선택 외에 교차 필드 규칙 검증이 필요합니다. |
특히 단일 토큰 후보 조건, 필드 간 의존성, 확률의 의미가 실제 구현에서 중요한 쟁점입니다.
5. 어디에 적합하고, 어디에 한계가 있는가
적합한 업무
이 구조는 필드와 허용값이 고정된 대량 분류 업무에 적합한 방향입니다.
- 문서의 위험 등급 판정
- 검토 필요 여부 분류
- 민원·문의 유형 분류
- 정책 위반 유형 분류
- 감리 지적사항의 분류 및 우선순위 판정
생성해야 하는 문자열을 줄이고 형식 처리를 코드로 옮기므로, 짧고 정형화된 결과를 반복적으로 생산하는 업무에서 이점이 기대됩니다. 다만 실제 속도 개선은 측정이 필요합니다.
한계가 있는 업무
다음 업무까지 동일한 방식으로 해결되지는 않습니다.
- 문서의 자유로운 요약
- 근거 문장·페이지 추출
- 개선방안 작성
- 임의 길이 문자열·배열·중첩 객체 생성
- 여러 필드가 서로 강하게 의존하는 판단
특히 OCR 문서를 입력하는 경우 OCR 오류도 그대로 판단에 영향을 줄 수 있습니다. 출력 JSON이 완벽하더라도 입력의 사실관계가 잘못되면 판단은 틀릴 수 있습니다.
종합 판단
이 그림의 설계 방향은 “LLM을 JSON 작성기로 쓰기보다, 제한된 후보를 평가하는 분류기로 쓰자”는 것입니다. 정형 분류에서는 의미 있는 접근입니다.
다만 그림의 ‘한 번의 forward pass’, ‘높은 확률’, ‘100% 유효성’은 각각 계산 범위·확률 해석·보장 범위를 제한해 읽어야 합니다. 빠르고 형식이 올바른 출력이 곧 근거 있고 정확한 판단은 아니라는 점이 가장 중요한 분석 결론입니다.
'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - O’Reilly Radar, AI 스택 보존 격차와 재구성 (0) | 2026.10.10 |
|---|---|
| 에이전트 AI - 삼성전자 SE Lab(DA), 코드 리뷰 전쟁 (0) | 2026.10.09 |
| 에이전트 AI - Jev : 10분 만에 Jev 이해하기 (0) | 2026.10.09 |
| 에이전트 AI - 개인용 에이전트: CPU와 메모리 수요 전망 (0) | 2026.10.09 |
| 에이전트 AI - NVIDIA NemoClaw 기반 개인 에이전트 구축 (0) | 2026.10.09 |