https://www.viksnewsletter.com/p/how-many-cpus-do-personal-ai-assistants
2026.9.28
[How Many CPUs Do Personal AI Assistants Need?]
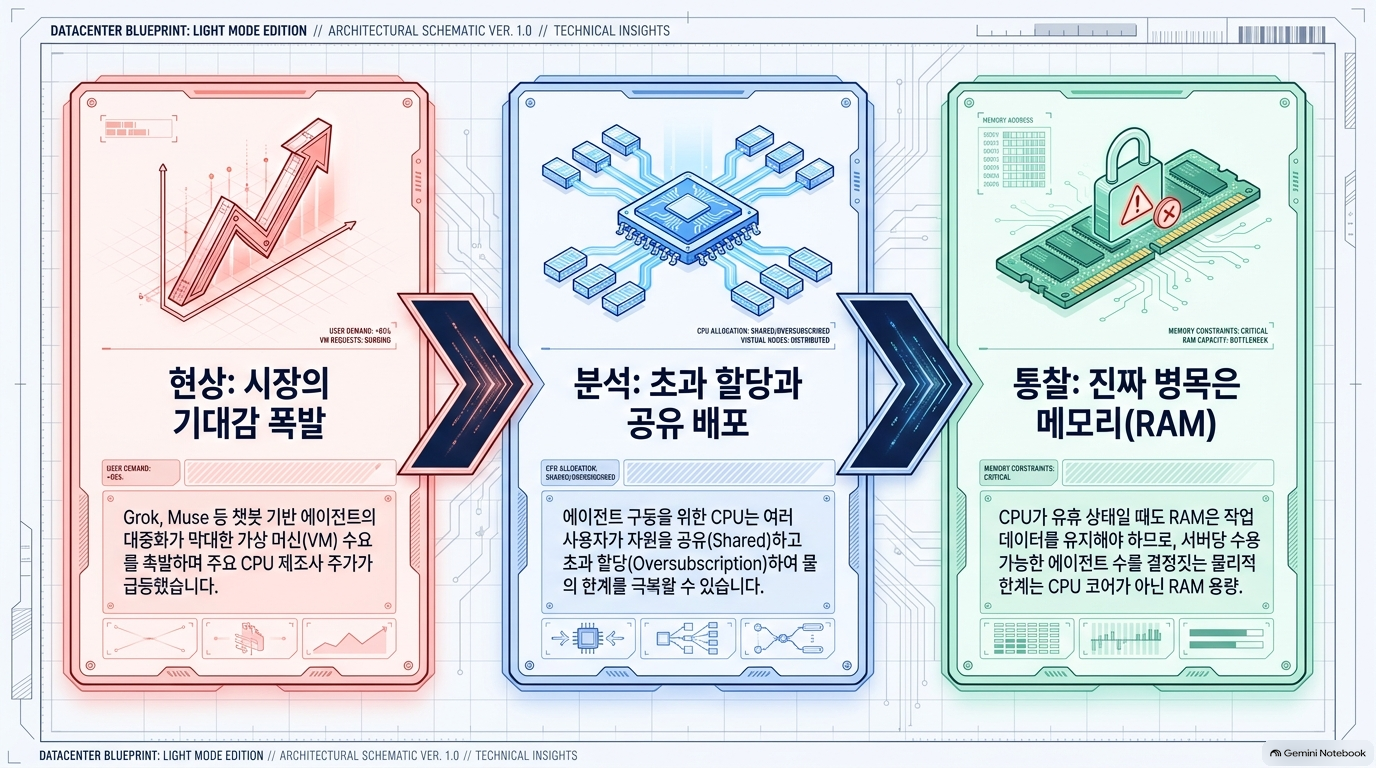
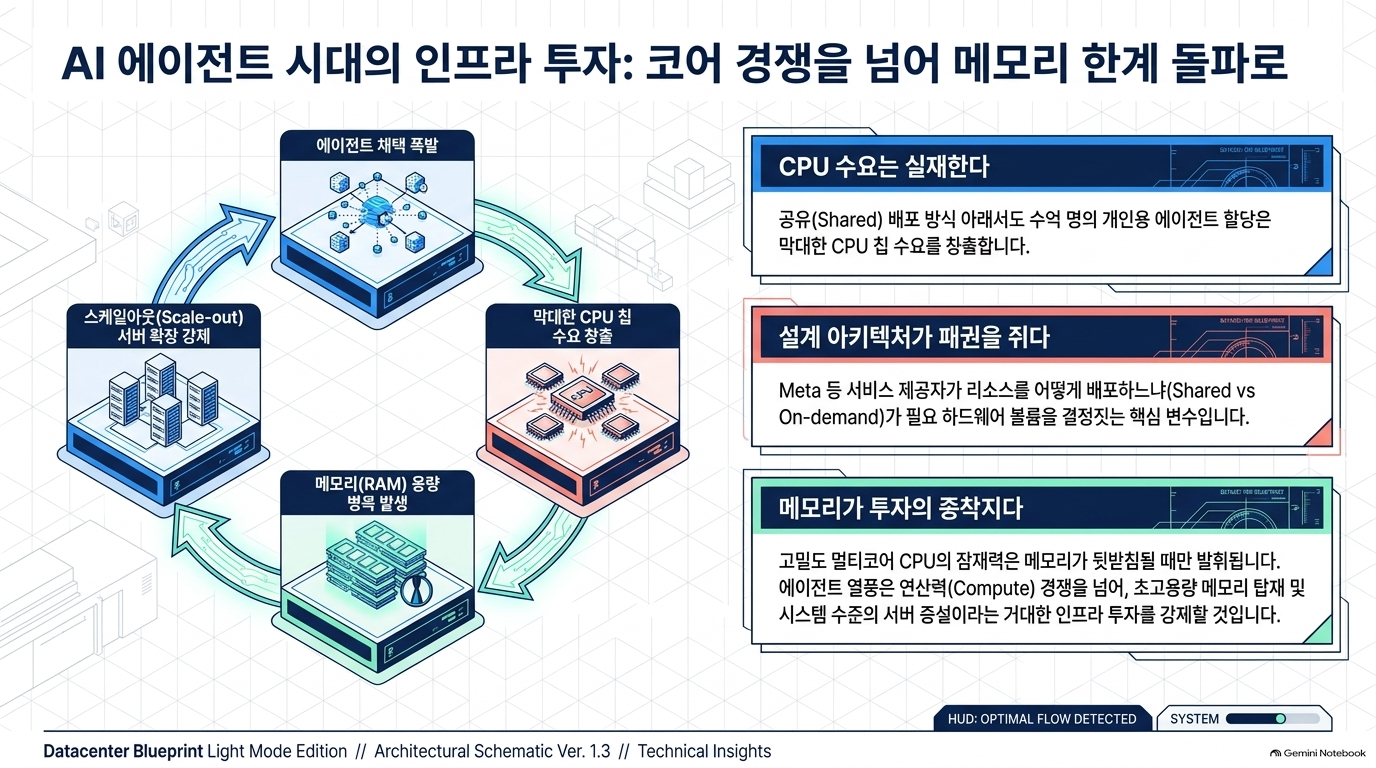
개인용 AI 비서의 급격한 확산은 가상 머신과 CPU에 대한 수요를 폭발적으로 증가시키고 있으며, 반도체 시장의 핵심 성장 동력으로 자리 잡고 있습니다. 각 사용자의 에이전트는 독립된 작업 환경을 구동하기 위해 컴퓨팅 자원을 소비하며, 데이터센터 운영자들은 서버 효율을 높이기 위해 CPU 공유 및 오버스브스크립션 기법을 활용해 수많은 가상 머신을 밀집 배치합니다. 그러나 단순한 프로세서 연산 능력 확보를 넘어, 상시 유지되는 작업 데이터로 인해 RAM 메모리 용량이 궁극적인 하드웨어 제약 요인으로 작용하게 됩니다. 결과적으로 이러한 차세대 AI 워크로드는 반도체 기업들의 매출 확대로 이어지지만, 실제 서버 구축 규모는 프로세서 코어 수뿐만 아니라 메모리와의 정교한 균형에 의해 결정됩니다.
핵심 결론: 개인용 AI 에이전트 이용자가 늘어도 필요한 CPU 수가 이용자 수에 비례해 늘지는 않습니다. 여러 이용자의 CPU 실행 시간을 공유할 수 있기 때문입니다. 오히려 에이전트가 쉬는 동안에도 브라우저와 작업 상태를 RAM에 유지한다면, CPU보다 메모리가 먼저 서버 수를 결정할 수 있다는 것이 공개 본문의 중심 주장입니다. 다만 이 글은 실제 서비스의 배치·사용률을 검증한 용량 보고서가 아니라, 가정을 놓고 수요를 시험하는 시나리오 분석입니다.[1]
읽을 수 있는 범위: 공개 원문은 「The Rise of Personal Agents」부터 「From Agent VMs to CPU revenue」의 도입부까지입니다. 2030년 매출 추정치, 업체별 상세 비교, 최종 투자 결론은 유료 구간에 있어 아래에서 사실처럼 재구성하지 않았습니다.[1]
1. The Rise of Personal Agents — 왜 CPU 수요를 다시 묻는가
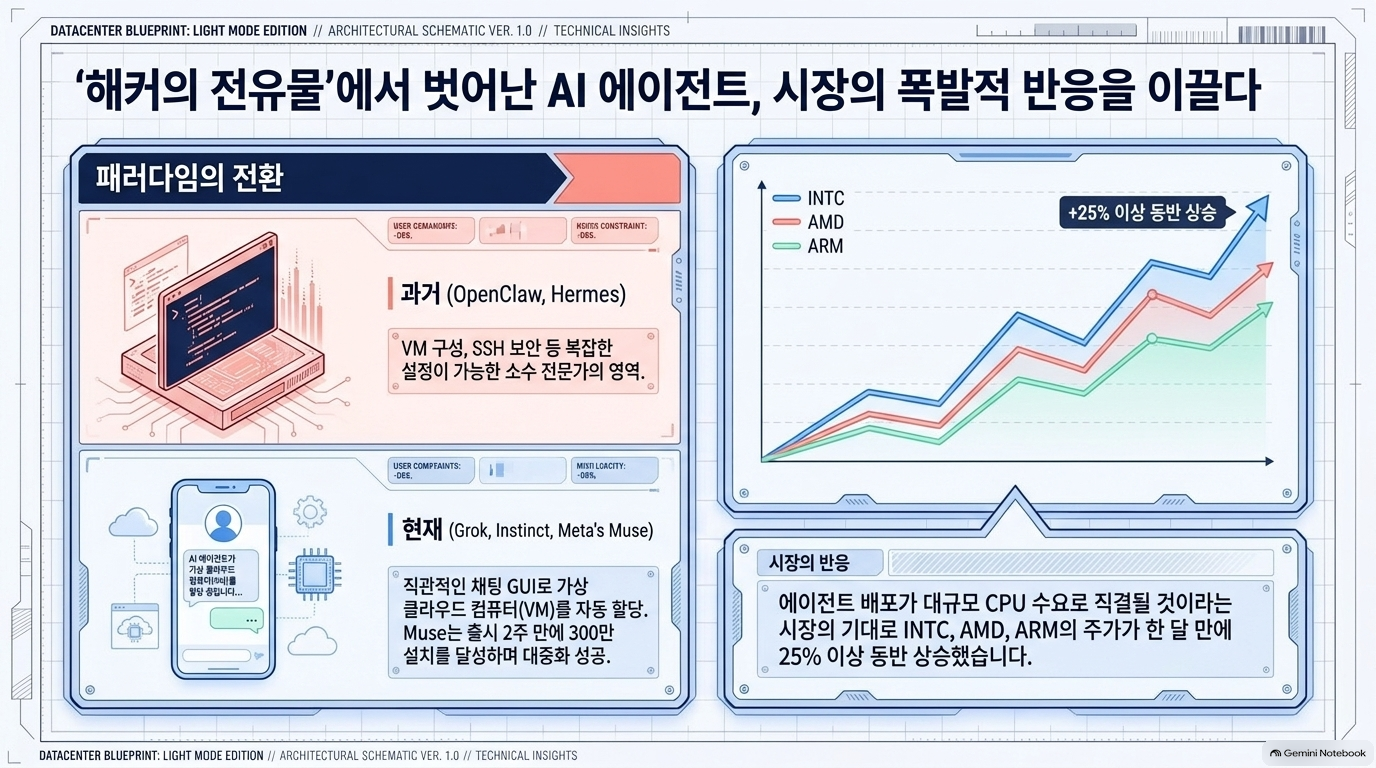
저자는 개인용 에이전트가 기술 숙련자의 자체 구축 도구에서 일반 이용자를 위한 서비스로 확장되고 있다고 봅니다. 추론은 주로 GPU에서 수행되지만, 에이전트가 웹을 탐색하고 도구를 실행하며 데이터를 조회하는 과정에는 CPU도 필요합니다. 따라서 이용자 기반이 커지면 CPU 수요가 급증할 것이라는 투자 가설이 생겼고, 글은 “CPU를 쓰는 작업이 많아진다”와 “새 CPU를 그만큼 구매해야 한다”가 같은 명제인지 검토합니다.[1]
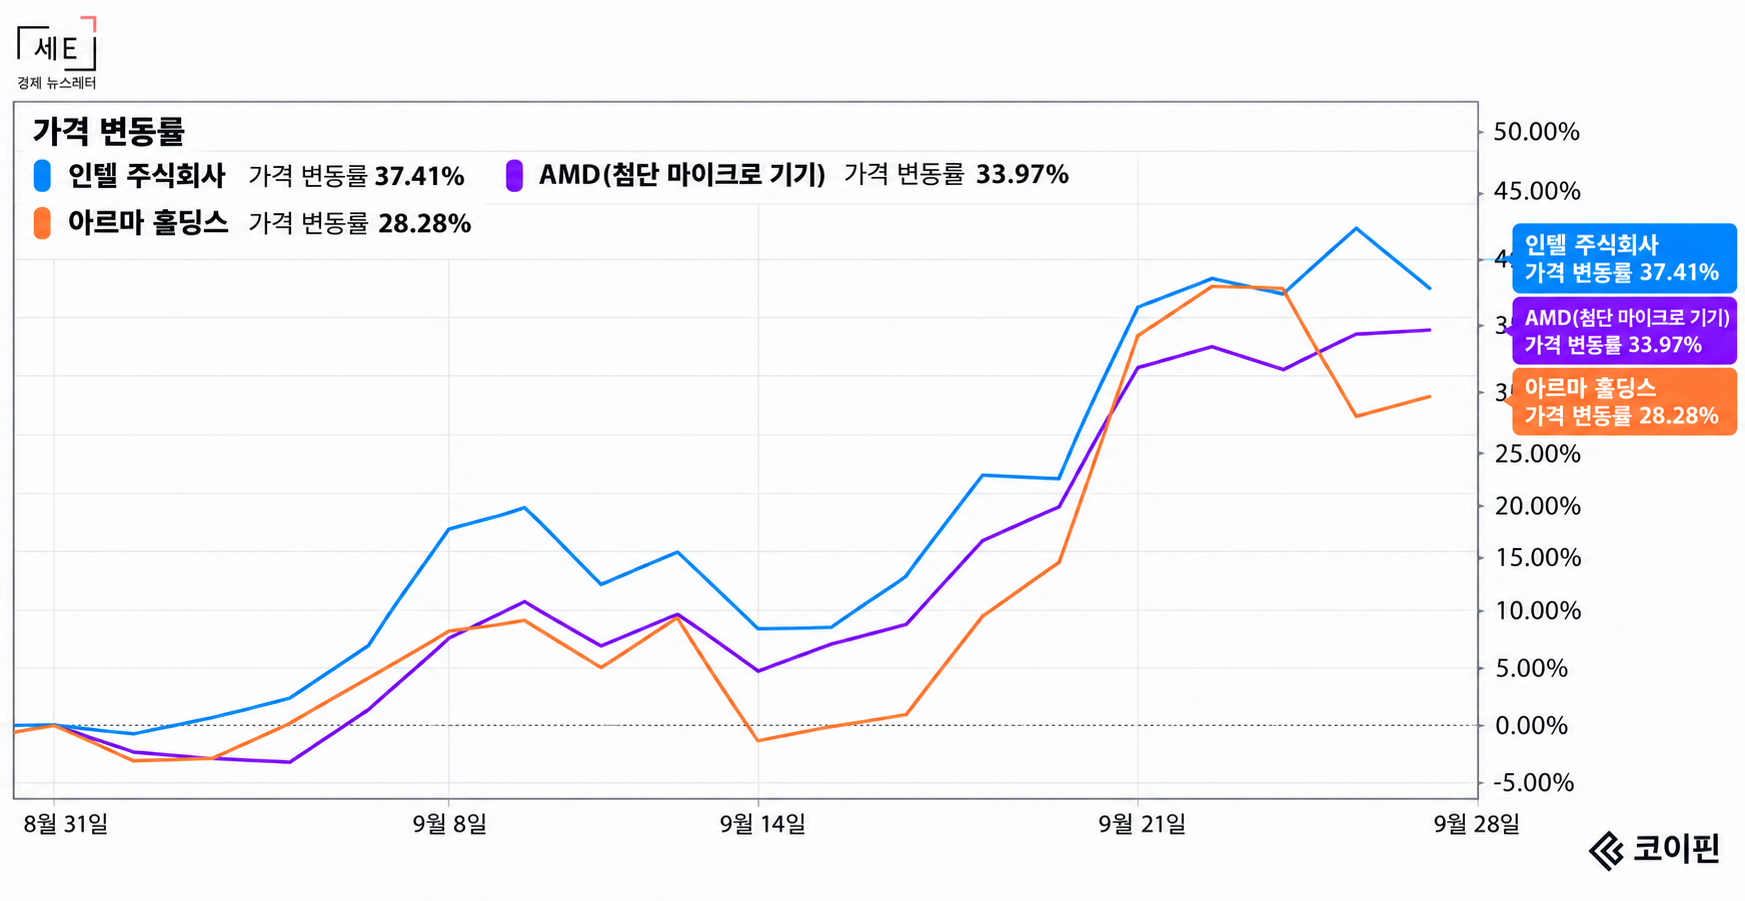
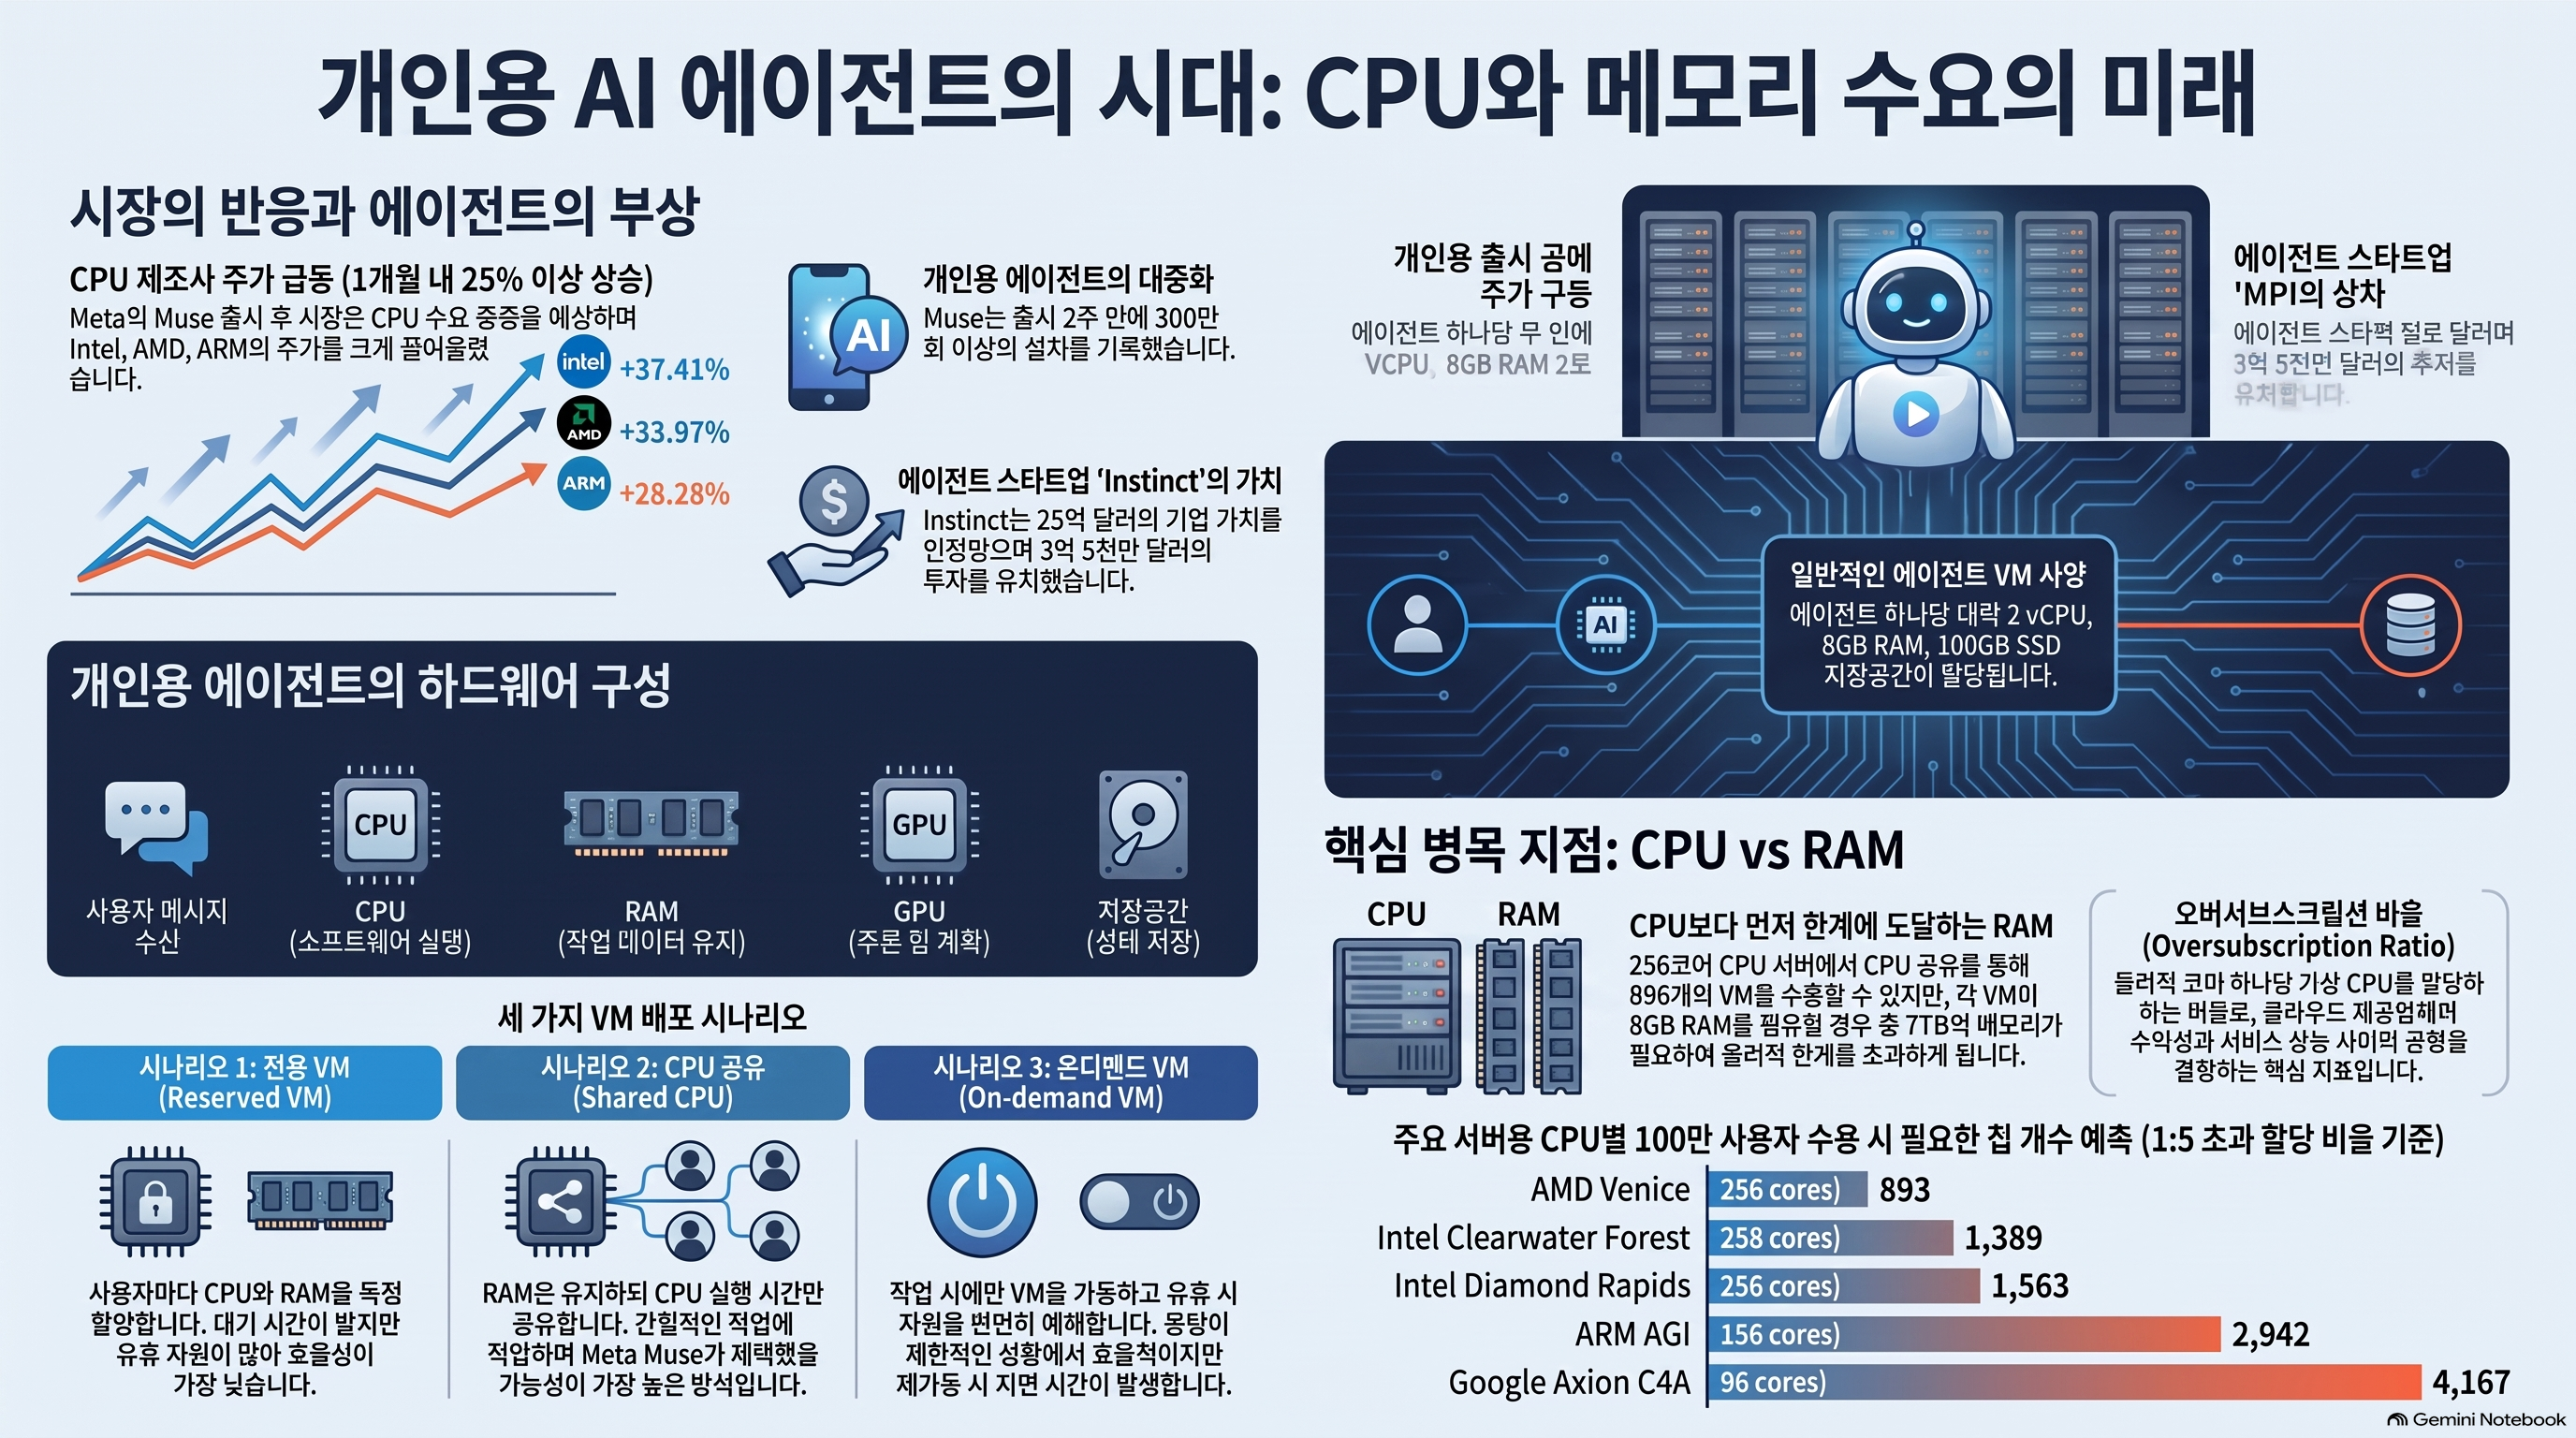
도입부의 주가 도표는 해당 기간 INTC 37.41%, AMD 33.97%, ARM 28.28% 상승을 표시합니다. 그러나 세 종목이 함께 올랐다는 관찰만으로 개인용 에이전트가 상승의 주된 원인이었다고 입증할 수는 없습니다. 채택 규모, 실제 CPU 구매량, 다른 시장 요인을 분리한 분석은 공개 구간에 제시되지 않습니다.[1]
해석: 이 장은 수요 증가의 가능성을 제기하는 문제 설정입니다. 이후 장의 자원 공유·메모리 제약을 보기 전에는 이용자 수를 CPU 판매량으로 환산할 수 없습니다.
2. What Runs a Personal Agent? — 에이전트 한 명의 자원 구성
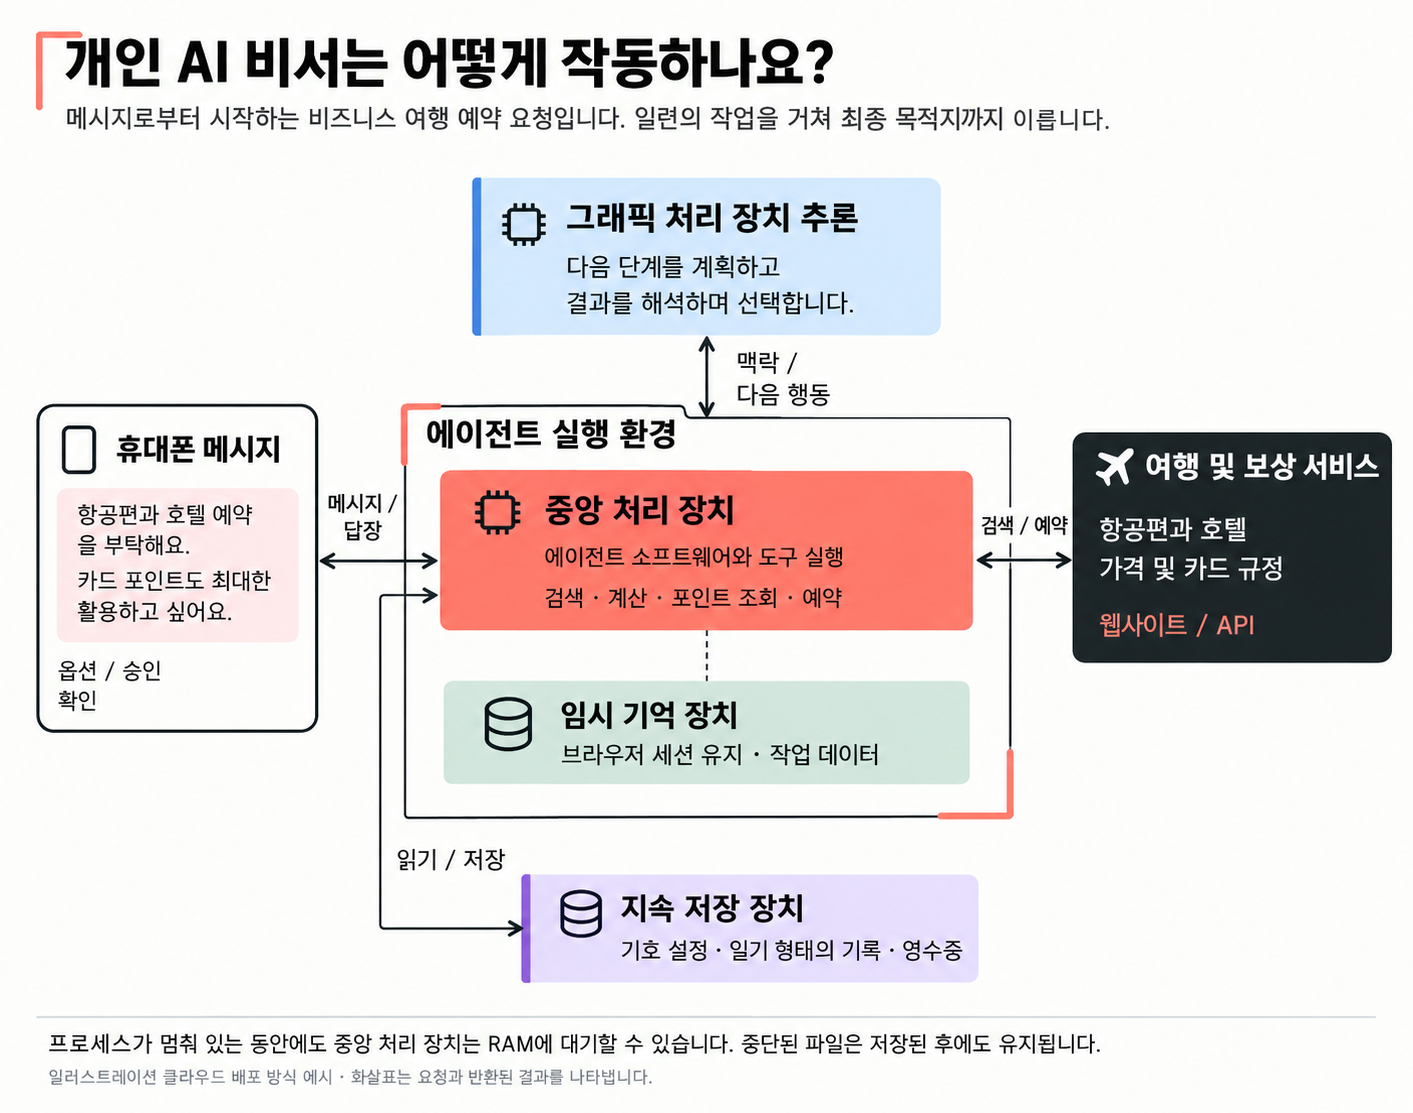
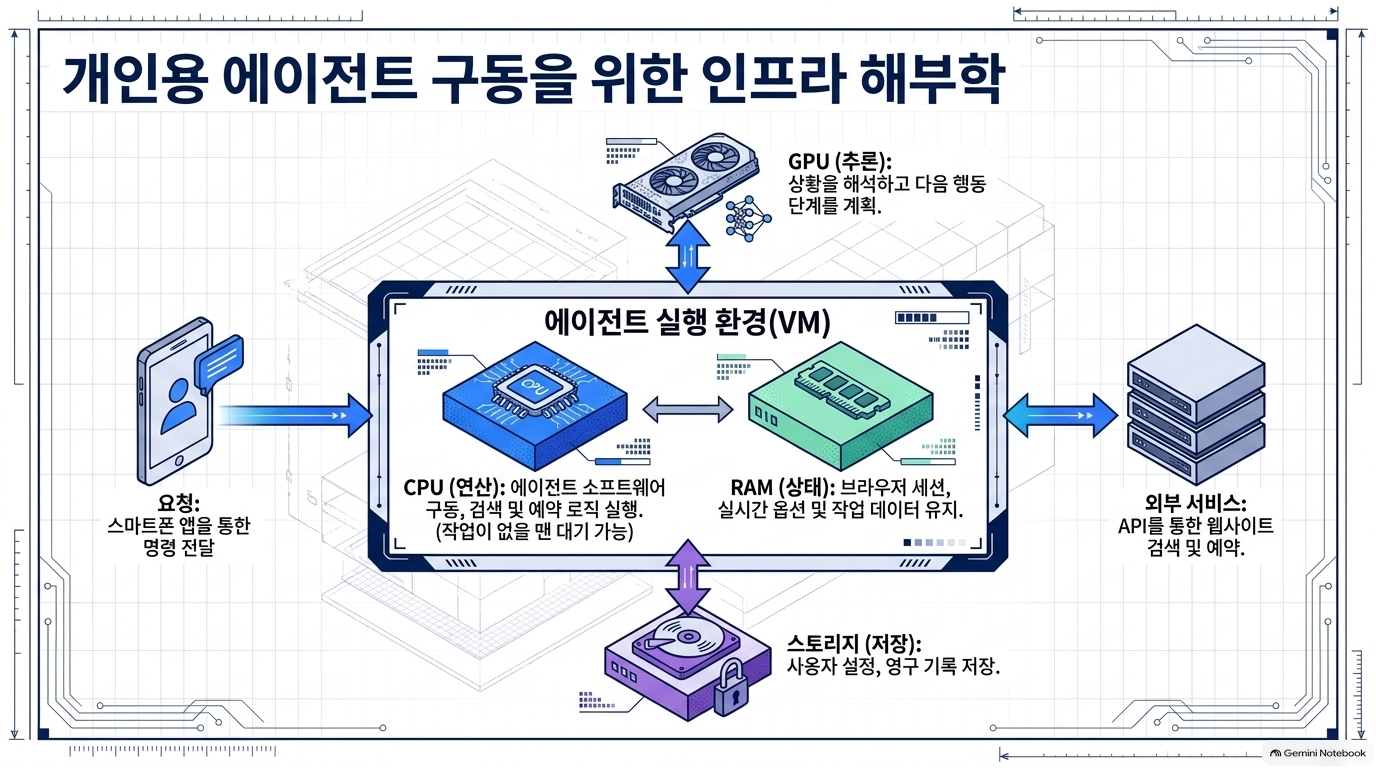
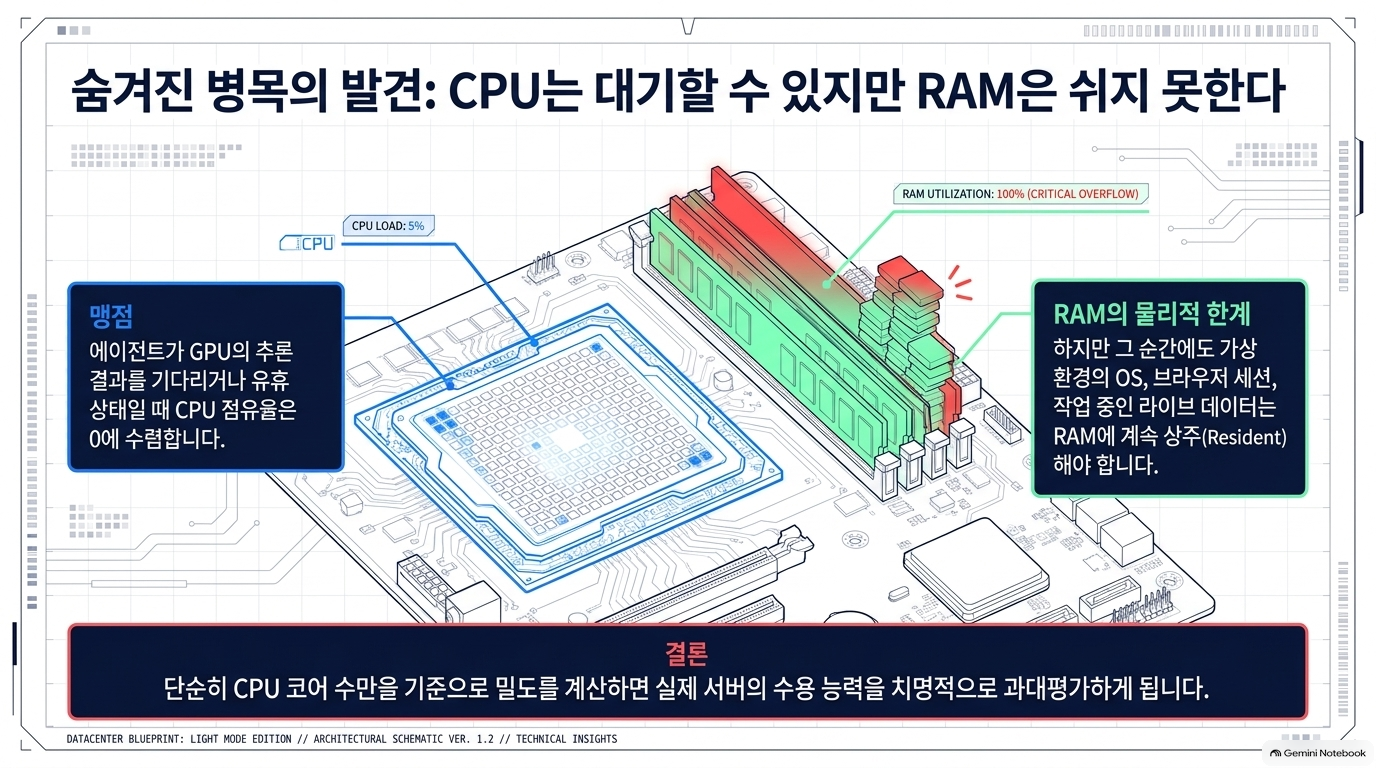
저자는 개인용 에이전트가 원격 VM에서 작업을 수행하는 예를 듭니다. 여행 예약 사례에서 휴대전화의 요청을 받은 실행 환경은 CPU로 검색·계산·예약 도구를 작동시키고, GPU 추론으로 결과를 해석하고 다음 행동을 계획합니다. RAM은 브라우저 세션과 현재 후보·작업 데이터를, 영구 저장소는 선호도·일정·결과물 등을 보관합니다. 그림의 요지는 CPU가 추론 응답을 기다려 쉬어도 RAM은 점유될 수 있다는 점입니다.[1]
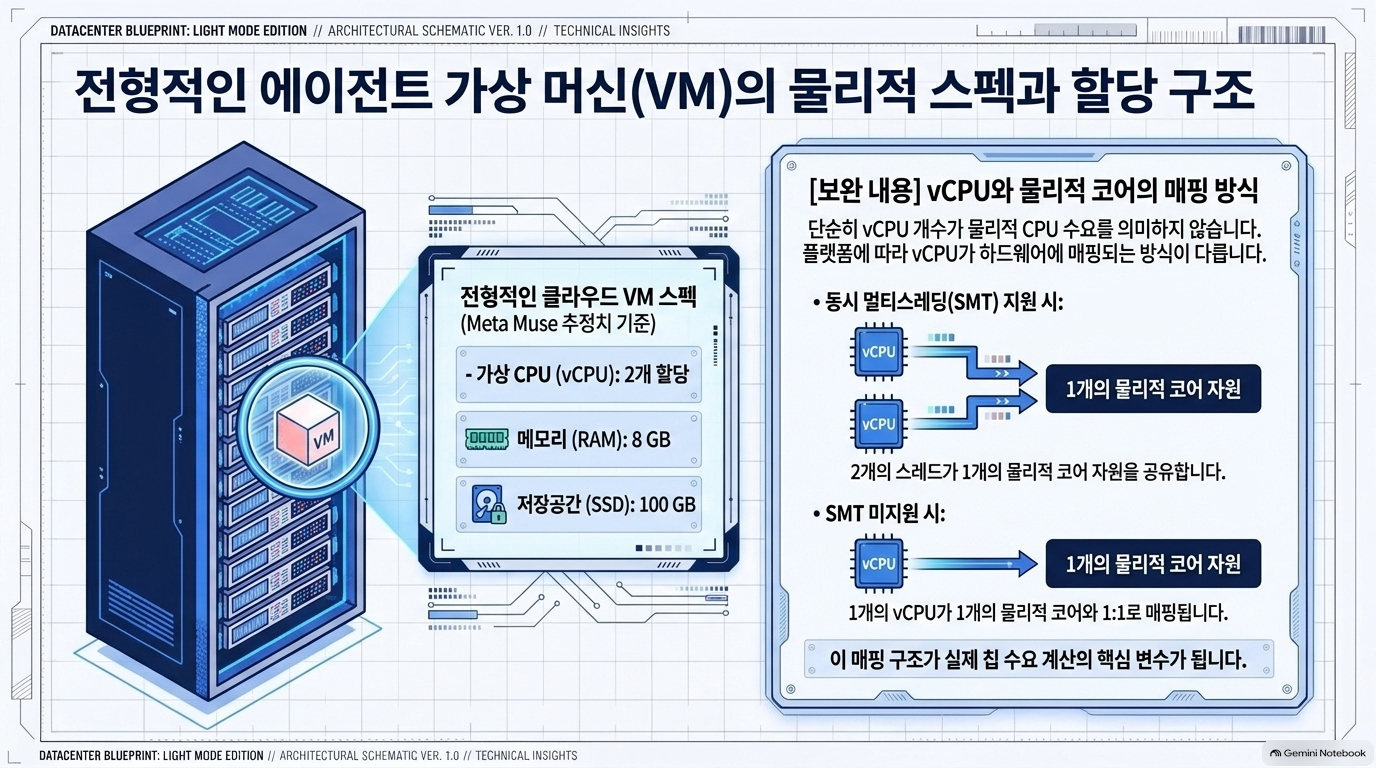
글은 특정 서비스의 VM을 2 vCPU·8 GB RAM·100 GB SSD로 파악했다는 사례를 제시하지만, 해당 사양은 운영사의 공식 확인을 받지 않았다고 명시합니다. 따라서 이를 모든 개인용 에이전트의 표준 사양이나 실제 메모리 사용량으로 취급하면 안 됩니다.[1]
또한 vCPU는 물리 코어와 동일하지 않습니다. 플랫폼에 따라 하드웨어 스레드에 대응할 수 있고, 동시 멀티스레딩(SMT)을 쓰는 두 스레드는 한 코어의 실행 자원을 공유합니다. VM에 할당한 vCPU를 단순 합산해 물리 CPU 구매량으로 바꿀 수 없는 이유입니다.[1]
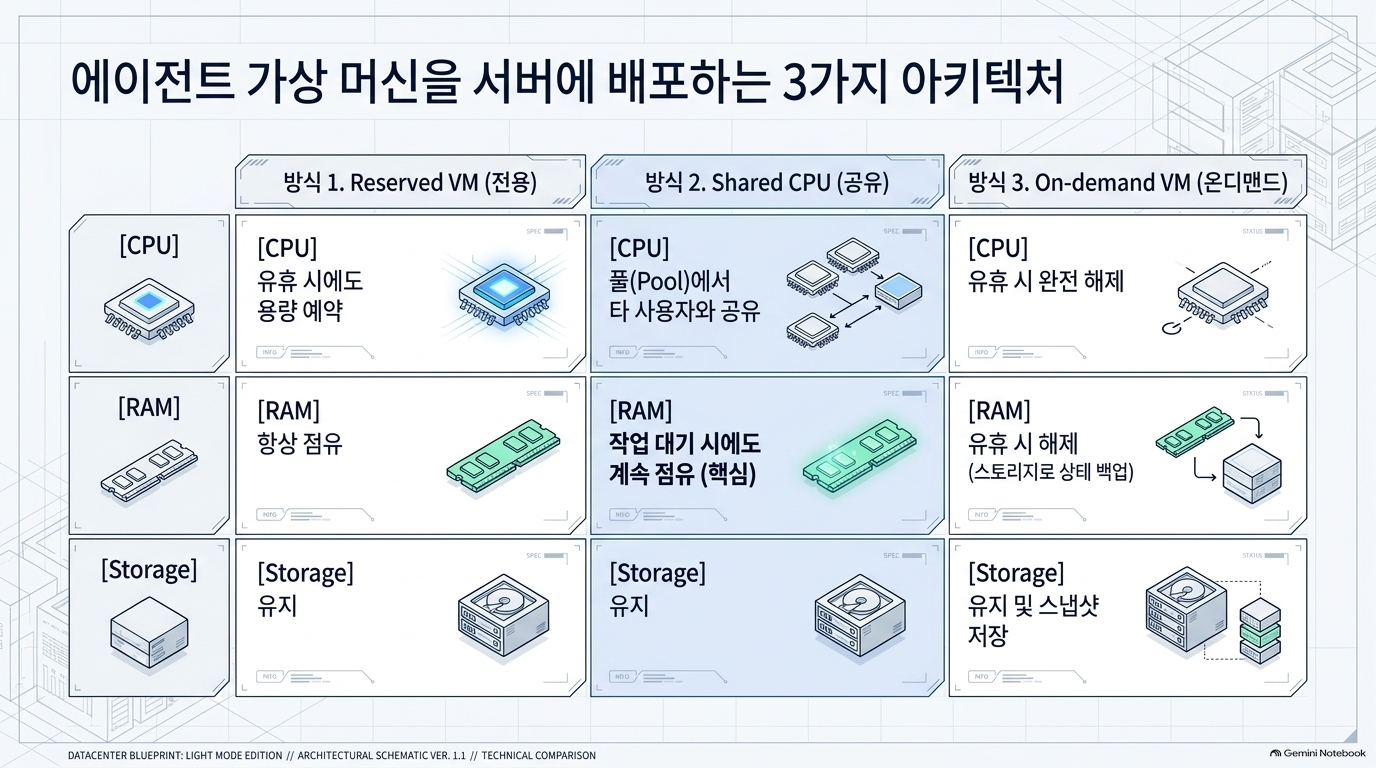
3. How Many Agents Can Share a CPU Server? — 배치 방식이 CPU 밀도를 바꾼다
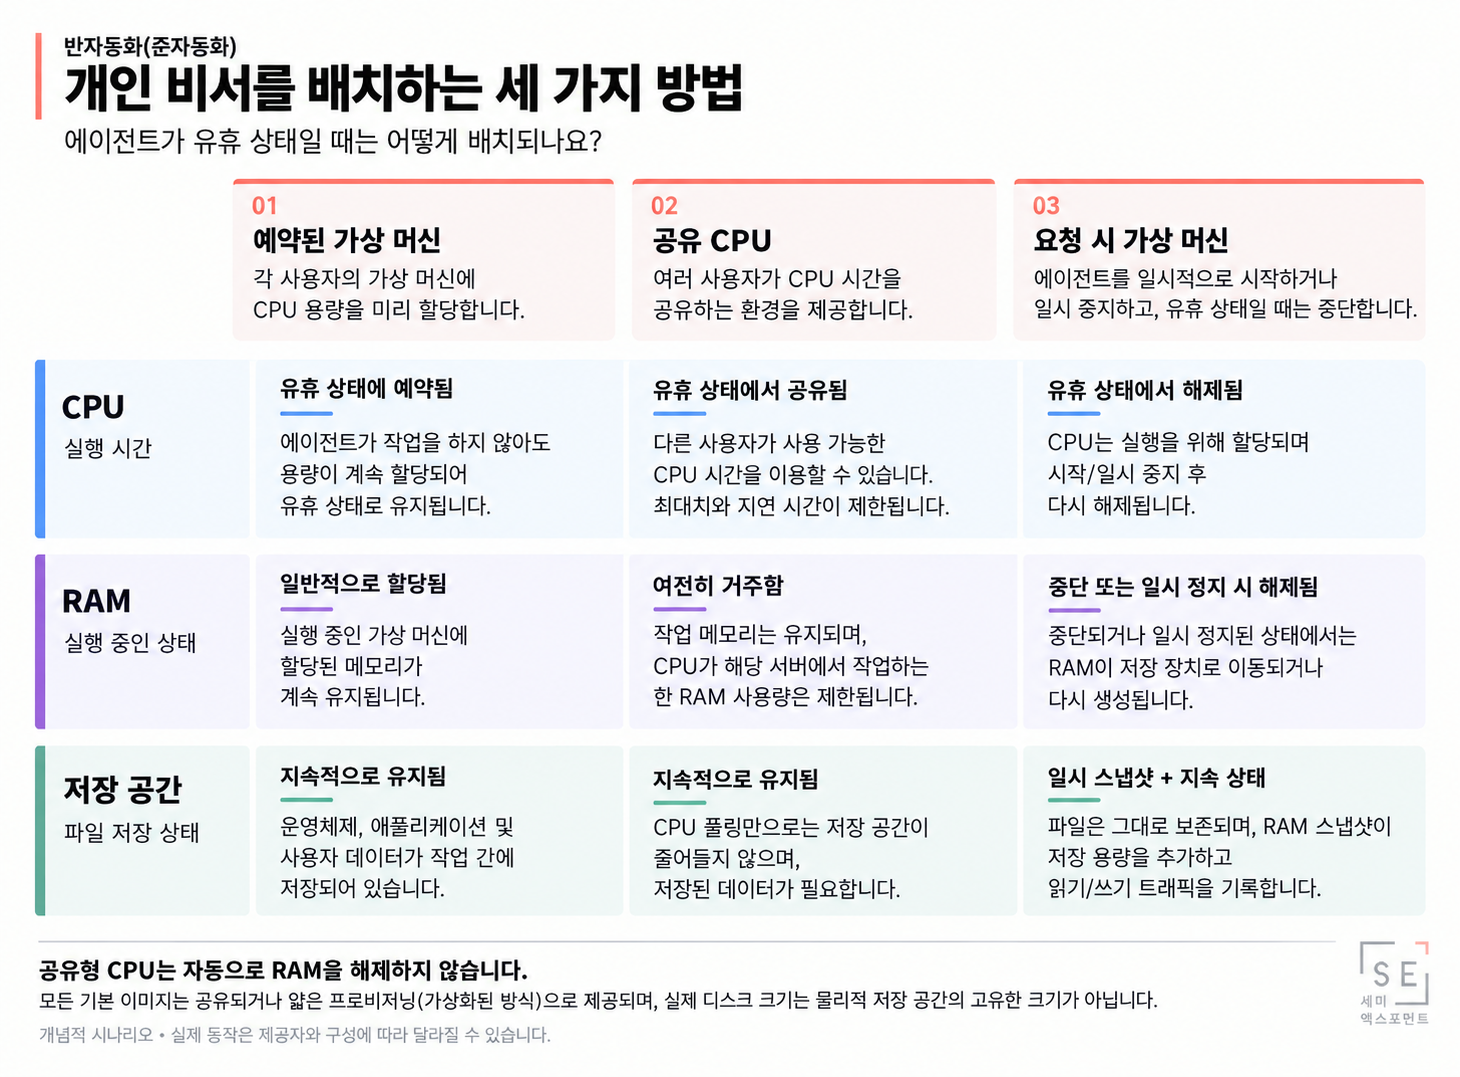
| 배치 방식 | 에이전트가 유휴 상태일 때 CPU | RAM | 주요 절충점 |
| Reserved VM | 이용자별 용량을 계속 확보 | VM에 계속 할당 | 지연을 낮추기 쉽지만 유휴 용량이 큼 |
| Shared CPU | 이용자 간 실행 시간 공유 | 실행 환경의 작업 메모리는 유지 | 간헐적 작업에 적합하나 RAM은 공유만으로 해제되지 않음 |
| On-demand VM | 작업 시 시작·재개하고 이후 해제 | 상태 저장·중단을 통해 상당 부분 해제 가능 | 재개 지연과 저장소 입출력 증가 |
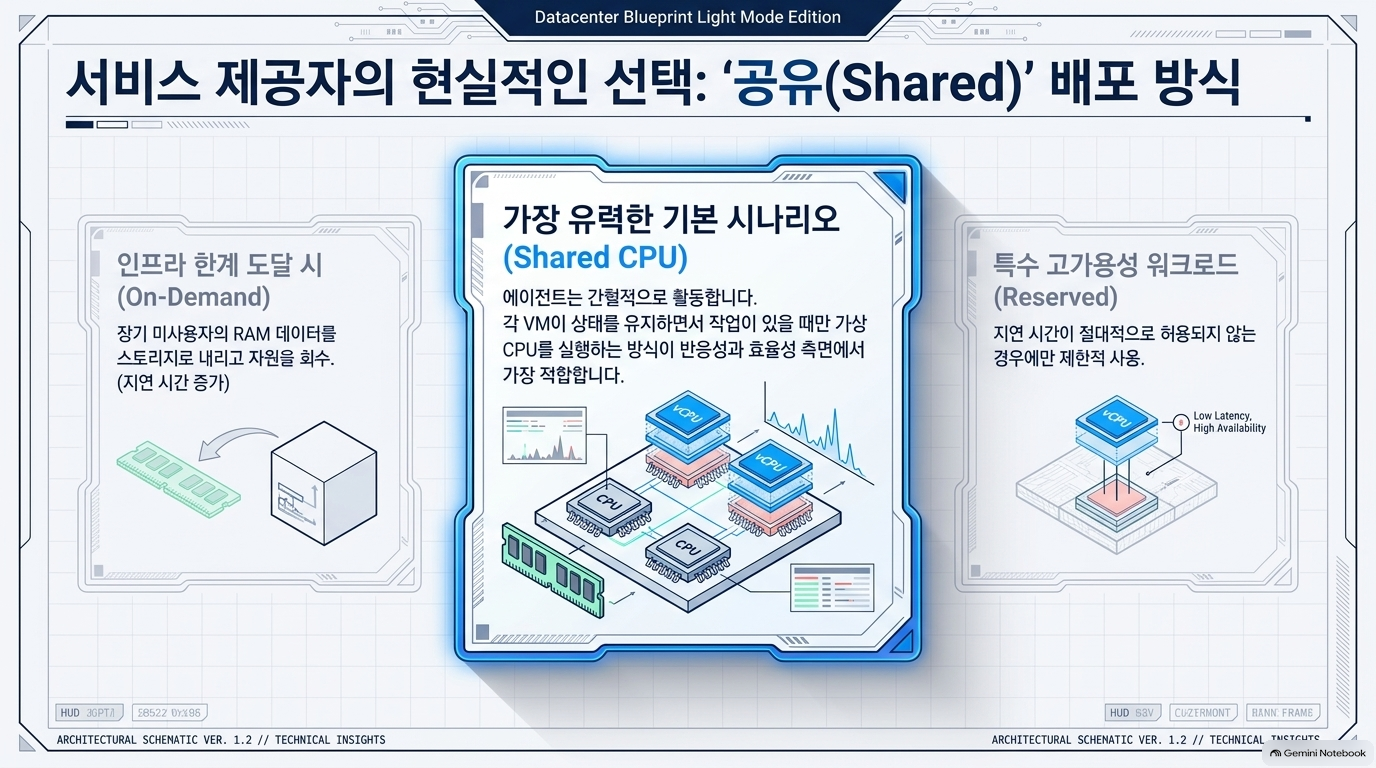
저자는 Shared CPU가 일반적인 경우에 가장 그럴듯하다고 판단하고, 장기간 비활성 이용자에게는 On-demand VM, 낮은 지연이 특별히 중요한 경우에는 Reserved VM이 적합할 수 있다고 봅니다. 이는 해당 서비스들의 실제 운영 방식을 확인한 결과가 아니라 저자의 추정입니다.[1]
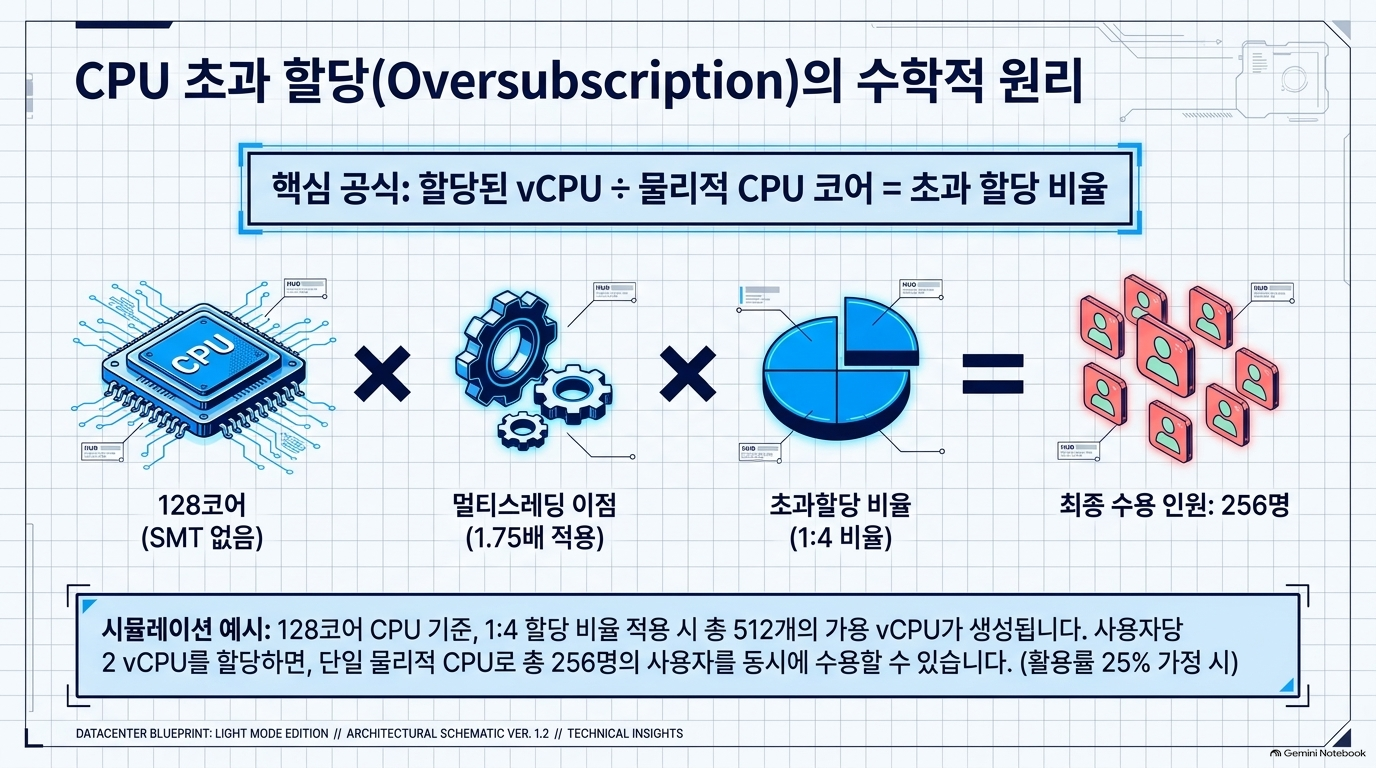
이 장의 산식은 다음과 같습니다.
초과할당 비율 = 할당한 vCPU 수 ÷ 물리 CPU 코어 수
예컨대 SMT를 제외한 128코어 CPU에 코어당 4개의 vCPU를 할당하고, 이용자당 2 vCPU를 준다면 512 vCPU, 즉 256개 VM을 배치할 수 있습니다. 그러나 이는 할당상 가능한 개수이지, 모든 VM이 동시에 CPU를 요구할 때 성능이 유지된다는 보장은 아닙니다.[1]
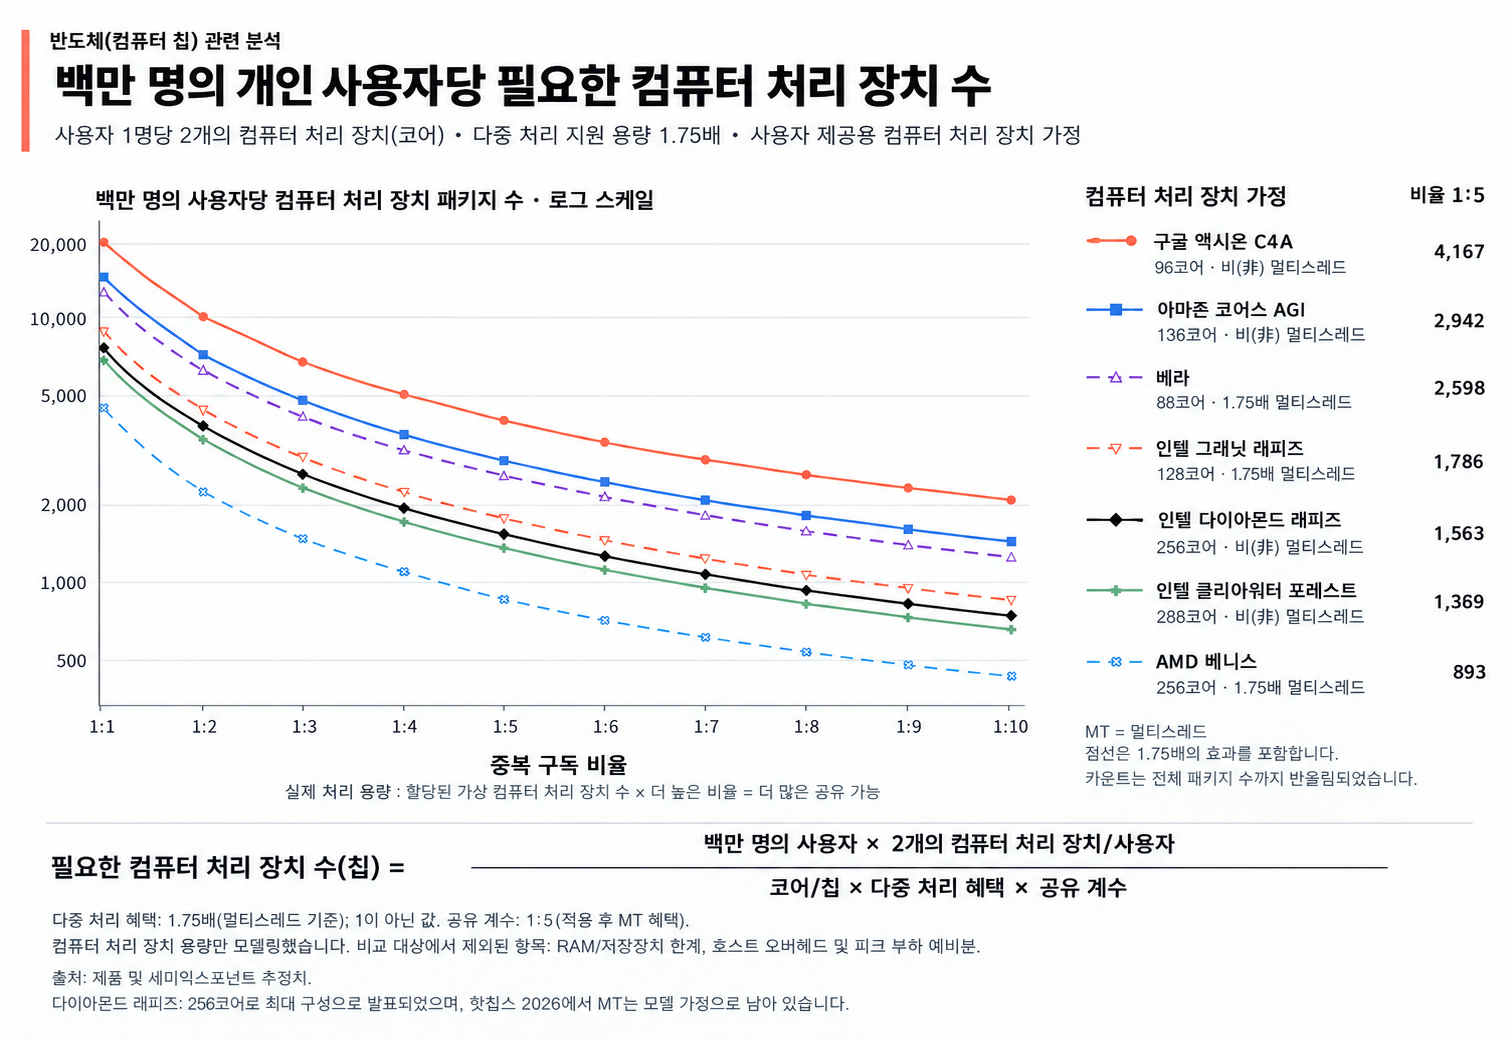
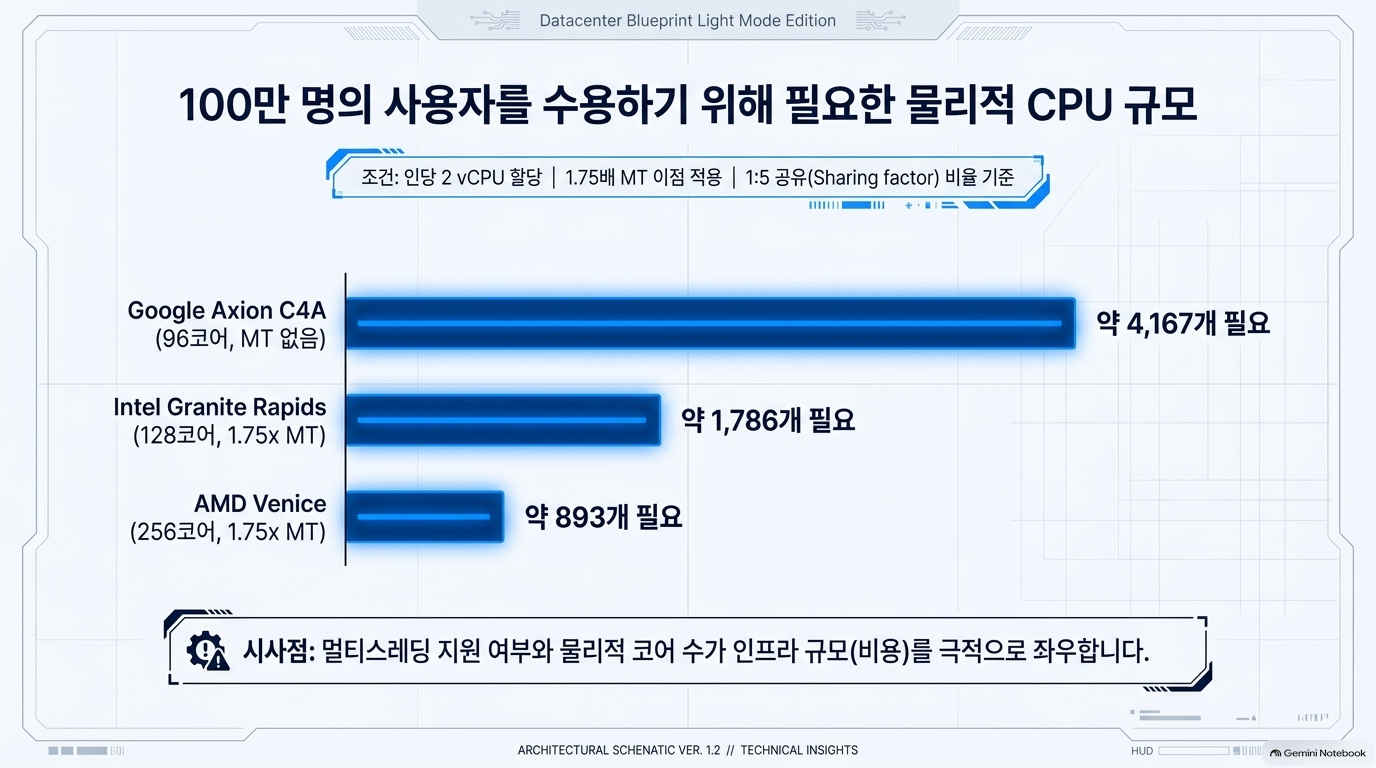
비교 도표는 이용자당 2 vCPU, SMT 적용 시 유효 용량 1.75배, 여러 CPU 공유율을 가정해 100만 이용자당 필요한 CPU 패키지를 그립니다. 공유 계수 5배 지점의 표시값은 다음과 같습니다.[1]
| 도표의 CPU 가정 | 100만 이용자당 CPU 패키지 |
| Google Axion C4A, 96코어·SMT 없음 | 4,167개 |
| ARM AGI, 136코어·SMT 없음 | 2,942개 |
| AMD Vera, 88코어·SMT 1.75배 가정 | 2,598개 |
| Intel Granite Rapids, 128코어·SMT 1.75배 가정 | 1,786개 |
| Intel Diamond Rapids, 256코어·SMT 없음 가정 | 1,563개 |
| Intel Clearwater Forest, 288코어·SMT 없음 | 1,389개 |
| AMD Venice, 256코어·SMT 1.75배 가정 | 893개 |
도표 해석의 경계: 이는 동등한 코어당 성능을 가정한 CPU 용량 모델입니다. 도표 자체도 RAM·저장소 제약, 호스트 오버헤드, 최대 사용 시간대의 여유 용량을 제외한다고 밝힙니다. 따라서 숫자는 구매 예측이나 제품 간 실측 성능 순위가 아닙니다. 특히 CPU 패키지 수를 서버 대수와 혼동해서도 안 됩니다.[1]
4. Memory Constraints on Agentic VMs — 메모리가 먼저 포화되는 사례
글의 핵심 반례는 256코어 CPU × SMT 유효 용량 1.75배 × CPU 공유 4배 ÷ VM당 2 vCPU = 896개 VM입니다. CPU만 보면 한 프로세서에 그만큼 배치할 수 있지만, 각 VM이 실제로 8 GiB를 계속 점유한다면 필요한 메모리는 7,168 GiB, 즉 7 TiB입니다. 반면 사용 가능한 RAM이 1.5 TiB라면, 호스트 메모리를 빼기도 전에 192개 VM밖에 상주시키지 못합니다. 두 계산값은 원문의 산식과 일치합니다.[1]
따라서 물리 자원별로 수용 가능한 VM 수를 따로 구한 뒤 먼저 한계에 닿는 자원을 기준으로 배치해야 합니다. CPU 공유율을 높여도 RAM을 그대로 붙잡는다면 CPU 밀도의 이득은 실현되지 않습니다. 반대로 사용하지 않는 VM을 중단하고 상태를 저장소에 보관하면 상주 RAM을 줄일 수 있지만, 재개 시간과 저장소 읽기·쓰기 부담이 생깁니다.[1]
여기서 ‘8 GB 할당’과 ‘8 GB 실제 상주’는 다릅니다. 원문도 VM이 할당받은 RAM을 모두 작업 집합으로 사용하지 않을 수 있다고 인정합니다. 그러므로 위의 192개는 특정 메모리 사용 가정하의 예시이지, 개인용 에이전트의 보편적 서버 밀도가 아닙니다.[1]
저자는 단일 256 TB QLC SSD라면 100 GB 규모의 VM 환경을 2,500개 이상 수용할 수 있다는 용량 예를 들어, 이 모델에서는 SSD 용량보다 RAM이 근본적인 제약이라고 봅니다. 다만 저장 용량이 충분하다는 사실만으로 다수 VM의 동시 재개에 필요한 입출력 성능이나 지연까지 충분하다고 결론낼 수는 없습니다. 이 부분은 모델의 범위 밖입니다.[1]
5. From Agent VMs to CPU revenue — 공개 구간의 결론과 미공개 부분
이 장의 공개된 도입부에서 저자는 에이전트 보급을 CPU 구매·매출로 연결하겠다고 밝히면서, 채택 경로는 검증된 배치 자료에 근거한 예측이 아니라 시나리오라고 선을 긋습니다.[1]
이후 유료 구간의 예고에는 2030년까지의 CPU 매출 모델, 공유율·할인·가격 하락·기존 장비 재사용 가정, 메모리 병목, AMD·Intel·NVIDIA·Arm 구성 비교, 투자 논거가 포함됩니다. 공개 원문만으로는 그 매출 수치나 업체별 최종 승자를 확인할 수 없습니다.[1]
종합 평가와 실무 시사점
이 글의 가장 유용한 기여는 이용자 수 → vCPU 할당량 → 물리 CPU 구매량이라는 단선적 계산을 깨고, 동시 실행 CPU 수요와 상주 메모리 수요를 분리한 데 있습니다. 반면 공유 계수와 SMT 유효 계수는 워크로드에 따라 달라지고, 제시된 VM 사양과 실제 배치 방식은 확인된 운영 데이터가 아닙니다.[1]
개인용 에이전트 인프라를 실제로 산정한다면, 먼저 최대 시간대 동시 활성 VM 수, VM별 CPU 사용 시간, 유휴 시 실제 상주 RAM, 재개 지연 허용치, 저장소 재개 트래픽을 측정해야 합니다. 그 결과로 CPU 제한 밀도와 RAM 제한 밀도를 각각 계산하고 작은 값을 적용하는 편이, 가입자 수에 고정 vCPU를 곱하는 방식보다 타당합니다. 투자 관점에서도 가입자 증가만이 아니라 VM 상주율과 재사용 가능한 기존 설비가 신규 CPU 구매를 얼마나 바꾸는지가 검증되어야 합니다.[1]
Sources
[1] Vikram Sekar, “How Many CPUs Do Personal AI Assistants Need?” — 공개 본문 및 도표

'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - Jev : Jev는 어떻게 동작하나요? (0) | 2026.10.09 |
|---|---|
| 에이전트 AI - Jev : 10분 만에 Jev 이해하기 (0) | 2026.10.09 |
| 에이전트 AI - NVIDIA NemoClaw 기반 개인 에이전트 구축 (0) | 2026.10.09 |
| 에이전트 AI - 개인 에이전트 시장의 경제성 분석 (0) | 2026.10.09 |
| AI 에이전트 - O’Reilly Radar, 코딩 에이전트의 Architectural Decision Records (ADRs) (0) | 2026.10.07 |