https://developer.nvidia.com/blog/building-a-memory-driven-agent-with-nvidia-nemoclaw
2026.9.4
[Building a Memory-Driven Agent with NVIDIA NemoClaw]
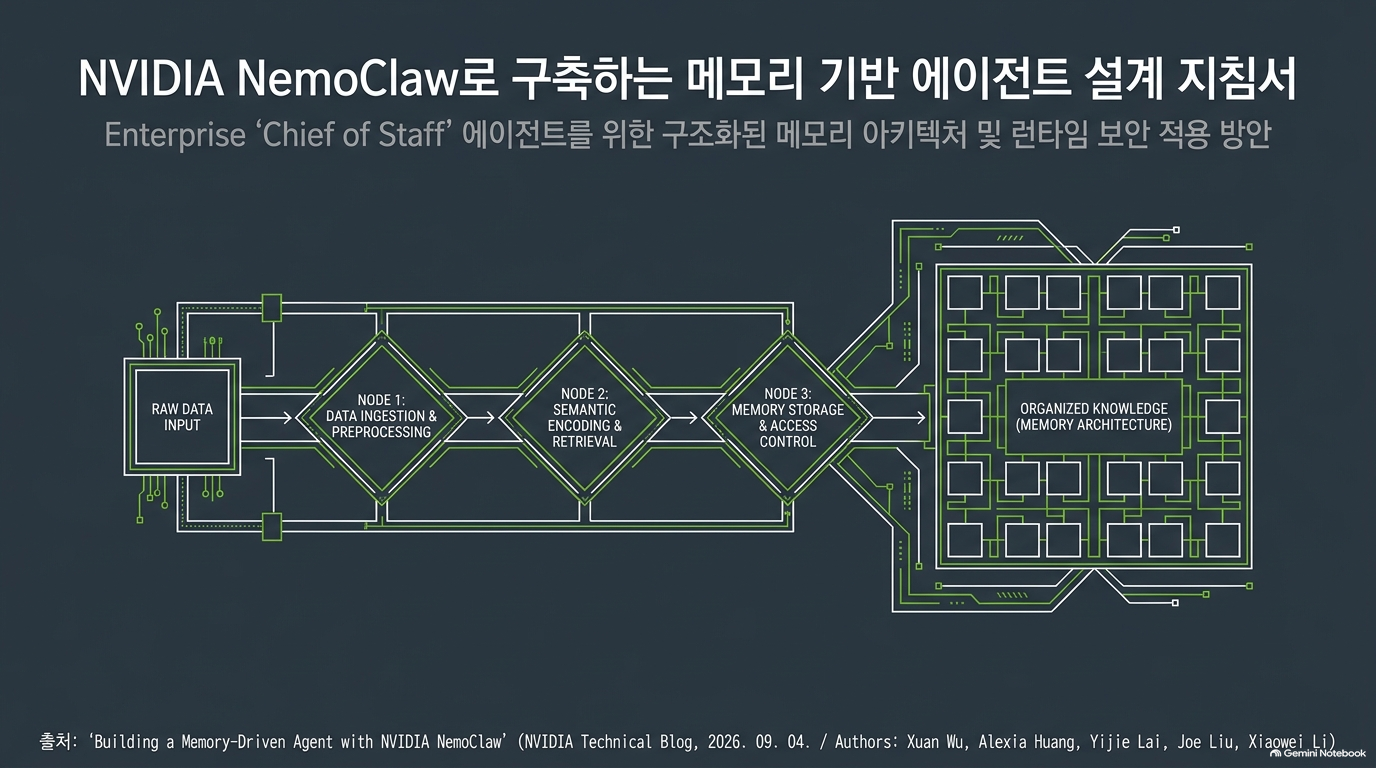
이 글은 NVIDIA NemoClaw를 활용해 기업 환경에서 복잡한 업무 맥락을 관리하는 메모리 기반 AI 에이전트 구축 방법을 소개합니다. 이 시스템은 단순한 데이터 저장을 넘어 사용자, 프로젝트, 우선순위를 기록하는 자기 모델(self model)을 생성하여 시간이 흐름에 따라 변화하는 지식을 구조적으로 유지합니다. 특히 단순한 긴급성보다 사용자의 의도를 우선시하고 사용자의 피드백을 통해 판단을 수정하는 기능을 갖추어, 기존 방식보다 월등히 높은 업무 정확도와 추론 능력을 보여줍니다. 결과적으로 NVIDIA OpenShell의 보안 환경 내에서 안전하게 작동하는 이 에이전트는 기업의 생산성을 높이는 지능형 수석 보좌관 역할을 수행할 수 있습니다.
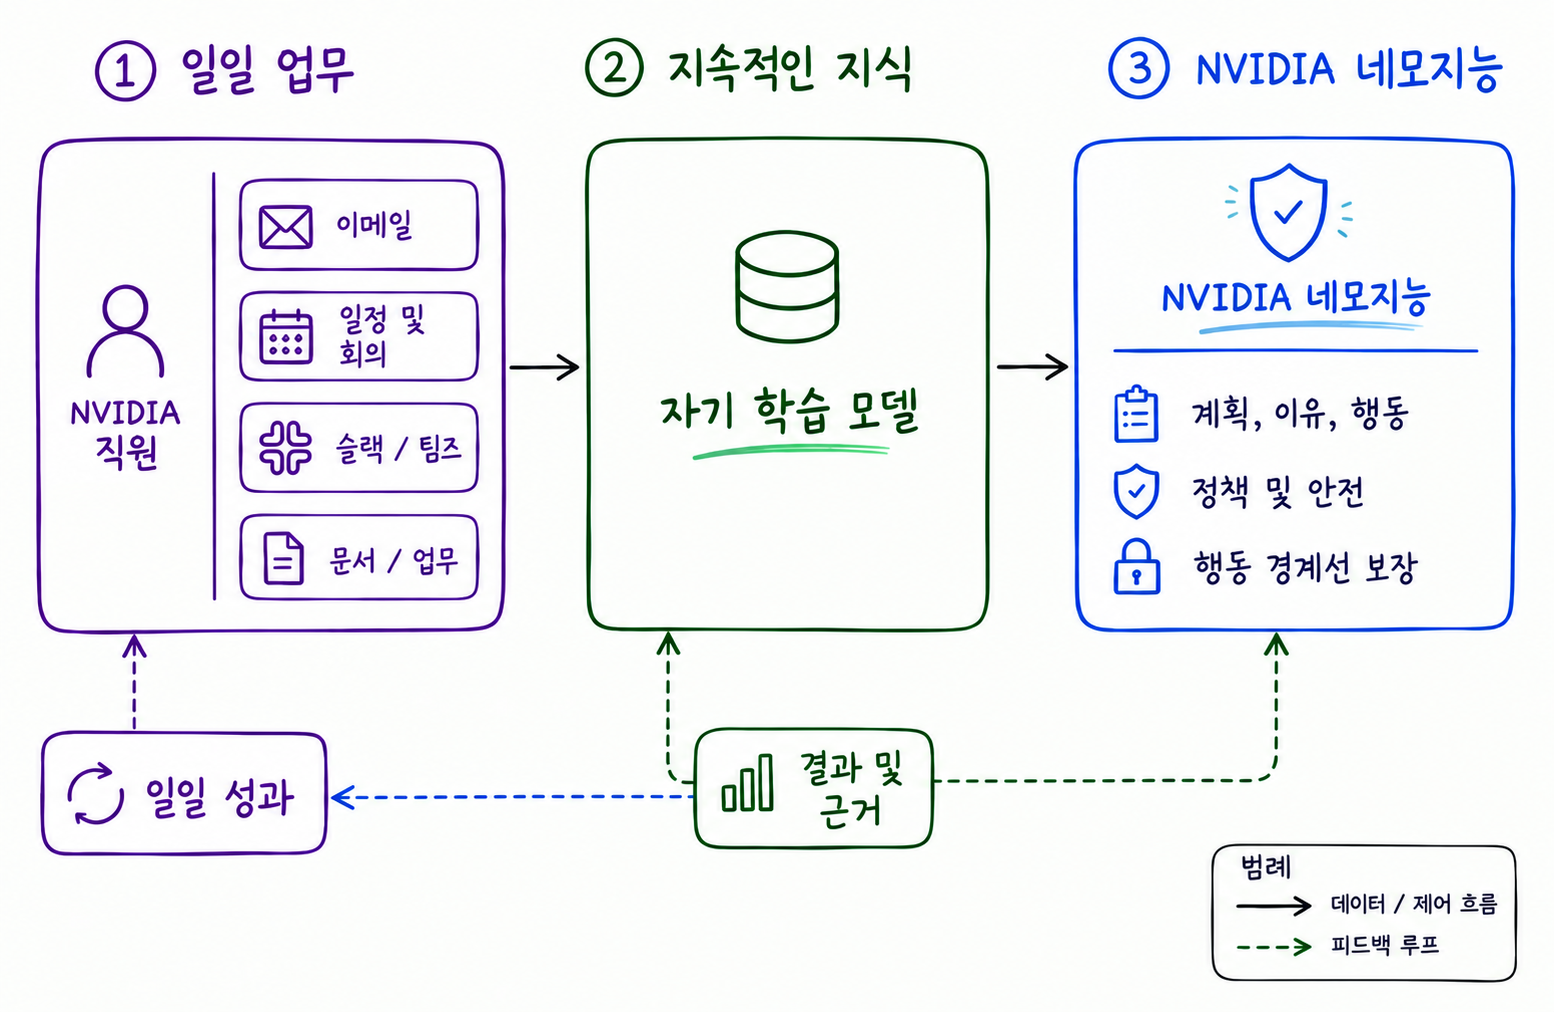
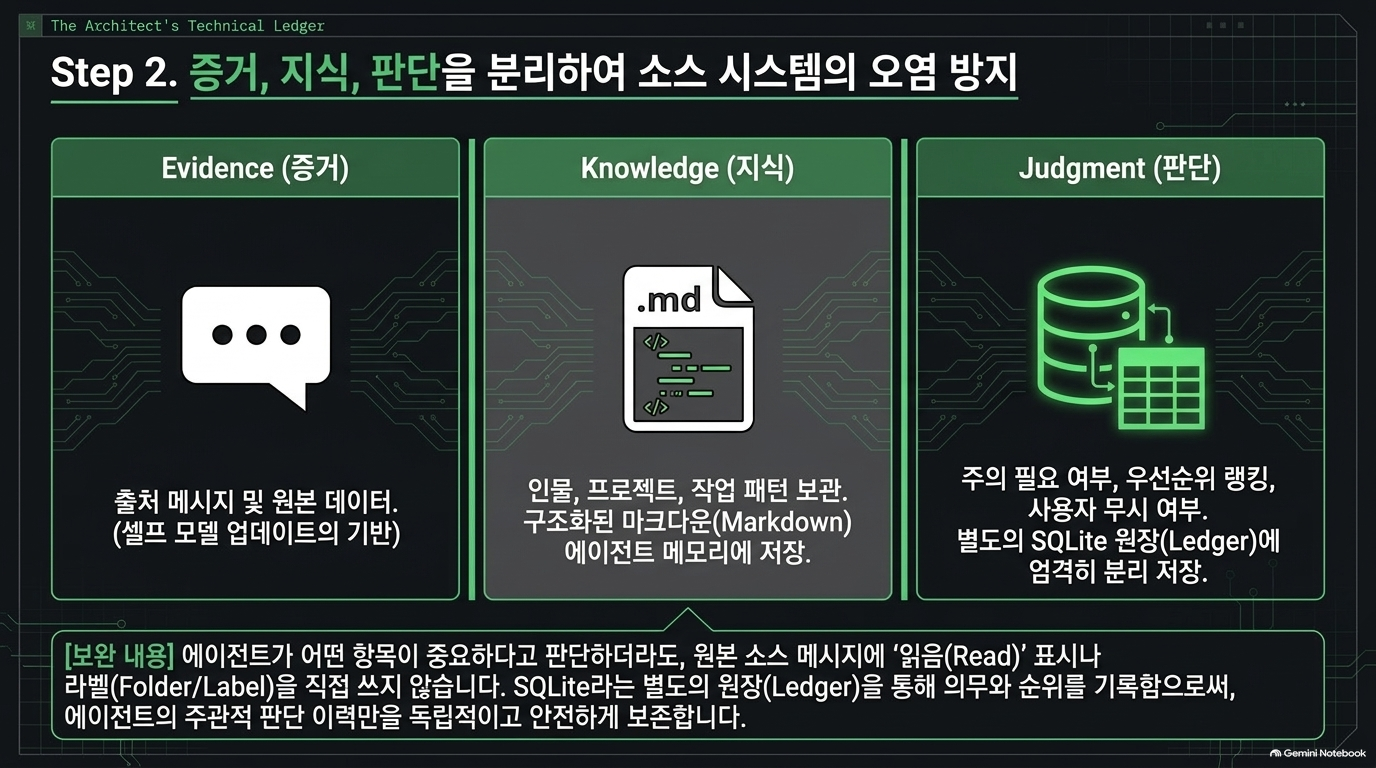
- 지식 : 사람, 프로젝트, 우선순위 및 업무 방식
- 판단 : 해당 항목에 주의가 필요한지, 중요도는 어느 정도인지, 그리고 사용자가 해당 항목을 무시했는지 여부
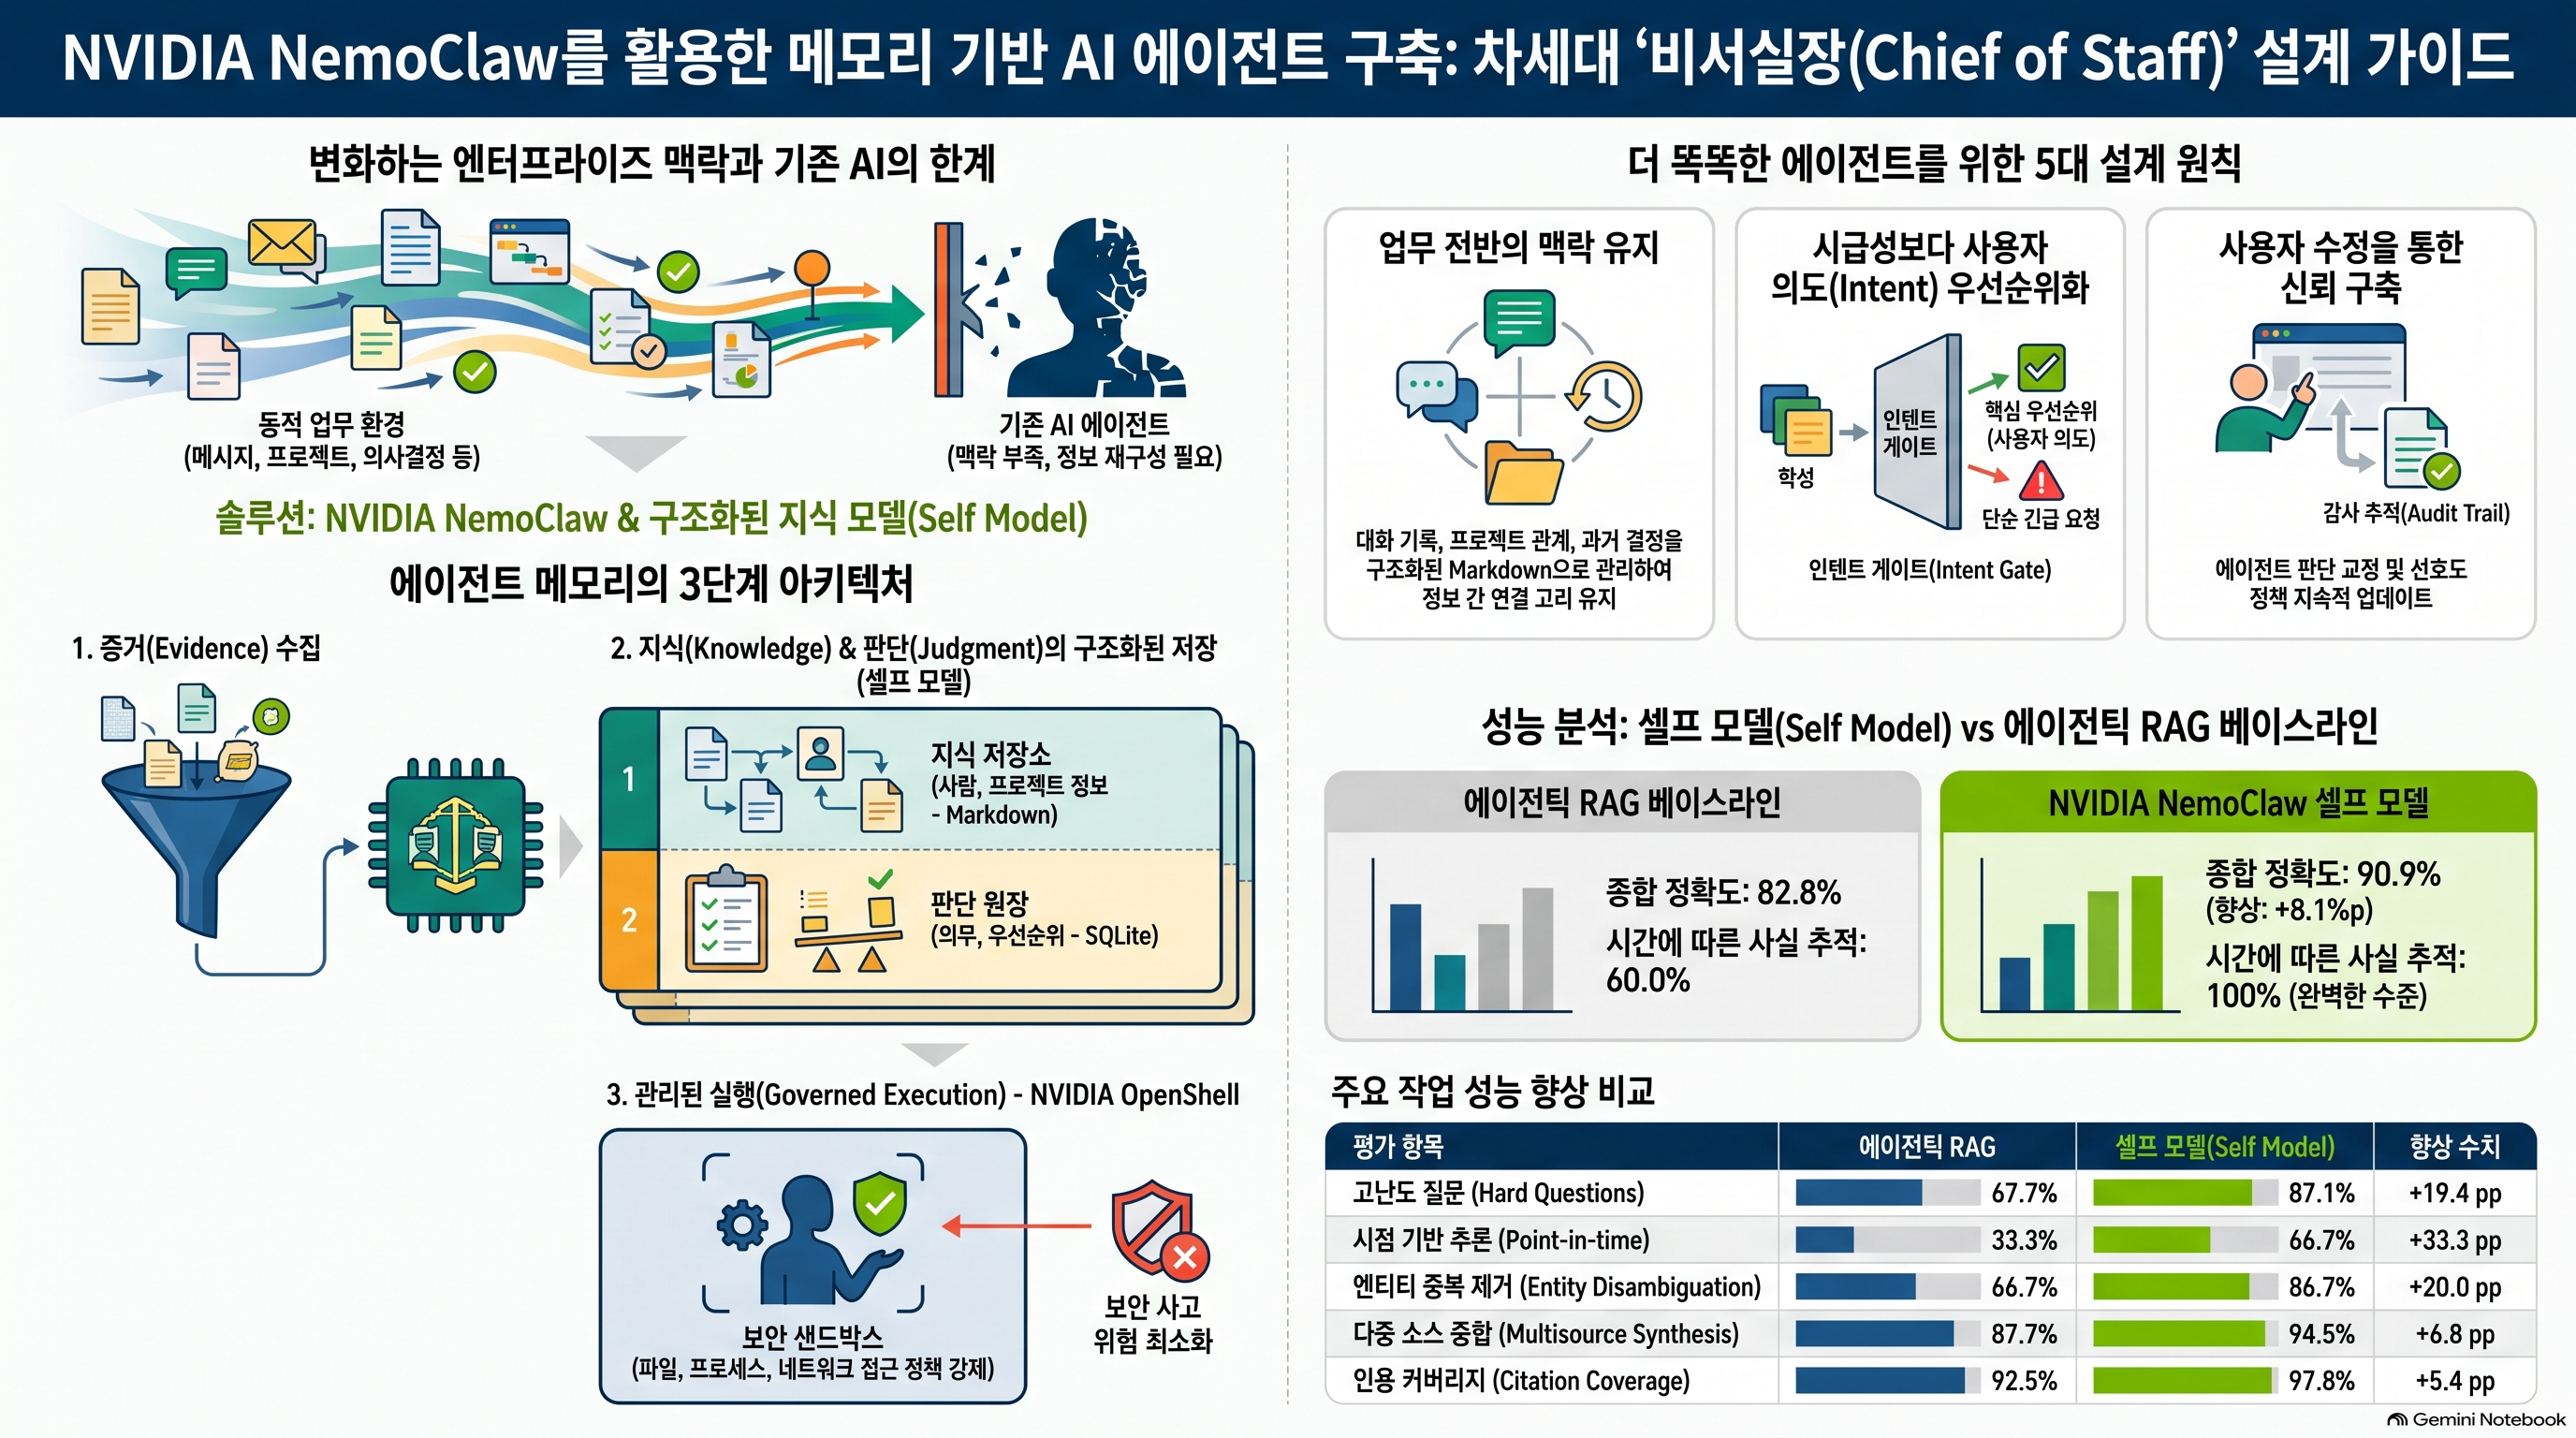
이 글은 NVIDIA가 업무 맥락을 지속적으로 유지하는 ‘Chief of Staff’형 AI 에이전트의 설계 원칙과 공개 구현 예제를 소개한 기술 블로그입니다. 2026년 9월 4일 게시되었으며, 본문은 7개 주요 챕터로 구성됩니다.[1]
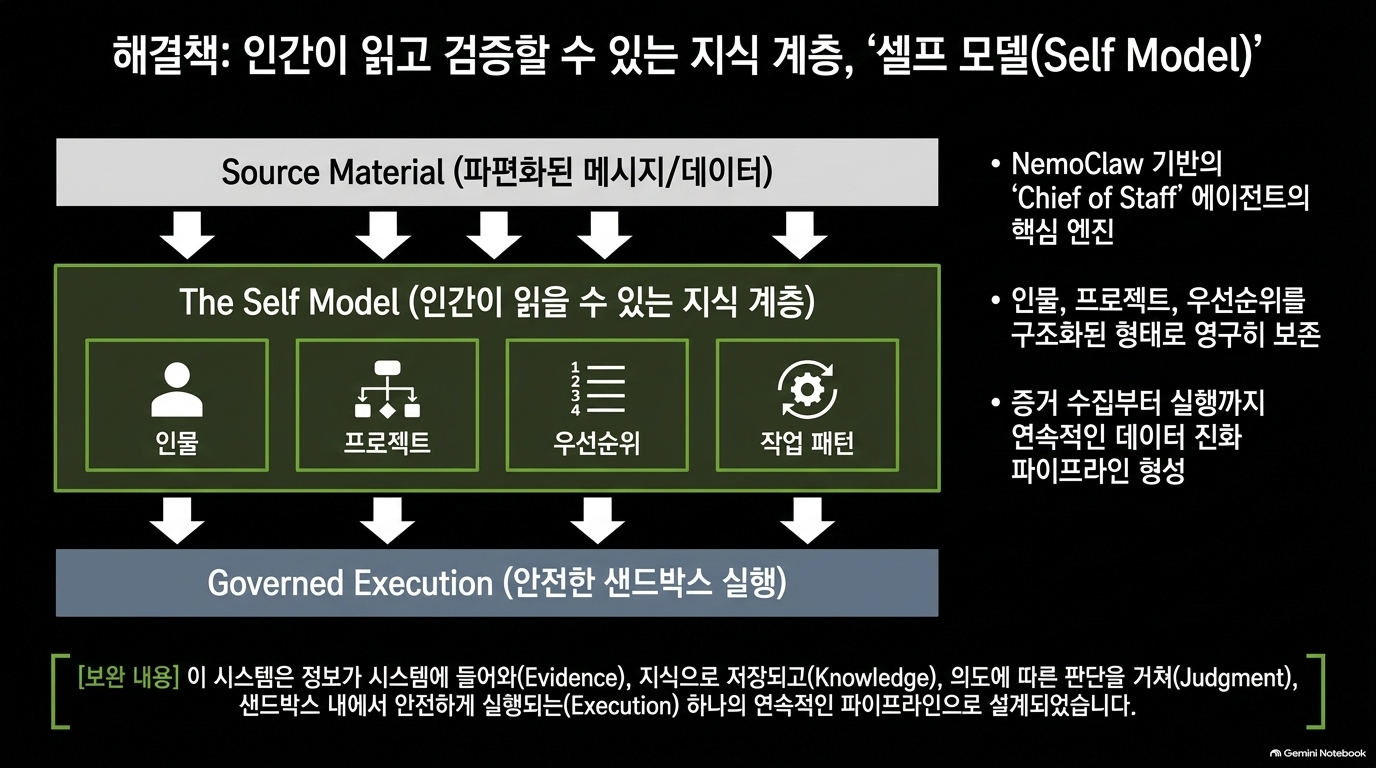
여기서 Self Model은 모델의 자아나 가중치 학습을 뜻하지 않습니다. 사람·프로젝트·우선순위·업무 패턴에 관한, 사람이 읽고 수정할 수 있는 지속적 업무 지식 계층을 의미합니다.[1]
핵심은 “에이전트가 많이 기억하게 하자”가 아니라, “근거·지식·판단·실행 권한을 분리하고 기억을 지속적으로 검증·수정하자”는 것입니다.
다만 설계의 타당성과 성능 검증의 강도는 구분해야 합니다. 원문은 정확도 개선을 보고하지만, 연결된 평가 자료는 단일 합성 코퍼스·단일 기반 모델에 한정되며, 평가에 사용된 Self Model의 어댑터와 메모리는 공개되어 있지 않다고 명시합니다.[5]
아래에서는 원문 내용, 해석, 실무 보완사항을 구분합니다.
2. 전체 논리 구조
| 챕터 | 원문 제목 | 다루는 문제 | 설계 원칙 |
| 1 | Maintain context across daily work | 대화·검색만으로 변화하는 업무 맥락을 유지하기 어려움 | 구조화된 지속적 업무 지식 |
| 2 | Separate evidence, knowledge, and action | 사실·에이전트 판단·실행 권한이 혼재됨 | 계층 분리 |
| 3 | Prioritize user intent over short-term urgency | 요청자의 긴급성이 사용자의 중요도를 압도함 | 사용자 의도 기반 우선순위 |
| 4 | Allow users to correct the agent | 잘못된 판단이 기억에 고착됨 | 수정·감사·선호 정책의 피드백 |
| 5 | Add memory to improve agent task performance | 메모리의 효과를 어떻게 검증할 것인가 | 유형별 성능 평가 |
| 6 | Enforce the boundary at runtime | 기억이나 검색 문서가 권한처럼 작동할 위험 | 런타임 강제 통제 |
| 7 | Get started building agent memory | 설계를 어떻게 구현·검토할 것인가 | 공개 레시피와 제한된 실증 범위 |
챕터 순서와 제목은 원문 기준입니다.[1]
3. 챕터별 상세 분석
챕터 1. 일상 업무 전반의 맥락 유지
Maintain context across daily work
① 원문의 주장
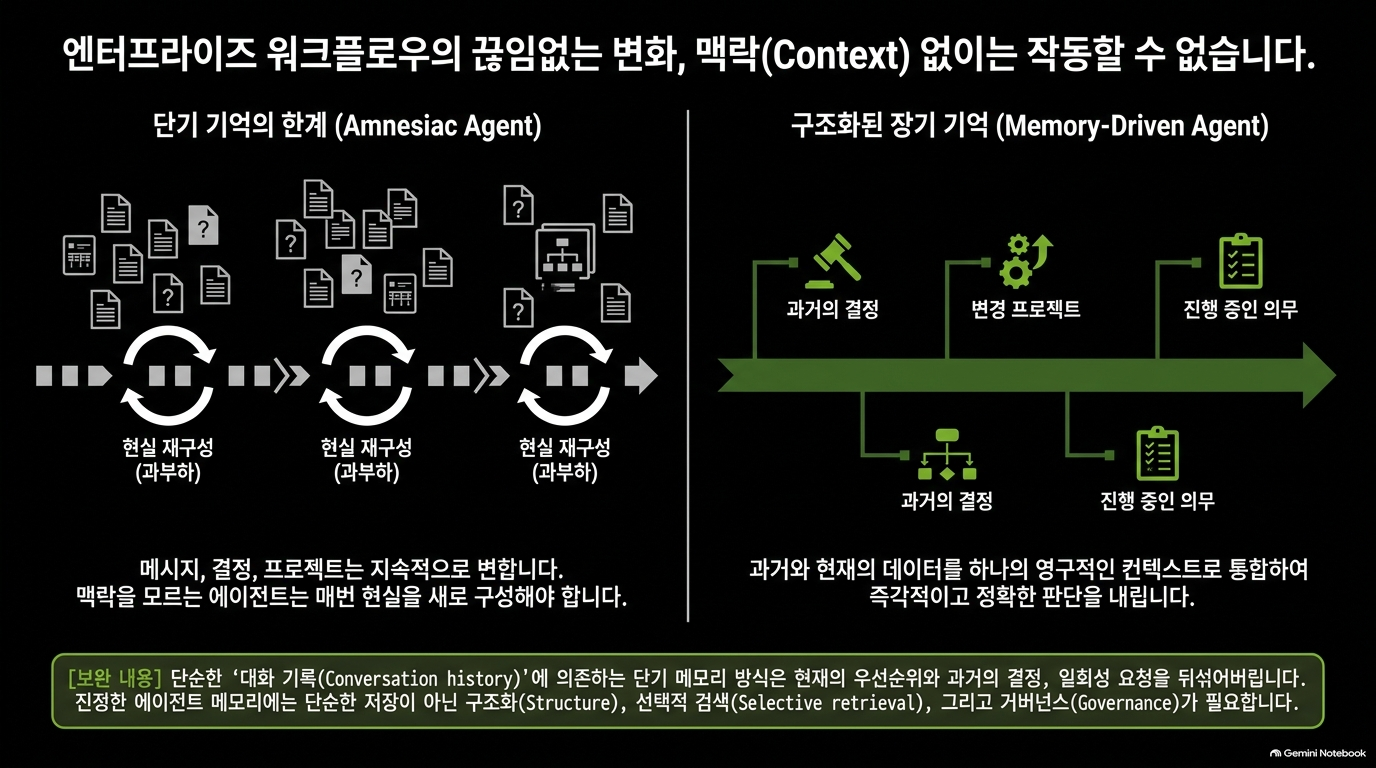
대화 이력은 단기적 연속성을 제공하지만, 현재 우선순위·과거 결정·일시적 요청이 섞여 있습니다. 검색은 관련 자료를 찾을 수 있어도, 시간에 따른 관계를 에이전트가 다시 연결해야 합니다.[1]
원문이 제시하는 프로젝트 상태 질문은 다음을 함께 이해해야 하는 사례입니다.[1]
- 이전에 내려진 결정
- 이후 메시지에서 수정된 내용
- 아직 해결되지 않은 의무
- 서로 다른 이름이 같은 프로젝트를 가리킨다는 사실
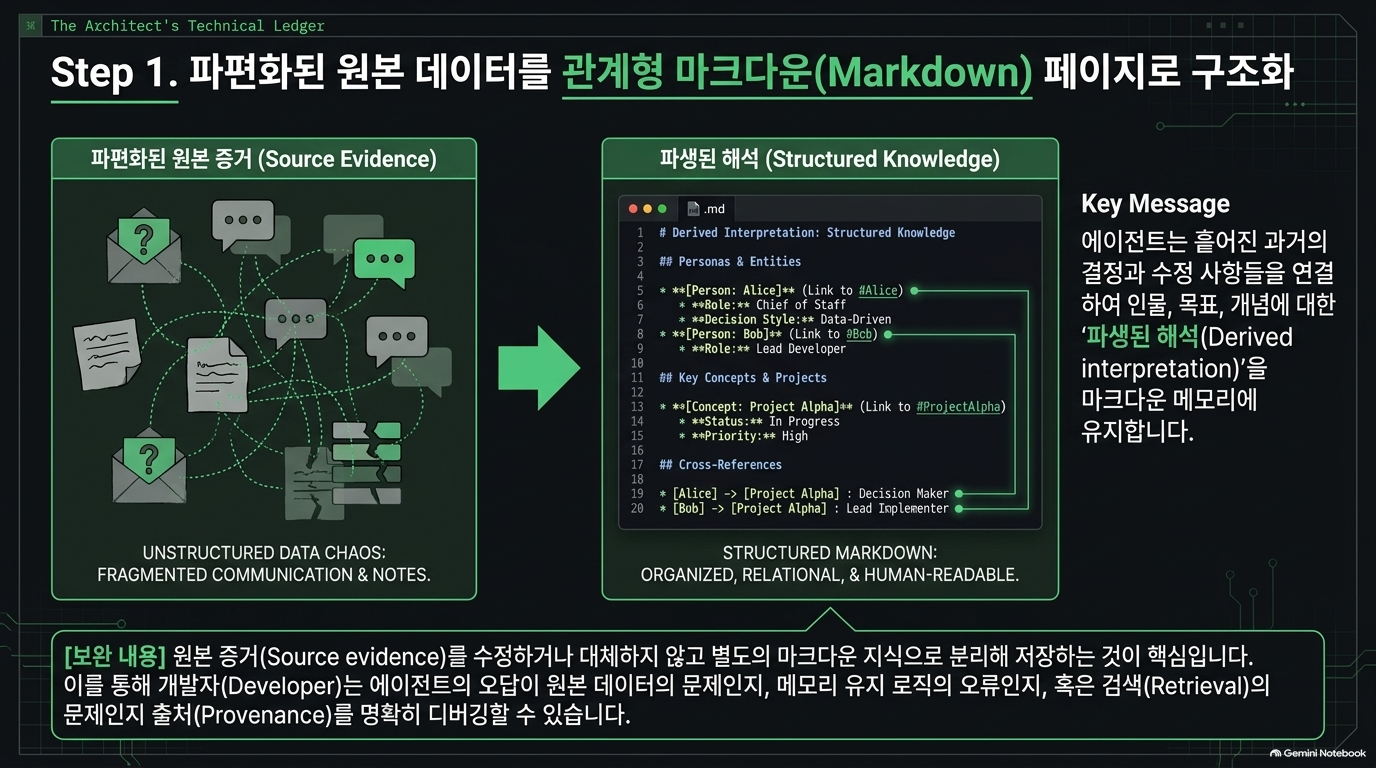
이를 위해 Self Model은 사람·프로젝트·우선순위·목표·개념·반복 업무 패턴을 구조화된 Markdown 페이지에 저장하고, 스키마로 인덱스·상호 참조·출처·성장 한계를 정의합니다.[1]
② 분석: 검색의 문제가 아니라 ‘상태 유지’의 문제
이 챕터의 핵심은 문서 관련성 검색과 현재 업무 상태 재구성은 다른 과제라는 점입니다.
예를 들어 다음은 분석을 위한 가상 사례입니다.
| 원천 근거 ├─ 초기 회의: A안을 채택 ├─ 후속 메일: 보안 검토로 A안 보류 └─ 최종 결정: B안 승인 업무 지식 ├─ 현재 유효한 결정: B안 ├─ A안: 과거 결정, 현재 보류 └─ 결정 변경의 근거: 후속 메일·최종 승인 기록 |
관련 문서를 모두 찾아도, 무엇이 현재 유효한 결정인지 판별하지 못하면 업무 답변은 틀릴 수 있습니다.
③ 중요한 구분: 업무 메모리는 원천 증거가 아니다
원문은 Self Model을 원천 근거에서 도출된 해석으로 규정합니다. 원천 증거를 대체하지 않으므로, 오답이 발생했을 때 근거·메모리 유지·검색·최종 판단 중 어느 단계에서 문제가 생겼는지 분리해 볼 수 있습니다.[1]
실무적 의미
- 업무 위키는 현재 상태를 빠르게 이해하는 계층입니다.
- 중요한 결론은 원천 문서로 역추적할 수 있어야 합니다.
- 기억에 저장되었다는 사실만으로 정확하거나 최신인 것은 아닙니다.
[보완 필요 — 분석자 권고]
공공·기업 업무에서는 출처 외에도 유효 시작일, 유효 종료일, 승인 상태, 대체 결정, 마지막 검증일을 관리하는 것이 적절합니다. 현재 사실과 특정 시점의 사실을 동시에 설명하려면 최신값만 덮어쓰는 방식으로는 부족합니다.
챕터 2. 근거·지식·행동 분리
Separate evidence, knowledge, and action
① 원문의 구조
원문은 다음 흐름을 제시합니다.[1]
| Evidence → Knowledge → Governed execution 근거 업무 지식 통제된 실행 |
그리고 저장할 정보를 두 종류로 구분합니다.[1]
| 구분 | 저장 대상 | 저장 방식 |
| Knowledge | 사람·프로젝트·우선순위·업무 패턴 | Markdown 업무 메모리 |
| Judgment | 주의 필요 여부·순위·사용자의 무시 결정 등 | SQLite 원장 |
SQLite 원장에는 의무, 순위, 수정, 감사 이벤트를 저장합니다. 에이전트의 판단을 원천 메시지의 읽음 표시·라벨·폴더에 기록하지 않는 것이 특징입니다.[1]
② 분석: 에이전트의 의견을 원천 업무 데이터와 분리
“이 메시지는 중요하지 않다”는 에이전트의 판단과 “사용자가 메시지를 읽었다”는 원천 시스템의 상태는 다릅니다.
둘을 같은 상태로 취급하면 다음과 같은 문제가 생길 수 있습니다.
- 에이전트가 낮은 순위를 부여했다는 이유로 미처리 메시지가 읽음 처리됨
- 사용자의 일시적 무시가 업무 완료로 오인됨
- 에이전트 판단이 원천 기록의 객관적 상태처럼 보임
따라서 이 설계는 원천 데이터의 의미를 보존하면서, 에이전트 판단을 별도 관리한다는 데 가치가 있습니다.
현재 공개 레시피에서는 모델이 SQL을 직접 작성하지 않습니다. 모델은 버전이 있는 JSON 결정 묶음을 반환하고, apply_decisions.py가 이를 검증한 뒤 트랜잭션으로 반영합니다.[2]
이는 모델의 의미 판단 → 코드의 구조 검증·상태 반영이라는 역할 분리를 보여줍니다. 다만 JSON 형식이 유효하다고 판단 내용까지 정확해지는 것은 아닙니다.
③ 가장 중요한 보안 원칙
원문은 다음을 명확히 구분합니다.[1]
맥락은 행동을 안내할 수 있지만, 행동을 승인할 수는 없다.
예를 들어 “협업자가 Slack을 선호한다”는 기억은 Slack 사용을 추천하는 근거가 될 수 있습니다. 그러나 실제 발송에는 자격증명·도구 권한·런타임 정책·사용자 승인이 별도로 필요합니다.[1]
④ 원문 그림을 읽을 때의 주의점
그림 1에는 이메일, 일정·회의, Slack·Teams, 문서·업무가 입력으로 표현됩니다. 그러나 공개 레시피가 이 모든 입력을 실제로 지원한다는 뜻은 아닙니다. 설계 제안은 초기 범위에서 일정·회의·회의록·대리 발송을 제외하며, 현재 README는 Slack과 Outlook 수집기를 명시합니다.[2][4]
분석 결론: 그림은 전체 개념을 설명하는 구조이고, 구현 범위는 레시피 문서에서 별도로 확인해야 합니다.
챕터 3. 단기 긴급성보다 사용자 의도 우선
Prioritize user intent over short-term urgency
① 원문의 주장
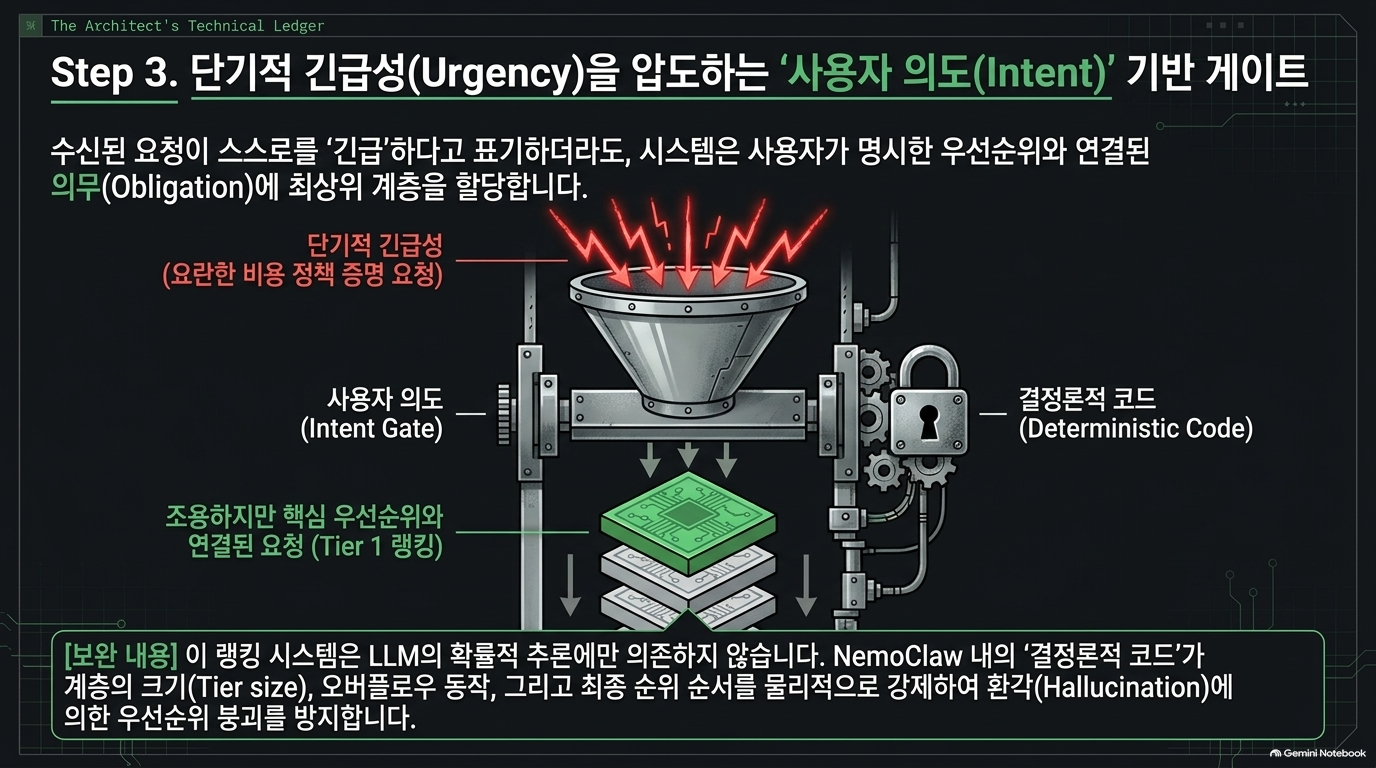
들어오는 요청은 자신을 긴급하다고 표현하기 쉽지만, 긴급성이 사용자의 실제 우선순위와 같지는 않습니다. 따라서 Intent Gate는 사용자가 명시한 우선순위와 연결되는 의무에 최상위 등급을 배정합니다.[1]
원문 예제에서는 긴급한 비용 정책 확인 요청보다, 조용하지만 사용자가 선택한 우선 업무에 연결된 요청이 높게 배치됩니다.[1]
② 분석: 중요한 것은 ‘누구의 긴급성인가’
이 설계는 요청자의 주장보다 사용자의 목표를 중심으로 주의를 배분합니다.
| 기준 | 판단의 중심 |
| 단순 긴급성 중심 | “요청자가 급하다고 말했는가?” |
| 사용자 의도 중심 | “사용자가 선택한 업무와 연결되는가?” |
현재 레시피는 high 등급에 대해 사용자가 그 업무를 선택했다는 메모리상의 근거를 요구합니다.[2]
이는 에이전트가 스스로 중요하다고 판단하는 것만으로 최상위 목록을 채우지 못하도록 하는 장치로 해석할 수 있습니다.
③ 모델 판단과 결정적 코드의 분업
원문은 모델이 업무와 사용자 우선순위의 관계를 해석하되, 등급별 크기·초과 처리·순위 규칙은 결정적 코드가 강제한다고 설명합니다.[1]
| 모델 └─ 이 요청이 사용자 목표와 어떻게 연결되는가? 코드 ├─ 등급별 개수 제한 ├─ 초과 항목 처리 └─ 순위 규칙 적용 |
분석 결론: “중요한 항목만 짧게 보여줘”라는 프롬프트보다, 목록 크기와 상태 규칙을 코드로 보장하는 방식이 운영 일관성을 높일 수 있습니다. 다만 코드가 순위 규칙을 정확히 실행하는 것과, 모델이 중요도를 올바르게 판단하는 것은 별개입니다.
챕터 4. 사용자가 에이전트를 수정할 수 있도록 설계
Allow users to correct the agent
① 원문의 주장
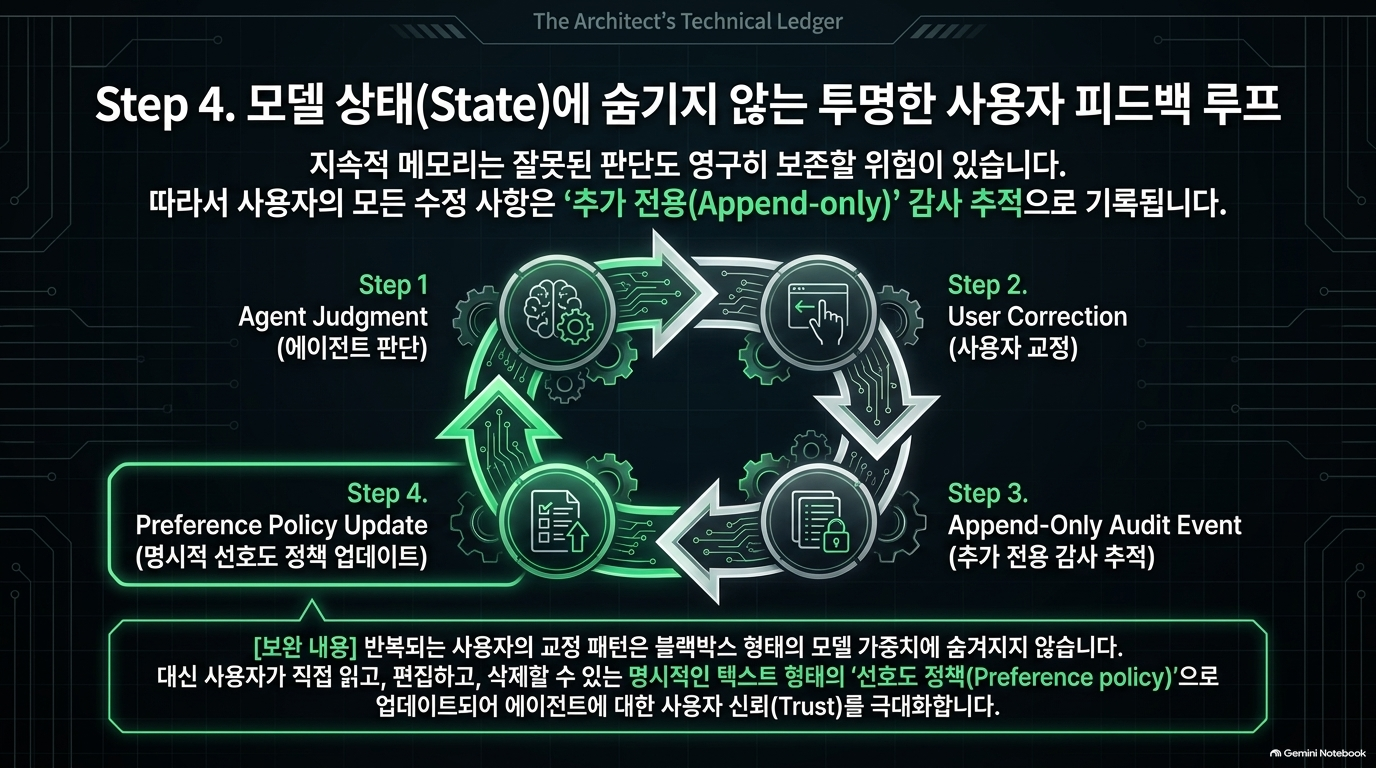
지속적 기억은 올바른 판단뿐 아니라 잘못된 판단도 보존할 수 있습니다. 따라서 사용자는 항목을 다른 등급으로 이동하거나 무시할 수 있고, 후속 실행에서도 그 결정이 유지됩니다.[1]
피드백 구조는 다음과 같습니다.[1]
| Agent judgment ↓ User correction ↓ Audit event ↓ Preference update |
반복되는 수정 패턴은 작고 읽기 쉬운 선호 정책에 반영되며, 사용자는 이를 확인·편집·삭제할 수 있습니다.[1]
② 분석: 불투명한 개인화보다 수정 가능한 개인화
설계 제안은 이 과정에서 모델을 학습시키지 않는다고 명시합니다. 선호 정책은 사람이 읽고 편집할 수 있는 파일이며, 삭제하면 기본 판단으로 돌아갑니다.[4]
이 접근의 장점은 다음과 같습니다.
- 왜 특정 판단이 반복되는지 확인 가능
- 잘못 학습된 선호를 직접 수정 가능
- 개인화 정책의 변경 이력 관리 가능
- 모델 교체와 별개로 업무 정책 유지 가능
③ 감사 로그의 품질이 개인화의 품질을 좌우
설계 제안은 실제 상태 전이만 수정 이벤트로 기록하도록 요구합니다. 동일한 명령을 재시도해도 수정 근거가 중복으로 늘어나 선호 정책 임계값을 넘지 않도록 하는 것입니다.[4]
예를 들어 사용자 의도는 한 번의 ‘무시’였는데, 네트워크 재시도로 여러 번 기록되면 에이전트가 이를 강한 선호로 잘못 해석할 수 있습니다.
④ 한계와 보완
[보완 필요 — 분석자 권고]
사용자의 행동과 장기 선호를 자동으로 동일시하지 않아야 합니다.
- 무응답은 거부가 아니라 미확인일 수 있습니다.
- 한 번의 무시는 일정 충돌 때문일 수 있습니다.
- 특정 프로젝트에서의 선호가 모든 업무에 적용되는 것은 아닙니다.
따라서 선호 정책에는 적용 범위·예외·유효기간·승인 여부를 두는 것이 적절합니다.
또한 append-only 감사 로그는 이력을 남기는 방식이지, 그 자체로 위변조 방지나 삭제 의무 충족을 보장하는 통제는 아닙니다.
챕터 5. 메모리를 추가했을 때의 성능
Add memory to improve agent task performance
① 원문 성능표
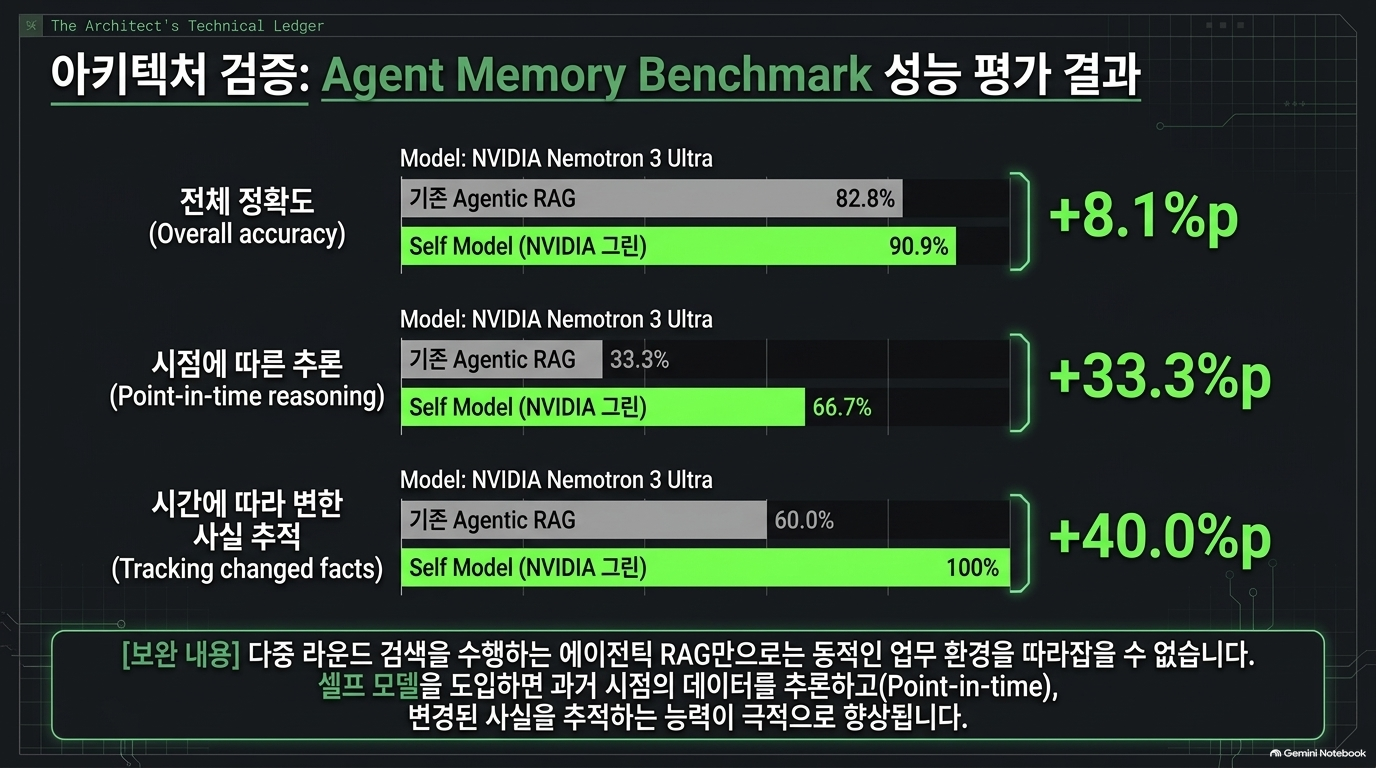
두 구성 모두 NVIDIA Nemotron 3 Ultra를 사용하며, 비교 대상은 여러 차례 검색을 수행하는 Agentic RAG와 Self Model입니다.[1]
| 평가 항목 | 문항 수 | Agentic RAG | Self Model | 원문 차이 |
| 전체 정확도 | 186 | 82.8% | 90.9% | +8.1%p |
| 어려운 질문 | 31 | 67.7% | 87.1% | +19.4%p |
| 시간에 따라 변경된 사실 추적 | 5 | 60.0% | 100.0% | +40.0%p |
| 특정 시점 기준 추론 | 6 | 33.3% | 66.7% | +33.3%p |
| 개체 구분 | 15 | 66.7% | 86.7% | +20.0%p |
| 다중 출처 종합 | 73 | 87.7% | 94.5% | +6.8%p |
| 코퍼스에 없는 내용에 대한 응답 유보 | 13 | 100.0% | 92.3% | −7.7%p |
| 단일 문서 사실 조회 | 30 | 86.7% | 83.3% | −3.3%p |
| 인용 커버리지 | 186 | 92.5% | 97.8% | +5.4%p |
수치와 차이는 원문 표를 그대로 보존했습니다. 반올림된 표시값끼리 빼면 일부 차이가 다를 수 있습니다.[1]
② 무엇이 개선되었는가
개선은 특히 시간 변화·과거 시점·개체 구분·다중 출처 종합에서 나타납니다.[1]
이는 구조화된 업무 메모리가 해결하려는 문제와 부합합니다. 다만 결과 자료는 공개된 산출물만으로 원인이나 구체적인 아키텍처 효과를 확정할 수 없다고 명시합니다.[5]
따라서 적절한 해석은 다음과 같습니다.
해당 평가에서는 Self Model 구성이 더 높은 정확도를 보였다. 그러나 어떤 구성 요소가 개선을 일으켰는지는 별도 검증이 필요하다.
③ 하락 항목이 중요한 이유
원문의 “Answered faithfully based on Corpus” 항목은 벤치마크에서 abstention입니다. 코퍼스에 답이 없을 때, 근거가 없다고 응답하는 능력을 평가합니다.[3][5]
이 항목과 단일 문서 조회에서는 Agentic RAG가 더 높았습니다.[5]
분석적 해석
- 풍부한 업무 해석이 근거 없는 추정을 유발할 가능성을 점검해야 합니다.
- 단순 사실 확인에는 원천 검색을 직접 사용하는 경로가 유리할 수 있습니다.
- 메모리를 모든 질의의 단일 경로로 삼기보다, 질의 유형별로 활용하는 설계가 적절합니다.
이는 가능한 설계 해석이며, 공개 자료가 입증한 실패 원인은 아닙니다.
④ 작은 표본의 영향
문항 수를 기준으로 계산하면, 변경 사실 추적 5문항에서 한 문항은 20%p, 특정 시점 추론 6문항에서는 약 16.7%p를 차지합니다.
따라서 “60% → 100%”는 큰 개선이지만, 해당 5문항의 결과입니다. 기업 업무 전반에서 변경 사실을 완벽하게 추적한다는 뜻은 아닙니다.
⑤ 연결된 평가 자료에서 확인되는 제한
| 검증 항목 | 공개 자료의 범위 | 해석 |
| 데이터 | 합성 코퍼스 A의 425개 문서·186문항 | 실제 기업 업무 성과와 구분 |
| 모델 | 하나의 기반 모델 | 모델 간 일반화 미검증 |
| 도메인 | 공개 비교는 코퍼스 A만 사용 | 코퍼스 B의 타 도메인 성능 미검증 |
| 반복성 | 구성별 참고 실행 결과 | 반복 실행 변동성 판단에 부족 |
| 재현성 | Self Model 어댑터·생성 메모리 미공개 | 동일 구성을 그대로 재현하기 어려움 |
| 결과 변환 | 공개 전 식별자 변경을 답변에도 적용 | 원본 답변과 변환 결과의 구분 필요 |
| 비용 | 양쪽 모두 comparable_on_cost: false | 방어 가능한 비용 비율 산출 불가 |
| 인용 | 인용 커버리지는 진단 지표 | 정답률이나 근거 적합성과 동일하지 않음 |
평가 범위와 제한은 벤치마크 README 및 결과 README에 명시되어 있습니다.[3][5]
이 챕터의 결론:
설계 효과를 보여주는 참고 결과로는 의미가 있지만, 일반적 우월성·생산성 향상·비용 절감까지 입증한 결과로 읽어서는 안 됩니다.
챕터 6. 보안 경계는 런타임에서 강제
Enforce the boundary at runtime
① 원문의 역할 분담
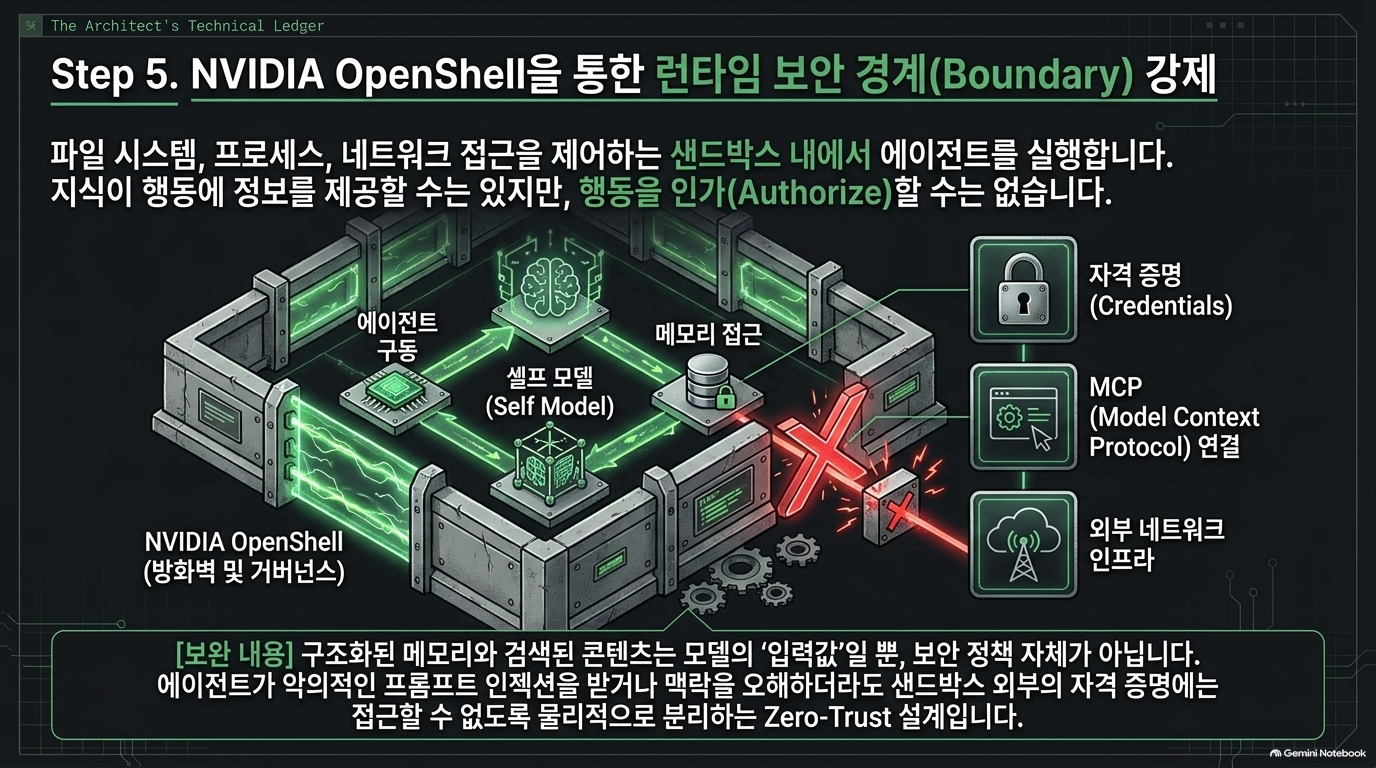
원문은 NemoClaw와 OpenShell의 역할을 다음과 같이 설명합니다.[1]
| 구성 요소 | 역할 |
| NemoClaw | 예제를 OpenShell과 통합하고 생명주기 관리 |
| OpenShell | 에이전트 샌드박스 실행 및 파일시스템·프로세스·네트워크 정책 강제 |
| 관리형 추론·MCP 연결 | 자격증명을 샌드박스 외부에 유지 |
② 분석: 기억과 검색 결과는 보안 정책이 아니다
원문의 중요한 전제는 메모리와 검색된 콘텐츠가 모델의 입력이지, 신뢰할 수 있는 보안 정책이 아니라는 것입니다.[1]
따라서 메모리에 악성 지시가 들어가거나 에이전트가 이를 잘못 해석하더라도, 운영자가 정한 런타임 경계 안에서만 행동하도록 통제합니다.[1]
이 설계는 다음을 분리합니다.
| 모델 입력 ├─ 메시지 ├─ 검색 문서 └─ 업무 메모리 신뢰되는 통제 ├─ 접근 가능한 경로 ├─ 허용된 프로세스 ├─ 허용된 네트워크 목적지 └─ 도구·자격증명 정책 |
③ 보안 효과의 범위
[확인 필요 — 분석자 관점]
샌드박스는 접근 범위와 실패 영향을 제한하는 통제입니다. 그러나 다음을 자동으로 보장하지는 않습니다.
- 답변의 사실 정확성
- 허용된 API를 통한 모든 행동의 적절성
- 민감한 내용의 외부 추론 전송 방지
- 저장 데이터의 암호화
- 모든 중요 작업의 건별 사용자 승인
특히 설계 제안은 자격증명 암호화와 메시지 저장소 암호화가 별개이며, 소유자 전용 디렉터리 권한은 저장 암호화가 아니라고 명확히 구분합니다.[4]
실무적 의미:
보안 검토에서는 런타임 격리, 최소 권한, 데이터 외부 전송, 저장 암호화, 업무 승인을 각각 검증해야 합니다.
챕터 7. 공개 레시피로 시작하기
Get started building agent memory
① 원문이 제공하는 구현 자산
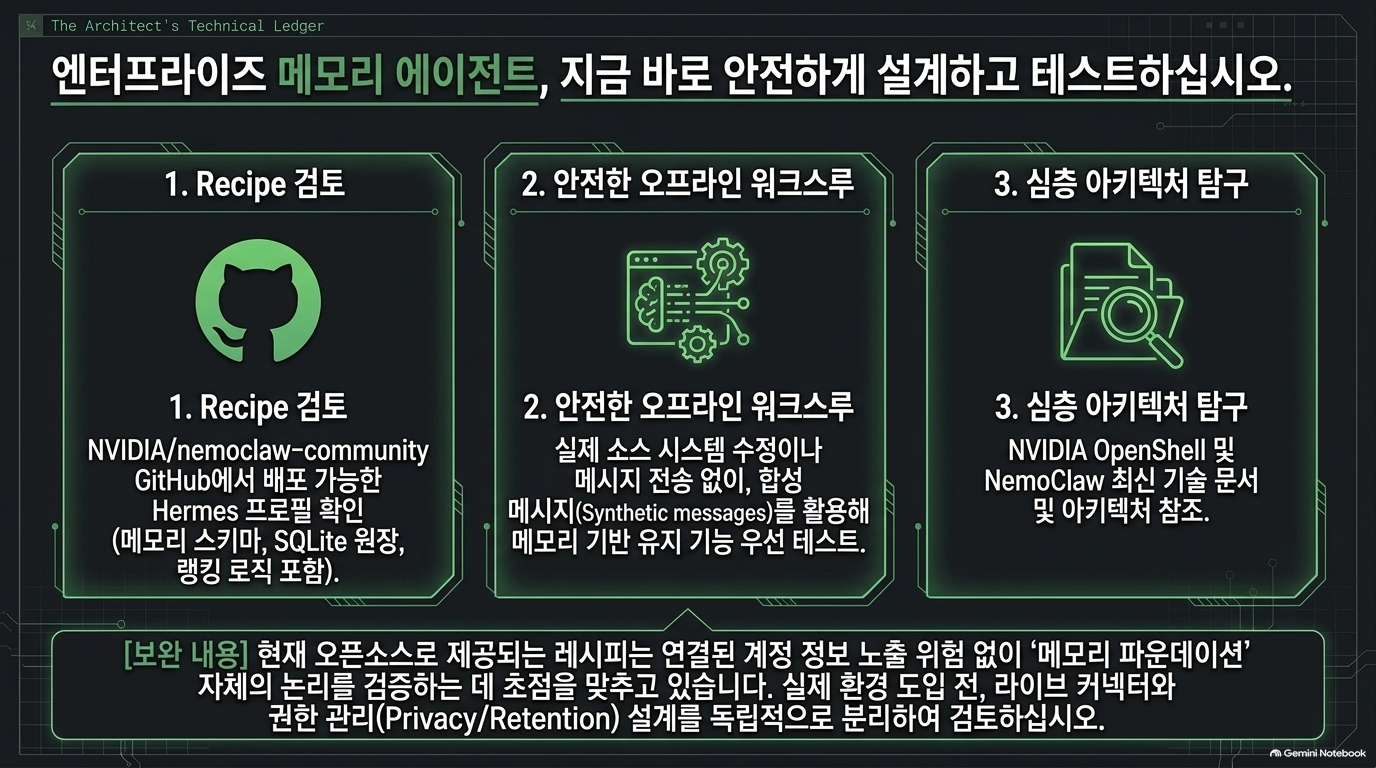
원문은 레시피를 NemoClaw용 배포 가능한 Hermes 프로필로 소개하며 다음을 포함한다고 설명합니다.[1]
- 구조화된 메모리 스키마
- 지속적인 의무 원장
- 제한된 순위 결정 로직
- 사용자 수정·감사 경로
- 예약된 메모리 유지관리
- 합성 메시지·메모리 페이지
- 오프라인 워크스루
- 단위 테스트
② 오프라인 예제의 정확한 의미
원문은 샘플 사람·조직·프로젝트·메시지가 모두 가상이며, 오프라인 워크스루에서는 기록된 모델 결정을 추론 대신 사용한다고 명시합니다.[1]
현재 README 역시 추론이 필요한 두 지점에서 기록된 JSON 결정 묶음을 대입하고, 그 이후에는 예약 실행과 같은 코드를 사용한다고 설명합니다.[2]
따라서 오프라인 워크스루가 보여주는 것은 주로 다음입니다.
- 결정 입력의 검증
- 순위·등급 규칙 적용
- 상태 저장
- 사용자 수정의 유지
- 감사 이력 및 검증 경로
워크스루의 성공은 실제 모델이 실시간으로 올바른 판단을 내린다는 검증과는 다릅니다.
③ 구현 범위에 대한 중요한 제한
원문은 레시피가 메시지를 보내거나 원천 시스템을 수정하지 않는다고 명시합니다. 실제 연결에는 자격증명·개인정보·보유·삭제에 대한 별도 처리가 필요합니다.[1]
현재 README는 Slack·Outlook 수집기와 통합 수준의 검증을 기술합니다. 또한 스키마는 여러 페이지 유형을 지원하지만, 예약된 작성기가 현재 유지하는 것은 사람과 주의·관심 항목 페이지라고 범위를 구분합니다.[2]
따라서 다음 세 가지를 혼동하지 않아야 합니다.
- 스키마가 표현할 수 있는 범위
- 현재 자동 작성기가 유지하는 범위
- 실제 외부 시스템에 수행하는 행동 범위
④ 실무 적용 위치
분석자 권고:
이 예제는 완전자율 비서의 완성품보다는 읽기 전용 업무 맥락·주의 배분 계층의 참조 구현으로 활용하는 것이 적절합니다.
초기 도입에서는 다음을 검증한 뒤 실행 기능을 확대하는 접근이 안전합니다.
| 읽기 전용 수집 ↓ 출처 기반 업무 지식 ↓ 미처리 의무·변경사항 식별 ↓ 사용자 수정과 평가 ↓ 승인된 제한적 실행 |
이 순서는 원문이 규정한 배포 절차가 아니라, 실무 적용을 위한 권고입니다.
종합 판단
이 글의 가장 중요한 기여는 에이전트 메모리를 저장소가 아니라, 근거와 상태를 관리하는 운영 계층으로 다룬다는 점입니다.
- 채택할 원칙: 출처 기반 기억, 지식·판단 분리, 사용자 수정, 결정적 상태 관리, 런타임 권한 통제
- 주의할 주장: 작은 표본의 100% 결과, 메모리의 일반적 우월성, 비용 절감, 실제 업무 생산성 향상
- 도입 시 보완: 시간·승인 상태, 강제 의무 예외, 개인정보 삭제 전파, 실제 업무 기반 반복 평가
결론적으로, 유용한 에이전트는 많이 기억하는 에이전트가 아니라, 무엇을 왜 기억하는지 설명하고, 잘못된 기억을 수정하며, 기억과 권한을 혼동하지 않는 에이전트입니다.
출처
[1]https://developer.nvidia.com/blog/building-a-memory-driven-agent-with-nvidia-nemoclaw
[2]https://github.com/NVIDIA/nemoclaw-community/tree/main/examples/recipes/nvidia/memory-driven-chief-of-staff
[3]https://github.com/NVIDIA/nemoclaw-community/tree/main/examples/tools/agent-memory-benchmark
[4] https://github.com/NVIDIA/nemoclaw-community/issues/122
[5]https://github.com/NVIDIA/nemoclaw-community/blob/main/examples/tools/agent-memory-benchmark/results/README.md
'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - Jev : 10분 만에 Jev 이해하기 (0) | 2026.10.09 |
|---|---|
| 에이전트 AI - 개인용 에이전트: CPU와 메모리 수요 전망 (0) | 2026.10.09 |
| 에이전트 AI - 개인 에이전트 시장의 경제성 분석 (0) | 2026.10.09 |
| 에이전트 AI - O’Reilly Radar, 코딩 에이전트의 Architectural Decision Records (ADRs) (0) | 2026.10.07 |
| 하네스 엔지니어링 - 자율주행 인공지능 에이전트의 통제 상실 (0) | 2026.10.04 |