https://www.langchain.com/blog/building-a-harness-with-jev
2026.9.17
[Building a Harness with Jev]
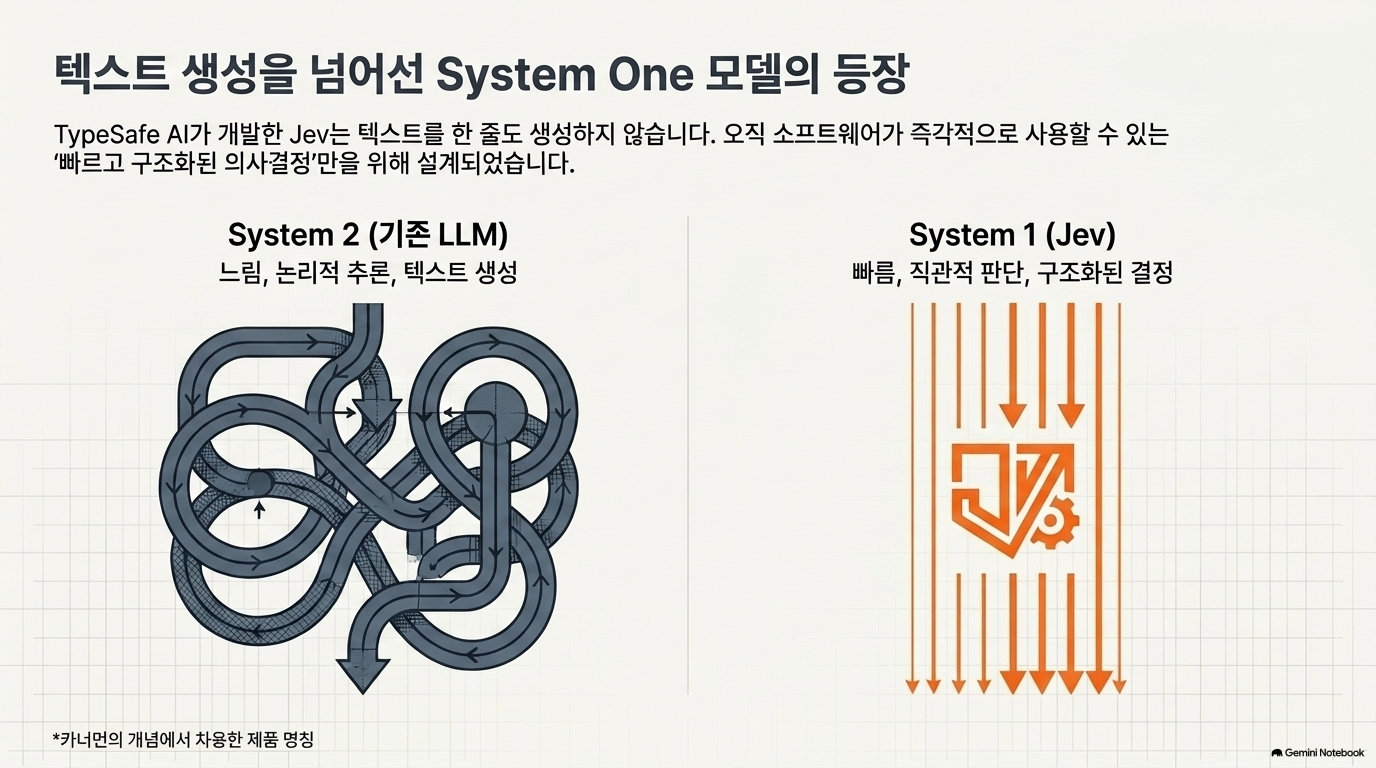
제공된 문서는 TypeSafe AI가 개발한 System One 모델인 Jev의 개념과 이를 LangChain 환경에서 활용하는 방법을 설명하는 기술 가이드입니다. 전통적인 대형 언어 모델과 달리 텍스트를 생성하지 않는 Jev는 상태 평가를 통한 빠른 분류와 구조화된 의사결정에 특화되어 있어, 에이전트 루프의 속도를 높이고 비용을 절감하는 데 기여합니다. 특히 문서에서는 Jev가 다수의 질문을 동시에 병렬 처리할 수 있는 방식을 소개하며, 이를 활용해 모델 라우팅을 최적화하거나 위험한 도구 실행을 차단하는 자동 모드(Auto Mode) 가드레일을 구축하는 실용적인 유스케이스를 제시합니다. 궁극적으로 이 글은 개발자들이 무겁고 느린 주력 생성 모델을 보완하기 위해 가볍고 정확한 분류기를 어떻게 결합하여 더욱 안전하고 효율적인 AI 에이전트를 만들 수 있는지 안내하는 목적을 가집니다.
핵심은 Jev 자체보다 ‘harness의 어느 지점에 판단 모델을 배치할 것인가’입니다. 이 글은 Jev를 생성형 LLM의 대체재가 아니라, 에이전트의 모델 선택과 도구 실행 전 위험 판정을 담당하는 미들웨어로 제시합니다. 다만 두 예제 모두 통합 패턴을 보여줄 뿐, 안전성이나 비용 절감 효과를 독립적으로 검증한 실험은 아닙니다.[1]
사용자 요청
↓
[ModelRouterMiddleware] ── 이번 실행에 사용할 LLM 선택
↓
생성형 LLM ── 응답·도구 호출 계획
↓
[AutoModeMiddleware] ── 지정된 도구 호출의 위험 판정
↓
허용된 도구 실행 또는 차단
1. 도입부 — 왜 agent loop에 또 다른 모델이 필요한가
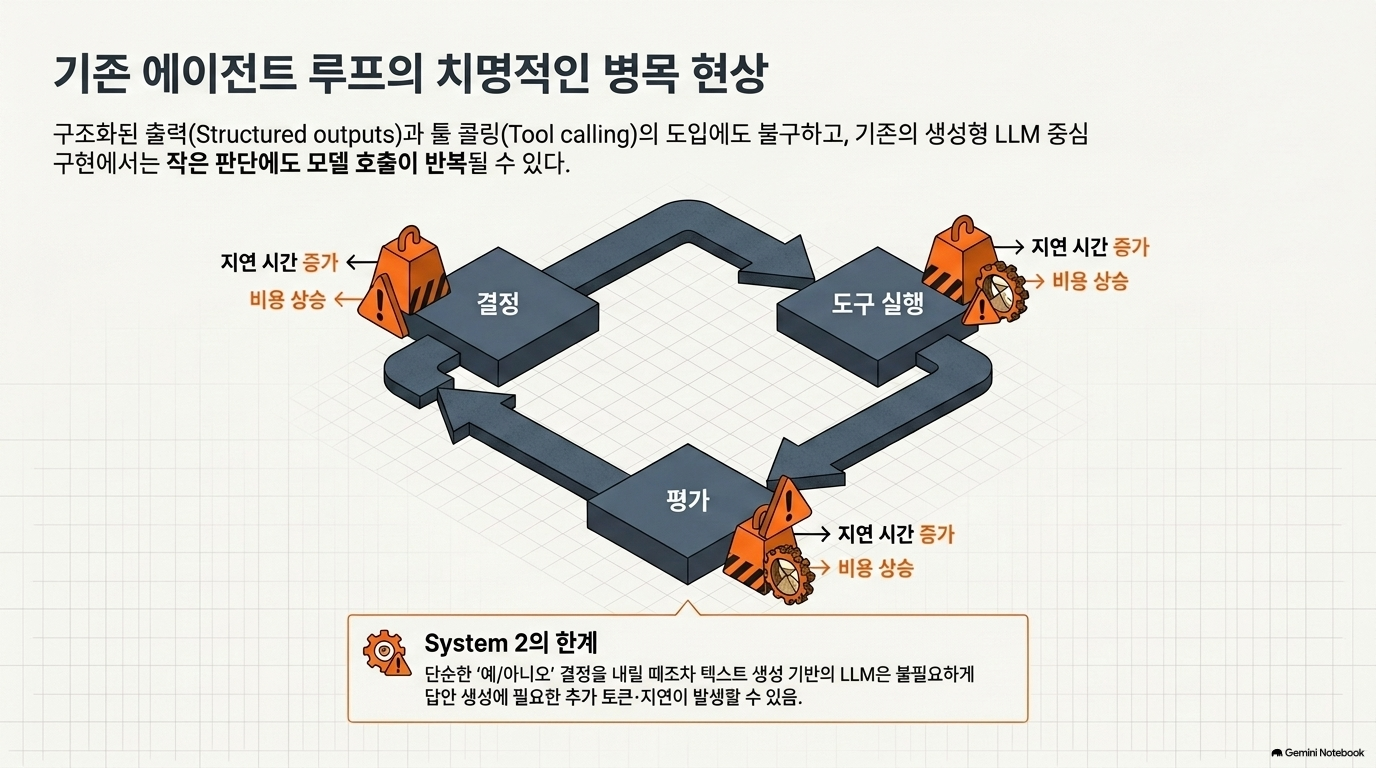
글은 에이전트를 LLM의 다음 행동 결정 → 도구 실행 → 결과 평가 → 반복의 루프로 설명합니다. Tool calling과 structured outputs 덕분에 LLM을 소프트웨어에 연결하기 쉬워졌지만, 작은 판단 하나에도 생성형 모델을 반복 호출하는 비용과 지연은 남았다는 문제의식입니다.[1]
여기서 구분해야 할 점이 있습니다. Jev를 넣어도 판단 호출 자체가 사라지지는 않습니다. 고비용 생성 호출을 저비용 판정 호출로 바꾸는 것입니다. 따라서 총효과는 호출 단가뿐 아니라 라우팅 오류로 인한 재시도, 도구 차단에 따른 복구, 최종 과업 성공률까지 포함해야 합니다.
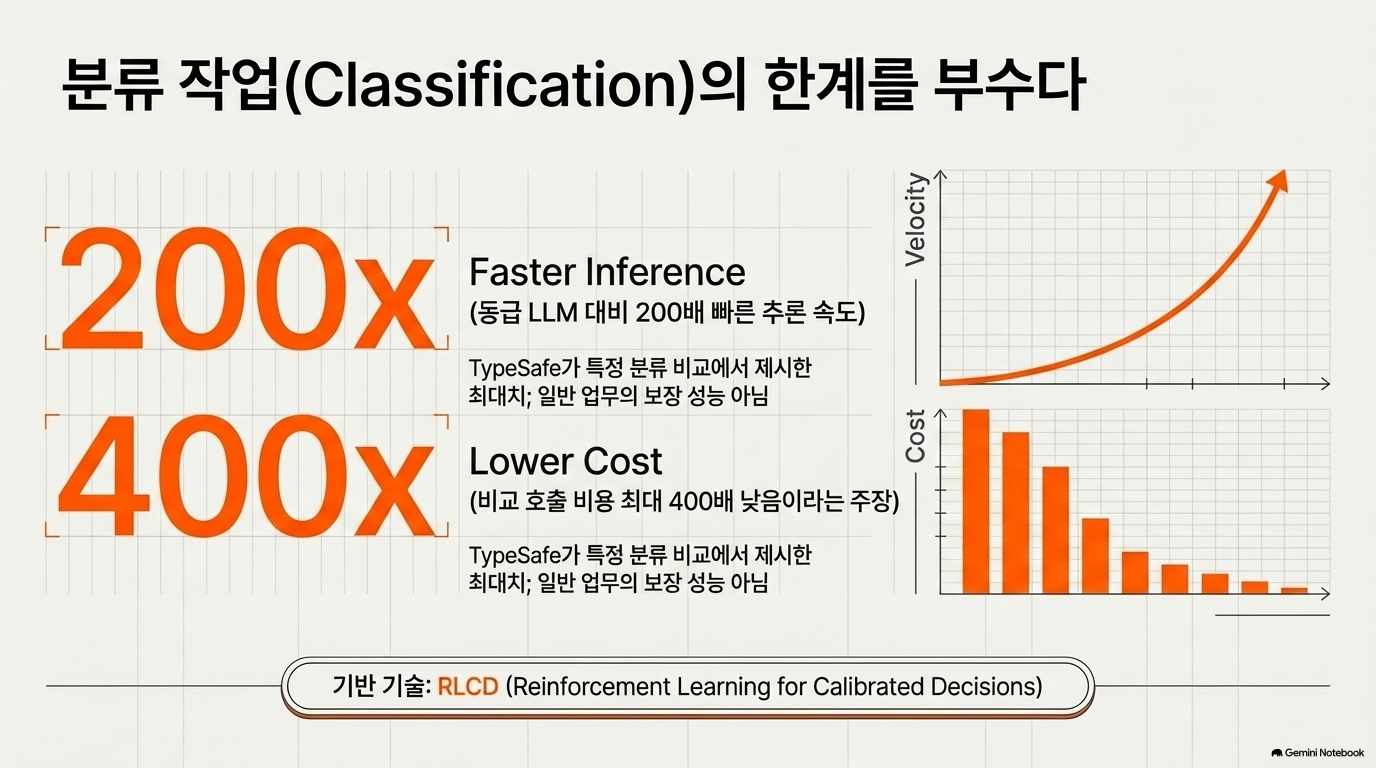
글이 인용한 최대 200배 속도·400배 비용 개선은 TypeSafe 측의 비교 주장이지, 이 LangChain 글에서 수행한 자체 벤치마크가 아닙니다.[1]
2. “All about Jev” — state와 질문을 분리하는 인터페이스
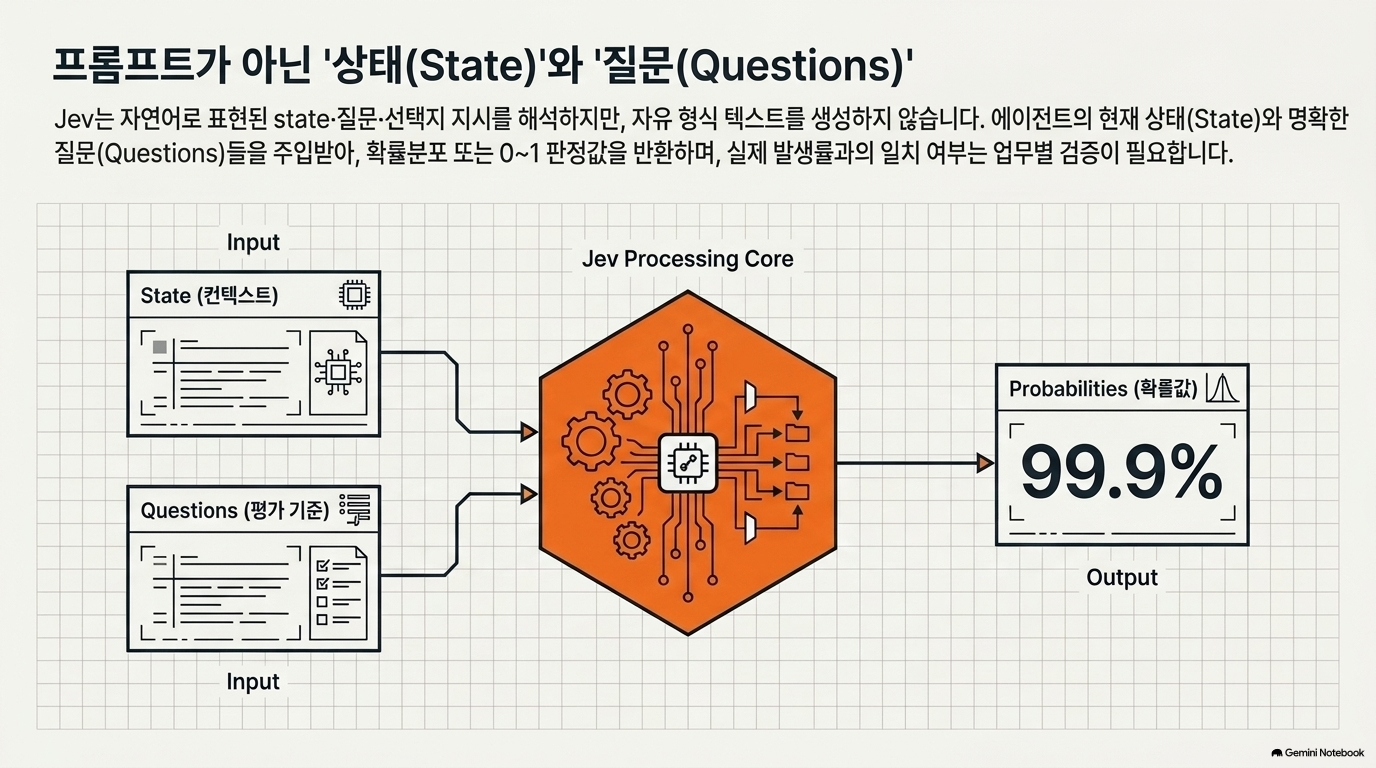
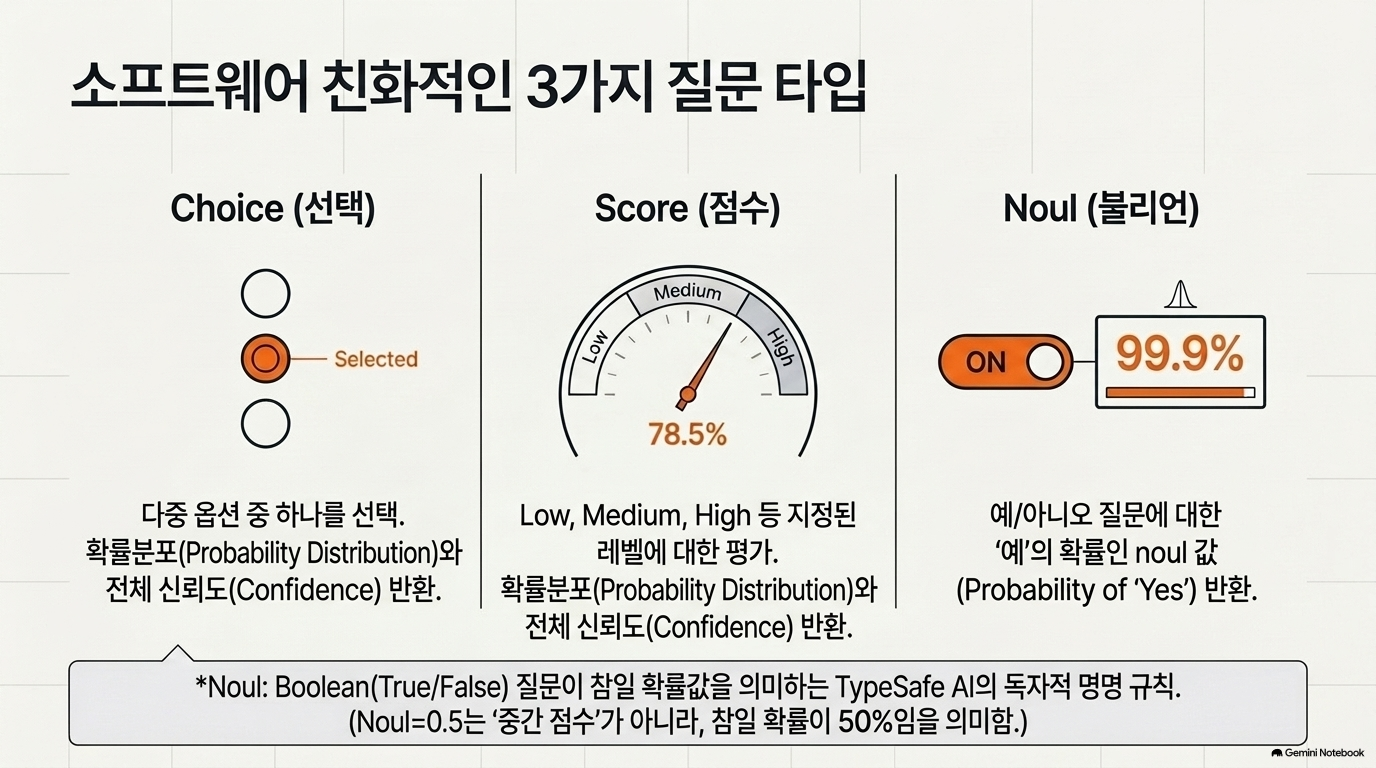
Jev에는 판단할 자료인 state와, 그 자료에 대해 묻는 questions를 보냅니다. 글의 고객지원 예시는 “Stripe 계정 연결이 계속 실패하고 매출 손실이 있다”는 메시지에 대해 is_urgent라는 이진 질문을 던지고 noul: 0.999를 받습니다.[1]
세 가지 질문 형태
| 타입 | 묻는 것 | 반환·활용 |
| Noul | 진술이 참인가? | ‘예’에 대한 0~1 값으로 분기 |
| Choice | 주어진 선택지 중 무엇인가? | 선택값, 선택지별 확률, confidence |
| Score | 순서 있는 척도에서 어느 수준인가? | 점수, 수준별 분포, confidence |
특히 Score와 Noul을 혼용하면 안 됩니다. 공식 통합 문서는 Noul=0.5를 ‘중간 수준’이 아니라 예/아니오가 반반인 상태로 구분합니다.[2]
0.999의 올바른 해석
글은 이를 “긴급할 확률 99.9%”라고 설명합니다.[1] API 출력의 뜻으로는 맞지만, 실제 업무에서 그 값을 받은 사건의 99.9%가 긴급하다는 검증 결과는 아닙니다. TypeSafe도 calibration은 여러 예측의 집단적 속성이며 개별 답의 정답을 보장하지 않는다고 명시합니다.[3]
따라서 운영상으로는 다음 세 값을 분리해야 합니다.
모델 출력값: noul = 0.999
검증집합의 실제 빈도: 별도 측정 필요
자동 에스컬레이션 규칙: 오판 비용에 따라 별도 설정
글은 동일 state에 여러 질문을 한 요청으로 보내고 병렬 평가할 수 있다고 강조합니다.[1] 이는 동일 사건에 대한 긴급도·담당팀·개인정보 포함·사람 검토 필요성을 한 번에 묻는 harness 설계에 적합합니다. 그러나 질문별 평가가 독립적이라는 것과 최종 업무결정의 오류가 독립적이라는 것은 다릅니다. 여러 판정이 동일하게 누락된 state를 읽으면 함께 틀릴 수 있습니다.
3. “How to Use Jev with LangChain” — 모델이 아니라 Runnable로 취급
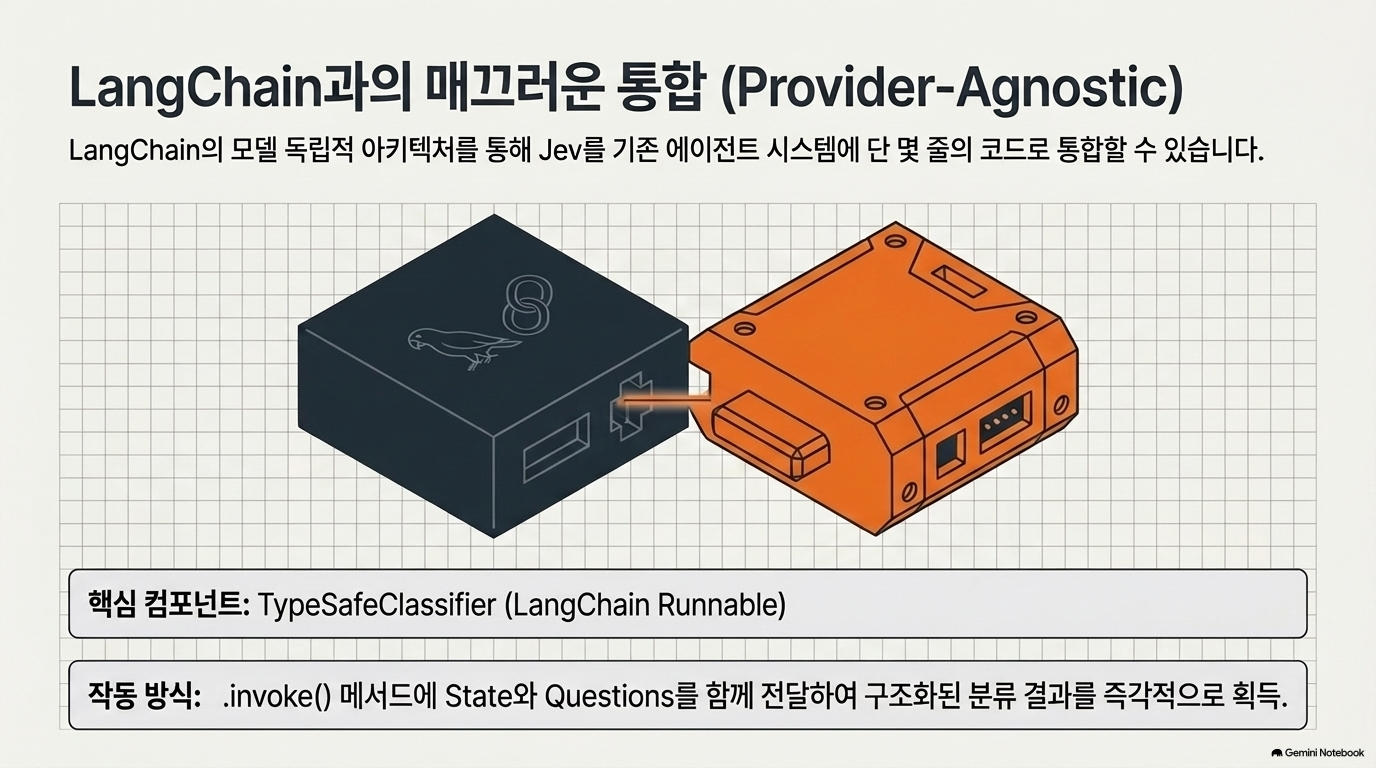
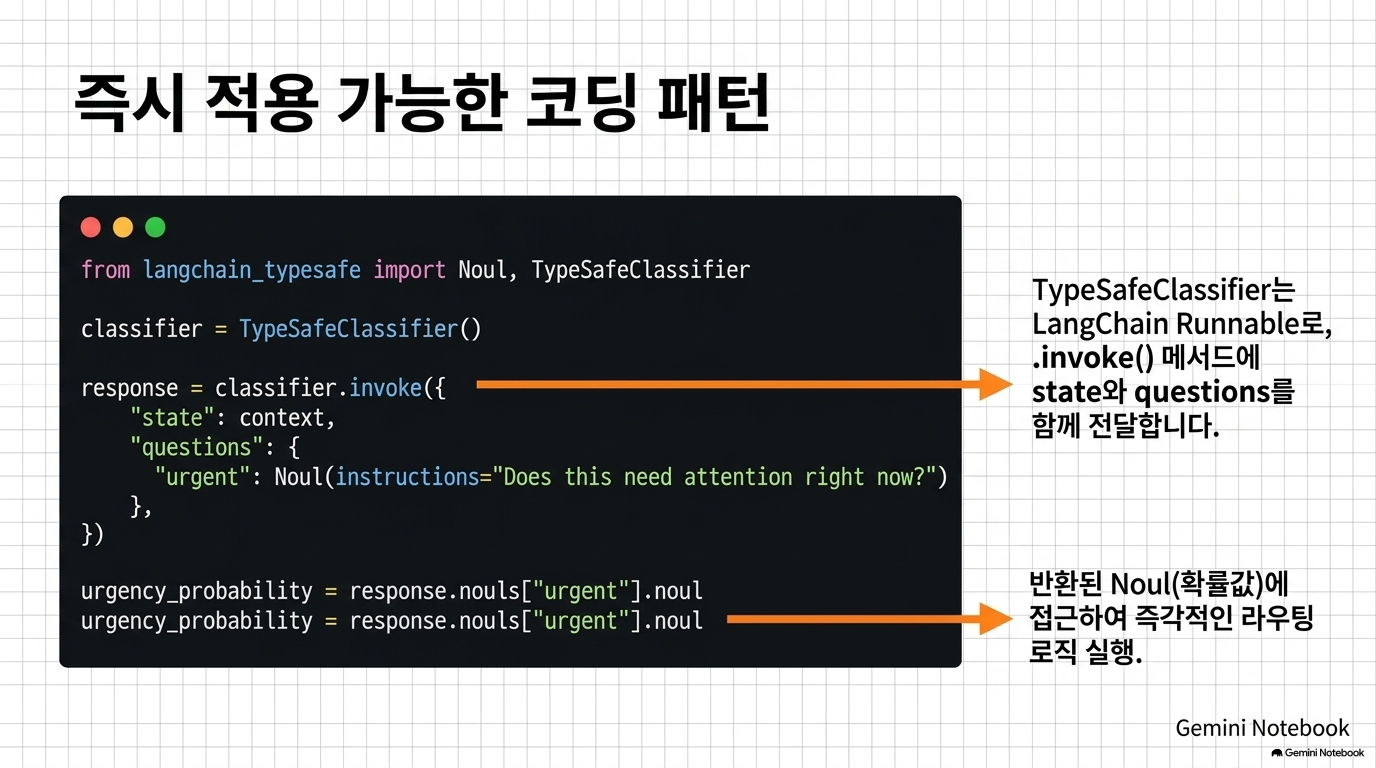
LangChain 통합은 TypeSafeClassifier를 통해 state와 명명된 questions를 .invoke()에 전달하고, 채팅 응답 대신 타입별 판정 결과를 받습니다.[1][2]
pythonCopy
classifier = TypeSafeClassifier()
response = classifier.invoke({
"state": "배포가 두 번 실패했고 고객에게 500 오류가 발생한다",
"questions": {
"urgent": Noul(instructions="즉시 대응이 필요한가?")
},
})
urgency = response.nouls["urgent"].noul
이 설계의 의미는 Jev를 “대화 상대”가 아니라 조합 가능한 판정 컴포넌트로 다룬다는 데 있습니다. state에는 문자열뿐 아니라 JSON 구조와 LangChain message 객체도 전달할 수 있고, 응답에는 질문 ID별 답·모델·사용량·request ID가 포함됩니다.[2]
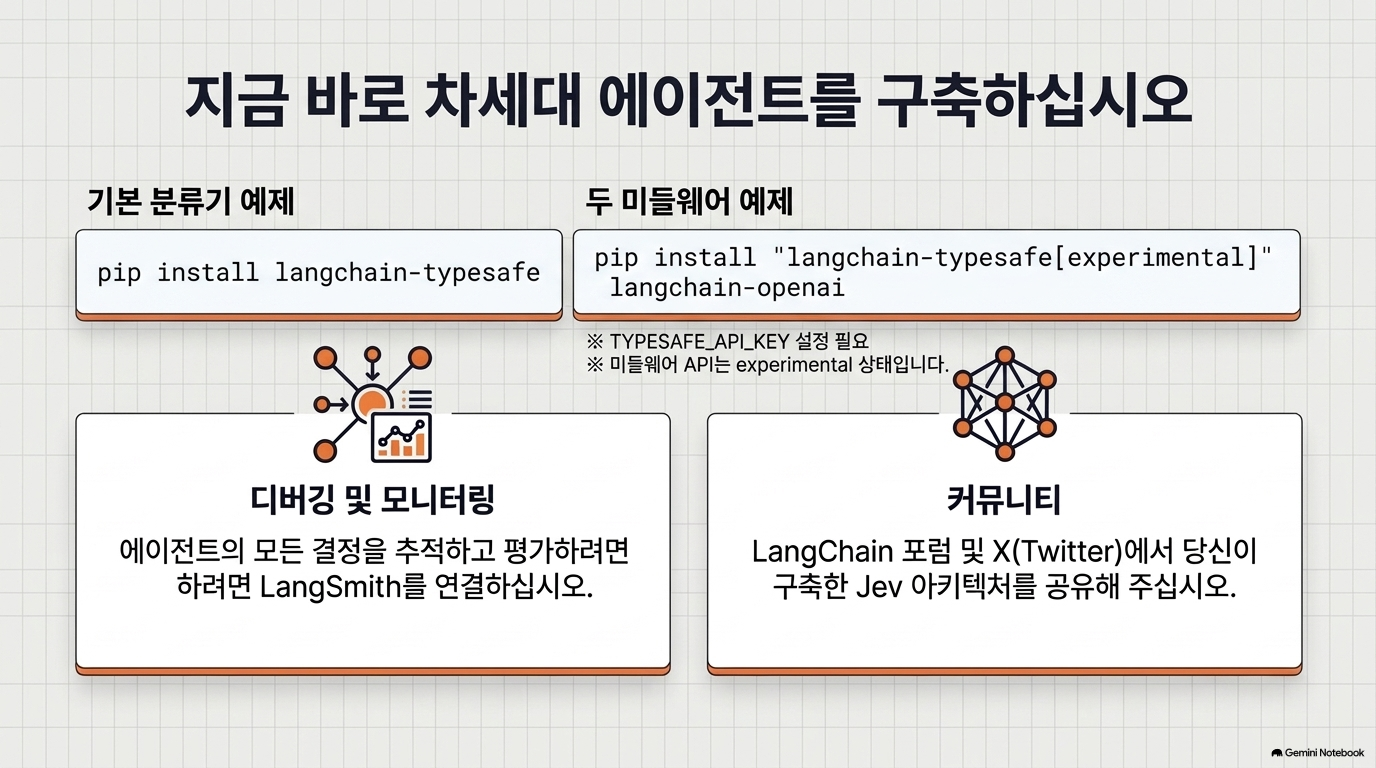
구현 시 유의: 원문은 기본 설치를 langchain-typesafe로 소개하지만, 현재 통합 문서상 두 실험적 미들웨어를 쓰려면 langchain-typesafe[experimental]와 대상 LLM 통합 패키지가 필요합니다. 또한 질문은 classifier 생성 시 고정하는 이전 방식이 아니라 invoke 호출에 state와 함께 전달하는 방식으로 안내됩니다.[2]
4. “Use Cases” — LLM 대체가 아닌 판단 계층 분업
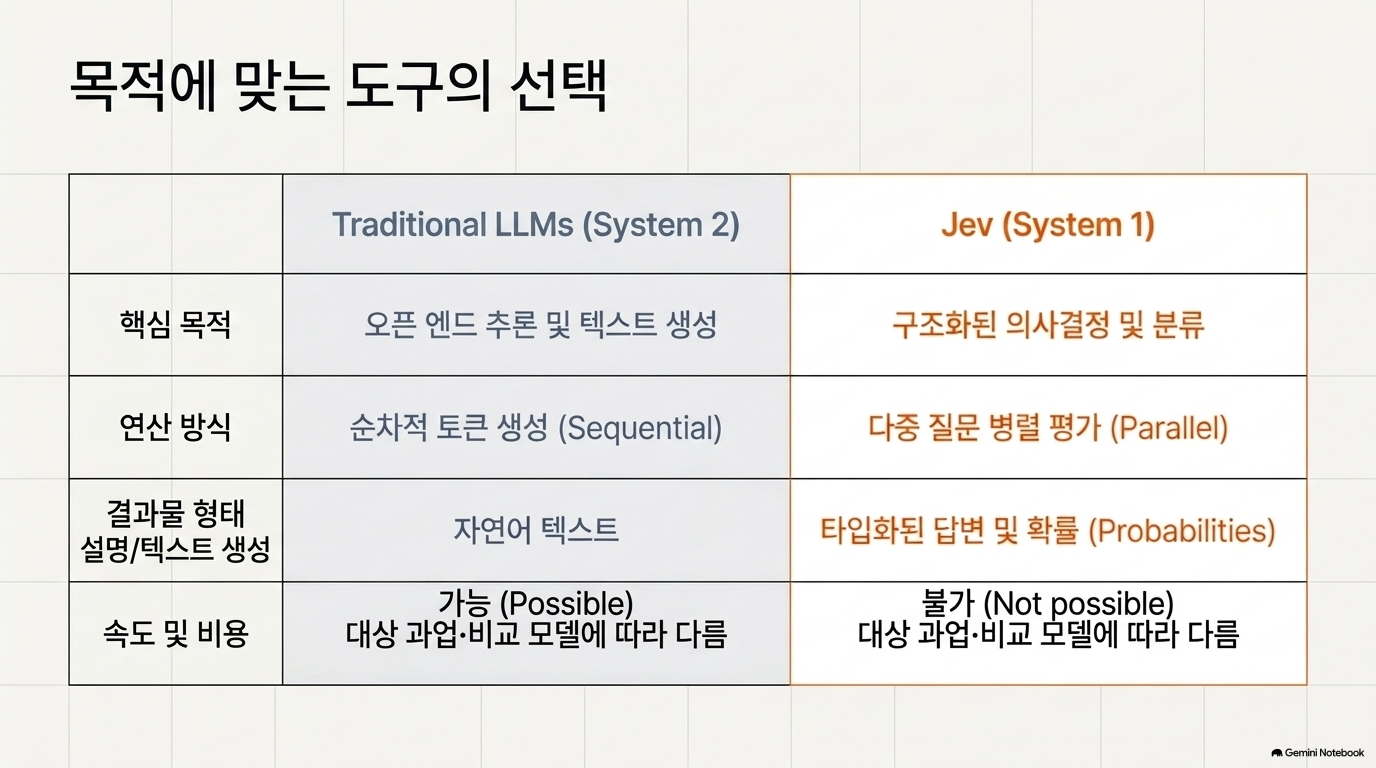
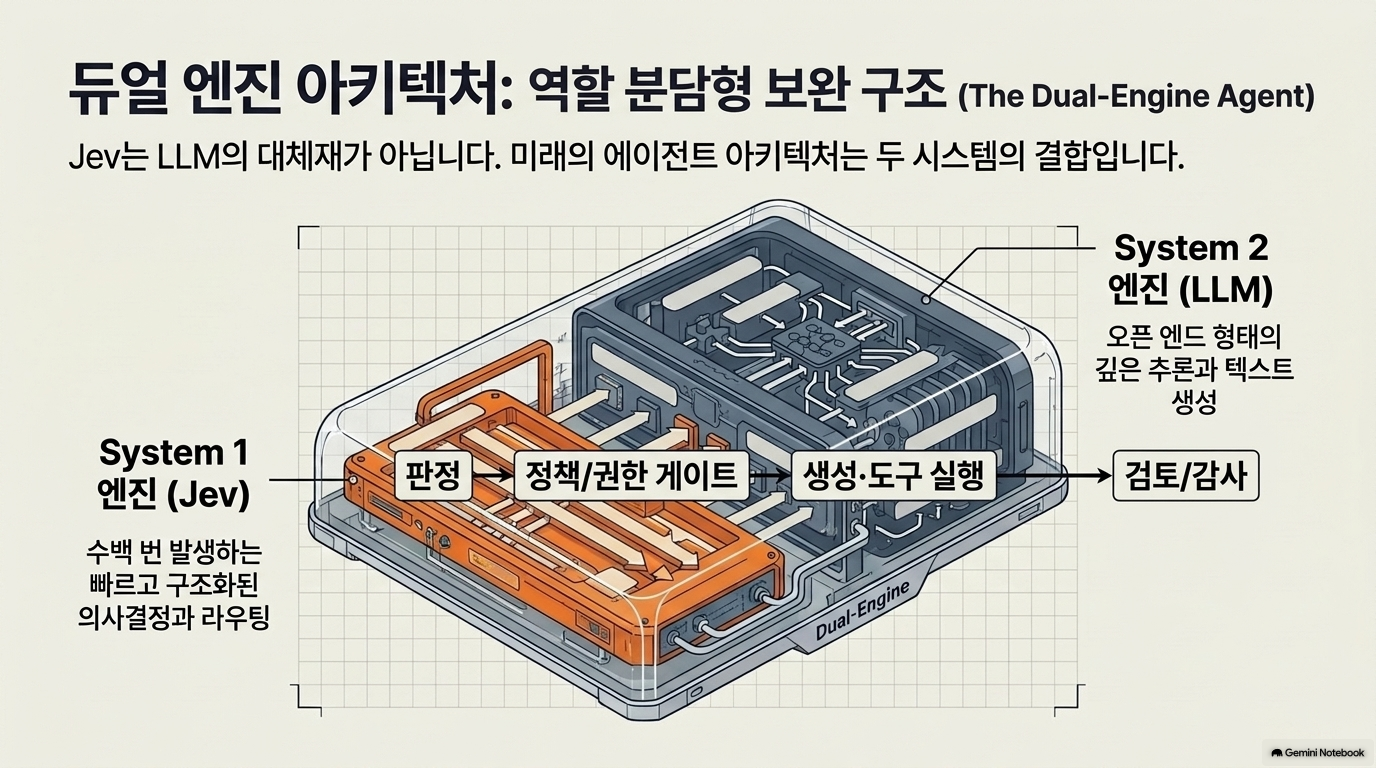
LangChain은 Jev가 글을 생성하지 않으므로 agent의 주 LLM을 그대로 대체할 수 없다고 명시합니다.[1] 역할 분담은 다음과 같습니다.
| 구성요소 | 책임 |
| Jev | 제한된 답안 공간의 빠른 분류·판정 |
| 생성형 LLM | 열린 문제의 추론, 설명, 텍스트·코드 생성 |
| Harness/미들웨어 | 언제 어느 모델을 쓰고 도구 실행을 허용할지 제어 |
| 결정론적 코드 | 권한·규칙·상태 전이·실행 |
따라서 이 글에서 harness는 단순한 프롬프트 모음이 아닙니다. 모델 호출 전후의 제어 지점에 정책을 심는 실행 구조입니다.
5. “Model routing” — 실행 시작 시 모델 선택
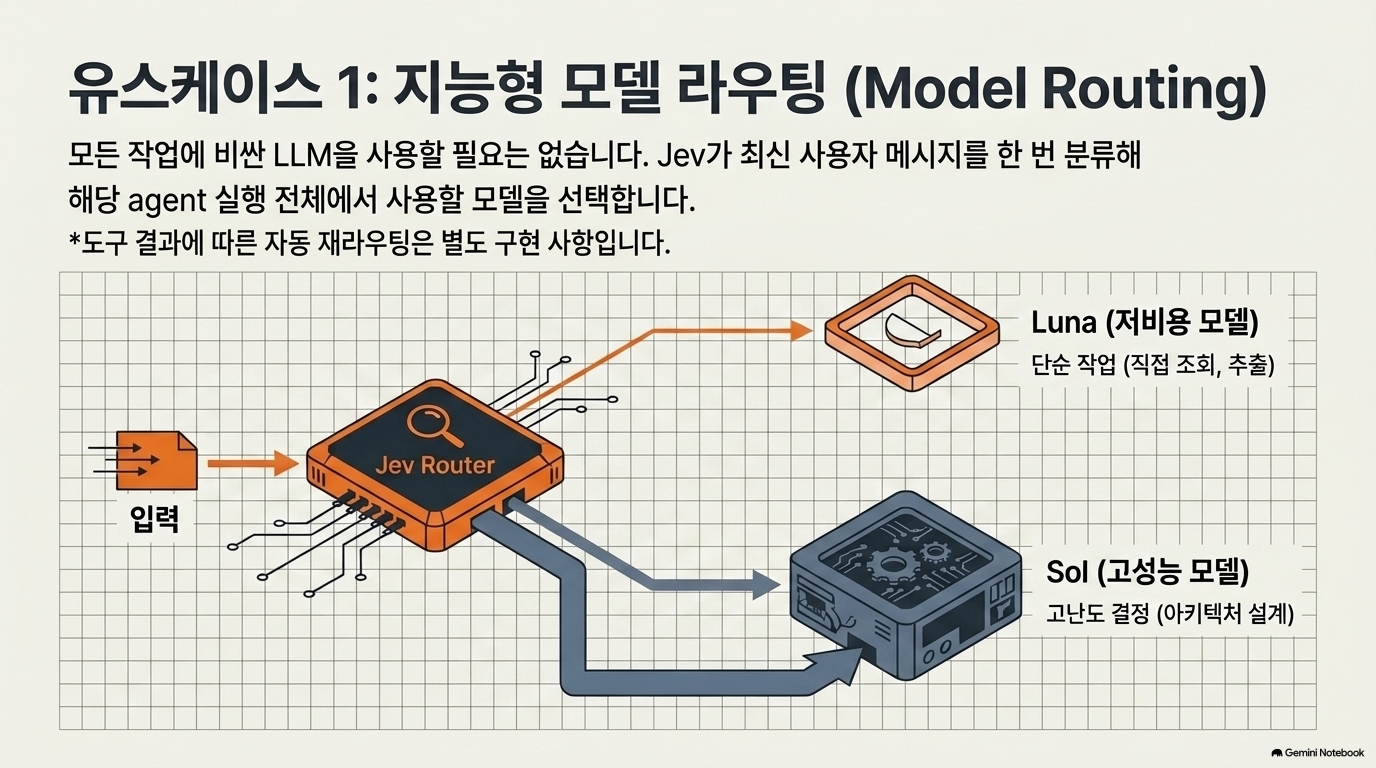
ModelRouterMiddleware 예제는 fast와 powerful이라는 선택지를 정의하고, Jev가 요청의 성격에 따라 저렴한 모델 또는 강한 모델을 선택하게 합니다. 라우터의 지시는 “과업을 완료할 수 있는 가장 저렴한 모델을 고르라”는 것입니다.[1]
실제 동작 범위
현재 통합 문서에 따르면 라우터는 가장 최근의 사용자 메시지를 한 번 분류하고, 선택한 모델을 해당 agent 실행 전체의 모델 호출에 사용합니다. 선택값뿐 아니라 확률과 confidence도 agent state에 남습니다.[2]
이 사실은 설계상 중요합니다.
- 장점: 실행 중 계속 라우터를 호출하지 않아 비용과 복잡도가 낮습니다.
- 한계: 처음에는 간단해 보였지만 도구 결과에서 복잡한 문제가 드러나도 자동으로 모델을 재선택하는 단계별 라우터는 아닙니다.
- 보완: 도구 결과 이후 재분류가 필요하면 별도의 before_model 등 lifecycle hook을 설계해야 합니다.[2]
무엇을 측정해야 하는가
라우터 자체의 분류 정확도만으로는 부족합니다.
저가 모델로 보낸 어려운 과업의 실패율
+ 강한 모델로 불필요하게 보낸 과업의 추가 비용
+ 재시도·에스컬레이션 비용
= 실제 라우팅 정책의 품질
고위험 업무에는 “가장 저렴한 모델”만이 아니라 안전하게 완료할 수 있는 최소 역량 모델이라는 기준과 실패 시 상향 전환 규칙이 필요합니다.
6. “Auto Mode” — 도구 호출 전 위험 게이트
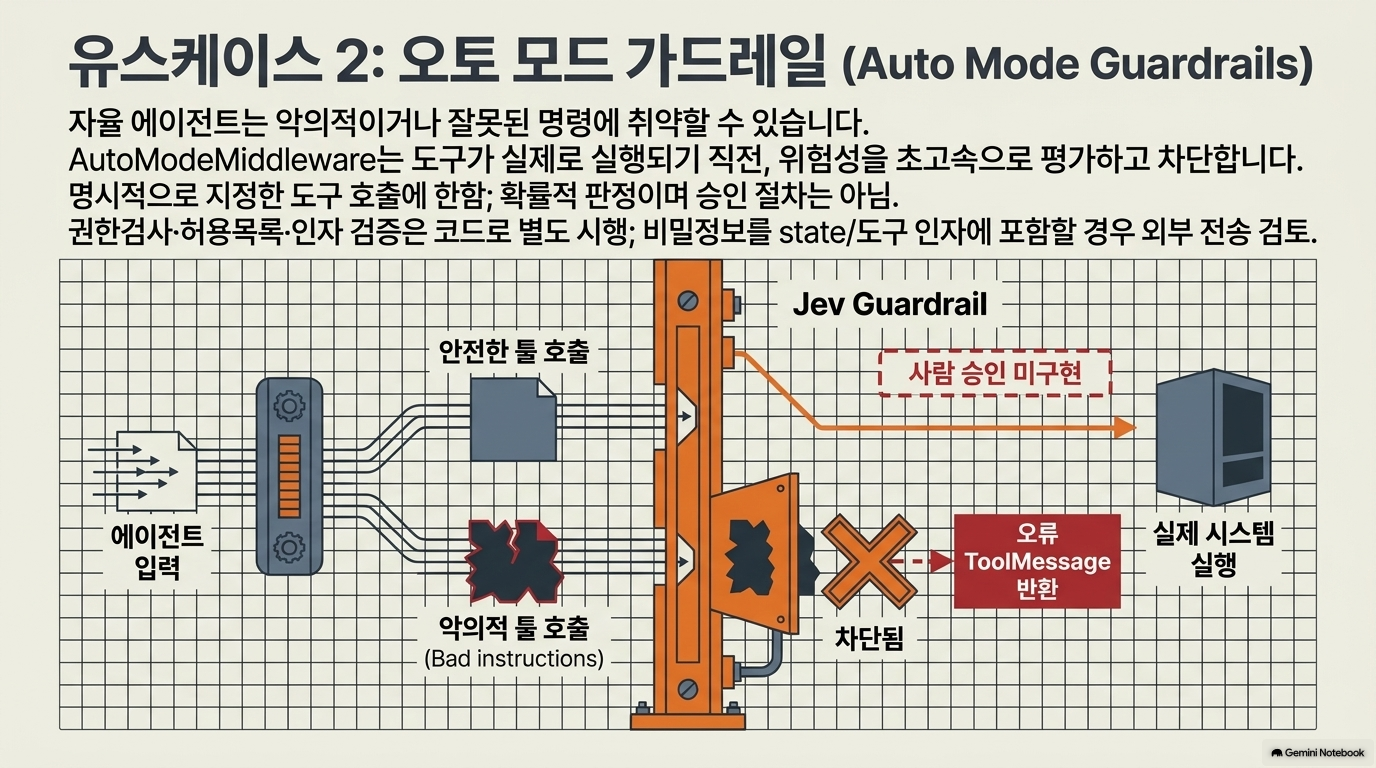
이 글의 가장 중요한 운영 사례입니다. 생성형 LLM이 bash 같은 도구 호출을 제안하면 AutoModeMiddleware가 실행 전에 위험을 판정하고, 위험하다고 판단한 호출을 차단합니다.[1]
공식 문서에서 이 미들웨어의 hook은 wrap_tool_call입니다. 명시적으로 지정한 도구만 검사하며, 위험하다고 판단한 호출에는 도구를 실제 실행하는 대신 오류 ToolMessage를 돌려줍니다.[2]
“안전 확인”으로 과대해석하면 안 되는 이유
- 도구 범위 제한: 예제의 tools=["bash"]는 bash에 대한 판정입니다. 다른 도구까지 포괄하는 전역 보안 경계가 아닙니다.[1][2]
- 확률적 판정: Jev의 오판으로 위험한 호출이 통과하거나 안전한 호출이 막힐 수 있습니다. 글은 이 미들웨어의 false negative/positive를 실측하지 않았습니다.
- 승인 절차 부재: 이 미들웨어는 위험 호출을 거부하지, 사람에게 승인을 요청하지 않습니다. 승인이 필요한 경우 human-in-the-loop 미들웨어를 별도로 결합해야 합니다.[2]
- 데이터 전송: 분류를 위해 전달한 대화 상태나 도구 인자가 TypeSafe 서비스로 보내질 수 있으므로, 비밀정보·민감정보를 담는지 검토해야 합니다.[2]
따라서 권고 구조는 다음과 같습니다.
도구 호출 제안
→ 코드 기반 권한·허용목록·인자 검증
→ Jev 위험 판정
→ 고위험/불확실: 사람 승인 또는 차단
→ 실행
→ 결과 기록·감사
Jev를 권한 시스템의 유일한 방어선으로 두어서는 안 됩니다. 분류기는 의미상 위험의 보조 탐지층이고, 실제 접근통제와 비가역 작업 제한은 결정론적 코드가 맡아야 합니다.
7. “Get Started!” — 데모 확산과 생산환경 검증의 차이
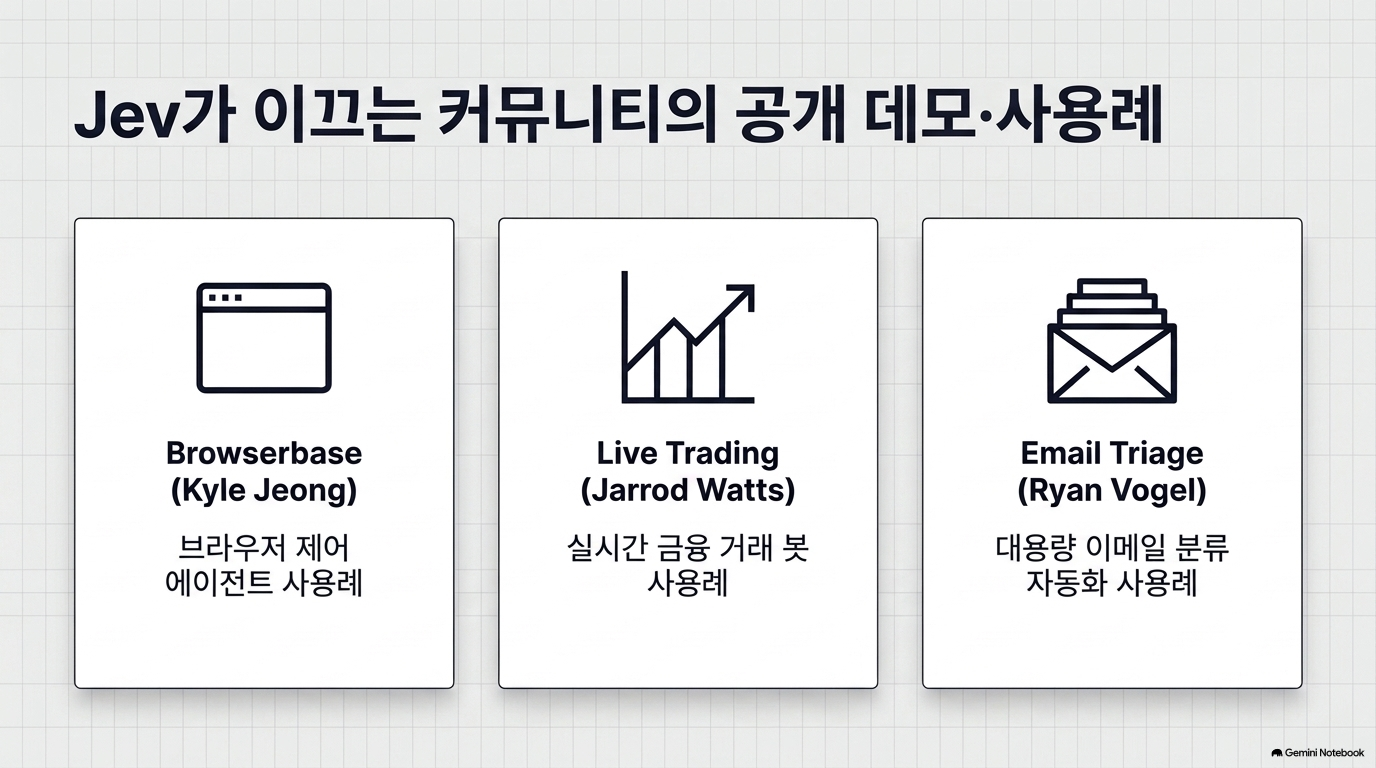
마지막 단락은 브라우저 에이전트, 실시간 거래, 대량 이메일 분류 등 커뮤니티 사용례를 소개합니다.[1] 이는 적용 가능성의 예시이지, 해당 사례의 안전성·수익성·실운영 성숙도를 검증한 결과는 아닙니다. 특히 거래·메일·브라우저 조작은 잘못된 한 번의 action이 외부 상태를 바꿀 수 있으므로, sandbox 시험과 rollback·승인 정책이 중요합니다.
이 글에 대한 종합 평가
강점: Jev를 추상적인 “새 모델”에서 끝내지 않고, before_agent / wrap_model_call / wrap_tool_call이라는 구체적 harness 개입 지점으로 번역했습니다. 모델 라우팅은 어떤 지능을 쓸지, Auto Mode는 제안된 행동을 실행할지라는 서로 다른 정책 문제임을 분명히 보여줍니다.[1][2]
한계: 비용·속도 배수는 벤더 주장이고, 원문 예제에는 라우팅의 최종 과업 성공률이나 위험 게이트의 누락률에 대한 평가가 없습니다. 두 미들웨어도 공식 문서상 experimental입니다.[1][2]
연구·실무 방향: 이 패턴을 검증하려면 동일 agent 과업집합에서 ① 모델 라우팅 오류 비용 ② 도구 위험 판정의 false negative ③ 사람 승인 전환율 ④ end-to-end 성공률·p95 지연·총비용을 측정해야 합니다. 공공·감리 환경이라면 분류 점수만이 아니라 입력 상태, 선택지·규칙 버전, 실행/차단 이유, 사람 승인 이력까지 추적해야 합니다.
Sources
[1] https://www.langchain.com/blog/building-a-harness-with-jev
[2] https://docs.langchain.com/oss/python/integrations/providers/typesafe
[3] https://docs.typesafe.ai/concepts/system-one

'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - Meta, Muse :AI 에이전트의 서비스 연결과 실행 범위를 구분한 생태계 분석 (0) | 2026.10.01 |
|---|---|
| 에이전트 AI - LangChain, Jev : 오케스트레이션 도구인 LangGraph를 결합 (0) | 2026.09.30 |
| Graph Engineering - AI 에이전트 시스템 구축 방법 (0) | 2026.09.30 |
| 에이전트 AI - TypeSafe AI, Jev :System 1 모델 등장 (0) | 2026.09.30 |
| 에이전트 AI - Weaviate, Engram: 관리형 에이전트 메모리 서비스 Engram (0) | 2026.09.30 |