https://www.langchain.com/blog/building-prod-with-jev-and-langgraph
2026.9.25
[Building Prod with Jev and LangGraph]
제공된 글은 최첨단 대형 언어 모델(LLM) 중심의 에이전트 구축 방식에서 벗어나, 특화된 판단 모델인 Jev와 오케스트레이션 도구인 LangGraph를 결합하여 더 빠르고 비용 효율적인 AI 소프트웨어를 구현하는 방법을 다루고 있습니다. 이 글은 복잡하고 비용이 많이 드는 범용 LLM 대신, 정형화된 판단을 저렴하고 신속하게 처리하는 Jev 모델의 등장 배경을 설명하며 핵심 주제를 엽니다. 이어지는 내용에서는 그래프 기반의 구조를 통해 프로그램의 흐름을 코드로 제어하고 상태를 관리하는 LangGraph의 역할을 상세히 소개합니다. 결론적으로 이 문서는 지능의 요소를 분할하여 단순한 판단은 가벼운 모델에 맡기고 복잡한 추론만 LLM에 위임하는 이른바 '지능의 대분할' 트렌드를 제시하며 실용적이고 신뢰성 있는 프로덕션 에이전트 개발의 청사진을 전달합니다.
이 글의 주장은 “더 강력한 LLM 하나에 모든 업무를 맡기자”가 아니라, “판단·생성·실행을 분리하고 각각에 적합한 구성요소를 배치하자”입니다.
- Jev: 제한된 선택지 안에서 의미적 판단을 수행
- LLM: 비식별화처럼 텍스트 생성·변환이 필요한 작업을 수행
- LangGraph: 실행 순서, 조건 분기, 상태 저장, 중단·재개를 관리
- 사람: 법적·업무적 책임이 큰 판단을 담당
- LangSmith: 실행 경로와 모델 판단 결과를 관찰·평가
따라서 글 제목에는 ‘Agents’가 사용되지만, 제시하는 구현 방향은 자유롭게 계획하는 자율 에이전트보다, AI 판단 기능을 내장한 통제 가능한 워크플로에 가깝습니다.[1][6]
아래에서는 원문 내용, 기술적 해석, 한계 및 보완 의견을 구분합니다. 원문뿐 아니라 연결된 공개 예제 코드와 공식 문서도 대조했습니다. 다만 모델 API를 직접 실행하거나 성능을 재측정한 것은 아니므로, 성능 수치는 해당 업체·저자의 보고값으로 해석해야 합니다.
0. 글의 구성과 문제의식
글 정보
| 항목 | 내용 |
| 제목 | Building Prod with Jev and LangGraph |
| 저자 | Sydney Runkle, Hunter Lovell |
| 게시일 | 2026년 9월 25일 |
| 성격 | LangChain의 아키텍처 설명 및 제품 활용 사례 |
| 중심 사례 | 소송 문서 검토 및 브라우저 자동화 |
위 정보는 원문에 표시되어 있습니다.[1]
본문은 다음 순서로 전개됩니다.
범용 LLM의 과잉 사용 문제
→ Jev를 판단 프리미티브로 도입
→ LangGraph로 판단과 실행을 조합
→ 상태·복구·사람 개입 설계
→ 문서 검토 사례
→ 지능 기능의 분리와 모델 라우팅
독해상 유의점: 이 글은 독립적인 성능 검증 보고서가 아니라, 특정 모델과 런타임을 결합하는 설계 패턴을 소개하는 글입니다. 아키텍처 논리와 성능 홍보 문구는 분리해 평가하는 것이 적절합니다.
1. 도입부 — “Prod, not god”: 범용 지능보다 운영 가능한 소프트웨어
1.1 원문 내용
원문은 범용 LLM의 능력이 확대되면서 개발자가 다음과 같은 서로 다른 업무를 모두 같은 종류의 모델로 처리하게 되었다고 지적합니다.
- 문장 생성
- 문서 정보 추출
- 검색 및 순위 결정
- 조사
- 분류
- 다음 행동 선택
그러나 실제로 필요한 답이 단순한 ‘예/아니오’인 경우에도, 범용 모델의 일반성에 대한 비용과 지연시간을 지불한다는 것이 문제입니다. TypeSafe는 이를 “prod, not god”, 즉 만능 지능보다 운영 가능한 제품을 만들자는 철학으로 설명합니다.[1]
원문은 TypeSafe 벤치마크를 인용해 Jev가 좁은 의사결정 작업에서 최대 200배 빠르고 400배 저렴하다고 소개합니다.[1]
1.2 기술적 해석
여기서 중요한 구분은 업무 난도와 출력의 개방성입니다.
예를 들어:
| 업무 | 필요한 기능 | 출력 형태 |
| 민원을 담당 부서에 배정 | 의미 분류 | 정해진 부서 중 선택 |
| 개인정보 포함 여부 판단 | 속성 판정 | 확률 또는 이진 판정 |
| 보고서 초안 작성 | 생성·구성 | 자유로운 텍스트 |
| 환급 금액 계산 | 정확한 연산 | 숫자 |
| 문서 공개 승인 | 정책 적용·책임 판단 | 승인 절차와 기록 |
문서가 복잡하다고 해서 모든 단계에 생성형 모델이 필요한 것은 아닙니다. 반대로 선택지가 단순하더라도 법적 책임이 크면 작은 모델에 자동 결정을 맡겨도 된다는 뜻은 아닙니다.
핵심은 ‘작은 모델 우선’ 자체가 아니라, 작업의 성격에 맞게 실행 주체를 분리하는 것입니다.
1.3 한계 및 보완 의견
[확인 필요: 원문 도입부]
‘최대 200배·400배’는 TypeSafe의 벤치마크를 인용한 상한 표현입니다. 이 글의 문서 검토 실험에서 직접 확인한 수치나, 모든 업무에 적용되는 평균 성능이 아닙니다.[1]
도입 판단에서는 다음을 별도로 확인해야 합니다.
- 동일 입력·동일 평가 기준인지
- 비교 모델과 버전이 무엇인지
- 정확도 수준이 동등한지
- 네트워크·게이트웨이 경로가 동일한지
- 모델 호출 비용 외에 재검토·오분류 비용을 포함했는지
실무 시사점: 도입 효과는 모델 단가보다 업무 완료까지의 총비용과 위험으로 평가해야 합니다.
2. 「Jev for decisions」 — 판단을 소프트웨어의 기본 구성요소로 만들기
2.1 원문 내용
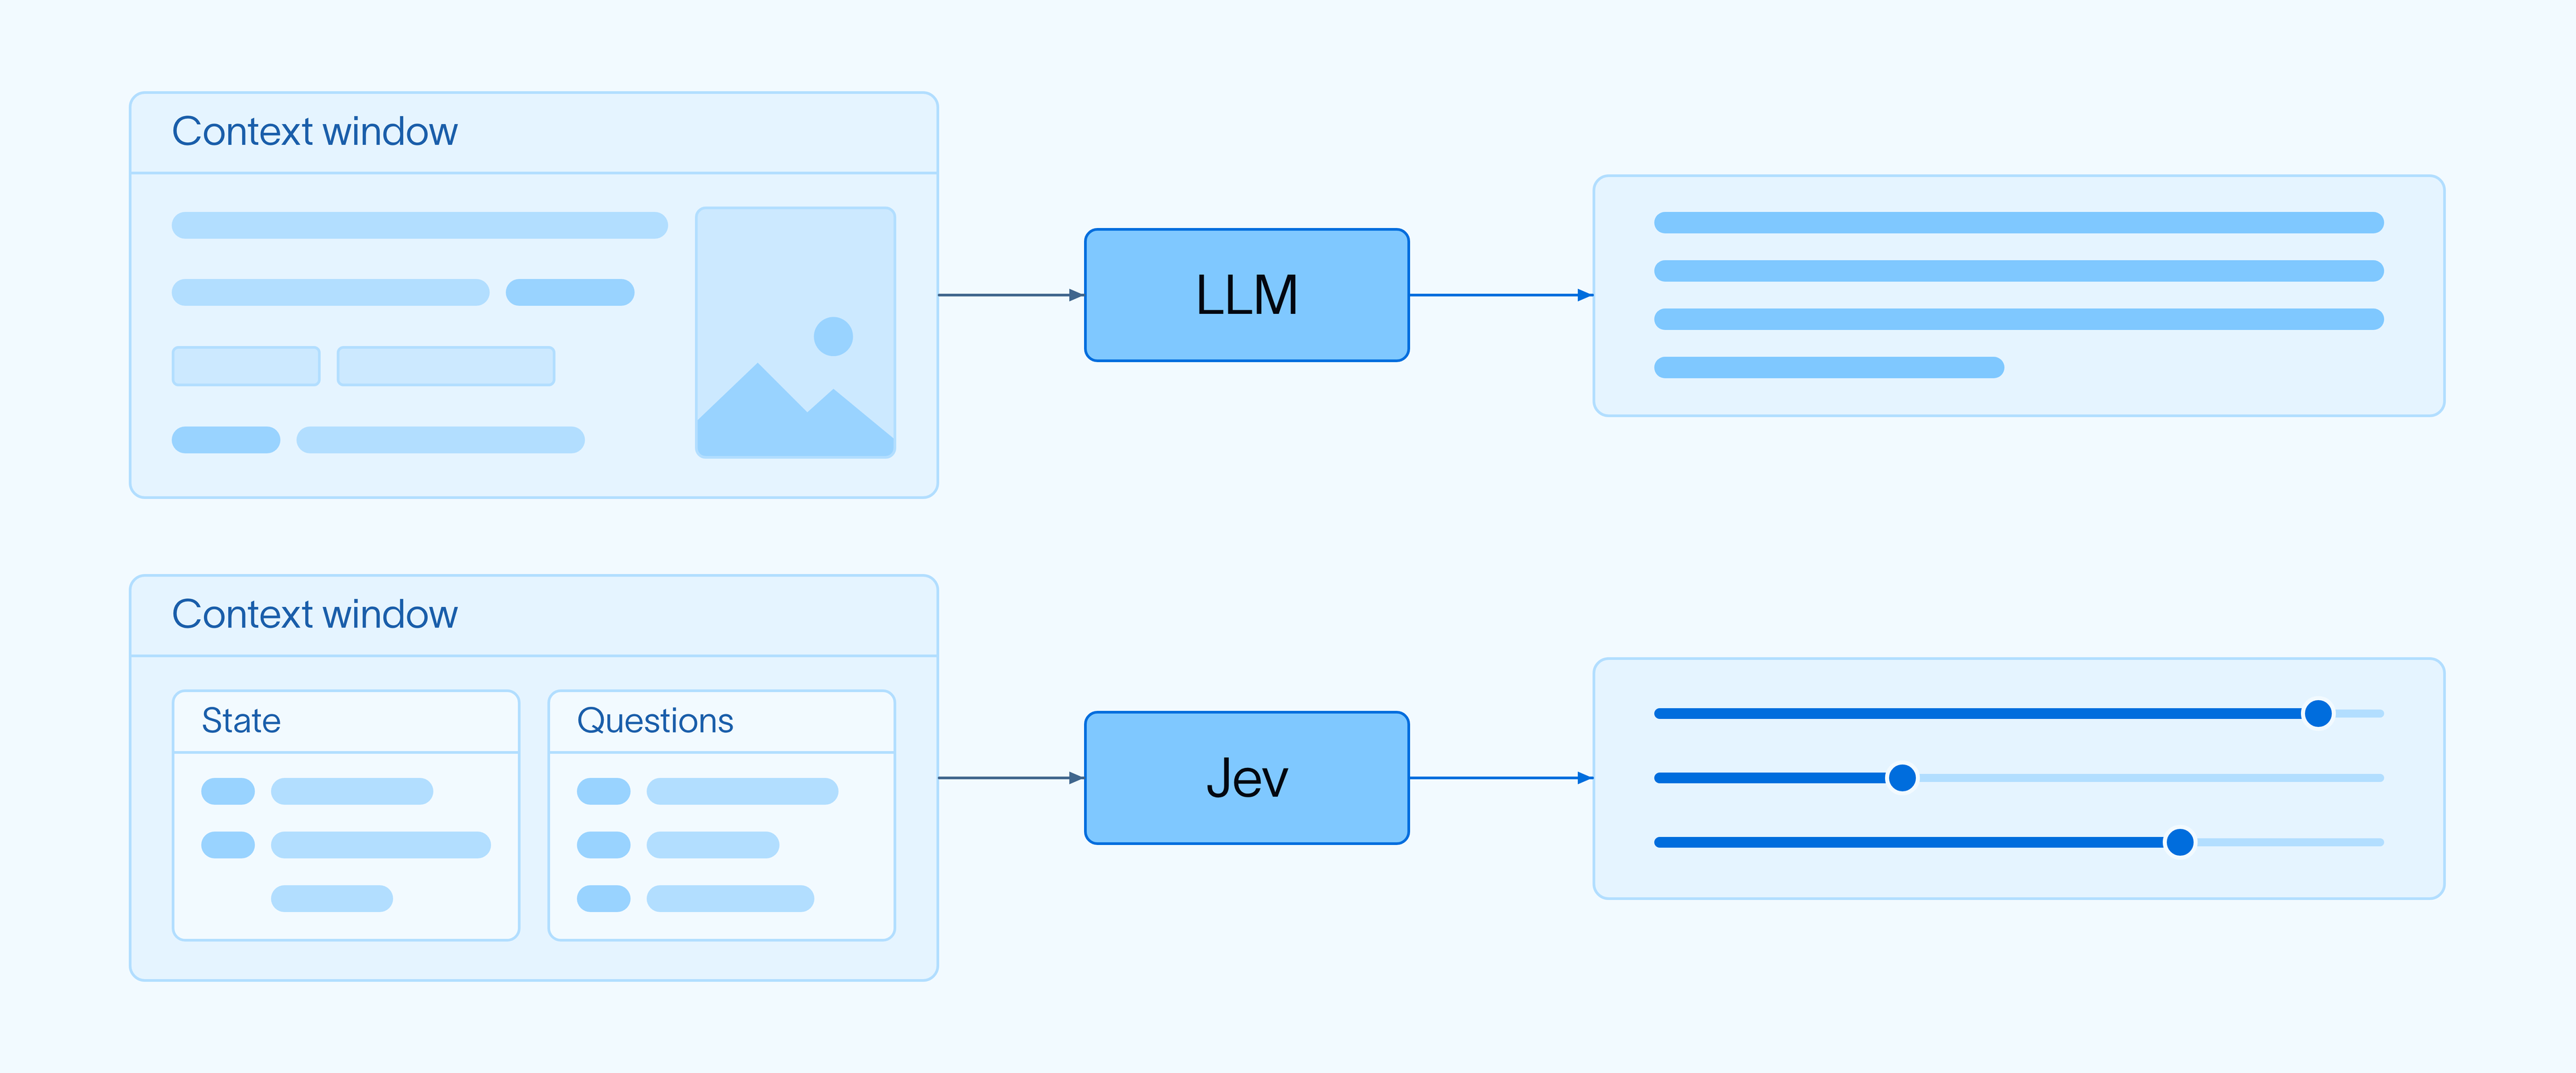
Jev는 일반적인 LLM처럼 문장을 생성하는 대신, 상태와 질문을 입력받아 타입이 정해진 답과 확률을 반환하는 ‘decision model’로 소개됩니다.[1]
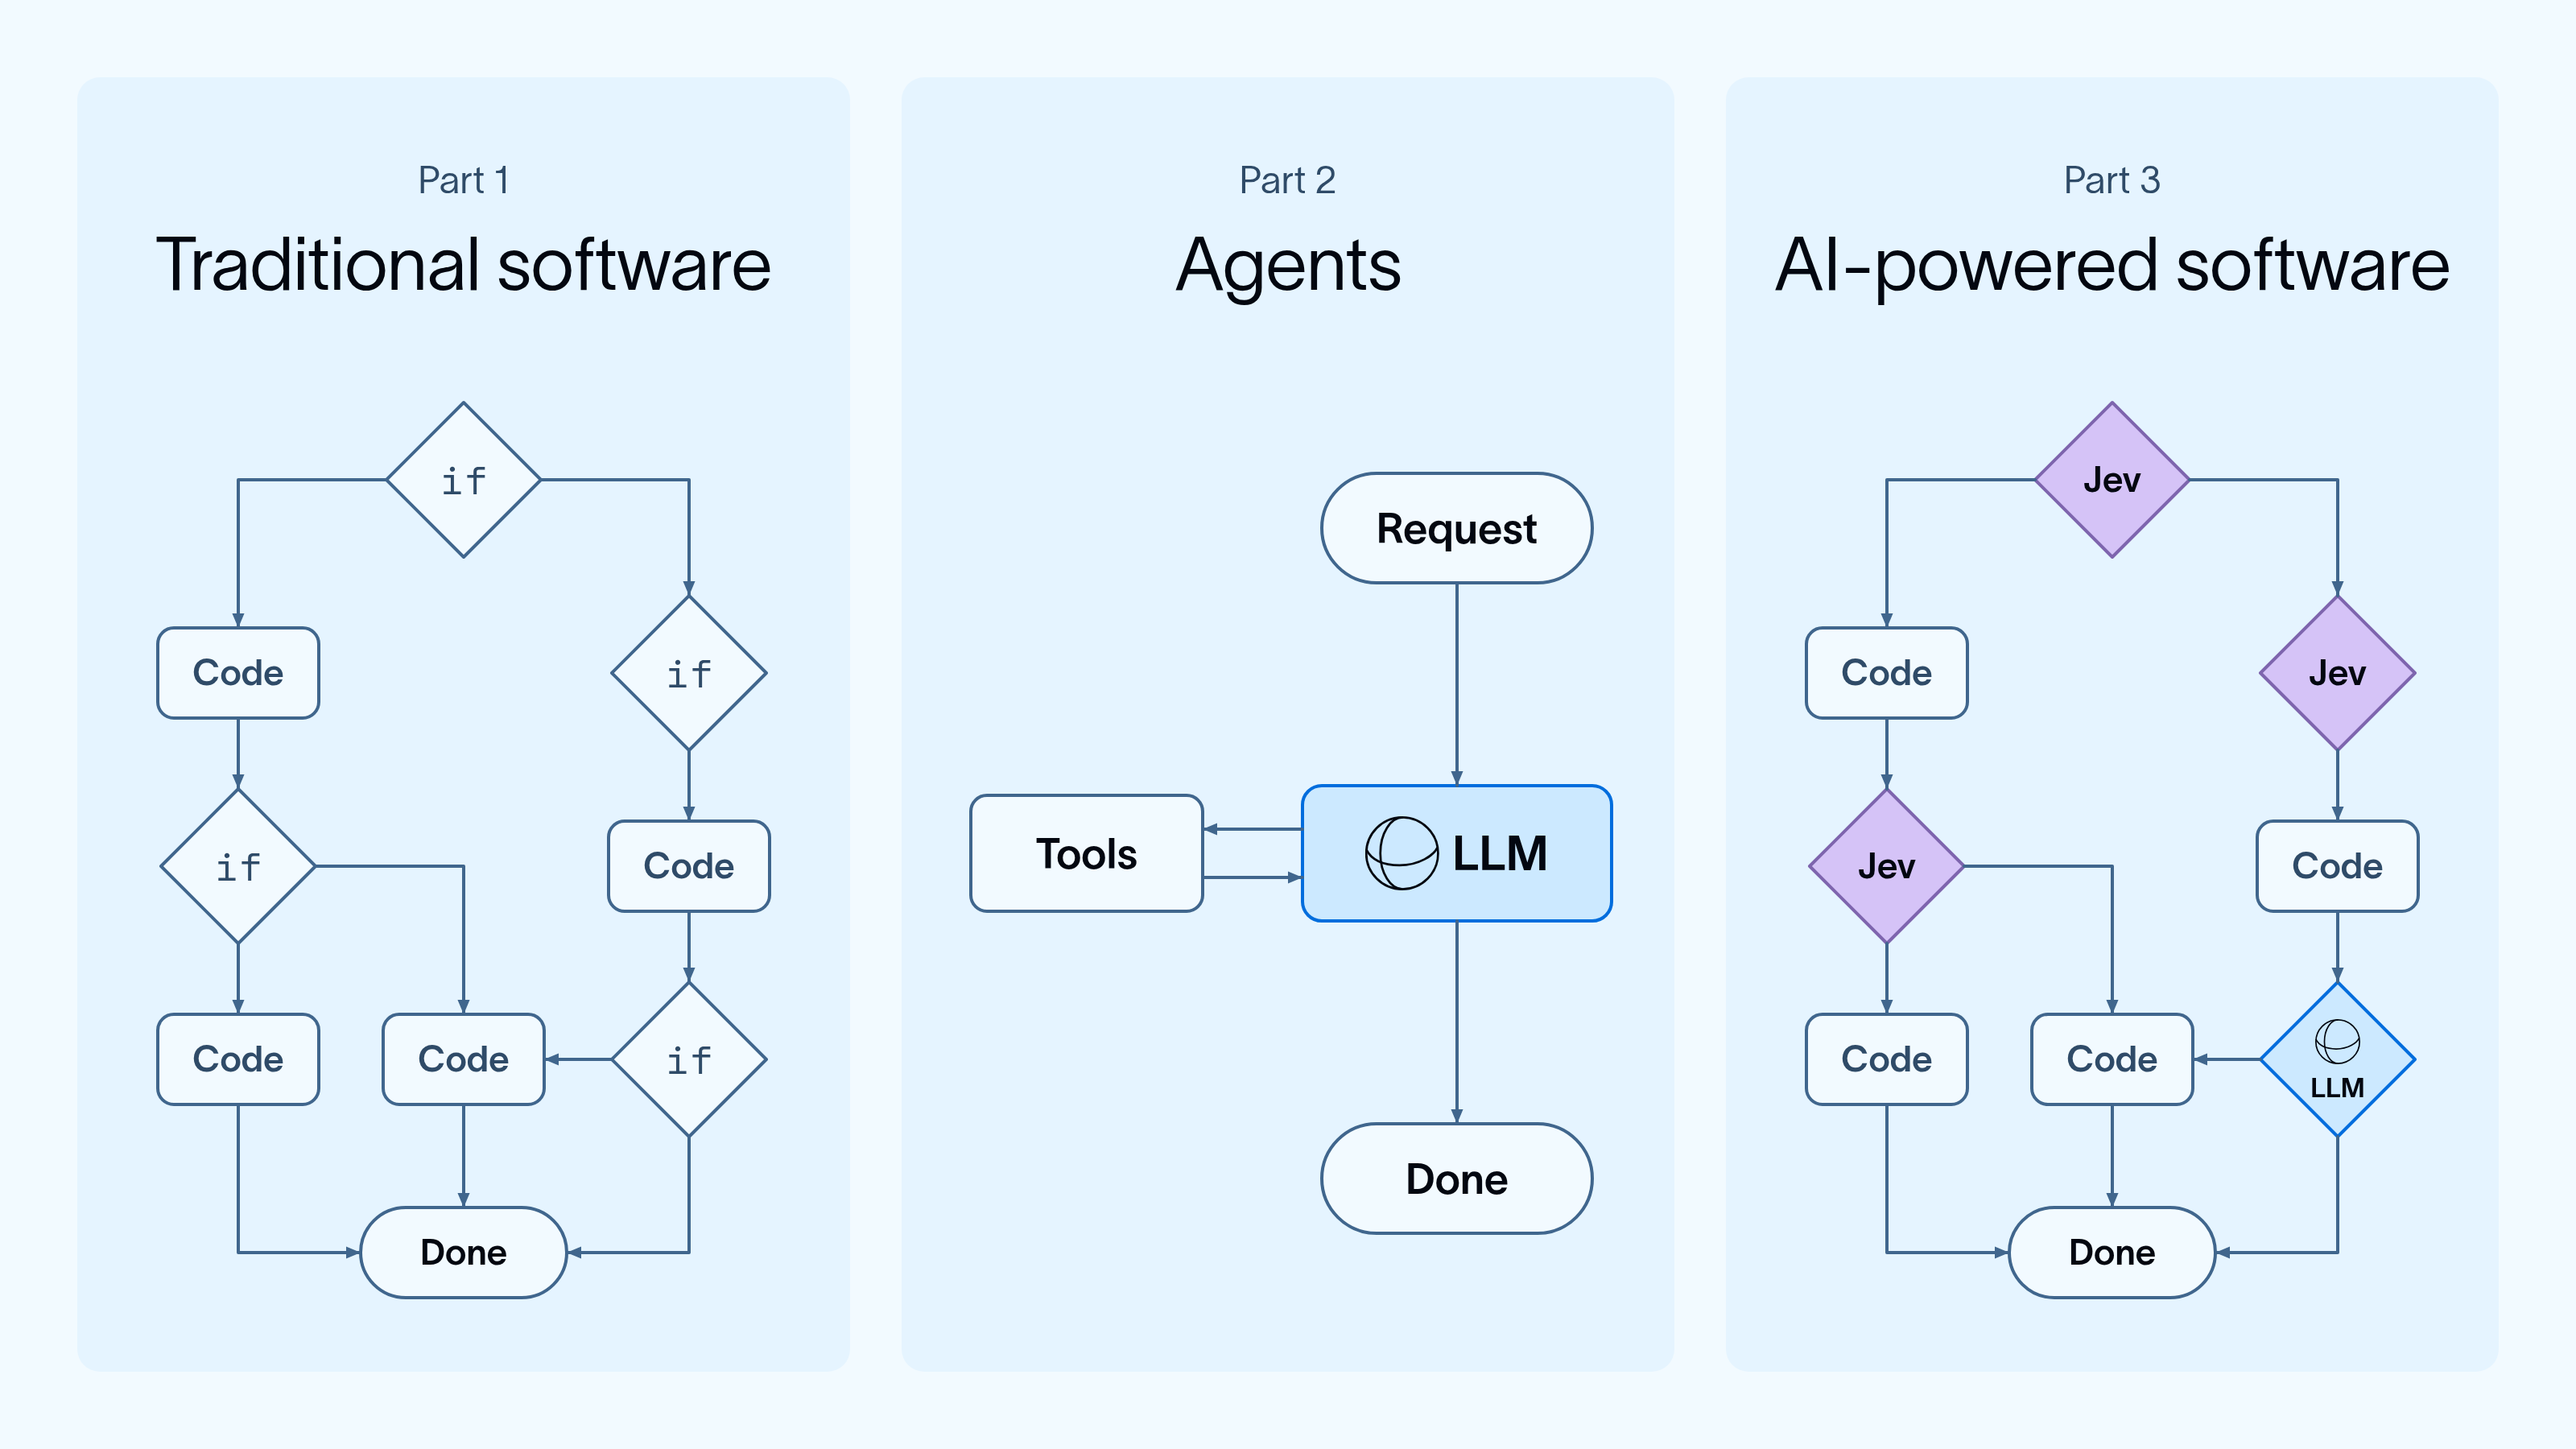
원문은 소프트웨어 구조를 세 유형으로 구분합니다.
| 구조 | 판단과 실행의 중심 | 특징 |
| 전통적 소프트웨어 | 명시적인 코드 | 감사 가능하지만 의미적 모호성에 경직됨 |
| LLM 에이전트 | 모델과 프롬프트 | 유연하지만 제어 흐름이 모델 판단에 의존 |
| AI-powered software | 코드 + 좁은 모델 판단 | 흐름은 코드가 유지하고 의미 판단만 모델이 수행 |
이 구분은 TypeSafe 공식 가이드의 핵심 철학이기도 합니다.[1][6]
원문이 강조하는 Jev의 속성은 다음과 같습니다.
- Structured: 타입이 정해진 결과를 반환
- Parallel: 같은 상태에 대해 여러 질문을 함께 평가
- Fast: 한 실행에서 다수의 판단을 수행하기에 적합
- Self-consistent: 같은 입력에 대해 안정적인 답을 반환하도록 설계[1]
2.2 판단 인터페이스를 이해하는 방법
보조 자료인 Browserbase 설명에서는 Jev의 판단을 세 가지 프리미티브로 설명합니다.[5]
| 프리미티브 | 의미 | 활용 예 |
| Choice | 정의된 선택지 중 하나 선택 | 담당 부서·행동 유형 선택 |
| Score | 순서가 있는 평가 기준에 따라 점수화 | 관련성·심각도 평가 |
| Noul | 질문에 대한 ‘예’의 확률 반환 | 개인정보·특권 가능성 판정 |
예를 들어 “이 문서를 적절히 처리하라”는 넓은 지시를 다음과 같이 분해하는 방식입니다.
- 요청 대상에 해당하는가?
- 개인정보가 포함되어 있는가?
- 법률상 보호되는 내용일 가능성이 있는가?
각 질문의 결과는 별도로 관찰하고, 최종 처리 규칙은 코드에서 조합합니다.
TypeSafe 공식 문서도 넓은 판단을 좁고 원자적인 질문으로 분해하고, 독립적인 질문은 함께 평가하라고 권고합니다.[6]
2.3 ‘독립 질문 병렬 평가’의 의미
여기서 병렬성은 모든 업무 단계를 한 번에 처리한다는 뜻이 아닙니다.
- 개인정보 여부와 문서 관련성처럼 같은 입력으로 독립 평가 가능한 질문은 함께 요청할 수 있습니다.
- 앞선 판단 결과에 따라 검색하거나 다른 자료를 읽어야 한다면 후속 단계가 필요합니다.
즉, 질문 수준의 병렬성과 워크플로 수준의 순차 의존성은 다릅니다.
이 구분을 잘못하면, 충분한 근거가 없는 상태에서 여러 판단을 동시에 요청하고 결과를 과신하는 구조가 됩니다.
2.4 안정성과 정확성은 구분해야 한다
원문은 초기 Jev 평가 실험에서 동일 작업을 100회 반복했을 때 점수 변동이 LLM 평가자보다 작았다고 설명합니다.[1]
그러나 다음은 서로 다른 품질 속성입니다.
| 속성 | 확인하는 것 |
| 출력 형식 적합성 | 스키마에 맞는가 |
| 반복 안정성 | 같은 입력에 같은 답을 주는가 |
| 의미적 정확성 | 정답과 일치하는가 |
| 확률 보정 | 높은 확률을 준 사례가 실제로 그만큼 맞는가 |
같은 오답을 일관되게 반환하는 모델도 안정적인 모델일 수 있습니다.
따라서 confidence나 확률을 곧바로 실측 정확도로 읽어서는 안 됩니다. TypeSafe가 확률 보정을 설계 목표로 제시하더라도, 실제 적용 분야의 정답 데이터로 별도 검증해야 합니다.[6]
실무 시사점
Jev의 가치는 단순히 ‘빠른 분류’에 있지 않습니다.
판단을 명시적인 입출력 계약으로 노출하고, 그 결과를 코드에서 통제할 수 있게 한다는 점이 더 중요합니다.
다만 지식 최신성, 한국어 문서, 산업별 용어, 희귀 위험 사례에 대한 성능은 이 글만으로 판단할 수 없습니다.
3. 「LangGraph for orchestration」 — 판단 모델과 실행 시스템은 별개다
3.1 원문 내용
원문은 모델 기반 시스템이 반복해서 마주치는 문제를 두 가지로 정리합니다.
- 컨텍스트 관리: 다음 판단에 필요한 정보를 적절히 구성하기 어렵다.
- 운영 신뢰성: 장애를 견디고, 사람 개입을 지원하며, 모든 단계를 관찰할 수 있어야 한다.[1]
LangGraph는 모델 판단과 결정론적 코드를 결합하는 런타임으로 제시됩니다. 원문은 월간 다운로드가 6천만 회 이상이며 Fortune 50 기업 다수가 사용한다고 설명하지만, 이는 본문에서 제시하는 업체 설명이지 별도로 검증된 도입 통계는 아닙니다.[1]
3.2 기술적 해석
판단 모델이 빨라지는 것과 전체 시스템이 운영 가능해지는 것은 다른 문제입니다.
모델 응답이 빨라도 다음 문제가 남습니다.
- 어떤 입력을 전달할 것인가?
- 결과가 애매하면 어디로 보낼 것인가?
- API 호출이 실패하면 어떻게 재시도할 것인가?
- 사람이 승인하기 전 실행을 막을 수 있는가?
- 중단 이후 어떤 상태에서 재개할 것인가?
- 같은 작업이 중복 실행되는 것을 어떻게 막을 것인가?
Jev는 주로 판단 인터페이스를 제공하고, LangGraph는 그 판단을 업무 흐름에 연결합니다.
분석적 결론
이 장의 핵심은 다음과 같습니다.
모델 선택은 구성요소 최적화이고, 오케스트레이션은 시스템 설계다.
모델의 단가·속도가 좋아져도 업무 책임, 복구, 접근통제, 결과 검증은 없어지지 않습니다.
4. 「State as context」 — 프롬프트에 숨겨진 업무 논리를 그래프로 드러내기
4.1 원문 내용
LangGraph 애플리케이션은 세 요소로 구성됩니다.
- Node: 코드, 모델 호출, 도구 호출, 하위 그래프 등 작업 단위
- State: 노드가 읽고 갱신하는 정보
- Edge: 다음 실행 노드를 결정하는 연결
하나의 그래프를 더 큰 그래프의 노드로 구성할 수 있어, 작은 단위의 테스트와 조합이 가능합니다.[1]
원문은 도메인 지식을 프롬프트에 몰아넣기보다 다음 요소에 표현하라고 주장합니다.
- 어떤 판단을 수행하는지
- 어떤 순서로 수행하는지
- 각 판단에 어떤 상태를 제공하는지
- 어떤 조건으로 분기하는지[1]
4.2 무엇을 ‘프롬프트에서 코드로’ 옮기는가
예를 들어 프롬프트만 사용하는 구조는 다음과 같습니다.
“관련성을 검토하고, 개인정보를 제거하고, 법률상 보호 가능성이 있으면 변호사에게 보내라.”
이 방식에서는 판단 순서와 예외 처리가 모델 해석에 상당 부분 의존합니다.
그래프 구조에서는 이를 분리합니다.
문서 입력
↓
판단 노드
↓
명시적인 분기 규칙
├─ 제외
├─ 사람 검토
├─ 비식별화
└─ 제공 가능
다만 모든 도메인 지식이 그래프 위상으로 옮겨지는 것은 아닙니다.
공개 예제에서도 관련성 기준과 법률상 보호 가능성의 설명은 여전히 모델 질문에 들어가고, 임계값과 경로 우선순위는 코드에 들어갑니다.[2]
따라서 더 정확한 구분은 다음과 같습니다.
| 지식·정책의 종류 | 배치 위치 |
| 의미 판정 기준 | 질문·평가 기준 |
| 실행 순서 | 그래프 구조 |
| 임계값·예외 처리 | 코드 |
| 현재 사건·업무 정보 | 상태 |
| 책임 있는 최종 결정 | 승인 절차 |
4.3 State는 자동으로 좋은 컨텍스트가 되지 않는다
원문은 실행 결과가 상태에 누적되어 후속 단계의 컨텍스트가 된다고 설명합니다.[1]
그러나 그래프 상태 전체와 모델에 전달하는 컨텍스트는 동일하지 않습니다.
실제 예제는 분류 모델에 상태 전체가 아니라 protocol과 page를 전달합니다.[2] TypeSafe 공식 가이드도 각 질문에 필요한 정보만 제공하라고 권고합니다.[6]
[보완 필요: 상태 설계]
실무에서는 다음을 명시해야 합니다.
- 상태 필드별 출처와 갱신 주체
- 원문·추출문·모델 판단의 구분
- 모델 호출에 전달할 필드의 허용 목록
- 문서·규정·질문·모델의 버전
- 기관·사용자별 상태 접근권한
- 중간 결과의 보존·삭제 기준
감리 관점의 시사점: 상태 설계는 단순한 개발 편의가 아니라, 판단 근거의 추적성과 개인정보 처리 범위를 결정하는 설계 항목입니다.
5. 「A reliable runtime」 — 복구·사람 개입·관찰 가능성
5.1 원문 내용
원문은 신뢰 가능한 런타임의 기능을 세 가지로 정리합니다.
| 기능 | 원문에서의 역할 |
| Durable execution | 상태를 저장하고 장애 이후 재개 |
| Human in the loop | 필요한 단계에서 중단·검토·승인 |
| Observability | LangSmith로 판단과 실행 경로 관찰 |
Jev도 비정형 텍스트를 받아 판단하므로, 생성형 LLM과 마찬가지로 이러한 운영 기능이 필요하다는 것이 주장입니다.[1]
5.2 체크포인트는 설정과 저장소에 의존한다
공식 문서에서 체크포인터는 스레드별 그래프 상태를 보존하는 구성요소이고, 장기적인 스레드 간 정보 저장은 별도의 Store 역할로 구분됩니다.[3]
중단·재개에는 다음이 필요합니다.
- 체크포인터
- 동일 실행을 식별하는 thread_id
- 중단 위치의 interrupt()
- 재개 입력을 전달하는 Command(resume=...)[4]
[보완 필요: 영속성]
공개 비교 예제는 InMemorySaver()를 사용합니다.[2] 이는 데모의 실행 중 상태 유지에는 적합하지만, 프로세스 종료 이후의 복구를 검증하는 운영 구성으로 읽어서는 안 됩니다. 공식 문서도 운영 환경에서는 데이터베이스 등에 기반한 영속 체크포인터를 사용하도록 설명합니다.[4]
5.3 재개는 단순히 ‘멈춘 다음 줄부터’ 실행하는 것이 아니다
공식 문서에 따르면 중단된 노드를 재개할 때 노드 시작부터 다시 실행하며, interrupt() 이전 코드도 재실행됩니다.[4]
따라서 다음과 같은 부작용이 중단 이전에 있으면 문제가 됩니다.
- 외부 메시지 발송
- 레코드 신규 생성
- 지급·주문 실행
- 중복 방지 없는 로그 추가
실무 권고: 외부 변경 작업에는 멱등성 키, 중복 확인, 별도 실행 노드, 결과 읽기 검증을 적용해야 합니다.
체크포인트가 있다는 사실만으로 외부 시스템의 작업이 정확히 한 번 실행된다고 보장되지는 않습니다.
5.4 사람 개입 기능과 승인 통제는 다르다
interrupt()는 외부 입력을 기다리는 기능입니다.[4] 그 입력을 누가 제출했는지, 권한이 있는지, 실제로 문서를 검토했는지는 애플리케이션에서 구현해야 합니다.
공개 비교 코드에서는 사전에 정의한 ATTORNEY_DECISIONS 값을 사용해 재개합니다.[2]
따라서 이 예제는:
사람 검토 경로와 재개 메커니즘을 시연하지만, 실제 변호사 검토 업무의 적정성을 입증하지는 않습니다.
운영 승인에는 최소한 다음이 필요합니다.
- 검토자 인증·권한
- 검토 대상 문서와 버전
- 승인·반려 사유
- 승인 시점
- 장기 미처리 건의 처리 정책
5.5 관찰 가능성과 설명 가능성도 다르다
LangSmith에서는 입력, 출력, 확률, 실행 경로를 관찰할 수 있습니다.[1]
하지만 “어떤 점수로 어느 경로를 탔는가”와 “왜 그 판단이 실질적으로 옳은가”는 다릅니다.
고위험 업무라면 확률과 경로 외에도 다음을 확보하는 것이 바람직합니다.
- 근거 문장·문서 위치
- 적용 규정·검토 기준
- 사람 검토 기록
- 오류 및 이의제기 처리 결과
6. 「Example: document review for discovery」 — 소송 문서 검토 사례
이 장은 글의 아키텍처를 가장 구체적으로 보여줍니다. 동시에 본문의 간단한 설명과 공개 코드 사이의 차이도 확인할 수 있습니다.
6.1 원문이 설명하는 업무 흐름
소송 과정에서 상대방에게 문서를 제공하기 전, 각 페이지에 대해 세 가지를 판단합니다.
- 요청과 관련된 페이지인가?
- 개인정보가 포함되어 있는가?
- 법률상 보호되는 문서일 가능성이 있는가?
관련 없는 페이지는 제외하고, 개인정보가 있으면 LLM으로 제거하며, 보호 가능성이 있으면 변호사 검토로 보냅니다. 페이지들은 병렬로 처리하는 구조입니다.[1]
여기서 privileged는 일반적인 ‘민감정보’와 같은 개념이 아니라, 사례에서 법률상 보호 여부를 검토할 대상으로 사용됩니다. 공개 질문은 변호사의 작성·수신 또는 법률 자문 전달 여부 등을 단서로 평가합니다.[2]
6.2 공개 코드의 실제 분기
코드는 세 질문을 함께 평가하지만, 다음 경로 선택에는 명확한 우선순위를 둡니다.[2]
| 순서 | 조건 | 처리 |
| 1 | privileged > 0.2 | attorney_review |
| 2 | 관련성 점수 < 0.5 | withhold |
| 3 | 관련성 점수 < 1.5 또는 관련성 confidence < 0.7 | attorney_review |
| 4 | 개인정보 확률 > 0.5 | redact |
| 5 | 위 조건에 해당하지 않음 | produce |
공개 코드의 조건을 그대로 옮긴 것입니다.[2]
중요한 차이: 본문에서는 관련성 판단을 먼저 설명하지만, 코드에서는 법률상 보호 가능성이 최우선입니다. 관련성이 낮더라도 보호 가능성이 기준을 넘으면 사람 검토로 갑니다.
6.3 임계값은 오류 비용의 비대칭을 반영한다
코드 주석은 보호 문서를 잘못 제공하는 비용이 불필요한 변호사 검토 비용보다 크기 때문에, 보호 가능성의 상향 기준을 낮게 잡았다고 설명합니다.[2]
이는 합리적인 설계 방향입니다.
다만 0.2라는 값 자체의 적정성은 별도 검증 대상입니다.
임계값을 정하려면 다음이 필요합니다.
- 보호 대상 문서의 누락률
- 불필요 검토율
- 사람 검토 처리 용량
- 사건·문서 유형별 분포
- 확률 보정 검증
- 잘못된 공개의 업무·법적 비용
핵심: 임계값은 모델의 기술 옵션이 아니라, 조직의 위험 수용 기준을 구현한 정책입니다.
6.4 Score는 단순한 정수 등급이 아니다
예제는 관련성을 세 수준으로 정의합니다.
- 관련 없음
- 관련 가능성 있음
- 직접 관련 있음
하지만 코드 주석은 Score.score를 분포에 대한 기대값으로 설명하고, 중간 값을 허용합니다.[2]
따라서:
- score는 평가 수준에 대한 위치를 나타내고,
- confidence는 그 분포의 집중 정도를 나타내며,
- 둘을 조합해 경로를 결정합니다.
코드는 명확한 비관련성 구간을 먼저 제외하므로, 낮은 confidence가 모든 제외 결정을 일괄 차단하는 구조는 아닙니다.[2]
6.5 공개 코드에서 확인되는 운영상 보완점
① 사람 승인 이후 개인정보 제거를 우회할 수 있음
attorney_review 노드는 재개 입력을 최종 결과에 기록하고 종료합니다. 검토자가 produce를 선택해도, 코드상 redact 노드를 다시 거치지 않습니다.[2]
[보완 필요: 예제 attorney_review 경로]
보호 가능성과 개인정보가 함께 있는 문서에서, 사람이 제공을 허용한 이후 개인정보 처리 여부를 다시 확인하는 경로가 필요합니다.
사람 승인과 비식별화는 서로 대체 관계가 아닙니다.
권고 흐름은 다음과 같습니다.
법률 검토
├─ 제공 금지 → 보류
└─ 제공 허용
↓
개인정보 처리 확인
↓
필요한 비식별화
↓
최종 제공
② LLM 비식별화 결과의 재검증이 없음
예제는 LLM에 개인정보를 [REDACTED]로 바꾸라고 요청한 뒤, 결과를 제공 가능한 문서로 기록합니다. 해당 노드에는 별도의 누락 검증이나 원문 보존성 검사가 없습니다.[2]
[보완 필요: 예제 redact 노드]
- 개인정보 잔존 검사
- 비개인정보 부분의 불필요한 변경 검사
- 출력 잘림·누락 검사
- 원문과 변환 결과의 연결 기록
- 최종 문서 파일에서 실제 제거 여부 확인
텍스트 수준의 치환 데모와 PDF·이미지 파일의 안전한 비식별화는 별도 문제로 보아야 합니다.
③ 중단 payload 최소화가 전체 저장 최소화를 뜻하지 않음
코드는 중단 payload에 문서 원문을 넣지 않고 문서 ID와 점수만 전달합니다. 그러나 PageState에는 page 원문이 있고, 모델 요청에도 원문이 포함됩니다.[2]
[확인 필요: 데이터 흐름]
중단 payload가 작다는 사실만으로 체크포인트·모델 API·트레이스에서 원문이 저장되지 않는다고 판단할 수 없습니다. 각각의 저장·전송·마스킹 설정을 확인해야 합니다.
④ 페이지 단위 처리의 맥락 한계
예제는 페이지 단위로 판단합니다.[1][2]
분석적 한계: 이메일 스레드, 첨부 문서, 앞뒤 페이지에 근거가 분산되어 있으면 페이지 하나만으로 판단하기 어렵습니다. 문서 전체 또는 관련 페이지를 선택적으로 보충하는 경로가 필요합니다.
6.6 성능 수치의 해석
원문은 동일 그래프에서 Jev와 Sonnet을 비교했을 때 분류 단계가 여러 시험에서 5~6배 빨랐다고 보고합니다.[1]
공개 비교 코드는 분류기 호출 시간을 비식별화 작업과 분리해 측정하고, 전체 그래프 실행 시간도 별도로 기록합니다. 또한 일부 비교군의 직접 호출과 게이트웨이 호출이 서로 다른 네트워크 경로를 사용한다는 주석이 있습니다.[2]
따라서 이 결과는 다음과 같이 읽어야 합니다.
해당 예제에서 분류 단계의 지연시간 개선을 보고한 결과이지, 문서 검토 전체 업무가 5~6배 빨라졌거나 법률 검토 품질이 동등하다는 증거는 아닙니다.
공개 코드의 소규모 문서 세트와 모델 간 경로 일치 비교도, 대규모 실문서에 대한 정답 기반 정확도 검증을 대신하지 않습니다.[2]
7. 「This is the great unbundling of intelligence」 — 지능 기능의 분리와 예외 기반 상향 처리
7.1 원문 내용
원문은 하나의 프런티어 LLM에 묶여 있던 기능을 분리하고, 각 기능을 수행할 수 있는 가장 저렴한 모델에 배치하는 흐름을 “Great Unbundling of Intelligence”로 설명합니다.[1]
그 운영 원칙은 다음 표현으로 요약됩니다.
Cheap by default, frontier on exception.
기본 경로는 저렴하게, 예외는 고성능 모델로.
Jev는 제한된 판단을 처리하고, 자신 있게 처리하기 어려운 사례나 개방형 추론·생성은 LLM에 넘기는 구조입니다.[1]
7.2 브라우저 자동화 사례
원문은 Browserbase의 Stagehand act() 개선을 사례로 듭니다.
Browserbase의 상세 설명에 따르면 흐름은 다음과 같습니다.
- 접근성 트리에서 상호작용 가능한 요소 표시
- Jev로 행동 유형 분류
- 해당 행동의 후보 요소 목록 구성
- 가장 적합한 후보와 일치 여부 판단
- 수락 기준 0.7을 적용
- 수락하면 Stagehand가 실행, 아니면 LLM으로 전환[5]
초기 시험에서 act() 지연시간 중앙값이 1.97초에서 0.46초로 감소했고, 약 4.3배 빨라졌다고 보고합니다.[1][5]
7.3 성공 조건은 ‘행동 공간의 구조화’다
이 사례의 본질은 단순히 모델을 교체한 데 있지 않습니다.
원래 넓은 질문:
“이 페이지에서 목표를 달성하려면 무엇을 해야 하는가?”
이를 다음과 같이 좁힌 것입니다.
“이번 행동에 해당하는 후보들 중 어느 요소가 적합한가?”
이 전환에는 모델 외의 개발 작업이 필요합니다.
- 행동 유형 정의
- 후보 생성
- 페이지 구조 해석
- 인자 파싱
- 실행 도구 구현
- 실패 시 상향 처리
분석적 결론: 작은 모델을 잘 쓰려면, 큰 모델이 암묵적으로 수행하던 문제 구조화의 일부를 소프트웨어로 옮겨야 합니다.
7.4 후보 선택이 맞아도 실행 성공은 별도다
올바른 버튼을 선택했더라도 다음 문제가 생길 수 있습니다.
- 버튼 비활성화
- 페이지 갱신으로 대상 변경
- 클릭 이후 서버 오류
- 인증 만료
- 예상과 다른 상태 전이
따라서 운영 흐름은 다음과 같이 확장하는 것이 적절합니다.
후보 생성 → 모델 판단 → 권한·정책 확인 → 실행 → 결과 상태 검증
0.7이라는 수락 기준은 정확도 70% 보장이나 안전 승인 기준이 아닙니다. 해당 제품의 라우팅 설정이며, 결제·삭제·권한 변경 같은 행동에는 별도의 결정론적 통제와 승인 절차가 필요합니다.
8. 「Getting started」 — 학습 자료보다 도입 순서가 중요하다
원문은 시작 자료로 다음 세 방향을 제시합니다.
- LangGraph 런타임의 설계 배경
- Jev를 이용한 에이전트 하네스 구성
- LangSmith를 이용한 관찰 및 평가[1]
이를 실제 도입 절차로 바꾸면 다음 순서가 적절합니다.
| 단계 | 핵심 작업 | 확인할 산출물 |
| 1. 판단 목록화 | 생성·판단·계산·승인 분리 | 업무 분해표 |
| 2. 질문 원자화 | 넓은 질문을 개별 속성으로 분해 | 질문·평가 기준 명세 |
| 3. 정답 데이터 준비 | 일반·경계·희귀 위험 사례 확보 | 평가 데이터셋 |
| 4. 오프라인 검증 | 정확도·누락률·확률 보정 검증 | 평가 보고서 |
| 5. 라우팅 정책 설계 | 임계값·예외·사람 개입 결정 | 정책 명세 |
| 6. 운영 검증 | 장애·재개·중복 실행·데이터 보호 시험 | 운영 테스트 결과 |
이 표는 원문을 바탕으로 한 실무 권고이며, 원문에 그대로 제시된 절차는 아닙니다.
TypeSafe 공식 가이드가 강조하는 원칙도 이와 정합적입니다. 정확한 연산과 부작용은 코드에 두고, 의미적 판단만 작고 명시적인 질문으로 모델에 맡기라는 것입니다.[6]
9. 「Acknowledgements」 — 근거의 성격
마지막 장은 저자 및 검토 참여자를 밝히는 감사의 글입니다.[1]
별도의 기술 주장은 없지만, 글을 해석할 때 다음을 구분하는 데 의미가 있습니다.
- 제품 개발·활용 경험을 바탕으로 한 설명
- 공개 데모 코드로 확인 가능한 구현
- 업체가 보고한 성능 수치
- 독립 검증이 필요한 일반화된 주장
이 글에서 가장 근거가 분명한 부분은 구성요소의 역할 분리와 공개 코드의 실행 경로입니다. 반면 특정 업무에서의 정확도·총비용·법적 적정성은 추가 검증이 필요합니다.
최종 판단
이 글의 가장 중요한 기여는 Jev의 속도 수치가 아니라 다음 설계 관점입니다.
AI를 업무 전체의 실행 주체로 놓기보다, 명시적인 소프트웨어 구조 안에서 제한된 판단을 제공하는 구성요소로 배치한다.
이는 공공부문 AI와 감리 관점에서도 유용합니다. 판단 단위를 분리하면 요구사항 매핑, 경로별 테스트, 승인 통제, 변경 영향 분석을 더 명확하게 할 수 있기 때문입니다.
다만 공개 예제는 운영 제품의 완성형이 아니라 구조를 설명하는 데모입니다. 실제 도입에서는 특히 다음을 보완해야 합니다.
- 영속 체크포인트와 복구 시험
- 실제 사람 승인 및 권한 통제
- 승인 이후 개인정보 처리의 누락 방지
- LLM 변환 결과 재검증
- 체크포인트·트레이스의 원문 보호
- 정답 데이터 기반 임계값·정확도 검증
결론적으로, “Jev + LangGraph를 쓰면 신뢰성이 생긴다”가 아니라, “판단을 분리하고 실행을 명시적으로 설계하면 신뢰성을 검증할 수 있는 구조가 된다”로 읽는 것이 정확합니다.
Sources
[1] https://www.langchain.com/blog/building-prod-with-jev-and-langgraph
[2] https://gist.github.com/sydney-runkle/a632ba4ea0b2b72501dfa4b6ab2a7d8a
[3] https://docs.langchain.com/oss/python/langgraph/durable-execution
[4] https://docs.langchain.com/oss/python/langgraph/interrupts
[5] https://www.browserbase.com/blog/what-is-jev
[6] https://docs.typesafe.ai/concepts/how-to-build-with-system-one
'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 하네스 엔지니어링 - Turbo Harness: 최적화된 하네스를 각 인스턴스에 맞게 조정할 수 있는 프레임워크 (0) | 2026.10.04 |
|---|---|
| 에이전트 AI - Meta, Muse :AI 에이전트의 서비스 연결과 실행 범위를 구분한 생태계 분석 (0) | 2026.10.01 |
| 에이전트 AI - LangChain, Jev : harness의 어느 지점에 둘 것인가 (0) | 2026.09.30 |
| Graph Engineering - AI 에이전트 시스템 구축 방법 (0) | 2026.09.30 |
| 에이전트 AI - TypeSafe AI, Jev :System 1 모델 등장 (0) | 2026.09.30 |