https://weaviate.io/blog/engram-memory-practical-guide
2026.9.22
[Agent Memory with Engram]
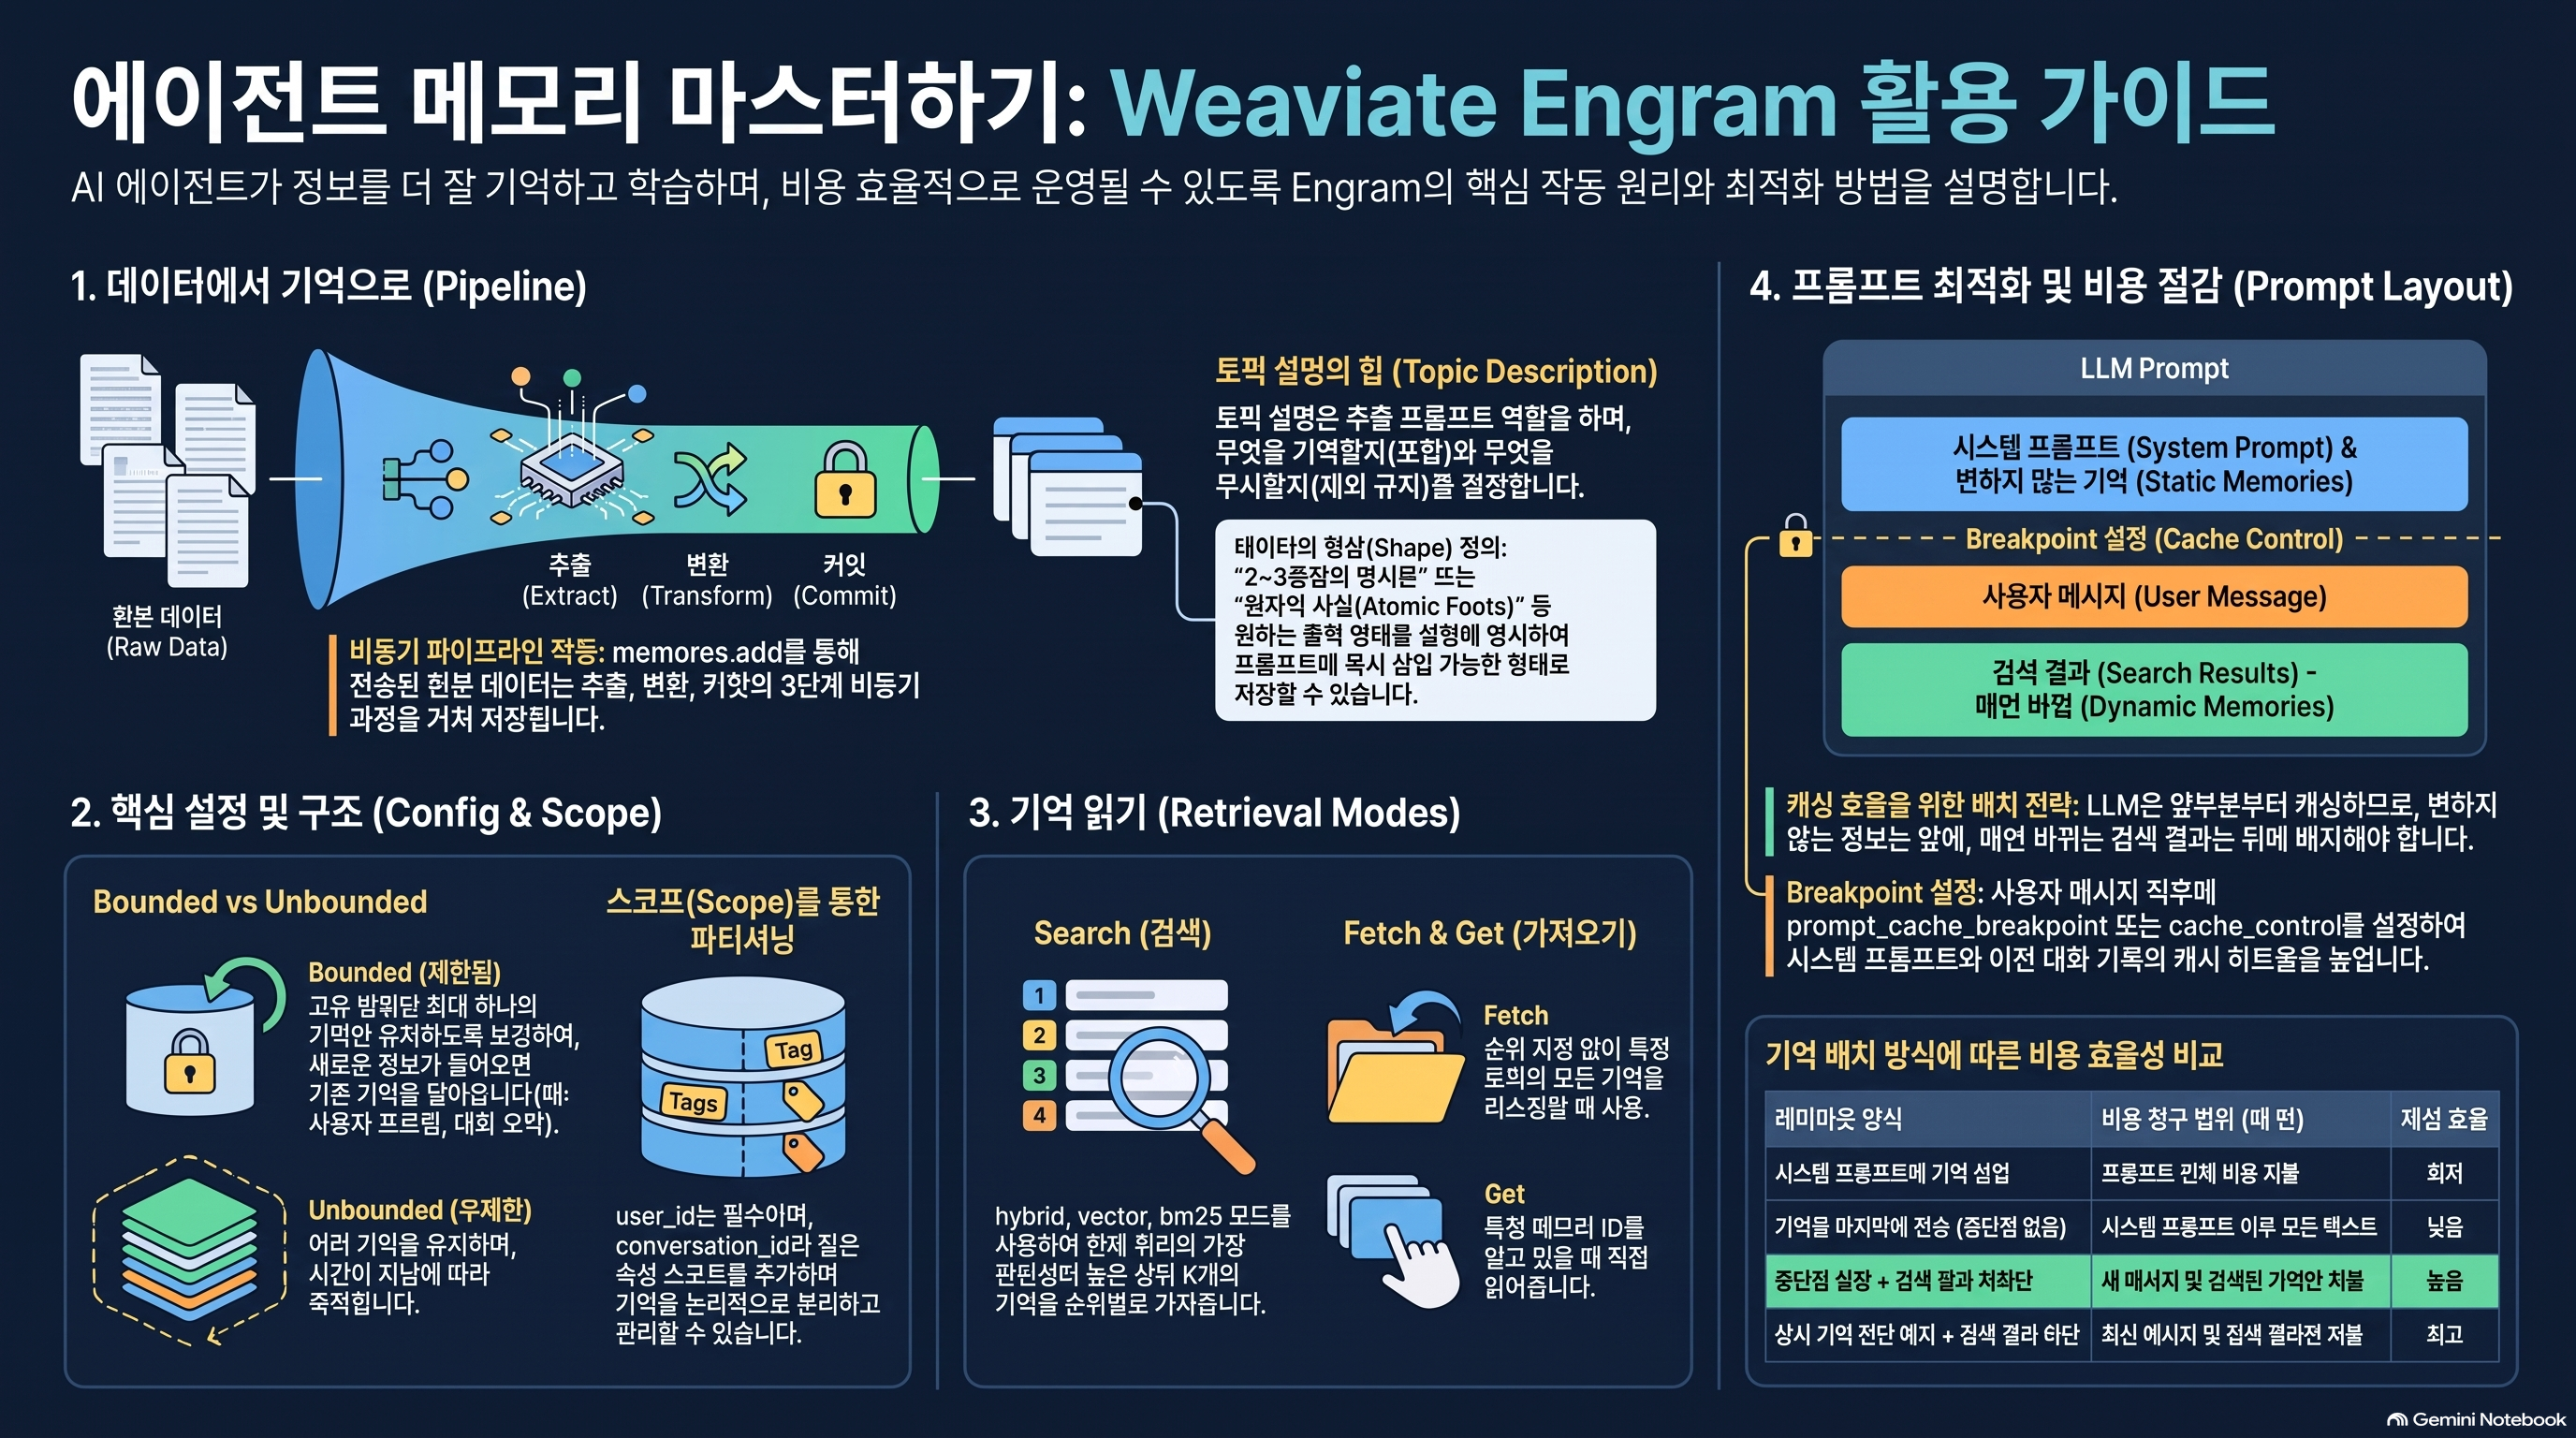
제공된 문서는 Engram이라는 완전 관리형 메모리 및 컨텍스트 서비스를 활용하여 인공지능 에이전트가 시간이 지남에 따라 정보를 기억하고 학습할 수 있도록 설정하고 최적화하는 방법을 다루는 실용적인 가이드입니다. 이 글의 주된 목적은 개발자들이 토픽 설명을 세밀하게 조정하고, 바운디드 및 스코프 설정을 관리하며, 검색 모드를 적절히 활용하여 에이전트의 기억 기능을 효과적으로 제어하는 방법을 안내하는 것입니다. 아울러, LLM의 프롬프트 캐싱 효율성을 극대화하기 위해 항상 활성화된 정보는 프롬프트 앞부분에 배치하고 가변적인 검색 결과는 맨 뒤에 위치시키는 등의 구체적인 프롬프트 배치 전략을 상세히 설명하고 있습니다.
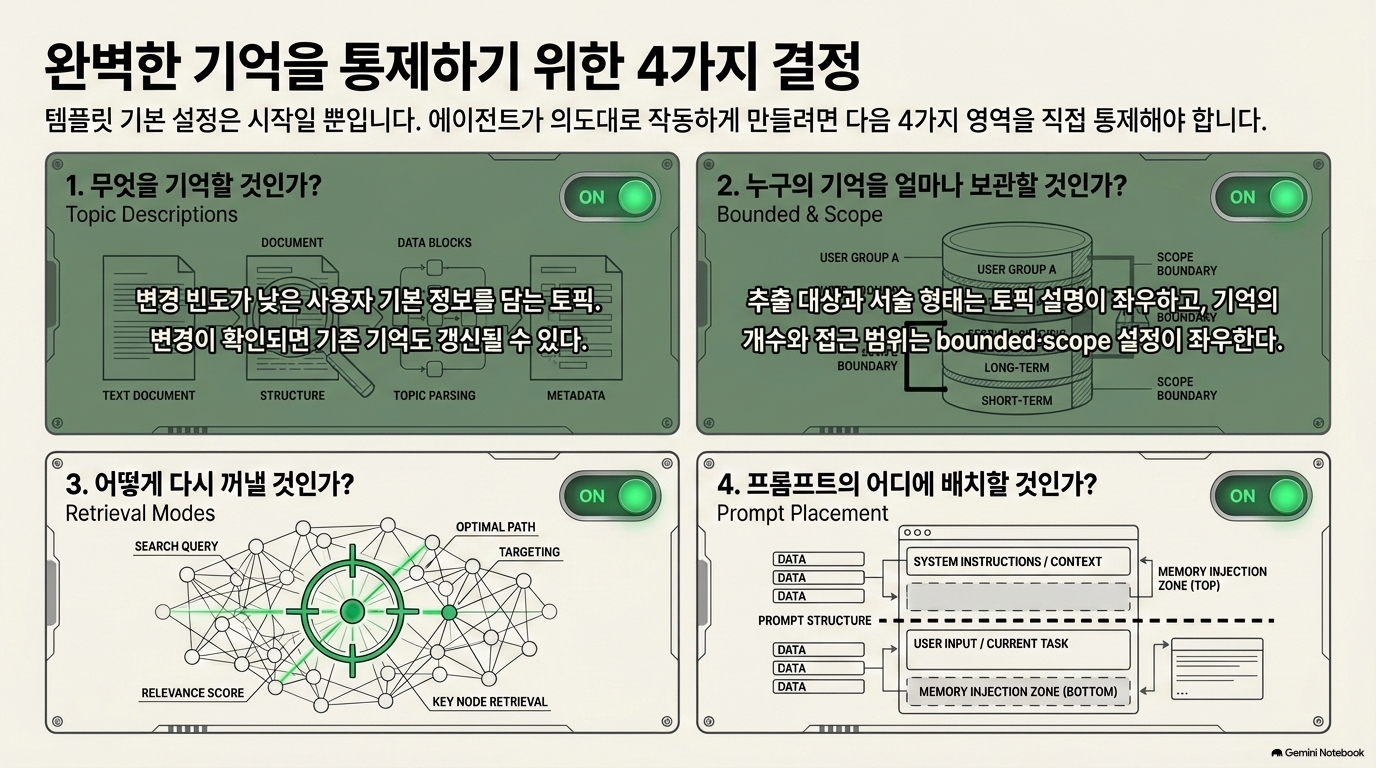
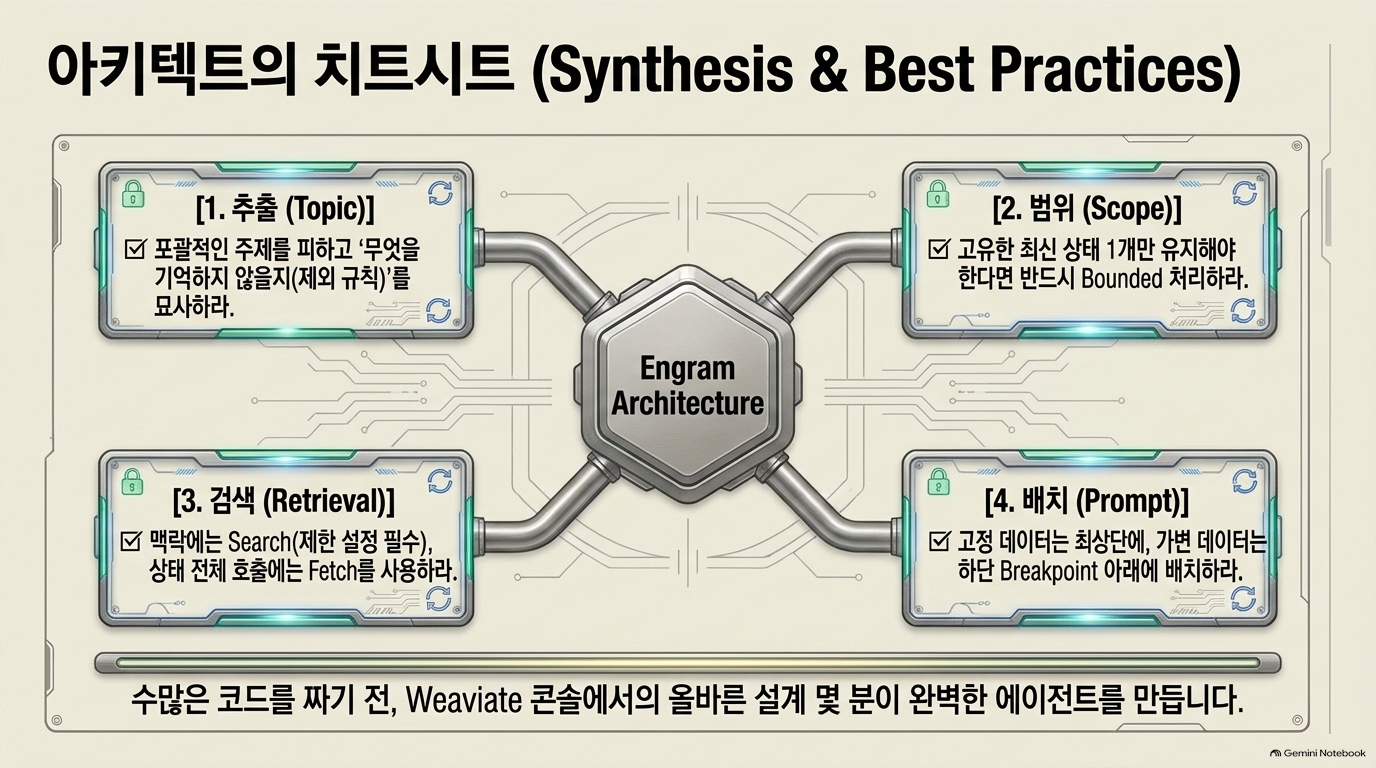
이 글의 요지는 에이전트 메모리의 성능이 저장 기능 자체보다 “무엇을 기억하고, 누구의 기억으로 분리하며, 어떻게 꺼내 프롬프트에 배치하는가”에 달려 있다는 것입니다. Weaviate의 관리형 메모리 서비스 Engram을 사례로 네 가지 설계 결정을 설명합니다.[1]
| 설계 결정 | 원문의 제안 | 실무적 의미 |
| 기억할 내용 | 토픽 설명에 포함 대상뿐 아니라 제외할 내용과 기록 형식을 명시 | 일시적 사건을 장기 사실로 저장하지 않도록 추출 기준을 설계 |
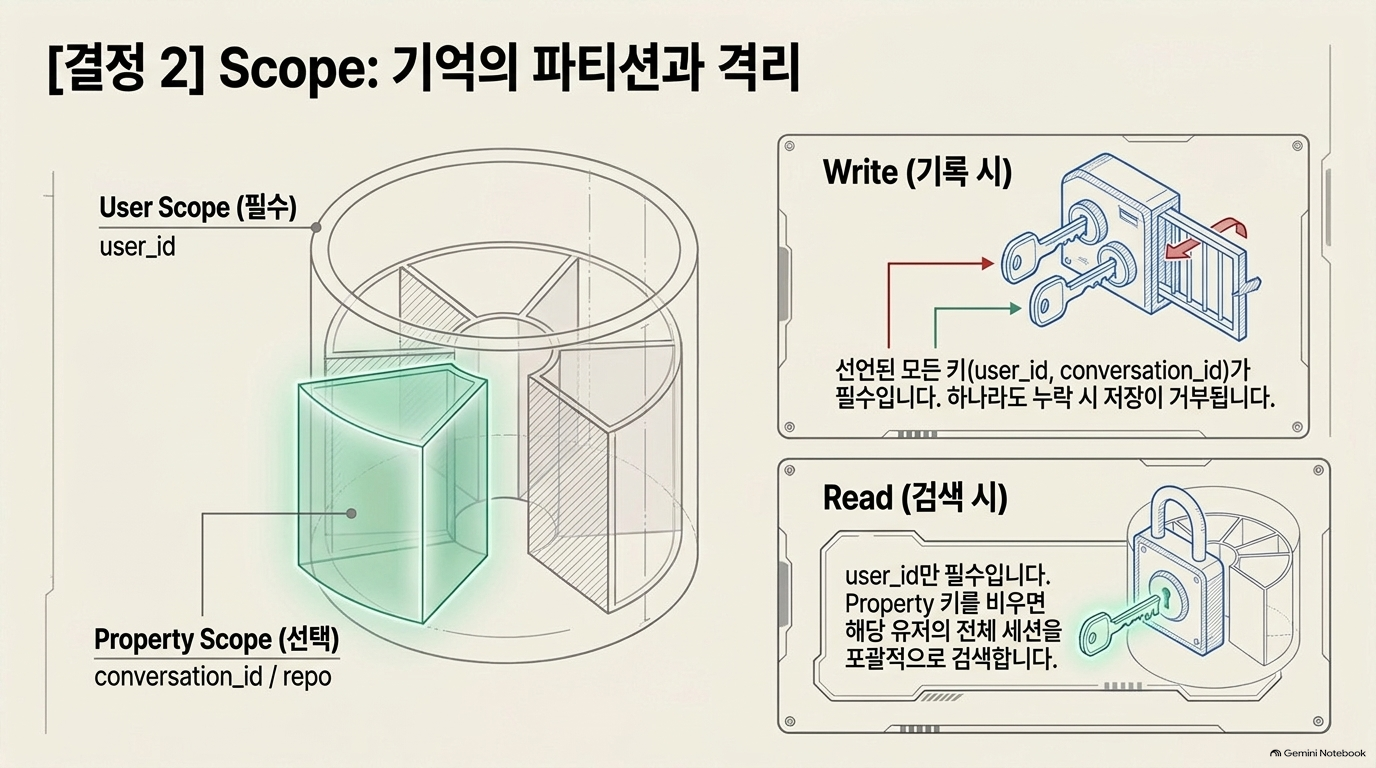
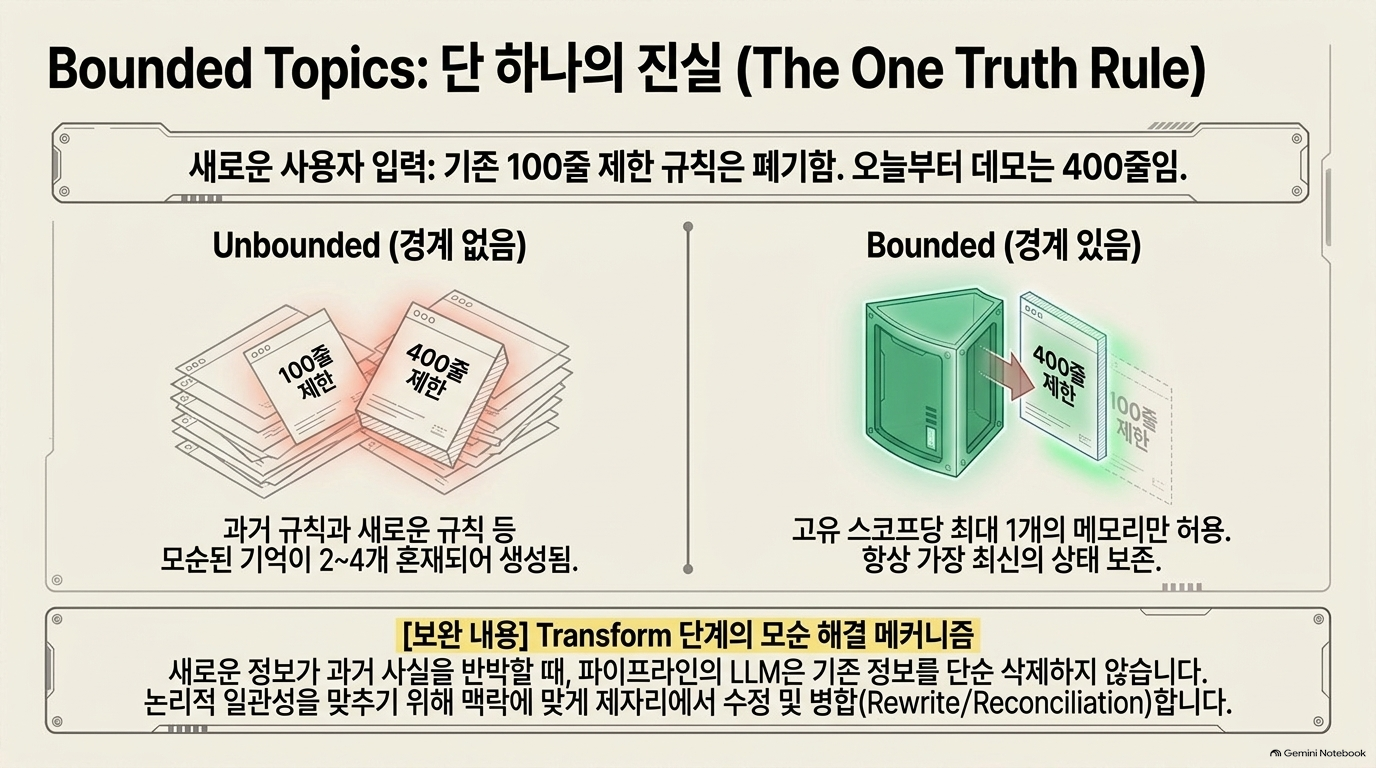
| 기억의 개수·소유자 | 단일 상태값은 bounded, 사용자·대화·저장소별 기억은 scope로 분리 | 중복 생성과 사용자 간 기억 혼입을 구조적으로 방지 |
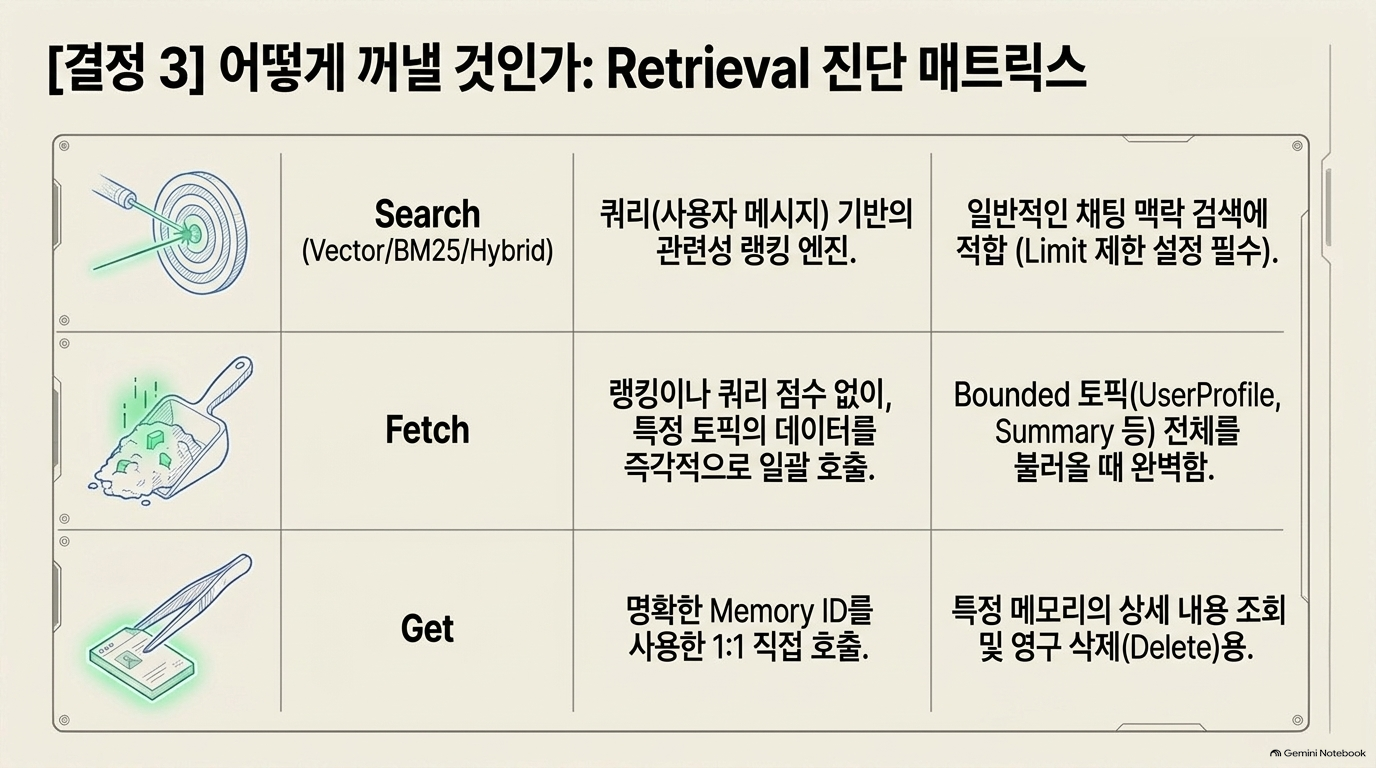
| 조회 방식 | 관련 기억은 search, 토픽 전체는 fetch, ID를 알면 get | 질의별 검색과 항상 필요한 프로필 조회를 구분 |
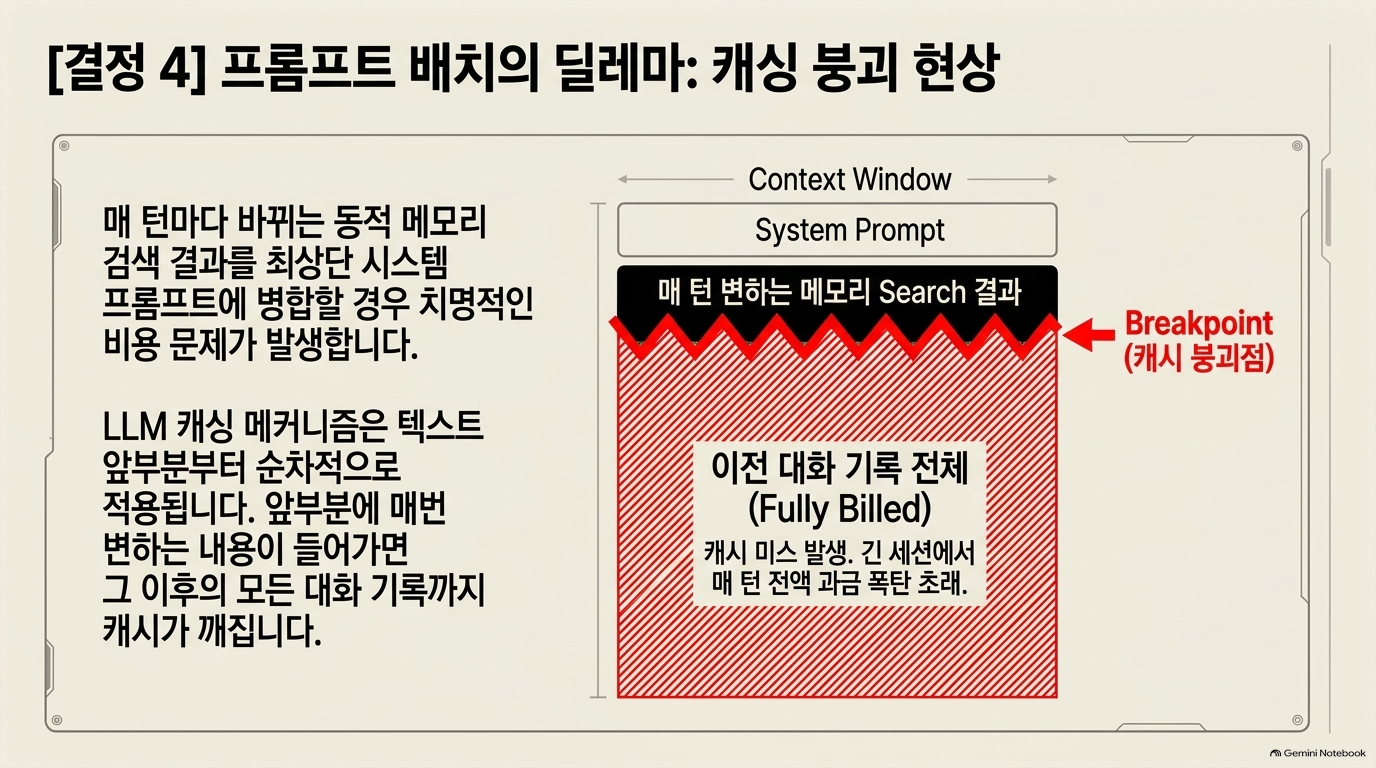
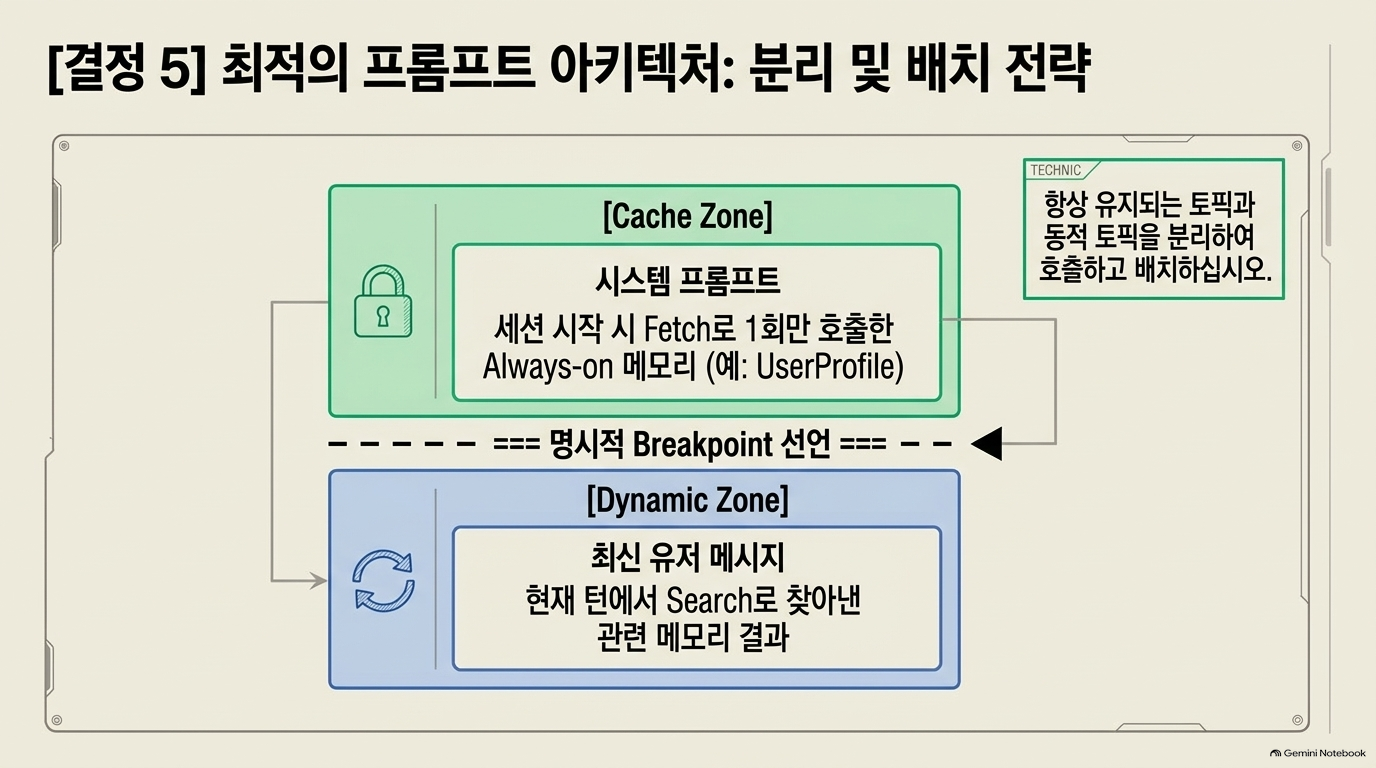
| 프롬프트 배치 | 안정적인 기억은 앞쪽에 고정하고, 매번 바뀌는 검색 결과는 뒤쪽에 배치 | 프롬프트 캐시 적중을 유지하면서 필요한 기억만 주입 |
특히 유용한 부분
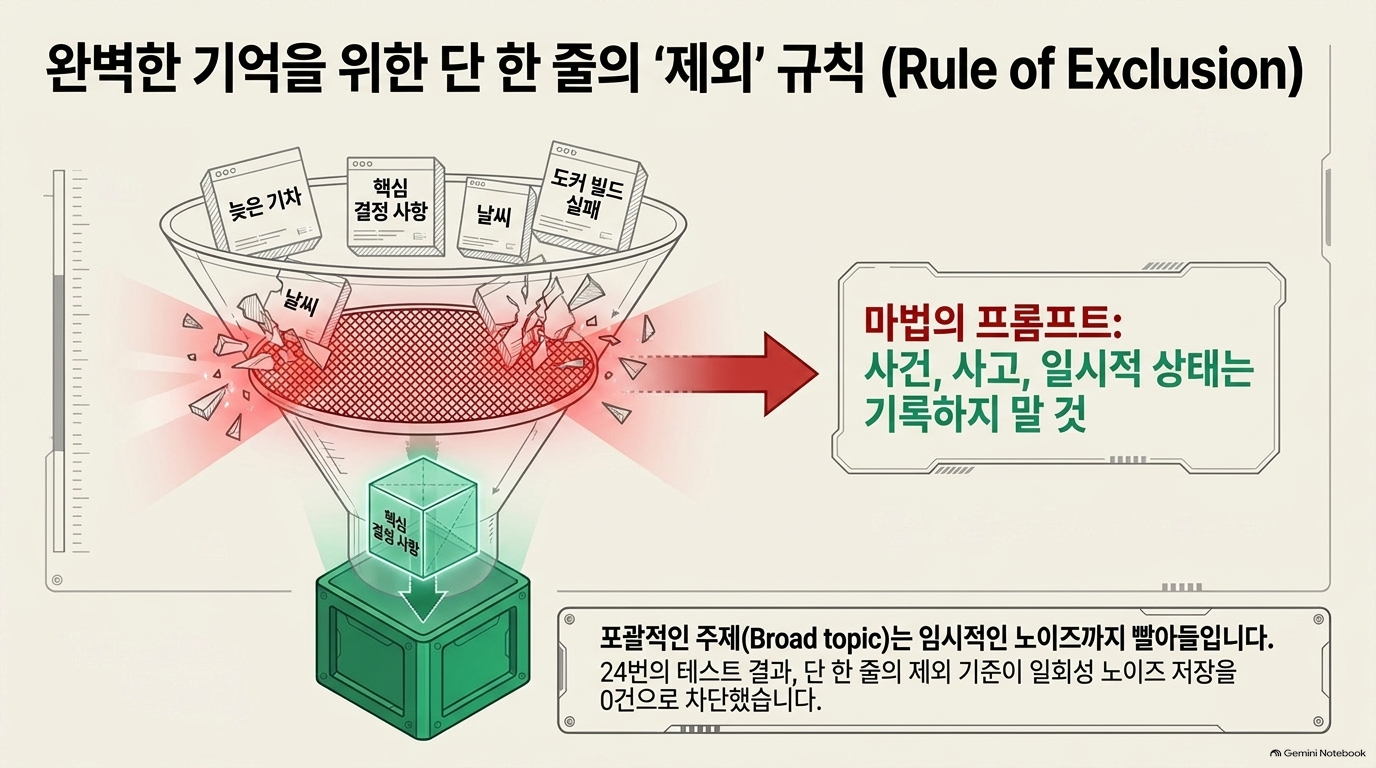
1. 메모리 추출 기준은 ‘포함 목록’보다 ‘제외 규칙’이 중요합니다. 글에서는 날씨·기기 고장 같은 일회성 사건과 지속적인 결정을 섞은 입력을 시험합니다. “사건, 사고, 일시적 상태를 기록하지 말라”는 규칙을 추가한 뒤 수행한 24회 실험에서는 해당 잡음이 새 토픽의 기억으로 생성되지 않았고, 지속적인 결정은 모두 포착됐다고 보고합니다. 다만 이는 저자가 구성한 사례의 결과이지, 일반적인 추출 정확도를 입증하는 벤치마크는 아닙니다.[1]
2. bounded는 ‘잘 요약해 줄 것’이라는 기대가 아니라 개수 보장입니다. 원문에 따르면 동일 범위의 bounded 토픽은 최대 한 개의 기억을 갖습니다. 반면 일반 토픽은 기존 사실을 갱신하더라도 여러 기억으로 분화될 수 있습니다. 따라서 사용자 프로필이나 대화별 누적 요약처럼 항상 하나여야 하는 상태에 적합합니다. 사용자 범위(user_id)와 대화·저장소 같은 속성 범위의 읽기·쓰기 규칙이 다르므로, 격리 요구에 맞춰 선택해야 합니다.[1]
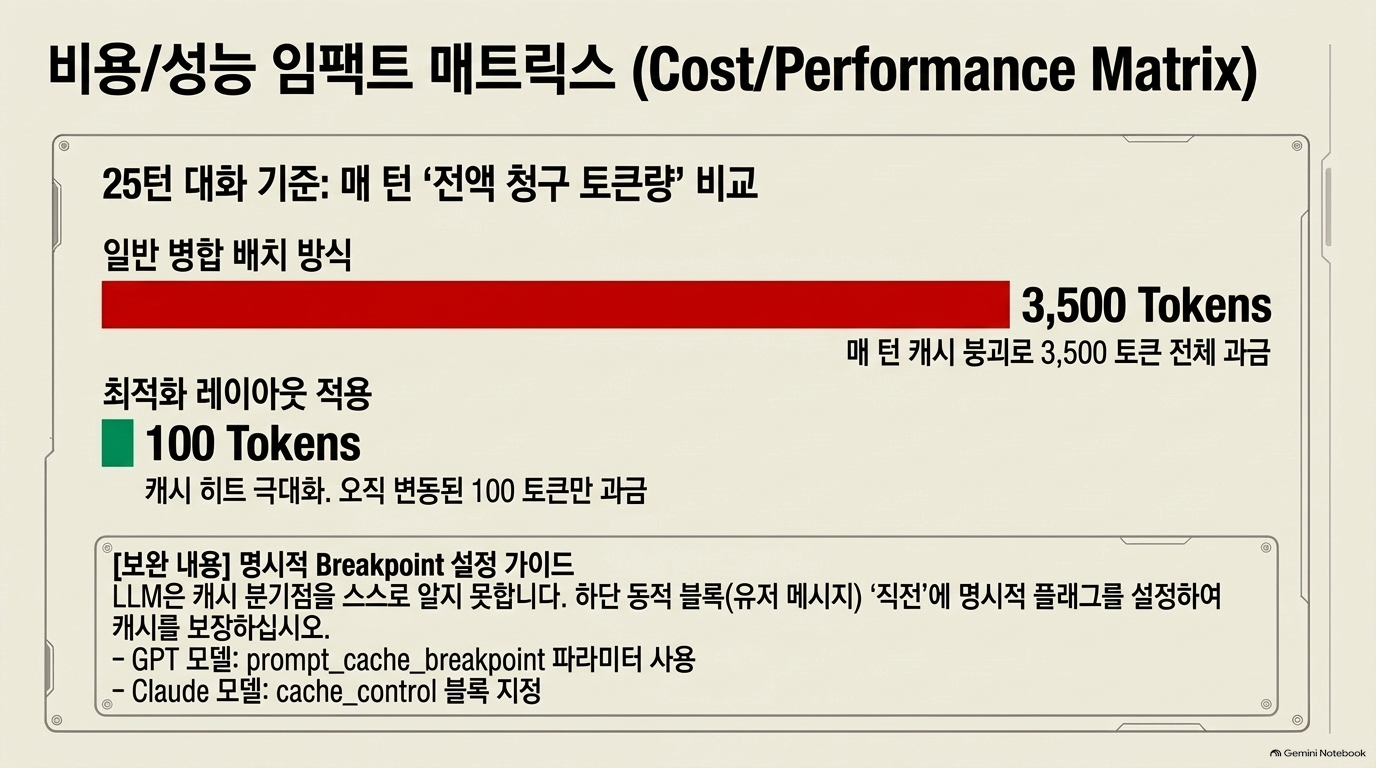
3. 검색 품질과 프롬프트 비용은 별개로 설계해야 합니다. search의 기본 반환 수는 10개라고 소개하지만, 글은 실제로 프롬프트에 필요한 수만큼 limit을 설정하라고 권합니다. 드물게 바뀌는 프로필은 세션 시작 시 fetch하여 고정 영역에 두고, 현재 질문과 관련된 기억만 매 턴 검색하는 구성이 핵심입니다. 저자의 25턴 프롬프트 배치 시험에서는 마지막 요청 약 3,500토큰 중 약 100토큰만 비캐시 처리됐다고 제시합니다. 이는 특정 모델·프롬프트 구성의 관찰값이지 일반적인 비용 절감률은 아닙니다.[1]
비판적 평가
- 강점: 메모리를 단순 벡터 검색 문제가 아니라 추출 정책 → 상태 갱신 → 접근 범위 → 검색 → 프롬프트 캐시의 연속 설계 문제로 다룹니다. 특히 “한 번성 사건은 남기지 않는다”와 “단일 상태는 구조적으로 하나만 유지한다”는 구분이 명확합니다.[1]
- 한계: 제품 제공사의 실무 가이드이며, 제시된 실험은 제한적인 예시입니다. 장기 사용 시 사실 오류율, 오래된 기억의 잔존, 사용자 간 누출, 검색 재현율을 비교 평가한 자료로 읽어서는 안 됩니다. 또한 누적 관찰을 위한 버퍼 단계는 원문 기준 엔터프라이즈 플랜 기능입니다.[1]
- 설계상 주의: 세션 시작 시 고정해 둔 프로필은 다른 세션에서 갱신되어도 현재 세션에는 즉시 반영되지 않습니다. 원문도 이 캐시 효율과 최신성의 교환관계를 인정합니다.[1]
적용 관점의 결론
공공·교육 분야 에이전트라면 이 글을 그대로 제품 도입 근거로 삼기보다, 메모리 정책의 설계 체크리스트로 활용하는 편이 타당합니다. 예컨대 사용자 선호는 지속 사실만 추출하고, 대화 요약은 대화별 단일 상태로 제한하며, 사업·문서별 사실은 프로젝트 범위와 출처·갱신 시점을 함께 관리해야 합니다. 특히 이 글에는 원문 증거로 되돌아가는 출처 추적과 정정·삭제의 운영 통제가 충분히 다뤄지지 않으므로, 감리·컨설팅 근거자료에 적용할 때는 메모리 검색 결과를 원본 문서의 검증 가능한 인용과 구별해야 합니다.
Sources
[1] https://weaviate.io/blog/engram-memory-practical-guide — Agent Memory with Engram: A Practical Guide
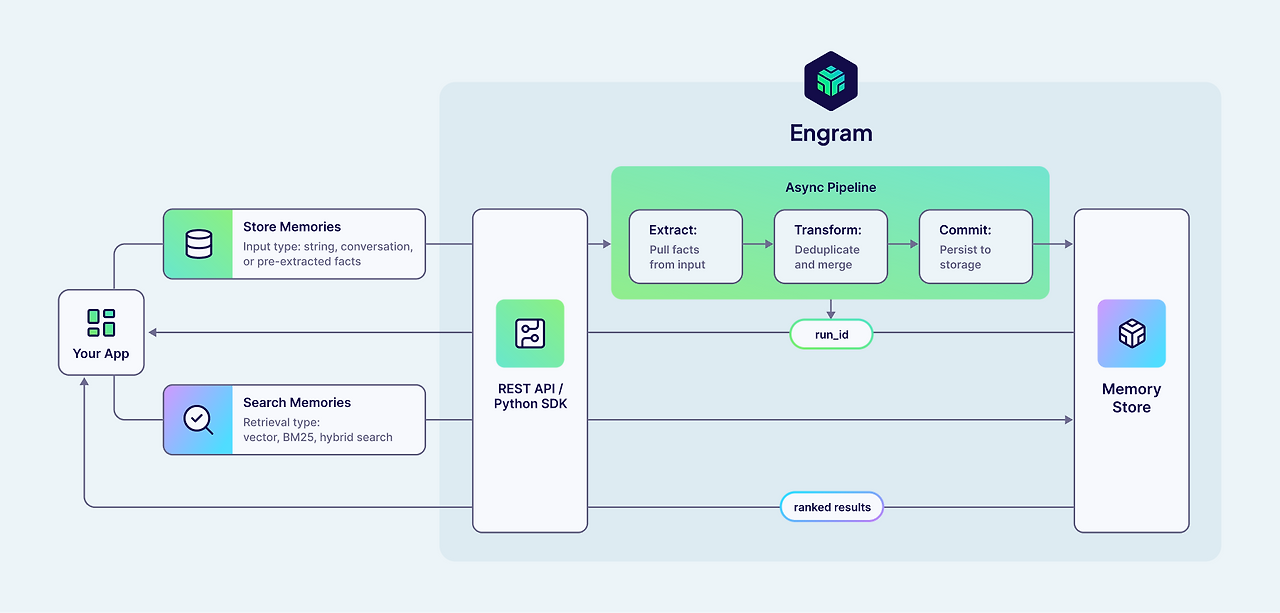
이 그림은 애플리케이션이 Engram에 기억을 저장하고 다시 검색하는 두 경로를 보여줍니다.
저장 경로(위쪽): Your App이 문자열·대화·이미 추출한 사실을 REST API / Python SDK로 전달합니다. Engram은 비동기 파이프라인에서 Extract(사실 추출) → Transform(중복 제거·병합) → Commit(저장) 순서로 처리하고 Memory Store에 기록합니다. 앱에는 저장된 기억 자체가 아니라 처리 작업을 식별하는 run_id가 반환됩니다. 따라서 호출 직후 검색 가능하다고 가정하면 안 됩니다.
검색 경로(아래쪽): 앱이 같은 API/SDK로 기억을 검색하면 Memory Store에서 벡터·BM25·하이브리드 검색을 수행하고, 관련도순 결과(ranked results)를 앱에 돌려줍니다.
즉, 저장은 비동기 처리, 검색은 저장소 조회라는 분리가 이 그림의 핵심입니다. 앞서 본 글의 fetch·get 조회 방식은 이 도식에는 표시되지 않았습니다.
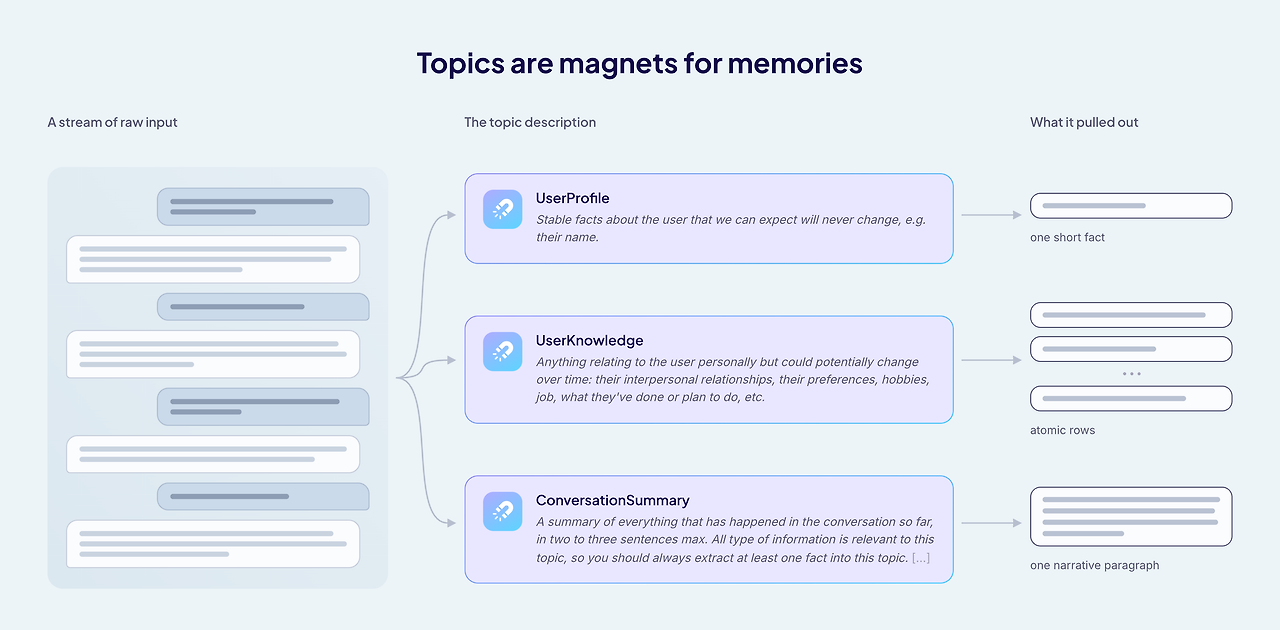
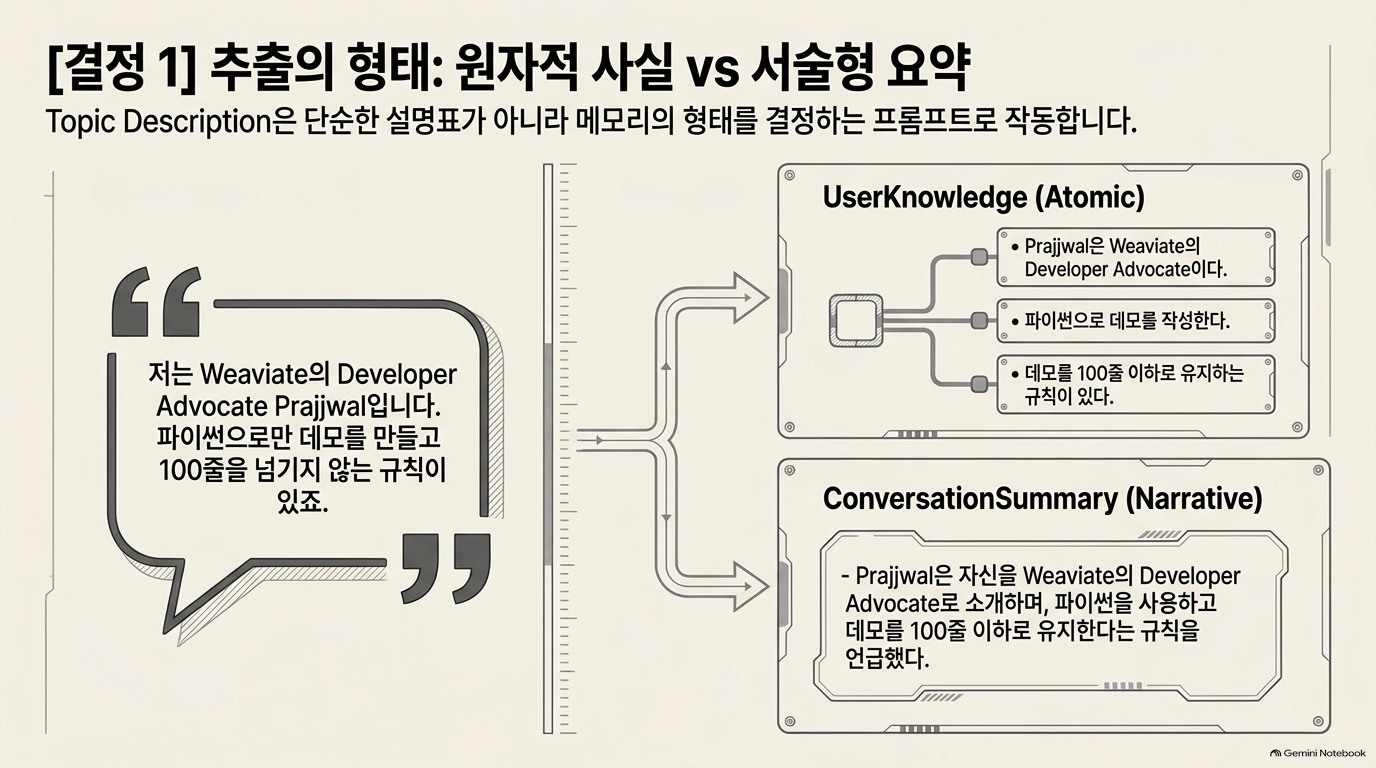
이 그림의 제목은 “Topics are magnets for memories” — 토픽은 기억을 끌어당기는 자석입니다. 왼쪽의 동일한 원시 대화 입력이 가운데의 토픽 설명(description)에 따라 서로 다른 형태의 기억으로 추출되는 모습을 보여줍니다.
| 토픽 | 무엇을 추출하도록 설명하는가 | 오른쪽의 결과 형태 |
| UserProfile | 이름처럼 변하지 않을 것으로 기대하는 사용자 정보 | 짧은 사실 하나 |
| UserKnowledge | 선호·취미·직업·계획 등 시간이 지나며 바뀔 수 있는 개인 정보 | 개별적으로 검색 가능한 원자적 사실 여러 개 |
| ConversationSummary | 지금까지 대화에서 일어난 일을 2~3문장 이내로 요약 | 서술형 요약 문단 하나 |
핵심은 토픽명이 아니라 설명 문구가 추출 기준과 기록 형식을 좌우한다는 점입니다. 같은 발화라도 “이름”은 프로필의 짧은 사실로, “선호와 계획”은 분리된 사실들로, 대화의 맥락은 요약문으로 저장될 수 있습니다. 그림의 오른쪽 상자는 실제 기억 내용이 아니라 결과의 형태를 나타낸 도식입니다.
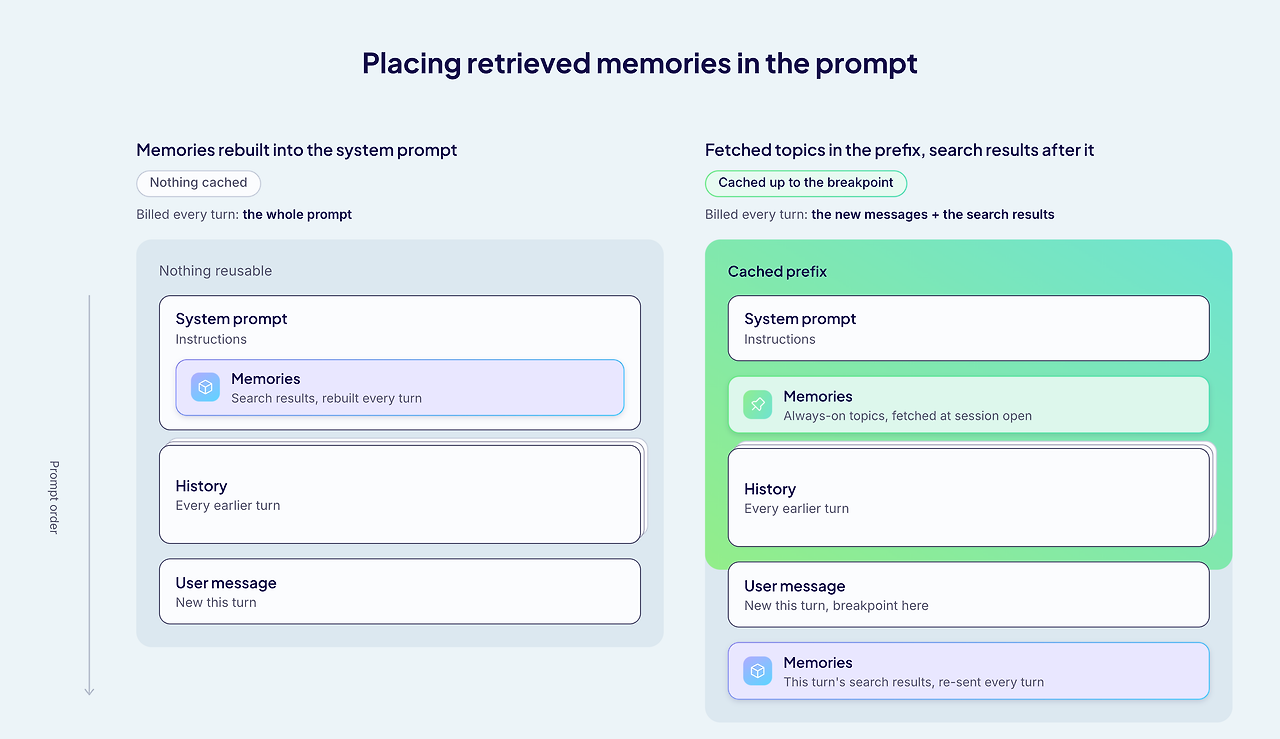
이 그림은 검색된 기억을 프롬프트의 어디에 놓느냐에 따라 캐시 재사용이 달라진다는 점을 좌우로 비교합니다. 위에서 아래로 갈수록 프롬프트의 뒤쪽입니다.
| 왼쪽: 매번 시스템 프롬프트에 삽입 | 오른쪽: 고정 기억과 검색 결과 분리 | |
| 배치 | 시스템 지시문 안에 매 턴 달라지는 검색 결과를 넣고, 그 뒤에 대화 기록·새 사용자 메시지를 배치 | 시스템 지시문 → 세션 시작 시 가져온 상시 기억 → 대화 기록 → 새 사용자 메시지 (캐시 경계) → 이번 턴의 검색 결과 |
| 캐시 | 앞부분의 기억이 바뀌면 그 뒤의 대화 기록까지 동일한 접두부로 재사용하기 어렵다 | 변경이 적은 앞부분을 캐시하고, 변하는 검색 결과만 경계 뒤에 둔다 |
| 그림의 비용 표현 | “매 턴 전체 프롬프트가 일반 입력으로 과금” | “매 턴 새 메시지와 검색 결과가 일반 입력으로 과금” |
핵심은 늘 필요한 사용자 프로필 등은 세션 시작 시 한 번 가져와 앞에 고정하고, 질의에 따라 바뀌는 검색 결과는 사용자 메시지 뒤에 둔다는 것입니다. 다만 오른쪽도 캐시된 토큰이 무료라는 뜻은 아닙니다. 그림은 캐시된 접두부와 매 턴 새로 처리되는 부분의 차이를 단순화해 보여줍니다.

'07.AI > 5. AI 자율성' 카테고리의 다른 글
| Graph Engineering - AI 에이전트 시스템 구축 방법 (0) | 2026.09.30 |
|---|---|
| 에이전트 AI - TypeSafe AI, Jev :System 1 모델 등장 (0) | 2026.09.30 |
| 에이전트 AI - Microsoft Research, Agensh: 1,024개 에이전트 확장 시스템 (0) | 2026.09.30 |
| 에이전트 AI - 개인 에이전트의 경제적 오정렬(Misalignment) (0) | 2026.09.26 |
| 에이전트 AI - 디지털 집사(Digital Butler)는 누구의 편에서 일하는가? (0) | 2026.09.26 |