반응형
https://arxiv.org/pdf/2608.27448
2026.8.27
[TTPO: Test-Time Policy Optimization]
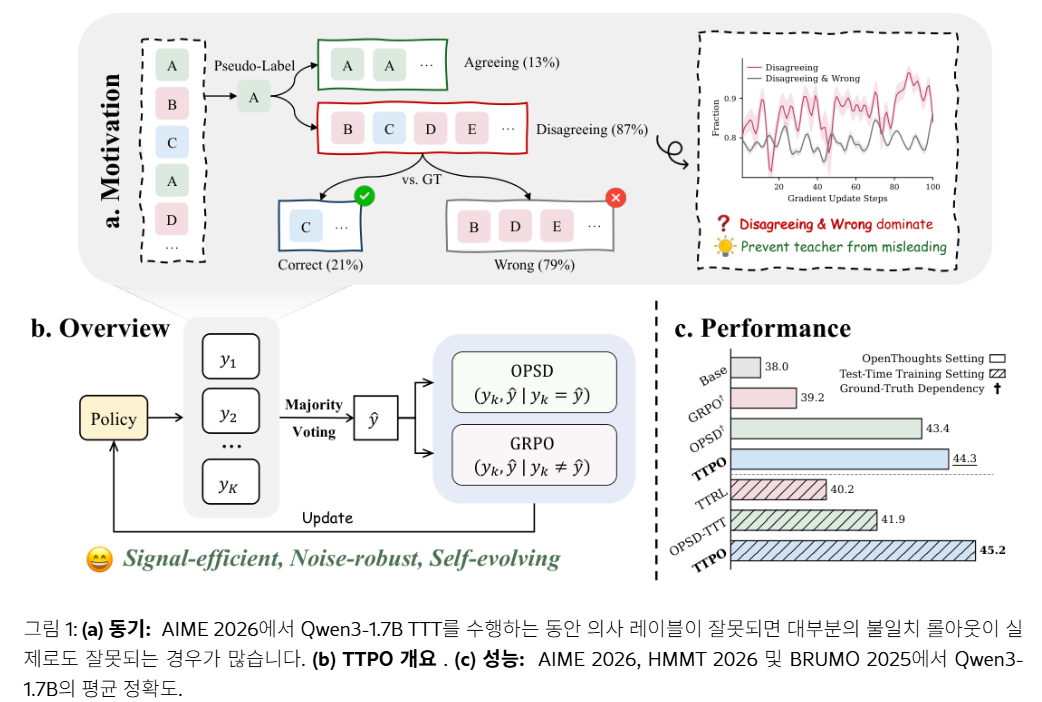
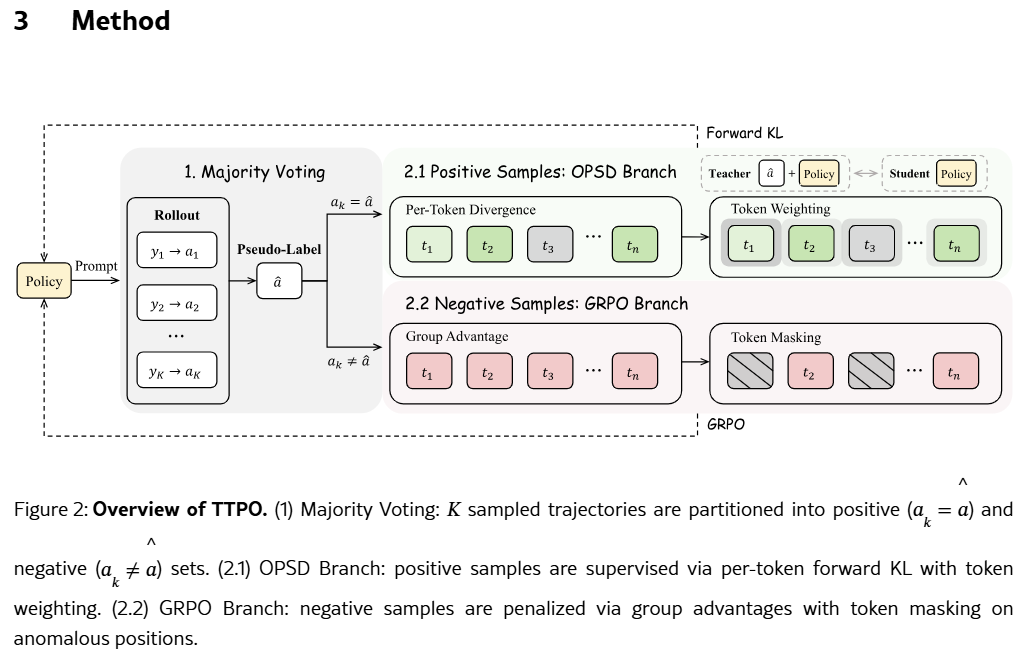
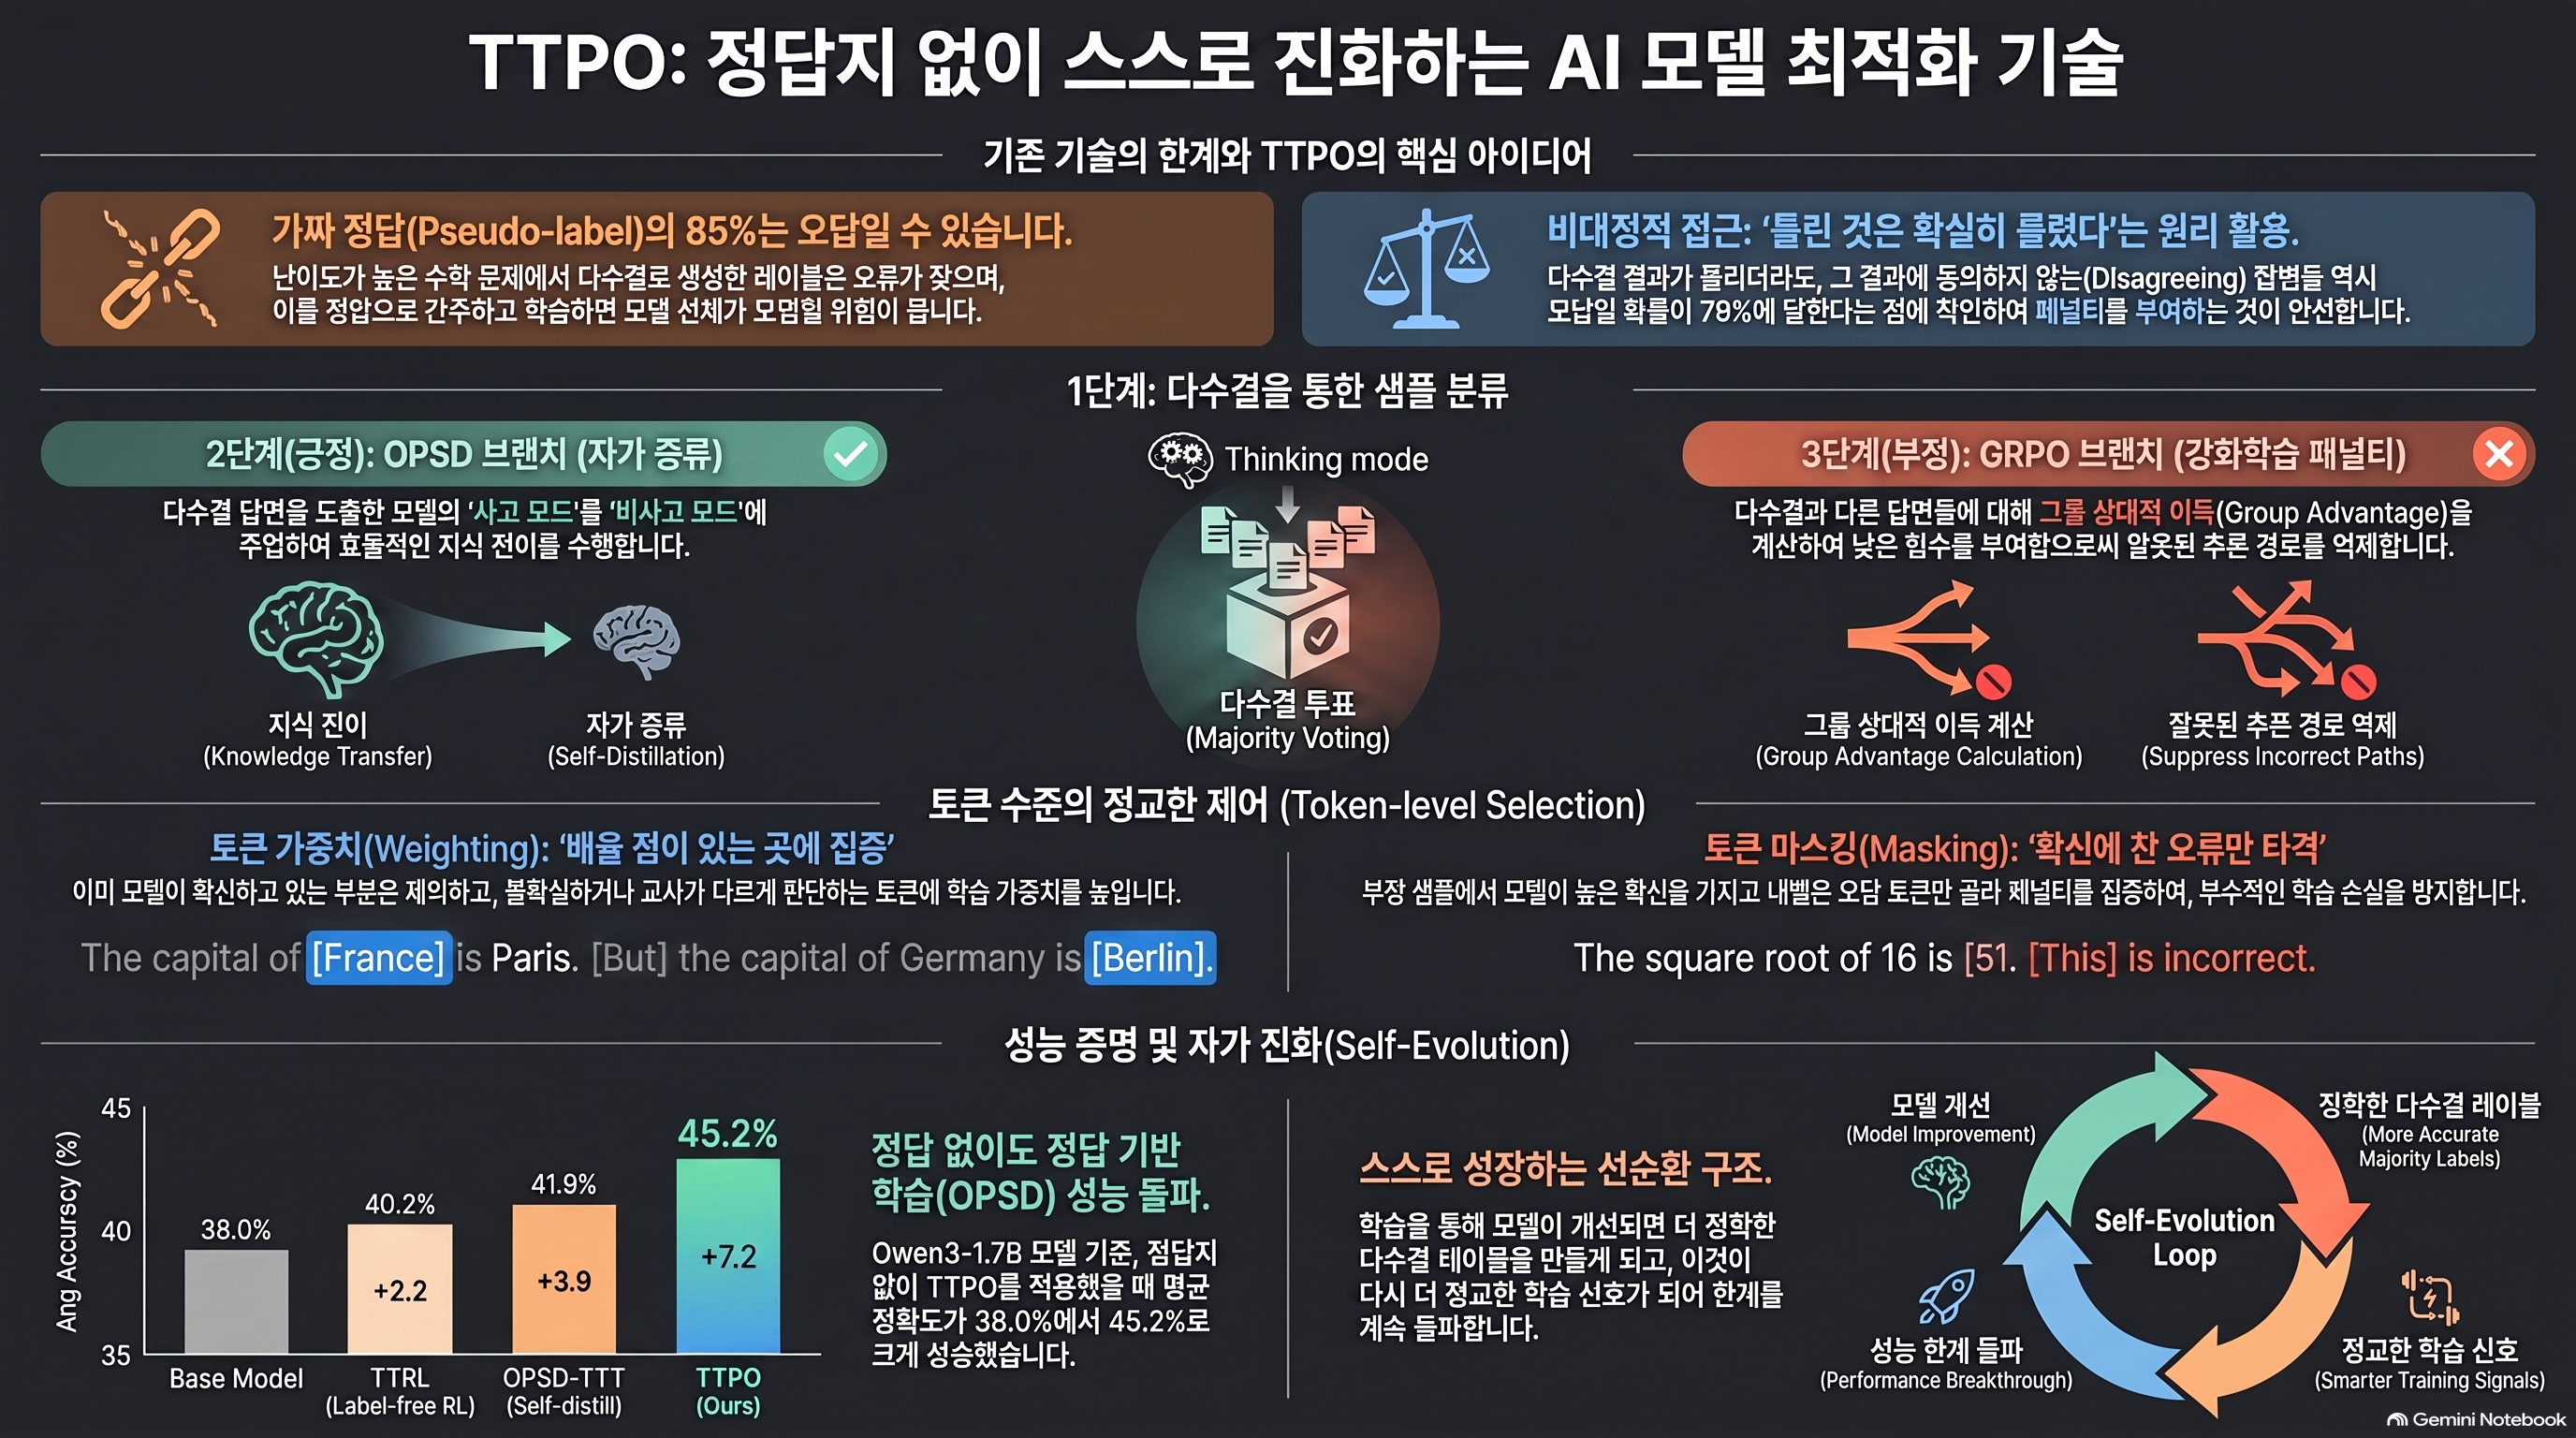
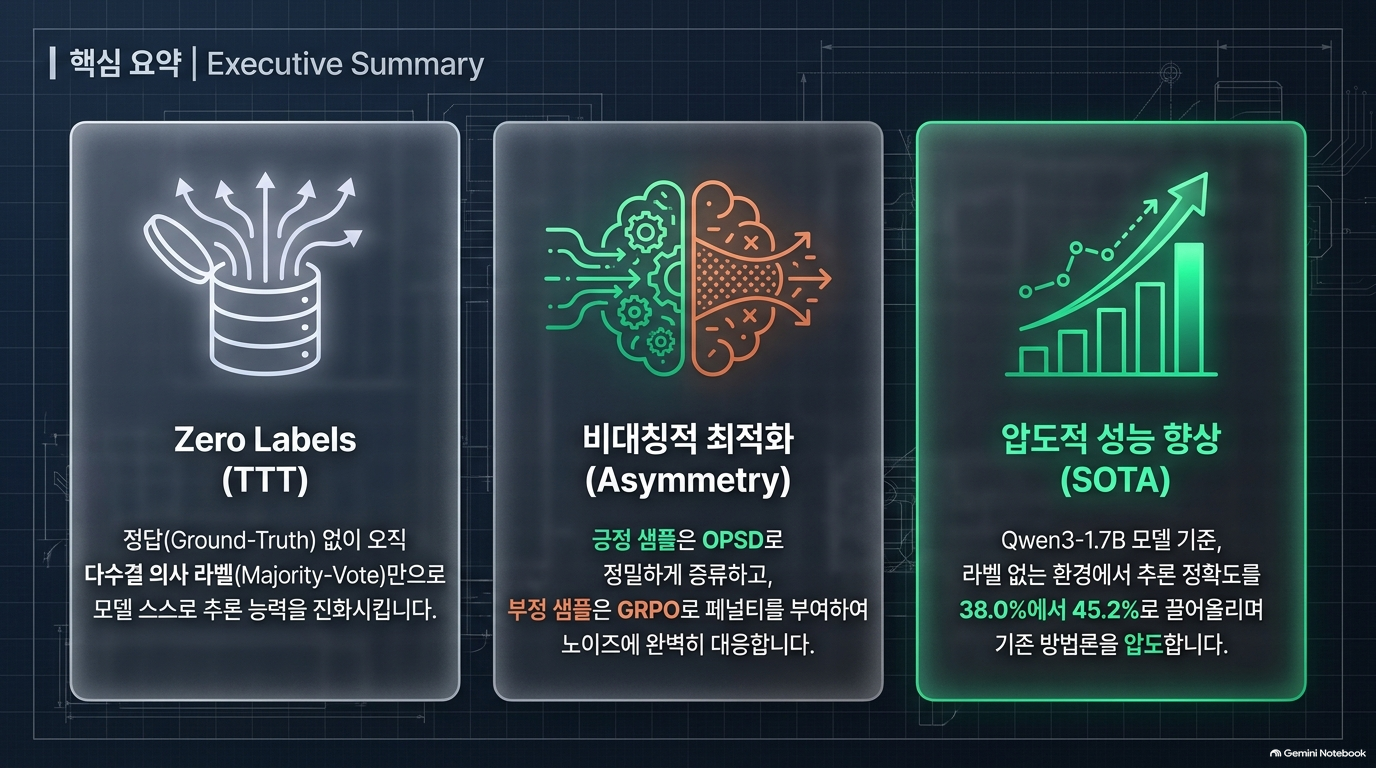
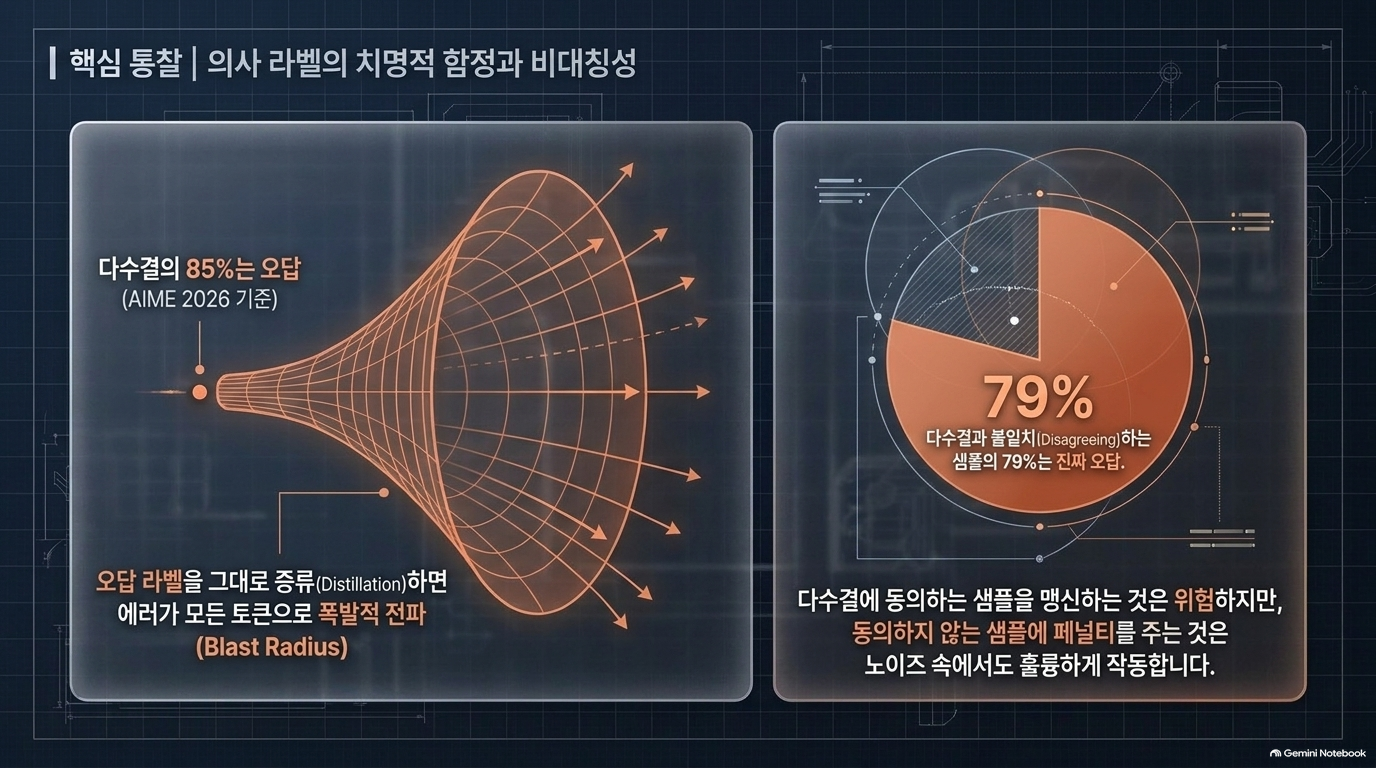
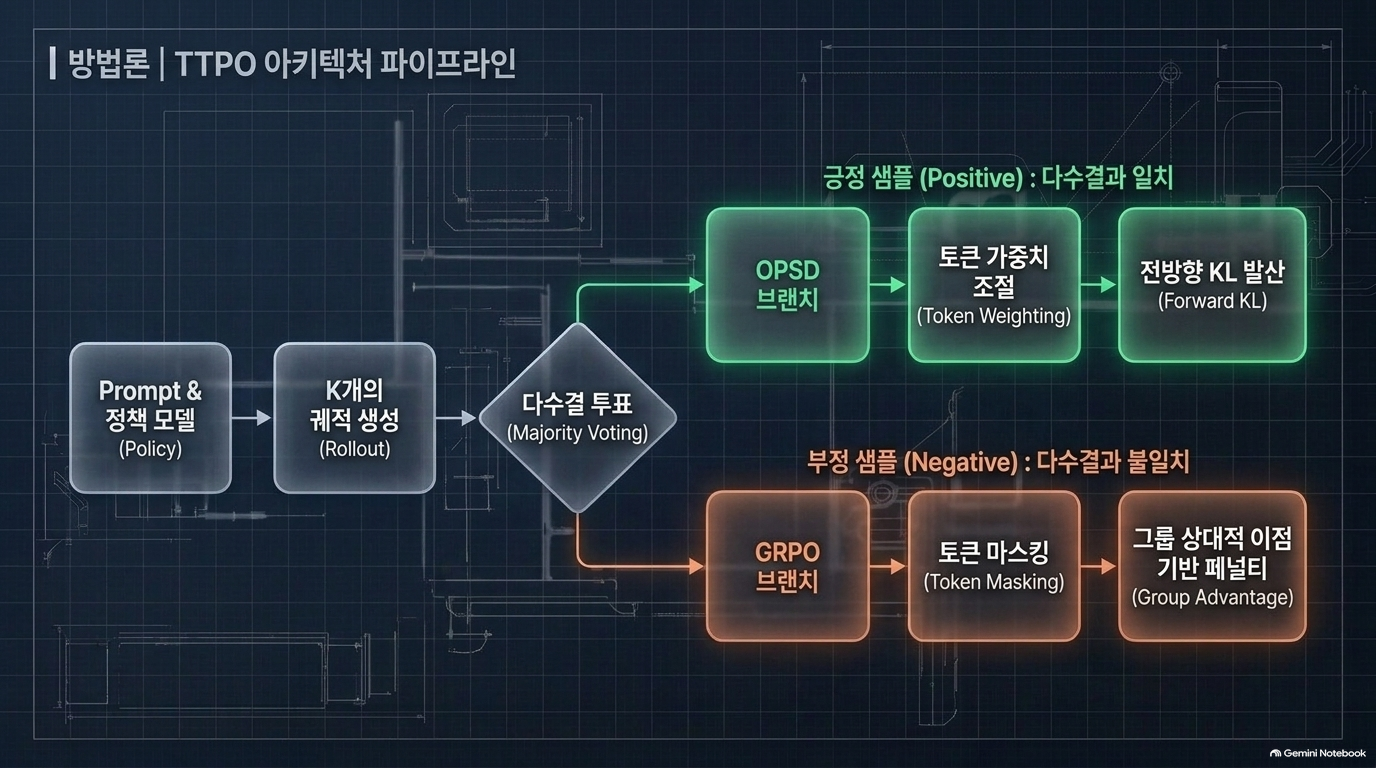
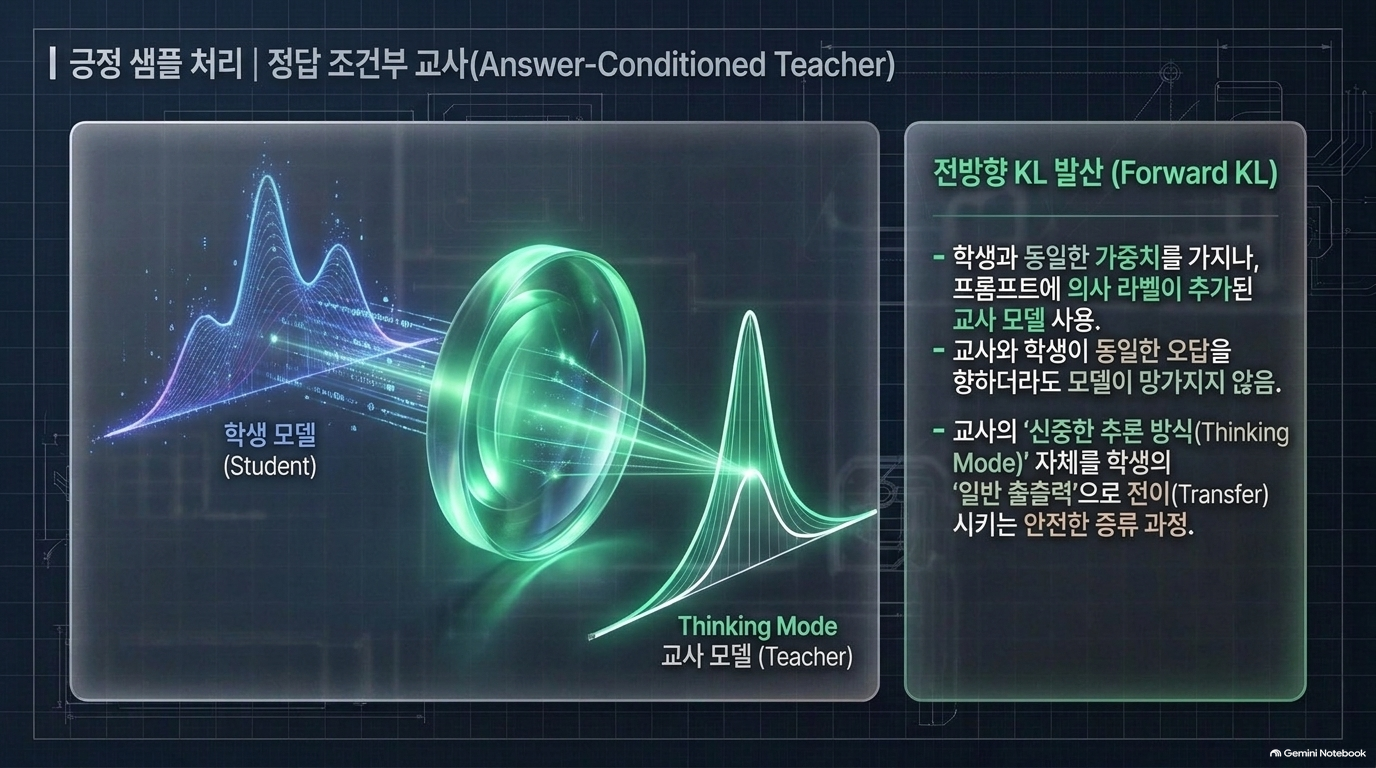
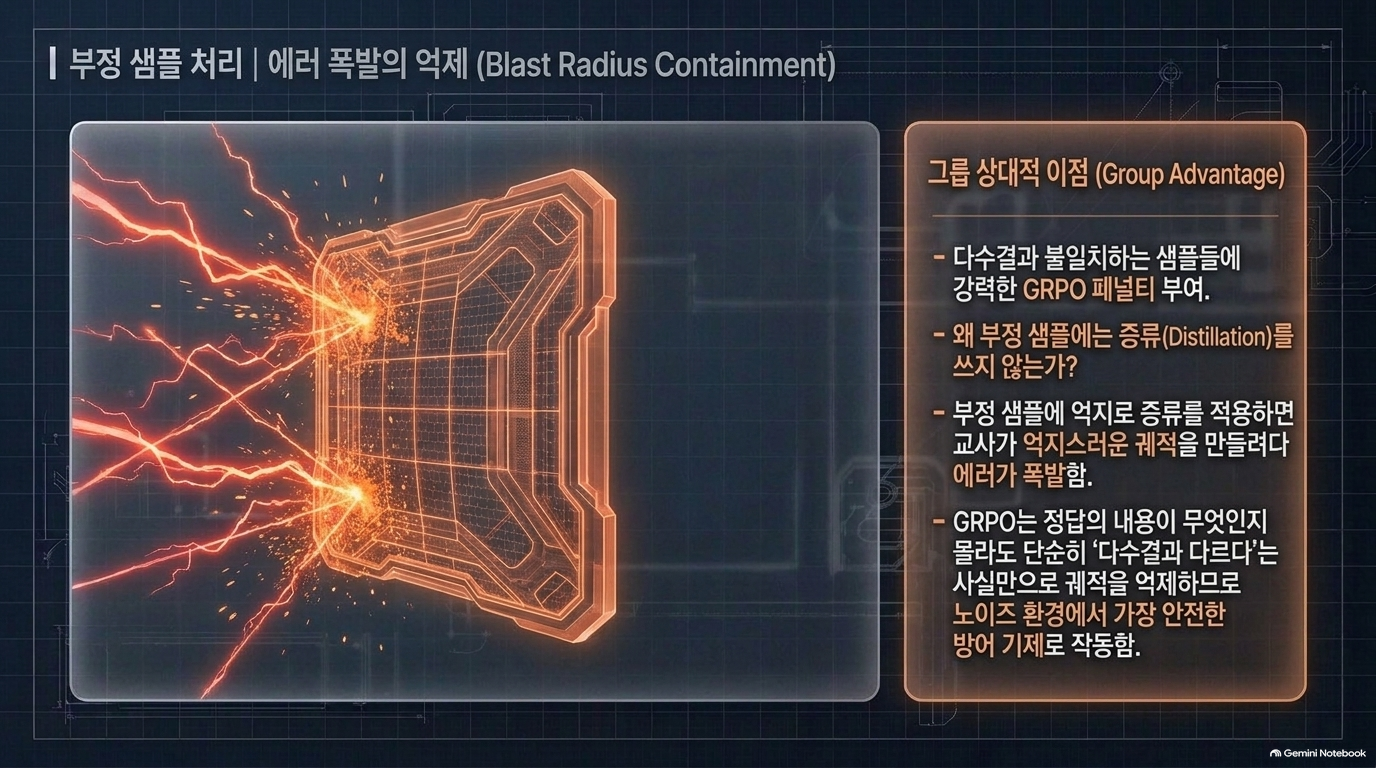
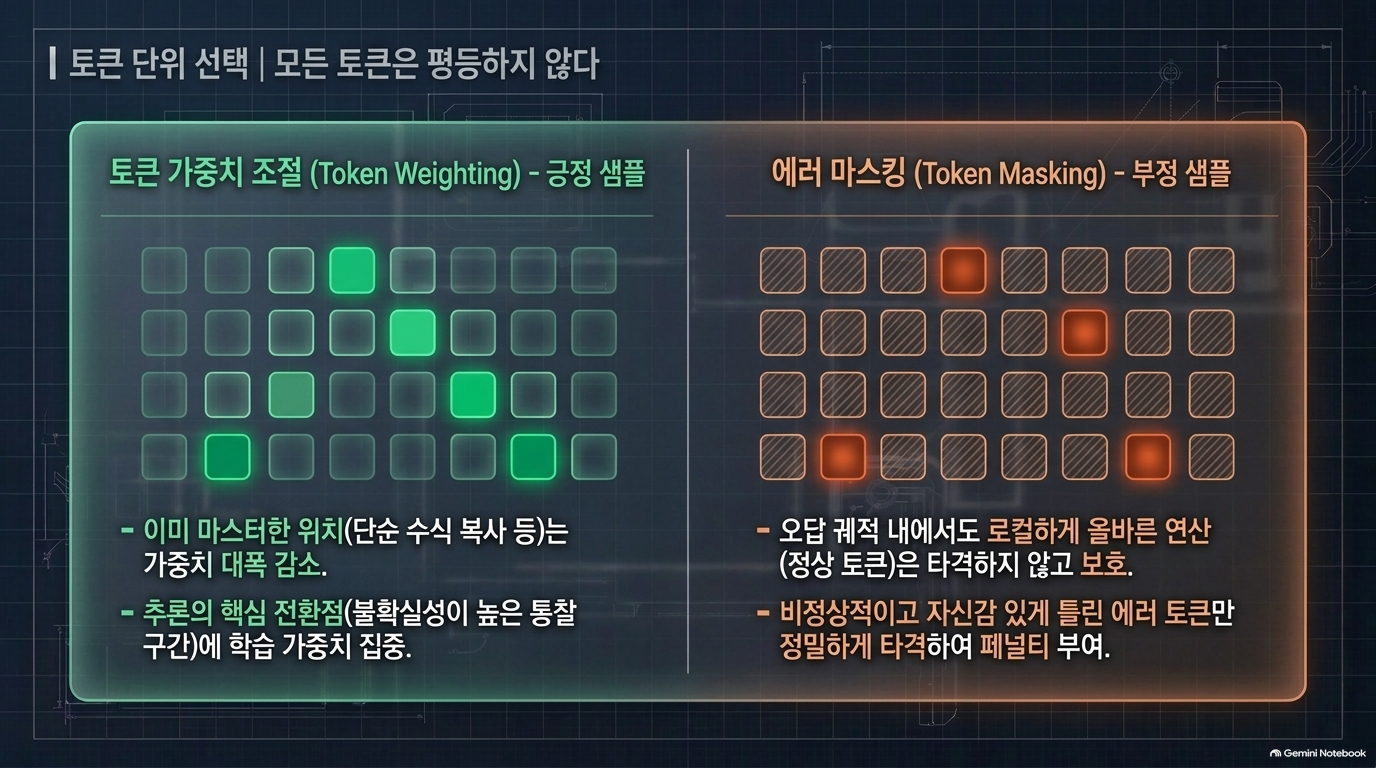
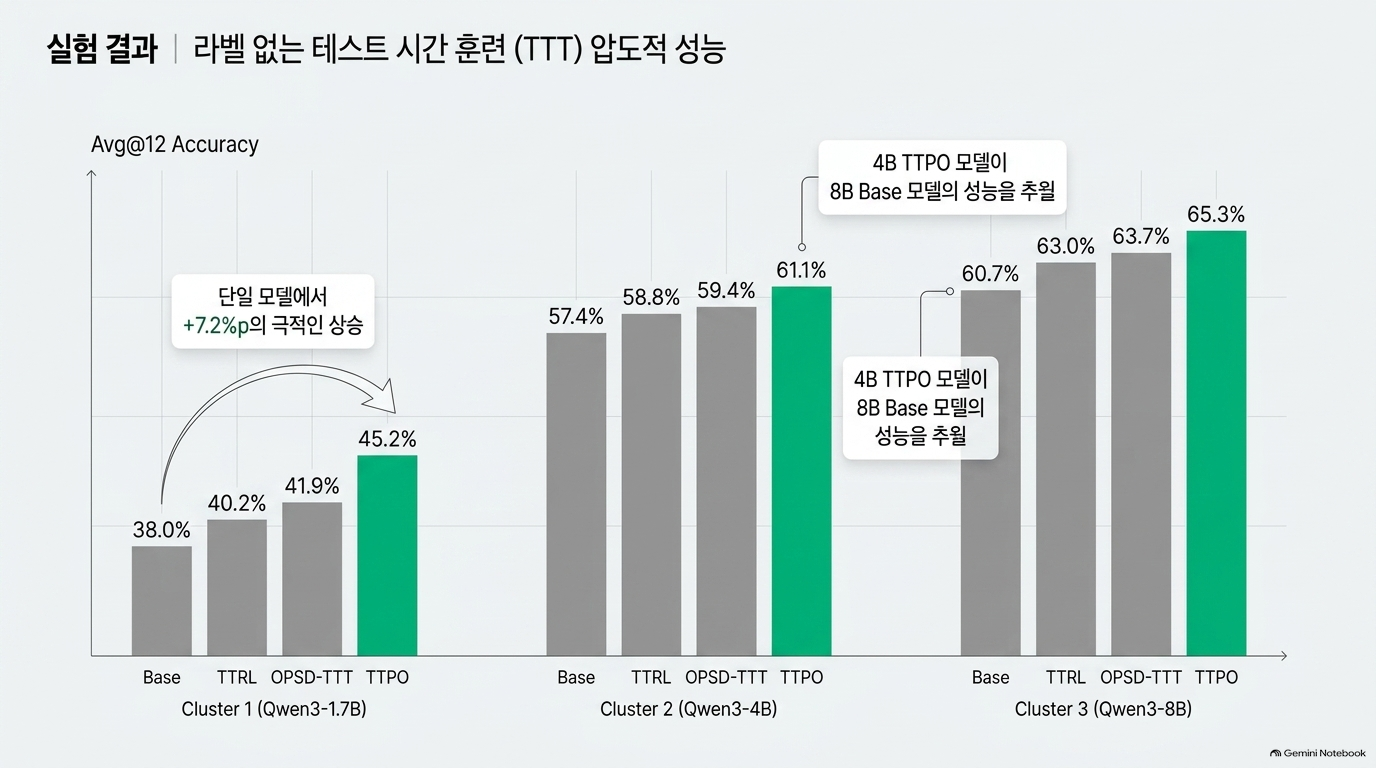
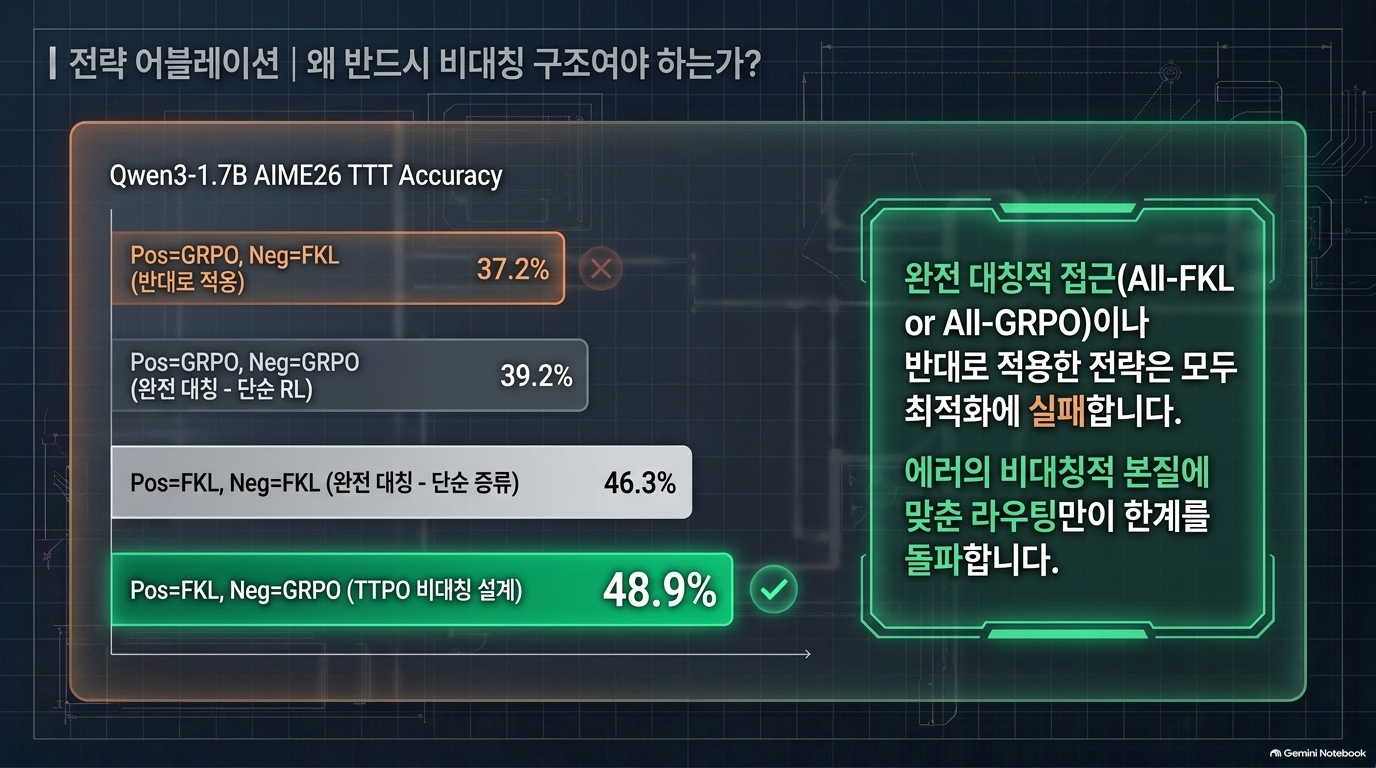
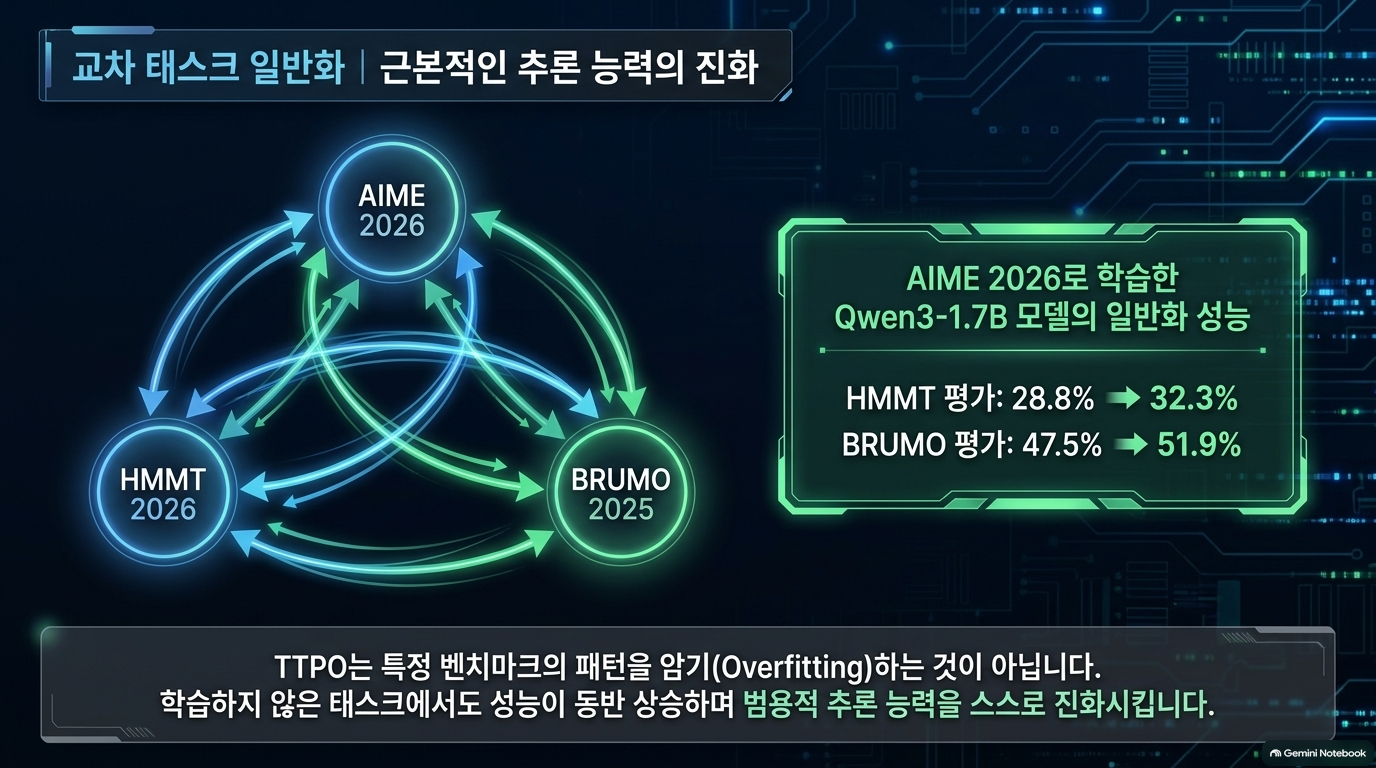
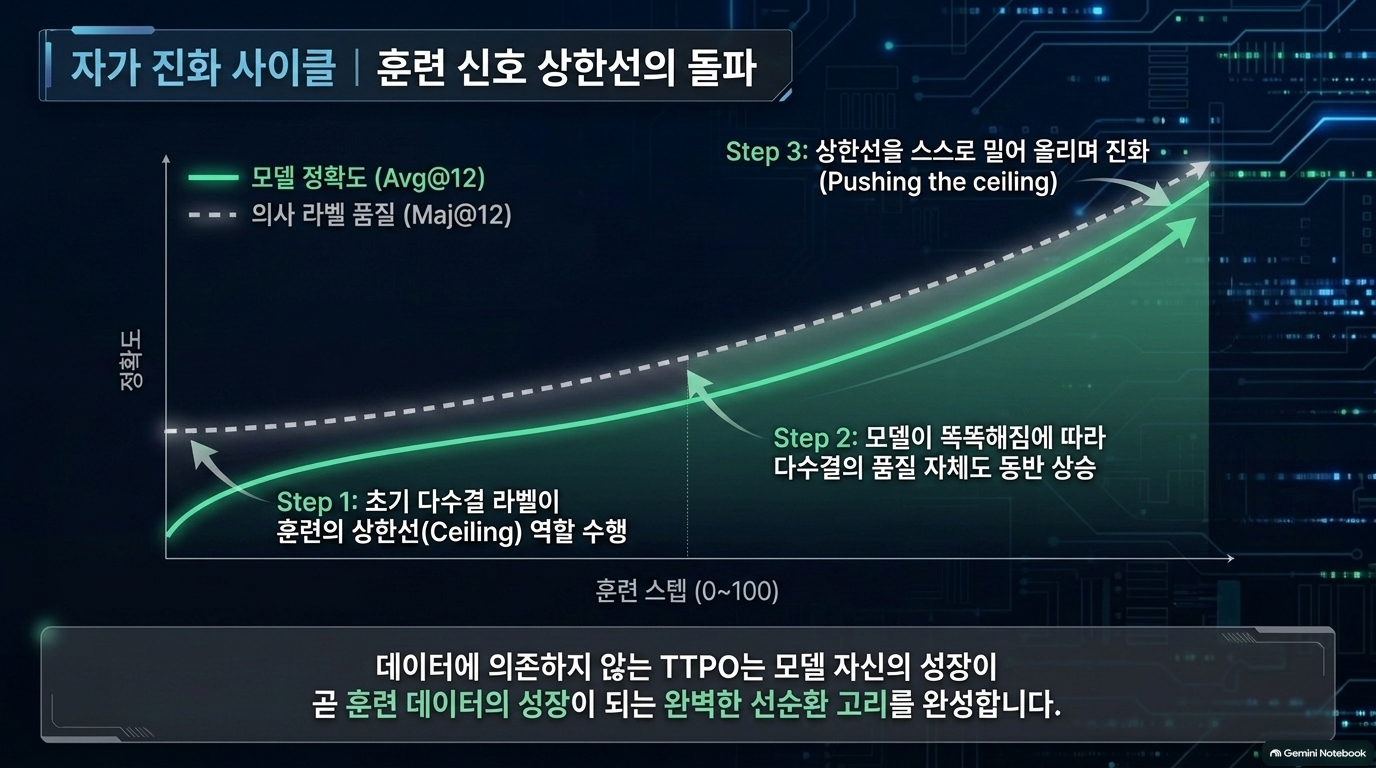
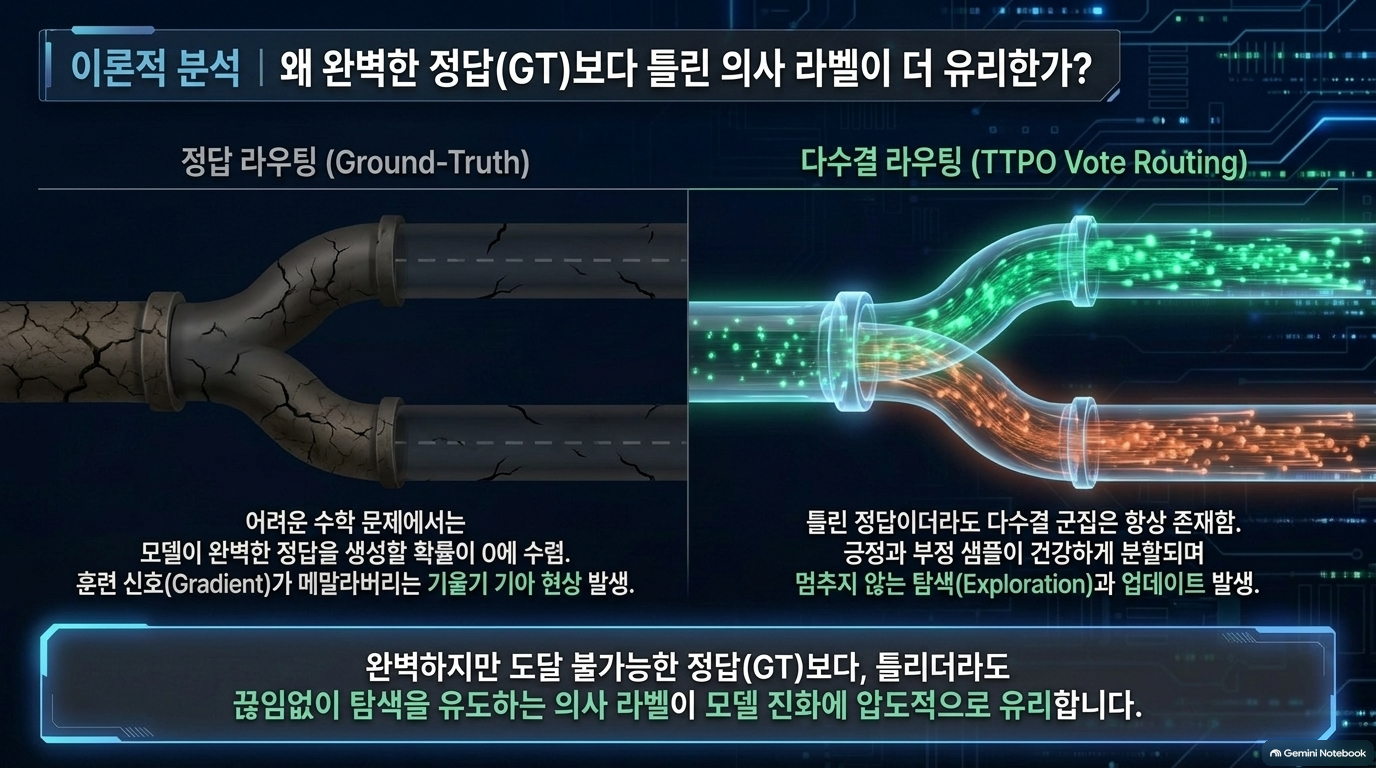
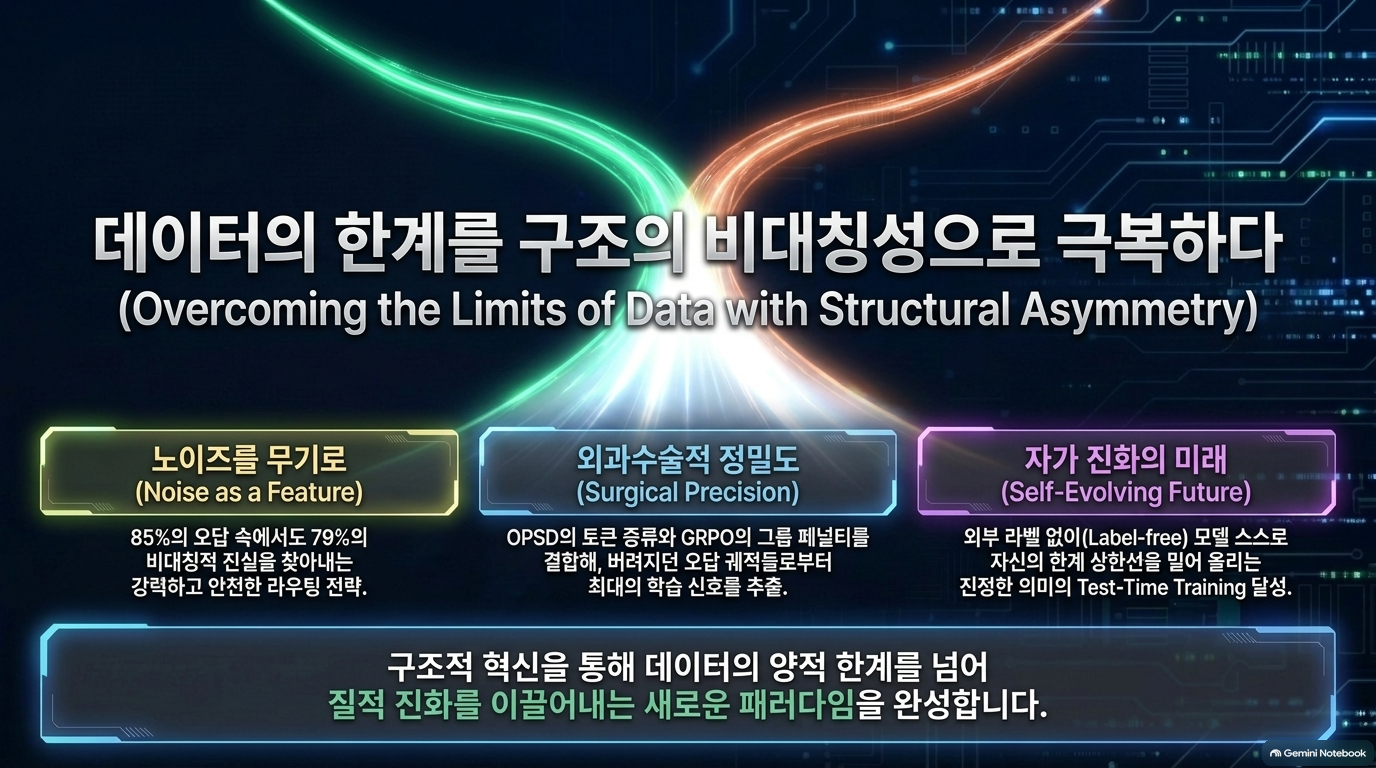
이 논문은 정답지가 없는 상황에서도 대규모 언어 모델(LLM)의 수학적 추론 능력을 스스로 향상시킬 수 있는 테스트 시간 정책 최적화(TTPO) 기술을 제안합니다. 기존의 방식들은 정답 라벨에 의존하거나 오답이 섞인 다수결 결과에 취약하다는 한계가 있었으나, TTPO는 다수결로 얻은 의사 라벨(Pseudo-label)의 오류를 수용할 수 있는 비대칭적 구조를 통해 이 문제를 해결합니다. 구체적으로, 다수 의견에 부합하는 답변은 온라인 자기 증류(OPSD)를 통해 모델의 사고 방식을 내면화하고, 다수 의견과 다른 답변은 그룹 강화학습(GRPO)을 적용해 효과적으로 배제합니다. 또한, 이미 학습된 부분은 제외하고 확신에 찬 오류만을 골라 수정하는 토큰 수준의 선택적 업데이트를 통해 학습의 정밀도를 높였습니다. 그 결과, TTPO는 정답 라벨 없이도 최고 수준의 수학 경시 대회 문제들에서 모델의 성능을 비약적으로 높였으며, 학습하지 않은 문제에서도 추론 능력이 향상되는 강력한 일반화 성능을 입증했습니다.


728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| LLM - 추론 최적화 - MoR: 적응형 토큰 수준 계산을 위한 동적 재귀 깊이 학습 (0) | 2026.09.09 |
|---|---|
| LLM - 성능 - 최적화 - 정규화된 저랭크 적응(NoRA) (0) | 2026.09.06 |
| 에이전트 최적화 - Azure, AI 에이전트 최적화의 경제학 (0) | 2026.09.06 |
| 에이전트 최적화 - Azure, 기업용 컨텍스트 엔지니어링(Context Engineering) (0) | 2026.09.06 |
| 에이전트 최적화 - Azure, 핀옵스(FinOps) 모델 기반 투자 수익률(ROI) 달성 가이드 (0) | 2026.09.06 |