반응형
https://arxiv.org/pdf/2507.10524
2025.10.25
[Mixture-of-Recursions: Learning Dynamic Recursive Depths for Adaptive Token-Level Computation]
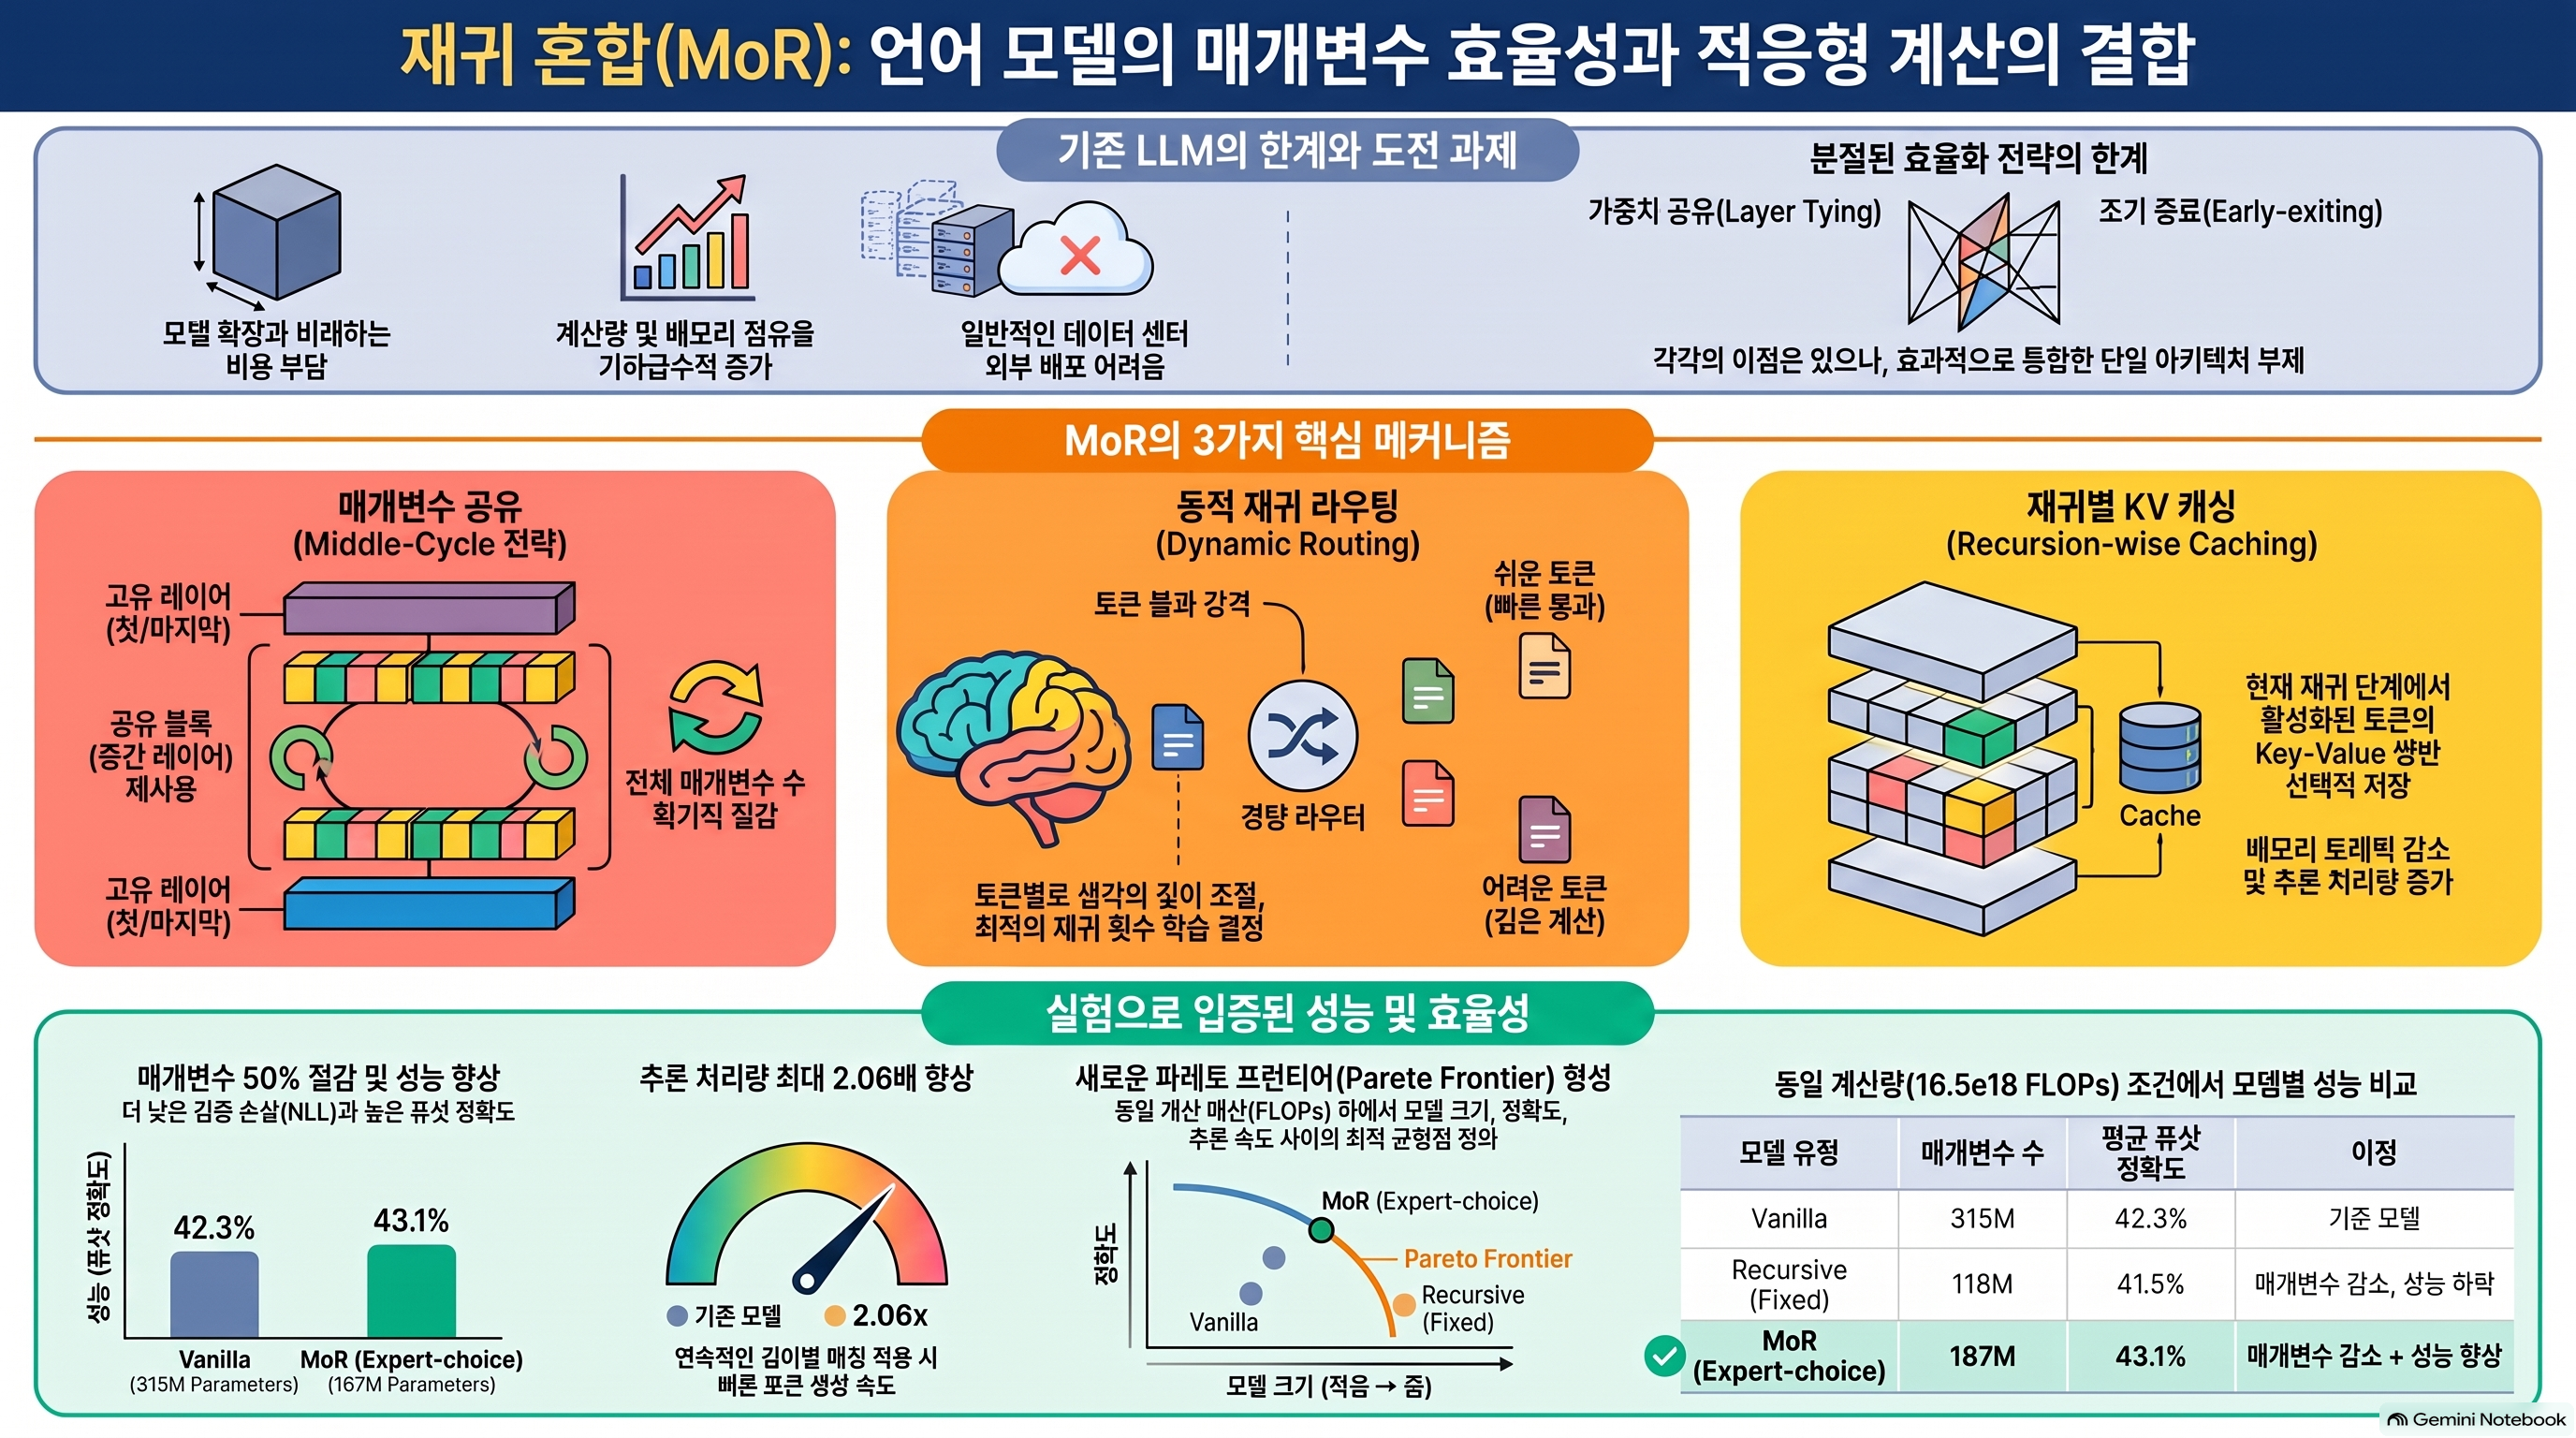
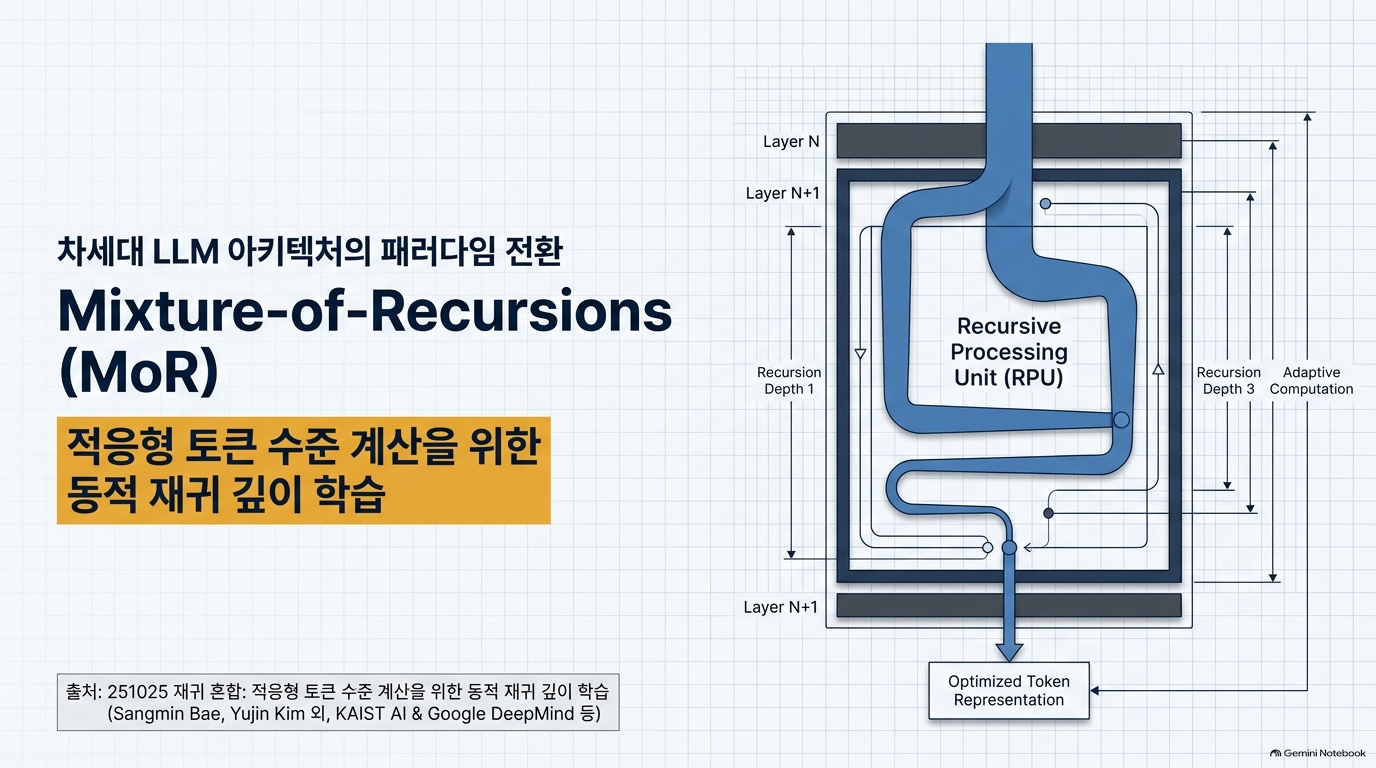
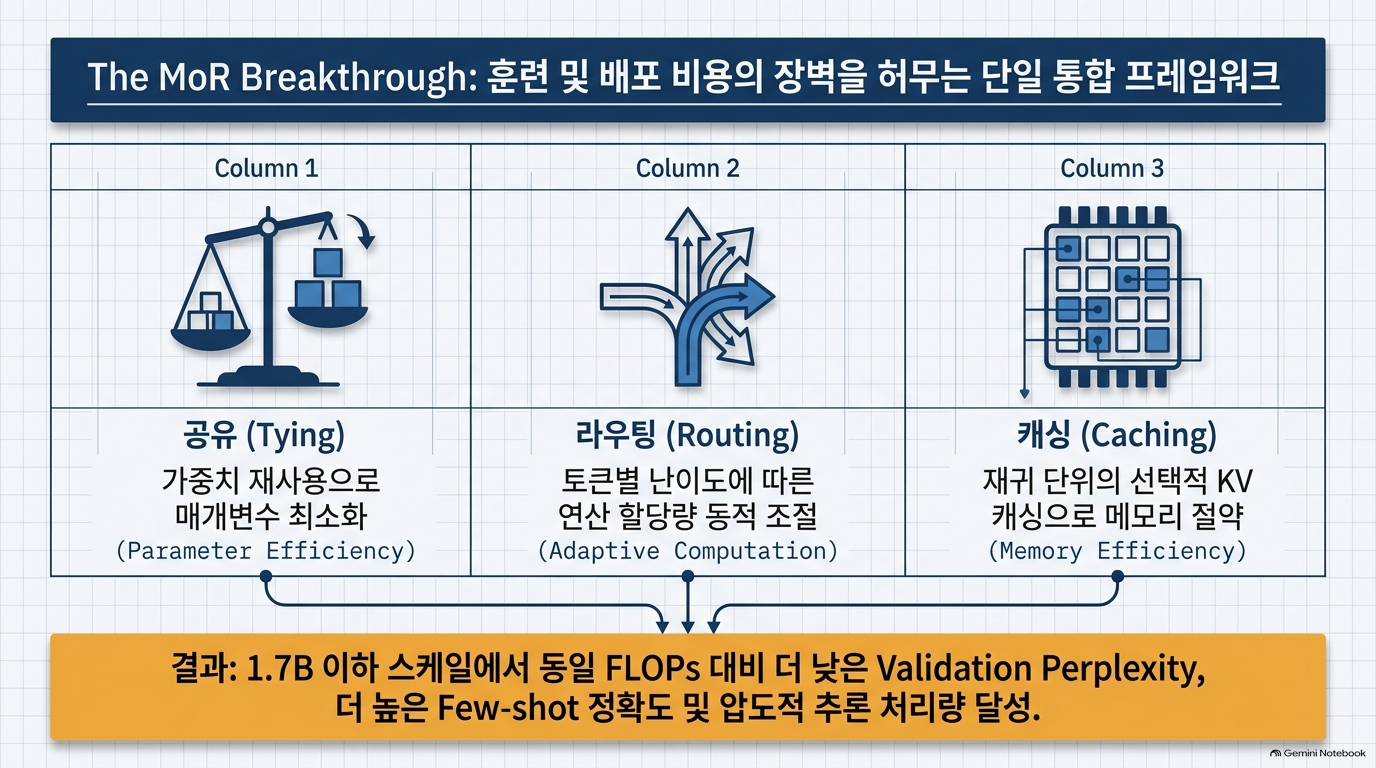
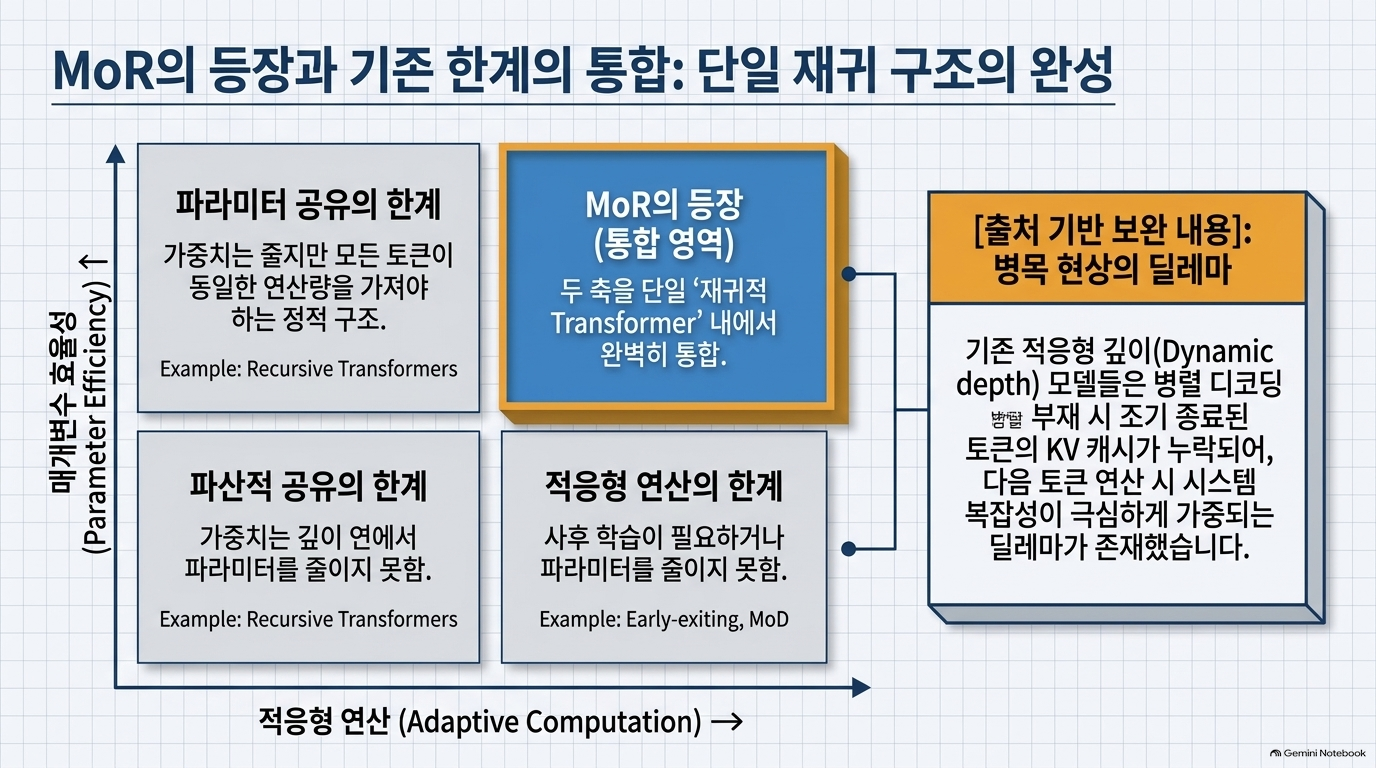
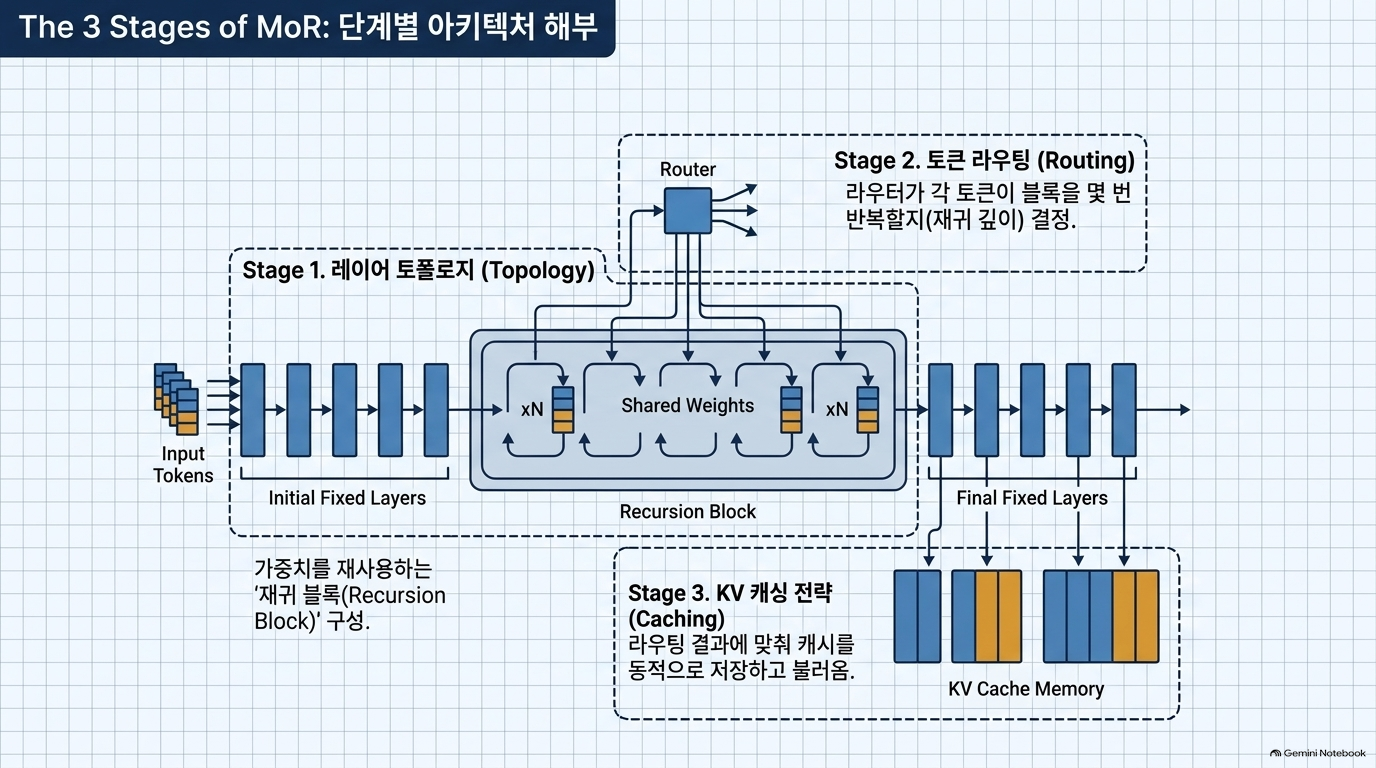
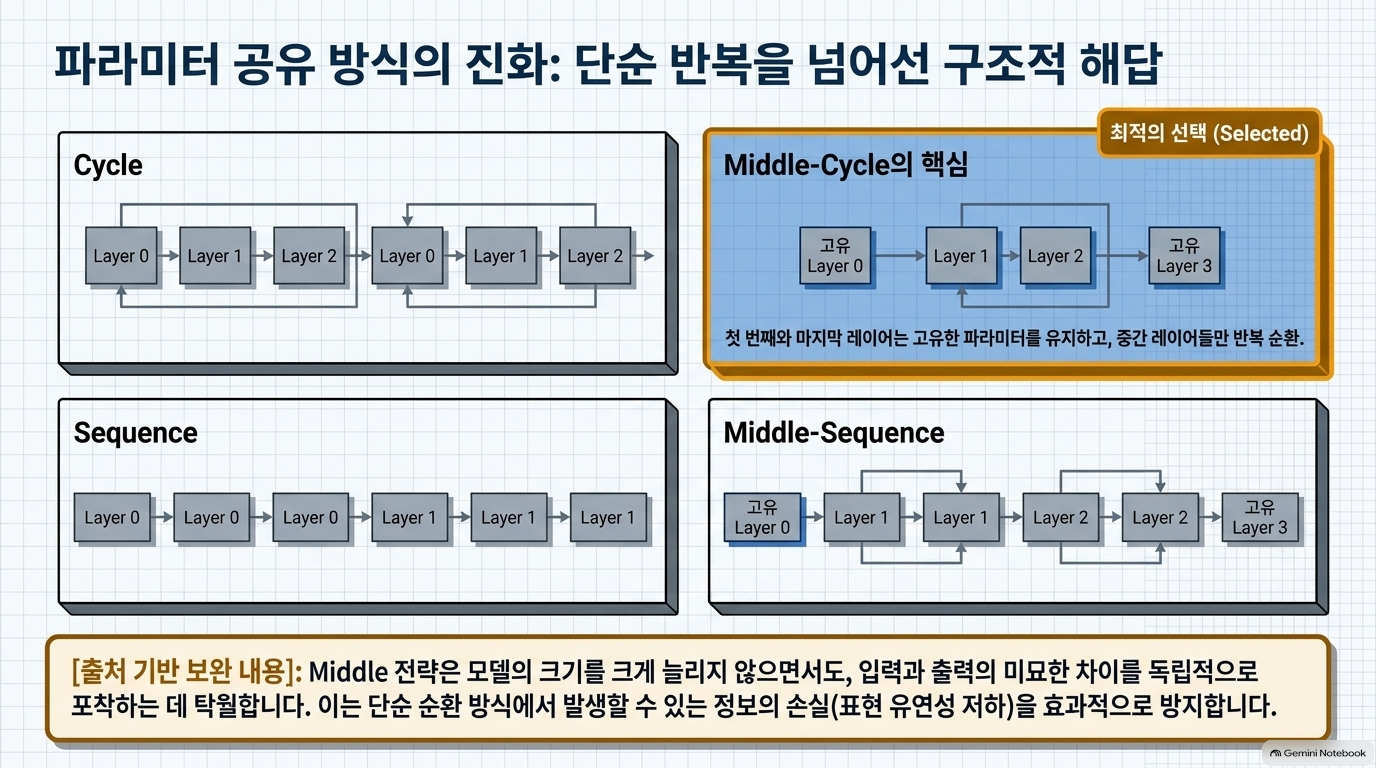
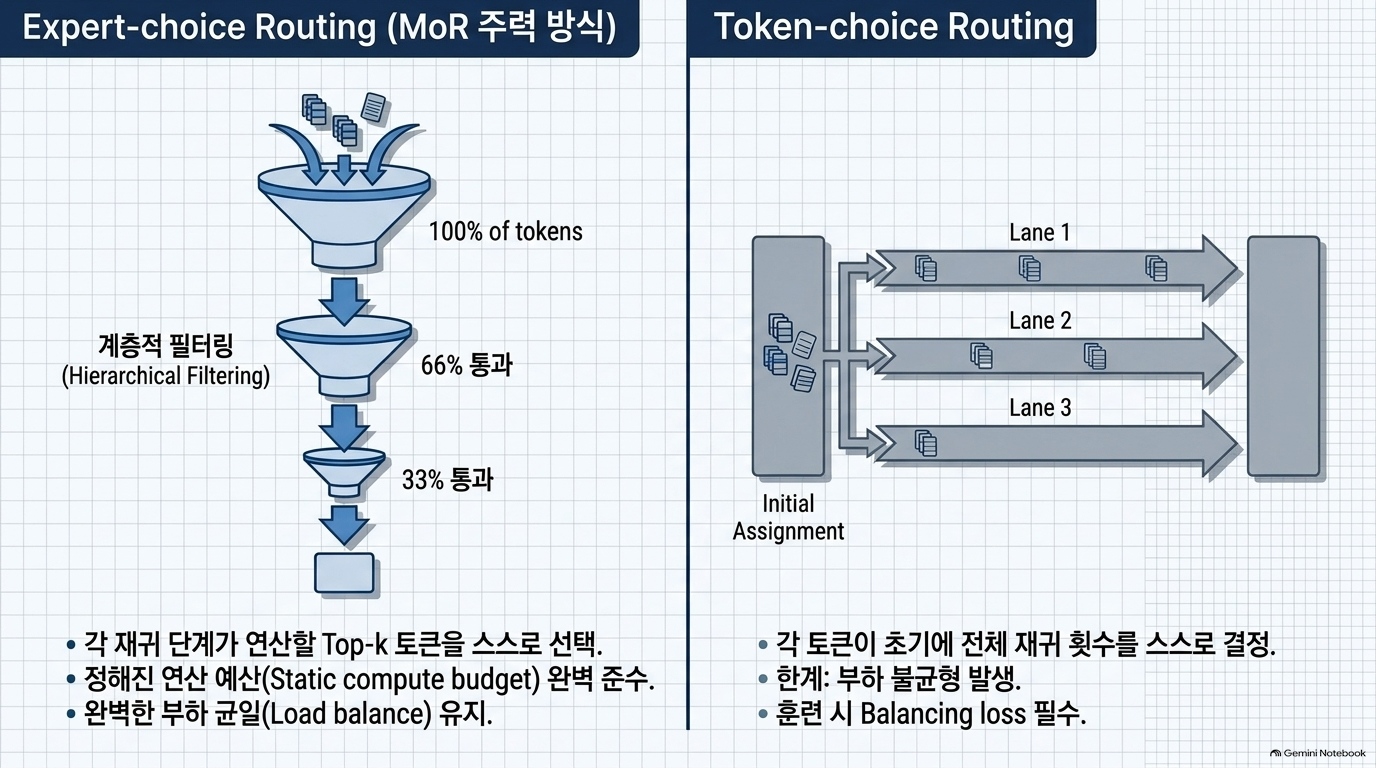
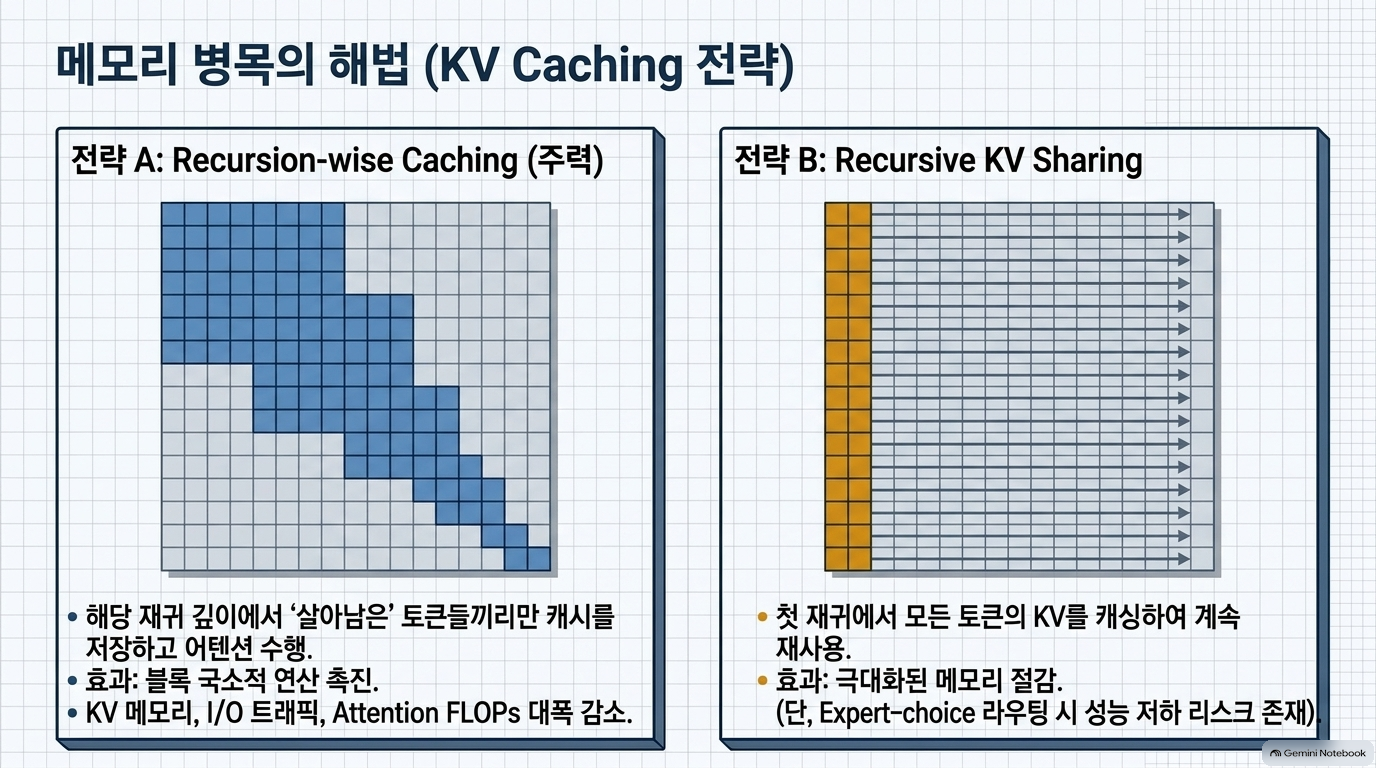
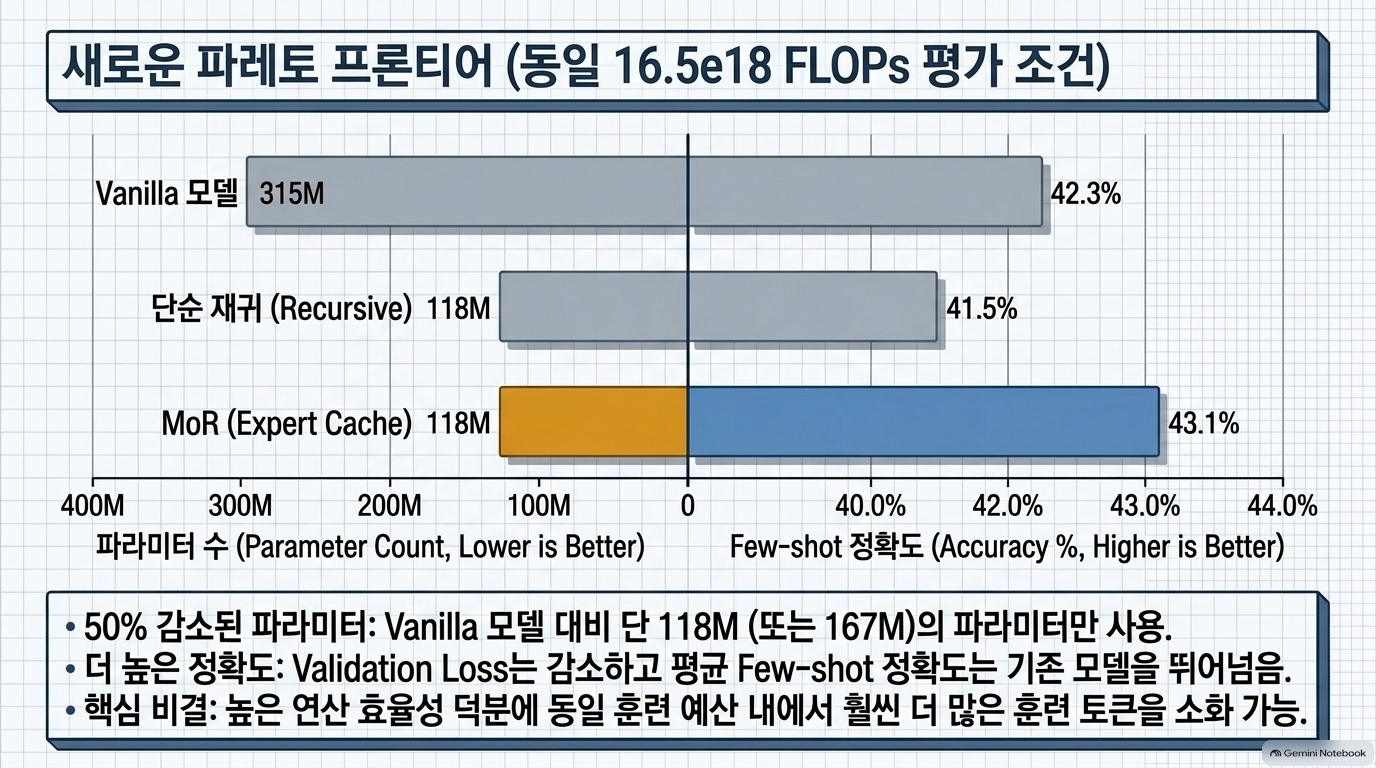
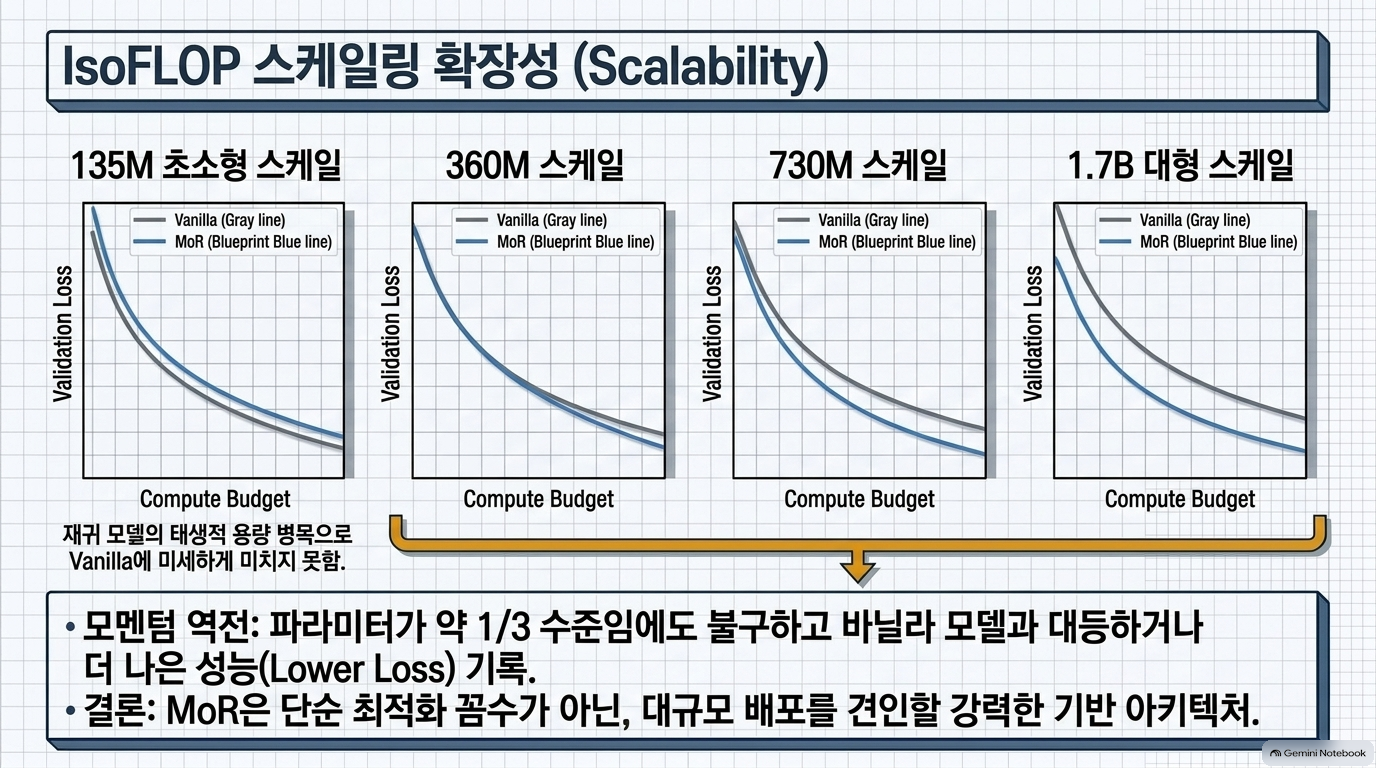
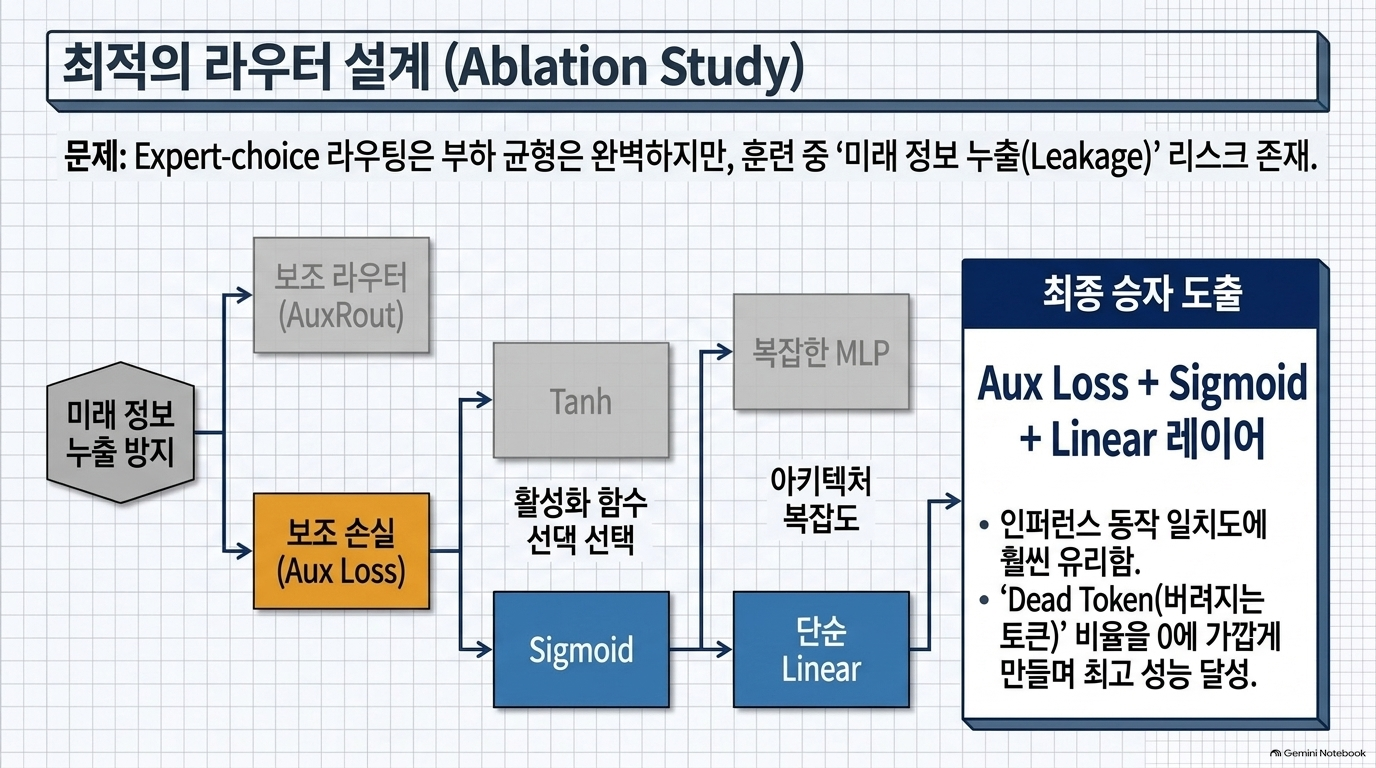
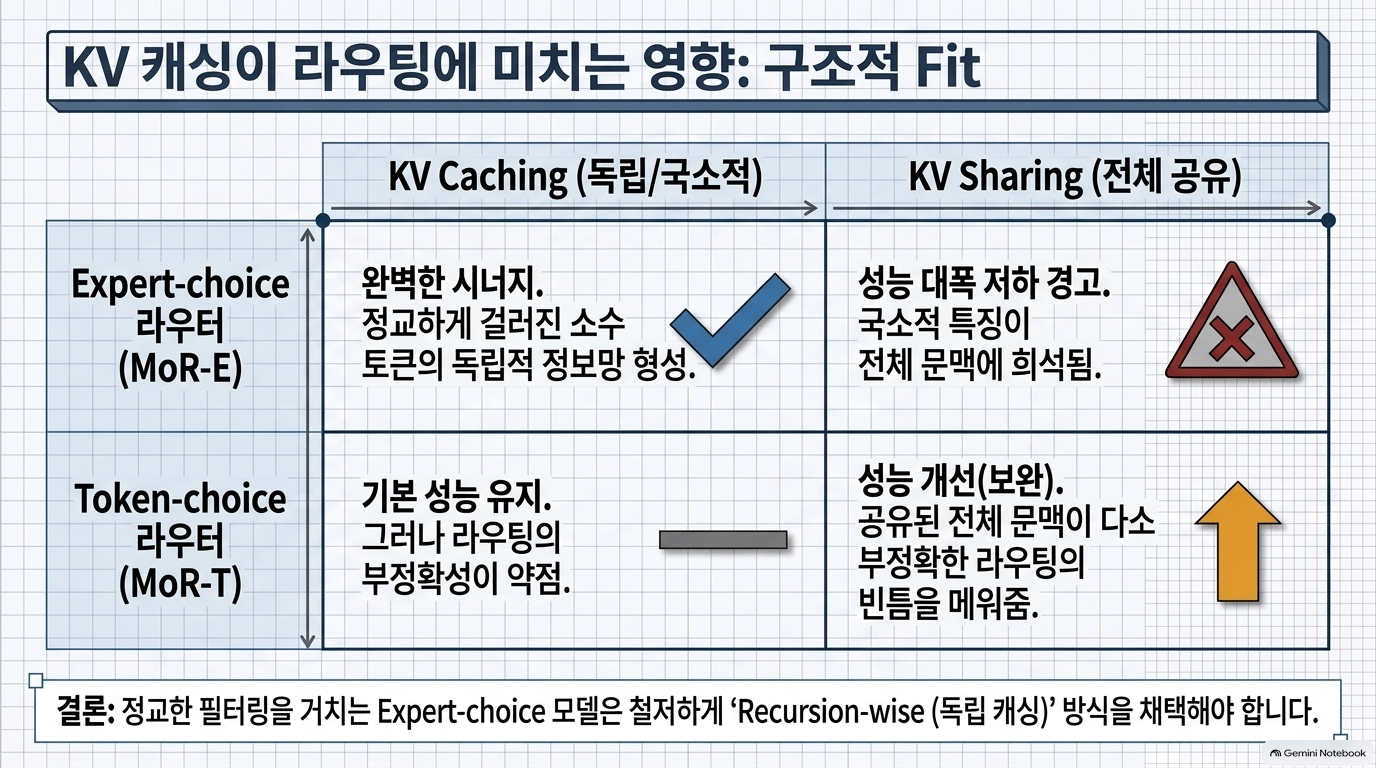
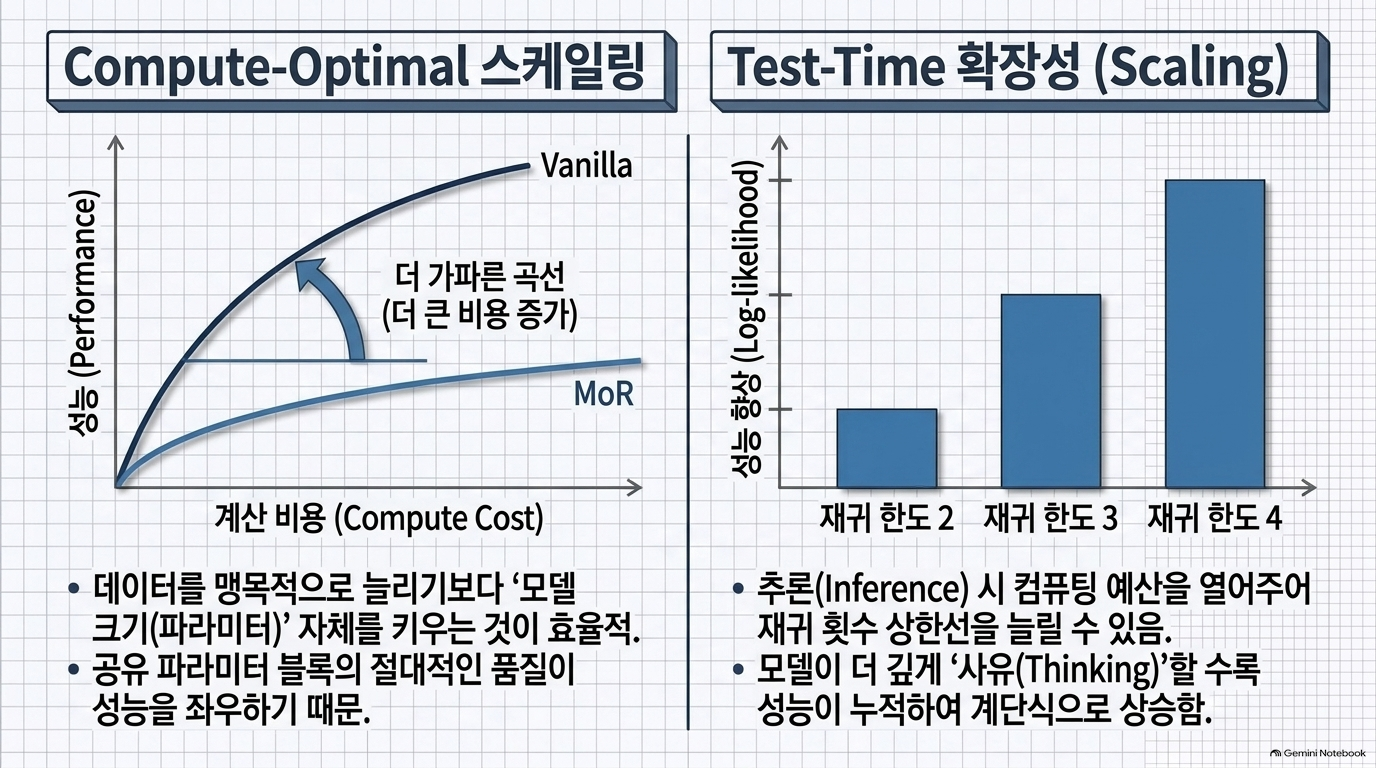
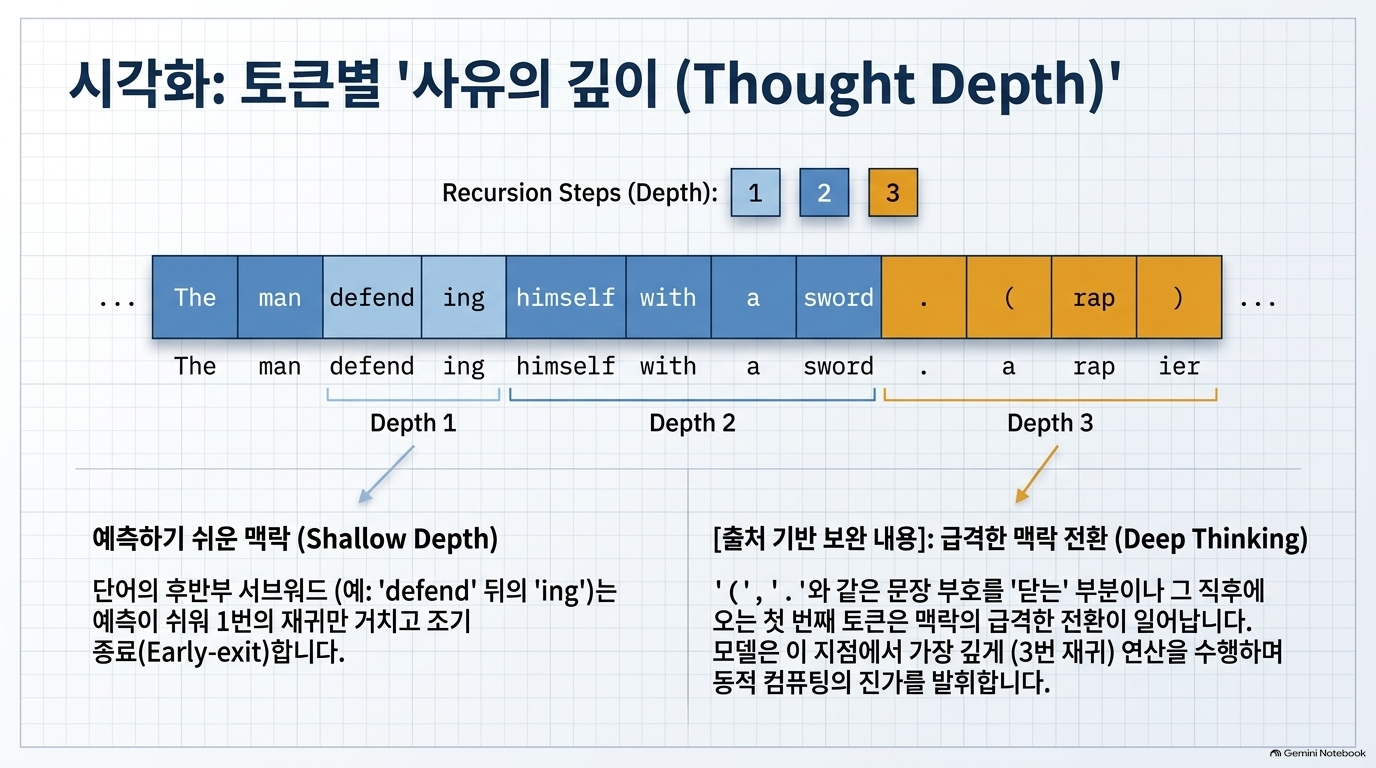
이 자료는 대규모 언어 모델의 성능을 유지하면서도 연산 효율성을 극대화하는 재귀 혼합(Mixture-of-Recursions, MoR) 프레임워크를 소개합니다. MoR은 동일한 가중치를 여러 층에서 재사용하는 매개변수 공유(Parameter Sharing)와 토큰의 난이도에 따라 계산량을 조절하는 적응형 연산(Adaptive Computation)을 하나의 구조로 통합한 것이 핵심입니다. 가벼운 라우터(Router)가 각 토큰별로 필요한 재귀 깊이를 동적으로 결정하여 쉬운 토큰은 일찍 내보내고 어려운 토큰에만 더 많은 연산을 집중시킵니다. 또한, 활성화된 토큰의 데이터만 선택적으로 저장하는 재귀별 KV 캐싱 전략을 통해 메모리 사용량과 연산 비용을 획기적으로 줄였습니다. 결과적으로 MoR은 기존 모델 대비 적은 매개변수와 낮은 연산량으로도 더 높은 정확도와 빠른 추론 처리량(Throughput)을 달성하며 효율적인 대형 모델 구축의 새로운 방향을 제시합니다.

728x90
반응형
'07.AI > 4.AI 비용' 카테고리의 다른 글
| 2026 - ramp, 9월 AI 지출 보고서 (0) | 2026.09.12 |
|---|---|
| LLM - 추론 최적화 - 잠재 추론을 활용한 테스트 시간 컴퓨팅 성능 향상: 순환 깊이 접근법 (0) | 2026.09.09 |
| LLM - 성능 - 최적화 - 정규화된 저랭크 적응(NoRA) (0) | 2026.09.06 |
| LLM - 추론 최적화 - TTPO: 테스트 시간 정책 최적화 (0) | 2026.09.06 |
| 에이전트 최적화 - Azure, AI 에이전트 최적화의 경제학 (0) | 2026.09.06 |