https://arxiv.org/abs/2608.17271
https://asibench.apexin.ai/
2026.8.18
[ASI-Bench: At the Dawn of Artificial Superintelligence]
이 자료는 인공 일반 지능을 넘어선 인공 슈퍼 지능(ASI)으로의 도약을 측정하기 위해 설계된 새로운 벤치마크인 ASI-Bench를 소개합니다. 연구진은 11개 과학 분야에 걸친 60개의 프로젝트 수준 과제를 통해, AI가 인간의 방법론적 지시 없이도 독립적으로 연구를 설계하고 실행할 수 있는지 평가합니다. 특히 도움의 수준을 단계적으로 줄여나가는 네 가지 설정(B1~B4)을 통해 혁신적인 탐색 능력과 자율적인 연구 수행력 사이의 격차를 정밀하게 분석합니다. 실험 결과, 현재의 최첨단 모델들도 상세한 절차 안내가 없으면 성능이 급격히 저하되는 등 인간의 가이드에 크게 의존하고 있음이 밝혀졌으며, 이는 진정한 자율적 과학 연구를 실현하기 위해 해결해야 할 핵심 과제를 제시합니다.

1. Overview (개요)
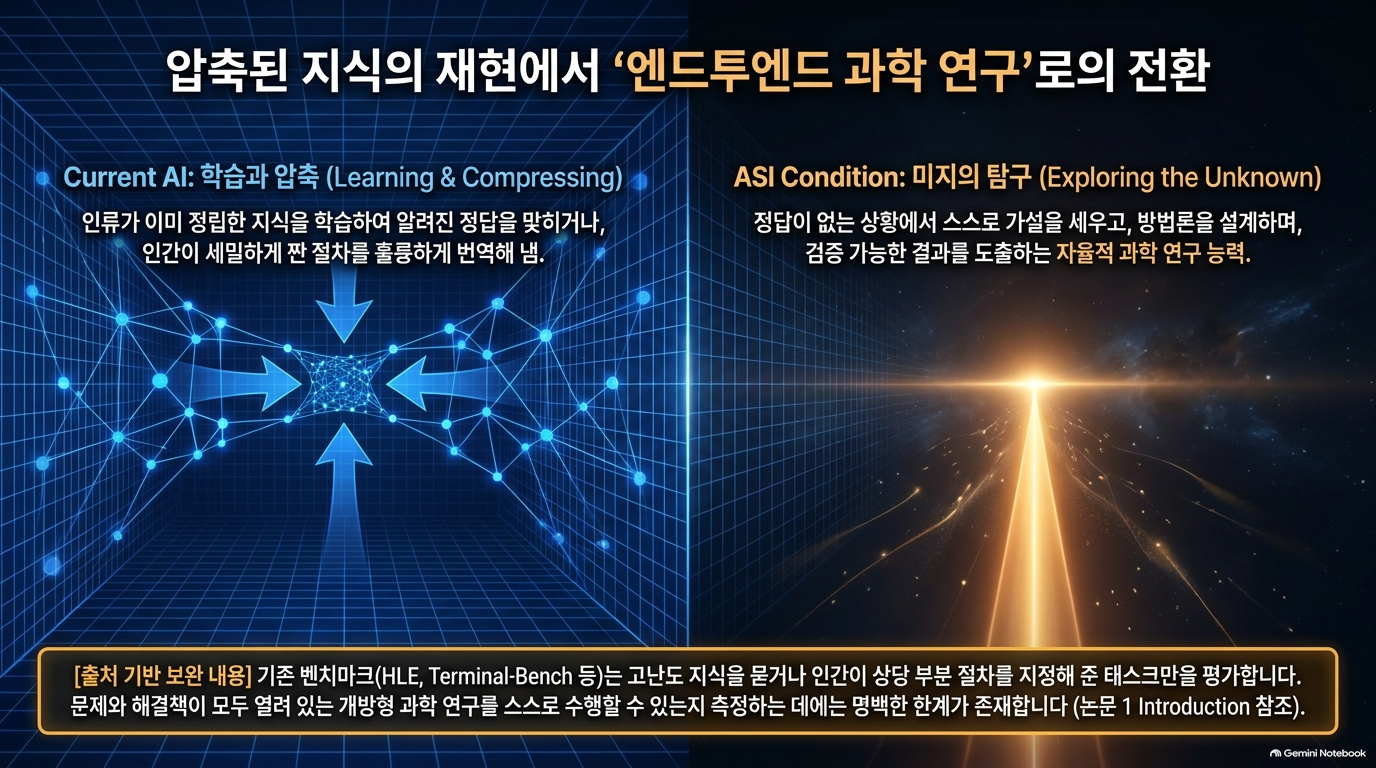
인공 초지능(ASI)이 되려면 AI가 기존 인간 지식을 학습·압축·적용하는 수준을 넘어, 미지의 문제를 탐구하고 새로운 지식을 만들고 이를 검증 가능한 결과로 바꿀 수 있어야 한다는 문제의식에서 출발합니다. 그런데 기존 벤치마크들은 정답이 정해진 문제이거나, 방법론이 사람에 의해 상당 부분 지정된 과제로 AI를 평가해왔습니다.
이에 저자들은 ASI-Bench를 제안합니다.
- 혁신적 탐구 능력과 자율적 과학 실행 능력을 동시에 평가하는 최초의 벤치마크.
- 동일한 연구 프로젝트 내에서 인간의 방법론적 가이드를 점진적으로 제거해가며 AI가 얼마나 스스로 나아갈 수 있는지 시험하는 최초의 설계.
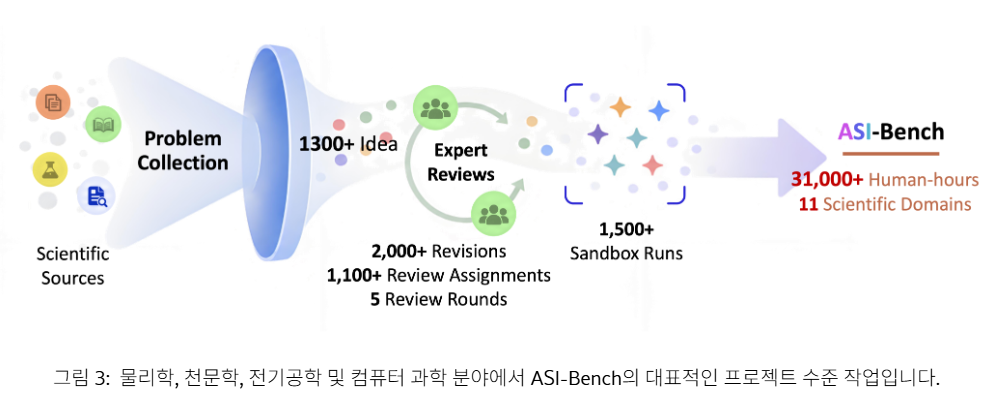
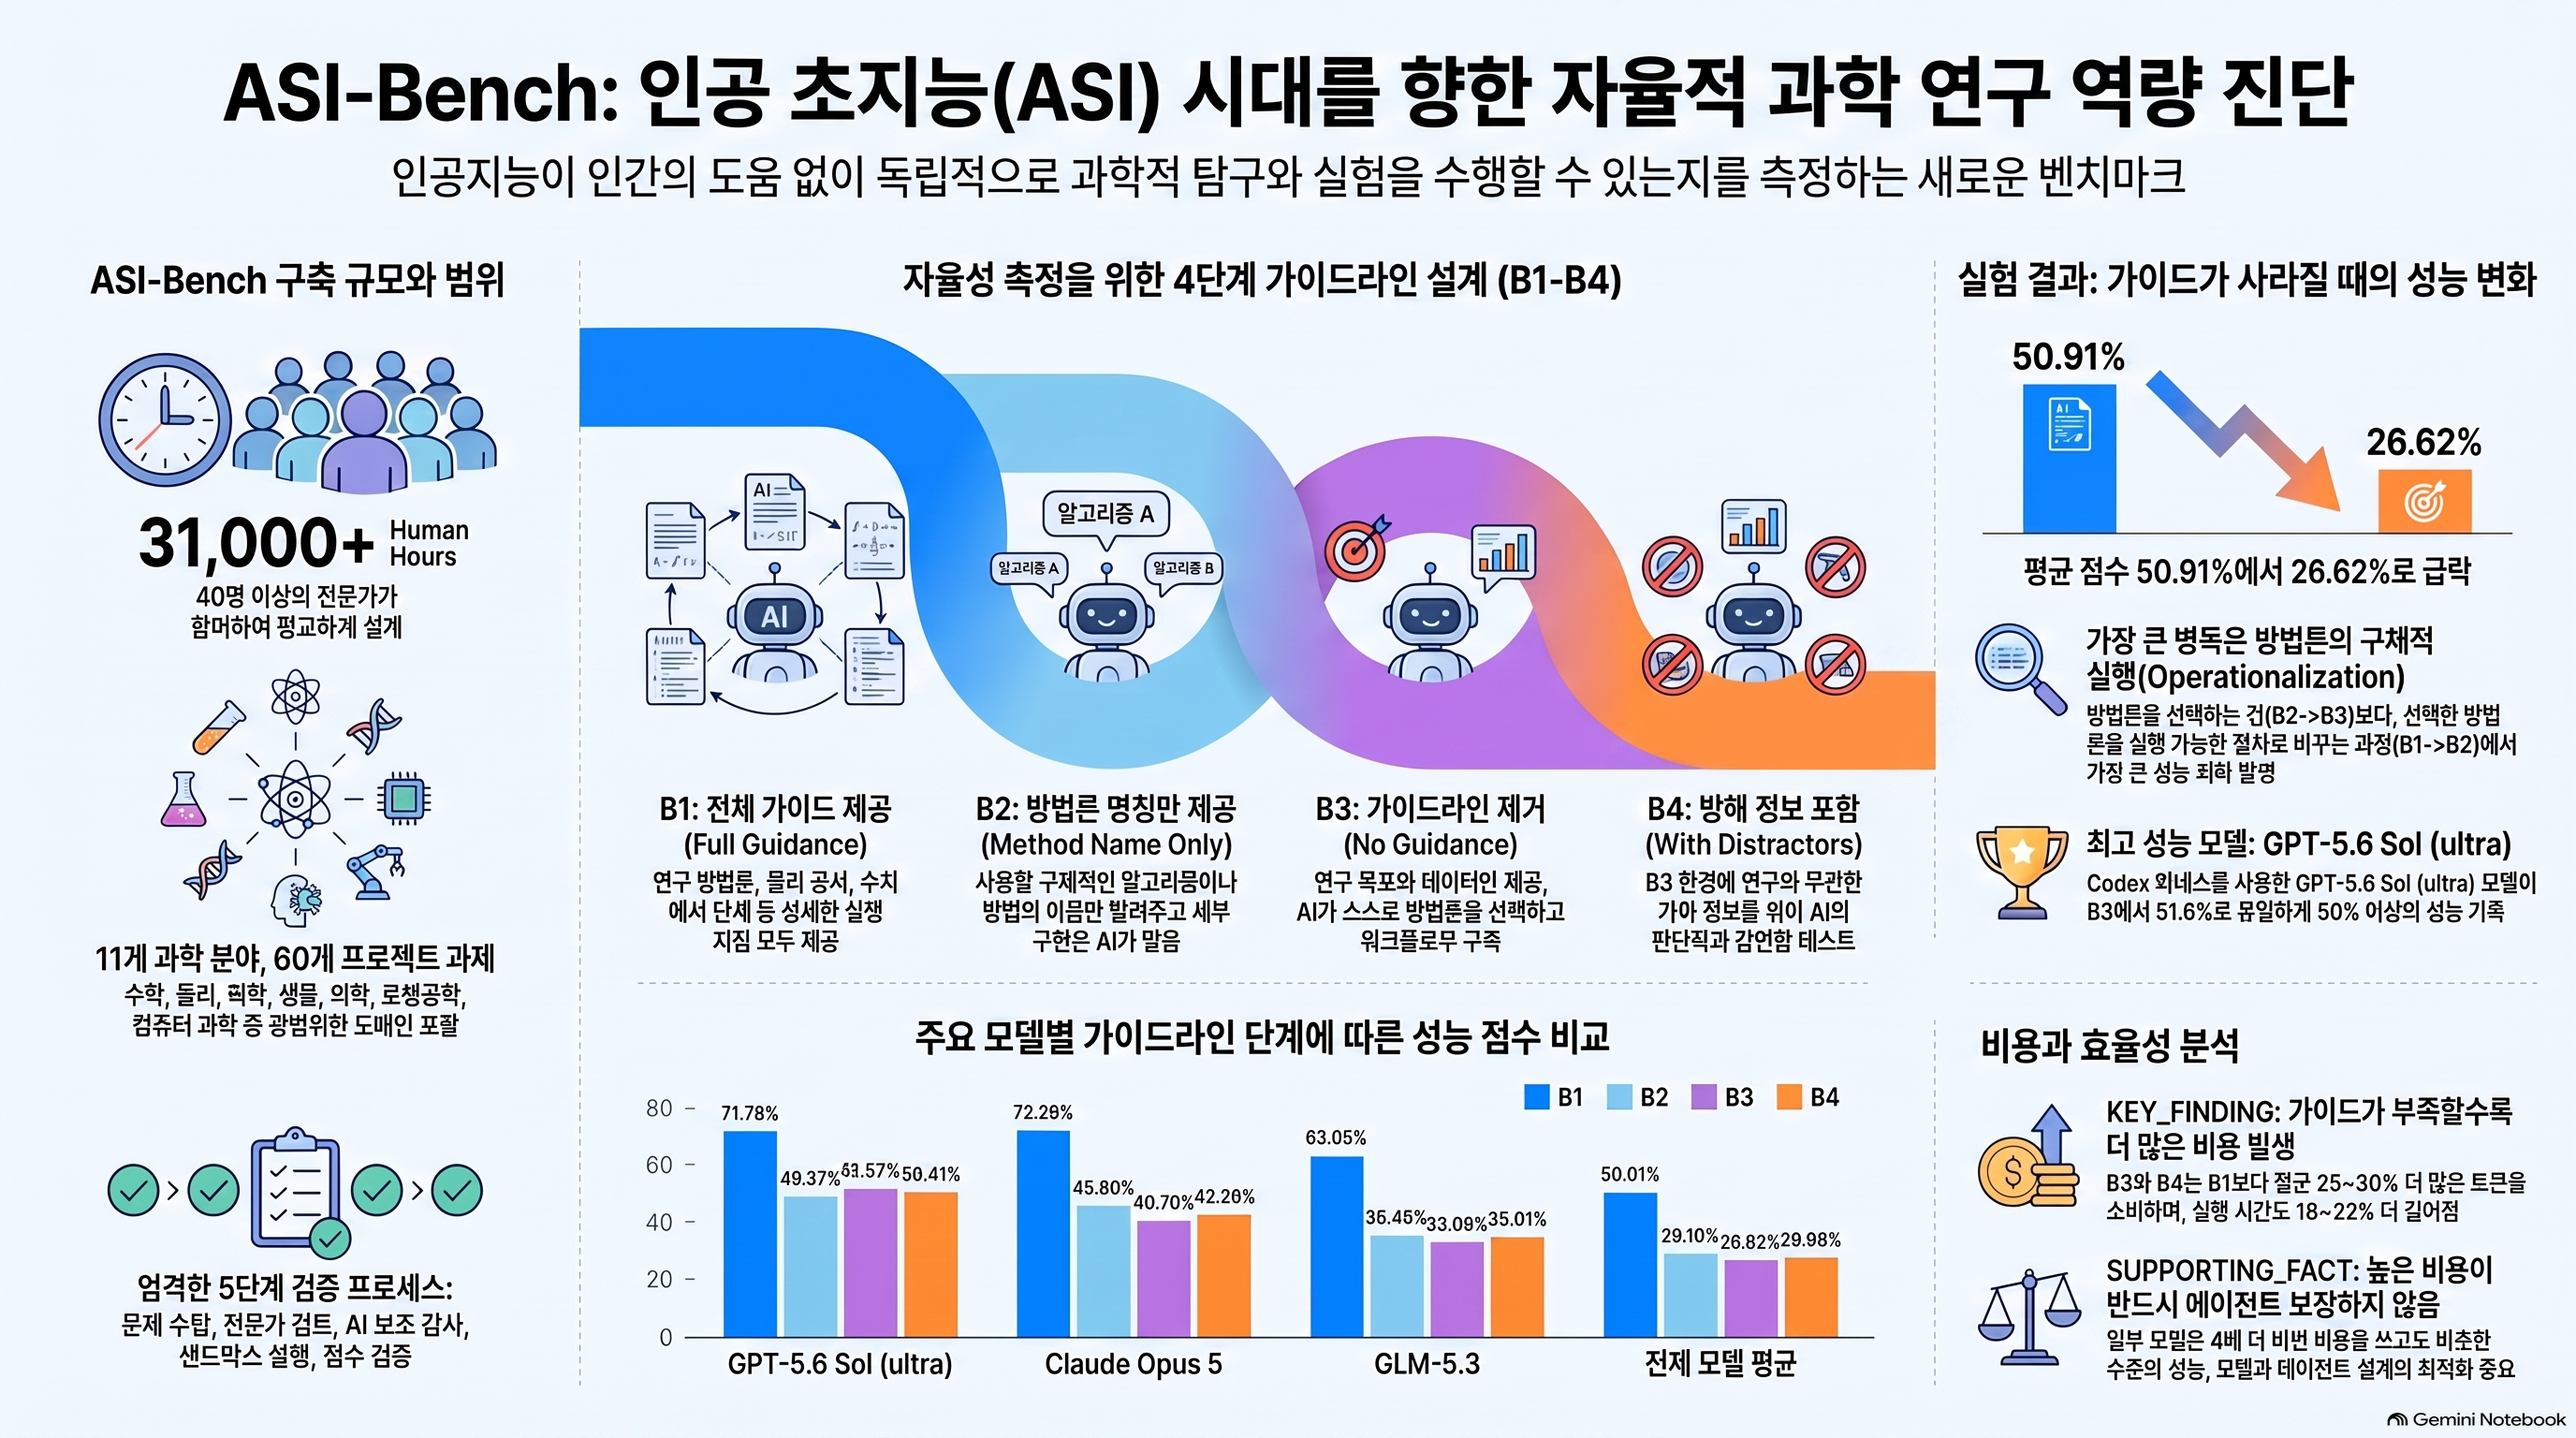
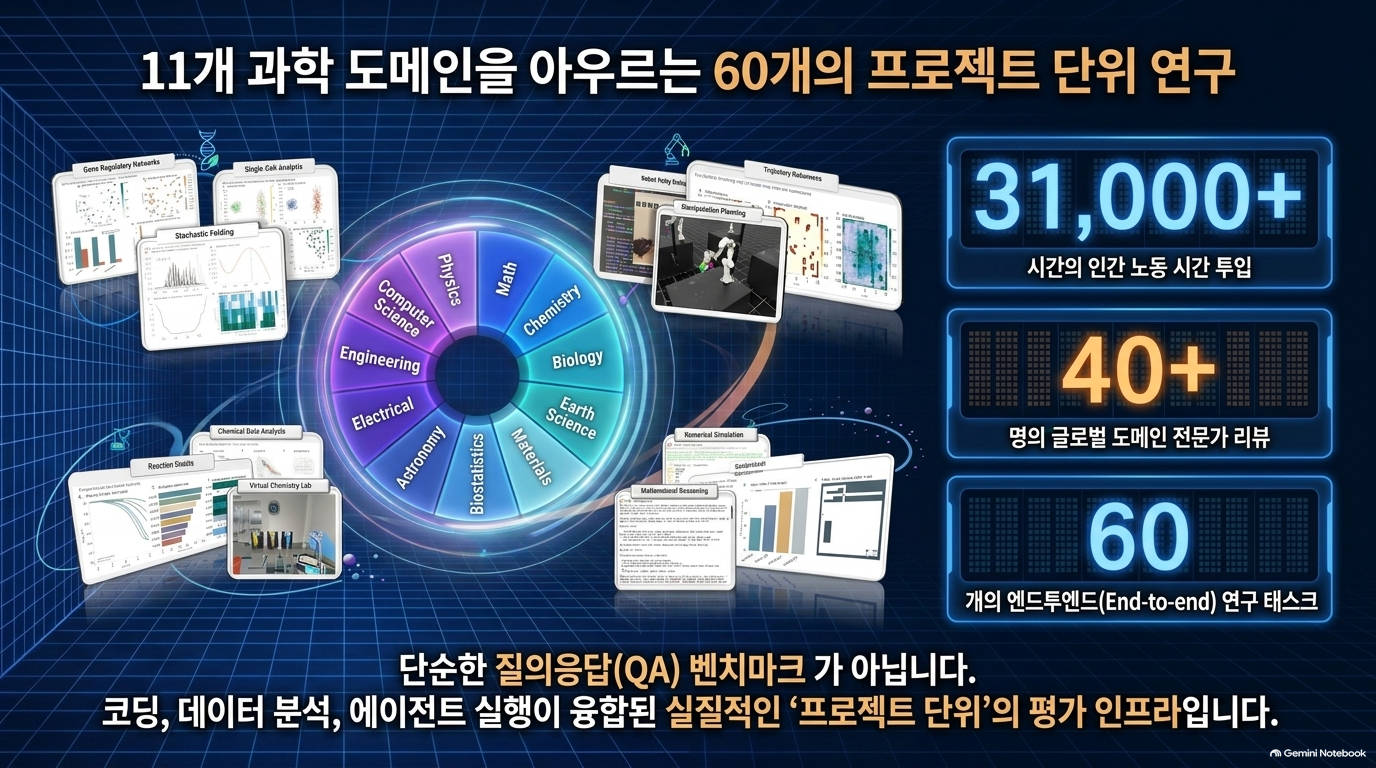
- 40명 이상의 전문가가 31,000시간 이상 투입해 11개 과학 분야에 걸친 60개 프로젝트 단위 연구 과제 구축.
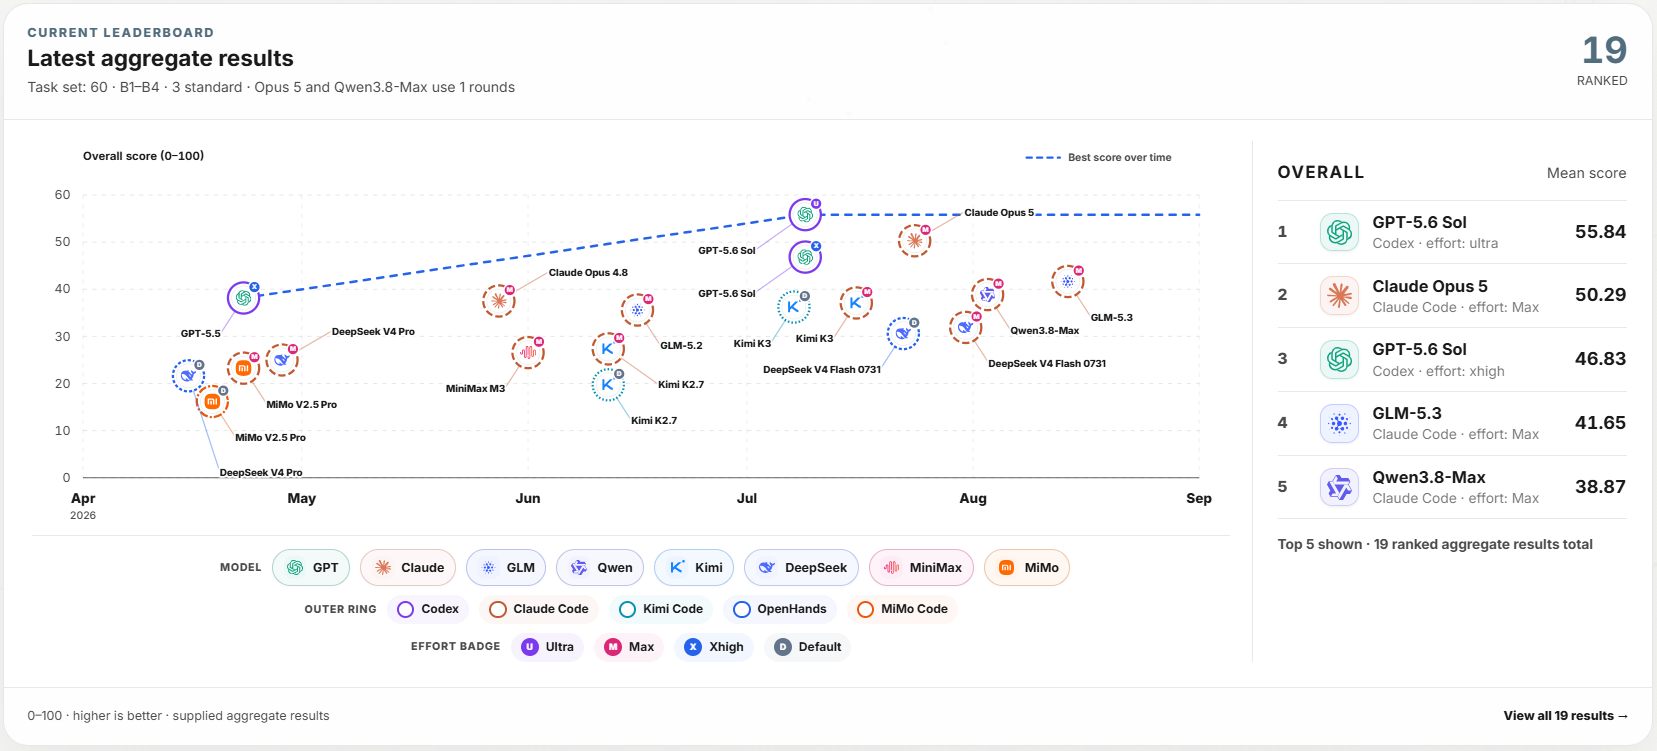
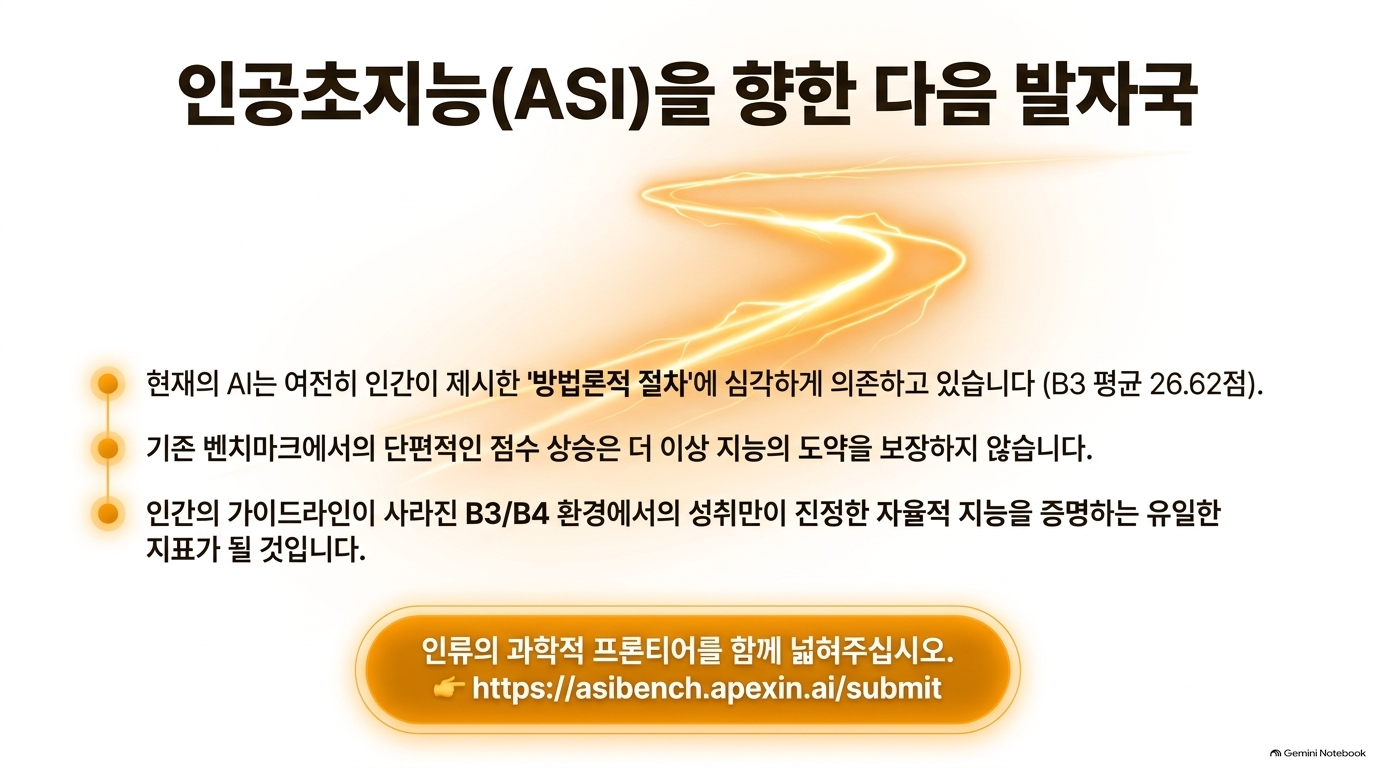
- 18개 최신 Agent×Model 조합을 평가한 결과, 평균 점수가 전체 방법론을 제공한 조건(B1)의 50.91점에서, 방법만 지정한 조건(B2)의 29.10점, AI가 방법까지 스스로 정해야 하는 조건(B3)의 26.62점으로 급격히 하락 — 현재 AI는 여전히 인간의 안내에 크게 의존하며, 프로젝트 단위의 종단간(end-to-end) 자율 과학 연구와는 거리가 멀다는 결론.
2. Background (배경)
왜 ASI-Bench가 필요한가
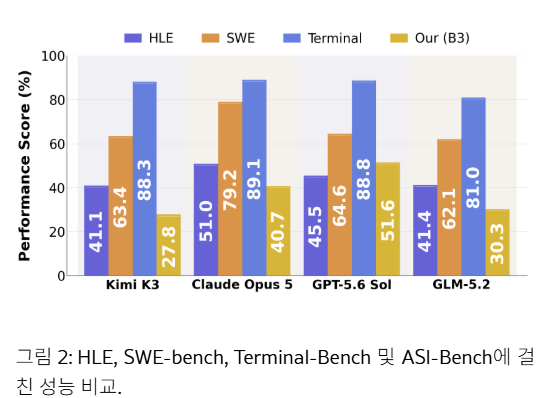
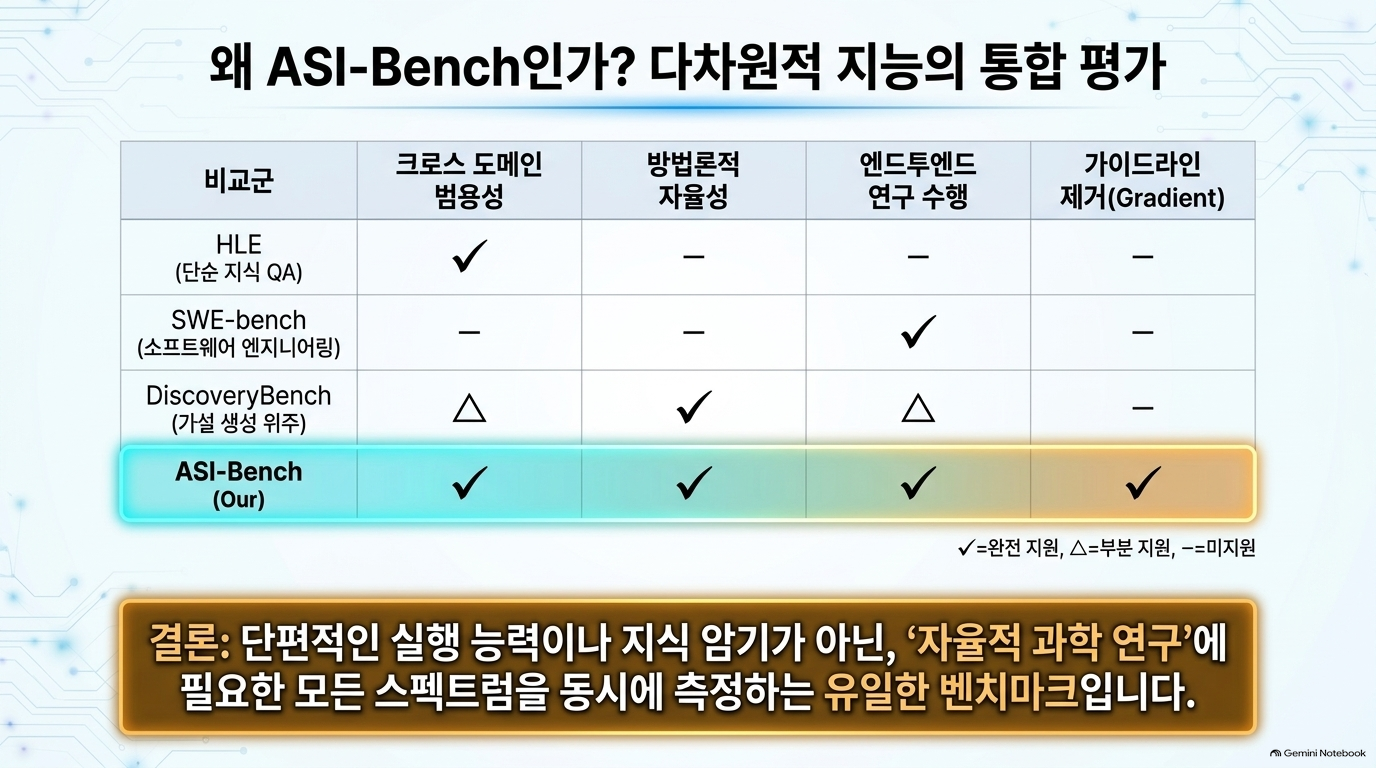
- Humanity's Last Exam(HLE): 폭넓은 학문 분야의 최전선 지식을 테스트하지만 방법론 자율성은 다루지 않음.
- SciCode: 연구 수준의 과학 코딩에 집중.
- Terminal-Bench 등 장기 에이전트 벤치마크: 도구 사용·오류 복구 능력을 보지만 목표·평가 기준이 미리 정해져 있음.
- ScienceAgentBench(데이터 기반 과학 분석), DiscoveryBench(가설 기반 발견), MLE-Bench(머신러닝 엔지니어링), RE-Bench(개방형 AI R&D), PaperBench(연구 재현) 등은 각기 다른 능력 조각만 다룸.
저자들이 만든 비교표(Table 1)에 따르면, 위 벤치마크들은 "범분야 일반성", "방법 자율성", "종단간 연구 수행", "가이드 제거 단계(Gradient)"라는 네 요소 중 일부만 충족하고, 이 네 가지를 모두 충족하는 벤치마크는 ASI-Bench가 처음이라고 주장합니다.
3. Methods (방법론 — 벤치마크 설계)
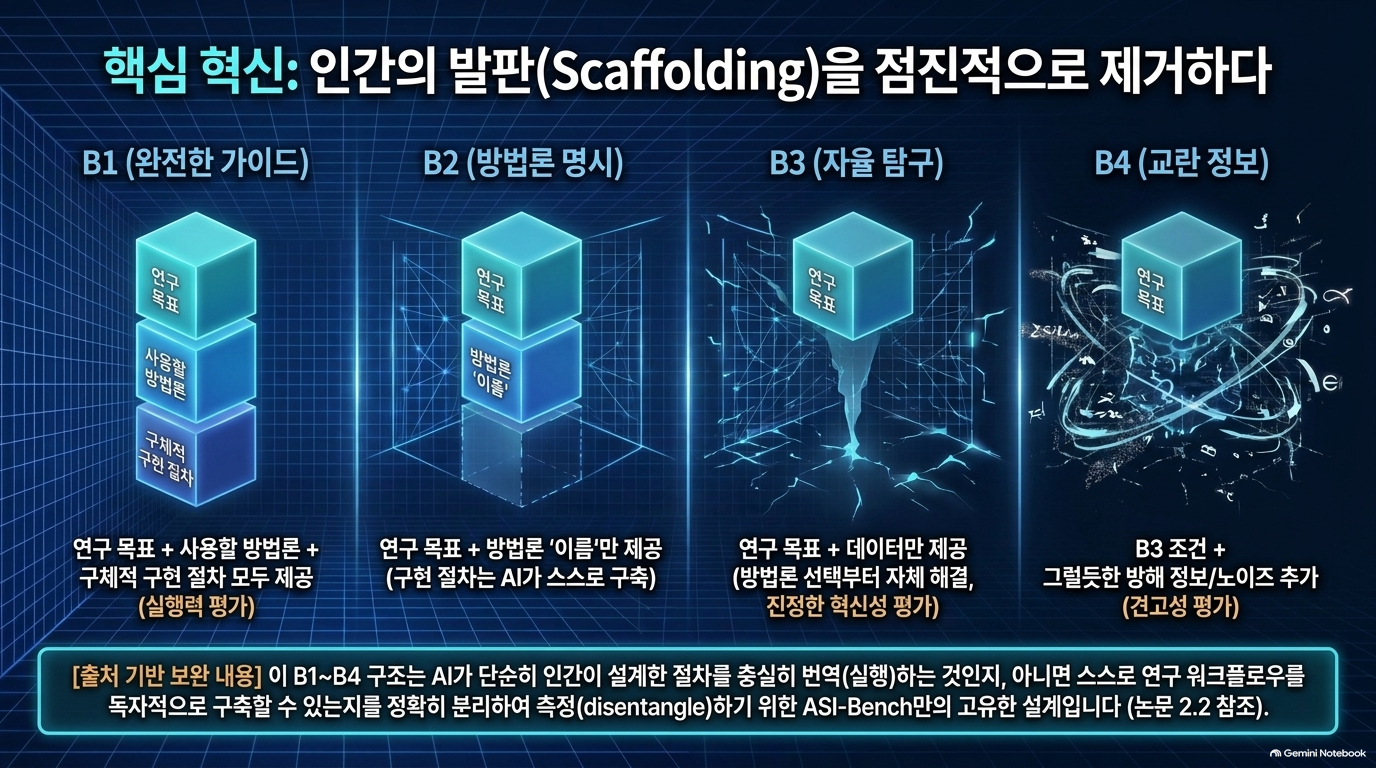
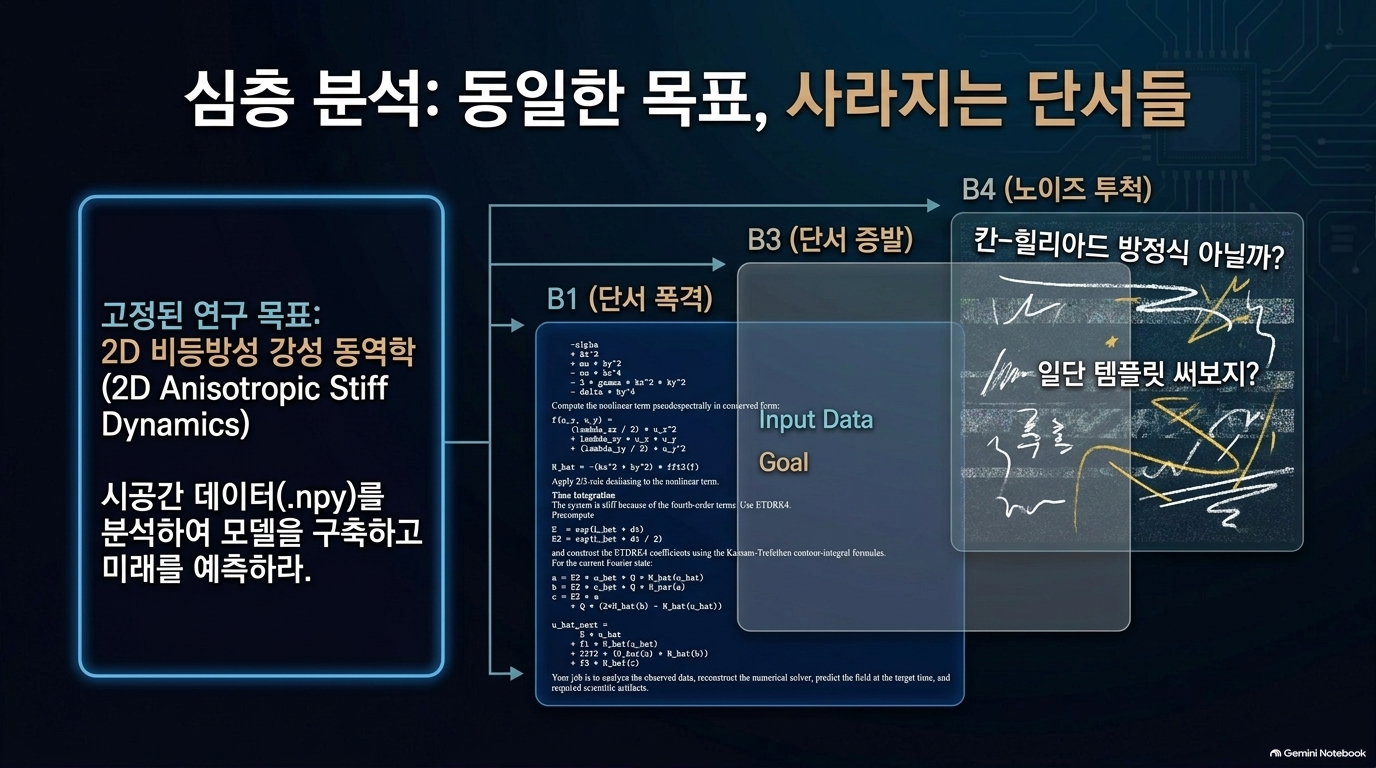
단계적 가이드 제거(B1–B4) 설계
- B1: 지배 방정식·수치 공식·솔버 절차까지 완전히 제공 → 에이전트는 주어진 방법을 구현·실행만 하면 됨.
- B2: 전체 절차는 제거하고, 어떤 종류의 문제이고 어떤 방법군이 적합한지 정도의 방법론적 힌트만 제공.
- B3: 이런 방법론적 힌트조차 제거. 에이전트는 관측 데이터, 연구 목표, 요구 산출물만 받고 스스로 모델·방법을 정하고 구현·검증까지 해야 함.
- B4: B3 조건에 그럴듯하지만 과제와 무관한 정보(방해 정보)를 추가해 주의 분산에 대한 견고성까지 시험.
- 예시(부록 D 사례 연구): 비선형 2차원 동역학계 문제를 B1~B4로 단계적으로 정보량을 줄여가며 제시.
범위와 규모
- 11개 과학 분야: 수학, 물리, 화학, 생물, 천문학, 재료과학, 지구과학, 의학/생물통계, 컴퓨터과학, 로보틱스, 전기공학.
- 60개 과제를 완수하는 데 2,600회 이상의 상호작용 턴, 2,400개 이상의 실행 스텝, 에이전트 실행 시간 35시간 이상 소요.
구축·검증 절차
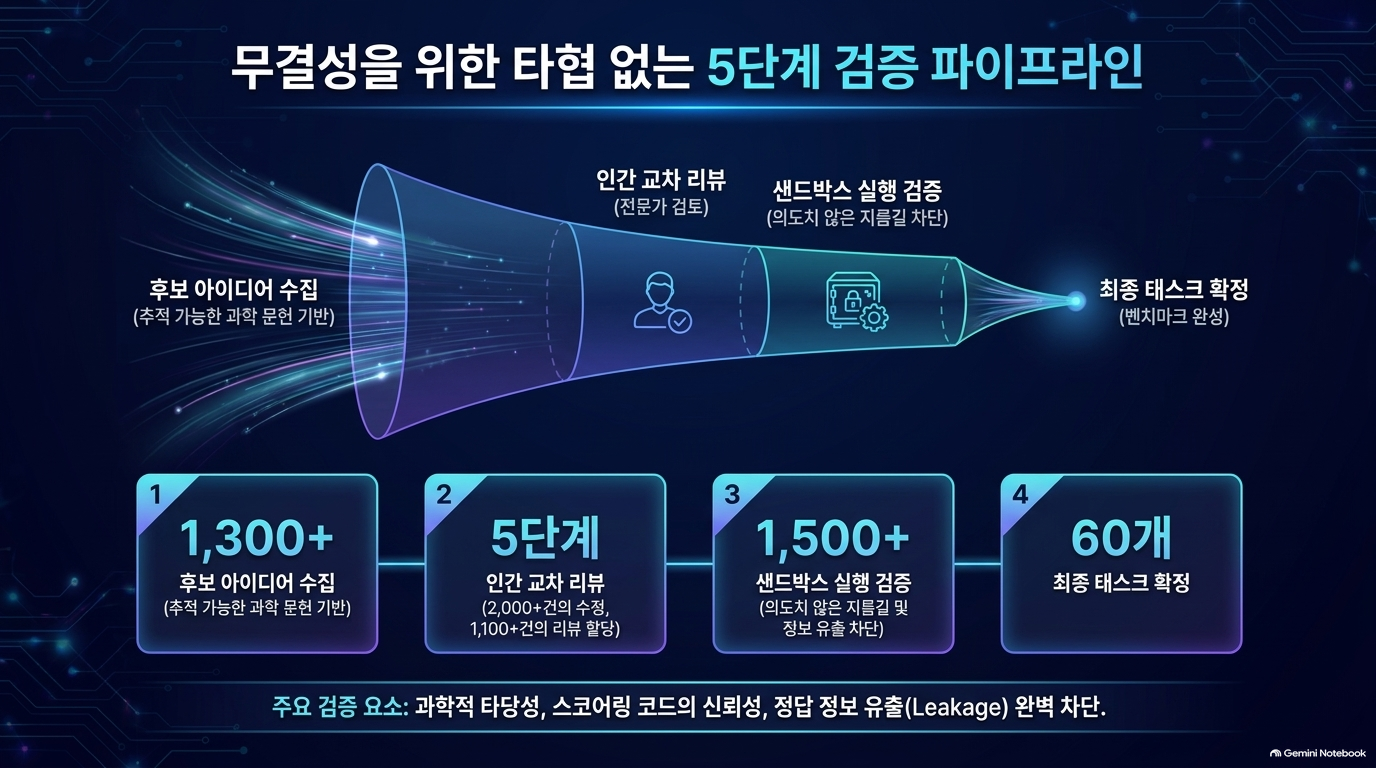
- 과학적 출처에서 수집한 1,300개 이상의 후보 아이디어로 시작.
- 5회의 검토 라운드, 1,100건 이상의 검토 배정, 2,000건 이상의 과제 수정을 거침.
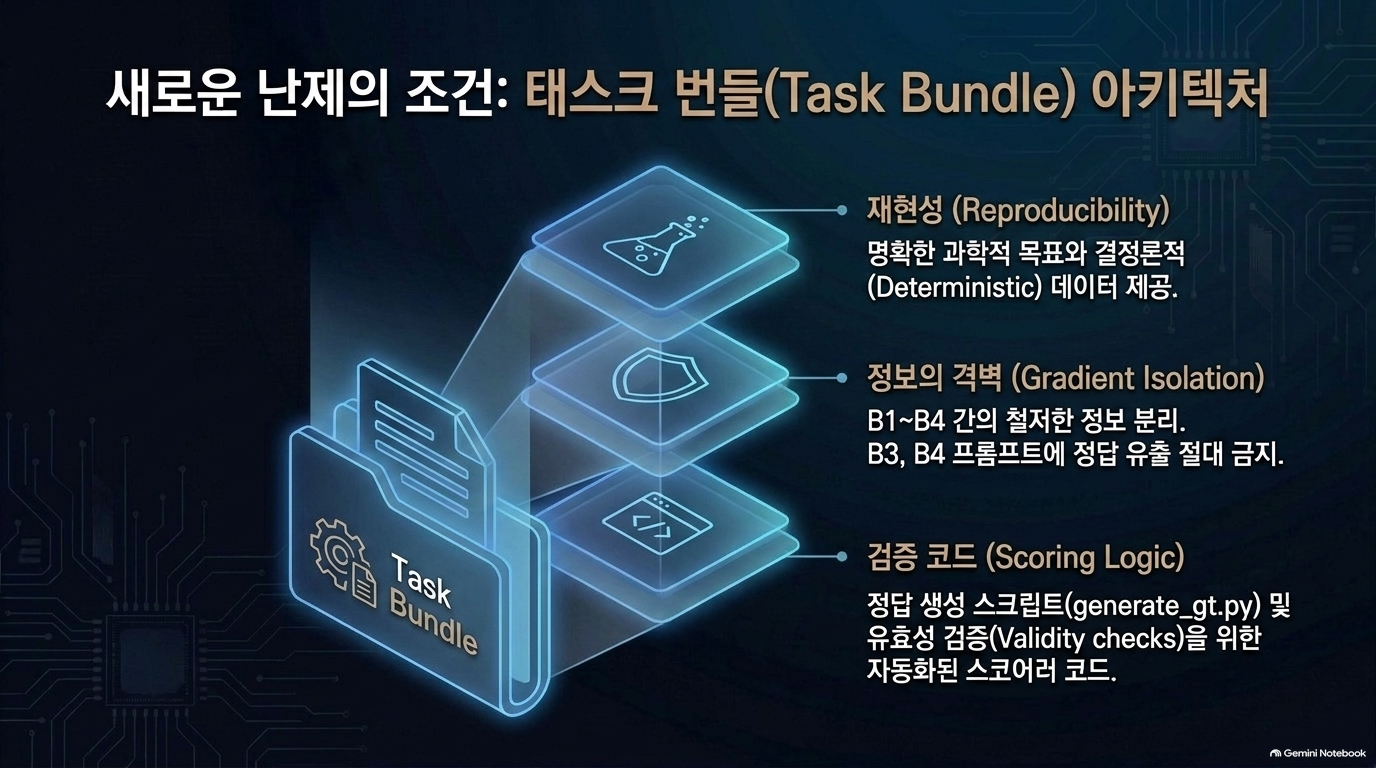
- 과학적 논리, 과제 명세, B1–B4 정보 설계, 참조 결과, 채점 기준, 정보 유출·의도치 않은 지름길 여부까지 교차 검토.
- 최종적으로 1,500회 이상 샌드박스 실행을 통해 재현성·채점 안정성을 검증한 뒤 60개 과제만 남김.
4. Experiments (실험)
4.1 주요 결과 (Table 2, 전체 18개 조합)
| 하네스 | 모델 | B1 | B2 | B3 | B4 | 전체평균 |
| Codex | GPT-5.5 (xhigh) | 57.57 | 35.28 | 29.29 | 30.46 | 38.15 |
| Codex | GPT-5.6 Sol (xhigh) | 62.75 | 42.96 | 40.86 | 40.74 | 46.83 |
| Codex | GPT-5.6 Sol (ultra) | 71.78 | 49.57 | 51.60(최고) | 50.41 | 55.84(최고) |
| Claude Code | Claude Opus 5 (단일 실행) | 72.29(최고) | 45.80 | 40.70 | 42.39 | 50.29 |
| Claude Code | Kimi K3 | 55.79 | 35.24 | 27.78 | 29.57 | 37.09 |
| Claude Code | Claude Opus 4.8 | 52.48 | 36.25 | 31.73 | 29.59 | 37.51 |
| Claude Code | GLM-5.3 | 63.05 | 35.45 | 33.09 | 35.01 | 41.65 |
| Claude Code | GLM-5.2 | 54.01 | 30.81 | 30.29 | 27.27 | 35.59 |
| Claude Code | DeepSeek V4 Flash | 51.85 | 26.49 | 24.84 | 24.41 | 31.90 |
| Claude Code | Kimi K2.7 | 44.43 | 23.84 | 19.75 | 21.34 | 27.34 |
| Claude Code | MiniMax M3 | 43.53 | 20.86 | 20.61 | 21.21 | 26.55 |
| Claude Code | DeepSeek V4 Pro | 42.97 | 18.79 | 19.20 | 18.94 | 24.98 |
| Claude Code | MiMo V2.5 Pro | 41.70 | 18.49 | 16.49 | 16.33 | 23.25 |
| Kimi Code | Kimi K3 | 56.16 | 34.05 | 28.15 | 26.53 | 36.22 |
| Kimi Code | Kimi K2.7 | 29.99 | 17.01 | 15.65 | 16.22 | 19.72 |
| MiMo Code | MiMo V2.5 Pro | 27.73 | 11.33 | 11.50 | 14.11 | 16.17 |
| OpenHands | DeepSeek V4 Flash | 50.60 | 24.89 | 21.91 | 24.99 | 30.60 |
| OpenHands | DeepSeek V4 Pro | 37.78 | 16.66 | 15.78 | 16.28 | 21.63 |
| 전체 평균(18개) | — | 50.91 | 29.10 | 26.62 | 26.99 | 33.41 |
세 가지 핵심 발견
① 자율적 과학 수행 능력은 여전히 제한적
가장 강력한 조합(Codex+GPT-5.6 Sol ultra)조차 B3(자율 조건)에서 51.60점에 그치고, 50점을 넘는 유일한 시스템입니다. 추론 강도를 xhigh→ultra로 올리면 B3가 40.86→51.60(+10.74)으로 개선되지만, 이는 역으로 "적당한 성능"에 도달하는 데도 상당한 추가 추론이 필요하다는 뜻이기도 합니다. 핵심 과제는 "주어진 절차를 실행할 수 있는가"가 아니라 "애초에 어떤 절차를 추구해야 할지 스스로 정할 수 있는가"입니다.
② 상세한 절차 안내에 대한 의존성
평균 성능은 B1(50.91)→B2(29.10)에서 21.82점 급락하는 반면, B2→B3(26.62)에서는 방법 자체를 제거해도 추가로 2.48점만 하락합니다. B4(26.99)도 B3와 거의 같습니다. 즉 병목은 "어떤 방법을 쓸지"보다 "그 방법을 완전한 절차로 구체화하는 것"에 있으며, 무관한 정보(방해 요소)의 영향은 상대적으로 미미합니다.
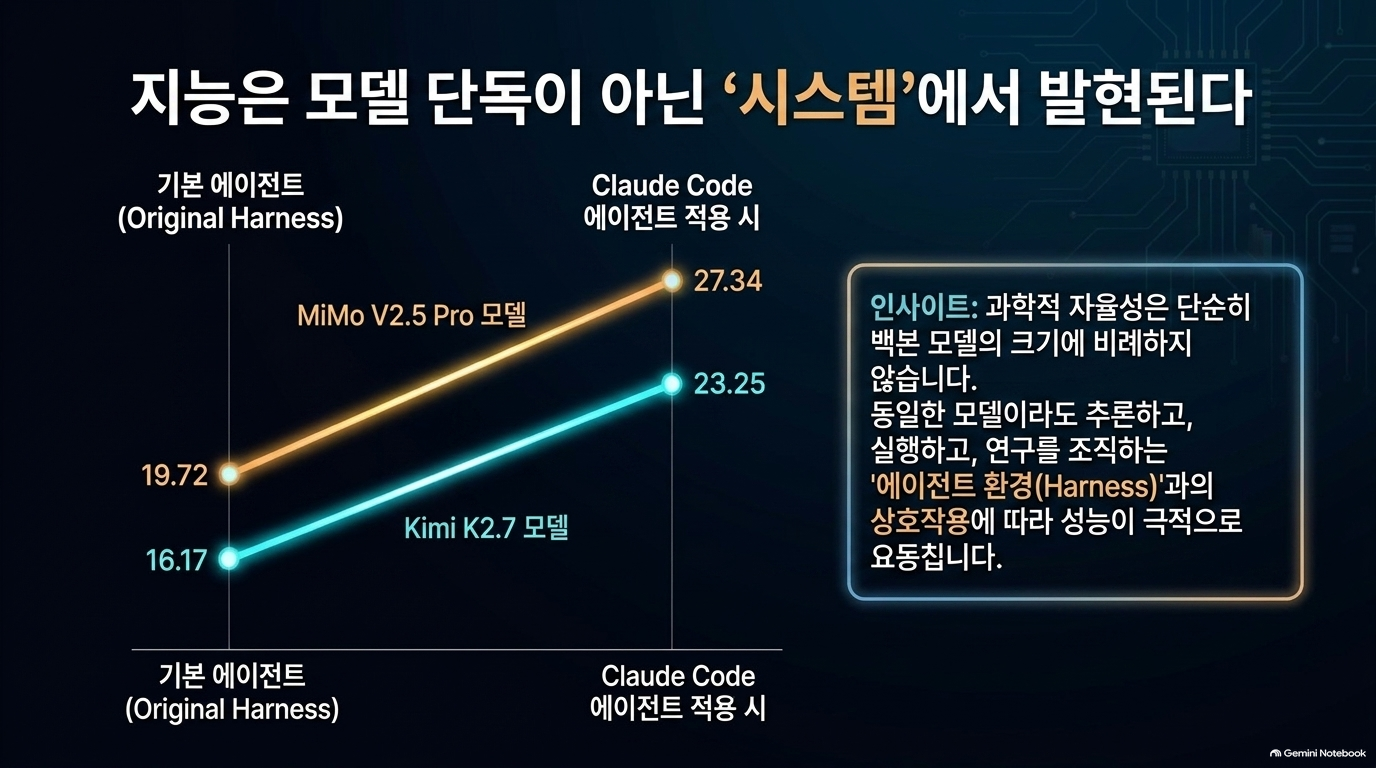
③ 하네스가 모델의 능력을 좌우함
동일 모델도 하네스(에이전트 프레임워크)에 따라 성능이 크게 달라집니다.
- MiMo V2.5 Pro: MiMo Code 16.17점 → Claude Code 23.25점
- Kimi K2.7: Kimi Code 19.72점 → Claude Code 27.34점
- 단, 균일하지 않음 — Kimi K3는 Kimi Code(36.22)와 Claude Code(37.09) 차이가 작음
과학적 능력은 백본 모델만으로 결정되지 않으며, 모델과 하네스의 상호작용에서 발현된다는 결론입니다.
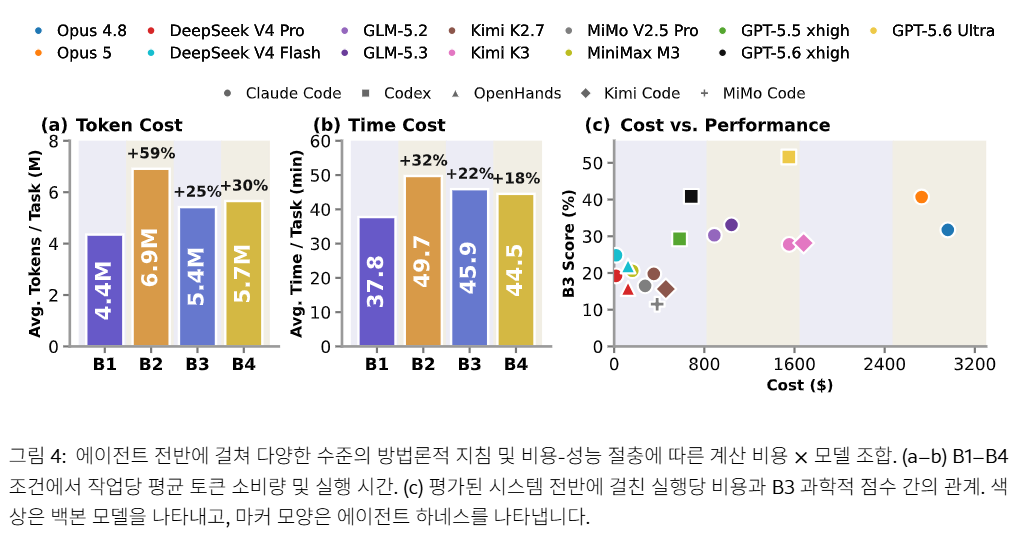
4.2 계산 비용 (Figure 4)
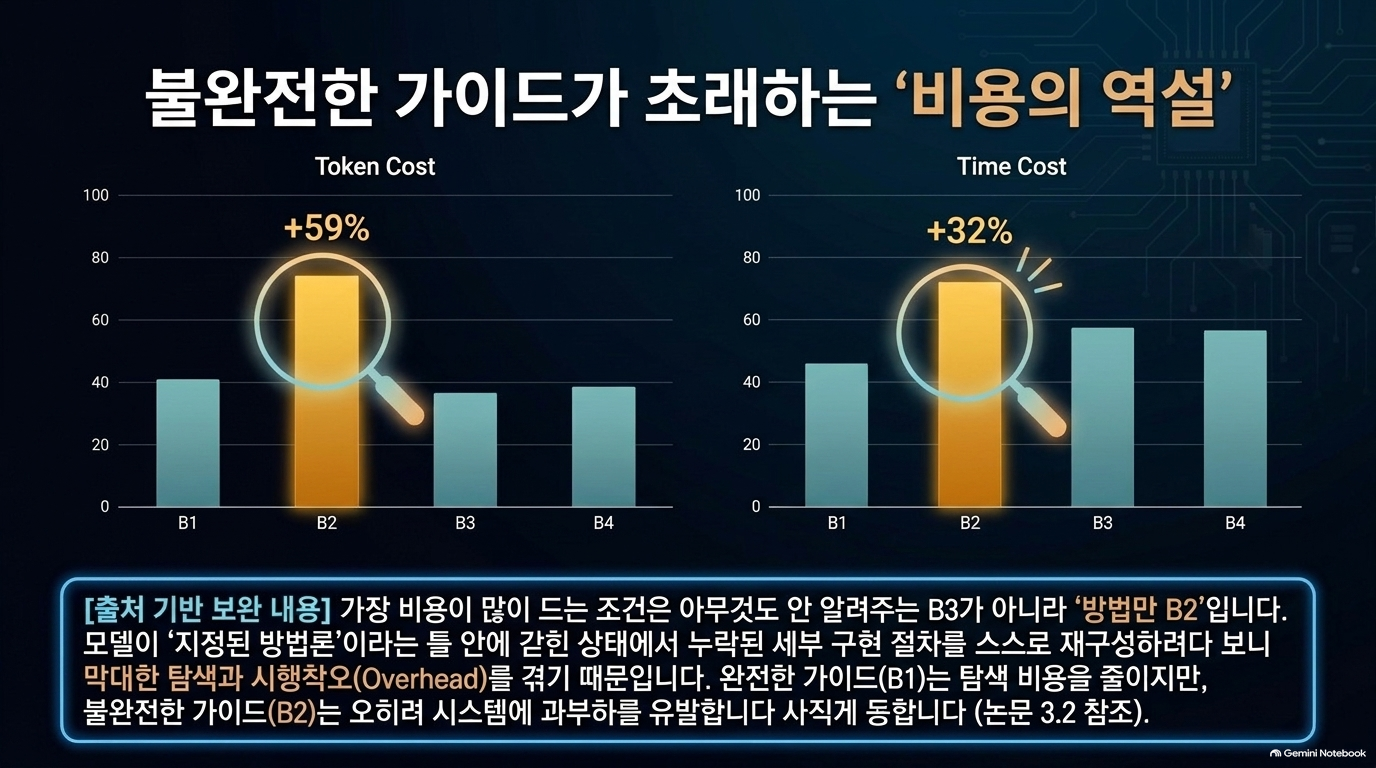
작업당 평균 비용: B1=토큰 435만/37.8분(가장 저렴) → B2=토큰 691만(+59%)/49.7분(+32%, 가장 비쌈) → B3=토큰 543만(+25%)/45.9분(+22%) → B4=토큰 570만(+30%)/44.5분(+18%)
완전한 안내는 계산 비용을 줄인다: 방법·구현·매개변수까지 명시하는 B1이 가장 저렴합니다. 흥미로운 점은 B2가 B3·B4보다도 더 비싸다는 것 — 방법 "이름만" 주어지면 에이전트가 정해진 방향에 묶인 채로 누락된 절차적 세부사항까지 재구성해야 해서 오히려 부담이 커집니다.
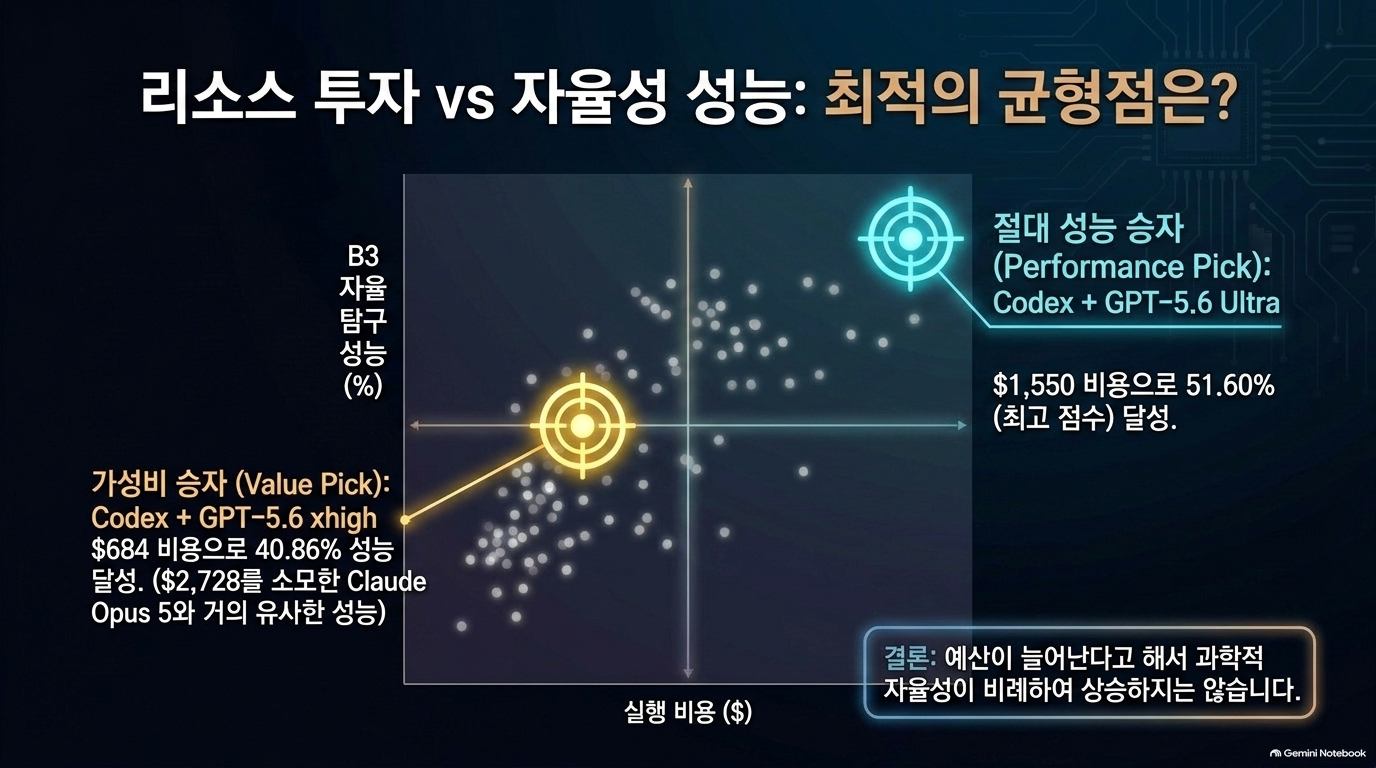
비용이 높다고 성능이 보장되지는 않는다: Codex+GPT-5.6 xhigh는 실행당 약 684달러로 B3 40.86%를 달성 — 실행당 2,728달러(약 4배)가 드는 Claude Opus 5+Claude Code의 40.70%와 거의 근접합니다. Codex+GPT-5.6 Ultra는 약 1,550달러로 최고점 51.60%를 기록합니다. 결론: GPT-5.6 xhigh가 비용 대비 성능 균형이 가장 좋고, 효율보다 최대 성능이 중요하면 GPT-5.6 Ultra가 낫습니다.
5. Conclusion (결론)
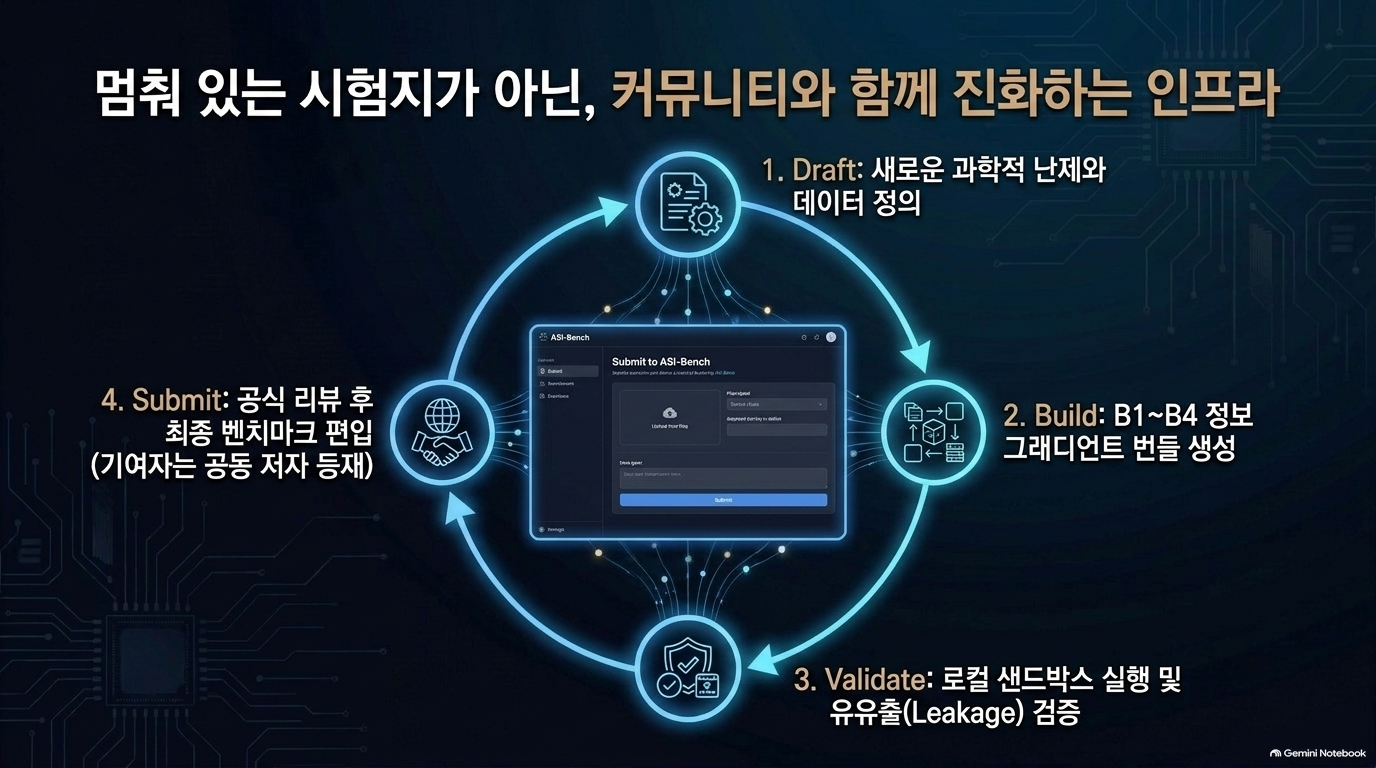
ASI-Bench는 단일 리더보드를 넘어 과학·AI 커뮤니티를 위한 공유 연구 인프라를 지향합니다. B1–B4 구조와 도메인별 분석은 모델·에이전트 간 통제된 비교를 가능케 하고, 어디서 진전이 일어나고 어디서 인간의 방법론적 안내가 여전히 필요한지 드러냅니다. 다만 어떤 고정된 벤치마크도, 단일 연구팀도 미래 AI가 마주할 어렵고 검증 가능한 문제들의 폭 전체를 대표할 수 없기에, ASI-Bench의 지속적 가치는 여러 분야 연구자들의 집단적 참여에 달려 있다고 강조합니다. 전 세계 과학자·엔지니어·에이전트 연구자들에게 연구 문제·과제·평가 방법·검증된 결과를 기여하고, AI 역량이 발전함에 따라 벤치마크 자체에도 도전해달라고 초대하며 마무리합니다.
부록 요약 (원문 확보 완료)
부록 A: 관련 연구
- AI 과학자 시스템: Coscientist(화학 분야 도구 활용), The AI Scientist(아이디어~논문 작성 통합), AI Scientist-v2(템플릿 의존 감소), Co-Scientist·Kosmos(협업적 장기 연구)를 개괄하되, 이런 시스템의 성공이 곧 "과학적 자율성"을 의미하진 않는다고 지적 — 목표·방법이 이미 인간이 정한 것일 수 있기 때문.
- 과학 에이전트 벤치마크: GPQA·HLE(지식 중심) → SciCode(과학 코딩) → DiscoveryBench·BLADE 등(데이터 기반 발견) → ScienceAgentBench·MLE-Bench·RE-Bench·PaperBench 등(더 긴 워크플로)으로 발전해왔지만, 대부분 과제가 고정 명세로 주어져 "워크플로를 완료했는가"는 보여줘도 "그 워크플로를 스스로 구성했는가"는 보여주지 못한다고 지적.
- 자율성-가이드 의존성: ScienceAgentBench(이진적 비교), ProjectionBench(가설 생성 초점), ProjectEval(소프트웨어 명세 다양화) 등 선행 시도가 있었지만, ASI-Bench처럼 동일 프로젝트 내에서 "정해진 방법 따르기"→"독립적 워크플로 구성"으로의 전환과 방해 요소 강건성까지 함께 측정하는 벤치마크는 없었다고 차별점을 제시.
부록 B/C: 저자·기여
21명의 연구자가 최종 채택된 과제를 기여했고, 5회 검토 라운드에서 1,100건 이상의 검토가 이루어짐. 커뮤니티 기여자는 asibench.apexin.ai/submit을 통해 새 과제를 제출할 수 있으며, 과제는 (1) 자명하지 않은 과학적 질문 정의 → (2) B1–B4 네 단계 프롬프트 구성 → (3) 로컬 테스트·제출·수정의 3단계를 거쳐야 함.
부록 D: 사례 연구 — "2D 비등방 강성 동역학" 과제를 예시로, 동일한 2차원 비선형 PDE 시스템 문제가 B1(방정식·수치기법·솔버까지 전부 명시) → B2(PDE 종류와 접근법 힌트만) → B3(관측 데이터와 목표만) → B4(B3 + 관련 없는 배경 정보와 그럴듯한 오답 힌트 몇 개 추가)로 정보량이 줄어드는 실제 프롬프트 예시를 제시. B4에는 일부러 "혹시 Cahn-Hilliard 아닐까?" 같은 그럴듯하지만 틀렸을 수 있는 메모까지 섞여 있어, 방해 정보에 흔들리지 않고 원래 데이터에 집중할 수 있는지를 시험함을 보여줍니다.

'07.AI > 7. AI 벤치마크' 카테고리의 다른 글
| 에이전트 AI - 벤치마크 - Artificial Analysis, Artificial Analysis Intelligence Index v4.3 (0) | 2026.09.10 |
|---|---|
| 에이전트 AI - 벤치마크 - Apodex Team, FrontierChallenge: 과학 워크플로 완료 평가 (0) | 2026.09.03 |
| LLM - 검색 증강 생성 (RAG) - AWS, AI Agent를 위한 OpenSearch 검색 품질 평가 (0) | 2026.08.28 |
| 에이전트 AI - 벤치마크 - EPOCH AI, 벤치마크 핵심 질문 9가지 (0) | 2026.08.17 |
| 에이전트 AI - 벤치마크 - PAST-Bench: 재귀적 자기개선(RSI) 기반 (0) | 2026.08.07 |