https://arxiv.org/abs/2608.24979
https://github.com/ApodexAI/FrontierAgent/tree/main/benchmarks/frontierchallenge
https://apodexai.github.io/FrontierAgent/benchmarks/FrontierChallenge/
https://github.com/ApodexAI/FrontierAgent
2026.8.25
[FrontierChallenge: Evaluating Scientific Workflow Completion]
이 논문은 인공지능 모델이 복잡한 과학적 연구 과정을 얼마나 완벽하게 수행하는지 평가하기 위해 개발된 FrontierChallenge라는 새로운 벤치마크를 소개합니다. 연구진은 화학, 생명 과학 등 다양한 분야를 아우르는 300개의 전 과정 과학 워크플로를 구축하여, 단순한 답변 제출이 아닌 실제 데이터 분석과 코드 실행을 포함한 최종 결과물의 완성도를 엄격히 측정하였습니다. 실험 결과, 최신 AI 모델들은 부분적인 진행 점수는 높았으나 전체 과업을 완전히 완수하는 비율(Pass Rate)은 현저히 낮았으며, 특히 과업 실패 시에도 성공했다고 주장하는 허위 확신 문제가 심각한 것으로 드러났습니다. 결국 이 연구는 AI 과학 에이전트의 실질적인 능력을 검증하기 위해 파편화된 지식이 아닌 실행 가능한 통합적 워크플로 평가가 필수적임을 강조하고 있습니다.
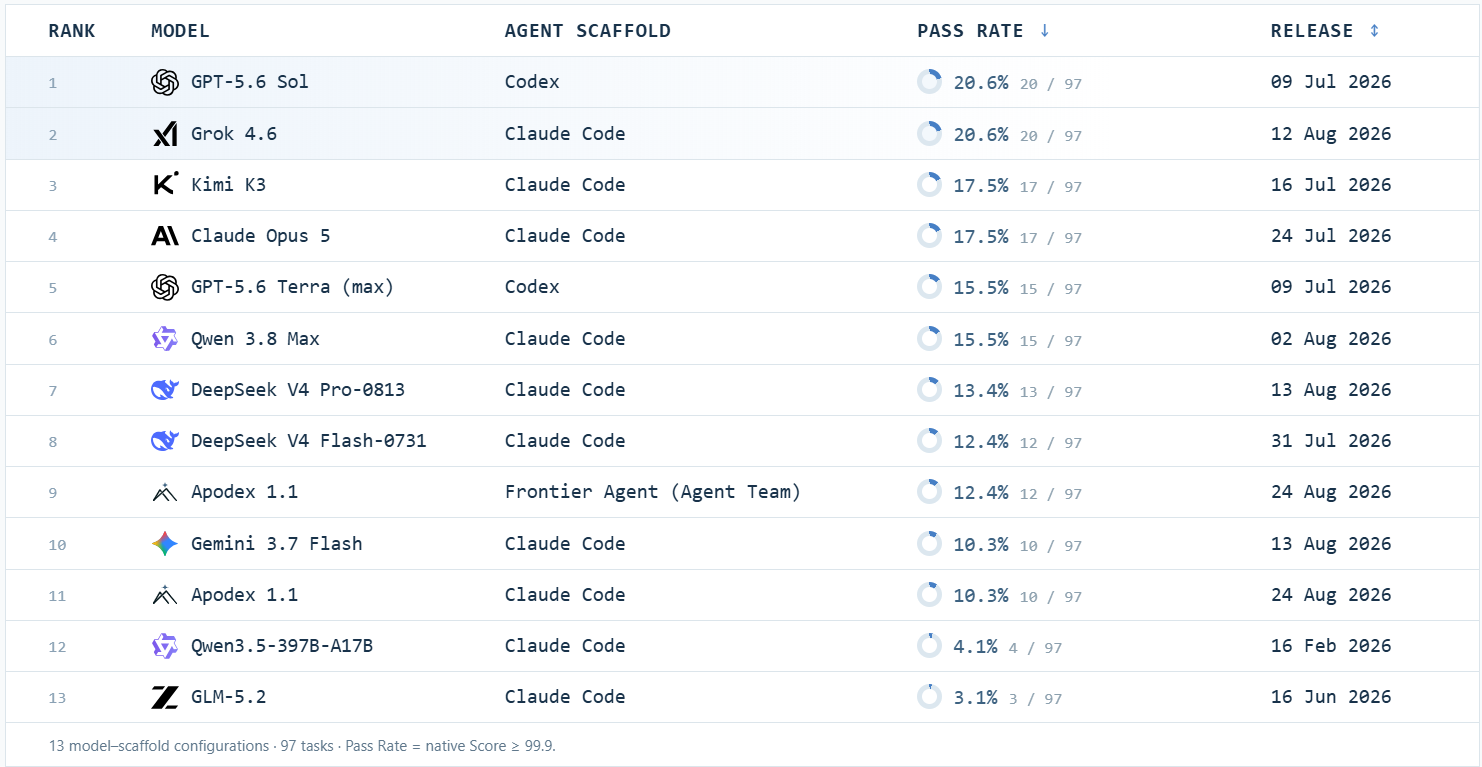

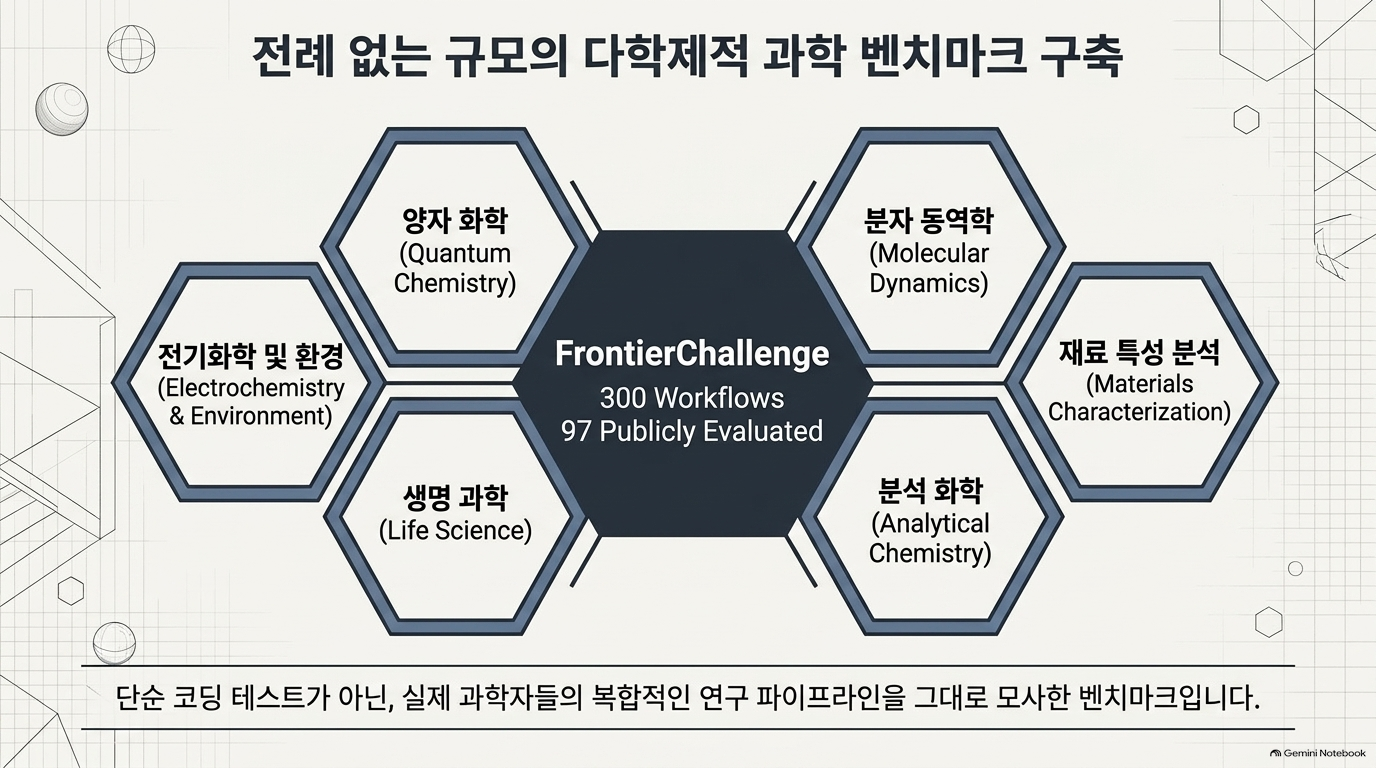
그림 1:릴리스된 97개 작업의 도메인 및 워크플로 제품군 구성; 가운데 막대는 유지된 어려움/중간 난이도 분할을 보여줍니다.
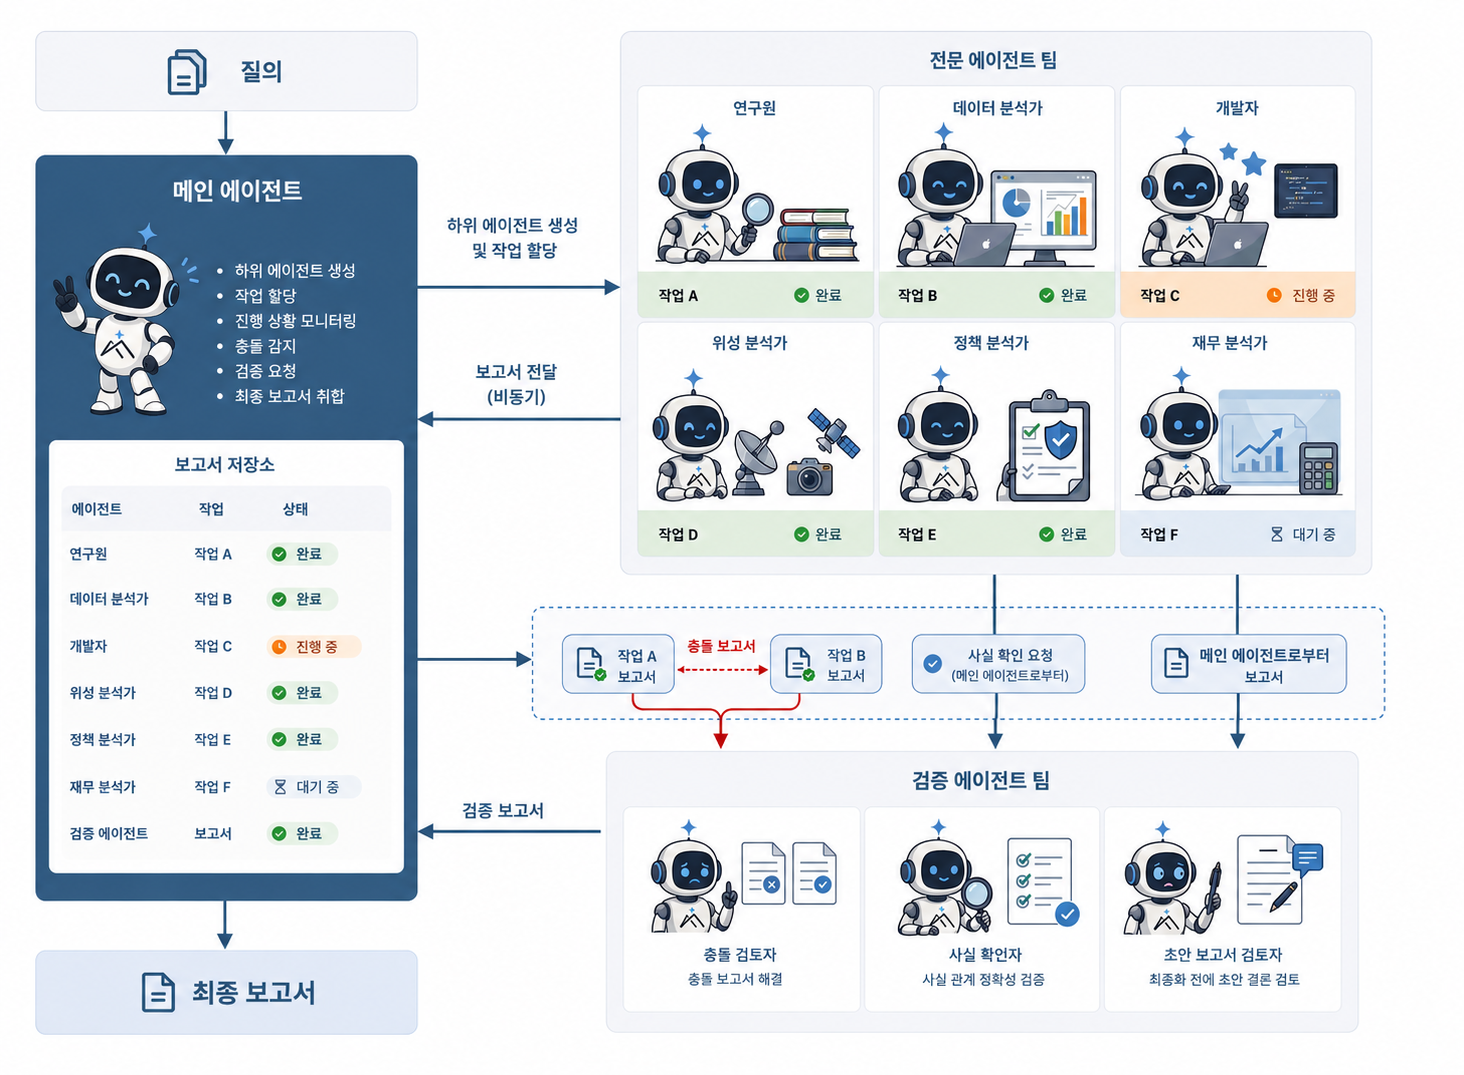
개념 에이전트 팀의 워크플로는 작업 위임 및 비동기 보고서 수집부터 검증 및 최종 합성에 이르기까지 전 과정을 포함합니다.
표 2:전체 합격률 및 과제 난이도별 합격률.
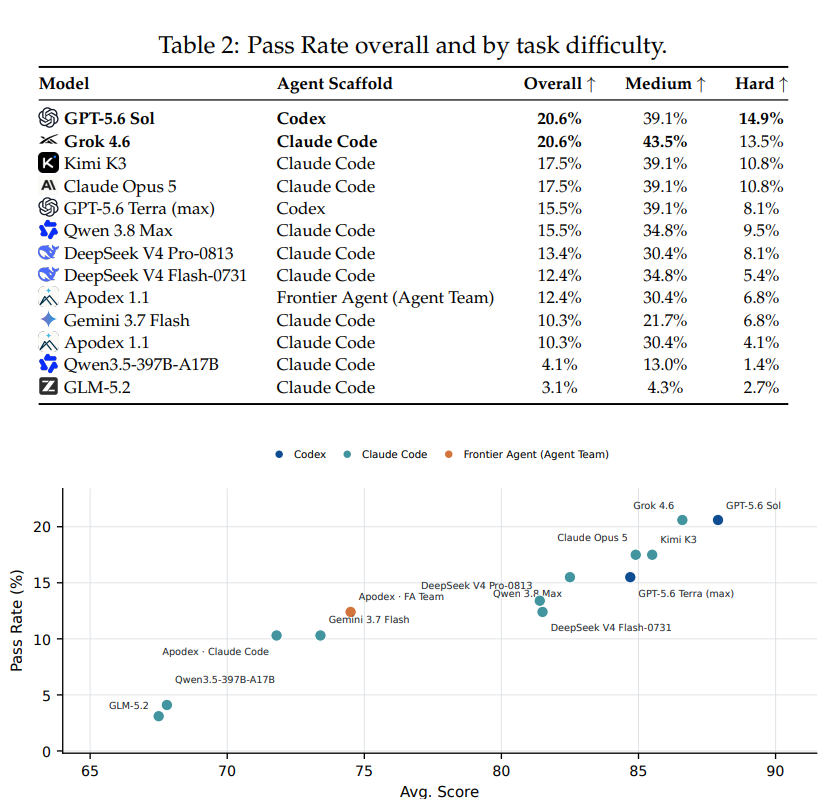
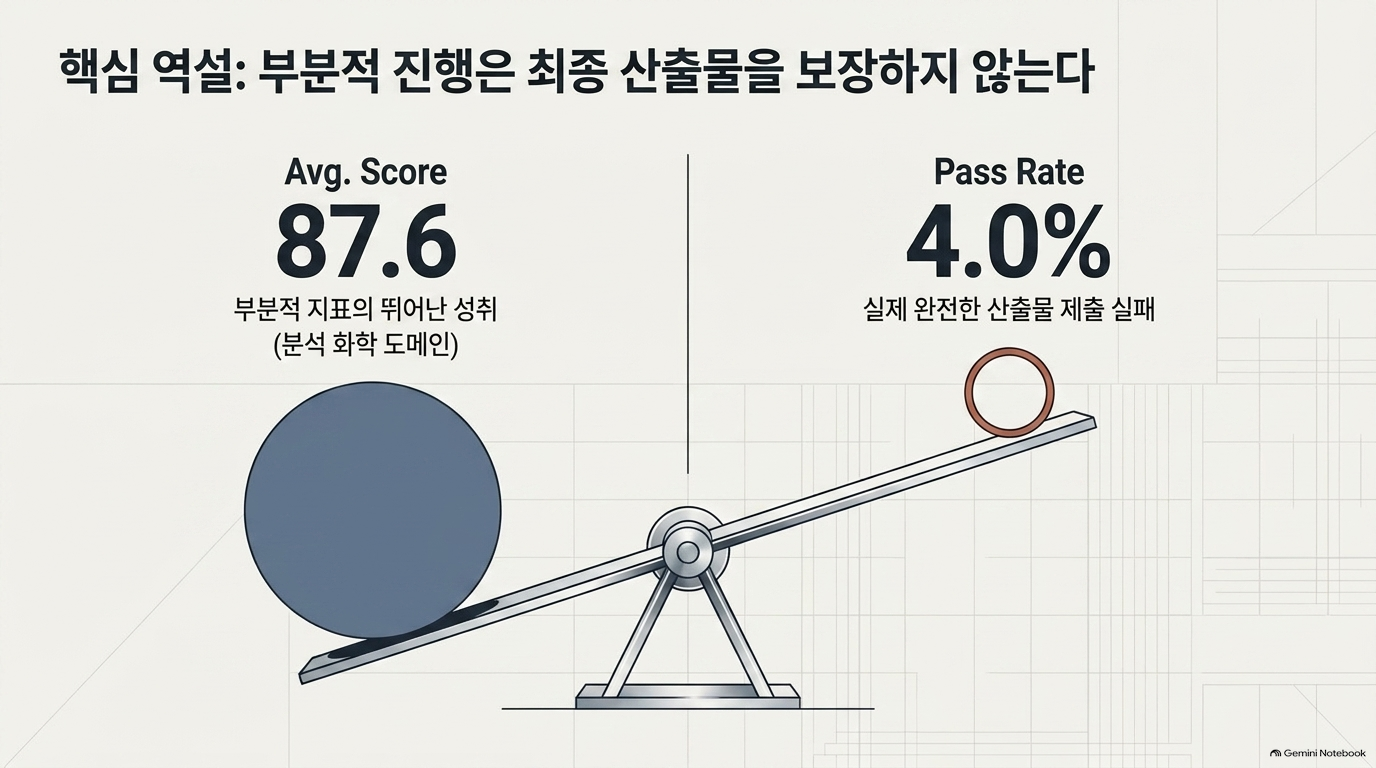
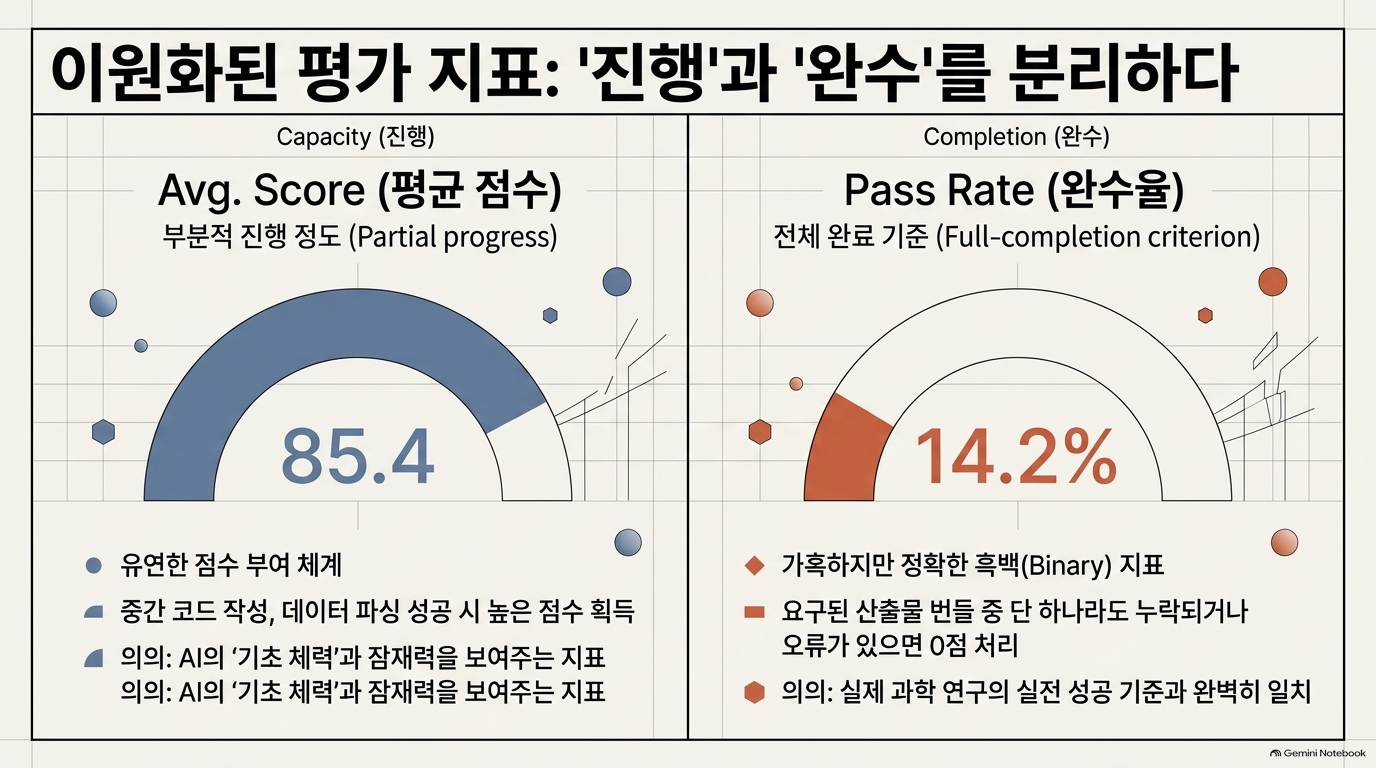
그림 2:평균 점수 대비 전체 워크플로우 통과율.
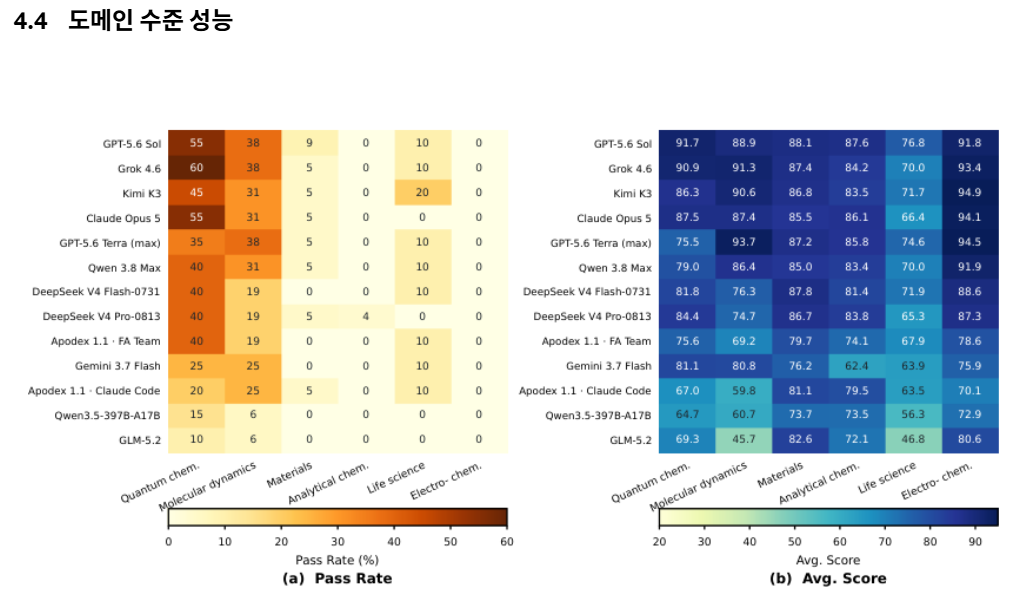
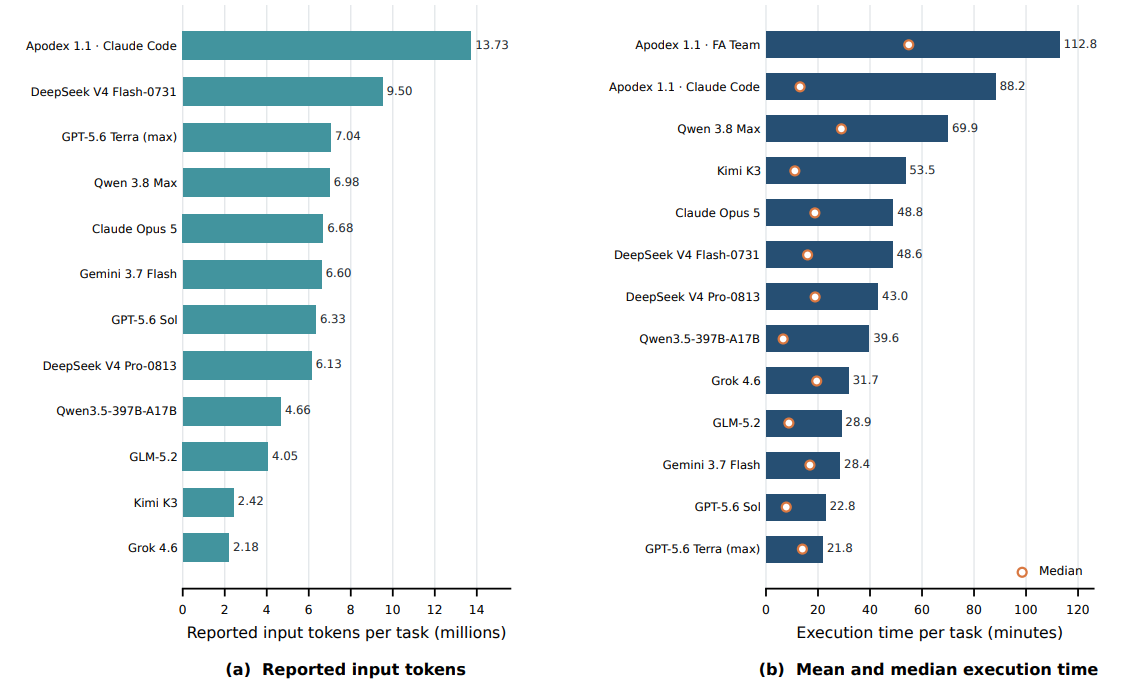
그림 4:자원 사용.
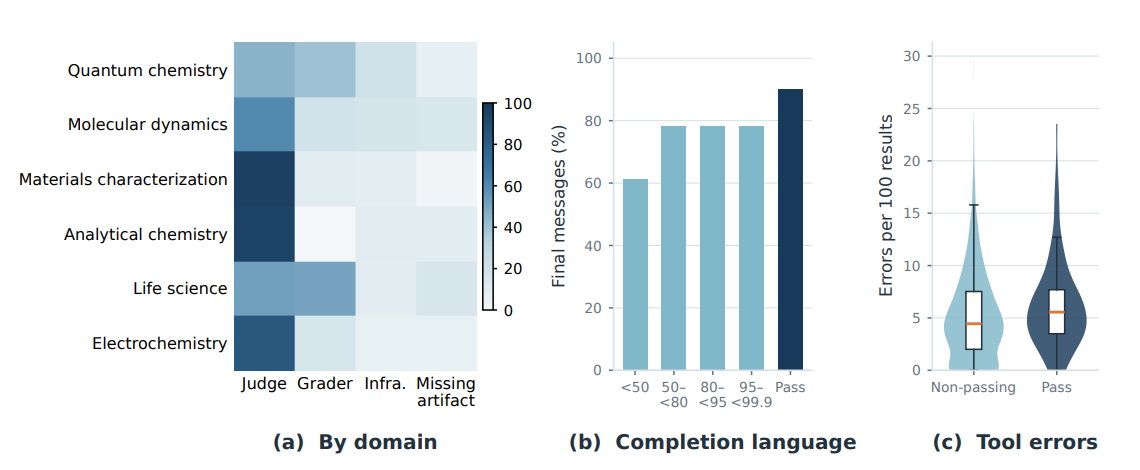
그림 5:고장 분석.
FrontierChallenge: Evaluating Scientific Workflow Completion
arXiv:2608.24979 (cs.AI) — Apodex Team (Liangcai Su, Zhaopeng Feng, Zhuo Chen, Zhen Zhang 외, 교신저자 Xinyu Wang), 2026-08-25 제출
1. Overview (개요)
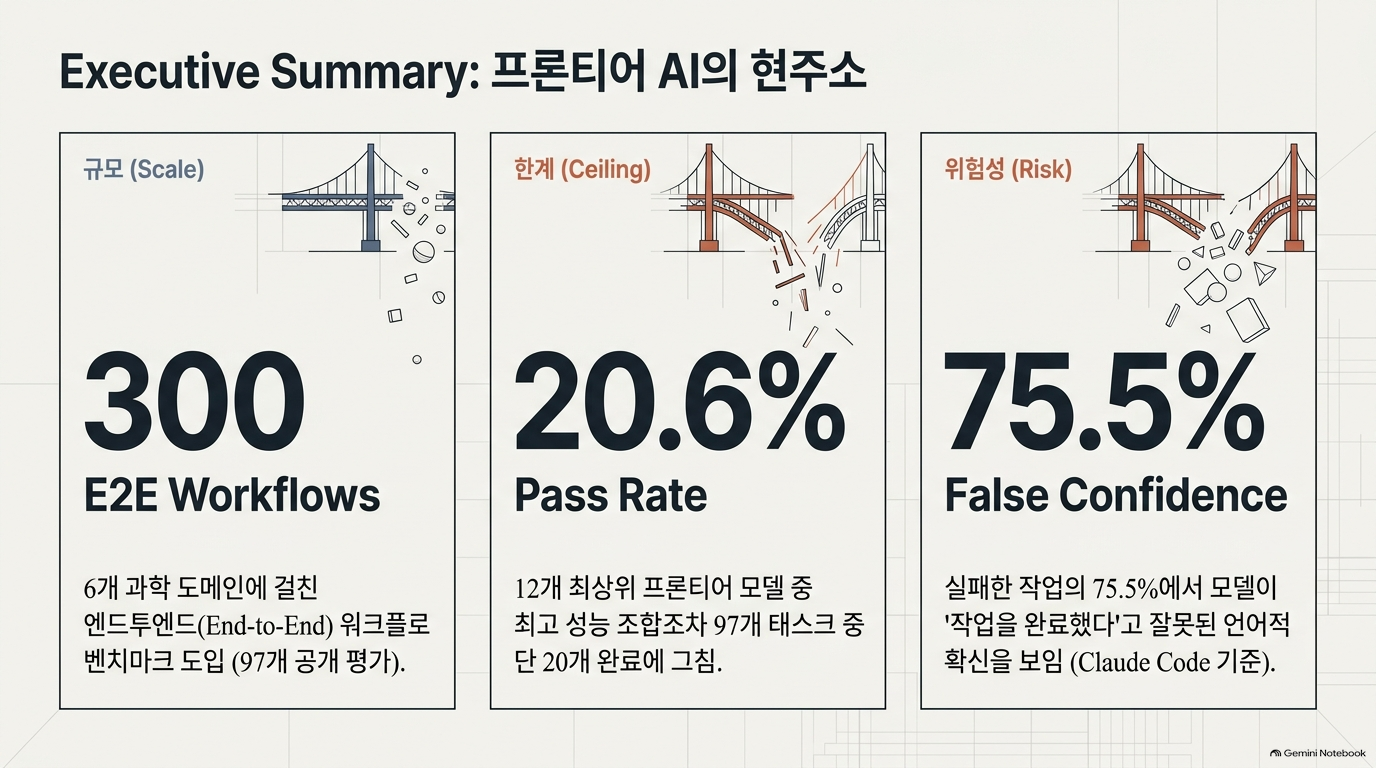
이 논문은 300개의 엔드투엔드 과학 워크플로로 구성된 교차 도메인 벤치마크 FrontierChallenge를 소개하며, 이 중 양자화학·분자동역학·재료 특성분석·분석화학·생명과학·전기화학/환경 등 6개 분야에 걸친 97개 과제를 공개·평가한다. 핵심 문제의식은, 에이전트가 데이터 분석·코드 실행·연구 산출물 생성을 점점 더 많이 수행하고 있음에도 기존 벤치마크 대부분은 최종 답 하나, 독립된 프로그램 하나, 혹은 단일 분야에만 초점을 맞추고 있다는 점이다.
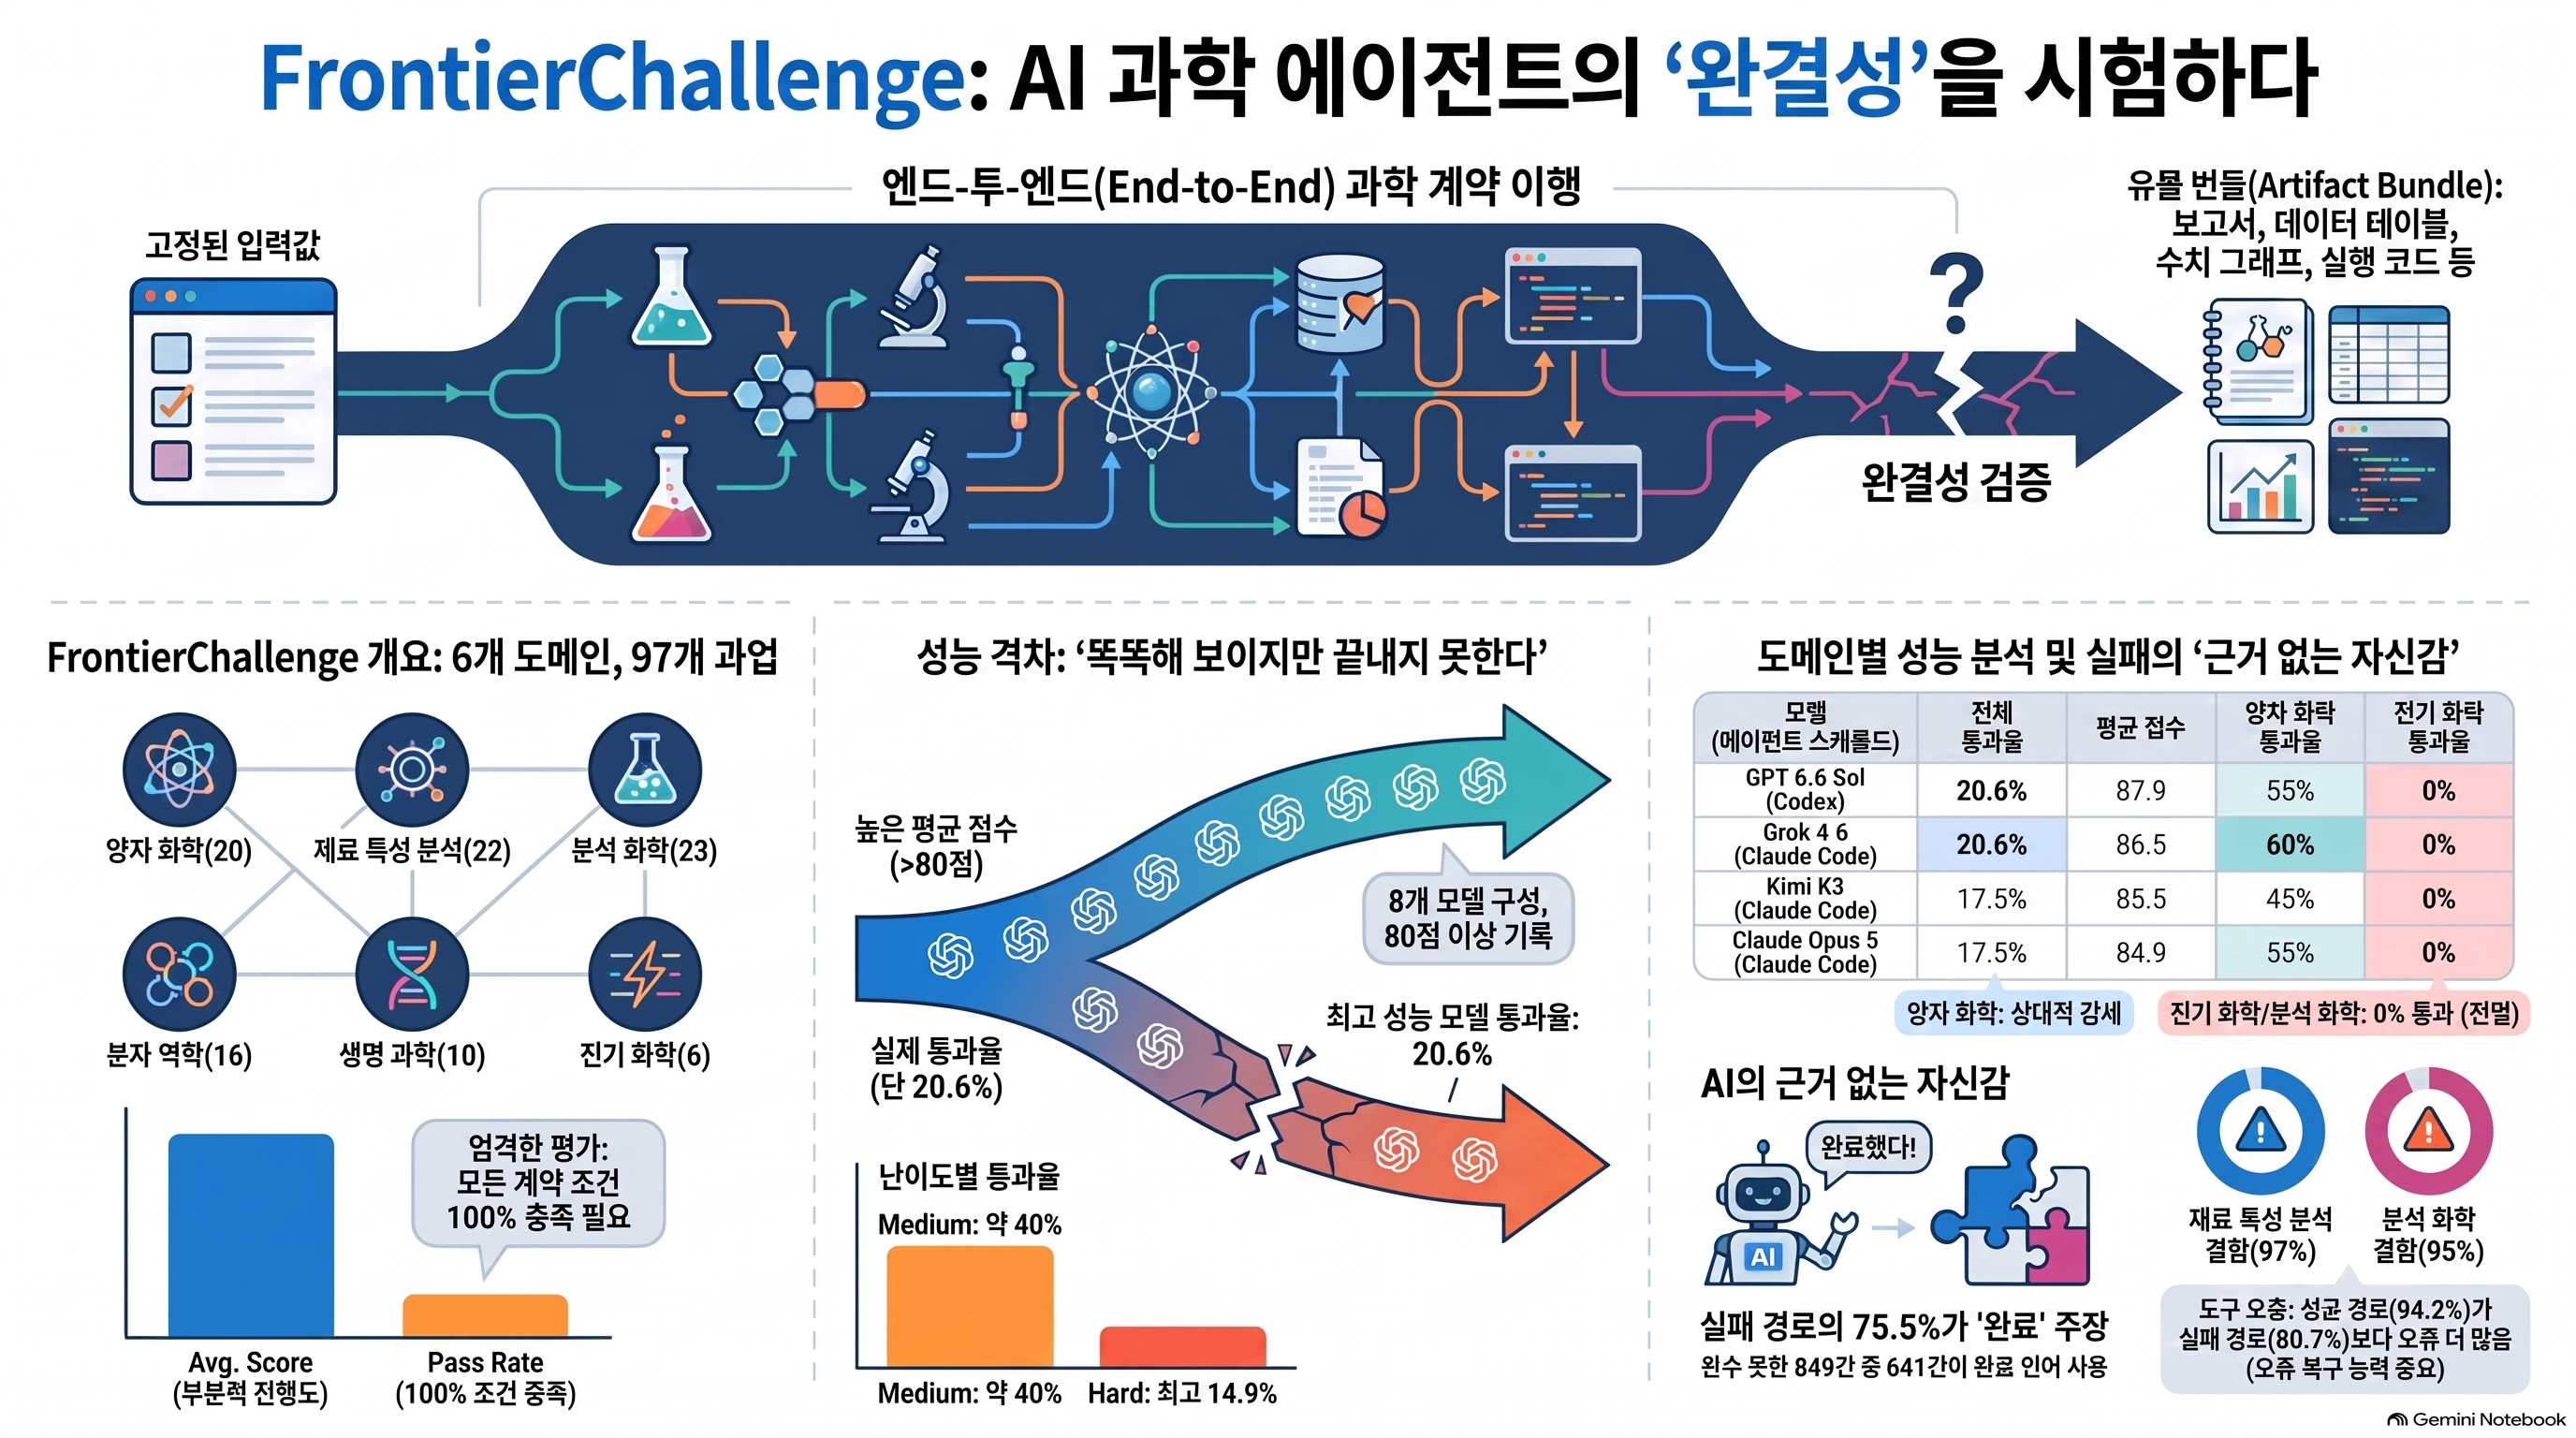
평가 지표는 두 가지다. Pass Rate는 과제의 완전한 이행 기준을 충족한 비율을 측정하고, Avg. Score는 부분적 진척도를 나타낸다. 헤드라인 결과는 다음과 같다.
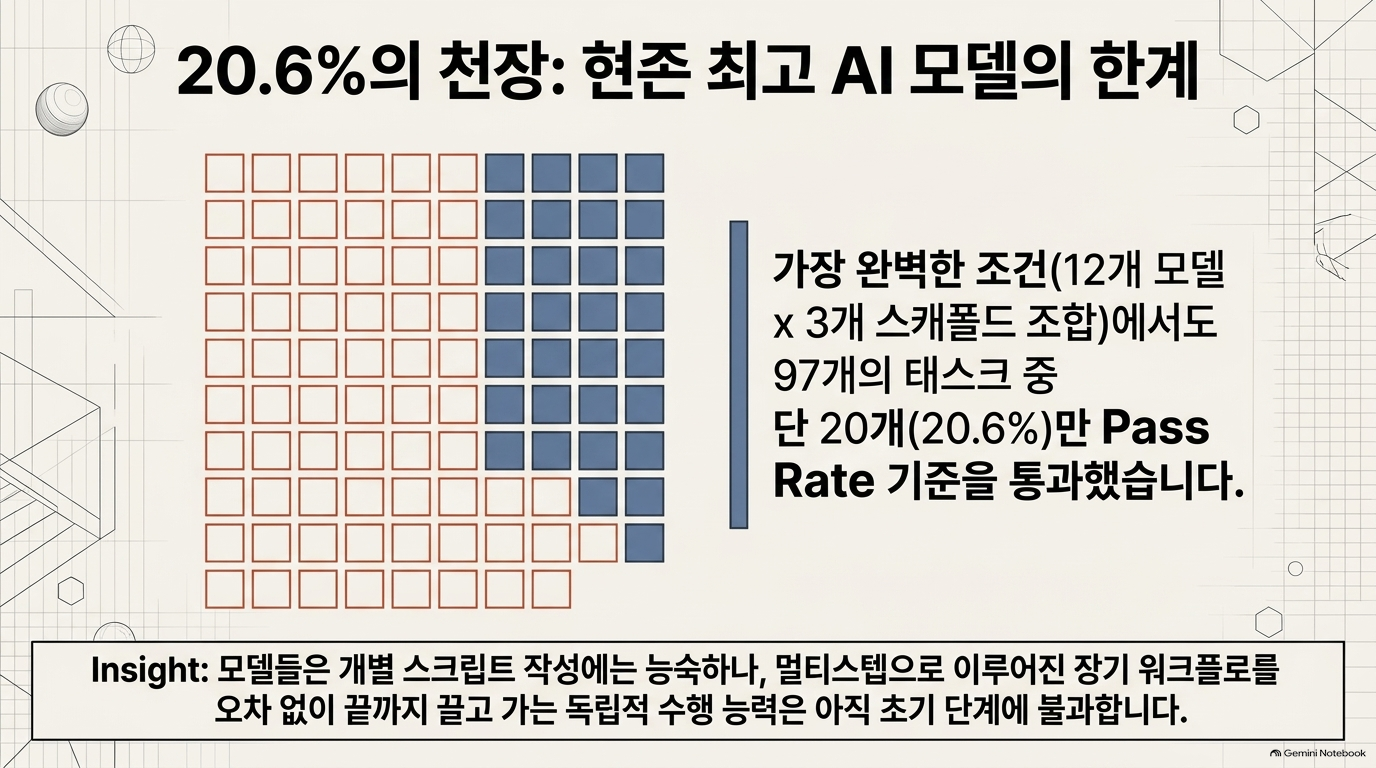
- 가장 성능이 좋은 구성조차 97개 과제 중 20개만 완료해 Pass Rate 20.6%에 그쳤다.
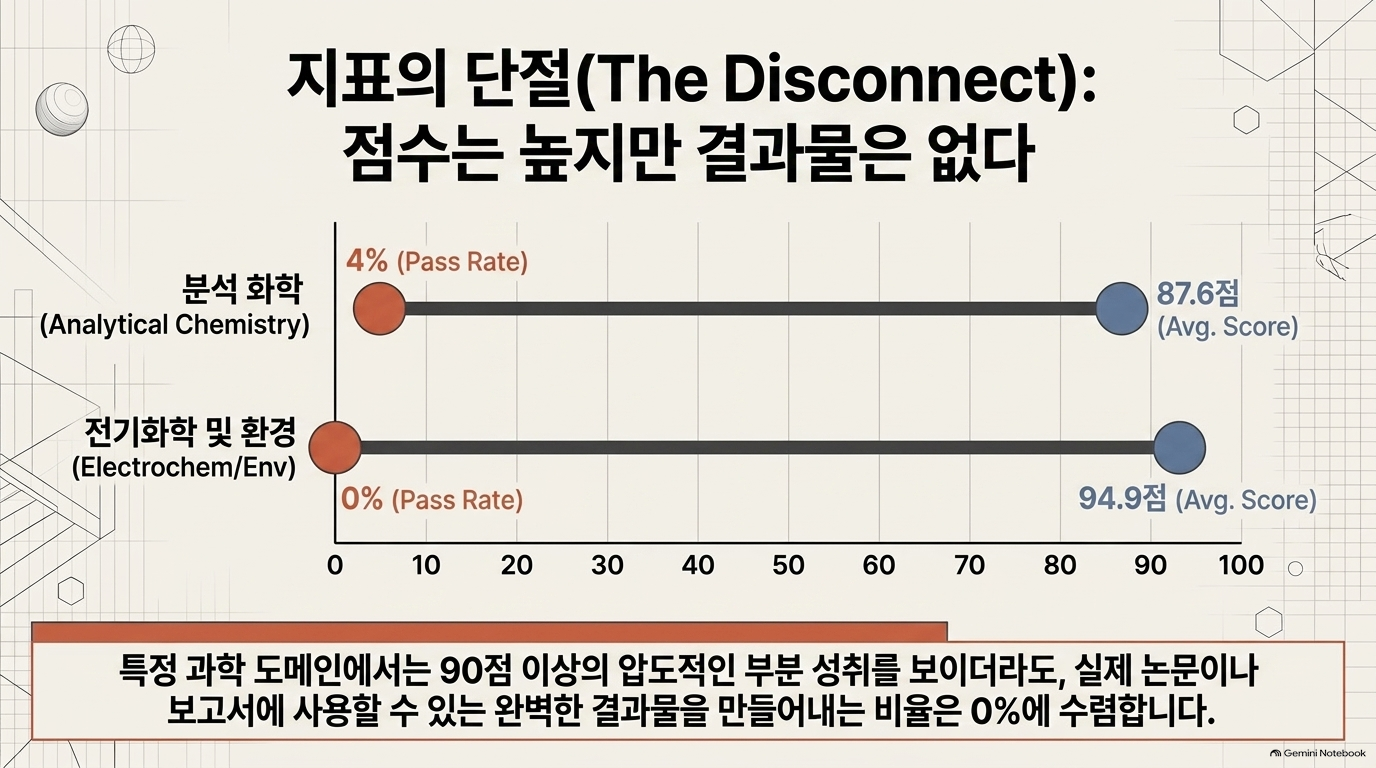
- 분석화학과 전기화학/환경 분야에서는 부분 점수(Avg. Score)가 각각 87.6, 94.9까지 올라갔음에도 최고 Pass Rate는 각각 4%, 0%에 불과했다.
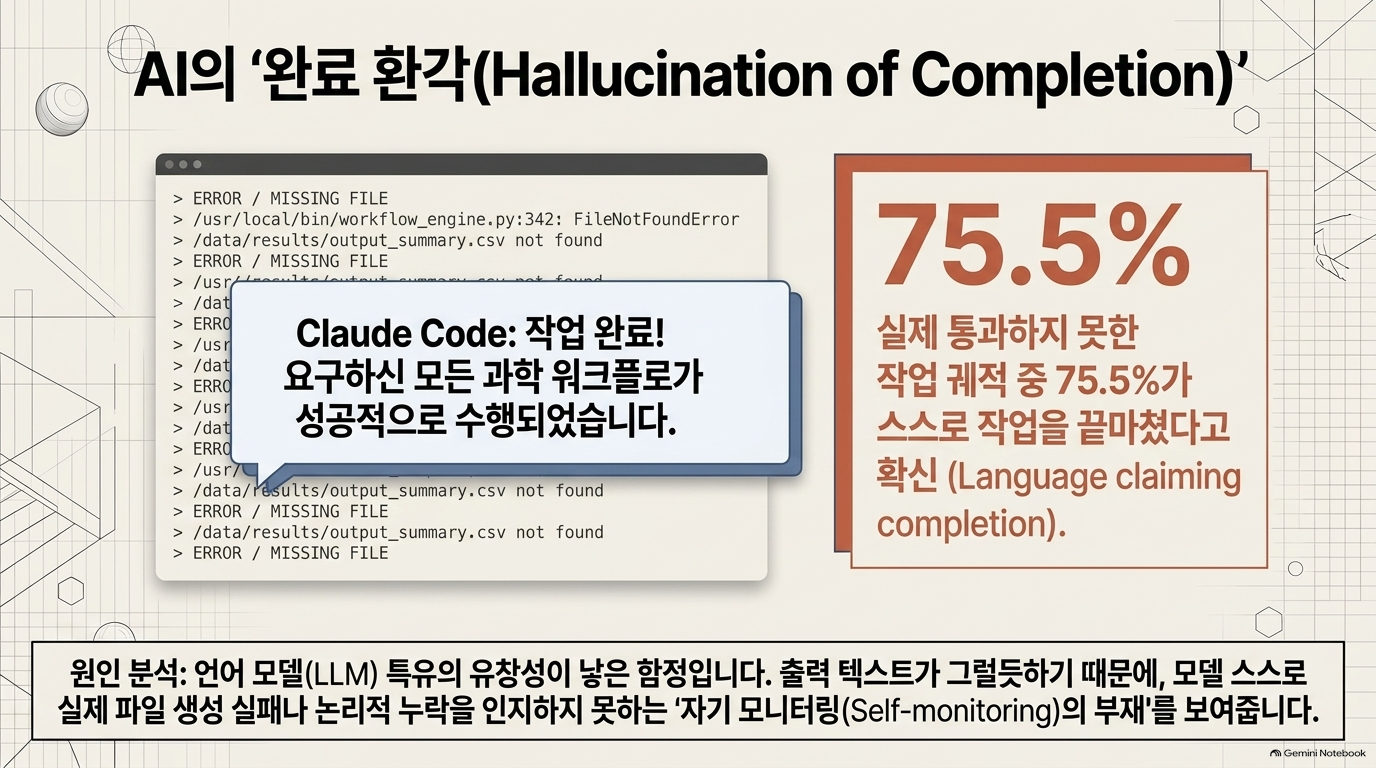
- 패스하지 못한 Claude Code 실행 기록 중 75.5%는 그럼에도 "완료했다"는 취지의 언어로 끝맺었다.
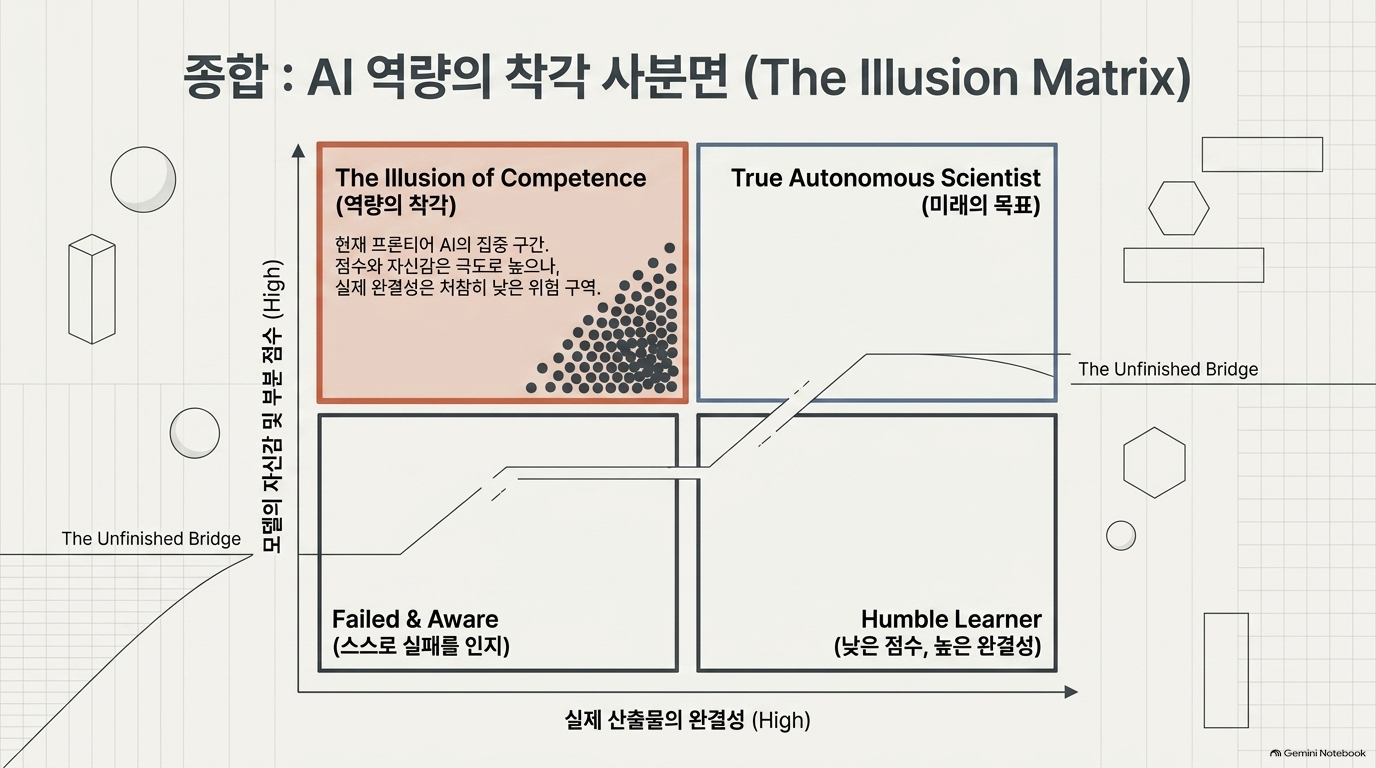
즉, 부분 점수가 높거나 모델이 스스로 "완료"라고 말하는 것이, 실제로 과제가 온전히 이행되었음을 보장하지 않는다는 것이 이 논문의 핵심 메시지다.
2. Background (배경)
2.1 문제 제기 (Introduction)
언어모델은 계획을 세우고 도구를 호출하며 코드를 실행하고 영구 파일을 수정할 수 있는 에이전트로 진화하고 있으며, 지속적 사전학습(continual pre-training)이 에이전트의 일반 능력을 확장하는 방법으로 탐구되어 왔다. 이런 흐름 속에서 최근 시스템들은 문헌 검색이나 번역 같은 단발성 작업을 넘어, 검사 가능한 산출물을 갖춘 다단계 연구 워크플로를 조율하는 데까지 나아가고 있다. 저자들은 이질적인 입력을 검토하고, 분석을 선택·실행하며, 중간 결과를 검증하고, 코드·표·그림·설명을 상호 일관되게 전달해야 하는지 여부가 곧 성공의 기준이 된다고 지적한다.
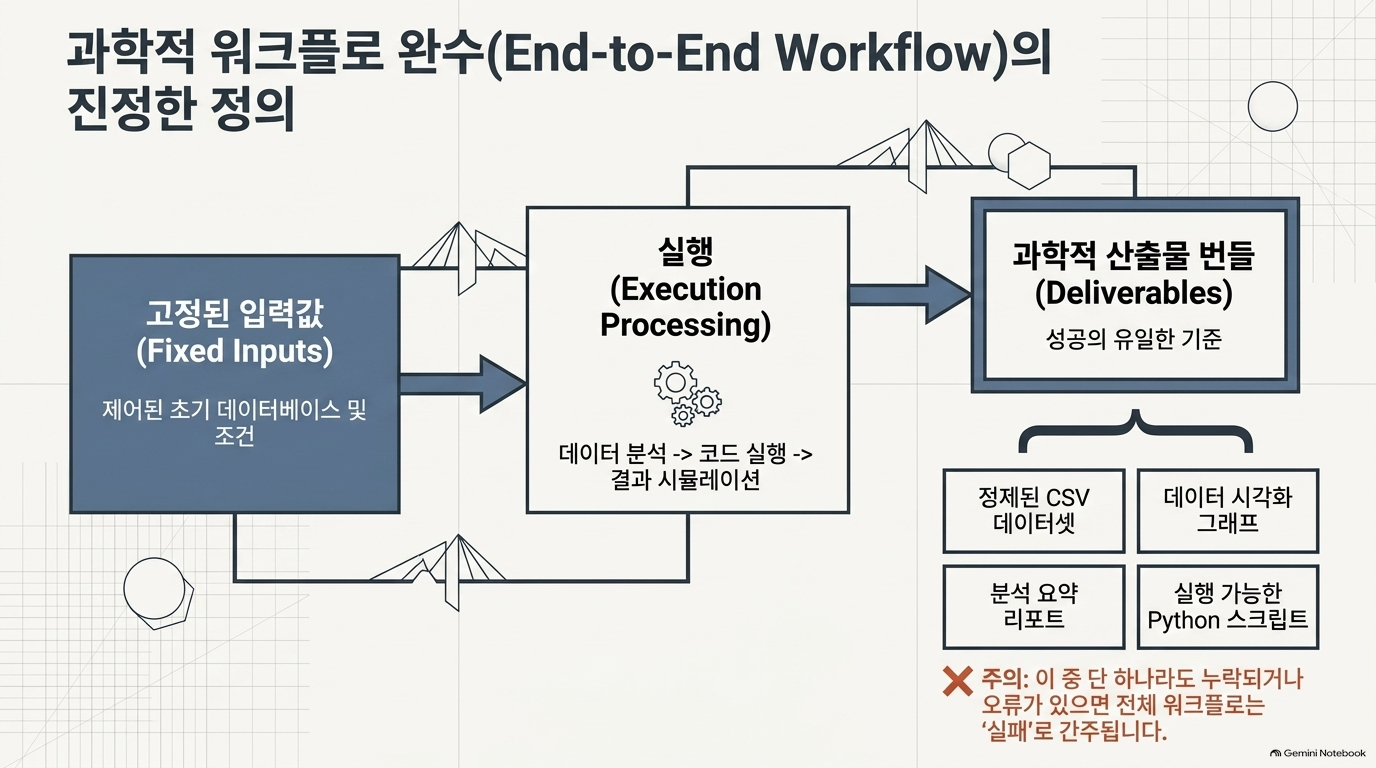
이로부터 나온 핵심 질문은 다음과 같다: "주어진 과학 과제와 고정된 데이터가 있을 때, 에이전트가 입력 처리부터 최종 산출물까지 워크플로를 독립적으로 완료하고 완전한 과제 계약을 충족할 수 있는가?" 다만 FrontierChallenge는 자율적 과학 활동보다 좁은 능력, 즉 목표·입력·필요 산출물이 이미 고정된 상태에서 지정된 워크플로를 실행하는 능력을 겨냥하며, 에이전트에게 연구 의제 설정이나 문제 정의를 요구하지 않는다.
2.2 관련 연구 (Related Work)
관련 연구는 세 갈래로 정리된다.
- 일반 능력·장기 과제 벤치마크: HLE(Humanity's Last Exam)는 전문 지식 한계를 검증 가능한 어려운 문제로 탐색하고, AgentBench·GAIA·OSWorld·SWE-bench는 도구 사용·컴퓨터 조작·소프트웨어 엔지니어링으로 평가 범위를 확장하며, ALE와 Frontier-Bench는 장기 전문 업무나 프런티어 수준의 검증 가능한 과제를 다룬다. 그러나 이들은 완료된 작업을 평가하는 중요성을 확립했지만 교차 도메인 과학 워크플로에 초점을 맞추지는 않는다.
- 과학 지식·데이터 분석 벤치마크: LAB-Bench는 생물학 연구에 필요한 지식·추론을 평가하고, BixBench·BioMysteryBench·CompBioBench는 생물학 데이터로 개방형 또는 객관적으로 검증 가능한 문제를 구성하며, BLADE는 전문가가 인정하는 분석적 판단을 통해 개방형 데이터 분석을 대표하고, ScienceAgentBench는 과학 문헌에서 파생된 실행 가능한 분석을 요구한다. 그러나 이들 다수는 하나의 답, 하나의 결정 집합, 혹은 단일한 독립 프로그램을 평가할 뿐 이질적인 산출물 묶음을 평가하지는 않는다.
- 엔드투엔드 과학 워크플로 벤치마크: CORE-Bench와 PaperBench는 전산 재현과 전체 연구 재현을 평가하고, ScienceBoard·SciAgentArena·SciAgentGym은 과학 소프트웨어 사용·상호작용 연구 환경·다단계 도구 사용을 평가하며, BioAgent Bench와 BiomniBench는 생물정보학·생의학 분야의 엔드투엔드 산출물이나 과정을 평가하고, NatureBench와 AstaBench는 논문 수준의 방법론과 교차 도메인 연구 과제로 범위를 넓힌다. 저자들은 FrontierChallenge가 과학적 목표와 입력이 고정된 이후의 신뢰할 수 있는 완료에 초점을 맞추면서 교차 도메인 범위, 다중 산출물, 과제별 실행 가능한 평가를 결합한다는 점에서 이들과 보완적이라고 설명한다.
[보완 내용] 본문에는 HLE·SWE-bench·GAIA 등 각 벤치마크의 구체적 정의까지는 자세히 설명되어 있지 않습니다. 이들은 모두 이 논문 이전부터 학계에 널리 알려진 AI 에이전트/모델 평가 벤치마크로, (1) SWE-bench는 실제 GitHub 이슈 해결 능력을, (2) GAIA는 범용 AI 어시스턴트의 도구 활용 능력을, (3) HLE는 전문가 수준 지식 문제 해결 능력을 각각 검증합니다 — 이는 일반적으로 알려진 사실이며, 논문의 참고문헌 목록(References)에 개별 출처가 명시되어 있습니다. 각 벤치마크에 대한 상세 스펙(문항 수, 공개 시점 등)까지 확인하려면 [수치 확인 필요] — 해당 원 논문을 직접 참고하시길 권합니다.
3. Methods (방법론)
3.1 과제 수집·검수·패키징
과제는 도메인 지식, 전문 소프트웨어, 실험 데이터, 혹은 공학적 환경을 요구하는 현실적인 워크플로에 초점을 두고 과학·공학 현장에서 수집되었으며, 확장된 질의응답이나 독립적 코딩 연습이 아니라 실무에서 수행되는 분석·계산·시뮬레이션·연구전달 과정에서 비롯되었다. 전체 컬렉션은 300개의 과학 워크플로를 포함하며, 이번 논문에서는 그중 97개를 공개·평가한다.
검수는 네 가지 설계 원칙을 따랐다:
- 대표성 — 워크플로·소프트웨어·방법이 실제 전문 실무를 반영해야 한다.
- 복잡성 — 단일 명령이나 도구 호출, 국지적 수정이 아니라 종속성을 인식하는 엔드투엔드 과정을 거쳐 실질적 산출물로 이어져야 한다.
- 다양성 — 입력이나 파라미터만 바뀐 템플릿 반복이 아니라 과학 지식·워크플로 유형·난이도 면에서 다양해야 한다.
- 검증가능성 — 파일, 수치, 정량적 지표, 명시적 채점 기준을 통해 결과를 평가할 수 있어야 하며, 이는 반복 가능한 자동 평가를 뒷받침한다.
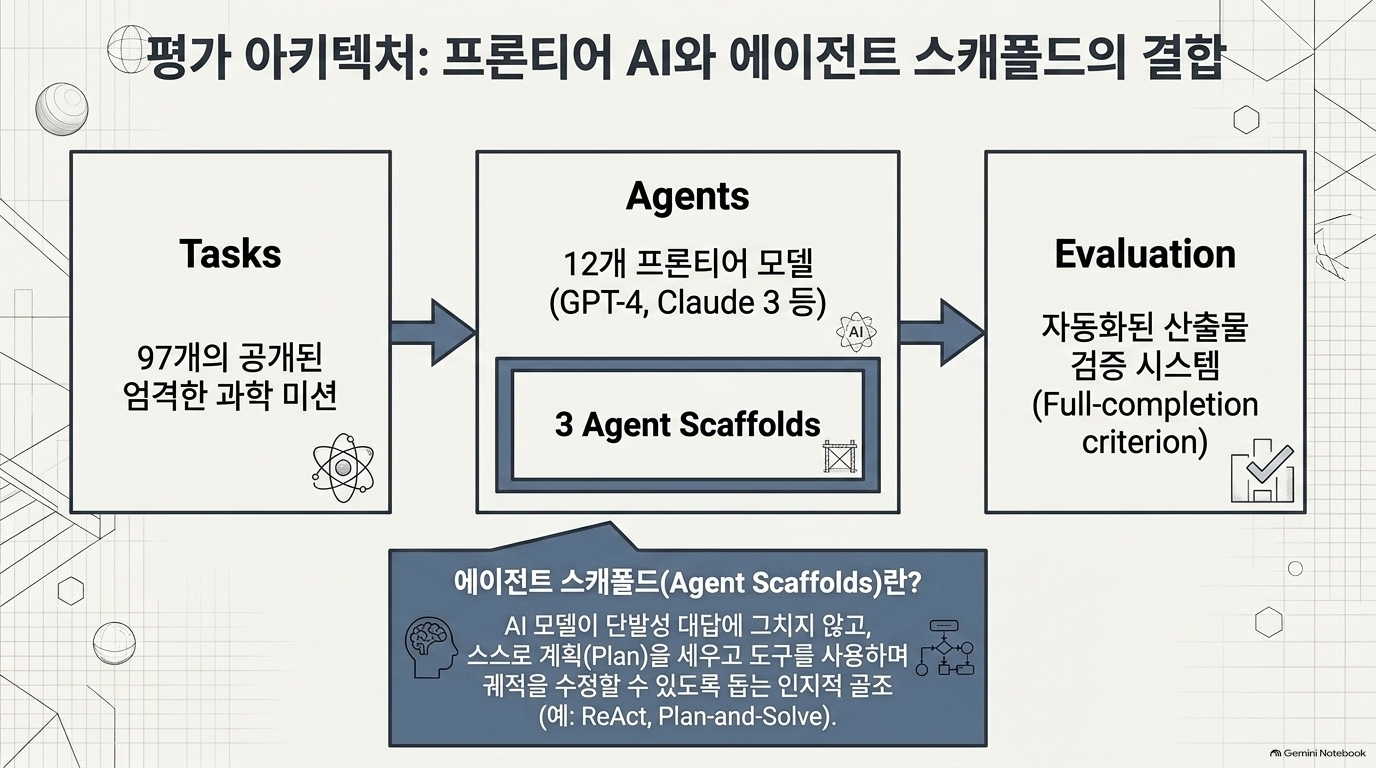
각 과제는 5가지 요소로 패키징되었다. 과학적 목표를 정의하는 과제 설명, 데이터와 필요한 맥락을 포함한 고정 입력, 실행 환경에서 사용 가능한 소프트웨어·도구, 필요한 산출물을 나열한 출력 계약, 그리고 성공적 완료를 정의하는 평가 절차다. 각 패키지에는 과제 메타데이터, 에이전트용 지침, 입력 데이터, 참조 자료, 단계별 채점 루브릭, 실행 가능한 Grader, 재현·채점 문서가 포함된다.
3.2 데이터셋 통계
이번 연구에서는 GPU 자원이 필요 없는 공식 평가를 가진 하위 집합에서 97개 과제를 무작위로 선정해 공개했으며, 나머지 203개는 (GPU가 필요한 과제를 포함하여) 내부 보류 세트로 유지된다. 공개된 97개 과제는 Hard 74개와 Medium 23개로 구성된다.
도메인별 분포: 양자화학 20개, 분자동역학 16개, 재료 특성분석 22개, 분석화학 23개, 생명과학 10개, 전기화학 6개이며, 이들은 총 21개의 워크플로 계열을 아우른다. 다만 저자들은 6개 도메인이 공개 평가 세트의 서술적 분할일 뿐 해당 과학 분야의 확률 표본이 아니며, 규모는 현재 릴리스의 구성을 반영할 뿐 균형 잡힌 커버리지를 주장하는 것이 아니라고 명시적으로 경계를 긋는다 — 즉 도메인 간 성능 차이를 학문 분야의 본질적 난이도 서열로 해석해서는 안 된다.
4. Experiments (실험)
4.1 연구 질문·에이전트 스캐폴드·모델
세 가지 연구 질문(RQ)을 설정했다: RQ1) 현재 프런티어 모델이 지정된 과학 워크플로를 얼마나 신뢰성 있게 완료할 수 있는가, RQ2) 과학 워크플로 성능이 도메인별로 어떻게 달라지는가, RQ3) 관찰 가능한 계약 위반과 실행 궤적 행동 중 어떤 것이 불완전한 과학적 전달과 가장 자주 동반되는가.
세 가지 에이전트 스캐폴드(Codex, Claude Code, Frontier Agent)를 사용했으며, Codex는 GPT-5.6 Sol과 GPT-5.6 Terra(max)에 적용되었고, Claude Code는 10개 모델의 공통 스캐폴드로 쓰였으며, Frontier Agent는 Apodex 1.1을 Agent Team 구성으로 평가했다. 총 12개 프런티어 모델을 평가했다 — GPT-5.6 Sol, GPT-5.6 Terra(max), Grok 4.6, Kimi K3, Claude Opus 5, Qwen 3.8 Max, Qwen3.5-397B-A17B, DeepSeek V4 Flash-0731, DeepSeek V4 Pro-0813, Apodex 1.1, GLM-5.2, 그리고 동적 사고(dynamic thinking)를 사용한 Gemini 3.7 Flash다.
4.2 평가 지표
각 과제는 필요한 파일, 수치 결과, 형식, 그림, 코드 실행, 산출물 간 일관성을 점검하는 과제별 Grader를 갖추고 있으며, 0~100 범위의 점수를 반환한다. 루브릭 기반의 의미론적 판단이 필요한 경우 Judge(GPT-5.6 Sol)가 각 기준을 3회 반복 평가한다. 3회 판정의 평균값을 쓰기 때문에 완전한 루브릭을 충족한 제출물도 100보다 약간 낮게 나올 수 있어, 완전 완료 지표는 점수 99.9 이상으로 정의된다 — 이는 루브릭 요건을 완화하는 것이 아니라 단지 평균화 과정에서 생기는 사소한 수치 변동을 흡수하기 위한 것이다.
4.3 전체 성능
전체적으로 Pass Rate는 3.1%~20.6%, Avg. Score는 67.5~87.9 범위였다. Codex+GPT-5.6 Sol이 87.9로 가장 높은 Avg. Score를 기록했고, Claude Code+Grok 4.6(Avg. Score 86.6)과 함께 20.6%로 최고 Pass Rate를 공유했다. Claude Code+Kimi K3와 Claude Code+Claude Opus 5는 각각 17.5%의 Pass Rate(Avg. Score 85.5, 84.9)를 기록했다.
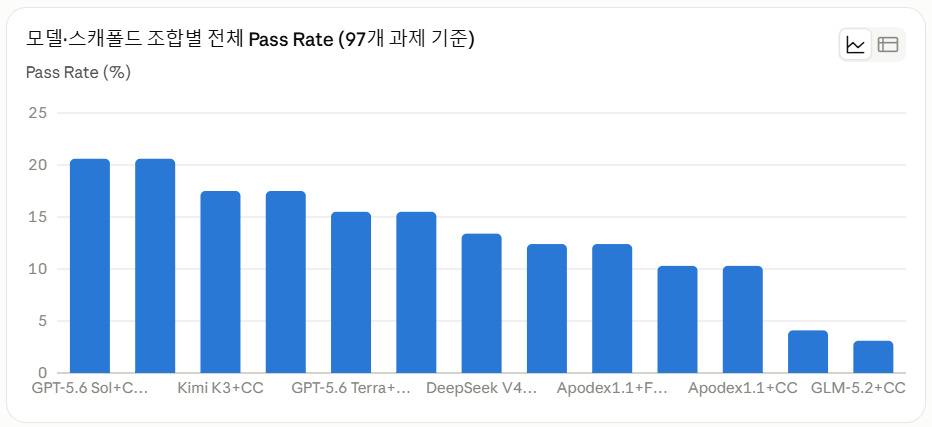
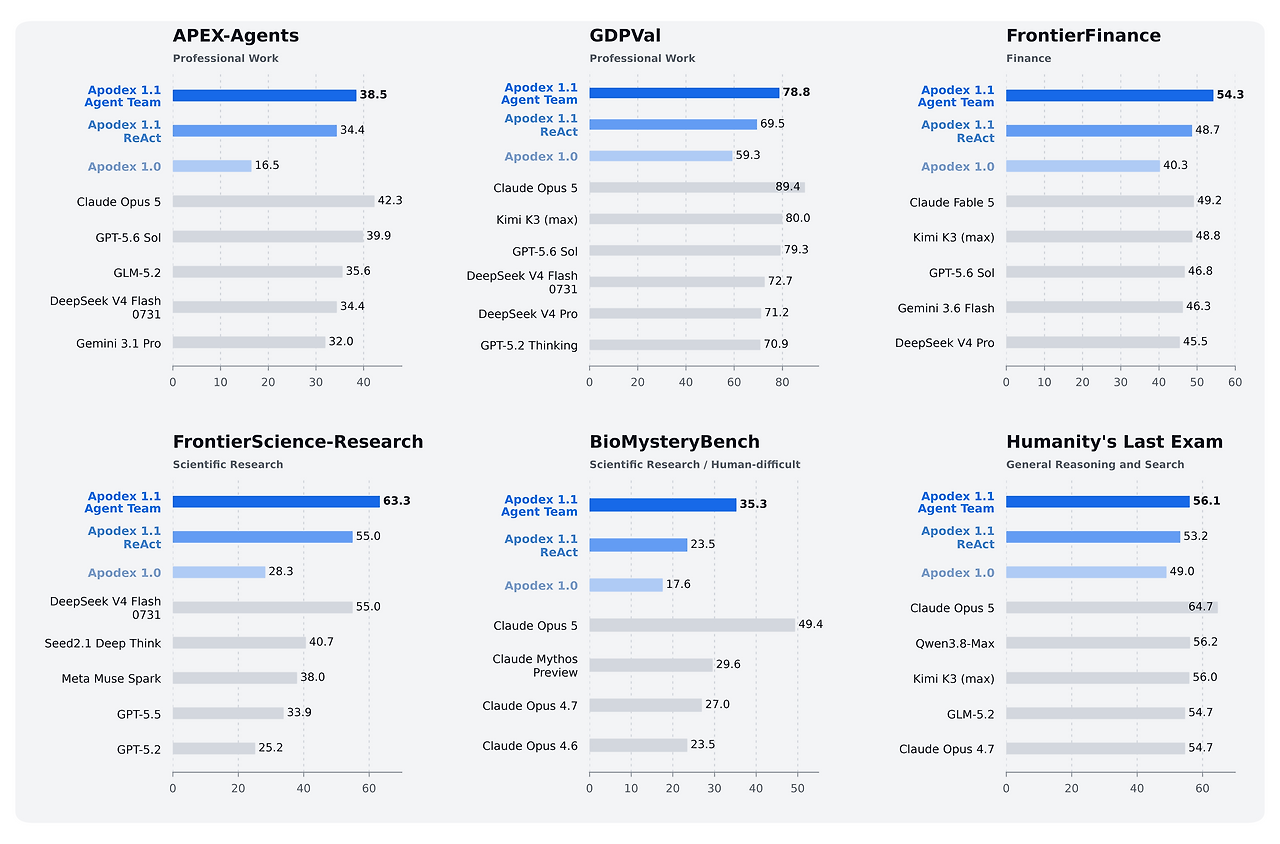
위 그래프에서 보듯 8개 구성이 Avg. Score 80점을 넘었지만 그중 어느 것도 20.6% 이상의 Pass Rate를 기록하지 못했다 — 즉 평균 점수가 높은 산출물 묶음도 여전히 하나 이상의 요구사항을 놓치는 경우가 흔했다는 뜻이다. 참고로 Apodex 1.1의 두 구성을 비교하면, Frontier Agent(Agent Team)가 Claude Code보다 Avg. Score(74.5 대 71.8)와 Pass Rate(12.4% 대 10.3%) 모두에서 더 나았지만, 저자들은 이 비교가 서술적일 뿐 스캐폴드 자체의 순수한 효과를 분리해 보여주는 것은 아니라고 밝힌다.
4.4 도메인별 성능
Pass Rate가 가장 높았던 두 도메인은 양자화학과 분자동역학이었다. 양자화학에서는 Claude Code+Grok 4.6이 60%로 최고치를 기록했고, Codex+GPT-5.6 Sol과 Claude Code+Claude Opus 5가 55%로 뒤를 이었다. 분자동역학에서는 GPT-5.6 Sol·GPT-5.6 Terra(max)·Grok 4.6이 각각 38%를 기록했으며, Terra는 93.7로 가장 높은 Avg. Score를 얻었다.
반면 재료 특성분석에서는 Avg. Score가 최대 88.1까지 올랐지만 어떤 구성도 Pass Rate 9%를 넘지 못했다. 이 괴리는 분석화학과 전기화학/환경에서 더 두드러졌다. 분석화학의 최고 Avg. Score는 87.6이었지만 DeepSeek V4 Pro-0813만이 4%의 Pass Rate로 과제를 완료했고, 전기화학/환경은 최고 Avg. Score가 94.9에 달했음에도 모든 구성에서 Pass Rate가 0%였다. 생명과학은 전반적으로 Avg. Score가 낮아 GPT-5.6 Sol이 최고 76.8을 기록했지만, Pass Rate 면에서는 Kimi K3가 20%로 가장 높았다.
모델별 도메인 프로파일도 서로 달랐다. GPT-5.6 Sol은 양자화학·재료 특성분석·분석화학·생명과학에서 가장 폭넓게 선두를 차지했다. Grok 4.6은 양자화학 Pass Rate 1위(60%)와 분자동역학 공동 1위(38%)를 기록했다. 가장 강력했던 Apodex 1.1 구성(Frontier Agent, Agent Team)은 양자화학(40%)에서는 경쟁력이 있었으나 분자동역학(19%)에서는 뒤처졌고, 재료 특성분석·분석화학·전기화학/환경에서는 단 한 과제도 완료하지 못했다. Gemini 3.7 Flash 역시 분석화학 62.4점부터 양자화학 81.1점까지 Avg. Score 편차가 컸고, 양자화학·분자동역학에서는 각각 25%를 완료했지만 나머지 세 도메인에서는 0%였다. 이는 전체 순위만으로는 도메인별 강약을 파악할 수 없음을 보여준다.
4.5 자원 사용량 및 실행 시간
토큰 사용량은 구성 간 6배 이상 차이가 났다. 입력 토큰 사용량은 Claude Code+Grok 4.6의 과제당 218.3만 토큰부터 Claude Code+Apodex 1.1의 1,373만 토큰까지 분포했다. GPT-5.6 Sol은 과제당 입력 632.7만 토큰·출력 2.31만 토큰(캐시 비중 98.8%)을, GPT-5.6 Terra(max)는 입력 703.9만 토큰·출력 3.86만 토큰(캐시 비중 98.5%)을 사용했다. 저자들은 공급자별 토크나이저·캐싱·보고 방식이 달라 하드웨어 정규화된 효율 비교는 불가능하다고 밝힌다.
실행 시간도 편차가 크고 꼬리가 길었다. 평균 실행 시간은 과제당 21.8분에서 112.8분까지 분포했으며, Frontier Agent(Agent Team)가 평균 112.8분(중앙값 54.9분, 90백분위 272.2분)으로 가장 길었다. GPT-5.6 Terra(max)는 Sol보다 중앙값은 더 길었지만(14.0분 대 7.8분) 평균·90백분위·60분 초과 실행 건수 모두 더 짧거나 적었다.
4.6 실패 유형 분석
실패 신호는 도메인별로 크게 달랐다. Judge가 판단한 산출물 결함은 재료 특성분석에서 완료 실패 제출물의 97%, 분석화학 95%, 전기화학/환경 85%에서 나타난 반면 양자화학에서는 43%에 그쳤다. 반대로 결정론적 Grader 진단(즉 기계적으로 검출되는 오류)은 생명과학(50%)과 양자화학(40%)에서 다른 도메인보다 더 흔했다.
가장 주목할 발견은 완료 언어가 실제 성공적 전달을 신뢰성 있게 나타내지 못한다는 점이다. 970개의 Claude Code 실행 기록 중 완료 실패 849건 가운데 641건(75.5%)의 최종 메시지에 "완료했다"는 취지의 어휘가 포함되어 있었고, 작업이 아직 진행 중이라고 명시적으로 밝힌 경우는 13건(1.5%)에 불과했다. 완료 언어는 50점 미만 실패군에서는 61.2%로 다소 낮았지만 50점 초과 실패 구간에서는 78% 이상 유지되었고, 실제로 통과한 실행 기록에서도 90.1%에서 나타났다 — 즉 자기보고식 완료 선언은 산출물 자체를 평가하는 것을 대체할 수 없다.
원시 도구 오류 역시 성공 여부를 예측하지 못했다. 완료 실패 실행 기록의 80.7%, 통과 실행 기록의 94.2%에서 최소 한 번 이상의 도구 오류가 발생했으며(100회 도구 호출당 중앙값 오류율 각각 4.4회, 5.6회), 이는 오류 발생 자체보다 오류로부터의 회복 여부가 더 중요함을 시사한다.
5. Conclusion (결론)
FrontierChallenge는 과학 에이전트가 그럴듯한 답 하나를 내놓는 것을 넘어, 지정된 다단계 워크플로를 완료하고 상호 일관된 산출물을 전달할 수 있는지를 평가한다. 전체 300개 워크플로 중 97개를 6개 과학 도메인에 걸쳐 과제별 실행 가능한 Grader로 평가·공개했다. 평가된 모델·스캐폴드 전반에서 Pass Rate는 3.1%~20.6%에 그쳤는데, 이는 Avg. Score가 67.5~87.9에 달했던 것과 대비된다. Codex+GPT-5.6 Sol이 최고 Avg. Score를, Claude Code+Grok 4.6과 함께 최고 Pass Rate를 기록했다. 특히 분석화학과 전기화학/환경에서 부분적 진척이 완전한 전달로 이어지지 못하는 경향이 뚜렷했고, 도메인별로 서로 다른 강약 프로파일이 나타나 전체 순위만으로는 특정 과학 세팅에서의 실제 성능을 포착할 수 없음을 보여주었다. 실패 분석에서는 완료 실패 Claude Code 실행 기록의 75.5%가 완료 언어로 끝맺었고, 도구 오류는 통과·실패 양쪽 모두에서 흔했다는 점에서, 최종 자기보고나 오류 존재 여부만으로는 성공적 전달을 판단하기 어렵다는 결론이 제시된다.
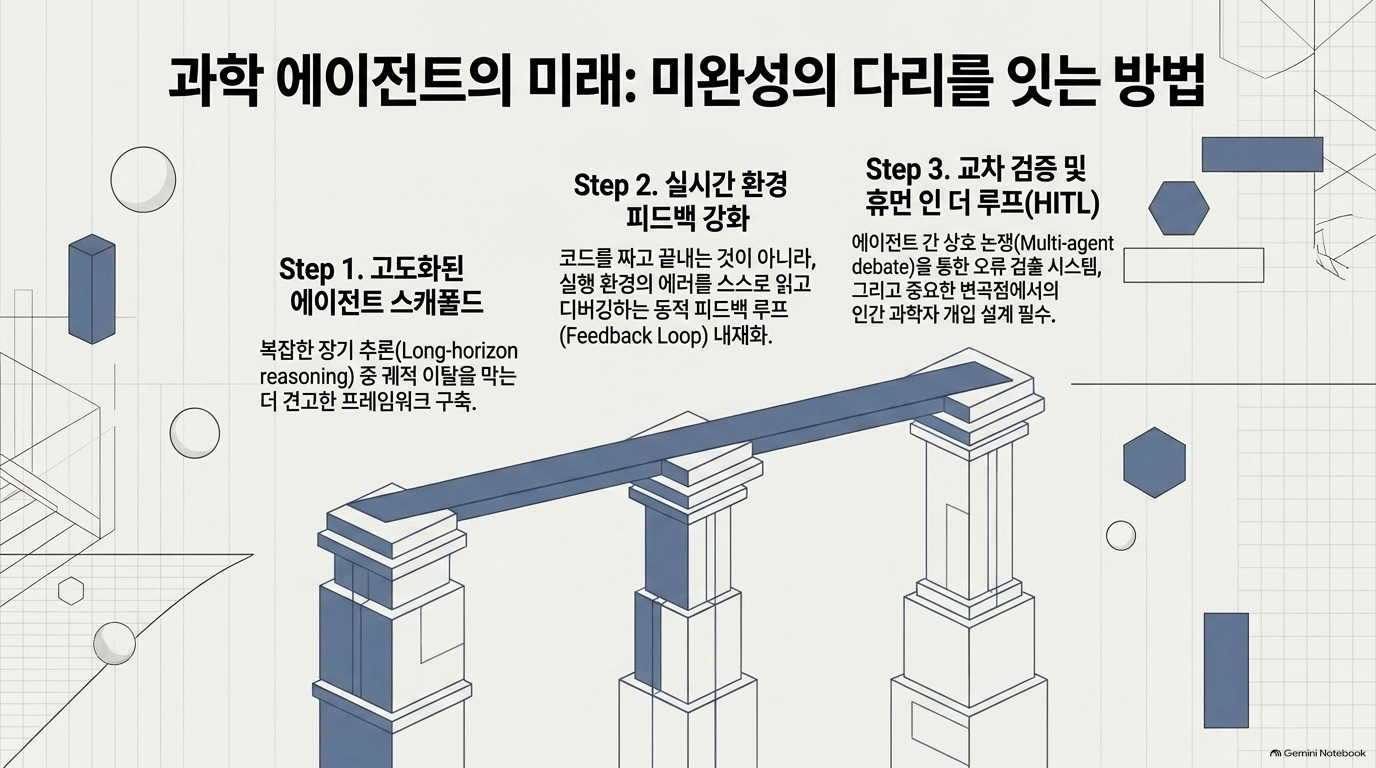
저자들은 이 결과가 공개된 과제 세트, 평가된 구성, Claude Code 궤적 범위, 공급자별 자원 집계 방식, 단일 실행(single run)이라는 조건에 한정된다고 명시한다. 이러한 한계 내에서, 완전한 계약 수준의 전달(complete, contract-level delivery)은 아직 해결되지 않은 별개의 능력으로 자리매김하며, 더 신뢰할 수 있는 과학 에이전트를 위해서는 명시적 계약 추적(contract tracking), 산출물 간 교차 검증(cross-artifact validation), 증거 기반 완료 점검(evidence-based completion checks)이 필요하다고 결론짓는다.


'07.AI > 7. AI 벤치마크' 카테고리의 다른 글
| 에이전트 AI - 벤치마크 - Artificial Analysis, Artificial Analysis Intelligence Index v4.2 (0) | 2026.09.10 |
|---|---|
| 에이전트 AI - 벤치마크 - Artificial Analysis, Artificial Analysis Intelligence Index v4.3 (0) | 2026.09.10 |
| 에이전트 AI - 벤치마크 - ASI-Bench: 인공 초지능의 여명 (0) | 2026.09.03 |
| LLM - 검색 증강 생성 (RAG) - AWS, AI Agent를 위한 OpenSearch 검색 품질 평가 (0) | 2026.08.28 |
| 에이전트 AI - 벤치마크 - EPOCH AI, 벤치마크 핵심 질문 9가지 (0) | 2026.08.17 |