반응형
2026.8.17
[AI Agent를 위한 OpenSearch 검색 품질 평가하기 (Part 1)]
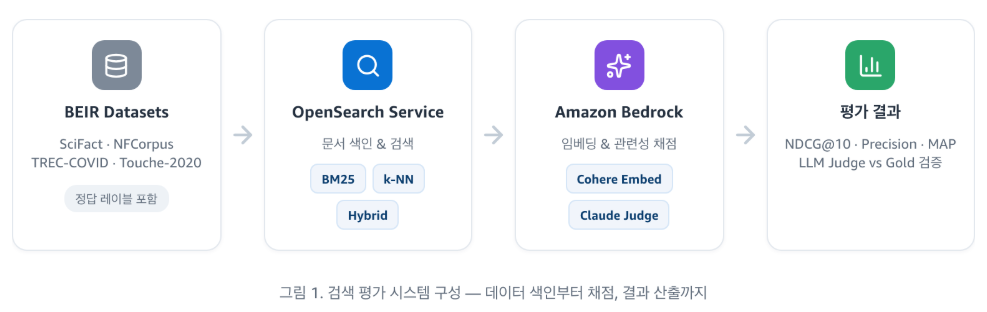
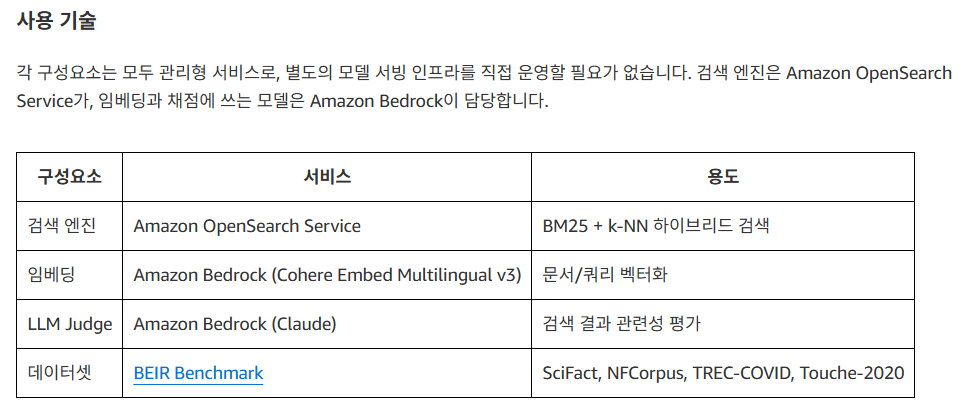
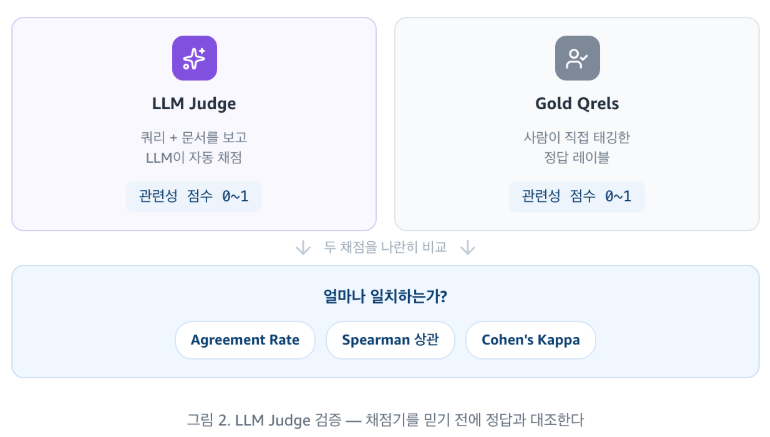
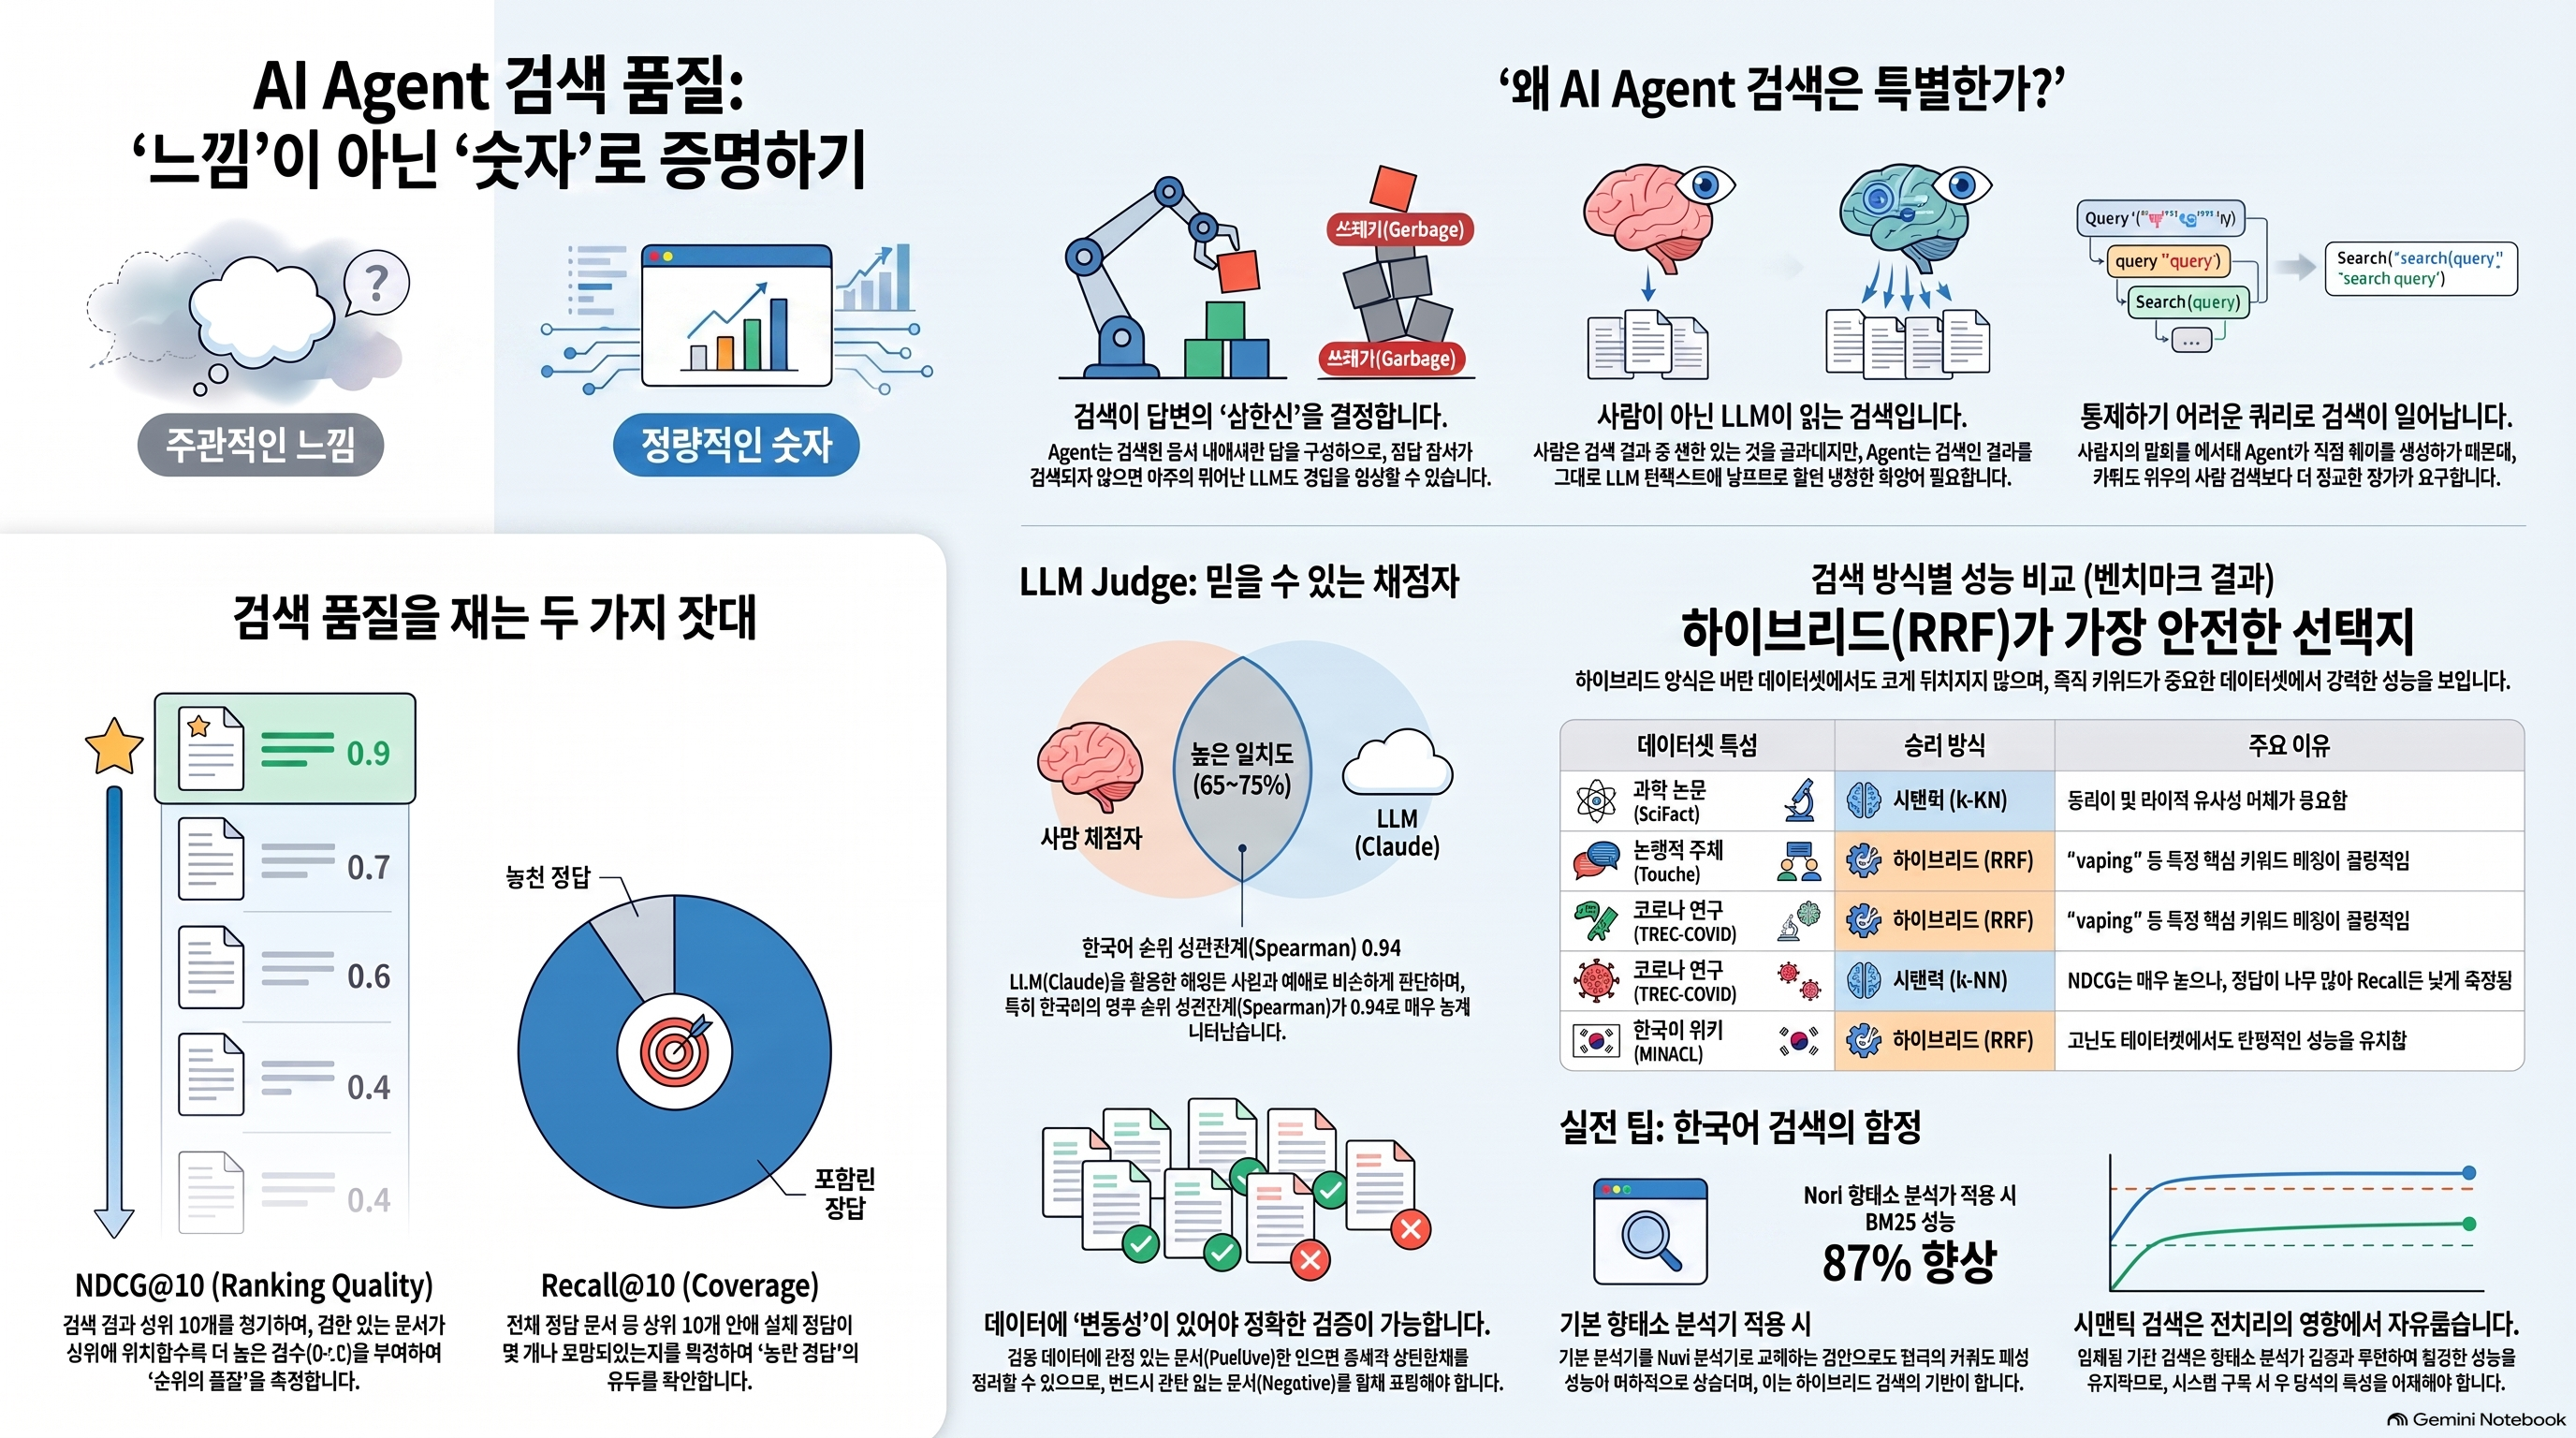
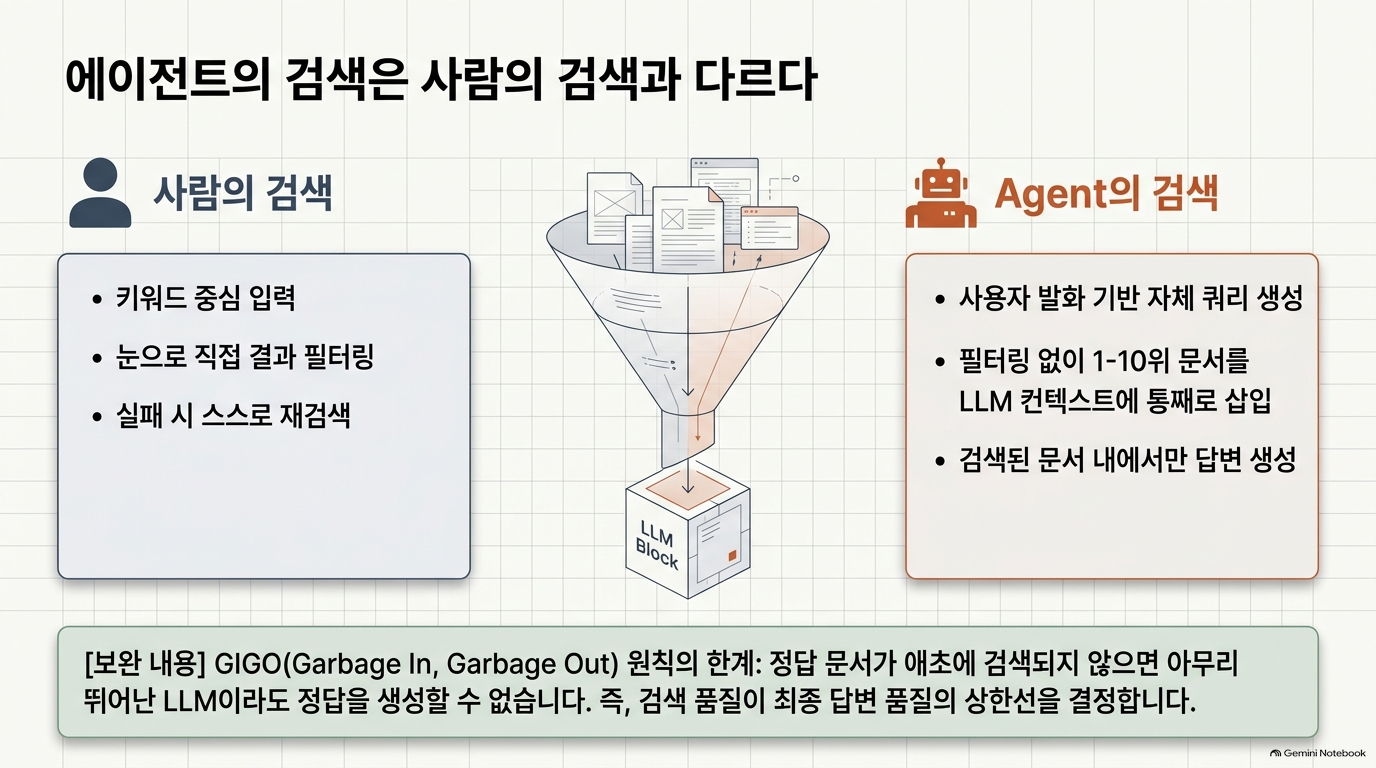
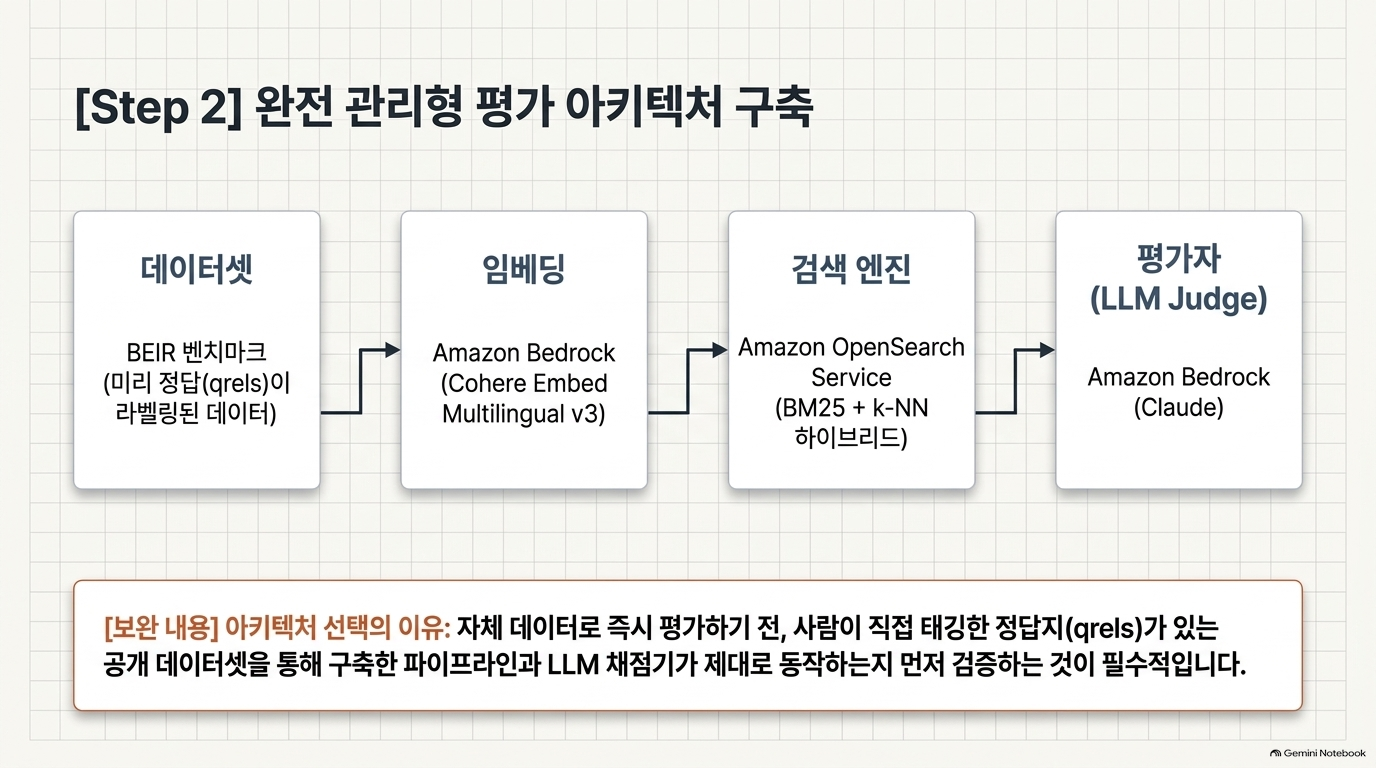
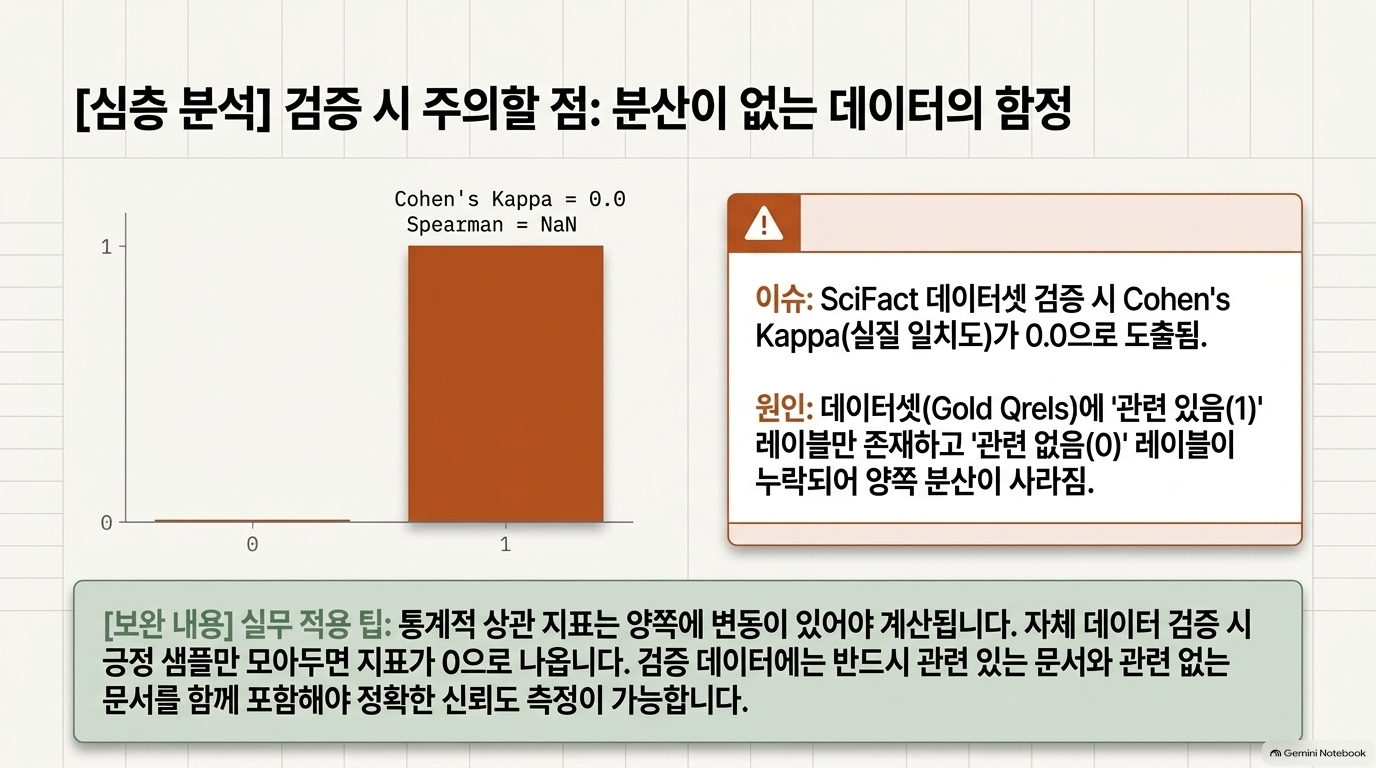
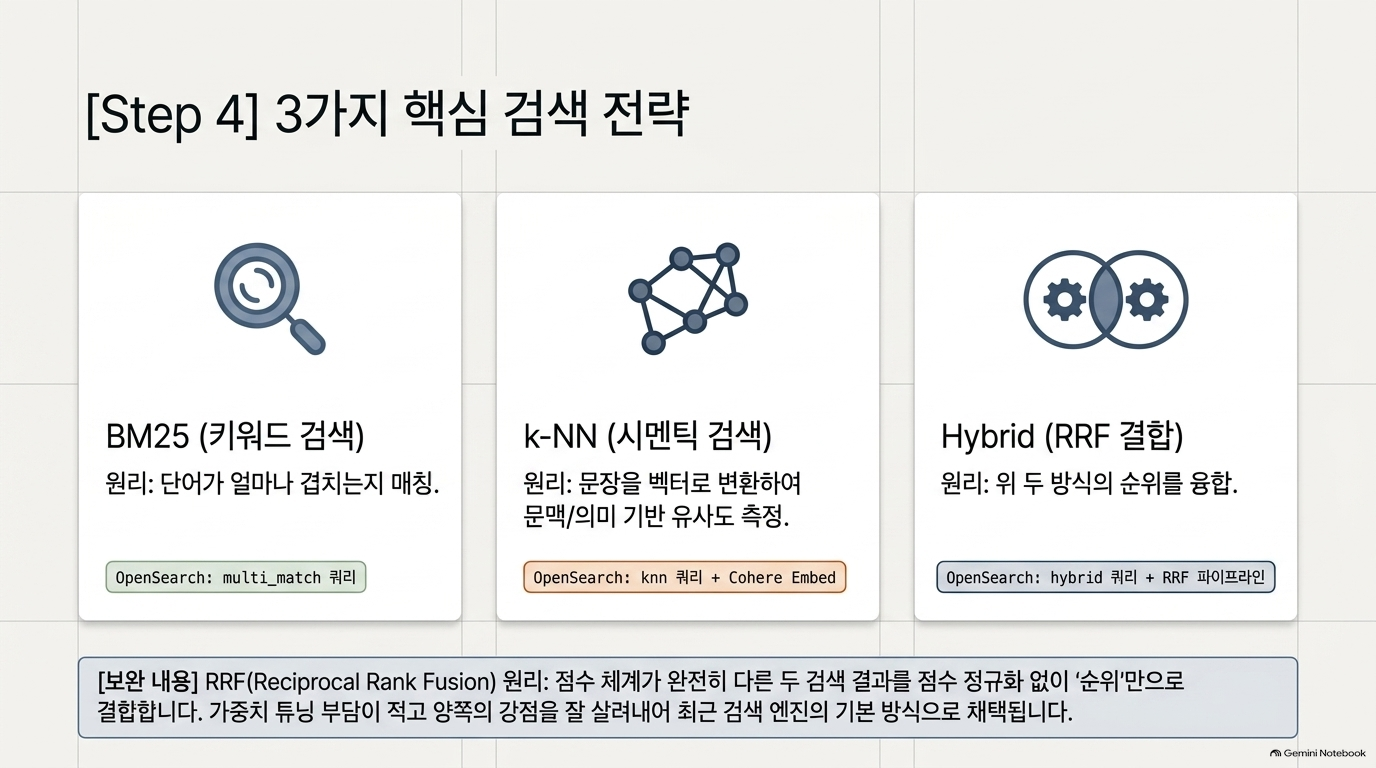
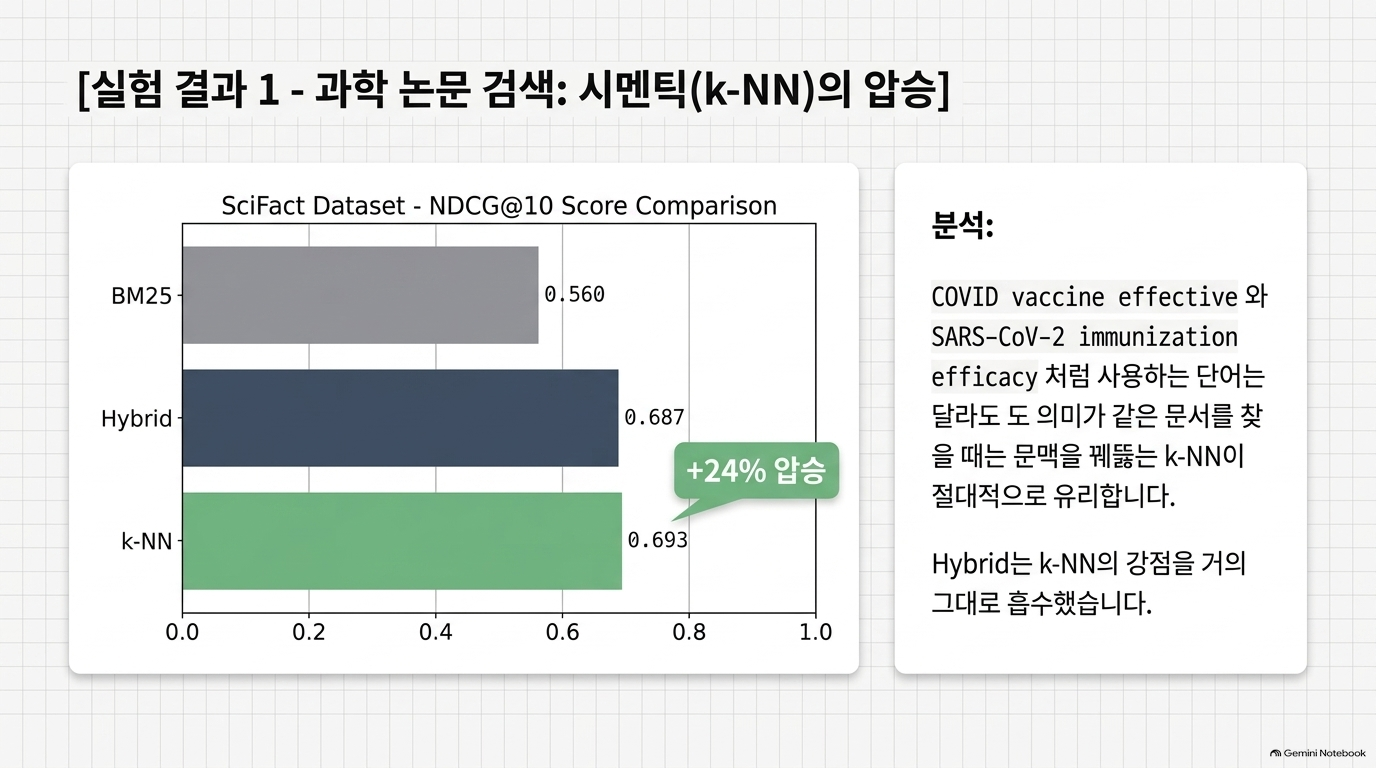
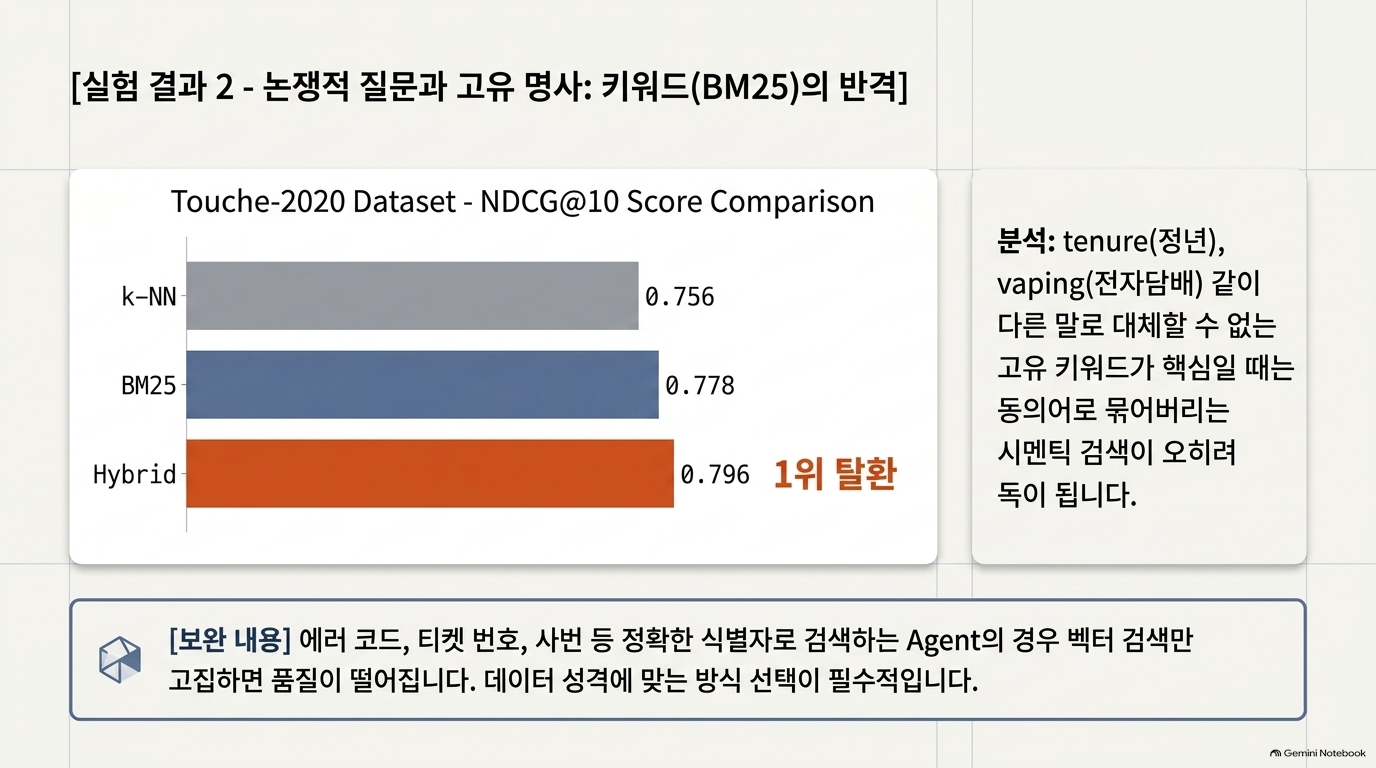
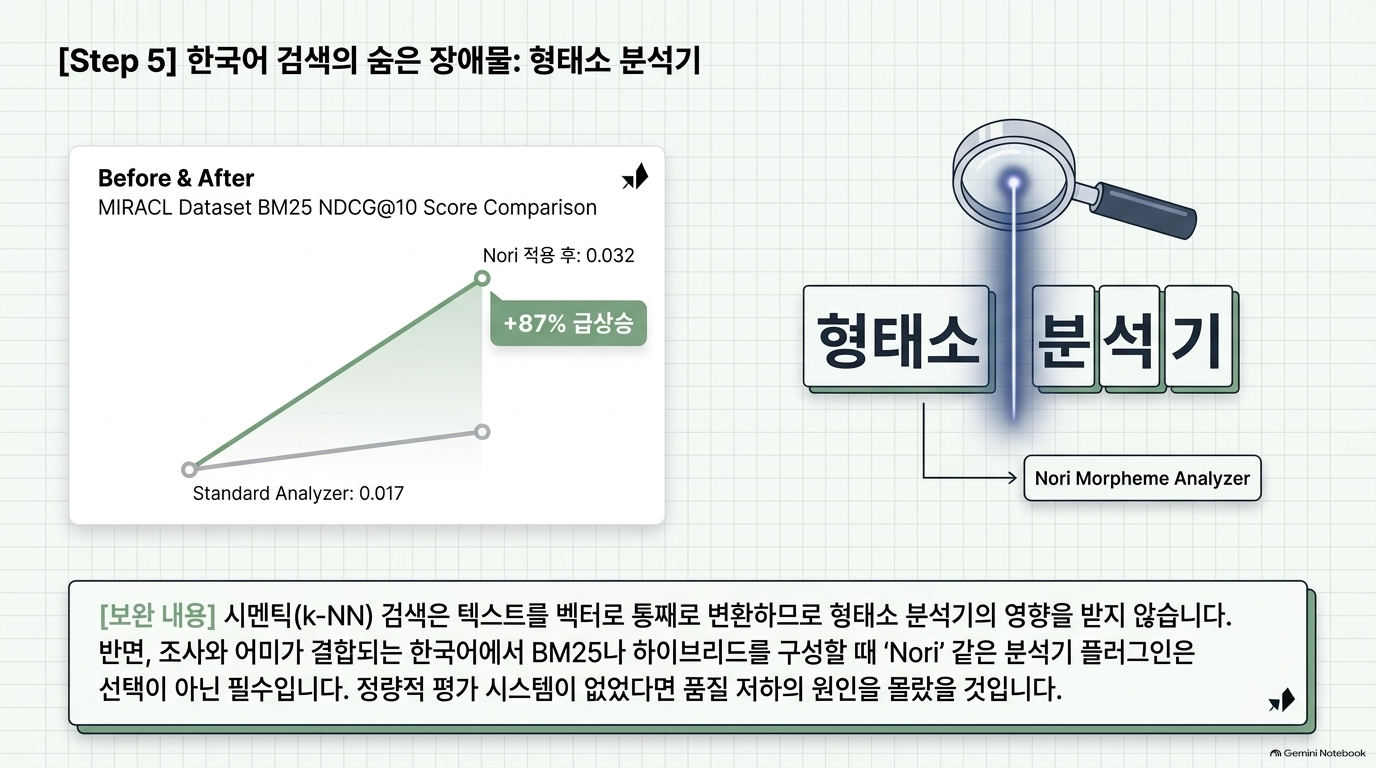
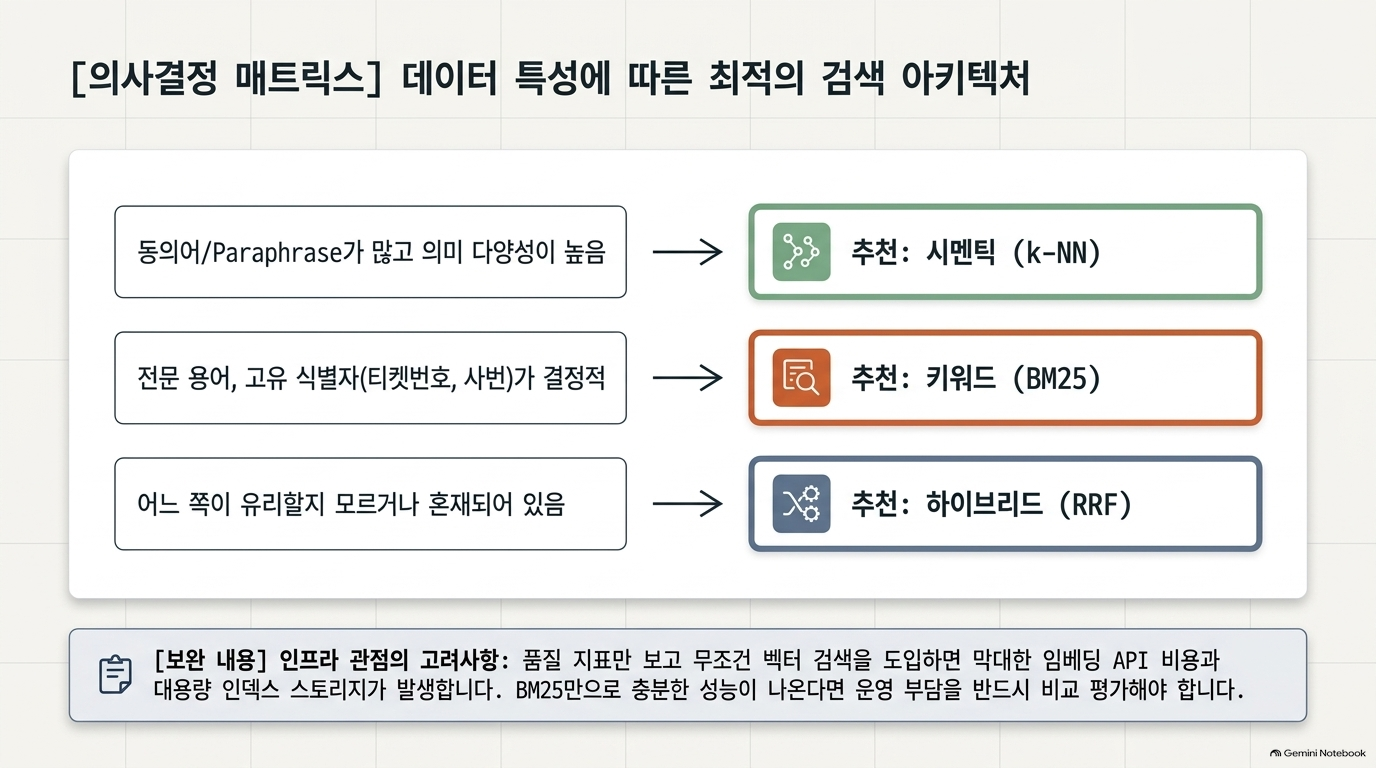
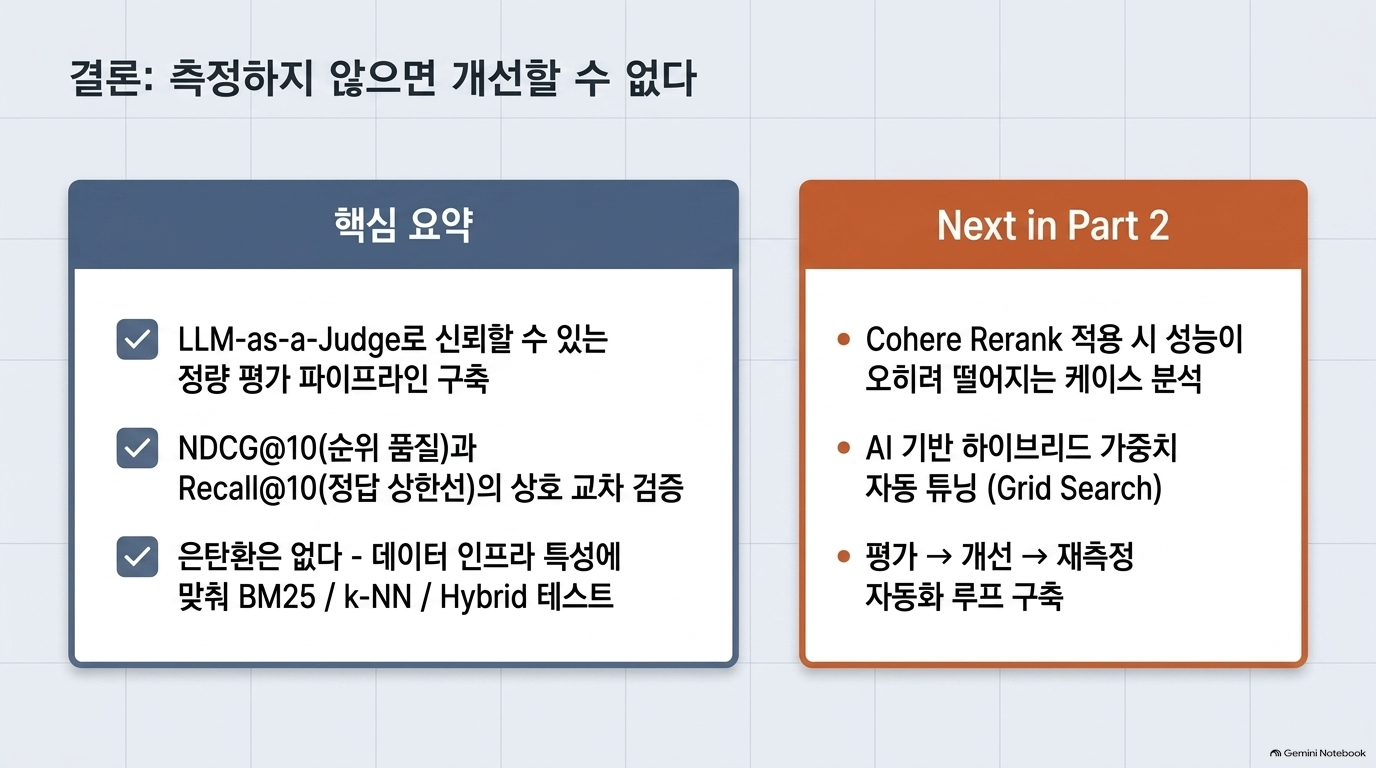
이 글은 RAG(검색 증강 생성) 기반 AI 에이전트의 성능을 좌우하는 검색 품질의 정량적 평가 체계를 구축하는 방법론을 제시합니다. 단순한 주관적 만족도를 넘어 NDCG@10 및 Recall@10과 같은 객관적 지표를 활용하여, 데이터의 성격에 따라 키워드(BM25), 시멘틱(k-NN), 하이브리드 중 어떤 검색 방식이 최적인지 수치로 증명하는 과정을 담고 있습니다. 특히 사람이 직접 채점하기 어려운 대규모 환경에서 LLM Judge(LLM-as-a-Judge)를 활용한 평가 자동화의 신뢰성을 검증하고, 한국어 형태소 분석기(Nori) 적용 유무에 따른 드라마틱한 품질 변화를 실전 사례로 보여줍니다. 결론적으로 이 텍스트는 효과적인 검색 시스템 최적화가 "측정할 수 있어야 개선할 수 있다"는 원칙에서 시작됨을 강조하며, 아마존 오픈서치와 베드락을 활용한 구체적인 기술 아키텍처를 가이드합니다.
무엇으로 재는가, NDCG@10
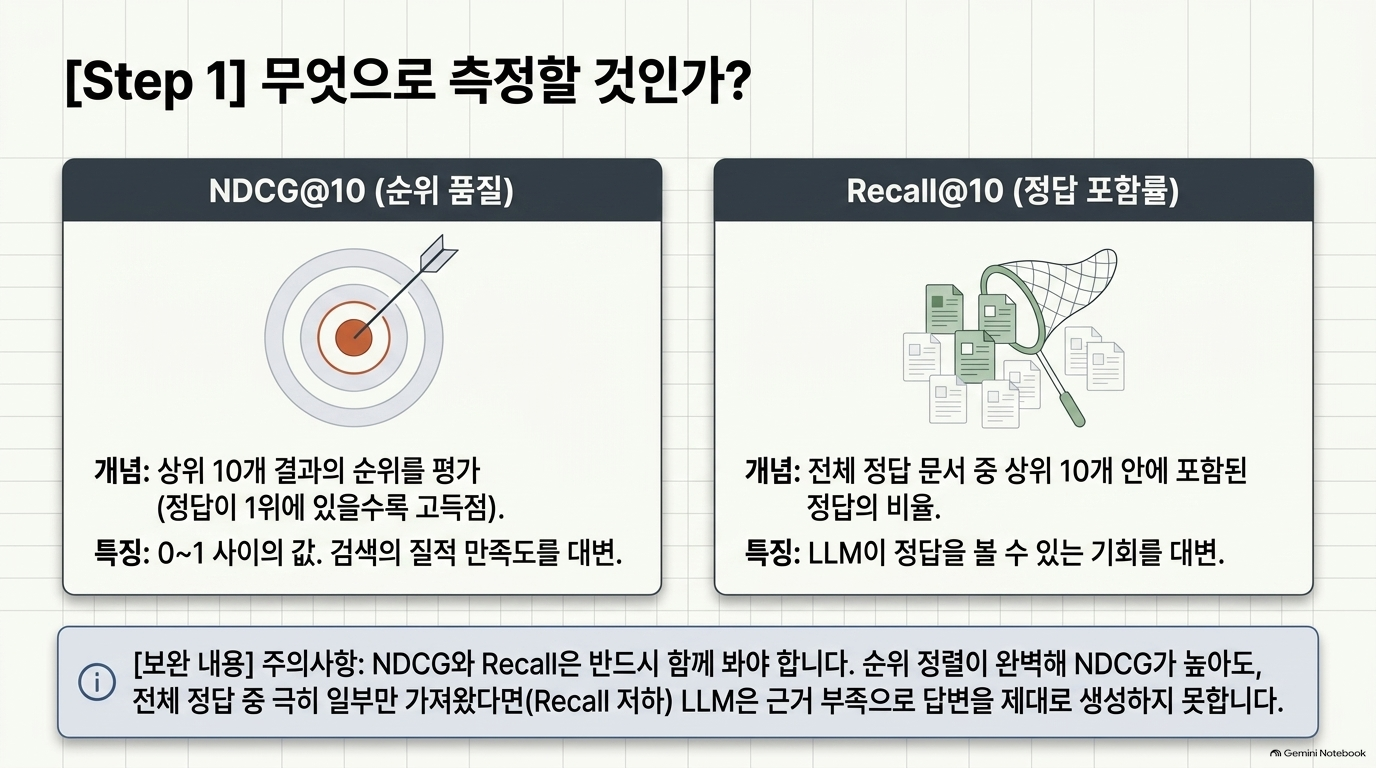
검색 품질을 측정하는 대표적인 지표는 NDCG@10(Normalized Discounted Cumulative Gain)입니다. 이름은 복잡하지만 아이디어는 직관적입니다.
- 검색 결과 상위 10개를 평가합니다.
- 관련 있는 문서가 상위에 있을수록 높은 점수를 줍니다. (보통 5위에 있는 정답보다 1위에 있는 정답이 더 가치가 있습니다.)
- 이상적인 순서(정답만 위에서부터 완벽히 정렬된 상태)로 나눠 정규화하기 때문에, 항상 0~1 사이 값으로 나옵니다. 1에 가까울수록 좋습니다.
Precision@10(상위 10개 중 관련 문서 비율)이나 MAP(Mean Average Precision) 같은 지표도 함께 쓰지만, NDCG@10은 “순위까지 고려한다”는 점에서 검색 품질을 가장 균형 있게 요약해줍니다. 이 글에서는 NDCG@10을 주력 지표로 삼아 여러 검색 방식을 비교합니다.
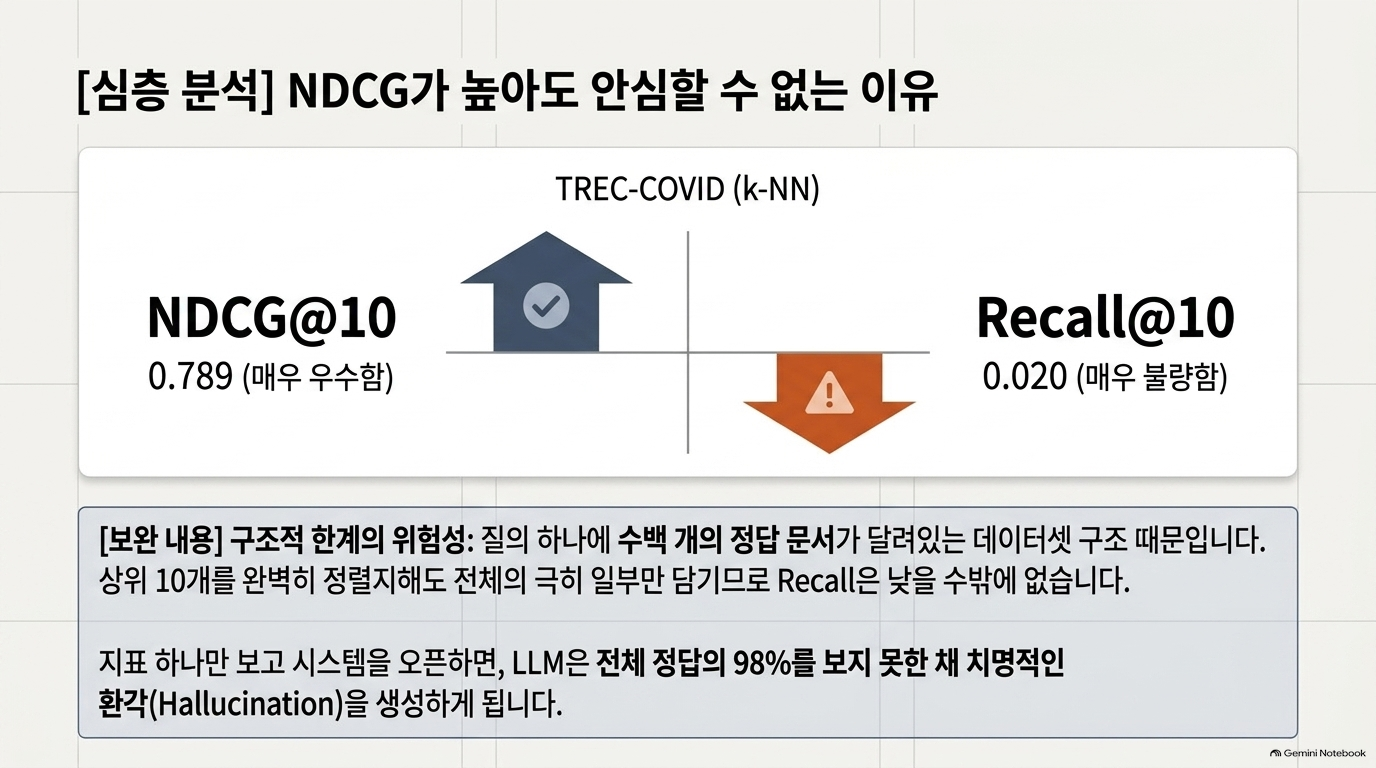
하나 더, RAG에서는 Recall@k도 반드시 함께 봐야 합니다. Recall@k는 “전체 정답 문서 중 상위 k개 안에 몇 개나 데려왔는가”의 비율입니다. NDCG가 순서의 품질을 본다면, Recall은 놓친 정답이 얼마나 되는가를 봅니다. 이 둘은 다른 이야기를 합니다. 순위는 좋은데(NDCG 높음) 정작 정답의 대부분을 상위 k개 밖에 두고 온(Recall 낮음) 경우가 실제로 자주 생기기 때문입니다. RAG는 검색이 데려온 문서만 근거로 답을 만들므로, Recall@k가 낮으면 LLM이 아무리 좋아도 답의 상한이 막혀버립니다. 그래서 이 글에서는 NDCG@10과 Recall@10을 나란히 보겠습니다.

728x90
반응형
'07.AI > 7. AI 벤치마크' 카테고리의 다른 글
| 에이전트 AI - 벤치마크 - Apodex Team, FrontierChallenge: 과학 워크플로 완료 평가 (0) | 2026.09.03 |
|---|---|
| 에이전트 AI - 벤치마크 - ASI-Bench: 인공 초지능의 여명 (0) | 2026.09.03 |
| 에이전트 AI - 벤치마크 - EPOCH AI, 벤치마크 핵심 질문 9가지 (0) | 2026.08.17 |
| 에이전트 AI - 벤치마크 - PAST-Bench: 재귀적 자기개선(RSI) 기반 (0) | 2026.08.07 |
| 에이전트 AI - 벤치마크 - 누적되는 다중턴 코딩, EvoCode-Bench (0) | 2026.07.31 |