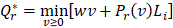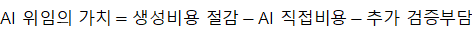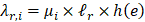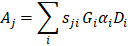2026.10.14 [AI Verification Costs and the Delegation of Work]
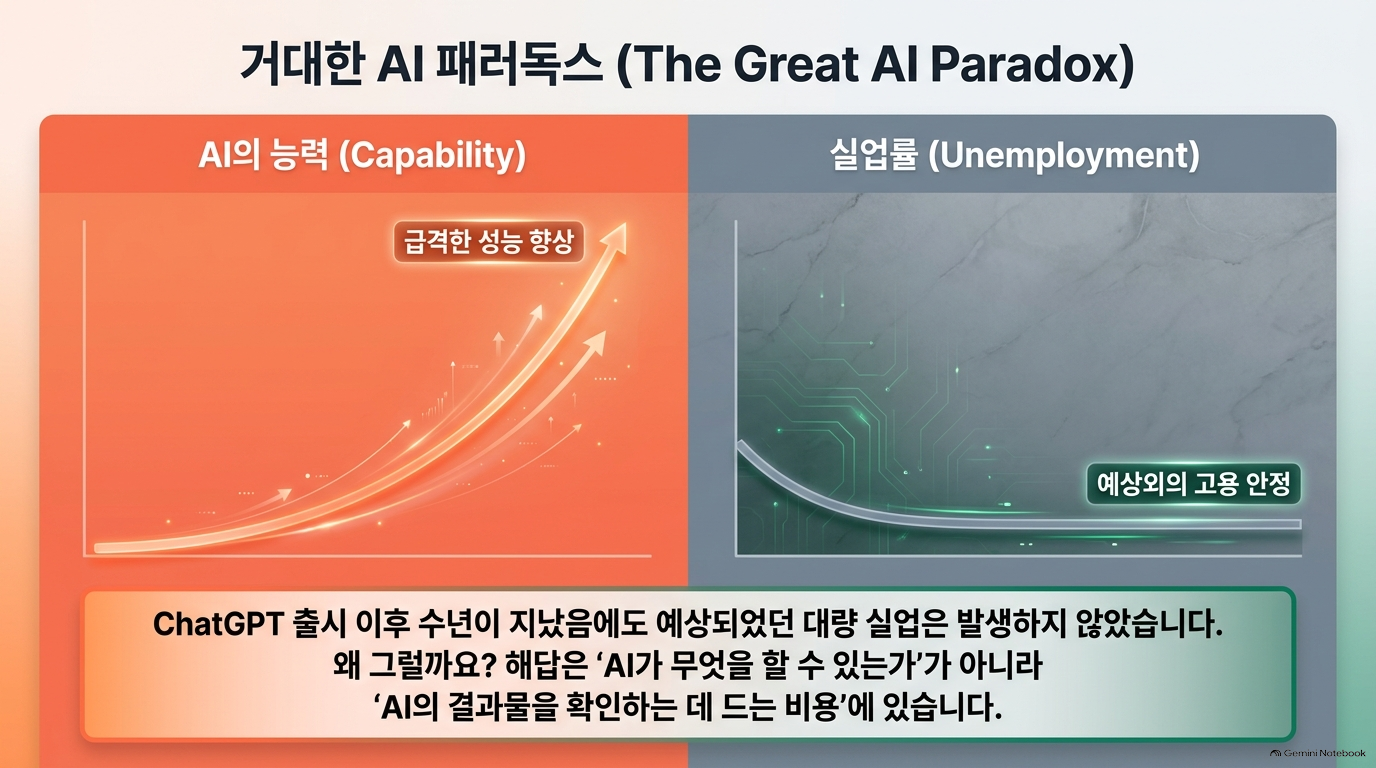
본 문헌은 인공지능(AI)이 노동 시장을 대체하는 범위를 결정하는 핵심 요인이 AI의 기술적 능력 자체가 아니라 AI가 수행한 작업의 결과를 검증하는 데 드는 비용이라는 점을 밝히고 있다. 저자는 AI가 작업 수행에 드는 시간은 대부분의 직군에서 비슷하게 절약해 주지만, 그 출력물을 신뢰할 만한 비용으로 검증할 수 있는지는 직무마다 크게 다르다고 주장한다. 이에 따라 작업의 검증 가능성과 오류 발생 시의 손실 크기를 결합하여 어떤 업무가 실제로 AI에게 위임될 수 있는지를 측정하는 새로운 프레임워크를 제안한다. 미국 노동 시장의 직업들을 대상으로 이 측정법을 적용한 결과, 놀랍게도 AI가 활용되는 업무 중 절반 미만만이 실제로 위임 가능한 수준인 것으로 나타났다. 특히 법률이나 경영 분석처럼 AI 활용도는 높지만 결과물 검증이 까다롭고 오류 비용이 큰 직업들은 실질적인 위임이 불가능한 반면, 행정 지원이나 단순 데이터 처리와 같이 검증이 저렴한 직업들은 쉽게 위임될 수 있음을 보여준다. 결론적으로 이 연구는 AI 도입이 노동 시장에 미치는 영향이 기술 그 자체의 발전 속도보다는 검증 비용과 오류의 위험성에 의해 엄격하게 제한된다는 점을 설득력 있게 설명하고 있다.
저자: Yue Xu, Durham University 분석 대상: 2026년 10월 14일 버전, 총 48쪽 제목 번역:「AI 검증비용과 업무의 위임」
핵심 주장: AI가 업무를 잘 수행하고 시간을 절약하더라도, 결과를 검증하는 비용과 미탐지 오류의 손실이 크면 그 업무를 경제적으로 위임하기 어렵다.
이 논문은 AI 역량 → 관측된 활용 → 검증을 고려한 위임 가능성을 구분합니다. 다만 위임 가능성은 분류 규칙으로 구성한 지표이며, 실제 검증비용을 직접 측정한 결과는 아닙니다. 실제 고용 감소의 인과효과도 확인하지 못했습니다.이 두 가지를 전제로 읽는 것이 중요합니다.[1]
Ⅰ. Introduction — 서론
PDF pp.3–7
1. 문제 제기: 왜 AI 역량 향상이 곧바로 일자리 대체로 이어지지 않는가?
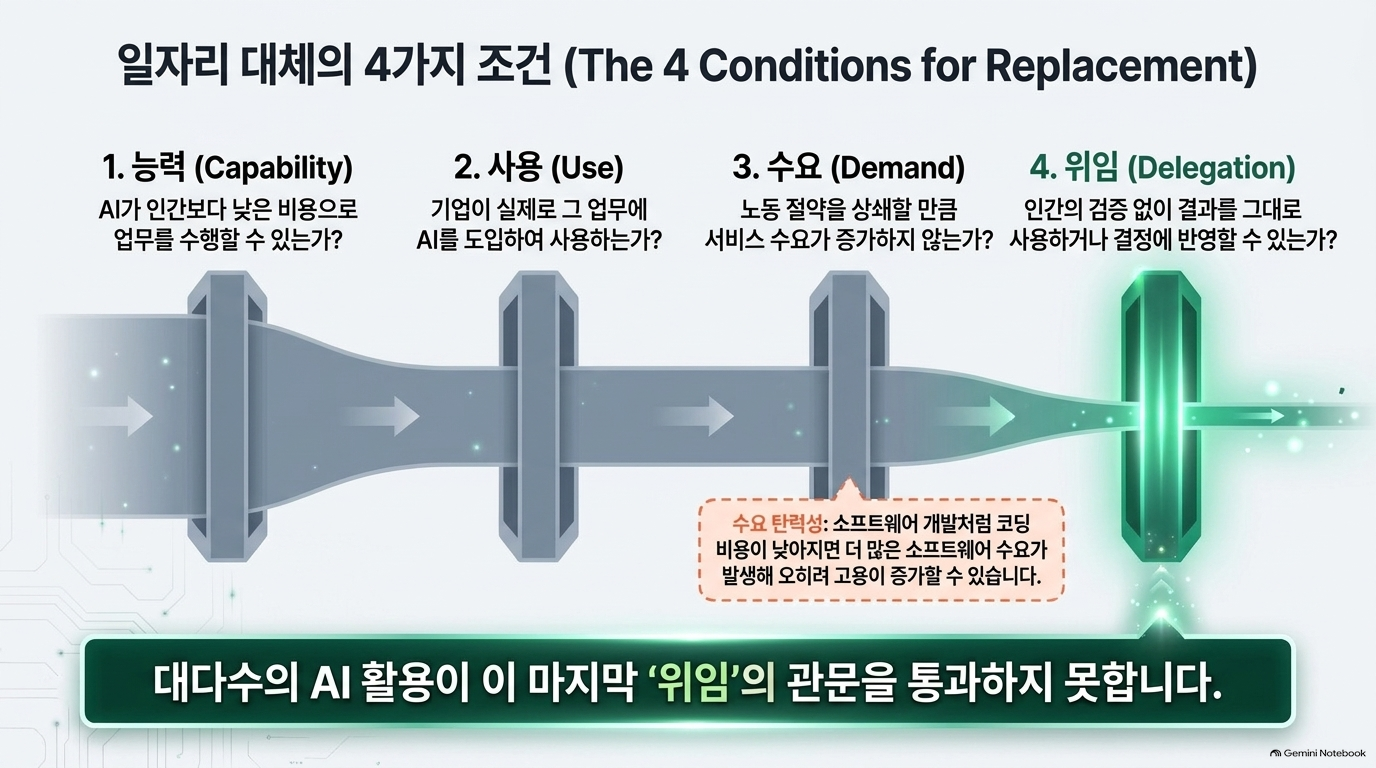
저자는 AI가 일자리를 줄이려면 다음 조건이 함께 충족되어야 한다고 설명합니다.[1, pp.3–4]
조건
핵심 질문
역량 Capability
AI가 인간보다 낮은 비용으로 업무를 수행할 수 있는가?
활용 Use
기업이 실제로 해당 업무에 AI를 사용하는가?
수요 Demand
비용 하락으로 늘어난 수요가 노동 절감을 상쇄하지 않는가?
위임 Delegation
인간의 업무를 보조하는 수준을 넘어 AI에 맡길 수 있는가?
논문이 추가하는 핵심은 마지막 조건입니다.
예를 들어 AI가 법률 문서나 투자 분석의 초안을 작성하더라도, 전문가가 사실관계·논리·위험을 다시 검토해야 한다면 AI 사용이 증가했다는 사실만으로 전문가의 업무가 대체되었다고 볼 수 없습니다.
2. 기존 연구와의 차별점
기존 지표가 주로 다룬 것은 다음 세 가지입니다.
AI가 할 수 있는 업무
사람들이 AI로 수행하는 업무
AI가 절약하는 시간
저자는 여기에 “그 결과를 신뢰하기 위해 무엇을 얼마나 확인해야 하는가?”를 추가합니다.[1, pp.6–7]
분석·평가
이 장의 기여는 AI 도입의 평가 단위를 생성 능력에서 결과물의 사용 가능성으로 옮긴 것입니다.
다만 논문에서 말하는 ‘위임’은 인간의 확인이 전혀 없는 완전 자율화가 아닙니다. AI가 결과를 만들고 인간은 그것을 확인하는 방식도 위임에 포함됩니다. 따라서 이후의 ‘위임 가능 비율’을 ‘무인 자동화 비율’로 읽으면 안 됩니다.[1, p.13]
Ⅱ. Model — 검증비용을 포함한 업무 위임 모형
PDF pp.7–14
Ⅱ.A. Setup: AI의 가치는 생성비용만으로 결정되지 않는다
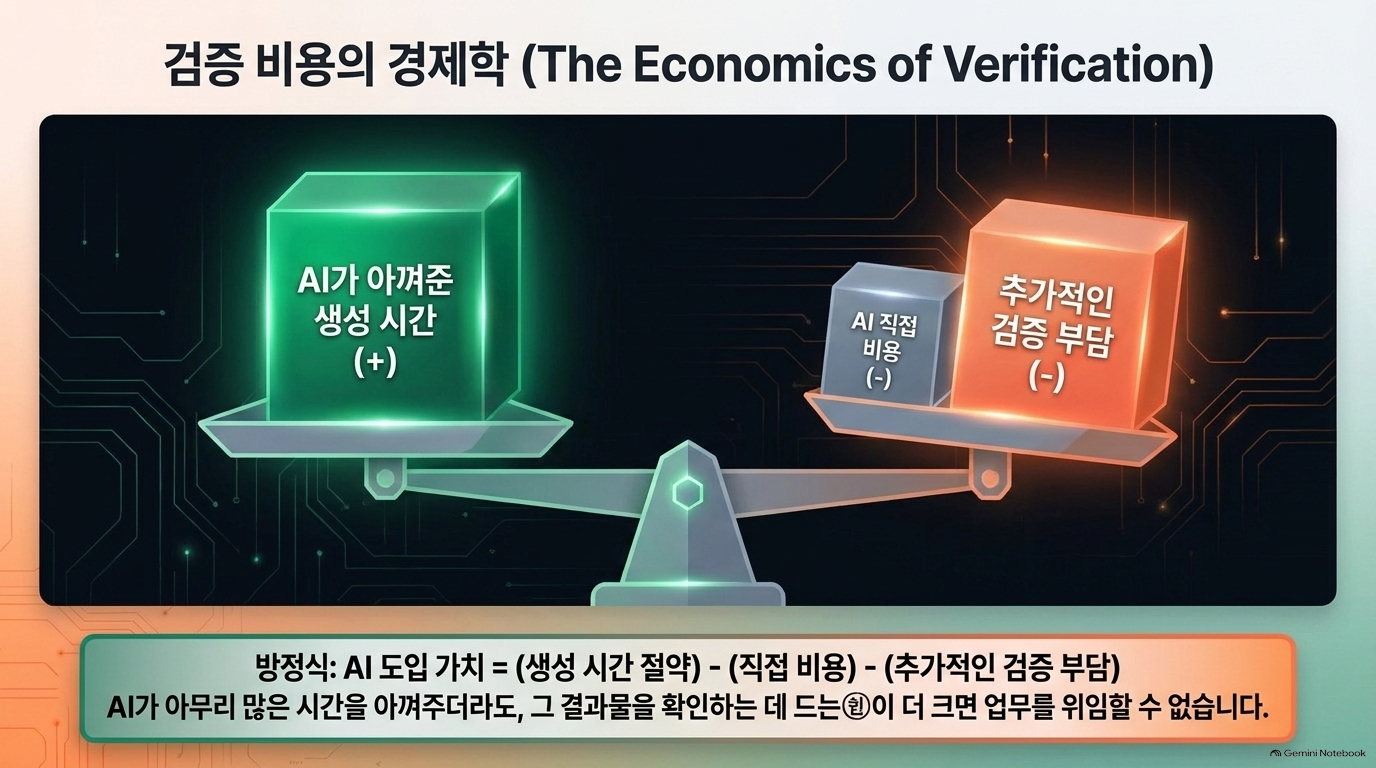
저자는 인간 또는 AI가 만든 결과물을 사용하기 전에 검증하는 상황을 설정합니다.
이때 검증부담 Verification burden은 단순한 검토시간이 아니라 다음 두 비용의 합입니다.[1, p.8, 식 2]
: 검증에 투입한 인건비
: 검증 후에도 중요한 오류가 남아 있을 확률
: 그 오류가 실제로 사용되었을 때 발생하는 손실
AI에 업무를 맡기는 순가치는 다음과 같습니다.[1, p.8, 식 3]
여기서 중요한 점은 인간의 결과물도 검증 대상이라는 것입니다. AI에 불리하게 계산해야 하는 것은 전체 검증비용이 아니라, 인간이 수행했을 때보다 추가되는 검증부담입니다.
Ⅱ.B. The Verification Burden: 오류를 얼마나 잘 발견할 수 있는가?
검증시간에 따른 잔존 오류확률을 지수함수로 설정하고, 오류 탐지율을 세 요소로 분해합니다.[1, pp.9–10, 식 4–5]
요소
의미
실무적으로 볼 질문
검증기술 𝜇 𝑖
중요한 오류를 저비용의 객관적 검사로 발견할 수 있는 정도
원문·테스트·계산식·절차와 대조할 수 있는가?
오류 가독성 ℓ 𝑟
오류가 검토자가 예상하는 위치와 방식으로 나타나는 정도
어디에서 틀릴지 예측하기 쉬운가?
검증자 전문성
중요한 오류를 찾아내는 검토자의 역량
업무 맥락과 오류 영향을 이해하는가?
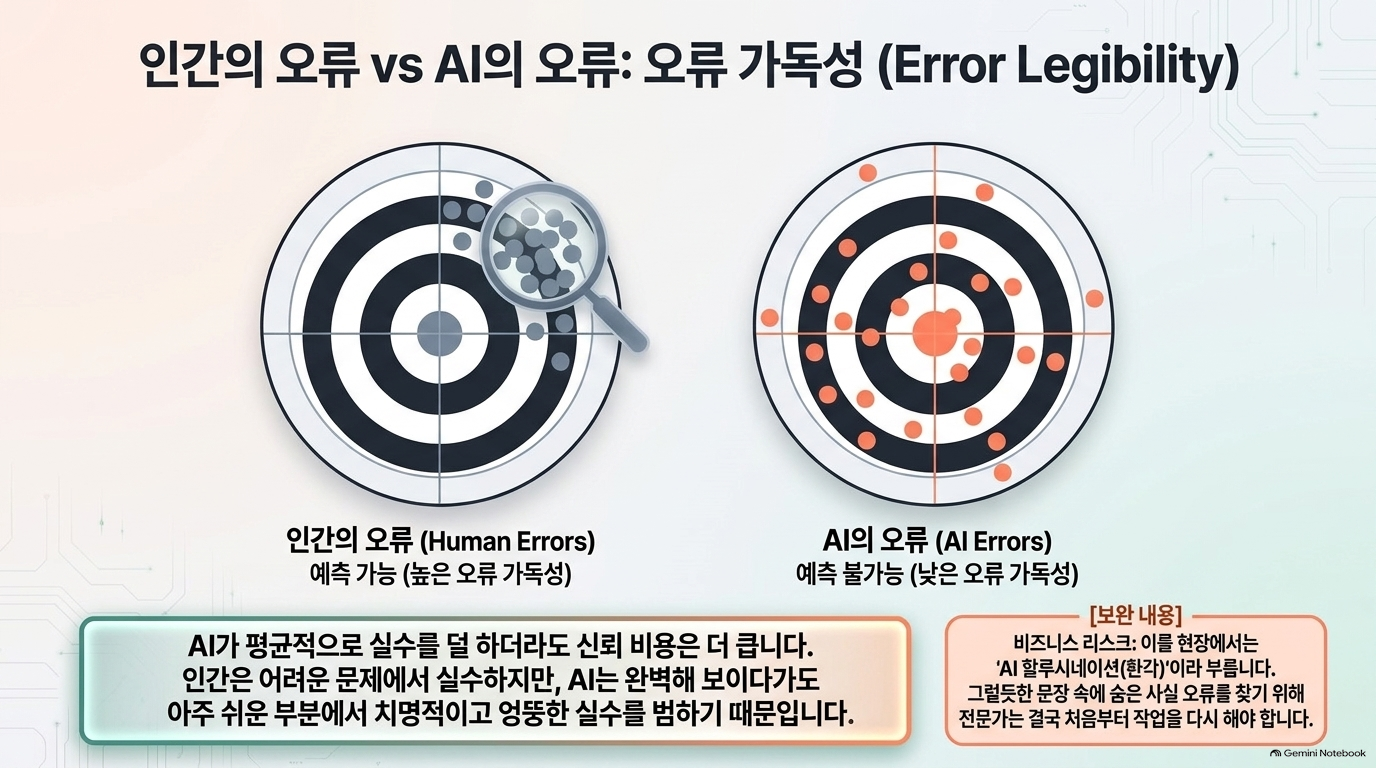
저자는 AI 오류가 인간 오류보다 찾기 어렵다는 관계를 모형에 설정합니다. AI는 어려운 문제를 해결하면서도 쉬운 부분에서 예상 밖의 오류를 낼 수 있기 때문이라는 설명입니다.[1, pp.9–10]
분석·평가:이 관계는 논문의 핵심 가정이지, 모든 업무에서 실제 탐지시간을 측정해 확인한 보편적 사실은 아닙니다.
Ⅱ.C. Results: 정확도가 높아도 신뢰비용은 높을 수 있다
모형은 두 가지 결과를 제시합니다.[1, pp.11–12]
① AI가 인간보다 덜 틀려도, 결과를 확인하는 비용은 더 클 수 있다.
오류 발생이 적더라도 어디를 확인해야 할지 예측하기 어렵다면, 검토자는 더 넓은 범위를 살펴야 합니다. 따라서 정확도와 검증 용이성은 별개의 성능 축입니다.
② 위임은 검증하기 쉽고 오류손실이 작은 업무에 집중된다.
다만 저비용 검증기술이 추가 검증부담을 낮춘다는 비교정태 결과에는 논문이 제시한 조건이 붙습니다. 이를 무조건적인 법칙으로 일반화해서는 안 됩니다.
Ⅱ.D. From the Model to the Measure: 이론을 실제 분류 규칙으로 바꾸기
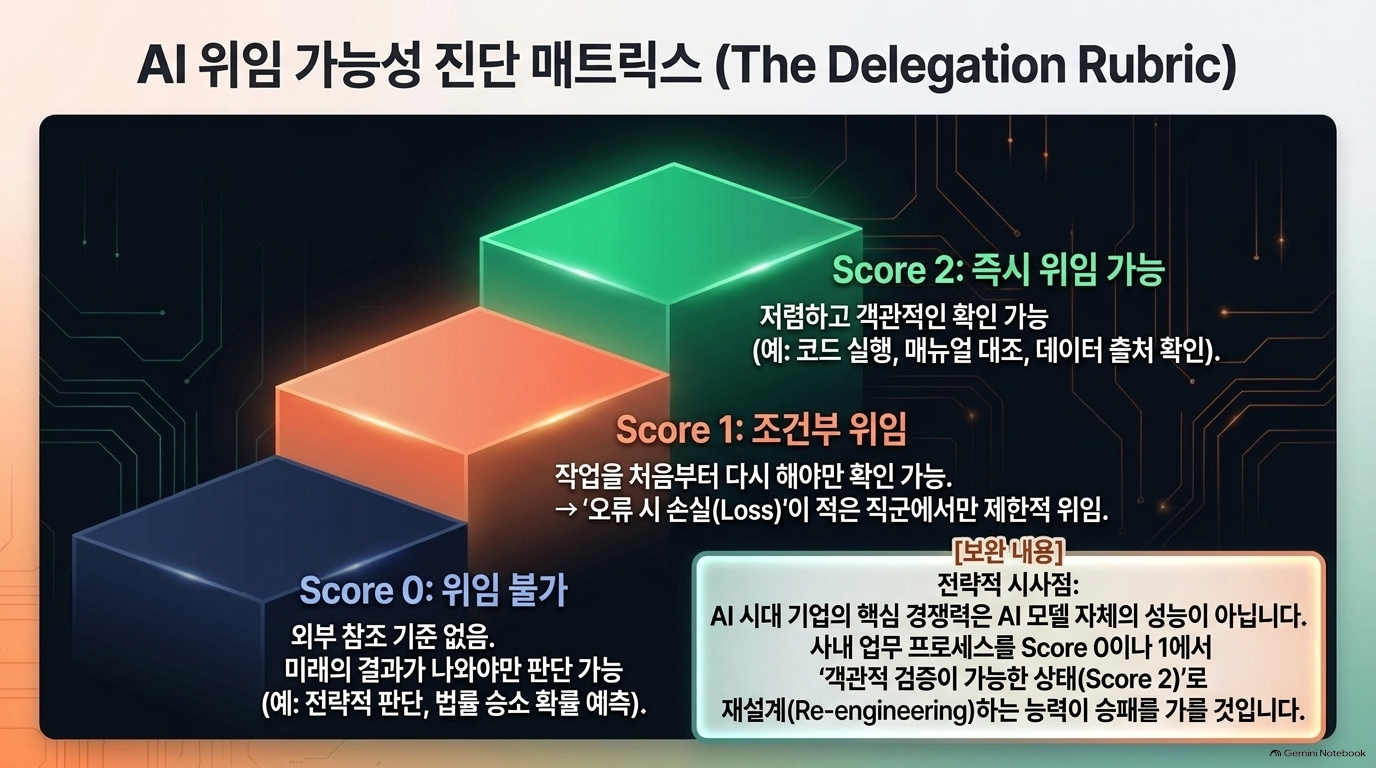
직접 관측하기 어려운 검증 용이성을 3등급으로 분류합니다.[1, pp.12–13]
검증등급
의미
논문의 위임 규칙
2
객관적 기준과 비교해 검증 가능
오류손실 수준과 관계없이 위임 가능
1
전문가가 업무를 다시 수행해야 검증 가능
소속 직업의 오류손실이 중앙값 미만일 때만 가능
0
사용 시점에 정답을 확인하기 어려움
위임 불가능
이 장에서 가장 중요한 한계
이론 모형의 연속적인 비용 판단이, 실증에서는 이산적인 통과·탈락 규칙으로 바뀝니다.
특히 다음을 구분해야 합니다.
등급 0은 항상 위임 불가능:저자가 명시한 측정상의 가정이며, 모형에서 자동으로 도출된 정리는 아닙니다.[1, p.13]
등급 1의 손실 기준은 중앙값:업무별 경제적 손익분기점을 직접 추정한 것이 아니라 공통 임계값으로 근사한 것입니다.[1, p.13]
등급 2는 손실과 무관하게 통과:검증 가능한 오류의 범위와 잔여위험을 충분히 고려했는지는 별도로 확인해야 합니다.
Ⅱ.E. Empirical Implications: 검증할 세 가지 예측
저자는 다음을 실증적으로 살펴봅니다.[1, p.14]
AI 활용도가 같아도 위임 가능성은 다를 것이다.
시간 절약의 차이보다 검증부담의 차이가 위임 가능성을 설명할 것이다.
AI가 노동을 대체한다면, 검증하기 쉬운 업무에 대한 노출을 통해 고용효과가 나타날 것이다.
뒤의 결과에서는 첫 번째 구분은 뚜렷하지만, 세 번째 노동시장 예측은 지지되지 않습니다.
Ⅲ. Data Sources and Measurement — 데이터와 지표 구성
PDF pp.15–21
Ⅲ.A. 데이터 구성
분석 요소
자료와 범위
업무·직업
O*NET 업무 17,951개, 6자리 SOC 직업 774개
AI 역량
Eloundou 등의 업무별 역량 평가
AI 활용
Anthropic Economic Index, 2026년 6월 공개 자료의 미국 사용
고용 가중치
2022년 OEWS 고용
미래 고용
BLS 2025–2035년 고용 전망
실제 노동시장
CPS 2015–2026년, 16–64세
출처: 원문 Ⅲ.A.[1, pp.15–16]
Ⅲ.B. 세 가지 노출지표
지표
의미
해석
역량 노출도
AI가 시간 절감에 기여할 수 있는 업무의 가중치
관측 노출도
역량·사용 게이트와 자동화 가중치를 반영한 노출
위임 가능 노출도
관측 노출 중 검증·손실 규칙을 통과한 부분
위임 가능 노출도는 다음과 같습니다.[1, p.16, 식 14]
: 직업 내 업무별 시간 비중
: 역량 및 미국 활용자료 출현 여부
: 자동화 방식의 활용에 더 큰 값을 주는 가중치
: 검증·손실 규칙에 따른 위임 가능 여부
주의:
는 실제 근로시간을 현장에서 직접 관찰한 비율이 아닙니다. 추정 시간 비중과 AI 사용자료를 결합한 구성지표입니다.
또한 확실하게 성립하는 관계는
입니다. 역량지표와 관측지표는 가중 방식이 달라 항상 인 것은 아닙니다.실제 Table IV에서 데이터 입력 직업의 역량 노출은 0.500, 관측 노출은 0.812입니다.[1, p.47]
Ⅲ.C–D. 시간 비중과 활용 게이트
업무별 시간 비중은 LLM이 직업명과 업무 목록을 받아 추정합니다. 프롬프트를 바꾼 추정치 사이의 상관계수는 0.96입니다.[1, pp.16–17]
활용은 미국 사용자료에 해당 업무가 나타나는지로 판단하며, 자동화 형태의 사용에 더 높은 가중치를 부여합니다.[1, p.17]
분석·평가
높은 프롬프트 간 상관은 추정의 일관성이지 실제 시간 배분의 정확성은 아닙니다.
사용자료에 나타나지 않는 업무를 0으로 처리하므로, 미관측과 미사용을 완전히 구분하기 어렵습니다.
특정 제공자의 사용 패턴을 경제 전체의 업무 활용으로 일반화하는 데 한계가 있습니다.
Ⅲ.E. 검증등급 코딩의 신뢰도
저자는 30개 업무로 예비 루브릭을 개발하고, 237개를 직접 분류했습니다. 전체 17,951개 업무는 LLM이 분류했으며, 최종 지표에는 모델의 분류값이 들어갑니다.[1, pp.18–20]
비교 대상
업무 수
정확 일치율
가중 카파
전체 비교 표본
237
69.2%
0.683
정보적 업무
198
66.2%
0.611
출처: Table I.[1, p.45]
분석·평가:일치도 확인은 장점이지만, 이는 분류의 정답률 검증은 아닙니다.특히 지식업무에 가까운 정보적 업무에서 일치도가 더 낮고, 등급이 바뀌면 위임 가능 여부도 달라질 수 있습니다.
Ⅲ.F–G. 오류손실과 위임 판정
오류손실은 O*NET의 다음 두 항목을 표준화·평균한 뒤 백분위로 변환합니다.[1, p.20]
오류의 결과: Consequence of Error
동료 또는 기업 성과에 대한 의사결정의 영향
핵심 한계:업무별 손실이 아니라 직업 단위 손실 대리변수입니다. 같은 직업 안의 단순 문서 처리와 고위험 의사결정에 동일한 손실 순위가 적용될 수 있습니다.
Ⅳ. Results — 분석 결과
PDF pp.21–32
Ⅳ.A. Summary Statistics: 얼마나 위임 가능한가?
구분
직업 수
분석 대상 전체
774
위임 가능한 업무가 하나 이상 있는 직업
265
AI 활용은 관측되지만 위임 가능 업무가 없는 직업
141
역량·활용 게이트를 함께 통과한 업무가 없는 직업
368
출처: Table II.[1, p.45]
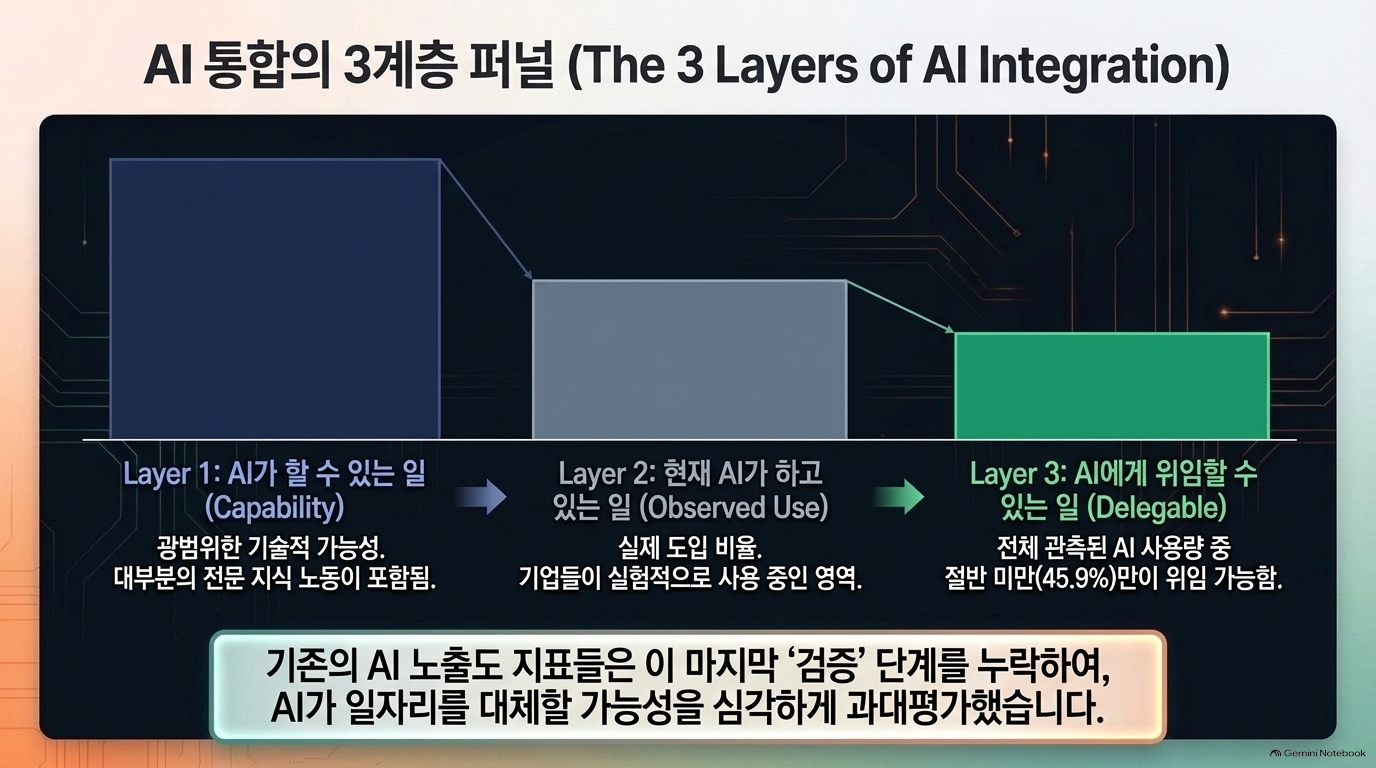
위임 가능 노출도의 직업별 평균은 전체 표본에서 3.0%, AI 사용이 관측된 406개 직업에서 5.7%입니다. 후자의 관측 활용 대비 위임 가능 비율
의 평균은 45.9%입니다.[1, pp.21–22, 46]
45.9%를 정확히 해석하면
AI 사용이 관측된 직업들에서, 각 직업의 ‘관측 노출 대비 위임 가능 노출’ 비율을 평균한 값입니다.
다음과는 다릅니다.
미국 전체 노동시간의 45.9%
AI가 수행한 모든 업무를 합산한 뒤 계산한 위임 비율
인간 검토 없이 자동화 가능한 비율
실제로 이미 대체된 노동 비율
따라서 “AI 업무의 절반 이상은 위임 불가능하다”는 제목식 요약에는 표본과 산출방식의 한정이 필요합니다.
Ⅳ.B. The Three Layers: 직업군별 차이
직업군
역량 노출
관측 노출
위임 가능 노출
컴퓨터·수학
57%
39%
27%
사무·행정지원
55%
21%
19%
출처: 원문 Ⅳ.B 및 Figure I.[1, pp.22–23, 38]
컴퓨터·수학 직업군은 위임 가능한 업무 비중이 높습니다. 사무·행정지원은 역량 대비 활용이 낮지만, 현재 관측된 활용 중에서는 검증 규칙을 통과하는 비중이 높습니다.
반면 법률 분야는 관측 활용과 위임 가능성 사이의 간격이 큽니다.
분석·평가:이는 법률업무에서 AI가 쓸모없다는 뜻이 아닙니다. 보조도구로서의 가치와 업무를 맡길 수 있는 범위를 구분한 결과입니다.
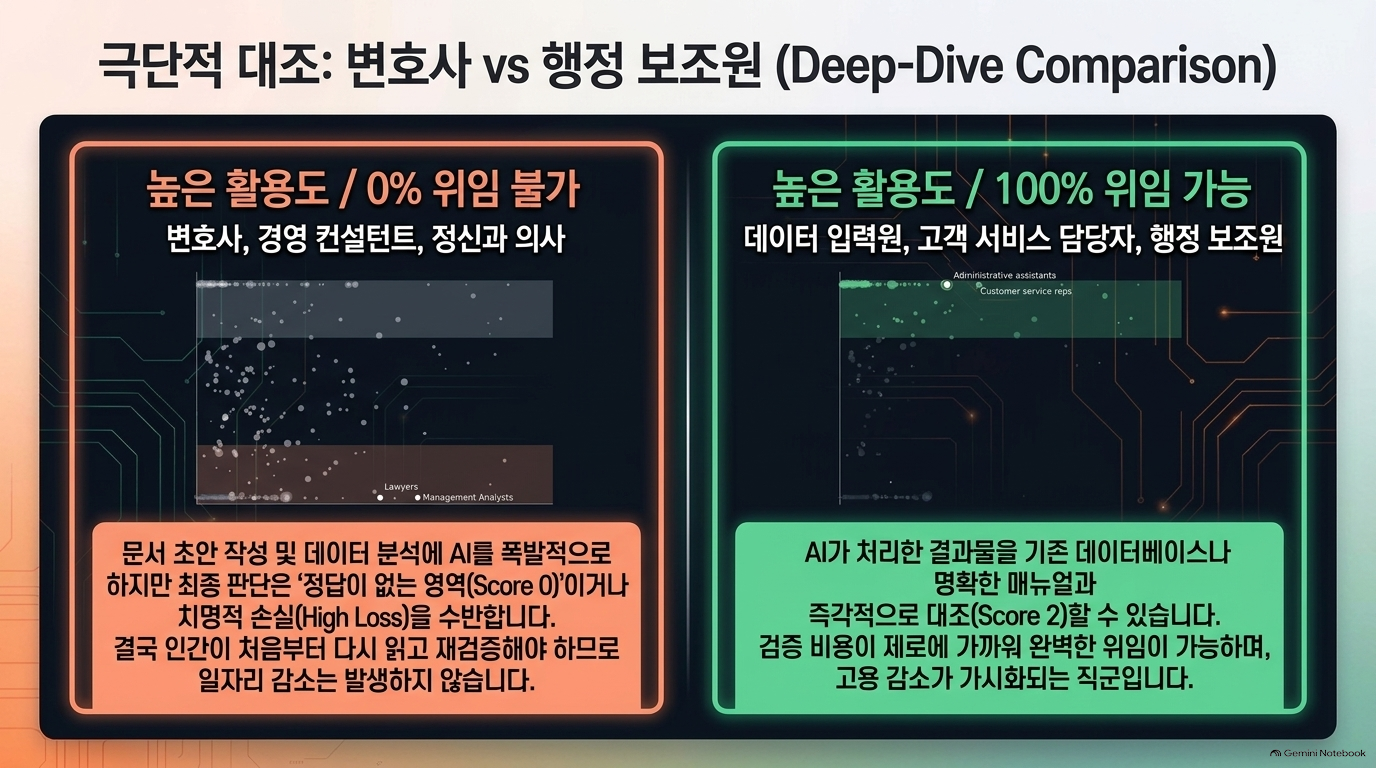
Ⅳ.C. Where Use and Delegability Come Apart: 비슷하게 사용해도 위임 가능성은 다르다
직업
관측 노출 𝑂 𝑗
위임 가능 노출 𝐴 𝑗
관측 활용 중 통과 비율
경영분석가
0.424
0.000
0%
변호사
0.344
0.000
0%
파일 관리 사무원
0.438
0.438
100%
고객서비스 담당자
0.291
0.291
100%
데이터베이스 관리자
0.137
0.137
100%
출처: Table IV.[1, p.47]
이 표가 보여주는 것은 AI 사용량만으로 위임 가능성을 판단하기 어렵다는 점입니다.
단, 100%는 그 직업 전체가 아니라 관측 노출에 포함된 업무가 모두 분류 규칙을 통과했다는 의미입니다. 데이터베이스 관리자 전체 업무를 자동화할 수 있다는 결론은 아닙니다.
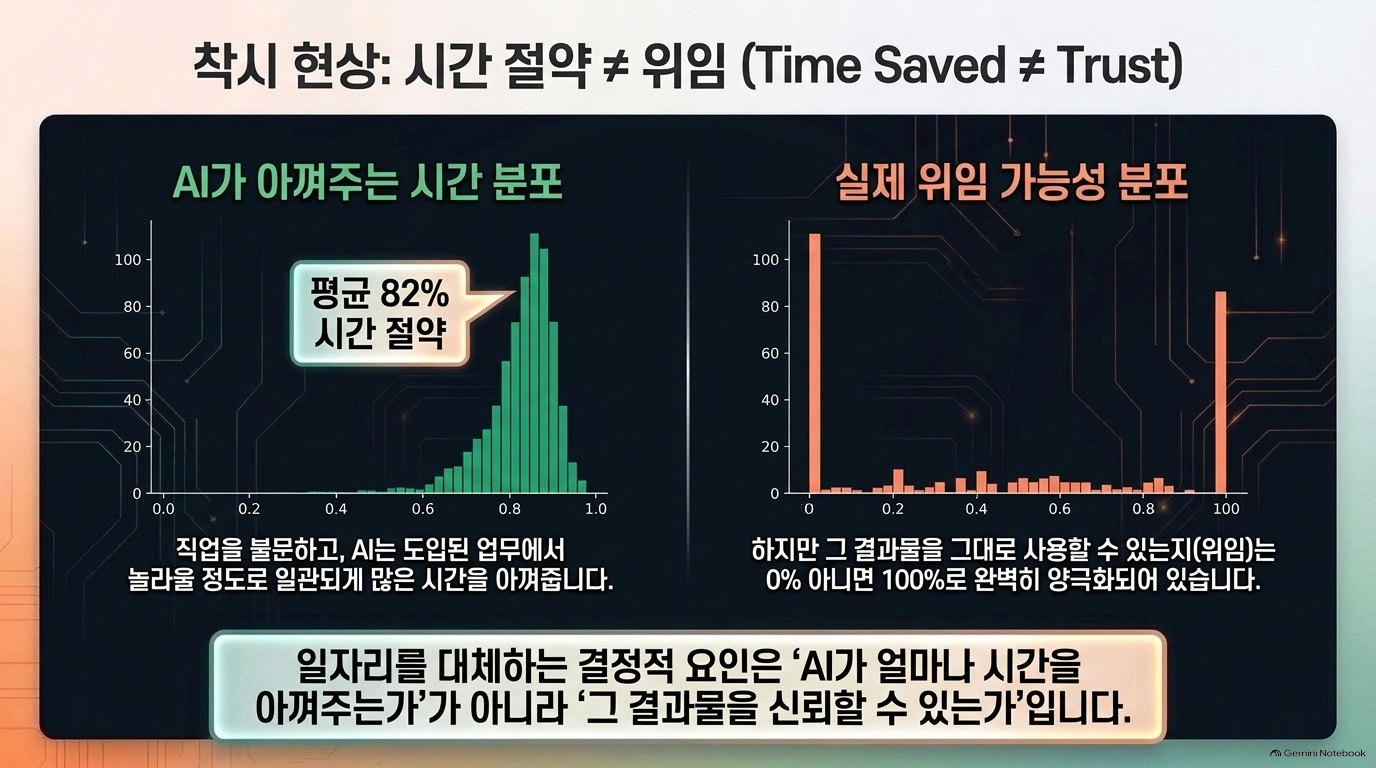
Ⅳ.D. Generation Saving versus Delegability: 시간 절약과 위임 가능성의 분포
저자가 비교한 직업별 분포는 다음과 같습니다.[1, p.25, Figure III p.40]
항목
평균
표준편차
AI 활용 업무의 추정 시간 절약률
82%
0.10
관측 활용 대비 위임 가능 비율
약 46%
0.42
시간 절약률은 상대적으로 비슷하지만, 위임 가능 비율은 0과 1 부근으로 크게 갈립니다.
분석·평가
이 결과는 검증 특성을 별도로 고려할 필요성을 보여줍니다. 다만 다음 이유로 “검증비용이 직업 간 차이를 인과적으로 설명했다”고까지 보기는 어렵습니다.
시간 절약률은 실제 근무시간 측정이 아니라 Claude가 대화에서 추정한 값입니다.
위임 가능성은 검증등급을 반영하도록 만든 지표입니다.
이산적 통과 규칙 자체가 극단적인 분포에 기여할 수 있습니다.
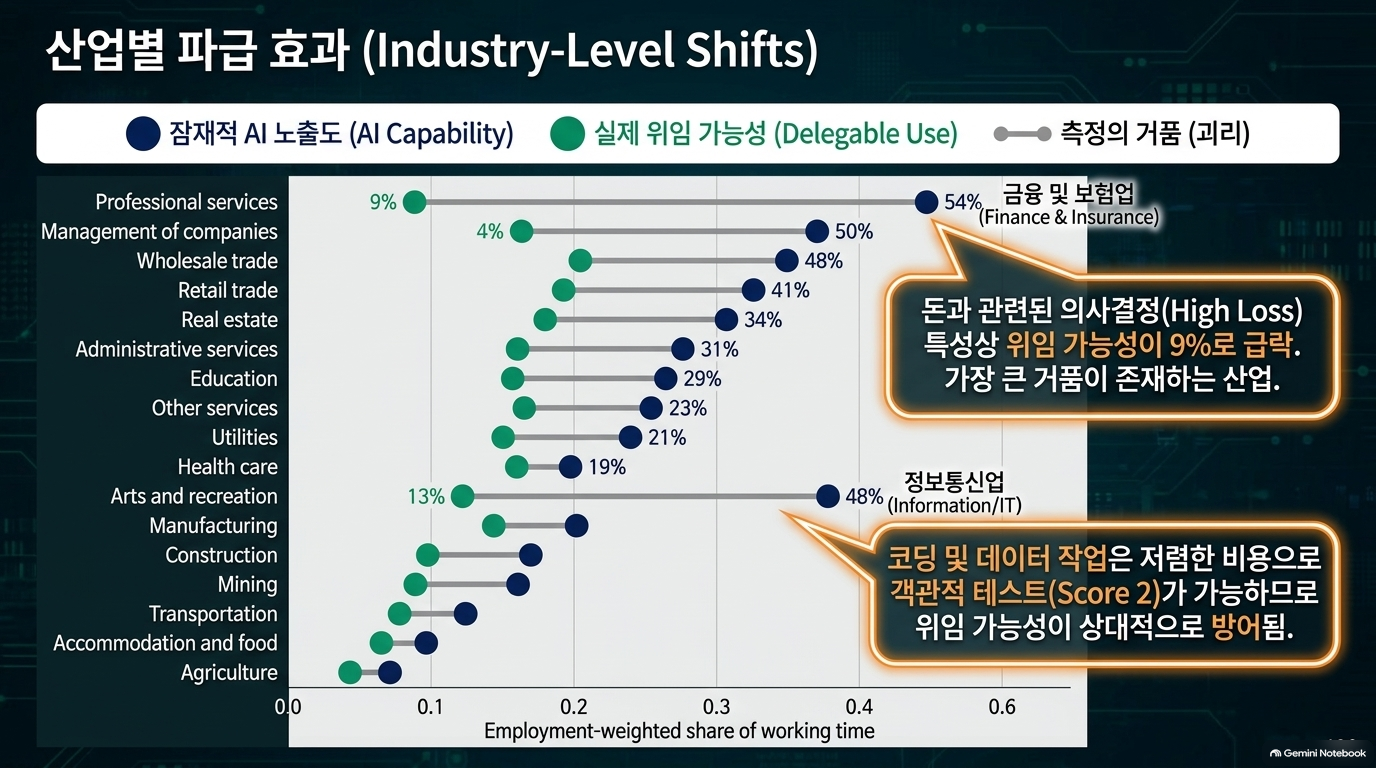
Ⅳ.E. Industry-Level Aggregation: 산업 순위도 달라진다
산업지표는 산업별 직업 구성에 직업별 노출도를 적용한 고용가중 평균입니다.[1, pp.25–26]
산업
역량 노출
위임 가능 노출
금융·보험
약 54%
약 9%
정보산업
약 48%
약 13%
출처: 원문 서론의 산업 비교 및 Figure IV.[1, p.5, p.41]
금융·보험은 역량 노출이 더 높지만, 검증을 고려하면 정보산업의 위임 가능 노출이 더 높아집니다.
분석·평가:산업 차이는 이 분석에서 고용한 직업의 구성 차이로 설명됩니다. 동일 직업이 산업마다 수행하는 업무나 검증체계가 다른 효과를 직접 측정한 것은 아닙니다.
Ⅳ.F. Projected Employment Growth: 미래 고용 전망과는 음의 관계
2025–2035년 고용 전망을 위임 가능 노출도에 회귀한 계수는 −23.4, 표준오차는 6.1입니다. 위임 가능 노출도가 0.1 높은 직업은 전망 고용증가율이 약 2.34%포인트 낮습니다.[1, pp.26–28]
하지만 저자도 다음 한계를 인정합니다.
전망치에 이미 AI 영향에 대한 예상이 반영되었을 수 있음
데이터 입력 등 기존 감소 직업의 장기추세가 반영되었을 수 있음
AI 이전에 작성된 고용 전망을 이용한 위약검증은 수행하지 않음
소프트웨어 개발자는 위임 가능 노출이 약 0.35인데도 고용이 약 10% 증가할 것으로 전망됩니다. 저자는 이를 수요 증가와 양립 가능한 사례로 설명합니다.[1, p.27]
판단:이 절은 예측치와의 상관관계이지, AI 위임 때문에 고용이 감소했다는 실증은 아닙니다.
Ⅳ.G. Labor-Market Outcomes: 실제 고용 대체효과는 확인되지 않았다
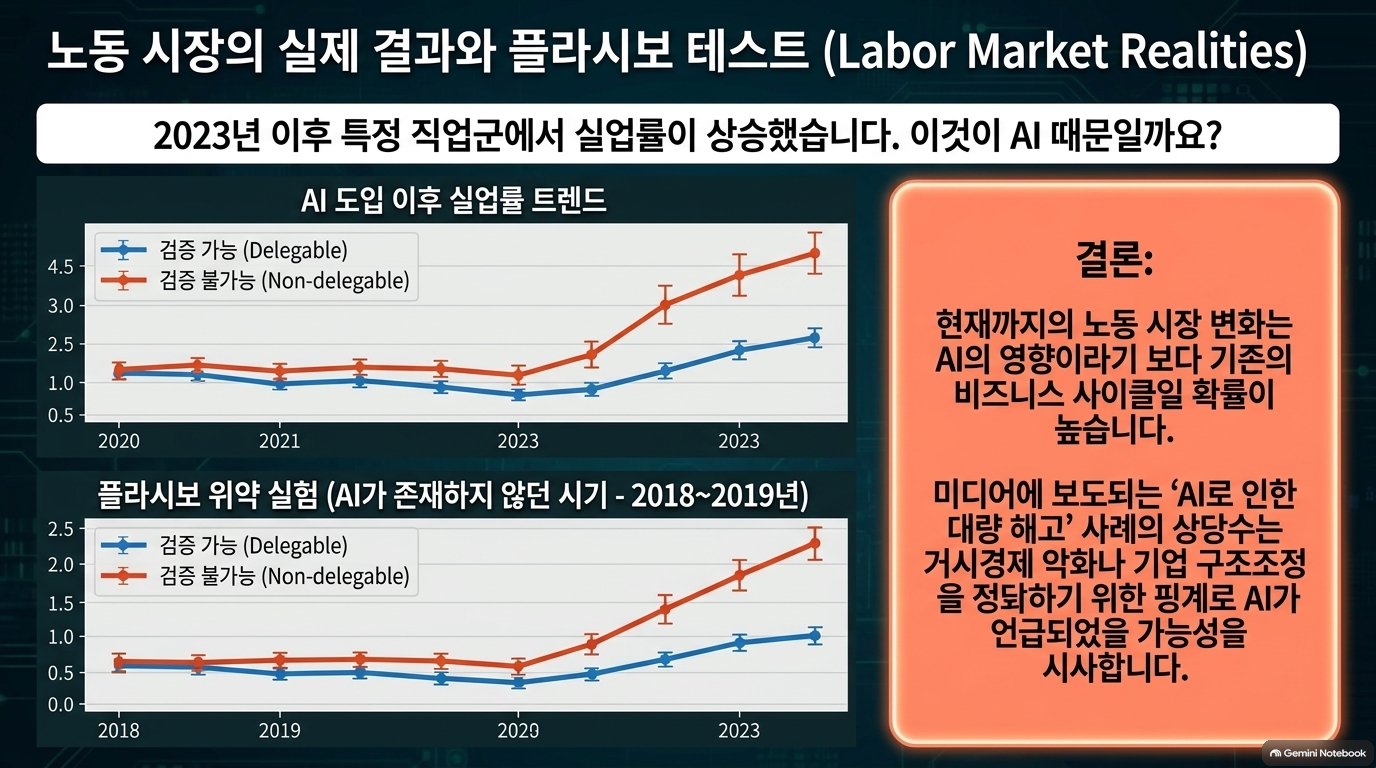
실제 노동시장 분석에서는 관측 노출을 다음으로 나눕니다.[1, pp.28–30]
객관적으로 저렴하게 검증할 수 있는 업무: 검증등급 2
그렇게 검증하기 어려운 업무: 검증등급 0 또는 1
289개 직업, 2,951개 직업-연도 관측치를 중심으로 실업률·구직성공률·채용률·청년 비중·근로시간·로그 고용을 분석합니다. 구직성공률 회귀의 관측치는 이보다 적습니다.[1, p.30, Table V p.48]
결과는 논문의 노동대체 가설을 지지하지 않습니다.
검증하기 쉬운 업무에 대한 노출계수는 여섯 결과 모두 5% 수준에서 유의하지 않았습니다.
검증하기 어려운 업무의 노출에서는 일부 유의한 관계가 나타났지만, 유사한 패턴이 생성형 AI 확산 이전의 위약기간에도 나타났습니다.[1, pp.30–32]
예를 들어 검증하기 어려운 업무 노출의 실업률 계수는 실제 분석에서 +0.467%포인트, 위약분석에서 +0.285%포인트였습니다.[1, p.48]
이 절의 의미
검증 가능성이 경제적 위임의 중요한 조건이라는 모형은 제시했지만, 그 경로가 실제 고용 감소로 이어졌다는 증거는 확보하지 못했습니다.
위약검증을 통해 단순한 사후 상관관계를 AI 효과로 해석하지 않은 점은 강점입니다. 반대로 유의하지 않다는 결과가 AI의 고용효과가 정확히 0임을 입증하는 것은 아닙니다.
또한 이 절의 ‘검증하기 쉬운 업무’ 구분은 최종 위임지표와 동일하지 않습니다. 최종 지표에서는 등급 1도 손실이 낮으면 통과하므로, 고용분석은 위임지표의 모든 구성요소를 그대로 분해한 검증은 아닙니다.
Ⅴ. Conclusion — 결론
PDF p.33
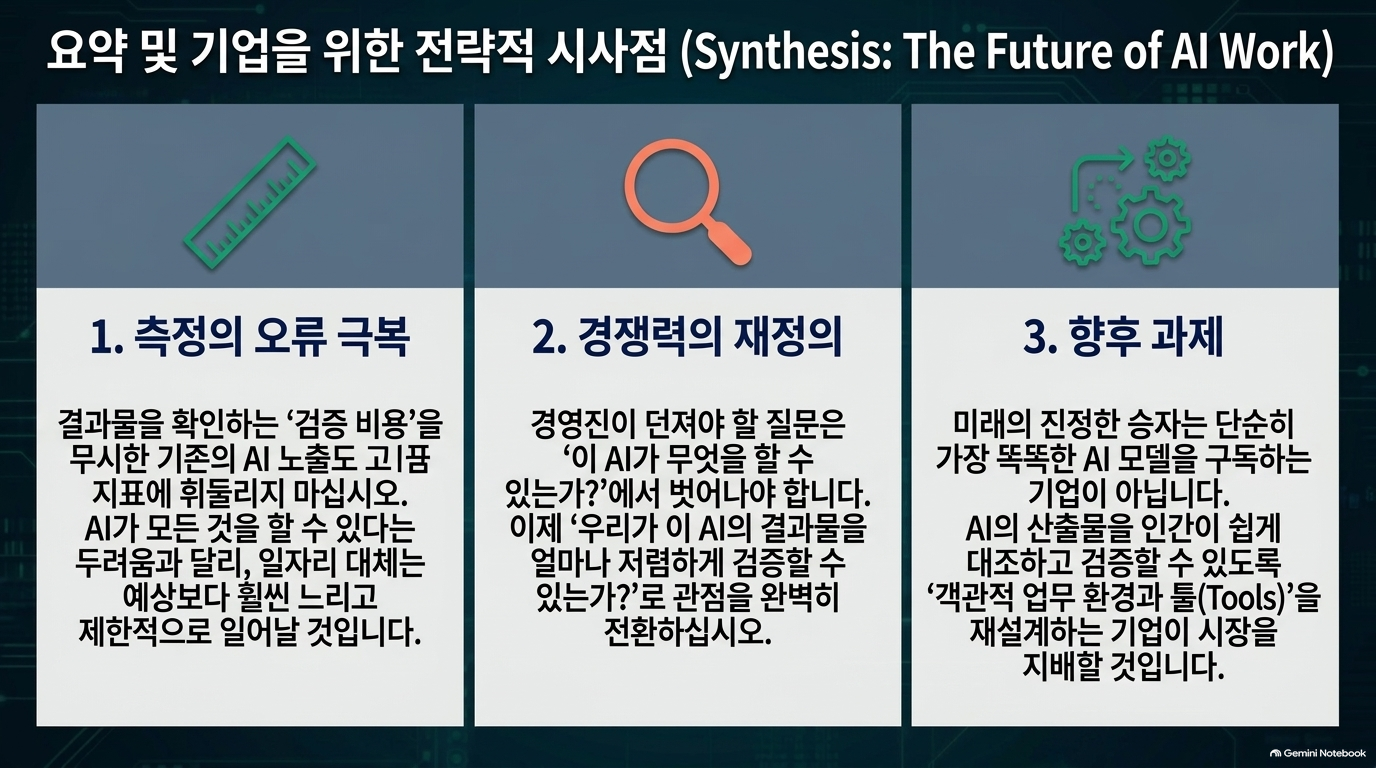
저자의 결론은 세 가지입니다.[1]
검증을 제외한 노출지표는 AI가 맡을 수 있는 업무 범위를 과대평가할 수 있다.
생성시간 절약만으로 위임 가능성의 차이를 설명하기 어렵다.
결과물을 저렴하게 확인하는 기술이 발전하면 위임 범위가 확대될 수 있다.
향후 과제로는 지표의 시계열 갱신, 기업별 AI 도입시점 자료를 활용한 인과분석, 인간과 AI의 업무 맥락·정보 격차 측정을 제시합니다.
분석·평가
가장 실용적인 메시지는 모델의 성능 향상만이 아니라 검증체계에 대한 투자도 자동화의 범위를 넓힌다는 것입니다.
다만 “검증도구의 개선이 모델 성능 향상보다 효과가 더 크다”는 비교는 이 논문이 직접 수행한 투자효과 실험의 결과가 아니라, 모형과 측정결과에서 도출한 시사점입니다.
Ⅵ. LLM Assistance Statement — LLM 활용 공개
PDF p.34
논문은 다음 활용을 공개합니다.[1]
Claude Opus 4.8:집필·코딩·서식 지원
GPT-5.6 Sol:루브릭에 따른 업무 검증등급 분류
분석·평가
LLM 활용 공개는 투명성 측면의 장점입니다. 다만 핵심 설명변수인 검증등급을 LLM이 생성했으므로, 재현성과 타당성을 판단하려면 분류 프롬프트·모델 설정·업무별 분류값·불일치 사례·대안 분류에 대한 민감도를 추가 확인할 필요가 있습니다.
종합 평가
1. 이 논문이 보여준 것과 보여주지 못한 것
구분
평가
개념적 기여
AI의 역량·활용·위임을 구분하고 검증부담을 비용으로 명시
측정적 기여
검증등급과 오류손실을 결합한 업무·직업별 지표 제안
기술통계 결과
같은 AI 활용 수준에서도 규칙상 위임 가능성이 크게 다름
전망과의 관계
위임 가능 노출이 높을수록 전망 고용증가율이 낮음
실제 고용 인과효과
확인하지 못함
실제 검증비용 측정
직접 수행하지 않음
2. 주요 보완·확인 사항
우선순위
검토사항
이유
높음
[보완 필요] 실제 검증시간·잔존 오류·손실 측정
분류 기반 지표와 실제 경제성을 연결해야 함
높음
[확인 필요] 등급 2의 검증 범위와 미탐지 위험
기준자료가 있어도 중요한 오류를 모두 찾는 것은 아님
높음
[보완 필요] 업무 단위 오류손실
직업 평균으로 업무별 위험 차이를 설명하기 어려움
중간
[보완 필요] 분류·손실 임계값 민감도
등급과 중앙값 기준 변화가 결과에 미치는 영향 확인
중간
[보완 필요] 다중 제공자·현장자료 검증
단일 제공자 사용자료의 대표성 한계
중간
[보완 필요] 기업별 도입자료를 통한 인과 식별
실제 도입과 고용 변화의 경로 확인
최종적으로 이 논문은 ‘AI가 일자리를 얼마나 없애는가’를 확정한 연구라기보다, ‘AI에 업무를 맡길 때 검증을 어떻게 비용과 측정에 포함할 것인가’를 제안한 연구로 읽는 것이 가장 정확합니다.