https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
2026.9.30
[Gemini 4 Argon: our next era of frontier intelligence]
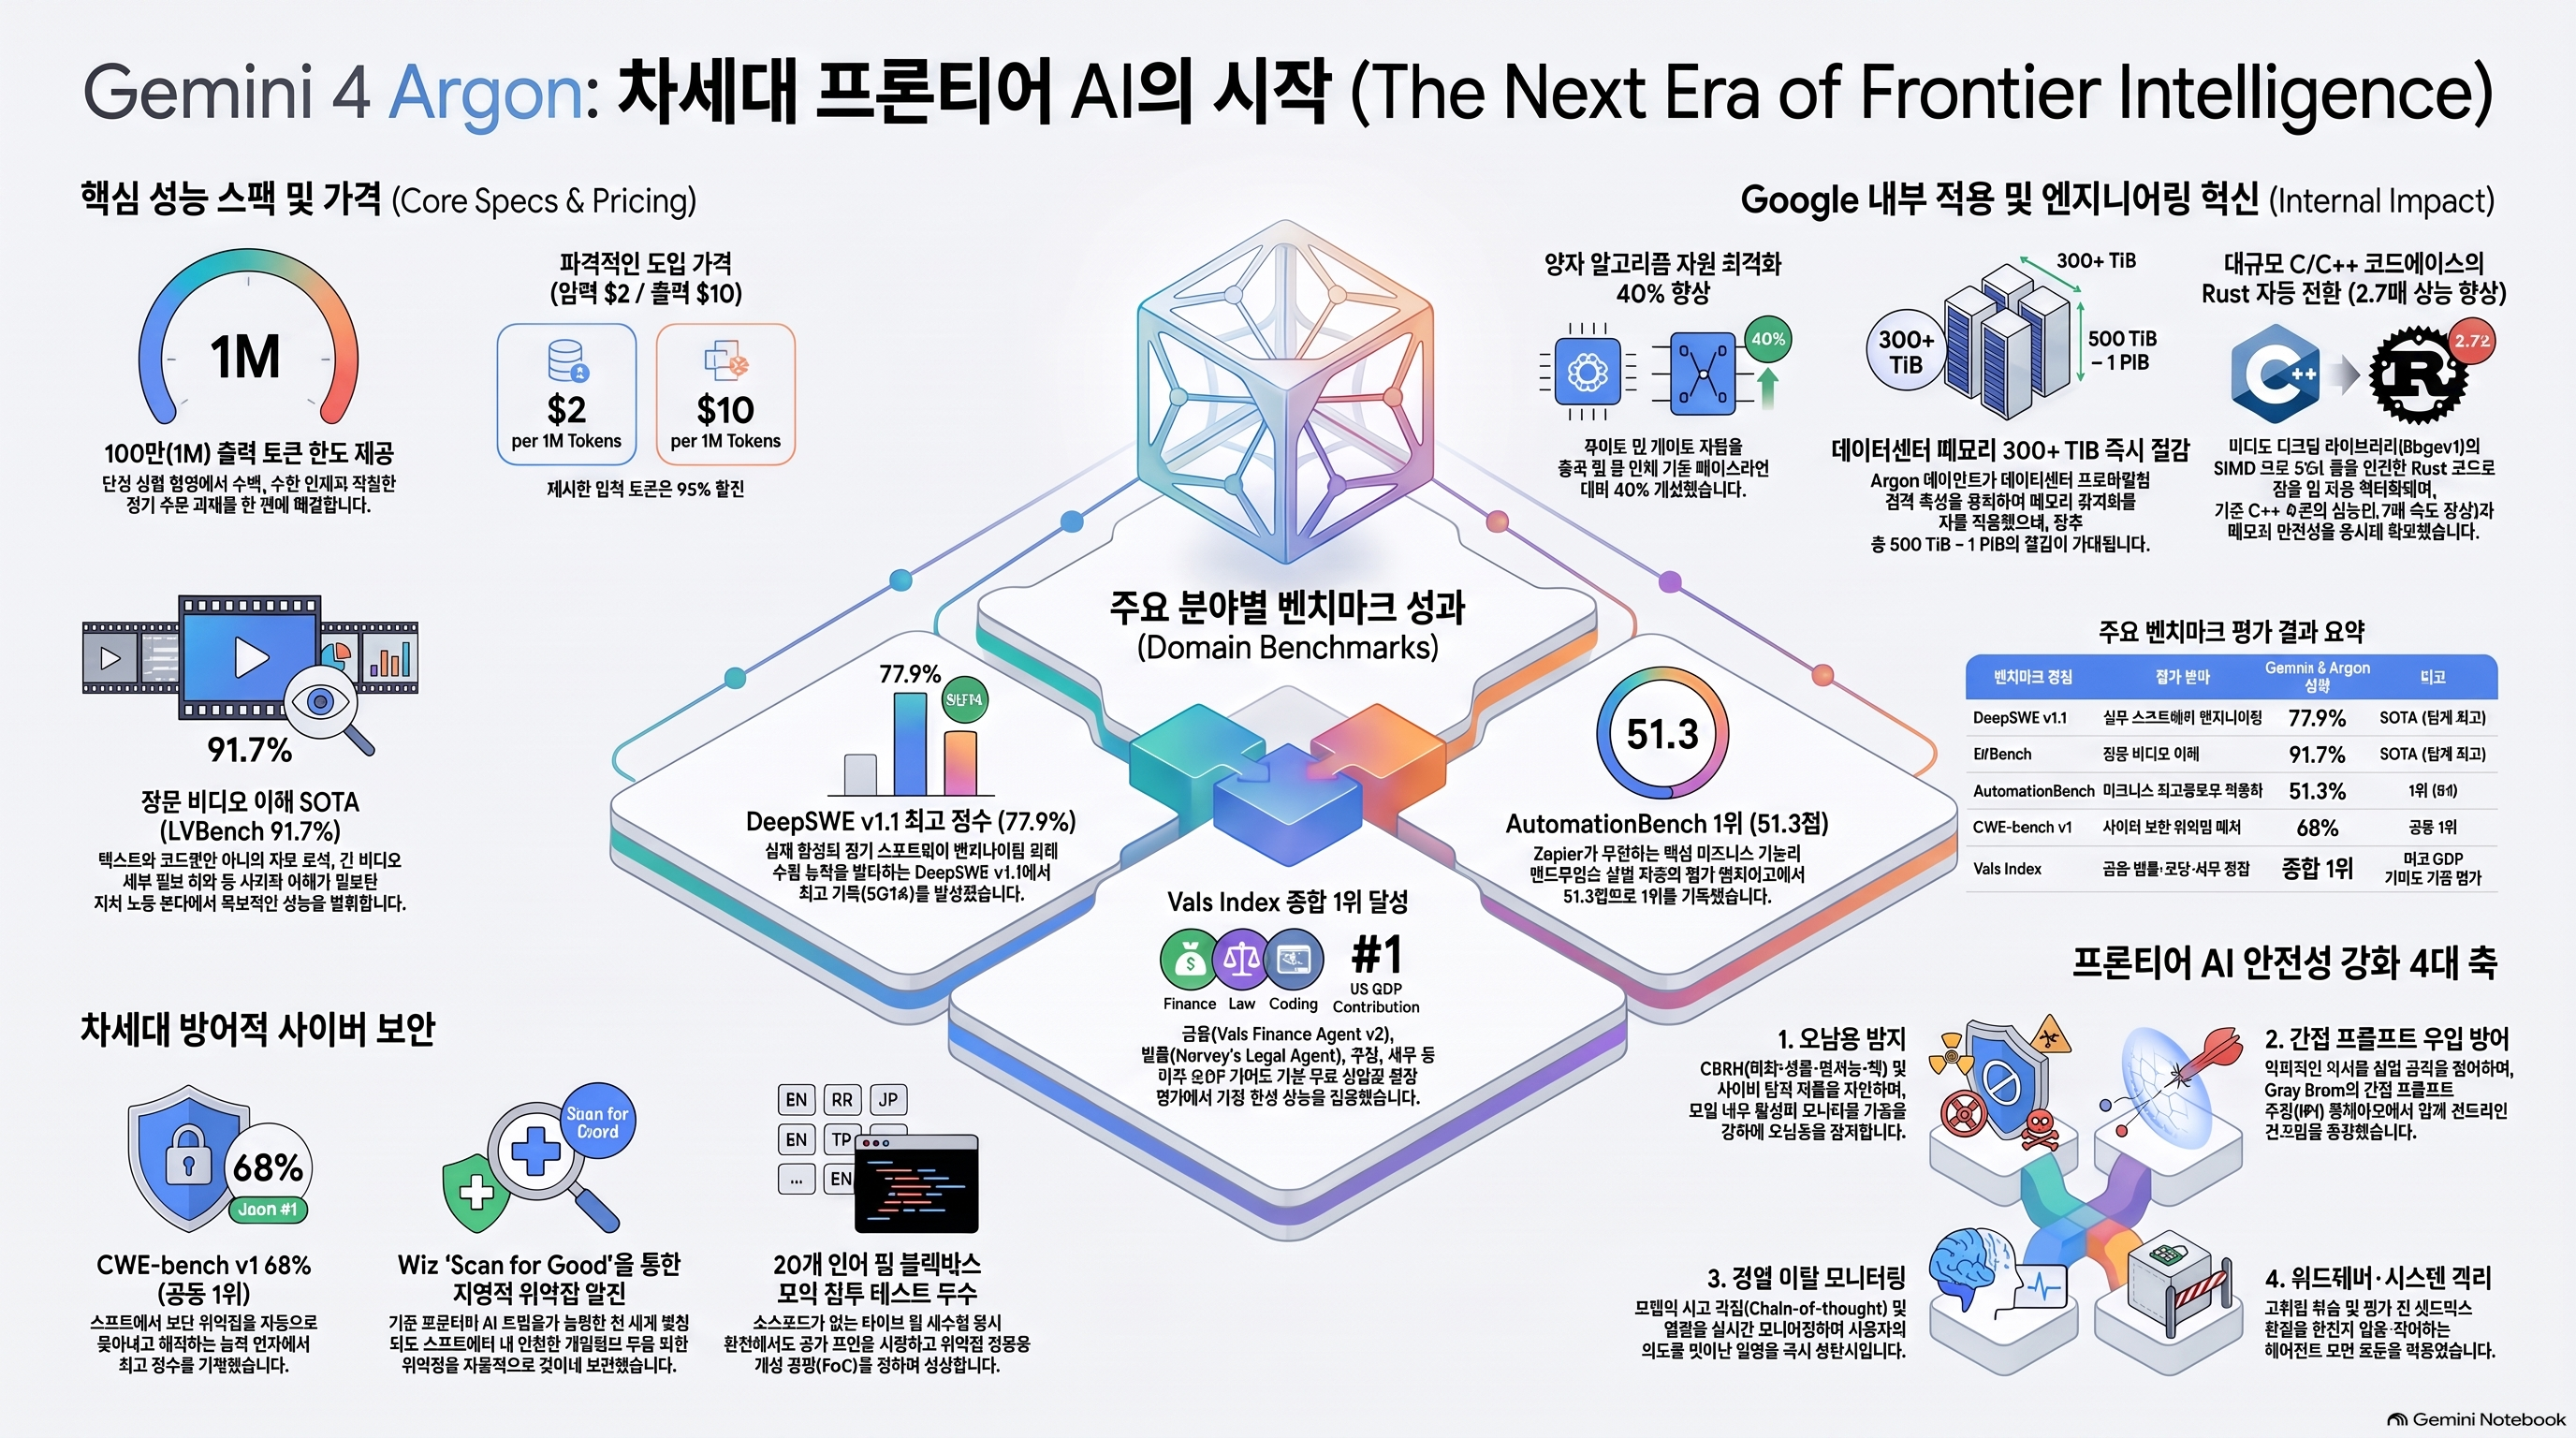
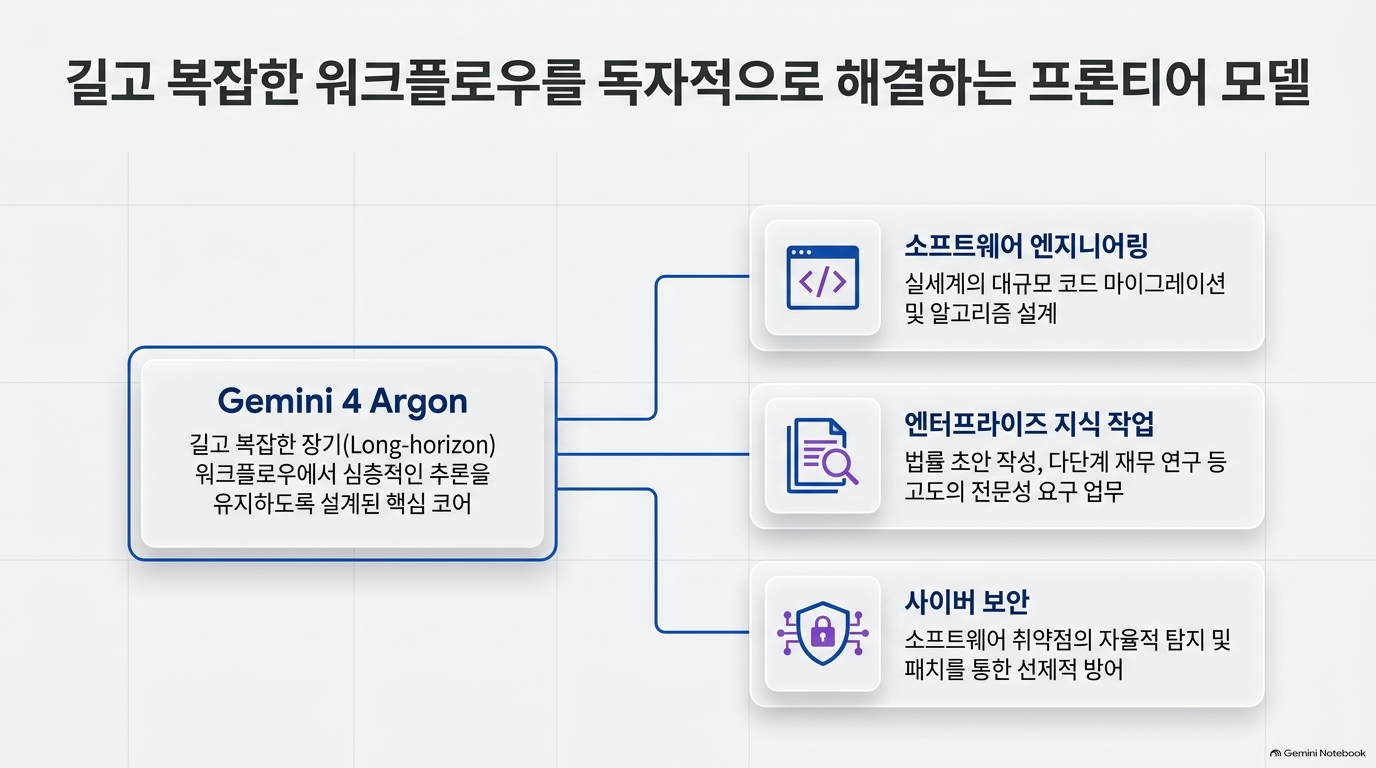
이 글의 중심 메시지는 “더 좋은 답변을 생성하는 모델”에서 “장시간 전문 업무를 수행하는 모델”로의 전환입니다. Google은 이를 소프트웨어 개발, 법률·금융 지식업무, 사이버 방어 사례로 설명하고 있습니다.[1]
다만 이 문서는 제품 출시 발표문입니다. 기술 논문이나 독립 검증 보고서와 구분해야 합니다. 아래에서는 원문의 실제 소제목 순서를 따르되, Google의 주장 → 근거와 한계 → 실무적 해석을 분리했습니다. 본문에 삽입된 벤치마크 이미지와 별도 평가 방법론도 함께 확인했습니다.[1][2]
| 구분 | 원문에서 확인한 내용 |
| 제목 | Gemini 4 Argon: our next era of frontier intelligence |
| 게시일 | 2026년 9월 30일 |
| 작성자 | Koray Kavukcuoglu — Google DeepMind SVP 겸 Google Chief AI Architect |
| 핵심 변화 | 장시간·다단계 업무 수행, 출력 토큰 한도 확대, 전문 업무 및 사이버 방어 강화 |
| 공개 방식 | 신뢰할 수 있는 사이버 방어 조직에 우선 제공한 뒤 단계적 확대 |
| 해석상 주의 | 벤치마크별 평가 조건이 다르며, 모든 영역에서 최고 성능인 것은 아님 |
위 정보는 발표문과 평가 방법론에 기재된 내용입니다.[1][2]
도입부. 성능 발표보다 먼저 제시하는 ‘단계적 공개’
원문 내용
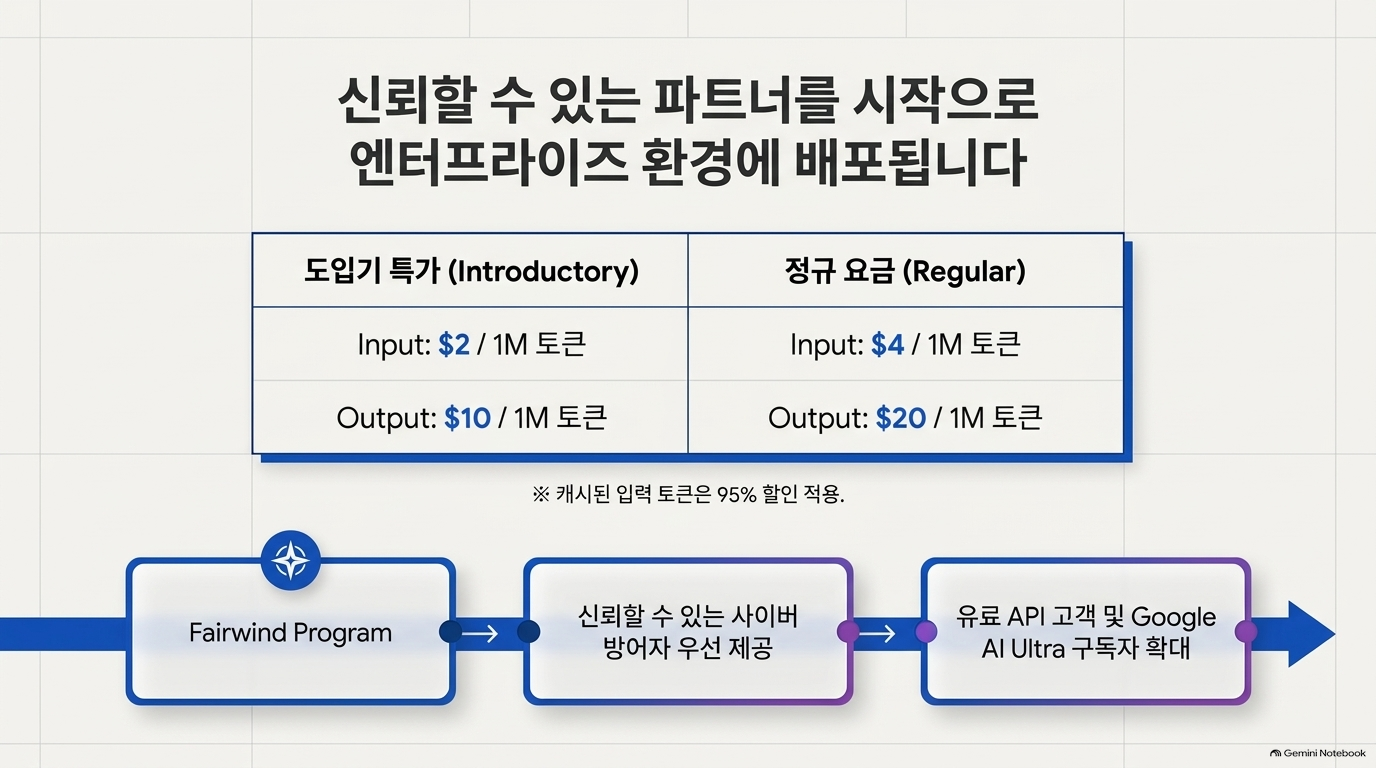
Google은 Argon을 Fairwind Program을 통해 일부 신뢰할 수 있는 사이버 방어 조직에 제공한다고 설명합니다. 일반 개발자·기업·소비자에게는 초기 사용자 피드백과 가드레일 개선을 거친 뒤 접근을 확대할 계획입니다. 미국 정부의 자발적 출시 전 모델 접근 절차에도 참여하고 있다고 밝힙니다.[1]
가격은 다음과 같이 제시됩니다.[1]
| 항목 | 도입기 가격 | 도입기 종료 후 |
| 입력 100만 토큰 | 2달러 | 4달러 |
| 출력 100만 토큰 | 10달러 | 20달러 |
| 캐시된 입력 | 입력 가격 대비 95% 할인 | 종료 후 세부 적용 조건은 추가 확인 필요 |
분석
성능과 접근 통제를 함께 설계하는 출시 전략입니다. 특히 사이버 역량은 방어 업무에 유용하면서도 악용 가능성이 있으므로, 사용자 집단별로 접근 범위와 보호조치를 다르게 적용하는 방향을 택하고 있습니다.
여기서 주의할 점은 “출시 발표”와 “일반 API 사용 가능”이 동일하지 않다는 것입니다. 이 글에는 전체 공개의 확정 날짜, 지역별 제공 여부, API 모델 식별자, 운영 SLA가 제시되지 않습니다.[1]
실무 시사점: 사업 제안이나 도입 계획에는 “발표된 역량”과 “실제로 계약·사용할 수 있는 서비스”를 별도 항목으로 관리해야 합니다.
1장. Google 내부 업무를 어떻게 바꾸고 있는가
Changing how we work and build at Google
① 주요 사례와 수치
| 사례 | Google이 제시한 결과 | 정확한 해석 |
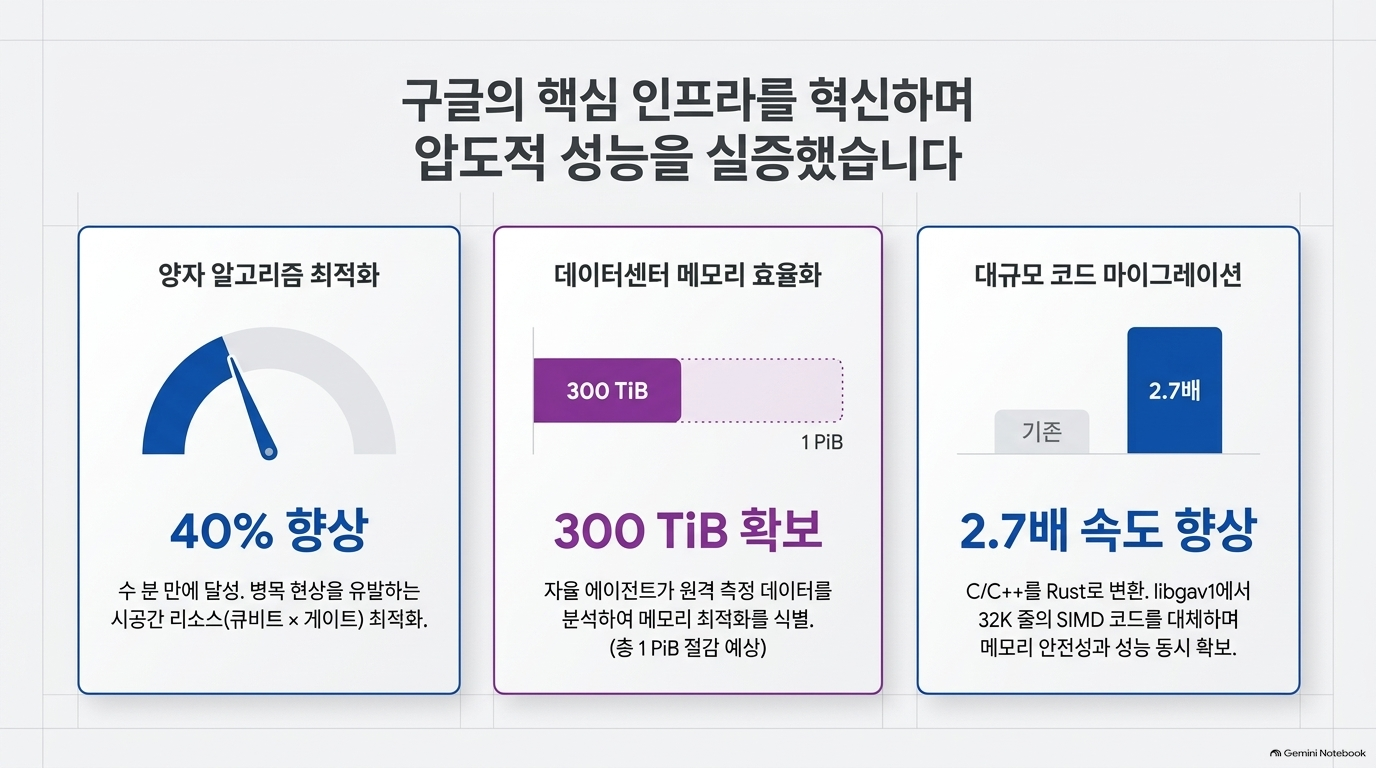
| 양자 알고리즘 최적화 | 특정 사례에서 발표된 기준선보다 시공간 자원 사용을 40% 개선 | 큐비트 × 게이트 자원 최적화 사례이며, 양자컴퓨팅 전체 성능이 40% 향상됐다는 뜻은 아님 |
| 데이터센터 메모리 최적화 | 배포 후 300 TiB 초과 메모리 확보 | 적용된 최적화의 결과로 제시 |
| 추가 메모리 절감 전망 | 총 500 TiB~1 PiB 절감 예상 | 이미 확보한 양과 향후 추정치를 구분해야 함 |
| C/C++ → Rust 전환 | 핵심 라이브러리의 수만 줄부터 Fuchsia Zircon 커널의 80만 줄 이상까지 작업 | 전체 전환이 완료되어 운영에 반영됐다는 뜻은 아님 |
| libgav1 최적화 | 기존 Rust 포트 대비 2.7배 빠른 메모리 안전 디코더 | 최적화된 C++ 대비 2.7배 빠르다는 뜻은 아님 |
이 수치와 비교 기준은 원문에 제시되어 있습니다.[1]
② 기술적 의미
가장 주목할 부분은 libgav1 사례입니다. Argon 에이전트는 기존 Rust 포트의 SIMD 코드 3만 2천 줄을 대체하면서, 프로파일 기반 실험을 반복하고 컴파일러 출력을 분석하여 컴파일러가 자동 벡터화할 수 있는 안전한 Rust 코드를 생성했다고 설명합니다.[1]
이는 단순한 코드 번역보다 다음과 같은 측정 기반 최적화 루프에 가깝습니다.
코드 분석 → 변경안 생성 → 컴파일·실행 → 성능 측정 → 결과 비교 → 재수정
위 흐름은 사례를 바탕으로 정리한 분석적 재구성입니다.
③ 근거의 한계
Google은 중요 시스템의 대규모 재작성에 대해 자동·수동 감사, 에뮬레이션 테스트, 검토를 수행한 뒤 운영에 반영한다고 명시합니다.[1]
따라서 이 장의 결론은 “AI가 검증 없이 핵심 시스템을 자율 변경할 수 있다”가 아니라, “AI가 변경안을 생산하는 범위가 확대되면서 검증 체계가 더 중요해졌다”입니다.
감리 관점의 확인 사항
- [확인 필요] 변경 전·후 기능 동등성 및 회귀시험 결과
- [확인 필요] 성능 개선의 비교 대상과 측정 환경
- [확인 필요] 에이전트가 생성한 변경의 인간 승인·배포 기록
- [보완 필요] 오류 발생 시 원복 및 책임 추적 체계
2장. 복잡한 문제에 더 오래 추론하도록 만드는 출력 한도
Working harder on your most complex problems
① 원문 내용
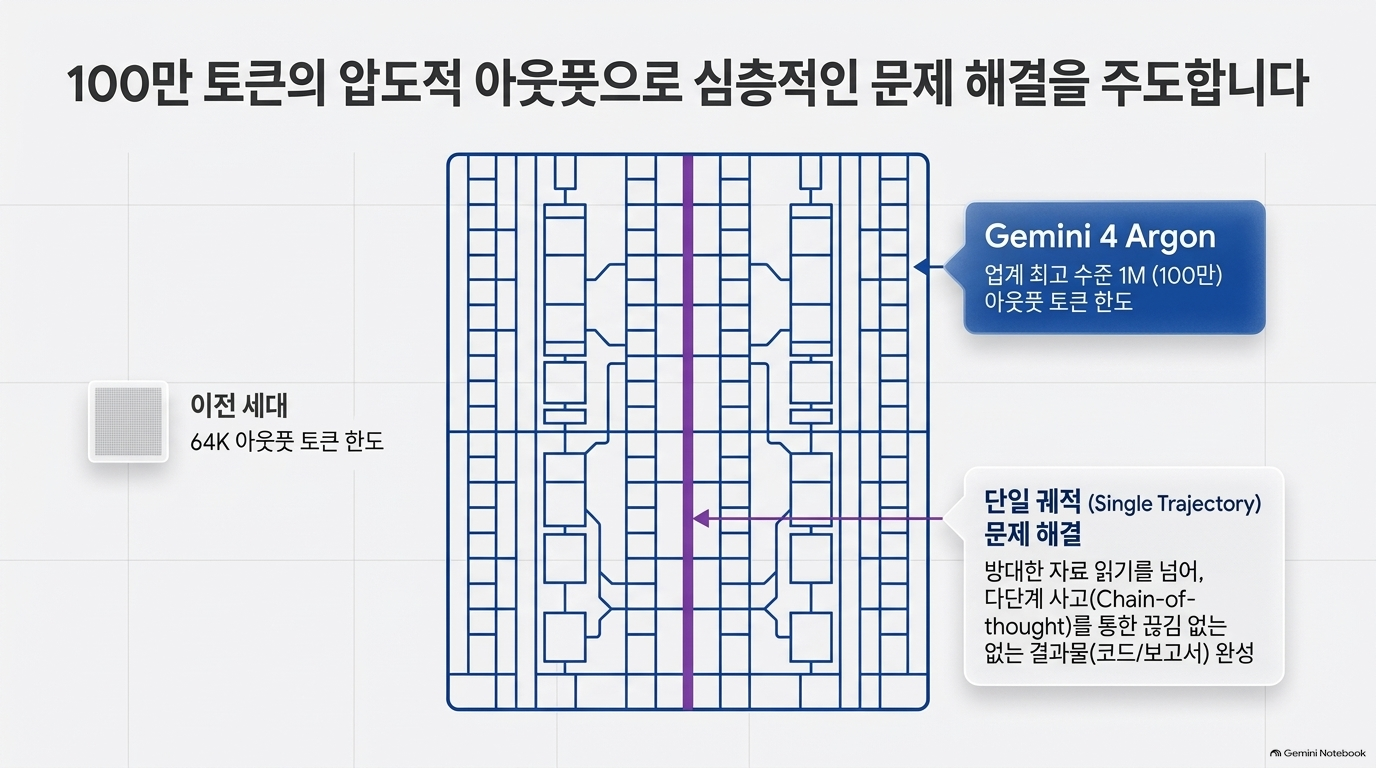
Google은 출력 토큰 한도를 기존 64K에서 1M으로 확대했다고 발표합니다. 하나의 실행 궤적에서 수십만 토큰을 생성할 여유를 제공하여, 복잡한 문제를 더 깊게 해결하도록 한다는 설명입니다.[1]
중요한 구분: 여기의 1M은 출력 토큰 한도입니다. 입력 컨텍스트 길이와 혼동하면 안 됩니다. 별도의 GraphWalks 평가는 입력 컨텍스트가 256K~1M인 문제군을 다루지만, 이는 다른 항목입니다.[1][2]
② 기술적 의미
출력 한도 확대는 모델이 중간 분석이나 긴 결과물을 생성할 때 토큰 부족으로 일찍 종료되는 제약을 줄일 수 있습니다.
다만 다음 세 가지는 별개입니다.
| 구분 | 의미 |
| 출력 용량 | 얼마나 긴 생성이 가능한가 |
| 추론 품질 | 생성 과정과 결론이 타당한가 |
| 업무 완결성 | 필요한 도구 실행·검증·승인까지 완료했는가 |
긴 출력이 곧 정확한 추론이나 성공적인 업무 완료를 보장하지는 않습니다. 이는 성능 수치와 운영 설계를 구분해야 한다는 분석적 판단입니다.
③ 비용·운영 측면
실제로 출력 100만 토큰이 청구된다면 발표된 단가 기준 출력 비용은 도입기 10달러, 도입기 종료 후 20달러입니다. 입력·도구·반복 실행 비용은 별도입니다.[1]
따라서 전문 업무 도입 시에는 토큰 단가보다 다음 지표가 중요합니다.
- 검증된 업무 1건당 총비용
- 성공까지의 반복 횟수
- 전체 처리시간
- 인간 검토시간
- 오류 수정·원복 비용
실무 시사점: 출력 한도가 큰 모델일수록 작업 예산, 중간 체크포인트, 종료 조건, 실패 시 중단 기준을 명확히 설정하는 것이 바람직합니다.
3장. 코딩·금융·법률·멀티모달 업무에서의 성능
Enabling coding and enterprise workflows across domains
① 주요 벤치마크
아래는 원문에 삽입된 종합 평가표의 수치입니다. 비교 모델명은 원문 표기 그대로 보존했습니다.[1]
| 평가 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
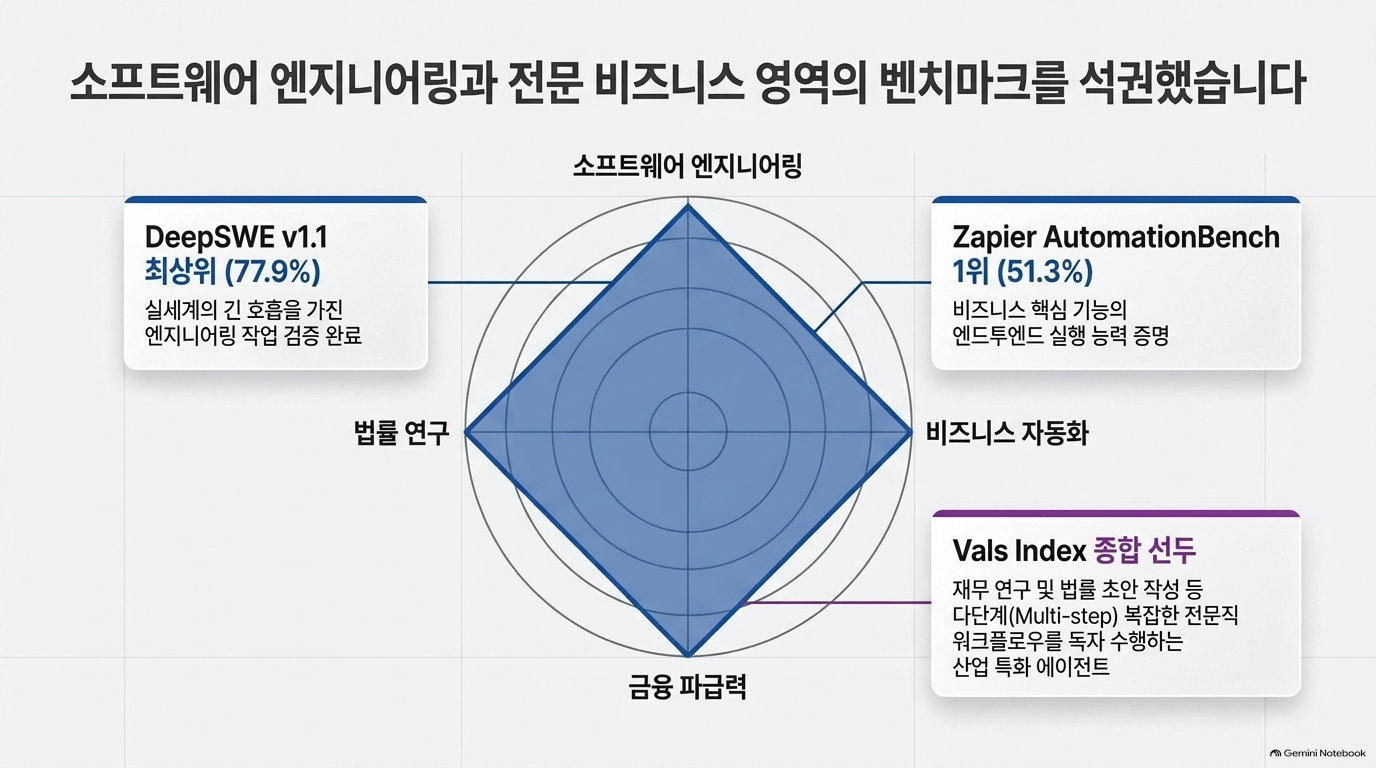
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
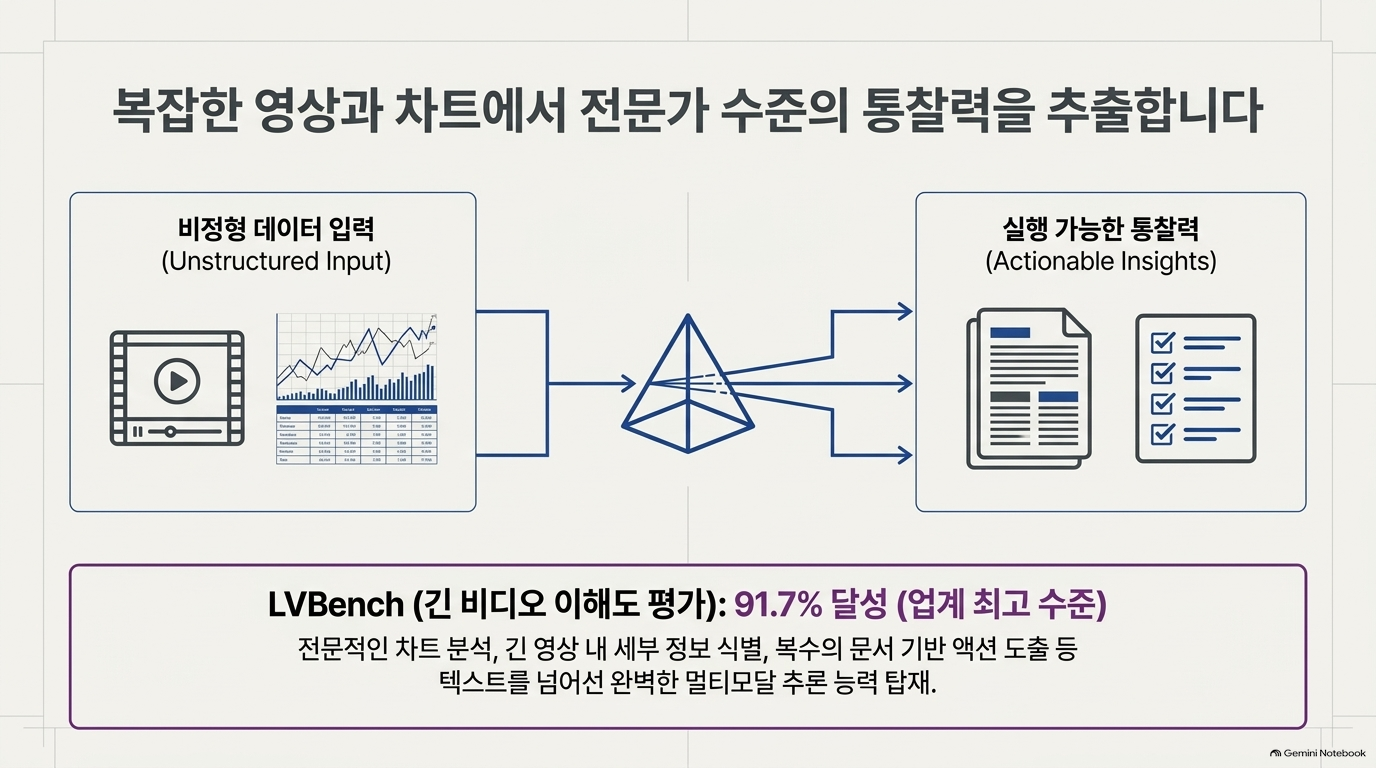
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
② 이 표가 말하는 것
첫째, 전문 업무를 연속적으로 처리하는 능력을 강조합니다.
Google은 Vals Index를 금융·코딩·법률·세무 업무를 미국 GDP 기여도에 따라 가중하는 지표로 설명합니다. AutomationBench는 핵심 업무 기능의 종단간 실행을 평가하는 벤치마크입니다.[1]
그러나 GDP 가중 점수는 실제 기업에서 측정한 경제적 효과나 투자수익률이 아닙니다. 평가 설계에 경제적 가중치를 적용한 점수로 읽어야 합니다.
둘째, 상대적 1위와 운영상 충분한 정확도는 다릅니다.
Harvey 법률 평가의 19.6%, AutomationBench의 51.3%는 비교 모델보다 높지만, 그 자체로 법률 검토나 기업 업무를 무인 운영해도 된다는 근거는 아닙니다. 특히 각 평가의 채점 정의를 확인하지 않고 “법률 정확도 19.6%”와 같이 일반화해서도 안 됩니다.[1][2]
셋째, 모든 코딩 환경에서 우위인 것은 아닙니다.
DeepSWE에서는 Argon이 앞서지만, FrontierSWE에서는 GPT-6 Astra, Terminal-bench에서는 Claude Opus 5.5가 더 높은 점수를 보입니다.[1]
따라서 “Argon이 코딩 전반에서 가장 우수하다”보다 “특정 장기 소프트웨어 개발 평가에서 강점이 확인됐다”가 정확한 표현입니다.
③ 방법론에서 확인한 제약
공식 평가 방법론은 다음 차이를 명시합니다.[2]
- 기본적으로 Argon은 최고 thinking 설정으로 평가됩니다.
- 비-Gemini 모델 수치는 별도 언급이 없으면 제공자의 자체 보고 결과를 사용합니다.
- DeepSWE의 Argon 결과는 mini-swe 에이전트 하네스로 자체 측정했습니다.
- LVBench는 API 제한에 따라 모델별 입력 프레임 제공 방식·수가 다릅니다.
- OSWorld 2.0은 오프라인 하위집합의 부분 점수이며, Argon 결과는 3회 실행 중 최댓값을 사용합니다.
이 차이는 점수를 무효화하지는 않지만, 모든 비교가 동일 조건의 직접 대조 실험은 아니라는 사실을 보여줍니다.
실무 시사점: 실제 도입 평가는 모델 단독이 아니라 모델 + 프롬프트 + 하네스 + 도구 + 데이터 + 검증기의 전체 조합으로 수행해야 합니다.
4장. 방어적 사이버보안 역량
Leading in defensive cybersecurity
① 원문 내용
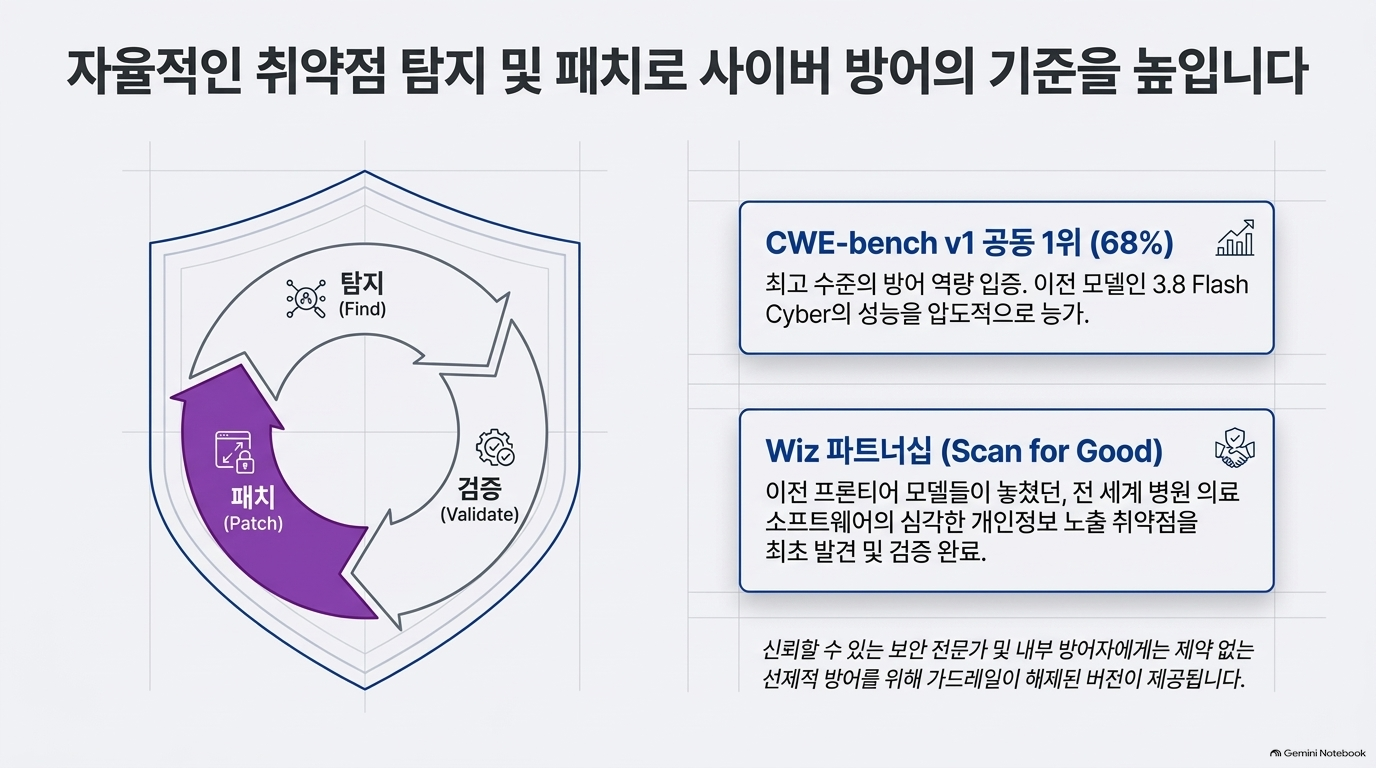
Google은 Argon이 중요 소프트웨어 취약점을 자율적으로 발견·검증·패치할 수 있다고 설명합니다. 신뢰할 수 있는 방어 조직과 Google 내부 팀에는 사이버 가드레일 없이 제공하여 해당 역량을 활용하도록 한다고 밝힙니다.[1]
Wiz의 Scan for Good 사례에서는 전 세계 병원이 사용하는 의료 소프트웨어에서 민감 개인정보 노출 취약점을 발견했다고 보고합니다. 다만 이 발표문에는 해당 사례의 구체적인 영향 범위나 재현 자료가 제시되지 않습니다.[1]
② 공개 평가와 내부 평가를 구분해야 함
| 평가 | Argon 결과 | 평가 의미와 한계 |
| CWE-bench v1 | 68.0% | 취약점 수정 평가, 공개 표 기준 공동 최고 점수 |
| Google 내부 취약점 발견 평가 | 85.8% | 확인된 과거 취약점에 대한 재현율 평가 |
| Wiz 내부 침투시험 평가 | 70.9% | 소스코드 없이 실제 웹 취약점에 대한 익스플로잇 작성 능력 평가 |
수치는 원문 그래프, 평가 정의는 공식 방법론에 근거합니다.[1][2]
이전 Gemini 3.8 Flash Cyber와 비교하면 내부 취약점 발견 점수는 14.8%p, Wiz 평가 점수는 12.7%p 높습니다. 이는 동일한 내부 평가에서의 차이이며, 실제 조직의 사고 감소율이나 방어 생산성 증가율로 치환할 수 없습니다.[1][2]
③ 핵심 해석
특히 85.8%를 “알려지지 않은 취약점의 85.8%를 찾아낸다”고 해석하면 안 됩니다. 방법론상 대상은 인기 오픈소스 프로젝트의 최근 확인된 과거 취약점입니다.[2]
또한 다음 단계는 구분해야 합니다.
취약점 후보 발견 → 재현·검증 → 패치 생성 → 회귀시험 → 승인·배포 → 위험 감소 확인
위 단계는 운영 관점의 권고 구조입니다. 발견·패치 역량이 입증되더라도 운영 환경의 안전한 수정 완료까지 자동으로 보장되는 것은 아닙니다.
감리 관점의 핵심: 모델의 유해 요청 거부보다, 테스트 대상·도구 권한·외부 통신·운영계 변경을 통제하는 실행 환경이 중요합니다.
5장. 일반 공개 전 강화하는 네 가지 안전장치
Strengthening frontier safeguards before broad availability
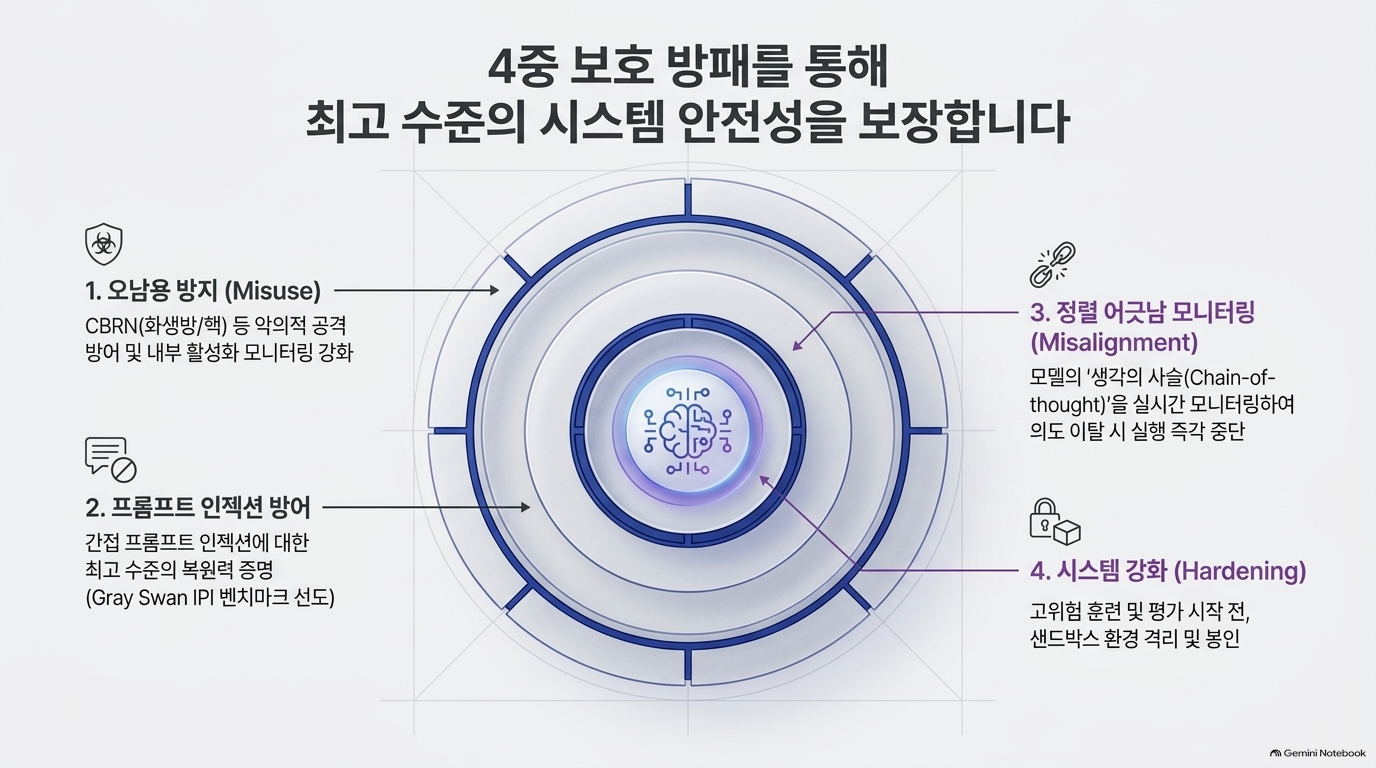
이 장은 안전을 하나의 거부 기능으로 보지 않고 모델 수준·행동 수준·시스템 수준으로 나누어 설명한다는 점에서 중요합니다.
① 악용 방어 — Defending against misuse
사이버 및 화학·생물학·방사선·핵 관련 악용 요청을 거부하면서 정당한 이중용도 연구는 허용하도록 설계한다고 설명합니다. 내부 활성값을 활용한 악용 탐지 기법도 강화하고, 내부·외부 레드팀이 수동·자동 공격으로 시험했다고 밝힙니다.[1]
분석: 거부와 허용을 구분하는 정책의 품질뿐 아니라, 정상 연구를 과도하게 차단하는 오탐과 악용을 놓치는 미탐을 함께 검증해야 합니다. 발표문은 이에 대한 상세 비율을 제시하지 않습니다.[1]
② 간접 프롬프트 인젝션 방어 — Defending against prompt injection attacks
원문의 Gray Swan IPI 그래프에서 Argon의 공격 성공률은 k=15 시도 조건에서 0.7%로 제시됩니다. 낮을수록 좋은 지표이며, 막대 위 숫자는 15회 시도 조건의 공격 성공률입니다.[1]
이는 “일반 업무의 정확도 99.3%”나 “모든 공격을 99.3% 차단”했다는 뜻이 아닙니다. 특정 평가에서의 공격 성공률입니다.
RAG 실무 해석: 검색 문서, 웹페이지, 첨부파일의 내용이 도구 실행 지시로 승격되지 않도록 해야 합니다. 모델의 인젝션 내성과 별개로 외부 자료를 비신뢰 입력으로 처리하고, 권한은 시스템에서 제한하는 설계가 필요합니다.
③ 의도 이탈 감시 — Monitoring for misalignment
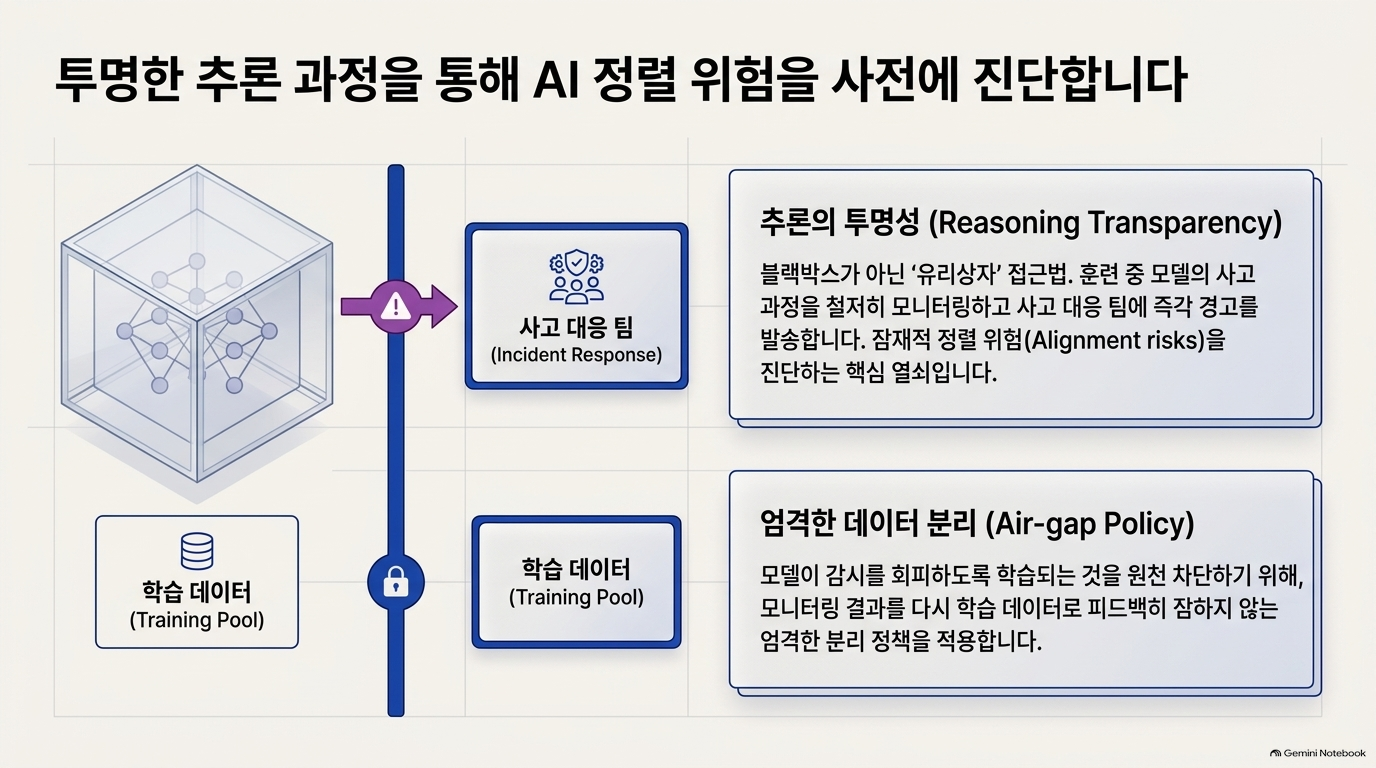
Google은 모델의 추론 과정과 행동을 감시하고 필요하면 실행을 중단하는 완화책을 적용한다고 설명합니다. 학습 실행에도 유사한 감시를 사용했으며, 감시 결과를 학습에 되먹임하여 모델이 감시 회피를 학습하지 않도록 주의했다고 밝힙니다.[1]
분석: 유해 요청 거부와 다른 층위입니다. 사용자의 정상적인 목표를 달성하는 과정에서도 모델이 허용 범위를 벗어날 수 있다는 문제를 다룹니다.
다만 추론 기록은 보조 진단 자료이지, 모델의 모든 내부 상태를 완전하게 입증하는 자료로 보아서는 안 됩니다. 감사 설계에서는 실제 도구 호출과 외부 시스템 변경 기록을 함께 확인하는 것이 바람직합니다.
④ 실행 환경 강화 — Hardening systems
고위험 학습·평가 전에 샌드박스 환경을 격리하고 봉쇄하는 방향을 제시합니다.[1]
분석: 가장 직접적인 통제 영역입니다. 모델이 잘못된 행동을 선택하더라도 시스템 권한과 네트워크 경계가 실제 영향을 제한하도록 설계해야 합니다.
| 안전 계층 | 확인할 운영 증거 |
| 요청·응답 보호 | 거부 정책, 오탐·미탐 평가 |
| 외부 문서 처리 | 인젝션 시험, 신뢰 경계 |
| 행동 감시 | 중단 조건, 탐지·중단 로그 |
| 실행 환경 | 권한 정책, 격리 설정, 통신 제한, 원복 절차 |
위 표는 발표문을 바탕으로 Google이 해당 형태의 증적을 공개했다는 의미는 아닙니다.
6장. 향후 공개 계획
Rolling out soon
원문 내용
Google은 초기 사이버 방어 조직과 신뢰할 수 있는 테스터의 평가·피드백으로 시스템을 강화한 뒤 개발자·기업·소비자에게 공개하겠다고 설명합니다. 유료 API 고객과 Google AI Ultra 구독자부터 시작할 계획입니다.[1]
분석
이 장은 공개 방향을 설명하지만, 확정된 서비스 계약 조건을 제시하지는 않습니다.
공공·기업 도입 전에는 다음을 추가 확인해야 합니다.
- [확인 필요] 실제 모델 ID 및 API 제공 시점
- [확인 필요] 데이터 처리·보관 지역과 삭제 정책
- [확인 필요] 입력·출력·추론 데이터의 보관 및 학습 사용 여부
- [확인 필요] 도구 호출 권한과 승인 방식
- [확인 필요] 모델 버전 변경·가격 변경·서비스 종료 정책
- [확인 필요] 운영 SLA와 장애·보안사고 대응 조건
이 항목들은 발표문에서 계약 수준으로 확인되지 않은 사항입니다.[1]
출처
[1] Google — Gemini 4 Argon: our next era of frontier intelligence — 본문 및 삽입 벤치마크 이미지
[2] Google DeepMind — Gemini 4 Argon Model evaluation — 평가 조건·하네스·데이터셋·비교 수치 출처
'07.AI > 12. AI 모델' 카테고리의 다른 글
| LLM - 오픈 웨이트(Open Weight) - Meta의 반격: 오픈 및 폐쇄형 프론티어 AI 시장 지형 변화 (0) | 2026.10.18 |
|---|---|
| 지식 증류(Knowledge Distillation) - On-policy Distillation (OPD)Cross-tokenizer 정렬 및 교사 피드백 활용 (0) | 2026.10.13 |
| LLM - Mistral Large 4 (0) | 2026.10.08 |
| LLM - 업스테이지, Solar Mini 4 (0) | 2026.10.05 |
| LLM - XiaomiMiMo, System Card: MiMo-V2.6-Pro-RL (0) | 2026.10.02 |