728x90
반응형
https://docs.mistral.ai/models/mistral-large-4-0
2026.10.6
[Mistral Large 4]
제공된 문서는 Mistral AI에서 개발한 최첨단 멀티모달 대형 언어 모델인 Mistral Large 4의 공식 기술 문서 및 제품 소개 페이지를 담고 있습니다. 이 자료는 해당 모델의 세부 구조와 핵심 사양, 예를 들어 혼합 전문가(Mixture-of-Experts) 아키텍처 및 파라미터 규모 등을 상세히 안내하고 있습니다. 또한 개발자들이 API를 통해 활용할 수 있는 다양한 기능과 가격 정책을 함께 제공하여 실무적인 이해를 돕습니다. 전반적으로 이 문서는 사용자가 최신 AI 기술의 성능을 파악하고 플랫폼 서비스와 도구를 효과적으로 활용할 수 있도록 돕는 종합 안내서의 역할을 합니다.
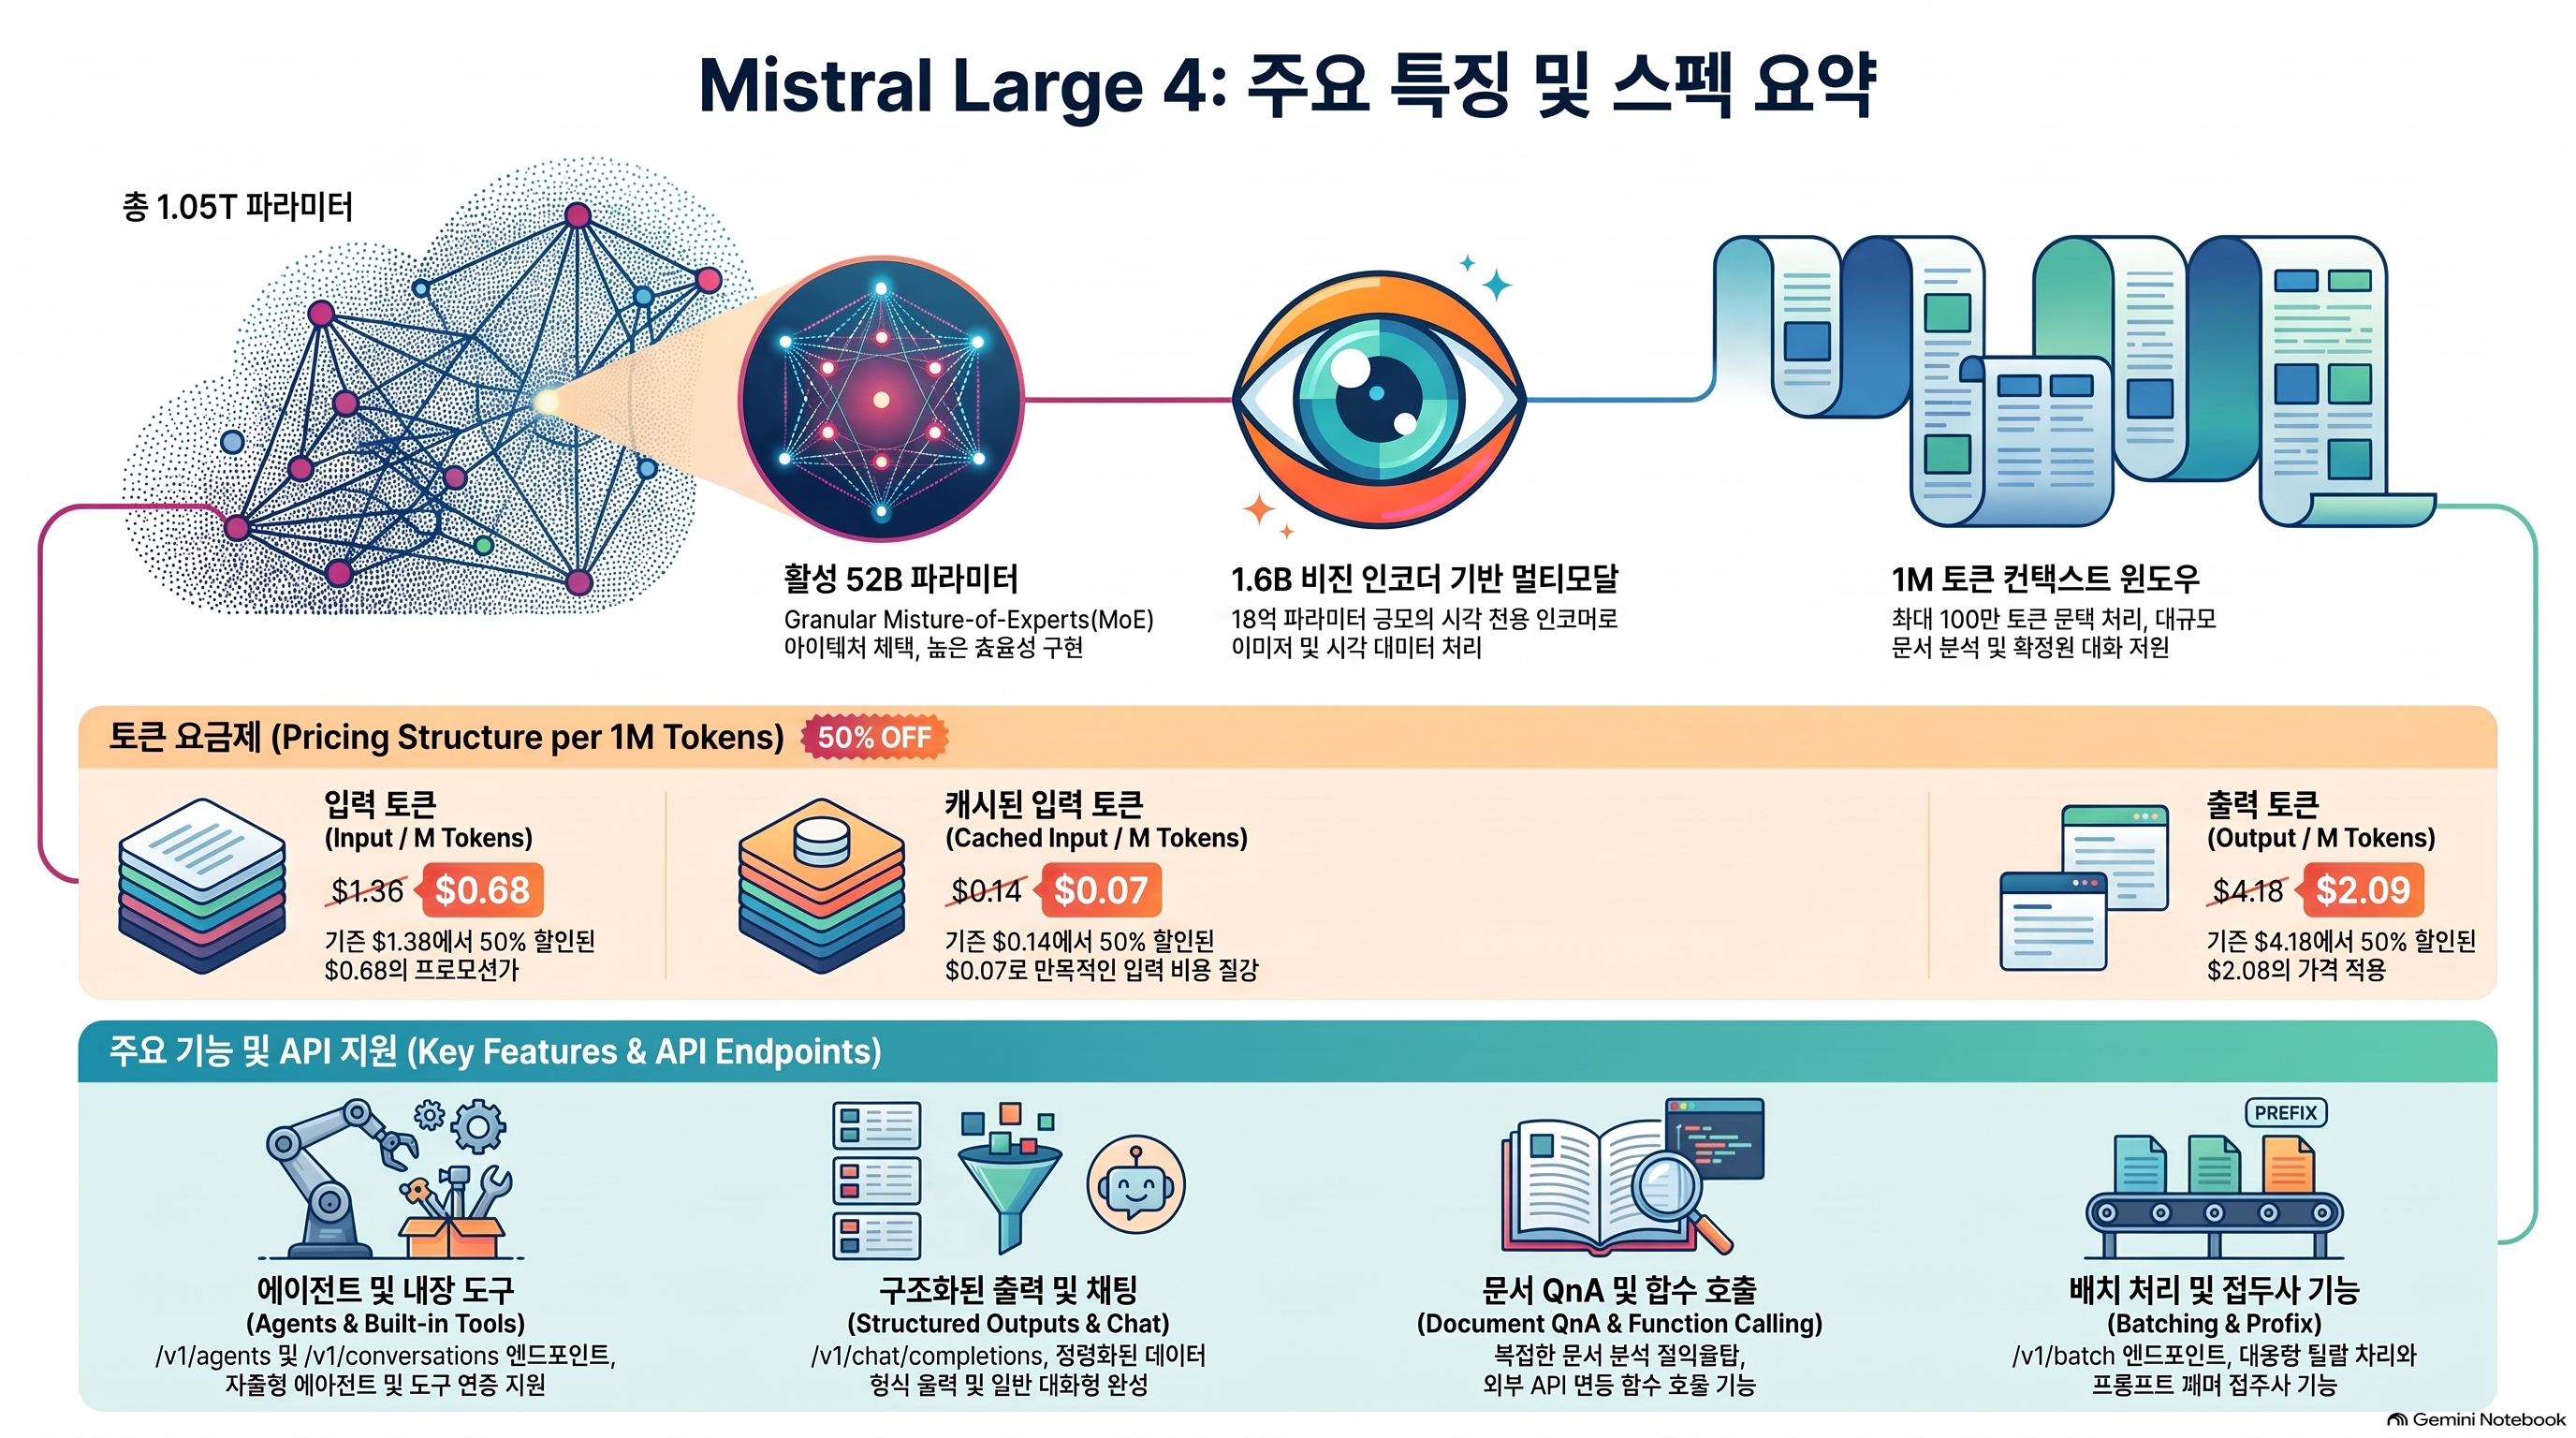
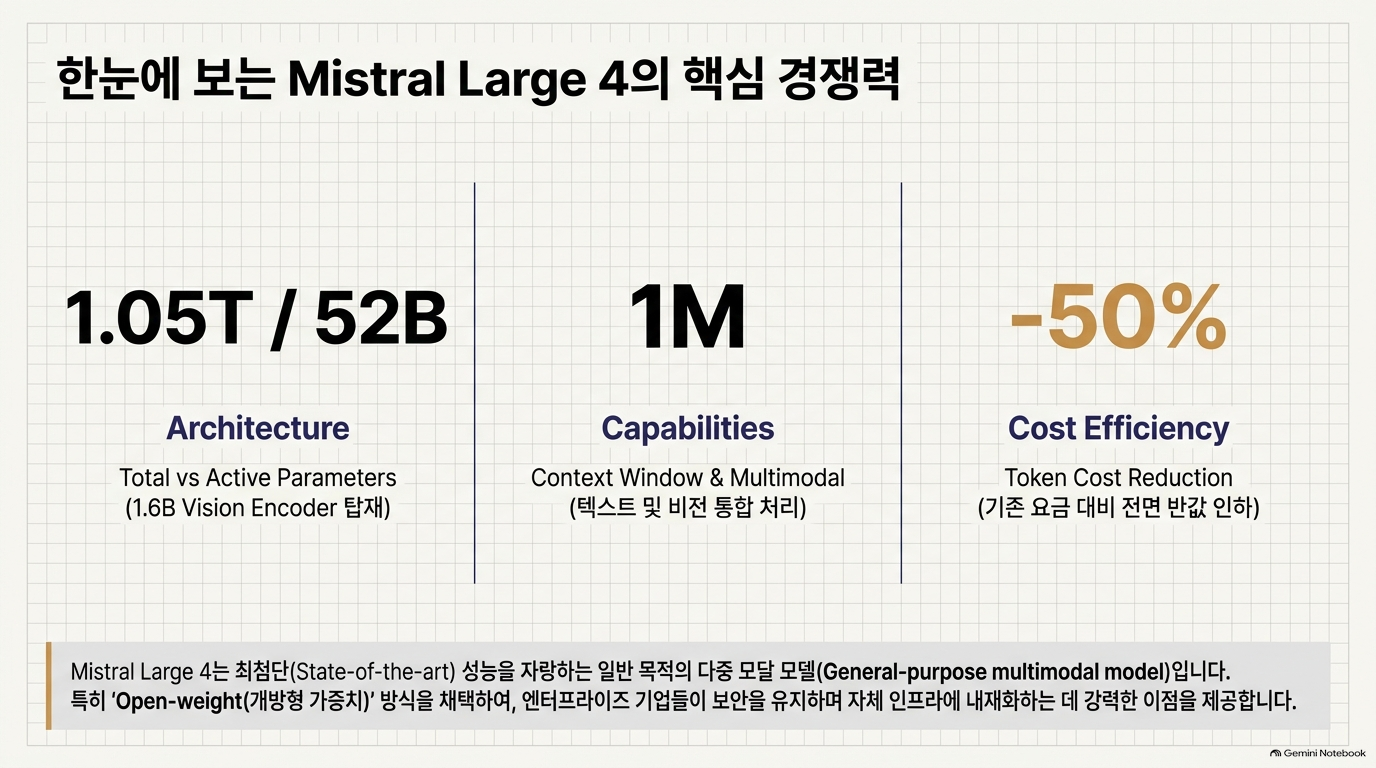
- Mistral Large 4는 1.05T 총 파라미터·52B 활성 파라미터의 MoE 구조, 1M 토큰 컨텍스트, 비전 인코더를 갖춘 범용 멀티모달 모델로 소개됩니다. 다만 문서상 상태는 Public Preview이며, 가중치와 라이선스는 아직 Coming soon입니다. 따라서 API 기반 검증 후보와 즉시 자체 구축 가능한 오픈웨이트 모델을 구분하여 판단해야 합니다.[1]
- 이 페이지는 상세 기술보고서가 아니라 모델 개요 → 사양·가격 → Features → Weights → Usage → Other Models로 구성된 제품 문서입니다. 아래는 그 순서를 따라 분석하되, 공식 기재사항과 분석·권고를 구분했습니다.
1. 모델 개요 — Mistral Large 4
1.1 공식 기재사항
| 항목 | 문서 내용 |
| 문서상 날짜 | 2026년 10월 6일 |
| 상태 | Public Preview |
| 분류 | Open |
| 버전 표시 | v26.10 |
| 모델 성격 | 범용 멀티모달 모델 |
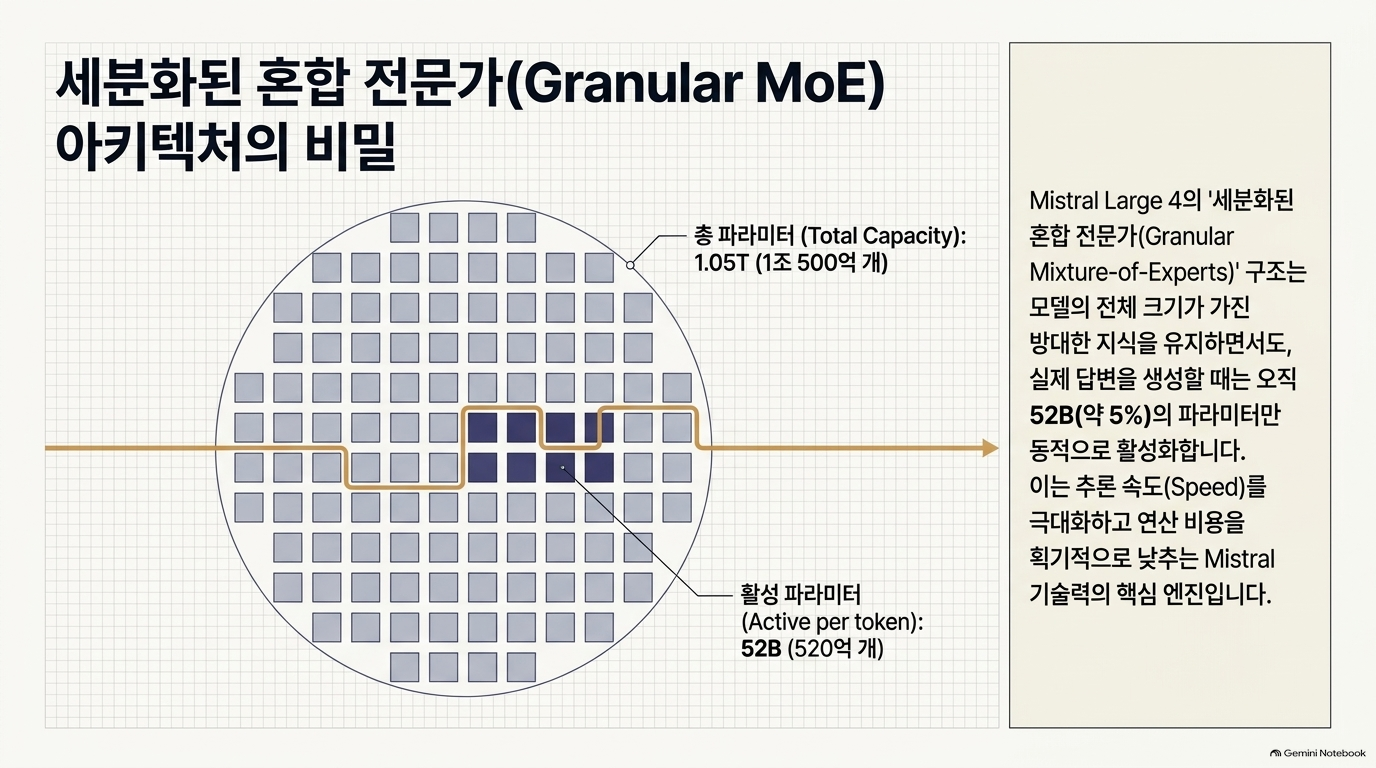
| 아키텍처 | Granular Mixture-of-Experts |
| 총 파라미터 | 1.05T |
| 활성 파라미터 | 52B |
| 비전 인코더 | 1.6B |
- 위 사양과 “state-of-the-art”라는 표현은 Mistral의 공식 설명이며, 이 페이지 자체에는 이를 검증할 비교 벤치마크와 평가 조건이 제시되어 있지 않습니다.[1]
1.2 기술적 의미
- ① 총 파라미터와 활성 파라미터를 분리해서 읽어야 합니다.
- 문서 수치로 계산하면 활성 파라미터는 총 파라미터의 약 4.95%입니다. 이는 MoE 구조가 전체 모델 중 일부 파라미터를 활성화하는 방식임을 이해하는 데 도움이 됩니다. 그러나 이를 “메모리도 전체의 4.95%만 필요하다”거나 “동급 Dense 모델보다 비용이 반드시 그 비율만큼 줄어든다”는 의미로 해석하면 안 됩니다.
- 활성 파라미터: 추론 연산량을 이해하는 지표
- 총 파라미터: 전체 가중치의 저장·배치 부담을 이해하는 지표
- 실제 운영비: 정밀도, 병렬화, 통신, 컨텍스트 길이, 동시 요청 등에 따라 달라짐
- ② 비전 인코더 규모는 이미지 처리 구성요소의 규모이지, 판독 정확도가 아닙니다.
- 1.6B 비전 인코더의 존재는 공식 사양으로 확인됩니다.[1] 다만 이 수치만으로 한국어 스캔 문서, 복잡한 표, 인프라 사진의 작은 글자, 도면 판독 성능을 판단할 수는 없습니다.
1.3 실무 판단
- 분석: 대규모 문서·이미지·도구 호출을 결합하는 업무에 검토할 만한 모델이지만, 파라미터 규모와 “최첨단”이라는 소개 문구는 업무 적합성의 증거를 대신하지 못합니다.
- [확인 필요: 모델 개요]
- 한국어 문서 이해·요구사항 추출 정확도
- 표·이미지의 항목명 및 수치 보존율
- 근거 없는 추론과 허위 인용 발생률
- 업무별 비교 모델 대비 성공률·지연·비용
2. 주요 사양·가격 — Context / Price
2.1 컨텍스트: 1M 토큰
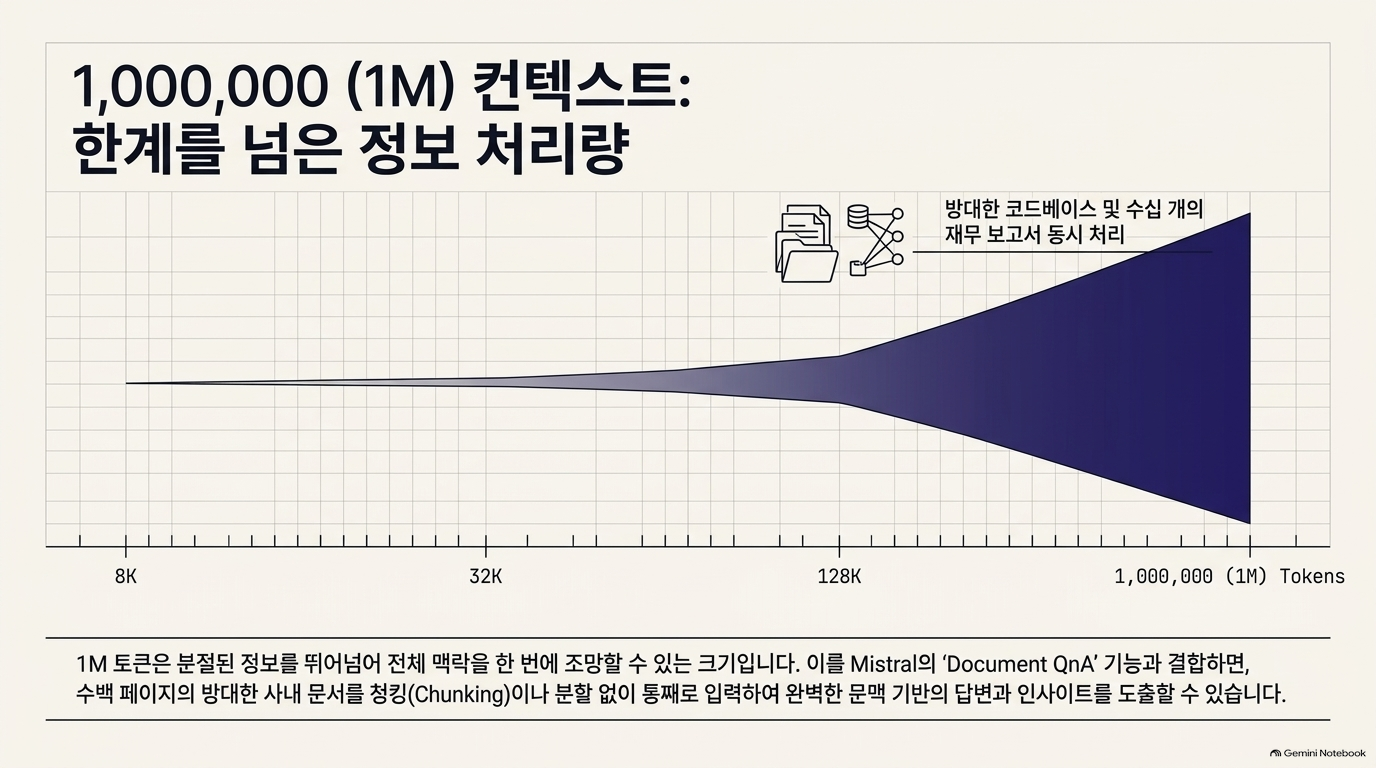
- 페이지는 컨텍스트 크기를 1M 토큰으로 표시합니다.[1]
- 기술적 의미
- 긴 문서와 다수의 자료를 한 요청에서 다루는 설계 가능성을 제공하지만, 다음을 보장하지는 않습니다.
| 구분 | 의미 |
| 컨텍스트 용량 | 요청에 포함할 수 있는 정보량과 관련된 한도 |
| 장문 이해 성능 | 긴 입력에서 필요한 근거를 찾아 연결하는 실제 능력 |
| 답변 정확도 | 찾아낸 근거를 올바르게 해석하고 답변하는 정도 |
| 출력 한도 | 생성 가능한 답변 길이 — 컨텍스트 크기와 별도로 확인할 사항 |
- 분석: “문서를 많이 넣을 수 있다”와 “모든 문서를 정확히 검토한다”는 다른 주장입니다. 또한 토큰 수를 고정된 문서 페이지 수로 환산하는 것은 문서 밀도·언어·이미지 처리 방식에 따라 달라져 부적절합니다.
- 권고: 감리·RFP 분석에서는 다음 조합이 더 검증 가능성이 높습니다.
- 문서별 근거 추출 → 요구사항 단위 구조화 → 관련 근거 검색 → 통합 판단 → 원문 대조
- 1M 컨텍스트는 이 흐름의 통합 검토 범위를 확대하는 수단으로 활용하고, 근거 추적 절차를 생략하는 이유로 사용하지 않는 것이 적절합니다.
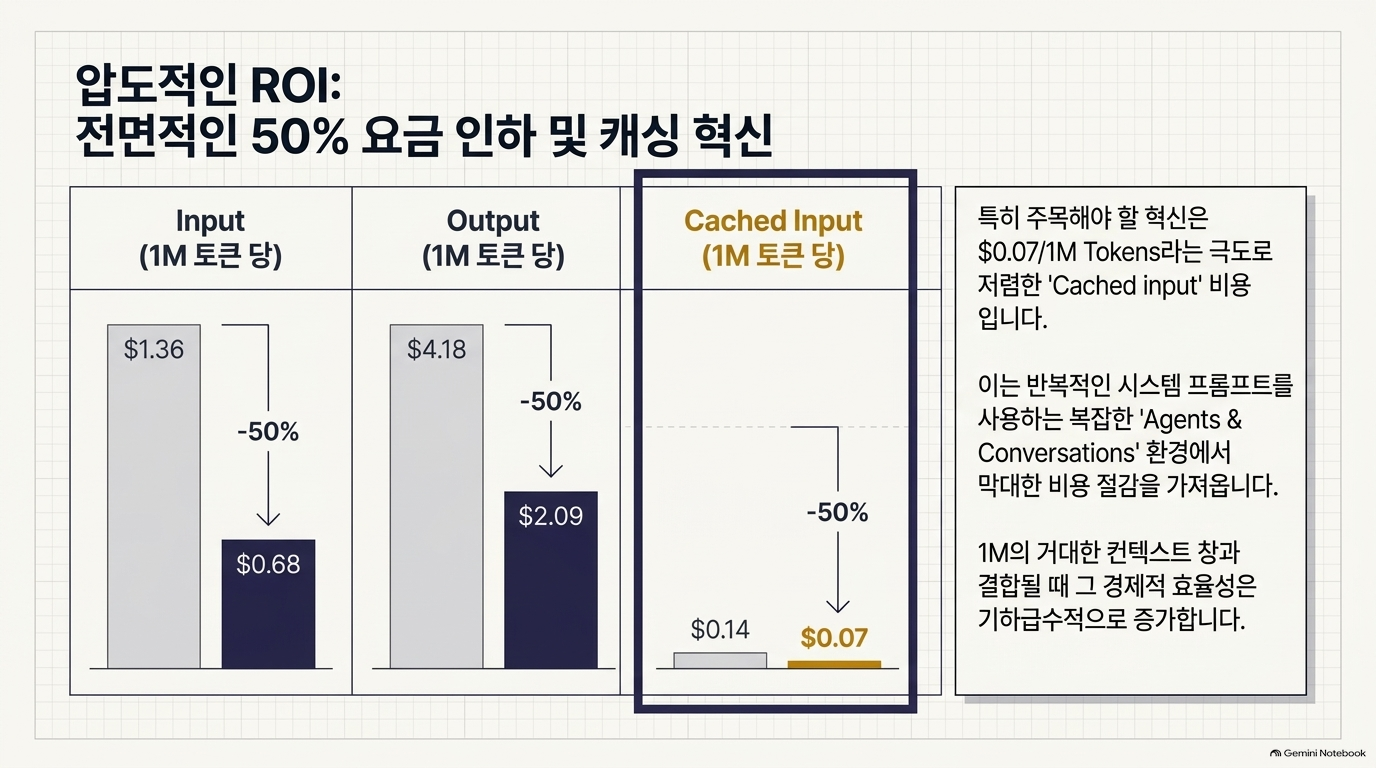
2.2 가격
- 공식 가격 페이지는 다음 값을 Sale price로 표시합니다. 단위는 100만 토큰당 미국 달러입니다.[2]
| 구분 | 원래 가격 | 표시된 할인 가격 |
| 입력 | $1.36 | $0.68 |
| 캐시 입력 | $0.14 | $0.07 |
| 출력 | $4.18 | $2.09 |
- 분석
- 반복되는 공통 지침·문서 입력은 캐시 적용 조건이 충족될 경우 비용 절감 여지가 있습니다.
- 긴 보고서 생성 업무는 입력량뿐 아니라 출력량도 비용 평가에 포함해야 합니다.
- 현재 표시값은 할인 가격이므로 장기 운영 예산의 고정 단가로 단정하면 안 됩니다.
- 가격 페이지에는 Standard·Batch·Priority와 지역 관련 선택 요소가 있어, 실제 적용 조건을 별도로 확인해야 합니다.[2]
- [확인 필요: 가격]
- 할인 적용 기간과 종료 후 단가
- 캐시 적용·유지 조건
- 추론 토큰의 과금·사용량 처리 방식
- OCR·내장 도구 등 부가 기능의 별도 비용
- 재시도까지 포함한 정확한 업무 결과 1건당 비용
3. Features — 지원 기능
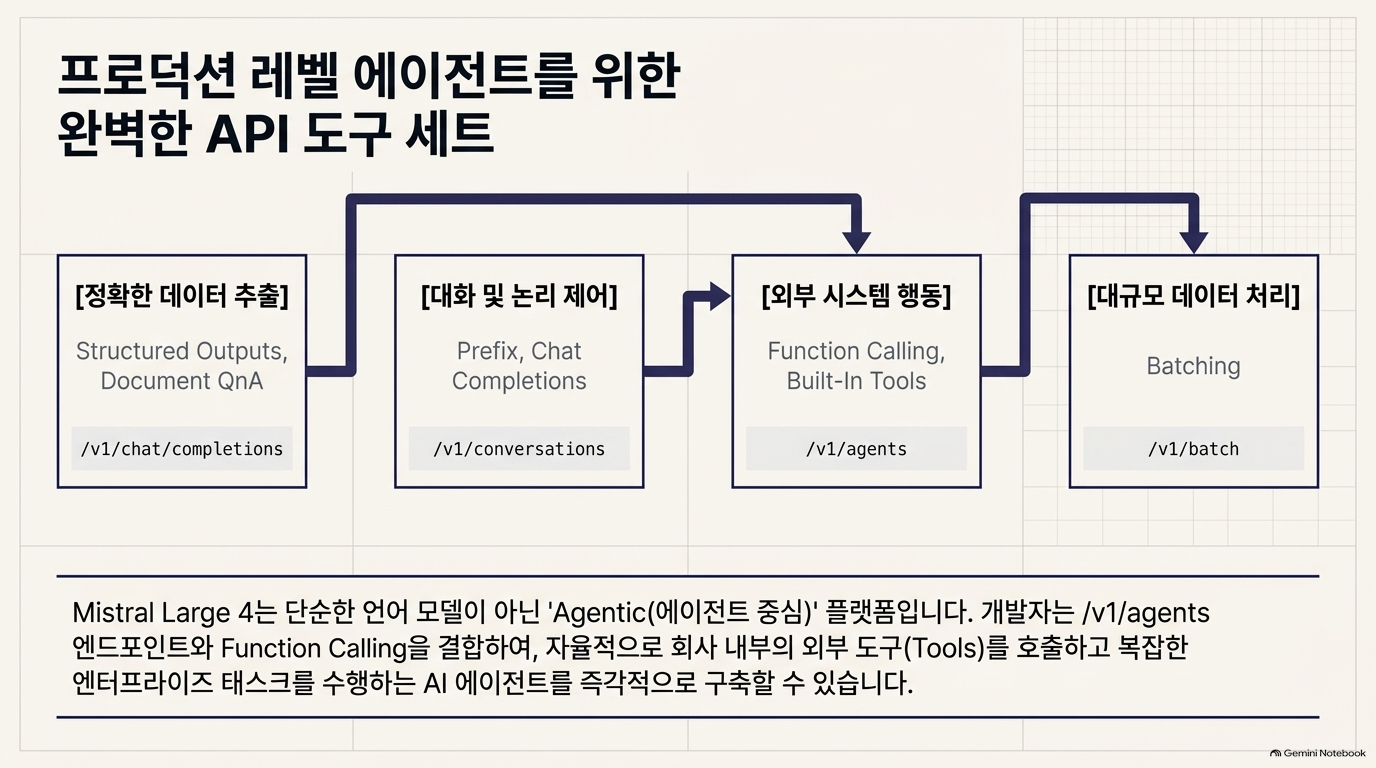
- 원문은 다음 기능과 적용 API 경로를 나열합니다.[1]
| 기능 | 표시된 API 경로 | 분석상 의미 |
| Structured Outputs | /v1/chat/completions, /v1/conversations | 요구사항·검토 결과를 정형 데이터로 생성 |
| Function Calling | /v1/chat/completions, /v1/conversations | 외부 도구와 연결하는 호출 생성 |
| Document QnA | /v1/chat/completions, /v1/conversations | 문서 기반 질의응답 |
| Prefix | /v1/chat/completions, /v1/conversations | 응답 시작 부분을 지정하는 기능 |
| Chat Completions | /v1/chat/completions | 기본 대화형 추론 인터페이스 |
| Batching | /v1/batch | 다수 요청의 배치 처리 |
| Agents & Conversations | /v1/agents, /v1/conversations | 에이전트·대화 기반 서비스 구성 |
| Built-In Tools | /v1/agents, /v1/conversations | 제공자 측 내장 도구 활용 |
3.1 Structured Outputs — 정형 출력
- 관련 공식 문서는 JSON Mode와 사용자 정의 스키마 방식을 구분하며, 가능하면 사용자 정의 구조화 출력을 권장합니다. JSON Mode에서는 프롬프트에 JSON 출력과 원하는 형식을 명시해야 한다고 안내합니다.[3]
- 실무 적용 예시 — 분석자 권고
- 감리 검토 결과를 다음 필드로 고정할 수 있습니다.
- REQ-ID | 판단 구분 | 근거 문서 | 페이지 | 원문 인용 | 보완 내용
- 다만 다음은 분리해서 검증해야 합니다.
- 형식 검증: 필수 필드·자료형·허용값 준수
- 내용 검증: REQ-ID, 페이지, 인용문, 판단의 실제 정확성
- 핵심: 스키마에 맞는 JSON이 생성되었다고 해서 사실과 근거까지 정확하다는 뜻은 아닙니다.
3.2 Function Calling — 도구 호출
- 모델 페이지는 Function Calling 지원을 명시합니다.[1]
- 분석: 도구 호출은 다음 단계 중 일부에 해당합니다.
- 호출 생성 → 애플리케이션의 권한 확인 → 실제 도구 실행 → 결과 반환 → 업무 완료 검증
- 따라서 지원 여부만으로 외부 시스템 변경의 안전성이나 업무 완료를 보장할 수 없습니다.
- 권고
- 조회 도구와 변경 도구의 권한 분리
- 문서 수정·삭제·발송에는 승인 절차 적용
- 호출 인자 검증과 실행 로그 보존
- 변경 후 실제 대상의 상태 재조회
3.3 Document QnA — 문서 질의응답
- 관련 공식 문서는 Document QnA를 OCR 처리와 LLM 이해를 결합한 기능으로 설명합니다.[4]
- OCR이 텍스트·구조·서식을 추출
- LLM이 추출된 내용을 분석하여 질의에 응답
- 다문서 비교, 정보 추출, 요약, 계약·기술문서 분석 등이 활용 사례로 제시됩니다.[4]
- 중요한 해석
- Document QnA는 모델 하나의 능력만이 아니라 문서 처리 파이프라인의 결과로 평가해야 합니다.
| 단계 | 주요 검증사항 |
| OCR | 숫자·기호·항목명·표 셀의 추출 정확도 |
| 구조 복원 | 제목 계층, 표 관계, 페이지·문단 연결 |
| LLM 분석 | 조항 간 관계, 예외조건, 수치의 정확한 해석 |
| 답변 생성 | 근거 위치와 원문 인용의 일치 |
- [보완 필요: Document QnA 평가]
최종 답변의 오류가 OCR에서 발생했는지, 구조 복원에서 발생했는지, 모델 해석에서 발생했는지를 구분할 수 있는 평가 설계가 필요합니다.
3.4 나머지 기능의 해석
- Prefix: 출력 형식의 시작을 유도하는 기능으로 이해하되, 스키마 검증과 동일한 통제로 보지 않아야 합니다.
- Batching: 다수의 문서·요구사항을 처리하는 업무의 후보 기능입니다. 대화형 응답과는 다른 처리 조건을 확인해야 합니다.
- Agents & Conversations / Built-In Tools: 서비스 구성의 선택지를 제공하지만, 기능 목록만으로 상태 보존·도구별 권한·실행 격리·감사 로그 수준까지 확인되지는 않습니다.
- 이 페이지의 Features는 지원 기능 목록이지, 각 기능의 운영 계약과 보안 보장을 상세히 설명하는 장은 아닙니다.[1]
4. Weights — 가중치·라이선스·자체 구축 사양
- 일반 본문 추출에서 보이지 않는 탭은 원본 HTML에 포함된 구조화 데이터를 확인했습니다. 해당 표는 다음과 같습니다.[1]
| 항목 | 표시값 |
| Weights | Coming soon |
| License | Coming soon |
| Parameters (T) | 1.05 |
| Active (B) | 52 |
| Vision Encoder (B) | 1.6 |
| 약식 GPU RAM — bf16~fp4 | N/A |
| Context Size | 1M |
4.1 가장 중요한 구분
- 모델 소개의 “open-weight”와 실제 가중치 배포 상태는 구분해야 합니다.
- 페이지는 오픈웨이트 모델로 소개하지만, Weights 표에는 다운로드 가능한 가중치와 라이선스가 아직 Coming soon으로 표시됩니다.[1]
- 따라서 이 문서만을 근거로 다음과 같이 표현하는 것은 부정확합니다.
- “현재 가중치를 내려받아 구축할 수 있다.”
- “특정 오픈소스 라이선스로 상업 이용이 가능하다.”
- “폐쇄망 운영 환경을 즉시 구성할 수 있다.”
4.2 인프라 측면
- GPU RAM 값도 N/A이므로 이 페이지에서는 자체 구축의 최소 하드웨어 요건을 확정할 수 없습니다.[1]
- [확인 필요: 자체 구축]
- 실제 배포 가중치의 정밀도·파일 크기
- 지원 추론 엔진과 양자화 형식
- GPU 구성·병렬화·네트워크 요건
- 긴 컨텍스트의 KV cache 및 동시 사용자 메모리
- 목표 지연·처리량을 달성하는 운영 구성
- 판단: 현재 문서에 근거한 자체 구축 검토는 확정 설계가 아니라 배포·라이선스 공개를 조건으로 한 검토가 적절합니다.
5. Usage — API 사용 방법
5.1 공식 예제의 핵심
- Usage 탭은 Chat Completions API에 mistral-large-4 모델명을 사용하도록 안내합니다. Python 예제의 주요 요소는 다음과 같습니다.[1]
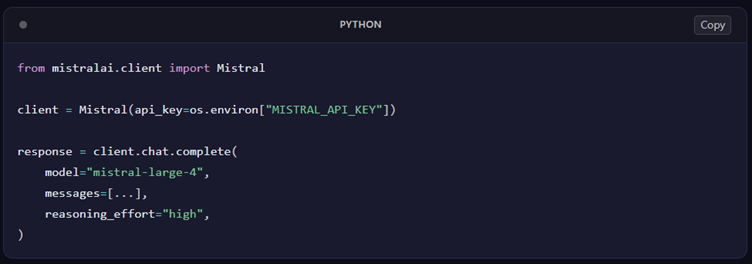
- 위 코드는 원문 핵심 발췌이며 실행 검증 결과가 아닙니다.
5.2 식별자 해석
| 구분 | 값 |
| 문서 URL의 식별자 | mistral-large-4-0 |
| Usage 예제의 모델명 | mistral-large-4 |
| REST 호출 주소 | https://api.mistral.ai/v1/chat/completions |
- 문서 경로와 실제 호출용 모델명을 혼동하지 않아야 합니다.[1]
5.3 reasoning_effort="high"의 의미와 한계
- 공식 사용 예제에는 reasoning_effort="high"가 포함됩니다.[1] 그러나 이 예제만으로 다음까지 확정할 수는 없습니다.
- 모든 허용값과 기본값
- 설정별 추론량·지연·정확도
- 추론 토큰과 출력 한도의 관계
- 추론 내용의 반환 여부와 과금 처리
- 분석: 복잡한 문서 교차검토에서는 추론 수준 설정을 검토할 수 있으나, high를 모든 업무의 기본값으로 정하기보다 업무별 실험이 필요합니다.
- [보완 필요: 운영 코드]
- 시간 초과·재시도·요청 제한 처리
- 입력 길이와 출력 예산 관리
- 실제 응답의 오류·종료 상태 확인
- 사용량과 요청 식별자 기록
- SDK 버전 및 실제 적용 모델 버전 관리
- 공식 예제는 호출 시작 방법을 보여주는 것이며, 운영용 오류 처리나 품질 검증 절차까지 포함한 예제는 아닙니다.
6. Other Models — 관련 모델
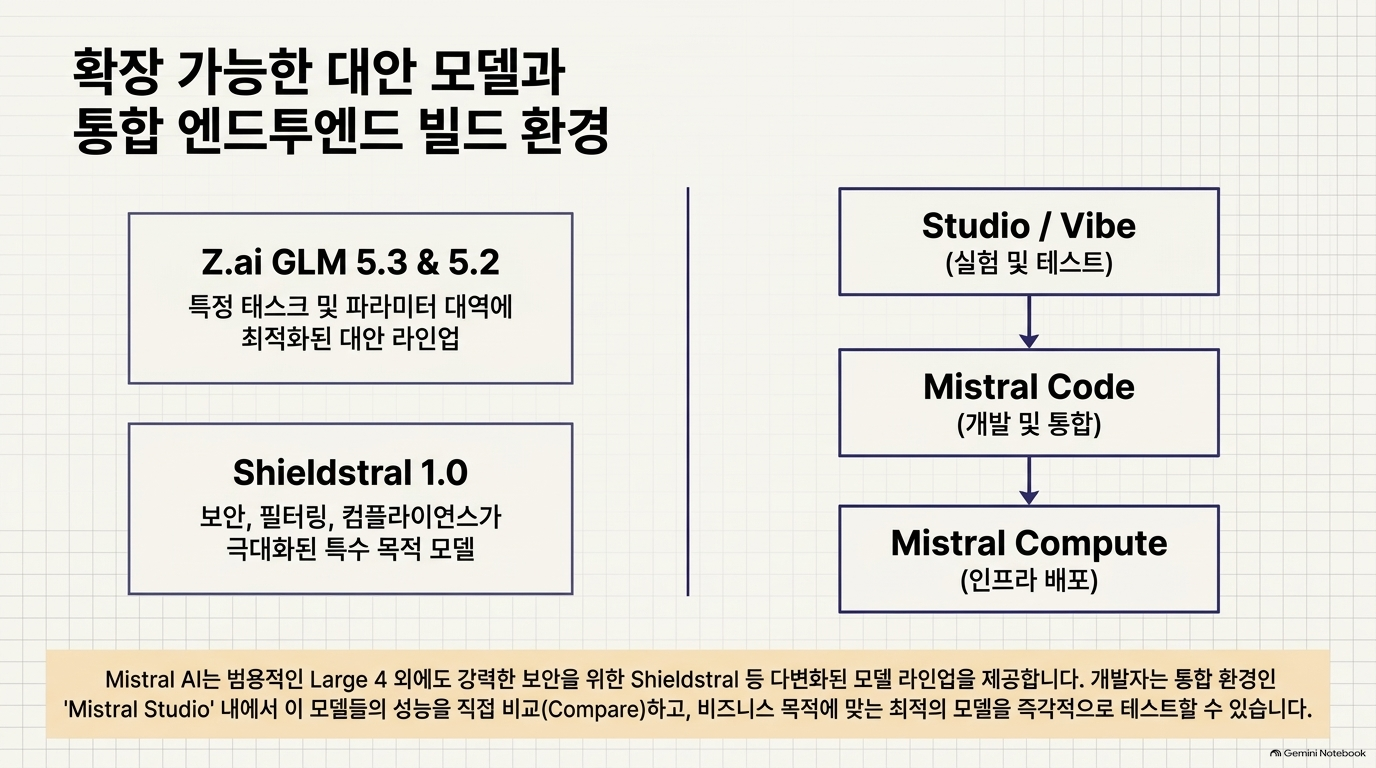
- 페이지 하단에는 Z.ai GLM 5.3, Z.ai GLM 5.2, Shieldstral 1.0으로 이동하는 링크가 있습니다.[1]
- 이 부분은 다른 모델을 탐색하기 위한 영역입니다. 나열 순서나 노출 여부를 성능 순위·동급 모델 판정·호환성 보장으로 해석하면 안 됩니다.
- 분석: 모델 선정에서는 이 링크 목록보다 동일한 업무 데이터와 평가 조건으로 비교하는 방식이 중요합니다.
결론
- Mistral Large 4의 문서상 강점은 대규모 MoE 구조, 긴 컨텍스트, 비전 구성요소, 정형 출력·문서 QnA·에이전트 기능을 결합할 수 있다는 점입니다. 반면 실제 업무 정확도와 자체 구축 가능성은 별도 검증이 필요합니다.[1]
- 강 박사님의 감리·요구사항 분석 업무에서는 다음 접근이 적절합니다.
- API 기반 PoC로 한국어 문서의 근거 추출·수치 보존·요구사항 매핑 성능을 먼저 검증하고, 자체 구축 검토는 가중치·라이선스·인프라 사양 공개를 확인한 뒤 진행하는 방식입니다.
출처
- [1] https://docs.mistral.ai/models/mistral-large-4-0 — Mistral Large 4 공식 모델 문서
[2] https://docs.mistral.ai/inference/pricing — 공식 가격 문서
[3] https://docs.mistral.ai/studio/conversations/structured-output — Structured Outputs
[4] https://docs.mistral.ai/studio/document-processing/document_qna — Document QnA
728x90
반응형
'07.AI > 12. AI 모델' 카테고리의 다른 글
| 지식 증류(Knowledge Distillation) - On-policy Distillation (OPD)Cross-tokenizer 정렬 및 교사 피드백 활용 (0) | 2026.10.13 |
|---|---|
| LLM - Google DeepMind, Gemini 4 Argon (0) | 2026.10.10 |
| LLM - 업스테이지, Solar Mini 4 (0) | 2026.10.05 |
| LLM - XiaomiMiMo, System Card: MiMo-V2.6-Pro-RL (0) | 2026.10.02 |
| LLM - 딥시크 (DeepSeek) - DeepSeek-V4 Pro (0) | 2026.09.24 |