https://oreillyradar.substack.com/p/from-raw-data-to-graph-native-ai
2026.9.28
[From Raw Data to Graph-Native AI]
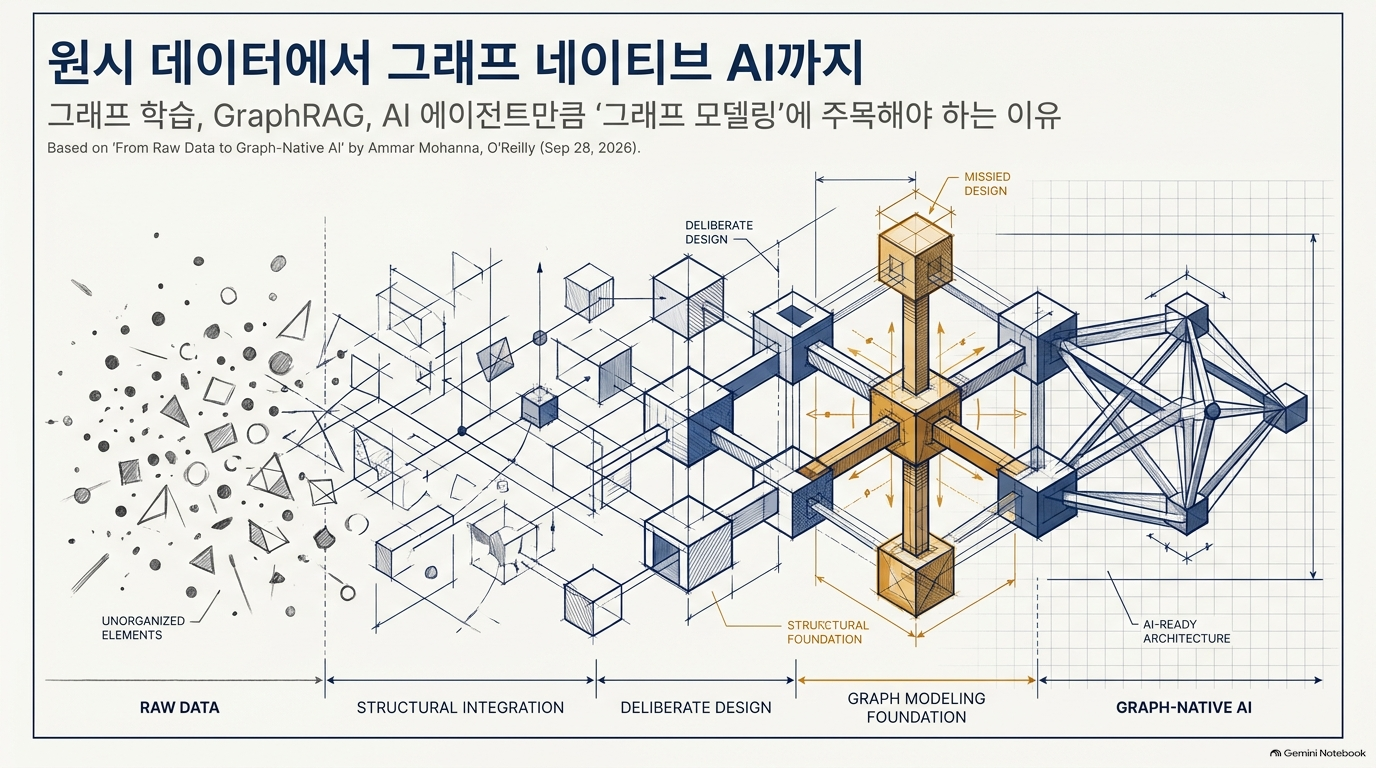
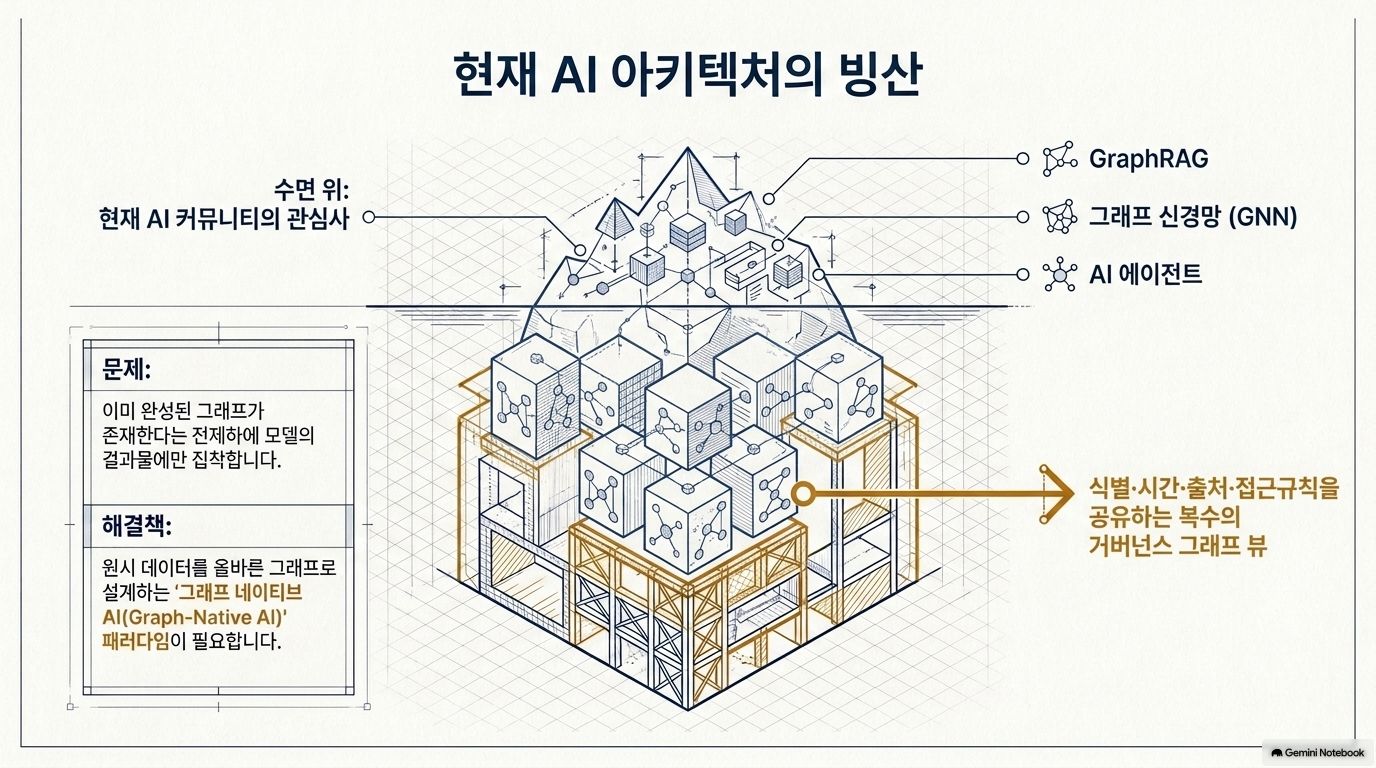
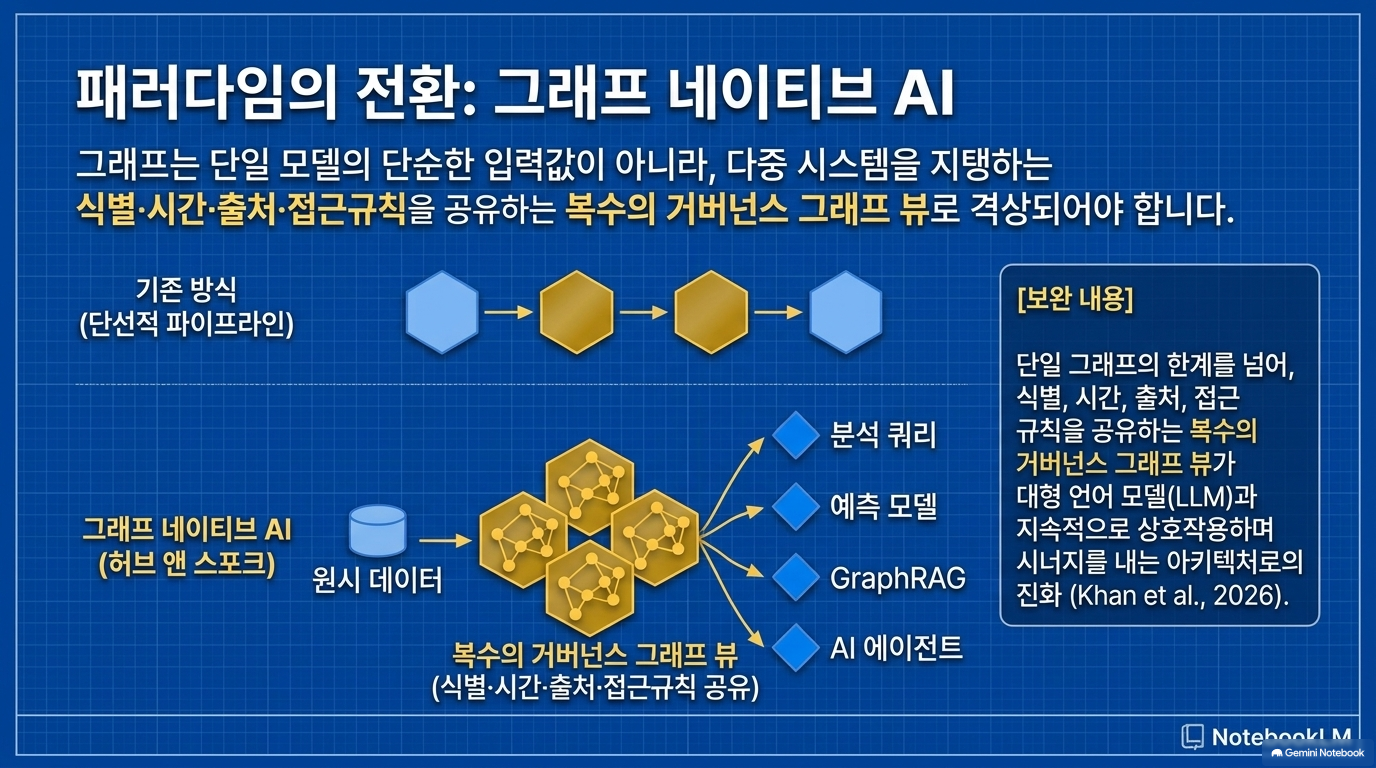
이 텍스트는 인공지능 분야에서 흔히 간과되는 핵심 단계인 원시 데이터를 적절한 그래프 구조로 변환하는 그래프 모델링의 중요성을 심도 있게 다룹니다. 저자는 단순히 이미 만들어진 그래프를 활용하는 기술에만 집중할 것이 아니라, 다양한 정보로부터 엔티티와 관계를 정의하고 검증하는 체계적인 과정이 선행되어야 한다고 강조합니다. 나아가 이렇게 공들여 구축된 거버넌스 기반의 그래프 뷰는 분석과 예측뿐만 아니라 검색 증강 생성(GraphRAG), 에이전트, 그리고 그래프 파운데이션 모델 등 다양한 AI 시스템을 지탱하는 공통의 기반이 될 수 있음을 설득력 있게 제시합니다.
핵심 논지: 이 글은 “그래프에서 어떤 모델을 학습할 것인가”보다 앞선 질문, 즉 “원천 데이터에서 무엇을 노드·관계·사건·증거로 표현할 것인가”를 독립적인 설계·평가 대상으로 삼아야 한다고 주장합니다. 저자 Ammar Mohanna가 말하는 graph-native AI는 모든 데이터를 하나의 거대한 그래프에 넣자는 뜻이 아닙니다. 신원·시간·출처·접근권한을 일관되게 관리하면서, 목적에 맞는 여러 그래프 뷰를 만들어 분석·예측·검색·에이전트에 활용하자는 접근입니다.[1]
읽는 관점: 원문은 도입부와 네 개의 주요 절로 구성됩니다. 아래의 ‘실무 해석’과 ‘검토 의견’은 원문의 주장과 구분한 제 분석입니다.
1. 도입 — AI 성능을 결정하는데 간과되는 단계
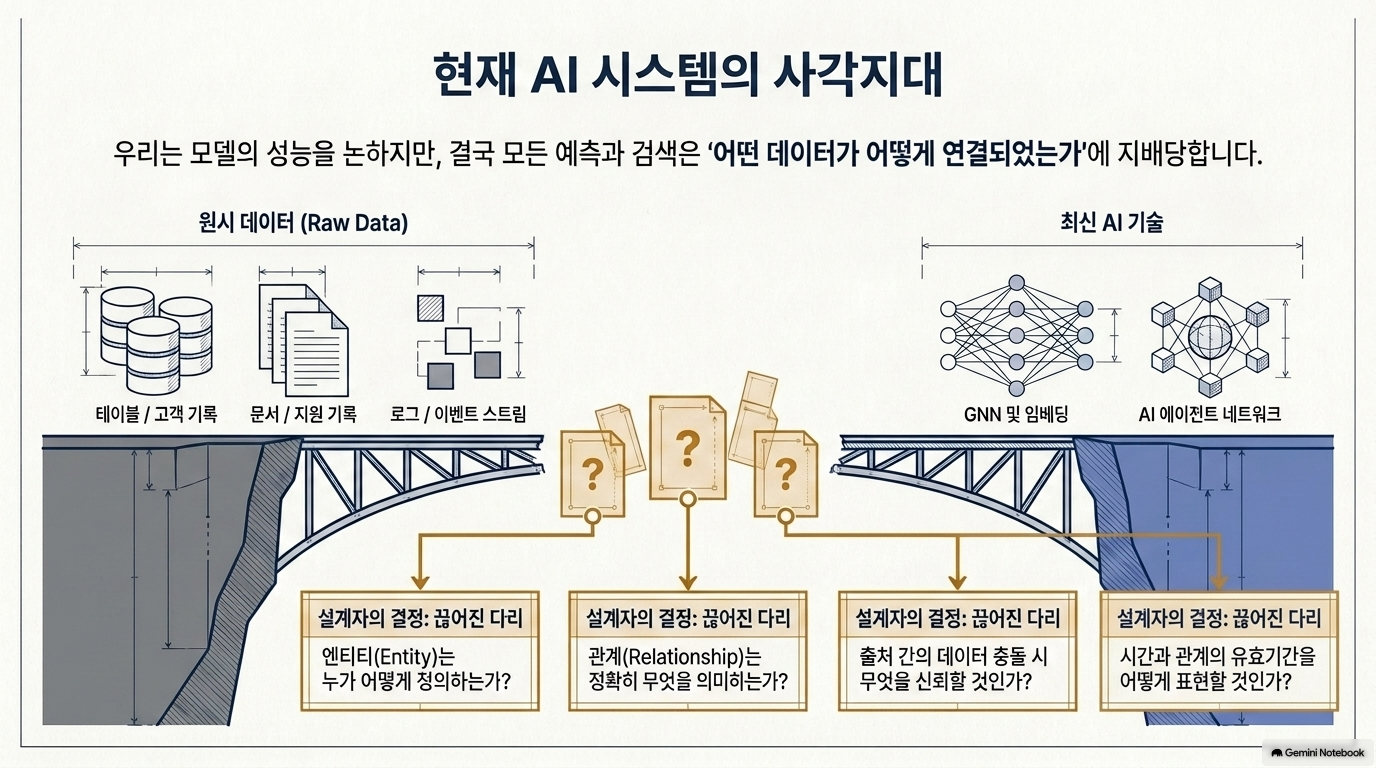
고객정보는 테이블에, 상담 내역은 문서에, 제품 사용기록은 이벤트 스트림에, 장애 이력은 티켓에 있을 수 있습니다. 이들을 그래프로 만들려면 먼저 동일한 고객을 어떻게 식별할지, 무엇을 관계로 볼지, 관계가 언제 유효한지, 상충하는 기록 중 어느 출처를 신뢰할지 결정해야 합니다. 저자는 이 결정이 후속 예측과 검색 결과, 에이전트의 판단 범위를 규정한다고 봅니다.[1]
- 핵심 전환: 그래프를 GNN이나 GraphRAG의 이미 주어진 입력으로 보지 않고, 원천 데이터와 AI 응용 사이의 일급 모델링 산출물로 봅니다.
- 실무 해석: 모델 정확도만 측정하면 데이터 표현의 오류가 모델 오류로 오인될 수 있습니다. 예컨대 같은 기관의 명칭 변경 이력을 서로 다른 기관으로 처리했다면, 검색 모델을 교체해도 관계 추적 문제는 남습니다.
- 주의: “그래프를 만들면 AI가 개선된다”는 보편적 성능 주장은 아닙니다. 어떤 그래프 표현이 어떤 과업에 유효한지 검증해야 한다는 것이 글의 출발점입니다.[1]
2. A graph is a model of the data — 그래프는 데이터의 ‘복사본’이 아니라 해석이다
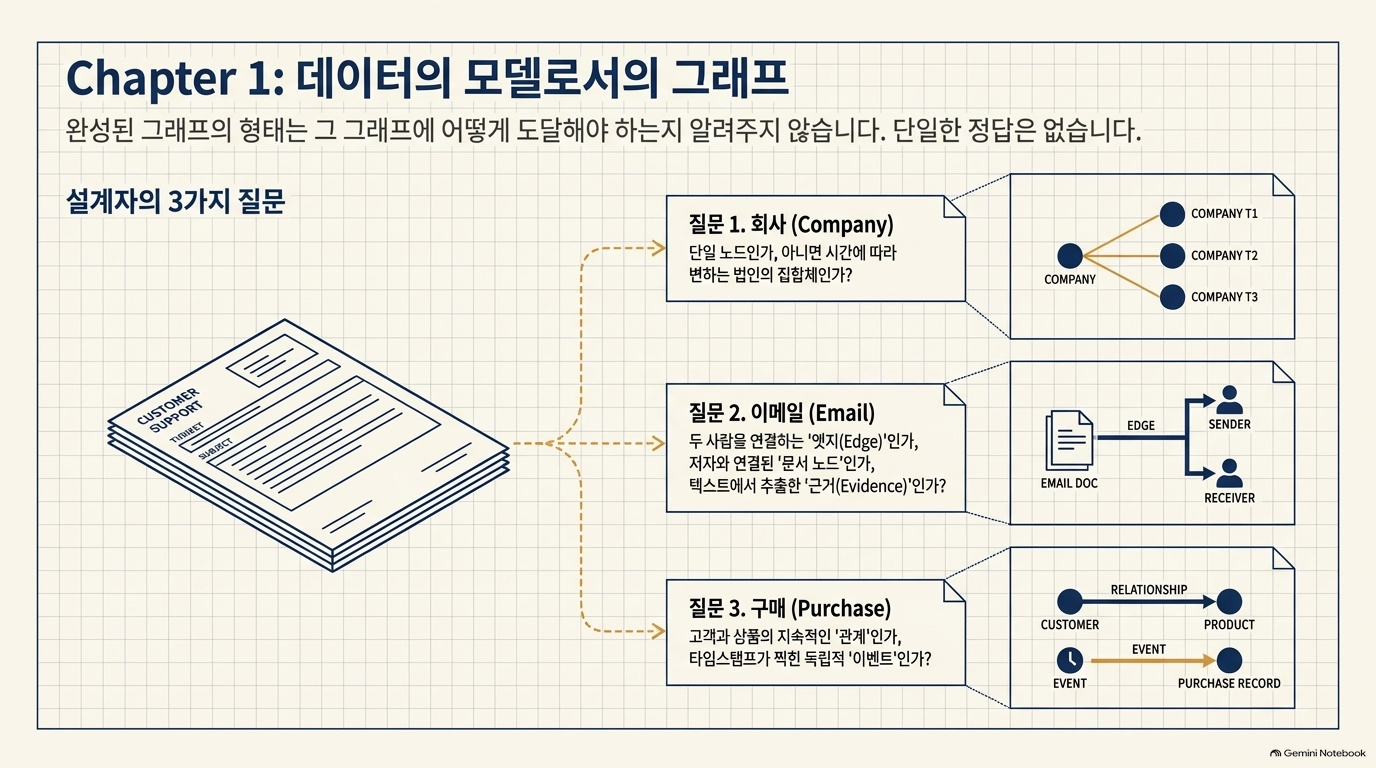
노드와 엣지만 정한다고 그래프 모델링이 끝나지 않습니다. 실제 시스템에는 유형, 타임스탬프, 출처·계보(provenance), 신뢰도, 권한도 필요합니다. 저자는 기업을 단일 노드로 볼지 시점에 따라 달라지는 여러 법인으로 볼지, 이메일을 사람 간 엣지로 볼지 문서 노드로 볼지, 구매를 지속 관계로 볼지 시점이 있는 사건으로 볼지 등의 예를 듭니다. 어느 하나가 항상 정답인 것은 아닙니다.[1]
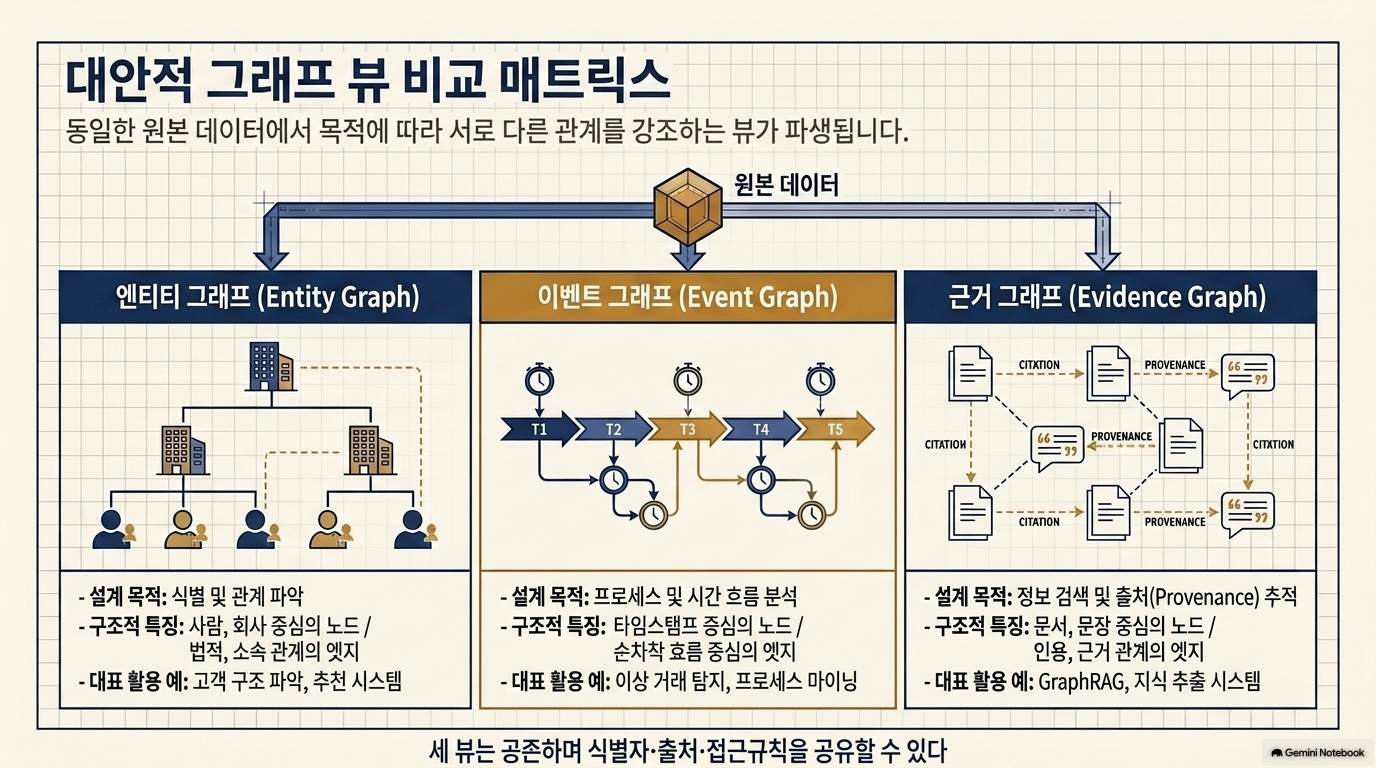
| 그래프 뷰 | 우선 보존하는 의미 | 적합한 질문의 예 |
| 개체 중심(entity) | 주체의 식별과 관계 | “두 고객 기록은 같은 사람인가?” |
| 사건 중심(event) | 행위의 발생 시점과 순서 | “장애 전후에 어떤 변경이 있었나?” |
| 증거 중심(evidence) | 주장과 그 근거·출처 | “이 답변을 뒷받침하는 원문은 무엇인가?” |
표의 질문은 원문의 구분을 바탕으로 든 설명용 예시입니다.[1]
실무 해석: 그래프 스키마는 단순한 저장 형식이 아니라 무엇을 질문할 수 있고 무엇을 잃는지를 결정하는 설계입니다. 특히 ‘동일 개체로 확정’과 ‘동일 개체일 가능성이 있음’을 구별하지 않으면, 불확실한 매칭이 확정 사실처럼 후속 경로 전체로 전파될 수 있습니다.
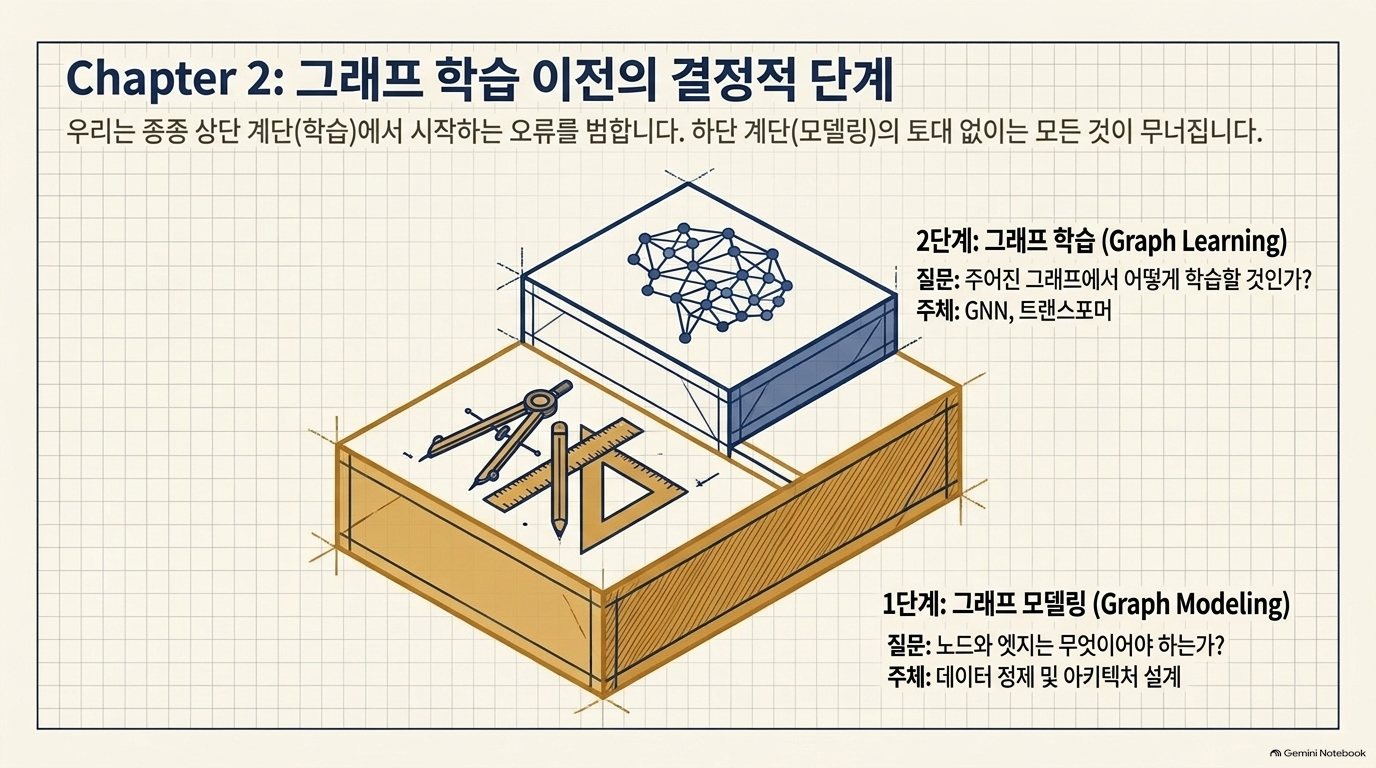
3. The step before graph learning — 학습 이전에 그래프 구조를 평가해야 한다
기존 그래프 표현학습은 대체로 인접 구조가 이미 정해졌다고 가정합니다. 임베딩은 노드를 벡터로 표현하고, GNN은 이웃 간 정보를 전달하며, 그래프 트랜스포머는 그래프 구조와 더 넓은 범위의 주의를 결합합니다. 반면 그래프 모델링은 그보다 앞서 “무엇을 연결해야 하는가?”를 묻습니다.[1]
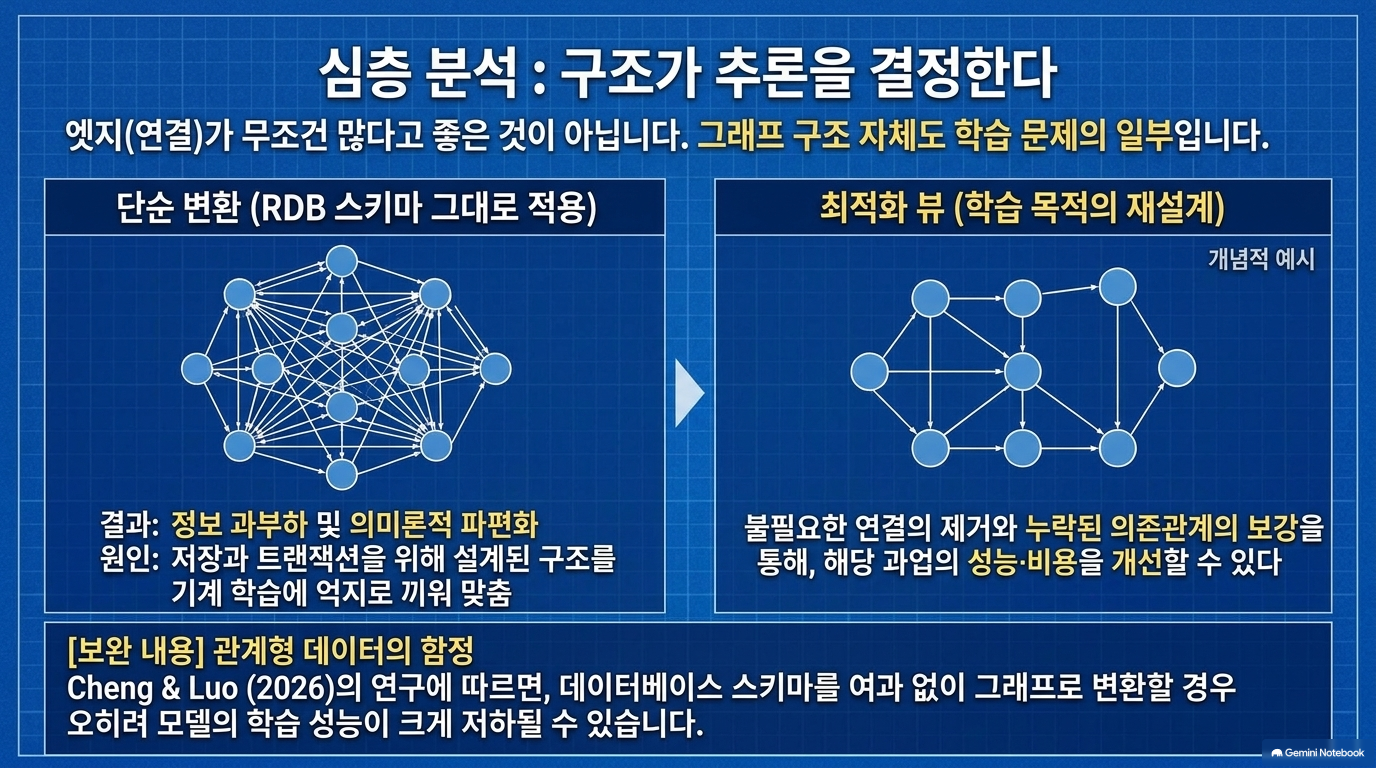
저자가 든 구체적 사례는 Relational Deep Learning(RDL)입니다. RDL은 관계형 데이터베이스의 행을 노드로, 기본키–외래키 연결을 엣지로 삼아 시간적·이종 그래프를 구성합니다. 이는 수동 조인과 특성공학 부담을 줄이는 방법이지만, 동시에 거래·저장을 위해 설계한 DB 스키마가 학습에도 적절한 그래프인가라는 가정을 포함합니다.[1][4]
원문이 인용한 후속 연구는 분류·회귀·추천을 포함한 26개 과업에서 스키마를 그대로 옮긴 그래프의 두 문제를 분석했습니다.[2]
- 정보 과부하: 관련성이 낮은 연결까지 메시지 전달에 들어와 유용한 신호를 흐릴 수 있습니다.
- 의미적 분절: 원래 스키마의 키 연결만으로는 과업에 필요한 관계가 연결되지 않을 수 있습니다.
- 구조 적응: 불필요한 연결을 필터링하고, 빠진 의존관계를 주입해 그래프를 조정합니다. 논문 초록에 따르면 최적화한 그래프는 해당 실험의 26개 과업에서 정확도를 개선했고, 추론 비용도 종종 줄였습니다. 모든 도메인에서 같은 개선을 보장한다는 뜻은 아닙니다.[2]
실무 해석: 그래프 구축을 일회성 ETL로 끝내지 말고, 후보 구조 생성 → 과업별 평가 → 실패 분석 → 구조 수정의 반복으로 운영해야 합니다. 엣지 수나 그래프 크기 자체가 품질지표는 아닙니다. 관계가 해당 과업의 추론에 실제로 필요한지가 더 중요합니다.[1][2]
4. What the graph can support — 모델링된 그래프의 다섯 활용 경로
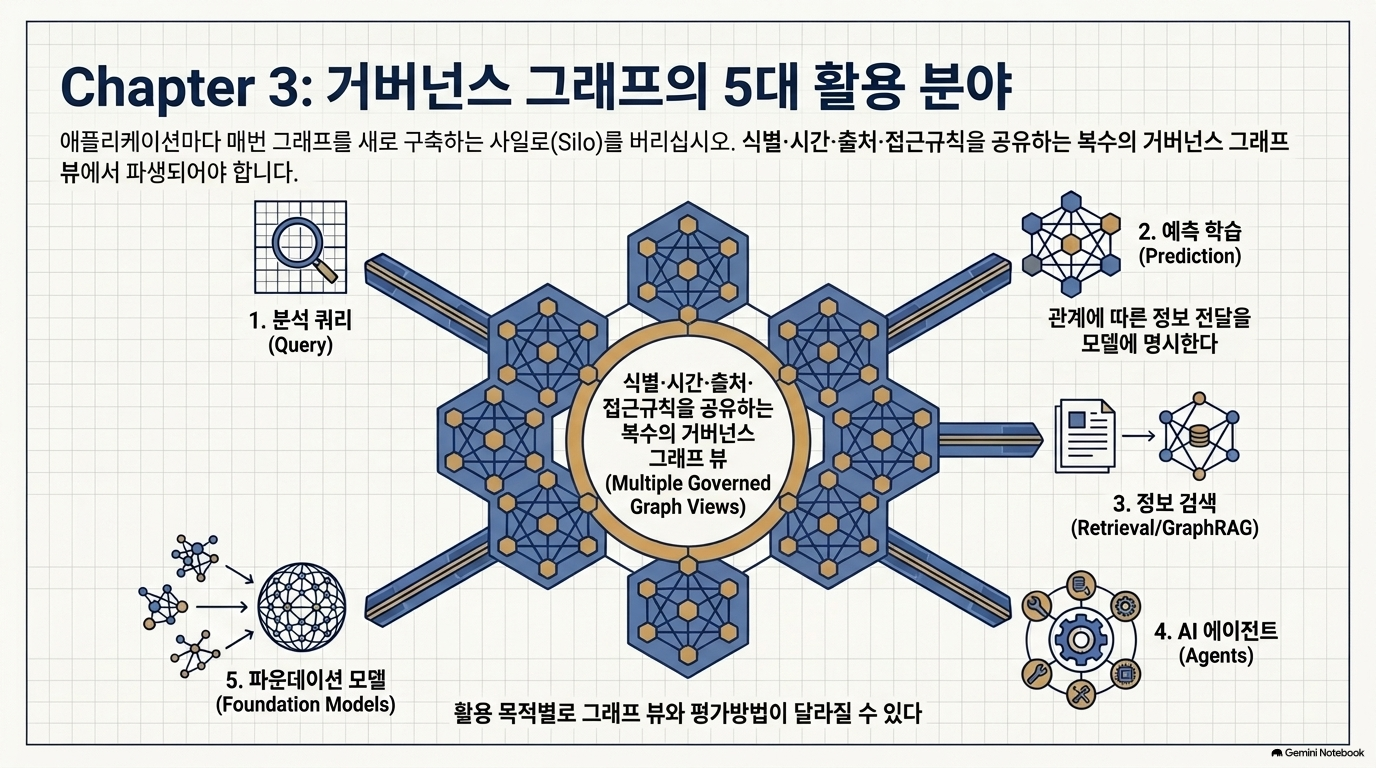
저자는 공통의 모델링·거버넌스 기반 위에서 여러 그래프 뷰를 만들 수 있다고 설명하며, 활용 경로를 다섯 가지로 나눕니다.[1]
| 경로 | 그래프의 역할 | 저자가 강조하는 판단 기준 |
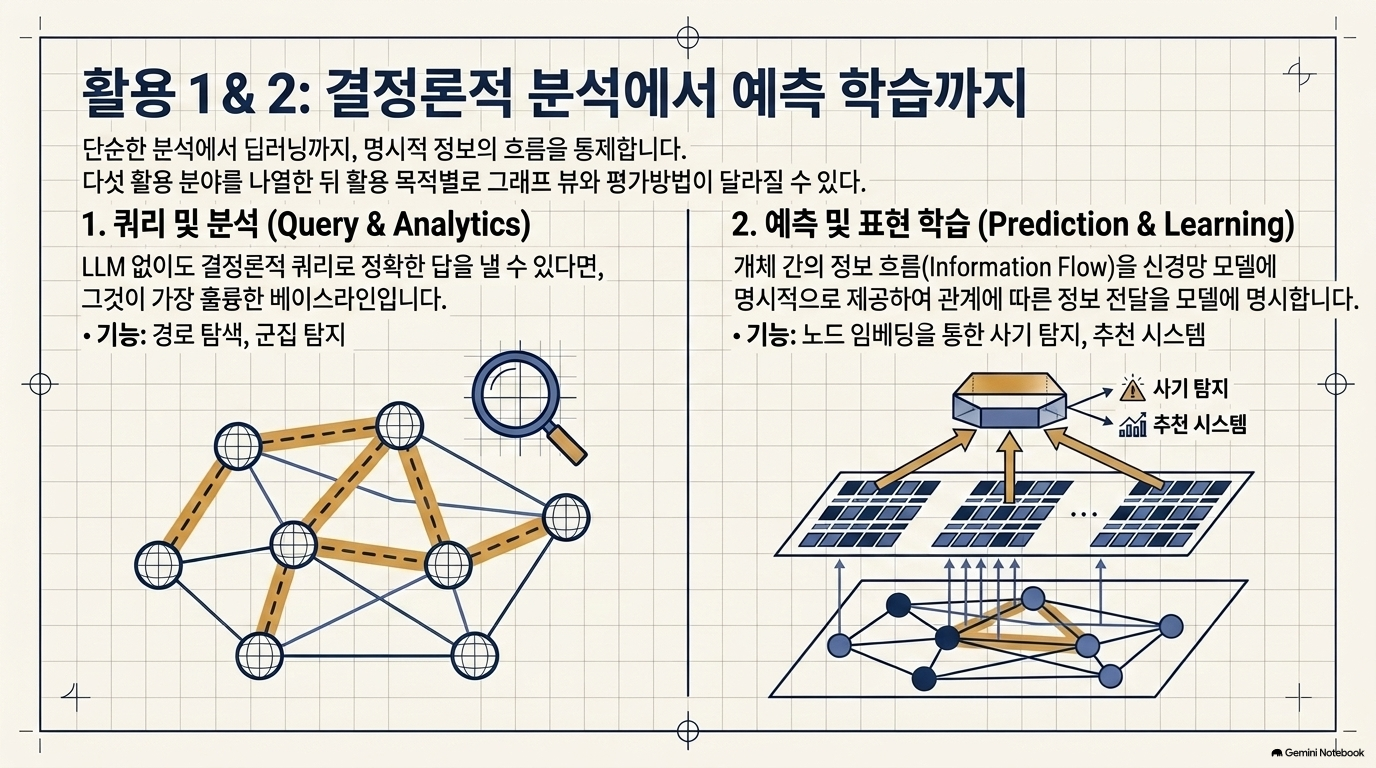
| ① 질의·분석 | 경로 탐색, 이웃 집계, 중심성·커뮤니티 분석 | 결정적 질의로 답할 수 있다면 LLM부터 도입할 필요가 없음 |
| ② 예측·표현학습 | 노드·엣지·부분그래프·전체 그래프에 대한 학습 입력 | 어떤 관계를 통해 정보를 전달할지 구조가 결정 |
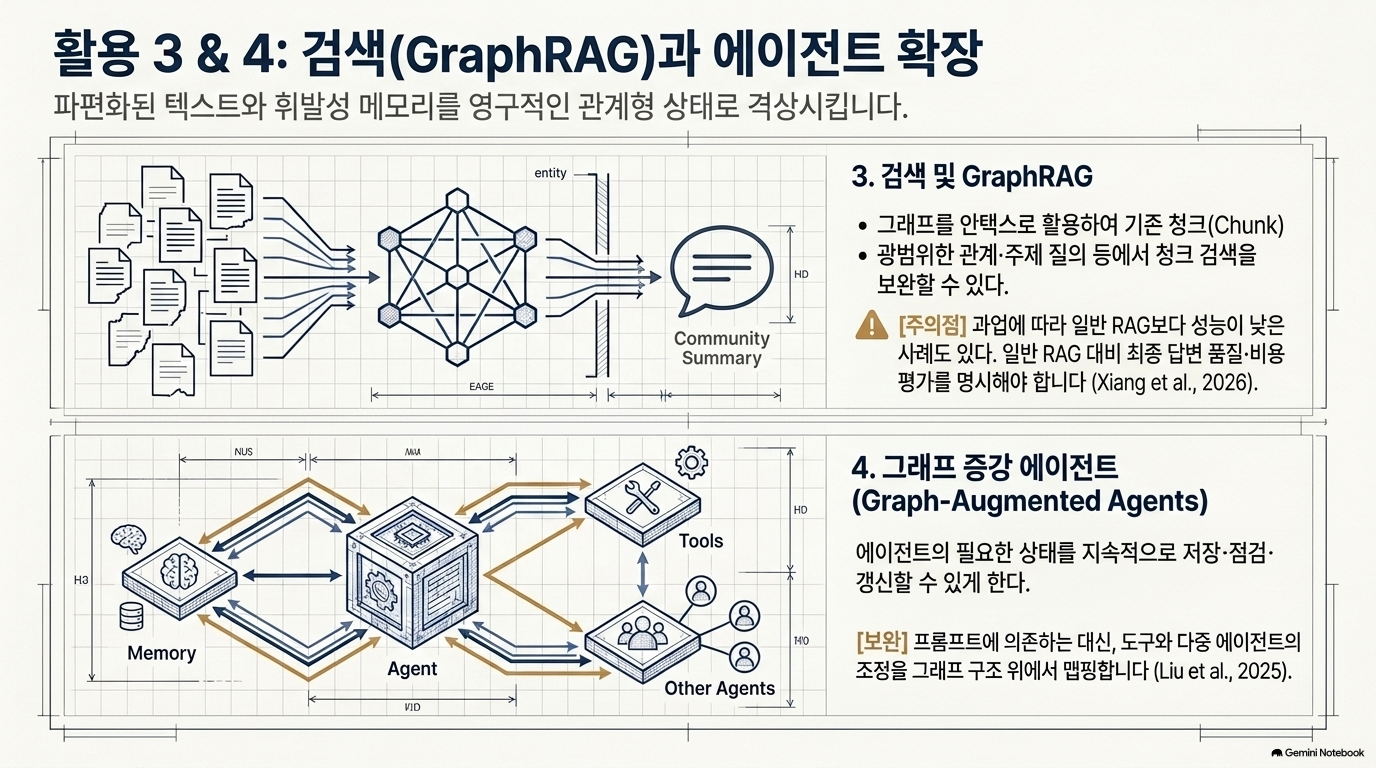
| ③ GraphRAG | 검색 인덱스와 근거 연결 구조 | 그래프 구축·검색의 추가 비용이 최종 답변 품질 개선으로 이어져야 함 |
| ④ 그래프 증강 에이전트 | 메모리, 계획, 도구, 상태 전이의 관계를 지속·점검 가능하게 표현 | 에이전트 상태 중 어느 부분에 그래프가 유익한지 선택 |
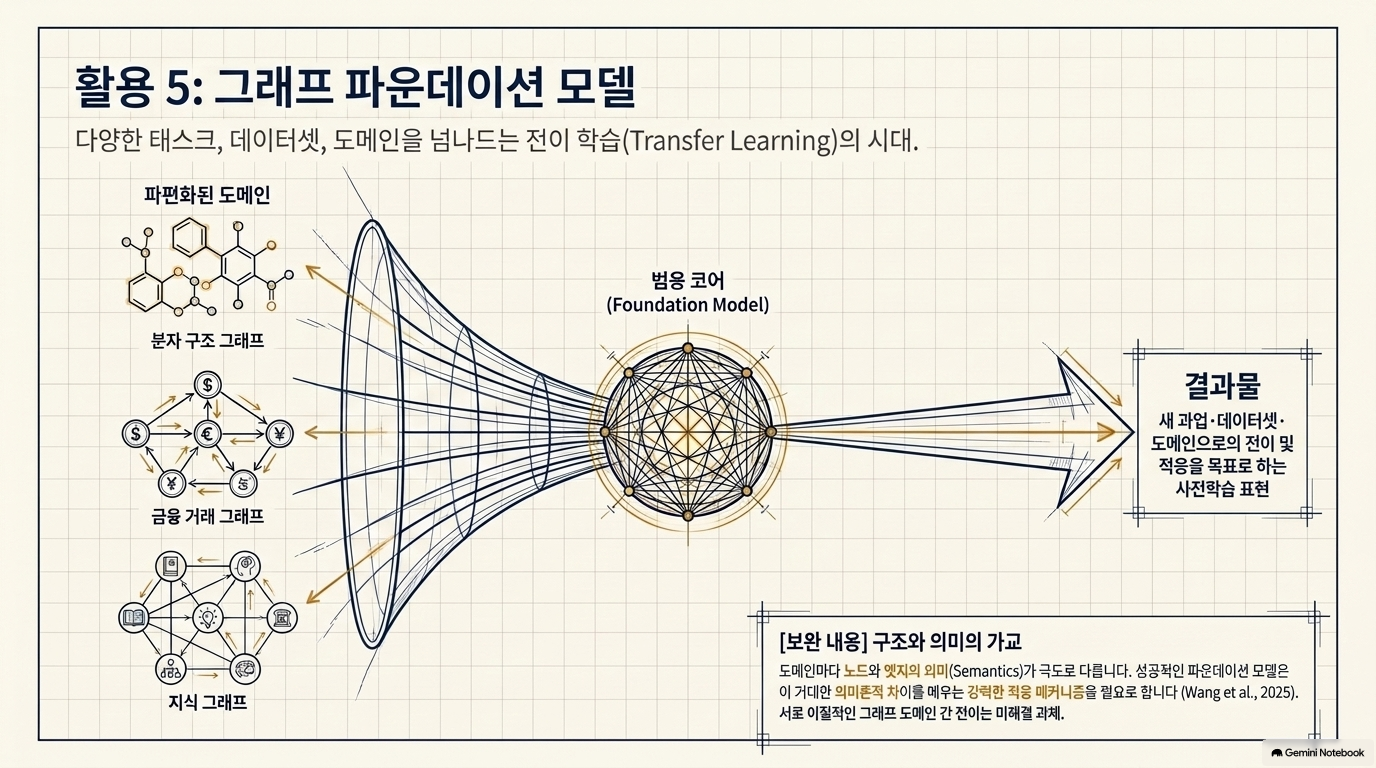
| ⑤ 그래프 파운데이션 모델 | 과업·데이터셋·도메인 간 전이를 위한 사전학습 기반 | 서로 다른 도메인의 노드·엣지 의미 차이를 극복해야 함 |
GraphRAG에 대한 중요한 단서: 그래프가 일반 RAG보다 항상 낫지는 않습니다. 원문은 GraphRAG가 바닐라 RAG보다 못한 사례를 다룬 벤치마크를 인용하며, 그래프 구축→검색→생성의 전체 파이프라인으로 평가해야 한다고 강조합니다. 해당 논문 초록도 사실 검색부터 복합 추론·요약·생성까지 과업을 나눠 적용 조건을 분석한다고 설명합니다.[1][3]
실무 해석: 다섯 경로는 성숙도 순서나 일괄 도입 목록이 아닙니다. 동일한 업무 질문에 대해 먼저 결정적 질의와 일반 검색을 기준선으로 두고, 관계 추론이 필요한 구간에서만 그래프 검색이나 학습을 추가하는 편이 타당합니다.
5. What better graph modeling would look like — ‘좋은 그래프 모델링 시스템’의 요건
저자의 목표는 원천 데이터를 넣으면 ‘유일하게 올바른 그래프’ 하나를 반환하는 범용 변환기가 아닙니다. 여러 후보 그래프 뷰를 제안·시험·유지보수하는 시스템입니다.[1]
원문에서 요구하는 기능을 운영 절차로 풀면 다음과 같습니다.
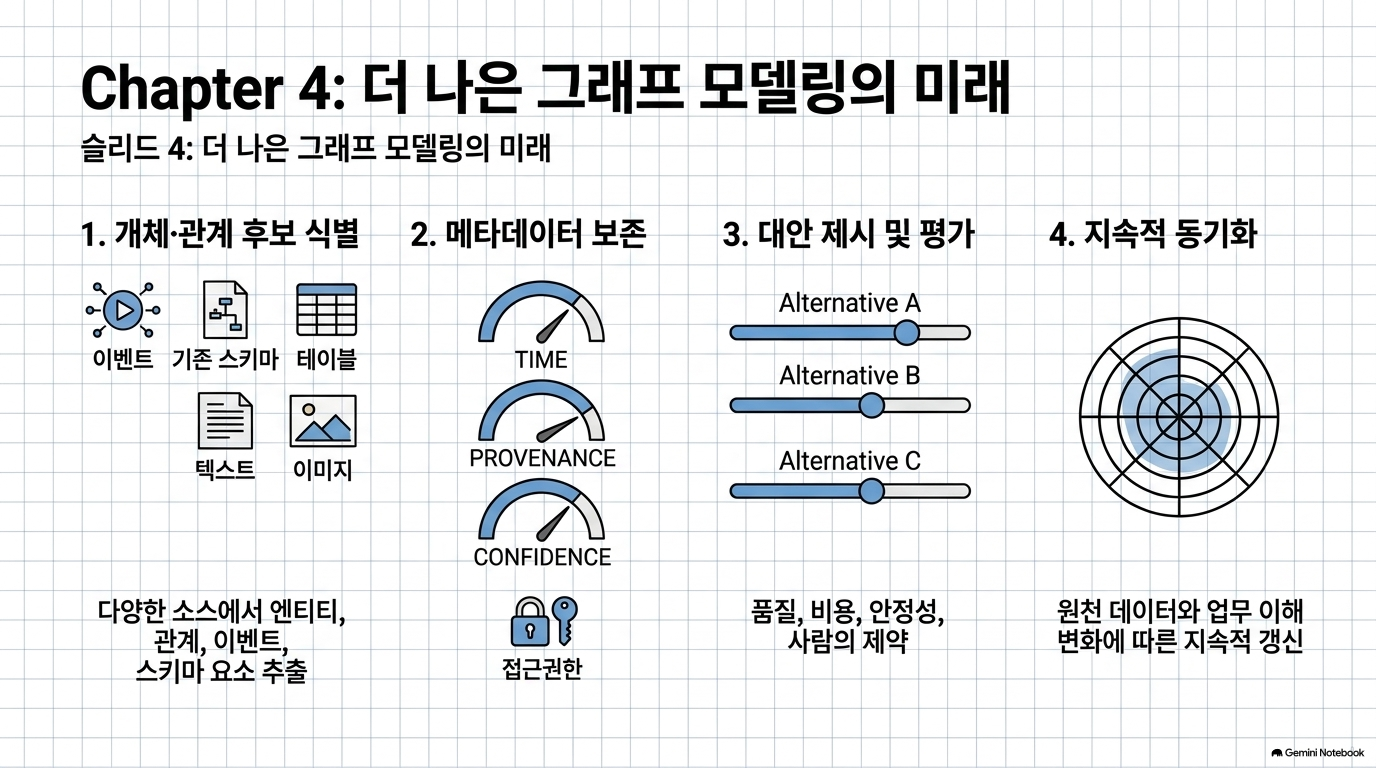
- 후보 발견: 테이블·텍스트·이벤트·이미지·기존 스키마에서 개체와 관계 후보를 찾는다.
- 맥락 보존: 유형·시간·출처·신뢰도·접근권한을 관계와 함께 관리한다.
- 대안 유지: 애매한 개체 병합이나 사건 표현을 조용히 확정하지 않고 복수 후보로 남긴다.
- 비교 평가: 후속 과업의 품질뿐 아니라 비용·안정성·사람의 제약 조건을 함께 본다.
- 지속 갱신: 원천 데이터와 조직의 업무 이해가 바뀌면 그래프도 갱신한다.[1]
저자는 예측 오류가 누락된 관계를, 검색 실패가 부적절한 근거 단위나 단절을, 에이전트 실패가 빠진 상태 전이를 드러낼 수 있다고 봅니다. 즉 그래프의 품질은 도식의 미려함이 아니라 실제 과업을 얼마나 잘 지원하는지로 평가해야 합니다.[1]
종합 평가와 적용 시사점
이 글의 강점은 그래프 DB·GNN·GraphRAG를 각각 별도의 유행 기술로 다루지 않고, 그 공통 상류에 있는 의미 모델링과 거버넌스를 평가 대상으로 끌어올린 점입니다. 특히 원천 스키마를 그대로 그래프로 옮기는 관행에 대해, 26개 관계형 과업의 구조 적응 연구와 GraphRAG 비교 연구를 들어 “구조 선택의 성능 효과를 측정하라”고 요구합니다.[1][2][3]
한계도 분명합니다. 본문은 설계 방향을 제시하는 논설이지, 신원해결의 정답 기준, 시간 모델의 상세 규칙, 권한 전파 방식, 후보 그래프의 평가척도·합격 임계값까지 제시한 구현 명세는 아닙니다. 또한 인용 연구의 결과를 특정 기관 데이터에 곧바로 일반화할 수 없습니다.[1][2][3]
사용자님의 공공·교육 데이터 품질/감리 관점으로 옮기면, 다음을 별도 검토항목으로 둘 만합니다. 이는 원문을 적용한 제안이지 원문에 명시된 의무사항은 아닙니다.
- 개체 식별: 기관·발행사·학습자·콘텐츠의 동일성 판단 기준과 변경 이력
- 관계 정의: ‘소속’, ‘배포’, ‘학습’, ‘평가’, ‘근거’의 의미·방향·유효기간
- 증거 계보: 각 엣지가 어느 원천 레코드·문서·추출 결과에서 왔는지
- 불확실성 관리: 추정 관계와 확인된 관계의 구분 및 인간 검토 절차
- 과업별 검증: 일반 SQL/검색/RAG를 기준선으로 둔 정확도·근거 적합성·지연시간·운영비 비교
- 변경 통제: 원천 정정이나 권한 변경 시 파생 그래프 뷰와 검색 인덱스의 동기화
한 문장 결론: 이 글에서 ‘graph-native’의 핵심은 그래프 기술을 많이 쓰는 것이 아니라, 데이터를 어떤 관계 구조로 해석했는지 명시하고 그 해석을 과업 성능과 거버넌스 기준으로 계속 검증하는 것입니다.[1]
Sources
[1] Ammar Mohanna, “From Raw Data to Graph-Native AI,” O’Reilly Radar
[2] Cheng & Luo, “What Makes a Desired Graph for Relational Deep Learning?”
[3] Xiang et al., “When to use Graphs in RAG”
[4] Fey et al., “Relational Deep Learning: Graph Representation Learning on Relational Databases”
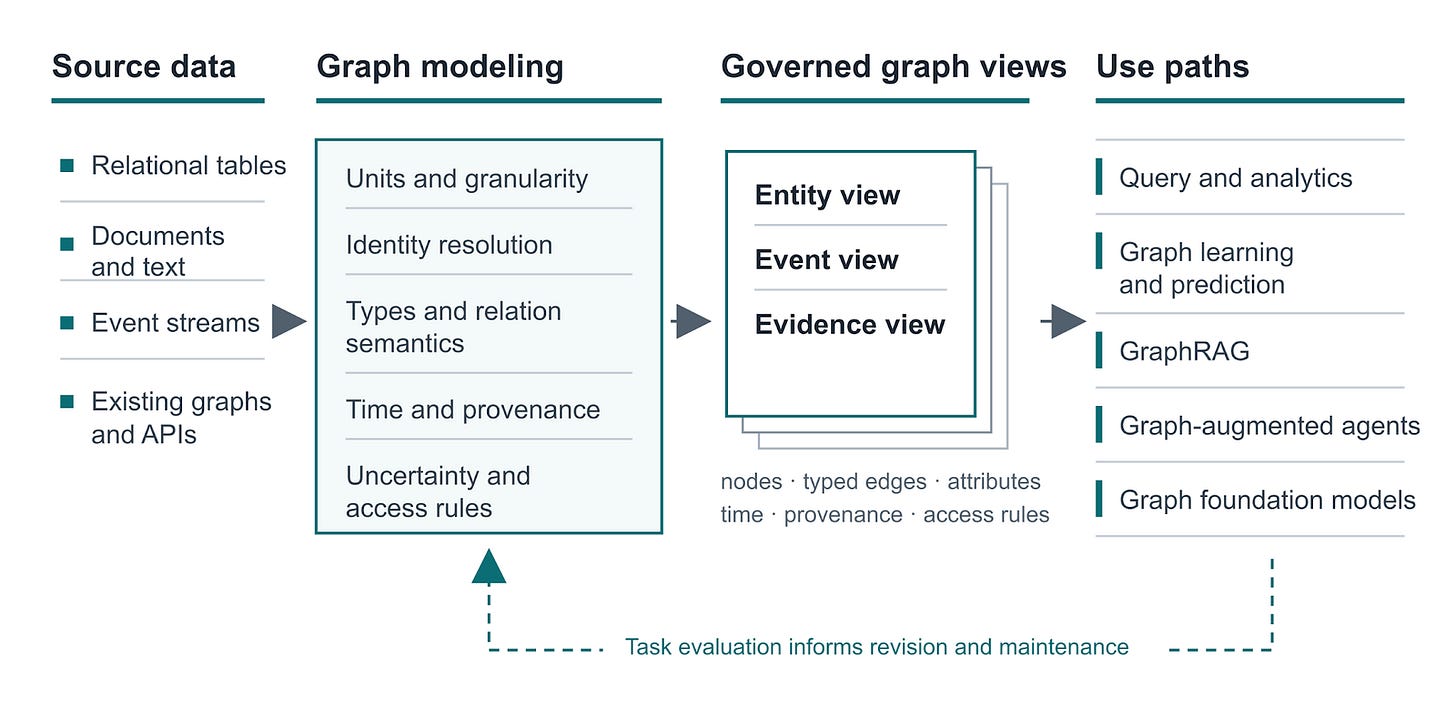
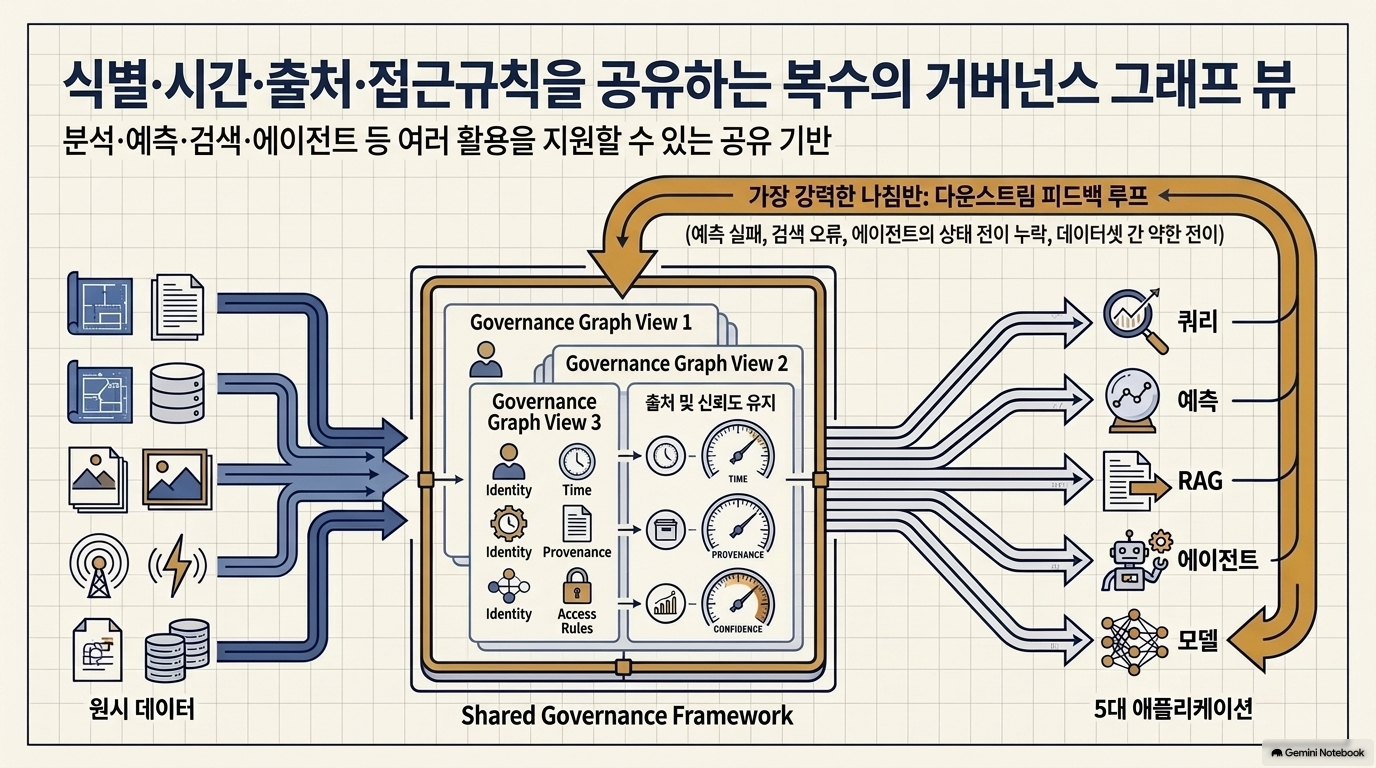
이 그림은 앞서 분석한 글의 핵심을 「원천 데이터 → 그래프 모델링 → 관리되는 그래프 뷰 → 활용」이라는 흐름으로 보여줍니다. 중요한 부분은 맨 아래 점선입니다. 활용 결과를 평가한 뒤 그래프 모델링을 수정하는 피드백 고리가 있어, 그래프를 한 번 만들고 끝내지 않습니다.
① Source data — 서로 다른 형태의 원천 데이터
관계형 테이블, 문서·텍스트, 이벤트 스트림, 기존 그래프·API가 입력입니다. 그림은 이 데이터들을 단순히 한곳에 모으는 것만으로는 AI가 사용할 만한 관계 구조가 생기지 않는다고 전제합니다.
② Graph modeling — 무엇을 어떻게 연결할지 결정
그림의 중심이자 가장 중요한 단계입니다.
| 그림의 항목 | 뜻 | 예시 |
| Units and granularity | 노드·사건의 단위와 상세 수준 | ‘기관’ 하나를 노드로 할지, 산하 조직까지 분리할지 |
| Identity resolution | 여러 기록이 동일 대상을 가리키는지 판정 | 명칭이 다른 두 고객 기록의 동일성 판단 |
| Types and relation semantics | 개체·관계의 유형과 의미 정의 | 소속과 거래를 서로 다른 관계로 정의 |
| Time and provenance | 관계의 유효 시점과 출처 기록 | 언제 소속됐으며 어느 문서가 근거인지 |
| Uncertainty and access rules | 추정의 불확실성과 열람 권한 관리 | ‘동일인 가능성’과 ‘동일인 확정’을 구분 |
즉, 테이블의 행을 기계적으로 노드로 바꾸는 변환 단계가 아니라 업무 의미를 정하는 단계입니다.
③ Governed graph views — 목적별로 관리되는 여러 관점
모델링 결과는 하나의 ‘만능 그래프’로 고정되지 않습니다. 그림은 겹쳐진 카드로 복수의 뷰를 표현합니다.
- Entity view(개체 뷰): 누가 누구와 연결되는가
- Event view(사건 뷰): 무엇이 언제 발생했고 어떤 순서로 이어졌는가
- Evidence view(증거 뷰): 어떤 주장·관계를 어느 자료가 뒷받침하는가
세 뷰는 서로 다른 질문에 답하지만, 아래에 표시된 노드·유형이 있는 엣지·속성·시간·출처·접근규칙을 일관되게 관리해야 합니다. Governed는 바로 이 공통 규칙이 있는 상태를 뜻합니다.
④ Use paths — 같은 기반을 서로 다른 방식으로 활용
오른쪽의 다섯 경로는 순차적인 개발 단계가 아니라 선택 가능한 활용 방식입니다.
- Query and analytics: 경로 탐색 등 결정적 질의·분석
- Graph learning and prediction: 그래프를 이용한 학습·예측
- GraphRAG: 관계와 증거를 활용한 검색·답변
- Graph-augmented agents: 에이전트의 상태·기억·행동 관계 관리
- Graph foundation models: 여러 그래프 과업·도메인으로의 전이를 목표로 하는 모델
⑤ 아래 점선 — 과업 평가 결과가 모델링을 다시 바꾼다
오른쪽 활용 경로에서 나온 평가 결과가 왼쪽 Graph modeling으로 돌아갑니다. 예를 들어 GraphRAG가 필요한 근거를 찾지 못한다면, LLM만 조정할 것이 아니라 증거 노드의 단위가 너무 크거나 관계가 누락됐는지 확인하라는 의미입니다. 예측이 잘못되면 불필요한 연결을 제거하거나 빠진 연결을 추가할 수 있습니다.
요약하면: 이 그림은 “원천 데이터를 그래프로 바꿔 AI에 넣는다”는 일방향 파이프라인이 아닙니다. 업무 의미와 거버넌스를 반영해 복수의 그래프 뷰를 설계하고, 실제 과업의 성과로 그 설계를 계속 검증·수정하는 구조입니다.
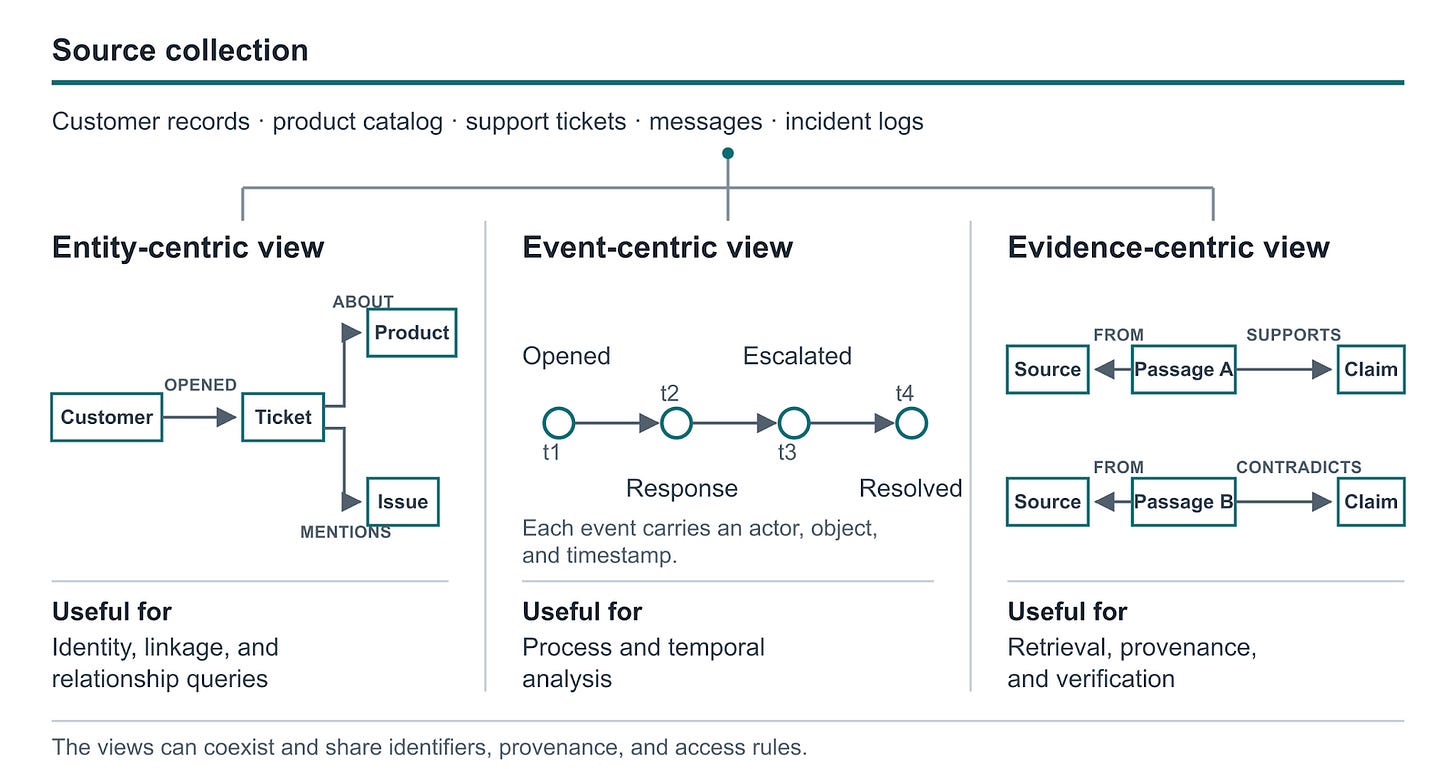
이 그림은 동일한 원천자료를 목적에 따라 세 가지 그래프 관점으로 표현할 수 있다는 뜻입니다. 위쪽의 고객 기록·제품 목록·지원 티켓·메시지·장애 로그가 세 관점의 공통 입력입니다.
| 관점 | 그림에서 표현한 내용 | 답하기 좋은 질문 |
| 개체 중심(Entity-centric) | 고객 —OPENED→ 티켓, 티켓 —ABOUT→ 제품, 티켓 —MENTIONS→ 이슈 | “이 고객이 제기한 티켓은 어떤 제품·이슈와 연결되는가?” |
| 사건 중심(Event-centric) | 접수(t1) → 응답(t2) → 상위 단계 이관(t3) → 해결(t4)의 시간 순서. 각 사건에는 행위자·대상·시각이 포함됨 | “어떤 절차를 거쳐 해결됐고, 어디에서 지연됐는가?” |
| 증거 중심(Evidence-centric) | [출처] ←FROM— 문단 A —SUPPORTS→ 주장과 출처 ←FROM— 문단 B —CONTRADICTS→ 주장 | “이 주장의 근거는 무엇이며, 반박하는 자료도 있는가?” |
차이는 무엇을 보존하느냐입니다. 개체 중심 뷰는 연결, 사건 중심 뷰는 발생 순서와 시간, 증거 중심 뷰는 주장에 대한 근거와 상충 정보를 전면에 둡니다. 예컨대 ‘티켓이 해결됐다’는 사실만 필요한 관계 질의와, 해결까지 걸린 시간 분석, ‘해결됐다’는 주장에 대한 원문 검증은 서로 다른 구조를 요구합니다.
그림 맨 아래 문장이 핵심입니다. 세 뷰는 양자택일이 아니라 공존할 수 있으며, 식별자·출처 정보·접근권한 규칙을 공유합니다. 따라서 같은 티켓을 세 관점에서 조회하더라도 서로 다른 사건이나 증거를 잘못 연결하지 않도록 공통 식별·거버넌스 기반이 필요합니다.
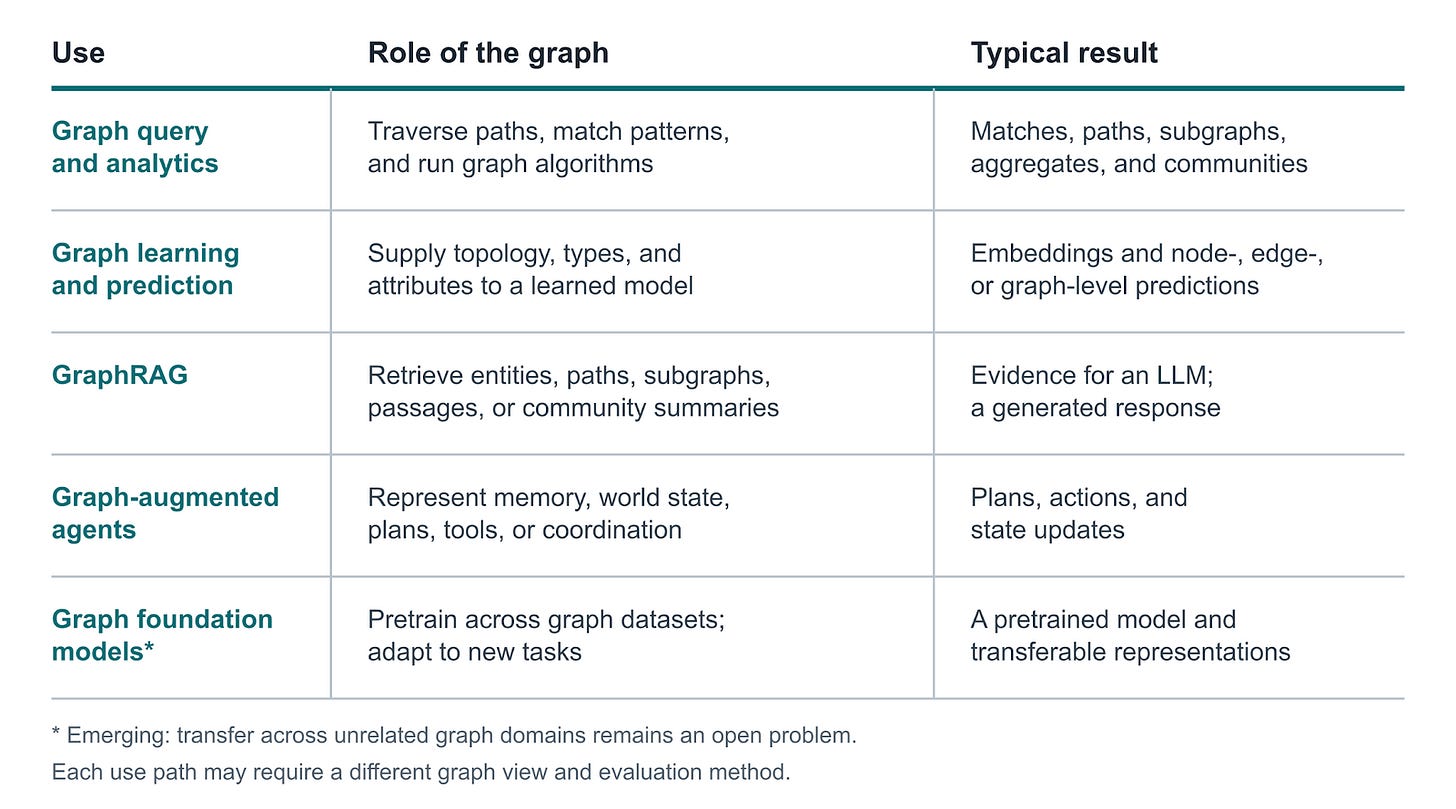
이 그림은 앞선 두 그림의 세 가지 그래프 뷰를 실제로 어디에 쓰는가를 정리한 표입니다. 열은 왼쪽부터 활용 방식(Use) → 그래프의 역할(Role) → 대표 결과(Typical result)입니다.
| 활용 방식 | 그래프가 하는 일 | 나오는 결과 |
| 그래프 질의·분석 | 연결 경로를 탐색하고, 관계 패턴을 찾고, 그래프 알고리즘을 실행 | 일치하는 패턴, 경로, 부분그래프, 집계, 커뮤니티 |
| 그래프 학습·예측 | 노드·엣지의 연결 구조(토폴로지), 유형, 속성을 학습모델에 제공 | 임베딩 및 노드·엣지·그래프 단위의 예측 |
| GraphRAG | 개체, 경로, 부분그래프, 원문 문단 또는 커뮤니티 요약을 검색 | LLM에 제공할 근거와 이를 바탕으로 생성된 답변 |
| 그래프 증강 에이전트 | 기억, 현재 상태, 계획, 도구, 에이전트 간 협력 관계를 표현 | 계획, 실행 행동, 상태 갱신 |
| 그래프 파운데이션 모델* | 여러 그래프 데이터셋에서 사전학습하고 새 과업에 적응 | 사전학습 모델과 전이 가능한 표현 |
구별할 지점은 그래프의 ‘역할’입니다. 질의·분석에서는 그래프를 직접 탐색해 결과를 얻습니다. 학습·예측에서는 그래프가 모델의 입력 구조이고, GraphRAG에서는 검색할 근거 구조입니다. 에이전트에서는 기억과 상태를 표현·갱신하는 구조, 파운데이션 모델에서는 사전학습 대상이 됩니다. 따라서 같은 그래프 기술을 쓴다고 평가방법까지 같아지는 것은 아닙니다.
하단의 주석도 중요합니다.
- \* 그래프 파운데이션 모델은 아직 발전 중이며, 서로 관련 없는 그래프 도메인 사이에서 학습한 표현을 효과적으로 전이하는 문제는 미해결 과제입니다.
- 각 활용 경로에는 서로 다른 그래프 뷰와 평가방법이 필요할 수 있습니다. 예를 들어 관계 경로 질의에는 개체 중심 뷰가, 처리 소요시간 분석에는 사건 중심 뷰가, 답변 근거 검증에는 증거 중심 뷰가 더 적합할 수 있습니다.
결국 이 표의 메시지는 “그래프 하나를 구축하면 다섯 용도에 그대로 재사용할 수 있다”가 아니라, 활용 목적을 먼저 정하고 그에 맞는 그래프 표현과 성과 기준을 선택하라는 것입니다.

'07.AI > 13. AI 데이터' 카테고리의 다른 글
| AI 데이터 - 온톨로지, 컨텍스트 그래프, 시멘틱 레이어 (0) | 2026.09.30 |
|---|---|
| 클라우드 컴퓨팅 - 네이버 클라우드, DB & Server Access Control(DSAC) (0) | 2026.09.23 |
| AI Slop - IEEE Spectrum, AI Slop은 엔지니어의 코드 검토 방식을 바꾸고 있습니다. (0) | 2026.09.13 |
| AI Slop - Ahrefs, AI 활용 블로그 내 고품질 컨텐츠 제작 전략 (0) | 2026.09.07 |
| 에이전트 AI - Cerebras 사내 지식 검색 시스템 (0) | 2026.08.20 |