https://contextandchaos.substack.com/p/ontologies-context-graphs-and-semantic
2026.1.23
[Ontologies, Context Graphs, and Semantic Layers: What AI Actually Needs in 2026]
이 글은 현대 데이터 관리 체계의 핵심인 시맨틱 레이어(Semantic Layer)와 온톨로지(Ontology)의 근본적인 차이를 분석하며, 2026년 인공지능이 진정으로 필요로 하는 기술적 토대가 무엇인지 탐구합니다. 저자는 과거의 시맨틱 레이어가 주로 일관된 지표 계산을 통한 측정(Measurement)에 집중해 왔다면, 온톨로지는 데이터 간의 복잡한 관계와 논리적 추론을 가능하게 하는 의미(Meaning) 형성에 목적을 둔다고 설명합니다. 특히 AI 시대가 도래함에 따라 단순한 대시보드용 데이터가 아닌, 맥락(Context)과 추론을 지원하는 정교한 지식 아키텍처의 구축이 기업의 생존을 결정짓는 핵심 역량이 될 것임을 강조합니다. 결국 미래의 AI 시스템은 단순한 수치 계산을 넘어, 지식 공학에 기반한 깊은 도메인 이해도를 갖추어야 비로소 진정한 지능형 의사결정을 지원할 수 있다는 것이 이 글의 핵심입니다.
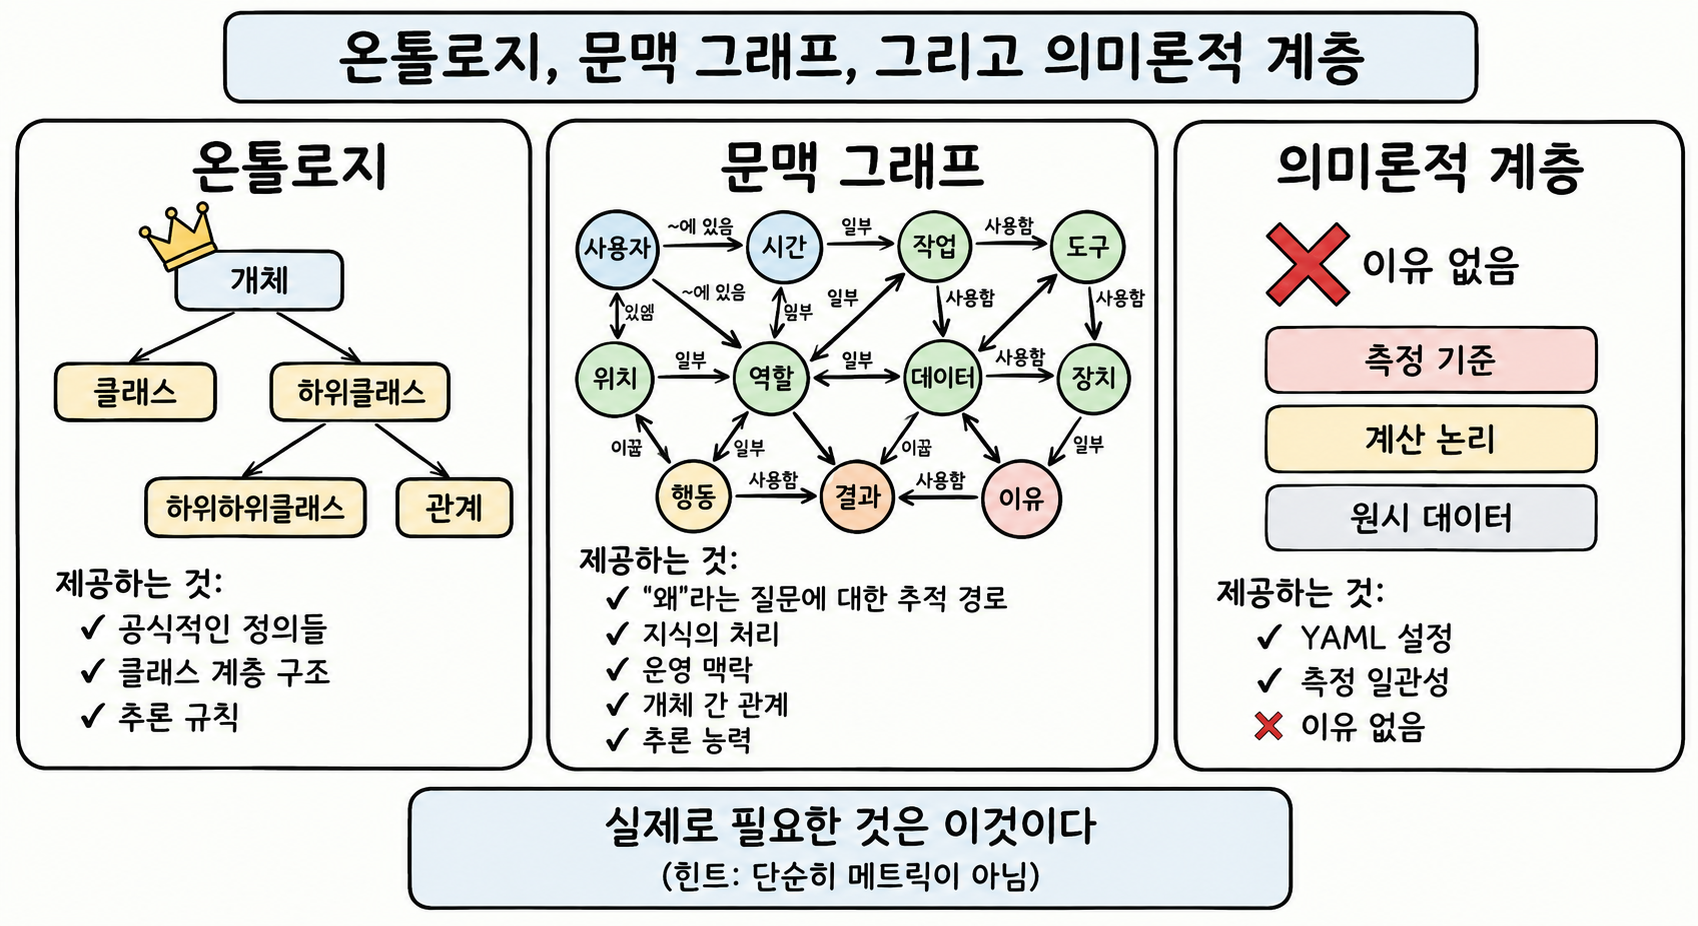
핵심 논지: 기업의 시맨틱 레이어는 지표를 일관되게 계산하도록 만들었지만, AI가 업무를 판단하려면 개념의 의미, 관계, 제약, 절차, 예외 승인 이유까지 표현할 수 있는 지식 아키텍처가 필요하다는 글입니다. 다만 이는 시맨틱 레이어가 무용하다는 실증 결과가 아니라, 업무 유형에 따라 계산 계층과 지식 계층의 역할을 구분하자는 아키텍처적 주장으로 읽는 편이 정확합니다.
아래에서는 광고·추천 글·댓글을 제외하고, 본문의 전개 순서에 따라 인접 단락을 묶어 해설합니다. 원문 주장과 분석·유의점을 구분했습니다.
1. 도입: “측정”과 “의미”가 갈라진 역사
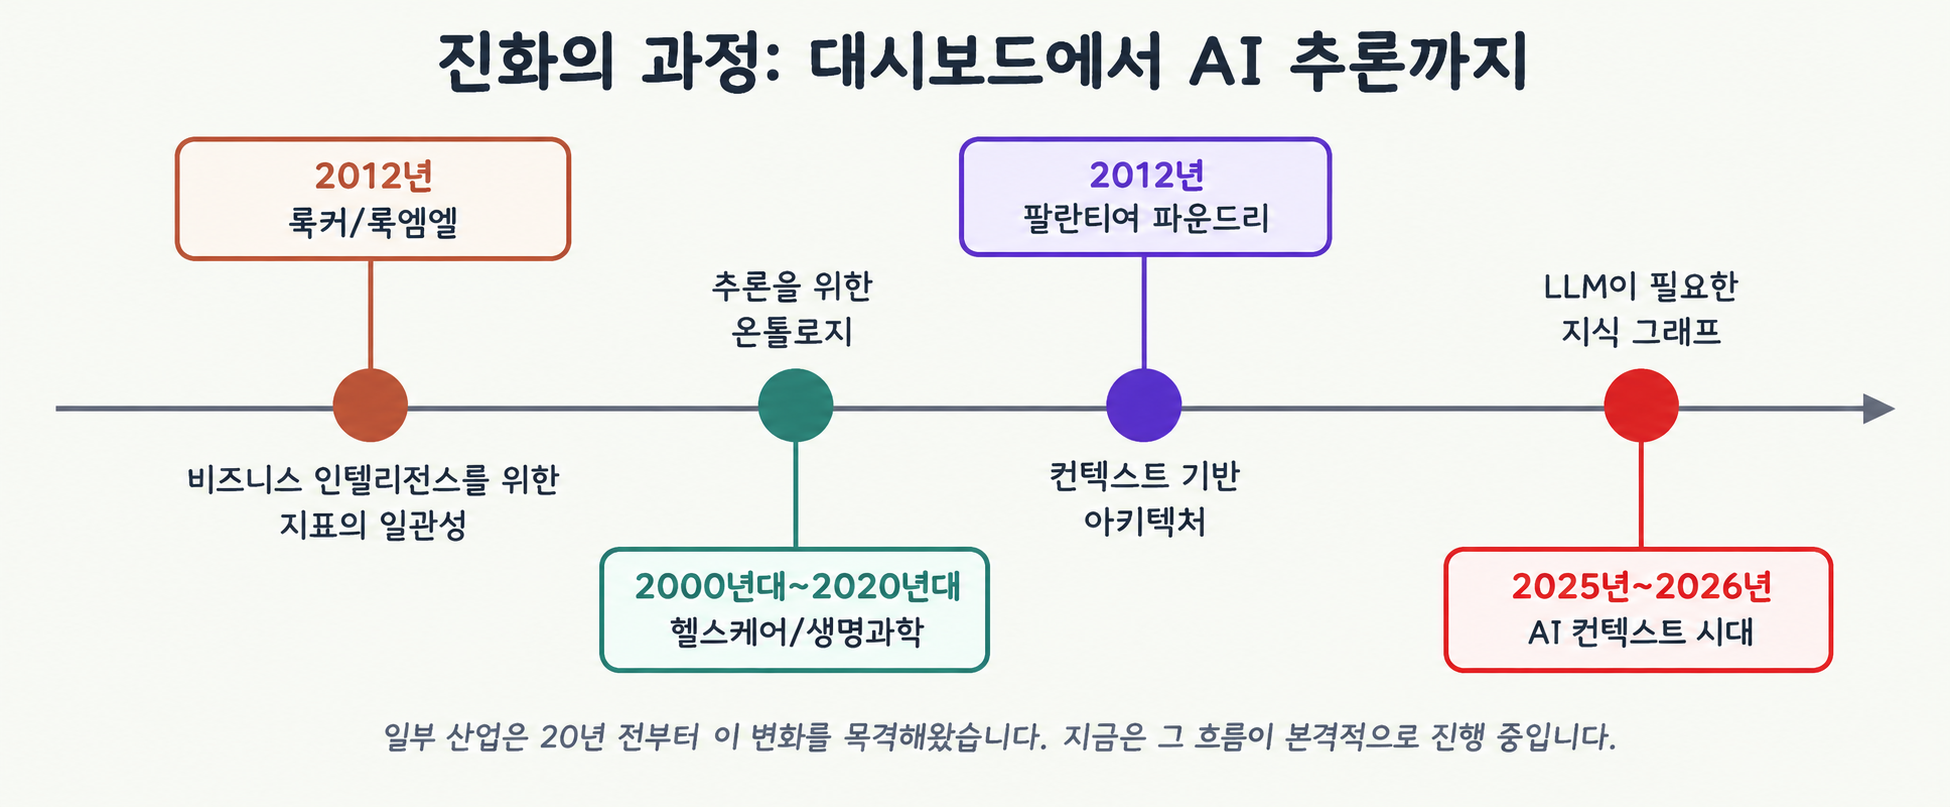
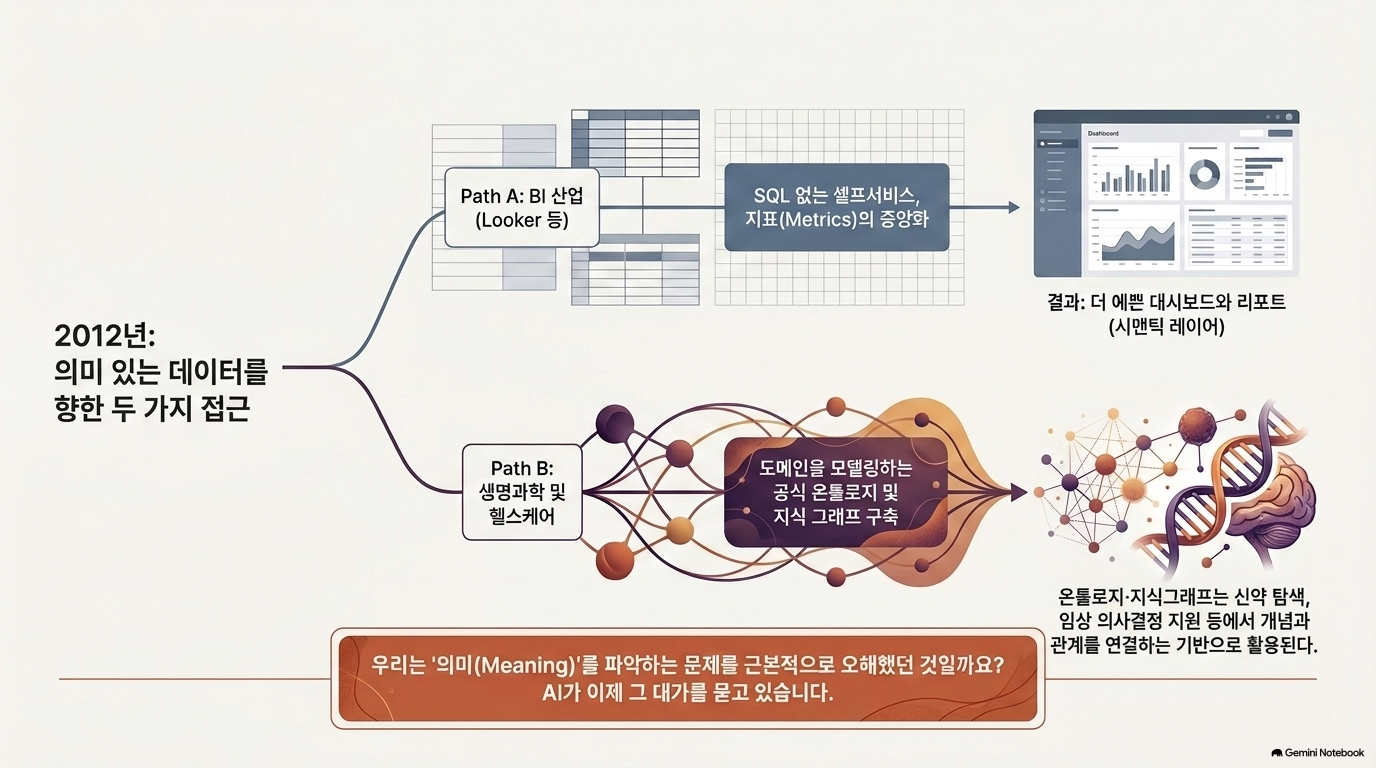
① LookML과 온톨로지의 동시대적 출발. 저자는 2012년 무렵 Looker의 LookML과 생명과학·의료 분야의 온톨로지·지식그래프 개발을 병치합니다. 양쪽 모두 “데이터에 의미를 부여한다”고 했지만 해결하려던 문제는 달랐습니다. 전자는 여러 분석가가 같은 매출 지표를 계산하게 하는 문제, 후자는 서로 다른 용어·개체·관계를 연결하는 문제입니다.
② 대시보드와 의사결정 지원의 대비. 저자는 한쪽은 보고서를, 다른 쪽은 신약 탐색·임상 의사결정·정보 분석을 가능하게 했다고 강조합니다. 이는 독자의 주의를 끄는 효과적인 대비이지만, 기술별 성과를 통제된 조건에서 비교한 결과는 아닙니다. 의료 의사결정 시스템의 효용을 온톨로지 하나에 귀속할 수는 없습니다.
③ 도입의 질문. “우리는 문제를 잘못 이해했는가?”라는 물음이 글 전체를 이끕니다. 저자의 대답은 “지표 계산의 표준화를 의미 이해의 완성으로 착각했다”입니다. 이후 각 절은 이 주장을 개념 정의→운영 맥락→AI 요구→실무 선택의 순서로 전개합니다.
2. What we thought Semantic Layers would solve — 시맨틱 레이어가 해결한 것과 남긴 것
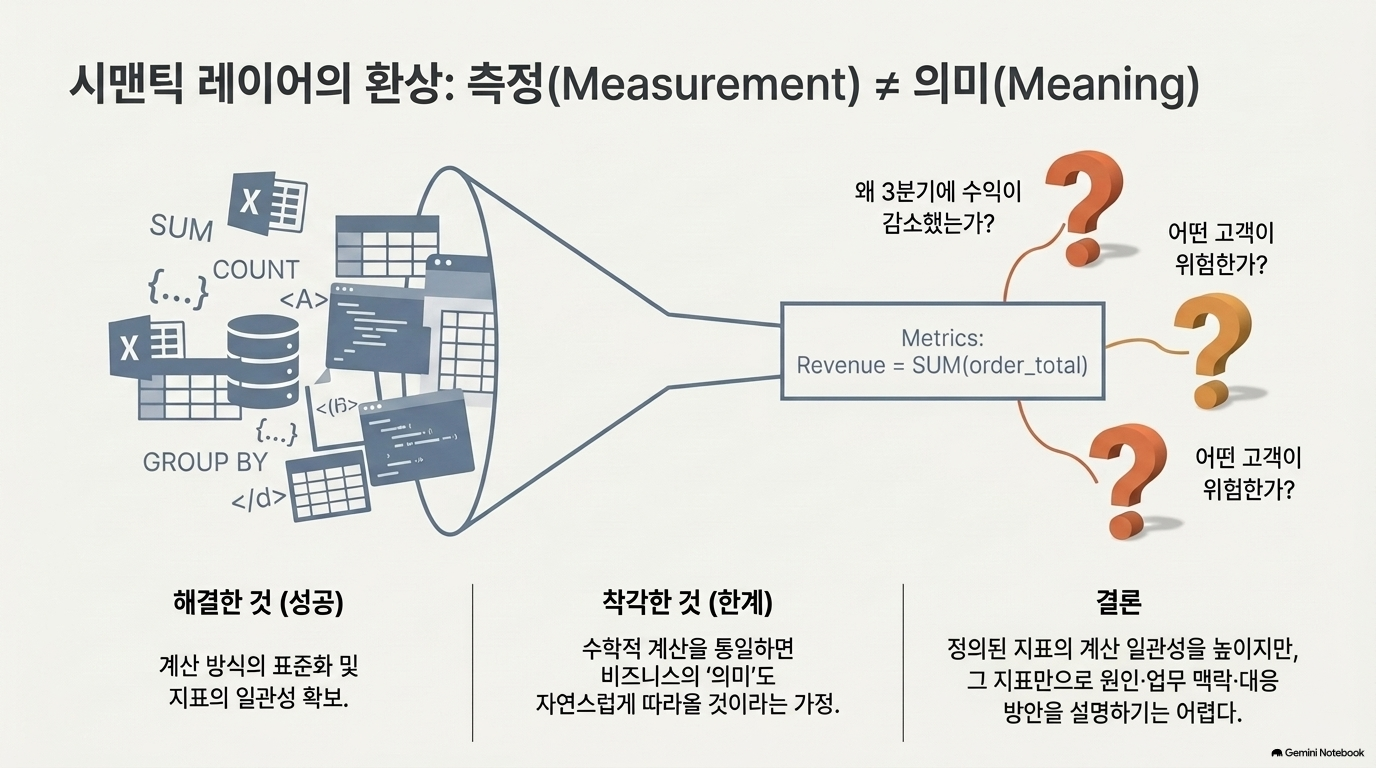
① 문제의 출발점. 부서마다 ‘매출’을 다르게 계산하고 데이터 준비에 시간을 쓰며 대시보드 수치를 신뢰하기 어려웠다는 설명입니다. 여기서 문제의 단위는 지표 정의의 불일치입니다.
② 처방. LookML 같은 계층에 지표 정의를 한 번 만들고, SQL을 직접 작성하지 않는 이용자도 이를 재사용하게 합니다. 예를 들어 완료 주문 금액의 합이라는 계산을 중앙에서 관리하면 대시보드별 수치 불일치를 줄일 수 있습니다.
③ 성과 인정. 저자는 시맨틱 레이어가 원래 약속한 지표 일관성에는 유효했다고 명시합니다. 따라서 이 글을 “BI·시맨틱 레이어 폐기론”으로 읽으면 저자의 인정 부분을 놓칩니다.
④ 숨은 가정에 대한 비판. 계산식을 표준화하면 데이터의 의미까지 확보된다고 여긴 것이 문제라는 주장입니다. 같은 revenue 수치를 알고 있어도 매출 하락의 원인, 위험 고객, 허용 가능한 대응책을 알 수는 없습니다.
⑤ 이 절의 결론. SUM(order_total) WHERE order_status='completed'는 어떻게 셀지를 규정하지만, 무엇이 일어났고 왜 그랬으며 무엇을 할 수 있는지까지 규정하지 않습니다. 다만 ‘왜 매출이 하락했는가’는 온톨로지 자체만으로도 답하기 어렵습니다. 원인 분석에는 시간별 관측값, 외부 요인, 가설 검증이나 인과분석이 추가로 필요합니다.
3. What Ontologies actually are — 온톨로지의 역할
① 분야별 요구. 생명과학은 연구마다 다른 어휘를 통합해야 하고, 의료는 환자 데이터와 의학 지식을 함께 해석해야 했다는 설명입니다. 지표 집계보다 개념 식별과 관계 해석이 우선하는 사례입니다.
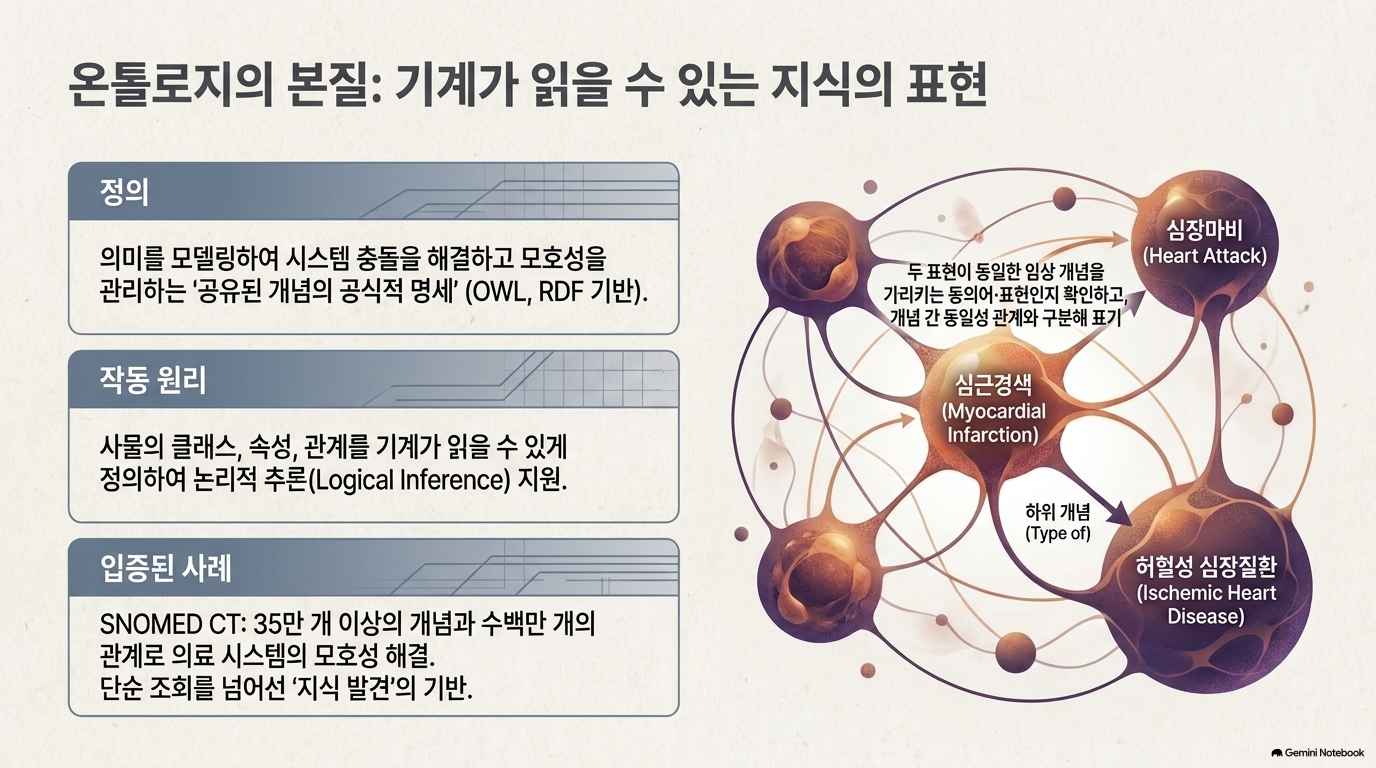
② 정의. 저자는 온톨로지를 공유된 개념화의 형식적·명시적 명세로 제시합니다. 즉 ‘고객’, ‘주문’, ‘질병’ 같은 클래스, 그 사이의 관계·속성, 관계에 부여한 논리적 제약을 기계가 처리할 수 있게 정의하는 작업입니다. RDF는 표현 기반, OWL은 형식적 의미와 추론, SKOS는 개념 체계·용어 관계를 다루는 데 쓰입니다. 셋을 동일한 종류의 언어로 취급해서는 안 됩니다.
③ Gene Ontology 사례. 유전자가 참여하는 생물학적 과정·분자 기능·세포 구성요소를 표현한다는 예입니다. 요점은 “유전자 수”라는 지표 자체보다 어떤 생물학적 개념의 범주 안에서 셀 것인지를 정의한다는 데 있습니다.
④ SNOMED CT 사례. 임상 개념과 동의어, 상위·하위 개념 및 관련 관계를 활용해 기록 간 의미를 맞추는 예입니다. 용어를 같게 쓰는 것뿐 아니라 서로 다른 표현이 가리키는 임상 개념을 연결하는 데 가치가 있습니다.
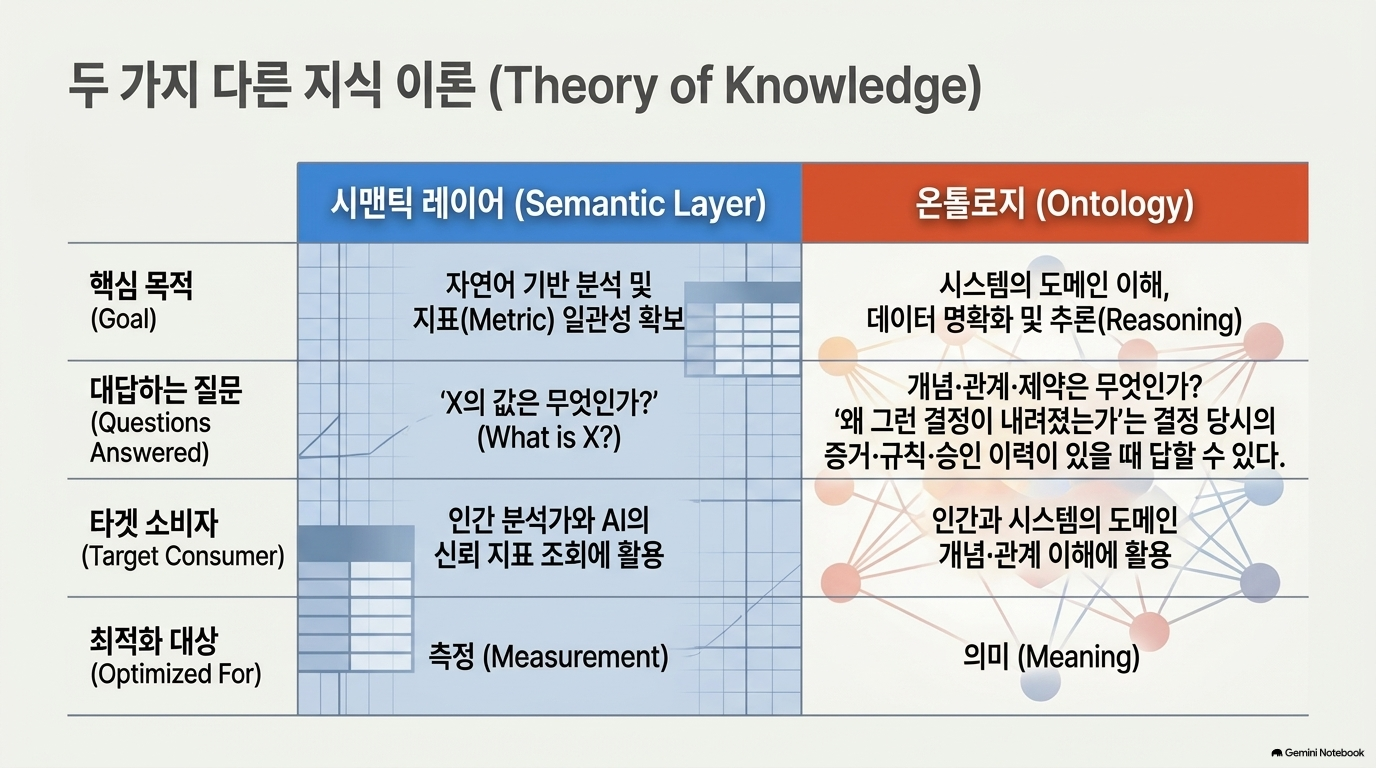
⑤ 두 계층의 대비. 저자의 구분은 다음과 같습니다.
| 구분 | 시맨틱 레이어 | 온톨로지 |
| 중심 질문 | “얼마인가, 몇 건인가?” | “무엇이며 무엇과 어떻게 관련되는가?” |
| 대표 자산 | 지표·측정값·차원·집계 규칙 | 개념·분류·관계·제약·공리 |
| 주된 용도 | 일관된 분석·보고 | 의미 해석·연계·일부 논리 추론 |
| 주의점 | 업무 맥락 전체를 담지는 않음 | 개념 모델만으로 사건의 원인이나 적법성이 입증되지는 않음 |
⑥ 이 절의 함의. 저자는 둘을 기술 수준의 상하관계가 아니라 목적이 다른 설계로 봅니다. 이는 설득력 있습니다. 다만 “시맨틱 레이어는 자연어 라벨만 정규화한다”는 식의 표현은 지나치게 좁습니다. 실제 시맨틱 모델도 엔터티, 차원, 조인 경로, 지표 정의 등 의미 있는 업무 규칙을 담을 수 있습니다. 논점은 담을 수 있는 의미의 범위와 형식적 추론 수준입니다.
4. What Palantir saw that we didn’t — 운영 의사결정 중심 설계
① 대비의 전환. 저자는 Palantir Foundry를 ‘metrics-first’가 아닌 ‘context-first’ 설계의 사례로 듭니다. 정보 분석·공급망·금융범죄 탐지에서는 집계 수치보다 개체 관계와 가능한 조치가 중요하다는 설명입니다.
② AI 시대의 재평가. 과거에는 과도한 설계로 보였을 수 있으나, 에이전트가 업무 객체를 이해하고 조치해야 하는 상황에서는 선견지명처럼 보인다는 해석입니다.
③ 확인 가능한 범위. Palantir 공식 문서는 Ontology에 객체·속성·링크뿐 아니라 actions, functions, dynamic security 같은 운영 요소가 포함된다고 설명합니다. 따라서 저자의 ‘운영 계층’ 해석은 문서와 부합합니다. 그러나 “Palantir가 처음부터 모든 예외 판단의 이유를 포착했다”거나 “다른 방식보다 우수하다”는 결론까지 이 자료만으로 입증되지는 않습니다.
5. What Context Graphs actually capture — 결정의 ‘왜’를 기록한다는 것
① 개념의 확대. 저자는 Palantir의 독점적 온톨로지 기반 환경을 일종의 context graph로 해석합니다. 이는 저자의 개념적 분류이지, 모든 맥락그래프가 Palantir 방식이라는 뜻은 아닙니다.
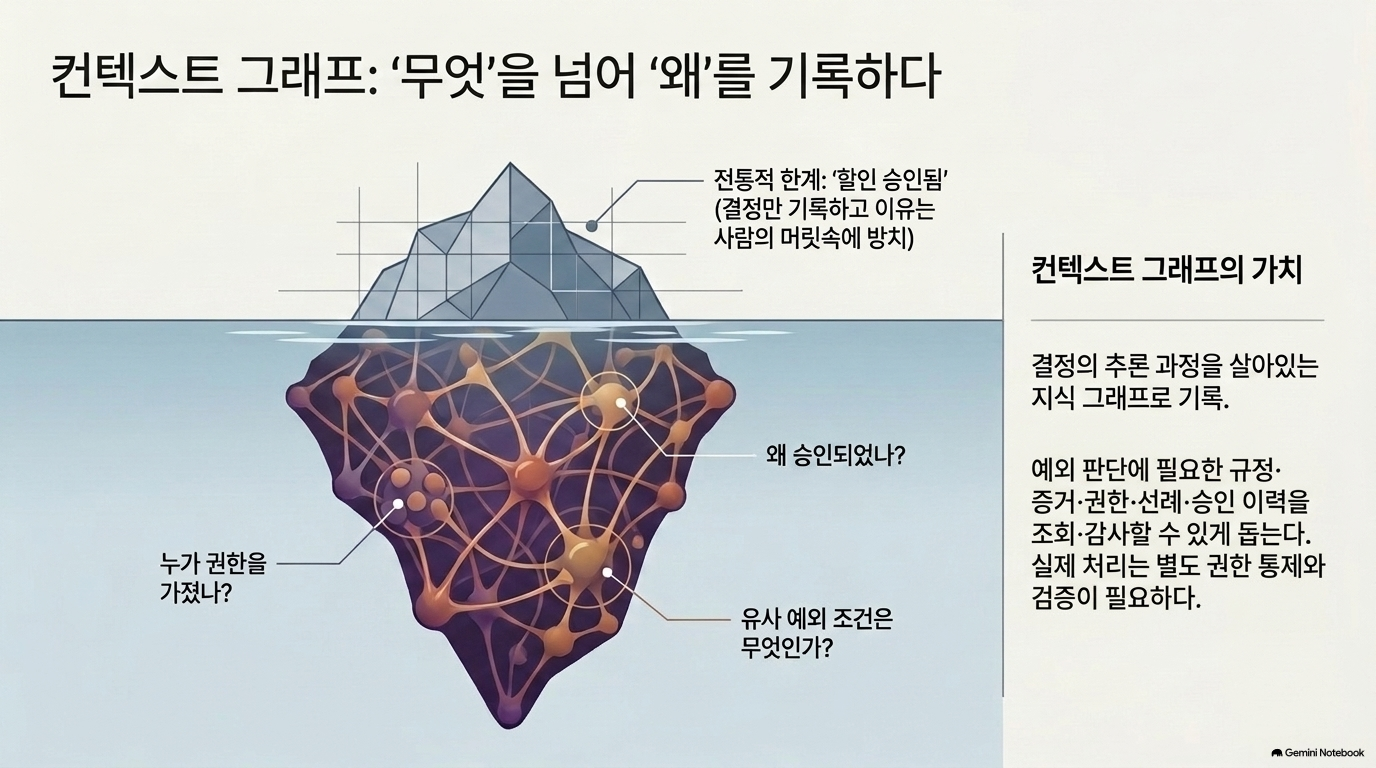
② 핵심 사례. 할인 한도를 넘는 승인이나 작업 절차 변경이 시스템에는 ‘결과’로 남지만, 승인 근거는 담당자의 머릿속·메시지·이메일에 흩어지는 문제를 제시합니다. 맥락그래프가 겨냥하는 정보는 다음과 같습니다.
결정/행위 → 적용 규정 → 예외 사유 → 승인 권한자 → 검토한 증거 → 선례 → 조건 → 결과
③ 지식그래프와의 관계. 고객이 주문했다는 관계도 지식그래프이고, 그 주문의 예외 승인 이유와 권한을 연결한 것 역시 지식그래프입니다. 따라서 맥락그래프는 지식그래프와 배타적인 기술이 아니라, 결정 근거·절차·시점·출처를 중점적으로 담는 사용 형태로 이해하는 편이 명료합니다.
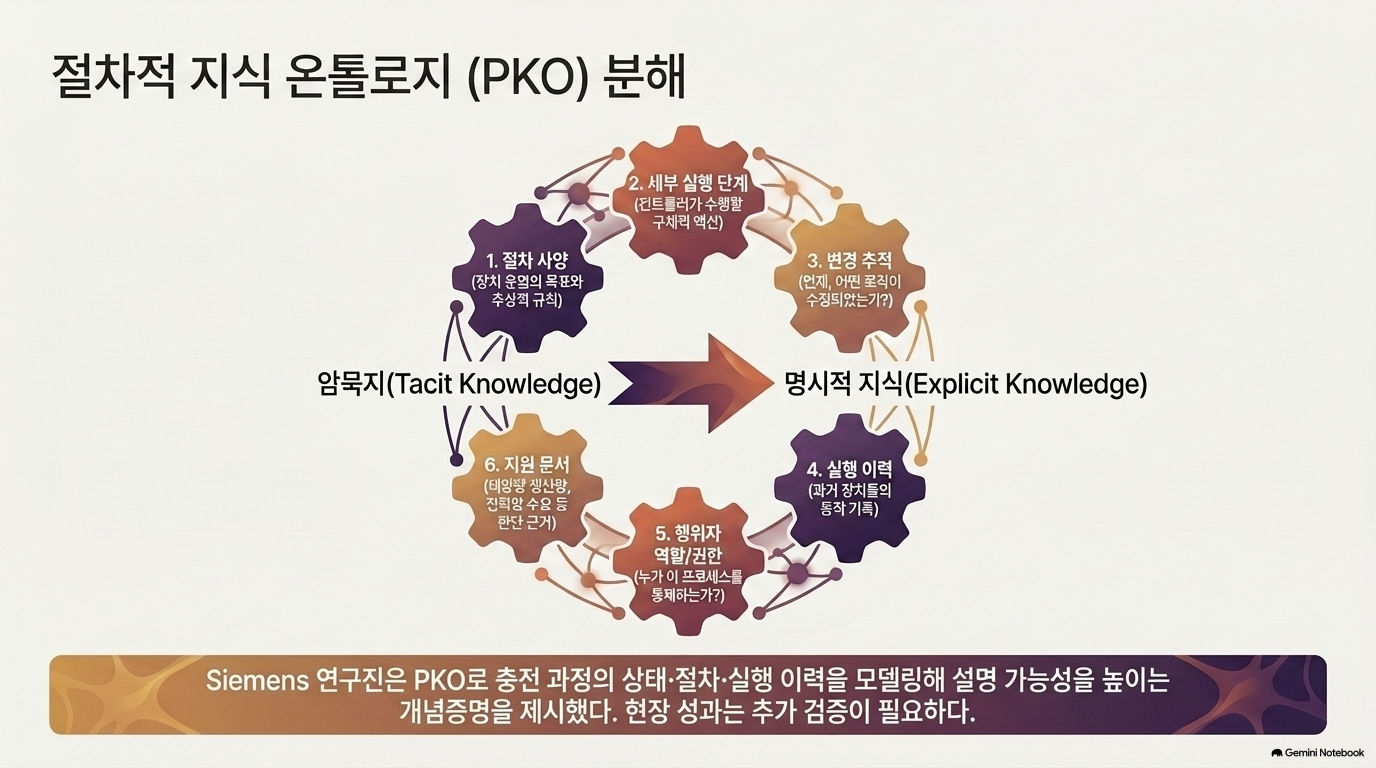
④ PKO의 역할. 저자가 소개하는 Procedural Knowledge Ontology는 절차 명세와 특정 시점의 절차 실행을 구분합니다. ‘정전 안전조치 절차’는 일반 규칙이고, ‘어느 기술자가 어느 날 어떤 조건에서 수행한 기록’은 실행 사례입니다. PKO 논문도 이 분리를 핵심으로 제시합니다.
⑤ 산업 사례의 증거 수준. 원문은 Siemens의 마이크로그리드 적용을 성공적으로 입증된 운영 사례처럼 서술합니다. 그러나 해당 Siemens 연구자의 발표 논문은 구현이 예비 단계의 개념증명(proof of concept)이라고 명시합니다. [보완 필요: 성과 근거] 충전 최적화, 이용자 설명력, 운영 효율 개선이 실제 현장에서 어느 정도 달성됐는지는 별도 평가자료가 필요합니다.
⑥ 진짜 병목. 저자의 가장 실무적인 지적은 기술보다 암묵지 수집입니다. 전문가 면담, 업무 관찰, 예외 판단의 문서화, 변경 이력 관리가 없다면 그래프 저장소만 구축해도 ‘왜’를 답할 수 없습니다. 특히 사후에 생성형 AI가 승인 사유를 추정해 채우는 것은 당시 실제 판단 근거의 기록과 다릅니다.
6. The YAML problem — 파일 형식이 아니라 표현 범위의 문제
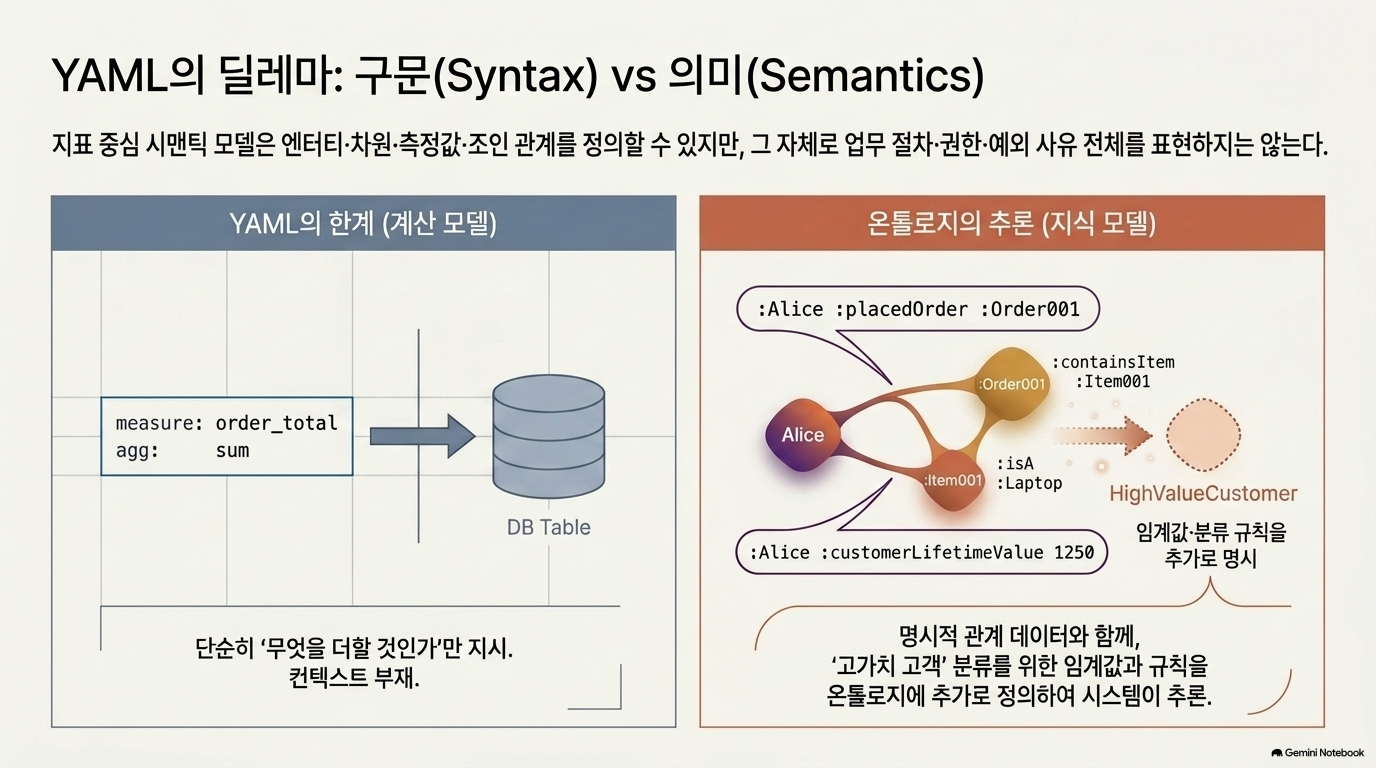
① 비판의 대상. 저자는 dbt MetricFlow의 YAML 시맨틱 모델을 들며 측정값·집계·엔터티 설정을 업무 의미의 전체 모델로 간주해서는 안 된다고 주장합니다. 예시 YAML은 주문의 집계 시점, 기본키, 합계 측정값을 기술합니다.
② 코드 비교가 보여 주는 것. 반대편 예시는 Alice → 주문 → 상품 등의 RDF식 관계와, 고가치 고객 분류·역관계 등 추론 결과를 놓습니다. 저자가 말하려는 차이는 SQL 생성에 필요한 메타데이터와 개념·관계에 관한 논리적 진술입니다.
③ 중요한 기술적 유의점. 원문의 INFERRED 예시는 앞에 보인 EXPLICIT 삼중항만으로 자동 도출되지 않습니다. 예를 들어:
- HighValueCustomer가 되려면 고객 생애가치의 임계값과 분류 규칙이 필요합니다.
- orderedBy에는 placedOrder의 역속성 선언이 필요합니다.
- purchased에는 관계를 잇는 속성 연쇄 규칙이 필요합니다.
- frequentlyBoughtWith Mouse에는 실제 상품 간 근거 관계가 먼저 있어야 합니다. 대칭 속성 선언만으로 구매 동반 사실이 새로 생기지는 않습니다.
- knowsCustomer Carol 역시 연결 경로와 전이성 선언이 필요하며, 현실의 ‘알고 지낸다’ 관계에 전이성을 부여하는 것이 타당한지도 따져야 합니다.
따라서 예시는 “온톨로지에 적절한 공리를 추가하면 가능한 추론의 유형”을 보여 줄 뿐, 제시된 데이터만으로 재현되는 실행 결과는 아닙니다. OWL의 클래스·속성·공리 체계는 W3C OWL 2 명세에서 확인할 수 있습니다.
④ 저자의 결론과 보정. 지표 정의와 온톨로지 공학은 다른 전문성이라는 결론은 타당합니다. 다만 YAML이라는 파일 형식 자체가 의미 표현을 막는 것은 아닙니다. 같은 YAML이라도 무엇을 모델링하고 어떤 해석·검증·추론 엔진에 연결하느냐가 중요합니다. 더 정확한 비판은 “일반적인 지표 중심 시맨틱 모델의 표현 범위가 업무 지식 전체에는 부족하다”입니다.
7. Why AI changes everything — AI가 추가로 요구하는 맥락
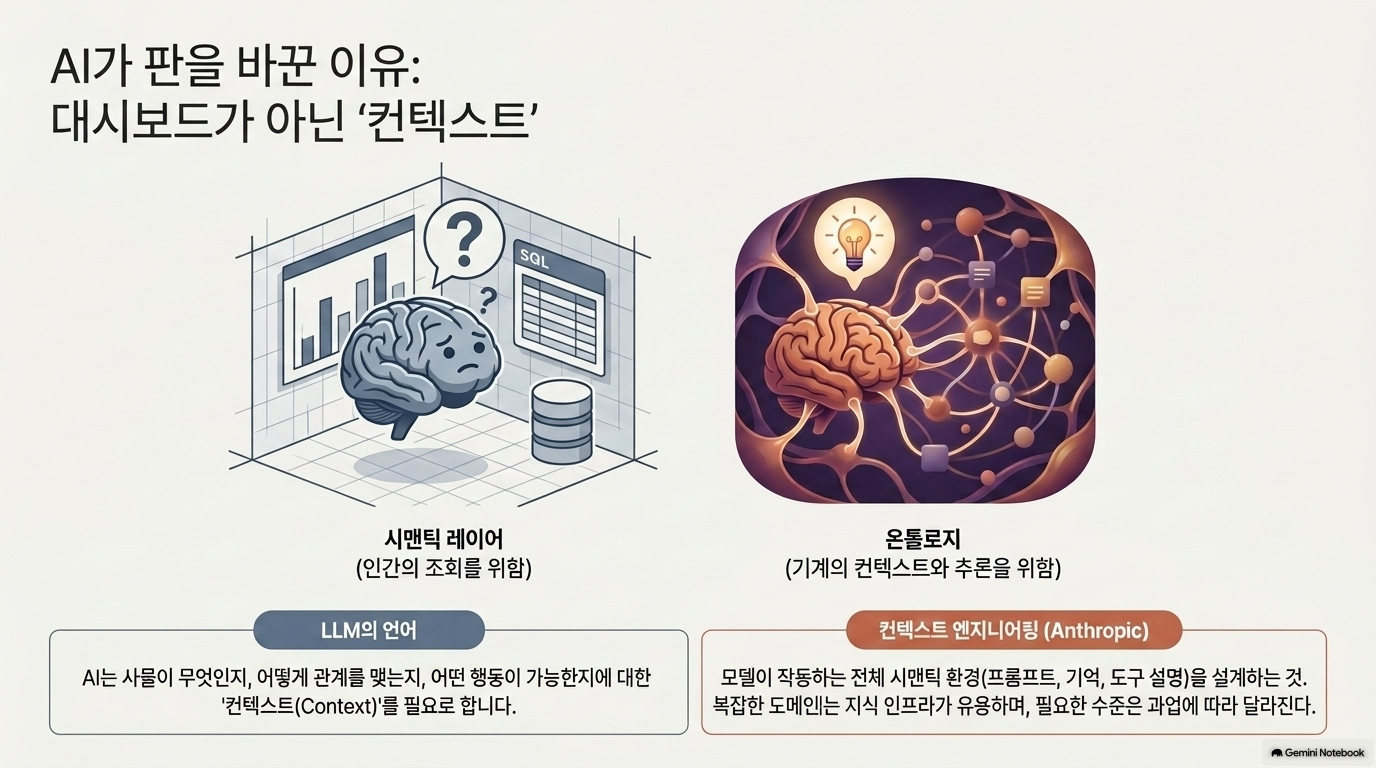
① 산업적 계기. 저자는 MetricFlow 오픈소스화와 ‘AI와 구조화 데이터의 연결’이라는 dbt Labs의 설명을 계기로 듭니다. 이에 대한 저자의 판단은 “신뢰할 수 있는 지표는 필요하지만, 그것만으로 충분하지 않다”입니다.
② 에이전트의 질문 변화. 대시보드 이용자는 “지난달 매출은?”을 묻지만, 업무 에이전트는 “이 고객에게 할인 예외를 적용해도 되는가?”, “누가 승인해야 하는가?”처럼 개체, 규칙, 권한, 현재 상태와 조치 가능성을 함께 요구합니다.
③ ‘컨텍스트 엔지니어링’과 온톨로지의 관계. 저자가 인용하는 Anthropic의 컨텍스트 엔지니어링 설명은 모델에 필요한 정보와 도구를 적절한 형식으로 제공하는 설계 실무를 가리킵니다. 온톨로지·지식그래프는 그 맥락의 공급원 중 하나이지, 프롬프트·메모리·도구 설명·최신 거래 데이터 전체를 대체하지는 않습니다.
④ 평가. “LLM에는 대시보드가 아니라 의미가 필요하다”는 수사보다 정확한 문장은 LLM의 업무 수행에는 검증된 수치와 그 수치가 가리키는 대상·관계·규칙·출처가 함께 필요하다입니다. 온톨로지가 존재해도 그래프에 잘못된 사실을 넣거나 최신성이 떨어지면 판단 품질은 개선되지 않습니다.
8. The real architectural difference — 아키텍처 비교
① 시맨틱 레이어의 강점. 지표 정의, 차원 분석, SQL 추상화, 보고 도구 간 일관성을 제공합니다. “정의된 범위의 수치를 일관되게 답하는가?”가 핵심 검증 질문입니다.
② 온톨로지·지식그래프의 강점. 개념 분류, 명시적 관계, 논리적 제약, 표준 형식 기반 연계와 일부 추론을 제공합니다. “이 개체는 무엇이며 어떤 규칙·관계가 적용되는가?”가 핵심 질문입니다.
③ 유의할 구분. 온톨로지는 개념과 규칙을 기술하고, 지식그래프는 그 개념에 따른 개체·사실·관계의 연결까지 포함하는 방식으로 구분하면 이해하기 쉽습니다. 실제 구현에서는 둘이 중첩됩니다. 또한 저자가 온톨로지를 ‘뉴로심볼릭 AI의 한 형태’라고 부른 대목은 넓은 표현입니다. 온톨로지 자체는 상징적 지식표현이며, 신경망 모델과 결합해 사용할 때 뉴로심볼릭 시스템이라고 부르는 편이 엄밀합니다.
④ 설계상의 결론. 선택지는 양자택일이 아닙니다. 정의된 지표 계산 → 관련 업무 개체 연결 → 적용 규칙·절차 조회 → 최신 사건·증거 확인 → 권한 내 조치처럼 계층을 결합할 수 있습니다. 어느 계층까지 필요한지는 질문의 종류와 잘못된 답의 비용으로 결정해야 합니다.
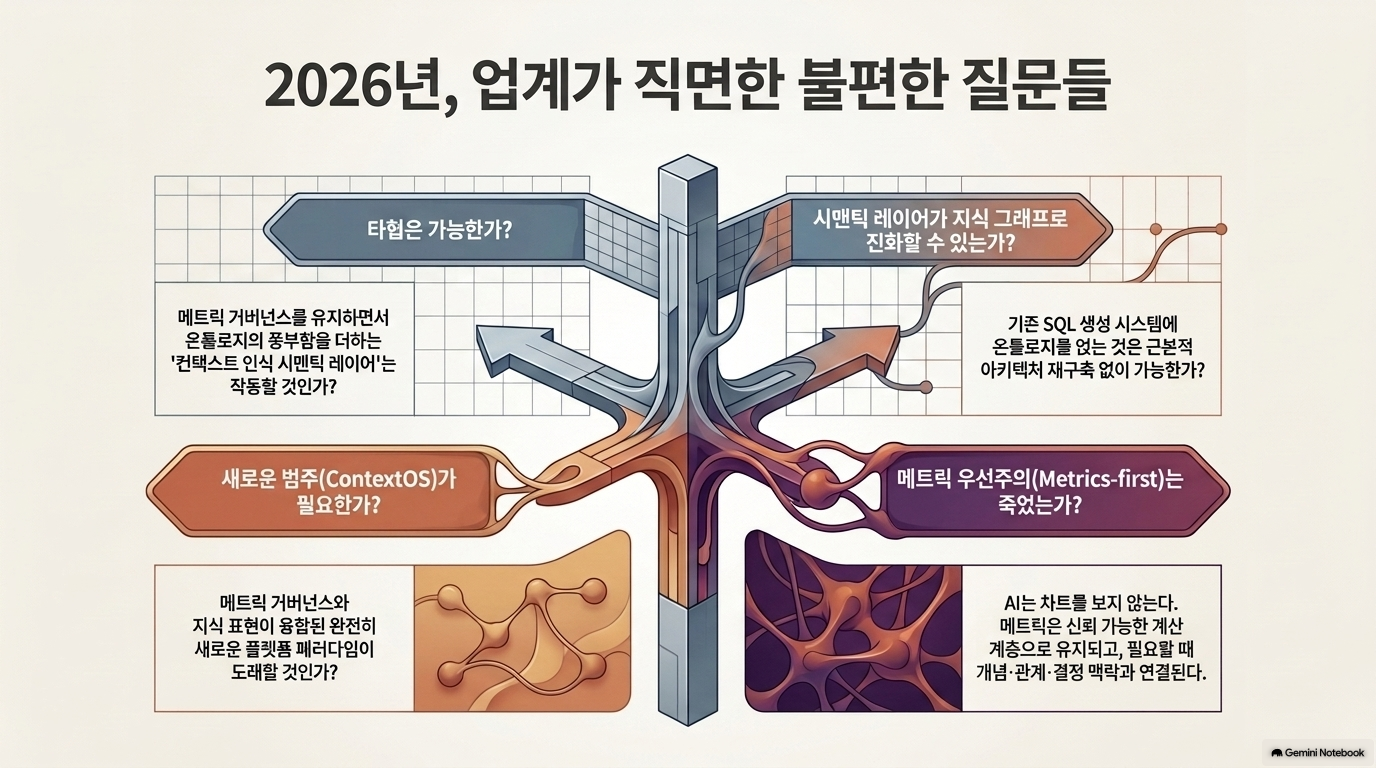
9. The hard questions for 2026 — 저자가 제기하는 미해결 과제
① 맥락 인식형 시맨틱 레이어가 가능한가? 지표 거버넌스를 유지하면서 개념·관계를 덧붙이는 중간 지대를 묻습니다. 가능성은 열려 있지만, 표준 교환 형식이 곧 동일한 의미 해석이나 추론 능력을 보장하지는 않습니다.
② 기존 레이어를 지식그래프로 확장할 수 있는가? 이미 정의된 지표·엔터티를 출발점으로 삼을 수 있습니다. 그러나 클래스 계층, 업무 관계, 제약, 출처, 이력, 예외 판단을 추가하는 순간 새로운 모델링·운영 책임이 발생한다는 것이 저자의 우려입니다.
③ ‘ContextOS’라는 새 범주가 필요한가? 저자는 이름보다 구현 난도를 강조합니다. 실제로는 지식 모델 외에도 권한, 시간에 따른 상태 변화, 승인 워크플로, 증거 보존, 조회 성능을 설계해야 합니다.
④ dbt와 metrics-first의 미래. 저자는 지표가 사라진다고 확정하지 않고, 더 풍부한 지식 아키텍처의 입력으로 재배치되는가를 묻습니다. 이 질문이 글의 결론보다 실무적으로 중요합니다. 계산이 필요한 업무에서는 지표 거버넌스가 여전히 필수입니다.
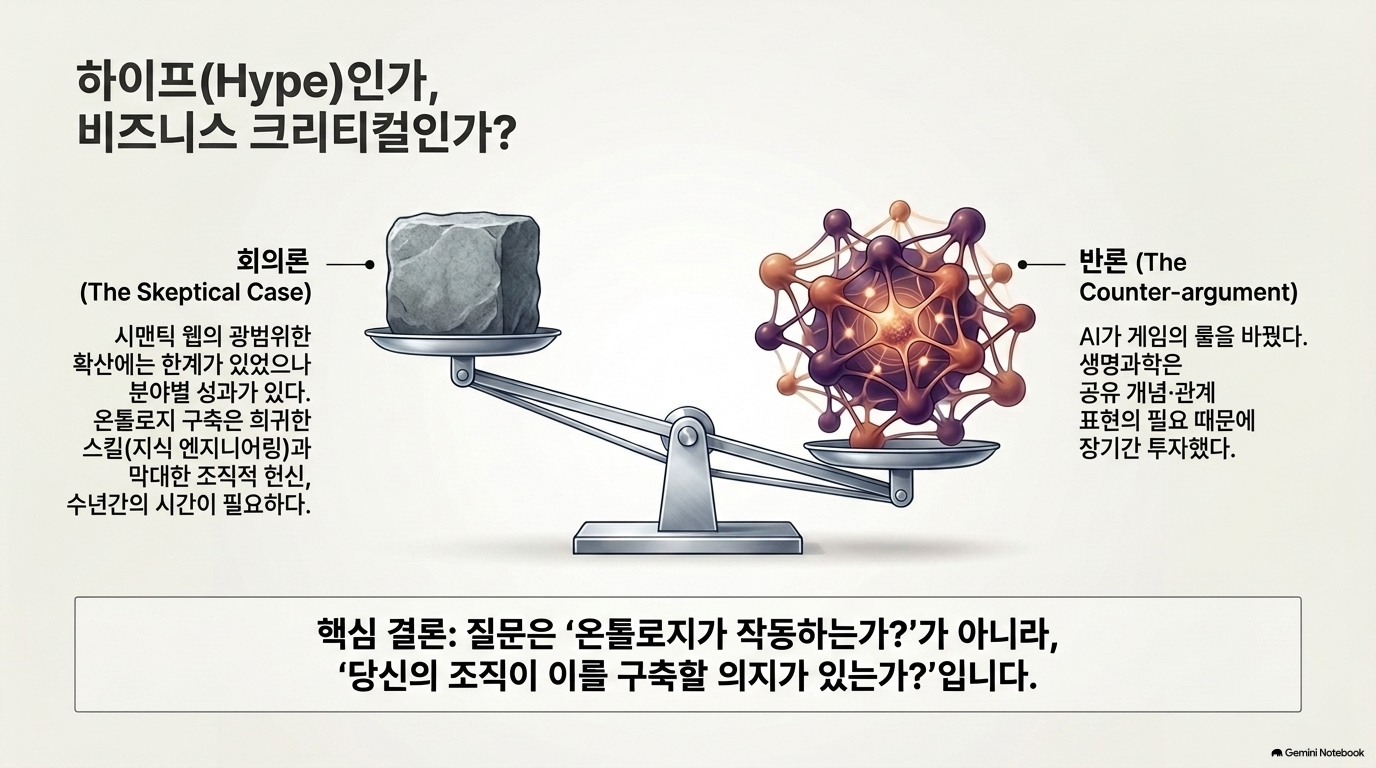
10. But haven’t we heard this before? — 온톨로지 회의론
① 회의론을 스스로 제기. 시맨틱 웹과 지식그래프가 과거에도 큰 약속을 했지만, 구축 난도·전문 인력·지속적 관리 비용 때문에 조직 내 확산이 쉽지 않았다고 인정합니다.
② 저자의 반론. 의료·생명과학에서는 형식적 지식표현의 효용이 누적됐고, AI가 다른 산업에서도 그 필요성을 높인다는 주장입니다.
③ 평가. “AI가 등장했으므로 모든 기업에 온톨로지가 필요하다”는 일반화는 아직 입증되지 않았습니다. [확인 필요: 적용 범위] 단순 지표 질의, 정해진 문서 검색, 복잡한 예외 심사 사이에는 요구되는 지식표현의 깊이가 다릅니다. 도입 여부는 범용 유행이 아니라 업무별 성능·설명가능성·유지관리 비용 비교로 결정해야 합니다.
11. What this means, practically — 실무 권고
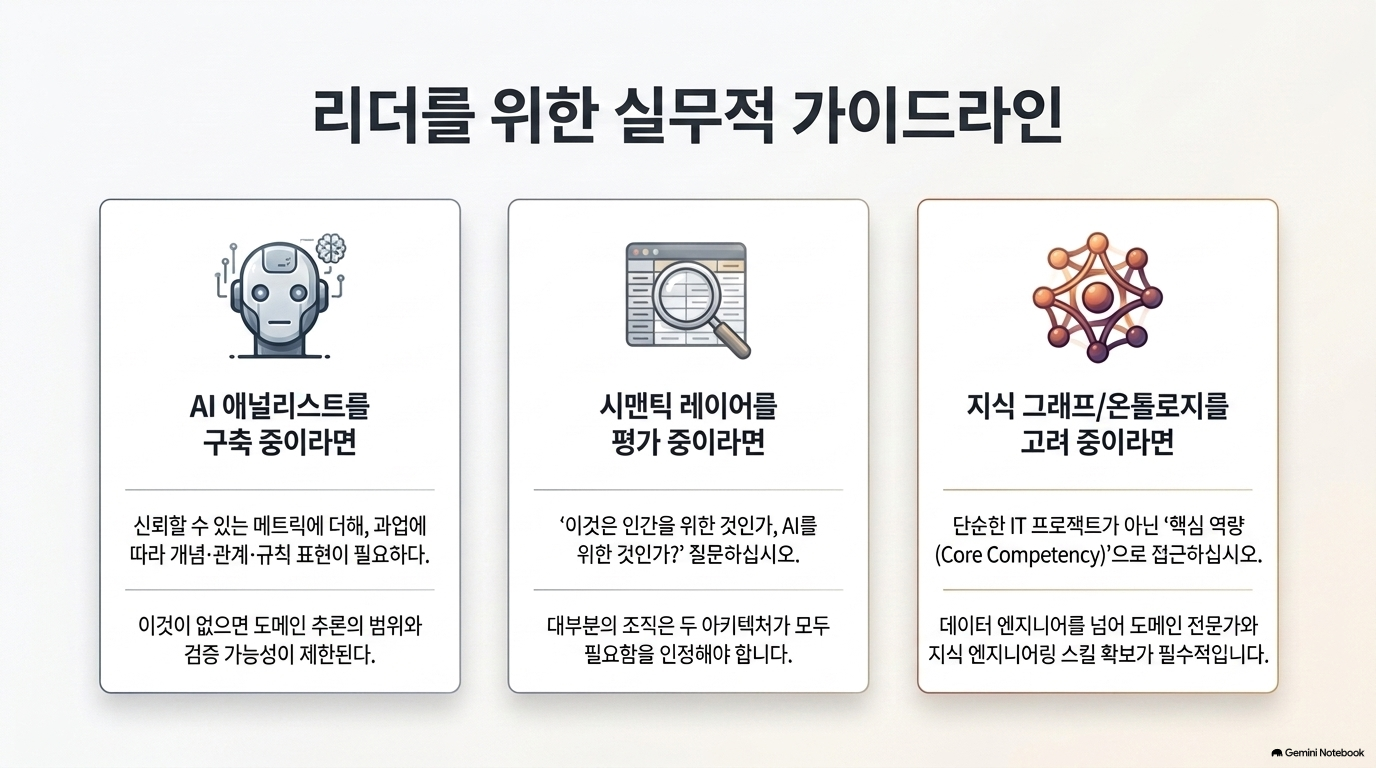
① AI 분석가를 만든다면. 숫자를 답하는 기능과 개념·관계·업무 규칙을 해석하는 기능을 구분하라고 권합니다. 예컨대 ‘이탈 위험 고객 수’는 지표 정의가 중요하지만, ‘이 고객에게 적용 가능한 유지 제안’에는 계약·권한·동의·예외 규칙이 필요합니다.
② 제품을 평가한다면. “사람용인가 AI용인가?”라는 저자의 질문은 유용하지만, 실제 구매·설계 기준은 더 세분해야 합니다. ① 정확한 계산 ② 개체 식별 ③ 관계·규칙 조회 ④ 출처와 시점 ⑤ 권한 있는 행동 ⑥ 판단 감사추적을 각각 시연받아야 합니다.
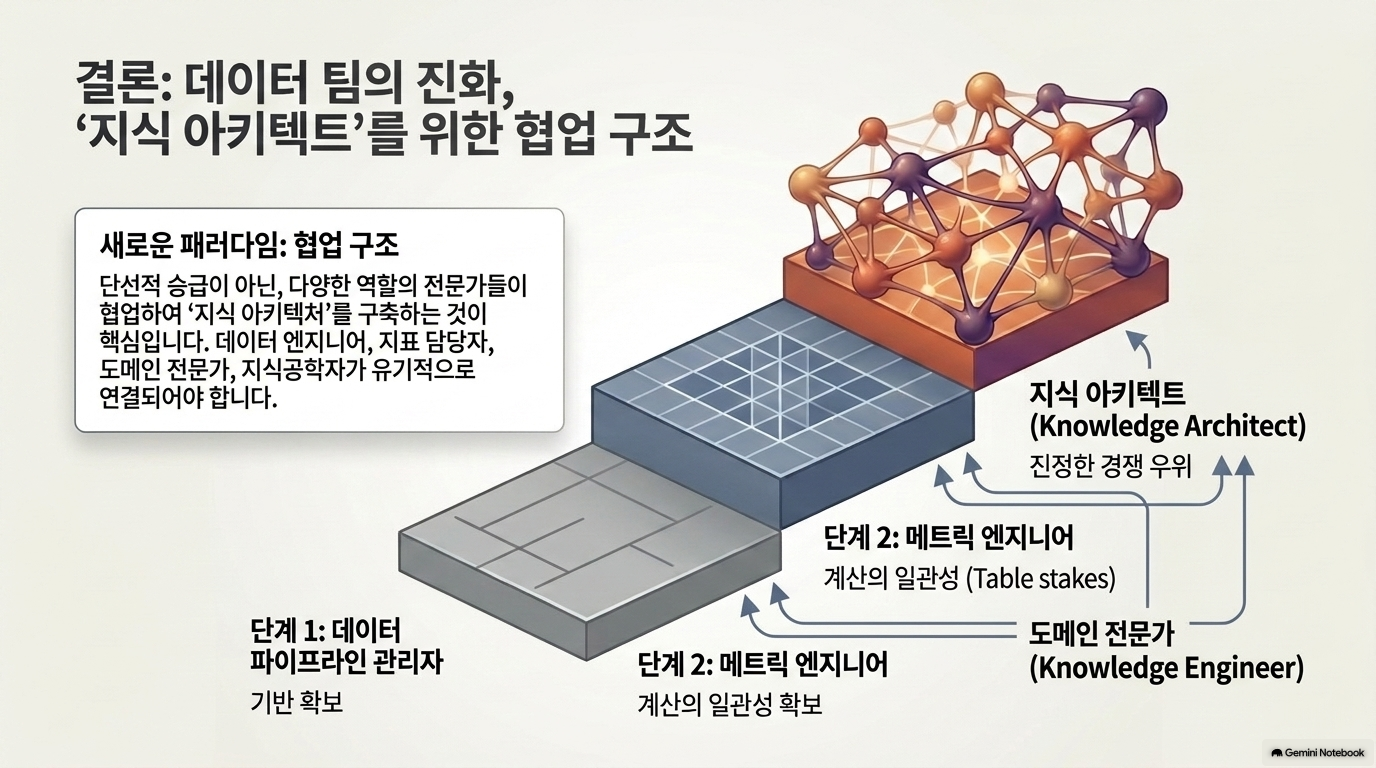
③ 온톨로지를 구축한다면. 저자는 이를 도구 도입이 아니라 도메인 전문가와 지식공학자가 함께 수행하는 지속적 관리 업무로 취급하라고 합니다. 한 번 만든 분류체계가 제도·상품·업무 절차의 변경을 자동 반영하지는 않습니다.
④ ‘승자’에 대한 주장. 의미를 모델링하는 조직이 우위를 점한다는 전망은 글의 전략적 주장입니다. 성과 예측으로 받아들이기보다, 우선 범위가 작은 고위험 업무에서 오답 감소·설명 가능성·업데이트 비용을 측정하는 가설로 다루는 것이 안전합니다.
12. Where do we go from here? — 최종 결론
① 이분법의 해소. 저자는 끝에서 시맨틱 레이어 대 온톨로지라는 구도 자체가 협소하다고 인정합니다. 지표 조회·기본 분석에는 기존 계층이 충분할 수 있고, 복잡한 추론·업무 판단에는 더 풍부한 표현이 필요하다는 과업별 선택론으로 귀결됩니다.
② “지식 아키텍처 문제”라는 결론. AI용 데이터 기반은 테이블 위에 설명문을 더하는 일만이 아니라, 개념·관계·제약·추론 규칙을 정의하고 실제 사건·결정의 근거를 유지하는 일이라는 뜻입니다. 저자가 사서·분류학자·지식공학자의 전문성을 강조하는 이유도 여기에 있습니다.
③ 마지막 문장의 성격. 경쟁사가 먼저 구축하면 뒤처진다는 표현은 전략적 촉구이지, 특정 구축 기간이나 투자수익률의 검증된 전망이 아닙니다. 글 말미에는 관련 행사 안내도 포함되어 있으므로, 전체 글은 기술 논문보다는 개념 정리와 산업적 주장으로 읽어야 합니다.
종합 평가: 채택할 주장과 보정할 주장
| 판단 | 내용 |
| 채택할 핵심 | 지표의 계산 일관성과 업무 의미·예외 판단의 표현은 다른 문제다. AI 에이전트의 업무 범위가 넓을수록 개체·관계·규칙·권한·결정 근거의 관리가 중요해진다. |
| 보정할 부분 | 시맨틱 레이어를 ‘라벨과 SQL만 있는 것’으로, 온톨로지를 ‘이유를 자동으로 아는 것’으로 단순화하면 안 된다. 두 방식은 결합 가능하며 둘 다 데이터 품질과 운영 관리에 의존한다. |
| 근거가 약한 부분 | 원문의 Siemens 사례는 예비 개념증명인데 확립된 산업 성과처럼 서술된다. 도입 조직의 경쟁우위나 AI 전반의 필수 아키텍처라는 주장에도 비교평가가 부족하다. |
| 기술적 오류 위험 | 원문의 RDF/OWL 예시에서 여러 INFERRED 문장은 필요한 공리나 선행 사실이 제시되지 않았다. ‘관계를 적으면 자동으로 정당한 결론이 나온다’는 식으로 이해하면 안 된다. |
주요 대조 출처: 원문 · PKO 연구 · Siemens 마이크로그리드 연구 · Palantir Ontology 공식 문서 · W3C OWL 2 명세

'07.AI > 13. AI 데이터' 카테고리의 다른 글
| AI 데이터 - O'Reilly, 원시 데이터를 적절한 그래프 구조로 변환하는 그래프 모델링 (0) | 2026.09.30 |
|---|---|
| 클라우드 컴퓨팅 - 네이버 클라우드, DB & Server Access Control(DSAC) (0) | 2026.09.23 |
| AI Slop - IEEE Spectrum, AI Slop은 엔지니어의 코드 검토 방식을 바꾸고 있습니다. (0) | 2026.09.13 |
| AI Slop - Ahrefs, AI 활용 블로그 내 고품질 컨텐츠 제작 전략 (0) | 2026.09.07 |
| 에이전트 AI - Cerebras 사내 지식 검색 시스템 (0) | 2026.08.20 |