반응형
https://newsletter.semianalysis.com/p/engrams-embedding-entendre-codesign
2026.9.18
[Engrams Embedding Entendre: Codesign for Efficient DRAM/SSD Offloading]
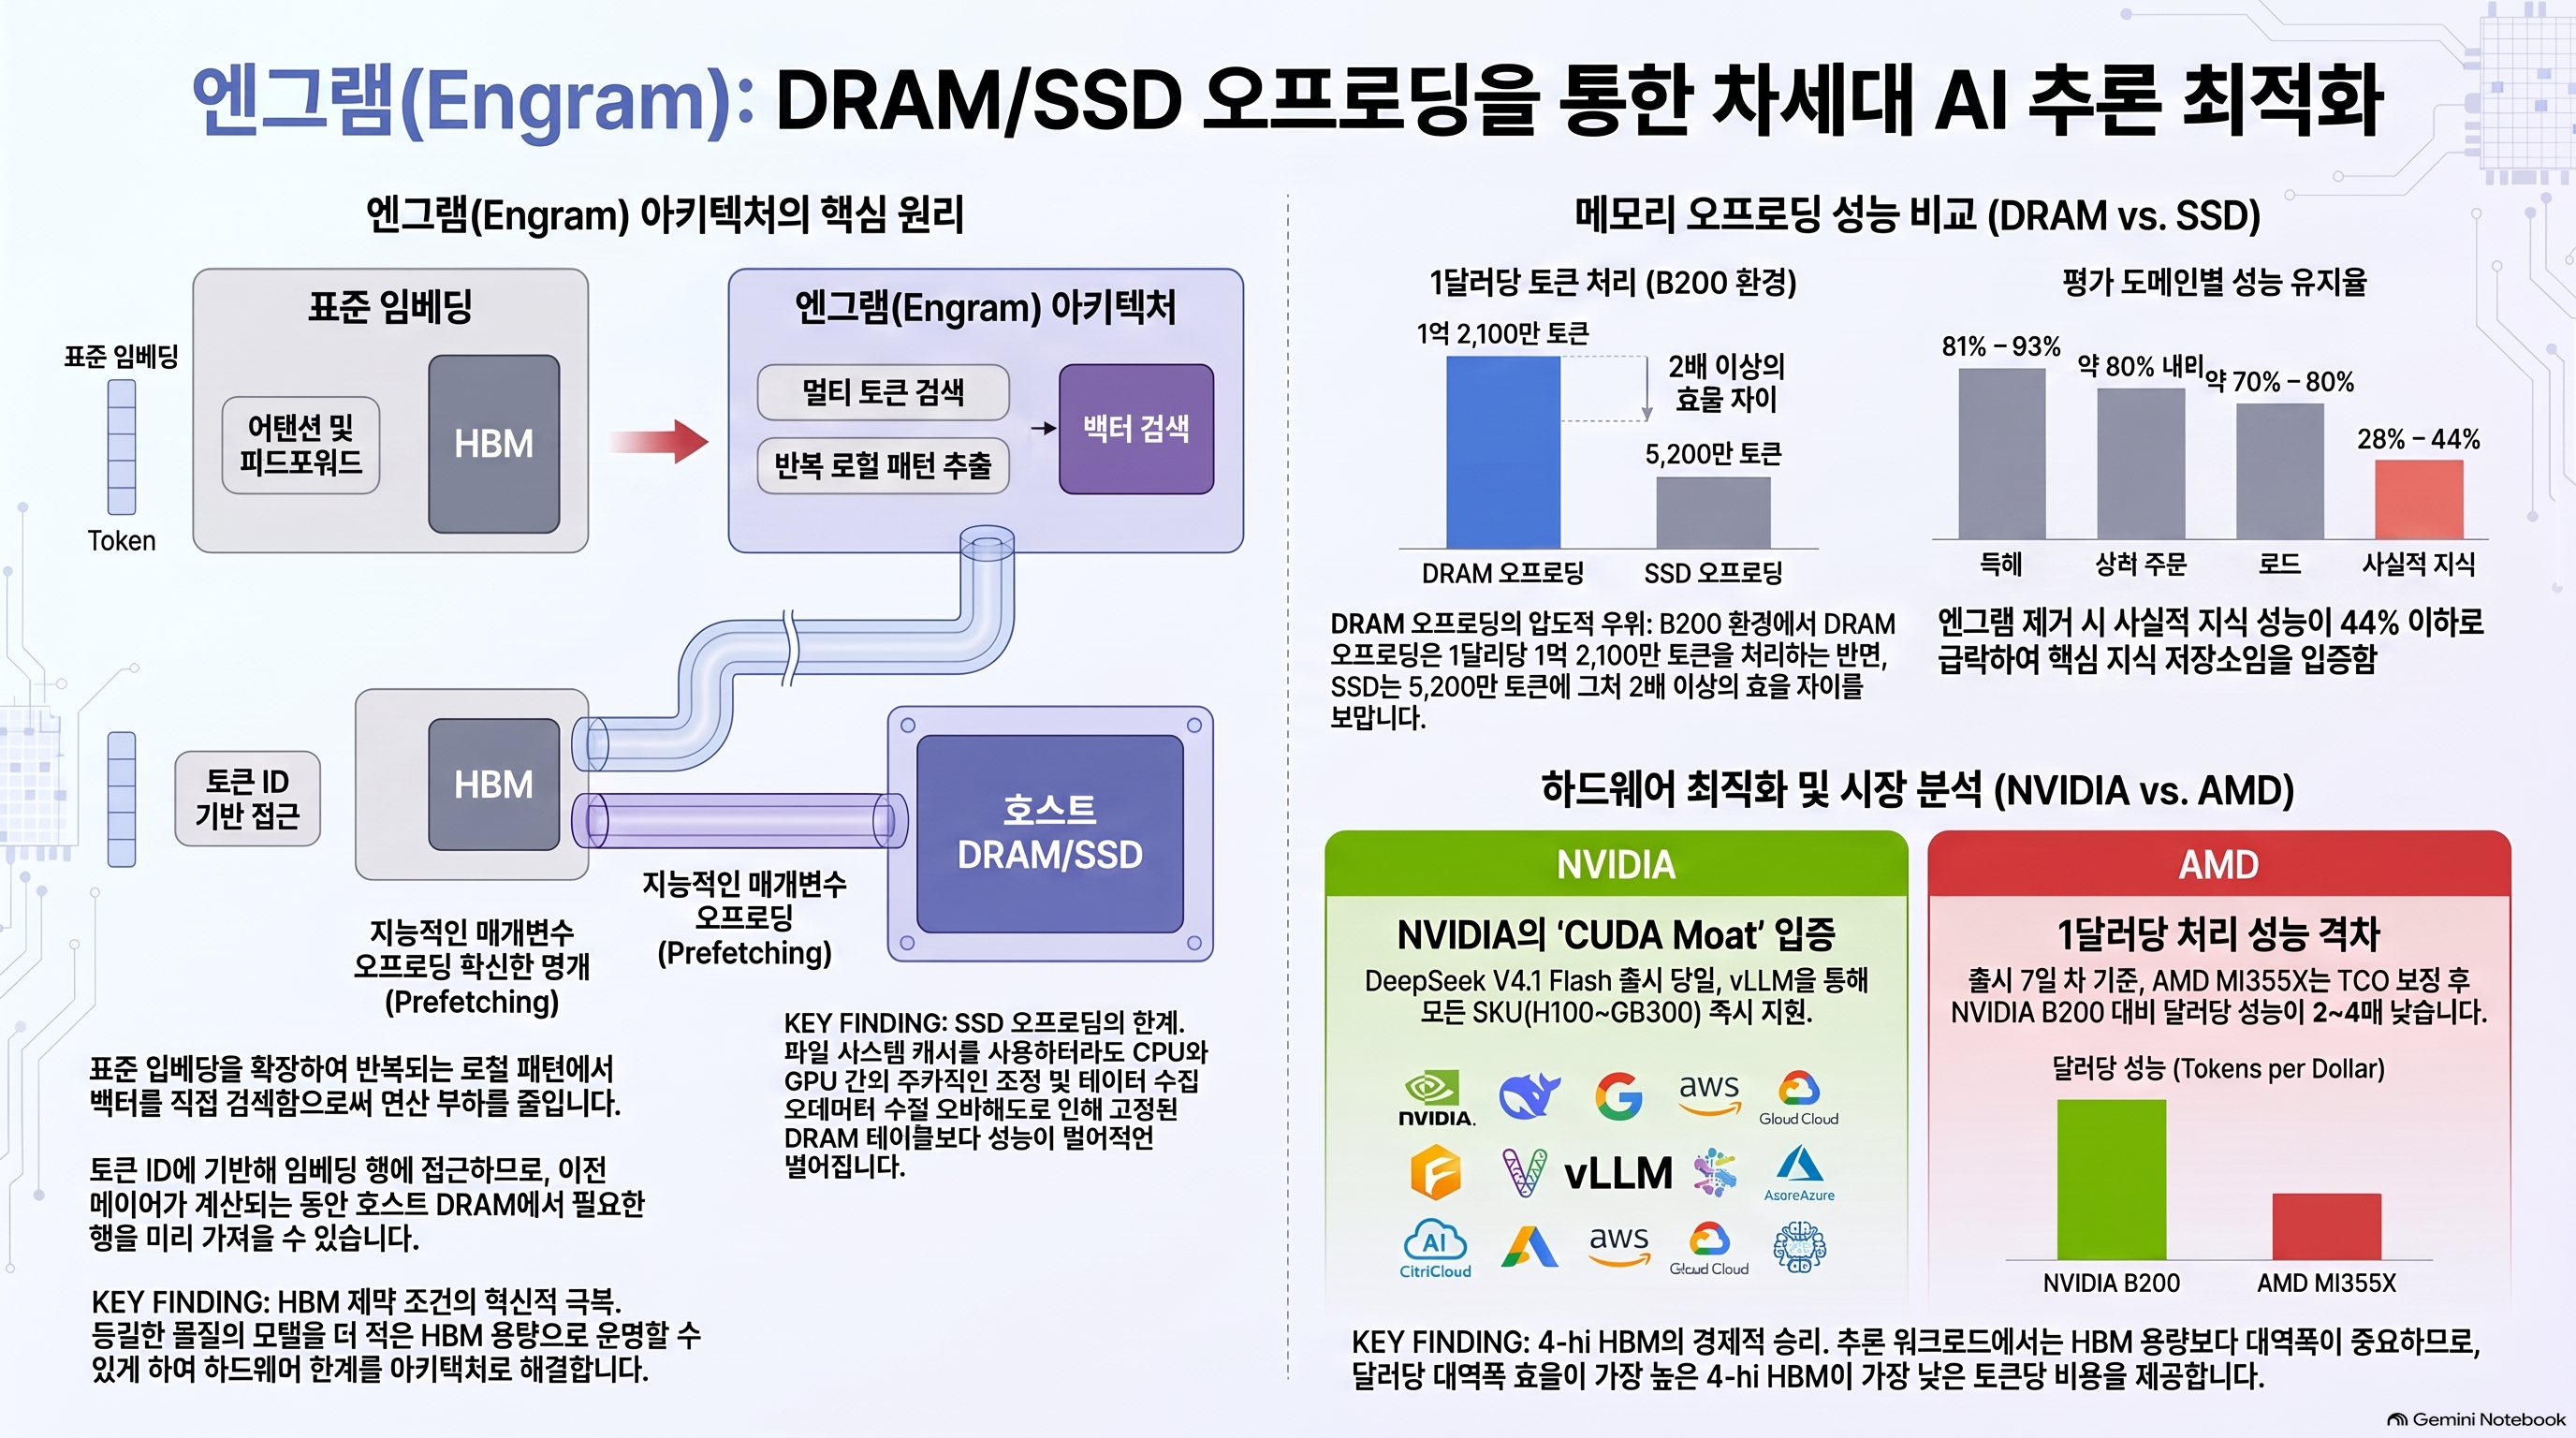
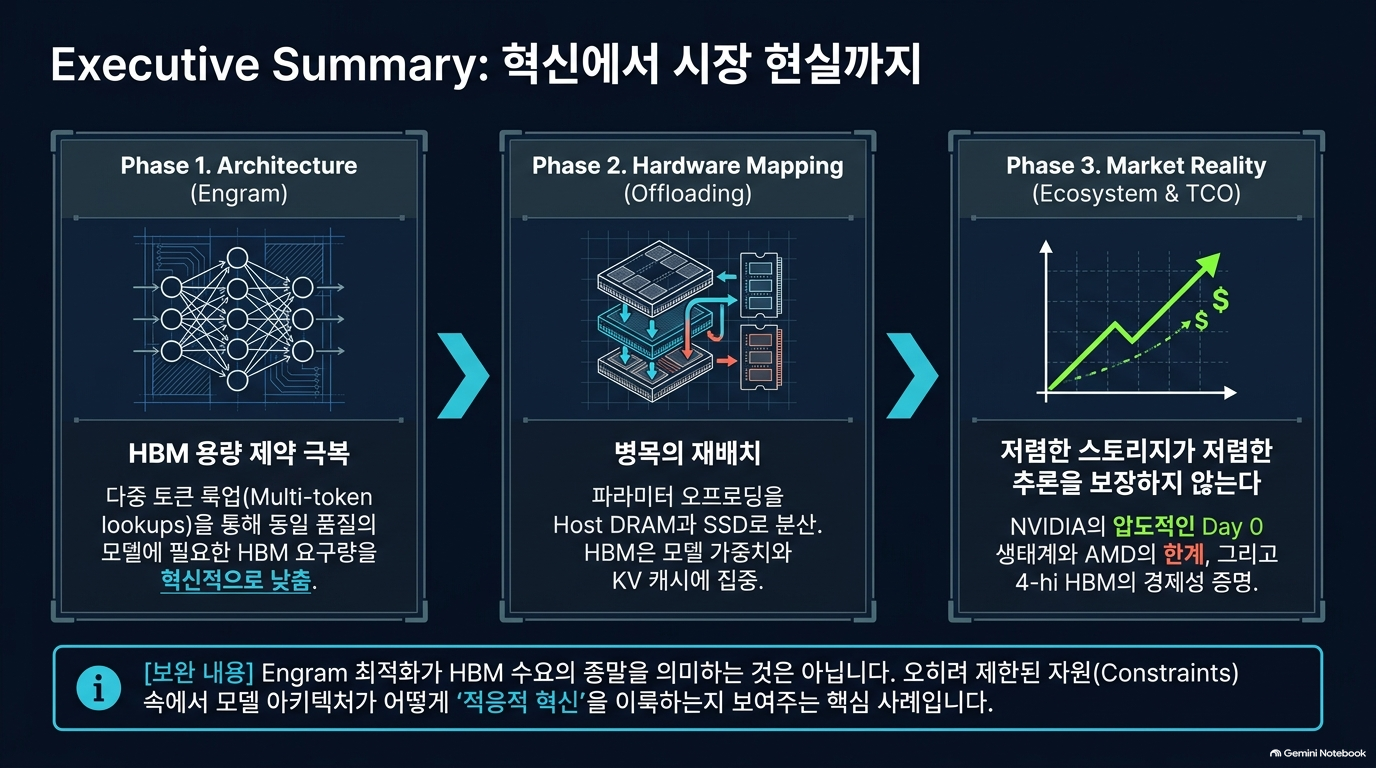
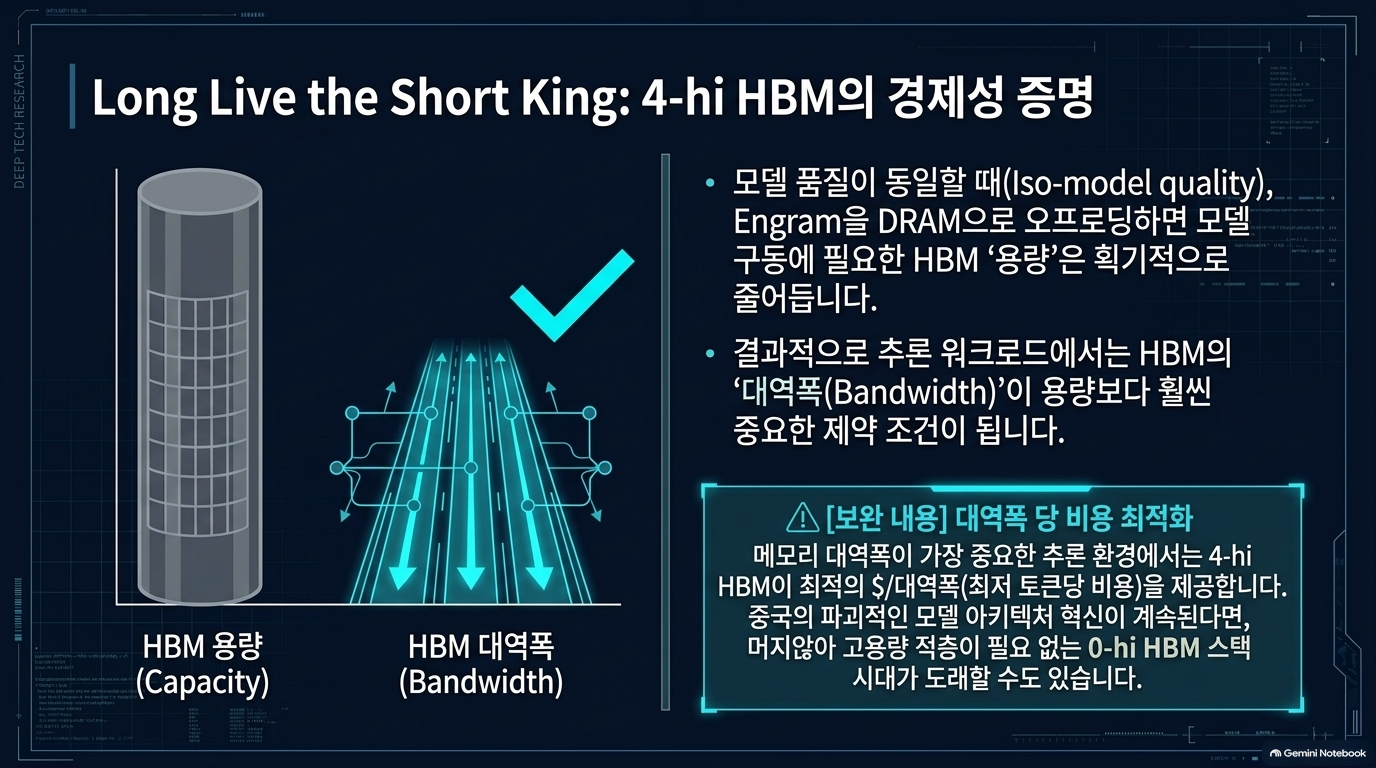
이 자료는 인공지능 모델의 효율성을 극대화하는 Engram 아키텍처와 그에 따른 하드웨어 활용 전략을 심도 있게 다룹니다. 핵심은 자주 반복되는 데이터 패턴을 별도의 벡터로 직접 조회하는 Engram 레이어를 도입하여, 고가의 HBM(고대역폭 메모리) 대신 저렴한 DRAM이나 SSD로 매개변수를 오프로딩함으로써 하드웨어 제약을 극복하는 것입니다. 연구에 따르면 Engram을 호스트 DRAM에 저장하는 방식은 통신 오버헤드를 줄여 시스템 성능을 최적화하지만, SSD를 활용한 오프로딩은 아직 비용 대비 효율성이 떨어지는 것으로 나타났습니다. 결과적으로 이 텍스트는 모델 설계와 메모리 계층 구조의 코드사인(Codesign)이 향후 추론 서비스의 경제성을 결정짓는 핵심 요소임을 강조하며, 특히 NVIDIA의 CUDA 생태계가 가진 강력한 하드웨어 최적화 우위를 입증하고 있습니다.
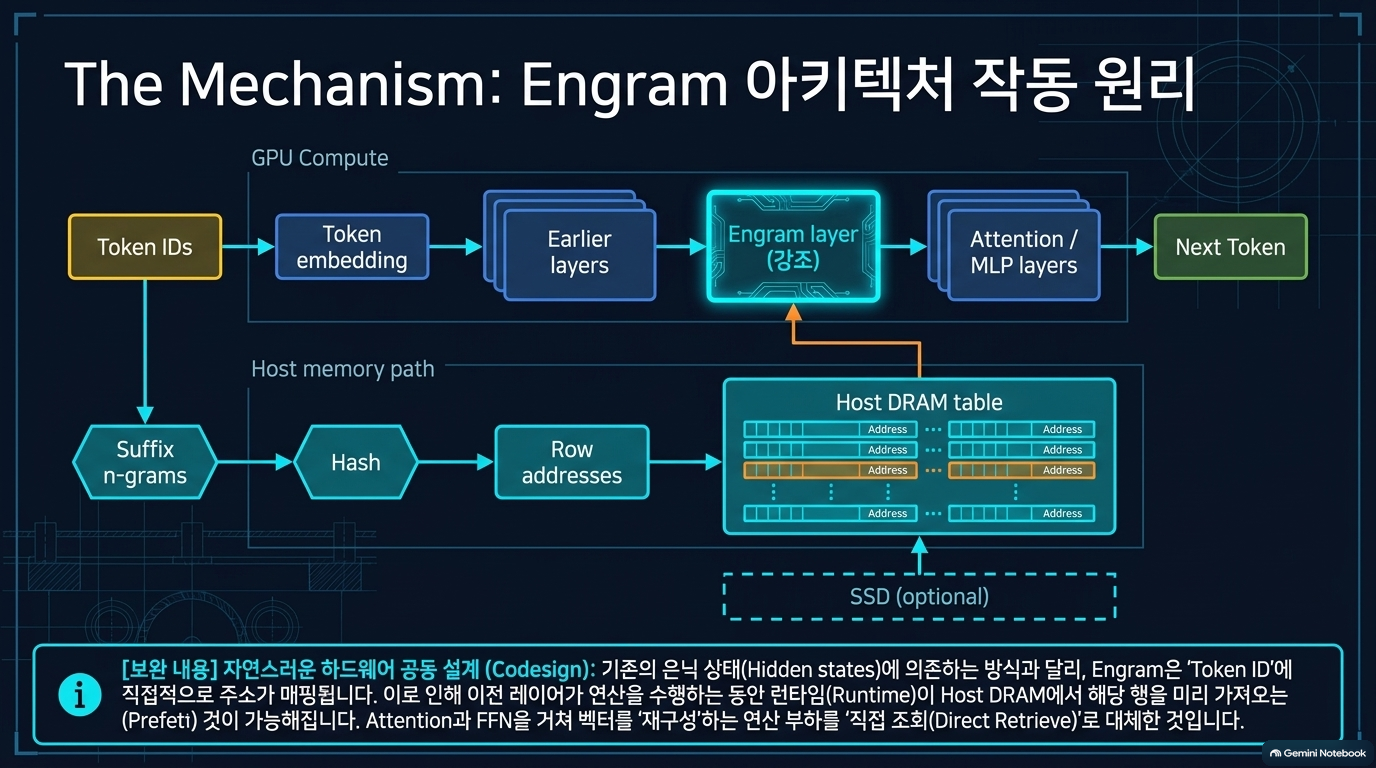
- Engram은 “가중치 전체를 오프로딩”하는 구조가 아니라, 입력 토큰 ID만으로 주소가 사전에 결정되는 거대 N-gram embedding table을 HBM 밖으로 옮기는 구조입니다. 따라서 MoE처럼 hidden state 기반 라우팅 결과를 기다릴 필요가 없으며, 이전 Transformer 블록의 연산 시간 동안 필요한 embedding row를 미리 가져와 통신 지연을 은닉할 수 있습니다.
- SemiAnalysis의 실험 결론은 명확합니다.
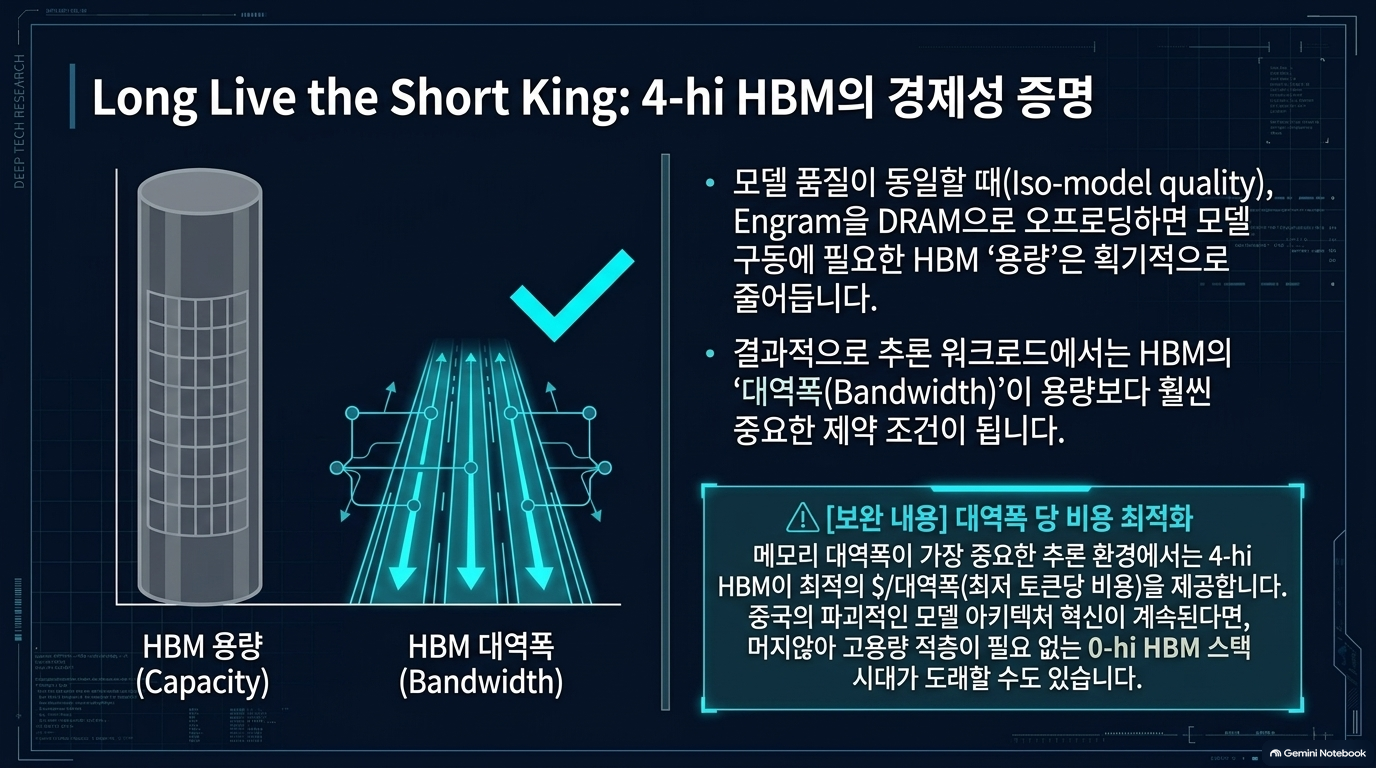
- DRAM 오프로딩: HBM에 Engram 전체를 상주시킨 경우보다 종종 더 좋은 전체 서빙 Pareto를 만들 수 있습니다. HBM을 Engram 대신 KV cache·다른 모델 가중치에 배정하고, 필요한 row만 DRAM에서 읽기 때문입니다.
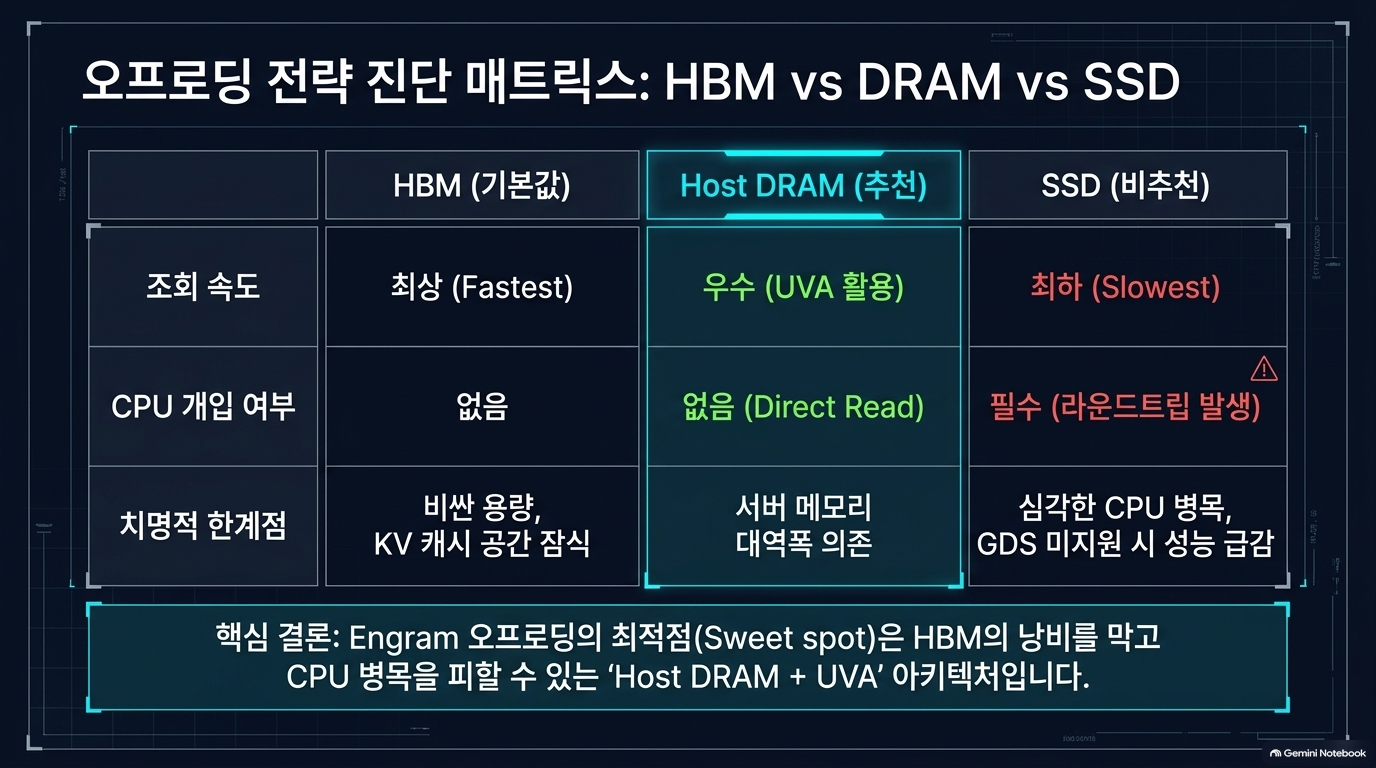
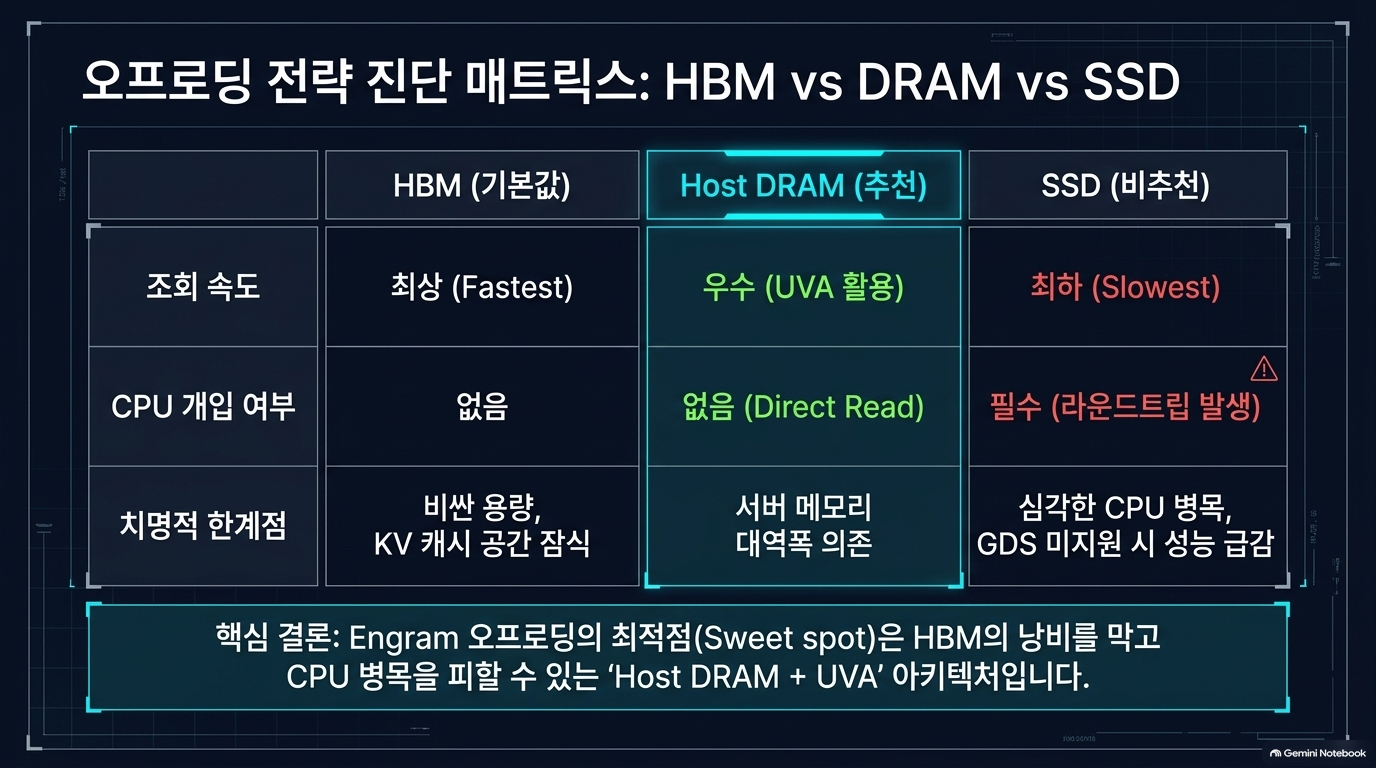
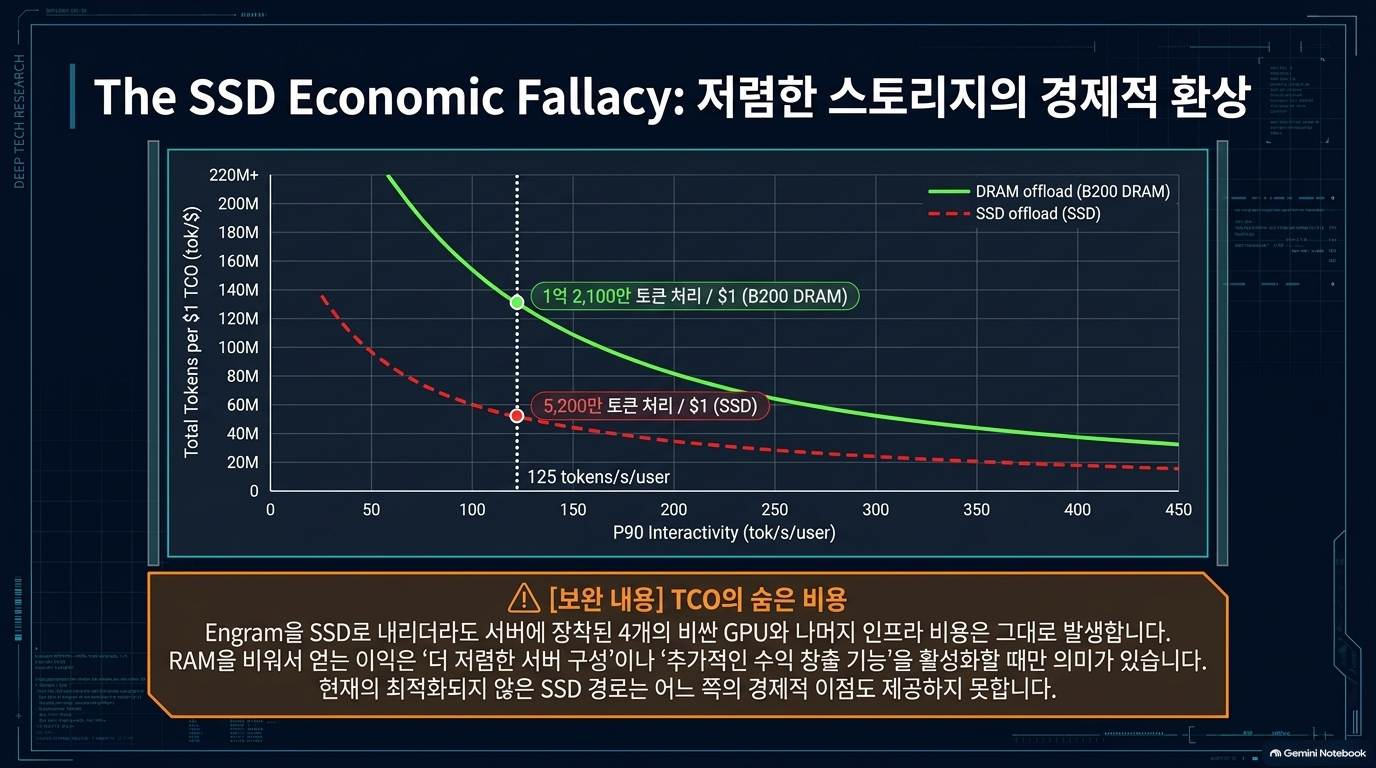
- SSD 오프로딩: 현재 공개된 구현에서는 생산 서빙에 부적합합니다. B200 실험에서 DRAM이 SSD보다 P90 interactivity와 총 token/$ 모두 우세했습니다.
- 따라서 실무 권고는 HBM + pinned DRAM의 2계층을 기본으로 하고, SSD는 cold-tier 실험 또는 용량 확장용으로 한정하는 것입니다.
1. Engram이 오프로딩 친화적인 이유
- 일반적인 Transformer/MoE 파라미터는 연산 중 hidden state와 동적 라우팅에 의해 실제 접근 위치가 결정됩니다. 반면 Engram은 다음 경로를 가집니다.
textCopy
- 입력 token IDs
- → tokenizer compression / 정규화
- → suffix 2-gram·3-gram 생성
- → deterministic multi-head hash
- → embedding-table row address 확정
- → row fetch
- → hidden state 기반 gate로 유용성 조절
- → residual 연결 후 Attention·MoE 수행
- 각 토큰 위치에서 N-gram을 해시하여 embedding row를 선택하므로, 주소가 token IDs만으로 결정됩니다. GPU가 해당 Engram layer에 도달하기 전에 필요한 row 집합을 계산하고 가져올 수 있습니다.
- Engram의 핵심은 다음 두 가지를 분리하는 것입니다.
| 구분 | 담당 기능 | 저장/연산 특성 |
| Conditional computation | MoE·Attention | hidden state 의존, 동적, HBM 상주 필요성이 큼 |
| Conditional memory | Engram | token ID 의존, 정적 sparse lookup, 계층 메모리 적합 |
- 원 논문은 이를 “conditional memory”라는 별도 sparsity 축으로 정의합니다. 각 토큰에서 조회하는 row 수는 상수이므로 table 총용량이 증가해도 토큰당 lookup량과 계산량은 크게 늘지 않습니다.
2. DRAM 오프로딩 아키텍처
2.1 원 논문의 기본 메커니즘: prefetch + overlap
- 원 논문의 추론 구조는 다음과 같습니다.
textCopy
- CPU / Host DRAM
- └─ Engram table
- └─ input IDs로 row index 사전 계산
- └─ 비동기 prefetch / transfer
- ───── 이전 GPU Transformer layer 연산과 중첩 ─────>
- GPU / HBM
- └─ prefetched active rows
- └─ Engram gate·projection·fusion
- └─ Attention / MoE
- 핵심 설계 조건은 두 가지입니다.
- Engram 삽입 layer를 너무 앞에 두면 모델링상 유리하지만 prefetch window가 짧아져 GPU stall 가능성이 커집니다.
- 너무 뒤에 두면 통신 은닉에는 유리하지만, Engram이 초기 layer의 정적 패턴 재구성을 덜어 주는 모델링 효과가 약해질 수 있습니다.
- 즉, Engram layer 위치는 단순 모델 정확도 문제가 아니라 정확도–통신 은닉 창(window) 공동 최적화 문제입니다.
2.2 SemiAnalysis 구현: UVA 기반 pinned DRAM 직접 조회
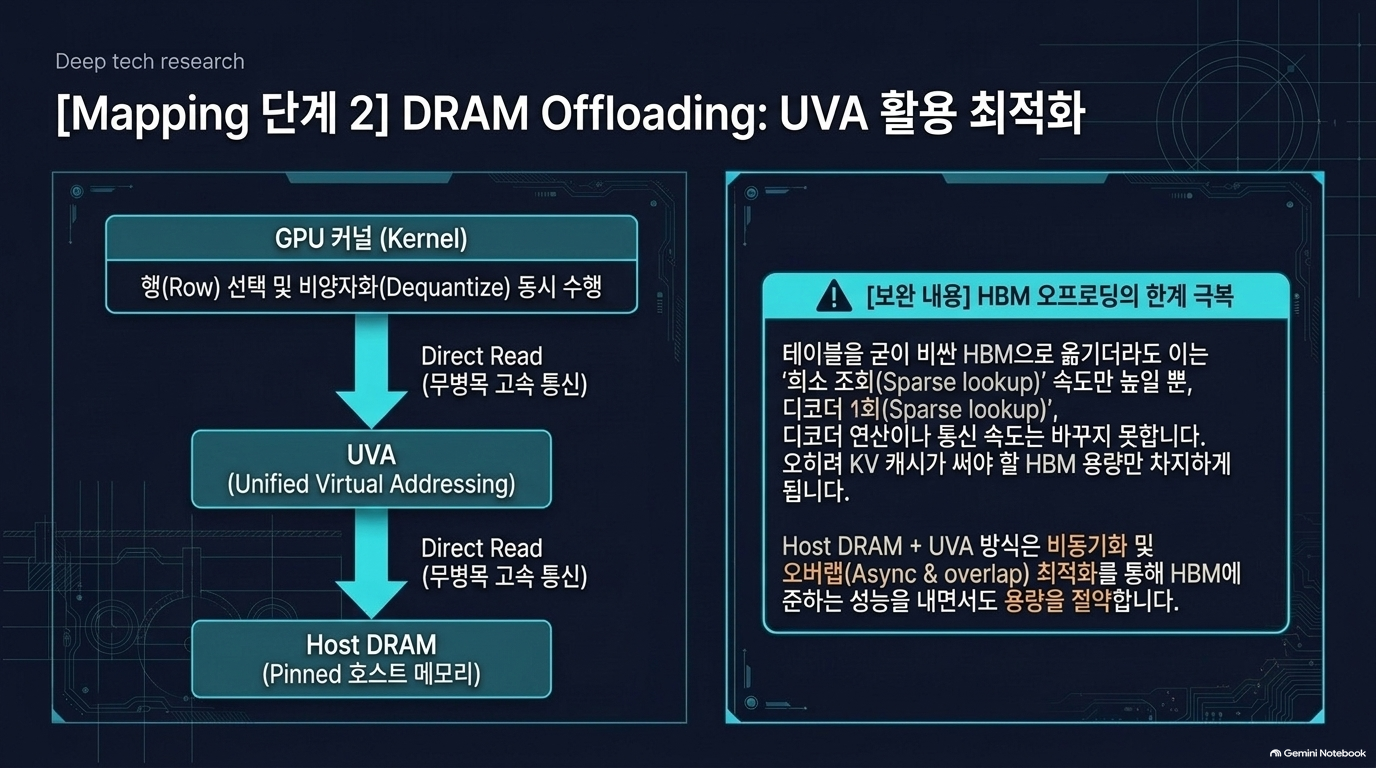
- SemiAnalysis 공개 구간의 DRAM 실험에서는 HBM과 DRAM이 같은 GPU kernel을 사용합니다.
- HBM 배치 시: GPU kernel이 GPU memory에서 row를 읽음
- DRAM 배치 시: UVA(Unified Virtual Addressing)로 GPU가 pinned host memory의 row를 직접 읽음
- 이후 row selection 및 dequantization은 GPU kernel 내에서 수행
- 이는 CPU가 매 토큰마다 row를 gather하고 GPU로 복사하는 전통적 offload 경로보다 훨씬 유리합니다. 즉, DRAM offloading의 성패는 “DRAM 대역폭” 자체보다도 다음에 달려 있습니다.
- GPU-direct/UVA 접근 가능 여부
- pinned memory 관리
- sparse row lookup과 dequantization의 kernel fusion
- 이전 layer 연산과 비동기 접근을 겹치는 정도
- Tensor Parallel 축소로 절감되는 GPU 간 통신량
2.3 왜 HBM보다 DRAM이 더 나을 수 있는가
- 직관과 달리 “가장 빠른 HBM에 전부 넣기”가 전체 시스템 최적은 아닙니다.
- Engram lookup 자체만 보면 HBM이 빠르지만, 전체 추론 시간은 아래처럼 구성됩니다.
T_{\text{total}} \approx \max(T_{\text{GPU compute}},\;T_{\text{Engram fetch}}) + T_{\text{unhidden}}
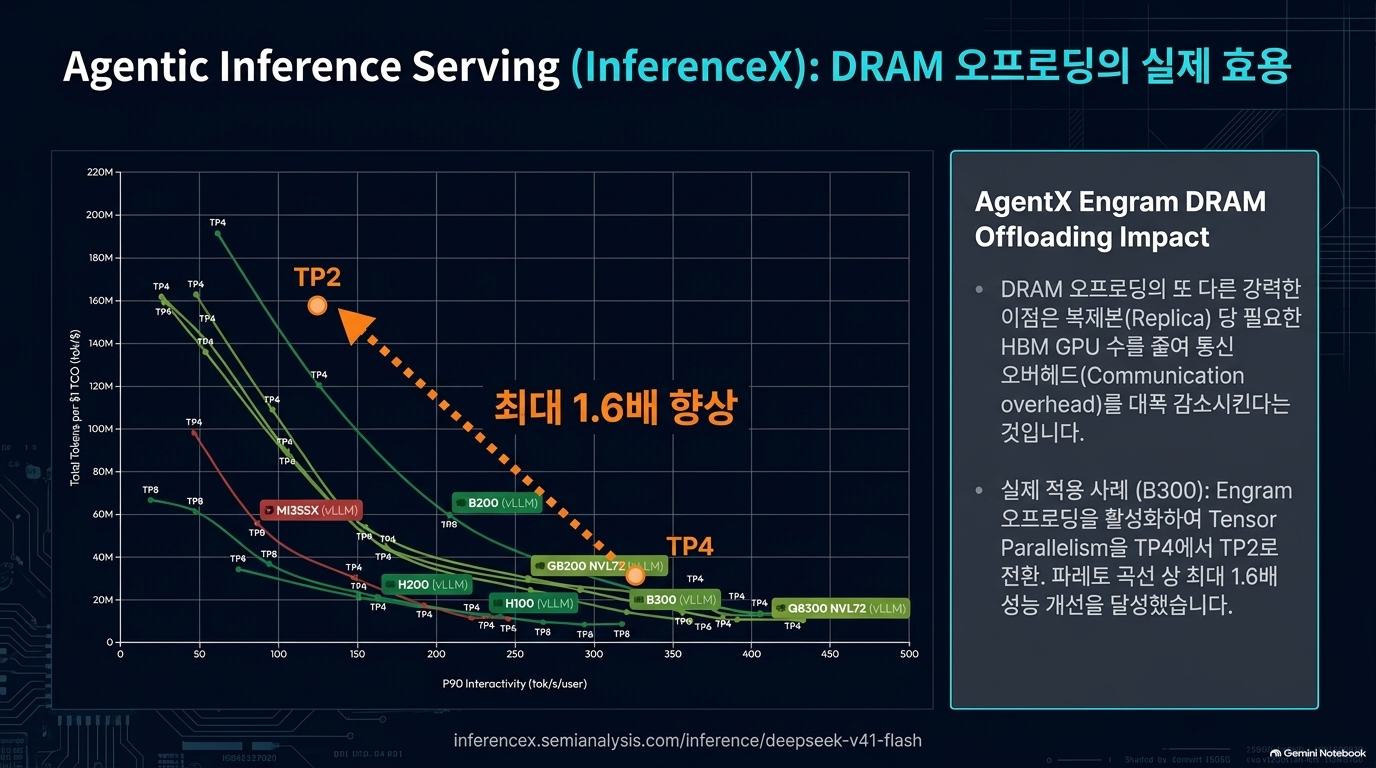
- DRAM fetch가 이전 layer compute에 완전히 또는 대부분 중첩되면, Engram을 HBM에 올려 얻는 이익은 작아집니다. 반면 HBM을 비워서 다음을 확보할 수 있습니다.
- 더 큰 KV cache
- 더 높은 batch/concurrency
- replica당 GPU 수 감소
- TP 통신 감소
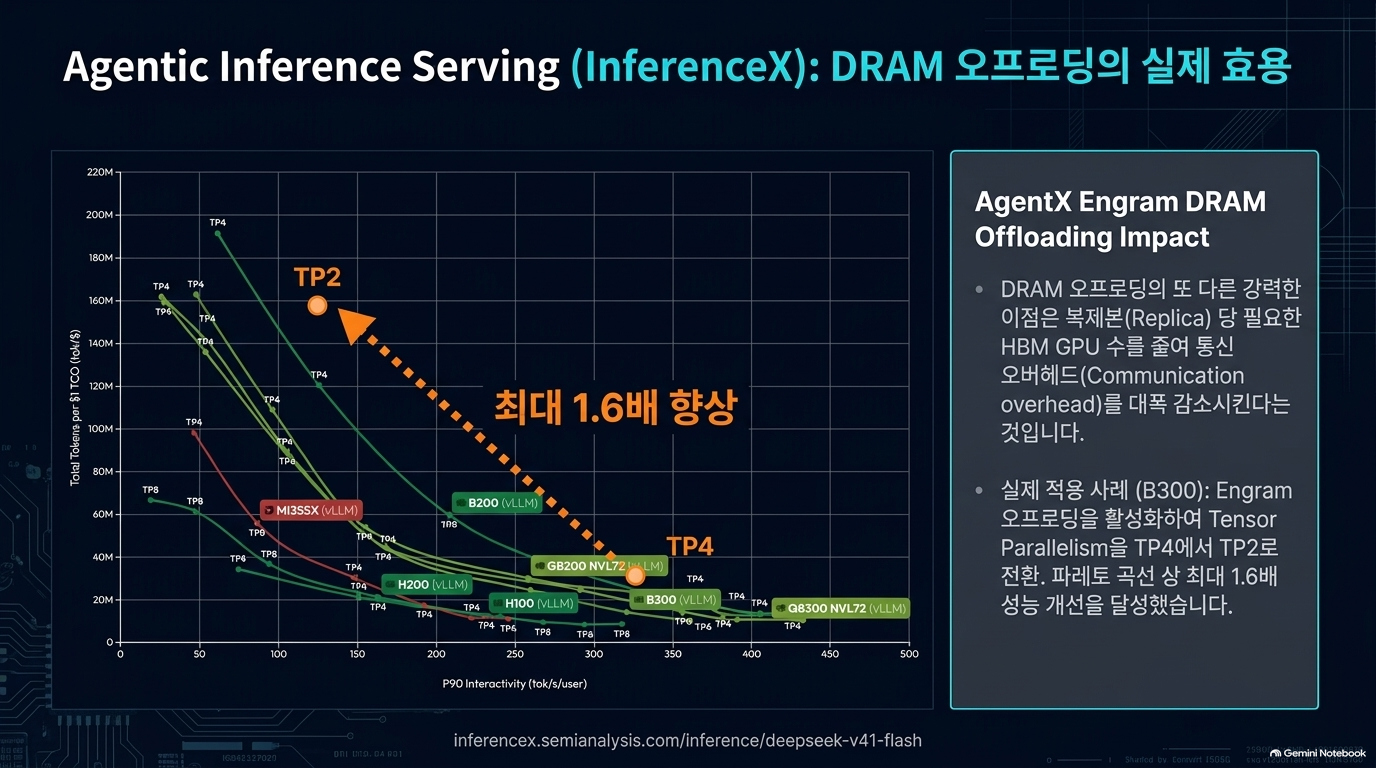
- SemiAnalysis는 B300에서 Engram offload로 TP4에서 TP2로 축소할 수 있었고, Pareto curve가 최대 1.6배 개선됐다고 제시합니다. 이 수치는 해당 워크로드·구현·하드웨어에 국한된 벤치마크 결과이지만, 방향성은 설득력이 있습니다. 즉, DRAM 오프로딩의 이익은 lookup latency 단축이 아니라 HBM 재배치와 parallelism 축소에서 발생합니다.
3. DeepSeek-V4.1-Flash 관점의 접근량
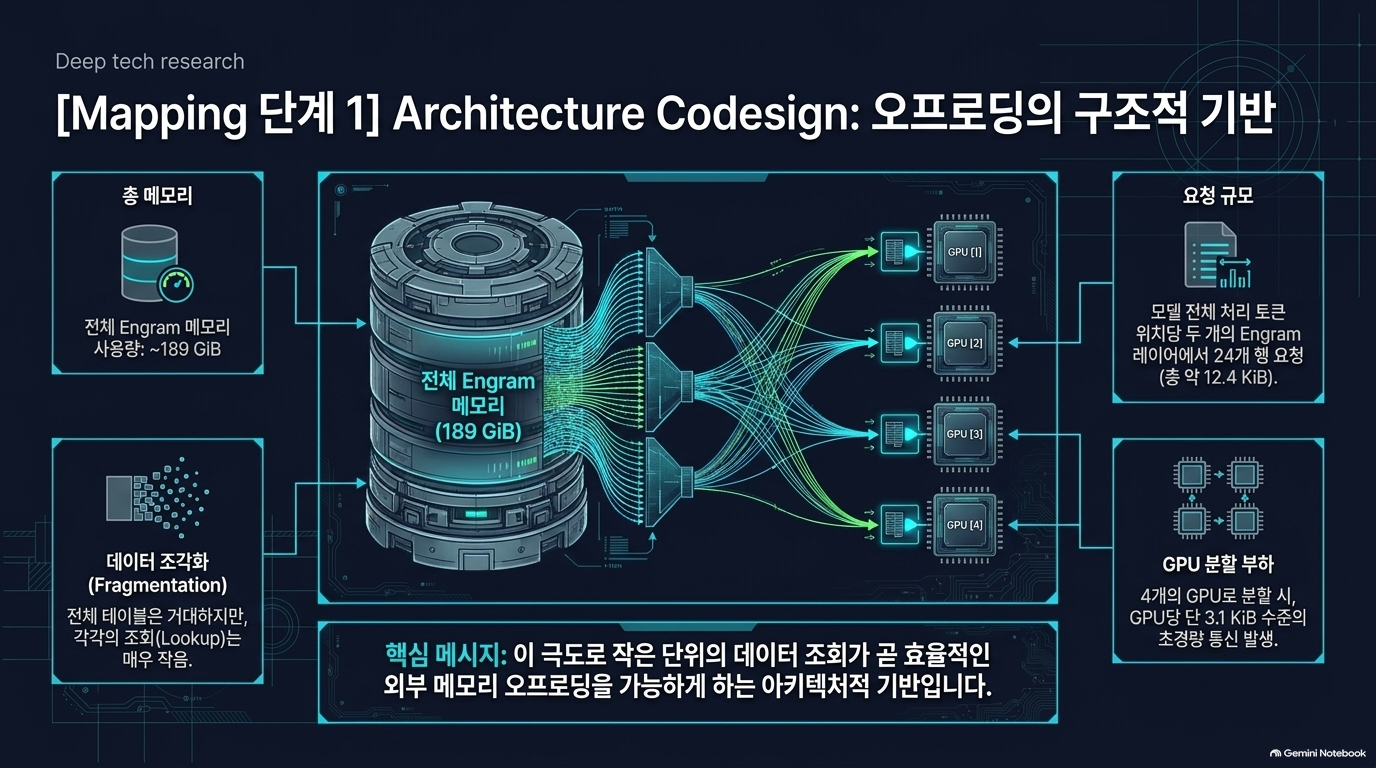
- SemiAnalysis는 DeepSeek-V4.1-Flash가 두 개의 Engram layer에서 토큰당 각각 24 rows를 요청하며, 모델 전체 기준 약 12.4 KiB/token-position, 4-GPU 분할 시 GPU당 약 3.1 KiB라고 설명합니다.
- 이런 액세스 특성은 다음과 같습니다.
| 항목 | 특성 | 오프로딩 영향 |
| Table 총용량 | 매우 큼 — 공개 실험에서 약 189 GiB | HBM에 전부 둘 경제성이 낮아짐 |
| 토큰당 요청량 | 작고 일정 | DRAM/UVA 접근에 유리 |
| 주소 결정 시점 | token ID 입력 직후 | prefetch 가능 |
| 액세스 분포 | N-gram의 Zipf 분포 예상 | hot row cache에 유리 |
| gate | row fetch 뒤 계산 | gate score만으로 사전 read-skipping은 어려움 |
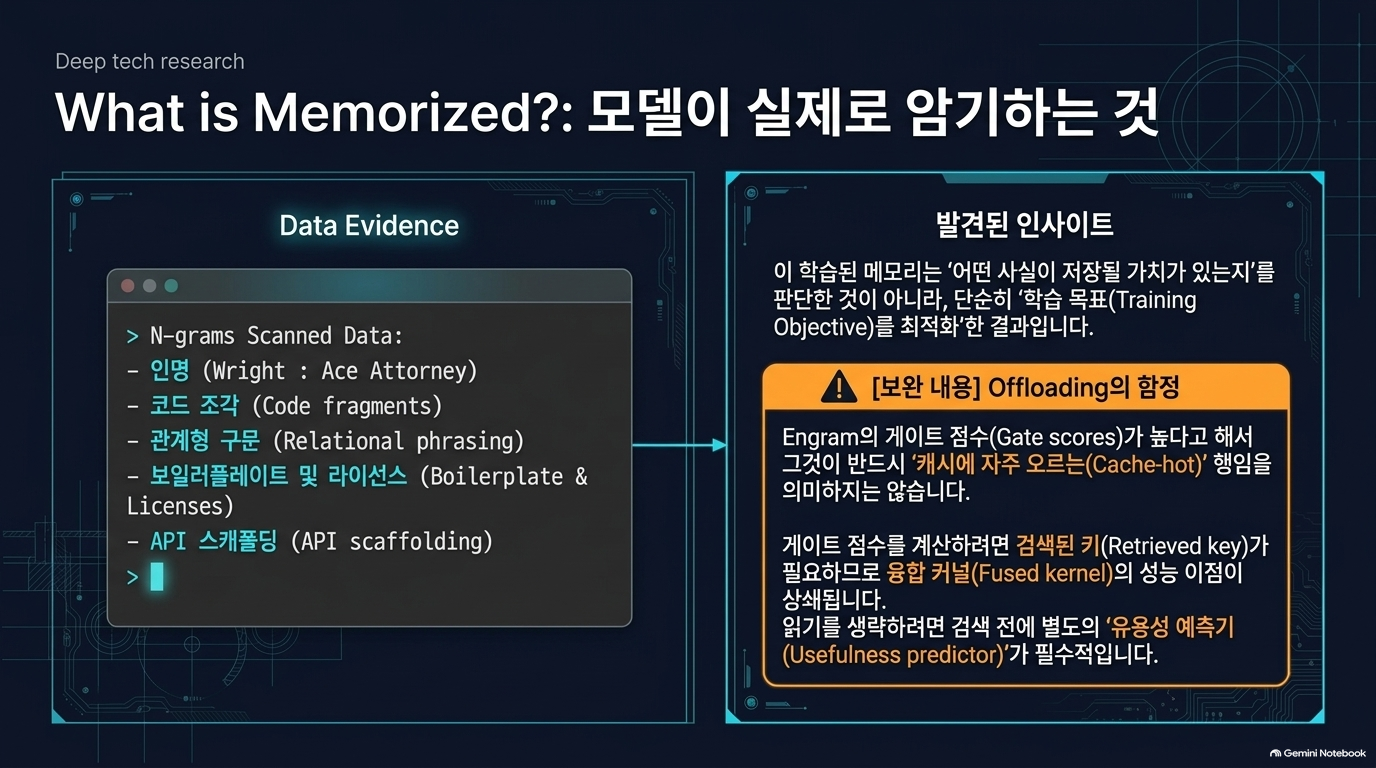
- 특히 마지막 항목이 중요합니다. Engram gate는 “가져온 memory가 현 문맥에 유용한가”를 판별하지만, gate를 계산하려면 이미 retrieved key/value가 필요합니다. 따라서 “gate가 낮을 것 같은 row는 안 읽자”는 최적화는 바로 적용할 수 없고, 별도의 usefulness predictor가 필요합니다.
4. SSD 오프로딩: 구조적 한계와 실험 결과
4.1 공개된 SSD 경로
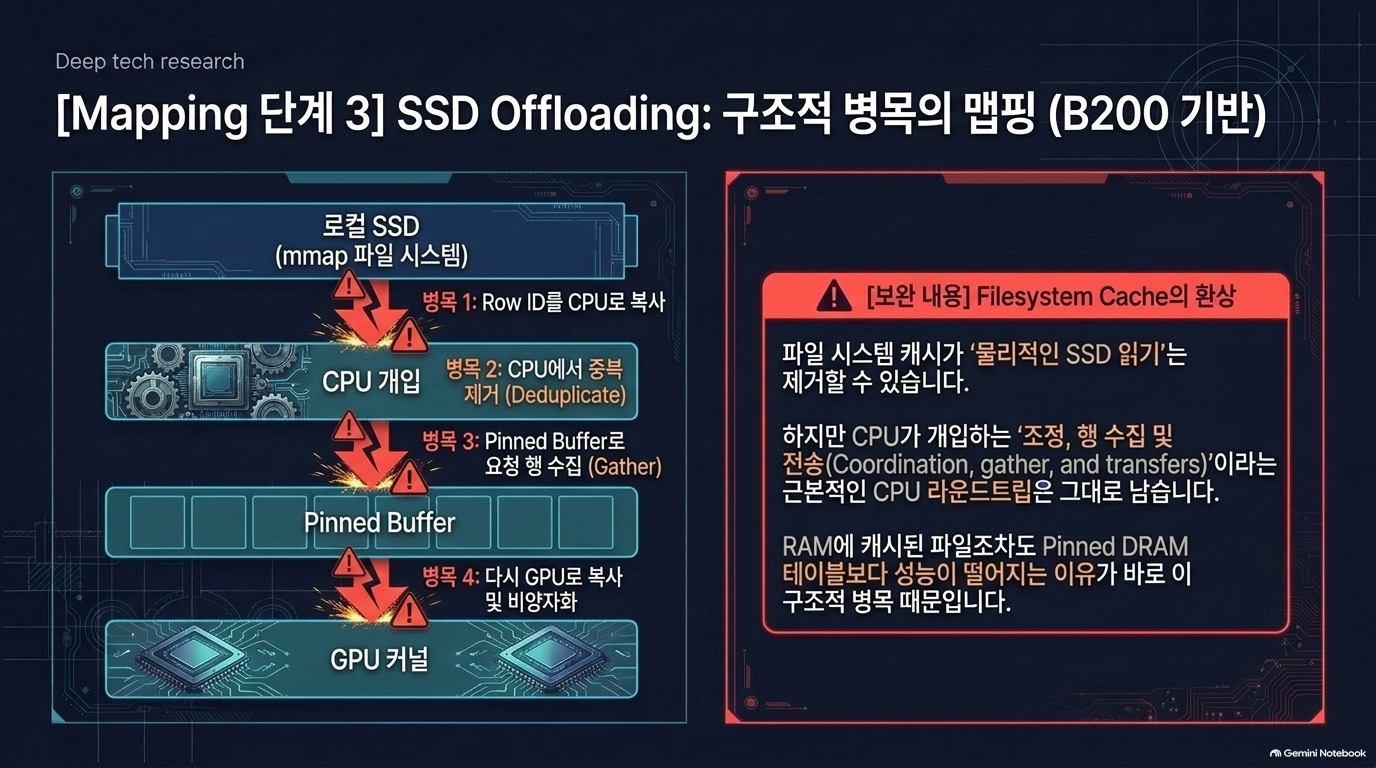
- SemiAnalysis의 B200 SSD 실험은 mmap 기반 Engram table을 로컬 SSD에 저장하는 방식입니다. 다만 GPU가 SSD/파일 캐시에서 sparse row를 직접 읽는 구조가 아닙니다.
textCopy
- mmap file on local NVMe SSD
- → OS page cache
- → CPU: requested row IDs 수집·중복 제거
- → CPU: requested rows gather
- → pinned buffer
- → CPU-to-GPU copy
- → GPU dequantization / Engram fusion
- 이 경로에는 DRAM/UVA 대비 다음 추가 비용이 존재합니다.
- GPU → CPU row ID 전달
- CPU deduplication
- CPU gather
- pinned buffer 구성
- GPU 재전송
- 그래프 구간 사이의 동기화/조정
- 따라서 파일 페이지가 이미 OS page cache에 있어 실제 SSD physical read가 사라져도, CPU orchestration 및 gather-copy path는 그대로 남습니다. SemiAnalysis도 warm file-system cache가 pinned DRAM table보다 여전히 느릴 수 있다고 명시합니다.
4.2 성능·경제성 판단
- 공개 결과에서 약 125 tokens/s/user 근방의 B200 구성은 다음과 같습니다.
| Tier | Total tokens / $ | 해석 |
| DRAM | 121 million | 기준 우세 |
| SSD | 52 million | DRAM의 약 43% 수준 |
- P90 interactivity 역시 모든 관측된 SSD 지점에 대해 DRAM 대안이 더 우수했다고 보고되었습니다.
- 따라서 “SSD가 싸니까 token cost도 낮다”는 결론은 성립하지 않습니다. GPU 4개, 서버, 네트워크 등 고정비는 그대로인데 Engram을 SSD로 내렸다고 DRAM 절감이 곧바로 서버 구성 축소로 이어지지 않기 때문입니다. 또한 mmap/page cache는 실제로는 DRAM을 여전히 소비합니다.
5. DRAM/SSD 계층화의 권장 참조 아키텍처
textCopy
- Tier 0: GPU HBM
- - 활성 모델 가중치
- - KV cache
- - hot Engram rows (선택적 cache)
- - GPU-resident lookup/dequant kernel
- Tier 1: Host pinned DRAM ← 운영상 핵심 계층
- - 전체 또는 대다수 Engram table
- - UVA / direct GPU access
- - async prefetch, overlap
- - hot/warm row cache
- Tier 2: Local NVMe SSD ← cold tier / capacity extension
- - long-tail Engram shards
- - mmap + page cache
- - background page-in / admission control
- - CPU gather를 최소화한 향후 direct-path 필요
- Tier 3: Remote storage
- - 온라인 token-path에는 비권고
- - offline table distribution, snapshot, shard loading 용도
운영 적용 판단 매트릭스
| 조건 | DRAM 오프로딩 | SSD 오프로딩 |
| HBM 부족, host DRAM 여유 | 권장 | 제한적 검토 |
| KV cache/concurrency가 병목 | 강력 권장 | 비권장 |
| GPU 수/TP degree 축소 가능 | 강력 권장 | 경제성 재검증 필요 |
| CPU 경유 sparse gather 필요 | 성능 위험 | 고위험 |
| GDS 또는 GPU-direct sparse I/O 부재 | 관리 가능 | 성능상 큰 제약 |
| cold data의 초대형 용량 확보 | warm-tier 필요 | 후보이나 tail latency 허용 필요 |
| latency-sensitive online serving | 적합 가능 | 현 구현 기준 부적합 |
6. 설계·검증 시 확인해야 할 항목
[보완 필요: 성능 검증]
- HBM-only vs DRAM-UVA vs DRAM-copy vs SSD-mmap을 분리 비교해야 합니다. SSD 결과가 나쁘더라도 SSD read latency, page fault, CPU dedup, gather, H2D copy 중 무엇이 병목인지 분해되지 않으면 개선 우선순위를 정할 수 없습니다.
- 평균 TPS가 아니라 P50/P90/P99 TTFT·TPOT, page-fault율, CPU utilization, PCIe/NVLink utilization, pinned-memory 사용량을 함께 수집해야 합니다.
- request batch size, prompt length, decode length, TP degree, cache warmness를 고정한 실험 매트릭스가 필요합니다.
[확인 필요: 캐시 정책]
- Engram gate score는 retrieval 이후에 계산되므로 cache admission 신호로 직접 쓰기 어렵습니다. N-gram frequency, recency, prompt-domain, 예상 reuse distance 기반의 별도 hotness predictor가 필요합니다.
- Prefix cache와 Engram row cache의 효과가 중복될 수 있으므로, 둘의 hit ratio와 DRAM footprint를 분리해 측정해야 합니다.
- SSD backing에서 OS page cache를 이용하면 “SSD table”이라도 실제 workload가 DRAM을 사용합니다. resident set size와 page-cache reclaim 시 P99 악화를 반드시 검증해야 합니다.
[확인 필요: 모델-시스템 공동설계]
- Engram layer의 위치는 early-layer 모델링 이득과 prefetch window 간 trade-off이므로, 모델팀이 layer placement를 임의로 고정하면 시스템 최적화 여지가 사라집니다.
- hash collision, tokenizer normalization, multi-head hash 수, row precision/quantization은 table 크기와 정확도뿐 아니라 cache locality와 PCIe traffic까지 바꿉니다.
- TP 축소로 얻는 통신 감소가 핵심 이익일 수 있으므로, offload 검증은 동일 GPU 수 비교만이 아니라 동등 QoS에서 최소 replica 비용 기준으로 해야 합니다.
최종 판단
- Engram은 HBM 절감을 위한 사후적 paging 기법이 아니라, deterministic sparse lookup을 전제로 모델 구조부터 설계한 “메모리 계층 친화형 conditional memory”입니다. 이 주소 결정 가능성이 DRAM offload의 본질적 차별점입니다.
- DRAM offload는 GPU-direct/UVA, async overlap, fused lookup/dequantization, HBM의 KV cache 전환, TP 축소가 함께 갖춰질 때 효과적입니다.
- SSD offload는 테이블 용량을 확장하는 방향성은 맞지만, 공개된 구현처럼 CPU가 sparse row를 수집·gather·복사하는 경로에서는 P90 latency와 token/$가 모두 악화됩니다.
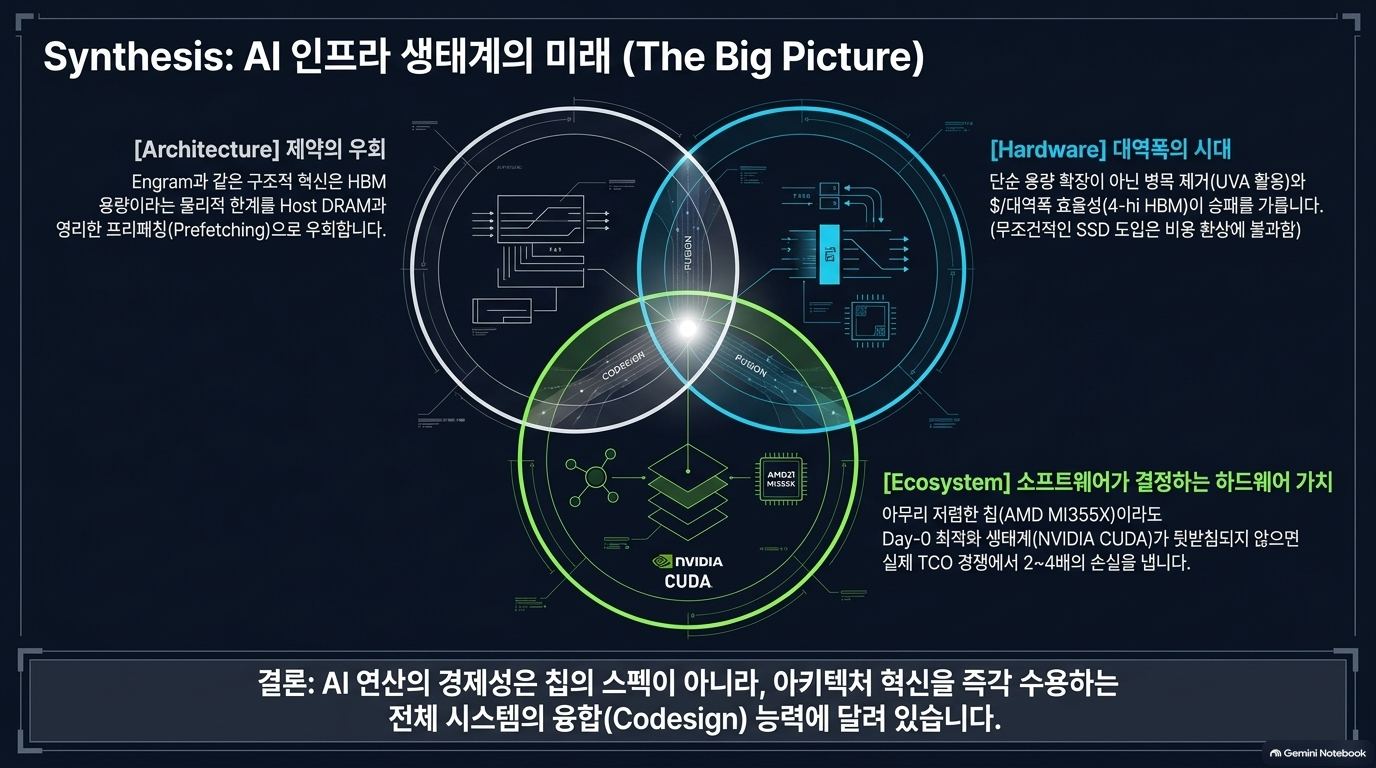
- 따라서 현 시점의 현실적 우선순위는 “Engram full/major table → pinned DRAM, HBM → KV cache 및 active compute, NVMe → cold backup/tail tier”입니다. SSD를 online serving tier로 승격하려면 GPU 중심 sparse I/O, batched page scheduling, hot-set DRAM cache, CPU 개입 최소화가 선행돼야 합니다.
728x90
반응형
'07.AI > 10. AI 반도체' 카테고리의 다른 글
| AI 반도체 - TrendForce, eSSD 수요가 낸드(NAND) 공급을 재편하다 (0) | 2026.09.22 |
|---|---|
| AI 반도체 - Semianalysis, MoE 모델을 추론 하드웨어에 매핑하기 (0) | 2026.09.22 |
| AI 반도체 - Semianalysis, AgentX: Vera Rubin NVL72 평가 (0) | 2026.09.18 |
| AI 반도체 - 메모리 - Semianalysis, 차세대 AI 추론용 4단 HBM (0) | 2026.09.15 |
| AI 반도체 - EPOCH AI, 화웨이는 2030년까지 엔비디아를 따라잡을 수 있을까요? (0) | 2026.09.13 |