https://typesafe.ai/blog/introducing-system-one-models-and-jev
2026.9.15
[Introducing System One Models & Jev]
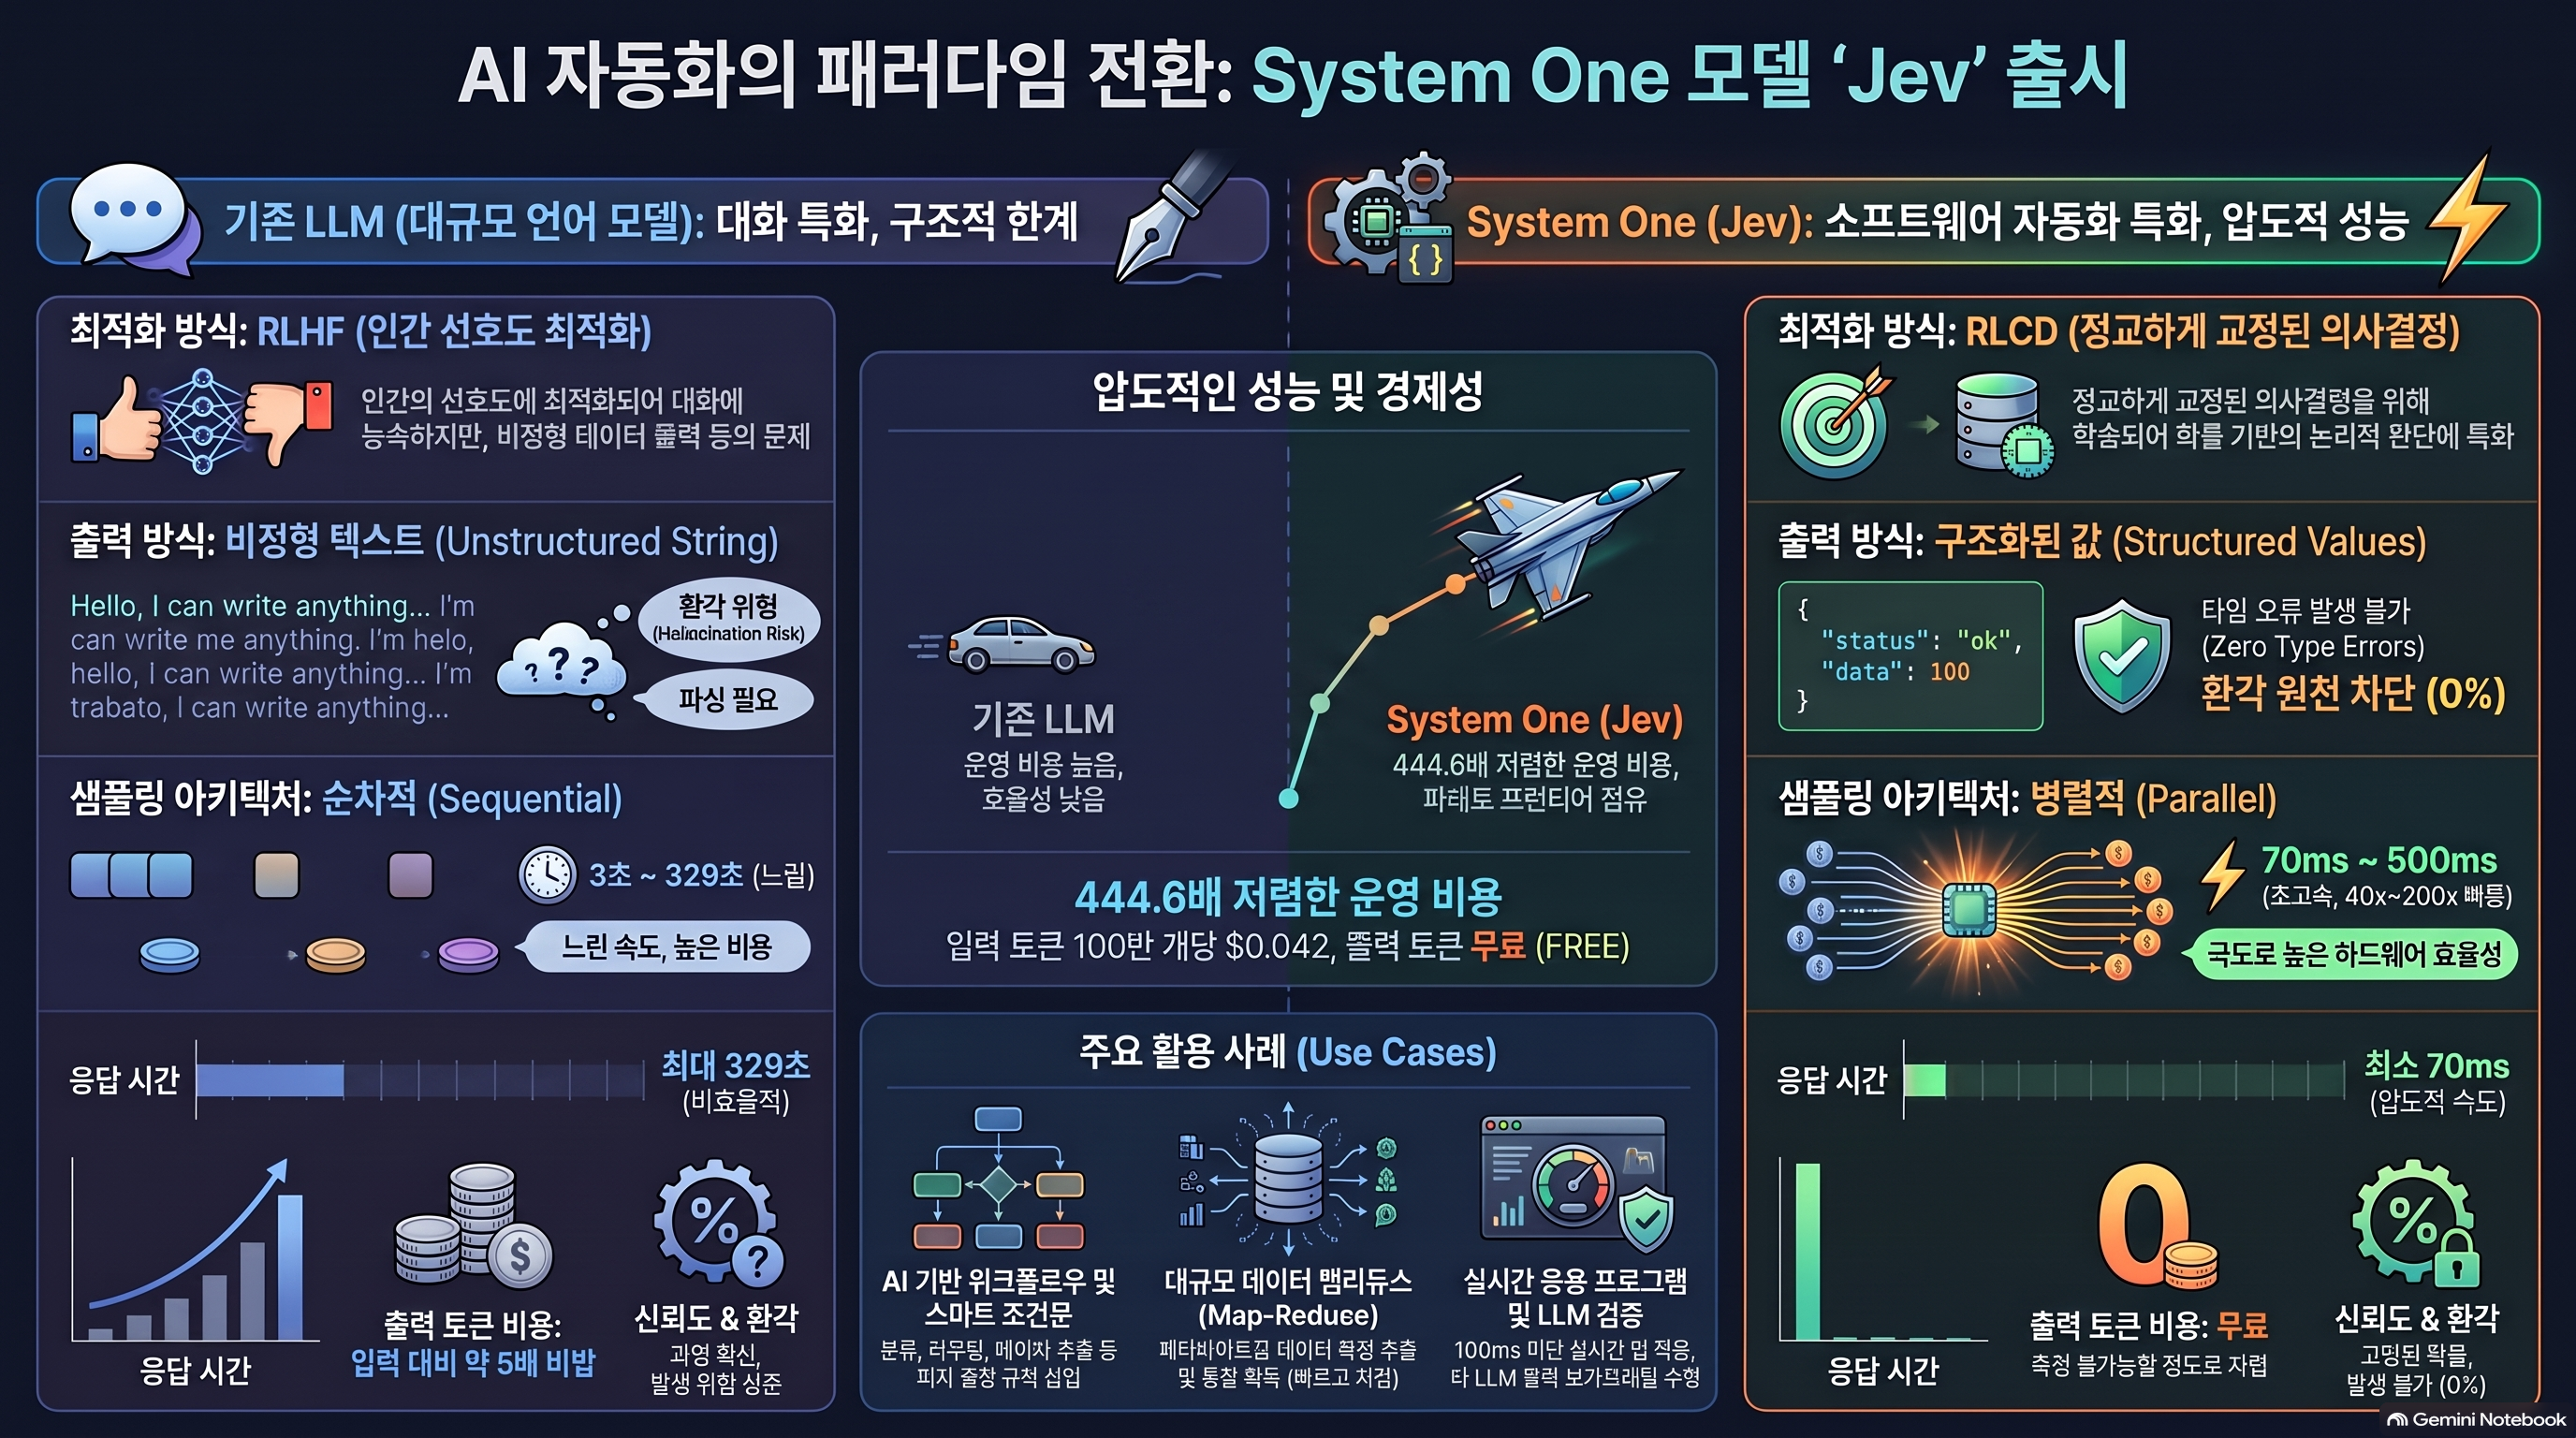
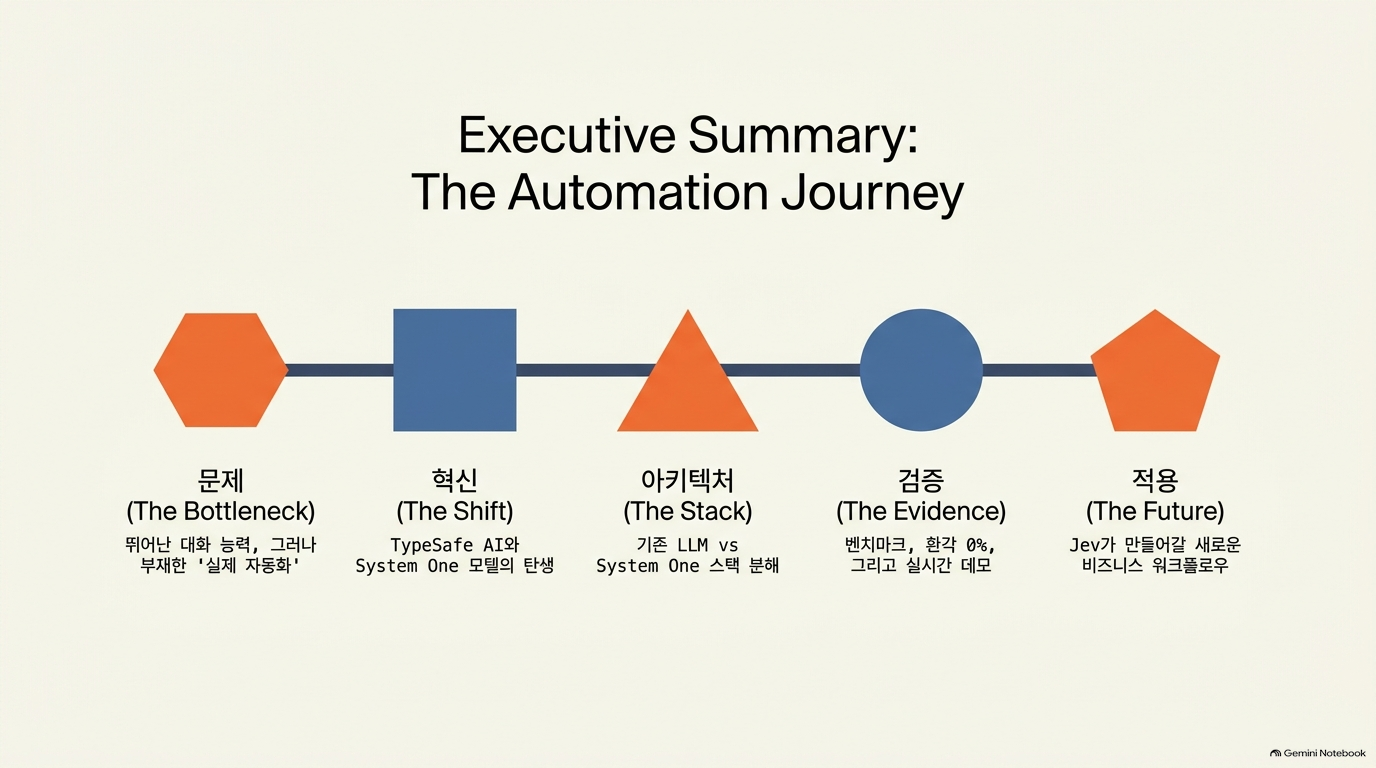
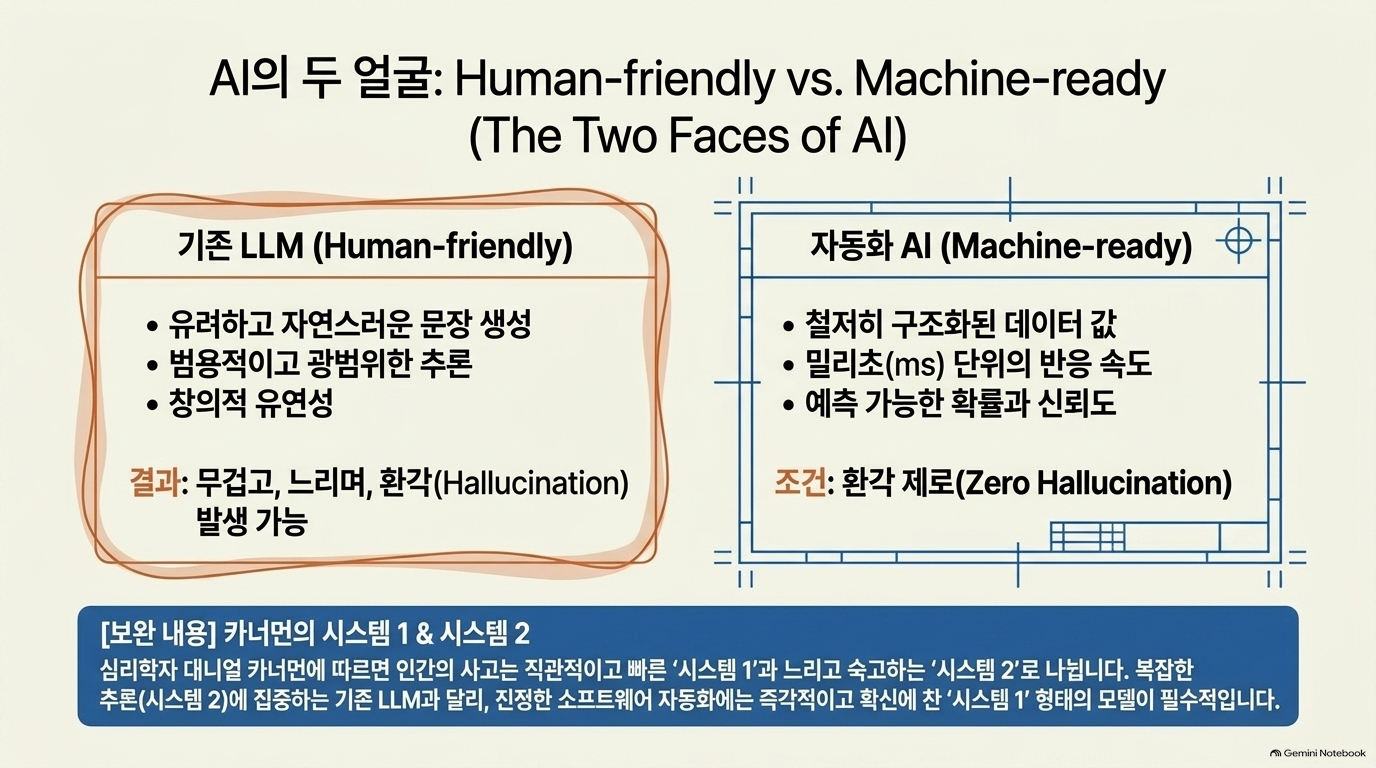
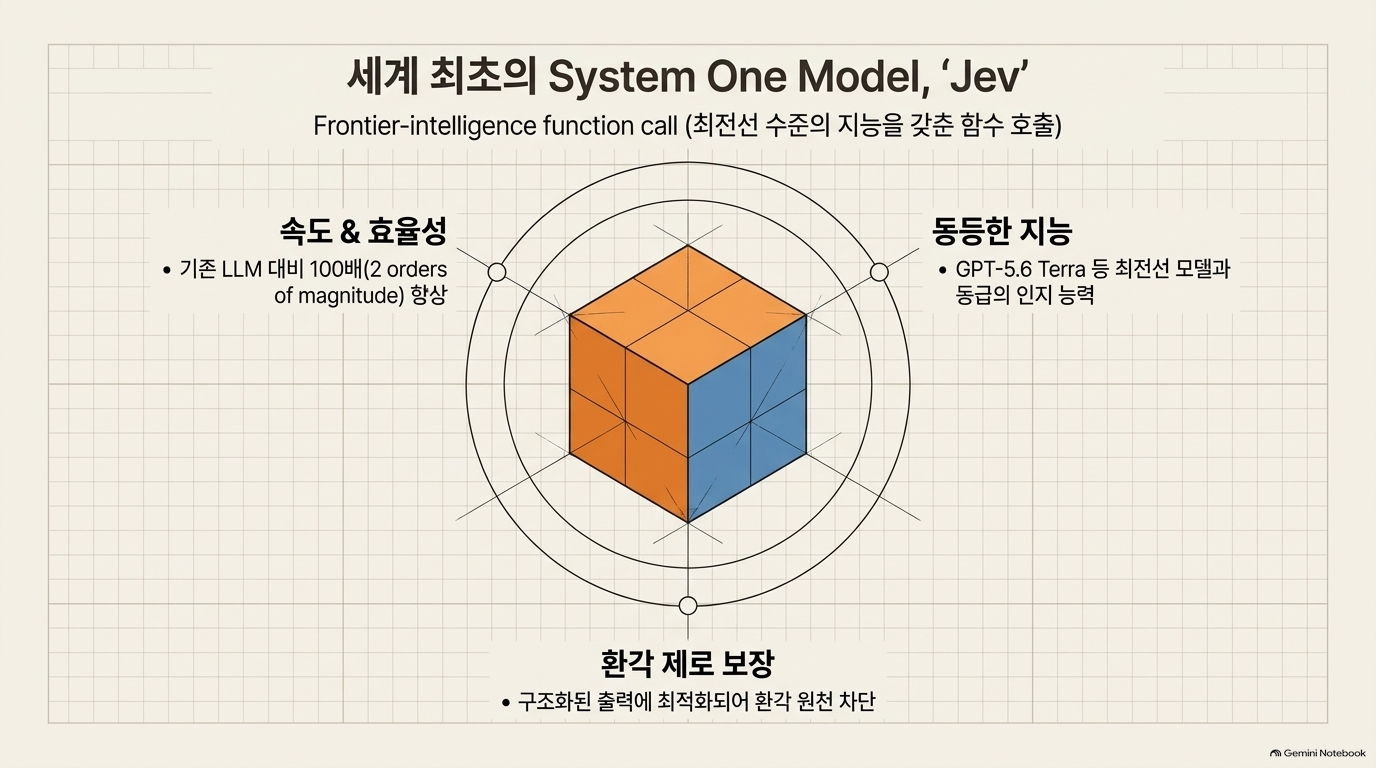
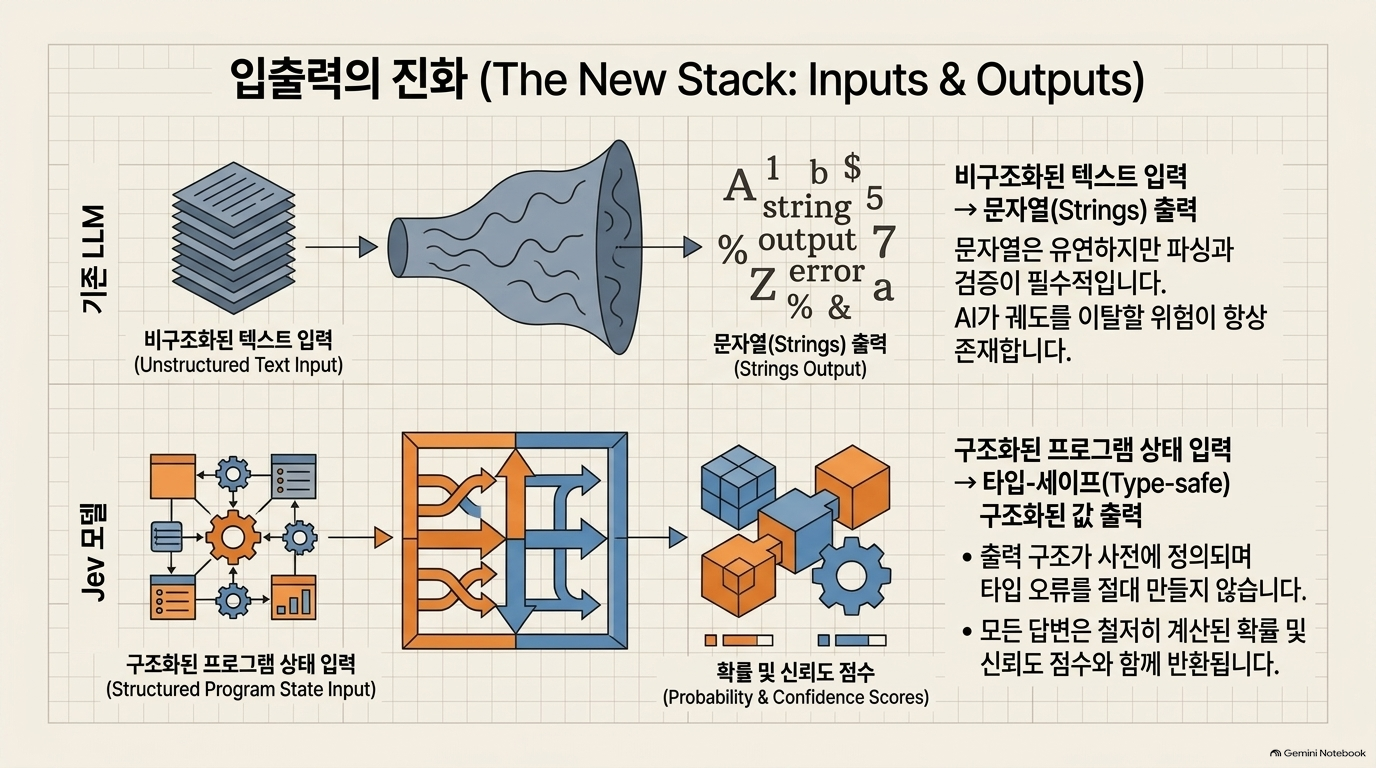
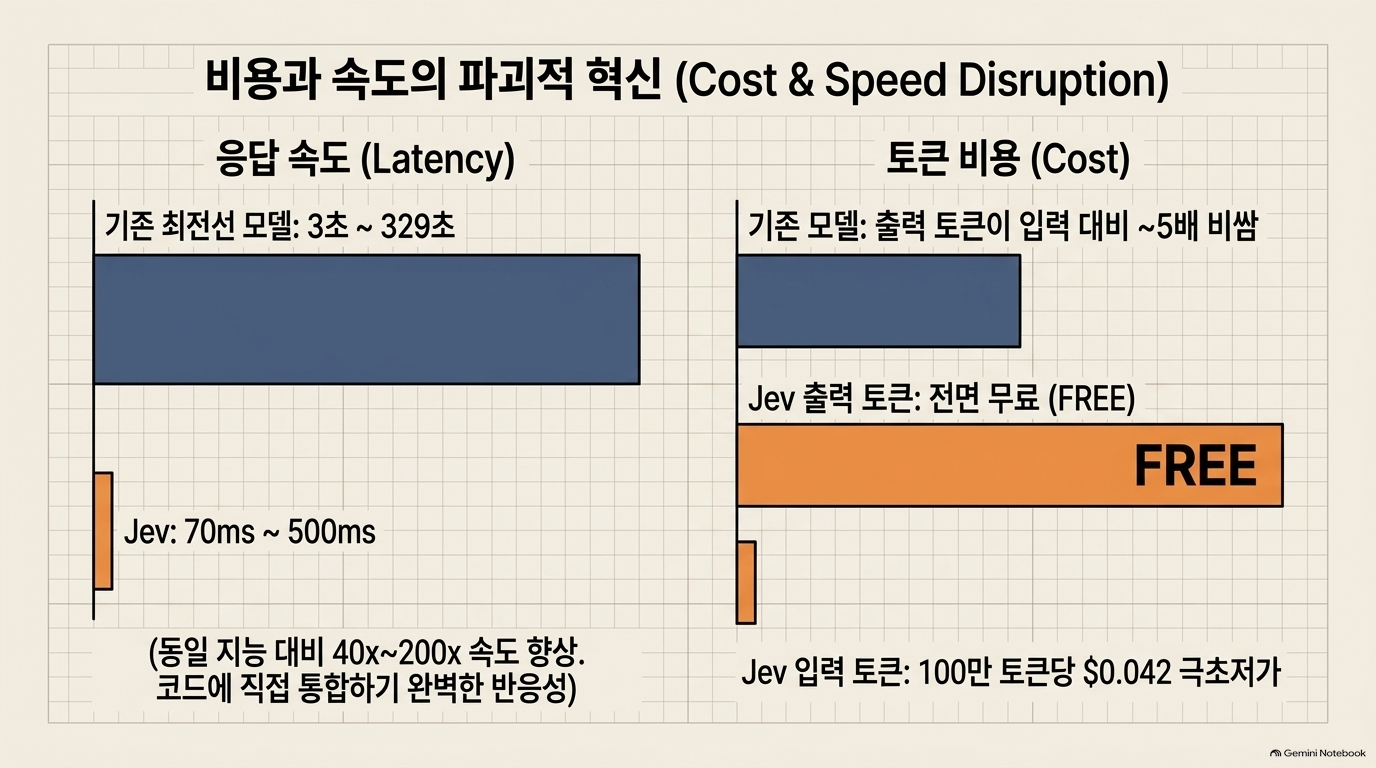
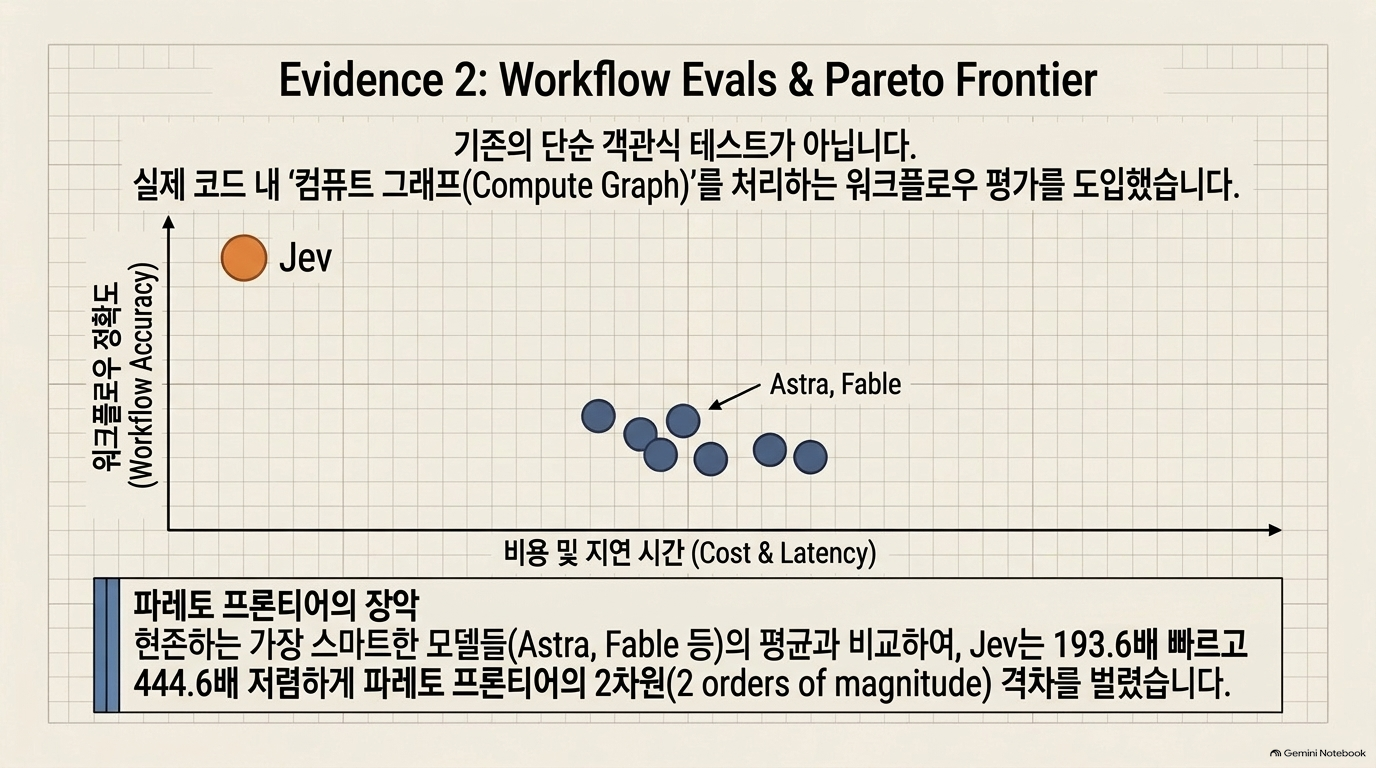
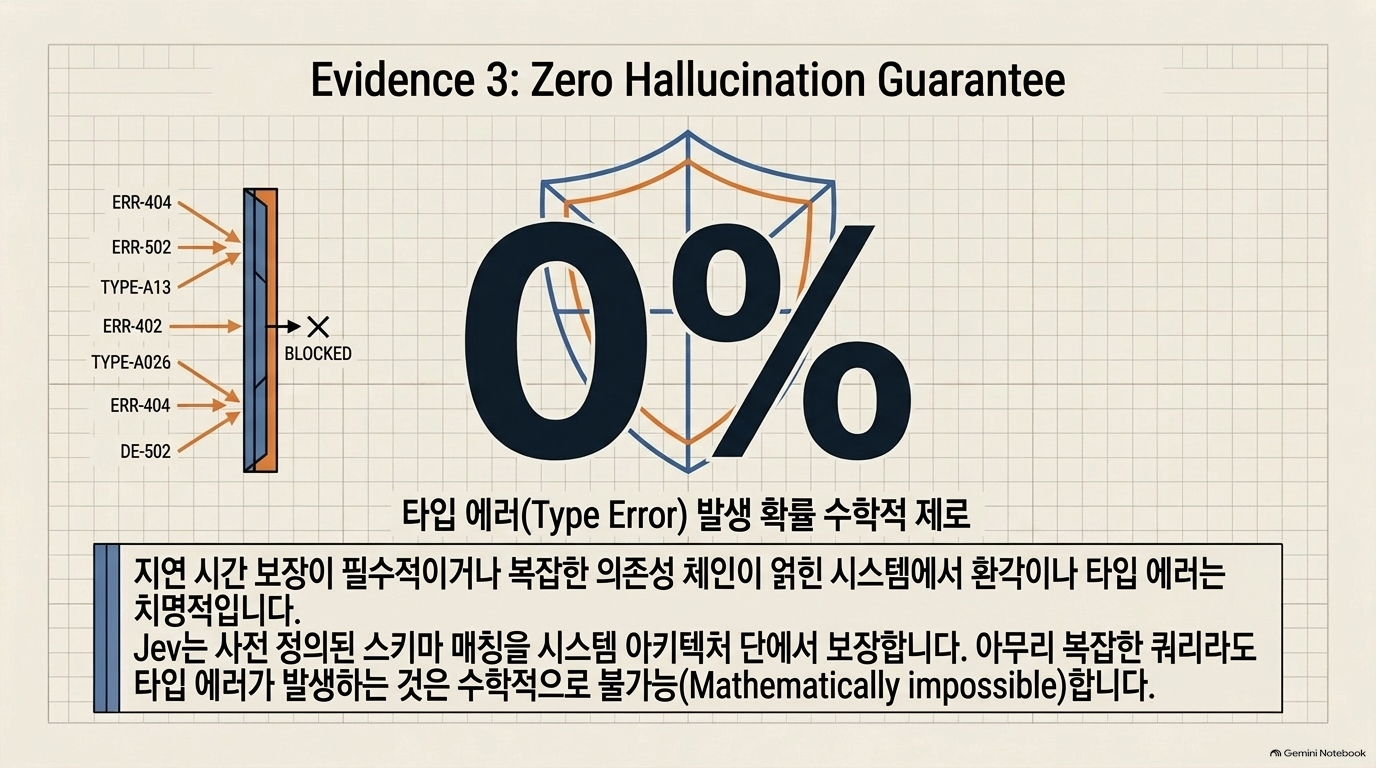
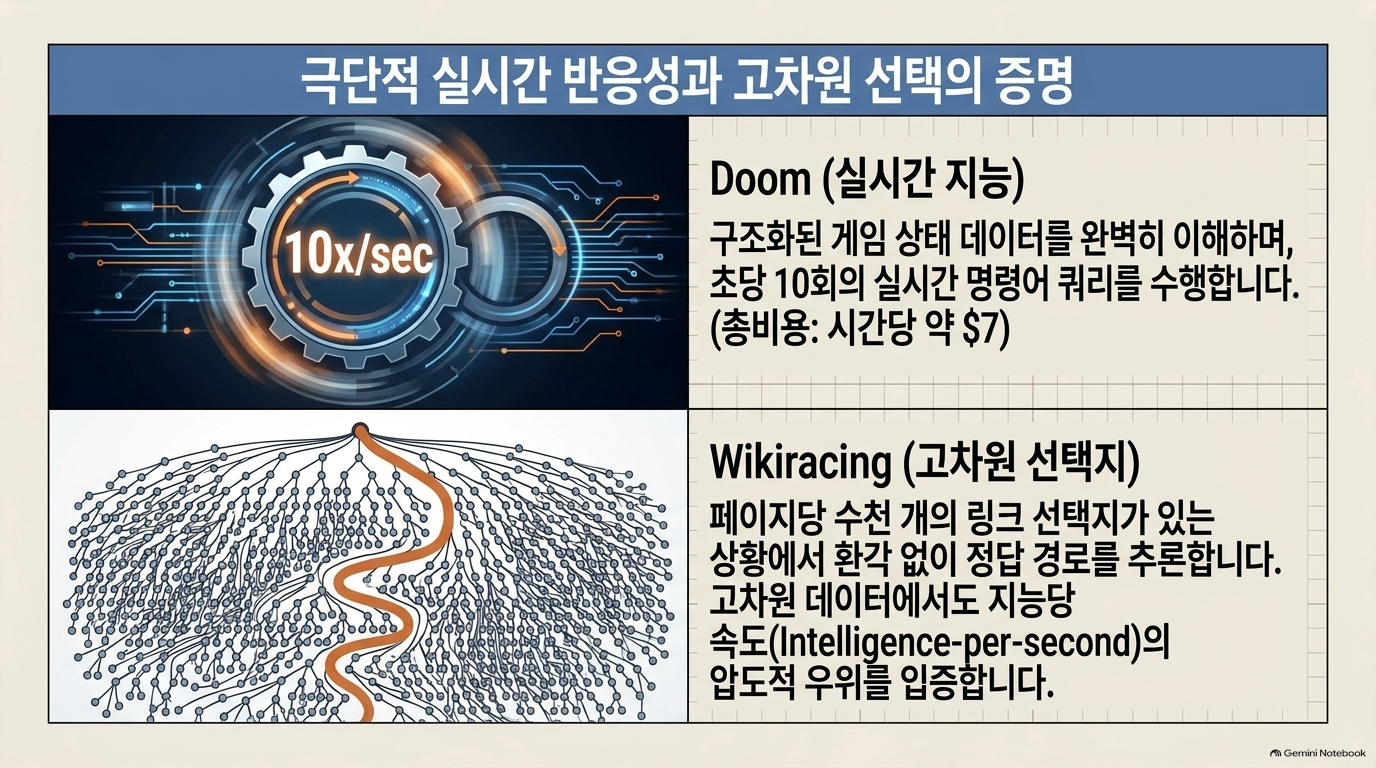
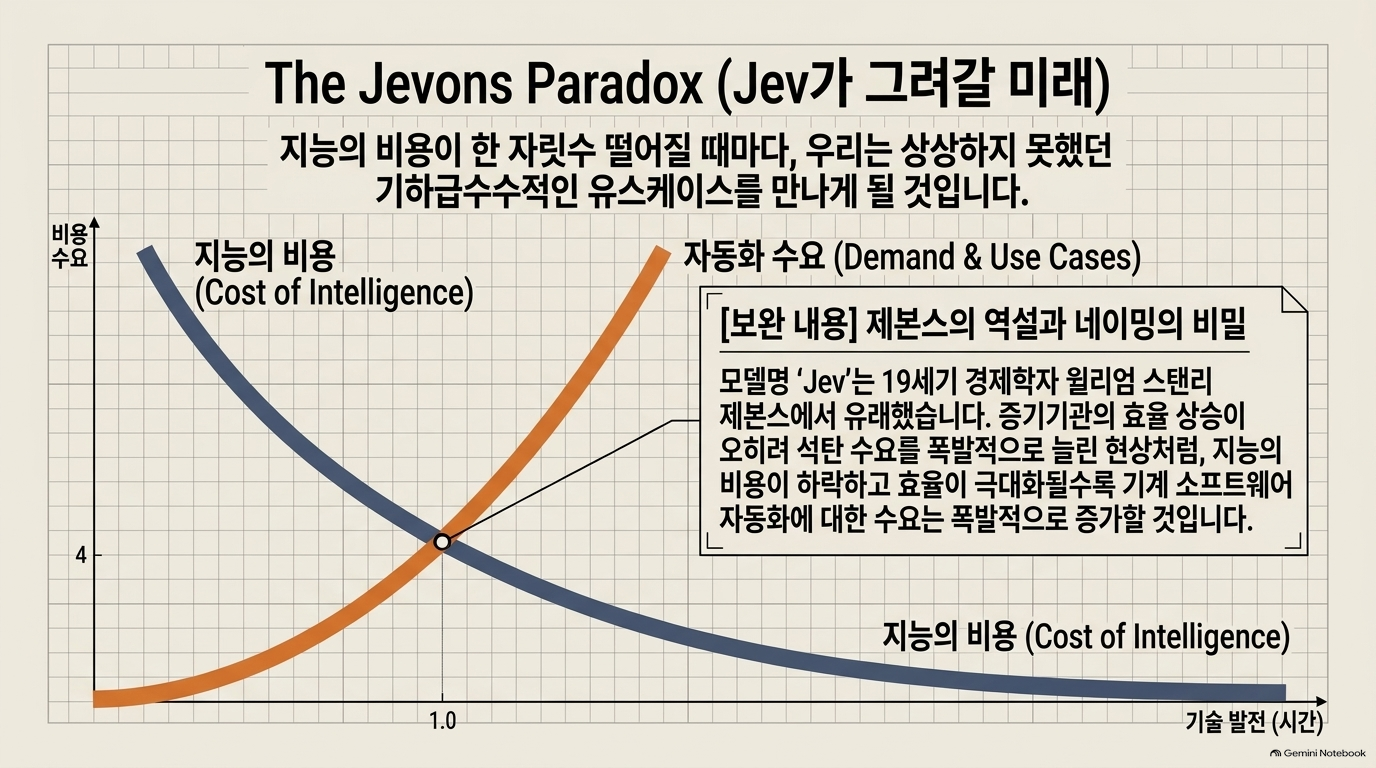
TypeSafe AI가 발표한 이 블로그 글은 기존 언어 모델의 한계를 넘어 소프트웨어 자동화에 최적화된 새로운 모델 클래스인 '시스템 원(System One)'과 그 첫 번째 모델인 '제브(Jev)'를 소개합니다. 제브는 텍스트를 생성하는 대신 미리 정의된 구조화된 데이터를 출력하도록 설계되어 인공지능의 고질적인 문제인 환각 현상을 원천적으로 차단하며, 기존 모델 대비 수백 배 빠른 속도와 저렴한 비용을 자랑합니다. 이 기술은 인간과의 대화보다는 복잡한 워크로드의 의사결정이나 실시간 데이터 처리에 특화되어 있으며, 개발자가 신뢰할 수 있는 유형 안전성(Type-safe)과 정밀한 신뢰도 점수를 제공하는 것이 핵심입니다. 결과적으로 저자는 지능의 비용을 획기적으로 낮춤으로써 실제 산업 현장의 완전한 자동화를 가속화하겠다는 포부를 밝히고 있습니다.
- “빠른 JSON LLM”이 아니라 decision API라는 주장 정확합니다. Jev는 텍스트를 생성하지 않고, 사전 정의된 Choice / Score / Noul에 대해 타입값과 확률분포를 돌려줍니다.
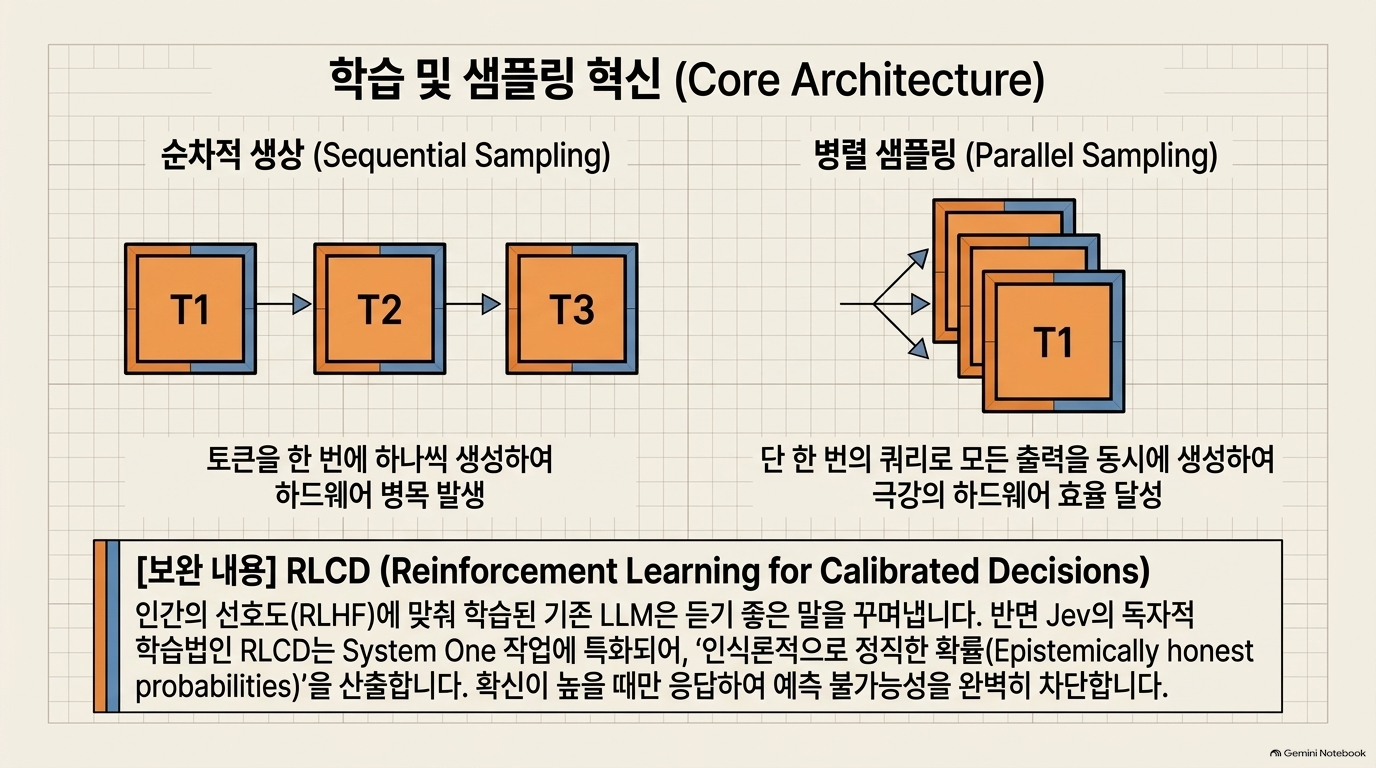
- Shared state + 다중 질문 병렬처리 가설 제품 동작과 잘 부합합니다. 공식 문서도 동일 state에 여러 질문을 넣고, 질문별로 독립·병렬 평가하며 질문 수 증가가 지연시간에 거의 영향을 주지 않는다고 설명합니다.[2] 다만 이것이 정확히 KV cache 공유인지, shared encoder인지, tree attention인지까지는 공개 정보로 확정할 수 없습니다.
- Question isolation의 중요성 아주 중요한 관찰입니다. 질문 A가 질문 B의 문구나 결론을 오염시키지 않는다면, 원자적 판단을 코드에서 조합하는 정책엔진 구조에 적합합니다. 이는 일반 LLM 프롬프트 하나에 복수 판단을 넣을 때 생기는 상호 간섭과 대비됩니다.
- 확률분포와 confidence의 구분 정확한 지적입니다. TypeSafe의 confidence는 분포의 집중도를 압축한 통계량이며, Choice·Score 응답의 확률분포에서 산출됩니다. 즉 confidence=0.9가 개별 판단의 실제 정답률 90%라는 뜻은 아닙니다.
추정으로 분리해야 할 부분
| 주장 | 판단 | 근거 수준 |
| 직접 probability readout | 공식 API 동작과 부합 | 높음 |
| Autoregressive text generation 미사용 | 공식 설명과 부합 | 높음 |
| Shared state / 질문 병렬성 | 공식 문서 및 API 동작과 부합 | 높음 |
| Question isolation | 블랙박스 실험 및 문서 주장 | 중간~높음 |
| Listwise option decision | 옵션 추가 시 분포 변화 관찰에 기반 | 중간 |
| KV cache 공유 | 합리적 serving 가설이나 비공개 | 중간 |
| Causal decoder / pointer head | 공개 증거 부족 | 낮음 |
| Sparse MoE | 속도·업계 추세에서 유추한 가설 | 낮음 |
특히 “Sparse MoE Transformer”는 현 단계에서 사실로 쓰면 안 됩니다. 회사가 아키텍처와 RLCD 학습 세부를 공개하지 않았고, API 관찰만으로 MoE를 식별할 방법은 제한적입니다.
핵심 보완점
이 글의 “Jev는 LLM이 아니다”라는 문구는 제품·인터페이스 관점에서는 유효하지만, 연구적으로는 다소 강합니다.
더 정확한 표현은 다음입니다.
Jev는 LLM 계열의 언어 이해 역량을 활용할 수 있으나, 자기회귀 텍스트 생성 대신 제한된 선택공간의 확률적 의사결정에 최적화된 System One 모델이다.
즉, 생성 모델과 분류기 사이의 이분법보다는 다음 스펙트럼에 가깝습니다.
textCopy
전통 분류기
└ 고정 레이블·고정 입력 특성
System One / Jev
└ 자연어 state + 자연어 질문/선택지
└ 구조화된 확률분포 출력
└ 코드 기반 정책 조합
일반 LLM
└ 자연어 state + 자유 생성
└ 설명·코드·추론·대화
연구적으로 더 중요한 질문
이 글의 구조 가설보다 우선 검증해야 할 것은 다음 세 가지입니다.
- 확률 보정성: p=0.8인 표본군에서 실제 정답률이 정말 약 80%인가? ECE, classwise ECE, Brier score, NLL, reliability diagram으로 업무·선택지·기관별 검증이 필요합니다.
- 분포 이동 안전성: 법령·정책 변경, 새 문서 양식, OCR 오류, 한국어 혼합문서, adversarial prompt에서 보정성과 정확도가 얼마나 붕괴하는가? In-domain 보정만으로는 충분하지 않습니다.
- 워크플로우 수준 안전성: 원자 질문 각각이 잘 보정되어도 여러 확률을 규칙으로 조합한 최종 action이 보정된다는 보장은 없습니다. 따라서 질문 단위뿐 아니라 최종 정책결정 단위의 risk-coverage 및 기대손실을 측정해야 합니다.
종합 판단
이 글은 Jev를 “말을 생성하지 않는 확률 기반 decision engine”으로 이해하는 데 매우 유용합니다. 특히 Shared state, question isolation, listwise option interaction은 실제 PoC에서 검증할 가치가 큰 가설입니다.
다만 아키텍처를 단정하기보다 아래처럼 증거 수준을 분리하는 것이 연구·감리 문서에는 적절합니다.
- 확인: 타입 안전 출력, 텍스트 비생성, 병렬형 다중 판단 API
- 유력 가설: shared state 처리, 질문 격리, 옵션 간 공동 판단
- 확인 필요: KV cache 설계, decoder/head 구조, Sparse MoE, RLCD 목적함수·학습데이터


'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 하네스 엔지니어링 - Software Factories, Light and Dark (0) | 2026.09.21 |
|---|---|
| 에이전트 AI - Tool 선택 판단 기준: Claude Code, Codex and Cursor (0) | 2026.09.20 |
| 에이전트 AI - Gavel: 혁신적 LLM 라우팅 기술 (0) | 2026.09.20 |
| 에이전트 AI - 재귀적 자기 개선(RSI) 자율성 5단계 개요 및 대표 시스템 (0) | 2026.09.20 |
| 에이전트 AI - IBM Research, ALTK-Evolve: 에이전트 일관성 격차 프레임워크 (0) | 2026.09.20 |