https://arxiv.org/pdf/2609.15982
2026.9.14
[The Router Within: Eliciting Native Skill Routing from a Frozen LLM]
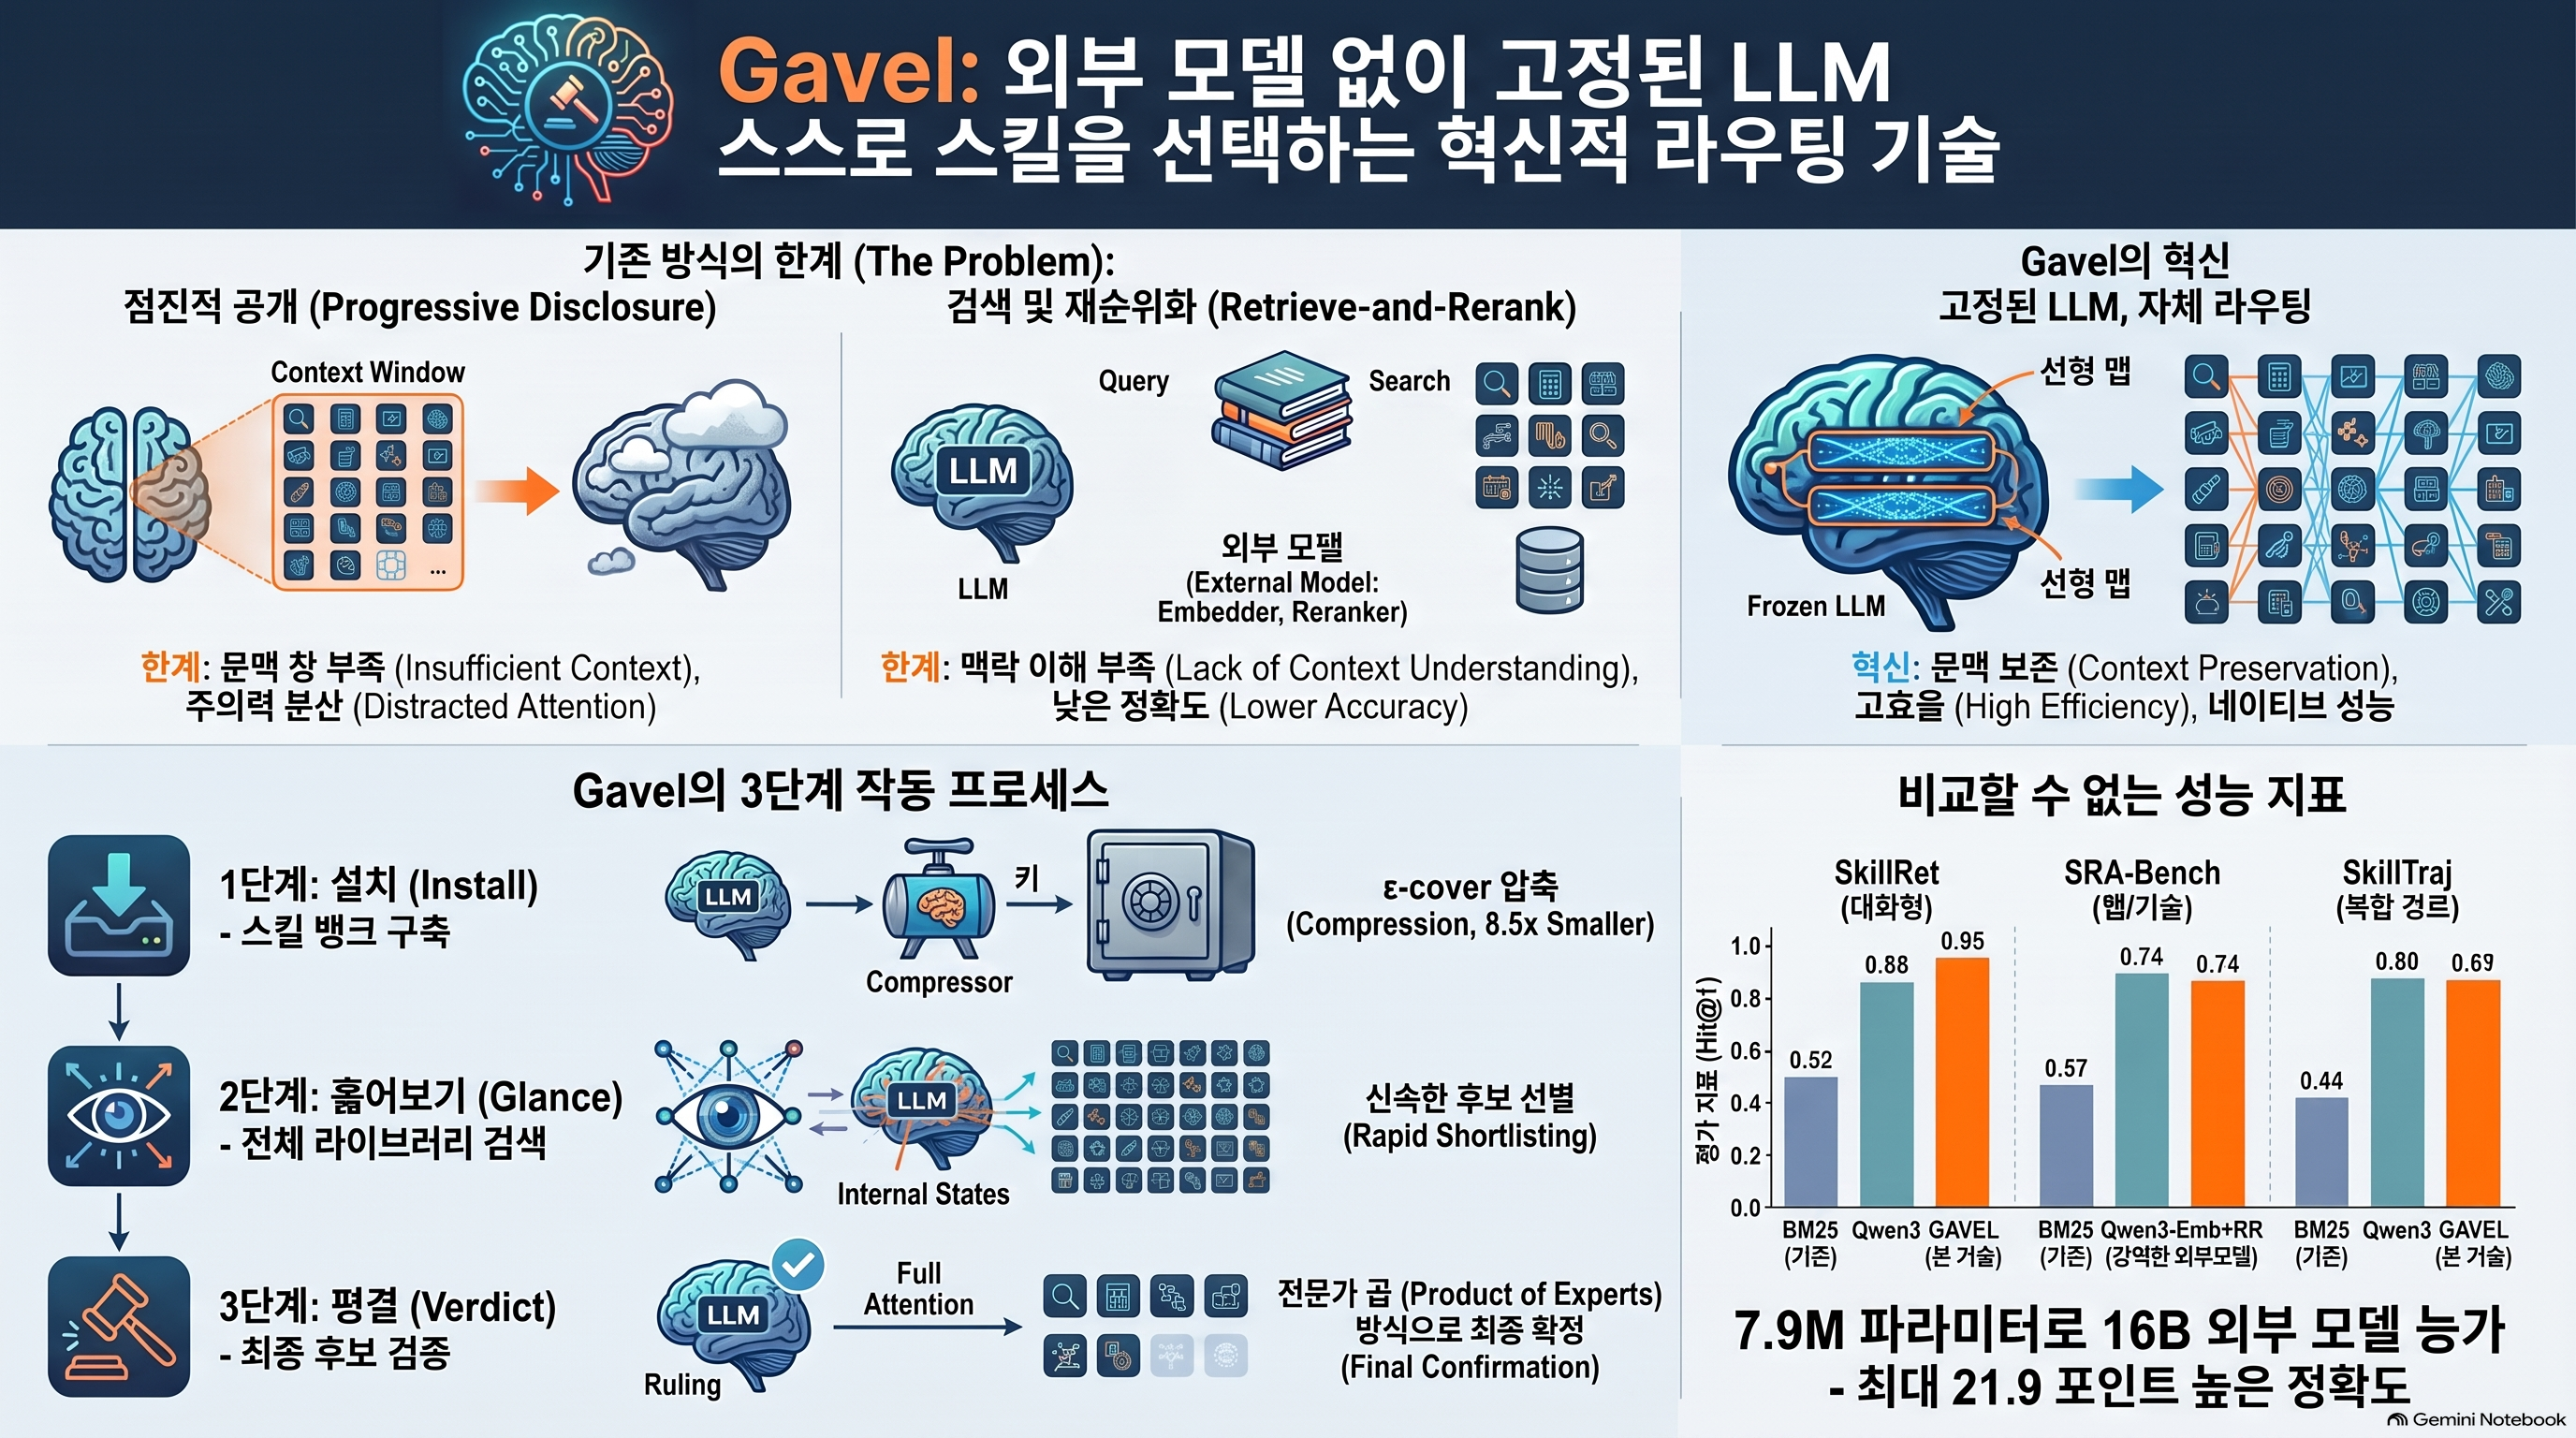
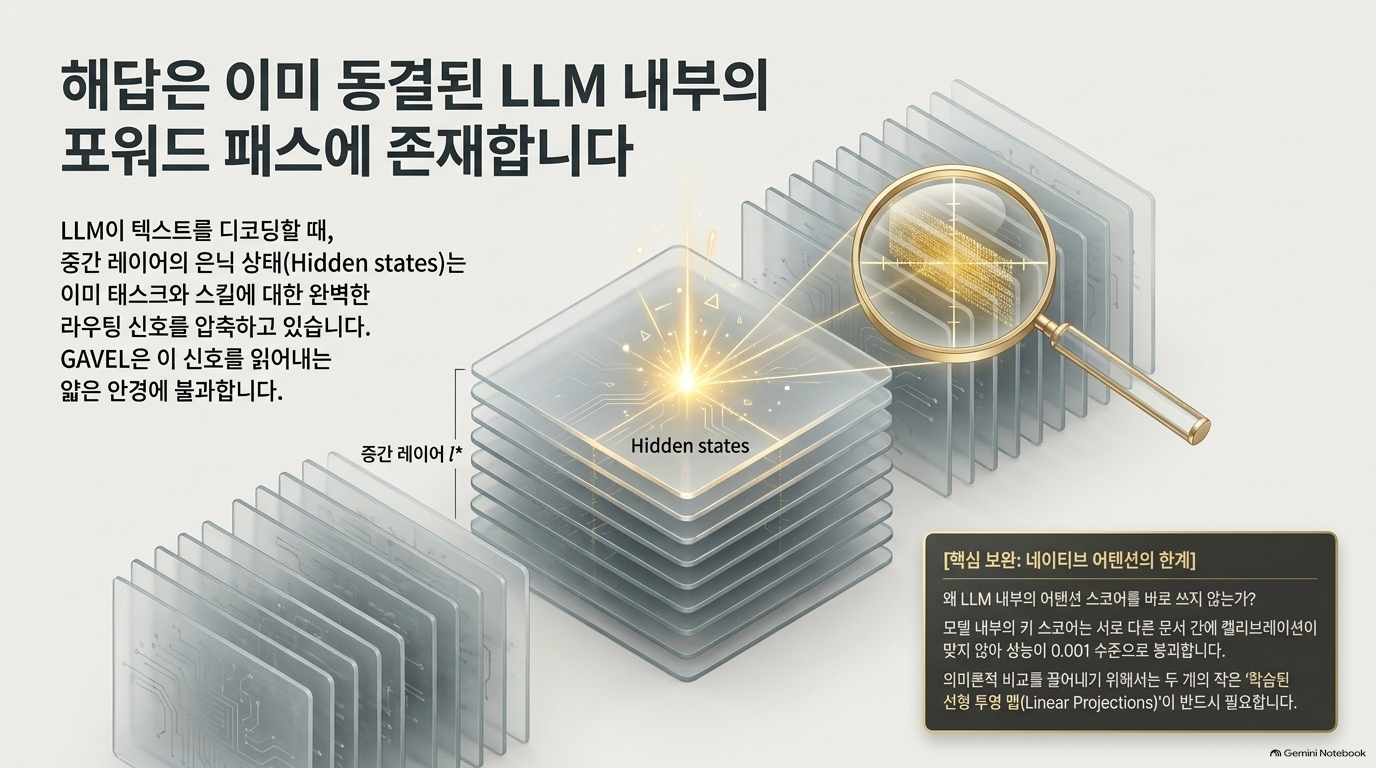
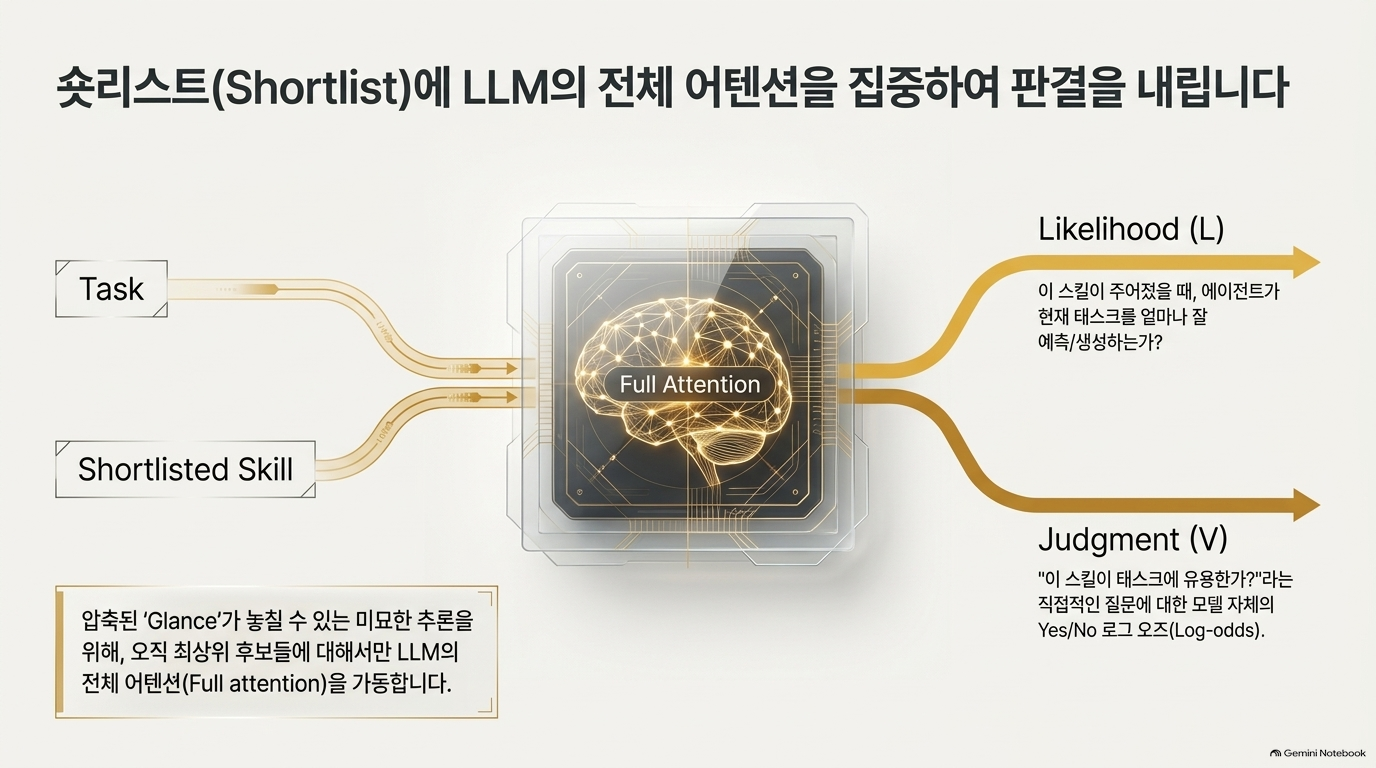
이 자료는 동결된 대규모 언어 모델(LLM)이 별도의 외부 모델 없이도 자신의 내부 신호를 활용하여 필요한 기술을 직접 선택할 수 있게 해주는 Gavel 프레임워크를 소개합니다. 기존의 방식은 수많은 기술 설명을 문맥창에 모두 집어넣어 모델의 집중력을 분산시키거나 외부 검색 모델에 의존해 정확도가 떨어지는 한계가 있었으나, Gavel은 모델 내부의 중간층 상태를 읽어내는 두 개의 선형 투영만으로 이 문제를 해결합니다. 시스템은 먼저 전체 라이브러리를 빠르게 훑는 Glance 단계와 상위 후보군을 정밀하게 검토하는 Verdict 단계를 거치며, 이를 통해 문맥창을 깨끗하게 유지하면서도 대용량 라이브러리에서 최적의 기술을 찾아냅니다. 결과적으로 Gavel은 고성능 외부 파이프라인보다 적은 연산량으로도 작업 수행 중 실시간 기술 호출 성능을 대폭 향상하며, 모델 자체의 지능이 높아질수록 기술 선택 능력도 함께 진화하는 구조적 우아함을 보여줍니다.
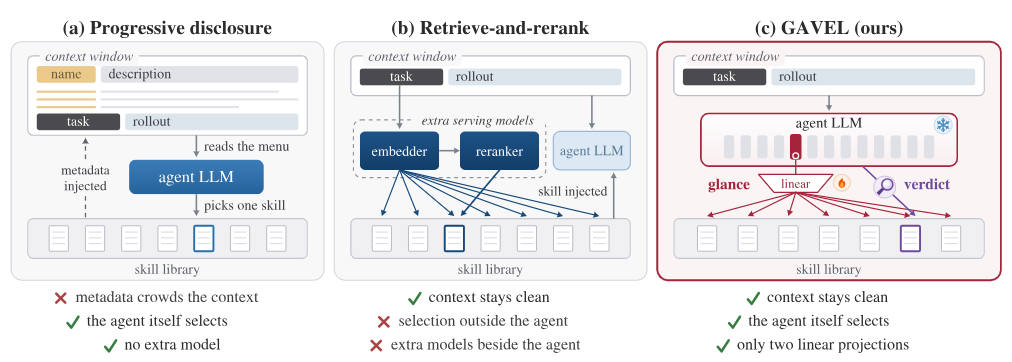
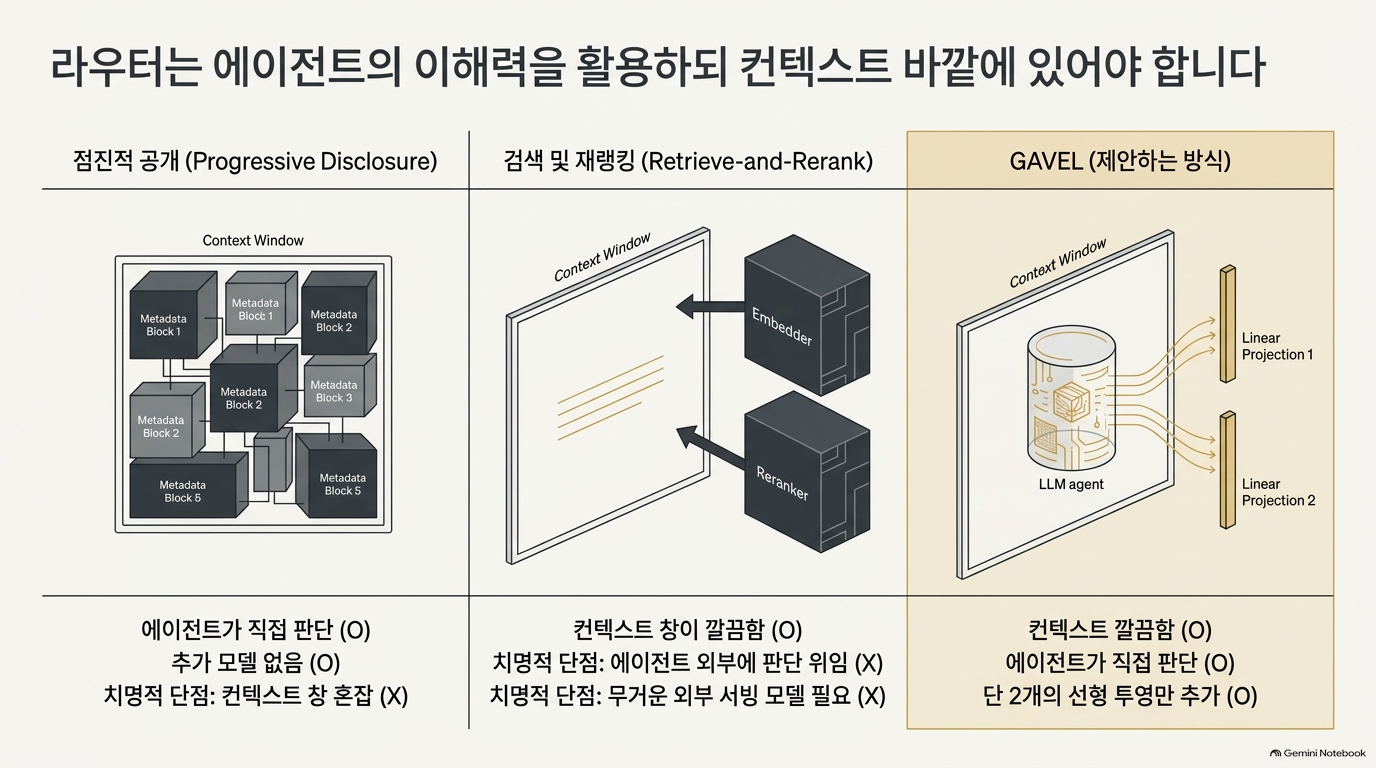
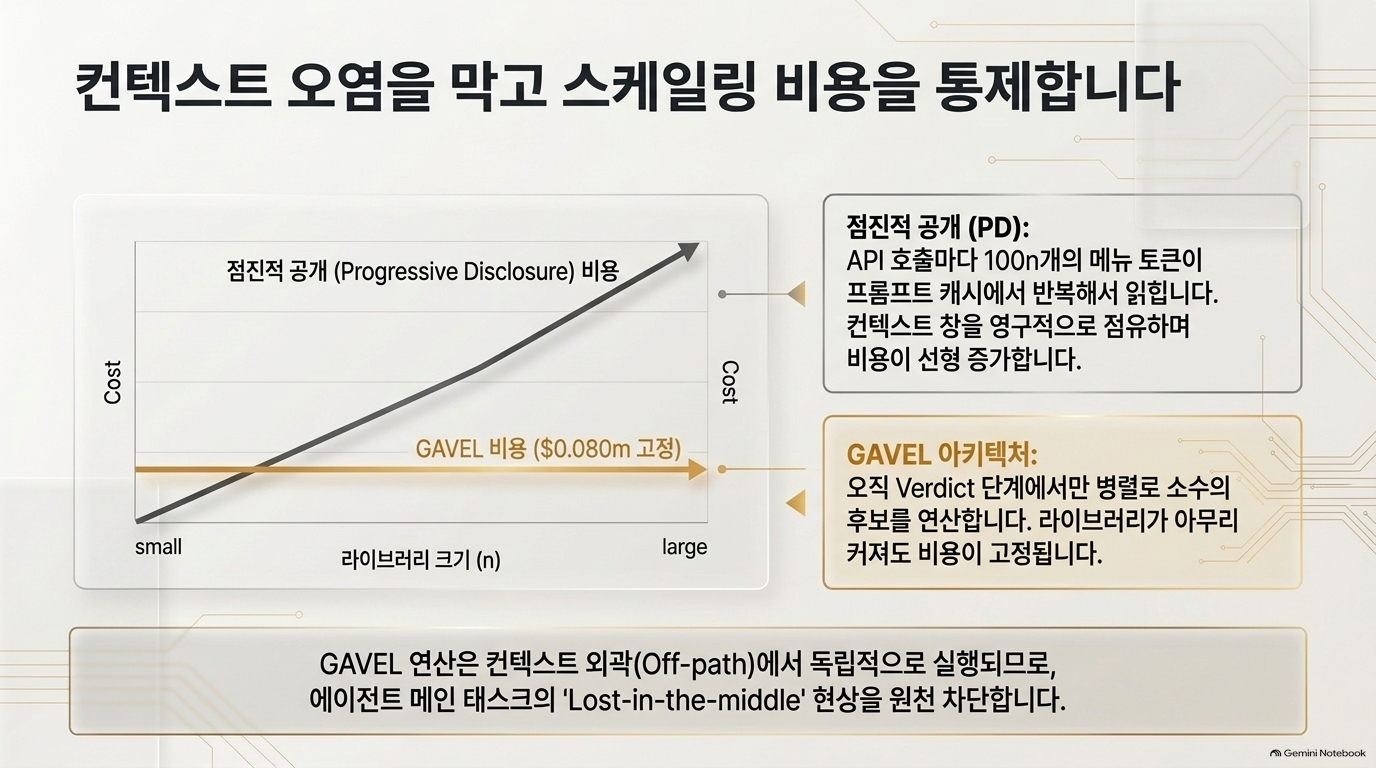
그림 1:스킬 라우팅을 위한 세 가지 설계 방식. (a) 점진적 공개 방식은 모든 스킬의 메타데이터를 프롬프트에 미리 로드하여 컨텍스트를 복잡하게 만듭니다. (b) 검색 및 재순위 지정 방식은 컨텍스트를 깔끔하게 유지하지만, 선택은 배포 환경에 노출되지 않는 외부 모델에 맡깁니다. (c) 고정된 에이전트 LLM 자체를 사용하는 Gavel 라우팅 방식: 전체 라이브러리를 훑어보고, 하나의 중간 계층 상태에서 두 개의 학습된 선형 맵을 통해 정보를 읽어들인 다음, 동일한 모델이 상위 후보들을 전체적으로 검토하여 최종 결정을 내립니다.
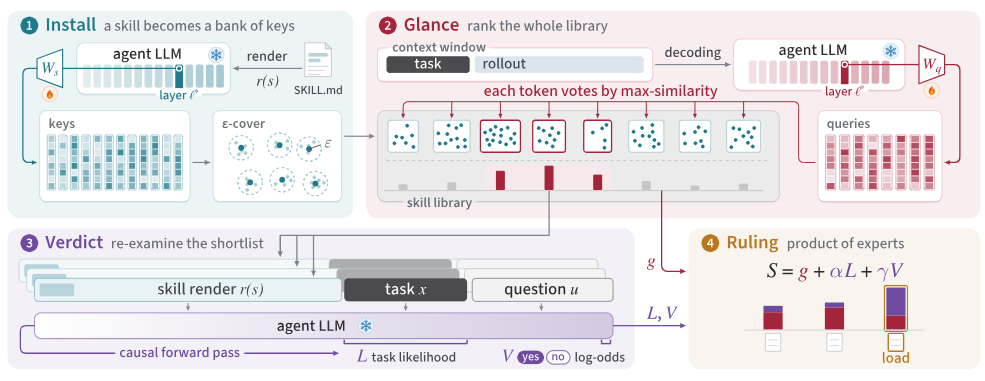
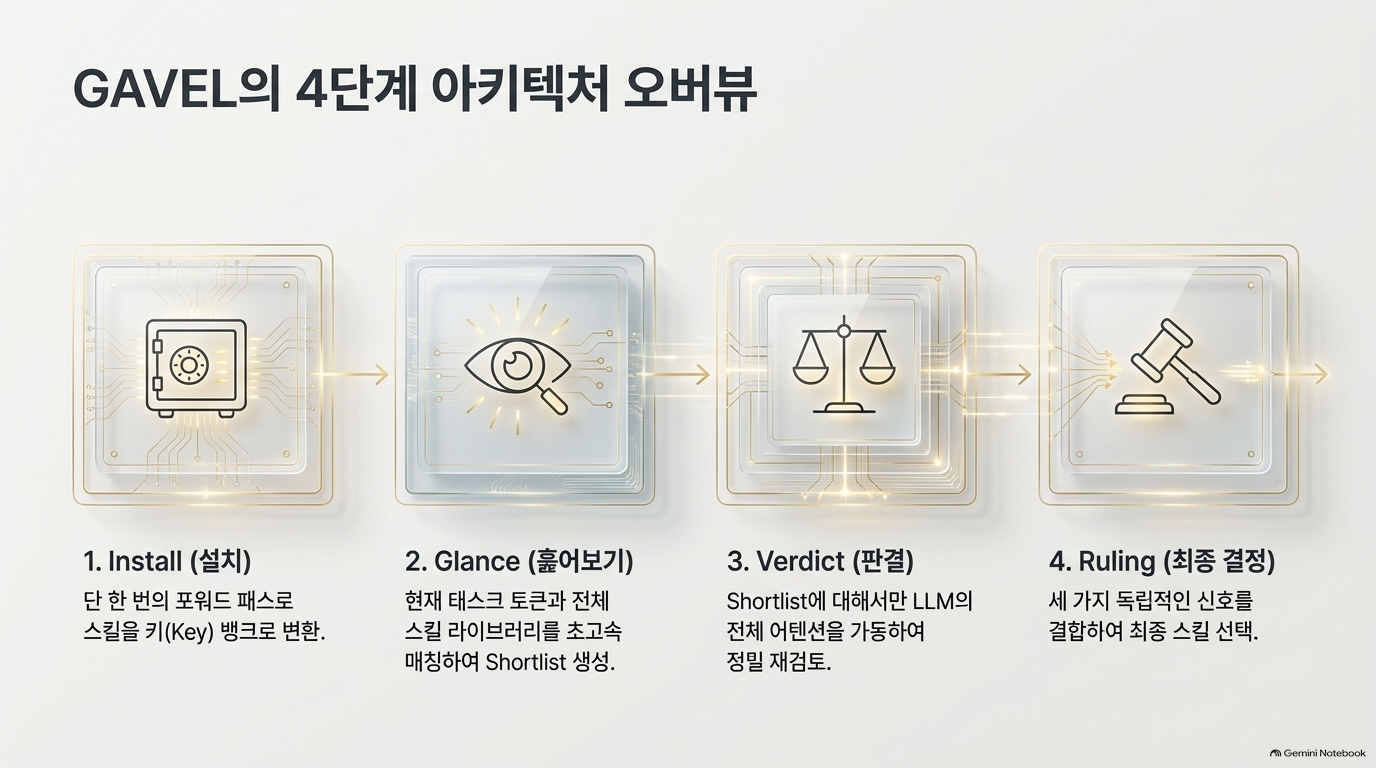
그림 2:Gavel 파이프 라인. 설치 방법 :W에스새로운 스킬의 레이어를 매핑합니다.ℓ∗동결된 에이전트 LLM의 상태는 다음과 같이 얇아진 키 뱅크로 변환됩니다.ε-표지. 한눈에 보기 :W큐모델이 디코딩하는 것과 동일한 레이어를 읽습니다. 각 작업 토큰은 모든 뱅크에 걸쳐 최대 유사도를 기준으로 투표하여 전체 라이브러리의 순위를 매깁니다. 결론 : 모델은 최종 후보에 오른 각 스킬을 작업에 대해 재검토하여 작업의 성공 가능성을 부여합니다.엘그리고 예/아니오 로그 확률다섯판결 : 전문가들의 검토와 판단을 통해 필요한 기술을 선정합니다.
결론
Gavel은 “LLM이 Skill을 고르게 하는” 기존 prompt 기반 라우팅에서 한 단계 이동해, 동결된 에이전트 LLM의 hidden state를 직접 읽어 대규모 Skill 라이브러리를 라우팅하는 구조입니다. 핵심 혁신은 외부 embedder/reranker를 별도로 두지 않고, 에이전트 백본 자체의 추론 능력을 경량 read-out으로 활용한다는 점입니다.[1]
기술 구조: Glance → Verdict → Ruling
| 단계 | 기능 | 구현상 의미 |
| Install | Skill 문서별 중간층 hidden state를 한 번만 계산하여 key bank 구축 | 신규 Skill은 재학습 없이 1회 forward pass로 등록 |
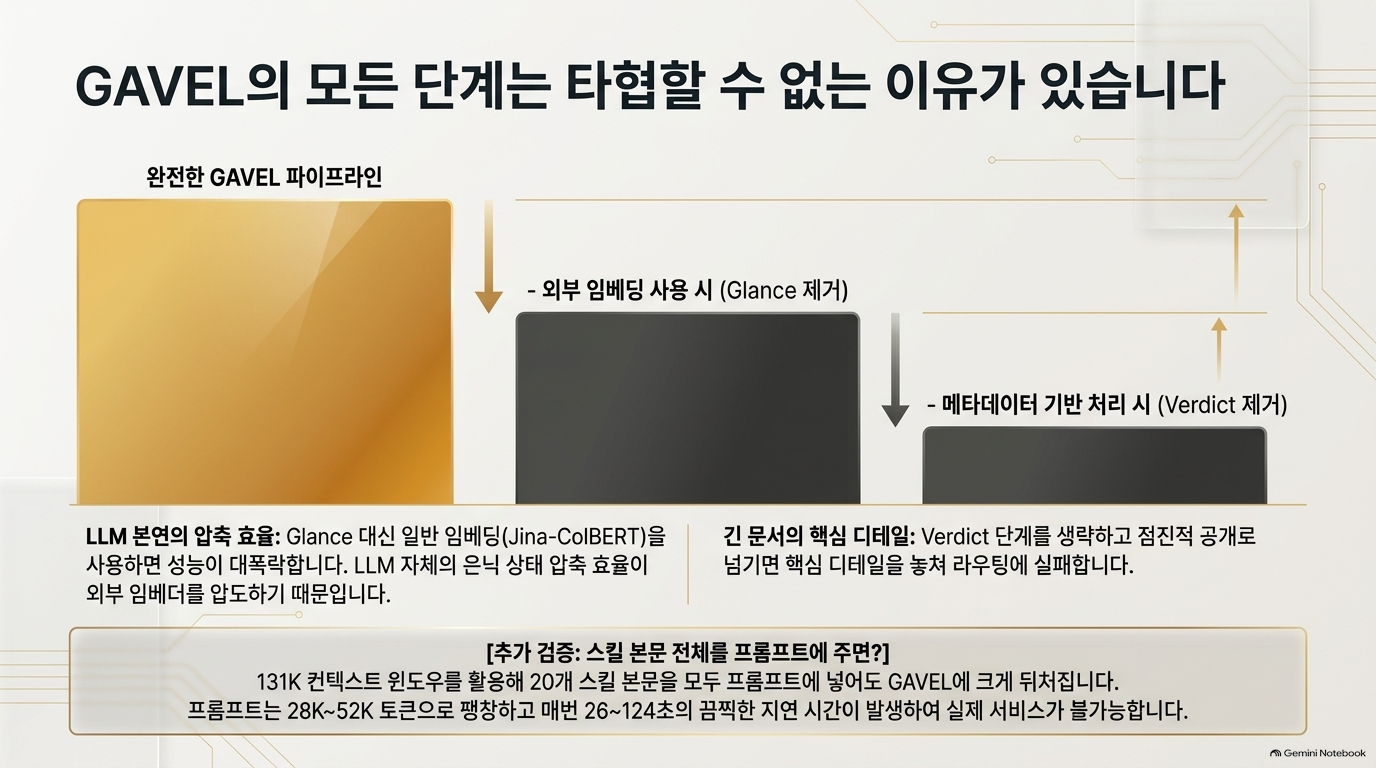
| Glance | task/rollout token과 Skill key bank를 token-level late interaction으로 전수 비교 | 대규모 라이브러리를 context에 넣지 않고 후보군 선정 |
| Verdict | shortlist에 대해서만 Skill 본문+현재 문맥을 함께 본 forward pass 수행 | task likelihood와 “이 Skill이 필요한가” yes/no log-odds 산출 |
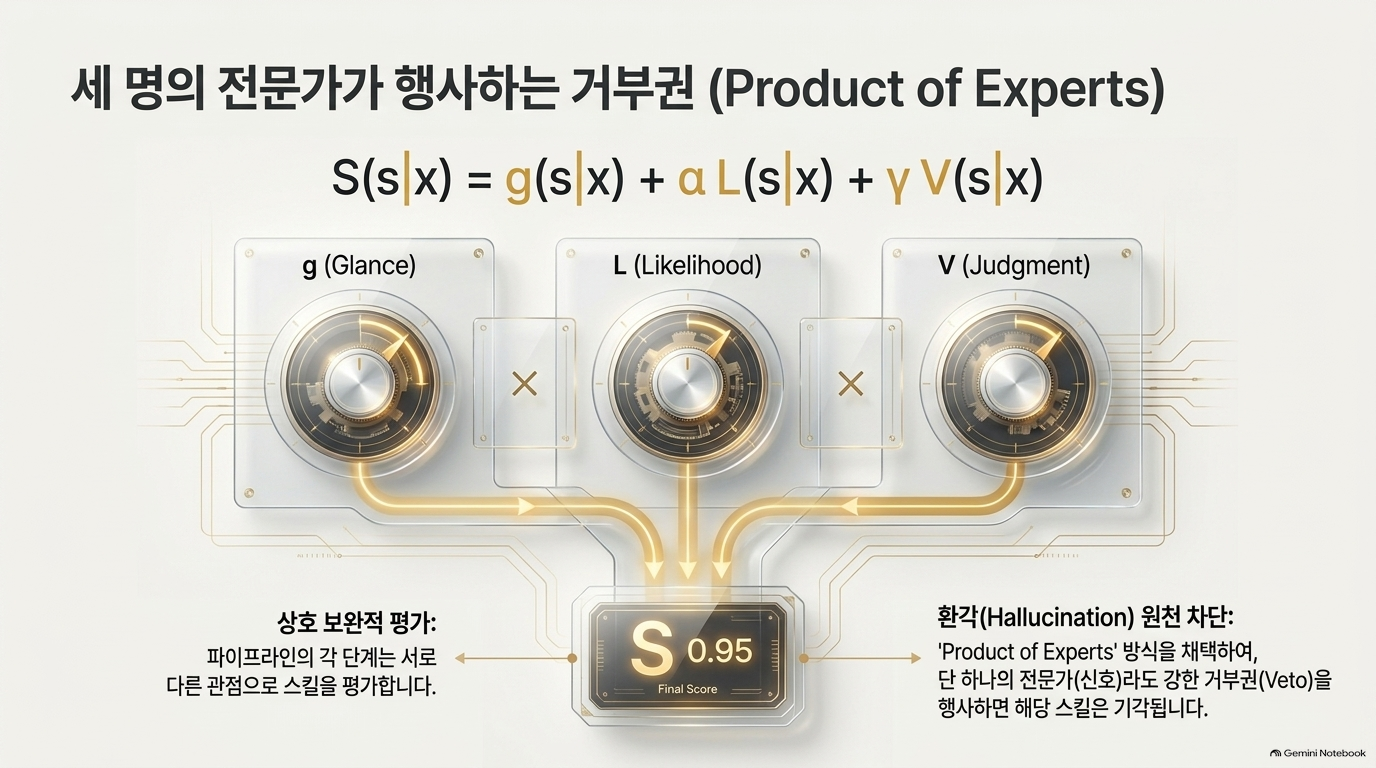
| Ruling | S = g + αL + γV product-of-experts 결합 | 한 점수만 높은 후보가 아니라 상호 검증되는 Skill을 선택 |
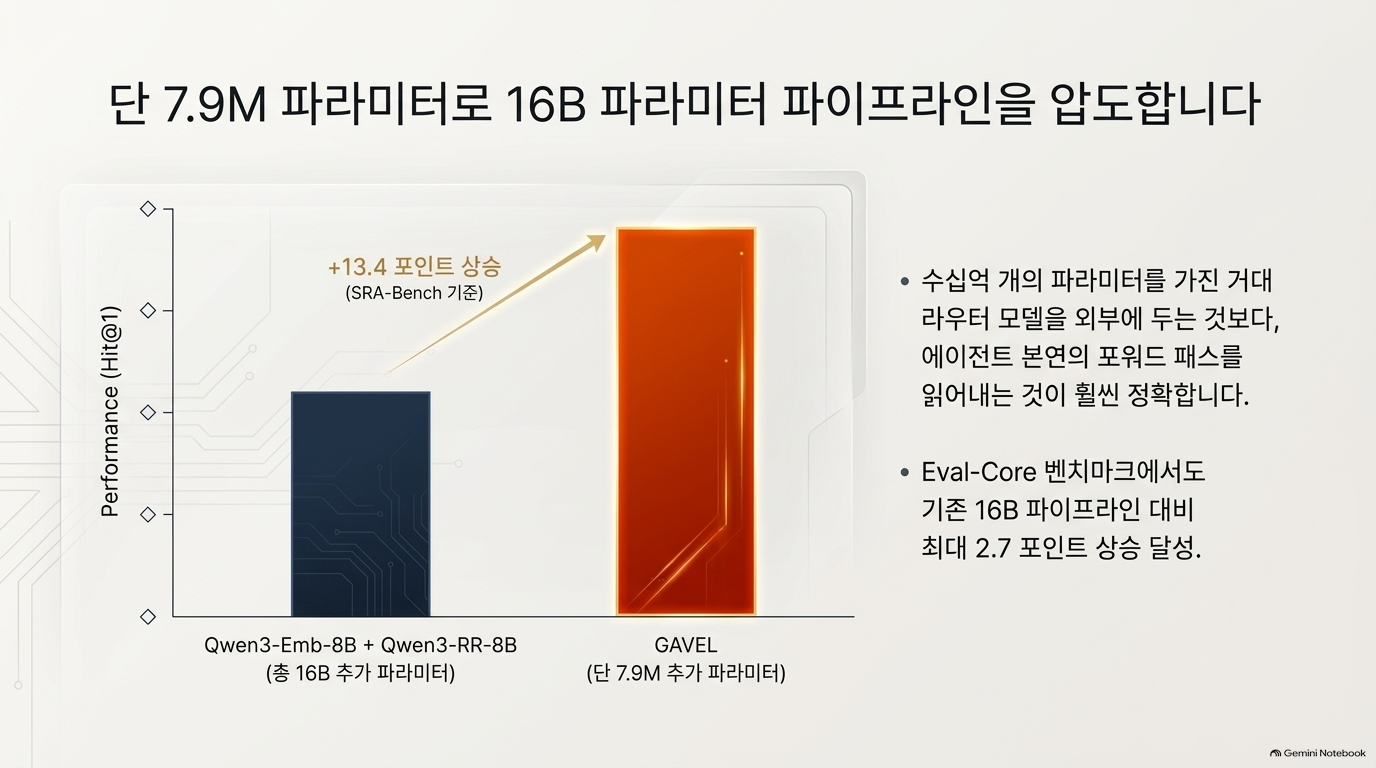
여기서 학습되는 것은 query/key 선형 projection 두 개, 총 7.9M 파라미터뿐이고 Qwen3-32B 백본은 고정합니다. Skill bank는 ε-cover 압축으로 약 8.5배 축소하며, 평균적으로 약 9개 후보만 Verdict로 재평가합니다.[1]
기존 접근 대비 혁신성
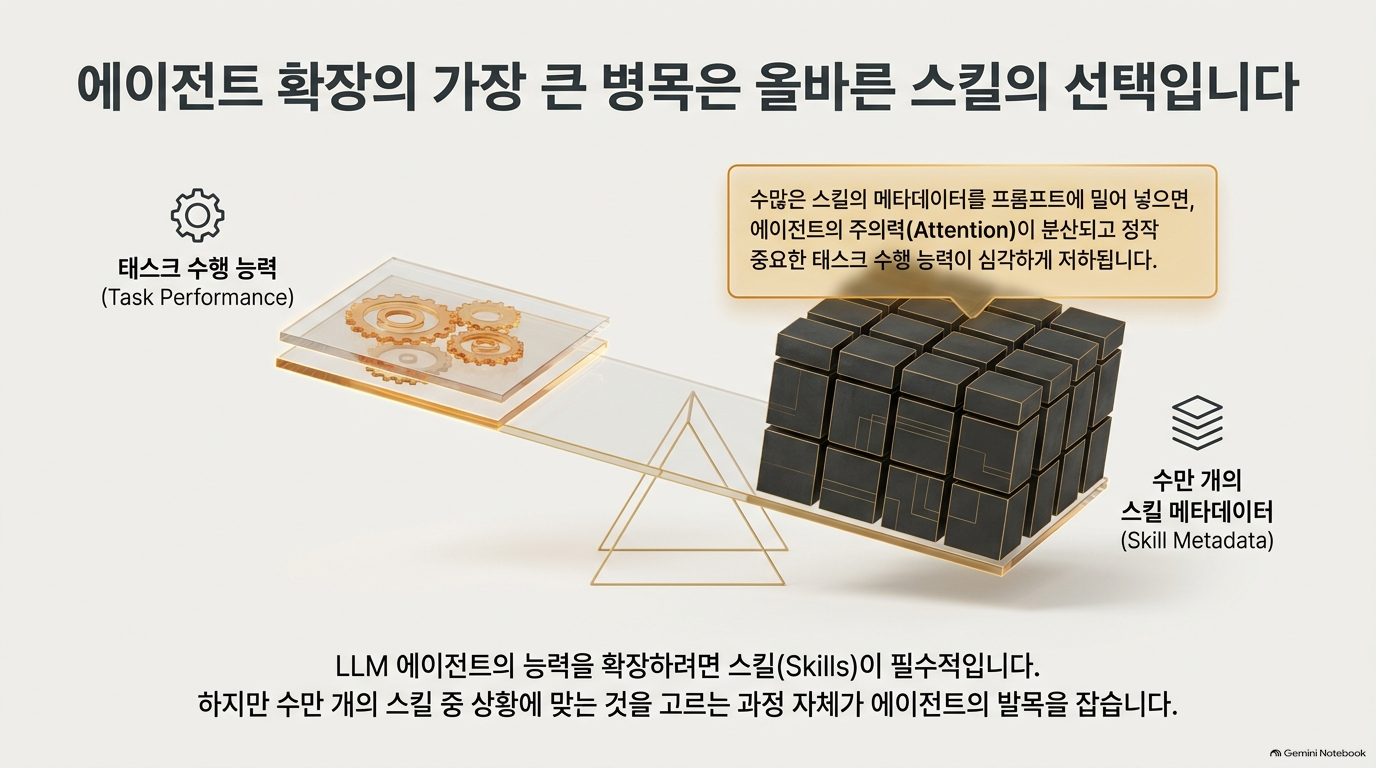
- Progressive disclosure의 context 오염 회피 기존 방식은 모든 Skill의 이름·설명을 system prompt에 투입합니다. 라이브러리 규모에 비례해 context를 점유하고, 모델 주의(attention)를 분산시키며, Skill 본문이 아닌 metadata만으로 선택하게 됩니다. Gavel은 선택 전까지 Skill 텍스트를 현재 agent context에 넣지 않습니다.[1]
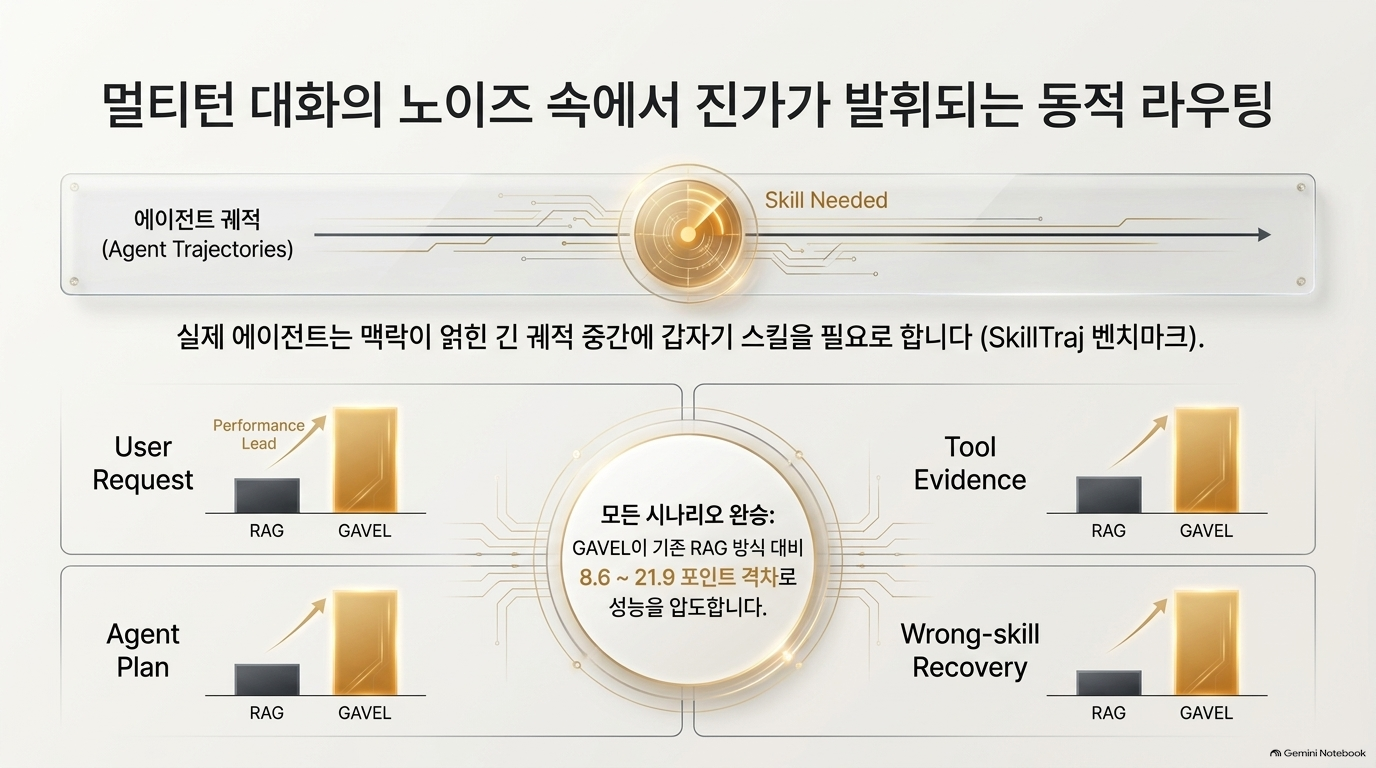
- Retrieve-and-rerank의 ‘에이전트 이해력 단절’ 보완 기존 RAG형 라우팅은 embedder와 reranker가 선택을 대행합니다. 반면 Gavel은 에이전트가 이미 생성 중인 hidden state를 활용하므로, 특히 tool 결과·직전 계획·실패한 Skill 등으로 필요성이 mid-rollout에 발생하는 상황을 더 잘 포착하려는 설계입니다.[1]
- ColBERT 계열 late interaction의 agent-native 전환 Glance는 각 task token과 Skill token의 최대 유사도를 사용하는 late interaction이라는 점에서 ColBERT의 계보에 있습니다. 다만 ColBERT는 별도 retrieval encoder를 학습하는 반면, Gavel은 실행 중인 agent LLM의 중간표상을 두 선형 map으로 읽어낸다는 차이가 본질적입니다.[1][2]
- Tool-token 학습 방식보다 동적 라이브러리에 적합 ToolkenGPT는 도구를 특수 token embedding으로 표현하지만 tool 추가에 학습 문제가 따라옵니다. Gavel은 Skill 추가 시 forward indexing만 수행하므로, 변경이 잦은 Skill/MCP catalog에 더 운영 친화적인 방향입니다.[1][3]
보고된 성능과 해석
- 서면 task 벤치마크에서 강한 retrieve-and-rerank pipeline 대비 SkillRet +3.8pt, SRA-Bench +13.4pt, Eval-Core +1.3~2.7pt Hit@1 개선을 보고합니다.[1]
- 저자 신설 SkillTraj(시뮬레이션된 372개 agent trajectory)에서는 rollout 중 Skill 필요성이 생기는 4개 상황에서 타 방식 대비 +8.6~21.9pt를 보고합니다.[1]
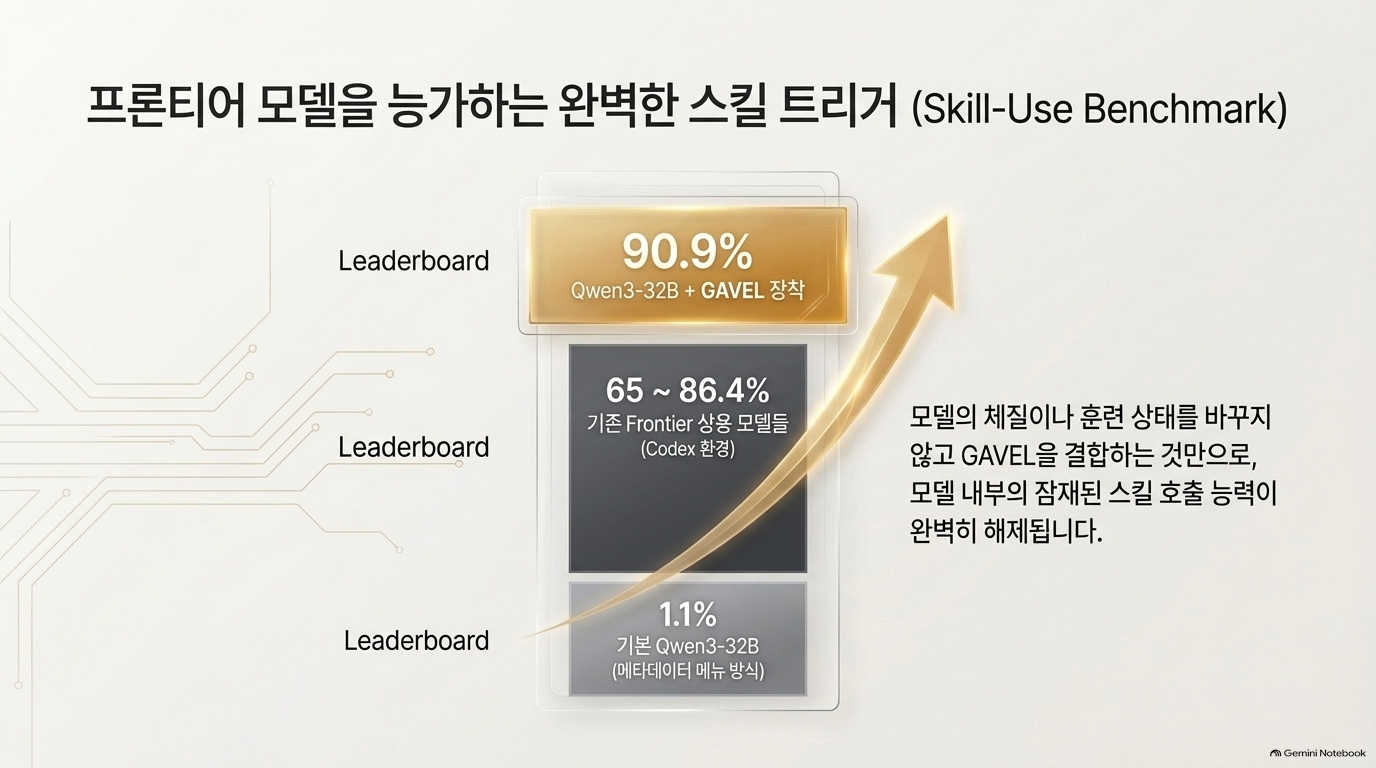
- end-to-end Skill-Use(177개 실행 task)에서 Qwen3-32B+Gavel의 올바른 Skill trigger 비율은 0.909이며, 동일 Qwen3-32B의 progressive disclosure 기준 0.011보다 크게 높습니다. 단, 이 수치는 서로 다른 harness 조건이 포함되어 있으므로 “모델 자체 성능 우위”보다는 라우팅/trigger 메커니즘의 효과로 해석해야 합니다.[1]
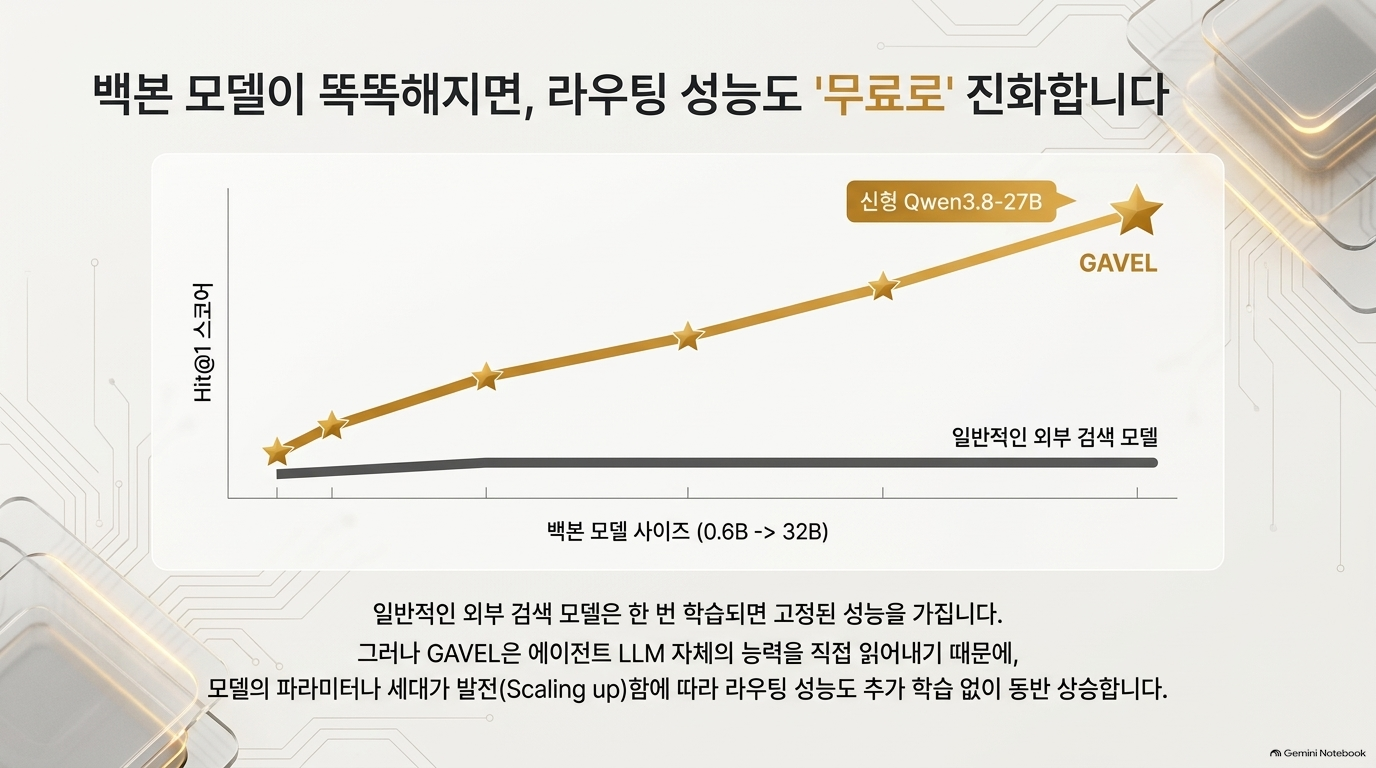
- 논문은 백본이 강해질수록 Gavel 성능도 향상된다고 보고합니다. 이는 외부 retriever 고정 성능에 매이지 않고 백본 개선을 라우팅 품질로 전이할 수 있다는 주장입니다.[1]
연구 동향상 위치
Gavel은 LLM 라우팅 연구가 다음의 3단계에서 4단계로 이동하는 신호로 볼 수 있습니다.
- Prompt menu: Skill metadata를 context에 나열하고 모델이 직접 선택
- Retriever + reranker: 외부 dense retrieval로 후보를 찾고 재정렬
- Learned tool token / API token: tool call 자체를 생성 token화
- Native representation routing: LLM의 중간표상을 읽어 context 외부에서 라우팅 — Gavel
향후 직접 파급 가능성이 큰 영역은 다음입니다.
- 수천~수만 개의 Agent Skill catalog
- MCP server / tool 선택 및 동적 discovery
- memory bank, policy/playbook, workflow template 라우팅
- 공공 AI 업무에서 업무유형별 지침·법령·점검표의 동적 로딩
[확인 필요] 한계와 도입 판단
| 검토 항목 | 판단 |
| 재현성 | 2026-09-14 공개된 arXiv v1 preprint이며, 현재 Semantic Scholar 인용은 0건입니다. 독립 재현·후속 검증 전에는 선도 연구로 보되, 확정적 우위로 판단하면 안 됩니다.[1] |
| 벤치마크 편향 | SkillTraj는 저자가 만든 372개 simulated trajectory입니다. 실제 운영 로그, 조직 고유 Skill, 다중 Skill 조합·순서 의존 업무에서의 검증이 필요합니다.[1] |
| 백본 접근성 | Glance는 중간 hidden state와 KV/cache 수준의 접근을 전제합니다. 현재 일반 상용 LLM API만 사용하는 환경에서는 고객 측 구현이 곤란하고, 모델 제공자 또는 self-hosted inference 계층 지원이 필요합니다.[1] |
| 운영비/지연 | 전수 Glance는 가볍지만, routing event마다 평균 약 9개 후보의 Verdict prefill이 필요합니다. 논문 추정은 현대 serving stack에서 약 0.5초 수준이지만, 조직별 Skill 길이·GPU·KV cache 조건으로 재측정해야 합니다.[1] |
| 거버넌스 | “가장 관련 있는 Skill”과 “정책상 허용되는 Skill”은 다릅니다. 공공·규제 업무라면 보안등급, 개인정보 처리권한, 기관별 적용 범위, 승인 상태를 hard constraint로 선필터링한 뒤 Gavel을 적용해야 합니다. |
적용 권고
[보완 필요: PoC 설계] Gavel 계열을 도입한다면, 순수 정확도 비교가 아니라 아래 4축을 함께 측정해야 합니다.
- Routing quality: Hit@1, Recall@k, 오선택률, abstention 정확도
- Agent effectiveness: Skill 적용 후 task completion rate 및 재시도율
- Operational efficiency: 선택 전 context token 절감량, p95 routing latency, GPU/KV cache 비용
- Governance compliance: 비인가 Skill 호출률, 정책상 필수 Skill 누락률, Skill version/audit traceability
따라서 Gavel의 진짜 가치는 “embedding retrieval을 조금 개선했다”가 아니라, 에이전트가 가진 능력은 유지하면서 라우팅만 context 밖으로 분리했다는 아키텍처 전환에 있습니다. 다만 현 시점에는 research preview로 보고, self-hosted 모델·대형 Skill library·mid-rollout routing 수요가 있는 환경에서 우선 PoC하는 것이 타당합니다.


'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - Tool 선택 판단 기준: Claude Code, Codex and Cursor (0) | 2026.09.20 |
|---|---|
| 에이전트 AI - TypeSafe AI, Jev : 확률 보정형·타입 안전 의사결정 레이어 (0) | 2026.09.20 |
| 에이전트 AI - 재귀적 자기 개선(RSI) 자율성 5단계 개요 및 대표 시스템 (0) | 2026.09.20 |
| 에이전트 AI - IBM Research, ALTK-Evolve: 에이전트 일관성 격차 프레임워크 (0) | 2026.09.20 |
| 에이전트 AI - Prime Agent: 자가 개선형 RLM 하네스 (0) | 2026.09.20 |