AI 안전성 - O’Reilly Radar, 클로드(Claude):텍스트 워터마킹은 Google DeepMind의 SynthID-Text 계열 방식
07.AI/9. AI Safety 2026. 10. 25. 02:34https://oreillyradar.substack.com/p/the-latest-anthropic-claude-models
2026.10.23
[The Latest Anthropic Claude Models Contain AI Text Watermarks: What Does This Mean for You?]
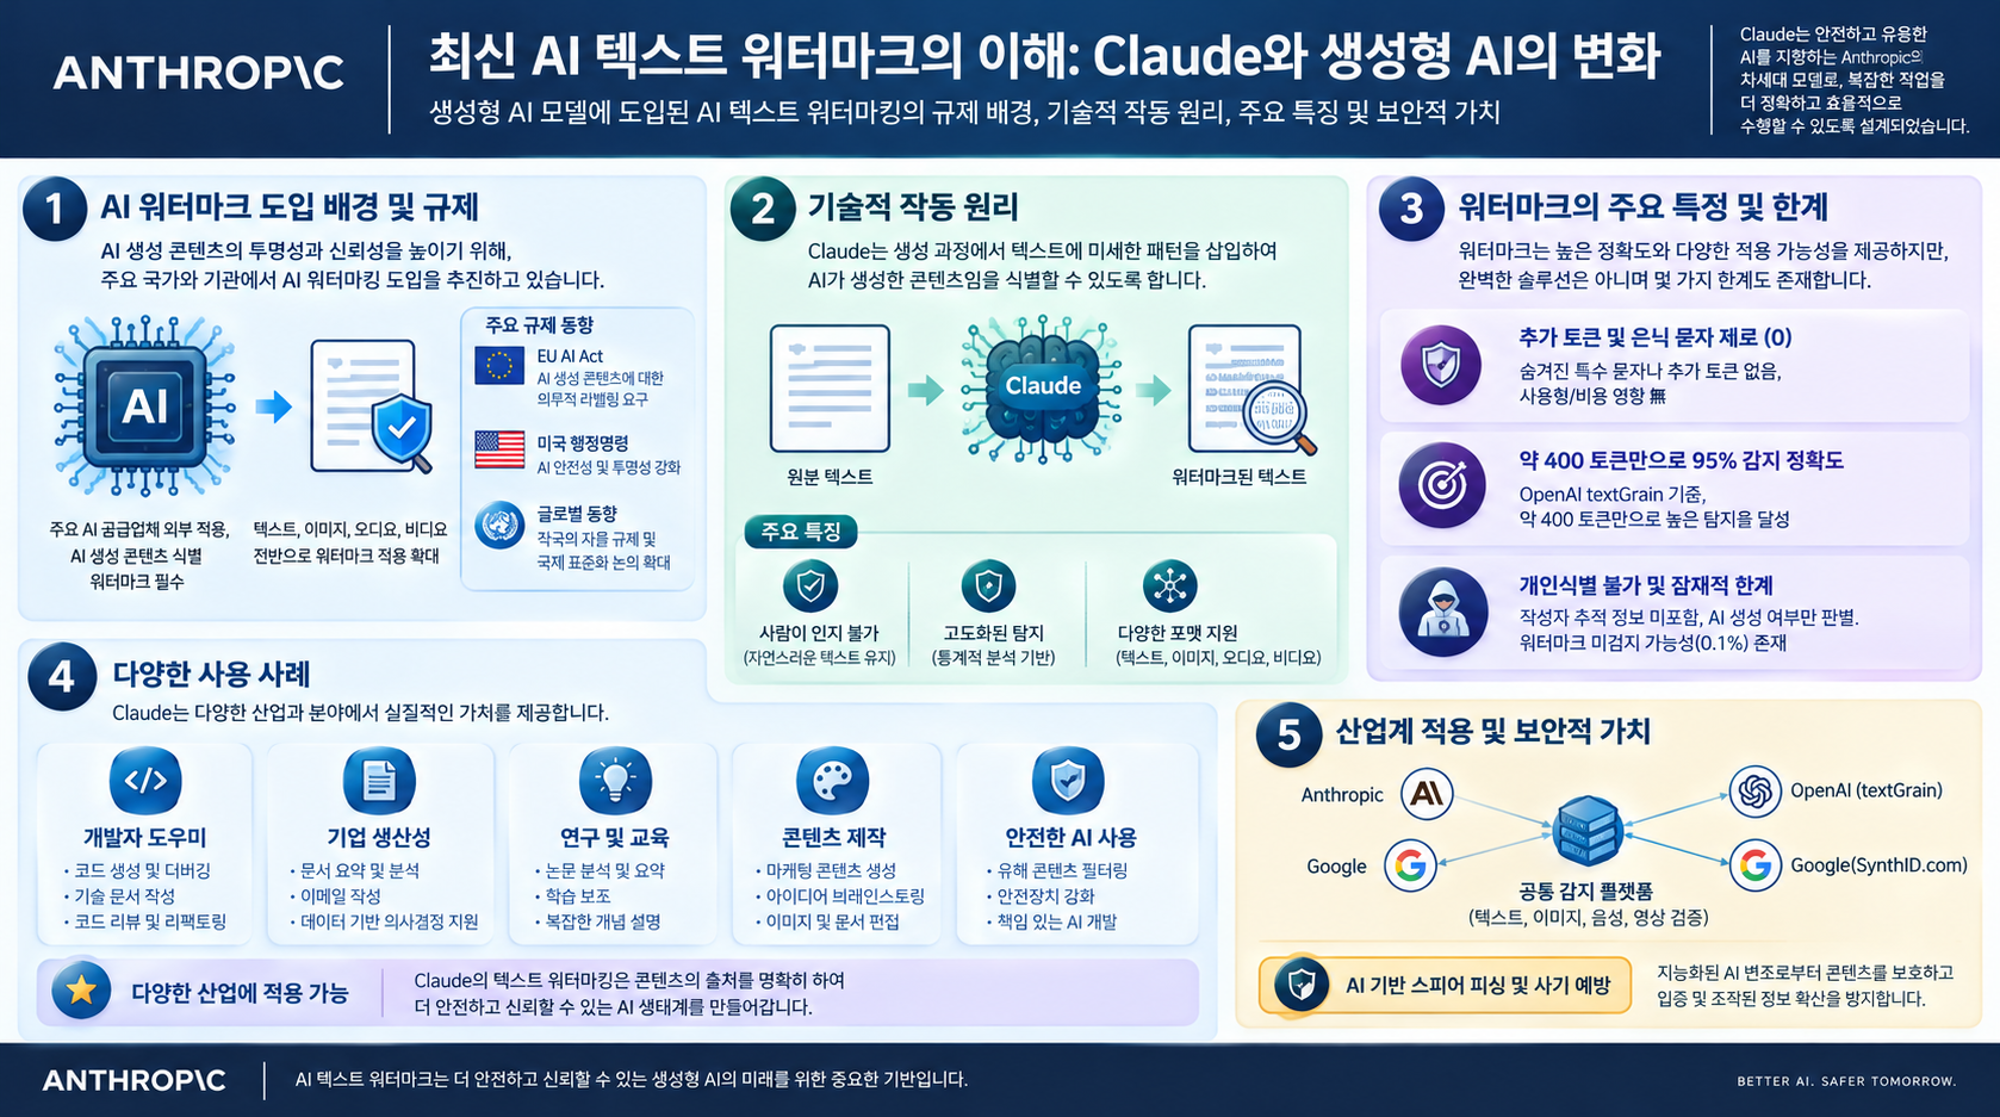
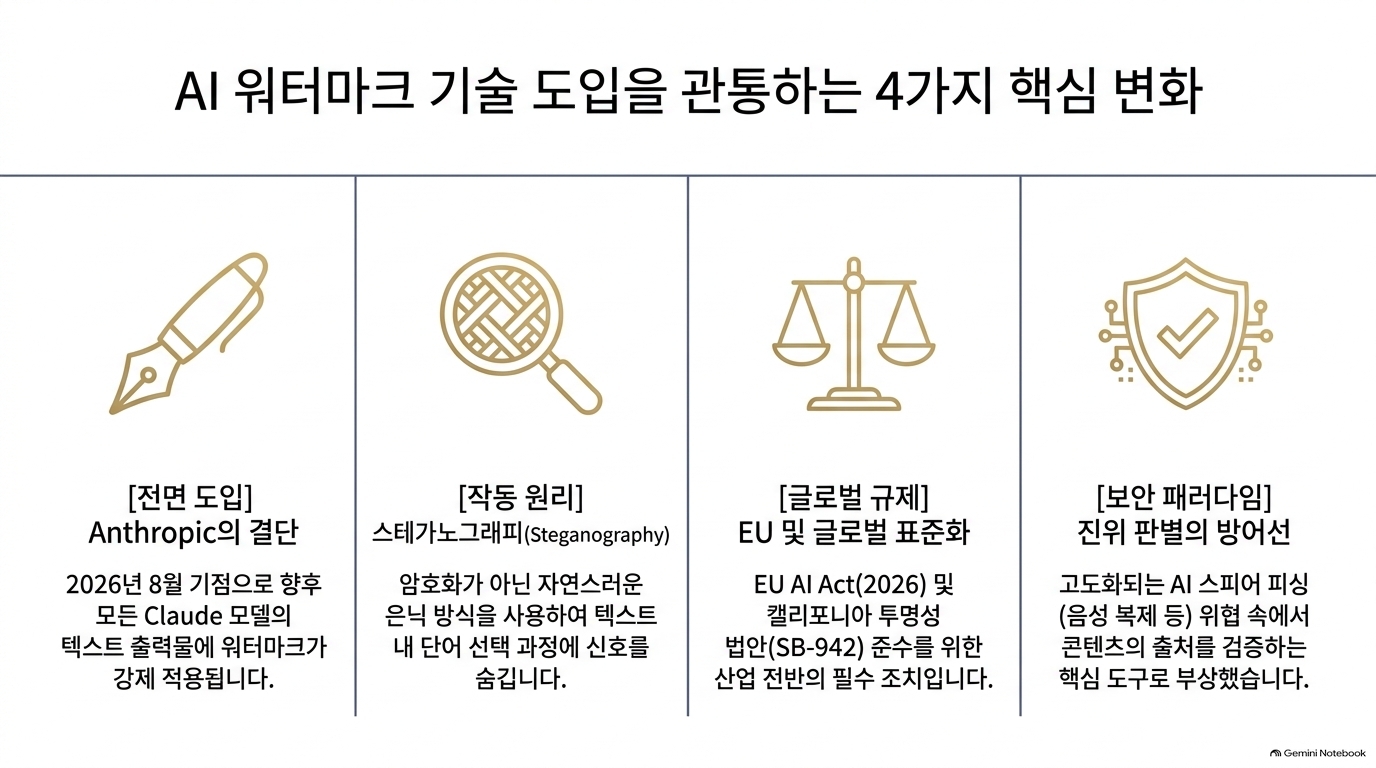
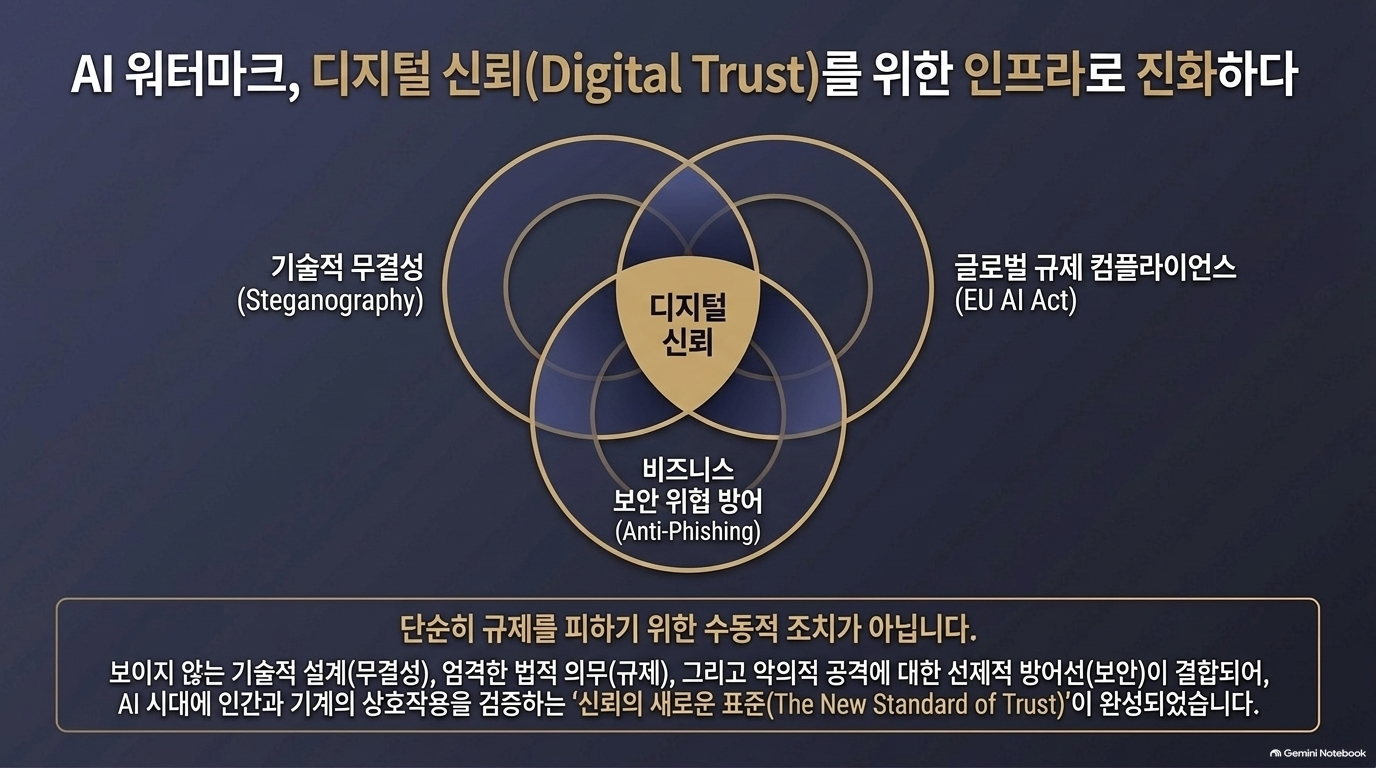
최근 도입된 인공지능 텍스트 워터마크 기술은 전 세계적인 법적 규제에 발맞추어 인공지능이 생성한 콘텐츠를 투명하게 식별하기 위해 필수적인 장치로 자리 잡았습니다. 이 글의 핵심 목적은 앤트로픽의 클로드 모델을 비롯한 주요 생성형 인공지능들이 암호화가 아닌 스테가노그래피 기법을 활용하여 눈에 띄지 않게 고유의 신호를 어떻게 심어두는지 독자들에게 쉽게 이해시키는 것입니다. 특히 미묘한 단어 선택의 변화를 유도하는 토너먼트 샘플링 방식을 통해 원본의 형태를 훼손하지 않으면서도 기계가 작성한 콘텐츠를 판별할 수 있음을 강조합니다. 궁극적으로 저자는 이러한 기술적 장치가 점교묘해지는 사이버 범죄와 피싱 공격을 예방하는 데 중요한 역할을 하며, 모든 인공지능 생성물에 대한 진위 여부를 가려내는 필수적인 안전망이 된다고 설명합니다.
Claude 텍스트 워터마킹: 챕터별 내용 분석
분석 대상: Bruce Hopkins, 「The Latest Anthropic Claude Models Contain AI Text Watermarks: What Does This Mean for You?」, O’Reilly Radar.[1]
이 글은 워터마킹의 도입 배경 → 개념 → 작동 원리 → 타사 동향 → 활용 가치 → 사용자 영향을 설명하는 입문 해설입니다. 원문의 7개 본문 소제목을 그대로 따르되, 각 장의 역할을 구분해 중복을 줄였습니다. 원문 설명과 공식 자료의 차이는 해당 장에서만 짚었습니다.
핵심 판단: 워터마크는 특정 AI가 콘텐츠 생성·처리에 관여했을 가능성을 알려주는 출처 신호입니다. 내용의 진실성, 인간의 기여도, 부정행위 여부를 확정하는 증거는 아닙니다.[2][4]
1. Anthropic은 무엇을 공식 발표했는가?
What did Anthropic officially announce?
원문의 핵심 내용
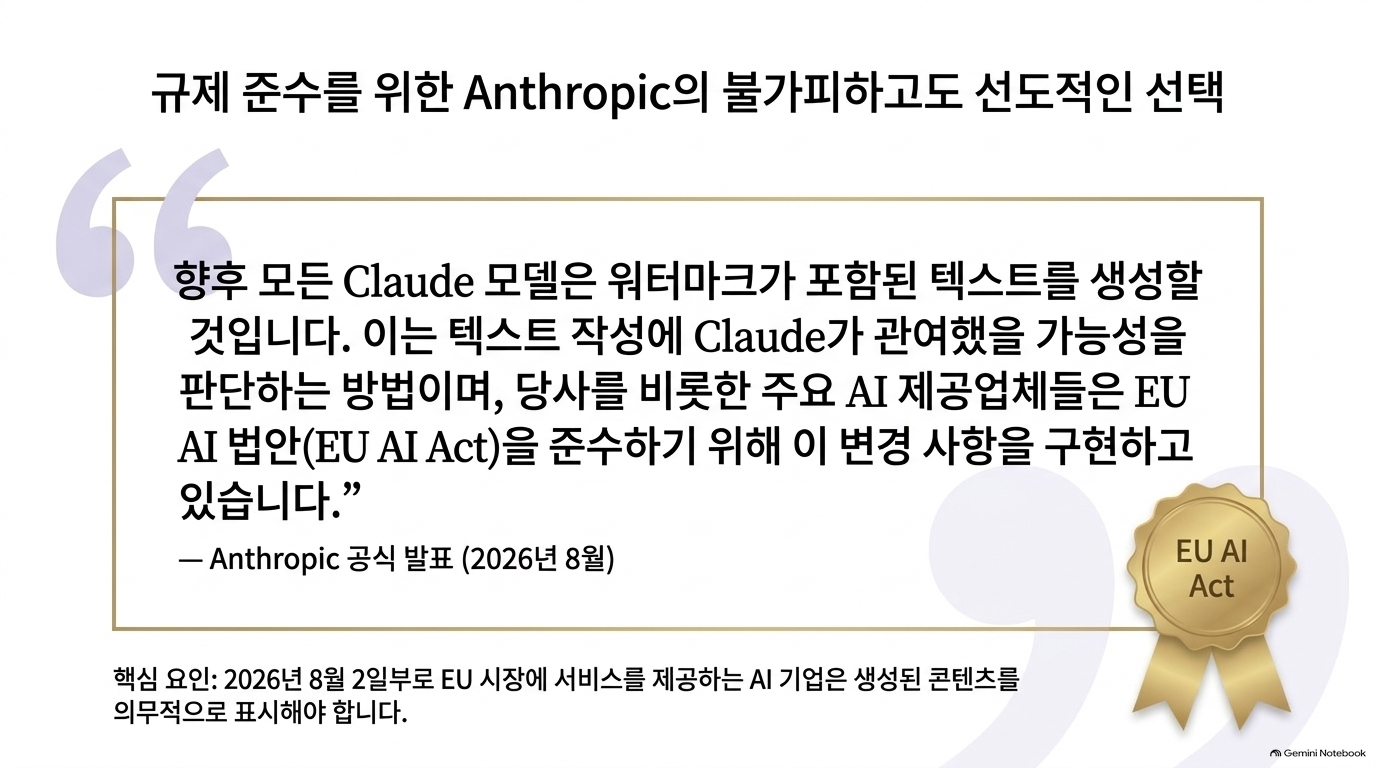
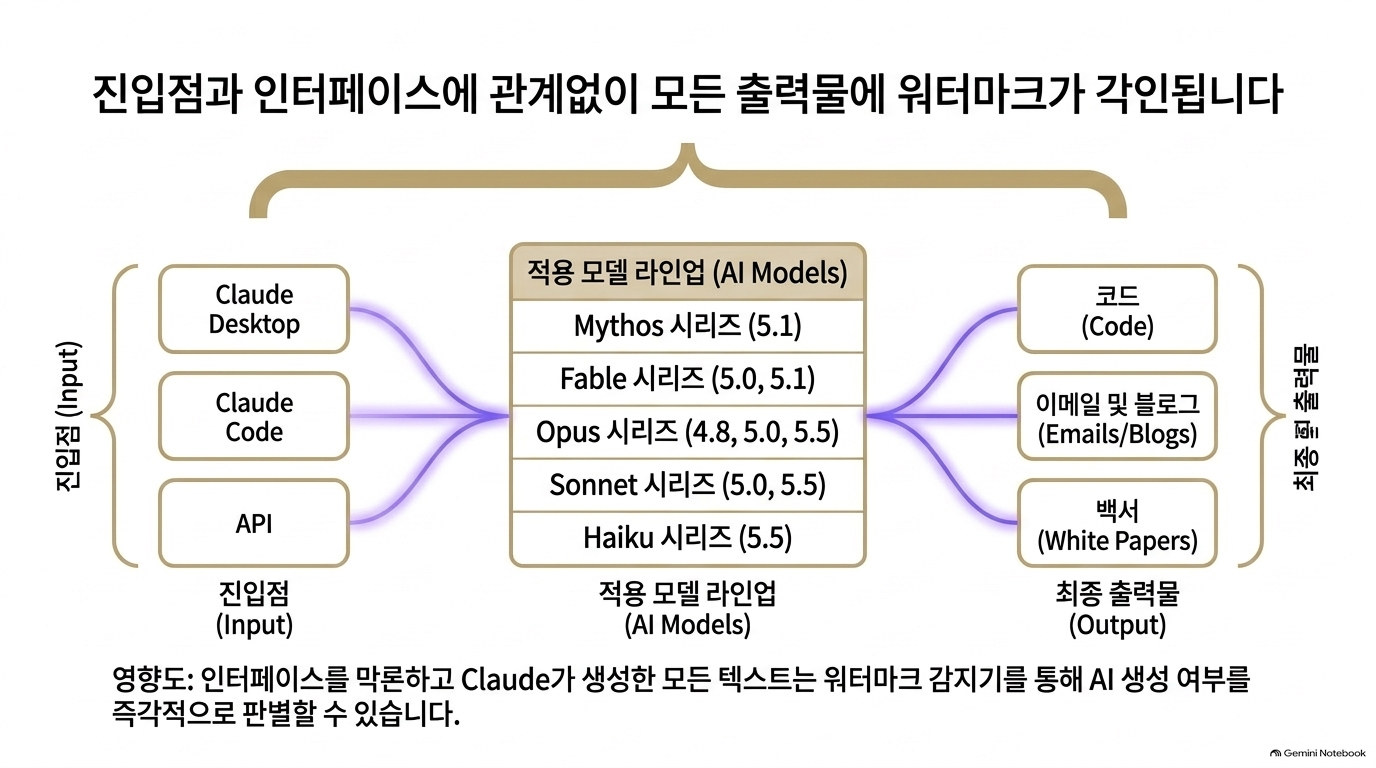
저자는 Anthropic의 발표를 인용해, 향후 Claude 모델이 생성하는 텍스트에 워터마크가 포함되며 그 배경이 EU AI Act 대응이라고 설명합니다. 적용 모델로 다음을 열거합니다.[1]
- Claude Mythos 5.1
- Claude Fable 5.1, Fable 5
- Claude Opus 5.5, Opus 5, Opus 4.8
- Claude Sonnet 5.5, Sonnet 5
- Claude Haiku 5.5
Claude 앱·Claude Code·API 등 사용 경로에 관계없이 적용되므로 이메일, 기사, 코드 등 다양한 결과물에 영향을 준다는 것이 이 장의 요지입니다.[1]
분석: 사용자 기능이 아니라 모델 수준의 표시 정책
이 장에서 중요한 변화는 사용자가 문서에 표시를 추가하는 방식이 아니라, 지원 모델의 생성 과정에서 표시가 만들어진다는 점입니다. 따라서 API로 서비스를 구축해도 단순히 화면에서 문구를 숨기는 것으로 워터마킹 적용 여부가 바뀌는 구조가 아닙니다.[3]
공식 지원 문서는 지원 모델의 워터마킹을 전 세계에 적용하며, 자사 제품뿐 아니라 클라우드 파트너 경로도 포함한다고 설명합니다. 다만 모델·플랫폼에 따라 지원 상태와 배포 일정이 구분됩니다.[3]
[보완 필요] “모든 출력”과 “누구나 쉽게 탐지”는 구분해야 함
원문은 적용 범위를 강조하면서 “워터마크 탐지기가 있는 누구나 쉽게 AI 생성 여부를 판별할 수 있다”고 서술합니다. 그러나 공식 자료에는 다음 조건이 있습니다.[2][3]
| 구분 | 정확한 해석 |
| 적용 범위 | 지원 모델의 생성 텍스트에 워터마킹을 적용 |
| 탐지 가능성 | 문장 길이와 단어 선택의 자유도 등에 따라 달라짐 |
| 탐지기 접근 | Claude 텍스트 탐지 API는 자격을 갖춘 기관 대상 비공개 프리뷰 |
| 기존 모델 | 이전 모델은 별도의 지원 확대 과정에 있음 |
이 장의 시사점: 조직은 “Claude를 사용하는가”만 확인할 것이 아니라 모델 버전·접속 경로·표시 지원 상태를 구분해 관리해야 합니다.
2. 암호화와 스테가노그래피는 어떻게 다른가?
What’s the difference between cryptography and steganography?
원문의 핵심 내용
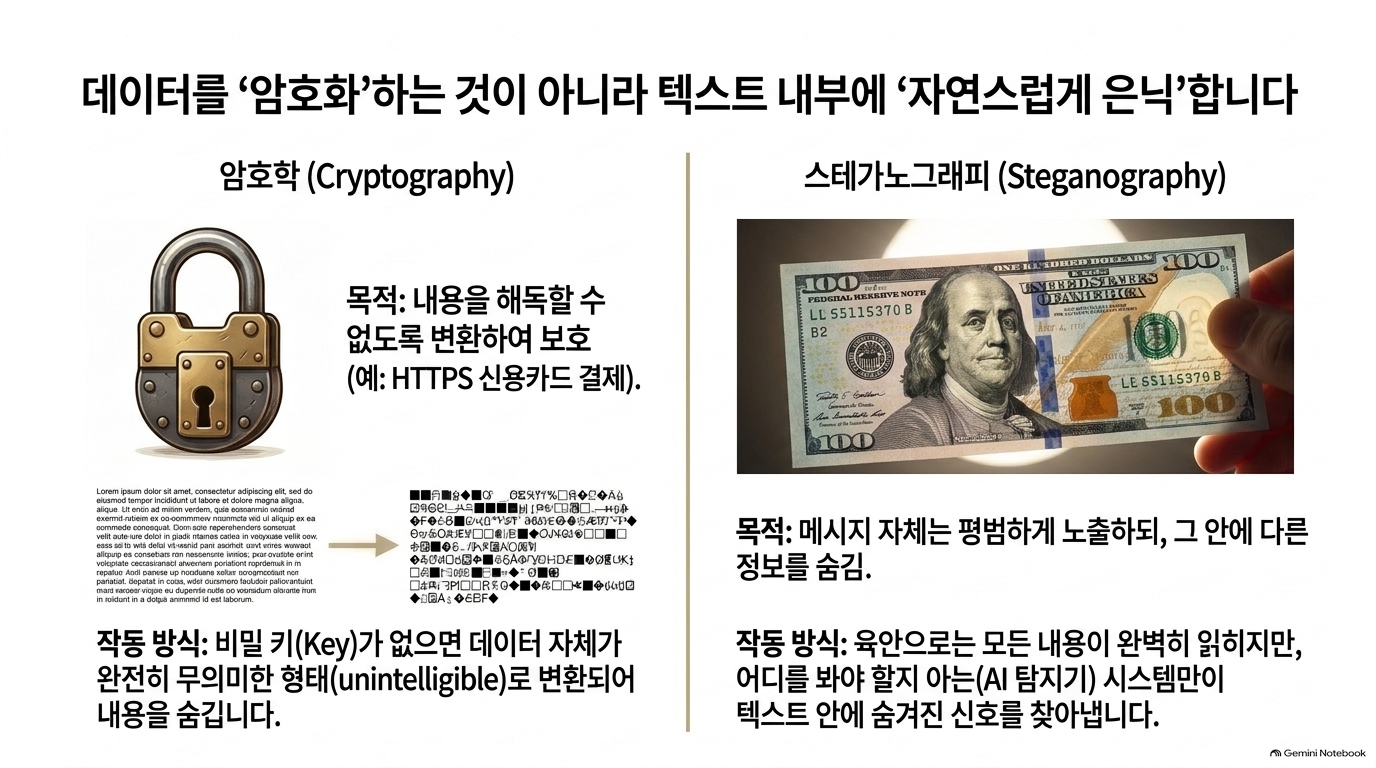
저자는 두 개념을 대비합니다.[1]
- 암호화: 키가 없으면 메시지 내용을 읽기 어렵게 만드는 기술. HTTPS를 예로 듭니다.
- 스테가노그래피: 겉으로는 평범한 대상 안에 별도의 신호를 감추는 기술. 지폐의 보안 요소를 비유로 사용합니다.
Claude 워터마킹은 텍스트를 읽지 못하게 만드는 것이 아니라, 읽을 수 있는 문장 안에 탐지 가능한 패턴을 남기는 방식이라는 설명입니다.[1]
분석: 보호하는 대상이 다름
두 기술은 해결하려는 문제가 다릅니다.
| 구분 | 암호화 | 이 글의 텍스트 워터마킹 |
| 주된 목적 | 내용의 기밀성 보호 | 생성·처리 출처의 단서 제공 |
| 일반 독자의 경험 | 복호화 전에는 내용을 읽기 어려움 | 평범한 문장으로 읽힘 |
| 키의 역할 | 내용을 복호화 | 통계적 패턴을 검증 |
다만 “스테가노그래피는 암호화가 아니다”라는 말이 암호학적 기법을 사용하지 않는다는 뜻은 아닙니다. 이 글의 워터마킹도 비밀 키와 의사난수 패턴을 사용합니다.[1][2]
또한 지폐 비유에는 한계가 있습니다. 지폐의 워터마크는 조건을 맞추면 눈으로 확인할 수 있지만, Claude의 텍스트 워터마크는 사람이 문장을 읽으며 식별하는 표식이 아닙니다.[2]
이 장의 시사점: 워터마킹은 보안 통신이나 개인정보 암호화를 대신하지 않습니다. 출처 표시와 기밀성 통제는 별개로 설계해야 합니다.
3. AI 워터마크는 기술적으로 어떻게 작동하는가?
So, technically, how does the AI watermark actually work?
원문의 핵심 내용
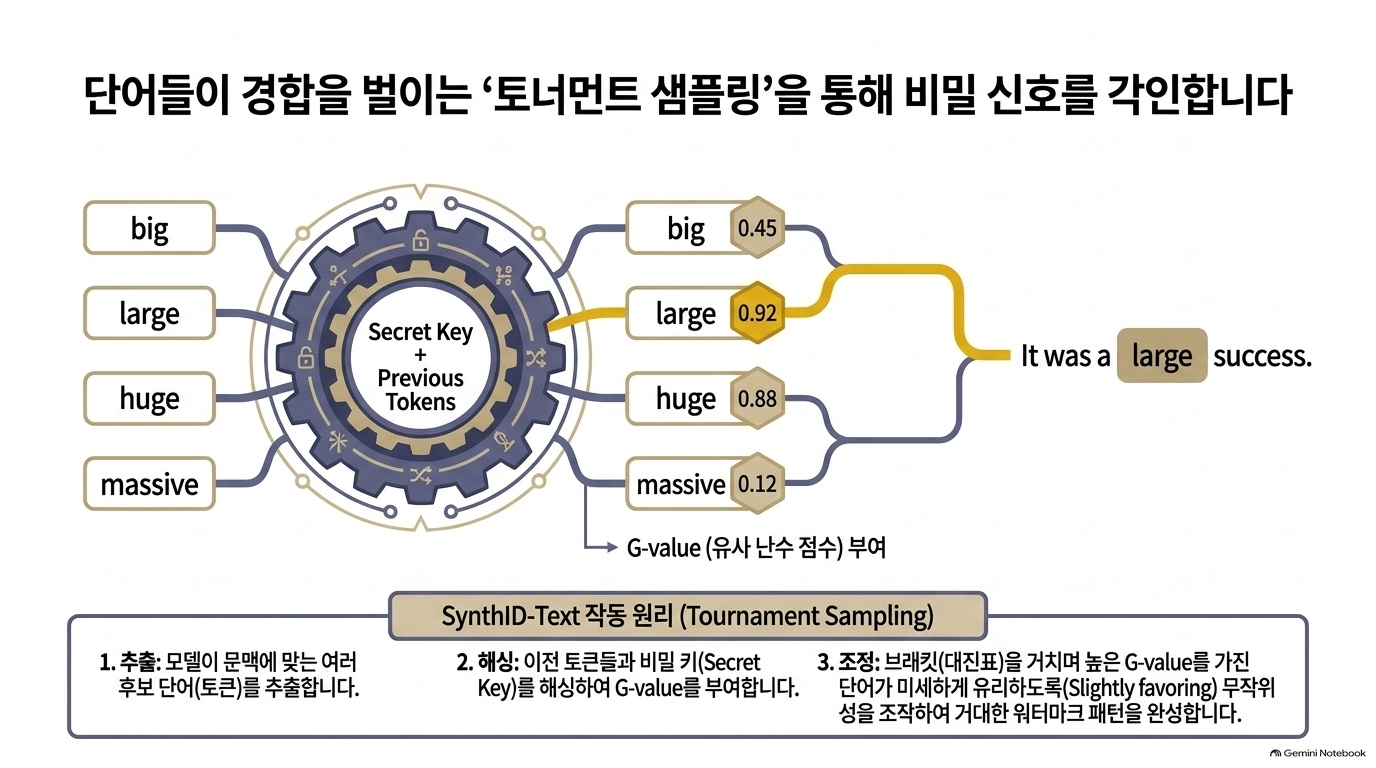
Claude의 워터마킹은 Google DeepMind의 SynthID-Text 계열 방식에 기반합니다. 핵심은 텍스트 뒤에 표시를 붙이는 것이 아니라 다음 토큰을 선택하는 샘플링 과정에 패턴을 만드는 것입니다.[1][2]
원문이 설명하는 흐름은 다음과 같습니다.[1]
- 모델이 다음 위치에 올 수 있는 후보 토큰들을 생성합니다.
- 앞선 토큰들과 비밀 키를 이용해 의사난수 점수인 g-values를 계산합니다.
- 후보들이 토너먼트 방식으로 비교됩니다.
- 긴 텍스트 전체에 걸쳐 키와 일치하는 통계적 패턴이 누적됩니다.
- 탐지기는 그 패턴을 분석해 생성 관여 가능성을 판단합니다.
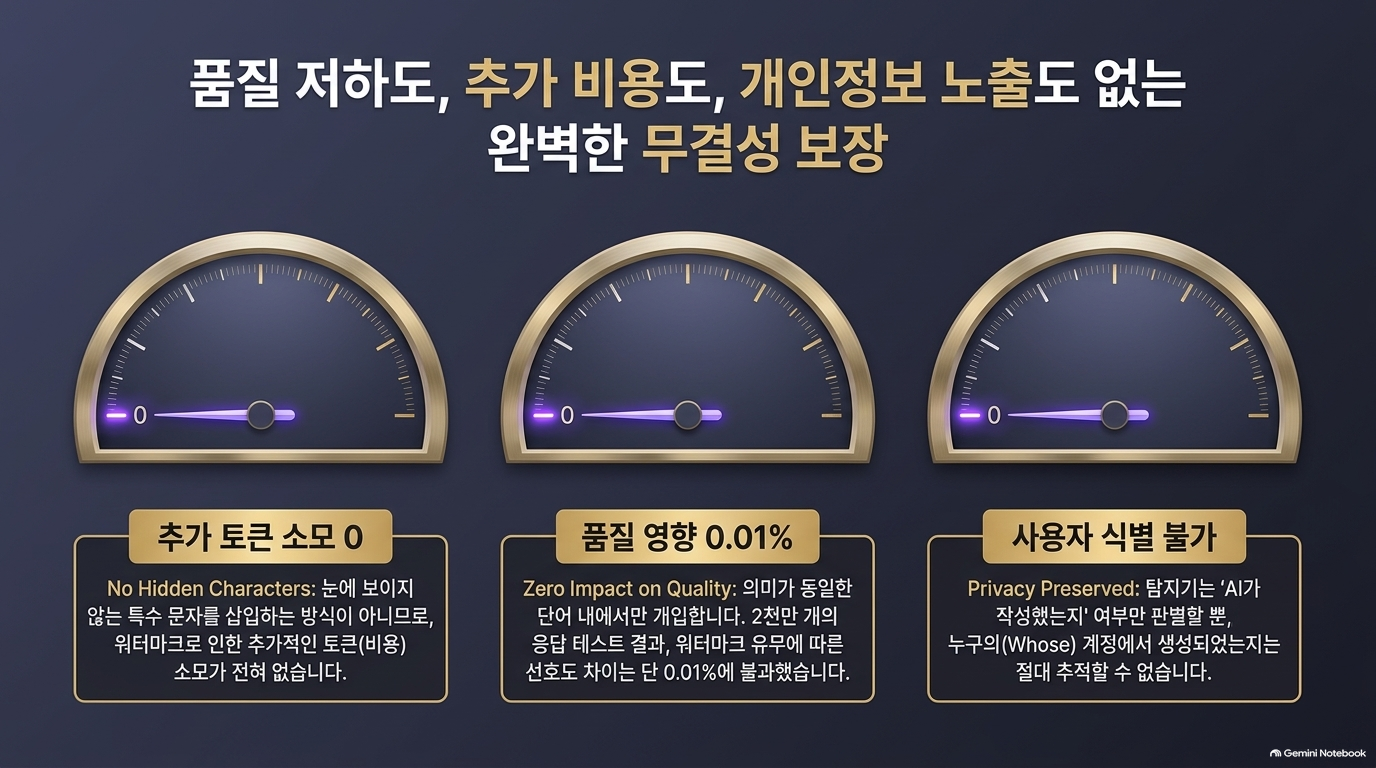
따라서 숨은 문자나 추가 토큰이 없어도 워터마크가 형성됩니다. 문장을 그대로 복사·붙여넣으면 단어 배열도 유지되므로 신호가 함께 이동합니다.[1][2]
분석: 문장에 표시를 추가하는 것이 아니라 선택 과정에 흔적을 남김
‘big’과 ‘large’처럼 문맥상 모두 가능한 표현 중 하나를 선택할 때 패턴을 남긴다는 설명이 직관적입니다. 다만 실제 작동 단위는 사람이 인식하는 단어와 항상 일치하지 않는 토큰입니다.
여기에서 중요한 제약이 생깁니다. 정확한 답이 사실상 하나뿐인 위치에서는 워터마크를 넣을 선택 여지가 적습니다. 공식 설명도 사실 중심 문장, 코드, 가벼운 교정에서는 신호가 약하거나 탐지하기에 부족할 수 있다고 밝힙니다.[2]
품질 근거를 어떻게 읽어야 하는가?
원문은 약 2,000만 건의 Gemini 응답을 평가한 연구에서 긍정 평가 비율 차이가 0.01%였다고 소개합니다.[1]
논문을 확인하면, 이는 워터마킹·비워터마킹 응답을 합한 약 2,000만 건의 실서비스 실험이며, 평가 비율의 분모는 수집된 긍정·부정 피드백의 합계입니다. 연구진은 긍정 평가 비율 차이 0.01%, 부정 평가 비율 차이 0.02% 모두 통계적으로 유의하지 않았다고 보고합니다.[5]
해석의 경계: 이 결과는 해당 Gemini 실험에서 품질 차이가 관찰되지 않았다는 근거입니다. 모든 Claude 모델·언어·코드 작업에서 영향이 전혀 없다는 독립 검증으로 확대할 수는 없습니다. Anthropic의 품질 무영향 설명은 자사 내부 시험 결과와 해당 선행 연구를 근거로 합니다.[2]
4. 다른 기업은 어떻게 워터마킹하고 있는가?
Who else is watermarking their AI-generated content?
원문의 핵심 내용
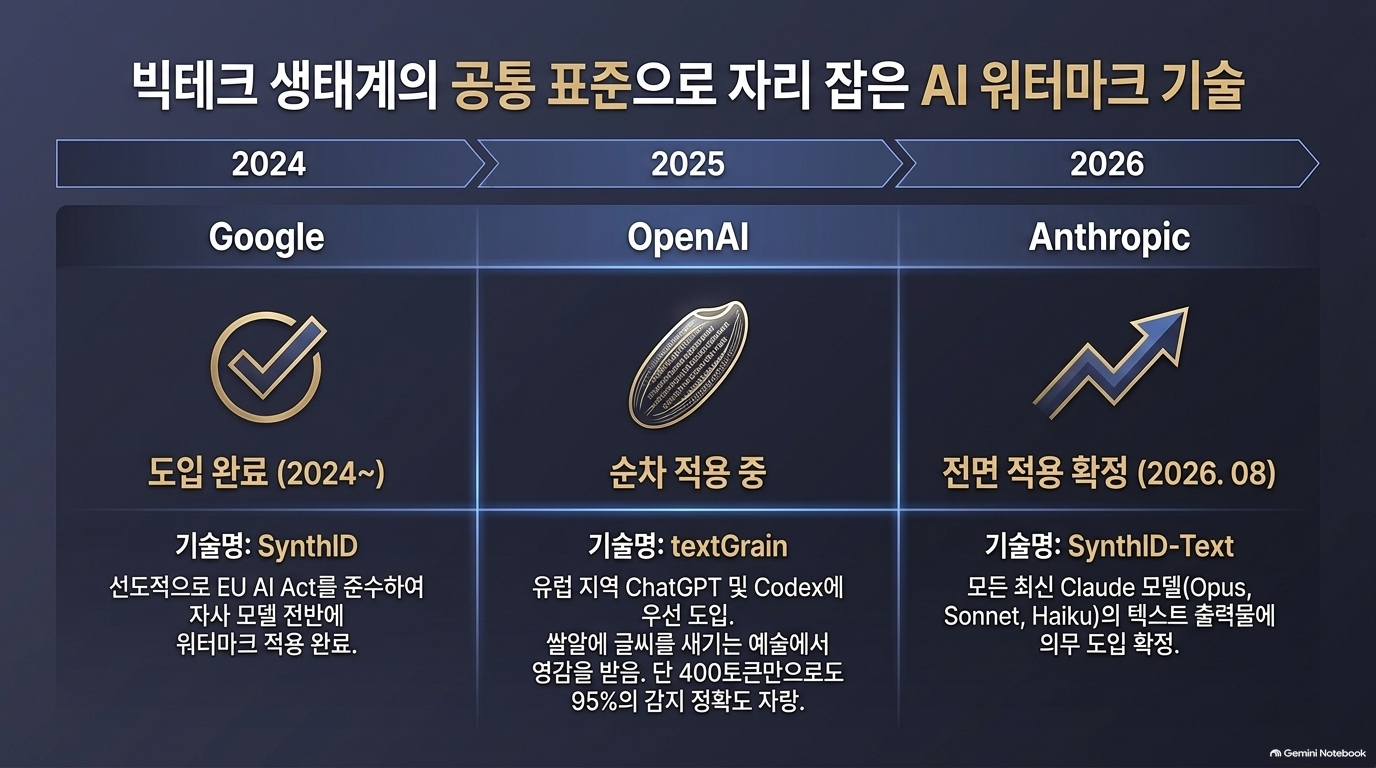
저자는 워터마킹을 Anthropic만의 선택이 아니라 산업 전반의 규제 대응으로 설명합니다. EU의 투명성 실천규범, OpenAI의 textGrain, 공개 미디어 검증 도구, 캘리포니아 SB-942를 사례로 제시합니다.[1]
분석 ①: 같은 규제 대응이라도 적용 정책은 다름
OpenAI 공식 발표는 Anthropic과 다른 적용 방식을 명시합니다.[4]
| 항목 | Anthropic | OpenAI |
| 지역 정책 | 지원 모델에 전 세계 적용 | 출시 시 ChatGPT·Codex의 대상 출력은 EU 한정 |
| API | 지원 모델 출력에 적용 | 전 세계 고객이 선택 모델에 옵트인, 기본값은 꺼짐 |
| 텍스트 탐지기 | 자격 기관 대상 비공개 프리뷰 | 승인 연구자·전문기관부터 제한 접근 |
따라서 원문의 방향성은 타당하지만, 이를 “모든 주요 모델의 모든 출력에 동일하게 적용된다”고 읽으면 부정확합니다.
분석 ②: “400토큰에서 정확도 95%”는 지표를 잘못 단순화함
원문은 OpenAI 탐지기의 성능을 “400토큰 문장에서 정확도 95%”라고 표현합니다.[1] 공식 발표의 정확한 조건은 다음과 같습니다.[4]
- 목표 오탐률 1%에서 평가
- 심리학과 같이 표현 선택 여지가 있는 콘텐츠에서
- 200토큰 문장은 약 80%, 400토큰 문장은 약 95%의 워터마크 탐지율
- 수학처럼 표현이 제한적인 콘텐츠에서는 탐지율이 상당히 낮음
즉, 전체 정확도 95%가 아니라 특정 조건에서의 탐지율입니다. 이것이 “탐지된 문서는 95% 확률로 AI가 작성했다”는 의미도 아닙니다.
분석 ③: 법률과 실천규범, 관할별 적용 대상을 구분해야 함
EU 집행위원회는 실천규범을 법적 표시·고지 의무의 이행을 돕는 수단으로 설명합니다. 서명 자체가 각 기업의 구현 완료나 성능 검증을 의미하지는 않습니다.[6]
또한 원문이 링크한 2024년 제정 SB-942 조문의 탐지·잠재적 표시 의무는 이미지·영상·음성 및 그 조합을 대상으로 합니다. 생성형 AI의 정의에 텍스트가 들어 있다는 이유만으로, 그 표시 의무를 텍스트에도 그대로 적용해서는 안 됩니다. 이후 개정까지 포함한 현행법 전체 검토는 별도입니다.[7]
이 장의 시사점: 규제 준수 검토는 기업 이름이 아니라 관할·매체·서비스·시행판·적용 조건 단위로 해야 합니다.
5. Google 모델의 출력에도 워터마크가 있는가?
Google’s model outputs also contain AI-watermarks
원문의 핵심 내용
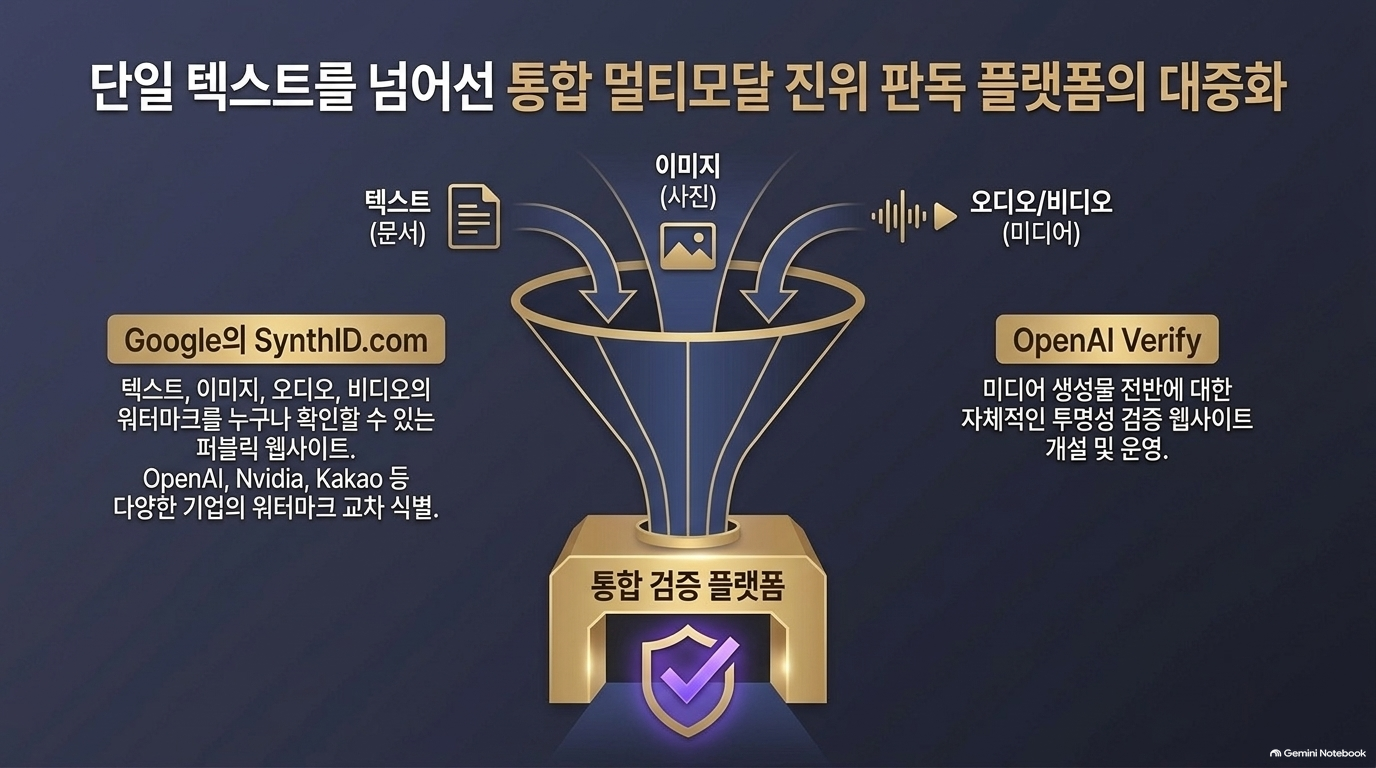
저자는 Google이 2024년부터 Gemini에 SynthID-Text를 적용했으며, SynthID.com에서 이미지·음성·영상의 워터마크를 확인할 수 있다고 설명합니다. Google뿐 아니라 OpenAI, Nvidia, Kakao의 지원 콘텐츠도 검증 대상이라고 소개합니다.[1]
분석: 텍스트 기술과 공개 미디어 탐지기는 다른 범위
Google의 2024년 텍스트 워터마킹 도입은 SynthID-Text 논문에서도 확인됩니다.[5] 하지만 텍스트 워터마킹 기술이 있다는 사실과, 공개 웹사이트에서 텍스트를 검사할 수 있다는 사실은 별개입니다.
현재 확인한 SynthID Detector의 공개 지원 유형은 다음과 같습니다.[9]
- 이미지
- 영상
- 음성
사이트도 스스로 범용 AI 탐지기가 아니며 SynthID를 채택한 모델의 지원 미디어만 탐지한다고 명시합니다.[9]
[보완 필요] 기술 도입 시점과 법적 준수 시점을 혼동하지 말 것
원문의 “Google은 수년 전에 EU AI Act를 준수했다”는 표현은 과도하게 압축되어 있습니다. 2024년 워터마킹 기술의 도입과 2026년 적용되는 특정 법적 의무의 충족은 다른 판단입니다. 기술 하나를 먼저 도입했다는 사실만으로 관련 의무 전체의 준수를 입증할 수는 없습니다.[5][6]
이 장의 시사점: 탐지 도구를 선정할 때는 브랜드보다 검사 매체·지원 생성 모델·표시 방식·판정 한계를 확인해야 합니다.
6. 모든 AI 콘텐츠에 워터마킹하는 것이 반드시 나쁜 일은 아니다
Watermarking all AI-generated content is not necessarily a bad thing
원문의 핵심 내용
저자는 자신이 컨설팅한 기업에서 발생한 CEO 사칭 송금 요청 이메일을 소개합니다. 당시에는 회사와 다른 이메일 도메인 때문에 사기를 알아차릴 수 있었다고 합니다.[1]
이어 공격자가 CEO의 음성을 복제해 전화했다면 직원이 속을 위험이 더 커졌을 것이라고 가정하며, AI 생성 콘텐츠를 식별하는 수단의 필요성을 주장합니다.[1]
분석: 실제 경험과 가상 위험 시나리오를 분리해야 함
이 장의 논증은 두 단계입니다.
| 구분 | 원문이 제시한 내용 | 증거 수준 |
| 실제 경험 | CEO를 사칭한 송금 요구 이메일 | 저자의 경험담 |
| 가정 | 음성 복제 전화로 공격이 정교해질 가능성 | 가상 시나리오 |
따라서 이 사례는 워터마킹의 필요성을 설명하지만, 워터마킹이 실제 사기를 차단했다는 실증 사례는 아닙니다.
더 근본적으로, AI 생성 여부와 요청의 정당성은 다른 문제입니다. 정상적인 기업 안내도 AI 음성을 사용할 수 있고, 사기범은 워터마킹을 지원하지 않는 도구를 사용할 수도 있습니다. SynthID 공식 안내 역시 미탐지가 AI 생성·조작의 부재를 뜻하지 않는다고 설명합니다.[9]
실무적 해석 — 분석자 권고: 송금 같은 고위험 업무에서는 워터마크 검사를 보조 신호로 활용하되, 기존에 등록된 연락처로 재확인하고 권한·결재 절차를 확인하는 통제를 유지해야 합니다. 이는 원문에 제시된 검증된 성과가 아니라, 사례에서 도출한 운영 권고입니다.
7. 사용자에게 무엇을 의미하는가?
What this means for you
원문의 핵심 내용
저자는 주요 LLM의 워터마킹 도입이 규제에 의해 지속될 것이며, AI 악용이 가능한 환경에서 콘텐츠의 진위를 판단하는 데 유용한 도구가 될 것이라고 결론짓습니다. 마지막에는 관련 O’Reilly 교육과정을 안내합니다.[1]
분석: ‘진위 판별’보다 ‘출처 판단 보조’로 이해해야 함
결론에서 가장 중요한 보완점은 AI의 관여와 내용의 신뢰성을 분리하는 것입니다. 공식 문서에 따르면 워터마크는 다음을 알려주지 못합니다.[2][4]
- 누가 요청하거나 작성했는지
- 인간이 어느 정도 기여했는지
- 원저작자나 권리자가 누구인지
- 내용이 사실인지
- 사용이 적법하거나 적절했는지
이를 실제 업무에 적용하면 다음처럼 정리할 수 있습니다.
| 상황 | 권장 해석·대응 |
| 보고서·기사 검토 | 탐지 결과와 별도로 인용 근거·사실관계·검토 책임 확인 |
| 교육·평가 | 탐지 결과만으로 부정행위를 확정하지 않고 작성 과정 확인 |
| 코드 검토 | [출처] 신호와 기능·보안·라이선스 검증을 분리 |
| 조직의 AI 활용 관리 | 모델·생성 및 수정 이력·검토자·승인 기록 관리 |
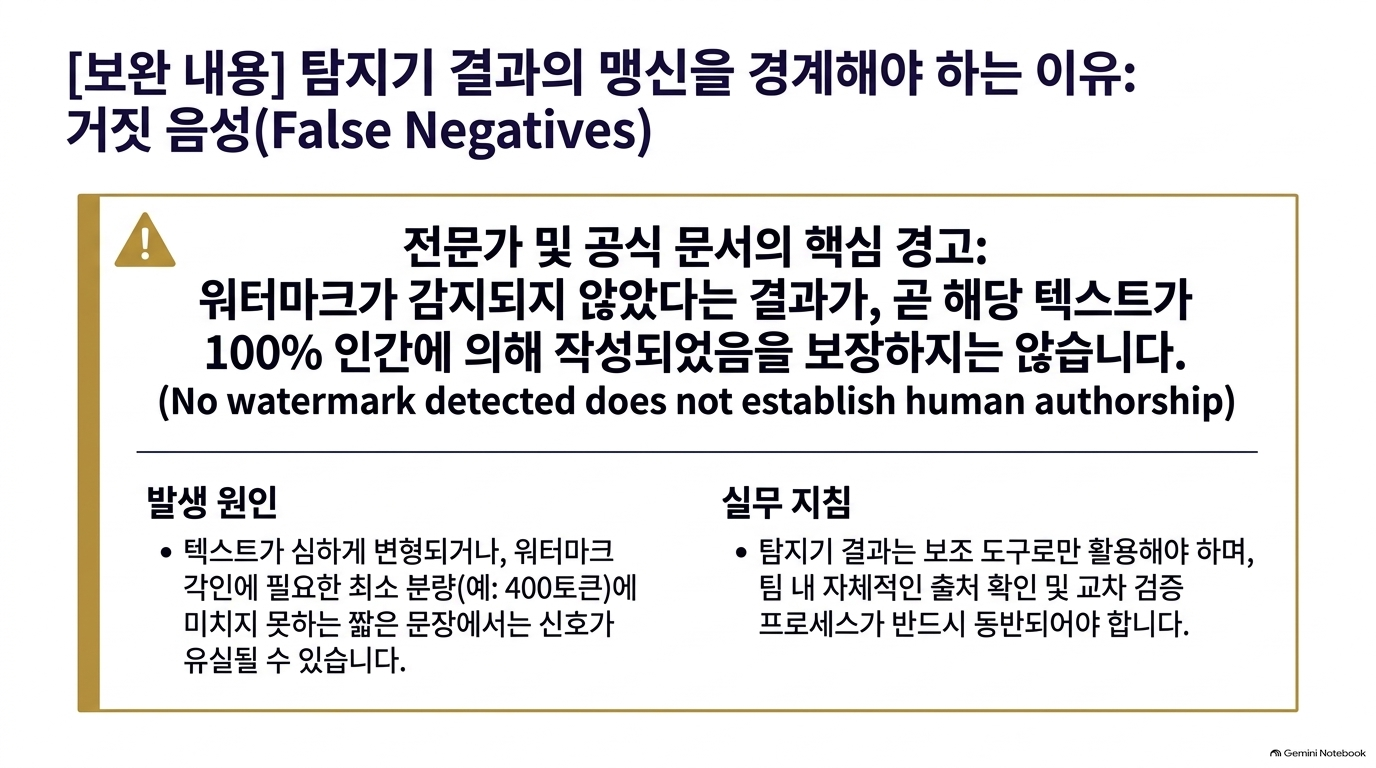
특히 “워터마크 미탐지 = 인간 작성”은 성립하지 않습니다. 짧은 문장, 편집·번역된 문장, 미지원 모델의 출력 등에서는 신호가 없거나 충분히 검출되지 않을 수 있습니다.[3][4]
종합 평가
이 글의 강점은 “숨은 문자를 넣는 것이 아니라, 생성 시 표현을 선택하는 과정에 통계적 패턴을 만든다”는 원리를 쉽게 설명한 데 있습니다. 반면 탐지기 접근성, 성능 지표, 규제 적용 범위, 출처와 진실성의 차이는 단순화되어 있습니다.
기사에서 연결한 독립 연구도 공개 SynthID-Text 구현의 평가와 실제 상용 Claude 구현의 검증은 다르다고 지적합니다. 공개 도구로 일반적인 방법을 시험할 수 있어도, 상용 서비스의 설정·키 관리·탐지 기준까지 확인했다는 뜻은 아닙니다.[8]
따라서 이 글은 워터마킹의 원리를 이해하는 입문 자료로는 유용하지만, 탐지 결과에 따른 제재·승인이나 법적 준수 판단의 단독 근거로 사용하기에는 부족합니다.
출처
[1] https://oreillyradar.substack.com/p/the-latest-anthropic-claude-models
[2] https://www.anthropic.com/news/claude-text-watermark
[3] https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content
[4] https://openai.com/index/eu-text-provenance
[5] https://www.nature.com/articles/s41586-024-08025-4
[6] https://digital-strategy.ec.europa.eu/en/news/strong-backing-code-practice-transparency-ai-generated-content
[7] https://leginfo.legislature.ca.gov/faces/billNavClient.xhtml?bill_id=202320240SB942
[8] https://arxiv.org/html/2609.09604v1
[9] https://synthid.com


'07.AI > 9. AI Safety' 카테고리의 다른 글
| LLM - 오픈 웨이트(Open Weight) - Epoch AI, 개방형 모델의 사이버 보안 역량은 6~7개월 뒤처져 있다 (0) | 2026.10.27 |
|---|---|
| AI 에이전트 - 앤스로픽(Anthropic)의 평가 및 내부 사용 과정에서 드러낸 의도치 않은 행동 사례들 (0) | 2026.10.18 |
| AI 에이전트 - Google Research, 에이전트 프라이버시·보안의 미해결 과제: 맥락 중심 접근 (0) | 2026.10.18 |
| AI 에이전트 - O’Reilly Radar, 보안 패러다임: 신원이 아닌 AI 의도 판단 (0) | 2026.10.11 |
| AI 신뢰성 - 금융보안원, 「금융분야 AI 에이전트 보안 평가기준」마련 (0) | 2026.10.08 |