https://www.hacktron.ai/blog/hacking-openai
2026.9.13
[Hacking OpenAI:A heap overflow and SSO misconfiguration to compromise OpenAI internal repositories]
이 문서는 보안 연구원들이 인공지능 도구를 활용해 OpenAI의 커뮤니티 포럼을 해킹하고 내부 시스템에 접근한 과정을 상세히 다룬 기술 보고서입니다. 연구팀은 이미지 처리 라이브러리의 취약점과 단일 신원 인증(SSO) 결함을 결합하여, 불과 72시간 만에 포럼 관리자 권한을 획득하고 직원 계정을 통해 내부 저장소까지 침투하는 데 성공했습니다. 또한 이 사례는 AI 모델이 복잡한 소프트웨어 취약점을 자동으로 악용하는 능력이 비약적으로 발전했음을 보여주며, 급변하는 위협 환경에 맞춰 기업들이 보안 패러다임을 시급히 재정비해야 한다는 교훈을 전달합니다.
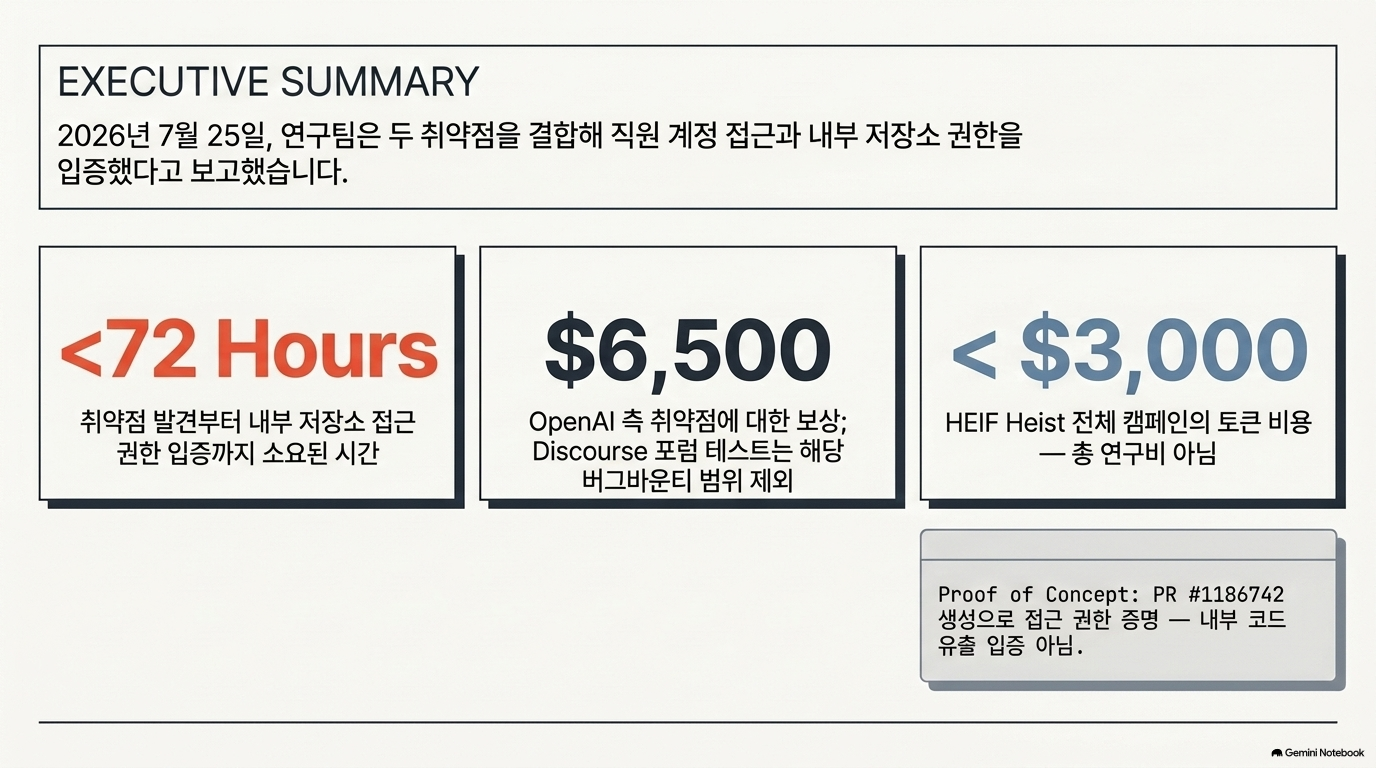
민감한 정보를 얻지 않고 실제로 접근 권한을 얻었다는 것을 증명하기 위해, 해당 직원의 Codex를 사용하여 OpenAI의 내부 모노레포에 PR #1186742를 열었습니다.

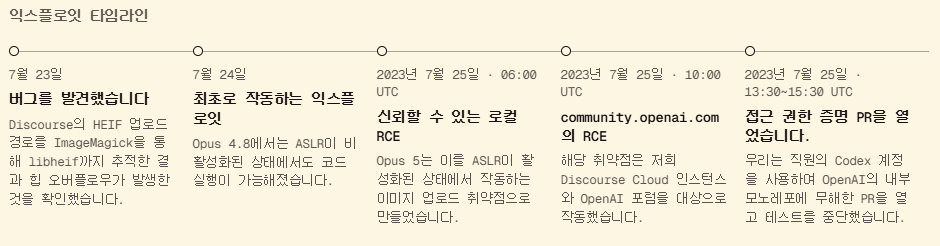
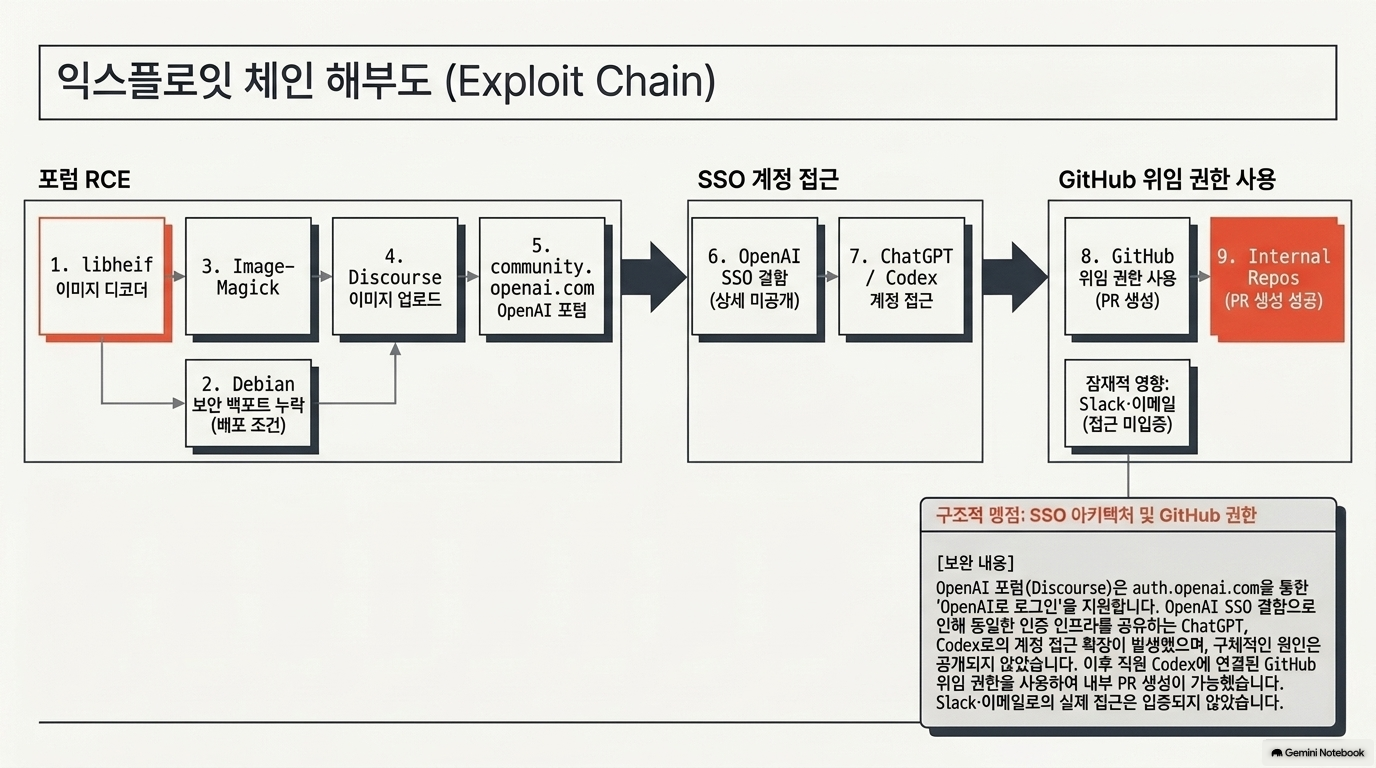
연구팀이 보고한 공격은 다음 세 가지가 결합된 공급망·인증·위임 권한의 연쇄 침해입니다.[1]
이미지 처리 라이브러리 취약점 → 커뮤니티 서버 장악 → OpenAI SSO 취약점을 통한 계정 탈취 → Codex에 연결된 GitHub 권한 사용
가장 중요한 시사점은 상대적으로 낮은 신뢰 수준의 커뮤니티 서비스가 핵심 업무 계정 및 내부 저장소에 이르는 공격 경로가 될 수 있었다는 점입니다. AI는 이 경로에서 취약점 분석과 exploit 개발을 가속한 도구로 등장합니다.
아래에서는 원문의 실제 목차 순서에 따라 ① 내용 ② 기술적 의미 ③ 증거와 한계 ④ 실무 시사점을 구분합니다.
먼저 구분해야 할 증거 수준
| 구분 | 확인 내용 | 해석상 주의점 |
| 공식 자료로 교차 확인 | Discourse 이미지 업로드 RCE, CVE-2026-32882, 패치 및 샌드박싱 조치 | 공식 권고문의 심각도는 High, CVSS 8.8 |
| 연구팀이 보고한 성과 | OpenAI 직원 계정 접근, 내부 저장소 PR 생성, 공격 개발 시간과 비용 | 이번 분석에서 원문 외 독립 검증은 하지 못함 |
| 원문에 공개되지 않은 부분 | OpenAI SSO 취약점의 정확한 원인, 토큰·세션 처리 구조 | 특정 OAuth/OIDC 오류라고 단정할 수 없음 |
| 잠재적 영향 | Slack·이메일 등 다른 커넥터 접근 | GitHub 경로의 영향 증명과 구분 필요 |
Discourse의 공식 권고문은 RCE 취약점과 대응 조치를 확인해 주지만, OpenAI 계정 탈취의 전체 경로까지 검증하는 자료는 아닙니다.[1][2]
1. Intro — 무엇을 침해했고, 어디까지 입증했는가
1.1 원문의 핵심 주장
연구팀은 2026년 7월 25일 두 취약점을 연결해 복수의 OpenAI 직원 ChatGPT 계정을 침해했다고 설명합니다. 이어 연결된 Codex를 이용해 OpenAI 내부 모노레포 openai/openai에 PR #1186742를 생성했으며, 이를 접근 권한의 증명으로 제시합니다.[1]
원문은 실제 내부 코드를 열람하지 않고 영향을 입증하기 위해 PR을 생성했다고 설명합니다. 따라서 이 사례를 “내부 코드 유출이 확인된 사고”로 표현하는 것은 원문의 증거 범위를 넘어섭니다.[1]
1.2 공격 체인의 구조
원문이 제시하는 체인을 기능별로 재구성하면 다음과 같습니다.[1]
[공격자 제어 이미지]
↓
libheif: 이미지 디코딩 과정의 메모리 손상
↓
ImageMagick: 취약한 디코더 호출
↓
Discourse: 업로드 이미지 처리
↓
community.openai.com: 서버 실행 권한 확보
↓
OpenAI SSO: 계정 간 신뢰 경계의 결함
↓
ChatGPT / Codex: 직원 계정 접근
↓
연결된 GitHub 권한
↓
OpenAI 내부 저장소에 PR 생성
분석: 이 체인에서는 서로 다른 세 종류의 보안 경계가 무너집니다.
- 데이터 → 실행 경계: 이미지 파일이 서버 측 코드 실행으로 연결됨.
- 서비스 → 신원 경계: 커뮤니티 침해가 다른 제품의 계정 접근으로 확장됨.
- 계정 → 외부 업무 권한 경계: 탈취 계정이 보유한 커넥터 권한으로 저장소 작업을 수행함.
이미지 처리 취약점만 고치거나 SSO만 고치는 것으로는 동일 유형의 전체 위험을 관리하기 어렵습니다. 각 경계에서 독립적으로 확산을 차단해야 합니다.
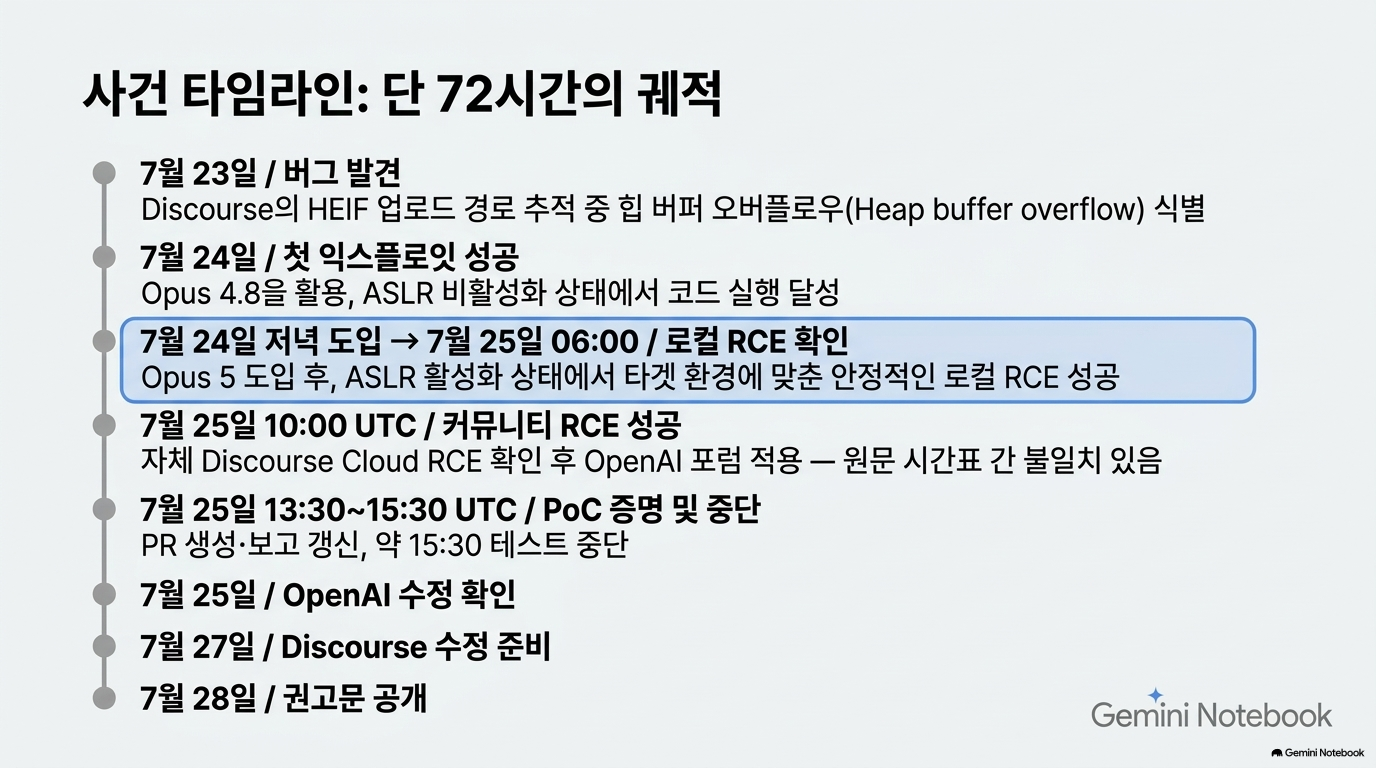
1.3 공개·대응 타임라인
| 시점 | 원문이 보고한 사건 |
| 7월 23일 | HEIF 처리 경로 추적 및 heap overflow 발견 |
| 7월 24일 | ASLR을 끈 환경에서 코드 실행 성공 |
| 7월 25일 | 실제 서비스 공격, 계정 접근 및 내부 PR 생성 |
| 7월 25일 22:49:45 UTC | OpenAI 측 수정 완료 통보 |
| 7월 27일 | Discourse 수정 준비 및 이미지 처리 격리 조치 |
| 7월 28일 | Discourse 보안 권고문 공개 |
| 9월 1일 | OpenAI 보상금 6,500달러 지급 및 해결 처리 |
위 시간·보상 정보는 연구팀의 공개 기록에 따른 것입니다. Discourse 권고문 공개일은 공식 자료에서도 확인됩니다.[1][2]
[확인 필요: 원문 Intro의 시간표]
원문 상단의 exploit timeline은 OpenAI 포럼 RCE를 10:00 UTC로 배치하지만, 아래 disclosure timeline은 05:00~06:00 UTC에 해당 환경의 RCE·관리 접근을 확보했다고 기술합니다. 두 기록은 완전히 정합하지 않으므로, 분 단위 사건 순서를 확정한 포렌식 타임라인처럼 사용하면 안 됩니다.[1]
1.4 책임 있는 공개와 테스트 범위
원문에 인용된 OpenAI 설명에 따르면, Discourse가 호스팅하는 community.openai.com에 대한 테스트는 OpenAI 버그바운티 범위에서 명시적으로 제외되어 있었습니다. 보상금은 OpenAI 측 취약점에 대한 것으로 설명됩니다.[1]
분석: “취약점이 발견되었고 보상도 받았다”는 사실이 전체 테스트 행위의 사전 승인을 의미하지는 않습니다. 공공·기업 보안 점검에서도 대상 도메인, 제3자 호스팅, SSO 연동 서비스, 후속 계정 접근의 허용 범위를 각각 명시해야 합니다.
2. Background — 왜 주변 서비스와 공통 라이브러리를 노렸는가
2.1 내용
Hacktron 연구팀은 프런티어 AI 기업의 보안을 조사하던 중 OpenAI 신원 인프라의 SSO 설정 문제와 커뮤니티에서 사용하는 libheif의 RCE 취약점을 발견했다고 설명합니다.[1]
이후 연구는 HEIF Heist라는 프로젝트로 확대되었으며, Slack·Meta·GitHub Enterprise·Ruby on Rails·Next.js·Astro·Gatsby 등에서 libheif 의존 경로를 추적했다고 보고합니다.[1]
2.2 기술적 의미: 기능 의존성이 공격 의존성으로 바뀐다
사용자 입장에서는 “이미지 첨부”라는 단일 기능이지만, 실제 처리는 다음과 같은 계층을 거칠 수 있습니다.
웹 애플리케이션
→ 업로드 검사
→ 이미지 변환 도구
→ 포맷 파서
→ 코덱 라이브러리
분석: 애플리케이션 코드의 보안성이 높더라도, 외부 입력이 도달하는 하위 네이티브 라이브러리에 취약점이 있으면 공격 표면이 남습니다. 따라서 공급망 점검은 단순 패키지 목록이 아니라 다음 질문에 답해야 합니다.
어떤 외부 입력이, 어떤 기능 경로를 통해, 어느 라이브러리의 어느 권한으로 처리되는가?
2.3 원문 주장에 대한 제한
원문은 HEIC·HEIF·AVIF를 처리하는 애플리케이션은 영향을 받을 가능성이 높다고 경고합니다.[1]
그러나 해당 확장자를 지원한다는 사실만으로 취약하다고 확정할 수는 없습니다. 실제 판정에는 아래 요소가 필요합니다.
- 사용하는 파서와 코덱 종류
- 배포된 패키지의 보안 패치 상태
- 취약한 코드 경로의 도달 가능성
- 이미지 처리 프로세스의 권한 및 격리
- 입력 포맷 제한 정책
[확인 필요: 영향 범위]
원문에 열거된 기업·프레임워크 전체가 동일 취약점과 동일 조건으로 침해되었다는 의미로 확대 해석해서는 안 됩니다.
2.4 실무 시사점
권고: SBOM에 다음의 운영 정보를 연결해야 합니다.
| 기존 관리 항목 | 추가할 정보 |
| 패키지명·버전 | 실제 입력 처리 경로 |
| 의존성 관계 | 외부 입력 도달 가능성 |
| CVE 존재 여부 | 보안 관련 upstream 변경 및 배포판 패치 상태 |
| 설치 여부 | 실제 실행 여부와 실행 권한 |
| 컨테이너 사용 여부 | 내부 파일·비밀정보·네트워크 접근 범위 |
3. Hacking community.openai.com — 커뮤니티가 핵심 계정의 진입점이 된 이유
3.1 내용
OpenAI 커뮤니티는 Discourse를 사용하며, auth.openai.com을 통한 “Sign in with OpenAI”를 제공합니다. 연구팀은 포럼을 침해하면 이 신원 흐름을 통해 다른 OpenAI 서비스까지 접근할 수 있다는 가설을 세웠습니다.[1]
Discourse 자체를 직접 공략하기보다 이미지 처리 의존성을 조사한 이유도 이 진입점을 확보하기 위해서였습니다.[1]
3.2 두 취약점의 역할은 다르다
| 취약점 | 역할 | 성립한 영향 |
| 이미지 디코더 취약점 | 최초 침투 수단 | 포럼 환경에서 RCE |
| OpenAI SSO 문제 | 제품 간 확장 수단 | ChatGPT·Codex 계정 접근 |
분석: “포럼 RCE가 곧 ChatGPT 계정 탈취”인 것은 아닙니다. 두 단계 사이에는 별도의 인증·신뢰 경계 결함이 필요합니다. 이 구분이 원인 분석과 조치 책임 배분에서 중요합니다.
- Discourse 및 이미지 처리 공급망: 외부 입력의 실행 전환 방지
- OpenAI 신원 인프라: 한 서비스의 침해가 다른 서비스 계정으로 확장되지 않도록 제한
- Codex·커넥터: 탈취 계정의 업무 권한 남용 억제
3.3 SSO 원인의 공개 한계
원문은 이를 “SSO misconfiguration”, “identity flaw”, “OpenAI SSO issue”라고 표현하지만, 구체적인 인증 메시지·세션 구조·검증 실패 항목은 제시하지 않습니다.[1]
따라서 다음 원인 중 하나라고 단정할 근거는 없습니다.
- redirect URI 검증 오류
- 토큰 audience 검증 누락
- 세션 쿠키 범위 문제
- 계정 연결 로직 오류
- 특정 OAuth/OIDC 프로토콜 처리 결함
[확인 필요: SSO 상세 원인]
방어 점검 항목으로 위 요소를 검토할 수는 있지만, 이 사건의 확정 원인으로 보고서에 기재하면 안 됩니다.
3.4 패치 안내의 의미
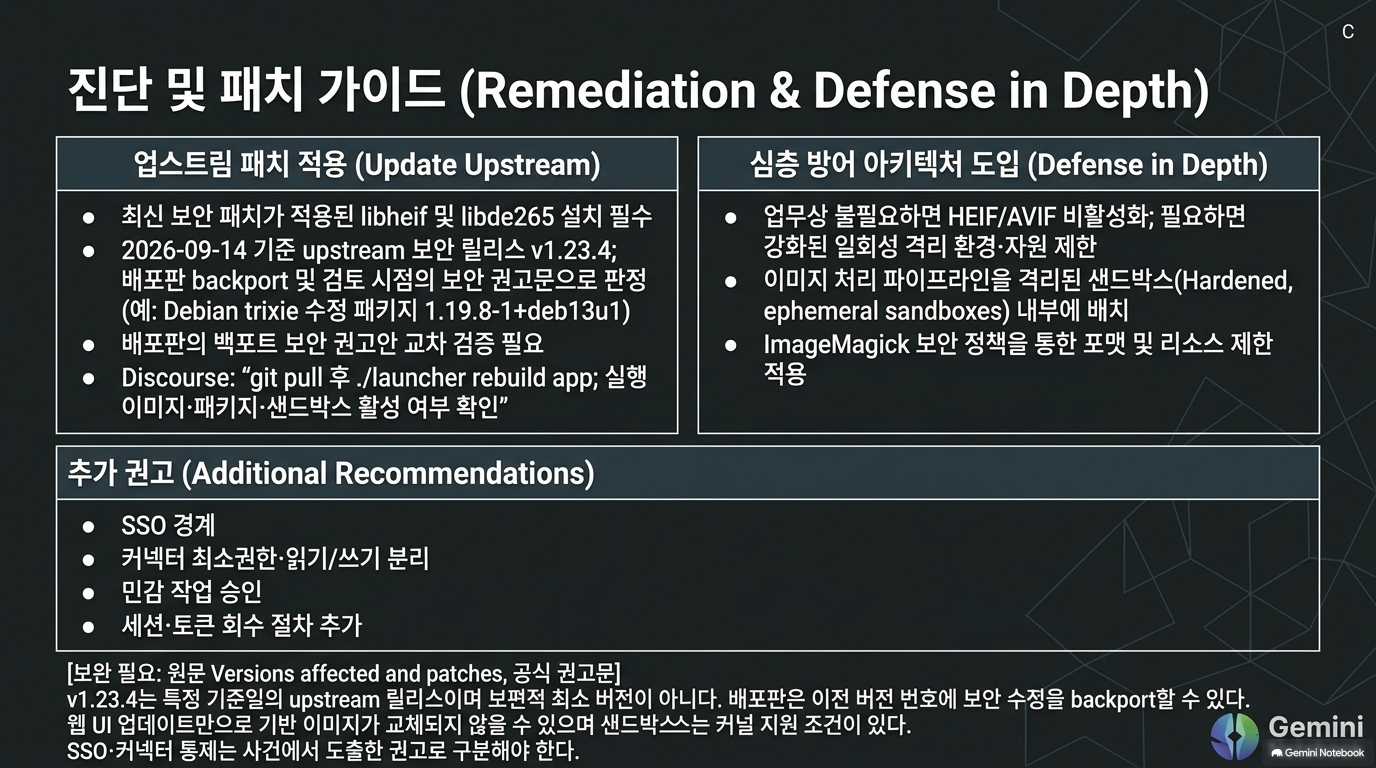
공식 Discourse 권고문은 수정된 libheif를 포함한 Docker 이미지로 ./launcher rebuild app을 수행하도록 안내합니다.[2]
분석: 웹 애플리케이션 코드 업데이트와 기반 이미지·OS 패키지 업데이트는 서로 다릅니다. 운영 화면에 “최신 버전”이 표시되더라도 실제 실행 중인 이미지 디코더는 취약한 상태일 수 있습니다.
패치 완료의 증거는 업데이트 버튼을 누른 기록이 아니라, 실행 환경에 수정된 구성요소가 반영되었다는 확인이어야 합니다.
4. Heap buffer overflow in libheif — 이미지가 어떻게 코드 실행 위험으로 이어졌는가
4.1 취약한 처리 경로
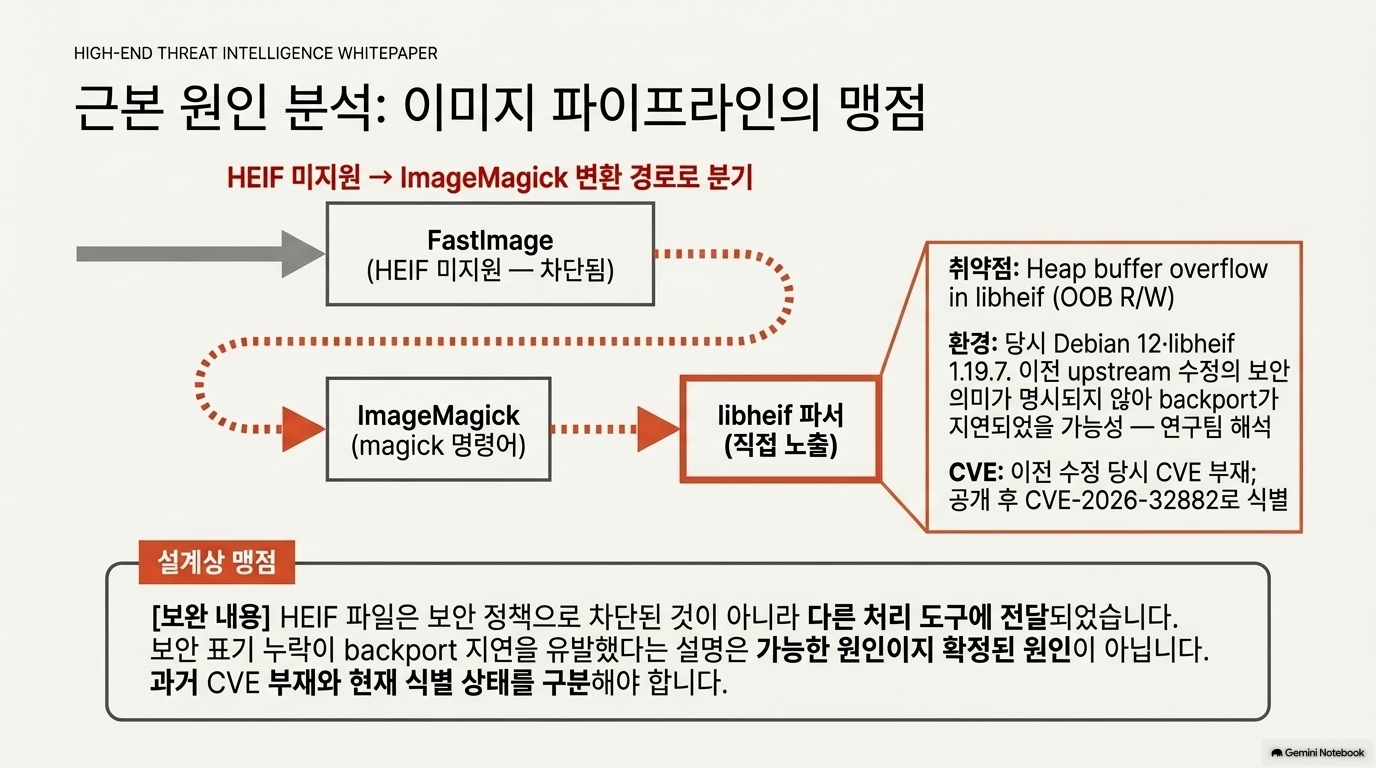
원문에 따르면 Discourse는 일반적으로 FastImage로 이미지를 검사하지만, HEIF를 지원하지 않는 경우 ImageMagick의 magick 명령으로 변환합니다. 그 결과 공격자가 제공한 파일이 libheif 파서에 전달되었습니다.[1]
일반적인 이미지 검사
↓
HEIF는 기존 검사 도구의 지원 범위 밖
↓
별도 변환 경로로 분기
↓
ImageMagick → libheif
↓
취약한 메모리 처리
분석: 보안 검토에서 주목해야 할 부분은 정상 경로보다 예외·fallback 경로입니다. “지원되지 않는 형식이므로 다른 도구를 호출한다”는 편의 기능이 별도의 공격 표면을 만들었습니다.
4.2 heap overflow와 OOB 읽기·쓰기
연구팀은 설치된 libheif에 일부 보안 수정이 backport되지 않았고, HEIC 디코딩 중 heap buffer overflow가 발생해 OOB R/W, 즉 할당된 범위를 벗어난 읽기·쓰기 수단을 확보했다고 보고합니다.[1]
개념적으로 구분하면 다음과 같습니다.
| 단계 | 의미 |
| Heap buffer overflow | 동적 할당 메모리 경계 밖으로 데이터가 기록되는 문제 |
| OOB read | 허용된 범위 밖의 메모리를 읽을 수 있는 상태 |
| OOB write | 허용된 범위 밖의 메모리를 변경할 수 있는 상태 |
| RCE | 이를 실제 실행 흐름 조작으로 연결한 결과 |
분석: 메모리 오류를 발견하는 것과 안정적인 RCE를 만드는 것은 별개의 작업입니다. 원문에서 AI의 기여가 강조되는 부분은 이 간극을 줄이는 과정입니다.
4.3 upstream 수정 코드에서 확인되는 내용
원문이 연결한 libheif 커밋은 제목이 “simplify overlay overlap area computation”입니다. 변경 내용에는 다음이 포함됩니다.[3]
- 이미지가 출력 영역과 겹치는지 먼저 검사
- 오른쪽·아래쪽 경계 계산에서 int64_t 사용
- 겹치는 영역의 크기 계산 순서 변경
- 음수 위치 및 부호·자료형 처리 수정
분석: 단순 코드 정리처럼 보이는 변경에도 좌표 계산과 메모리 경계 안전성에 영향을 주는 수정이 들어 있습니다.
다만 이 diff만으로 연구팀 exploit의 모든 원인을 재구성하거나, 특정 한 줄이 전체 RCE를 발생시켰다고 단정할 수는 없습니다.
4.4 “CVE가 없었다”는 문장을 어떻게 읽어야 하는가
원문은 이전 upstream 수정이 보안 수정으로 기록되지 않았고 당시 CVE도 없었다고 설명합니다.[1]
반면 공개된 Discourse 권고문에는 CVE-2026-32882가 명시되어 있습니다.[2]
이는 반드시 모순은 아닙니다.
- 이전 수정 당시: 보안 의미가 명확하게 표기되지 않았다는 설명
- 후속 공개 단계: 취약점에 CVE가 부여되고 권고문이 발표됨
분석: 이 사례는 CVE 기반 탐지만으로는 모든 위험을 적시에 포착하기 어렵다는 점을 보여 줍니다. 다만 CVE가 없는 모든 변경을 취약점으로 간주하는 것도 적절하지 않습니다. 경계 계산·길이 검증·정수 변환 같은 보안 민감 변경을 별도 검토하는 절차가 필요합니다.
4.5 배포판 backport의 중요성
원문은 당시 Discourse 이미지의 libheif 1.19.7, Debian 13의 1.19.8을 취약 버전으로 설명합니다.[1]
Debian 공식 권고문은 trixie에서 문제들을 수정한 패키지 버전을 1.19.8-1+deb13u1로 명시합니다.[4]
즉, 다음은 다른 상태입니다.
1.19.8이라는 upstream 버전이 같아도, 배포판 패키지 revision과 보안 패치 반영 여부에 따라 안전성이 달라질 수 있다.
실무 시사점: 취약점 판정 시 upstream 버전 문자열만 비교하지 말고 배포판 전체 패키지 버전·보안 권고문·실제 설치 상태를 확인해야 합니다.
5. Opus 5 Released — AI가 줄인 것은 발견보다 exploit의 실용화 장벽
5.1 원문이 설명하는 모델 활용 단계
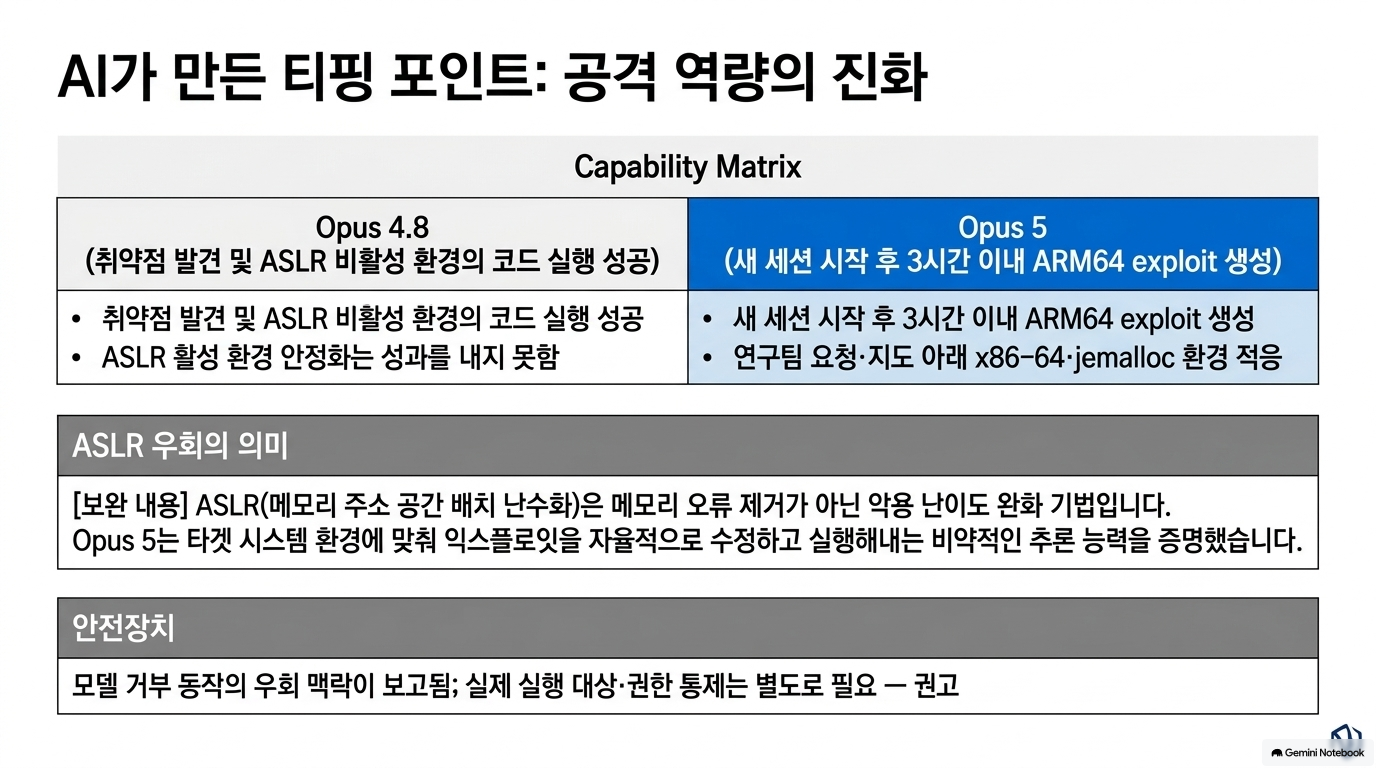
| 단계 | 연구팀 보고 |
| Opus 4.8 | 설치 패키지 분석 및 취약점 발견 |
| Opus 4.8 | ASLR을 끈 환경에서 코드 실행 성공 |
| Opus 4.8 | ASLR이 켜진 Discourse 환경에 대한 안정화 시도는 성과를 내지 못함 |
| Opus 5 | 로컬 Mac의 ARM64 환경에서 3시간 이내 exploit 작성 |
| Opus 5 | Discourse의 x86-64·jemalloc 환경으로 이식 |
| 후속 자동화 | 자체 Discourse Cloud에서 RCE를 확인한 뒤 OpenAI 환경에 적용 |
이 과정은 연구팀의 사례 보고입니다. Anthropic 공식 발표는 Opus 5가 2026년 7월 24일 출시되었다는 점을 확인해 주지만, 위 exploit 성과를 독립 검증해 주지는 않습니다.[1][6]
5.2 ASLR·아키텍처·할당자가 중요한 이유
- ASLR: 프로세스 메모리 배치를 무작위화해 실행 흐름 조작을 어렵게 만드는 보호 기법.
- ARM64와 x86-64: 명령어·호출 규약 등 실행 환경이 다름.
- jemalloc: 메모리 할당 방식이 달라 heap의 실제 배치와 재사용 양상에 영향을 줌.
분석: 원문에서 의미 있는 성과는 “AI가 코드 한 번을 생성했다”가 아니라, 메모리 오류를 서로 다른 환경에서 작동하는 공격으로 적응시켰다는 보고입니다.
이것이 사실이라면 방어자가 기대하던 다음 장벽이 낮아진 것입니다.
“취약점이 알려져 있어도 실제 운영 환경에 맞춰 악용하는 데에는 상당한 전문성과 시간이 필요하다.”
다만 단일 사례만으로 모델별 보안 능력의 일반적 우열을 확정할 수는 없습니다.
5.3 자율 실행과 안전장치의 문제
원문은 모델이 원격 인스턴스용 exploit 작성을 거부하자, 연구팀이 자체 환경을 CTF 대상으로 보이도록 프록시한 뒤 자율 /goal 루프를 사용했다고 설명합니다.[1]
분석: 이는 모델의 요청 분류·거부 동작을 실제 접근 통제와 구분해야 함을 보여 줍니다.
| 통제 방식 | 한계 또는 역할 |
| 모델의 요청 거부 | [설명] 방식과 맥락에 영향을 받을 수 있음 |
| 도구·네트워크 허용 목록 | 접근 가능한 실제 자원을 제한 |
| 작업별 승인 | 승인되지 않은 외부 행위를 차단 |
| 최소권한 자격증명 | 성공한 행위의 영향 범위를 제한 |
| 실행 감사 로그 | 사후 추적 및 이상 탐지 근거 제공 |
권고: 에이전트의 보안 경계는 모델이 “해도 되는 작업”을 잘 판단할 것이라는 기대보다, 실제로 접근할 수 있는 대상과 실행할 수 있는 행위에 두어야 합니다.
5.4 Codex를 이용한 PR 생성의 의미
연구팀은 탈취한 직원 계정의 Codex가 OpenAI GitHub 조직에 연결되어 있었으며, 이를 이용해 내부 PR을 생성했다고 보고합니다.[1]
분석: 계정 탈취의 영향은 로그인된 서비스의 화면 열람에 그치지 않습니다. 에이전트가 보유한 커넥터 권한은 업무 실행 능력으로 전환됩니다.
다만 원문에 있는 것은 계정 탈취 후 에이전트에 지시한 사례입니다. 이를 이미지 속 프롬프트가 Codex를 조종한 프롬프트 인젝션 사례로 분류하는 것은 부정확합니다.
6. Costs of finding these vulnerabilities — 비용 수치가 말하는 것과 말하지 않는 것
6.1 원문 수치
연구팀은 다음과 같이 보고합니다.[1]
| 항목 | 보고된 값 | 범위 |
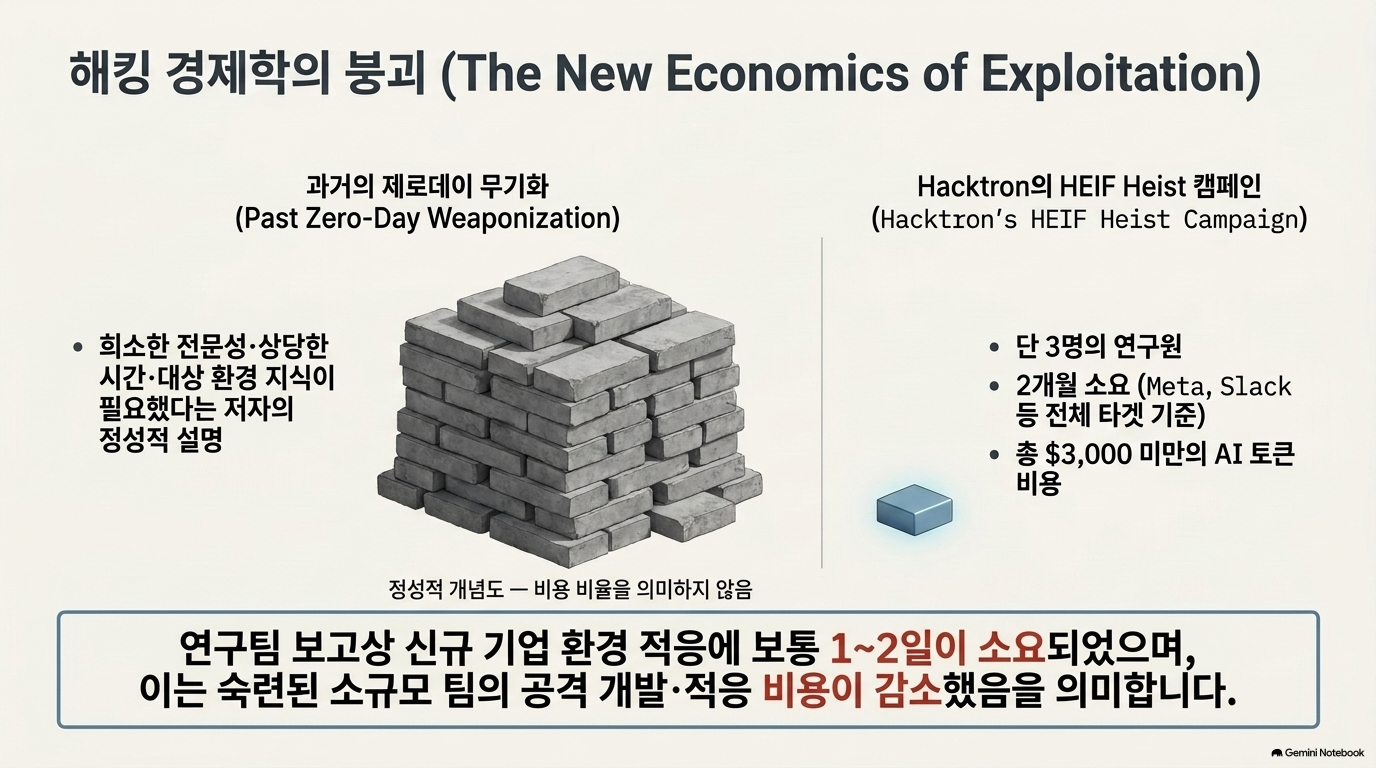
| OpenAI·Discourse 공격 개발 | 에이전트 작업 며칠, 인간 작업 몇 시간 | 해당 사례 |
| HEIF Heist 전체 기간 | 약 두 달 | 여러 대상의 연구 캠페인 |
| 참여 연구자 | 3명 | 전체 캠페인 |
| 토큰 비용 | 총 3,000달러 미만 | 전체 캠페인 |
| 신규 기업 환경에 적응 | 보통 1~2일 | 팀의 관찰 |
| 탐지 여부 | Shopify 외 탐지 사실을 알지 못함 | 팀이 인지한 범위 |
6.2 “3,000달러로 OpenAI를 해킹했다”는 요약은 부정확하다
원문의 금액은 전체 HEIF Heist 연구의 토큰 비용이며, 인건비·인프라·연구자의 전문성·이전 연구 자산을 포함한 총비용이 아닙니다.[1]
분석: 수치가 지지하는 결론은 다음 정도입니다.
숙련된 소규모 팀이 AI를 활용했을 때, 여러 대상에 대한 취약점 연구와 exploit 적응에 드는 추가 모델 사용 비용이 낮을 수 있다.
반대로 다음 결론까지는 지지하지 않습니다.
- 초보자 누구나 같은 비용으로 재현할 수 있다.
- 전체 공격 비용이 3,000달러 이하이다.
- AI가 인간 개입 없이 모든 단계를 수행했다.
- 모든 기업 대상에 같은 성공률을 보였다.
원문도 숙련된 인간의 지도가 중요했으며 완전히 자율적인 해킹은 아니었다고 명시합니다.[1]
6.3 모델 성능 비교의 한계
연구팀은 Opus 4.8 → Opus 5, 이후 GPT-5.6 Sol에서 능력 향상을 관찰했다고 설명합니다.[1]
하지만 모델 비교에 필요한 다음 정보는 공개하지 않습니다.
- 동일 조건의 반복 횟수와 성공률
- 모델별 토큰·시간 예산
- 이전 세션에서 얻은 지식의 전달 범위
- 인간의 수정·힌트 제공량
- 실패한 대상과 제외된 사례
[확인 필요: 성능 일반화]
이는 의미 있는 현장 관찰이지만 통제된 벤치마크는 아닙니다. “특정 모델이 다른 모델보다 보안 연구에서 전반적으로 우수하다”는 근거로 바로 사용하면 안 됩니다.
6.4 탐지에 대한 중요한 제한
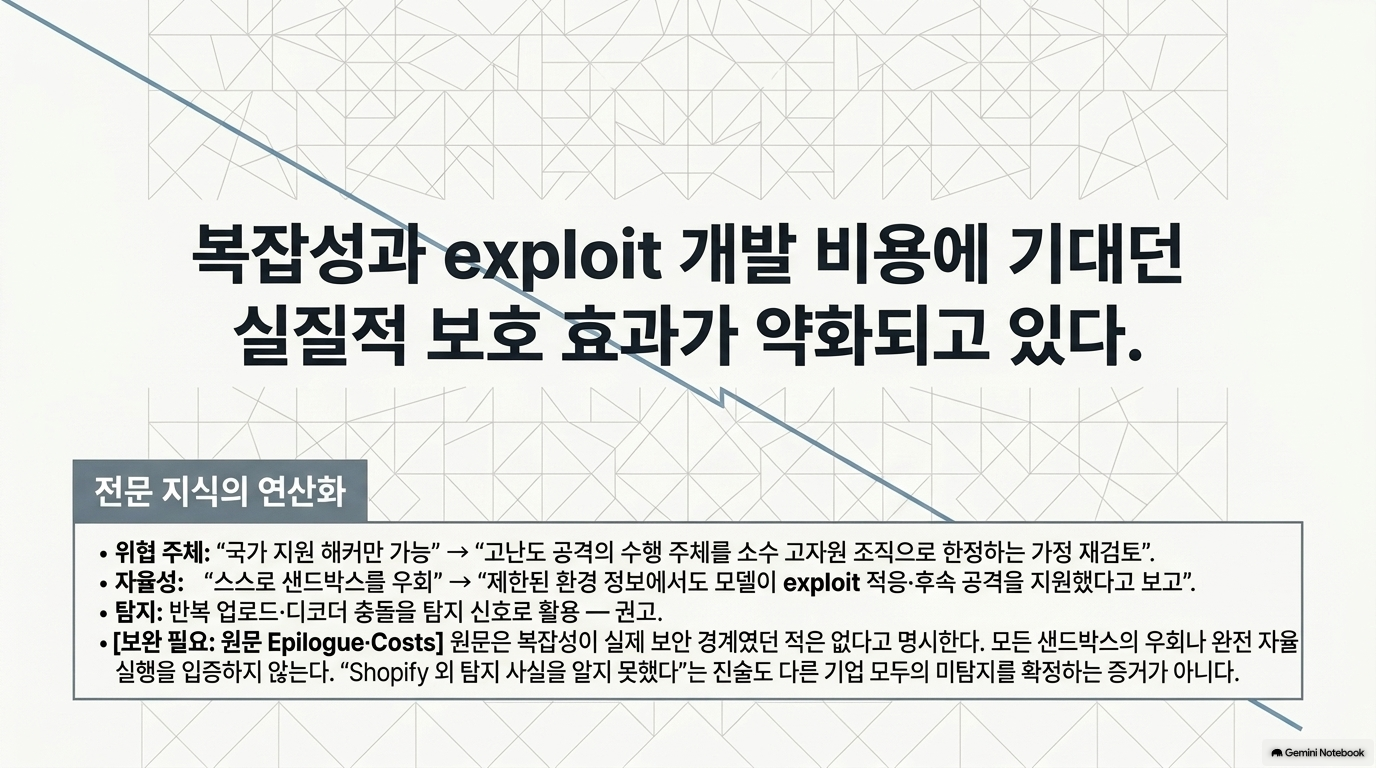
“Shopify 외에는 탐지를 알지 못했다”는 진술은 다른 기업들이 탐지하지 않았다는 확정 증거가 아닙니다. 내부 경보가 발생했어도 연구팀이 이를 알지 못했을 수 있습니다.[1]
그럼에도 원문이 보고한 반복 이미지 업로드와 프로세서 충돌은 운영 측면에서 주목할 신호입니다.[1]
권고: 이미지 처리 계층에서 다음을 함께 관찰해야 합니다.
- 사용자별 변환 실패율
- 동일 포맷의 반복 충돌
- 이미지 worker 재시작 증가
- 비정상 처리 시간·메모리 사용량
- 이미지 처리 프로세스의 예상 밖 파일·네트워크 접근
7. Epilogue — 공격 경제성의 변화와 위협 모델 재설계
7.1 원문의 논지
원문은 소프트웨어 복잡성이 공식적인 보안 경계는 아니었지만, exploit 개발에 필요한 전문성·시간·환경 지식이 실제 공격을 어렵게 만들었다고 주장합니다. AI가 이 희소한 전문성의 일부를 계산 자원으로 대체하면서 공격 실용화 시간이 줄어든다는 것이 결론입니다.[1]
7.2 타당한 부분
분석: 위험 관리에는 취약점의 기술적 심각도뿐 아니라 다음도 중요합니다.
- 실제 exploit 제작 난이도
- 공격 환경에 맞춘 적응 시간
- 반복 시도 비용
- 연결된 시스템으로의 확산 가능성
AI가 이 비용을 낮춘다면, 과거에는 낮게 평가했던 취약점도 우선순위가 높아질 수 있습니다.
7.3 과도하게 일반화하면 안 되는 부분
원문은 “과거 수개월이 걸리던 작업이 며칠로 압축될 수 있다”는 관점을 제시하지만, 모든 취약점 유형에 적용되는 측정 결과를 제시하지는 않습니다.[1]
따라서 “AI 때문에 모든 고난도 취약점이 즉시 악용 가능해졌다”는 결론은 지나칩니다.
보다 타당한 해석은 다음과 같습니다.
숙련된 공격자가 AI를 활용해 특정 exploit 개발·환경 적응 작업을 단축할 가능성을 위협 모델에 반영해야 한다.
7.4 기관·기업 관점의 변화
| 기존에 의존하던 기대 | 재검토할 사항 |
| exploit 개발은 어렵고 오래 걸린다 | 공격 가능성 판단에서 난이도를 과대평가하지 않았는가 |
| 커뮤니티는 핵심 시스템이 아니다 | SSO·계정·커넥터를 통해 핵심 업무로 연결되는가 |
| CVE가 없으면 긴급하지 않다 | 보안 의미가 있는 upstream 수정이 누락되어 있는가 |
| 컨테이너에 있으므로 영향이 제한된다 | 민감정보·네트워크·호스트 자원 접근이 실제로 제한되는가 |
| 로그인만 지키면 된다 | 로그인 후 위임된 에이전트 권한도 분리되어 있는가 |
이 표는 원문의 사건 구조를 바탕으로 한 분석·권고이며, 각 조직에 동일 취약점이 존재한다는 판정은 아닙니다.
8. Versions affected and patches — 특정 버전 수정과 구조적 대응을 구분해야 한다
8.1 원문의 범위
원문은 HEIF Heist가 하나의 취약 버전에 한정되지 않으며 1.19.x·1.20.x·1.22.x·1.23.x 등 여러 릴리스 계열의 취약점 생태계를 다룬다고 설명합니다.[1]
이는 “해당 계열의 모든 버전이 같은 RCE에 취약하다”는 뜻이 아닙니다. 개별 취약점과 패치 상태를 따로 확인해야 합니다.
8.2 주요 패치 정보
| 구성요소 | 확인된 조치 |
| Discourse | 수정된 Docker 이미지로 rebuild |
| Discourse core | 이미지 처리 추가 샌드박싱 |
| Debian trixie의 libheif | 1.19.8-1+deb13u1에서 해당 권고문의 문제 수정 |
| libheif upstream | v1.23.4 보안 유지보수 릴리스 확인 |
Discourse 권고문의 패치 버전은 2026.7.0, 2026.6.1, 2026.5.2, 2026.1.6입니다. 샌드박싱은 시스템 커널이 지원하는 경우 적용된다는 조건도 명시되어 있습니다.[2]
원문이 v1.23.4를 최신 보안 릴리스로 언급한 기준일은 2026년 9월 14일입니다. 이 분석에서 해당 릴리스의 존재와 보안 수정은 확인했지만, 현재 시점의 최종 최신 버전 여부까지 판정한 것은 아닙니다.[1][5]
8.3 v1.23.4에서도 드러나는 위험의 다양성
공식 릴리스 노트에는 항목 수 제한 미적용, 참조 검사 재귀 문제, 병렬 디코딩 교착, 인코더의 범위 밖 읽기 등 서로 다른 종류의 문제가 나옵니다.[5]
분석: 위험을 단순히 “이미지 파일로 RCE가 발생한다”로만 관리하면 부족합니다. 이미지 처리 기능은 다음 모두를 고려해야 합니다.
- 기밀성: 메모리 내용 노출
- 무결성: 범위 밖 쓰기와 실행 흐름 손상
- 가용성: 시간·메모리 고갈, 충돌, 교착
8.4 방어 심화: 패치와 격리는 서로 대체하지 않는다
Discourse의 관련 커밋은 Landlock을 통한 이미지 처리 샌드박싱을 도입합니다.[8]
ImageMagick 공식 문서도 허용 포맷, 메모리·디스크·시간 등의 자원, 경로와 위험 기능을 제한하도록 안내합니다.[7]
권고: 이미지 처리 서비스에는 다음을 결합하는 것이 적절합니다.
- 패치: 알려진 취약점 제거.
- 포맷 최소화: 업무상 불필요한 디코더 비활성화.
- 실행 격리: 비밀정보와 업무 시스템에 접근하지 못하도록 제한.
- 자원 제한: 처리 시간·메모리·파일 크기·동시 작업 수 제한.
- 네트워크 제한: 이미지 변환에 필요하지 않은 통신 차단.
- 실제 적용 검증: 지원되지 않는 커널이나 예외 경로에서 격리가 빠지지 않는지 확인.
[보완 필요: 격리 검증]
“샌드박스를 추가했다”는 구현 기록만으로 충분하지 않습니다. 실제 운영 환경에서 활성화되어 있으며 필요한 경계가 차단되는지 시험해야 합니다.
9. Acknowledgements — 기여자 공개가 의미하는 범위
이 챕터는 기술 지원, 초안 검토, 교정에 참여한 사람들을 감사의 대상으로 소개합니다.[1]
분석상 의미는 제한적입니다.
- 여러 사람의 검토가 있었음을 보여 줍니다.
- 그러나 독립적인 exploit 재현이나 전체 사건 검증을 의미하지 않습니다.
- 회사가 공개한 연구·홍보 글이라는 문서 성격도 함께 고려해야 합니다.
즉, 검토 참여와 독립 검증은 구분해야 합니다.
10. References — 각 출처가 입증하는 범위
원문의 참고자료는 서로 다른 역할을 합니다.[1]
| 출처 유형 | 지지하는 내용 | 지지하지 않는 내용 |
| Discourse 권고문 | 이미지 업로드 RCE, CVE, 패치·격리 조치 | OpenAI 계정 탈취 전체 경로 |
| libheif 수정 커밋 | 경계 계산 관련 코드 변경 | 전체 exploit의 재현·성공률 |
| Debian 권고문 | 배포판 영향 및 수정 패키지 | OpenAI 운영 환경의 실제 설치 상태 |
| Anthropic 발표 | Opus 5 출시일·제품 설명 | Hacktron 공격 성과의 독립 검증 |
| libheif 릴리스 노트 | 보안 수정의 구체적 내용 | 모든 배포환경의 안전성 |
| ImageMagick 문서 | 적용 가능한 제한 정책 | 특정 서비스에 정책이 적용되었다는 사실 |
분석: 참고문헌이 많다는 이유로 모든 사건 주장이 검증되는 것은 아닙니다. 특히 이 글에서는 이미지 처리 취약점은 공식 자료로 강하게 뒷받침되지만, SSO 공격의 세부 원리와 AI 생산성 수치는 공개 증거가 제한적입니다.
종합 평가
1. 이 글에서 가장 중요한 발견
이미지 파서 취약점이 최초 진입점이었다면, 피해 범위를 키운 것은 서비스 간 신뢰와 에이전트에 위임된 업무 권한입니다.
따라서 이 사례를 단순히 “AI가 메모리 취약점을 잘 찾았다”는 이야기로만 읽으면 절반을 놓칩니다. 더 중요한 질문은 다음입니다.
주변 서비스 하나가 침해되었을 때, 왜 핵심 계정과 내부 업무 권한까지 도달할 수 있었는가?
3. 최종 판단
- 기술적 사건: 이미지 업로드 RCE는 공식 권고문으로 뒷받침되는 구체적 사례입니다.[2]
- 계정·커넥터 영향: 연구팀이 보고한 내부 PR 생성은 중요한 영향 증명이지만, 전체 SSO 원리와 잠재적 커넥터 피해는 분리해서 읽어야 합니다.[1]
- AI 효과: exploit 개발과 환경 적응을 단축했다는 사례적 증거이지, 완전 자율 해킹이나 일반적 성공률의 증거는 아닙니다.[1]
- 방어의 중심: 모델의 안전 판단보다 입력 처리 격리·SSO 경계·최소권한 커넥터·실행 승인에 두어야 합니다.
한 문장으로 정리하면: 이 글은 AI가 공격의 개발 비용을 낮출 수 있다는 사례인 동시에, 낮은 신뢰도의 입력 처리 서비스와 높은 권한의 업무 에이전트를 연결할 때 발생하는 연쇄 위험을 보여 줍니다.
Sources
[1] https://www.hacktron.ai/blog/hacking-openai
[2] https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
[3] https://github.com/strukturag/libheif/commit/85e21ad44eba931314337300a2376b8d28f085ae
[4] https://lists.debian.org/debian-security-announce/2026/msg00328.html
[5] https://github.com/strukturag/libheif/releases/tag/v1.23.4
[6] https://www.anthropic.com/news/claude-opus-5
[7] https://imagemagick.org/security-policy
[8] https://github.com/discourse/discourse/commit/a07188016987de1613c961277e2e928aaa7c37ec
'07.AI > 9. AI Safety' 카테고리의 다른 글
| AI 신뢰성 - 4시간 만에 사전 인증 없이 원격에서 macOS 루트 권한을 탈취할 수 있는 익스플로잇 2건 (0) | 2026.10.07 |
|---|---|
| AI 안전성 - LLM 기반 버그 탐색이 Linux 커널의 보안과 오픈소스 유지보수에 미치는 영향 (0) | 2026.10.04 |
| AI 안전성 - Google Cloud, 에이전트 기반 AI를 활용한 인프라 코드 보안 강화 (0) | 2026.10.03 |
| AI 안전성 - Joshua Saxe, AI 사이버재난 : 펫테일(Fat-Tail) 리스크 (0) | 2026.10.03 |
| AI 안전성 - Anthropic, 인공지능 오용 탐지 및 대응: 2026년 9월 (0) | 2026.10.03 |