https://oreillyradar.substack.com/p/will-typesafes-jev-change-how-we
2026.9.24
[Will TypeSafe’s Jev Change How We Build AI Applications?]
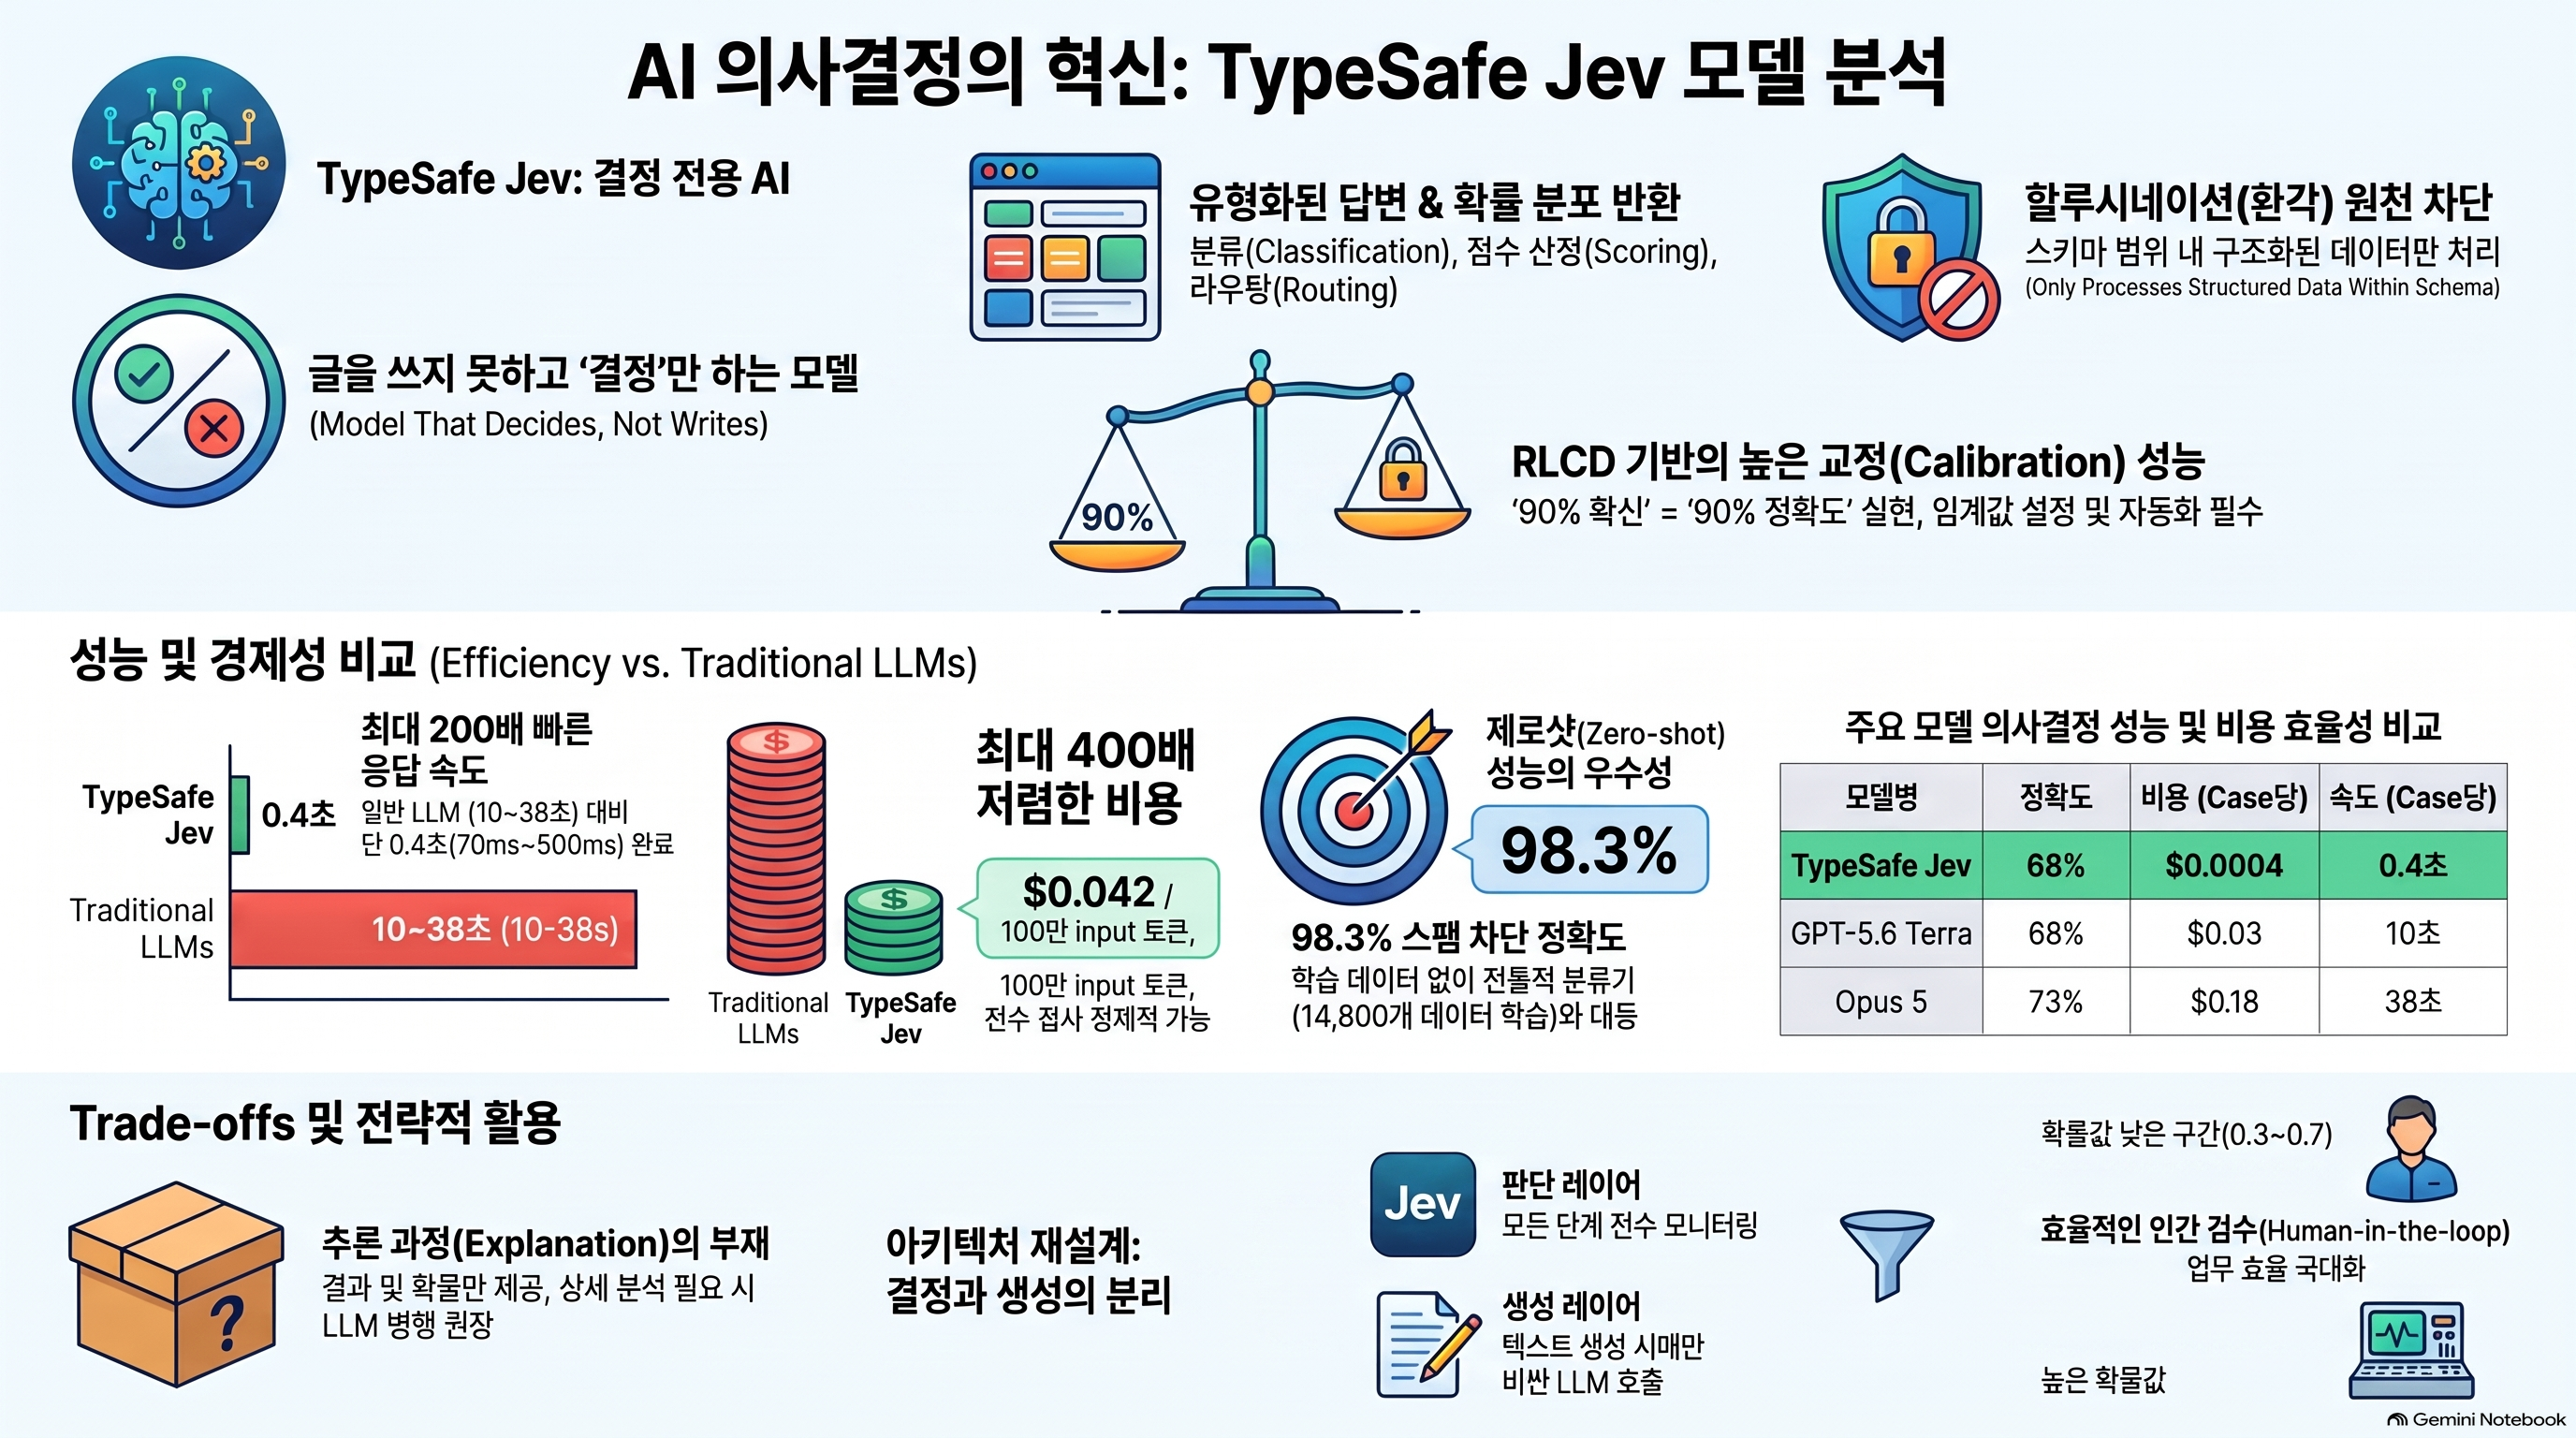
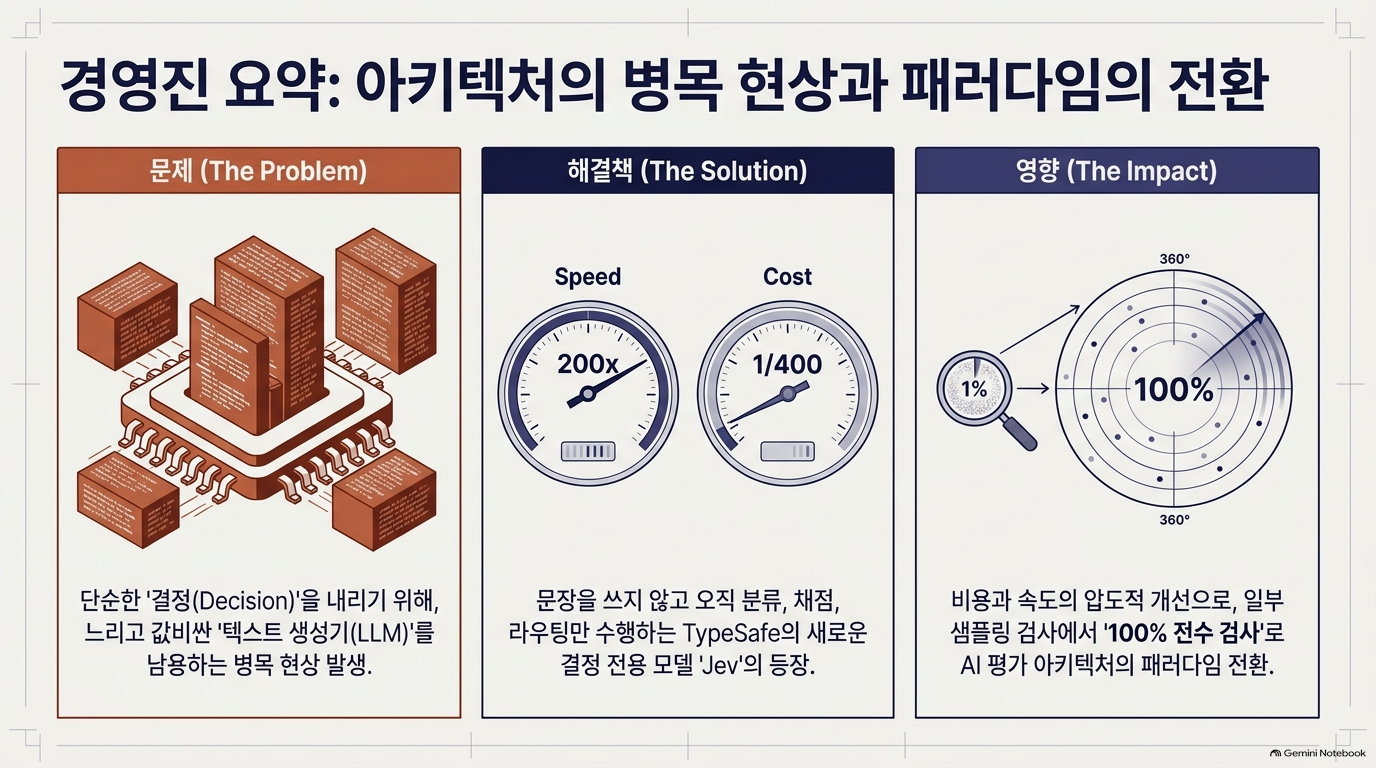
이 글은 텍스트 생성 능력은 없지만 오직 판단과 분류에만 최적화된 새로운 AI 모델인 TypeSafe의 Jev를 소개하며, 이것이 AI 애플리케이션 설계에 미칠 파급력을 분석합니다. 저자는 Jev가 기존 거대 언어 모델(LLM)보다 압도적으로 저렴한 비용과 빠른 속도를 자랑하면서도, 정확한 확률 분포를 제공하여 의사결정의 신뢰도를 높인다는 점을 핵심 장점으로 꼽습니다. 비록 생성형 모델처럼 상세한 추론 근거를 설명하지는 못하지만, 대규모 데이터의 실시간 모니터링이나 효율적인 평가 레이어 구축에 있어 혁신적인 대안이 될 수 있음을 강조합니다. 결과적으로 이 텍스트는 개발자들에게 모든 작업에 무거운 LLM을 사용하는 대신, 의사결정과 텍스트 생성을 분리하는 보다 경제적이고 정교한 아키텍처로의 전환을 제안하고 있습니다.
이 글은 Jev의 기술적 새로움보다 AI 애플리케이션 아키텍처를 바꿀 수 있는 경제성에 초점을 둔 가장 실용적인 분석입니다.[1]
핵심 주장
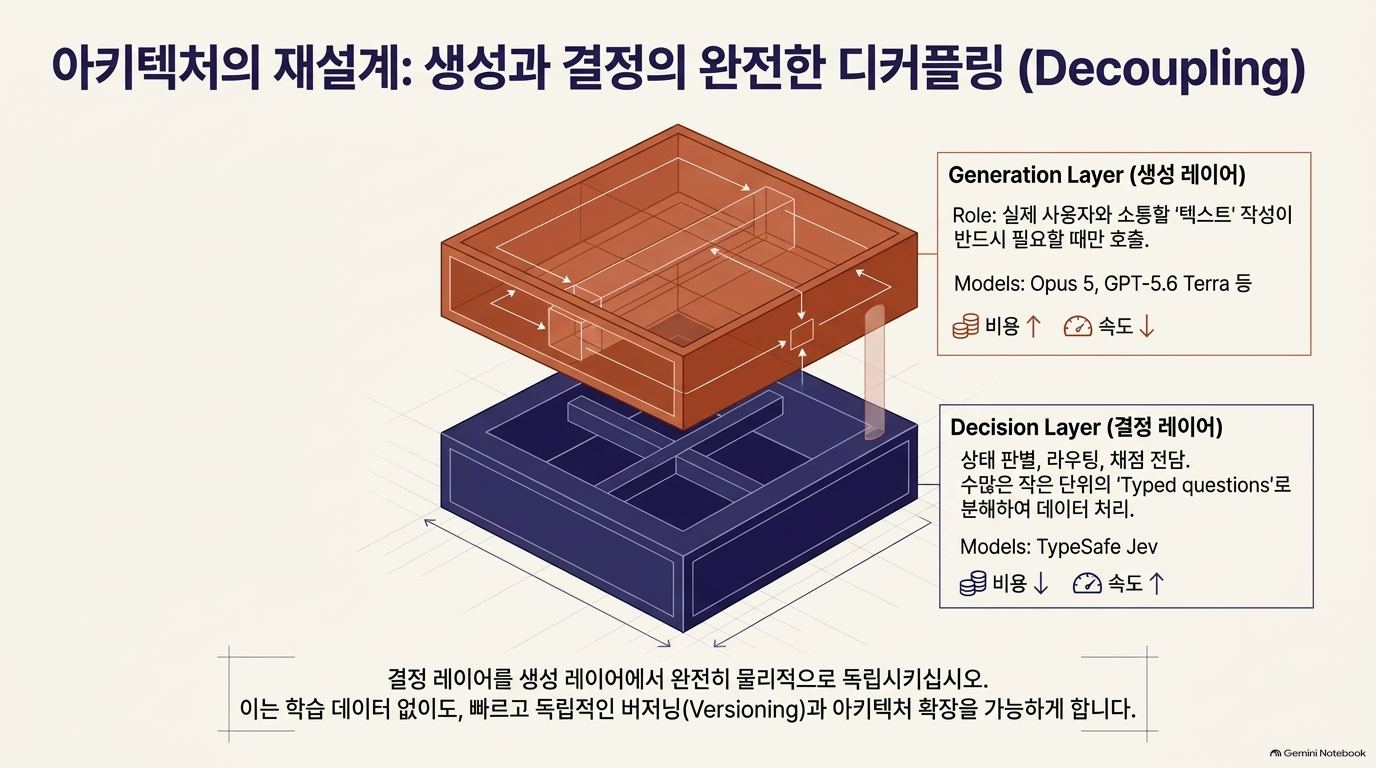
1. “생성”과 “판단”을 분리하라
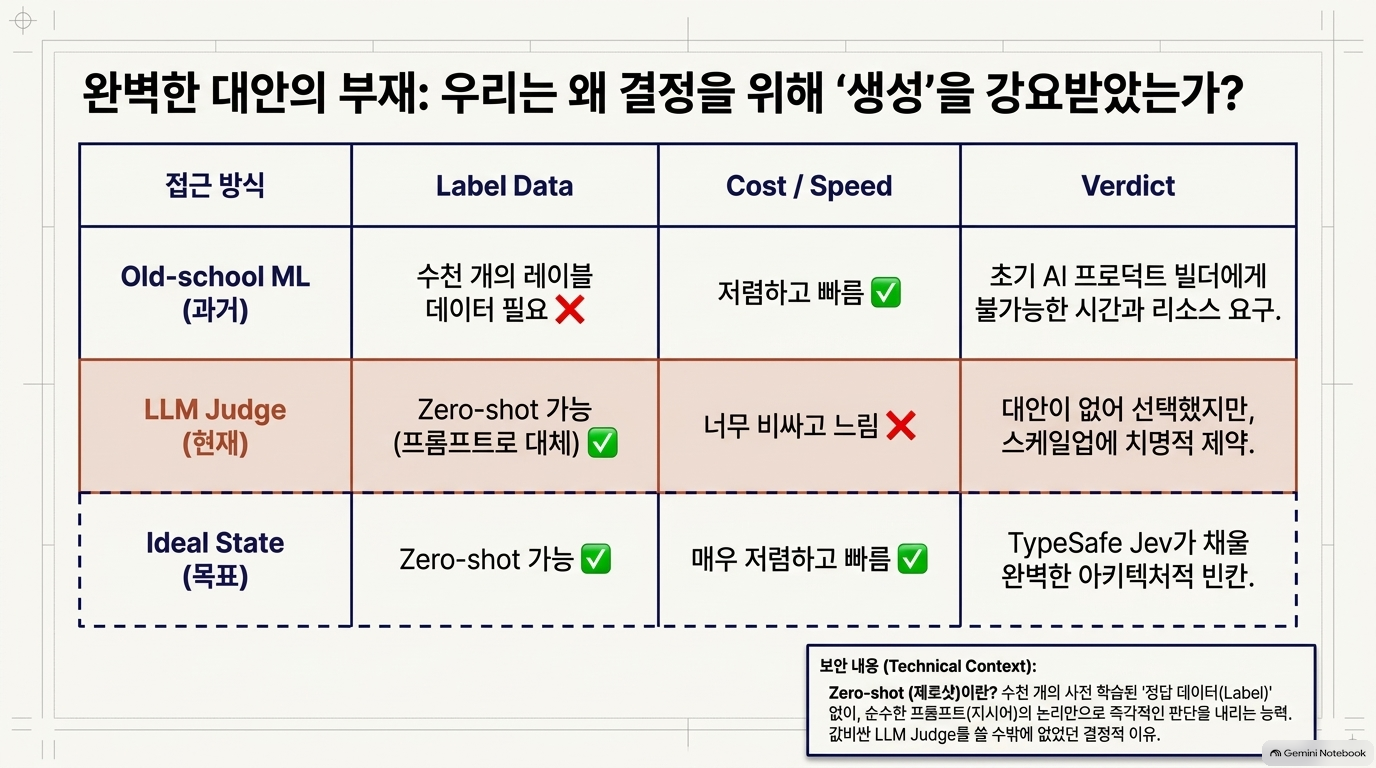
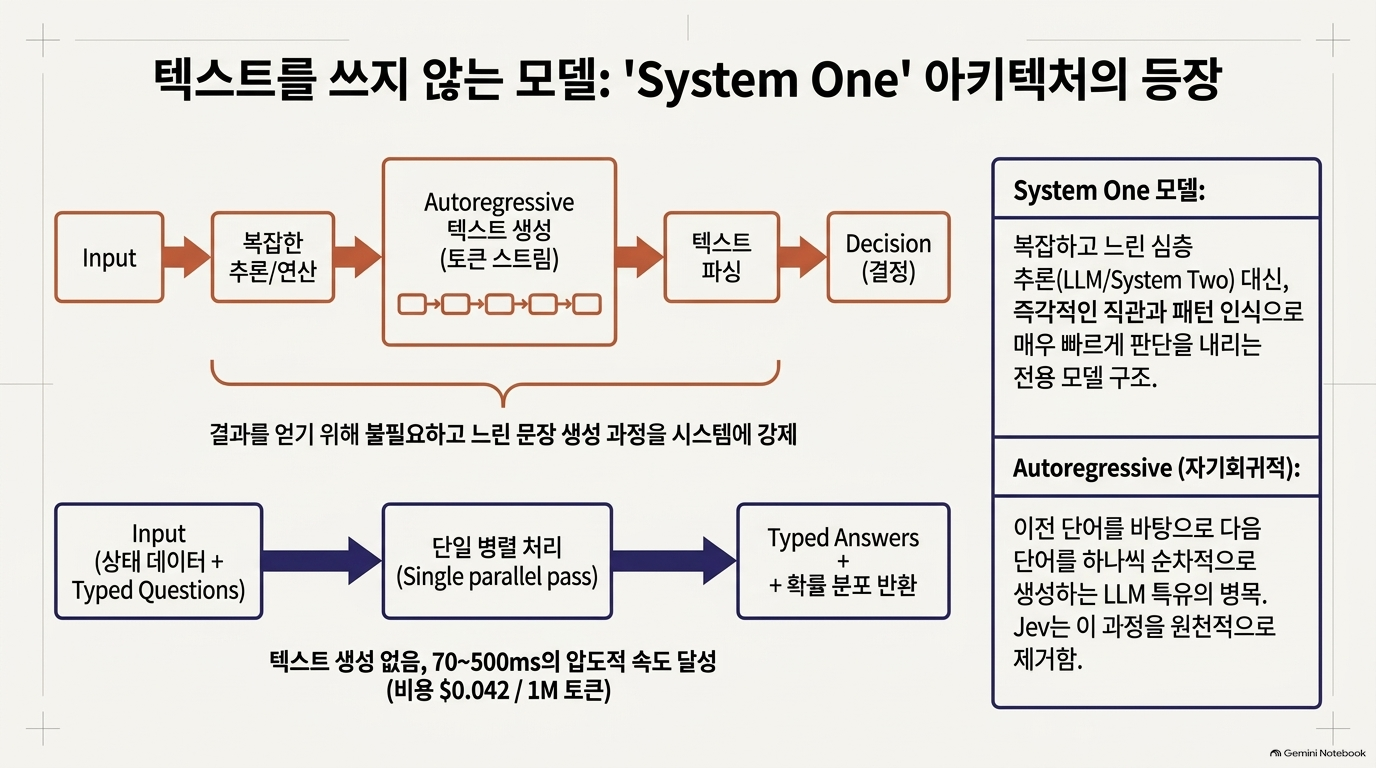
현재 많은 AI 애플리케이션은 다섯 개 중 하나를 고르는 판단에도 범용 LLM이 긴 추론과 JSON 생성을 수행합니다. 글은 이를 비효율로 봅니다.
기존
상태 → 범용 LLM 생성·추론 → 텍스트/JSON → 파싱 → 정책 실행
Jev식
상태 → 확률 기반 typed decision → 정책 엔진 → 실행·검토·생성
즉, LLM은 설명·작성·복합추론에만 쓰고, 라우팅·통과/실패·위험도·검토 필요성 같은 반복 판단은 Jev 같은 decision layer로 분리하자는 제안입니다.[1]
2. 가장 큰 가치는 “전수 평가” 가능성
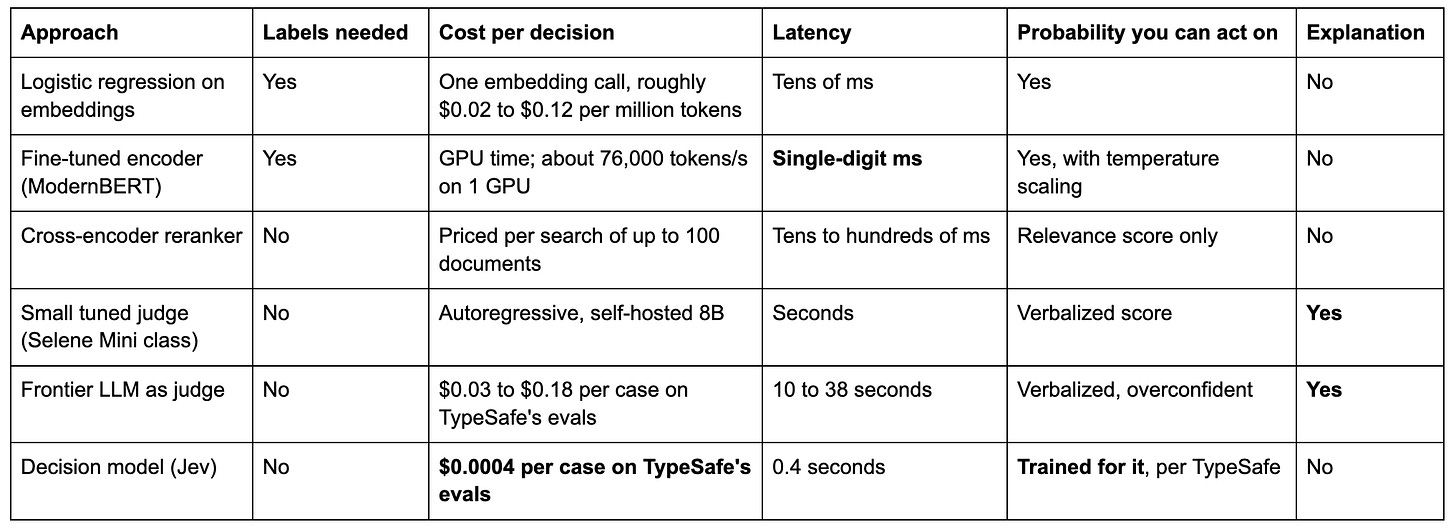
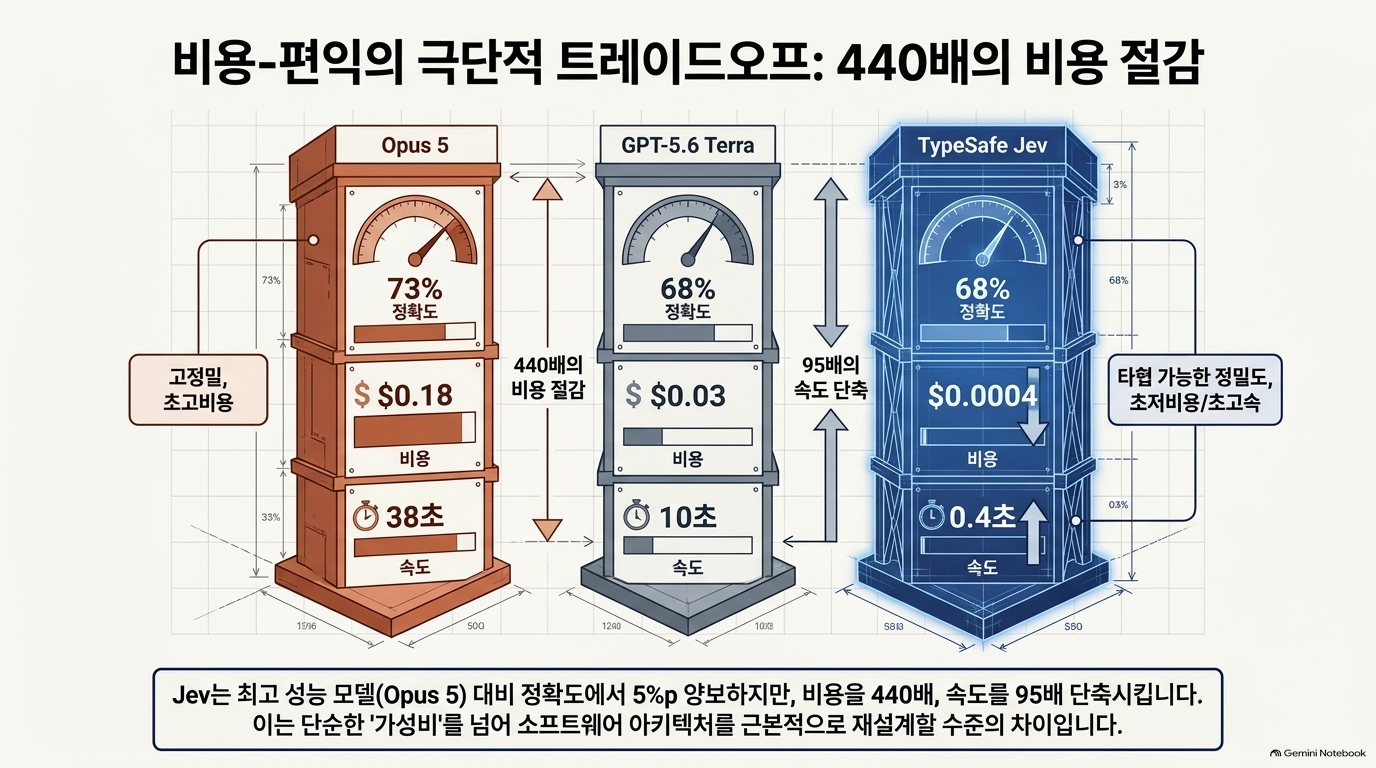
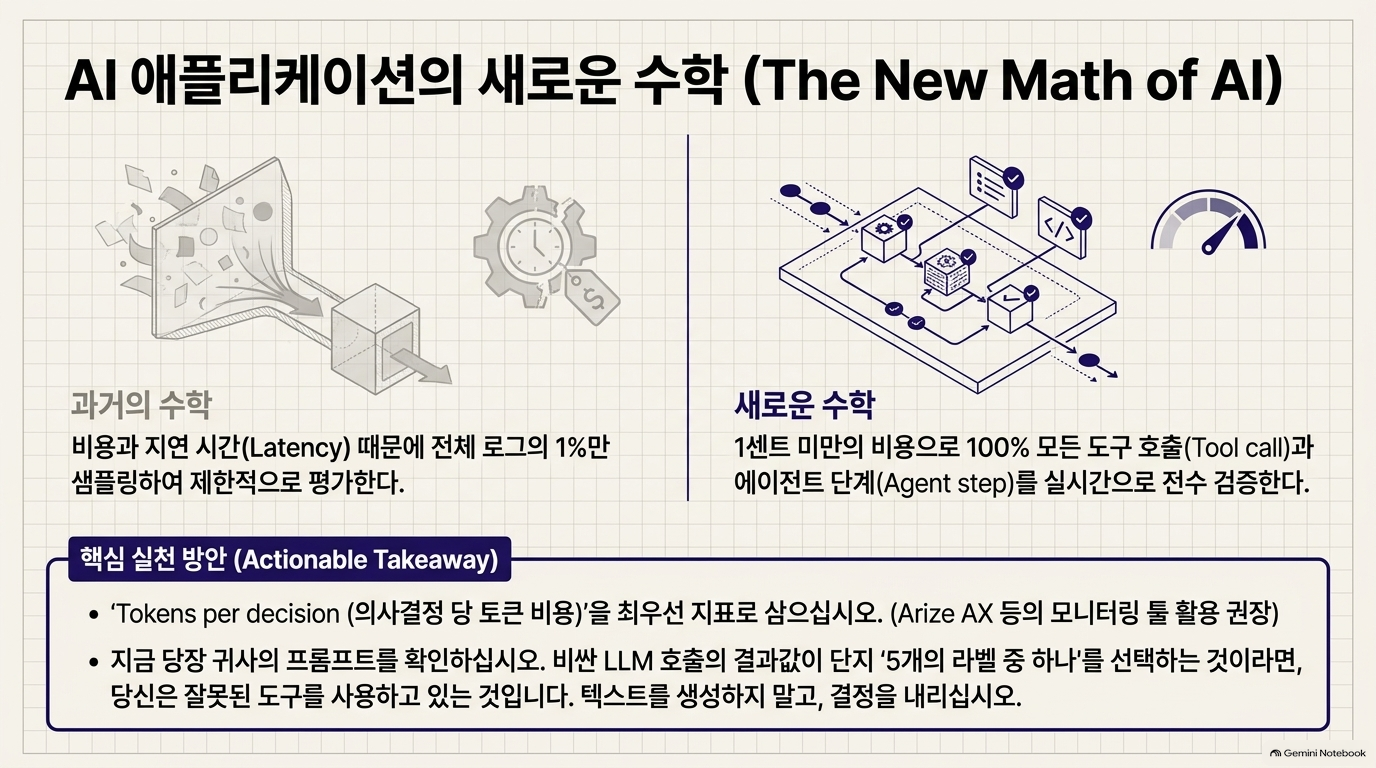
글이 제시하는 Jev의 공개 평균은 건당 $0.0004, 0.4초, 정확도 약 68%입니다. 비교 대상으로 든 Terra workflow는 정확도 약 68%, $0.03, 10초입니다. 정확도가 동등 수준이라면 비용·지연 차이로 인해 샘플링 평가가 아니라 모든 agent trace·tool call·중간 결과를 검사하는 구조가 가능해진다는 주장입니다.[1]
이는 다음과 같은 감리·운영 구조로 이어집니다.
모든 처리 건
├─ Jev: 정책 위반·누락·위험·검토 필요성 전수 판정
├─ 고확신·저위험: 자동 처리
├─ 중간 확률: 사람 검토 큐
└─ 저확신·고위험: 강한 추론모델 또는 사람 재검증
3. 정확도보다 “어느 5%를 넘길 것인가”가 중요
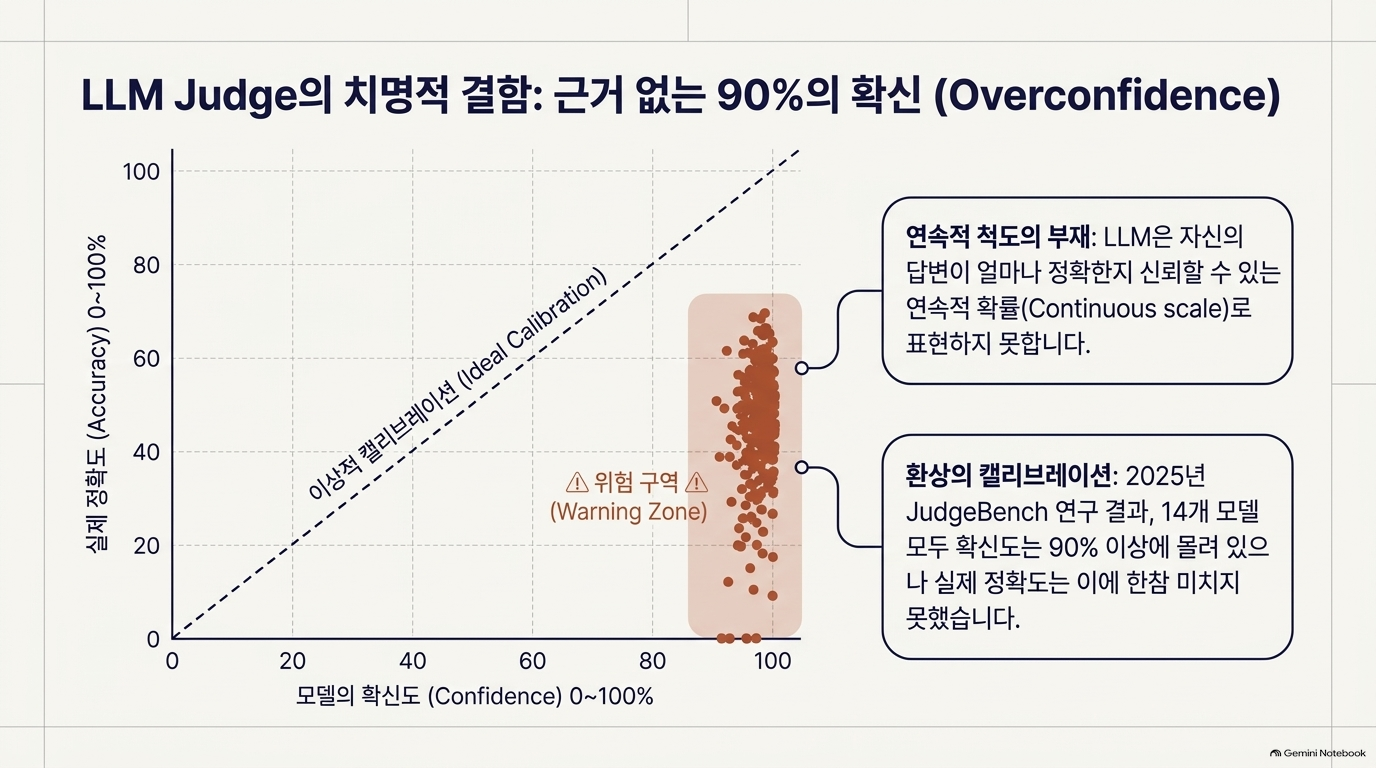
글의 가장 중요한 메시지입니다. 모델이 95% 정확해도 오류가 어디에 있는지 모르면 결국 전량을 사람이 검토해야 합니다. 자동화에는 평균 정확도뿐 아니라 보정된 확률, threshold, escalation, drift monitoring이 필요합니다.[1]
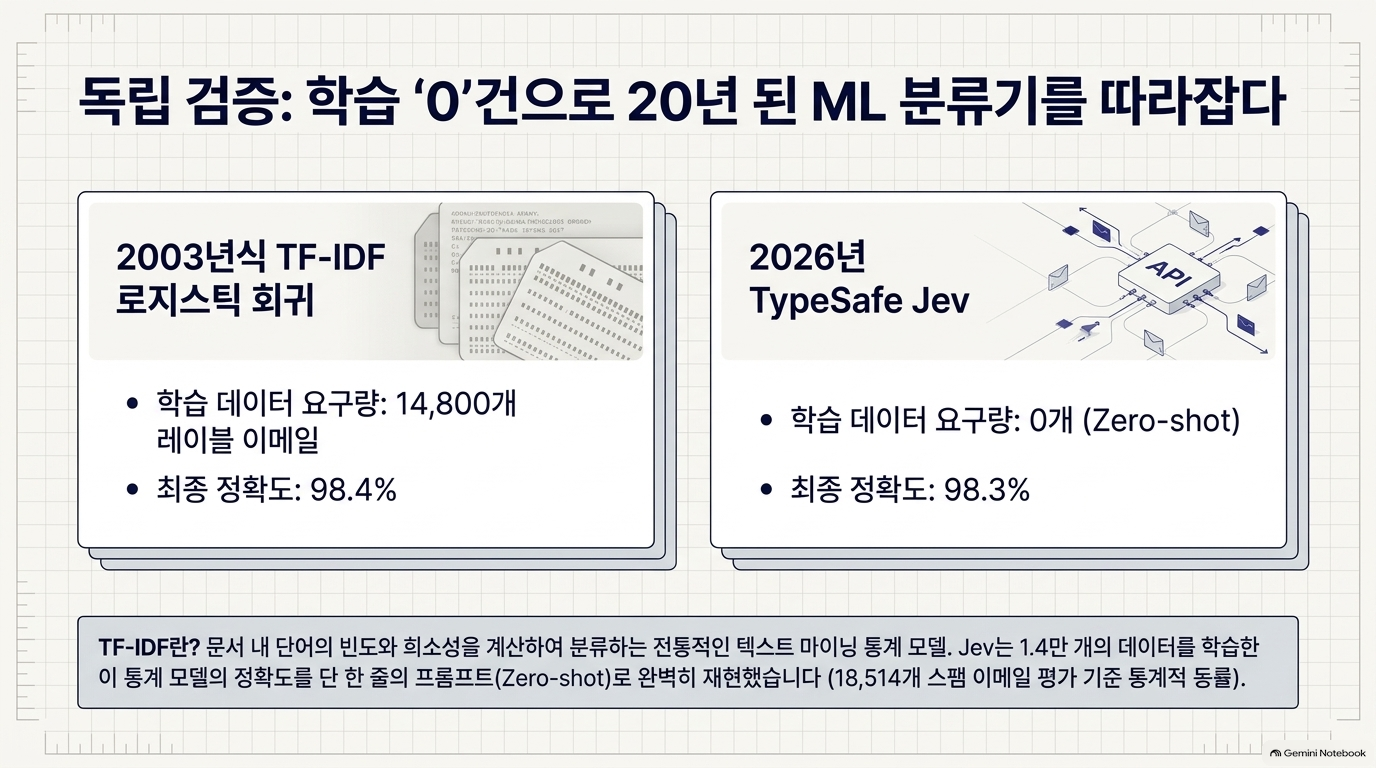
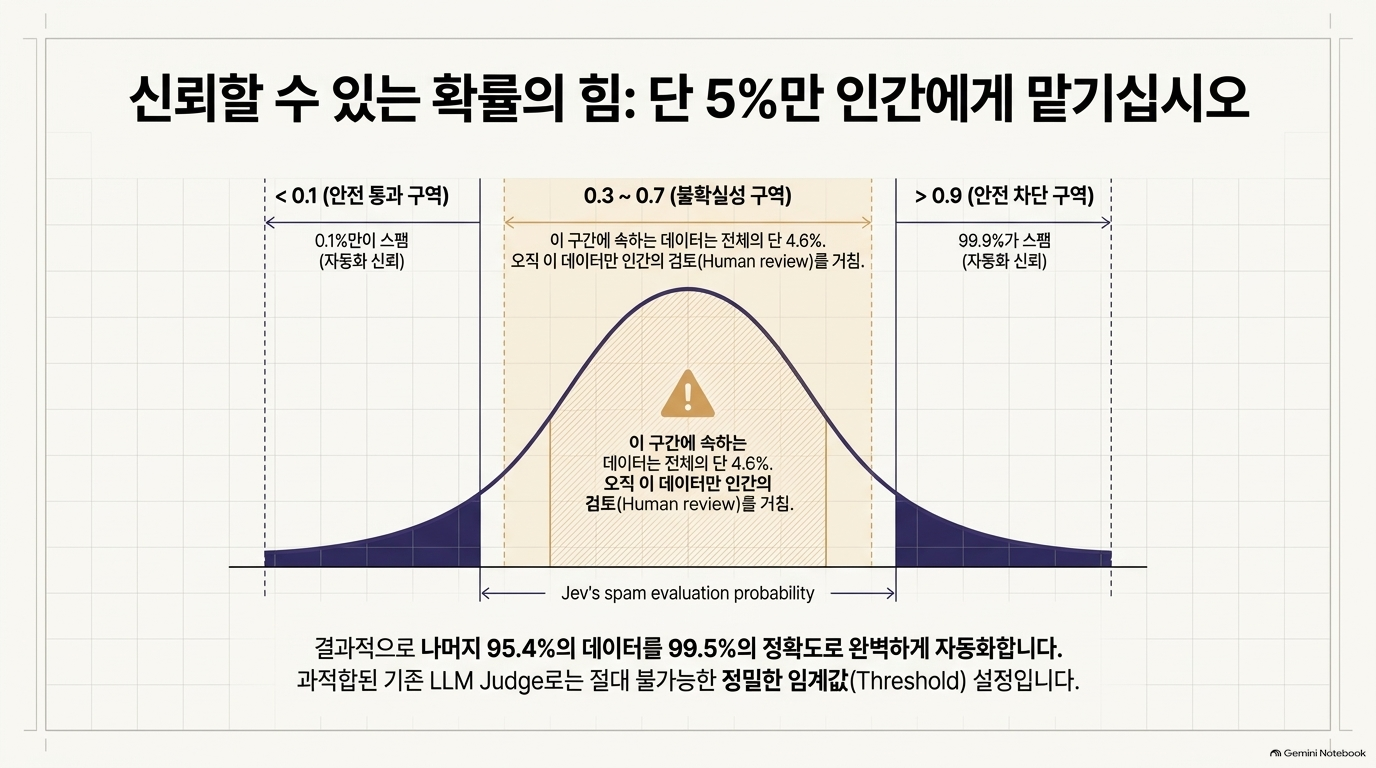
글이 인용한 spam 예시에서는:
- Jev 확률 <0.1 표본의 실제 spam 비율: 0.1%
- Jev 확률 ≥0.9 표본의 실제 spam 비율: 99.9%
- 0.5~0.6 구간 실제 spam 비율: 38%
- 0.3~0.7 구간 4.6%만 사람에게 보내면, 나머지는 99.5% 정확도라는 결과가 제시됩니다.[1]
이 수치는 유망하지만 단일 초기 사례일 뿐이며, 다른 업무·언어·시간대·기관 데이터에 일반화된다고 볼 수는 없습니다.
이 글이 기존 분석에 더하는 핵심
| 기존 초점 | O’Reilly 글이 보완하는 관점 |
| RLCD의 기술적 독창성·보정성 | 저비용 판단이 만드는 운영 아키텍처 변화 |
| 출력 타입 안전성 | 전수 모니터링·전수 검증의 경제성 |
| 확률 calibration | 임계값·사람 검토율·drift monitor에 확률을 연결하는 방법 |
| Jev 대 일반 LLM 성능 비교 | Jev + LLM judge의 2단 구조 |
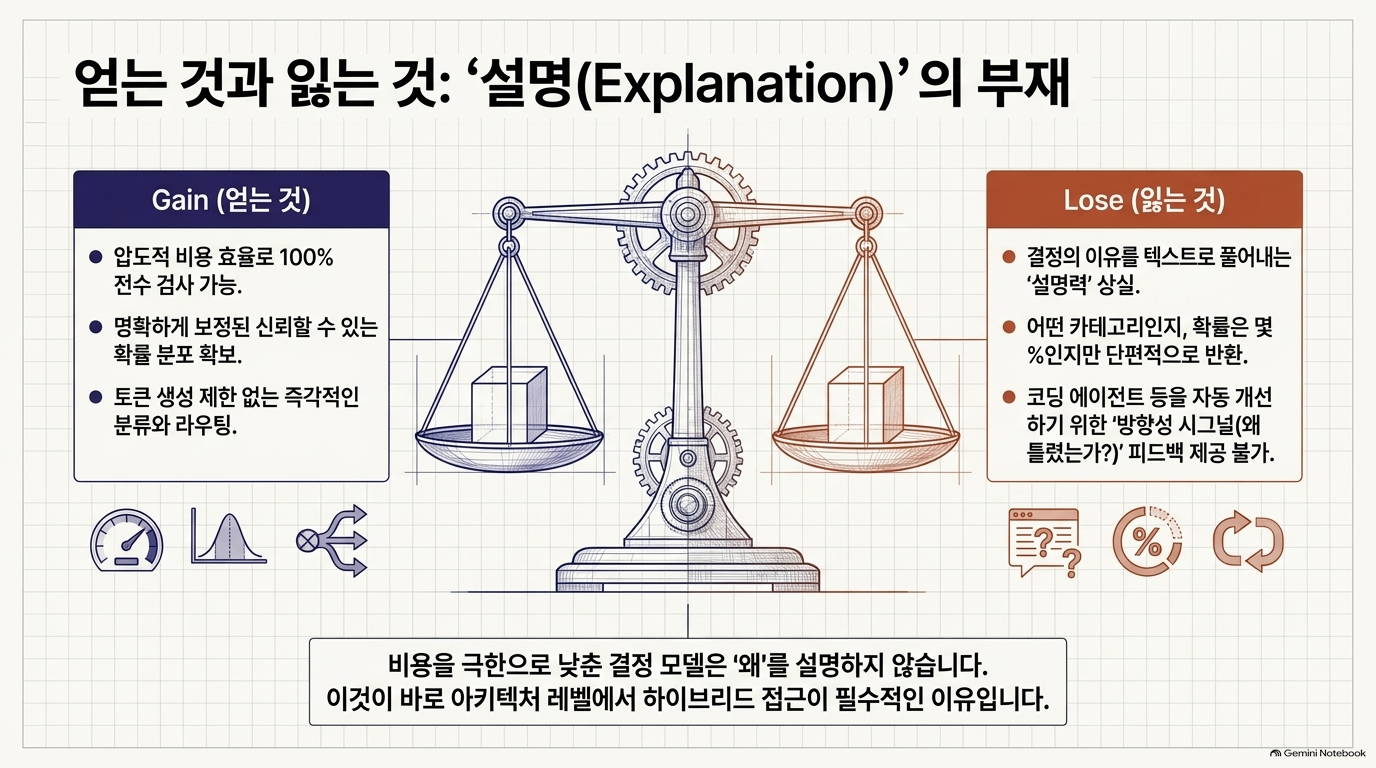
| [설명] 부재의 한계 | 전수 Jev 판정 후 실패 표본만 LLM judge로 설명 생성 |
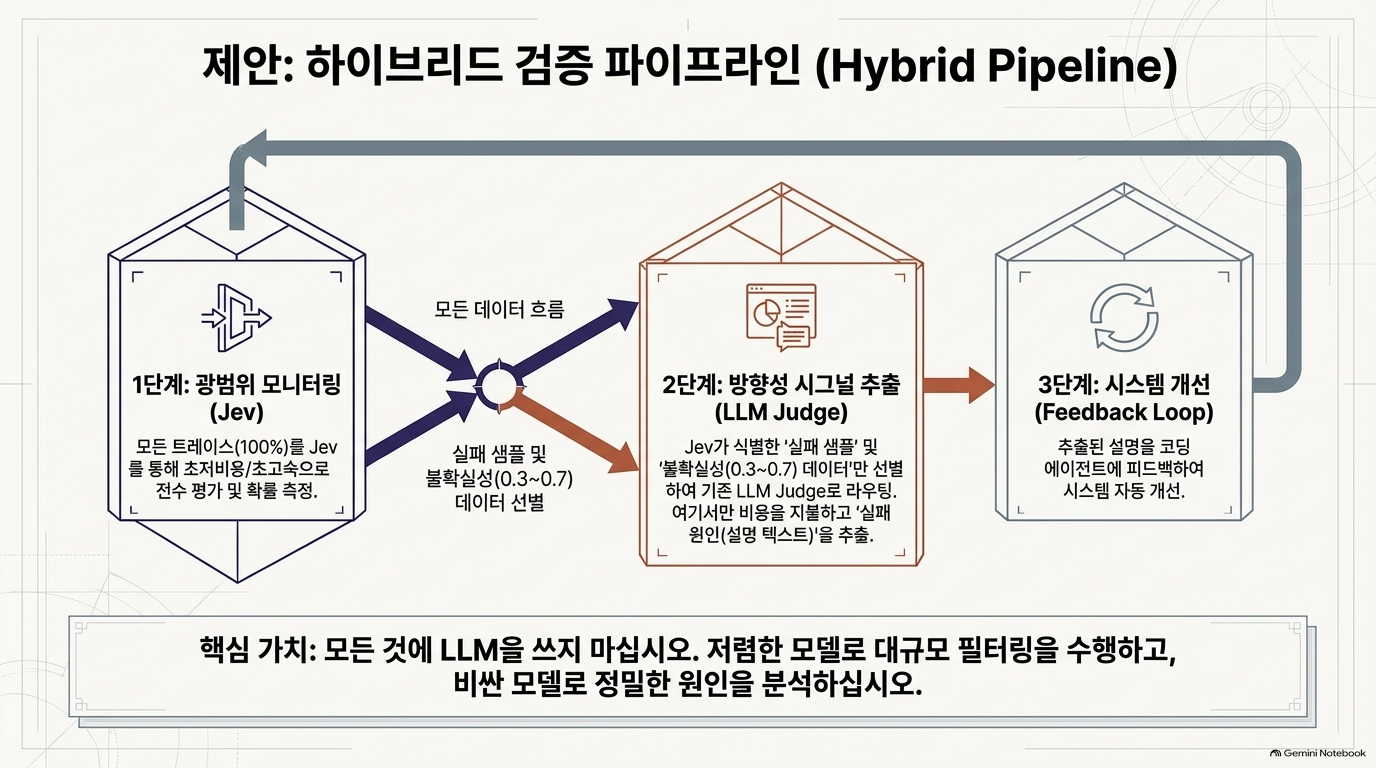
가장 현실적인 권고: Two-tier 평가 구조
글의 제안은 Jev를 LLM judge 대체재로만 쓰지 말고, 두 모델의 역할을 분리하는 것입니다.
① Jev — 전수·고빈도·저비용 판단
- 모든 응답, agent trace, tool call 검사
- 분류·스코어·라우팅·이상 탐지
- 확률/threshold 기반 human escalation
② LLM Judge — 표본·고난도·설명 필요 판단
- Jev의 저확신·경계 구간
- 실패/이상 표본의 원인 설명
- 코드·프롬프트·정책 개선 피드백 생성
이 구조는 Jev의 약점인 설명 부재를 보완합니다. Jev는 “무엇이 문제인지”를 빠르게 대량 선별하고, LLM judge는 “왜 문제인지”를 적은 비용으로 해석합니다.[1]
한계 및 반론
- 벤더·초기 사례 중심의 증거 글도 TypeSafe의 40~200배 속도, 40~400배 비용 주장을 독립 검증해야 한다고 명시합니다. Every, NearHere, spam 평가도 초기·소규모 또는 특정 도메인 사례입니다.[1]
- “확률을 신뢰할 수 있다”는 전제가 가장 큰 미검증 요소 전수 판단 아키텍처는 확률이 실제 오류율과 맞을 때만 성립합니다. 다른 기관·언어·업무·시간 분포에서 ECE, Brier, NLL, risk-coverage를 실측하지 않으면 automation threshold는 근거가 약합니다.
- 설명 가능성 비용이 사라지지 않는다 Jev가 오류를 줄여도, 정책 개선·감사·이의제기 대응에는 근거와 설명이 필요합니다. 따라서 Jev 단독이 아니라 evidence retrieval·규칙엔진·LLM explanation 또는 사람 검토와 결합해야 합니다.
- “토큰 수”는 보조 지표 output token이 많다고 항상 낭비인 것은 아닙니다. 복합 규정 해석, 증거 대조, 긴 reasoning이 정답률·근거성·재현성을 실질적으로 높이는 경우에는 생성 비용이 정당화됩니다. 따라서 tokens per decision은 정확도·보정성·오류 비용과 함께 봐야 합니다.
결론적으로, 이 글의 가장 설득력 있는 통찰은 Jev의 성공 여부가 “더 좋은 분류기인가”보다, 판단 비용을 낮춰 전수 검증과 위험기반 인간 개입을 가능하게 하는가에 달려 있다는 점입니다.
Sources
[1] https://oreillyradar.substack.com/p/will-typesafes-jev-change-how-we

'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 하네스 엔지니어링 - Harness-Zero: Harness Distillation (0) | 2026.09.25 |
|---|---|
| 에이전트 AI - Jev : 자연어로 즉석 정의된 판단 과제가 바뀌어도 정확도와 확률 보정이 유지되는가 (0) | 2026.09.25 |
| 에이전트 AI - 재귀적 자기 개선(RSI), AI 연구 가속, 미·중 격차, 현실세계 병목의 재평가 (0) | 2026.09.22 |
| 하네스 엔지니어링 - 레거시 코드를 AI 에이전트 도입 전략 (0) | 2026.09.21 |
| 에이전트 AI - 속도 조정 이후, AI 컴퓨팅에 대한 수요와 자본 지출은 계속해서 증가할 것 (0) | 2026.09.21 |