반응형
https://arxiv.org/pdf/2609.08832
2026.3.11
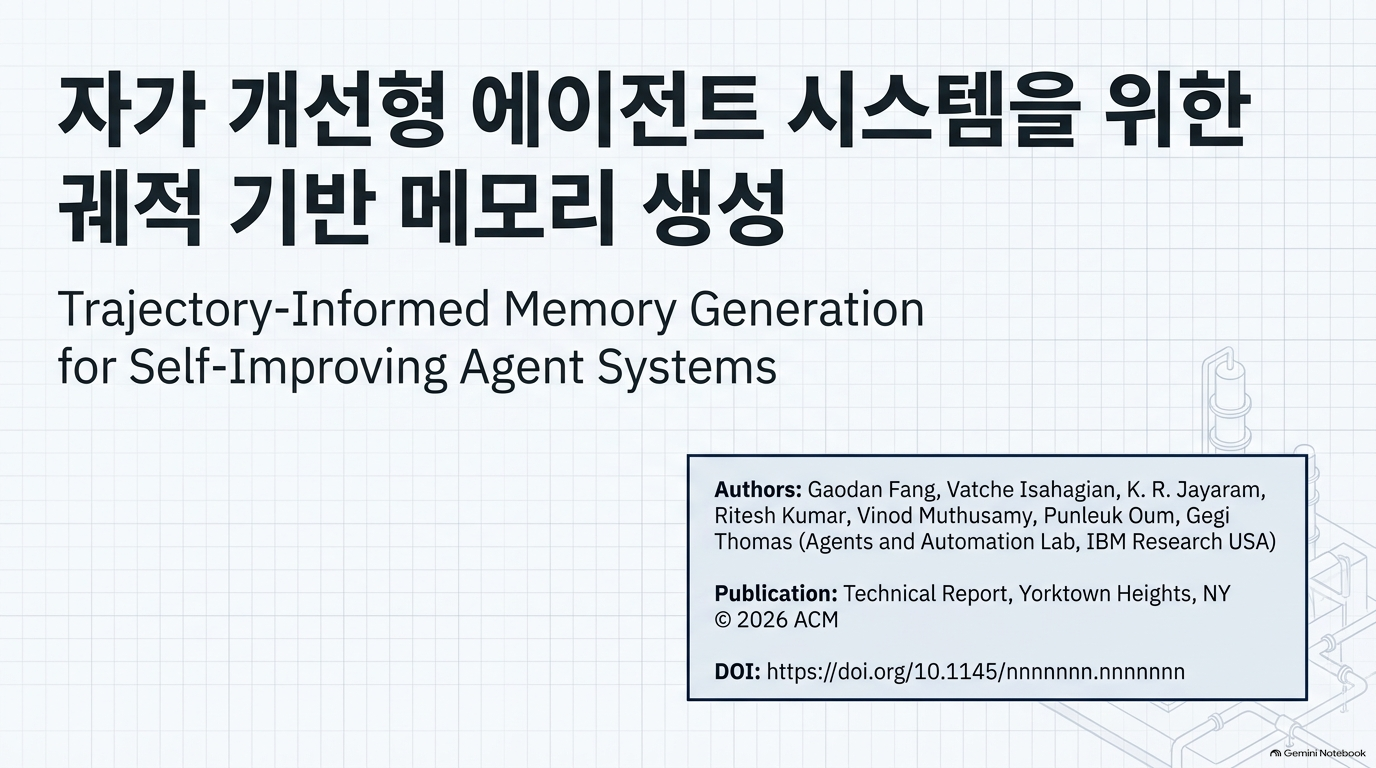
[Trajectory-Informed Memory Generation for Self-Improving Agent Systems]
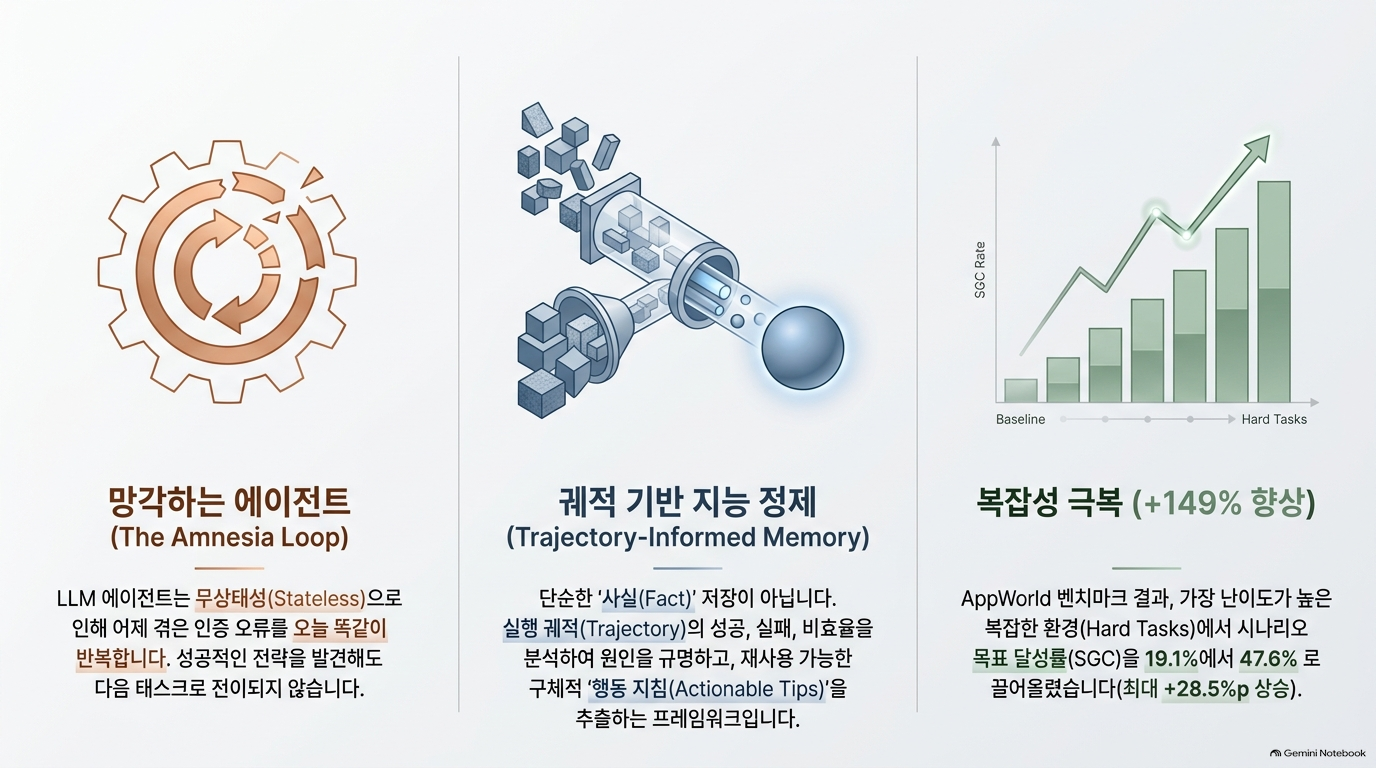
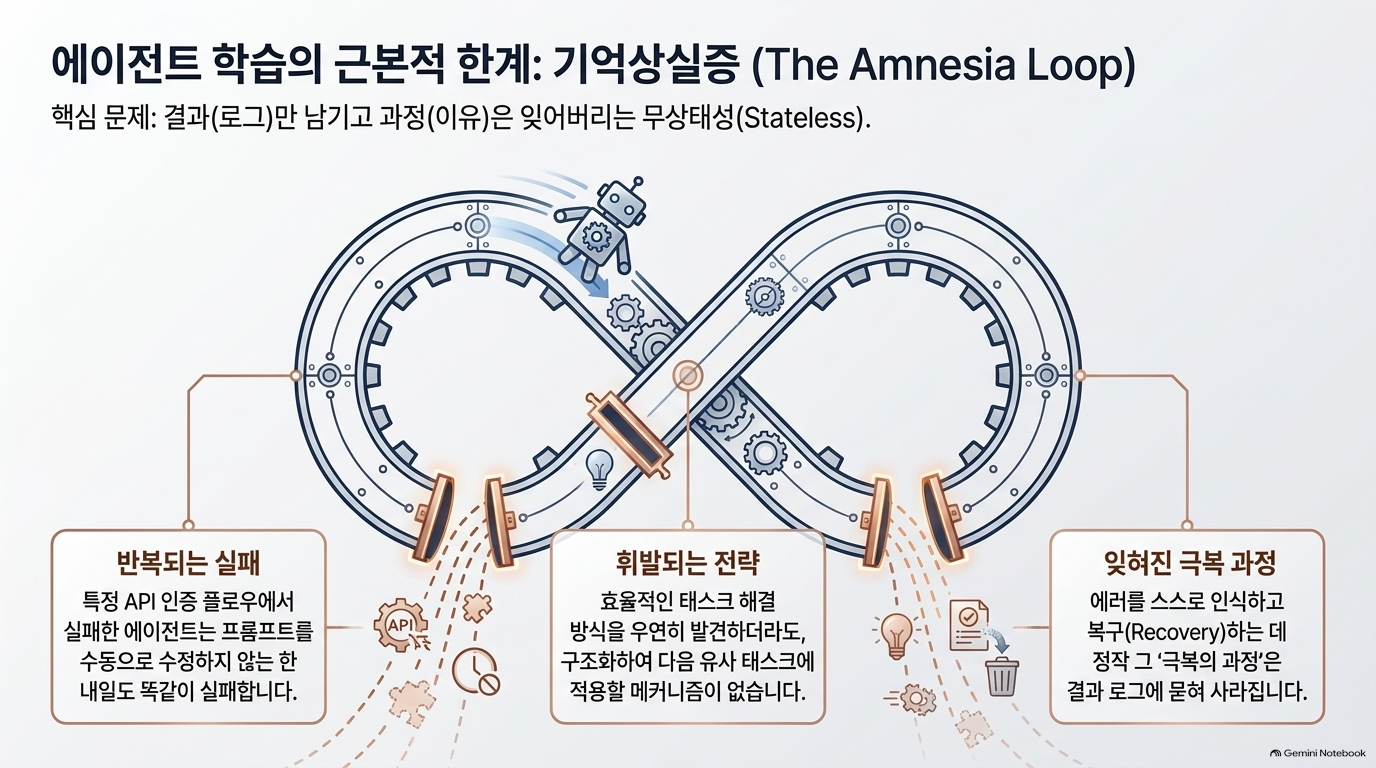
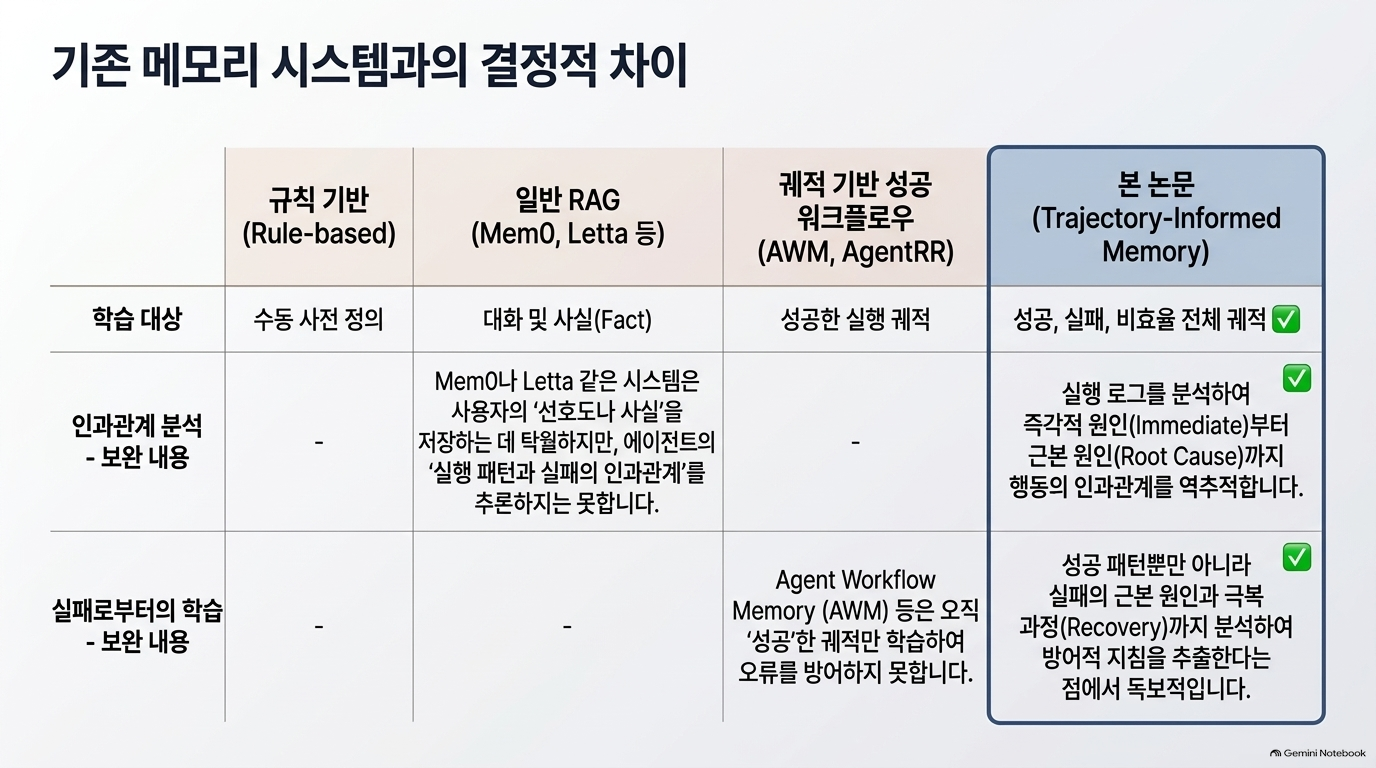
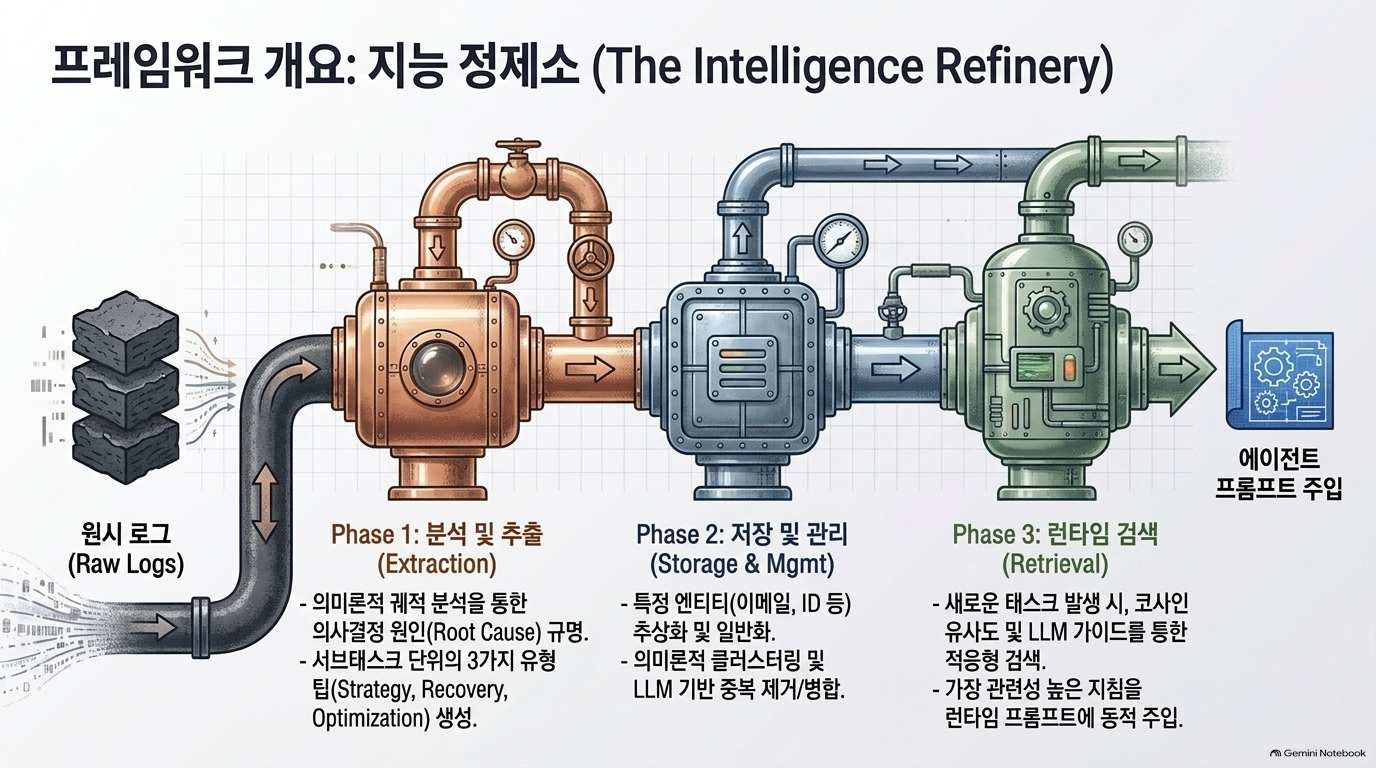
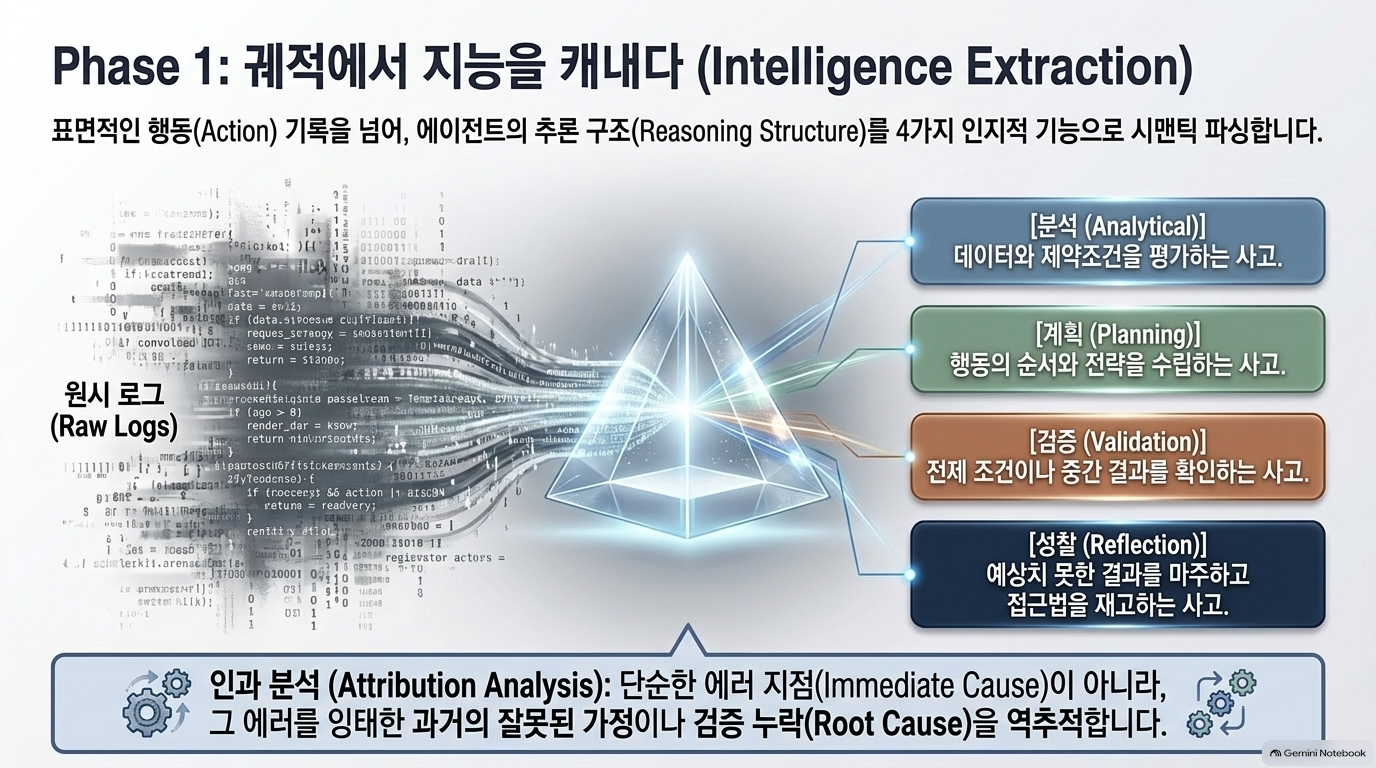
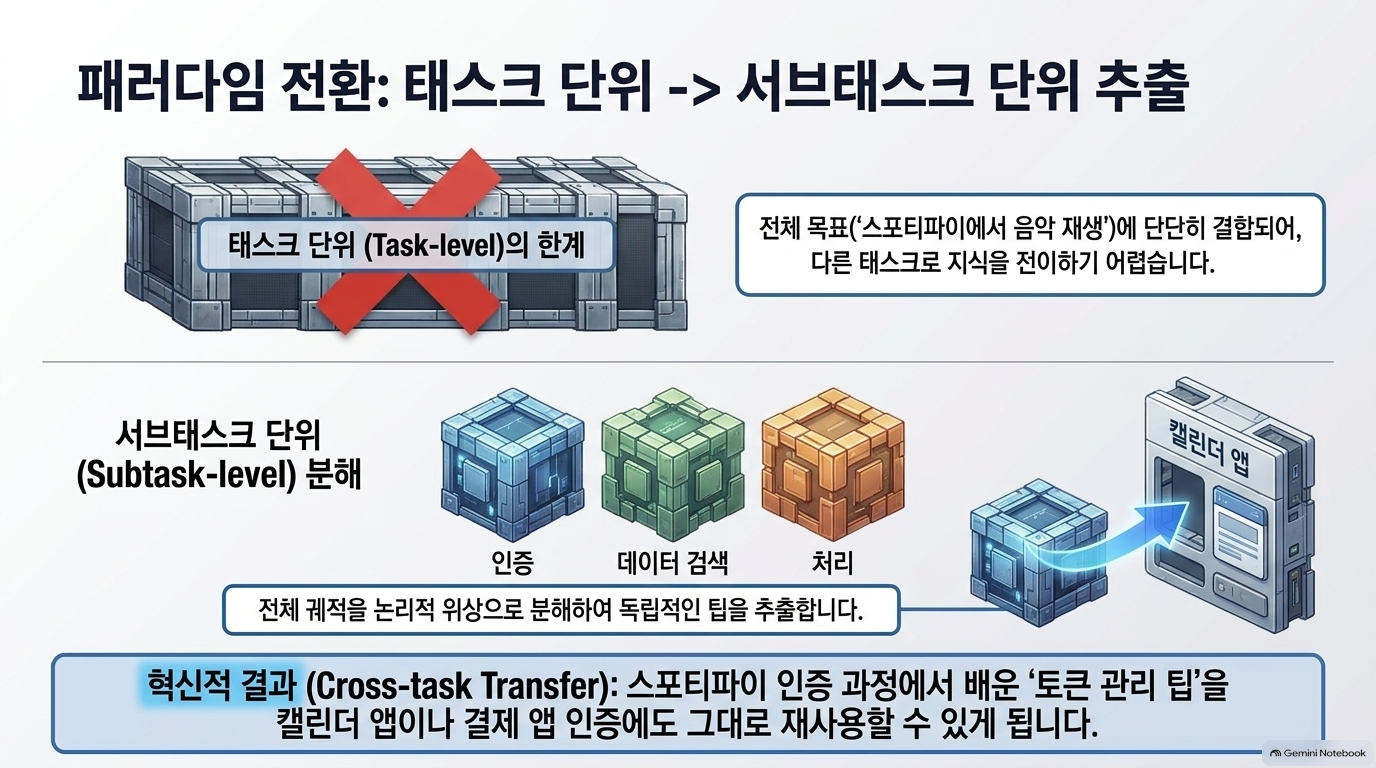
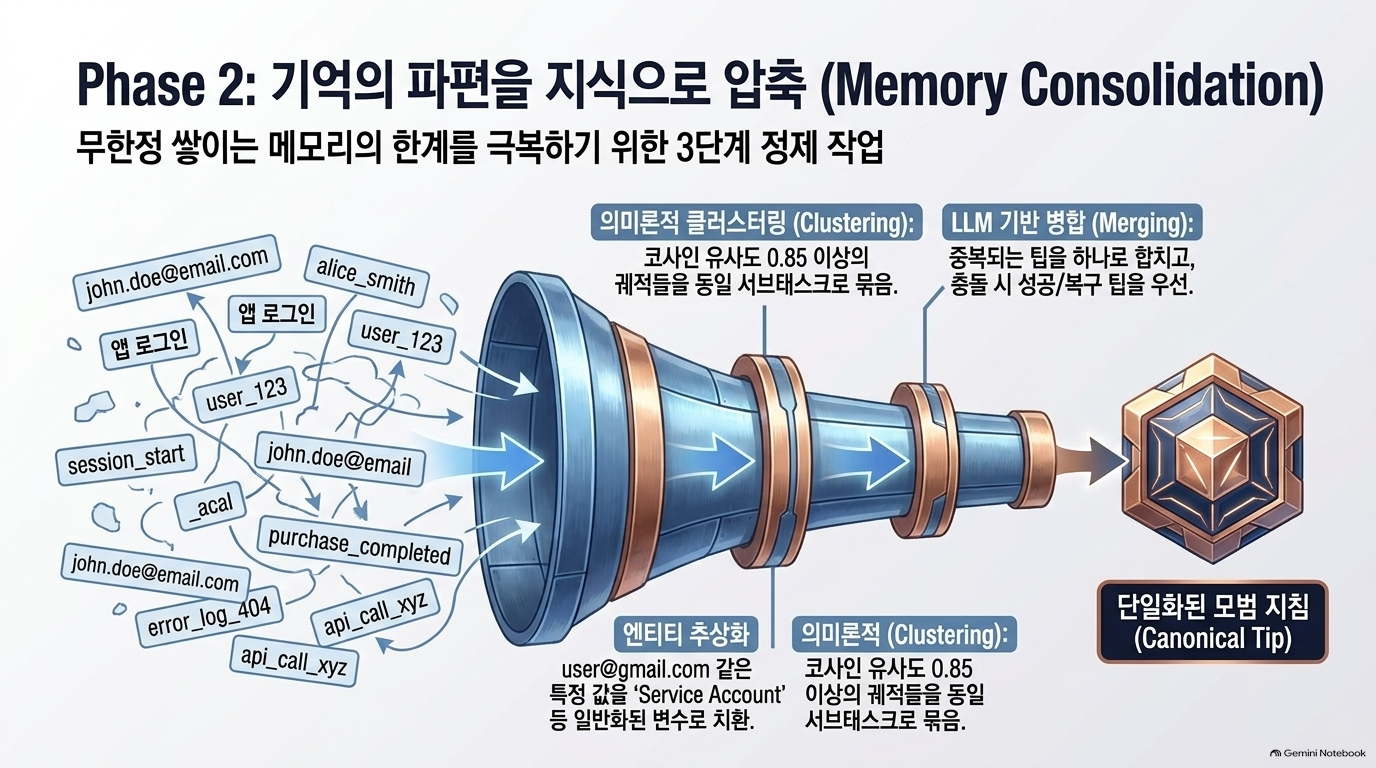
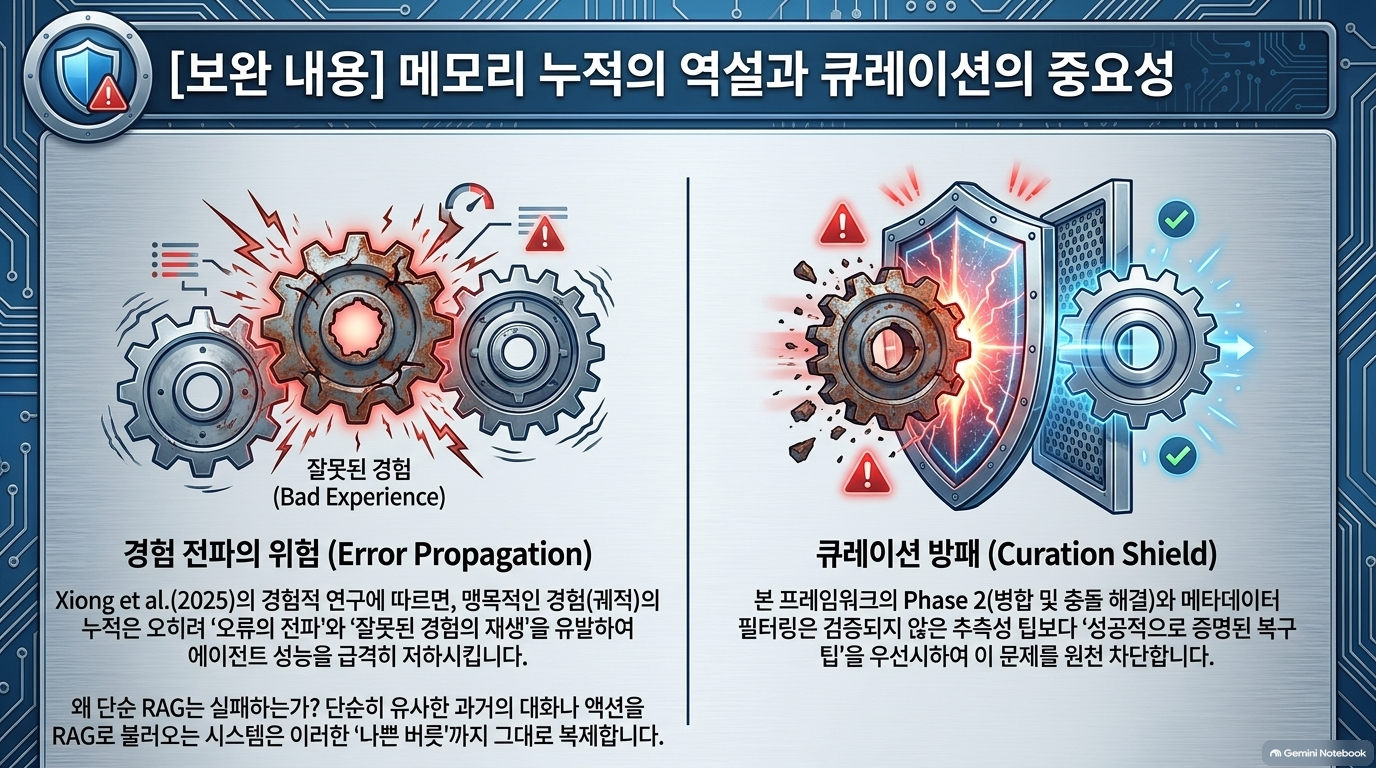
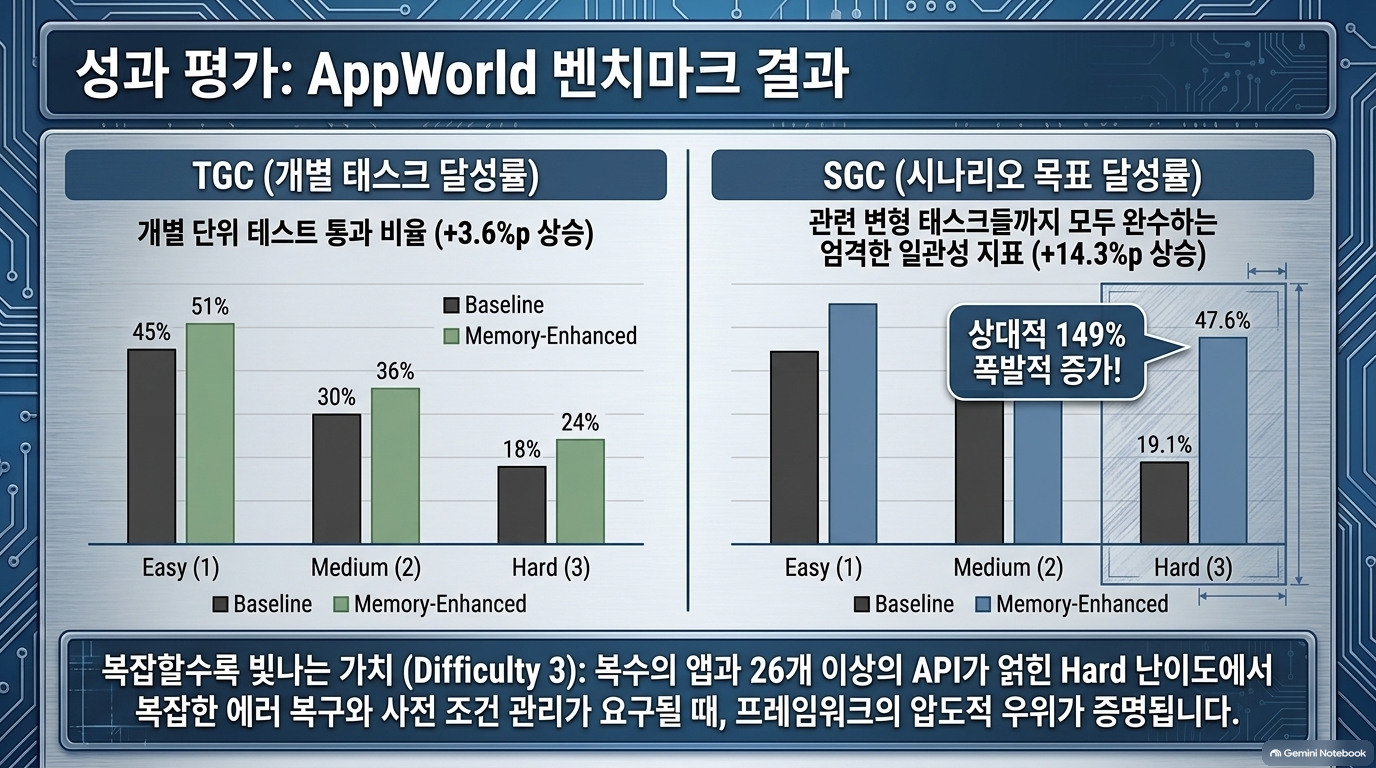
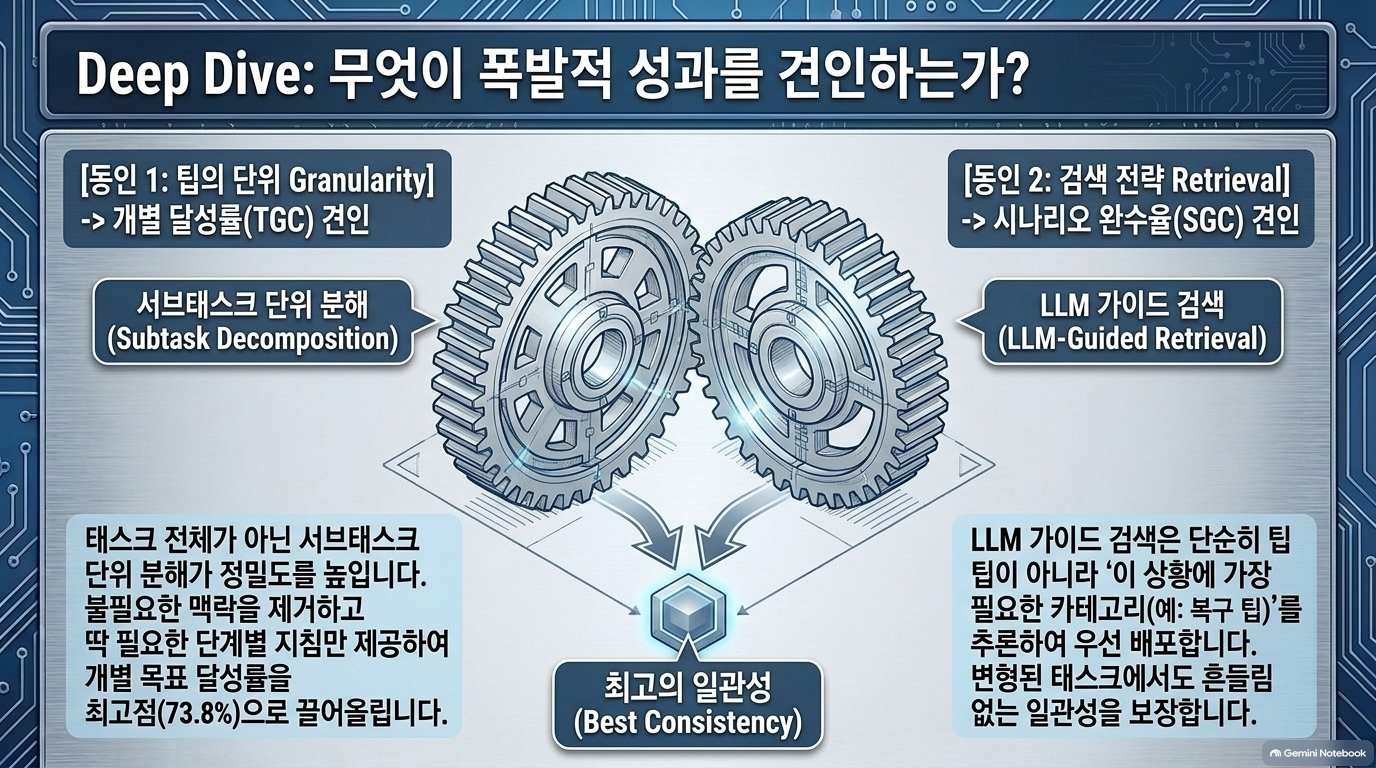
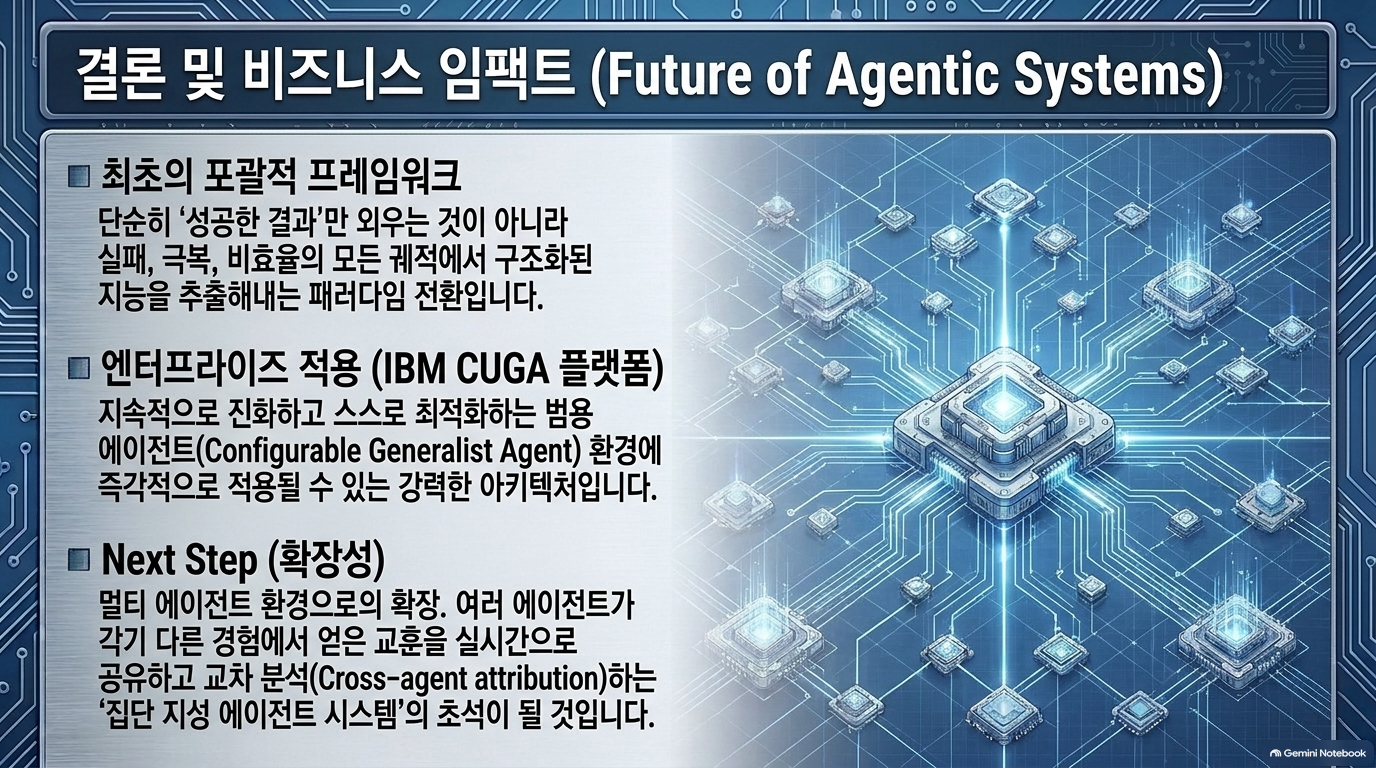
이 연구는 자가 개선형 에이전트 시스템인 ALTK-Evolve 프레임워크를 통해, 인공지능 에이전트가 과거의 실행 기록에서 행동 지침(Actionable Learnings)을 스스로 추출하여 성능을 높이는 방법을 제시합니다. 시스템은 에이전트의 사고와 행동 궤적을 분석하여 성공적인 전략, 오류 복구 과정, 그리고 비효율적인 성공을 개선하기 위한 최적화 팁을 구조화된 메모리 형태로 생성합니다. 단순한 사실 저장에 그쳤던 기존 메모리 방식과 달리, 이 기술은 인과 관계 분석을 통해 실패의 근본 원인을 파악하고 이를 세부 작업 단위로 일반화하여 저장함으로써 새로운 과제에도 유연하게 적용할 수 있습니다. 결과적으로 이 시스템은 복잡한 다단계 업무에서 시나리오 목표 달성률을 획기적으로 향상하며, 에이전트가 경험을 통해 끊임없이 진화할 수 있는 강력한 토대를 마련합니다.

728x90
반응형
'07.AI > 5. AI 자율성' 카테고리의 다른 글
| 에이전트 AI - Google Cloud AI Research, ScientistOne: 증거의 연쇄 (Chain-of-Evidence) (0) | 2026.09.20 |
|---|---|
| 에이전트 AI - IBM Research, ALTK-Evolve: 에이전트 일관성 격차 보완 (0) | 2026.09.20 |
| 에이전트 AI - 속도 조정 이후, 안전 vs 규제 포획(regulatory capture) (0) | 2026.09.18 |
| 에이전트 AI - 속도 조정 이후, 사실 아무도 멈추지 않았다 (0) | 2026.09.18 |
| 에이전트 AI - 속도 조정 이후, AI 안전과 HW 시장 (0) | 2026.09.18 |