반응형
https://z.ai/blog/glm-5.3-flash
2026.8.26
[GLM-5.3-Flash: 프론티어 인텔리전스, 플래시]
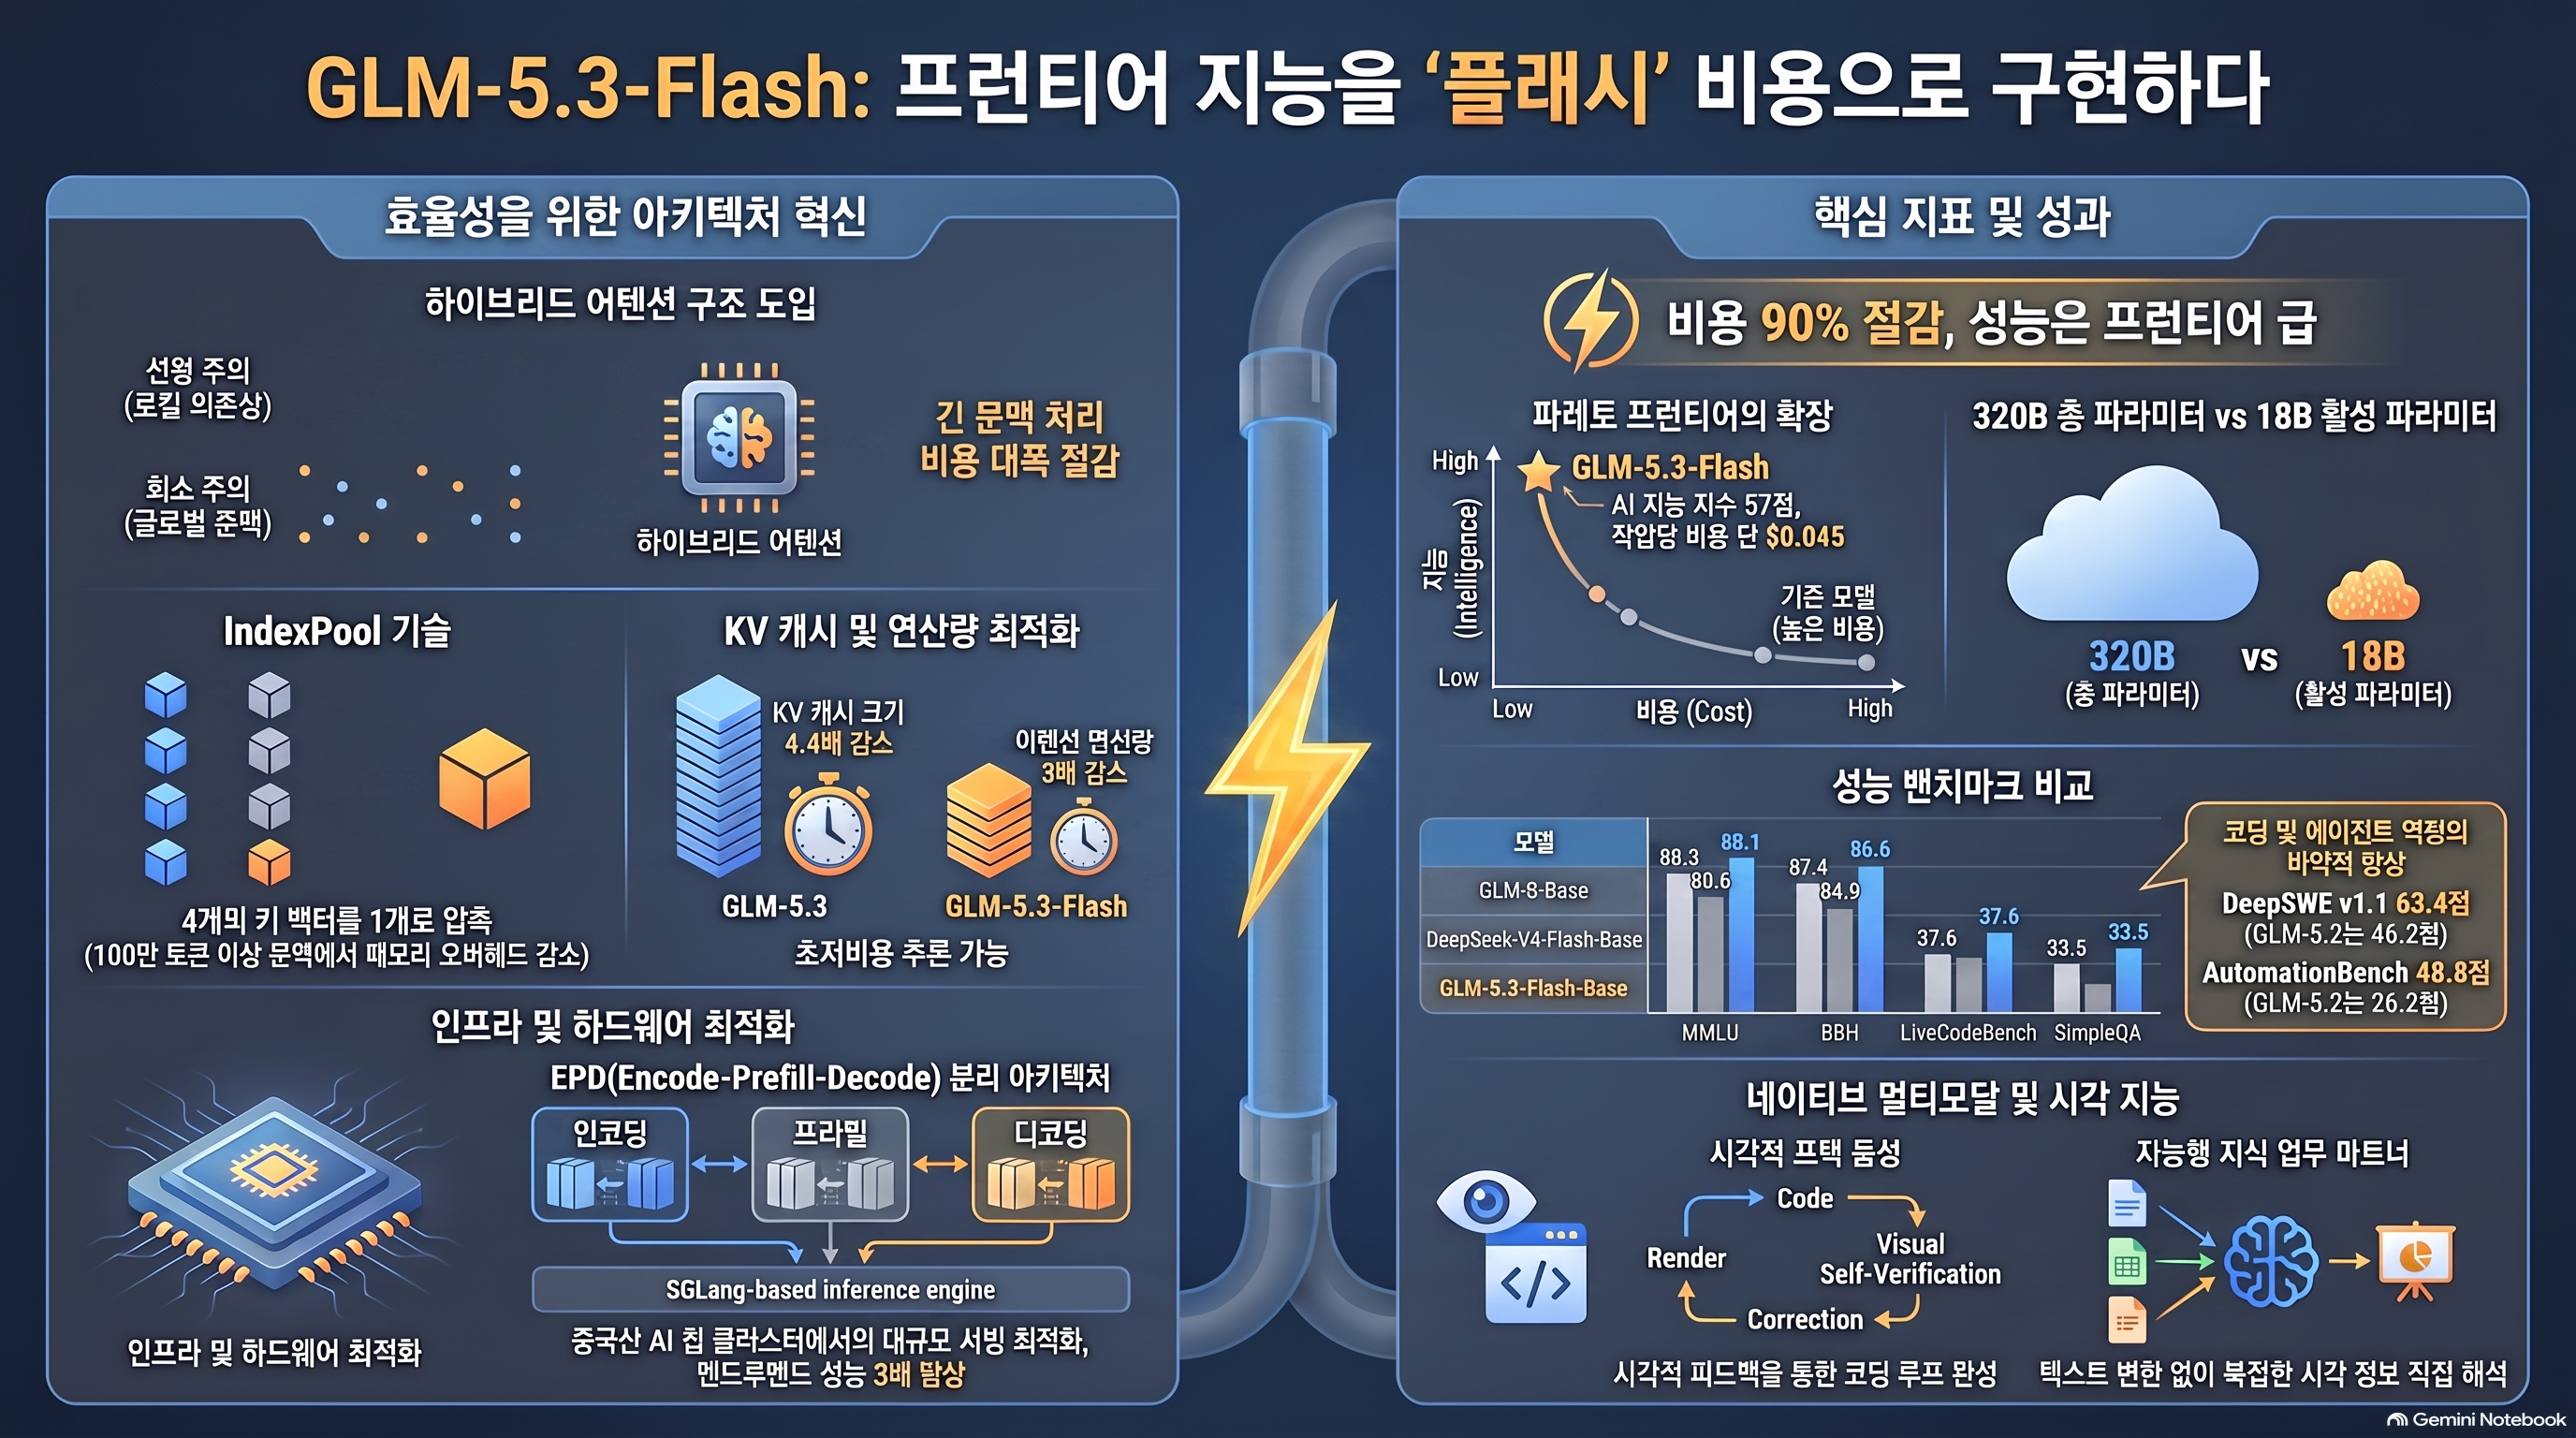
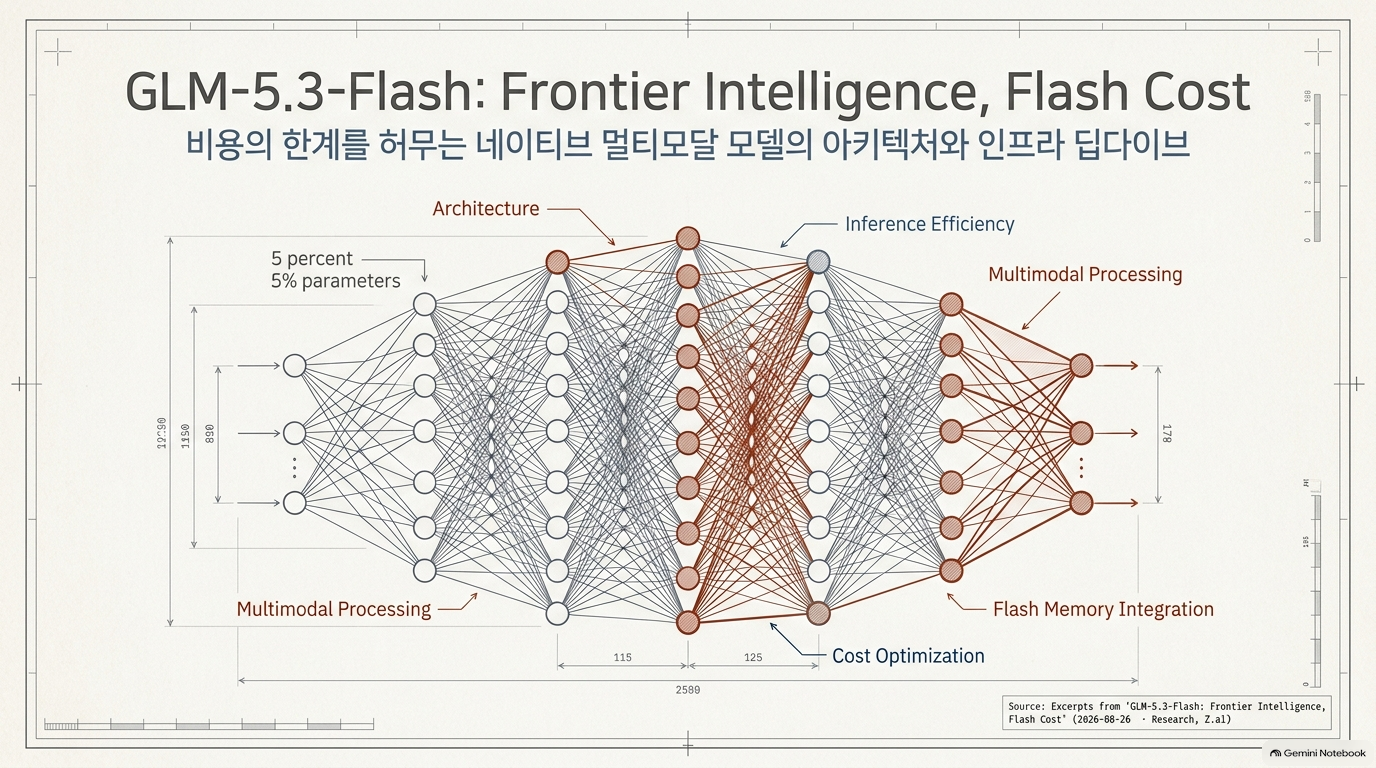
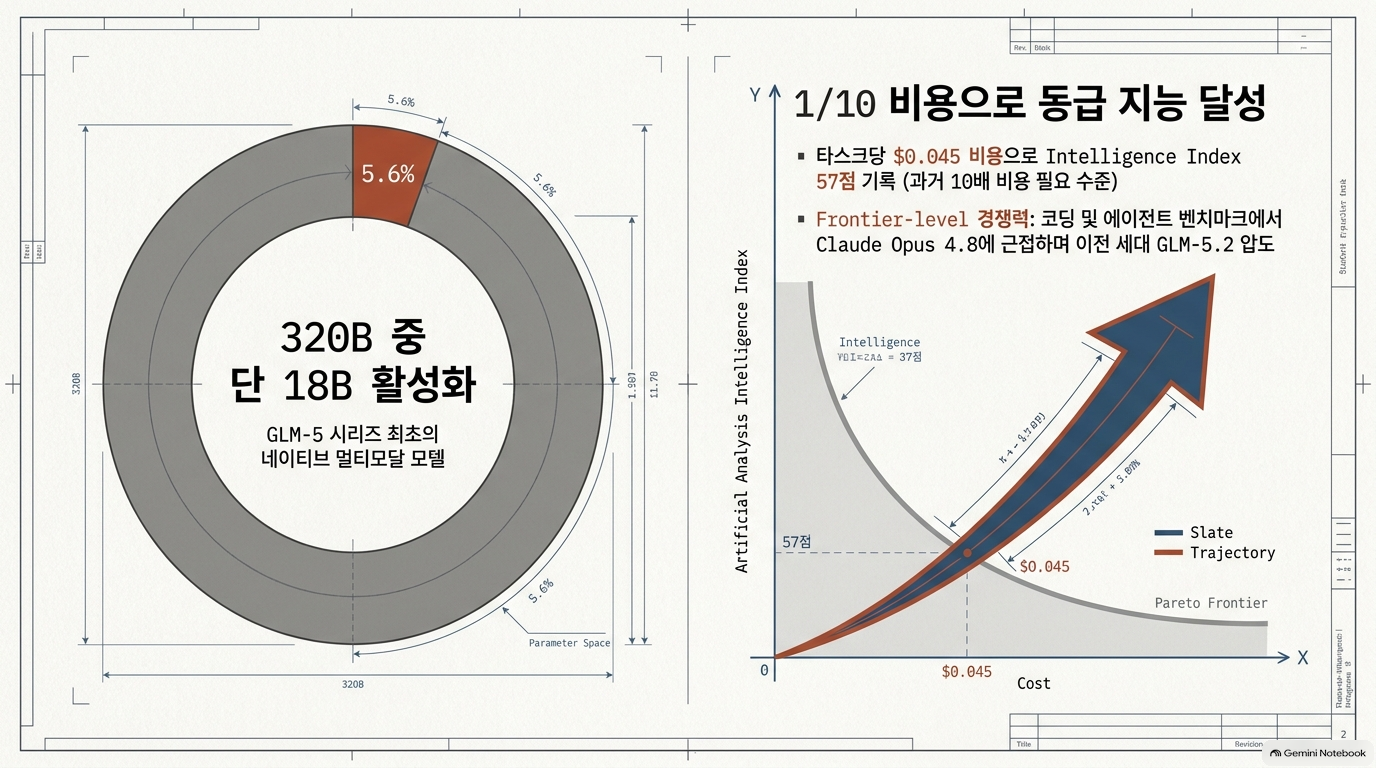
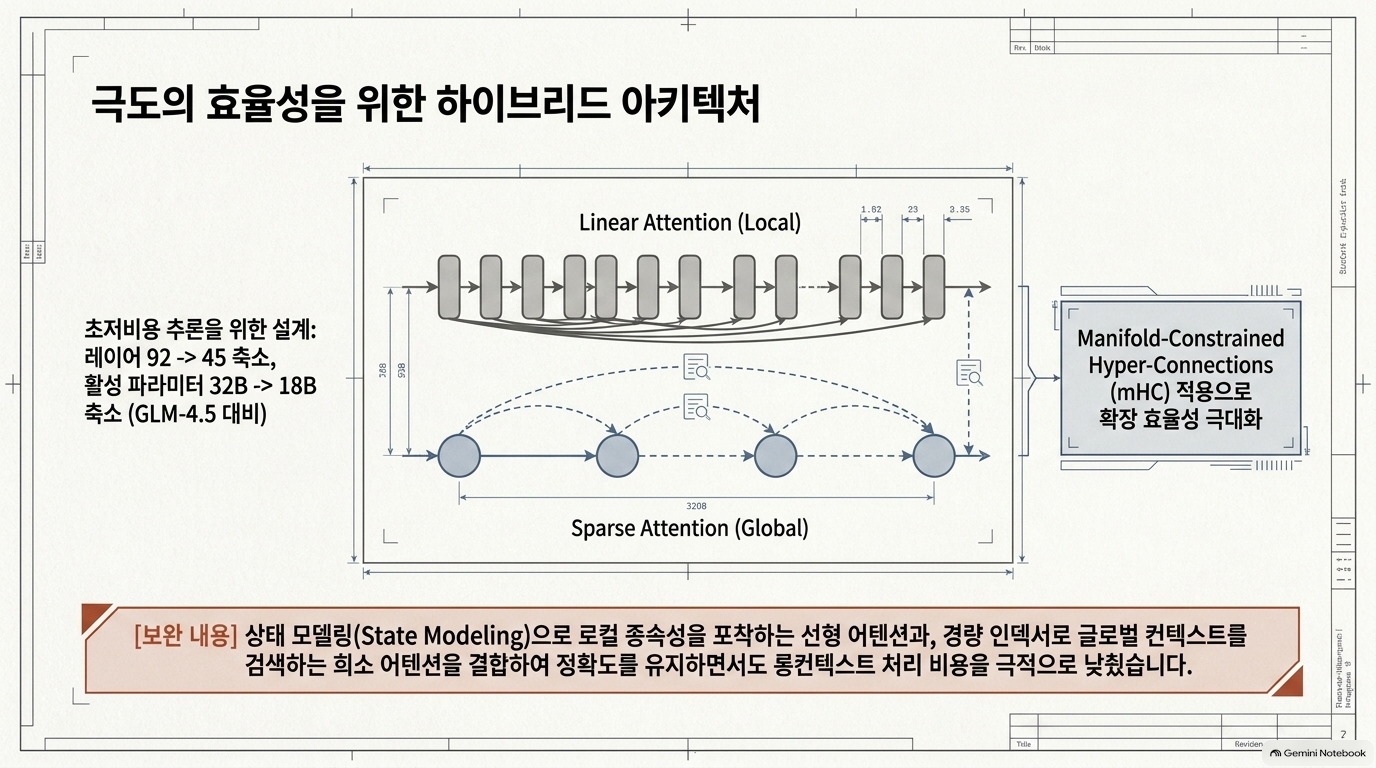
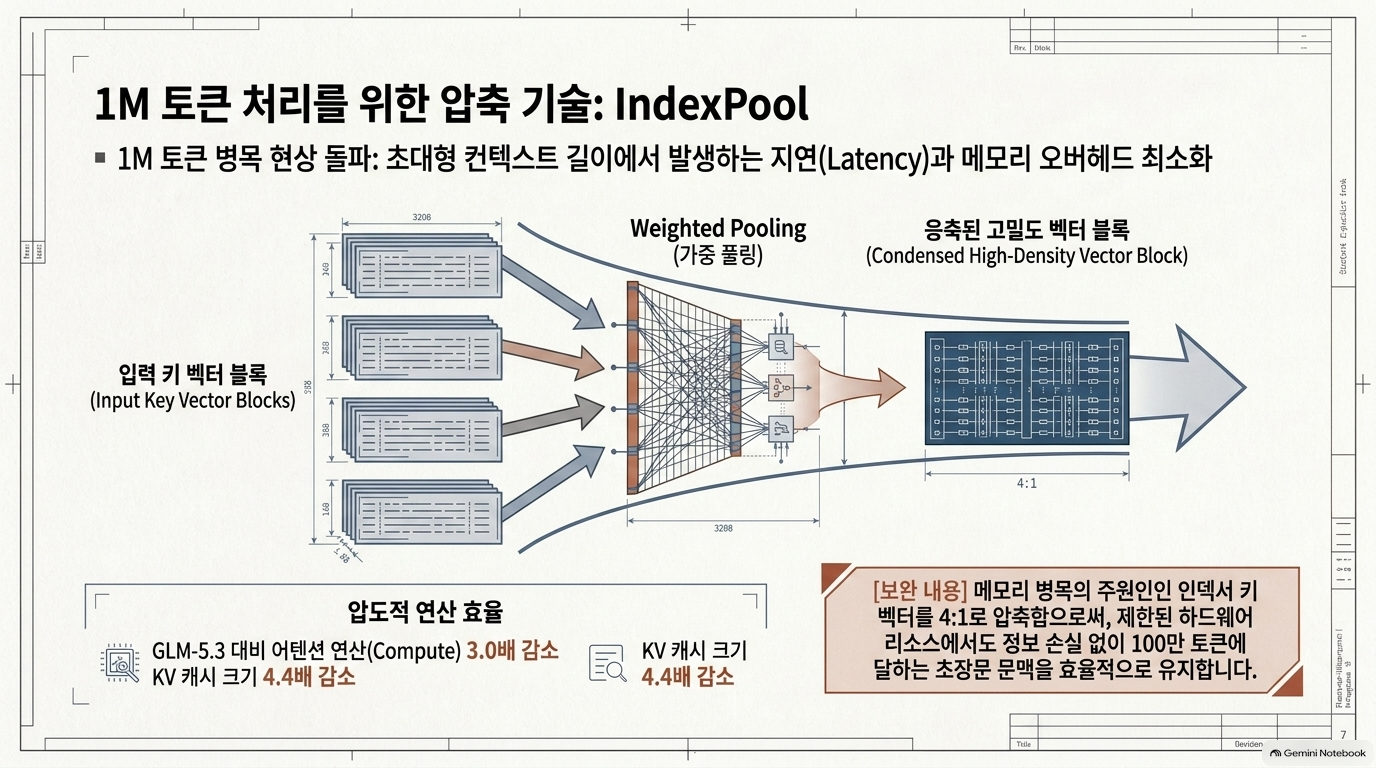
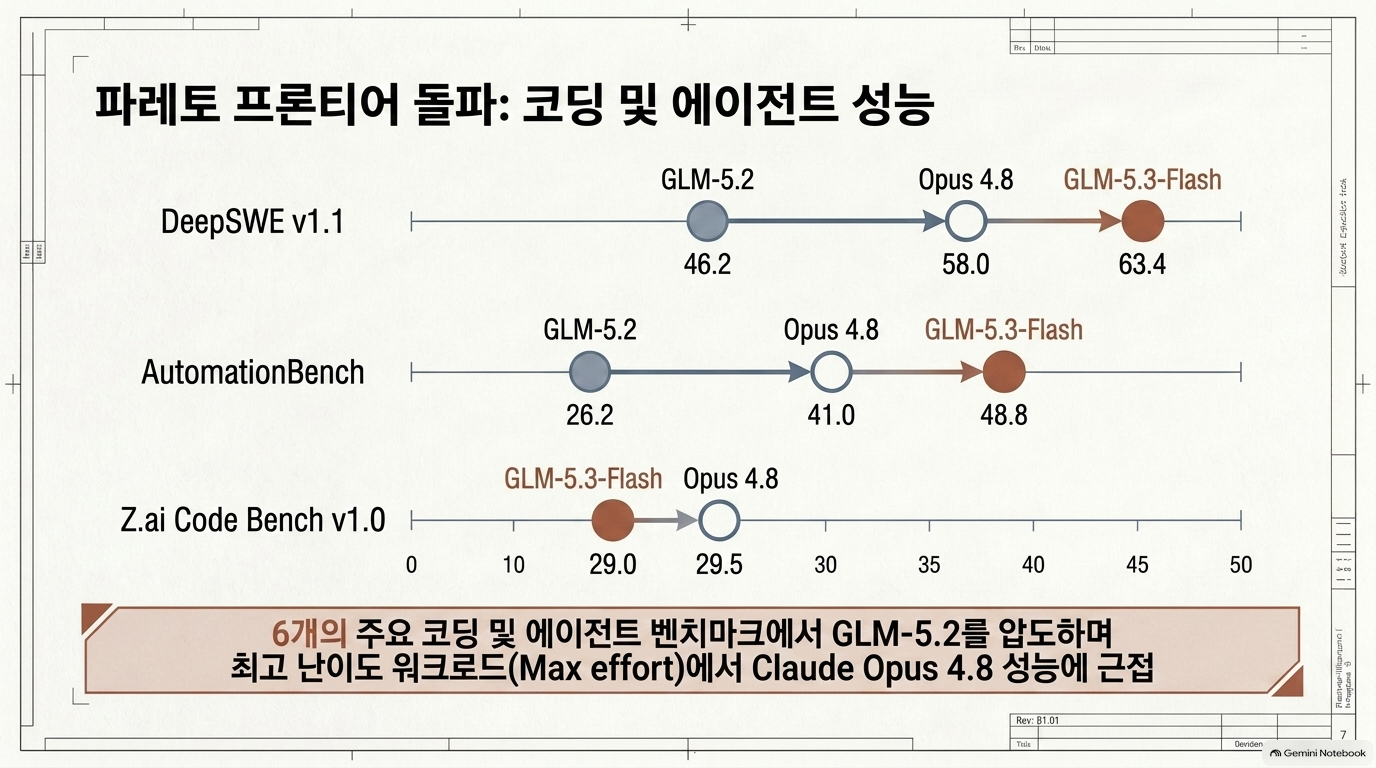
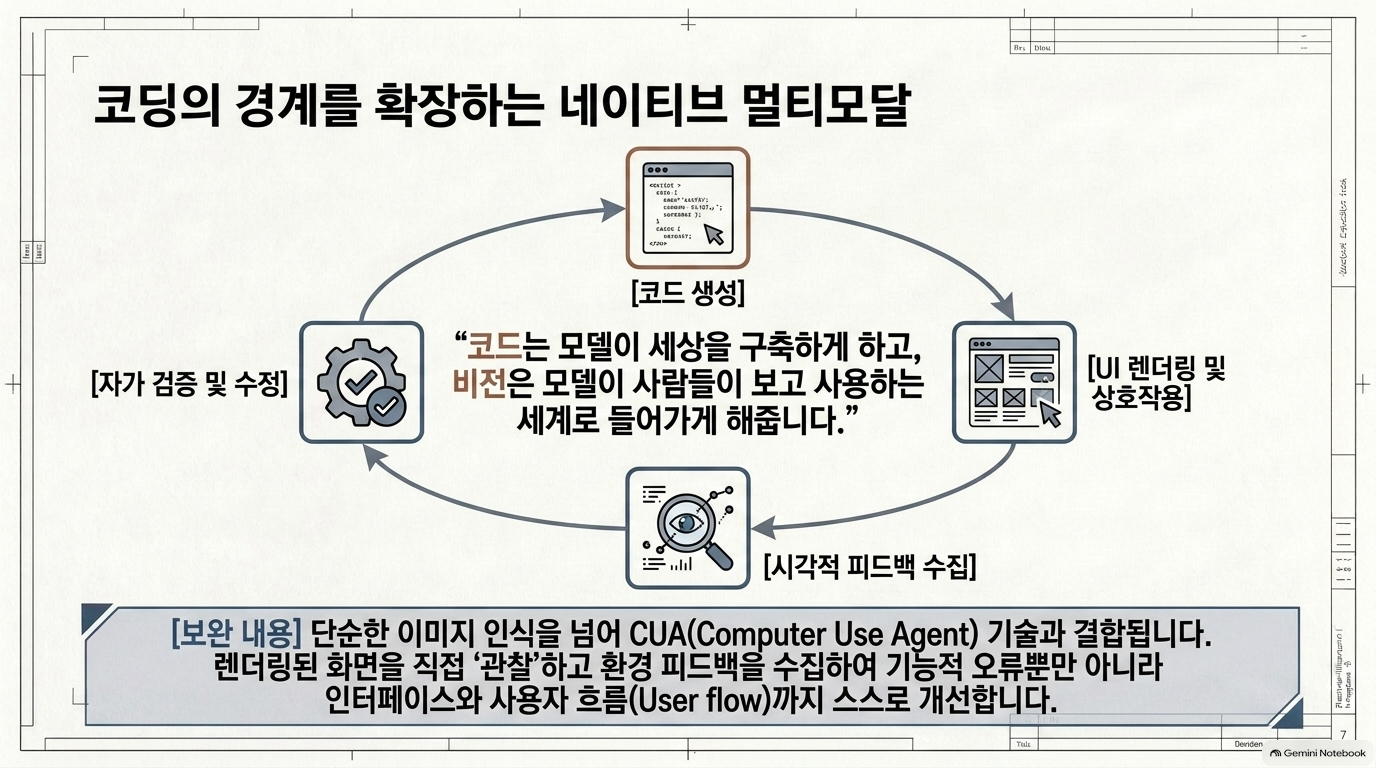
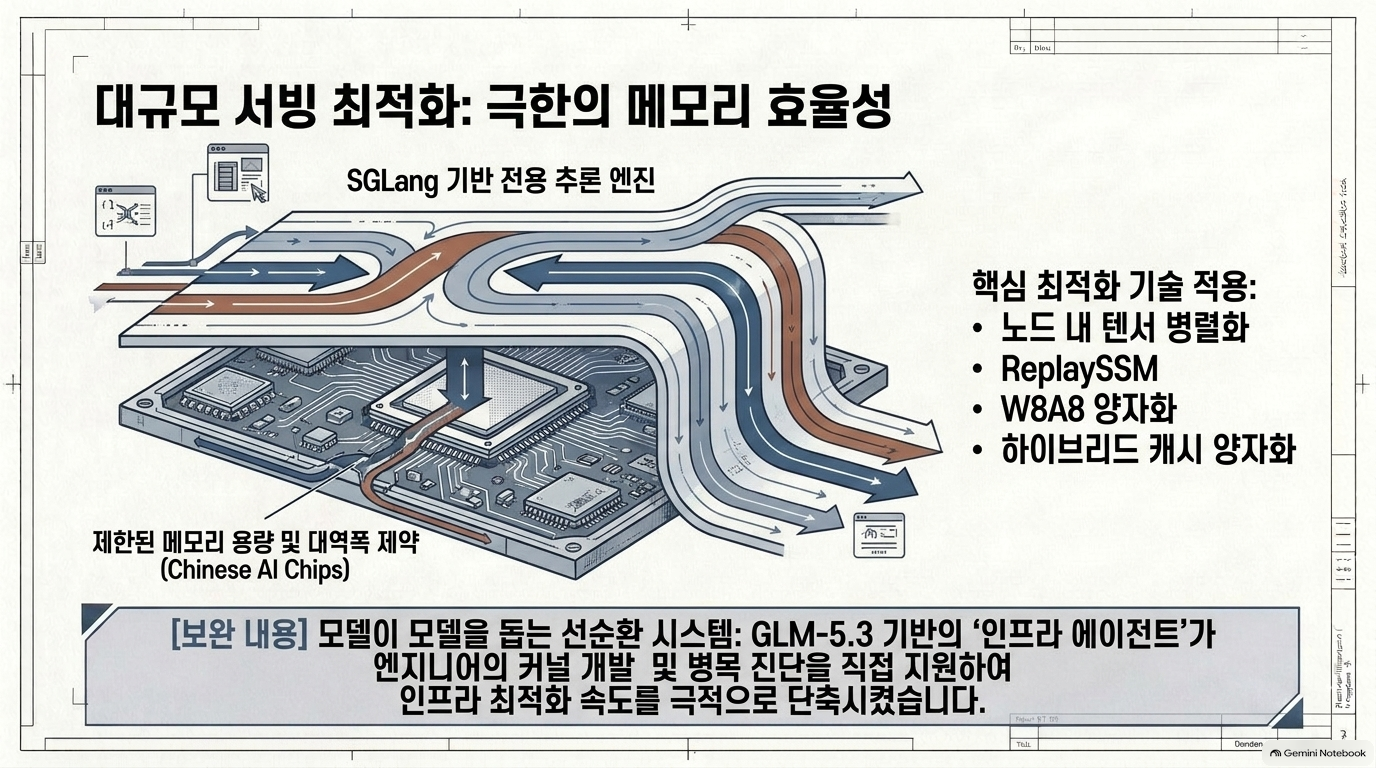
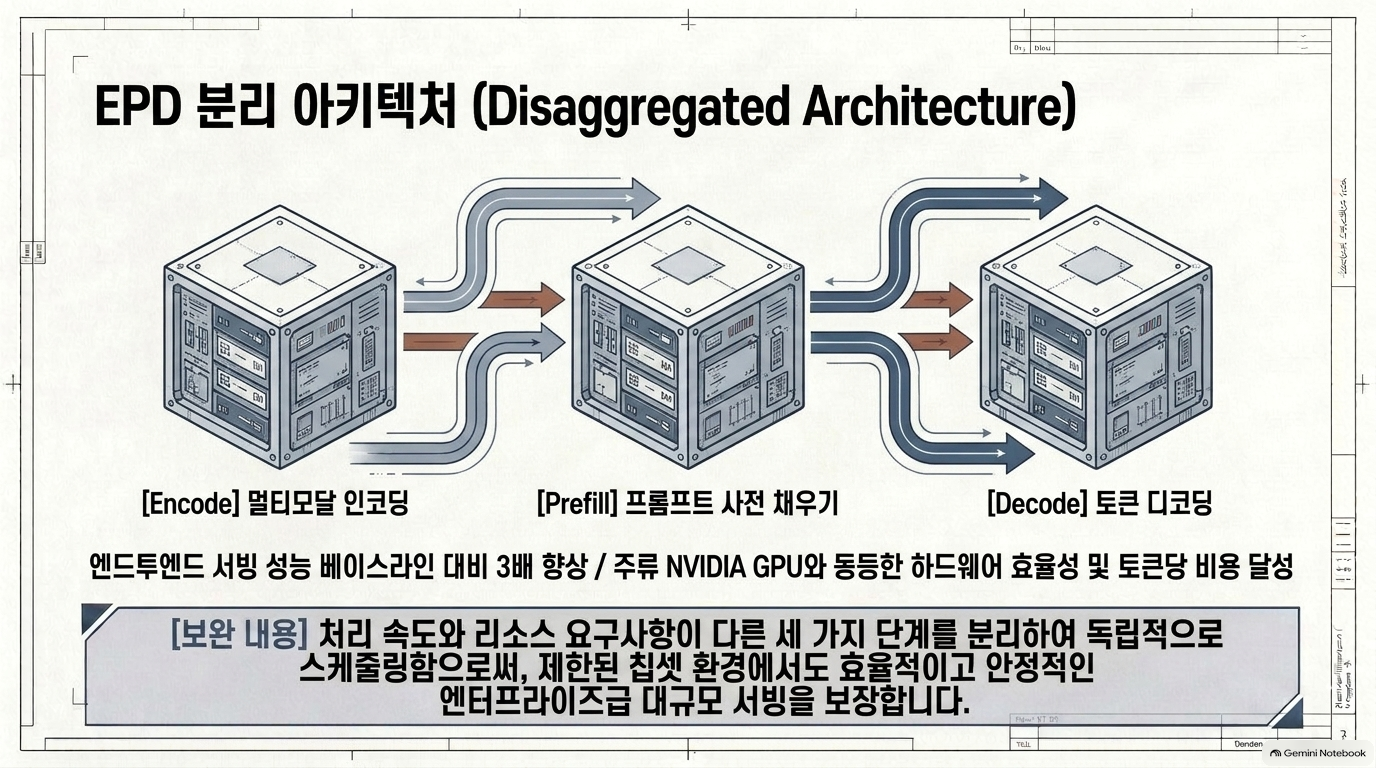
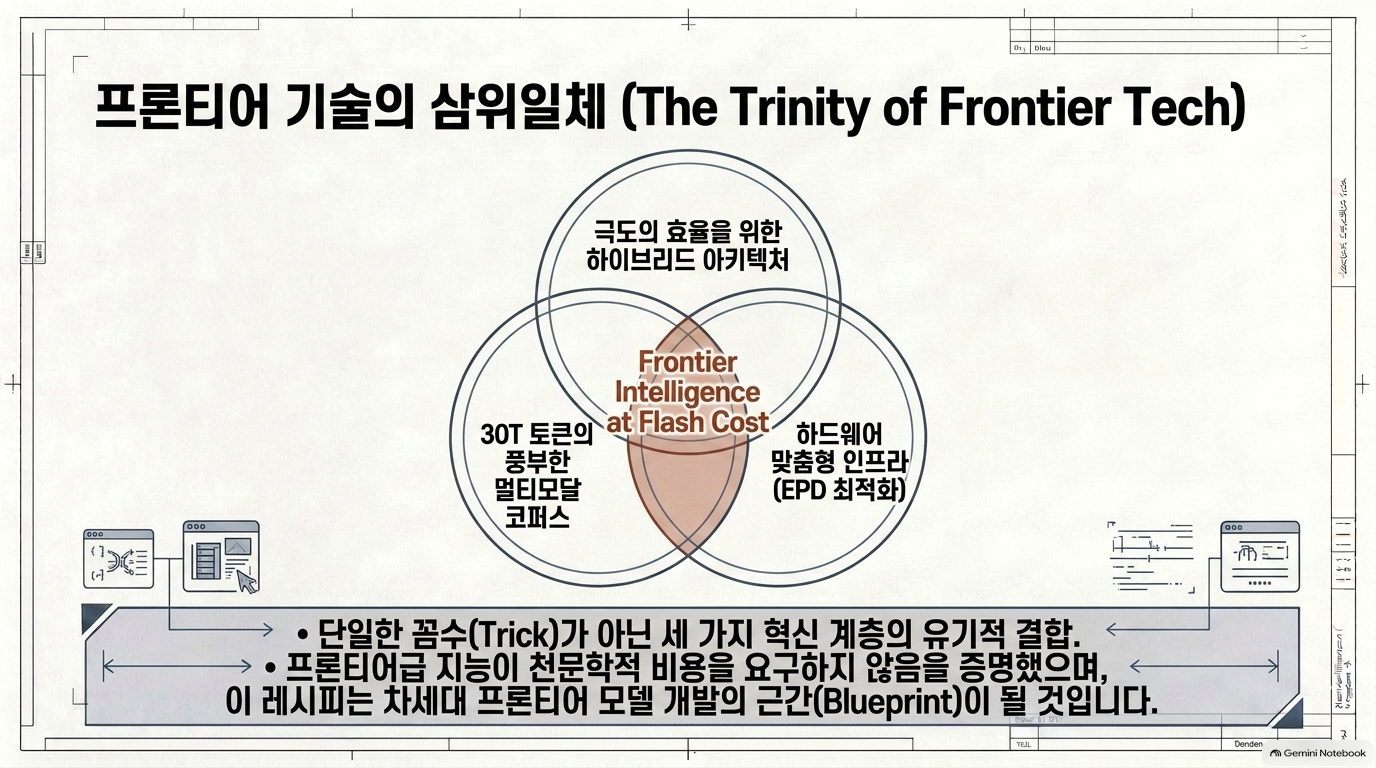
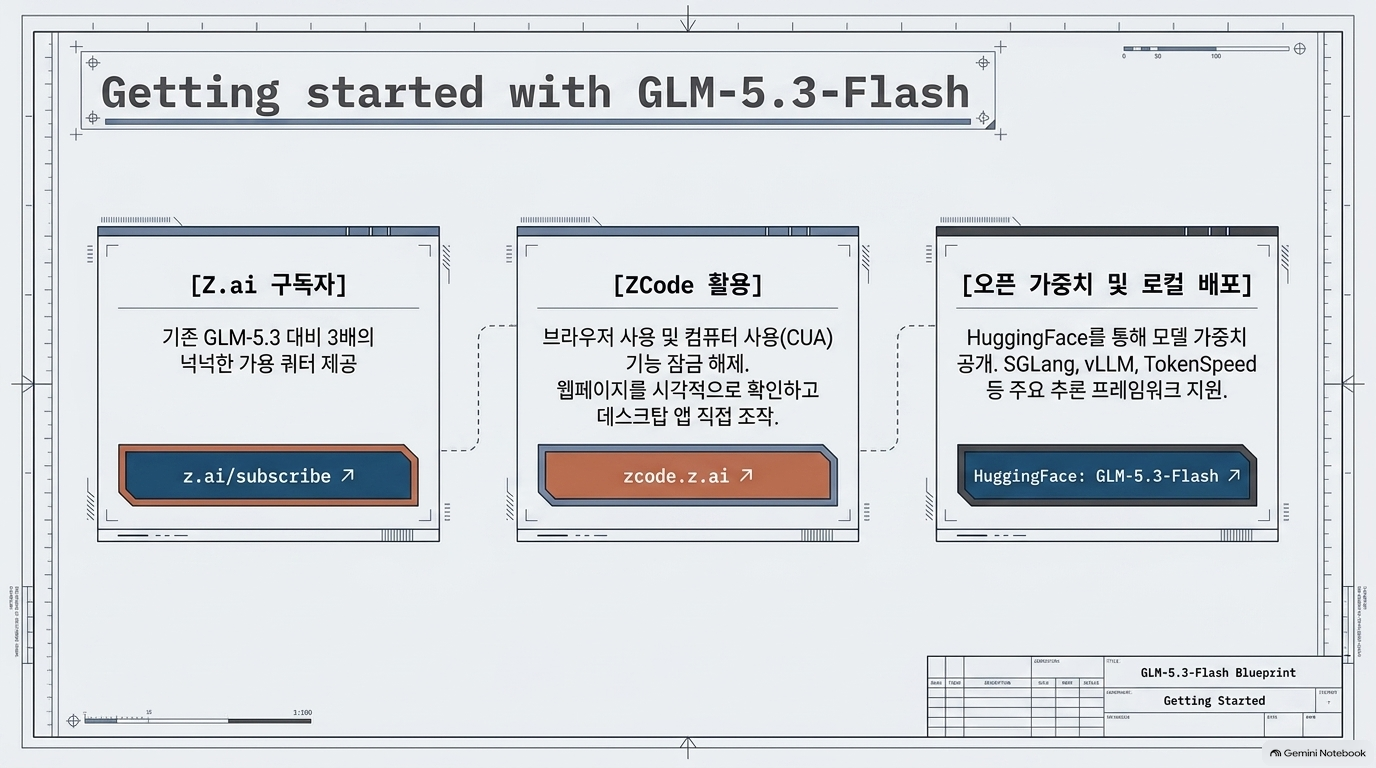
이 문서는 지능적 수준은 높이면서 비용은 획기적으로 낮춘 GLM-5.3-Flash 모델의 출시와 기술적 성과를 소개합니다. 해당 모델은 sparse 및 linear attention을 결합한 하이브리드 구조를 통해 긴 문맥 처리 효율을 극대화했으며, 특히 코딩 및 에이전트 작업에서 고가의 유료 모델에 근접하는 강력한 성능을 보여줍니다. 또한 시각적 지능을 통합하여 단순한 텍스트 처리를 넘어 실제 인터페이스를 확인하고 수정하는 능력을 갖추었으며, 전용 추론 엔진을 통해 중국산 AI 칩 기반의 대규모 서비스를 성공적으로 구현했습니다. 결과적으로 본 자료는 적은 연산 자원으로도 최첨단 멀티모달 지능을 구현할 수 있음을 입증하며 차세대 모델의 방향성을 제시하고 있습니다.


728x90
반응형
'07.AI > 12. AI 모델' 카테고리의 다른 글
| LLM - LG, K-엑사원(EXAONE) 2.0:K-EXAONE-2.0-750B-A37B (0) | 2026.09.01 |
|---|---|
| 네오 클라우드 - 추론 클라우드 (0) | 2026.08.31 |
| LLM 추론 최적화 - Semianalysis, AgentX:에이전트 중심의 추론 워크로드 벤치마 (0) | 2026.08.25 |
| LLM - 오픈 웨이트(Open Weight) - 폐쇄형(프론티어) 모델과의 격차 (0) | 2026.08.23 |
| LLM 추론 최적화 - 추론 클라우드 (0) | 2026.08.21 |