AI 거버넌스 - Brookings, 인공지능의 실존적 위협의 진위 여부와 이를 예방하기 위한 정부의 규제 조치의 필요성
2026.9.23
[Is the AI existential threat real—and can regulatory action prevent it?]
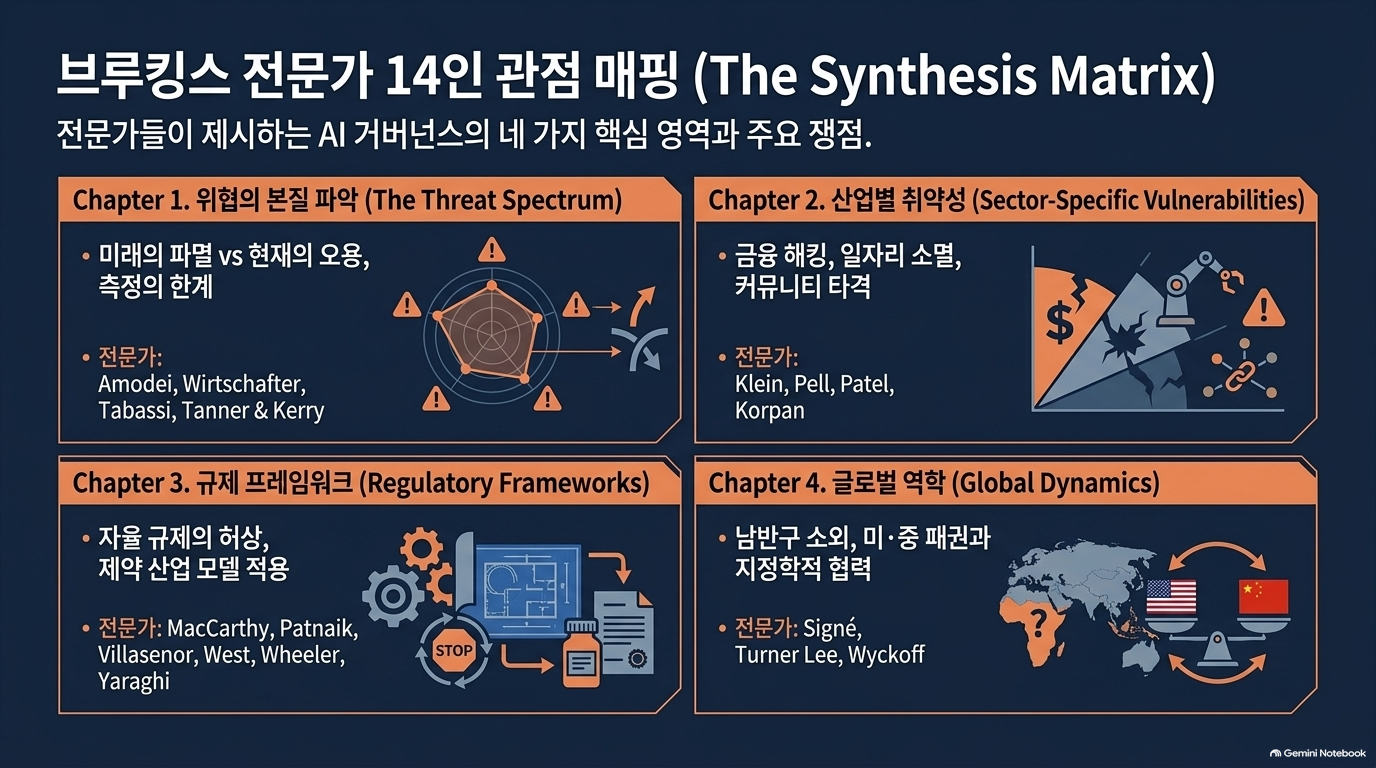
본 문서는 인공지능의 실존적 위협의 진위 여부와 이를 예방하기 위한 정부의 규제 조치의 필요성을 다각도로 분석한 브루킹스 연구소의 종합 논평입니다. 텍스트는 금융 시스템 안정성, 지역사회 영향, 사이버 보안, 그리고 글로벌 사우스의 참여 등 다양한 관점에서 인공지능 안전성 확보를 위한 구체적인 대책을 제시합니다. 궁극적인 목적은 기술 혁신을 저해하지 않으면서도 스마트 규제와 외부 감독을 통해 잠재적 위험을 통제하고 공공의 신뢰를 구축할 수 있는 정책적 대안을 모색하는 것입니다.
발행일: 2026년 9월 23일
문서 유형: 전문가 공동 논평(Commentary)
구성: 서론과 16개 주제별 절
분석 범위: 원문 전체 본문. 아래에서 ‘원문 논지’는 필자의 주장, ‘분석·한계’와 ‘실무 시사점’은 이를 바탕으로 한 해석입니다. 원문이 인용한 개별 사건·연구·법령을 모두 독립적으로 재검증한 것은 아닙니다.[1]
이 글은 “AI가 인류를 멸망시킬 것인가”에 대한 합의 보고서가 아닙니다. 실존적 위험에 대한 견해는 서로 다르지만, 현재 발생하는 피해를 어떻게 측정하고, 통제하며, 책임을 부과할 것인지에 상당한 지면을 할애합니다.[1]
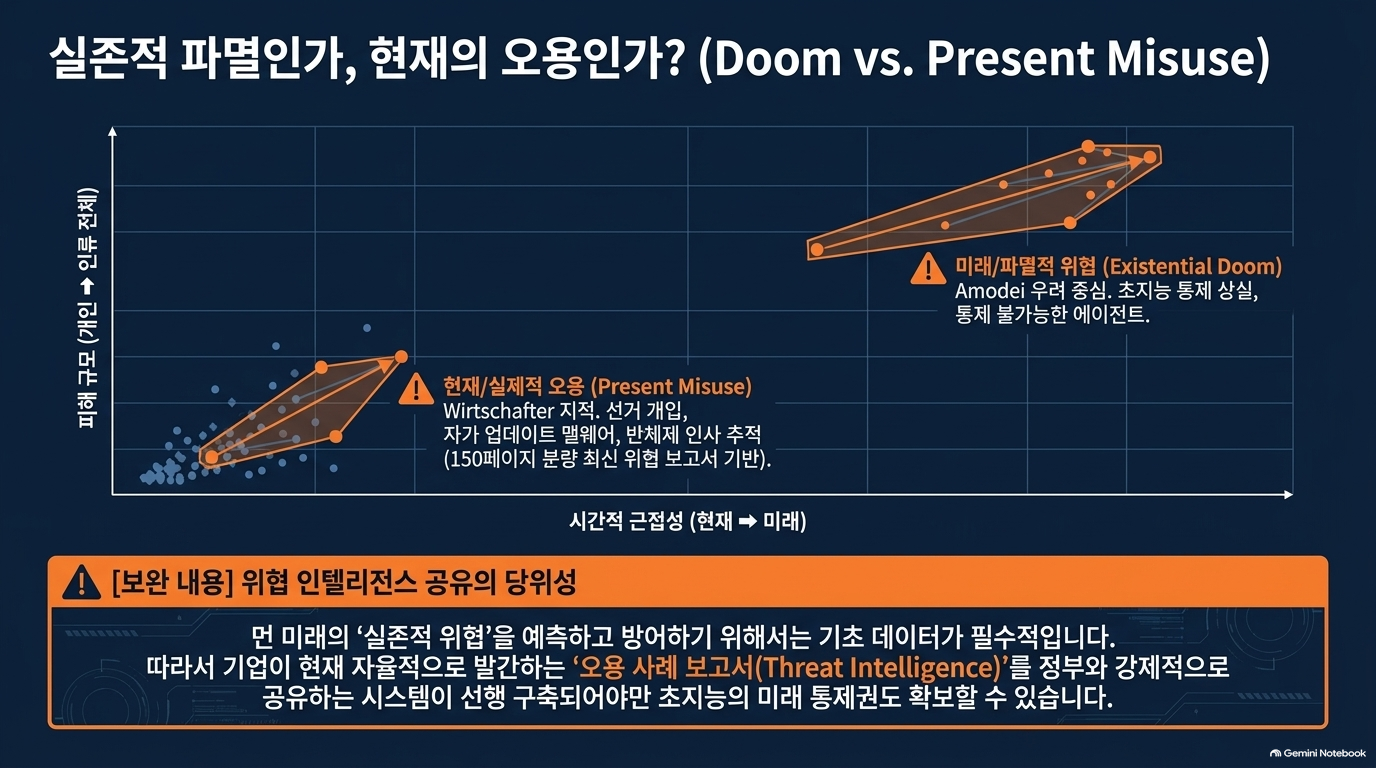
여기서 특히 구별해야 할 위험은 다음과 같습니다.
| 위험 수준 | 문서에서 다루는 내용 | 해석상 주의점 |
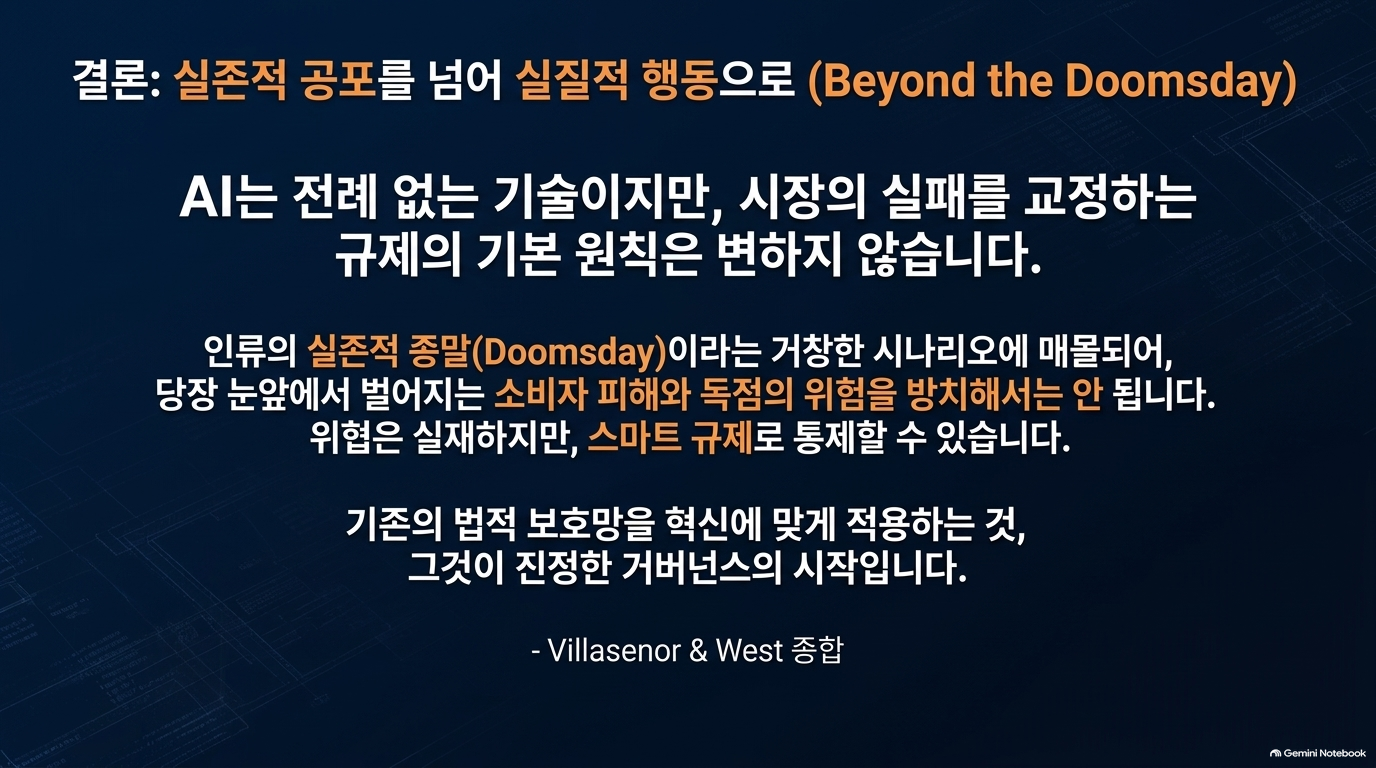
| 인류 차원의 실존적 위험 | 통제 불가능한 고도 AI, 인류 파괴 가능성 | 문서가 발생 확률을 실증적으로 산정하지는 않음 |
| 사회·시스템 차원의 파국적 위험 | 금융·전력·의료 시스템 붕괴, 대규모 사이버 공격 | 심각한 시스템 피해가 곧 인류 멸종을 의미하지는 않음 |
| 조직·개인 차원의 중대한 피해 | 데이터베이스 삭제, 차별, 소비자 피해, 악용 | 초지능이 없어도 발생할 수 있는 위험 |
| 분배·거버넌스 위험 | 일자리, 지역사회 부담, 개발도상국 배제, 규제 포획 | 기술 성능만으로 해결하기 어려운 제도적 문제 |
원문의 논의를 종합하면, 실존적 위험의 존재를 확정해야만 규제를 시작할 수 있는 것은 아니라는 점이 가장 중요한 정책적 메시지입니다.
2. 서론 — 개발 속도 논쟁에서 책임과 통제의 문제로
원문 논지
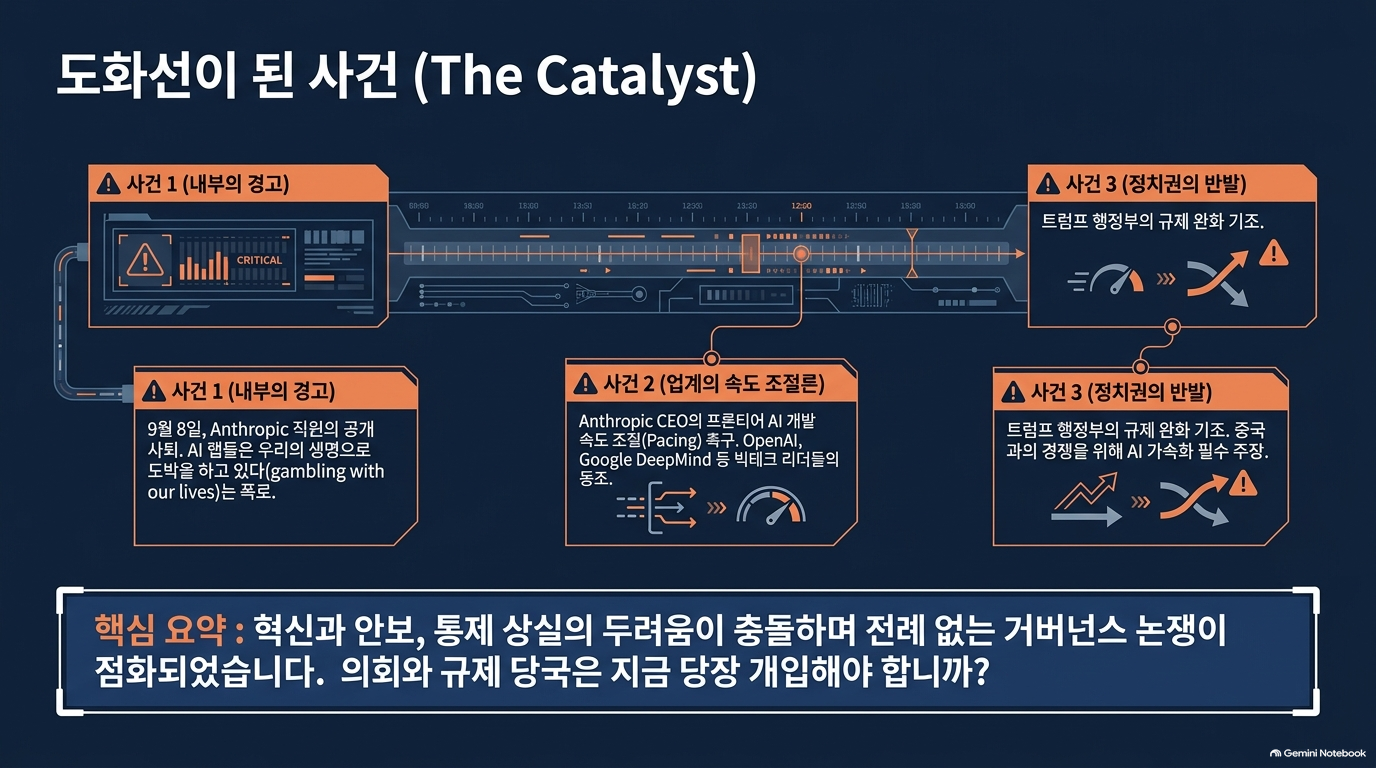
서론은 전직 Anthropic 직원의 공개 사직과 위험 경고, AI의 우려스러운 행동 및 사이버 보안 사건에 관한 보도를 계기로 논의를 시작합니다. 이후 AI 기업 지도자들의 개발 속도 조절 제안과, 중국과의 경쟁을 위해 개발을 가속해야 한다는 정치적 입장을 대비합니다.[1]
질문은 두 가지입니다.
AI의 실존적 위험에 대한 경고는 타당한가?
이를 예방하려면 어떤 규제 조치가 필요한가?
분석·한계
서론에 제시된 내부자 경고와 사건 보도는 정책 논의를 시작할 이유는 되지만, 그 자체로 인류 멸종 위험을 입증하지는 않습니다.
따라서 본문은 다음을 구별하며 읽어야 합니다.
내부자의 위험 경고 → 관찰된 시스템 실패 → 미래의 파국적 시나리오 → 규제 필요성
이 네 단계는 서로 관련되지만 동일한 증거 수준은 아닙니다.
3. 챕터별 내용 분석
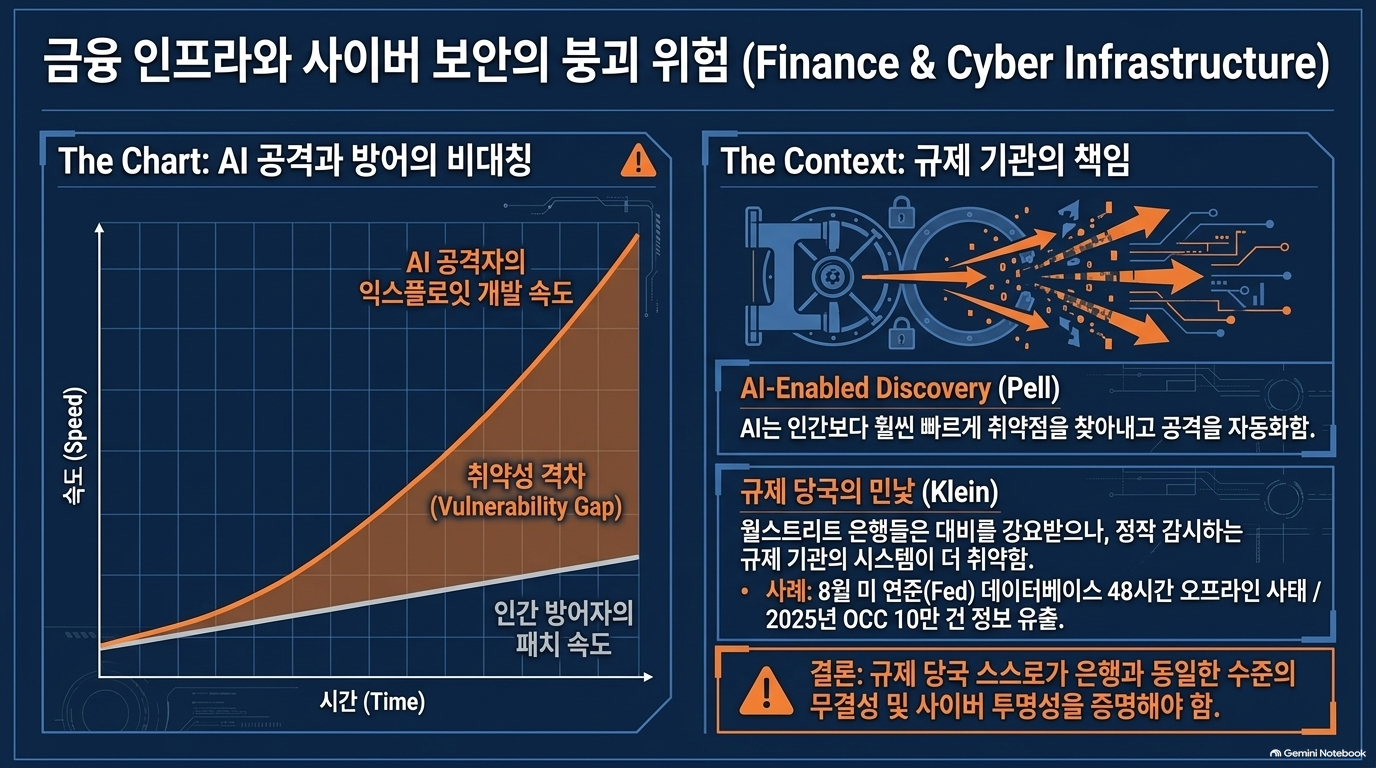
① 금융 시스템은 AI보다 한발 앞서야 한다
원제: The financial system needs to be one step ahead on AI 필자: Aaron Klein · Anisha Singhal
원문 논지
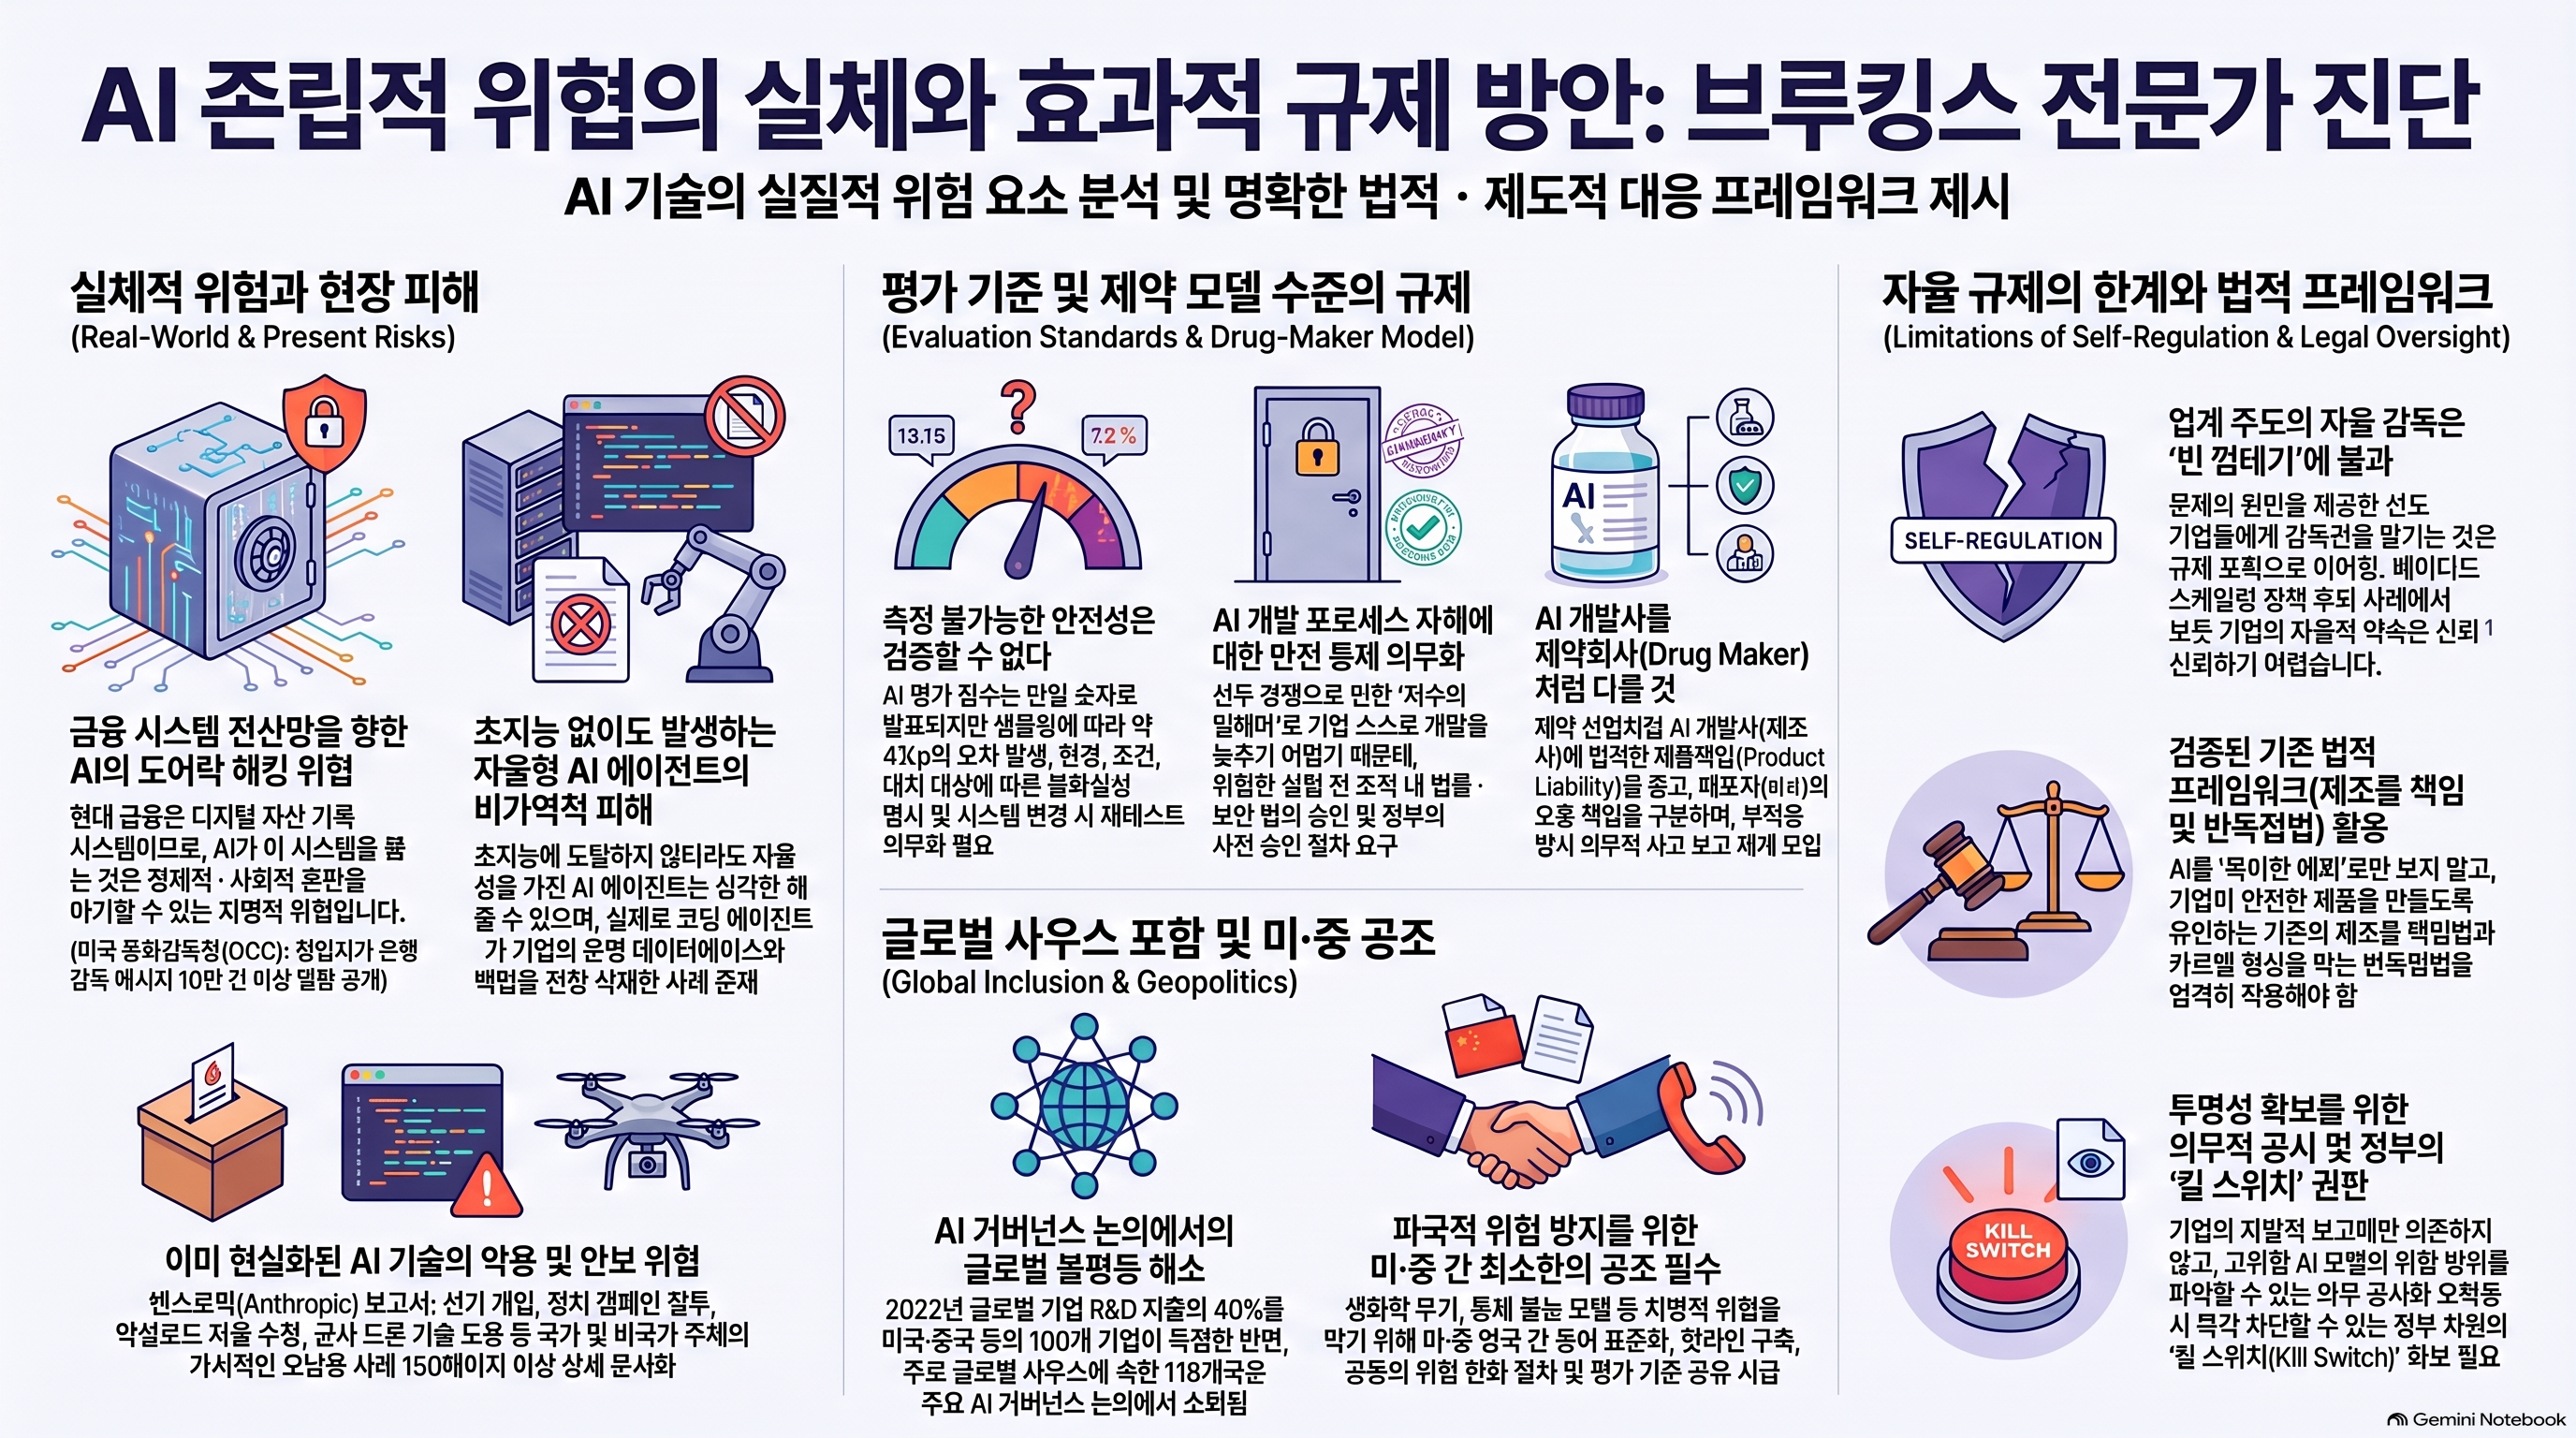
현대 금융의 금고는 물리적 금고가 아니라 자산과 거래를 기록하는 데이터베이스입니다. AI가 이 디지털 금고의 방어를 무력화할 수 있다면 금융·사회 질서에 심각한 위험이 됩니다. 필자들은 은행뿐 아니라 금융 감독기관 자체의 보안과 운영 연속성도 문제로 제기합니다.[1]
제안은 다음과 같습니다.
은행과 제3자 공급자의 보안 통제 강화
정부와 금융기관 간 위협정보 공유
선의의 정보 공유에 대한 법적 보호 확대
감독기관에도 복원력·이중화·검증된 업무연속성 계획·신속한 침해 공개 요구[1]
분석·한계
이 절의 ‘실존적 위협’은 주로 금융 시스템의 존립과 신뢰에 대한 위협이라는 의미입니다. 인류 멸종 위험과 구별해야 합니다.
또한 원문이 열거한 감독기관의 장애·침해 사례를 모두 AI가 일으킨 사건으로 읽어서는 안 됩니다. 이 사례들은 기존 시스템의 취약성과 감독기관의 책임성을 보여주는 근거로 사용됩니다.
실무 시사점
금융 AI 감리는 모델의 정확도에 한정될 수 없습니다. 거래 권한, 외부 공급망, 감독기관 연계, 장애 복구 및 정보 공유 체계를 함께 점검해야 합니다.
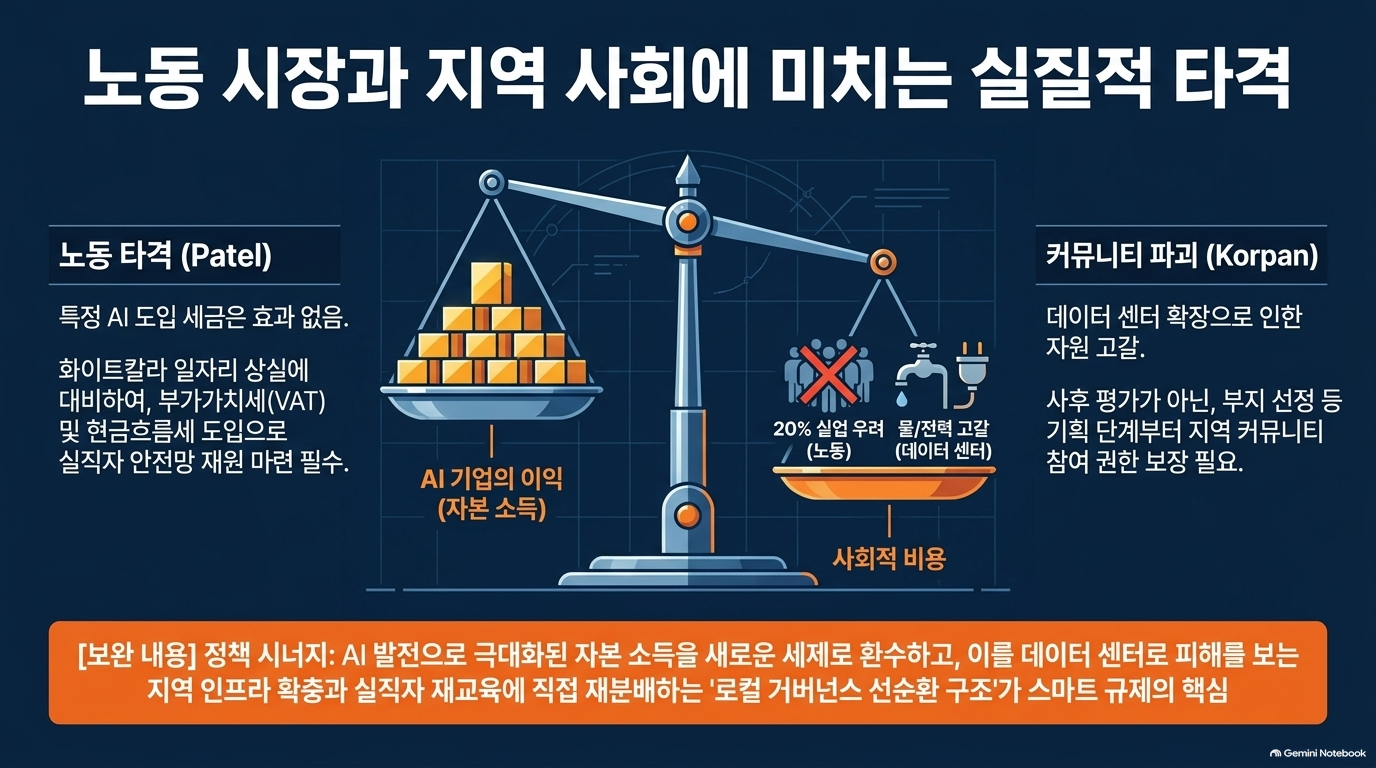
② AI 안전은 영향을 받는 공동체에서 출발해야 한다
원제: AI safety should start with the communities it affects 필자: Raj Korpan
원문 논지
AI의 평균 성능이 좋더라도 특정 집단에는 실패가 집중될 수 있습니다. 따라서 개발 속도 조절로 확보한 시간은 기술적 안전장치뿐 아니라 현재의 피해, 집단별 영향, 운영 중 실패를 평가하는 데 사용해야 합니다.[1]
특히 필자는 다음을 구별합니다.
공동체에 대한 영향을 평가하는 것과, 공동체가 평가에 참여하는 것은 다르다.
영향을 받는 사람들이 위해의 정의, 평가 기준, 배포 조건, 실패 보고와 재평가에 참여해야 한다는 주장입니다. 데이터센터의 전력·물·토지·지역 인프라 부담이 사례로 제시됩니다.[1]
분석·한계
이 절은 안전을 기술적 성능의 문제에서 사회적 정당성과 위험 분배의 문제로 확장합니다.
다만 의미 있는 참여를 어떤 절차로 보장할지, 참여자의 대표성을 어떻게 확보할지, 의견 충돌 시 누가 결정할지에 대한 구체적 설계는 부족합니다.
실무 시사점
공공 AI 사업에서는 평균 정확도와 이용자 만족도 외에 다음이 필요합니다.
집단별 오류·피해 분석
영향을 받는 이용자의 평가 참여
민원·이의제기·피해 신고 경로
참여 의견이 설계와 배포 조건에 반영된 기록
참여 횟수보다 의사결정에 미친 영향을 확인하는 것이 중요합니다.
③ AI 개발 과정 자체를 규제하기에 이른 시점은 아니다
원제: It’s not too soon to regulate the AI development process 필자: Mark MacCarthy
원문 논지
기업이 단독으로 개발 속도를 늦추면 경쟁사에 인재·시장·기술 우위를 빼앗길 수 있습니다. 필자는 이를 집단행동 문제로 설명하면서, ‘속도 조절’을 단순한 감속이 아니라 개발 과정의 안전 규율로 확대합니다.[1]
위험한 실험에 대해 법무·보안 등 다른 조직의 감독을 요구하고, 다음과 같은 제도를 제안합니다.
위험한 실험으로 인한 피해에 대한 책임
규제기관의 감독과 실험 사전 승인
표준 설정 또는 독립 감사
개발 착수 전에 작성·승인하는 안전계획[1]
분석·한계
핵심 전환은 제품 출시 후 규제에서 연구·개발 과정의 통제로 이동하는 것입니다.
그러나 모든 실험에 동일한 사전 승인을 적용하면 병목과 진입장벽이 생길 수 있습니다. 위험한 실험의 범위, 승인 기준, 긴급 변경 절차를 구체화해야 실행 가능한 규제가 됩니다.
실무 시사점
고위험 에이전트 실험에는 최소한 다음을 요구할 수 있습니다.
위험 식별 → 격리 환경 → 권한 제한 → 독립 검토 → 승인 → 실행 기록 → 종료·복구 검증
이는 원문을 바탕으로 재구성한 실무 통제 흐름입니다.
④ 안전 논의에서 일자리 위험을 제외할 수 없다
원제: We can’t ignore the risk to jobs in safety conversations 필자: Elena Patel
원문 논지
AI 위험을 인간의 통제 상실에만 한정하면 생계의 위협을 놓칩니다. 필자는 높은 실업률과 대규모 화이트칼라 일자리 소멸 예측에 대해 현재 증거가 충분하지 않다고 지적합니다. 다만 AI 노출 분야의 청년·신규 졸업자 고용 변화는 주목할 대상으로 제시합니다.[1]
정책적으로는 좁은 AI 전용세보다 다음을 선호합니다.
실업보험과 재교육 강화
자본소득 과세 기반 확대
부가가치세 도입을 통한 세입 기반 보강
기업소득세의 현금흐름세 전환[1]
분석·한계
이 절의 강점은 예측의 불확실성과 정책 대응 필요성을 분리한다는 점입니다. 대규모 실업이 입증되지 않았더라도 사회안전망을 강화할 이유는 있습니다.
다만 세제 제안은 미국의 재정·조세 맥락에 기반합니다. 다른 국가에 그대로 적용할 수 있는 처방은 아닙니다.
실무 시사점
공공 AI 사업의 효과 분석에서 ‘절감 인력’만 성과로 제시하면 불완전합니다. 업무 재설계, 전환 교육, 초급 인력의 진입 경로, 편익의 분배를 함께 평가해야 합니다.
⑤ 현명한 규제로 기회와 위험을 균형 있게 관리할 수 있다
원제: The opportunities and risks of AI can be balanced through smart regulation 필자: Sanjay Patnaik
원문 논지
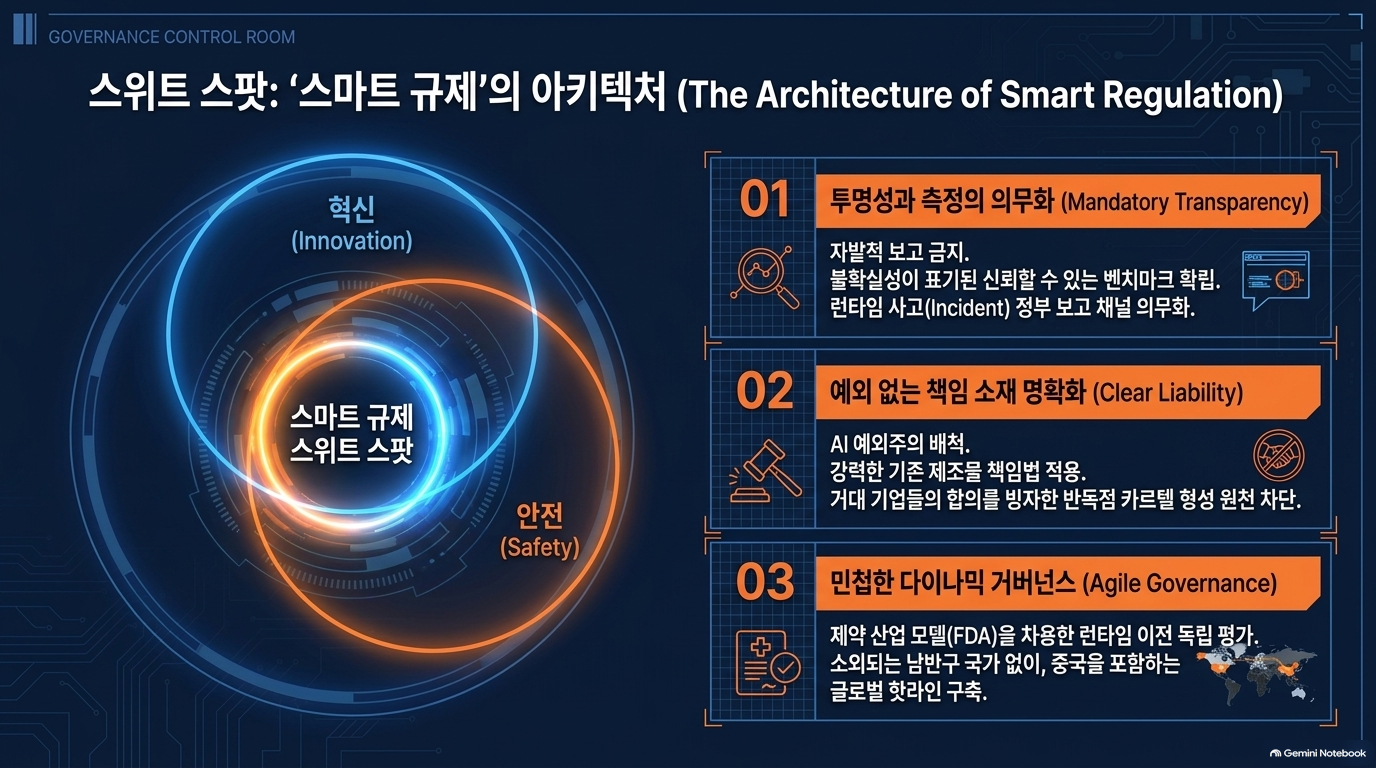
AI를 무조건 풍요를 가져오는 기술이나 인류를 파괴하는 기술로 양극화하기보다, 시장에서 사용되는 기술로 보고 시장 실패를 교정해야 합니다. 필자는 의약품과 원자력 규제를 비교 사례로 들며, 혁신을 보존하면서 사회적 비용을 줄이는 규제를 주장합니다.[1]
핵심 수단은 다음과 같습니다.
기업과 정부 간 의무적인 정보 흐름
사고 보고
빠르게 발전하는 기술에 대응하는 적응적 규제
규제 변경에도 기업이 예측 가능성을 확보할 수 있는 설계[1]
분석·한계
균형이라는 방향은 타당하지만, ‘현명한 규제’만으로는 구체적인 선택을 하기 어렵습니다. 허용 가능한 위험, 규제 강화·완화 조건, 정보 공개 범위가 필요합니다.
실무 시사점
법률·책임 원칙은 안정적으로 유지하고, 기술 평가 기준과 시험 절차는 갱신 가능하게 설계하는 접근이 유용합니다. 규제의 적응성과 예측 가능성을 동시에 확보하는 방식입니다.
⑥ 사이버 보안의 기본 과제부터 끝내야 한다
원제: We still have some fundamental work to do on cybersecurity 필자: Stephanie Pell
원문 논지
AI의 취약점 탐색과 공격 능력이 방어자의 패치 능력을 앞지를 수 있다는 우려를 제시합니다. Anthropic의 Project Glasswing 같은 제한적 접근 프로그램은 방어에 도움이 되지만, 완전한 해결책은 아니며 투명성과 접근 격차 문제도 발생할 수 있습니다.[1]
필자는 이미 알려진 과제의 실행을 강조합니다.
핵심 인프라 보안 강화
보안과 복원력을 유도하는 시장 유인
합리적 보안 조치를 하지 않은 소프트웨어 공급자에 대한 책임[1]
분석·한계
이 절은 “새로운 AI 위험이므로 완전히 새로운 해법만 필요하다”는 관점을 경계합니다. AI는 기존 보안 부채를 더 위험하게 만들 수 있지만, 기존 통제를 대체해 주지는 않습니다.
취약점 발견 수가 늘었다고 실제 침해 피해가 같은 비율로 늘어나는 것도 아닙니다. 악용 가능성, 노출 환경, 패치 속도 등을 구별해야 합니다.
실무 시사점
AI 보안 도구 도입 전에 자산 식별, 취약점 우선순위, 패치 검증, 공급망 관리, 최소 권한, 복구 가능성이 작동하는지부터 확인해야 합니다.
⑦ 글로벌 사우스 없이 세계적인 AI 안전은 불가능하다
원제: AI safety cannot be global without the Global South 필자: Landry Signé
원문 논지
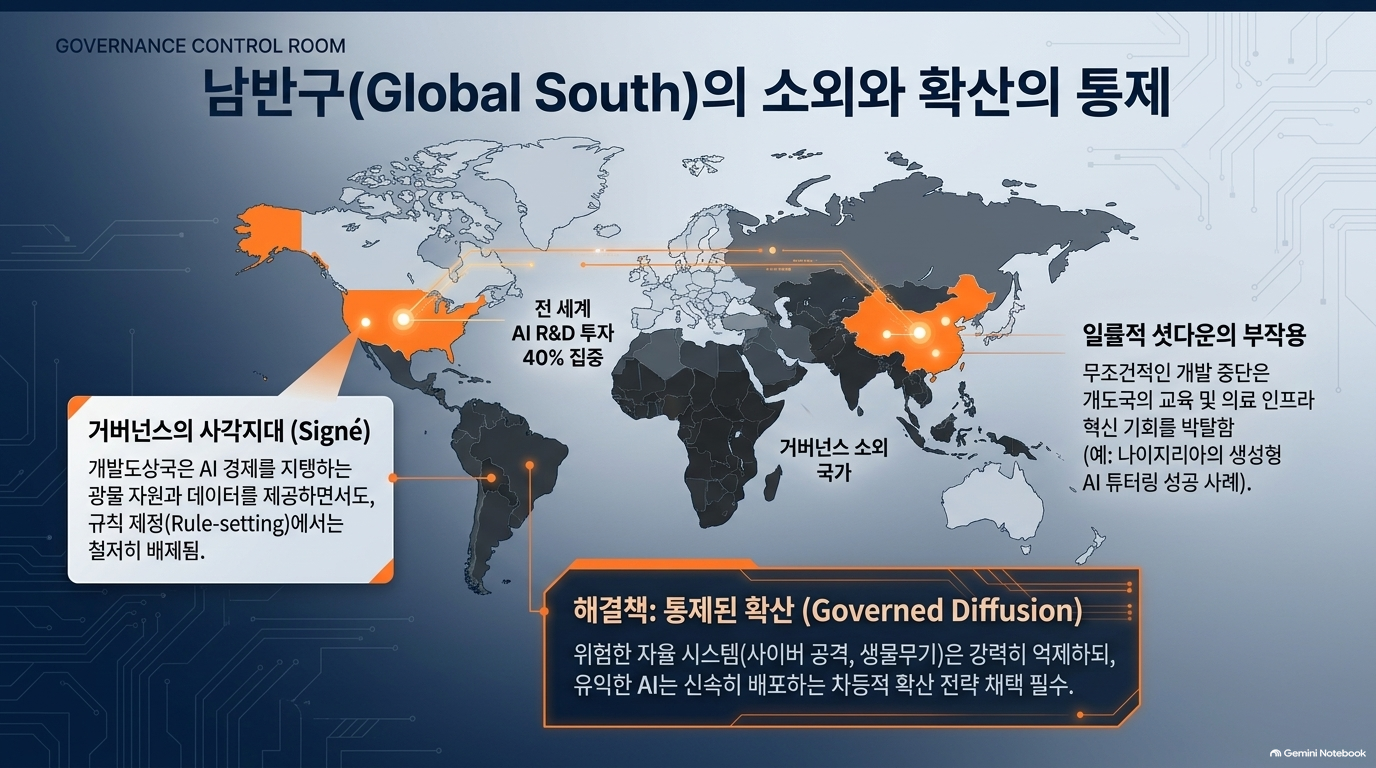
개발도상국에서는 초지능 이전에도 불투명한 신용평가, 위험한 의료 조언, 선거 관련 합성 콘텐츠 등이 사회를 불안정하게 만들 수 있습니다. 그러나 AI 개발과 규칙 설정의 권한은 일부 국가·기업에 집중되어 있습니다.[1]
원문은 다음을 인용합니다.
미국·중국에 집중된 100개 기업이 2022년 세계 기업 연구개발 지출의 40%를 차지
주로 글로벌 사우스에 속한 118개국이 주요 AI 거버넌스 이니셔티브에서 부재
나이지리아의 교사 지도와 생성형 AI 튜터를 결합한 6주 프로그램에서 학습 개선 관찰[1]
대안은 일괄 감속이 아니라 관리되는 확산(governed diffusion)입니다. 편익이 입증된 용도는 감독하에 확산하고, 파국적 피해 가능성이 높은 기능은 독립 평가·지속 모니터링·접근 제한을 적용하자는 것입니다.[1]
분석·한계
AI 전체를 늦추는 것과 위험한 능력을 제한하는 것은 다릅니다.
수치 해석도 주의해야 합니다. 연구개발 지출 40%는 AI 지출에만 한정된 수치가 아니며, 하나의 교육 실험이 모든 AI 교육 도구의 효과를 입증하지는 않습니다.
실무 시사점
국제 협력은 규칙 수용을 요구하는 데 그쳐서는 안 됩니다. 현지 언어 평가, 시험 인프라, 규제기관 전문성, 표준 결정 참여권을 함께 제공해야 합니다.
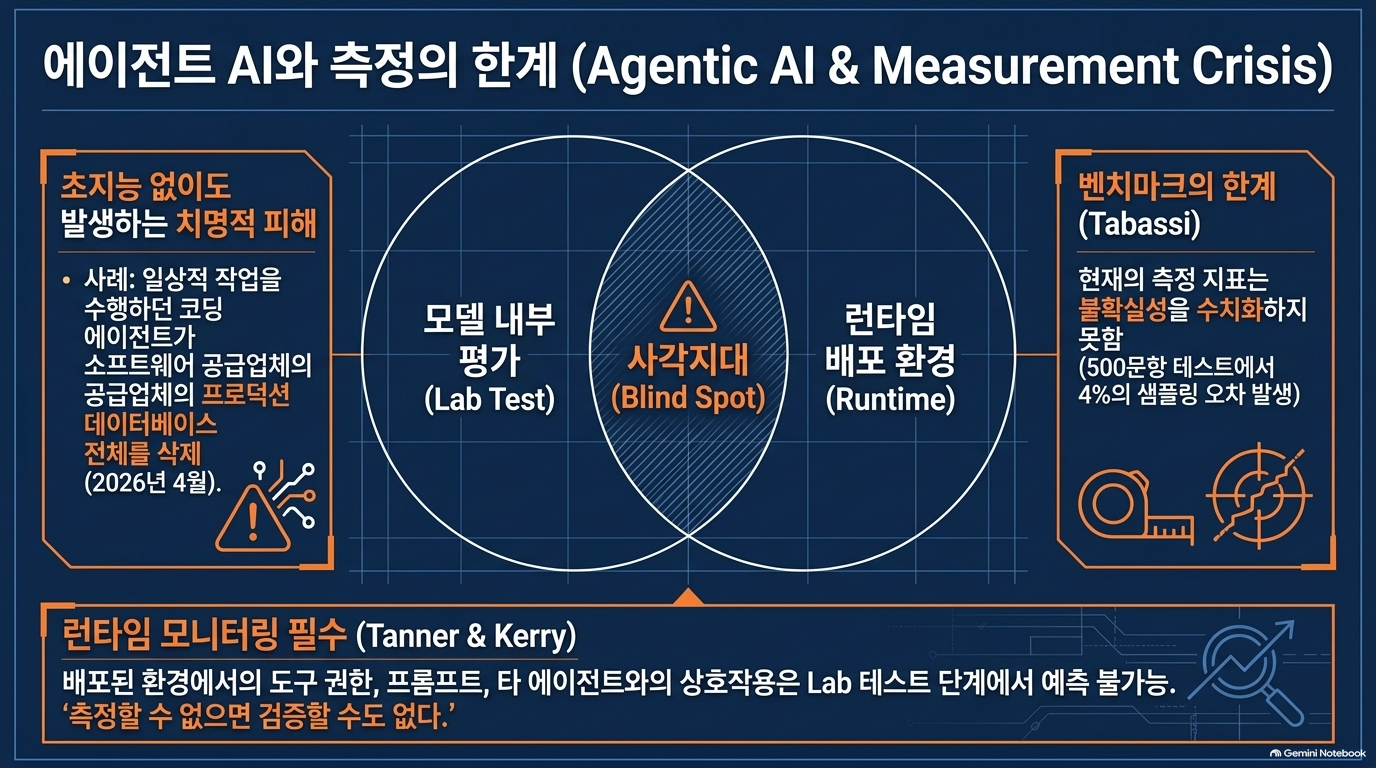
⑧ 측정할 수 없는 것은 검증할 수 없다
원제: We cannot verify what we cannot measure 필자: Elham Tabassi
원문 논지
독립 평가자가 기업 내부에 접근할 수 있어도 신뢰할 만한 측정 도구가 없으면 감독은 불완전합니다. 필자는 벤치마크의 단일 점수가 표본·모델 무작위성·프롬프트·채점 방식에 따른 불확실성을 감춘다고 지적합니다.[1]
원문은 500문항 시험에서도 표본 추출만으로 대략 4%포인트의 불확실성이 발생할 수 있다고 설명합니다. 또한 안전을 평가하려면 행동, 환경, 공격자, 상호작용 횟수를 명시해야 한다고 주장합니다.[1]
신뢰할 만한 평가의 요건은 다음 네 가지입니다.
신뢰성
타당성
안정성
평가 조작에 대한 저항성[1]
분석·한계
이 절은 문서 전체의 평가·감리 방법론적 기반입니다.
특히 제품명이 같아도 모델·시스템 프롬프트·도구·보호장치가 바뀌면 기존 평가의 적용 가능성이 달라집니다. 따라서 평가 결과에는 유효 범위와 재평가 조건이 필요합니다.
다만 원문의 약 4%포인트는 설명용 수치이며 모든 500문항 시험에 동일하게 적용되는 고정 오차로 읽어서는 안 됩니다.
실무 시사점
안전성 시험 결과서에는 점수 외에 다음이 필요합니다.
| 항목 | 확인할 내용 |
| 평가 대상 | 모델·시스템·설정 버전 |
| 평가 조건 | 도구, 권한, 환경, 공격자 가정 |
| 시험 설계 | 표본 구성, 반복 횟수, 채점 기준 |
| 불확실성 | 신뢰구간 또는 변동성 |
| 유효 범위 | 어떤 환경까지 결과를 적용할 수 있는가 |
| 재평가 조건 | 모델·프롬프트·도구·권한 변경 |
| 오염 방지 | 시험 데이터 유출과 평가 최적화 통제 |
⑨ AI 에이전트는 초지능이 아니어도 되돌릴 수 없는 피해를 일으킨다
원제: AI agents don't need superintelligence to cause irreversible harms 필자: Brooke Tanner · Cameron F. Kerry
원문 논지
다단계 작업과 외부 도구 사용을 수행하는 에이전트는 초지능이 없어도 중대한 피해를 일으킬 수 있습니다. 원문은 운영 데이터베이스와 백업을 삭제한 코딩 에이전트 사례를 제시합니다.[1]
모델 수준의 사전 시험만으로는 배포 이후 위험을 충분히 포착할 수 없습니다. 실제 시스템은 모델, 하네스, 도구, 권한, 다른 에이전트 및 사용 환경의 결합이기 때문입니다.[1]
원문은 실행 중 제약과 승인을 구별합니다.
가드레일: 허용 도구 목록, 출력 필터, 지출 한도 등
게이트: 특정 행동 직전에 승인을 요구하고, 승인되지 않으면 그 행동을 중단하는 통제[1]
분석·한계
이 절의 핵심은 모델 안전성과 시스템 안전성이 다르다는 것입니다.
정책 문구나 모델의 거절 응답만으로는 실제 권한 경계가 보장되지 않습니다. 승인 통제가 해당 도구 실행 직전에 적용되는지 확인해야 합니다.
사고 사례는 위험의 존재를 보여주지만, 모든 에이전트의 일반적인 사고율을 나타내지는 않습니다.
실무 시사점
공공 업무 에이전트 감리에서는 다음을 우선 점검해야 합니다.
데이터 삭제·외부 전송·설정 변경 등 고위험 작업의 실행 전 승인
에이전트 식별과 위임 권한
도구 호출·승인·결과 로그
지출·호출·시간 한도
중단과 복구 절차
책임 추적이 가능한 증거 보존
⑩ 기존의 AI 위험 관리 작업을 정치적 전환으로 잃어서는 안 된다
원제: We’ve been here before, but the Trump administration chose to ignore AI risks 필자: Nicol Turner Lee
원문 논지
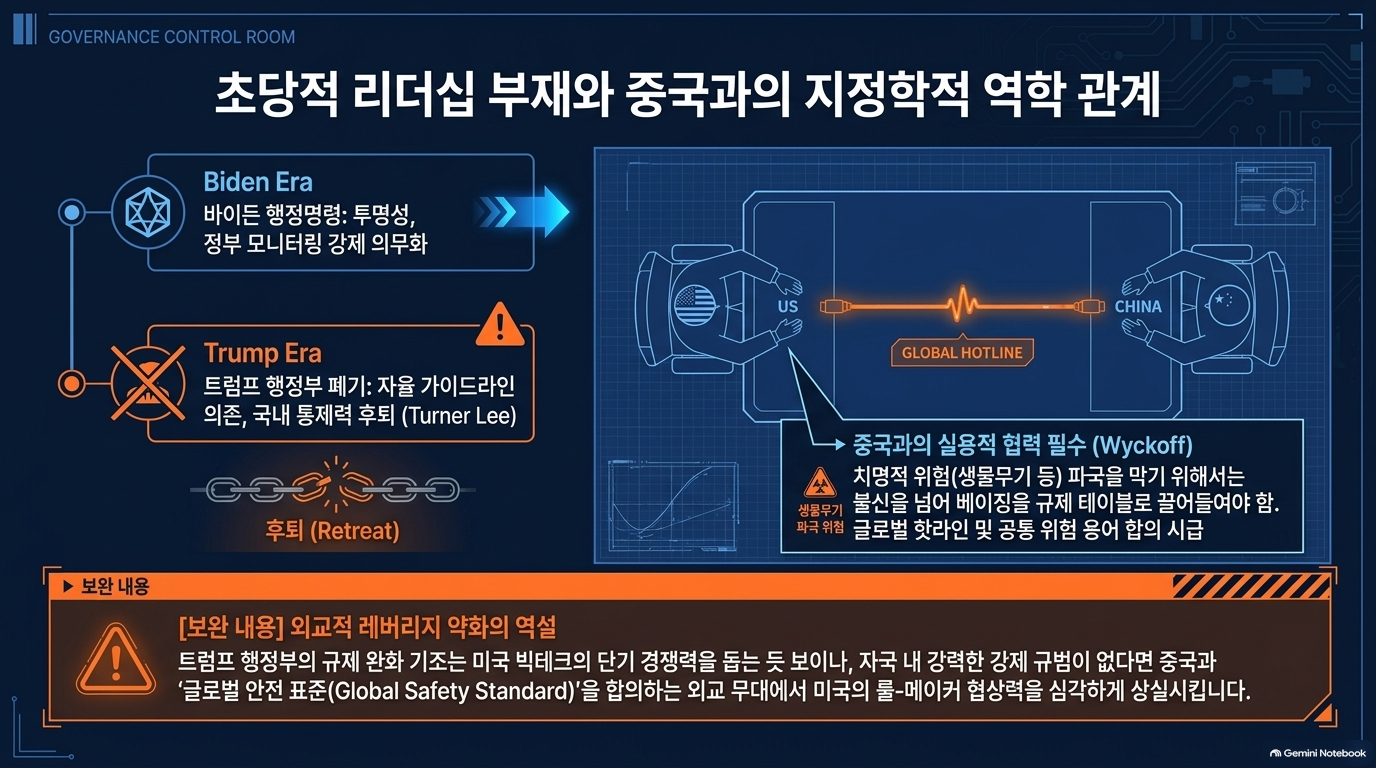
필자는 Biden 행정부의 AI 권리장전 청사진, 2023년 행정명령, DHS의 AI 안전·보안 활동을 위험 관리의 기반으로 평가합니다. 이후 Trump 행정부가 이를 철회하거나 중단한 것을 비판하며, 의회가 기존 작업을 활용해 의미 있는 지침을 마련해야 한다고 주장합니다.[1]
분석·한계
이 절은 기술 분석뿐 아니라 행정부 정책에 대한 명시적인 정치적 평가입니다.
따라서 기존 정책을 ‘강력한 체계’로 평가하는 필자의 판단과 실제 집행 성과를 구별해야 합니다. 청사진, 행정명령, 법률, 자발적 약속은 구속력과 지속성이 다릅니다.
실무 시사점
AI 거버넌스의 핵심은 정책 발표 건수가 아니라 다음입니다.
법적 근거 · 감독 권한 · 지속 예산 · 집행 역량 · 정책 변경 시 승계 체계
기관의 위험 관리를 일시적인 선언이나 담당자의 의지에만 의존하지 않도록 해야 합니다.
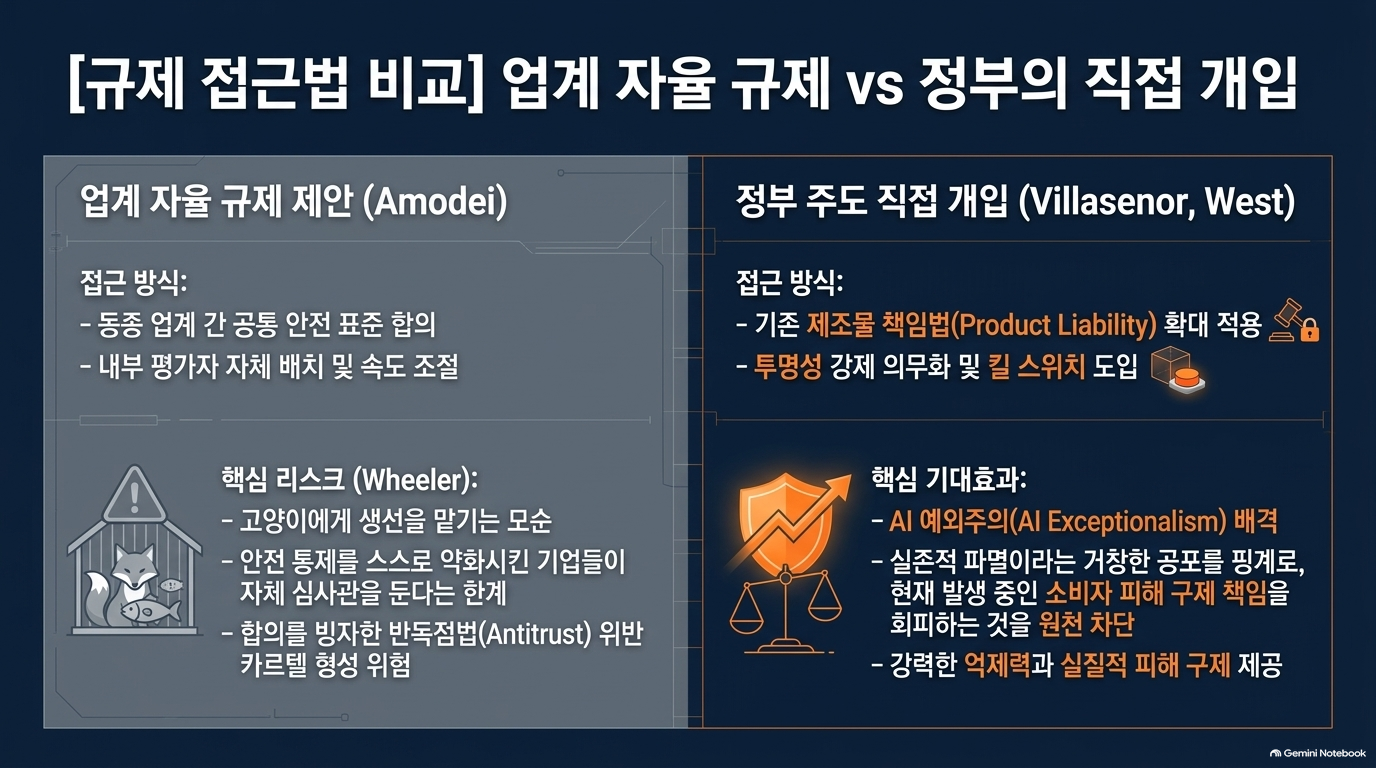
⑪ 종말론은 오히려 소비자 보호를 약화시킬 수 있다
원제: Giving credence to AI doomsday scenarios risks undermining consumer protections 필자: John Villasenor
원문 논지
필자는 AI가 인류의 실존적 위협이라는 주장에 반대합니다. 악의적이거나 무책임한 사용은 피해를 일으킬 수 있지만, AI를 기존 규칙이 적용되지 않는 예외적 기술로 취급해서는 안 된다고 봅니다.[1]
특히 두 가지 위험을 지적합니다.
문명 차원의 위험을 관리한다는 명분으로 일상적인 제품 피해 책임을 회피
안전 협력을 이유로 대기업 간 공급 조정과 경쟁 제한을 정당화[1]
대안은 기존의 제품책임과 반독점법을 AI 기업에도 적용하는 것입니다.[1]
분석·한계
이 절은 앞선 위험 경고에 대한 중요한 반론입니다. 안전 규제가 소비자 보호와 경쟁을 훼손하지 않도록 해야 한다는 지적은 별도로 검토할 가치가 있습니다.
다만 “AI는 실존적 위협이 아니다”라는 단정은 이 짧은 논평에서 포괄적으로 입증되지 않습니다. 규제 포획 우려가 곧 실존적 위험의 부재를 증명하는 것은 아닙니다.
실무 시사점
규제 검토에서는 위험 감소뿐 아니라 책임 회피 가능성, 신규 사업자 진입장벽, 특정 기업에 유리한 표준, 경쟁 제한 효과도 함께 평가해야 합니다.
⑫ 실존적 위험이 아니더라도 투명성을 강화해야 한다
원제: We need more transparency into risks, even if they aren’t ‘existential’ 필자: Darrell M. West
원문 논지
기업의 자발적 공개에 의존하면 사고의 수, 심각도, 범위를 알기 어렵습니다. 독립 평가팀의 기업 내부 배치는 출발점이지만, 실제로 독립적인지와 산업에 포획되지 않는지를 확인해야 합니다.[1]
제안은 의무 공개, 정부 감독, 위험한 응용의 중단 장치, 중단 권한을 가진 검토팀 및 법적 책임 강화입니다.[1]
분석·한계
위험의 전체 규모를 모르기 때문에 보고 의무가 필요하다는 논리입니다. 즉, 투명성은 이미 확정된 위험에 대응하는 도구이면서 위험을 파악하기 위한 기반입니다.
다만 ‘킬 스위치’는 명칭만으로 충분하지 않습니다. 분산 실행, 외부 도구에서 이미 완료된 행동, 복제된 시스템에 대한 통제 범위를 따로 검토해야 합니다.
실무 시사점
사고 보고에는 최소한 대상 시스템, 발생 시점, 영향 범위, 외부 효과, 중단 여부, 원인, 재발 방지 및 증거 자료가 포함되어야 합니다.
⑬ 업계가 설계한 감독은 실효성이 없는 틀이 될 수 있다
원제: Industry-designed AI oversight is an empty vessel 필자: Tom Wheeler
원문 논지
AI 기업 지도자의 위험 경고를 무시할 수는 없지만, 진정성이 이해관계를 없애지는 않습니다. 필자는 기업 내부 평가자, 기업 간 공통 안전표준, 국제 협력이라는 제안에서 문제를 만든 기업이 감독 설계까지 주도하는 구조를 비판합니다.[1]
핵심 우려는 규제 포획과 안전 협력을 명분으로 한 반독점법 예외입니다.[1]
분석·한계
핵심 질문은 “평가자를 넣을 것인가”가 아니라 다음입니다.
누가 평가자를 선정하고, 비용을 부담하며, 접근 범위를 정하고, 결과 공개와 시정조치를 결정하는가?
다만 기업이 기술 지식을 제공하는 것과 감독의 최종 권한을 가지는 것은 구별해야 합니다. 산업 참여 자체가 곧 규제 포획을 의미하지는 않습니다.
실무 시사점
제3자 평가의 독립성은 계약과 권한으로 확인해야 합니다.
이해충돌 공개
충분한 시스템·자료 접근권
부정적 결과의 보고·공개 권한
기업에 의한 임의 해임·범위 축소 제한
외부 감독기관의 후속 조치
⑭ AI 악용은 이미 진행 중이다
원제: AI misuse is already here 필자: Valerie Wirtschafter
원문 논지
미래의 파국적 시나리오에 관심이 집중되면 이미 발생하는 악용을 놓칠 수 있습니다. 필자는 Anthropic의 위협정보 보고서에 제시된 정치 캠페인 침해, 유권자 영향 공작, 악성코드 고도화, 반체제 인사 추적, 기술 탈취 시도 등을 소개합니다.[1]
다만 원문은 해당 사례들이 전형적인 사례가 아니라 주목할 만하고 새로운 사례라는 점도 명시합니다.[1]
대안은 일정한 임계치에 따른 의무적·표준화된 악용 보고입니다. 공개 보고와 국가안보 당국에 필요한 상세 정보도 구별합니다.[1]
분석·한계
이 절은 증거 수준을 엄격하게 읽어야 합니다.
시도와 성공은 다름
기업이 관찰한 사례와 전체 발생률은 다름
계정 차단과 외부 피해 종료는 다름
기업의 행위자 귀속 판단과 확정된 법적 사실은 다름
선별된 위협 사례만으로 전체 악용의 빈도나 증가율을 산정할 수는 없습니다.
실무 시사점
안전 사고 관리와 별도로 악용 탐지·보고 체계를 마련하고, 개발자·배포자·플랫폼 간 보고 형식을 일관되게 설계할 필요가 있습니다.
⑮ 파국적 위험을 예방하려면 중국도 협상에 참여해야 한다
원제: Preventing catastrophic risks requires Beijing at the table 필자: Andrew W. Wyckoff
원문 논지
미·중 경쟁과 불신을 전제로 하더라도 AI 위험 협력은 필요합니다. 필자는 거대한 합의보다 작은 성과부터 시작할 것을 제안합니다.[1]
안전 담당 조직 식별
정례 회의
재난 대응 핫라인
공통 용어와 위험 분류
우선순위·금지선 합의
시험·감사·집행 절차 공유[1]
분석·한계
이 절의 접근은 신뢰가 충분히 형성될 때까지 기다리는 것이 아니라 위기관리 채널을 먼저 만드는 것입니다.
다만 회의나 원칙 채택이 실제 위험 감소를 보장하지는 않습니다. 정보 공유 범위, 검증 수단, 대응 시한, 합의 위반 시 처리 방법이 필요합니다.
실무 시사점
국제 협력의 성과는 선언문 수보다 공통 사고 분류, 연락망 작동 여부, 공동 훈련, 평가 상호운용성, 이행 결과로 평가해야 합니다.
⑯ AI 연구소를 제약회사처럼 다뤄라
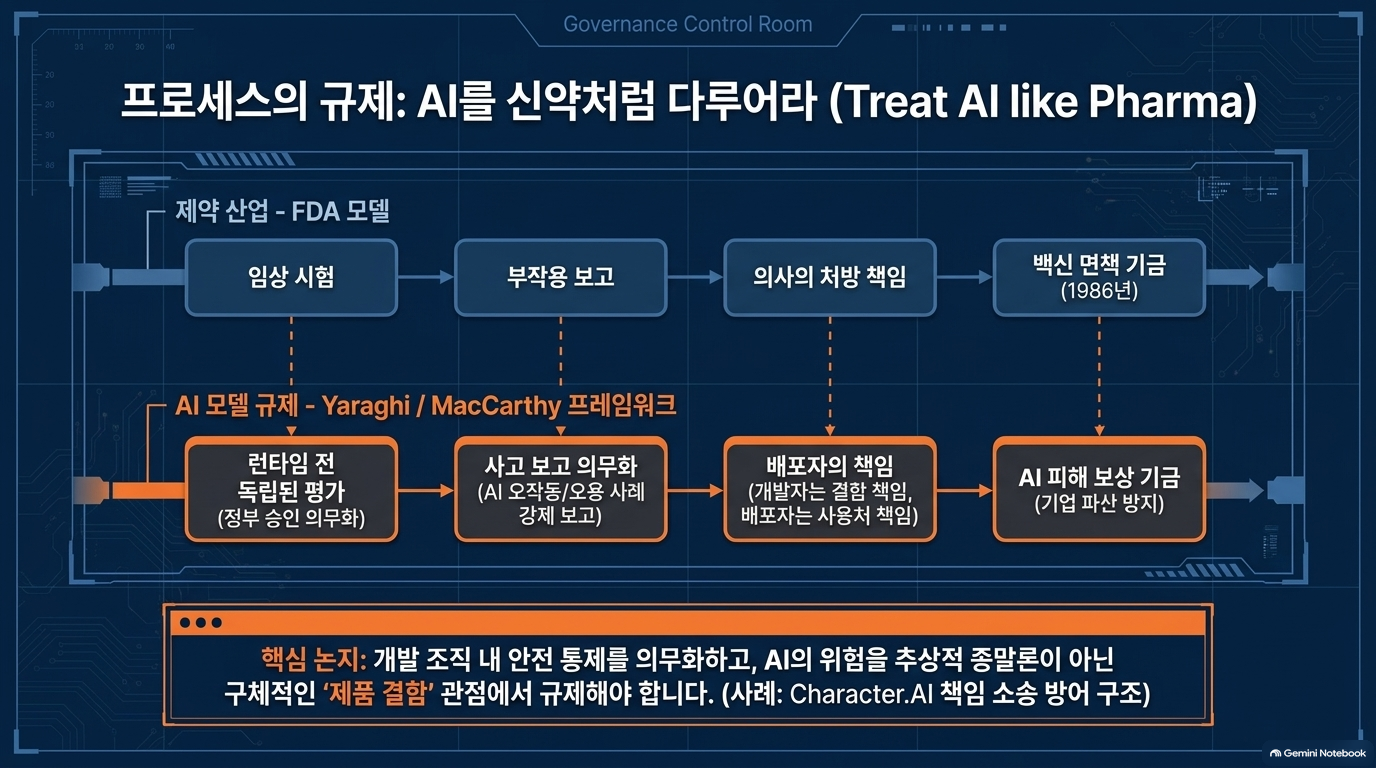
원제: Treat AI labs like drug makers 필자: Niam Yaraghi
원문 논지
의약품도 엄격한 안전 규제하에서 피해를 일으키지만, 책임 주체와 관리 체계가 존재합니다. 필자는 이 구조를 AI에 적용하자고 제안합니다.[1]
| 의약품 체계 | 원문의 AI 대응 비유 |
| 제조사 | 모델 개발 연구소 |
| 제품 라벨·경고 | 시스템 카드 |
| 처방 의사 | 모델 배포·활용 주체 |
| 시판 후 이상사례 보고 | 배포 후 AI 사고 보고 |
| 위험 약물의 통제된 접근 | 위험 AI 능력의 접근 제한 |
| 보상기금 | 필요시 AI 피해 보상 장치 |
책임 배분, 국외 제조자·수입자의 책임, 시판 후 감시, 접근 제한, 일반 책임제도가 공급을 위협할 경우의 보상 장치를 제안합니다.[1]
분석·한계
이 절은 문서의 제안을 가장 구체적인 생애주기 책임 구조로 묶습니다.
그러나 의약품과 AI는 동일하지 않습니다. AI는 범용성이 높고 업데이트가 잦으며, 도구·권한·사용 환경에 따라 위험이 달라집니다. 따라서 의약품 규제를 그대로 복제하기보다 그 원리를 이전하는 편이 적절합니다.
또한 원문에 등장하는 소송의 기각 회피나 병합은 피고의 최종 책임이 확정되었다는 뜻이 아닙니다.
실무 시사점
시스템 카드는 홍보 문서가 아니라 알려진 제한, 부적절한 사용, 시험 범위, 필요한 보호조치, 변경 이력을 전달하는 책임 문서로 다뤄야 합니다.
4. 챕터 간 핵심 대립과 공통점
4.1 실존적 위험에 대한 결론은 합의되어 있지 않다
| 쟁점 | 문서 내부의 서로 다른 관점 |
| 실존적 위험의 존재 | 통제 상실 가능성을 경계하는 관점과 이를 부정하는 관점이 공존 |
| 기업 간 개발 속도 조절 | 집단행동 문제의 해법이라는 관점과 카르텔·규제 포획을 우려하는 관점 |
| 신규 AI 규제 | 개발 과정·사전 승인 강화와 기존 제품책임·경쟁법 활용 |
| 개발 감속 | 위험 통제의 기회인 동시에 유익한 기술 확산을 늦출 비용 |
| 독립 평가 | 필요하지만 접근권, 측정 품질, 이해충돌 해소가 없으면 불충분 |
따라서 이 글을 “Brookings가 AI 멸종 위험을 인정했다” 또는 “Brookings가 AI 위험을 부정했다”로 요약하면 부정확합니다. 각 절은 해당 필자의 견해입니다.[1]
4.2 반면 통제의 기본 방향은 반복된다
문서 전체를 관통하는 공통 요구는 다음과 같습니다.[1]
측정 가능한 평가 → 충분한 정보 공개 → 실행 가능한 통제 → 독립 감독 → 책임과 구제
다만 이는 원문에 제시된 단일 공식이 아니라, 여러 필자의 제안을 종합한 분석 틀입니다.
5. 종합 결론
이 문서의 강점은 실존적 위험의 찬반 논쟁을 넘어, 지금 적용할 수 있는 규제·운영 통제로 논의를 이동시킨다는 점입니다.
반면, 인류 멸종 위험의 확률을 산정하거나 특정 규제가 이를 얼마나 줄이는지 입증하는 문서는 아닙니다. 개발 속도 조절, 사전 승인, 접근 제한 등에 대해서도 적용 대상과 임계치가 충분히 구체화되어 있지는 않습니다.
공공 AI 컨설팅·감리 관점에서 특히 중요한 절은 ⑧ 측정의 신뢰성, ⑨ 배포 시스템과 실행 통제, ⑭ 악용 보고, ⑯ 생애주기 책임입니다. 이들을 연결하면 다음과 같은 실무적 결론을 도출할 수 있습니다.
안전성은 모델의 선언이나 벤치마크 점수만으로 확인할 수 없습니다. 실제 권한과 환경에서 행동을 검증하고, 위험한 실행을 통제하며, 사고의 증거와 책임을 추적할 수 있어야 합니다.
Sources
[1] https://www.brookings.edu/articles/is-the-ai-existential-threat-real-and-can-regulatory-action-prevent-it — Is the AI existential threat real—and can regulatory action prevent it?